모수적 생존 모형
개요
모수적 생존 모형은 사건시간이 유한개의 모수로 완전히 지정되는 알려진 확률분포를 따른다고 가정한다. 비모수적인 카플란-마이어 추정량과 달리 모수 모형은 매끄러운 생존곡선과 위험곡선을 만들고, 외삽을 가능하게 하며, 정보기준을 통한 형식적 모형 비교를 지원한다. 이 절에서는 가장 흔한 세 모수족 --- 지수, 와이불, 로그정규 --- 을 다루고 절단자료의 최대가능도 추정을 보인다.
지수 모형
설정
지수분포는 가장 단순한 모수적 생존 모형으로, 비율모수 \(\lambda > 0\) 하나와 상수 위험으로 특징지어진다.
평균 생존시간은 \(E[T] = 1/\lambda\)이다.
무기억성
지수분포는 무기억성으로 유일하게 특징지어진다.
추가로 \(s\)만큼 더 생존할 확률이 이미 얼마나 오래 생존했는지에 의존하지 않는다는 뜻이다.
최대가능도 추정
시간 \(t_1, \ldots, t_n\)과 사건 지시자 \(\delta_1, \ldots, \delta_n\)(사건이면 \(\delta_i = 1\), 절단이면 \(0\))을 갖는 대상 \(n\)명에 대해 로그가능도는
이며 \(d = \sum \delta_i\)다. \(\ell'(\lambda) = 0\)으로 놓으면
를 얻는다. MLE는 사건 수를 총 인시로 나눈 값이다.
와이불 모형
설정
와이불 분포는 척도모수 \(\lambda > 0\)에 형상모수 \(k > 0\)을 더해 지수분포를 일반화한다.
형상모수의 역할
| \(k\) | 위험의 거동 | 해석 |
|---|---|---|
| \(k < 1\) | 감소 | 초기 고장이 지배적. 살아남은 것은 견고해짐 |
| \(k = 1\) | 일정 | 지수분포(\(\lambda\))로 환원 |
| \(k > 1\) | 증가 | 마모나 노화. 시간에 따라 위험이 커짐 |
중앙 생존시간은 \(t_{0.5} = \lambda (\ln 2)^{1/k}\)이다.
최대가능도 추정
와이불 모형의 로그가능도는
이다. 닫힌 형태의 해는 없다. 수치 최적화(예: 뉴턴-랩슨이나 프로파일 가능도)를 쓴다.
와이불 가정 점검하기
와이불 모형은 로그-로그 척도에서의 선형성을 함의한다.
와이불 모형이 적절하다면 (넬슨-알렌 추정량으로 구한) \(\ln \hat{H}(t)\) 대 \(\ln t\) 그림이 직선에 가까워야 한다.
로그정규 모형
설정
로그정규 모형은 \(\ln T \sim N(\mu, \sigma^2)\)을 가정한다. 생존함수와 위험함수는 단순한 닫힌 형태가 없고 표준정규 누적분포함수 \(\Phi\)로 표현된다.
여기서 \(\phi\)는 표준정규 확률밀도함수다.
핵심 특징
로그정규 위험은 비단조다. 처음에 증가했다가 감소한다. 그래서 위험이 중간 시점에 정점을 이룬 뒤 내려가는 현상(예: 수술 후 회복, 특정 질병의 재발 양상)에 적합하다.
보기 1. 세 모수적 생존모형의 로그가능도. 아래 세 함수는 절단을 포함한 음의 로그가능도를 계산한다.
(1) 지수모형의 로그가능도 \(\ell(\lambda) = d\ln\lambda - \lambda\sum_i t_i\)에서 최대가능도추정량이 \(\hat\lambda = d/\sum_i t_i\)임을 유도하시오(\(d\)는 사건 수). 절단된 관측도 분모의 총 관찰시간에 들어간다는 점을 설명하시오.
(2) 와이불 로그가능도에 \(k = 1\)을 넣으면 지수 로그가능도와 정확히 같아짐을 식으로 보이고, 둘 다 코드로 확인하시오.
풀이
(1) 해석적으로. 위험이 상수 \(\lambda\)이면 \(f(t) = \lambda e^{-\lambda t}\), \(S(t) = e^{-\lambda t}\)다. 사건을 겪은 사람은 \(f(t_i)\)를, 절단된 사람은 \(S(t_i)\)를 기여하므로 가능도는
이다. 지수항이 두 무리에서 똑같은 꼴이라 전부 합쳐지고, \(\lambda\)의 거듭제곱만 사건 수 \(d\)만큼 남는다. 그래서 자료가 \((d, \sum_i t_i)\) 두 수로 요약된다. 로그를 취하면
이고 \(\ell''(\lambda) = -d/\lambda^2 < 0\)이므로 최대다.
분모가 관측 수 \(n\)이 아니라 총 관찰시간이라는 점이 핵심이다. 절단된 사람은 분자에 사건을 보태지 않지만 분모에는 자기가 지켜본 시간만큼 기여한다. \(\hat\lambda\)는 "단위 시간당 몇 건이 일어났는가"이고, 이것이 역학에서 말하는 발생률이다. 절단을 버리면 분모가 줄어 위험을 과대평가하게 된다.
(2) 해석적으로. 코드의 와이불 로그가능도에 \(k = 1\)을 넣는다.
이다. 셋째 항의 계수 \(k-1\)이 0이 되어 통째로 사라진다. 한편 지수 로그가능도에 비율 \(\lambda_E = 1/\lambda\)를 넣으면
로 글자 하나까지 같다. 근사가 아니라 항등식이다. 와이불의 \(\lambda\)가 척도이고 지수의 \(\lambda\)가 비율이어서 서로 역수라는 점만 맞추면 된다.
그래서 두 모형은 내포 관계다. 와이불이 모수를 하나 더 쓰면서 \(k = 1\)에서 지수를 품으므로, \(H_0: k = 1\)에 대한 가능도비검정을 자유도 1로 할 수 있다.
(1)(2) 수치적으로.
import numpy as np
from scipy.optimize import minimize
from scipy.stats import norm

def neg_loglik_exponential(lam, times, events):
    """지수모형의 음의 로그가능도.

    위험함수가 시간에 관계없이 일정하다고 본다. 가장 단순한 모형이라
    사건 수와 총 관찰시간만 있으면 되고, MLE 도 그 비로 바로 나온다.
    """
    d = events.sum()
    total_time = times.sum()
    return -(d * np.log(lam) - lam * total_time)

def neg_loglik_weibull(params, times, events):
    """와이불모형의 음의 로그가능도.

    모양모수 k 가 위험함수의 방향을 정한다. k>1 이면 시간이 갈수록 위험이
    커지고(마모), k<1 이면 작아지며(초기 결함), k=1 이면 지수모형이 된다.
    지수모형을 특수한 경우로 품고 있는 셈이다.
    """
    k, lam = params
    d = events.sum()
    ll = (d * np.log(k)
          - d * k * np.log(lam)
          + (k - 1) * np.sum(events * np.log(times + 1e-15))
          - np.sum((times / lam) ** k))
    return -ll

def neg_loglik_lognormal(params, times, events):
    """로그정규모형의 음의 로그가능도.

    위험함수가 올랐다가 다시 내려가는 모양이 된다. 수술 직후 위험이 높다가
    회복하면서 낮아지는 자료처럼, 와이불로는 담기 어려운 경우에 쓴다.
    """
    mu, sigma = params
    # 1e-15 를 더하는 것은 시각이 0 일 때 로그가 발산하는 것을 막기 위함이다.
    z = (np.log(times + 1e-15) - mu) / sigma
    # 사건이 관측된 사람은 밀도함수를, 중도절단된 사람은 생존함수(logsf)를
    # 기여한다. 중도절단 자료를 다루는 가능도의 일반적인 꼴이다.
    ll = np.sum(
        events * norm.logpdf(z) - events * np.log(sigma * times + 1e-15)
        + (1 - events) * norm.logsf(z)
    )
    return -ll

# --- 자료를 만든다. 참 비율 0.1, t = 15 에서 행정절단 ---
rng = np.random.default_rng(1)
n = 200
T = rng.exponential(10.0, n)
times = np.minimum(T, 15.0)
events = (T <= 15.0).astype(int)

d, S = events.sum(), times.sum()
print(f"n = {n}, 사건 d = {d}, 총 관찰시간 = {S:.4f}")
print(f"해석적 lambda_hat = d / sum(t) = {d / S:.6f}   (참값 0.1)")

res = minimize(neg_loglik_exponential, x0=[0.05], args=(times, events),
               bounds=[(1e-8, None)])
print(f"수치최적화 lambda_hat = {res.x[0]:.6f},  -ll = {res.fun:.6f}")
print(f"해석적 자리의 -ll      = {neg_loglik_exponential(d / S, times, events):.6f}")

# --- (2) k = 1 에서 두 로그가능도가 같아야 한다 ---
for lam_scale in (5.0, 10.0, 23.7):
    a = neg_loglik_weibull((1.0, lam_scale), times, events)
    b = neg_loglik_exponential(1.0 / lam_scale, times, events)
    print(f"  scale={lam_scale}: 와이불(k=1) {a:.9f}   지수(1/scale) {b:.9f}   차 {a - b:.2e}")

print(f"  SE(lambda_hat) = lambda_hat/sqrt(d) = {(d / S) / np.sqrt(d):.6f},  "
      f"z = {(0.1 - d / S) / ((d / S) / np.sqrt(d)):+.2f}")
출력:
n = 200, 사건 d = 156, 총 관찰시간 = 1598.9815
해석적 lambda_hat = d / sum(t) = 0.097562   (참값 0.1)
수치최적화 lambda_hat = 0.097562,  -ll = 519.053513
해석적 자리의 -ll      = 519.053513
  scale=5.0: 와이불(k=1) 570.868604999   지수(1/scale) 570.868604999   차 -1.14e-13
  scale=10.0: 와이불(k=1) 519.101419837   지수(1/scale) 519.101419837   차 0.00e+00
  scale=23.7: 와이불(k=1) 561.281679379   지수(1/scale) 561.281679379   차 0.00e+00
  SE(lambda_hat) = lambda_hat/sqrt(d) = 0.007811,  z = +0.31
해석적 답과 수치최적화가 소수 여섯째 자리까지 같다. 두 자리에서의 음의 로그가능도도 \(519.053513\)으로 일치하니 최적화가 같은 점을 찾았다.
\(\hat\lambda = 0.097562\)는 참값 \(0.1\)에서 \(0.31\) 표준오차 떨어져 있다. 표준오차가 \(\hat\lambda/\sqrt d\)인 것도 (1)에서 나온다. \(\ell''(\lambda) = -d/\lambda^2\)이므로 관측정보가 \(d/\hat\lambda^2\)이고 그 역수의 제곱근이 \(\hat\lambda/\sqrt d\)다. 정밀도를 정하는 것은 표본크기 \(n = 200\)이 아니라 사건 수 \(d = 156\)이며, 생존연구에서 "사건 수가 검정력을 정한다"고 말하는 까닭이 이것이다.
\(k = 1\)에서 두 로그가능도의 차이가 세 척도 모두 \(10^{-13}\) 이하다. 부동소수점 오차 수준이므로 (2)의 항등식이 그대로 확인된다.
각 함수는 표준 최소화 루틴을 쓸 수 있도록 음의 로그가능도를 계산한다. 사건 지시자 events[i] 는 관측된 사건이면 1, 절단이면 0이다. 절단된 대상은 생존함수 항 \(\ln S(t_i)\)을 통해 기여한다.
\(\varepsilon = 10^{-15}\) 보정에 대하여
코드의 times + 1e-15는 \(t_i = 0\)일 때 \(\log 0\)을 피하기 위한 것이다. 생존시간이 엄밀히
양수라면 필요 없지만, 자료에 \(t = 0\)이 섞여 있으면 방어가 된다. 다만 \(t = 0\)인 관측치가
실제로 있다면 그것은 자료 오류일 가능성이 높으므로, 보정으로 덮기보다 원인을 확인하는 편이
낫다.
또한 최적화 시 \(k, \lambda, \sigma\)가 양수여야 하므로, 21.3절에서 권한 대로 로그 척도에서
최적화하거나 minimize(..., bounds=...)로 제약을 걸어야 한다. 위 함수들을 그대로
무제약 최적화에 넘기면 음수 모수에서 nan이 발생할 수 있다.
모형 선택
모수 모형은 최대화된 로그가능도 \(\hat{\ell}\)과 모수 개수 \(p\)로 계산한 정보기준으로 비교한다.
값이 낮을수록 적합도와 복잡도의 절충이 낫다. 지수 모형은 \(p = 1\), 와이불과 로그정규는 \(p = 2\)다.
지수 모형은 와이불에 내포되어 있으므로(\(k = 1\)), 가능도비 검정으로 형상모수가 추가로 필요한지를 형식적으로 검정할 수 있다.
그림 진단
적합된 모수적 생존곡선을 언제나 카플란-마이어 추정치와 비교하라. AIC가 무엇을 말하든 크게 어긋나면 모형이 잘못 지정된 것이다.
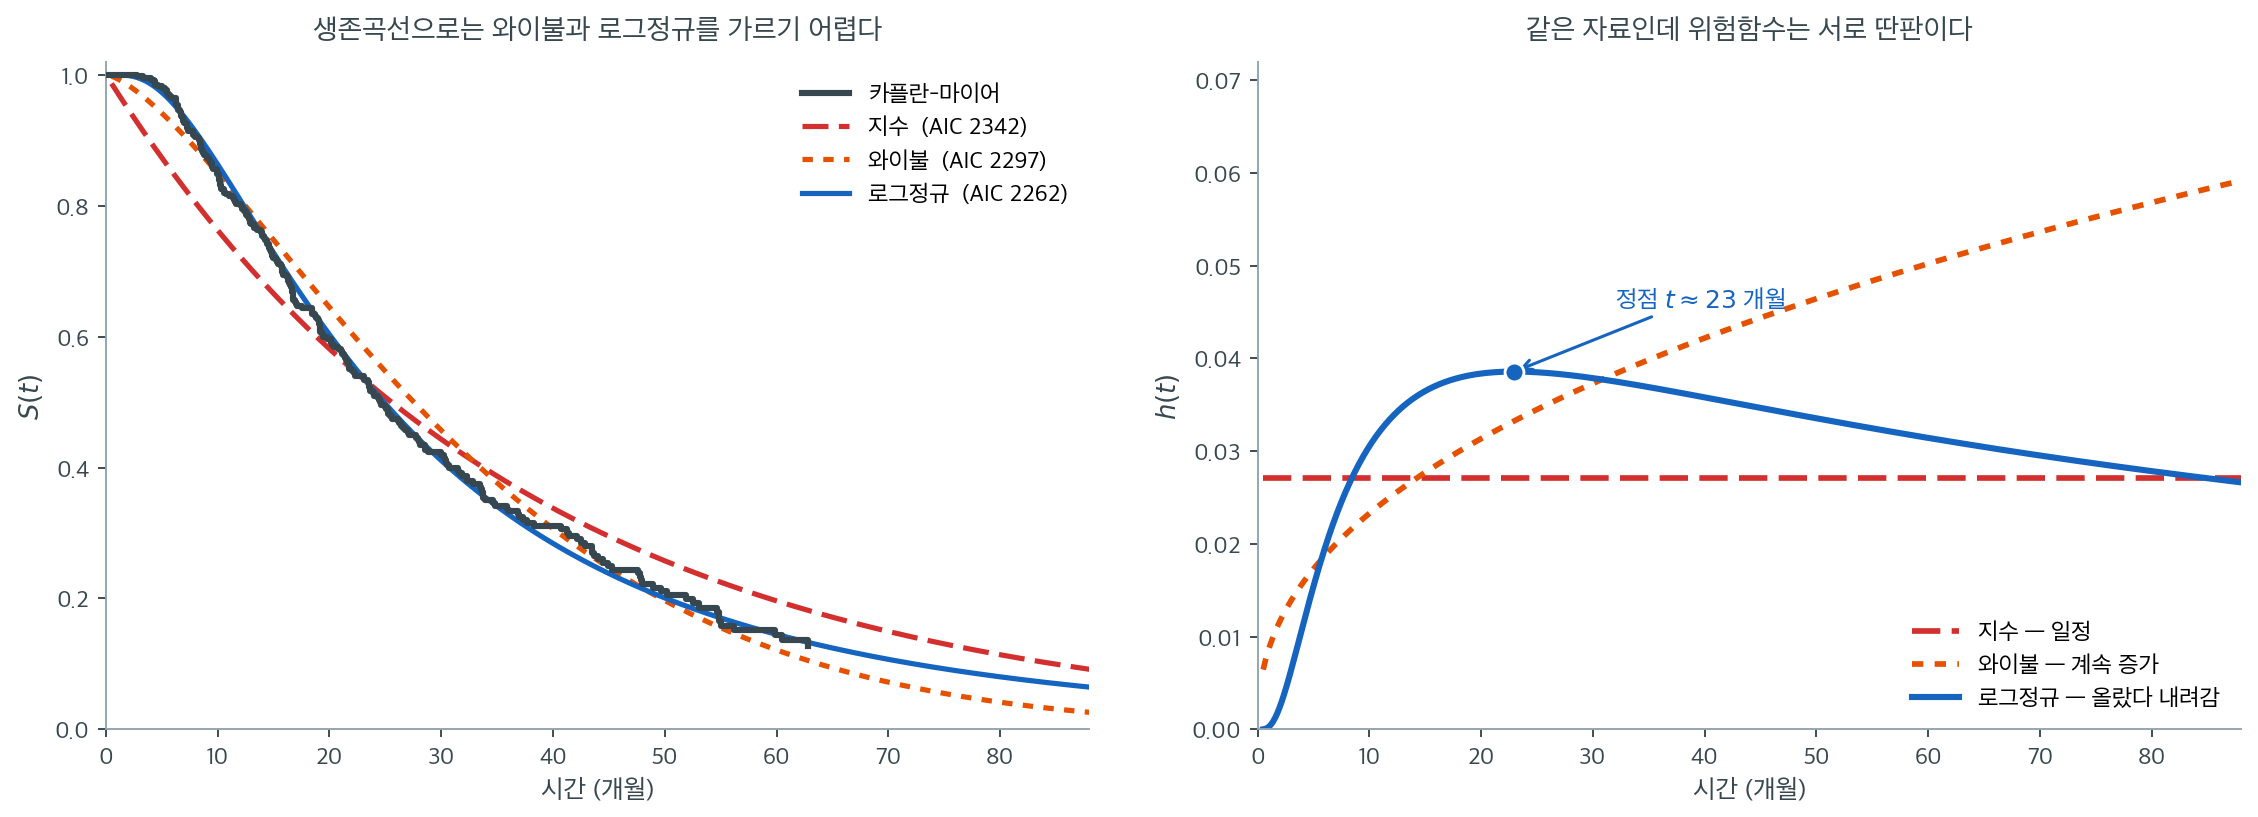
참값이 로그정규(\(\mu = 3.2\), \(\sigma = 0.8\))인 자료 \(n = 400\)을 만들고 무작위로 절단해 절단율 \(36.5\%\), 사건 254건을 얻은 뒤 세 모형을 최대가능도로 적합했다. 결과는 \(\hat\lambda = 0.0271\)(지수), \(\hat k = 1.43\)·\(\hat\lambda = 35.6\)(와이불), \(\hat\mu = 3.21\)·\(\hat\sigma = 0.83\)(로그정규)이고 AIC는 각각 \(2342\), \(2297\), \(2262\)다. AIC가 로그정규를 고르며, 참값을 정확히 되찾았다.
그런데 왼쪽 그림을 보면 그 승부가 눈으로는 잘 보이지 않는다. 지수 모형(붉은 파선)은 초반에 카플란-마이어보다 아래로 처져 눈에 띄게 어긋나지만, 와이불(주황 점선)과 로그정규(파란 실선)는 계단을 따라 거의 나란히 지나간다. 둘의 AIC 차이 \(35\)는 통계적으로 결정적인 크기인데, 생존곡선 위에서는 \(t = 50\) 부근에서 겨우 \(0.02\) 정도 벌어질 뿐이다.
오른쪽으로 옮기면 사정이 달라진다. 같은 세 적합의 위험함수가 서로 완전히 다른 이야기를 한다. 지수는 \(0.0271\)로 평평하고, 와이불은 \(\hat k = 1.43 > 1\)이라 끝없이 올라가며, 로그정규는 \(t \approx 23\)개월에서 \(h = 0.039\)로 정점을 찍고 내려온다. "이 대출들의 부도 위험은 앞으로 커지는가, 줄어드는가"라는 실무 질문에 두 모형이 정반대로 답한다. 30개월 이후를 보면 와이불은 위험이 계속 커진다고 하고 로그정규는 이미 고비를 넘겼다고 한다.
그러니 순서를 이렇게 잡는 것이 좋다. AIC로 후보를 좁히고, 생존곡선 그림으로 큰 오지정을 걸러내고, 위험함수 그림으로 결론이 실제로 무엇을 뜻하는지 확인한다. 위 그림에서 지수 모형은 두 번째 단계에서 탈락하고, 와이불과 로그정규의 승부는 첫 번째 단계가 가른다. 그리고 그 승부의 실질적 의미는 세 번째 단계에서야 드러난다. 어느 한 단계만으로는 부족하다.
해석
- 지수 모형: 위험이 대략 일정할 때 적절하다. 기준선으로 유용하지만 실제로 정확한 경우는 드물다.
- 와이불 모형: 단조 위험을 포착한다. 형상모수 \(k\)가 위험이 시간에 따라 증가하는지(\(k > 1\)) 감소하는지(\(k < 1\))를 곧바로 알려 준다.
- 로그정규 모형: 올랐다가 내려가는 비단조 위험에 적합하다. 초기 위험이 높지만 장기 생존자의 위험은 감소하는 의학적 응용에서 흔하다.
- 모형 선택: 비내포 비교에는 AIC/BIC를, 내포 모형에는 가능도비 검정을 쓴다. 언제나 그림 점검으로 보완하라.
연습문제
연습문제 1. 지수 모형의 MLE
어떤 연구가 대상 25명을 추적한다. 관측된 사건이 16건(\(d = 16\))이고 총 인시는 \(\sum t_i = 3{,}200\)시간이다.
(a) MLE \(\hat{\lambda}\)를 계산하라.
(b) 평균 생존시간과 \(t = 100\)에서의 생존확률을 추정하라.
풀이
(a) \(\hat{\lambda} = d / \sum t_i = 16 / 3200 = 0.005\)(시간당).
(b) 평균 생존시간은 \(1/\hat{\lambda} = 200\)시간이다.
\(t = 100\)에서의 생존율은
연습문제 2. 와이불 형상모수의 해석
장비 고장 자료에 적합한 와이불 모형이 \(\hat{k} = 2.3\), \(\hat{\lambda} = 800\)시간을 주었다.
(a) 위험이 증가하는가 감소하는가?
(b) 고장까지의 중앙시간을 계산하라.
(c) \(t = 400\)과 \(t = 600\)에서의 추정 위험을 비교하라.
풀이
(a) \(\hat{k} = 2.3 > 1\)이므로 위험이 시간에 따라 증가한다. 장비가 마모된다.
(b) \(t_{0.5} = \lambda (\ln 2)^{1/k} = 800 \times (0.6931)^{1/2.3} = 800 \times 0.6931^{0.4348} = 800 \times 0.8527 = 682.2\)시간.
(c) \(t = 400\)에서
\(t = 600\)에서
이다. \(t = 600\)의 위험이 \(t = 400\)의 약 \(1.69\)배로, 위험이 증가한다는 사실과 부합한다.
위험비는 시간의 비만으로 결정된다
와이불에서 \(h(t) \propto t^{k-1}\)이므로
이다. 여기서 \((600/400)^{1.3} = 1.5^{1.3} = 1.69\)로 척도모수 \(\lambda\)가 소거된다. 즉 위험의 상대적 증가는 형상모수만으로 정해지고, \(\lambda\)는 절대 수준만 조절한다.
연습문제 3. 로그정규 위험의 모양
(a) 로그정규 위험함수가 왜 비단조인지 설명하라.
(b) \(\mu = 3\), \(\sigma = 0.8\)인 로그정규 모형에서 중앙 생존시간을 계산하라.
풀이
(a) 로그정규 위험 \(h(t) = f(t)/S(t)\)는 밀도와 생존함수의 비다. \(t\)가 작으면 밀도 \(f(t)\)가 증가하는 동안 \(S(t)\)는 1에 가까우므로 위험이 증가한다. \(t\)가 크면 \(f(t)\)와 \(S(t)\)가 모두 감소하지만 \(f(t)\)가 더 빨리 감소하여 위험이 결국 내려간다. 그 결과 봉우리형 위험곡선이 된다.
(b) 로그정규분포에서 \(T\)의 중앙값은 \(e^{\mu}\)다. \(\ln T \sim N(\mu, \sigma^2)\)의 중앙값이 \(\mu\)이고 지수함수가 단조증가이므로 \(e^\mu\)가 \(T\)의 중앙값이 된다. 따라서
중앙 생존시간은 약 20.1 시간단위다. 중앙값이 \(\sigma\)와 무관하다는 점에 주목하라. \(\sigma\)는 분포의 퍼짐만 조절하며 평균 \(e^{\mu + \sigma^2/2} = e^{3.32} = 27.7\)에는 영향을 준다.
연습문제 4. 모형 비교
어떤 분석자가 대상 100명의 같은 자료에 모형 세 개를 적합했다. 결과는 다음과 같다.
| 모형 | 모수 | 최대 로그가능도 |
|---|---|---|
| 지수 | 1 | \(-312.5\) |
| 와이불 | 2 | \(-298.1\) |
| 로그정규 | 2 | \(-300.3\) |
(a) 각 모형의 AIC를 계산하라.
(b) \(\alpha = 0.05\)에서 지수 대 와이불의 가능도비 검정을 수행하라.
(c) 어느 모형을 고르겠는가? 이유는?
풀이
(a) AIC \(= -2\hat{\ell} + 2p\)이므로,
- 지수: \(-2(-312.5) + 2(1) = 627.0\)
- 와이불: \(-2(-298.1) + 2(2) = 600.2\)
- 로그정규: \(-2(-300.3) + 2(2) = 604.6\)
(b) 가능도비 통계량은
이다. \(H_0: k = 1\) 아래에서 \(\Lambda \sim \chi^2_1\)이고 \(\alpha = 0.05\)의 임계값은 3.84다. \(28.8 \gg 3.84\)이므로 지수 모형을 기각하고 와이불을 택한다. 위험이 일정하지 않다.
(c) 와이불 모형의 AIC가 600.2로 가장 낮고, 가능도비 검정에서 지수 모형보다 유의하게 낫다. 로그정규보다도 낫다(AIC 600.2 대 604.6). 이 자료에서 와이불이 적합도와 간결성의 절충이 가장 좋다.
다만 와이불과 로그정규의 AIC 차이 \(4.4\)는 결정적이라 하기에는 크지 않다. 두 모형은 위험의 모양에 대해 전혀 다른 이야기를 한다(단조 증가 대 봉우리형). 관측 구간 안에서 예측만 한다면 어느 쪽이든 비슷하지만, 위험의 모양 자체가 결론이거나 외삽이 필요하다면 AIC 차이 \(4.4\)에 의존해서는 안 된다. 넬슨-알렌 누적위험 그림을 보고 어느 쪽이 자료의 모양과 맞는지 직접 확인하라.
연습문제 5. 절단이 있는 가능도
밀도가 \(f(t)\)이고 생존함수가 \(S(t)\)인 모수적 생존 모형에서, 시점 \(t_i\)에 절단된 관측치의 가능도 기여가 \(f(t_i)\)가 아니라 \(S(t_i)\)임을 보여라.
풀이
시점 \(t_i\)의 관측된 사건에 대해서는 사건이 무한소 구간 \([t_i, t_i + dt)\)에서 일어났음을 안다. 그 확률이 \(f(t_i)\,dt\)이므로 (비례상수를 무시하면) 가능도 기여는 \(f(t_i)\)다.
시점 \(t_i\)에 절단된 관측치에 대해서는 참 사건시간 \(T_i\)가 \(t_i\)를 넘는다는 것만 안다. 그 확률은
이다. 따라서 가능도 기여는 \(f(t_i)\)가 아니라 \(S(t_i)\)다. 두 경우를 합치면 대상 \(i\)의 가능도는
이며 사건이면 \(\delta_i = 1\), 절단이면 \(\delta_i = 0\)이다. 이것이 절단자료를 다루는 모든 모수적 생존 모형 추정의 기초다. \(\square\)
정리하며
모수 모형은 매끄러운 곡선과 외삽을 준다.
- 카플란–마이어의 계단과 대조된다. 분포를 가정한 대가로 매끄러운 \(\hat S(t)\) 와 \(\hat h(t)\) 를 얻고, 관측 범위 밖으로 외삽할 수 있다.
- 모수가 적어 효율적이다. 가정이 맞으면 비모수보다 정밀하며, 특히 표본이 작을 때 이득이 크다.
- 가정이 틀리면 편향된다. 그것이 대가이며, 진단이 필수다.
- 모형 선택은 AIC 와 진단 그림으로 한다. 누적위험 그림의 모양이 어느 분포가 맞는지 알려 주며, 13장의 정보기준이 그대로 쓰인다.
- 외삽은 조심해야 한다. 관측 기간 밖의 예측은 전적으로 분포 가정에 의존하므로, 5년 자료로 20년을 예측하는 일은 위험하다.
다음 절부터 콕스 비례위험 모형으로 넘어간다.