교란과 인과관계
두 변수는 어느 한쪽이 다른 쪽을 유발하지 않고도 함께 움직일 수 있다. 교란(confounding) 은 그러한 비인과적 연관성을 만들어내는 기제를 가리키는 공식 명칭이며, "상관관계는 인과관계를 뜻하지 않는다"는 표어가 그 일상적 요약이다. 교란을 이해하는 것은 관찰자료에서 나타나는 어떤 통계적 연관성이든 해석하는 데 필수적이며, 이를 알아보느냐 못 보느냐가 유용한 경험적 발견과 행동을 오도하는 결론을 가른다.
정의 1. 교란변수
교란변수 \(Z\)는 노출 \(X\)와 결과 \(Y\) 모두와 연관되어 있으면서 \(X\)에서 \(Y\)로 가는 인과 경로 위에 있지는 않은 변수다. 도식으로 나타내면 다음과 같다.
\(Z\)가 존재하는데 고려되지 않으면, 관측된 \(X\)와 \(Y\)의 연관성은 \(X\)가 \(Y\)에 미치는 (0일 수도 있는) 인과효과와 \(Z\)를 통해 유도된 허위 연관성을 뒤섞게 된다.
방향에 관한 표현이 중요하다. 인과 경로 위에 있는 변수(\(X \to Z \to Y\))는 교란요인이 아니라 매개변수(mediator) 다. \(X\)와 \(Y\) 모두에 의해 유발되는 변수는 충돌변수(collider) 이며, 여기에 조건을 걸면 허위 연관성을 제거하기는커녕 오히려 만들어낼 수 있다.
고전적 예
- 아이스크림 판매와 익사는 둘 다 여름에 증가한다. 교란요인: 기온.
- 커피 애호가와 폐암은 상관이 있어 보인다. 역사적 교란요인: 흡연(커피를 마시는 사람이 담배도 피우는 경향이 있었다).
- 학령기 아동의 신발 크기와 읽기 능력은 양의 상관을 보인다. 교란요인: 나이.
- 입원과 사망률: 입원한 환자가 더 자주 사망한다. 교란요인: 질병의 중증도.
- 적포도주와 장수: 적포도주를 즐기는 사람이 더 오래 산다. 교란요인: 사회경제적 지위(의료 접근성, 식단, 생활양식이 함께 따라온다).
- 황새 개체수와 출생률: 일부 유럽 지역에서 황새가 많은 곳에 아이도 많이 태어난다. 교란요인: 도시화 정도(농촌은 황새 서식지가 넓고 가구당 자녀 수도 많다).
- 패스트푸드점 수와 범죄율: 함께 증가한다. 교란요인: 인구밀도와 빈곤(둘 다 도심에 집중된다).
- 클래식 음악 감상과 학업성취: 클래식을 듣는 학생의 성적이 높다. 교란요인: 부모의 교육수준과 소득.
- 절도 건수와 경찰 인력: 경찰이 많은 지역일수록 절도가 많다. 교란요인: 도시의 규모와 소득 수준(사람도 많고, 훔칠 것도 많고, 그래서 경찰도 많이 배치한다). 여기서는 역인과의 가능성까지 겹친다 — 절도가 많아서 경찰을 늘렸을 수도 있다.
- 아이스크림 판매와 우산 판매: 아이스크림이 잘 팔리는 날에는 우산이 덜 팔린다. 교란요인: 날씨.
각 경우에 관측된 연관성 자체는 실재하지만, 제시된 인과적 해석은 틀렸다.
교란요인은 가운데에 있고, 양쪽 방향으로 다 밀 수 있다
앞의 예들을 그림으로 그리면 화살표는 언제나 가운데에서 바깥으로 나간다. 교란요인 \(Z\)가 손잡이를 쥐고 \(X\)와 \(Y\)를 동시에 움직인다.
아이스크림 예 둘을 나란히 놓으면 중요한 사실 하나가 보인다.
| 관측된 연관 | \(Z\) | \(Z \to X\) | \(Z \to Y\) | 부호 |
|---|---|---|---|---|
| 아이스크림 ↑, 익사 ↑ | 기온 | \(+\) | \(+\) | 양 |
| 아이스크림 ↑, 우산 ↓ | 날씨(맑음) | \(+\) | \(-\) | 음 |
같은 아이스크림 판매량인데 한 번은 양의 연관, 한 번은 음의 연관이 나온다. 교란은 허위의 양의 상관만 만드는 것이 아니다. \(Z\)가 \(X\)와 \(Y\)를 반대 방향으로 밀면 허위의 음의 상관이 나오고, 심하면 실재하는 양의 인과효과를 상쇄해 아무 상관도 없는 것처럼 보이게 만들 수도 있다.
실무적 함의: "상관이 없으니 인과도 없다"는 추론도 "상관이 있으니 인과가 있다"는 추론만큼 위험하다. 두 경우 모두 교란요인을 찾기 전에는 아무 말도 할 수 없다.
황새 보기를 우습게 보지 말 것
황새와 출생률은 농담처럼 들리지만, 실제로 통계 교육에서 가장 유용한 예다. 아무도 황새가 아기를 물어다 준다고 믿지 않기 때문이다.
바로 그래서 이 예에서는 우리가 상관계수를 보고도 인과를 주장하지 않는다. 그런데 적포도주와 장수에서는 어떤가? 클래식 음악과 성적에서는? 구조는 완전히 동일하다. 다른 것은 그럴듯한 인과 이야기가 머릿속에 이미 있느냐뿐이다.
교훈: 인과 주장을 받아들일지 말지를 결정하는 것은 자료가 아니라 우리가 이미 믿고 있는 이야기다. 자료만 놓고 보면 네 사례가 구별되지 않는다. 그러므로 "말이 되니까 인과일 것"이라는 판단을 경계해야 한다. 말이 되는 이야기는 교란요인에도 얼마든지 붙일 수 있다.
무작위 시험 안에서도 교란이 되살아난다: 클로피브레이트
위의 예들은 관찰연구다. 무작위 대조 시험을 하면 교란이 사라진다고 생각하기 쉽다. 자료를 배정받은 대로만 분석하는 한 그렇다. 한 걸음만 벗어나면 교란은 즉시 돌아온다.
관상동맥 약물 연구(Coronary Drug Project, 1966–1975)는 콜레스테롤 저하제 클로피브레이트를 위약과 비교한 대규모 무작위 이중눈가림 시험이었다. 5년 사망률은 다음과 같았다.
| 클로피브레이트 | 위약 | |
|---|---|---|
| 전체 (배정대로 분석) | 20.0% (1,103명) | 20.9% (2,789명) |
차이가 없다. 약은 듣지 않았다.
연구진은 여기서 자연스러운 질문을 던졌다. 약을 실제로 복용한 환자만 보면 어떤가? 처방받은 양의 80% 이상을 복용한 사람을 "순응자"로 나누어 보았다.
| 클로피브레이트 | 위약 | |
|---|---|---|
| 순응자 (복용률 \(\ge 80\)%) | 15.0% | 15.1% |
| 비순응자 | 24.6% | 28.3% |
| 전체 | 20.0% | 20.9% |
클로피브레이트 열만 보면 결정적인 증거처럼 보인다. 약을 제대로 먹은 사람은 \(15\)%, 안 먹은 사람은 \(25\)%. 약이 사망률을 \(40\)% 낮춘 것 아닌가?
위약 열을 가리고 보면 반드시 속는다
오른쪽 열을 보라. 위약을 성실히 먹은 사람도 \(15.1\)%였다. 설탕약을 열심히 먹은 것이 진짜 약을 열심히 먹은 것과 정확히 같은 결과를 냈다.
설탕약이 사람을 살릴 리 없다. 그렇다면 무엇이 순응자와 비순응자를 갈랐는가? 순응 그 자체가 결과가 아니라 증상이다. 약을 꾸준히 먹는 사람은 운동도 하고, 식단도 지키고, 병이 덜 진행되었고, 우울증이 없고, 형편이 낫다. 이런 특성이 사망률을 낮춘 것이다.
결정적인 지점은 이것이다. 순응은 무작위 배정된 변수가 아니다. 연구진이 무작위화한 것은 "클로피브레이트냐 위약이냐"이지 "성실히 먹느냐 마느냐"가 아니다. 순응 여부로 자료를 쪼개는 순간 무작위화가 만들어 준 균형이 깨지고, 그 안에서는 관찰연구를 하고 있는 셈이 된다.
이것을 처리 후 변수로 조건화하기라고 부르며, 이 페이지 뒤쪽 "엉뚱한 것을 보정하기"에서 다루는 문제의 가장 값비싼 사례다. 위약군이 없었다면 이 시험은 효과 없는 약을 효과 있다고 발표했을 것이다. 위약군은 위약효과를 통제하기 위해서만 있는 것이 아니라, 우리 자신의 분석 실수를 잡아내는 거울이기도 하다.
이 사건이 무작위 시험에서 배정대로 분석(ITT) 이 표준이 된 이유다(편향과 무응답 절의 연습문제 6 참조).
다만 이 이야기의 최신판
Murray와 Hernán(2016, 2018)은 이 자료를 다시 분석하여, 무작위화 이후에 측정된 순응 예측변수들을 적절히 보정하면 위약군에서 나타난 순응–사망률 연관이 대부분 사라진다는 것을 보였다.
즉 "순응도 보정은 원리적으로 불가능하다"는 강한 교훈은 다소 과했고, 옳은 방법을 쓰면 프로토콜대로의 효과도 추정할 수 있다는 것이다. 그러나 단순히 순응자끼리 비교하는 것이 심각하게 틀린다는 원래의 교훈은 그대로다.
- The Coronary Drug Project Research Group (1980). "Influence of Adherence to Treatment and Response of Cholesterol on Mortality in the Coronary Drug Project." New England Journal of Medicine, 303(18), 1038–1041.
- Murray, E. J., & Hernán, M. A. (2018). "Improved Adherence Adjustment in the Coronary Drug Project." Trials, 19, 158.
- 표의 정리는 Freedman, Pisani, & Purves, Statistics (4th ed.), 2장을 따랐다.
심슨의 역설
특히 극적인 형태의 교란으로, 모든 하위집단에서 나타나는 연관성이 하위집단을 합치면 뒤집힐 수 있다. 1973년 버클리 대학원 입학 연구가 유명한데, 전체적으로는 여성의 합격률이 남성보다 낮아 보였지만 개별 학과 안에서는 여성의 합격률이 같거나 오히려 높았다. 교란요인은 여성이 경쟁이 치열한(합격률이 낮은) 학과에 불균형하게 많이 지원했다는 사실이었다.
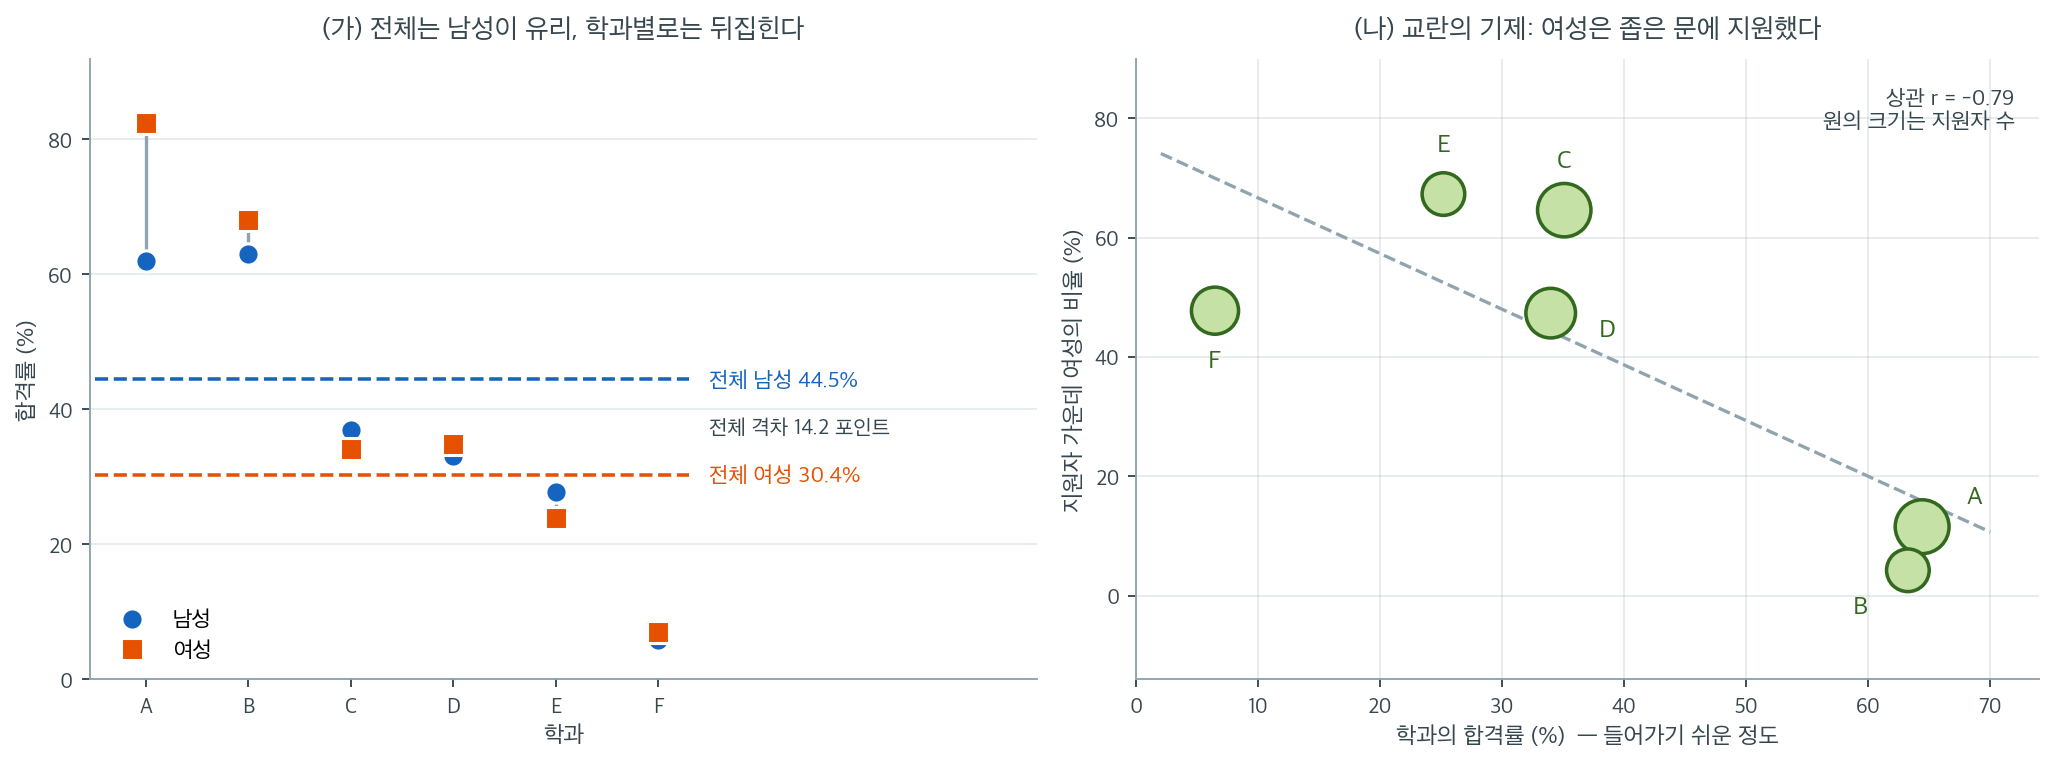
실제 수치를 보자. 지원자가 가장 많은 \(6\)개 학과에서 남성은 \(2{,}691\)명 중 \(1{,}198\)명이 합격해 \(44.5\)%, 여성은 \(1{,}835\)명 중 \(557\)명이 합격해 \(30.4\)%였다. 격차가 \(14.2\) 포인트다. 그런데 (가)에서 학과별 점을 보면 \(6\)개 중 \(4\)개(A, B, D, F)에서 여성의 합격률이 더 높다. 가장 큰 격차는 A학과인데 여성 \(82.4\)%, 남성 \(62.1\)%로 여성이 \(20\) 포인트 앞선다. 여성이 뒤지는 C와 E에서도 차이는 각각 \(2.9\), \(3.8\) 포인트에 그친다. 학과 안에서는 어디서도 \(14.2\) 포인트짜리 격차가 발견되지 않는다.
그 \(14.2\) 포인트가 어디서 왔는지는 (나)가 말해 준다. 가로축은 학과의 전체 합격률, 세로축은 그 학과 지원자 가운데 여성의 비율이다. 둘의 상관은 \(-0.79\)다. A학과는 합격률이 \(64.4\)%로 가장 넉넉한데 지원자 중 여성은 \(11.6\)%뿐이고, E학과는 합격률이 \(25.2\)%로 좁은데 여성이 \(67.3\)%다. 여성은 좁은 문 앞에 줄을 섰다. 학과라는 변수가 지원자의 성별 구성과 합격률 양쪽에 걸쳐 있으니, 학과를 무시하고 합치면 학과 난이도의 차이가 성별의 차이로 둔갑한다.
여기서 조심할 것이 있다. 전체 표가 거짓말을 한 것이 아니다. 그해 여성 지원자의 합격률이 실제로 낮았다는 것은 사실이며, 그 사실 자체가 중요한 자료일 수 있다. 틀린 것은 거기에 "입학 심사가 여성에게 불리하게 작동했다"는 인과적 해석을 붙이는 일이다. 반대 방향의 오독도 똑같이 조심해야 한다. 학과별 수치가 차별이 없었음을 증명하지는 않는다. 왜 여성이 합격률 낮은 학과에 몰렸는가는 그 자체로 답해야 할 질문이며, 원논문의 저자들도 이 점을 분명히 했다.
그래서 심슨의 역설이 던지는 진짜 물음은 "합친 숫자와 나눈 숫자 중 어느 쪽이 옳은가"가 아니다. 성별은 학과 선택보다 앞서므로 학과는 성별의 결과이기도 하다. 성별 → 학과 선택 → 합격이라는 경로가 있다면 학과는 교란요인이 아니라 매개변수이고, 학과별 수치는 총효과가 아니라 "같은 학과에 지원한 사람들끼리의 직접효과"를 본 것이 된다. 두 숫자는 서로 다른 질문에 대한 서로 맞는 답이다. 자료는 어느 질문을 물어야 하는지 알려 주지 않는다. 이 구분은 아래 "엉뚱한 것을 보정하기"에서 다시 다룬다.
- Bickel, P. J., Hammel, E. A., & O'Connell, J. W. (1975). "Sex Bias in Graduate Admissions: Data from Berkeley." Science, 187(4175), 398–404. 위 그림의 수치는 이 논문의 표 1(지원자가 가장 많은 \(6\)개 학과)을 따랐다.
이 이야기는 책 뒤에서 세 번 더 돌아온다. 2.2절 사례 연구 — 타이타닉 생존과 성별은 같은 구조를 타이타닉 자료에서 그림으로 보고, 10.2절 독립성 검정 — 타이타닉 생존과 성별은 그 분할표에 검정을 붙이며, 12.2절 Simpson의 역설이 역설의 대수적 조건을 따진다.
연관성에서 인과관계로
인과효과를 식별하는 두 갈래 길:
-
개입: \(X\)를 무작위로 배정한다. 무작위화 아래에서 \(X\)는 (관측되든 아니든) 모든 \(Z\)와 독립이 되므로 관측된 연관성은 인과 경로만을 반영한다. 이것이 표준이다.
-
식별 가정(무작위화가 불가능할 때):
- 모든 교란요인이 측정되었다는 가정 아래의 층화 / 짝짓기 / 회귀 보정.
- 외생적인 변동 원천이 \(X\)에는 영향을 주지만 \(Y\)에는 직접 영향을 주지 않을 때의 도구변수.
- 평행추세 가정 아래의 이중차분법.
- 뚜렷한 기준선이 \(X\)를 결정할 때의 회귀 불연속.
각각은 무작위화를 자료만으로는 검정할 수 없는 가정으로 대체한다.
엉뚱한 것을 보정하기
"모든 것을 다 보정하자"는 반사적 충동이 있는데, 이는 잘못이다.
- 매개변수: 매개변수를 보정하면 정작 추정하고 싶은 그 경로를 차단하게 된다. 질문이 "교육이 소득을 높이는가?"라면, (매개변수인) 직업을 보정할 경우 간접 경로를 이미 제거해 버렸으므로 추정된 효과가 줄어든다.
- 충돌변수: \(X\)와 \(Y\) 모두에 의해 유발되는 변수를 보정하면 둘 사이에 허위 경로가 열린다. 분석을 입원 환자(질병 중증도와 처리의 충돌변수)로 제한하면, 모집단에는 존재하지 않는 처리와 결과의 연관성이 만들어질 수 있다.
인과 그래프(DAG, Pearl 2000)는 어떤 보정이 타당한지를 형식화한다.
보기 1. 교란과 인과관계. 학생 \(500\)명이 A·B 두 학과에 절반씩 속한다. 공부시간은 A에서 \(N(8,1)\), B에서 \(N(4,1)\)이고, 성적은 A에서 \(50 + 3\cdot\text{공부} + N(0,5^2)\), B에서 \(70 + 3\cdot\text{공부} + N(0,5^2)\)이다. 참 인과효과는 두 학과 모두 \(+3\)으로 같다.
(1) 공분산을 학과 안의 몫과 학과 사이의 몫으로 나누어 적고, 전체 상관의 이론값을 구하시오. 왜 부호가 뒤집히는가.
(2) 학과 안에서의 상관도 이론적으로 구하고, 모의실험과 견주시오.
풀이
(1) 해석적으로. 학과를 \(D\)라 하면 전체 공분산이 두 조각으로 쪼개진다(전공분산의 법칙).
학과 안에서는 \(\operatorname{Cov} = 3\times\operatorname{Var}(\text{공부}\mid D) = 3\times 1 = 3\)으로 양수다. 참 인과효과 \(+3\)이 그대로 나타난다.
학과 사이는 다르다. 학과평균이
인데, 전체평균이 \((6, 78)\)이므로
로 음수다. 더 많이 공부하는 학과가 더 낮은 점수를 받기 때문이다. 합치면
이고 학과 사이의 음수가 학과 안의 양수를 압도한다. 이것이 심슨의 역설의 산술이다.
분산도 같은 방식으로 쪼갠다.
따라서
(2) 해석적으로. 학과를 고정하면 공분산 \(3\), 분산 \(1\)과 \(34\)이므로
로 두 학과 모두 같은 값이다. 부호도 크기도 참 효과를 반영한다.
(1)(2) 수치적으로.
"""심슨의 역설: 학과가 교란요인일 때 공부시간과 성적의 상관이 뒤집힌다."""

import numpy as np
import pandas as pd

rng = np.random.default_rng(42)
n = 500

# 교란요인: 학과. 학생은 A와 B에 절반씩 속한다.
dept = rng.choice(["A", "B"], size=n, p=[0.5, 0.5])

# 학과가 공부시간에 영향을 준다.
#   A학과 학생은 평균 8시간, B학과 학생은 평균 4시간 공부한다.
study_hours = np.where(dept == "A",
                       rng.normal(8, 1, n),
                       rng.normal(4, 1, n))

# 학과가 성적에도 영향을 준다 — 이것이 교란의 핵심이다.
#   A학과는 채점이 박해서 기본점이 50, B학과는 후해서 70에서 출발한다.
#   반면 기울기는 두 학과 모두 +3으로 같다.
#   즉 "공부시간이 1시간 늘면 성적이 3점 오른다"가 참인 인과효과다.
grade = np.where(dept == "A",
                 50 + 3 * study_hours + rng.normal(0, 5, n),
                 70 + 3 * study_hours + rng.normal(0, 5, n))

# 정리하면 이런 구조다.
#   공부시간  <---  학과(교란요인)  --->  성적
#         \___________ +3 ____________/
# 학과가 두 화살표를 모두 쏘고 있으므로, 학과를 무시하면 상관이 오염된다.
df = pd.DataFrame({"dept": dept, "study_hours": study_hours, "grade": grade})

# 학과를 무시하고 전체에서 상관을 낸다 -> 음수가 나온다(!)
# 많이 공부한 A학과 학생들의 성적이 채점이 박해서 낮게 나오기 때문이다.
print(f"전체 상관 (공부시간, 성적): {df['study_hours'].corr(df['grade']):+.3f}")

# 학과별로 나누어 다시 낸다 -> 두 학과 모두 양수가 나온다.
# 이것이 심슨의 역설이다. 부분에서의 방향과 전체에서의 방향이 반대다.
for d in ["A", "B"]:
    sub = df[df["dept"] == d]
    print(f"  {d}학과: 상관 = {sub['study_hours'].corr(sub['grade']):+.3f}, "
          f"평균 성적 = {sub['grade'].mean():.1f}, "
          f"평균 공부시간 = {sub['study_hours'].mean():.1f}")
출력:
전체 상관 (공부시간, 성적): -0.349
  A학과: 상관 = +0.416, 평균 성적 = 72.9, 평균 공부시간 = 8.0
  B학과: 상관 = +0.549, 평균 성적 = 82.0, 평균 공부시간 = 4.1
전체 상관의 이론값 \(-0.3162\)와 모의값 \(-0.349\)가 맞는다. \(n = 500\)에서 상관의 표준오차가 \((1-r^2)/\sqrt n = 0.040\)이므로 \(0.8\) 표준오차 차이다.
학과 안의 상관은 이론 \(0.5145\)에 B학과가 \(0.549\)(\(+0.75\) 표준오차), A학과가 \(0.416\)(\(-2.1\) 표준오차)이다. A학과 쪽은 몬테카를로 오차의 가장자리에 걸쳐 있다. 학과당 \(250\)명이라 상관의 표준오차가 \(0.047\)로 작지 않다. 두 학과의 참값이 같다는 사실이 이 한 표본에서는 완벽히 보이지 않는다.
학과 내부의 상관은 인과관계가 시사하는 대로 두 학과 모두 양수다(\(+0.416\), \(+0.549\)). 더 공부하면 성적이 오른다. 그런데 학과를 지우고 \(500\)명을 한 덩어리로 보면 상관이 \(-0.349\)로 부호가 뒤집힌다. 참인 인과효과는 어디서나 "한 시간 더 공부하면 \(3\)점"인데도 그렇다.
뒤집히는 이유는 (1)에서 계산한 \(3 - 8 = -5\) 한 줄이다. A학과가 공부는 더 하면서(\(8.0\)시간 대 \(4.1\)시간) 성적은 더 낮은(\(72.9\)점 대 \(82.0\)점) 쪽이므로 학과 사이의 공분산이 \(-8\)이 되고, 학과 안의 \(+3\)을 눌러 버린다. 학과가 공부시간과 성적 양쪽에 화살표를 쏘고 있으므로, 학과를 무시하면 "채점이 박한 학과일수록 공부를 많이 한다"는 학과 간 대비가 공부시간과 성적의 관계로 둔갑한다. 이것이 심슨의 역설이며, 여기서 교란요인은 학과다.
연습문제
연습문제 1. 어떤 신문이 아이스크림 트럭이 많은 도시일수록 범죄율이 높다고 보도하며, 아이스크림 트럭이 범죄를 유발한다고 결론지었다.
(a) 이 연관성을 설명할 수 있는 그럴듯한 교란변수를 제시하라. (b) 이 관찰적 설계로는 왜 인과관계를 확립할 수 없는지 설명하라. (c) 이 관계를 더 잘 분리해 낼 수 있는 연구를 구상하고, 그것이 왜 비현실적인지 설명하라.
풀이
(a) 기온(또는 인구밀도). 더운 날씨는 아이스크림 수요(트럭 증가)와 야외 활동(범죄 기회 증가)을 함께 늘린다. 인구밀도도 마찬가지다. 밀도가 높은 도시는 단위 면적당 모든 것이 많으며, 여기에는 트럭과 범죄가 모두 포함된다.
(b) 자료가 관찰적이다. 교란요인을 통제하지 않으면, 관측된 상관은 아이스크림 트럭의 인과효과 가능성과 기온/밀도의 숨은 효과를 뒤섞는다. 모든 관련 교란요인을 통제하지 않는 한(일반적으로 이는 불가능하다) 어떤 인과적 주장도 정당화되지 않는다.
(c) 무작위 실험이라면 도시들을 서로 다른 수의 아이스크림 트럭에 무작위 배정하고 범죄율을 측정할 것이다. 비현실적인 이유는 (i) 도시를 실험 단위처럼 통제할 수 없고, (ii) 아이스크림 트럭 수를 중앙에서 조작할 수 없으며, (iii) 실험을 위해 공공 안전 조건을 바꾸는 데 따르는 윤리적 문제 때문이다.
보다 현실적인 접근으로는 한 도시의 갑작스러운 허가 정책 변화를 이용하고 비슷한 도시를 대조군으로 삼는 자연실험(이중차분법)이 있다. 이조차도 불안정한데, 평행추세 가정을 도시 수준에서 옹호하기가 어렵기 때문이다.
연습문제 2. 교란변수, 매개변수, 충돌변수를 구분하라. \(X\)가 \(Y\)에 미치는 효과를 회귀분석할 때 각각을 "보정"하면 어떤 결과가 생기는지 진술하라.
풀이
교란변수 \(Z\): \(X\)와 \(Y\)를 모두 유발한다. 보정하면 \(X\)–\(Y\) 연관성의 허위 성분이 제거되어 편향이 줄어든다.
매개변수 \(M\): \(X\)에 의해 유발되고 그 자신이 \(Y\)를 유발한다(즉 \(X \to M \to Y\)). 보정하면 간접 경로가 차단되어 편향이 커진다 — 보정된 계수는 이제 총효과가 아니라 직접효과 \(X \to Y\)만을 추정한다.
충돌변수 \(C\): \(X\)와 \(Y\) 모두에 의해 유발된다(즉 \(X \to C \leftarrow Y\)). 보정하면 \(X\)와 \(Y\) 사이에 비인과적 경로가 열려 원래 없던 허위 연관성이 생긴다. 이는 회귀의 형태로 나타난 선택편향이다.
규칙은 이렇다. 교란변수는 보정하고, 매개변수(직접효과를 명시적으로 원하는 경우가 아니라면)나 충돌변수는 보정하지 않는다. 무엇이 무엇인지 아는 데는 자료생성 과정에 대한 실질적 지식이 필요하며, 이는 흔히 인과 DAG로 표현하는 것이 가장 좋다.
연습문제 3. 구체적인 표로 보는 심슨의 역설. 어떤 약을 두 병원에서 시험하여 다음과 같은 결과를 얻었다.
| 병원 A — 회복 | A — 전체 | 병원 B — 회복 | B — 전체 | |
|---|---|---|---|---|
| 투약 | 80 | 100 | 200 | 300 |
| 미투약 | 240 | 300 | 50 | 100 |
전체 및 각 병원 내에서 투약군과 미투약군의 회복률을 계산하라. 겉보기 역전에 대해 논평하라.
풀이
병원 A 내부: 투약 회복률 \(= 80/100 = 80\%\), 미투약 회복률 \(= 240/300 = 80\%\). 동일하다.
병원 B 내부: 투약 회복률 \(= 200/300 = 66.7\%\), 미투약 회복률 \(= 50/100 = 50\%\). 약이 도움이 된다.
합쳤을 때: 투약 \(= (80+200)/(100+300) = 280/400 = 70\%\), 미투약 \(= (240+50)/(300+100) = 290/400 = 72.5\%\).
합치면 미투약이 더 나아 보인다. 그런데 각 병원 안에서는 투약이 미투약보다 최소한 같거나 낫지 결코 나쁘지 않다. 역전이 일어나는 이유는 투약 여부가 병원과 상관되어 있고(투약 환자의 75%가 병원 B에 있는 반면 미투약 환자는 25%만 그렇다), 회복률 또한 병원마다 다르기(A가 B보다 높다) 때문이다. 병원이 교란요인이다. 옳은 결론은 병원 내부의 결론, 즉 약이 최소한 같거나 더 효과적이라는 것이다. 병원을 통제하지 않고 합치는 것은 오도한다.
연습문제 4. 뒷문 기준(Pearl 1995)은 어떤 변수들이 보정 통제변수로 충분한지를 판별하는 그래프적 규칙을 준다. 이 기준을 비형식적으로 진술하고, 잘못된 집합을 보정하면 뒷문을 닫기는커녕 여는 작은 DAG 예를 제시하라.
풀이
뒷문 기준(비형식적): \(X\)가 \(Y\)에 미치는 인과효과를 식별하려면, (1) \(S\)의 어떤 변수도 \(X\)의 후손이 아니고 (2) \(S\)가 \(X\)에서 \(Y\)로 가는 모든 "뒷문" 경로 — 즉 \(X\)로 들어오는 화살표로 시작하는 \(X\)–\(Y\) 경로 — 를 차단하는 변수 집합 \(S\)를 고른다.
DAG 예: \(X \to Y\), \(Z \to X\), \(Z \to W\), \(Y \to W\)라고 하자. 여기서 \(W\)는 경로 \(X \to Y \to W \leftarrow Z \to X\) 위의 충돌변수다. \(\{Z\}\)를 보정하면 뒷문 경로 \(X \leftarrow Z \to W \leftarrow Y\)가 닫힌다(이 경로는 충돌변수 \(W\)에서 이미 차단되어 있었다). 반면 \(\{Z, W\}\)를 보정하면 \(W\)를 지나는 뒷문 경로가 열린다 — 충돌변수에 조건을 걸면 \(W\)의 층 안에서 \(Z\)와 \(Y\) 사이에 연관이 생기고, 이것이 \(X\)–\(Y\) 분석으로 새어 들어간다.
교훈: 통제변수는 많을수록 좋은 것이 아니다. 통제변수를 고르려면 인과 구조를 알아야 하며, "모든 것을 보정하라"는 도움이 되는 만큼이나 쉽게 해가 될 수 있다.
연습문제 5. 어느 의학 연구자가 커피를 마시는 사람의 심근경색 위험이 30% 낮아진다고 주장한다. 보도자료는 이를 "커피가 심근경색을 예방한다"로 요약한다. 교란요인 두 가지를 제시한 뒤, 이 주장을 인과적 결론으로 격상하려면 어떤 종류의 연구가 필요한지 설명하라.
풀이
교란요인 두 가지:
- 생활양식: 커피를 마시는 사람은 대체로 취업 상태이고 도시에 살며 전반적으로 건강에 더 신경 쓰는 경향이 있다(특히 현대 서구 표본에서 그렇고, 과거 표본은 반대 패턴을 보인다). 이 요인들 자체가 심근경색 위험을 낮춘다.
- 선택(역인과): 심장 문제의 초기 징후가 있는 사람은 의사에게 커피를 줄이라는 말을 들었을 가능성이 높다. 그래서 더 아픈 사람이 커피를 끊는다. 남아 있는 커피 애호가는 평균적으로 더 건강하며, 그 결과 실제로는 커피가 아무 일도 하지 않았고 인과의 화살표가 반대 방향인데도 커피가 보호 효과를 지닌 것처럼 보인다.
인과적 격상: 무작위 대조시험이 필요하다. 건강한 자원자를 10년간 하루 2–3잔의 커피를 마시는 군과 0잔인 군에 배정하고 심근경색 발생률을 측정한다. 윤리적·현실적 문제로는 긴 추적기간, 순응도, 눈가림(대상자가 자신이 커피를 마시는지 안다는 점) 등이 있다. 현실적인 절충안은 카페인 대사에 영향을 주는 유전 변이를 이용한 도구변수 분석(멘델 무작위화)이다. 유전 변이가 수정 시점에 무작위로 배정되고 생활양식의 영향을 받지 않으면서 커피 소비를 예측한다는 사실을 활용한다.
연습문제 6. 평균처리효과(ATE) 와 처리군에 대한 평균처리효과(ATT) 를 구분하라. 관찰자료로 ATE를 식별할 수 있는 것은 언제이고 ATT만 식별되는 것은 언제이며, 이것이 정책에서 왜 중요한가?
풀이
ATE: 모집단 전체에 걸쳐 평균한 \(\mathbb{E}[Y(1) - Y(0)]\). 모두를 처리했을 때와 아무도 처리하지 않았을 때의 차이다.
ATT: 처리받은 부분모집단에 걸쳐 평균한 \(\mathbb{E}[Y(1) - Y(0) \mid T = 1]\). 실제로 처리받은 사람들을 처리했을 때와 그들을 처리하지 않았을 때의 차이다.
관찰자료에서:
- 비교란성 \((Y(0), Y(1)) \perp T \mid X\) 와 중첩(overlap)이 성립하면 ATE가 식별된다. 처리군과 비처리군 모두에 대해 각자의 조건부 분포 아래에서 반사실적 결과를 추정할 수 있다.
- 더 약한 조건(예: \(Y(0) \perp T \mid X\) 만) 아래에서는 ATT는 식별되지만 ATE는 그렇지 않다. 처리군의 반사실적 미처리 결과는 추정할 수 있어도, 비처리군의 반사실적 처리 결과는 추정할 수 없다.
정책적 함의: 어떤 정책이 그 프로그램에 자원했던 바로 그 모집단에 적용될 것이라면 중요한 것은 ATT다. 정책이 모두에게 의무화될 것이라면 중요한 것은 ATE이며, 그 답은 다를 수 있다. (이익을 기대해서 선택해 들어온) 처리군에게 이로운 약이, 스스로는 선택하지 않았을 평균적인 사람에게는 거의 효과가 없거나 심지어 해로울 수 있다. 이 구분은 자발적 프로그램 대 의무적 프로그램을 둘러싼 정책 논쟁에 늘 따라다니지만, 헤드라인 숫자에서는 명시적으로 언급되는 일이 드물다.
연습문제 7. 본문의 "교란요인은 양쪽 방향으로 다 밀 수 있다"를 수치로 확인하라. 참된 인과효과가 양수인데 관측된 연관성이 \(0\)이거나 음수가 되도록 교란요인을 설계하고, 보정이 이를 되살리는지 보여라.
풀이
자료생성 과정을 \(X = Z + \varepsilon\), \(Y = \tau X + \gamma Z + u\)로 두자(\(\varepsilon, u, Z\)는 모두 표준정규). 그러면
이므로 보정하지 않은 회귀계수는 \((2\tau+\gamma)/2\)다. \(\gamma = -2\tau\)로 두면 정확히 \(0\)이 된다.
import numpy as np
import statsmodels.api as sm

rng = np.random.default_rng(0)
n = 50_000
beta = lambda y, *X: sm.OLS(y, sm.add_constant(np.column_stack(X))).fit().params[1]

Z = rng.normal(size=n)
X = Z + rng.normal(size=n)
tau = 0.5                                   # 참 인과효과는 언제나 +0.5

print(f"참 효과 {tau} (모든 경우에 동일)\n")
print(f"{'gamma':>7}{'보정 안 함':>12}{'Z 보정':>10}{'이론 단순':>11}")
for gamma in (0.0, -1.0, -2.0):
    Y = tau * X + gamma * Z + rng.normal(size=n)
    print(f"{gamma:>7.1f}{beta(Y, X):>+12.4f}{beta(Y, X, Z):>+10.4f}"
          f"{(2 * tau + gamma) / 2:>+11.4f}")
출력:
참 효과 0.5 (모든 경우에 동일)

  gamma      보정 안 함      Z 보정      이론 단순
    0.0     +0.5052   +0.5090    +0.5000
   -1.0     -0.0015   +0.5020    +0.0000
   -2.0     -0.5026   +0.5036    -0.5000
세 줄 모두 참 효과가 \(+0.5\)인데 관측되는 연관성은 전혀 다르다.
| \(\gamma\) | 보정 안 함 | 해석 |
|---|---|---|
| \(0\) | \(+0.50\) | 교란 없음, 그대로 보인다 |
| \(-1\) | \(\approx 0\) | 효과가 감쪽같이 사라진다 |
| \(-2\) | \(-0.50\) | 부호가 뒤집힌다 |
보정하면 세 경우 모두 \(+0.50\)을 회복한다.
이것을 억제(suppression)라 부른다. 교란요인이 인과효과와 반대 방향으로 작용하면 참된 효과를 가리거나 뒤집는다.
실무적 함의가 무겁다.
- "상관이 없으니 인과도 없다"는 추론은 "상관이 있으니 인과가 있다"만큼 틀렸다. 교란되지 않았다는 근거 없이는 영(null) 결과도 해석할 수 없다.
- 병원 자료에서 어떤 치료가 사망률과 양의 상관을 보이는 일이 흔한데, 이는 중증 환자에게 그 치료를 쓰기 때문이다. 참된 효과는 보호적일 수 있다.
- 부호가 뒤집히는 경우는 특히 위험하다. 효과가 없다는 결론보다 해롭다는 결론이 정책적으로 훨씬 큰 영향을 미치기 때문이다. \(\square\)
연습문제 8. 성향점수를 이용한 역확률가중(IPW)을 구현해 ATE를 회복하라. 그런 다음 중첩(positivity) 이 깨지면 무슨 일이 일어나는지 보여라.
풀이
성향점수는 \(e(X) = P(T = 1 \mid X)\)다. 각 개체에 \(1/e(X)\) 또는 \(1/(1-e(X))\)의 가중치를 주면 처리 배정이 공변량과 무관한 가상의 모집단이 만들어진다.
import numpy as np
import statsmodels.api as sm

rng = np.random.default_rng(1)
n = 200_000
X = rng.normal(size=n)
T = (rng.random(n) < 1 / (1 + np.exp(-1.2 * X))).astype(float)
Y = 1.0 + 2.0 * T + 1.5 * X + rng.normal(size=n)          # 참 ATE = 2.0

ps = sm.Logit(T, sm.add_constant(X)).fit(disp=0).predict()
w = np.where(T == 1, 1 / ps, 1 / (1 - ps))
ipw = ((w * T * Y).sum() / (w * T).sum()
       - (w * (1 - T) * Y).sum() / (w * (1 - T)).sum())

print("참 ATE 2.0")
print(f"  단순 차이 {Y[T == 1].mean() - Y[T == 0].mean():.4f}   ← 편향")
print(f"  회귀 보정 {sm.OLS(Y, sm.add_constant(np.column_stack([T, X]))).fit().params[1]:.4f}")
print(f"  IPW      {ipw:.4f}")
print(f"  성향점수 범위 {ps.min():.4f} ~ {ps.max():.4f}   최대 가중치 {w.max():.1f}")
출력:
참 ATE 2.0
  단순 차이 3.3871   ← 편향
  회귀 보정 1.9982
  IPW      1.9945
  성향점수 범위 0.0065 ~ 0.9949   최대 가중치 102.7
IPW가 \(1.9945\)로 참값을 잘 회복한다.
중첩이 깨지면. 처리 배정이 공변량에 훨씬 강하게 의존하도록 계수를 \(1.2\)에서 \(4.0\)으로 올려 보자.
import numpy as np
import statsmodels.api as sm

rng = np.random.default_rng(1)
n = 200_000
X = rng.normal(size=n)
T = (rng.random(n) < 1 / (1 + np.exp(-4.0 * X))).astype(float)   # 강한 선택
Y = 1.0 + 2.0 * T + 1.5 * X + rng.normal(size=n)

ps = sm.Logit(T, sm.add_constant(X)).fit(disp=0).predict()
w = np.where(T == 1, 1 / ps, 1 / (1 - ps))
ipw = ((w * T * Y).sum() / (w * T).sum()
       - (w * (1 - T) * Y).sum() / (w * (1 - T)).sum())

print(f"성향점수 범위 {ps.min():.6f} ~ {ps.max():.6f}")
print(f"최대 가중치 {w.max():.1f}   ← 한 사람이 수만 명분의 목소리를 낸다")
print(f"IPW      {ipw:.4f}   ← 참값 2.0 에서 벗어난다")
print(f"회귀 보정 {sm.OLS(Y, sm.add_constant(np.column_stack([T, X]))).fit().params[1]:.4f}")
출력:
성향점수 범위 0.000000 ~ 1.000000
최대 가중치 67063.1   ← 한 사람이 수만 명분의 목소리를 낸다
IPW      0.7611   ← 참값 2.0 에서 벗어난다
회귀 보정 1.9980
성향점수가 \(0\)과 \(1\)에 붙고 최대 가중치가 \(67{,}063\)까지 치솟으면서 IPW 추정값이 \(0.7611\)로 주저앉는다. 참값 \(2.0\)의 절반도 되지 않는다.
중첩 가정이란. 모든 공변량 값에서 처리받을 확률과 받지 않을 확률이 둘 다 \(0\)보다 커야 한다. \(X\)가 큰 사람이 사실상 전부 처리를 받는다면, 그런 사람의 "처리받지 않았을 때"를 알려 줄 자료가 없다. 반사실이 자료에 존재하지 않는 것이다.
회귀가 더 안전해 보이는 것은 착시다
위에서 회귀는 \(1.9980\)으로 멀쩡해 보인다. 하지만 이는 회귀가 선형 모형을 믿고 자료가 없는 영역까지 외삽했기 때문이다. 여기서는 모형이 실제로 옳아서 통했지만, 모형이 틀리면 아무 경고 없이 틀린 답을 준다.
IPW의 미덕은 문제를 드러낸다는 것이다. 극단적인 가중치는 "이 비교를 뒷받침할 자료가 없다"는 신호다. 그래서 실무에서는 성향점수 분포를 두 군에 대해 겹쳐 그려 보고, 겹치지 않는 영역을 아예 잘라내(common support 제한) 답할 수 있는 질문으로 문제를 좁힌다. \(\square\)
연습문제 9. "처리 이전에 측정된 변수는 보정해도 안전하다"는 말은 널리 퍼져 있지만 틀렸다. 처리보다 앞서 측정되었고 교란요인도 아닌 변수를 보정해 편향이 생기는 M-편향의 예를 만들어라.
풀이
다음 구조를 생각하자. 문자를 M자 모양으로 배치하면 이름의 유래가 보인다.
\(U_1\)과 \(U_2\)는 측정되지 않았다. \(Z\)는 처리 이전에 측정되었고, \(T\)의 원인도 \(Y\)의 원인도 아니며, 교란요인도 아니다(\(T\)와 \(Y\)의 공통 원인이 아니다). 그런데 \(Z\)는 \(U_1\)과 \(U_2\)의 충돌부다.
import numpy as np
import statsmodels.api as sm

rng = np.random.default_rng(5)
n = 200_000
beta = lambda y, *X: sm.OLS(y, sm.add_constant(np.column_stack(X))).fit().params[1]

U1 = rng.normal(size=n)                       # 측정되지 않음
U2 = rng.normal(size=n)                       # 측정되지 않음
Z = U1 + U2 + rng.normal(size=n)              # 처리 이전에 측정됨. U1, U2 의 충돌부
T = U1 + rng.normal(size=n)
Y = 0.0 * T + U2 + rng.normal(size=n)         # 참 인과효과는 0

print("참 효과 0.0")
print(f"  Z 를 보정하지 않음: {beta(Y, T):+.4f}   ← 옳다")
print(f"  Z 를 보정함:       {beta(Y, T, Z):+.4f}   ← 없던 편향이 생겼다")
출력:
참 효과 0.0
  Z 를 보정하지 않음: -0.0010   ← 옳다
  Z 를 보정함:       -0.2005   ← 없던 편향이 생겼다
보정하지 않으면 \(0\)이 정확히 나오는데, \(Z\)를 넣는 순간 \(-0.20\)이 된다. \(Z\)는 처리보다 먼저 측정되었고 어느 쪽의 원인도 아닌데도 그렇다.
왜 그런가. \(Z\)를 고정하면 \(U_1\)과 \(U_2\) 사이에 인위적 연관이 생긴다(충돌부에 조건을 걸었으므로). \(Z\)가 크다고 알려진 집단에서 \(U_1\)이 작으면 \(U_2\)가 컸어야 한다. 그런데 \(U_1\)은 \(T\)를 움직이고 \(U_2\)는 \(Y\)를 움직이므로, 이 인위적 연관이 \(T\)와 \(Y\) 사이의 가짜 경로로 흘러든다. 원래는 \(Z\)에서 막혀 있던 통로를 보정이 열어젖힌 것이다.
함의.
- "처리 이전 변수는 안전하다"는 규칙은 없다. 시간 순서가 아니라 인과 구조가 판단 기준이다.
- "가능한 모든 공변량을 넣는" 자동화된 변수 선택은 이 함정을 피할 수 없다. 자료만 보아서는 \(Z\)가 교란요인인지 충돌부인지 구별되지 않는다.
- 다만 실무에서 M-편향의 크기는 교란을 방치했을 때보다 대개 작다는 반론도 있다. 그래서 \(Z\)가 교란요인일 가능성도 있다면 보정하는 쪽이 나은 경우가 많다.
결론은 겸손이다. 어떤 변수를 보정할지는 통계적 판단이 아니라 영역 지식에 근거한 인과 모형의 문제이며, 그 모형은 자료로 검증할 수 없다. 인과 그래프를 명시적으로 그리는 습관이 필요한 이유가 이것이다. \(\square\)
연습문제 10. 연습문제 6(관찰연구)에서 언급한 민감도 분석을 정량화하라. 관측된 위험비 \(\mathrm{RR}\)을 미측정 교란만으로 설명해 없애려면 그 교란이 얼마나 강해야 하는가? E-value를 계산하고 그 의미를 논하라.
풀이
미측정 교란요인 \(U\)가 만들어 낼 수 있는 최대 편향인자는
이다. 여기서 \(\mathrm{RR}_{TU}\)는 처리와 \(U\)의 연관, \(\mathrm{RR}_{UY}\)는 \(U\)와 결과의 연관이다. E-value는 두 연관이 같다고 놓고 \(B = \mathrm{RR}\)을 풀어 얻는다.
import numpy as np

E = lambda rr: rr + np.sqrt(rr * (rr - 1))
B = lambda a, b: a * b / (a + b - 1)

print("관측된 RR 과 그것을 설명해 없애는 데 필요한 교란의 세기")
for rr in (1.05, 1.2, 1.5, 2.0, 4.0, 10.0):
    print(f"  RR {rr:>5}: E-value {E(rr):>6.2f}   (확인: B(E,E) = {B(E(rr), E(rr)):.4f})")

print("\nRR = 2 를 없애는 비대칭 조합들")
for a in (3.414, 4, 6, 10, 20):
    print(f"  RR_TU = {a:>6.3f} 이면  RR_UY = {(2 * a - 2) / (a - 2):.3f} 이 필요하다")
출력:
관측된 RR 과 그것을 설명해 없애는 데 필요한 교란의 세기
  RR  1.05: E-value   1.28   (확인: B(E,E) = 1.0500)
  RR   1.2: E-value   1.69   (확인: B(E,E) = 1.2000)
  RR   1.5: E-value   2.37   (확인: B(E,E) = 1.5000)
  RR   2.0: E-value   3.41   (확인: B(E,E) = 2.0000)
  RR   4.0: E-value   7.46   (확인: B(E,E) = 4.0000)
  RR  10.0: E-value  19.49   (확인: B(E,E) = 10.0000)

RR = 2 를 없애는 비대칭 조합들
  RR_TU =  3.414 이면  RR_UY = 3.414 이 필요하다
  RR_TU =  4.000 이면  RR_UY = 3.000 이 필요하다
  RR_TU =  6.000 이면  RR_UY = 2.500 이 필요하다
  RR_TU = 10.000 이면  RR_UY = 2.250 이 필요하다
  RR_TU = 20.000 이면  RR_UY = 2.111 이 필요하다
확인 열이 보여 주듯 \(B(\text{E}, \text{E})\)가 정확히 원래 \(\mathrm{RR}\)을 되돌려 준다.
어떻게 읽는가. 관측된 \(\mathrm{RR} = 2.0\)의 E-value는 \(3.41\)이다. 이 결과를 교란만으로 지우려면, 미측정 교란요인이 처리와도 \(3.41\)배, 결과와도 \(3.41\)배 연관되어 있어야 한다. 이미 보정한 어떤 변수도 그만큼 강하지 않다면 결과는 견고한 편이다.
핵심은 관측된 효과가 클수록 지우기 어렵다는 것이다.
| 관측 RR | E-value | 판단 |
|---|---|---|
| \(1.05\) | \(1.28\) | 약한 교란으로도 지워진다 |
| \(1.5\) | \(2.37\) | 상당히 강한 교란이 필요 |
| \(10\) | \(19.49\) | 사실상 설명 불가능 |
이것이 흡연–폐암 논쟁의 결정적 논거였다. 관측된 위험비가 \(10\)을 넘었으므로, 이를 지우려면 흡연과도 폐암과도 \(20\)배 가까이 연관된 미지의 요인이 있어야 한다. 그런 요인은 이미 알려진 어떤 위험인자보다도 강력하며, 그러면서도 아무에게도 발견되지 않았어야 한다. 피셔가 제기한 "유전적 소인" 가설이 무너진 자리가 여기다.
비대칭 조합도 유의미하다. 한쪽 연관이 강하면 다른 쪽은 약해도 된다. \(\mathrm{RR}_{TU} = 20\)이면 \(\mathrm{RR}_{UY} = 2.11\)로 충분하다. E-value는 두 연관이 같다고 놓았을 때의 최솟값이므로 가장 보수적인 하나의 요약값이다.
한계를 분명히 하라. E-value는 미측정 교란요인이 하나이고 이진변수이며 측정오차가 없다는 등의 가정 위에 있다. 또한 "교란요인이 실제로 그만큼 강한가"에는 답하지 않는다. 얼마나 강해야 하는지를 계산해 줄 뿐, 그런 것이 있는지는 여전히 영역 지식의 문제다. 그럼에도 "미측정 교란이 있을 수 있다"는 막연한 경고를 하나의 숫자로 바꾸어 놓았다는 점에서 값지다. \(\square\)
정리하며
두 변수가 함께 움직인다는 사실만으로는 어느 쪽도 다른 쪽의 원인이라고 말할 수 없다.
- 교란변수 \(Z\) 는 \(X\) 와 \(Y\) 모두와 연관되면서 \(X\to Y\) 의 인과 경로 위에 있지 않은 변수다. 아이스크림과 익사 사이의 기온, 커피와 폐암 사이의 흡연이 그렇다.
- 세 가지를 구별해야 한다. 인과 경로 위의 변수는 매개변수이고, \(X\) 와 \(Y\) 가 함께 만들어내는 변수는 충돌변수다. 셋을 뭉뚱그려 "통제"하면 낭패를 본다.
- 충돌변수에 조건을 걸면 없던 연관이 생긴다. 교란을 없애려고 변수를 더 넣는 습관이 위험한 이유이며, 무엇을 통제할지는 자료가 아니라 인과 구조에 대한 가정이 정한다.
- 관측된 연관성 자체는 실재한다. 틀린 것은 거기에 붙인 인과적 해석이다.
교란은 자료를 더 모아서 해결할 수 없다. \(n\) 을 늘리면 허위 연관성의 추정이 더 정밀해질 뿐이고, 더 좁은 신뢰구간으로 더 확신에 차서 틀리게 된다.
다음 절 자료 수집을 설계하라는 그래서 방향을 바꾼다. 이미 있는 자료를 어떻게 분석할지가 아니라, 애초에 교란이 생기지 않도록 자료를 어떻게 만들 것인가를 묻는다. 무작위 배정이 그 답이며, 이것이 고전통계학의 출발점이다.