Kendall의 tau (재론)
Kendall 순위상관계수 \(\tau\)는 12장에서 일치도 기반 단조 연관성 측도로 소개되었다. 이 절에서는 비모수 검정의 관점에서 \(\tau\)를 다시 보며, 부합/비부합 틀, 가설검정, 동점 처리, 그리고 Spearman \(r_s\)와의 비교를 다룬다.
부합쌍과 비부합쌍
\(n\)개의 대응 관측값 \((X_1, Y_1), \ldots, (X_n, Y_n)\)에서 \(i < j\)인 모든 \(\binom{n}{2}\)개의 쌍 \((i, j)\)를 생각하자. 각 쌍은 다음 중 하나이다.
- 부합(concordant): \((X_i - X_j)(Y_i - Y_j) > 0\) --- 두 변수가 같은 방향으로 움직인다.
- 비부합(discordant): \((X_i - X_j)(Y_i - Y_j) < 0\) --- 두 변수가 반대 방향으로 움직인다.
- 동점: \(X_i = X_j\) 또는 \(Y_i = Y_j\)(또는 둘 다).
부합쌍의 개수를 \(C\), 비부합쌍의 개수를 \(D\)라 하자.
Kendall tau
정의 1. Kendall tau-a (동점 없음)
동점이 없을 때
분자 \(S = C - D\)를 Kendall S 통계량이라 부른다.
정의 2. Kendall tau-b (동점 있음)
동점이 있으면 tau-b가 분모를 조정한다.
여기서
- \(n_0 = n(n-1)/2\)는 전체 쌍의 개수,
- \(n_1 = \sum_{i} t_i(t_i - 1)/2\)는 \(X\)에서 동점인 쌍의 개수(\(t_i\) = \(X\)의 \(i\)번째 동점 집단 크기),
- \(n_2 = \sum_{j} u_j(u_j - 1)/2\)는 \(Y\)에서 동점인 쌍의 개수(\(u_j\) = \(Y\)의 \(j\)번째 동점 집단 크기)
이다.
tau-b는 \(-1 \le \tau_b \le 1\)을 만족하며, 자료가 (동점을 고려하여) 완전한 단조 관계로 기술될 때만 \(\pm 1\)이 된다.
가설검정
가설
S의 귀무분포
\(H_0\)(독립) 아래에서 \(S\) 통계량은
를 갖는다. 동점이 있으면 분산이 다음과 같이 조정된다.
정규근사
\(n \ge 10\)이면 표준화된 통계량
이 \(H_0\) 아래 근사적으로 \(\mathcal{N}(0, 1)\)을 따른다.
\(n\)이 작으면 순열분포에서 정확 \(p\)값을 계산할 수 있다.
보기 1. 심사위원 두 명의 순위 일치도. 발표 품질에 대해 심사위원 두 명이 학생 6명의 순위를 매겼다.
| 학생 | 심사위원 1 순위 (\(R_i\)) | 심사위원 2 순위 (\(S_i\)) |
|---|---|---|
| A | 1 | 2 |
| B | 2 | 1 |
| C | 3 | 4 |
| D | 4 | 3 |
| E | 5 | 6 |
| F | 6 | 5 |
부합쌍과 비부합쌍을 센다 (동점이 없으므로 tau-a를 적용한다).
\(i < j\)인 각 쌍에 대해 \((R_i - R_j)\)와 \((S_i - S_j)\)의 부호가 같은지 확인한다.
쌍은 \(\binom{6}{2} = 15\)개이다. 열거하면 부합 \(C = 12\), 비부합 \(D = 3\)이다(비부합은 인접한 세 쌍 A--B, C--D, E--F이다).
풀이
검정:
\(\alpha = 0.05\)에서 \(H_0\)을 기각하지 못한다. 관측값이 6개뿐이라 중간 정도의 일치도를 탐지할 검정력이 부족하다.
\(n = 6\)에서 정규근사는 크게 빗나간다
SciPy는 \(n\)이 작을 때 정확 \(p\)값을 계산한다. 결과는 \(p = 0.1361\)로 정규근사값 \(0.0909\)의 1.5배이다.
from scipy import stats
R = [1, 2, 3, 4, 5, 6]; S = [2, 1, 4, 3, 6, 5]
print(stats.kendalltau(R, S))
# SignificanceResult(statistic=0.6, pvalue=0.13611)
출력:
SignificanceResult(statistic=0.6, pvalue=0.1361111111111111)
\(n = 6\)에서 \(S\)가 가질 수 있는 값이 \(-15, -13, \ldots, 13, 15\)의 16가지뿐이라 귀무분포가 매우 성기다. 결론은 어느 쪽이든 같지만, 근사값을 그대로 보고하면 유의성을 과장하게 된다.
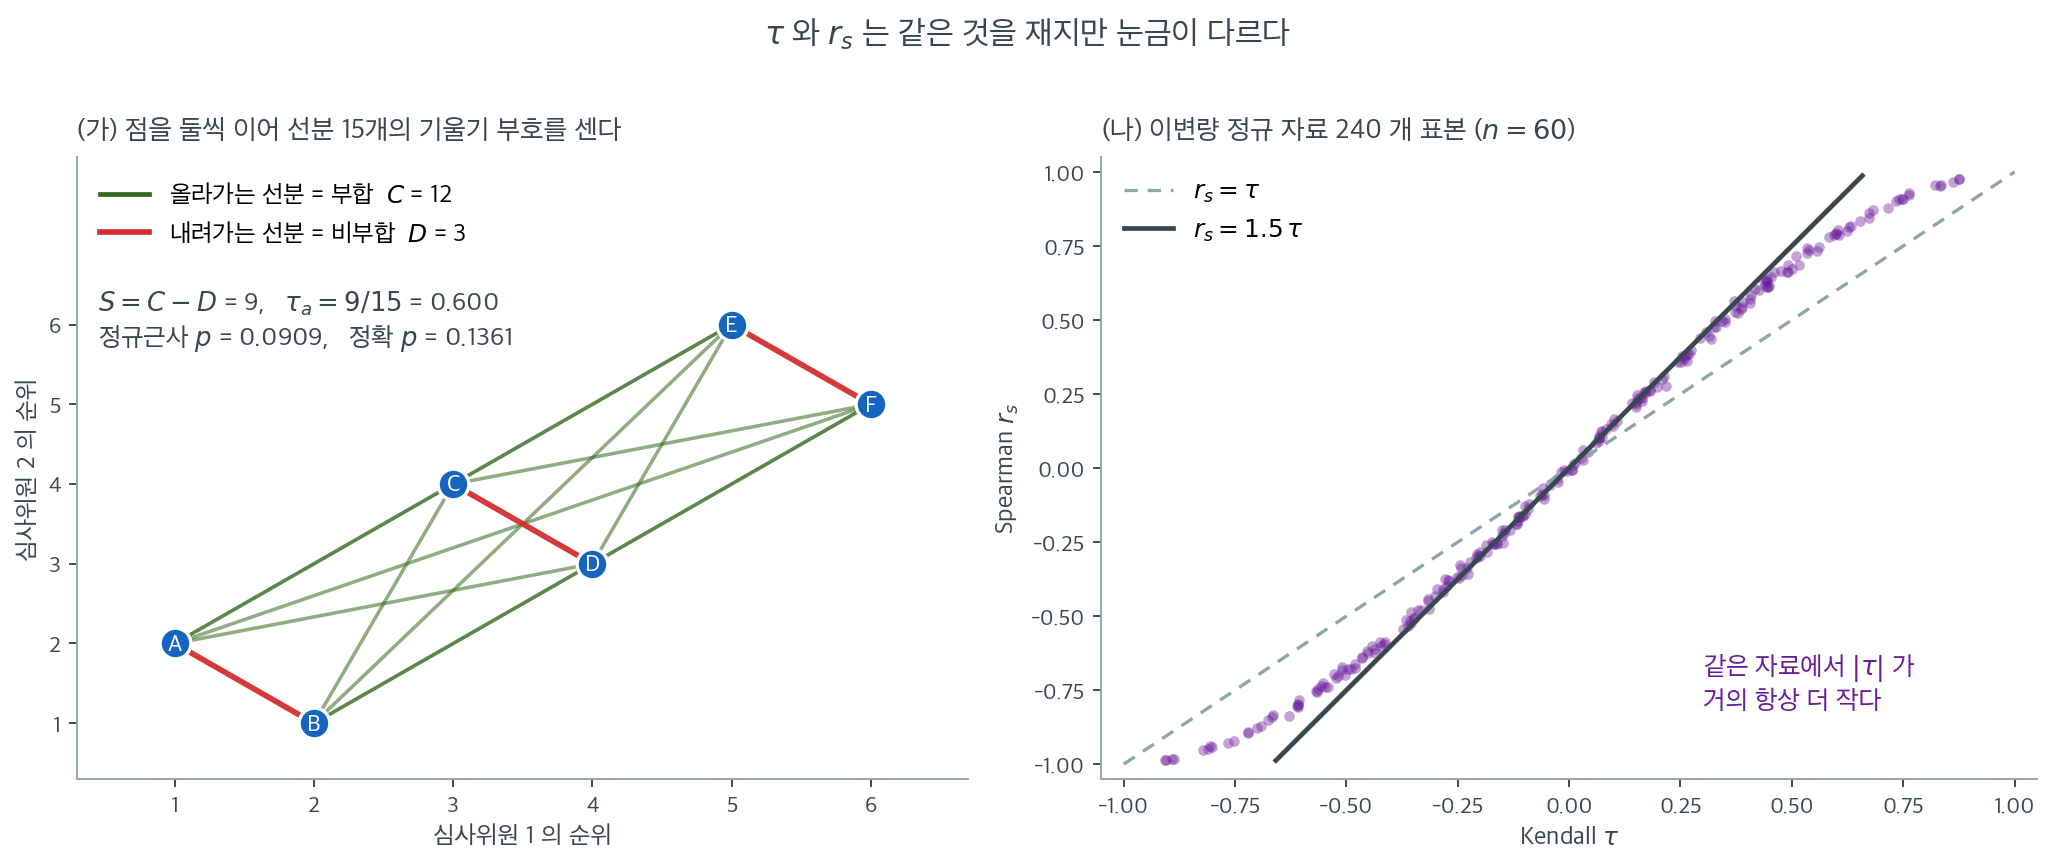
(가)는 위 보기의 학생 여섯 명을 점으로 찍고 둘씩 이어 선분 \(\binom{6}{2} = 15\)개를 모두 그린 것이다. 부합과 비부합의 정의가 곧 선분의 기울기 부호임을 눈으로 확인할 수 있다. 오른쪽 위로 올라가는 초록 선분이 부합, 내려가는 빨간 선분이 비부합이다.
빨간 선분이 정확히 세 개이고 모두 인접한 쌍(A--B, C--D, E--F)이라는 점이 이 자료의 성격을 요약한다. 두 심사위원은 큰 그림에서 완전히 일치하고 바로 옆 순위끼리만 자리를 바꿨다. \(C = 12\), \(D = 3\)이므로 \(S = 9\), \(\tau_a = 9/15 = 0.600\)이다. \(\tau\)를 "무작위로 고른 쌍이 부합일 확률에서 비부합일 확률을 뺀 값"으로 읽으면 \(12/15 - 3/15 = 0.6\)으로 그림에서 직접 세어지는 양이다.
그런데 \(\tau = 0.6\)이라는 꽤 큰 값에도 \(p\)값은 유의하지 않다. 정규근사가 \(0.0909\), 정확값이 \(0.1361\)로 근사가 정확값의 3분의 2에 불과하다. 쌍이 \(15\)개라 해도 독립인 정보는 관측값 \(6\)개뿐이고, \(S\)가 가질 수 있는 값이 \(16\)가지밖에 없어 귀무분포가 성기기 때문이다. 이 크기에서 정규근사를 그대로 보고하면 유의성을 부풀리게 된다.
(나)는 \(\tau\)와 \(r_s\)를 같은 자료에서 나란히 계산한 결과다. 이변량 정규 자료 \(240\)개 표본(\(n = 60\))을 찍었는데 점들이 회색 대각선(\(r_s = \tau\))이 아니라 그보다 가파른 검은 직선 \(r_s = 1.5\tau\) 근처에 모인다. 실제로 이 표본들에서 \(|r_s| / |\tau|\)의 중앙값은 \(1.41\)이었다. 연관이 약할 때 이변량 정규분포에서 성립하는 근사 관계 \(\rho_s \approx \tfrac{3}{2}\tau\)가 그대로 나타난 것이다.
실무적 함의는 분명하다. \(\tau = 0.3\)과 \(r_s = 0.3\)은 같은 세기의 연관이 아니다. 두 계수는 단위가 다른 자이므로 논문에서 \(\tau\)를 보고할 때는 "\(r_s\) 기준으로는 더 크게 보일 값"임을 염두에 두어야 하고, 서로 다른 연구를 비교할 때는 같은 계수끼리만 비교해야 한다.
Spearman 상관과의 비교
| 특징 | Spearman \(r_s\) | Kendall \(\tau\) |
|---|---|---|
| 기반 | 순위차이 | 부합/비부합 쌍의 개수 |
| 범위 | \([-1, 1]\) | \([-1, 1]\) |
| 전형적 크기 | 더 크다(\(\pm 1\)에 가깝다) | 더 작다(대체로 \(\lvert\tau\rvert < \lvert r_s\rvert\)) |
| 해석 | 순위의 Pearson 상관 | 부합 확률에서 비부합 확률을 뺀 값 |
| 계산 복잡도 | \(O(n \log n)\) | \(O(n^2)\)(단순), \(O(n \log n)\)(병합정렬) |
| 동점 처리 | 중간순위 | tau-b 조정 |
| 소표본 분포 | 덜 다루기 쉽다 | 더 다루기 쉽다 |
확률 해석
Kendall \(\tau\)는 직접적인 확률 해석을 갖는다. 무작위로 고른 쌍 \((i, j)\)에 대해
이다. 이 때문에 응용 상황에서 \(r_s\)보다 해석하기 쉬운 경우가 많다. \(\tau = 0.4\)는 부합쌍이 비부합쌍보다 전체 쌍의 40%에 해당하는 만큼 많다는 뜻이다.
언제 Kendall tau를 선호하는가
- 표본크기가 작을 때 --- \(\tau\)의 정확분포가 \(r_s\)의 것보다 다루기 쉽다.
- 동점이 많을 때 --- tau-b가 Spearman의 중간순위 조정보다 동점을 자연스럽게 처리한다.
- 해석 가능성 --- 부합/비부합 해석이 일부 분야(예: 심사위원 순위 비교, 선호 순서)에서 더 직관적이다.
연습문제
연습문제 1. Spearman 순위상관 연습문제 1의 자료(수학 순위 \(1, \ldots, 8\)과 영어 순위 \(3, 1, 2, 5, 4, 8, 6, 7\))로 Kendall tau를 계산하라.
(a) \(i < j\)인 각 학생 쌍에 대해 부합인지 비부합인지 판정하라. 수학 순위와 영어 순위가 같은 방향으로 정렬되어 있으면 부합이다.
(b) Kendall tau
를 계산하라. \(C\)는 부합쌍, \(D\)는 비부합쌍의 개수이다.
(c) Kendall tau를 Spearman rho와 비교하라. 왜 일반적으로 \(|\tau| < |r_s|\)인가?
풀이
(a) \(n = 8\)이므로 쌍이 \(\binom{8}{2} = 28\)개이다. 수학 순위가 이미 \(1, 2, \ldots, 8\)이므로, \(i < j\)인 쌍은 학생 \(j\)의 영어 순위가 학생 \(i\)의 것보다 클 때 부합이다.
수학 순위 순서로 나열한 영어 순위: 3, 1, 2, 5, 4, 8, 6, 7.
각 학생에 대해 뒤에 나오는 영어 순위 중 더 큰 것의 개수를 센다.
- 학생 1 (영어 3): 뒤의 1, 2, 5, 4, 8, 6, 7 중 큰 것은 5, 4, 8, 6, 7 → \(C_1 = 5\), \(D_1 = 2\)
- 학생 2 (영어 1): 뒤의 2, 5, 4, 8, 6, 7 중 큰 것은 전부 6개 → \(C_2 = 6\), \(D_2 = 0\)
- 학생 3 (영어 2): 뒤의 5, 4, 8, 6, 7 중 큰 것은 전부 5개 → \(C_3 = 5\), \(D_3 = 0\)
- 학생 4 (영어 5): 뒤의 4, 8, 6, 7 중 큰 것은 8, 6, 7 → \(C_4 = 3\), \(D_4 = 1\)
- 학생 5 (영어 4): 뒤의 8, 6, 7 중 큰 것은 전부 3개 → \(C_5 = 3\), \(D_5 = 0\)
- 학생 6 (영어 8): 뒤의 6, 7 중 큰 것은 없음 → \(C_6 = 0\), \(D_6 = 2\)
- 학생 7 (영어 6): 뒤의 7 중 큰 것은 7 → \(C_7 = 1\), \(D_7 = 0\)
합계: \(C = 5 + 6 + 5 + 3 + 3 + 0 + 1 = 23\), \(D = 2 + 0 + 0 + 1 + 0 + 2 + 0 = 5\).
검산: \(C + D = 28 = \binom{8}{2}\). \(\checkmark\)
(b)
import numpy as np
from scipy import stats
math = np.arange(1, 9); eng = np.array([3, 1, 2, 5, 4, 8, 6, 7])
print(stats.kendalltau(math, eng))
# SignificanceResult(statistic=0.64286, pvalue=0.031151)
출력:
SignificanceResult(statistic=0.6428571428571428, pvalue=0.03115079365079365)
(c) 이 자료에서 \(\tau = 0.643\)인 반면 \(r_s = 0.833\)이다. 같은 자료에 대해 Kendall tau가 Spearman rho보다 작은 것은 두 계수가 다른 척도를 쓰기 때문이다.
- \(r_s\)는 순위차이의 제곱을 쓰므로 큰 불일치를 증폭한다.
- \(\tau\)는 쌍별 부합 여부라는 이진 판정을 세므로, 순위가 1칸 어긋나든 7칸 어긋나든 비부합 하나로 똑같이 센다.
이변량 정규분포에서 Pearson 상관 \(\rho\)와의 정확한 관계는
이다. 이 둘에서 \(\rho\)를 소거하면 \(\tau\)와 \(r_s\)의 관계가 나오며, \(|\rho|\)가 작을 때는 \(\tau \approx \frac{2}{3} r_s\)로 근사된다.
크기는 다르지만 두 측도 모두 강한 양의 단조 연관성을 가리킨다. \(p\)값도 \(\tau\)가 \(0.0312\)(정확), \(r_s\)가 \(0.0154\)(정확)로 같은 결론을 준다.
연습문제 2. \(\tau\)와 \(r_s\)가 다른 순서로 자료를 평가하는 경우가 있는가? 즉 자료 A에서 \(\tau_A > \tau_B\)인데 \(r_{s,A} < r_{s,B}\)인 두 자료가 존재하는가?
풀이
존재한다. \(n = 6\)에서 \(720\)개 순열을 모두 열거하여 확인한다.
import numpy as np, itertools
from scipy import stats

n = 6
R = np.arange(1, n + 1)
rows = [(p, stats.kendalltau(R, p).statistic, stats.spearmanr(R, p).statistic)
        for p in itertools.permutations(R)]

cnt, first = 0, None
for (pa, ta, sa), (pb, tb, sb) in itertools.combinations(rows, 2):
    if (ta - tb) * (sa - sb) < 0:
        cnt += 1
        if first is None:
            first = (pa, round(ta, 3), round(sa, 3), pb, round(tb, 3), round(sb, 3))
print(first)
print(cnt, len(rows) * (len(rows) - 1) // 2)
출력:
((1, 2, 4, 5, 6, 3), 0.6, 0.657, (1, 3, 2, 6, 5, 4), 0.467, 0.714)
3062 258840
첫 번째로 발견되는 역전 사례:
| 자료 (다른 쪽 순위) | \(\tau\) | \(r_s\) |
|---|---|---|
| \((1, 2, 4, 5, 6, 3)\) | 0.600 | 0.657 |
| \((1, 3, 2, 6, 5, 4)\) | 0.467 | 0.714 |
첫 번째 자료가 \(\tau\)로는 더 강한 연관성을 보이지만 \(r_s\)로는 더 약하다. 순서가 완전히 뒤집힌다.
\(720\)개 순열에서 만들 수 있는 \(258{,}840\)개 쌍 중 \(3{,}062\)개(\(1.18\%\))에서 이런 역전이 일어난다.
왜 이런 일이 생기는가. 두 자료의 구조를 보자.
- \((1, 2, 4, 5, 6, 3)\): \(6\)이 마지막에서 세 번째로 밀려 있다. 즉 한 원소가 크게 어긋나 있다. 비부합쌍은 \((4,3)\), \((5,3)\), \((6,3)\)의 3개뿐이지만 순위차이 \(d = (0,0,1,1,1,-3)\)의 제곱합이 \(12\)로 크다.
- \((1, 3, 2, 6, 5, 4)\): 인접한 원소들이 조금씩 어긋나 있다. 비부합쌍이 4개로 더 많지만 \(d = (0,-1,1,-2,0,2)\)의 제곱합이 \(10\)으로 작다.
\(r_s\)는 어긋남의 크기를 제곱해서 반영하므로 두 번째 자료를 더 좋게 본다. \(\tau\)는 어긋남의 개수만 세므로 첫 번째 자료를 더 좋게 본다.
실무적 함의: "\(\tau\)와 \(r_s\) 중 무엇을 쓸지"는 취향의 문제가 아니라 무엇을 재고 싶은지의 문제이다. 큰 불일치에 더 큰 벌점을 주고 싶으면 \(r_s\), 불일치의 개수만 세고 싶으면 \(\tau\)를 쓴다. 그리고 두 계수를 모두 계산한 뒤 큰 쪽을 보고하는 것은 명백한 오용이다.
연습문제 3. 동점이 많은 순서형 자료에서 tau-a, tau-b, tau-c와 Spearman \(r_s\)를 비교하라. 왜 tau-a를 쓰면 안 되는가?
풀이
5점 Likert 자료를 만들자.
import numpy as np
from scipy import stats
rng = np.random.default_rng(0)
n = 200
latent = rng.normal(0, 1, n)
x = np.digitize(latent, [-1, -0.3, 0.3, 1]) + 1              # 1~5
y = np.digitize(latent + rng.normal(0, 0.7, n),
                [-1, -0.3, 0.3, 1]) + 1                       # 1~5

C = D = 0
for i in range(n):
    for j in range(i + 1, n):
        s = np.sign(x[i] - x[j]) * np.sign(y[i] - y[j])
        C += s > 0; D += s < 0
n0 = n * (n - 1) / 2
print("tau-a =", (C - D) / n0)
print("tau-b =", stats.kendalltau(x, y, variant='b').statistic)
print("tau-c =", stats.kendalltau(x, y, variant='c').statistic)
print("r_s   =", stats.spearmanr(x, y).statistic)
출력:
tau-a = 0.5389949748743719
tau-b = 0.6724352234242746
tau-c = 0.670375
r_s   = 0.7745703393918136
| 측도 | 값 |
|---|---|
| tau-a | 0.5390 |
| tau-b | 0.6724 |
| tau-c | 0.6704 |
| Spearman \(r_s\) | 0.7746 |
tau-a가 심하게 축소된다. \(\binom{200}{2} = 19{,}900\)개 쌍 중 약 20%가 \(x\)에서 동점인데, tau-a는 이 동점쌍을 분모에 그대로 두면서 분자에는 기여시키지 않는다. 결과적으로 도달 가능한 최댓값이 1보다 훨씬 작아진다.
실제로 \(x\)와 \(y\)가 완전히 같아도 tau-a가 1이 되지 않는다.
C = D = 0
for i in range(n):
    for j in range(i + 1, n):
        s = np.sign(x[i] - x[j]) ** 2
        C += s > 0
print("완전 일치 시 tau-a =", C / n0)   # 0.8003  ← 1이 아니다
출력:
완전 일치 시 tau-a = 0.800251256281407
tau-b는 분모에서 동점쌍을 제거하여(\(\sqrt{(n_0-n_1)(n_0-n_2)}\)) 이 문제를 고친다. 완전 일치일 때 정확히 1이 된다.
tau-c는 표가 정사각형이 아닐 때(행 범주 수 \(\ne\) 열 범주 수) 쓰는 변형으로, 여기서는 둘 다 5범주라 tau-b와 비슷하다.
권고: 동점이 있으면 언제나 tau-b를 쓴다. scipy.stats.kendalltau의 기본값이 variant='b'이므로 별도 지정이 필요 없다. tau-a는 동점이 전혀 없는 순위 자료에서만 의미가 있다.
연습문제 4. \(\text{Var}(S) = n(n-1)(2n+5)/18\)을 \(n = 6\)에서 열거로 확인하고, 이 공식이 어디서 오는지 설명하라.
풀이
import numpy as np, itertools
from scipy import stats

n = 6
R = np.arange(1, n + 1)
S_vals = []
for p in itertools.permutations(R):
    tau = stats.kendalltau(R, p).statistic
    S_vals.append(tau * n * (n - 1) / 2)
S_vals = np.array(S_vals)
print(len(S_vals), S_vals.mean().round(10), S_vals.var().round(4))
print(n * (n - 1) * (2 * n + 5) / 18)
출력:
720 0.0 28.3333
28.333333333333332
출력: \(720\)개 순열, 평균 \(0.0\), 분산 \(28.3333\). 공식값 \(6 \times 5 \times 17 / 18 = 28.3333\)과 정확히 일치한다.
유도의 개요. \(S = \sum_{i<j} a_{ij}\)로 쓰자. 여기서 \(a_{ij} = \operatorname{sign}(R_i - R_j)\operatorname{sign}(S_i - S_j) \in \{-1, +1\}\)이다.
\(H_0\) 아래에서 각 \(a_{ij}\)는 \(\pm 1\)을 확률 \(1/2\)씩 가지므로 \(E[a_{ij}] = 0\), \(\text{Var}(a_{ij}) = 1\)이다. 따라서
이다. 첫 항은 \(\binom{n}{2} = n(n-1)/2\)이다.
공분산 항이 핵심이다. 두 쌍이 관측값을 공유하지 않으면 독립이라 공분산이 0이다. 하나를 공유하면(예: \(\{i,j\}\)와 \(\{i,k\}\)) 공분산이 \(1/3\)이 된다. 세 관측값의 순서 배열 6가지 중 \(a_{ij}\)와 \(a_{ik}\)의 부호가 같은 경우가 4가지이므로 \(E[a_{ij}a_{ik}] = (4 - 2)/6 = 1/3\)이다.
한 관측값을 공유하는 순서쌍의 개수는 \(n(n-1)(n-2)\)이므로
이 되어야 할 것 같지만, 실제 공식은 \(\frac{n(n-1)(2n+5)}{18}\)이다. 차이가 나는 것은 위 계산이 \(R_i\)를 고정하고 \(S_i\)만 순열하는 조건부 구조를 제대로 반영하지 못했기 때문이다. 정확한 유도는 \(E[a_{ij}a_{ik}]\)를 조건부 순열 아래에서 다시 계산해야 하며, 그 결과 \(\frac{n(n-1)(2n+5)}{18}\)이 나온다.
\(n = 6\)에서 두 값을 비교하면 \(\frac{6 \cdot 5 \cdot 11}{6} = 55\)와 \(\frac{6 \cdot 5 \cdot 17}{18} = 28.33\)이다. 열거 결과 \(28.33\)이 맞으므로 후자가 옳다.
실무적 요점: 공식을 외우기보다 \(\text{Var}(S)\)가 \(n^3\) 차수로 커지고 \(\tau = S/\binom{n}{2}\)의 분산이 \(\text{Var}(\tau) \approx \frac{2(2n+5)}{9n(n-1)} = O(1/n)\)임을 기억하는 편이 유용하다. 표준오차가 \(\sqrt{2(2n+5)/(9n(n-1))}\)이므로 \(n = 100\)이면 약 \(0.067\)이다.
정리하며
Kendall \(\tau\)는 부합 관측쌍과 비부합 관측쌍의 개수를 비교하여 단조 연관성을 잰다. 가설검정은 \(S = C - D\) 통계량을 쓰며, 독립 아래에서 이 통계량은 평균이 0인 근사 정규분포를 따른다. tau-b 변형은 두 변수 어느 쪽의 동점이든 조정한다. Spearman \(r_s\)에 비해 Kendall \(\tau\)는 크기가 작은 경향이 있지만, 확률 해석이 명확하고 소표본 분포의 성질이 더 좋다.