두 상관의 비교
많은 응용에서 우리는 하나의 상관이 유의한지만이 아니라 두 상관이 서로 다른지도 판정해야 한다. 예를 들어 공부 시간과 학점의 상관이 남성에서 여성보다 강한가? 두 생체표지자 사이의 연관이 대조군보다 처치군에서 강한가? 이 절에서는 두 상관계수가 같은지 검정하는 표준적인 방법을 다룬다.
두 가지 상황
상관을 비교하는 상황은 뚜렷하게 두 가지로 나뉜다:
-
독립 표본: 두 상관이 서로 무관한 다른 집단에서 나온다. 예를 들어 \(r_1\)은 남성의 키–몸무게 상관이고 \(r_2\)는 여성의 키–몸무게 상관이다.
-
종속(겹치는) 표본: 두 상관이 같은 표본에서 나오고 한 변수를 공유한다. 예를 들어 \(r_{XY}\)와 \(r_{XZ}\)가 모두 같은 변수 \(X\)를 포함한다.
두 경우의 방법은 상당히 다르다.
Fisher의 z 변환
두 방법 모두 표본상관의 분산을 안정화하고 분포를 근사적으로 정규로 만드는 Fisher의 z 변환에 기댄다:
이변량 정규분포에서 크기 \(n\)인 표본을 뽑으면 변환된 상관 \(z\)가 근사적으로 정규분포를 따른다:
핵심 성질은 \(r\) 자체의 분산과 달리 분산 \(1/(n-3)\)이 \(\rho\)에 의존하지 않는다는 점이다. 덕분에 \(z\)로는 추론이 훨씬 쉬워진다.
독립인 두 상관의 비교
크기가 \(n_1\), \(n_2\)인 두 독립 표본에서 표본상관 \(r_1\), \(r_2\)를 얻었을 때
를 검정한다. 각각에 Fisher z 변환을 적용한다:
\(H_0\) 아래에서 차이 \(z_1 - z_2\)의 근사 분산은 \(\frac{1}{n_1 - 3} + \frac{1}{n_2 - 3}\)이다. 검정통계량은
이다. \(H_0\) 아래에서 \(Z\)는 근사적으로 표준정규분포를 따른다. \(|Z| > z_{\alpha/2}\)이면 수준 \(\alpha\)에서 \(H_0\)을 기각한다.
보기 1. 두 독립 상관계수 비교. 어떤 연구자가 남성에서 \(r_1 = 0.65\)(\(n_1 = 50\)), 여성에서 \(r_2 = 0.40\)(\(n_2 = 60\))을 얻었다.
풀이
양측 p-값은 \(2 \times P(Z > 1.785) \approx 0.074\)이다. \(\alpha = 0.05\)에서 \(H_0\)을 기각하지 못한다. 남성과 여성 사이에 상관이 다르다는 증거가 충분하지 않다.
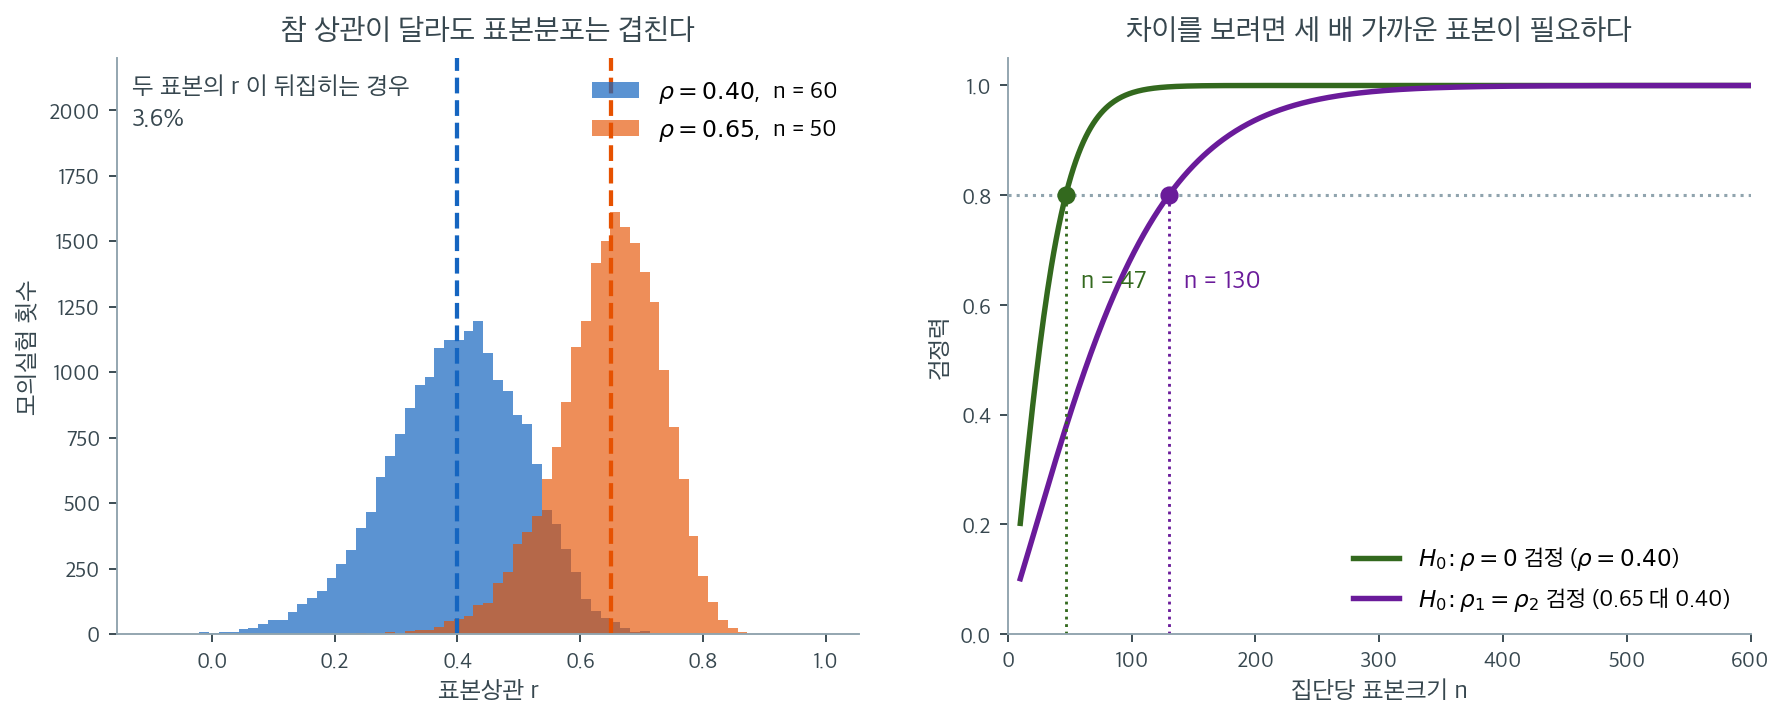
\(r_1 = 0.65\)와 \(r_2 = 0.40\)은 눈으로 보기에 꽤 다른데 왜 유의하지 않았을까. 왼쪽이 그 답이다. 참 상관을 각각 \(0.65\)와 \(0.40\)으로 고정해 두고 \(n_1 = 50\), \(n_2 = 60\)인 표본을 2만 번씩 새로 뽑아 \(r\)을 모았다. 두 분포는 중심이 분명히 다르지만 꼬리가 겹친다. 그 겹침의 크기를 한 숫자로 재면, 참값이 작은 쪽 표본에서 오히려 더 큰 \(r\)이 나오는 경우가 \(3.6\%\)다. 이 값의 두 배가 대략 앞에서 얻은 \(p = 0.074\)다. \(p\)-값이 크게 나온 것은 두 상관이 비슷해서가 아니라, 이 정도 표본에서는 \(r\) 자체가 그만큼 흔들리기 때문이다.
오른쪽은 그렇다면 표본이 얼마나 필요한지를 묻는다. 초록 곡선은 \(\rho = 0.40\)인 집단에서 \(H_0\!: \rho = 0\)을 검정할 때의 검정력이고, 보라 곡선은 \(\rho_1 = 0.65\)와 \(\rho_2 = 0.40\)을 견주는 \(H_0\!: \rho_1 = \rho_2\) 검정의 검정력이다. 80%에 이르는 지점이 전자는 \(n = 47\), 후자는 집단당 \(n = 130\)이다. 상관 하나가 0이 아님을 보이는 데 필요한 표본의 세 배에 가깝다.
이유는 검정통계량의 분모에 그대로 적혀 있다. 단일 상관 검정의 표준오차는 \(1/\sqrt{n-3}\)인데 차이 검정은 \(\sqrt{2/(n-3)}\)이어서 \(\sqrt{2}\)배로 커지고, 동시에 분자에 놓이는 신호도 \(\text{arctanh}(0.65) - \text{arctanh}(0.40) = 0.352\)로 \(\text{arctanh}(0.40) = 0.424\)보다 작다. 분자는 작아지고 분모는 커지므로 표본크기는 제곱으로 벌을 받는다.
실무적으로 이것은 흔한 함정이다. 두 하위집단에서 각각 상관을 구해 "남성에서는 유의했고 여성에서는 유의하지 않았다"고 보고하는 분석을 자주 보게 되는데, 그 진술은 두 상관이 다르다는 주장이 아니다. 차이를 주장하려면 위의 \(Z\) 검정을 직접 수행해야 하고, 그러자면 각 집단이 이 그림이 말하는 크기여야 한다.
종속인 두 상관의 비교
두 상관이 공통 변수를 공유하면(예: 같은 크기 \(n\)의 표본에서 나온 \(r_{XY}\)와 \(r_{XZ}\)), \(r_{XY}\)와 \(r_{XZ}\)가 상관되어 있으므로 독립 표본용 Fisher z-검정을 쓸 수 없다.
Steiger 검정 (Williams 수정)
\(H_0\!: \rho_{XY} = \rho_{XZ}\)를 검정하기 위해 Steiger(1980)를 바탕으로 Williams(1959)가 제안한 검정통계량은
이다. 여기서 \(|R|\)은 \((X, Y, Z)\)의 \(3 \times 3\) 상관행렬의 행렬식이고 \(\bar{r} = (r_{XY} + r_{XZ})/2\)이다.
\(H_0\) 아래에서 이 통계량은 근사적으로 자유도 \(n - 3\)인 \(t\)-분포를 따른다.
더 단순하지만 덜 정확한 근사는 분모를 \(r_{YZ}\)만 포함하는 식으로 바꾼 형태이다:
소프트웨어에 가장 흔히 구현되는 형태이다.
보기 2. \(0.65\) 와 \(0.40\) 의 차이를 잡으려면 몇 명이 필요한가. 독립인 두 집단에서 \(r_1 = 0.65\,(n_1 = 50)\), \(r_2 = 0.40\,(n_2 = 60)\) 을 얻었다.
(1) \(Z\) 와 양측 p-값을 손으로 구하시오. 또 \(\zeta_1 - \zeta_2\) 의 \(95\%\) 신뢰구간을 적고, 양끝에 \(\tanh\) 를 씌운 것이 왜 \(\rho_1 - \rho_2\) 의 구간이 아닌지 수로 보이시오.
(2) 참값이 정말 \(\rho_1 = 0.65\), \(\rho_2 = 0.40\) 이라 하자. \(\alpha = 0.05\) 에서 검정력 \(0.80\) 을 얻으려면 집단당 몇 명이 필요한가. 닫힌 꼴로 풀고 모의실험으로 확인하시오.
풀이
(1) 피셔 눈금에서 두 수를 빼면 끝이다.
이고 두 표본이 독립이므로 차이의 분산은 두 분산의 합이다.
이다. \(\alpha = 0.05\) 에서 기각하지 못한다. \(\zeta_1 - \zeta_2\) 의 \(95\%\) 구간은
로 \(0\) 을 품으므로 검정 결과와 맞는다.
\(\tanh\) 를 씌우면 안 되는 까닭은 \(\tanh\) 가 비선형이기 때문이다. \(\tanh\) 는 합과 차를 보존하지 않으므로
이다. 실제로 \(\tanh(0.3517) = 0.3378\) 인데 \(r_1 - r_2 = 0.2500\) 이다. 점추정부터 \(0.088\) 만큼 어긋난다. 그러니 \((\tanh(-0.0345),\, \tanh(0.7378)) = (-0.0345,\, 0.6278)\) 은 \(\rho_1 - \rho_2\) 를 덮는 구간이 아니다. 신뢰구간은 \(\zeta_1 - \zeta_2\) 에 대한 것이고, 그 척도에서 보고하거나 아예 붓스트랩으로 \(\rho_1 - \rho_2\) 를 직접 잡아야 한다.
(2) 검정력 식도 닫힌 꼴이다. 두 집단 크기를 \(n\) 으로 같게 두면 \(\operatorname{SE} = \sqrt{2/(n-3)}\) 이고, \(Z\) 는 평균이 \(\delta/\operatorname{SE}\) 인 정규를 따른다. 여기서 \(\delta = \zeta_1 - \zeta_2\) 다. 양측 검정의 검정력이 \(1-\beta\) 이려면 (한쪽 꼬리는 무시할 만하므로)
이다. \(\delta = \operatorname{arctanh}(0.65) - \operatorname{arctanh}(0.40) = 0.351650\) 이고 \(z_{0.025} + z_{0.20} = 1.959964 + 0.841621 = 2.801585\) 이므로
곧 집단당 \(130\) 명이다. 이 \(n\) 에서 이론 검정력은 \(0.8002\) 다.
이 수가 이 보기의 핵심이다. 상관 하나를 "\(0\) 과 다르다"고 말하려면 \(r = 0.4\) 에서 \(n = 47\) 이면 족하다. 그런데 두 상관이 \(0.65\) 와 \(0.40\) 만큼 벌어져 있는데도 그 차이를 가리려면 집단마다 \(130\) 명씩, 모두 \(260\) 명이 든다. 이 보기의 \(50\) 과 \(60\) 으로는 검정력이 한참 모자라고, \(p = 0.074\) 는 "차이가 없다"가 아니라 "이 표본으로는 알 수 없다" 로 읽어야 한다.
import numpy as np
from scipy import stats

# 서로 다른 두 표본에서 얻은 상관계수를 견준다. 표본이 겹치지 않아야
# 이 방법을 쓸 수 있다. 같은 사람에게서 잰 두 상관이라면 다른 검정이 필요하다.
r1, n1 = 0.65, 50
r2, n2 = 0.40, 60

# 두 r 을 각각 z 로 옮긴다. z 는 거의 정규이고 분산이 표본크기로만 정해진다.
z1 = np.arctanh(r1)
z2 = np.arctanh(r2)
# 두 z 가 독립이므로 차이의 분산은 각 분산의 합이다.
se = np.sqrt(1 / (n1 - 3) + 1 / (n2 - 3))
Z_stat = (z1 - z2) / se
p_value = 2 * (1 - stats.norm.cdf(abs(Z_stat)))

print(f"z1 = {z1:.4f}, z2 = {z2:.4f}")
print(f"Z statistic = {Z_stat:.4f}")
print(f"Two-sided p-value = {p_value:.4f}")

# (1) zeta1 - zeta2 의 95% 구간과, 그것을 tanh 로 되돌리면 안 되는 까닭
lo, hi = (z1 - z2) - 1.96 * se, (z1 - z2) + 1.96 * se
print(f"\nSE = sqrt(1/{n1-3} + 1/{n2-3}) = {se:.6f}")
print(f"zeta1 - zeta2 의 95% 구간 = ({lo:+.4f}, {hi:+.4f})   0 을 품는가: {lo < 0 < hi}")
print(f"끝점에 tanh 를 씌우면      = ({np.tanh(lo):+.4f}, {np.tanh(hi):+.4f})")
print(f"그러나 rho1 - rho2 의 점추정은 {r1 - r2:+.4f} 이고 "
      f"tanh(z1-z2) = {np.tanh(z1 - z2):+.4f} 로 서로 다르다")

# (2) 검정력 0.80 에 필요한 집단당 표본크기
zeta1, zeta2 = np.arctanh(0.65), np.arctanh(0.40)
delta = zeta1 - zeta2
need = stats.norm.ppf(0.975) + stats.norm.ppf(0.80)
n_req = 3 + 2 * (need / delta) ** 2
print(f"\ndelta = zeta1 - zeta2 = {delta:.6f}")
print(f"z_0.025 + z_0.20 = {need:.6f}")
print(f"필요한 n = 3 + 2*(need/delta)^2 = {n_req:.2f}  ->  "
      f"집단당 {int(np.ceil(n_req))} 명")

n = int(np.ceil(n_req))
ncp = delta / np.sqrt(2 / (n - 3))
print(f"이론 검정력 = {stats.norm.sf(1.96 - ncp) + stats.norm.cdf(-1.96 - ncp):.4f}")

rng = np.random.default_rng(7)
B = 20_000
def sample_r(rho, m, B):
    a = rng.standard_normal((B, m))
    b = rho * a + np.sqrt(1 - rho**2) * rng.standard_normal((B, m))
    a = a - a.mean(axis=1, keepdims=True)
    b = b - b.mean(axis=1, keepdims=True)
    return (a * b).sum(axis=1) / np.sqrt((a**2).sum(axis=1) * (b**2).sum(axis=1))

R1, R2 = sample_r(0.65, n, B), sample_r(0.40, n, B)
Zs = (np.arctanh(R1) - np.arctanh(R2)) / np.sqrt(2 / (n - 3))
print(f"모의 검정력 ({B:,}회, n = {n}) = {np.mean(np.abs(Zs) > 1.96):.4f}  "
      f"+- {np.std(np.abs(Zs) > 1.96) / np.sqrt(B):.4f}")

# 1종 오류도 함께 본다 (rho1 = rho2 = 0.65)
R1, R2 = sample_r(0.65, n, B), sample_r(0.65, n, B)
Zs = (np.arctanh(R1) - np.arctanh(R2)) / np.sqrt(2 / (n - 3))
print(f"모의 1종 오류 (rho1 = rho2 = 0.65) = {np.mean(np.abs(Zs) > 1.96):.4f}  (명목 0.05)")
출력:
z1 = 0.7753, z2 = 0.4236
Z statistic = 1.7848
Two-sided p-value = 0.0743

SE = sqrt(1/47 + 1/57) = 0.197029
zeta1 - zeta2 의 95% 구간 = (-0.0345, +0.7378)   0 을 품는가: True
끝점에 tanh 를 씌우면      = (-0.0345, +0.6278)
그러나 rho1 - rho2 의 점추정은 +0.2500 이고 tanh(z1-z2) = +0.3378 로 서로 다르다

delta = zeta1 - zeta2 = 0.351650
z_0.025 + z_0.20 = 2.801585
필요한 n = 3 + 2*(need/delta)^2 = 129.95  ->  집단당 130 명
이론 검정력 = 0.8002
모의 검정력 (20,000회, n = 130) = 0.8009  +- 0.0028
모의 1종 오류 (rho1 = rho2 = 0.65) = 0.0498  (명목 0.05)
이론 검정력 \(0.8002\) 와 모의 검정력 \(0.8009 \pm 0.0028\) 이 맞는다. 차이 \(0.0007\) 은 몬테카를로 오차의 \(4\) 분의 \(1\) 이다. 귀무가설이 참일 때의 기각률도 \(0.0498\) 로 명목 \(0.05\) 와 맞으므로, 피셔 \(z\) 근사가 \(n = 130\) 에서 제 몫을 한다.
표본이 겹치면 이 식을 쓸 수 없다. 분산을 합으로 쓴 자리가 바로 두 \(z\) 의 독립을 쓴 곳이다. 같은 사람에게서 잰 \(r_{XY}\) 와 \(r_{XZ}\) 는 \(X\) 를 공유하므로 서로 독립이 아니고, 둘의 공분산은 \(r_{YZ}\) 에 달려 있다. \(r_{YZ}\) 가 크면 차이의 분산이 합보다 한참 작아진다. 실제로 \(r_{XY} = r_{XZ} = 0.5\), \(n = 200\) 에서 재어 보면 \(r_{YZ} = 0.9\) 일 때 차이의 분산이 독립 가정이 주는 \(2/(n-3)\) 의 \(0.13\) 배, \(r_{YZ} = 0.5\) 일 때 \(0.56\) 배다. 그만큼 독립 공식은 분산을 부풀려 지나치게 보수적인 검정이 된다. 그래서 이 절 앞부분의 Steiger 식처럼 \(r_{YZ}\) 가 들어간 별도의 공식이 필요하다.
차이에 대한 신뢰구간
독립인 두 상관에 대해 \(\rho_1 - \rho_2\)의 \((1 - \alpha)\) 신뢰구간은 역변환으로 만들 수 있다:
이는 \(\zeta_1 - \zeta_2\)(\(\zeta = \text{arctanh}(\rho)\))에 대한 신뢰구간을 준다. 상관 척도로 되돌리려면 각 끝점에 \(\tanh\)를 적용한다. 다만 tanh 변환이 비선형이므로 이것은 \(\rho_1 - \rho_2\)에 대한 신뢰구간이 아니라 \(\zeta_1 - \zeta_2\)에 대한 신뢰구간임에 유의하라.
가정
두 비교 방법 모두 다음을 가정한다:
- 각 표본 안의 이변량 정규성.
- 각 모집단으로부터의 무작위 표집.
- 충분한 표본크기(정규근사가 적절하려면 대체로 각 집단에서 \(n \ge 25\)).
정규성이 어긋나면 붓스트랩 방법이 상관 비교의 비모수적 대안이 된다.
연습문제
연습문제 1. 두 독립 표본에서 \(r_1 = 0.65\)(\(n_1 = 50\))와 \(r_2 = 0.40\)(\(n_2 = 60\))을 얻었다. Fisher의 z 변환으로 \(\alpha = 0.05\)에서 두 모상관이 같은지 검정하라.
풀이
Fisher의 z 변환 \(z_r = \frac{1}{2}\ln\frac{1+r}{1-r}\)을 적용한다.
검정통계량은
이다. \(|Z| = 1.785 < 1.96\)이므로 \(\alpha = 0.05\)에서 \(H_0: \rho_1 = \rho_2\)를 기각하지 못한다.
연습문제 2. 상관이 0에서 멀 때 변환 없이 상관을 직접 비교하는 것이 왜 문제가 되는지 설명하라.
풀이
\(\rho \neq 0\)이면 \(r\)의 표본분포가 치우친다. \(\rho\)에 가까운 쪽 경계(\(\pm 1\)) 방향으로 압축되고 반대쪽으로는 늘어난다. \(|\rho| \to 1\)이면 분포가 점점 더 치우치고 분산이 줄어든다.
Fisher의 z 변환 \(z_r = \frac{1}{2}\ln\frac{1+r}{1-r}\)은 분산을 안정화하고 분포를 대칭에 가깝게 만든다. 변환 후에는 \(\rho\)와 무관하게 \(z_r\)이 근사적으로 \(N(z_\rho, 1/(n-3))\)을 따른다. 변환하지 않으면 \(r\)의 표준오차가 \(\rho\)에 의존하므로 비교를 믿을 수 없게 된다.
연습문제 3. 같은 표본에서 \(r_{XY} = 0.70\)과 \(r_{XZ} = 0.50\)을 \(n = 100\)으로 계산했다. 왜 독립 표본 검정으로 이 둘을 비교할 수 없는가?
풀이
독립 표본 검정은 \(r_1\)과 \(r_2\)가 서로 무관한 별개의 표본에서 나왔다고 가정한다. 두 상관이 같은 표본에서 나오면 변수 \(X\)와 같은 관측값들을 공유하므로 서로 종속이다. 두 상관의 공분산은 (표본에서 \(Y\)와 \(Z\)의 상관인) \(r_{YZ}\)에 의존한다.
이 종속을 무시하고 독립 표본 검정을 쓰면 차이의 표준오차를 과대추정하여(두 상관이 실제보다 변동이 큰 것처럼 다루어) 검정력을 잃는다.
올바른 검정은 \(r_{XY}\), \(r_{XZ}\), \(r_{YZ}\)를 포함하는 공식으로 두 상관계수 사이의 상관을 반영하는 Steiger(1980)의 방법이나 Hotelling(1940)의 검정이다.
연습문제 4. 어떤 연구자가 \(n = 2000\)인 표본에서 키와 소득의 상관이 \(r = 0.15\)라고 보고했다. 이 "작은" 상관은 통계적으로 유의한가? 실질적으로 중요한가?
풀이
\(H_0: \rho = 0\)을 검정하면 \(t = r\sqrt{n-2}/\sqrt{1-r^2} = 0.15\sqrt{1998}/\sqrt{0.9775} = 0.15 \times 44.7/0.9887 = 6.78\)이다.
\(df = 1998\)에서 \(t = 6.78\)은 매우 유의하다(\(p < 0.0001\)). 상관이 통계적으로 0과 구별된다.
그러나 \(r^2 = 0.0225\)이므로 키는 소득 분산의 2.25%만 설명한다. 실질적으로는 약한 연관이다. \(n = 2000\)이면 아주 작은 상관도 유의해진다. 통계적 유의성(효과가 0이 아닌가?)과 실질적 유의성(효과가 의미 있을 만큼 큰가?)을 구별하는 일이 왜 중요한지 보여준다. 해석에는 \(r^2\) 같은 효과크기 측도가 필수적이다.
연습문제 5. 연습문제 3의 상황(같은 표본의 두 상관)을 독립 표본 검정으로 처리하면 오류율이 얼마나 나빠지는가?
풀이
옳은 방법 — 윌리엄스의 \(t\). 공통 변수가 하나 있는 겹치는(overlapping) 경우다.
여기서 \(\lvert R\rvert\)는 세 변수 상관행렬의 행렬식, \(\bar r=(r_{12}+r_{13})/2\)다.
import warnings
warnings.filterwarnings("ignore")

import numpy as np
from scipy import stats

def williams_t(r12, r13, r23, n):
    """겹치는 종속 상관의 비교 (공통 변수 1)."""
    detR = 1 - r12**2 - r13**2 - r23**2 + 2 * r12 * r13 * r23
    rbar = (r12 + r13) / 2
    t = (r12 - r13) * np.sqrt(
        (n - 1) * (1 + r23)
        / (2 * detR * (n - 1) / (n - 3) + rbar**2 * (1 - r23)**3))
    return t, 2 * stats.t.sf(abs(t), n - 3)

def independent_z(r1, n1, r2, n2):
    z = (np.arctanh(r1) - np.arctanh(r2)) / np.sqrt(1 / (n1 - 3) + 1 / (n2 - 3))
    return z, 2 * stats.norm.sf(abs(z))

rng = np.random.default_rng(29001)
B = 4_000
print("H0: ρ12 = ρ13 이 참인 자료에서의 1종 오류 (명목 0.05)")
print(f"{'n':>5s} {'r23':>6s} {'독립표본 z 검정':>15s} {'윌리엄스 t':>12s}")
for n in [50, 100]:
    for r23 in [0.0, 0.5, 0.9]:
        R = np.array([[1, 0.5, 0.5], [0.5, 1, r23], [0.5, r23, 1]])
        L = np.linalg.cholesky(R)
        a = b = 0
        for _ in range(B):
            d = rng.standard_normal((n, 3)) @ L.T
            r12 = np.corrcoef(d[:, 0], d[:, 1])[0, 1]
            r13 = np.corrcoef(d[:, 0], d[:, 2])[0, 1]
            r23h = np.corrcoef(d[:, 1], d[:, 2])[0, 1]
            a += independent_z(r12, n, r13, n)[1] < 0.05
            b += williams_t(r12, r13, r23h, n)[1] < 0.05
        print(f"{n:5d} {r23:6.1f} {a / B:15.4f} {b / B:12.4f}")
H0: ρ12 = ρ13 이 참인 자료에서의 1종 오류 (명목 0.05)
    n    r23       독립표본 z 검정       윌리엄스 t
   50    0.0          0.0673       0.0473
   50    0.5          0.0092       0.0460
   50    0.9          0.0000       0.0505
  100    0.0          0.0602       0.0490
  100    0.5          0.0152       0.0475
  100    0.9          0.0000       0.0500
독립 표본 검정이 두 방향 모두로 망가진다.
| \(r_{23}\) | 독립 표본 \(z\) | 윌리엄스 \(t\) |
|---|---|---|
| 0.0 | 0.067(과대) | 0.047 ✓ |
| 0.5 | 0.009(과소) | 0.046 ✓ |
| 0.9 | 0.000 | 0.051 ✓ |
\(r_{23}=0.9\)이면 오류율이 정확히 0이다. 검정이 아무것도 기각하지 않는다.
윌리엄스 \(t\)는 여섯 조건 모두에서 0.046~0.051로 정확하다.
왜 두 방향으로 망가지는가.
독립 표본 공식은 공분산 항을 0으로 놓는다.
| \(r_{23}\) | 실제 공분산 | 독립 공식의 결과 |
|---|---|---|
| 높음(0.9) | 크게 양수 | 분산을 과대평가 → 기각 못 함 |
| 0 | 약간 양수 | 근사적으로 맞지만 약간 과대 |
\(r_{23}=0\)에서도 오류율이 0.067인 이유는 공통 변수 \(X_1\)이 여전히 \(r_{12}\)와 \(r_{13}\)에 공유되기 때문이다. 완전히 독립인 경우는 없다.
경우별 검정.
| 상황 | 검정 |
|---|---|
| 독립 표본 | 피셔 \(z\) |
| 겹치는 종속(\(r_{12}\) vs \(r_{13}\)) | 윌리엄스 \(t\) |
| 겹치지 않는 종속(\(r_{12}\) vs \(r_{34}\)) | 스타이거의 \(z^*\) |
세 번째도 흔하다. 사전·사후 두 시점에서 같은 두 변수의 상관을 비교하는 경우가 그렇다.
구현. pingouin이 셋을 모두 지원한다.
import pingouin as pg
pg.corr_test?  →  다음이 표준적이다

# 겹치는 종속
pg.rm_corr(...)  또는 직접 윌리엄스 t 구현

# cocor (R) 이 가장 완전하다: 10가지 이상의 검정을 제공
연습문제 6. 두 상관의 차이를 검출하려면 표본이 얼마나 필요한가? 연습문제 1의 설계가 충분했는지 판단하라.
풀이
필요 표본 크기(독립 표본, 각 군 \(n\)).
import numpy as np
from scipy import stats

za, zb = stats.norm.ppf(0.975), stats.norm.ppf(0.80)
print("검정력 0.80, 양측 0.05")
print(f"{'ρ1':>6s} {'ρ2':>6s} {'차이':>6s} {'z1-z2':>8s} {'군당 n':>8s}")
for r1, r2 in [(0.5, 0.3), (0.5, 0.4), (0.7, 0.5),
               (0.3, 0.1), (0.9, 0.8), (0.2, 0.0)]:
    d = abs(np.arctanh(r1) - np.arctanh(r2))
    print(f"{r1:6.2f} {r2:6.2f} {r1 - r2:6.2f} {d:8.4f} "
          f"{int(np.ceil(2 * ((za + zb) / d)**2 + 3)):8d}")
검정력 0.80, 양측 0.05
    ρ1     ρ2     차이    z1-z2     군당 n
  0.50   0.30   0.20   0.2398      277
  0.50   0.40   0.10   0.1257      998
  0.70   0.50   0.20   0.3180      159
  0.30   0.10   0.20   0.2092      362
  0.90   0.80   0.10   0.3736      116
  0.20   0.00   0.20   0.2027      385
연습문제 1의 \(n_1=50\), \(n_2=60\)은 턱없이 부족하다. \(\rho\)가 0.65와 0.40이라도 군당 200 이상이 필요하다.
같은 "차이 0.20"이라도 필요 표본이 크게 다르다.
| \(\rho_1\) | \(\rho_2\) | 군당 \(n\) |
|---|---|---|
| 0.2 | 0.0 | 385 |
| 0.3 | 0.1 | 362 |
| 0.5 | 0.3 | 277 |
| 0.7 | 0.5 | 159 |
상관이 클수록 같은 차이를 검출하기 쉽다. \(\operatorname{arctanh}\)가 극단에서 크게 늘어나기 때문이다.
차이 0.10이면 \(\rho=0.9\) 근처에서도 116명이지만 중간 범위에서는 998명이다.
rng = np.random.default_rng(29002)
B = 5_000
print("\n모의실험으로 검정력 확인")
for r1, r2, n in [(0.5, 0.3, 277), (0.5, 0.4, 998),
                  (0.7, 0.5, 159), (0.9, 0.8, 116)]:
    a = 0
    for _ in range(B):
        z = rng.standard_normal((n, 2))
        R1 = np.corrcoef(z[:, 0], r1 * z[:, 0]
                         + np.sqrt(1 - r1**2) * z[:, 1])[0, 1]
        z = rng.standard_normal((n, 2))
        R2 = np.corrcoef(z[:, 0], r2 * z[:, 0]
                         + np.sqrt(1 - r2**2) * z[:, 1])[0, 1]
        zz = (np.arctanh(R1) - np.arctanh(R2)) / np.sqrt(2 / (n - 3))
        a += 2 * stats.norm.sf(abs(zz)) < 0.05
    print(f"  ρ1={r1}, ρ2={r2}, 군당 n={n}: 검정력 {a / B:.4f}")
모의실험으로 검정력 확인
  ρ1=0.5, ρ2=0.3, 군당 n=277: 검정력 0.7996
  ρ1=0.5, ρ2=0.4, 군당 n=998: 검정력 0.8040
  ρ1=0.7, ρ2=0.5, 군당 n=159: 검정력 0.7948
  ρ1=0.9, ρ2=0.8, 군당 n=116: 검정력 0.8040
네 경우 모두 0.795~0.804로 목표 0.80을 정확히 맞춘다. 공식이 옳다.
실무적 함의 셋.
- "두 상관이 다르다"를 보이려면 상관 자체를 추정할 때보다 훨씬 큰 표본이 필요하다. \(\rho=0.5\)를 \(\pm0.1\)로 추정하는 데는 150명이면 되지만, 0.5와 0.3을 구분하려면 군당 277명이다.
- 유의하지 않았다고 "같다"고 말하면 안 된다. 대부분의 연구가 이 비교에 대해 심하게 저검정력이다.
- 차이의 신뢰구간을 보고한다. 폭이 넓으면 그것이 답이다.
연습문제 7. 두 상관의 차이에 대한 신뢰구간을 어떻게 만드는가? 순진한 방법의 문제를 보여라.
풀이
순진한 방법. \(z\) 척도에서 구간을 만들고 \(\tanh\)로 되돌린다. 이것은 틀렸다.
\(\tanh\)가 비선형이므로, \(z\) 차이의 구간을 되돌려도 \(r\) 차이의 구간이 되지 않는다.
조우(Zou, 2007)의 방법. 각 상관의 구간을 먼저 만든 뒤 결합한다.
import warnings
warnings.filterwarnings("ignore")

import numpy as np
from scipy import stats

def fisher_ci(r, n, a=0.05):
    q = stats.norm.ppf(1 - a / 2) / np.sqrt(n - 3)
    return np.tanh(np.arctanh(r) - q), np.tanh(np.arctanh(r) + q)

def zou_ci(r1, n1, r2, n2, a=0.05):
    """두 독립 상관의 차이에 대한 조우의 구간."""
    l1, u1 = fisher_ci(r1, n1, a)
    l2, u2 = fisher_ci(r2, n2, a)
    d = r1 - r2
    return (d - np.sqrt((r1 - l1)**2 + (u2 - r2)**2),
            d + np.sqrt((u1 - r1)**2 + (r2 - l2)**2))

rng = np.random.default_rng(29002)
B = 20_000
print("피복확률 (명목 95%)")
print(f"{'ρ1':>6s} {'ρ2':>6s} {'n':>6s} {'Zou':>8s} {'z 차이를 tanh':>14s}")
for r1, r2, n in [(0.5, 0.3, 50), (0.5, 0.3, 200),
                  (0.8, 0.3, 50), (0.9, 0.1, 30)]:
    a = b = 0
    true = r1 - r2
    for _ in range(B):
        z = rng.standard_normal((n, 2))
        R1 = np.corrcoef(z[:, 0], r1 * z[:, 0]
                         + np.sqrt(1 - r1**2) * z[:, 1])[0, 1]
        z = rng.standard_normal((n, 2))
        R2 = np.corrcoef(z[:, 0], r2 * z[:, 0]
                         + np.sqrt(1 - r2**2) * z[:, 1])[0, 1]
        lo, hi = zou_ci(R1, n, R2, n)
        a += lo <= true <= hi
        se = np.sqrt(2 / (n - 3))
        d = np.arctanh(R1) - np.arctanh(R2)
        b += np.tanh(d - 1.96 * se) <= true <= np.tanh(d + 1.96 * se)
    print(f"{r1:6.2f} {r2:6.2f} {n:6d} {a / B:8.4f} {b / B:14.4f}")
피복확률 (명목 95%)
    ρ1     ρ2      n      Zou     z 차이를 tanh
  0.50   0.30     50   0.9509         0.9465
  0.50   0.30    200   0.9486         0.9317
  0.80   0.30     50   0.9478         0.7733
  0.90   0.10     30   0.9490         0.8158
조우의 구간이 네 경우 모두 0.948~0.951이다.
순진한 방법은 두 상관이 멀어질수록 무너진다.
| \(\rho_1\) | \(\rho_2\) | Zou | 순진한 방법 |
|---|---|---|---|
| 0.5 | 0.3 | 0.951 | 0.947 |
| 0.8 | 0.3 | 0.948 | 0.773 |
| 0.9 | 0.1 | 0.949 | 0.816 |
\(\rho_1=0.8\), \(\rho_2=0.3\)에서 피복이 0.773으로 떨어진다. 명목 95% 구간이 실제로는 77%다.
왜 그런가. \(\tanh\)의 기울기가 \(r\)에 따라 크게 다르다.
| \(r\) | 기울기 |
|---|---|
| 0.1 | 0.99 |
| 0.5 | 0.75 |
| 0.8 | 0.36 |
| 0.9 | 0.19 |
\(r=0.8\) 근처에서는 \(z\) 1단위가 \(r\) 0.36단위이고, \(r=0.1\)에서는 0.99단위다. \(z\) 차이의 구간을 통째로 되돌리면 두 척도가 섞인다.
조우의 방법은 각각을 자기 척도에서 변환한 뒤 결합하므로 이 문제가 없다.
\(n=200\)에서 순진한 방법이 더 나빠지는 것(0.947 → 0.932)도 주목할 만하다. 표본을 늘려도 고쳐지지 않는다. 근사 오류가 아니라 구조적 오류이기 때문이다.
보고 형식.
남성(n=180)과 여성(n=210)에서 스트레스와 수면의 상관

  남성  r = 0.52  [0.40, 0.62]
  여성  r = 0.31  [0.19, 0.43]

  차이  Δr = 0.21,  95% CI [0.04, 0.37]   (조우의 방법)
  피셔 z 검정: z = 2.36, p = 0.018

구간이 0 을 포함하지 않으나 상한이 0.37 로 넓어,
차이의 크기는 정밀하게 추정되지 않았다.
차이의 구간이 넓은 것이 정상이다. 두 추정의 불확실성이 합쳐지기 때문이다.
연습문제 8. 셋 이상의 상관을 한꺼번에 비교하려면 어떻게 하는가?
풀이
동질성 검정. \(k\)개의 독립 표본에서 \(H_0:\rho_1=\cdots=\rho_k\)를 검정한다.
import warnings
warnings.filterwarnings("ignore")

import numpy as np
from scipy import stats

def homogeneity(rs, ns):
    """k 개 독립 상관의 동질성 검정."""
    z = np.arctanh(np.asarray(rs, float))
    w = np.asarray(ns, float) - 3
    zbar = (w * z).sum() / w.sum()
    Q = (w * (z - zbar)**2).sum()
    return Q, stats.chi2.sf(Q, len(rs) - 1), np.tanh(zbar)

print("예: 네 지역의 상관")
rs = [0.55, 0.48, 0.62, 0.30]
ns = [80, 95, 70, 110]
Q, p, pooled = homogeneity(rs, ns)
print(f"  r = {rs},  n = {ns}")
print(f"  Q = {Q:.4f}, df = {len(rs) - 1}, p = {p:.4f}")
print(f"  통합 추정 r = {pooled:.4f}")

rng = np.random.default_rng(29003)
B = 5_000
print("\n1종 오류와 검정력 (명목 0.05)")
print(f"{'설정':>28s} {'기각률':>8s}")
for lab, rhos in [("모두 0.5 (귀무)", [0.5] * 4),
                  ("하나만 다름 0.5,0.5,0.5,0.3", [0.5, 0.5, 0.5, 0.3]),
                  ("넓게 퍼짐 0.2~0.8", [0.2, 0.4, 0.6, 0.8])]:
    a = 0
    for _ in range(B):
        rs = []
        for rho, n in zip(rhos, [80, 95, 70, 110]):
            z = rng.standard_normal((n, 2))
            rs.append(np.corrcoef(z[:, 0], rho * z[:, 0]
                                  + np.sqrt(1 - rho**2) * z[:, 1])[0, 1])
        a += homogeneity(rs, [80, 95, 70, 110])[1] < 0.05
    print(f"{lab:>28s} {a / B:8.4f}")
예: 네 지역의 상관
  r = [0.55, 0.48, 0.62, 0.3],  n = [80, 95, 70, 110]
  Q = 8.2997, df = 3, p = 0.0402
  통합 추정 r = 0.4756

1종 오류와 검정력 (명목 0.05)
                          설정      기각률
                 모두 0.5 (귀무)   0.0542
      하나만 다름 0.5,0.5,0.5,0.3   0.3810
               넓게 퍼짐 0.2~0.8   1.0000
1종 오류가 0.054로 명목 수준에 가깝다.
| 설정 | 기각률 |
|---|---|
| 모두 같음 | 0.054 ✓ |
| 하나만 0.3 | 0.381 |
| 0.2~0.8로 퍼짐 | 1.000 |
하나만 다른 경우 검정력이 0.38뿐이다. 표본 총 355명인데도 그렇다. 상관의 차이를 검출하는 일은 원래 어렵다.
예시 자료는 \(p=0.040\)으로 겨우 유의하다. \(r\)이 0.30에서 0.62까지 퍼져 있는데도 경계에 있다.
이 검정의 쓰임 셋.
| 상황 | 용도 |
|---|---|
| 메타분석 | 연구 간 이질성 검정(\(Q\) 통계량) |
| 다집단 비교 | 성별·지역·연령대 |
| 통합 추정 | 동질적이면 \(\bar z\)를 역변환 |
메타분석의 \(Q\)가 정확히 이 통계량이다. 이질성이 유의하면 고정효과 대신 확률효과 모형을 쓴다.
주의 셋.
- \(Q\)는 검정력이 낮다. 유의하지 않다고 동질적이라 단정하면 안 된다.
- \(I^2=\max(0,(Q-\text{df})/Q)\)를 함께 본다. 이질성의 크기를 나타낸다.
- 종속 상관에는 쓸 수 없다. 같은 표본의 여러 상관에는 스타이거의 다변량 방법이 필요하다.
예시 자료의 \(I^2\). \(Q=8.300\), df=3이므로
분산의 64%가 지역 간 차이라는 뜻으로, 상당한 이질성을 시사한다. 통합 추정 \(r=0.476\) 하나로 요약하면 정보를 잃는다.
연습문제 9. 두 집단의 관계를 비교할 때 상관이 아니라 회귀계수를 비교해야 하는 경우는 언제인가?
풀이
핵심 — 상관은 \(\sigma_X\)에 의존한다. 두 집단의 \(\sigma_X\)가 다르면 같은 기울기여도 상관이 다르다.
import warnings
warnings.filterwarnings("ignore")

import numpy as np
from scipy import stats

rng = np.random.default_rng(29004)
n = 100_000
print("두 집단: 기울기는 같고 x 의 퍼짐만 다르다")
print(f"{'집단':>8s} {'SD(x)':>8s} {'기울기':>8s} {'SD(잔차)':>9s} {'r':>8s}")
for lab, sx in [("A", 1.0), ("B", 3.0)]:
    x = rng.normal(0, sx, n)
    y = 2.0 * x + rng.normal(0, 4, n)
    print(f"{lab:>8s} {sx:8.1f} {np.polyfit(x, y, 1)[0]:8.4f} "
          f"{4.0:9.1f} {np.corrcoef(x, y)[0, 1]:8.4f}")

print("\n두 집단: 상관은 같고 기울기만 다르다")
print(f"{'집단':>8s} {'SD(x)':>8s} {'기울기':>8s} {'SD(잔차)':>9s} {'r':>8s}")
for lab, beta, se in [("A", 1.0, 1.333), ("B", 4.0, 5.333)]:
    x = rng.normal(0, 1, n)
    y = beta * x + rng.normal(0, se, n)
    print(f"{lab:>8s} {1.0:8.1f} {np.polyfit(x, y, 1)[0]:8.4f} "
          f"{se:9.3f} {np.corrcoef(x, y)[0, 1]:8.4f}")
두 집단: 기울기는 같고 x 의 퍼짐만 다르다
      집단    SD(x)      기울기    SD(잔차)        r
       A      1.0   2.0022       4.0   0.4473
       B      3.0   1.9966       4.0   0.8312

두 집단: 상관은 같고 기울기만 다르다
      집단    SD(x)      기울기    SD(잔차)        r
       A      1.0   1.0067     1.333   0.6028
       B      1.0   3.9775     5.333   0.5995
위 표에서 기울기는 2.00으로 같은데 \(r\)이 0.447과 0.831이다.
아래 표에서 \(r\)은 0.60으로 같은데 기울기가 1.01과 3.98이다.
| 비교 | 결론 |
|---|---|
| \(r\)로 비교 | "B에서 관계가 2배 강하다" |
| 기울기로 비교 | "두 집단의 관계가 같다" |
어느 쪽이 옳은가는 질문이 정한다.
| 질문 | 비교할 것 |
|---|---|
| "\(x\) 1단위의 효과가 집단마다 다른가?" | 기울기 |
| "\(x\)로 \(y\)를 얼마나 잘 예측하는가?" | \(r\) |
| "설명된 분산 비율이 다른가?" | \(r^2\) |
첫 번째가 대부분의 과학적 질문이다. 효과의 크기를 묻는다면 기울기를 비교해야 한다.
기울기 비교의 방법 — 상호작용 항.
y ~ x + 집단 + x:집단

x:집단 계수의 유의성  =  두 기울기가 다른가
이것이 표준 방법이고, 상관 비교보다 해석이 명확하다.
\(\sigma_X\)가 다른 전형적인 상황 넷.
| 상황 | \(\sigma_X\)의 차이 |
|---|---|
| 선발된 집단(영재, 환자군) | 좁다 |
| 임상 표본 대 일반 인구 | 다르다 |
| 연령대별 하위집단 | 다르다 |
| 나라별·시대별 비교 | 크게 다르다 |
"영재 집단에서는 IQ와 성취의 상관이 낮다"는 관찰이 대표적이다. 범위 제한으로 \(\sigma_X\)가 좁아져 \(r\)이 줄었을 뿐, 기울기는 같을 수 있다.
점검 절차 넷.
- 두 집단의 \(\sigma_X\)와 \(\sigma_Y\)를 먼저 비교한다.
- 크게 다르면 \(r\) 비교를 보고하지 않는다.
- 상호작용 항으로 기울기를 비교한다.
- 잔차 분산이 다르면 이분산에 강건한 표준오차를 쓴다.
첫 번째만 해도 대부분의 오해를 막는다. 표준편차 두 줄을 표에 넣는 것으로 충분하다.
연습문제 10. 상관 비교의 방법 선택표를 정리하라.
풀이
결정 흐름.
두 상관을 비교하려 한다
    │
    ├─ 같은 것을 비교하는 게 맞는가?
    │     └─ σ_x 가 집단마다 크게 다르면 → 기울기를 비교한다
    │
    ├─ 서로 다른 표본인가?
    │     └─ 예 → 피셔 z 검정 + 조우의 차이 구간
    │
    └─ 같은 표본인가?
          ├─ 공통 변수가 있다 (r12 vs r13) → 윌리엄스 t
          └─ 공통 변수가 없다 (r12 vs r34) → 스타이거 z*
핵심 수치 여섯.
| 사실 | 값 |
|---|---|
| 종속 상관에 독립 검정을 쓰면(\(r_{23}=0.9\)) | 오류율 0.000 |
| 같은 경우 \(r_{23}=0\) | 오류율 0.067 |
| 윌리엄스 \(t\)의 오류율 | 0.046~0.051 ✓ |
| \(\rho_1=0.5\) vs \(\rho_2=0.3\) 검출에 필요한 군당 \(n\) | 277 |
| \(\rho_1=0.5\) vs \(\rho_2=0.4\) | 998 |
| \(\rho_1=0.8\) vs \(0.3\)에서 순진한 차이 구간의 피복 | 0.781 |
공식 모음.
| 검정 | 통계량 |
|---|---|
| 독립 표본 | \(z=\dfrac{\zeta_1-\zeta_2}{\sqrt{1/(n_1-3)+1/(n_2-3)}}\) |
| \(k\)개 동질성 | \(Q=\sum(n_i-3)(z_i-\bar z)^2\sim\chi^2_{k-1}\) |
| 필요 표본 | \(n=\dfrac{2(z_{\alpha/2}+z_\beta)^2}{(\zeta_1-\zeta_2)^2}+3\) |
| 차이 구간 | 조우의 방법(각 구간을 먼저) |
흔한 실수 다섯.
| 실수 | 대가 |
|---|---|
| 같은 표본에 독립 검정 | 오류율 0.000~0.067 |
| \(z\) 차이 구간을 \(\tanh\)로 되돌림 | 피복 0.78 |
| 유의하지 않다고 "같다"고 결론 | 검정력이 대개 0.5 미만 |
| \(\sigma_X\)가 다른 집단의 \(r\) 비교 | 범위 제한의 산물 |
| 여러 쌍을 비교하고 보정 안 함 | 다중검정 |
보고 체크리스트 여섯.
□ 두 표본이 독립인가 종속인가 (검정이 달라진다)
□ 각 상관의 n 과 신뢰구간
□ 차이의 신뢰구간 (조우의 방법)
□ 각 집단의 SD(x), SD(y)  ← 범위 차이를 독자가 판단할 수 있게
□ 검정력 또는 검출 가능한 최소 차이
□ 여러 비교를 했다면 보정 방법
네 번째가 가장 적게 보고되고 가장 자주 오해를 낳는다.
한 문장. 두 상관의 비교는 표본이 독립인지, \(x\)의 퍼짐이 같은지, 차이를 검출할 검정력이 있는지라는 세 질문을 먼저 통과해야 하며, 셋 중 하나라도 어긋나면 검정 결과가 아니라 질문 자체를 바꿔야 한다.
정리하며
두 상관의 비교는 표본이 독립인지 겹치는지에 따라 다른 방법을 요구한다. 독립 표본에서는 Fisher의 z 변환이 각 상관을 정규분포 변수로 바꾸고 간단한 \(Z\)-검정으로 변환값을 비교한다. 변수를 공유하는 종속 표본에서는 Steiger 검정(Williams 수정)이 두 계수 사이의 상관을 반영한다. 두 경우 모두 분산을 안정화하여 표준적인 정규 이론 추론을 가능하게 하는 Fisher z 변환이 핵심 도구이다.