다중공선성
개요
들어가는 이야기 — 공선성이 보이면 빼는 처방이 치르는 값
공선성이 보이면 변수를 빼는 것이 흔한 처방이다. 그 처방이 무엇을 치르는지 먼저 보아야 한다. 주택 자료에서 VIF(variance inflation factor) 가 큰 두 변수 — 위도와 경도 — 를 빼면 남은 어떤 계수가 \(0.015013\) 에서 \(-0.038326\) 으로 부호가 뒤집히고 \(R^2\) 이 \(0.5860\) 에서 \(0.4808\) 로 떨어진다. 공선성 지표는 깨끗해지는데 모형이 말하는 내용이 달라진 것이다.
탐지하는 쪽에도 함정이 있다. 쌍별 상관을 훑는 것이 가장 쉬운 진단인데, 서로 독립인 설명변수(explanatory variable) \(m\) 개에 그 합을 하나 더 얹으면 각 변수와 합의 공분산이 \(1\), 합의 분산이 \(m\) 이므로 쌍별 상관이 모두 \(1/\sqrt m\) 이 된다. \(m = 50\) 이면 \(0.141\) 이다. 상관행렬의 모든 칸이 작은데 설계행렬은 특이하다.
실제로 그렇게 만든 자료에서 VIF 최댓값이 \(98068.6\), 중앙값이 \(9979.2\) 로 나온다. VIF 는 한 변수를 나머지 전부에 회귀해 \(1/(1-R^2)\) 로 재므로, 한 변수가 여럿의 합으로 적히는 사정을 잡아낸다. 쌍만 보는 진단은 그것을 못 본다. \(R^2\) 이 \(0.99999\) 이면 VIF 가 십만이니, 저 최댓값은 한 변수가 나머지로 거의 완전히 적힌다는 뜻이다.
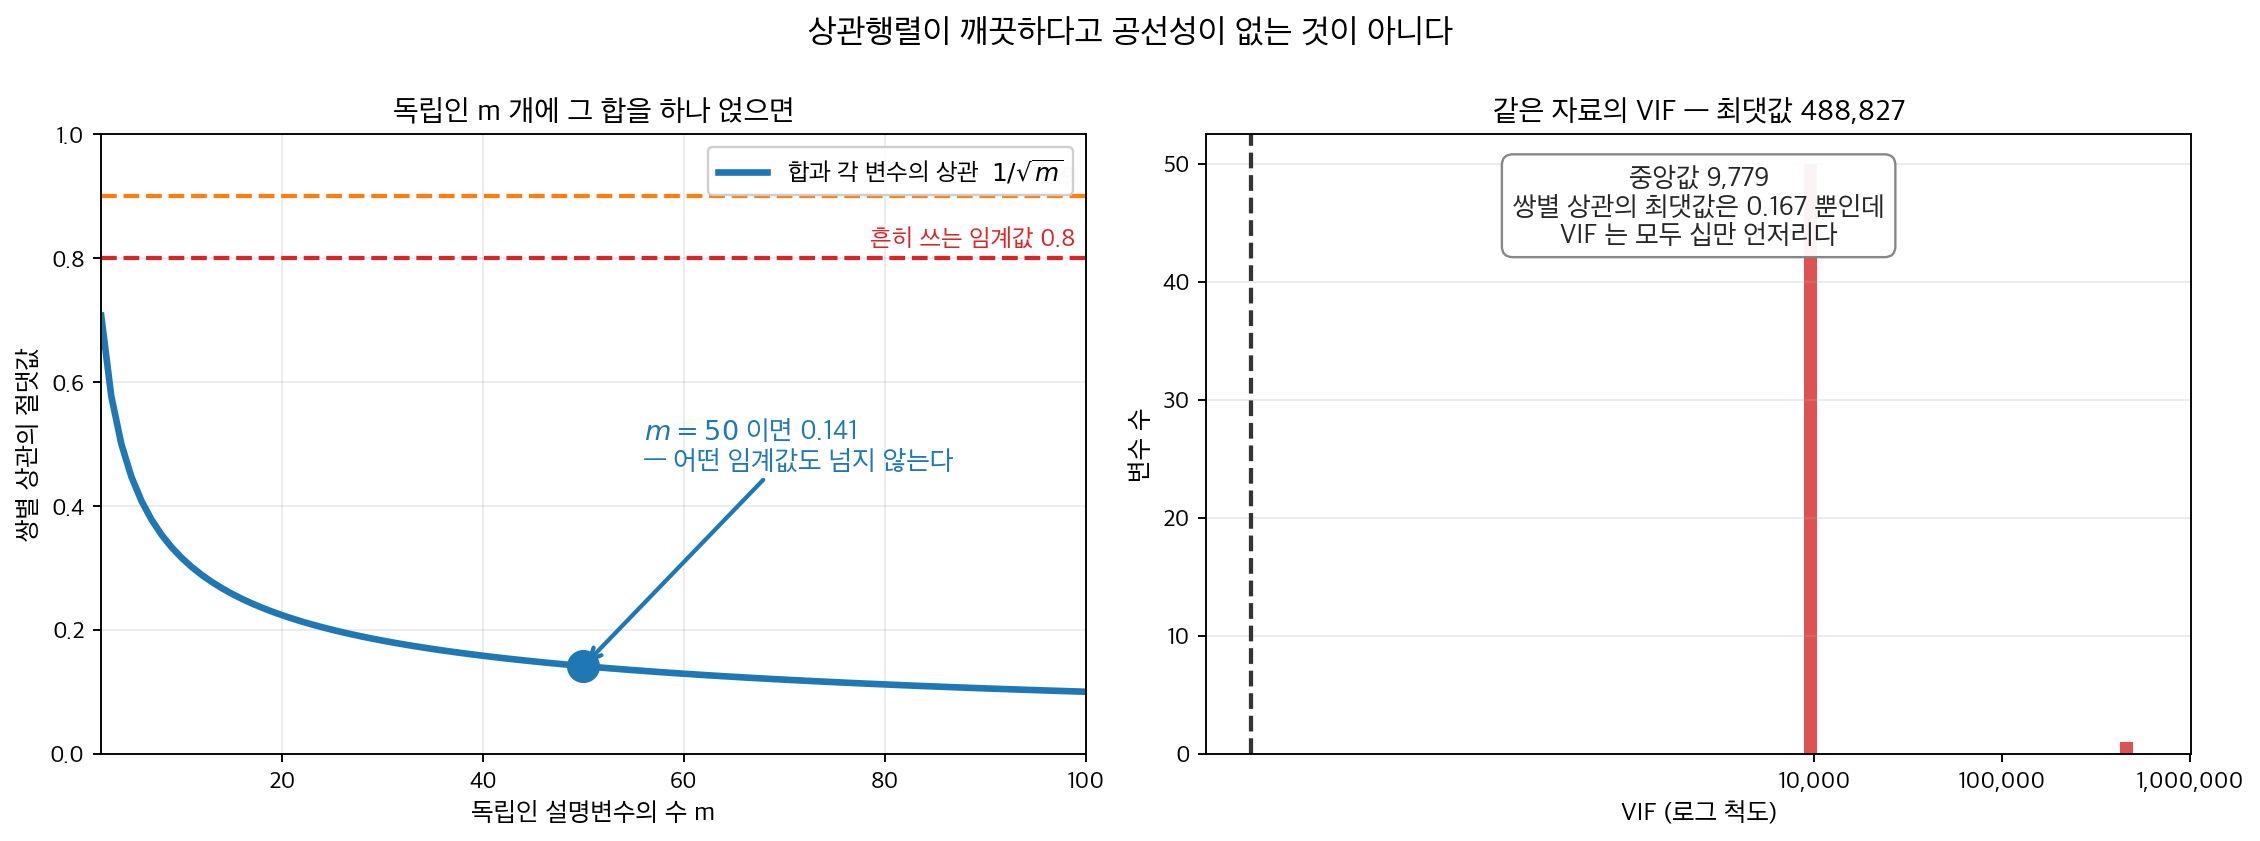
왼쪽. 독립인 설명변수 \(m\) 개에 그 합을 하나 얹으면 각 변수와 합의 상관이 \(1/\sqrt{m}\) 이다. \(m = 50\) 이면 \(0.141\) 이라 흔히 쓰는 임계값 \(0.8\) 이나 \(0.9\) 를 전혀 넘지 않는다. 상관행렬의 모든 칸이 작은데 설계행렬은 특이하다. 오른쪽. 같은 자료의 VIF 는 중앙값이 만 단위, 최댓값이 수십만이다. VIF 는 한 변수를 나머지 전부에 회귀해 \(1/(1-R^2)\) 로 재므로 한 변수가 여럿의 합으로 적히는 사정을 잡아낸다. 합을 정확히 넣으면 수학적으로 VIF 가 무한이므로, 여기서는 아주 작은 잡음을 섞어 유한하게 만들었다.
그러니 이 쪽에서 읽을 것은 두 방향이다. 상관행렬이 깨끗하다고 공선성이 없는 것이 아니고, VIF 가 크다고 변수를 빼면 되는 것도 아니다. 공선성은 무엇으로 탐지하고, 탐지한 다음에는 무엇을 치르고 무엇을 얻는가. 아래 상자가 이 문제를 처음 아프게 만났던 자리 — 같은 자료에 같은 회귀를 돌리고도 계산기마다 다른 답이 나오던 시절 — 을 따라간다.
확인한 곳 — 이 쪽 「계산기가 서로 다른 답을 내놓던 시절」 상자와 그 출처 줄
다중공선성(multicollinearity)은 회귀모형의 설명변수 둘 이상이 강하게 상관되어 있을 때 나타난다. 이는 추정과 추론에 다음 문제를 일으킨다.
- 부풀려진 표준오차: 계수가 불안정해지고 신뢰구간이 넓어진다
- 믿을 수 없는 계수: 자료가 조금만 달라져도 추정된 계수가 크게 바뀐다
- 떨어진 검정력: 설명변수의 개별 유의성을 판정하기 어려워진다
- 떨어진 해석 가능성: 각 변수의 고유한 기여를 신뢰성 있게 평가할 수 없다
이런 문제에도 불구하고 다중공선성은 계수 추정을 편향시키지 않으며 비슷한 자료에 대한 정확한 예측을 막지도 않는다. 해석이 어려워지더라도 모형은 예측에 여전히 쓸모가 있다.
1. 다중공선성 탐지
방법 1: 상관행렬
가장 간단한 진단은 설명변수 사이의 쌍별 상관을 살피는 것이다.
보기 1. 상관행렬로 훑어보기
(1) 상관행렬은 쌍별 관계만 본다. \(z_1, \ldots, z_m\)이 서로 독립이고 분산이 같을 때 \(z_{m+1} = z_1 + \cdots + z_m\)으로 두면
임을 보이시오. 그러므로 \(m\)이 크면 쌍별 상관이 모두 작은데도 완전공선인 자료를 만들 수 있다.
(2) 주택 자료의 상관행렬을 그려 큰 쌍을 찾고, (1)의 자료를 만들어 상관행렬이 무엇을 놓치는지 보이시오.
풀이
(1) 해석적으로. \(\operatorname{Var}(z_j) = \sigma^2\)이라 하자. 독립이므로 \(\operatorname{Var}(z_{m+1}) = m\sigma^2\)이고, 공분산은 \(z_j\) 자신과의 항만 남는다.
따라서
이다. \(m = 10\)이면 \(0.316\), \(m = 50\)이면 \(0.141\)로 \(m\)을 키우면 얼마든지 작아진다. 그런데 \(z_{m+1}\)은 앞의 변수들로 완전히 설명되므로 \(R_{m+1}^2 = 1\), 곧 \(\text{VIF}_{m+1} = \infty\)다.
상관행렬을 아무리 들여다봐도 이 공선성은 보이지 않는다. 모든 칸이 \(0.32\) 이하인데 설계행렬은 특이하다. 이것이 "공선성"과 "다중공선성"을 가르는 이유이고, VIF가 필요한 이유다.
(2) 수치적으로. 먼저 주택 자료다.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# 캘리포니아 주택 자료. 위도와 경도처럼 서로 얽힌 변수가 들어 있다.
from sklearn.datasets import fetch_california_housing

housing = fetch_california_housing()
df = pd.DataFrame(housing.data, columns=housing.feature_names)

# 상관행렬은 다중공선성을 훑어보는 첫걸음이다. 다만 쌍끼리의 상관만
# 보므로, 세 변수 이상이 얽힌 경우는 놓친다. 그래서 VIF 가 필요하다.
corr_matrix = df.corr()

# 열지도로 한눈에 본다.
plt.figure(figsize=(10, 8))
plt.imshow(corr_matrix, cmap='coolwarm', vmin=-1, vmax=1)
plt.colorbar(label='Correlation')
plt.xticks(range(len(housing.feature_names)), housing.feature_names, rotation=45)
plt.yticks(range(len(housing.feature_names)), housing.feature_names)
plt.title('Correlation Matrix: Housing Features')
plt.tight_layout()
plt.show()

# 눈으로 놓치기 쉬우므로 0.7 을 넘는 쌍만 따로 찍는다.
print("High Correlations (|r| > 0.7):")
for i in range(len(corr_matrix.columns)):
    for j in range(i+1, len(corr_matrix.columns)):
        if abs(corr_matrix.iloc[i, j]) > 0.7:
            print(f"  {corr_matrix.columns[i]} <-> {corr_matrix.columns[j]}: {corr_matrix.iloc[i, j]:.3f}")
출력:
High Correlations (|r| > 0.7):
  AveRooms <-> AveBedrms: 0.848
  Latitude <-> Longitude: -0.925
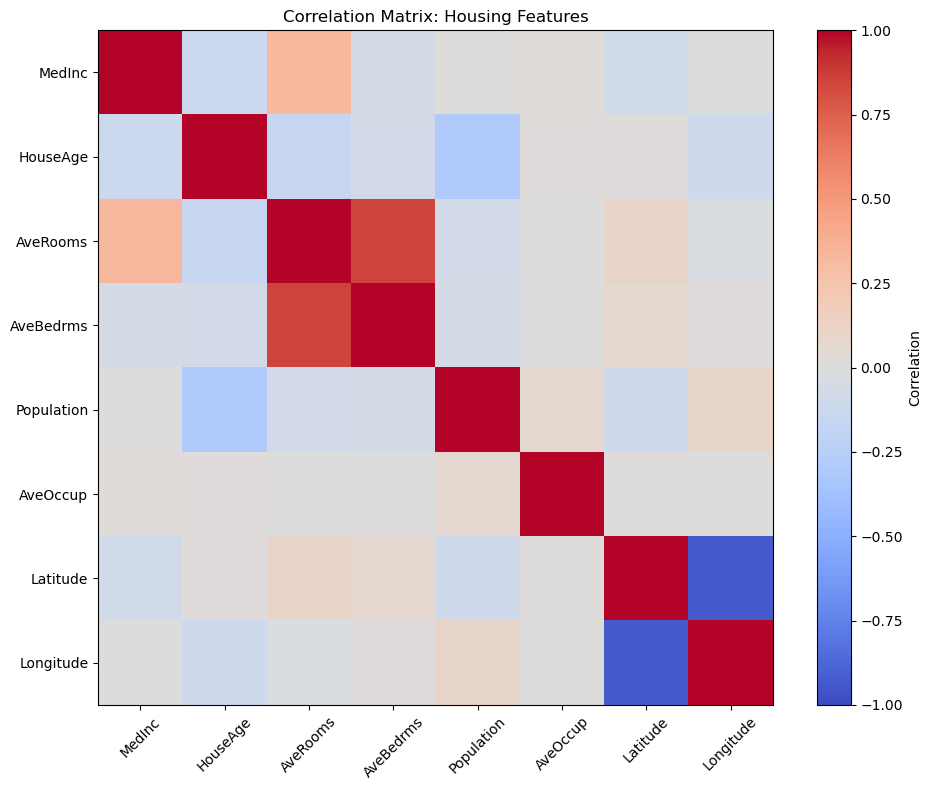
AveRooms와 AveBedrms가 \(0.848\), Latitude와 Longitude가 \(-0.925\)로 강하게 상관되어 있다. 열지도에서도 그 네 칸만 진하다. 이 자료에서는 상관행렬이 제 몫을 한 셈이다.
이제 (1)의 자료를 만들어 상관행렬이 무엇을 놓치는지 본다.
import numpy as np
from statsmodels.stats.outliers_influence import variance_inflation_factor

# 쌍별 상관은 모두 1/sqrt(m) 인데 완전공선인 자료를 만든다.
rng = np.random.default_rng(0)
m, N = 10, 2000
Z = rng.normal(size=(N, m))
Z = np.column_stack([Z, Z.sum(axis=1) + rng.normal(0, 0.01, N)])   # 마지막 열 = 앞의 합

C = np.corrcoef(Z, rowvar=False)
off = C[~np.eye(m + 1, dtype=bool)]
print(f"변수 {m + 1}개, 쌍별 상관의 최대 절대값 = {np.abs(off).max():.4f}")
print(f"이론값 1/sqrt(m) = {1 / np.sqrt(m):.4f}")
print(f"0.7 을 넘는 쌍의 개수 = {(np.abs(off) > 0.7).sum()}")

vifs = [variance_inflation_factor(Z, j) for j in range(m + 1)]
print(f"\nVIF 최대 = {max(vifs):.1f}  (마지막 열)")
print(f"VIF 중앙값 = {np.median(vifs):.1f}")
출력:
변수 11개, 쌍별 상관의 최대 절대값 = 0.3569
이론값 1/sqrt(m) = 0.3162
0.7 을 넘는 쌍의 개수 = 0

VIF 최대 = 98068.6  (마지막 열)
VIF 중앙값 = 9979.2
상관행렬이 완전히 눈이 멀었다. 쌍별 상관의 최대 절대값이 \(0.3569\)로 이론값 \(1/\sqrt{10} = 0.3162\) 근처이고(\(N = 2000\)의 표집 변동 때문에 조금 크다), \(\lvert r \rvert > 0.7\)인 쌍은 하나도 없다. 위 코드의 경보 임계값 \(0.7\)을 쓰면 아무것도 걸리지 않는다. 그런데 VIF는 최대 \(98{,}069\), 중앙값조차 \(9{,}979\)다.
VIF가 무한이 아니라 \(10^4\) 언저리인 것은 마지막 열에 표준편차 \(0.01\)의 잡음을 섞었기 때문이다. \(R_j^2 = 1 - 10^{-4}\) 정도이면 \(\text{VIF} \approx 10^4\)가 되고, 계수의 표준오차는 \(\sqrt{10^4} = 100\)배로 부푼다. 잡음을 아예 빼면 설계행렬이 특이해져 회귀 자체가 불가능해진다.
중앙값 VIF도 \(10^4\)라는 데 주목하라. 공선성은 "마지막 변수의 문제"가 아니다. \(11\)개 변수가 모두 한 덩어리의 관계에 묶여 있고, 어느 하나를 집어 나머지로 회귀시켜도 완벽히 맞는다. 변수 하나를 빼야 한다면 어느 것을 빼도 좋다는 뜻이기도 하다.
한계: 쌍별 상관은 두 변수 사이의 관계만 포착한다. 변수 셋 이상이 얽혀 있으면 쌍별 상관이 크지 않아도 다중공선성이 존재할 수 있다. 이런 이유로 두 변수 사이의 단순 상관을 뜻하는 공선성과 여러 변수가 얽힌 다중공선성을 구분한다.
방법 2: 분산팽창인자(VIF)
분산팽창인자(VIF)는 다른 설명변수들과의 다중공선성 때문에 어떤 회귀계수(regression coefficient)의 분산이 얼마나 부풀려졌는지를 수량화한다.
수학적 정의
설명변수 \(X_j\)의 VIF는
여기서 \(R_j^2\)은 \(X_j\)를 나머지 모든 설명변수에 회귀시켰을 때의 \(R^2\)이다.
VIF 를 이렇게 읽는다.
- VIF = 1: 다른 설명변수와 상관이 없다
- VIF < 5: 일반적으로 받아들일 만하다(경험 법칙)
- VIF > 5: 다중공선성이 우려되는 수준이다
- VIF > 10: 심각한 다중공선성으로 대개 조치가 필요하다
함수 하나로 구하기
보기 2. VIF 계산. 왜 이 수를 "분산팽창인자"라 부르는지 먼저 밝힌다.
(1) 다중회귀(multiple regression)에서
임을 보이시오. 그러므로 \(\text{VIF}_j\)는 "\(X_j\)가 다른 변수들과 무관했다면 가졌을 분산"의 몇 배인가를 재는 수다.
(2) VIF를 계산하고, (1)의 식으로 표준오차를 재구성해 statsmodels가 보고한 값과 맞추시오.
풀이
(1) 해석적으로. Frisch–Waugh–Lovell 정리를 쓴다 — 다중회귀의 한 계수는 그 변수에서 나머지 변수들의 몫을 걷어낸 잔차로 구한 단순회귀 계수와 같다는 정리로, 0장 직교사영행렬에서 보였다. \(\mathbf X_{-j}\)를 \(X_j\)를 뺀 나머지 열들(상수항 포함)이라 하고, 그 위로의 사영을 빼는 행렬을 \(M_{-j}\)라 하자. 정리에 따르면
이다. 이것은 \(\mathbf y\)의 선형결합이고 계수벡터가 \(M_{-j}\mathbf x_j / \lVert M_{-j}\mathbf x_j\rVert^2\)이므로, 등분산이면
이다. 남은 것은 분모를 읽는 일이다. \(\lVert M_{-j}\mathbf x_j \rVert^2\)은 \(X_j\)를 나머지 변수들에 회귀시켰을 때의 잔차제곱합이고, 그 회귀의 결정계수(coefficient of determination)가 \(R_j^2\)이므로
이다. 넣으면 구하는 식이 된다.
이 한 줄이 공선성 이야기 전부다. \(R_j^2 \to 1\)이면 분모가 0으로 가고 분산이 터진다. \(R_j^2 = 0.9\)면 \(\text{VIF} = 10\)이고 표준오차가 \(\sqrt{10} = 3.16\)배, \(R_j^2 = 0.99\)면 \(\text{VIF} = 100\)이고 \(10\)배다.
동시에 공선성이 무엇을 해치지 않는지도 보인다. 식에 \(\beta_j\)가 들어 있지 않으므로 추정값은 여전히 불편이고, \(\hat{\mathbf y} = \mathbf X\hat{\boldsymbol\beta}\)의 분산을 관측값마다 더한 합도 \(\sigma^2 \operatorname{tr}(H) = p\sigma^2\)로(\(p\)는 절편(intercept)을 포함한 모수의 개수다) 공선성과 무관하다. 공선성은 계수를 하나씩 떼어 읽으려 할 때만 아프다.
(2) 수치적으로.
import statsmodels.api as sm
from statsmodels.stats.outliers_influence import variance_inflation_factor

# 위도와 경도를 함께 넣으면 VIF 가 치솟는다. 캘리포니아가 북서에서 남동으로
# 비스듬히 뻗어 있어 두 좌표가 강하게 얽히기 때문이다.
X = sm.add_constant(df[['MedInc', 'AveRooms', 'AveOccup', 'Latitude', 'Longitude']])

vif_data = pd.DataFrame()
vif_data['Feature'] = X.columns[1:]  # Skip constant
vif_data['VIF'] = [variance_inflation_factor(X.values, i+1) for i in range(X.shape[1]-1)]

print(vif_data)
출력:
     Feature       VIF
0     MedInc  1.269059
1   AveRooms  1.248489
2   AveOccup  1.000990
3   Latitude  8.184505
4  Longitude  7.977739
(1)의 식으로 표준오차를 직접 만들어 본다.
import numpy as np
import statsmodels.api as sm

features = ['MedInc', 'AveRooms', 'AveOccup', 'Latitude', 'Longitude']
y = housing.target
full = sm.OLS(y, sm.add_constant(df[features])).fit()
s2 = full.mse_resid

print(f"{'변수':>10}{'R_j^2':>10}{'VIF':>9}{'공식 SE':>13}{'보고 SE':>13}")
for f in features:
    others = [g for g in features if g != f]
    r2 = sm.OLS(df[f], sm.add_constant(df[others])).fit().rsquared
    Sjj = ((df[f] - df[f].mean()) ** 2).sum()
    se_formula = np.sqrt(s2 / (Sjj * (1 - r2)))
    print(f"{f:>10}{r2:>10.6f}{1 / (1 - r2):>9.4f}"
          f"{se_formula:>13.8f}{full.bse[f]:>13.8f}")
출력:
        변수     R_j^2      VIF        공식 SE        보고 SE
    MedInc  0.212015   1.2691   0.00306483   0.00306483
  AveRooms  0.199032   1.2485   0.00233421   0.00233421
  AveOccup  0.000989   1.0010   0.00049790   0.00049790
  Latitude  0.877818   8.1845   0.00692281   0.00692281
 Longitude  0.874651   7.9777   0.00728654   0.00728654
유도한 식이 다섯 변수 모두에서 소수점 여덟째 자리까지 맞는다. \(\sigma^2/(S_{jj}(1-R_j^2))\)로 만든 표준오차와 statsmodels가 보고한 값이 같다.
Latitude와 Longitude의 VIF가 \(8\)을 넘는다. 캘리포니아가 북서에서 남동으로 비스듬히 뻗은 주여서 두 좌표가 \(r = -0.925\)로 얽히기 때문이다. 표준오차가 각각 \(\sqrt{8.18} = 2.86\)배, \(\sqrt{7.98} = 2.82\)배로 부풀었다는 뜻이다. 나머지 세 변수는 \(1.3\) 이하라 문제가 없고, 특히 AveOccup은 \(1.0010\)으로 다른 변수들과 사실상 완전히 무관하다.
VIF를 직접 계산하기
VIF가 어떻게 계산되는지 이해하면 더 깊은 통찰을 얻을 수 있다.
보기 3. VIF를 정의대로 직접 구하기
(1) \(\text{VIF}_j \ge 1\)이고 등호는 \(R_j^2 = 0\)일 때뿐임을 보이시오. 또 설명변수가 둘뿐이면 두 VIF가 같고
(\(r\)은 두 변수의 상관)임을 보이시오.
(2) VIF를 정의대로 계산해 variance_inflation_factor와 맞추고, Latitude의 VIF \(8.18\)이 두 변수 공식이 주는 값보다 큰 까닭을 밝히시오.
풀이
(1) 해석적으로. \(R_j^2\)은 결정계수이므로 상수항이 있는 회귀에서 \(0 \le R_j^2 < 1\)이다(\(R_j^2 = 1\)이면 설계행렬이 특이해 회귀가 아예 정의되지 않는다). \(u \mapsto 1/(1-u)\)가 \([0,1)\)에서 증가하므로
이고 등호는 \(R_j^2 = 0\), 곧 \(X_j\)가 나머지 변수들의 어떤 선형결합으로도 설명되지 않을 때뿐이다. 보기 2의 식으로 읽으면 "분산이 부풀 수는 있어도 줄 수는 없다"는 말이다. 다른 변수를 모형에 넣어서 \(\hat\beta_j\)가 더 정밀해지는 일은 없다.
설명변수가 \(X_1, X_2\) 둘뿐이면 \(X_1\)을 \(X_2\)에 회귀시키는 것이 단순회귀(simple linear regression)이므로 \(R_1^2 = r^2\)이고, \(X_2\)를 \(X_1\)에 회귀시켜도 같은 \(r^2\)이다. 상관은 대칭이기 때문이다. 따라서
이다. 이 경우에 한해 상관행렬만 보아도 VIF를 알 수 있다. 변수가 셋 이상이면 그렇지 않고, 그 차이를 (2)에서 수로 본다.
(2) 수치적으로.
import numpy as np
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.datasets import fetch_california_housing

# 자료 읽기
housing = fetch_california_housing()
df = pd.DataFrame(housing.data, columns=housing.feature_names)

features = ['MedInc', 'AveRooms', 'AveOccup', 'Latitude', 'Longitude']
X = df[features]

# VIF 를 정의대로 직접 구해 본다. 변수 하나를 반응으로 두고 나머지로
# 회귀한 뒤, 그 R^2 에서 1/(1-R^2) 을 계산하는 것이 전부다.
print("Manual VIF Calculation:")
print("=" * 60)

for j, target_feature in enumerate(features):
    # 관심 변수를 나머지 변수들로 회귀한다.
    other_features = [f for f in features if f != target_feature]
    X_j = X[target_feature].values.reshape(-1, 1)
    X_others = X[other_features].values

    # 관심 변수를 나머지 변수들로 회귀한다
    model = LinearRegression()
    model.fit(X_others, X_j.ravel())

    # 그 회귀의 R^2. 1 에 가까울수록 그 변수가 나머지로 거의 설명된다는 뜻이다.
    y_pred_j = model.predict(X_others)
    ss_res = np.sum((X_j.ravel() - y_pred_j) ** 2)
    ss_tot = np.sum((X_j.ravel() - X_j.mean()) ** 2)
    r2_j = 1 - (ss_res / ss_tot)

    # R^2 가 0.9 면 VIF 가 10, 0.99 면 100 이 된다. 계수의 표준오차가
    # 그 제곱근만큼 부풀려진다는 뜻이다.
    vif_j = 1 / (1 - r2_j)

    print(f"{target_feature:12s}:  R² = {r2_j:.4f},  VIF = {vif_j:7.2f}")

print("=" * 60)
출력:
Manual VIF Calculation:
============================================================
MedInc      :  R² = 0.2120,  VIF =    1.27
AveRooms    :  R² = 0.1990,  VIF =    1.25
AveOccup    :  R² = 0.0010,  VIF =    1.00
Latitude    :  R² = 0.8778,  VIF =    8.18
Longitude   :  R² = 0.8747,  VIF =    7.98
============================================================
보기 2의 variance_inflation_factor가 내놓은 값과 소수점 둘째 자리까지 같다. \(\text{VIF}_j = 1/(1-R_j^2)\)이므로 해당 변수를 나머지에 회귀시킨 \(R_j^2\)만 알면 된다. 다섯 값이 모두 \(1\) 이상이라는 (1)의 하한도 지켜진다.
두 변수 공식과의 차이를 보자. Latitude와 Longitude의 상관이 \(r = -0.9247\)이므로 두 변수만 있었다면
이었을 것이다. 그런데 실제 VIF는 \(8.18\)과 \(7.98\)로 더 크다. 모형에 MedInc, AveRooms, AveOccup이 함께 들어 있고, 이 셋이 Latitude를 설명하는 데 조금씩 보태기 때문이다. \(R_{\text{Lat}}^2\)이 \(0.8551\)(\(= r^2\))에서 \(0.8778\)로 올라간 것이 그 몫이며, \(1-R^2\)이 분모라 이 작은 상승이 VIF를 \(19\%\) 키웠다.
\(R^2\)이 1에 가까울수록 작은 변화가 VIF를 크게 흔든다. \(R^2 = 0.99\)에서 \(0.995\)로 가면 VIF가 \(100\)에서 \(200\)으로 두 배가 된다. VIF를 소수 둘째 자리까지 읽고 \(9.8\)과 \(10.2\)를 다르게 대우하는 것이 무의미한 이유다.
이 자료에서 Latitude와 Longitude의 VIF \(8\) 근처는 경험 법칙의 임계값 \(5\)를 넘지만 "심각"의 기준 \(10\)에는 못 미친다. 캘리포니아가 북서–남동으로 길게 뻗은 주라는 지리가 그대로 수에 나타난 것이다. 두 계수의 표준오차가 각각 \(\sqrt{8.18} = 2.86\)배, \(\sqrt{7.98} = 2.82\)배 부풀었고, 나머지 세 변수는 \(1.3\) 이하로 문제가 없다.
2. 다중공선성에 대처하기
방법 1: 중복된 설명변수 제거
두 설명변수가 강하게 상관되어 있으면 하나를 뺀다.
보기 4. 대책 1 — 변수 빼기. Latitude와 Longitude를 빼면 VIF 문제는 사라진다. 그 대신 치르는 값을 재어 보자.
(1) 완전모형의 계수를 \((\hat{\boldsymbol\beta}_K, \hat{\boldsymbol\beta}_D)\)(남길 변수와 뺄 변수), 뺀 변수들을 남긴 변수들에 회귀시킨 계수행렬을 \(\hat\Delta\)라 하자. 축소모형의 계수가
로 정확히 적힘을 보이시오(기댓값이 아니라 표본에서 성립하는 항등식이다).
(2) 변수를 빼고 적합한 뒤 이 항등식을 확인하고, 계수가 얼마나 달라지는지 보시오.
풀이
(1) 해석적으로. 완전모형의 적합은
이다. 한편 \(\mathbf X_D\)를 \(\mathbf X_K\)에 회귀시키면 \(\mathbf X_D = \mathbf X_K \hat\Delta + \mathbf U\)이고 \(\mathbf X_K^\top \mathbf U = \mathbf 0\)이다. 둘째 식을 첫째 식에 넣으면
가 된다. 나머지 \(\mathbf r\)가 \(\mathbf X_K\)와 직교한다. \(\mathbf X_K^\top \mathbf U = \mathbf 0\)이고 \(\mathbf X_K^\top \mathbf e = \mathbf 0\)이기 때문이다. \(\mathbf X_K\)의 열공간 위에서 \(\mathbf y\)를 분해했는데 나머지가 그 공간과 직교한다면, 그것이 바로 축소모형의 최소제곱 적합이다. 분해는 유일하므로
이다.
기댓값을 취하면 교과서의 누락변수 편향 공식 \(E[\hat{\boldsymbol\beta}_{\text{short}}] = \boldsymbol\beta_K + \hat\Delta \boldsymbol\beta_D\)가 되지만, 위 식은 한 표본 안에서 이미 등식이라는 점이 중요하다. 편향의 크기가 두 가지에 달려 있음도 읽힌다. 뺀 변수가 반응을 얼마나 설명하는가(\(\hat{\boldsymbol\beta}_D\))와, 뺀 변수가 남긴 변수들과 얼마나 얽혀 있는가(\(\hat\Delta\))다. 둘 중 하나라도 0이면 편향이 없다. 공선성이 심할수록 \(\hat\Delta\)가 커지므로, 변수를 빼서 가장 큰 이득을 보는 상황이 바로 가장 큰 대가를 치르는 상황이다.
(2) 수치적으로.
# 대책 1: 얽힌 변수를 빼 버린다. 가장 간단하지만, 뺀 변수가 실제로
# 반응을 설명하고 있었다면 남은 계수에 누락변수 편향이 생긴다.
y = housing.target                                     # 주택가격 중앙값
features_reduced = ['MedInc', 'AveRooms', 'AveOccup']  # 위도·경도를 뺀다
X_reduced = sm.add_constant(df[features_reduced])
model_reduced = sm.OLS(y, X_reduced).fit()
항등식을 확인한다.
import numpy as np
import statsmodels.api as sm

features_full = ['MedInc', 'AveRooms', 'AveOccup', 'Latitude', 'Longitude']
dropped = ['Latitude', 'Longitude']
model_full = sm.OLS(y, sm.add_constant(df[features_full])).fit()

# 뺀 변수들을 남긴 변수들에 회귀시킨 계수행렬 Delta
Delta = np.column_stack([
    sm.OLS(df[d], X_reduced).fit().params.values for d in dropped
])
predicted = (model_full.params[['const'] + features_reduced].values
             + Delta @ model_full.params[dropped].values)

print(f"{'':>10}{'완전모형':>12}{'축소모형':>12}{'항등식 예측':>14}")
for k, name in enumerate(['const'] + features_reduced):
    print(f"{name:>10}{model_full.params[name]:>12.6f}"
          f"{model_reduced.params[name]:>12.6f}{predicted[k]:>14.6f}")
print(f"\n최대 오차 = {np.abs(model_reduced.params.values - predicted).max():.2e}")
print(f"\nR^2: 완전 {model_full.rsquared:.4f}  →  축소 {model_reduced.rsquared:.4f}")
출력:
                  완전모형        축소모형        항등식 예측
     const  -42.829801    0.606932      0.606932
    MedInc    0.359016    0.434683      0.434683
  AveRooms    0.015013   -0.038326     -0.038326
  AveOccup   -0.003366   -0.004174     -0.004174

최대 오차 = 1.58e-14

R^2: 완전 0.5860  →  축소 0.4808
항등식이 기계 정밀도까지 맞는다. 최대 오차가 \(1.6 \times 10^{-14}\)다.
치른 값이 작지 않다. AveRooms의 계수가 \(+0.0150\)에서 \(-0.0383\)으로 부호가 뒤집혔다. 완전모형은 "같은 위치·같은 소득이면 방이 많을수록 집값이 조금 비싸다"고 말하는데, 축소모형은 "방이 많을수록 싸다"고 말한다. 방이 많은 동네가 땅값 싼 내륙에 몰려 있어서 생기는 일이며, 위치를 통제하지 않으면 그 효과가 AveRooms에 얹힌다. MedInc의 계수도 \(0.359\)에서 \(0.435\)로 \(21\%\) 커졌다.
\(R^2\)도 \(0.586\)에서 \(0.481\)로 떨어진다. VIF \(8\)을 없애려고 설명력의 \(18\%\)를 버리고 한 계수의 부호를 뒤집은 셈이다. 변수 빼기가 가장 간단한 대책이지만 가장 흔히 잘못 쓰이는 대책이기도 한 이유다. 뺀 변수가 반응과 무관할 때만 안전하다.
방법 2: 상관된 설명변수 결합
상관된 변수들로 합성 지표를 만든다.
보기 5. 대책 2 — 변수 합치기. 위도와 경도를 평균 내 "위치" 지표 하나로 만든다. 상관이 \(r = -0.925\)로 음수라는 데 유의하라.
(1) 두 변수의 표준편차를 \(s_1, s_2\)라 할 때
임을 쓰고, 이 자료에서 두 값을 계산하시오. \(r\)이 \(-1\)에 가까우므로 합은 거의 사라지고 차만 남는다. 그렇다면 합과 차 가운데 어느 쪽을 합성변수로 써야 하는가.
(2) 둘을 모두 만들어 모형에 넣고 \(R^2\)을 견주시오. 예상이 맞는가.
풀이
(1) 해석적으로. 분산의 덧셈 법칙에서 바로 나온다.
이고 제곱근을 취하면 된다. \(s_1 = 2.136\), \(s_2 = 2.004\), \(r = -0.9247\)이므로
이다. 합의 산포가 차의 \(1/5\)다. 두 좌표가 거의 반비례로 움직이므로 더하면 상쇄되고 빼면 증폭되기 때문이다.
여기서 성급한 결론을 내리기 쉽다. "산포가 큰 쪽이 정보가 많으니 차를 쓰자"는 것이다. 그러나 그 결론은 틀릴 수 있다. 합성변수의 쓸모를 정하는 것은 그 변수 자체의 분산이 아니라 반응과의 관계다. 완전모형의 계수가 \(\hat\beta_{\text{Lat}} = -0.498\), \(\hat\beta_{\text{Lon}} = -0.512\)로 거의 같으므로 반응이 실제로 쓰는 조합은
곧 합이다. 그러니 합을 써야 한다. 산포가 작은 방향이 신호를 나르는, 공선성 자료의 전형적인 모습이다.
(2) 수치적으로.
# 대책 2: 얽힌 변수를 하나로 합친다. 여기서는 위도와 경도를 평균 내
# "위치" 지표 하나로 만들었다. 뜻이 통하는 합성이어야 쓸모가 있다.
df['Location'] = (df['Latitude'] + df['Longitude']) / 2
합과 차를 모두 만들어 견준다.
import numpy as np
import statsmodels.api as sm

lat, lon = df['Latitude'], df['Longitude']
r = lat.corr(lon)
print(f"sd(Latitude) = {lat.std():.4f},  sd(Longitude) = {lon.std():.4f},  r = {r:.4f}")
print(f"sd(합/2) 공식 = {np.sqrt((lat.var() + lon.var() + 2 * lat.cov(lon)) / 4):.4f}"
      f"   실측 = {((lat + lon) / 2).std():.4f}")
print(f"sd(차/2) 공식 = {np.sqrt((lat.var() + lon.var() - 2 * lat.cov(lon)) / 4):.4f}"
      f"   실측 = {((lat - lon) / 2).std():.4f}")

df['Diff'] = (lat - lon) / 2
print(f"\n{'모형':>26}{'R^2':>9}{'합성변수의 계수':>16}")
print(f"{'MedInc+AveRooms+AveOccup':>26}{model_reduced.rsquared:>9.4f}{'-':>16}")
for name in ('Location', 'Diff'):
    mm = sm.OLS(y, sm.add_constant(df[features_reduced + [name]])).fit()
    print(f"{'  + ' + name:>26}{mm.rsquared:>9.4f}{mm.params[name]:>16.4f}")
print(f"{'  + Latitude, Longitude':>26}{model_full.rsquared:>9.4f}"
      f"{model_full.params['Latitude'] + model_full.params['Longitude']:>16.4f}")
출력:
sd(Latitude) = 2.1360,  sd(Longitude) = 2.0035,  r = -0.9247
sd(합/2) 공식 = 0.4069   실측 = 0.4069
sd(차/2) 공식 = 2.0304   실측 = 2.0304

                        모형      R^2        합성변수의 계수
  MedInc+AveRooms+AveOccup   0.4808               -
                + Location   0.5855         -0.9991
                    + Diff   0.4813         -0.0130
     + Latitude, Longitude   0.5860         -1.0097
공식이 맞는다. 합의 표준편차 \(0.4069\), 차의 표준편차 \(2.0304\)가 실측과 소수점 넷째 자리까지 같다.
예상대로 합이 이긴다. Location(합) 하나를 넣으면 \(R^2\)이 \(0.4808 \to 0.5855\)로 올라 두 좌표를 다 넣은 \(0.5860\)을 거의 그대로 회복한다. 변수 하나를 잃고 설명력은 \(0.0005\)만 잃었다. 반면 Diff(차)를 넣으면 \(0.4813\)으로 아무 변화가 없다. 산포가 다섯 배 큰 변수인데도 그렇다.
계수도 들어맞는다. Location의 계수가 \(-0.9991\)인데, 완전모형의 두 계수를 더한 값 \(-1.0097\)과 \(1\%\) 안에서 같다. (1)에서 \(-0.498L_1 - 0.512L_2 \approx -1.01 \cdot \frac{L_1+L_2}{2}\)라 쓴 것이 자료에서 그대로 확인되는 셈이다.
이 보기의 교훈은 "평균 내라"가 아니다. 상관이 양수인 두 변수였다면 합이 큰 분산을 갖고 차가 상쇄되어, 합성해야 할 것이 합이 되었을 것이다. 상관의 부호와 완전모형 계수의 부호를 함께 보고 반응이 실제로 쓰는 방향을 골라야 한다. 그 방향을 자료에게 물어보는 자동 절차가 보기 7의 주성분회귀이고, 반응까지 함께 보는 것이 부분최소제곱(partial least squares)이다.
방법 3: 정칙화(릿지 회귀 또는 라쏘 회귀)
계수를 축소하는 벌점 기반 방법을 쓴다.
보기 6. 대책 3 — 능형회귀(ridge regression)와 라쏘
(1) 능형회귀의 해가 \(\hat{\boldsymbol\beta}_\lambda = (\mathbf X^\top \mathbf X + \lambda \mathbf I)^{-1}\mathbf X^\top \mathbf y\)임을 보이고, \(\mathbf X^\top \mathbf X\)의 고윳값을 \(d_1 \ge \cdots \ge d_p\)라 할 때 고윳방향마다 수축비가 \(d_k/(d_k+\lambda)\)임을 보이시오. 그러므로 \(\lambda\)가 \(d_k\)에 견주어 작으면 아무 일도 일어나지 않는다.
(2) alpha=1.0을 넣은 능형이 이 자료에서 실제로 얼마나 수축시키는지 재시오. 벌점이 척도에 의존한다는 것도 확인하시오.
풀이
(1) 해석적으로. 능형의 목적함수는
이다. 미분해 0으로 두면
이고, \(\lambda > 0\)이면 \(\mathbf X^\top \mathbf X + \lambda \mathbf I\)가 항상 양정치라 역행렬이 존재한다. \(\mathbf X\)가 완전공선이어도 능형은 답을 준다는 것이 이 한 줄의 내용이다. 이계도함수가 \(2(\mathbf X^\top\mathbf X + \lambda\mathbf I) \succ 0\)이므로 이 정류점이 최소점이다.
수축의 모양을 보려면 고유분해 \(\mathbf X^\top \mathbf X = \mathbf V \mathbf D \mathbf V^\top\)를 넣는다. \(\mathbf D = \operatorname{diag}(d_1, \ldots, d_p)\)이고 \(\mathbf V\)가 직교이므로
이다(마지막 등식은 \(\mathbf X^\top \mathbf y = \mathbf X^\top \mathbf X \hat{\boldsymbol\beta}_{\text{OLS}} = \mathbf V\mathbf D\mathbf V^\top \hat{\boldsymbol\beta}_{\text{OLS}}\)). 곧 \(\mathbf V\)의 \(k\)번째 방향 성분이
배로 줄어든다. \(d_k \gg \lambda\)인 방향은 손대지 않고, \(d_k\)가 작은 방향 — 곧 공선성이 사는 방향 — 만 크게 줄인다. 능형이 공선성에 듣는 이유가 이것이고, 동시에 \(\lambda\)를 자료의 척도에 맞춰 골라야 하는 이유이기도 하다. 모든 \(d_k\)가 \(\lambda\)보다 훨씬 크면 수축비가 전부 1에 붙어 능형이 OLS와 구별되지 않는다.
(2) 수치적으로.
from sklearn.linear_model import Ridge, Lasso

# 대책 3: 벌점회귀. 능형회귀는 계수를 0 쪽으로 줄여 분산을 낮춘다.
# 편향이 조금 생기는 대신 분산이 크게 줄어드는 트레이드오프다.
ridge = Ridge(alpha=1.0)
ridge.fit(X, y)
print(ridge.coef_)

# 라쏘는 일부 계수를 정확히 0 으로 만들어 변수 선택까지 해 준다.
lasso = Lasso(alpha=0.1)
lasso.fit(X, y)
print(lasso.coef_)
출력:
[ 0.35902368  0.01500534 -0.00336581 -0.4979378  -0.51160538]
[ 0.37150935 -0.         -0.00281434 -0.18079981 -0.1744082 ]
닫힌 꼴로 재현하고, 수축이 실제로 얼마나 일어났는지 잰다.
import numpy as np
from sklearn.linear_model import LinearRegression

# 능형의 닫힌 꼴. sklearn 은 절편을 벌하지 않으므로 중심화한 뒤 푼다.
Xc = X.values - X.values.mean(axis=0)
yc = y - y.mean()
lam = 1.0
b_closed = np.linalg.solve(Xc.T @ Xc + lam * np.eye(X.shape[1]), Xc.T @ yc)
print("닫힌 꼴      :", np.round(b_closed, 8))
print("sklearn Ridge:", np.round(ridge.coef_, 8))
print(f"최대 오차 = {np.abs(b_closed - ridge.coef_).max():.2e}")

# 수축이 실제로 얼마나 일어났는가
b_ols = LinearRegression().fit(X, y).coef_
print(f"\n||b_OLS||   = {np.linalg.norm(b_ols):.6f}")
print(f"||b_Ridge|| = {np.linalg.norm(ridge.coef_):.6f}")
print(f"||b_Lasso|| = {np.linalg.norm(lasso.coef_):.6f}")

# 왜 능형이 거의 아무 일도 하지 않았는가: X'X 의 고윳값과 견주어 lambda 가 너무 작다
ev = np.linalg.eigvalsh(Xc.T @ Xc)[::-1]
print(f"\nX'X 의 고윳값 = {np.array2string(ev, precision=1)}")
print(f"수축비 d/(d+lambda) = {np.array2string(ev / (ev + lam), precision=6)}")

# 벌점은 척도에 의존한다. 표준화하면 결과가 완전히 달라진다.
Xs = (X - X.mean()) / X.std()
print(f"\n표준화 뒤 OLS   : {np.round(LinearRegression().fit(Xs, y).coef_, 4)}")
print(f"표준화 뒤 Ridge : {np.round(Ridge(alpha=1.0).fit(Xs, y).coef_, 4)}")
print(f"표준화 뒤 Lasso : {np.round(Lasso(alpha=0.1).fit(Xs, y).coef_, 4)}")
출력:
닫힌 꼴      : [ 0.35902368  0.01500534 -0.00336581 -0.4979378  -0.51160538]
sklearn Ridge: [ 0.35902368  0.01500534 -0.00336581 -0.4979378  -0.51160538]
최대 오차 = 1.11e-16

||b_OLS||   = 0.799364
||b_Ridge|| = 0.799260
||b_Lasso|| = 0.448480

X'X 의 고윳값 = [2226360.5  172828.2  139581.8   59862.2    5540.9]
수축비 d/(d+lambda) = [1.       0.999994 0.999993 0.999983 0.99982 ]

표준화 뒤 OLS   : [ 0.6821  0.0371 -0.035  -1.0637 -1.0252]
표준화 뒤 Ridge : [ 0.6821  0.0371 -0.035  -1.063  -1.0244]
표준화 뒤 Lasso : [ 0.6931 -0.     -0.     -0.011  -0.    ]
닫힌 꼴이 sklearn과 기계 정밀도까지 같다. 오차 \(1.1 \times 10^{-16}\)이다.
그런데 alpha=1.0의 능형은 이 자료에서 사실상 아무 일도 하지 않았다. 계수 노름이 \(0.799364\)에서 \(0.799260\)으로 \(0.013\%\) 줄었을 뿐이다. 까닭은 (1)의 수축비가 말해 준다. \(\mathbf X^\top\mathbf X\)의 고윳값이 \(5{,}541\)부터 \(2{,}226{,}360\)까지인데 \(\lambda = 1\)은 그에 견주어 미미해서, 수축비가 가장 작은 방향에서도 \(0.99982\)다. 능형의 \(\lambda\)는 자료의 척도에 달린 양이고, \(1.0\)이라는 수 자체에는 아무 뜻이 없다.
같은 \(\lambda\)로 라쏘는 많은 일을 한다. AveRooms를 정확히 \(0\)으로 보내고 Latitude·Longitude를 \(-0.498, -0.512\)에서 \(-0.181, -0.174\)로 크게 줄여 노름이 \(0.448\)이 되었다. 벌점이 \(\lVert\boldsymbol\beta\rVert^2\)이 아니라 \(\lVert\boldsymbol\beta\rVert_1\)이라 작은 계수에도 상수 크기의 힘이 걸리기 때문이다.
마지막 세 줄이 가장 중요하다. 변수를 표준화하면 그림이 뒤집힌다. 능형은 여전히 거의 아무 일도 하지 않는데(표준화해도 \(d_k\)가 \(\lambda\)보다 훨씬 크다), 라쏘는 MedInc 하나만 남기고 전부 0으로 보낸다. 표준화 전에는 살아 있던 Latitude·Longitude가 사라진 것이다. 벌점 \(\lambda\lVert\boldsymbol\beta\rVert_1\)은 변수의 단위에 따라 값이 달라지므로, 표준화하지 않고 쓴 벌점회귀의 변수 선택은 "어느 변수가 중요한가"가 아니라 "어느 변수의 단위가 큰가"를 읽고 있을 수 있다. 벌점회귀에서 표준화가 권고가 아니라 전제인 이유다.
방법 4: 주성분분석(PCA)
상관된 설명변수를 서로 무상관인 주성분으로 변환한다.
보기 7. 대책 4 — 주성분회귀
(1) explained_variance_ratio_가 공분산행렬의 고윳값 \(\lambda_k\)에 대해 \(\lambda_k / \sum_j \lambda_j\)임을 쓰고, 공선성의 신호가 큰 고윳값이 아니라 작은 고윳값에 있음을 설명하시오. 조건수 \(\kappa = \sqrt{\lambda_1/\lambda_p}\)가 쓰이는 이유는 무엇인가.
(2) 고윳값을 직접 계산해 sklearn과 맞추고, 첫 성분이 무엇인지 적재로 확인하시오. 변수를 표준화하면 그림이 어떻게 달라지는가.
풀이
(1) 해석적으로. 중심화한 자료의 표본공분산행렬 \(S\)를 고유분해하면 \(S = \mathbf V \Lambda \mathbf V^\top\)이고, \(k\)번째 주성분 점수 \(\mathbf z_k = \mathbf X_c \mathbf v_k\)의 표본분산(sample variance)은
이다. 성분들이 직교하므로 분산이 그대로 더해져 \(\sum_k \lambda_k = \operatorname{tr}(S)\), 곧 원래 변수들의 분산 합과 같다. 그러므로 설명비율이 \(\lambda_k/\sum_j \lambda_j\)다.
공선성이 사는 곳은 작은 고윳값 쪽이다. 어떤 방향 \(\mathbf v\)에 대해 \(\mathbf X_c \mathbf v \approx \mathbf 0\)이면 그 방향이 "변수들 사이의 거의 성립하는 선형관계"이고, 그때 \(\lambda = \operatorname{Var}(\mathbf X_c\mathbf v) \approx 0\)이다. 보기 2의 식으로 보면 \(\operatorname{Var}(\hat{\boldsymbol\beta}) = \sigma^2(\mathbf X^\top\mathbf X)^{-1}\)의 고윳값이 \(\sigma^2/d_k\)라 가장 작은 \(d_k\)가 분산을 터뜨린다.
큰 고윳값은 이와 무관하다. 변수 하나가 다른 것들보다 단위가 커서 혼자 분산을 독차지하기만 해도 첫 성분이 \(90\%\)를 설명한다. "첫 성분이 분산의 대부분을 설명한다"는 공선성의 증거가 아니다. (2)에서 그 반례를 본다.
조건수 \(\kappa = \sqrt{\lambda_1/\lambda_p}\)는 가장 큰 축과 가장 작은 축의 비라 단위에 덜 휘둘린다. 관례로 \(\kappa > 30\)이면 공선성을 의심한다.
(2) 수치적으로.
from sklearn.decomposition import PCA

# 대책 4: 주성분회귀. 서로 직교하는 성분으로 바꾸므로 다중공선성이
# 원리적으로 사라진다. 대신 성분이 원래 변수의 섞임이라 해석이 어려워진다.
pca = PCA(n_components=3)
X_pca = pca.fit_transform(X)

# 주성분으로 모형을 적합한다
model_pca = LinearRegression()
model_pca.fit(X_pca, y)
print(f"Explained variance ratio: {pca.explained_variance_ratio_}")
출력:
Explained variance ratio: [0.85492016 0.06636584 0.05359929]
고윳값을 직접 구하고 첫 성분의 정체를 확인한다.
import numpy as np
from sklearn.decomposition import PCA

# explained_variance 는 공분산행렬의 고윳값이다.
pca_all = PCA().fit(X)
eig = np.linalg.eigvalsh(np.cov(X.values, rowvar=False))[::-1]
print("sklearn explained_variance :", np.round(pca_all.explained_variance_, 6))
print("공분산행렬의 고윳값        :", np.round(eig, 6))
print("비율                       :", np.round(pca_all.explained_variance_ratio_, 6))
print(f"조건수 sqrt(l_1/l_p)       = {np.sqrt(eig[0] / eig[-1]):.3f}")

# 첫 성분이 무엇인지 적재로 확인한다.
print("\n첫 성분의 적재 :", dict(zip(features, np.round(pca_all.components_[0], 4))))
print(f"AveOccup 의 분산 = {X['AveOccup'].var():.4f},  첫 고윳값 = {eig[0]:.4f}")

# 표준화하면 완전히 다른 그림이 된다.
Xs = (X - X.mean()) / X.std()
pca_s = PCA().fit(Xs)
print("\n표준화 뒤 비율 :", np.round(pca_s.explained_variance_ratio_, 6))
print("표준화 뒤 조건수 =",
      f"{np.sqrt(pca_s.explained_variance_[0] / pca_s.explained_variance_[-1]):.3f}")
print("가장 작은 성분의 적재 :",
      dict(zip(features, np.round(pca_s.components_[-1], 4))))
출력:
sklearn explained_variance : [107.871529   8.373863   6.763014   2.900441   0.268466]
공분산행렬의 고윳값        : [107.871529   8.373863   6.763014   2.900441   0.268466]
비율                       : [0.85492  0.066366 0.053599 0.022987 0.002128]
조건수 sqrt(l_1/l_p)       = 20.045

첫 성분의 적재 : {'MedInc': 0.0035, 'AveRooms': -0.0012, 'AveOccup': 1.0, 'Latitude': 0.0005, 'Longitude': 0.0005}
AveOccup 의 분산 = 107.8700,  첫 고윳값 = 107.8715

표준화 뒤 비율 : [0.386895 0.265062 0.200103 0.135386 0.012553]
표준화 뒤 조건수 = 5.552
가장 작은 성분의 적재 : {'MedInc': -0.105, 'AveRooms': 0.0963, 'AveOccup': 0.0062, 'Latitude': -0.7051, 'Longitude': -0.6946}
explained_variance_가 공분산행렬의 고윳값과 소수점 여섯째 자리까지 같다.
첫 성분은 공선성과 아무 관계가 없다. 적재가 AveOccup에 \(1.000\), 나머지에 \(0.004\) 이하다. 곧 첫 주성분은 그냥 AveOccup 한 변수이며, 첫 고윳값 \(107.87\)은 AveOccup의 분산 \(107.87\) 그 자체다. 그런데 AveOccup은 보기 2에서 VIF가 \(1.0010\)으로 다섯 변수 가운데 공선성이 가장 없는 변수였다. 평균 거주 인원이라 단위가 큰 탓에 분산을 독차지했을 뿐이다. "첫 성분이 \(85.5\%\)를 설명하므로 변수들이 강하게 얽혀 있다"고 읽으면 안 되는 이유다.
공선성은 마지막 성분에 있다. 표준화한 뒤의 가장 작은 성분(설명비율 \(1.26\%\))의 적재가 Latitude \(-0.705\), Longitude \(-0.695\)로 거의 같다. 곧 그 방향이 \(\text{Lat} + \text{Lon}\)이며, 보기 5에서 만든 Location 변수와 사실상 같은 방향이다. 자료에서 거의 변하지 않는 방향, 곧 두 좌표가 묶여 있다는 사실이 여기 있다.
표준화 여부로 그림이 뒤집힌다. 표준화 전에는 첫 성분이 \(85.5\%\)였는데 표준화 후에는 \(38.7\%\)로 내려가고 다섯 성분이 고르게 퍼진다. 조건수도 \(20.0\)에서 \(5.6\)으로 바뀐다. PCA는 단위에 전적으로 의존하므로 공선성 진단에 쓰려면 반드시 표준화해야 한다. 표준화한 조건수 \(5.55\)는 관례의 임계값 \(30\)에 한참 못 미치며, 보기 2의 VIF \(8\)이 "우려되나 심각하지 않다"고 말한 것과 같은 판정이다.
주성분회귀 자체에 대해서는 한 가지만 덧붙인다. 성분 셋만 남기면 공선성은 원리적으로 사라지지만, 버린 성분이 반응을 설명하고 있었다면 그만큼 잃는다. 보기 5가 보인 대로 이 자료에서 반응이 쓰는 방향은 분산이 가장 작은 쪽이었다. 분산이 큰 순서로 성분을 고르는 PCA는 반응을 한 번도 보지 않는다는 점을 기억해야 한다.
3. 핵심 개념
다중공선성을 이해하려면 다음을 알아야 한다.
-
모형의 문제가 아니라 자료의 문제이다: 문제는 모형 선택이 아니라 자료의 구조에서 온다.
-
예측 대 추론: 다중공선성은 주로 추론(변수 효과의 이해)에 영향을 준다. 비슷한 자료에 대한 예측은 여전히 신뢰할 만하다.
-
분야 맥락이 중요하다: 해석이나 분야 이해를 위해 상관된 변수들을 그대로 두는 것이 정당할 때도 있다. 부풀려진 표준오차를 감수하는 것이다.
-
대책에는 대가가 따른다: 변수를 빼면 정보를 잃는다. 정칙화는 편향을 도입하되 분산을 줄인다. PCA는 무상관 성분을 만들어 주지만 그 성분들의 의미를 해석하기 어렵다.
그림으로 보는 통계학 1. 계산기가 서로 다른 답을 내놓던 시절
위 세 항목은 다중공선성이 통계적으로 무엇을 망가뜨리는지를 말한다 — 표준오차가 부풀고, 계수의 부호가 흔들리고, 해석이 어려워진다. 청구서가 한 장 더 있다. 맞는 자릿수다.
\(1967\) 년, 미국 노동통계국의 제임스 롱리가 『미국통계학회지』에 논문을 싣는다. 제목이 그대로 문제의식이다 — 「사용자의 관점에서 본 전자계산기용 최소제곱 프로그램들의 평가」. 그는 미국 거시경제 자료 \(16\) 년치로 회귀를 하나 돌리고, 같은 계산을 당시의 여러 프로그램에 맡겨 보았다. 결과가 서로 달랐다. 그래서 그는 참값을 유효숫자 \(10\) 자리까지 손으로 구해 놓고 프로그램들을 채점했다.
그 자료가 지금도 쓰인다. 미국표준기술연구소(NIST)의 선형최소제곱 기준자료에 들어가 있고, 통계 소프트웨어가 새로 나오면 이것부터 돌려 본다. 「롱리 자료를 여덟 자리까지 맞추면 쓸 만하다」가 오래된 기준이었다.
무엇이 그렇게 어려웠는가.
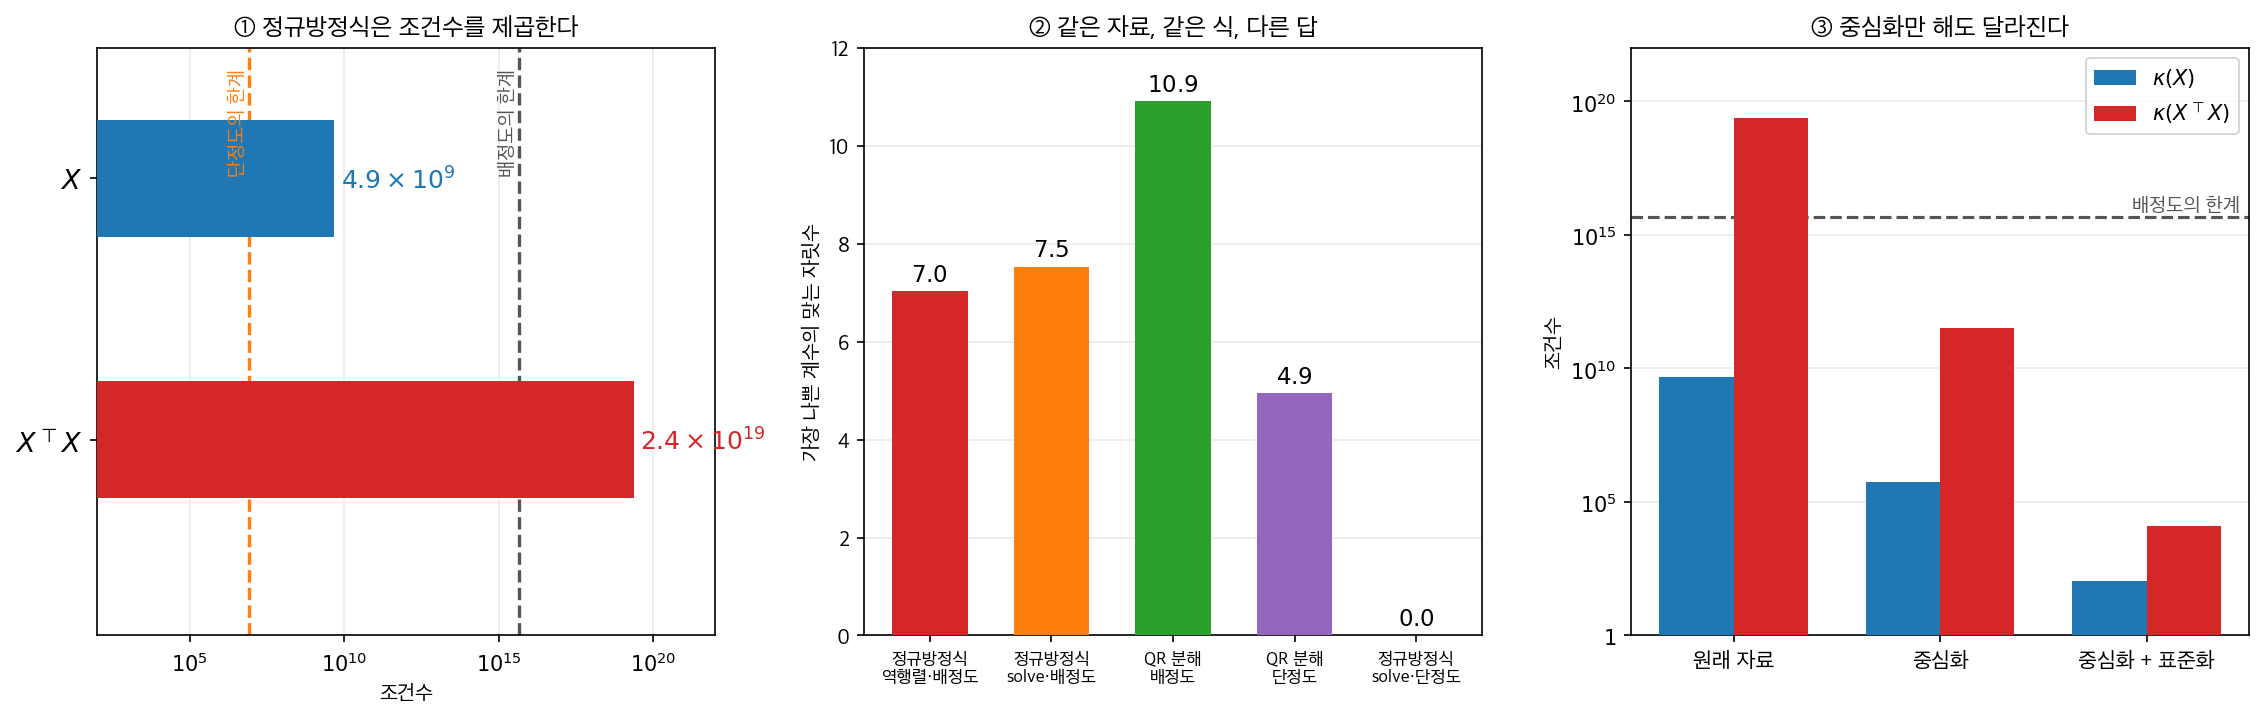
가운데 칸의 다섯 막대는 같은 자료에 같은 식을 푼 것이다. 바뀐 것은 푸는 순서와 소수점의 길이뿐이다.
왼쪽 칸이 까닭이다. 설계행렬 \(X\) 의 조건수가 \(4.9 \times 10^{9}\) 인데, 정규방정식(normal equations) \(X^\top X \boldsymbol\beta = X^\top \mathbf{y}\) 를 세우는 순간 그 조건수가 제곱되어 \(2.4 \times 10^{19}\) 이 된다. 배정도 부동소수가 구별할 수 있는 한계는 \(1/\varepsilon \approx 4.5 \times 10^{15}\) 다. 정규방정식을 세우는 그 한 걸음이 자료를 배정도의 바깥으로 밀어낸다.
가운데 칸이 그 결과다. 참값은 자료가 유한소수이므로 유리수 산술로 정확히 구할 수 있다. 그 참값과 견준 맞는 자릿수가 이렇다.
| 푸는 방법 | 맞는 자릿수 |
|---|---|
| 정규방정식 + 역행렬, 배정도 | \(7.0\) |
정규방정식 + solve, 배정도 |
\(7.5\) |
| QR 분해, 배정도 | \(\mathbf{10.9}\) |
| QR 분해, 단정도 | \(4.9\) |
정규방정식 + solve, 단정도 |
\(\mathbf{0.0}\) |
맨 아랫줄이 무슨 뜻인지 한 계수로 보면 분명하다. YEAR 의 참값은 \(+1829.15\) 인데,
단정도로 정규방정식을 풀면 \(-239.08\) 이 나온다. 크기도 부호도 다르다. 「연도가
\(1\) 년 늘면 고용이 \(1829\) 명 는다」가 「\(239\) 명 준다」가 된다. 어느 쪽도 경고를 내지
않고, 둘 다 그럴듯한 수로 보인다.
QR 분해가 배정도에서 \(10.9\) 자리를 지키는 것은 \(X^\top X\) 를 만들지 않기 때문이다.
오늘날의 statsmodels 와 sklearn 이 내부에서 QR 이나 SVD 를 쓰는 까닭이고,
\(1967\) 년에 프로그램마다 답이 달랐던 까닭이기도 하다.
오른쪽 칸이 실무의 처방이다. 설명변수를 중심화하기만 해도 \(\kappa(X)\) 가 \(4.9 \times 10^{9}\) 에서 \(5.8 \times 10^{5}\) 로 떨어지고, 표준화까지 하면 \(110\) 이 된다. \(\kappa(X^\top X)\) 로는 \(10^{19}\) 에서 \(10^{4}\) 다. 연도를 \(1947\) 대신 \(0, 1, 2, \ldots\) 로 적는 것만으로 열다섯 자리를 되찾는 셈이다. 이 쪽 \(2\) 절의 「상관된 설명변수 결합」이나 「정칙화」로 가기 전에, 척도를 옮기는 공짜 수단이 먼저 있다.
확인한 곳 — 롱리의 논문이 『Journal of the American Statistical Association』 \(62\) 권 \(319\) 호 \(819\)–\(841\) 쪽(\(1967\))이고 프로그램의 반올림 오차를 재려는 것이었다는 것, 참값을 유효숫자 \(10\) 자리까지 구해 둔 것, 이 자료가 NIST 의 선형최소제곱 기준자료에 들어 있고 여덟 자리가 오랜 기준이었다는 것. 조건수와 자릿수는 그 자료로 직접 계산했고 참값은 유리수 산술로 구했다
연습문제
연습문제 1. 설명변수가 세 개인 회귀모형에서 \(\text{VIF}_1 = 1.2\), \(\text{VIF}_2 = 8.5\), \(\text{VIF}_3 = 12.3\)을 얻었다. 이 값들을 해석하고 어떤 설명변수에 주의가 필요한지 제안하라.
풀이
VIF(분산팽창인자)는 다중공선성 때문에 계수 추정의 분산이 얼마나 부풀려졌는지를 잰다. 흔한 임계값은 VIF > 5(중간 정도 우려)와 VIF > 10(심각한 우려)이다.
- \(\text{VIF}_1 = 1.2\): 다중공선성 우려가 없다. \(X_1\)은 다른 설명변수들과 거의 무상관이다.
- \(\text{VIF}_2 = 8.5\): 중간 정도의 다중공선성이다. \(\hat{\beta}_2\)의 표준오차가 \(\sqrt{8.5} \approx 2.9\)배로 부풀려진다.
- \(\text{VIF}_3 = 12.3\): 심각한 다중공선성이다. \(\hat{\beta}_3\)의 표준오차가 \(\sqrt{12.3} \approx 3.5\)배로 부풀려진다.
\(X_2\)와 \(X_3\)이 강하게 상관되어 있을 가능성이 높다. 하나를 빼거나, 둘을 결합하거나, 능형회귀를 쓰는 것을 고려하라.
연습문제 2. 다중공선성이 OLS 계수 추정을 편향시키지는 않지만 왜 믿을 수 없게 만드는지 설명하라. 구체적으로 어떤 양이 영향을 받는가?
풀이
다중공선성 아래에서도 OLS 추정량은 불편이다. \(E[\hat{\beta}] = \beta\)는 \(E[\varepsilon|X] = 0\)만을 요구하며 설명변수들 사이의 상관과는 무관하기 때문이다.
그러나 다중공선성은 추정량의 분산을 부풀린다. 공분산행렬은 \(\text{Var}(\hat{\beta}) = \sigma^2 (X^\top X)^{-1}\)인데, 설명변수들이 강하게 상관되면 \((X^\top X)\)가 거의 특이행렬이 되어 \((X^\top X)^{-1}\)의 대각원소가 매우 커진다. 그 결과 개별 계수의 신뢰구간이 넓어지고, 자료의 작은 변화에 민감해지며, 설명변수들이 결합적으로는 유의한데도 개별 \(p\) 값은 클 수 있다.
연습문제 3. 집값을 예측하는 모형에 "총면적"과 "방 개수"가 모두 들어 있다. 두 변수의 상관은 \(r = 0.92\)이다. 두 변수의 예측 정보를 모두 유지하면서 이 다중공선성에 대처하는 두 가지 방법을 제안하라.
풀이
-
합성 변수 만들기: 상관된 두 설명변수를 "방당 면적"(\(X_{\text{new}} = \text{총면적}/\text{방 개수}\))으로 바꾼다. 크기 정보를 하나의 변수에 더 효율적으로 담는다.
-
능형회귀: 손실함수에 벌점 \(\lambda \|\beta\|^2\)을 더하는 \(L_2\) 정칙화를 쓴다. 상관된 계수들을 서로 가까이 축소하여 약간의 편향을 대가로 분산을 줄인다. 능형회귀는 어느 변수도 버리지 않으면서 추정을 안정화한다.
연습문제 4. 보기 1 은 \(z_1, \ldots, z_m\)이 독립이고 분산이 같을 때 \(z_{m+1} = z_1 + \cdots + z_m\)으로 두면 \(\operatorname{corr}(z_j, z_{m+1}) = 1/\sqrt m\)임을 보였다. 보기 1 의 코드는 \(\lvert r \rvert > 0.7\)인 쌍만 찍어 경보로 삼는다.
(1) 이 구성에서 경보가 울리는 \(m\)을 모두 구하시오. 완전공선인 자료가 경보를 피하기 시작하는 가장 작은 \(m\)은 얼마이고, 그때 \(z_1\)의 VIF 는 얼마인가.
(2) 임계값을 \(0.7\)보다 작은 어떤 수 \(c > 0\)으로 낮추면 이 구성을 모두 잡을 수 있는가.
(3) 보기 1 의 수치 실험(\(m = 10\), \(N = 2000\))은 쌍별 상관의 최대 절대값을 \(0.3569\)로 보고했고 이론값은 \(0.3162\)다. 표본상관의 표준오차가 근사적으로 \((1 - \rho^2)/\sqrt N\)임을 써서 이 차이가 표집 변동으로 설명되는지 재고, 보고된 최대값이 참상관이 \(0\)인 \(45\)개 쌍에서 나왔을 수 없음을 보이시오.
풀이
(1) 경보 조건은 \(1/\sqrt m > 0.7\), 곧 \(m < 1/0.49 = 2.0408\)이다. 정수 \(m\)으로는
둘뿐이다. \(m = 2\)는 \(0.7071 > 0.7\)로 간신히 걸린다. \(m = 3\)이면 \(1/\sqrt 3 = 0.5774\)로 경보가 침묵한다.
그런데 \(m = 3\)에서 자료는 완전공선이다. \(z_4 = z_1 + z_2 + z_3\)이므로
이 오차 없이 성립해 \(R_1^2 = 1\), 곧 \(\text{VIF}_1 = 1/(1 - 1) = \infty\)다. 네 변수 가운데 어느 것을 골라도 같다. 변수가 넷이고 쌍별 상관의 최대가 \(0.577\)뿐인데 설계행렬이 특이하다.
(2) 잡을 수 없다. 어떤 \(c > 0\)을 골라도 \(m > 1/c^2\)인 \(m\)을 택하면 모든 쌍별 상관의 절대값이
가 되고 자료는 여전히 완전공선이다. \(1/\sqrt m \to 0\)이므로 고정된 양수 임계값은 어느 것도 통하지 않는다.
임계값을 자료의 잡음 수준까지 낮추는 것도 답이 아니다. \(N = 2000\)에서 참상관이 \(0\)인 쌍의 표본상관은 표준오차가 \(1/\sqrt N = 0.0224\)이므로, \(c = 0.07\)쯤으로 내리면 서로 아무 관계가 없는 쌍들이 줄줄이 걸린다. 쌍의 개수가 \(\binom{p}{2}\)로 늘어나는 것까지 생각하면 오경보가 폭발한다.
(3) \(\rho = 0.3162\)이므로 \(\rho^2 = 0.1\)이고
이다. 관측된 초과분은 \((0.3569 - 0.3162)/0.0201 = 2.02\) 표준오차다. 그런데 보고된 값은 한 쌍의 상관이 아니라 참상관이 \(1/\sqrt{10}\)인 \(10\)개 쌍의 최대값이다. 표준정규 \(10\)개의 최대의 기댓값이 약 \(1.54\), 표준편차가 약 \(0.59\)이므로 최대값의 기댓값은
이고 산포는 \(0.59 \times 0.0201 = 0.0119\)다. 관측값 \(0.3569\)는 여기서 \(0.8\) 표준편차 떨어져 있을 뿐이다. 표집 변동으로 충분히 설명된다.
참상관이 \(0\)인 \(45\)개 쌍에서는 나올 수 없다. 그 쌍들의 표본상관은 표준오차가 \(0.0224\)이고, \(45\)개의 절대값 최대의 기댓값은 \(2.3 \times 0.0224 = 0.05\) 정도다. 관측값 \(0.3569\)는 그 쌍들의 기준으로 \(0.3569/0.0224 = 15.9\) 표준오차 밖이다. 곧 최대값은 반드시 \(z_{m+1}\)이 끼어 있는 쌍에서 나왔다. 상관행렬이 보고 있는 가장 큰 수조차 공선성의 출처를 가리키고는 있는데, 그 크기가 \(0.36\)에 지나지 않아 아무 경보도 울리지 못하는 것이다.
연습문제 5. 보기 3 은 Latitude 의 VIF 가 두 변수 공식이 주는 값 \(6.90\)보다 큰 \(8.1845\)임을 보고 그 차이를 "나머지 세 변수가 보탠 몫"이라 했다. 그 몫을 수로 떼어내자. \(X_1\)을 \(X_2\) 하나에만 회귀시킨 결정계수를 \(r^2\), 나머지 설명변수 전부에 회귀시킨 결정계수를 \(R_1^2\)이라 한다.
(1) \(R_1^2 \ge r^2\)임을 말하고, 그러므로 쌍별 상관으로 계산한 VIF 는 늘 참 VIF 의 하한임을 보이시오. 보기 1 의 자료에서 그 하한이 얼마나 쓸모없는지 수로 보이시오.
(2) 다음이 성립함을 보이고 \(f\)가 무엇인지 말하시오.
(3) 보기 3 의 \(r = -0.9247\), \(R_{\text{Lat}}^2 = 0.877818\), \(R_{\text{Lon}}^2 = 0.874651\)로 두 변수의 \(f\)와 두 인자를 계산하고, 보고된 VIF \(8.1845\)와 \(7.9777\)과 맞추시오. \(f\)가 \(0.157\)에 불과한데 VIF 가 \(19\%\)나 커진 까닭을 설명하시오.
풀이
(1) \(X_2\)에만 회귀시킨 것은 나머지 전부에 회귀시킨 것의 부분모형이다. 설명변수를 더하면 최소제곱의 잔차제곱합이 커질 수 없으므로 \(R_1^2 \ge r^2\)이고, \(u \mapsto 1/(1-u)\)가 증가하므로
이다. 쌍별 상관이 주는 수는 참 VIF 를 아래로 가둘 뿐이며, 틀리는 방향은 항상 "과소평가"다.
보기 1 의 자료가 이 하한의 쓸모를 보여 준다. 쌍별 상관이 모두 \(1/\sqrt m\)이므로 하한은
이고 \(m = 10\)이면 \(10/9 = 1.111\)이다. 참값은 \(\infty\)(잡음을 섞은 보기 1 의 수치판에서는 \(98{,}069\))다. 하한이 \(1.11\)인데 참값이 \(10^5\)라면 하한을 안다는 것이 아무 뜻도 없다.
(2) 분모를 쪼개면 끝난다.
역수를 취하면 구하는 식이다. \(f\)는 \(X_2\)를 이미 넣은 뒤 남은 설명 여지 \(1 - r^2\) 가운데 나머지 변수들이 더 먹은 비율, 곧 \(X_2\)를 통제한 뒤의 부분결정계수다. \(0 \le f < 1\)이고, \(f = 0\)이면 두 변수 공식이 정확하다.
(3) \(r^2 = (-0.9247)^2 = 0.855070\)이므로 \(1 - r^2 = 0.144930\)이고 첫 인자는
이다(보기 3 의 \(6.897\)과 반올림 범위에서 같다). Latitude 는
이므로 \(\text{VIF} = 6.900 \times 1.1862 = 8.185\)다. 보고값 \(8.1845\)와 맞는다. Longitude 는
로 \(6.900 \times 1.1562 = 7.978\)이고 보고값 \(7.9777\)과 맞는다. 두 VIF 의 비 \(8.1845/6.900 = 1.1862\)가 둘째 인자와 같다는 것이 분해의 요지다.
\(f = 0.157\)이라는 작은 수가 VIF 를 \(19\%\) 키운 것은 이상한 일이 아니다. \(f\)는 이미 \(0.1449\)로 좁아진 여지 안에서의 비율이다. 절대 척도로 보면 \(R^2\)이 \(0.8551\)에서 \(0.8778\)로 \(0.0227\) 올랐을 뿐인데, VIF 의 분모가 \(0.1449\)에서 \(0.1222\)로 줄어 비가 \(1.19\)가 된다. \(R^2\)이 1 에 가까울수록 분모의 작은 변화가 VIF 를 크게 흔든다는 보기 3 의 말이 곱 분해의 둘째 인자로 그대로 나타난 것이다.
연습문제 6. 보기 4 에서 Latitude 와 Longitude 를 빼자 AveRooms 의 계수가 \(+0.015013\)에서 \(-0.038326\)으로, MedInc 의 계수가 \(0.359016\)에서 \(0.434683\)으로 움직였다. 보기 4 는 이를 "방이 많은 동네가 땅값 싼 내륙에 몰려 있다"로 설명했다. 그 설명을 항등식에서 직접 꺼내자. 완전모형(OLS)의 계수는 \(\hat\beta_{\text{Lat}} = -0.49802\), \(\hat\beta_{\text{Lon}} = -0.51169\)다.
(1) 보기 4 의 항등식 \(\hat{\boldsymbol\beta}_{\text{short}} = \hat{\boldsymbol\beta}_K + \hat\Delta \hat{\boldsymbol\beta}_D\)에서 AveRooms 행과 MedInc 행을 적으시오. \(\hat\Delta\)의 해당 행을 \((\delta_{\text{Lat}}, \delta_{\text{Lon}})\)이라 쓴다.
(2) 두 등식에서 \(\delta\)들의 부호에 대해 근사 없이 말할 수 있는 것은 무엇인가.
(3) \(\hat\beta_{\text{Lat}} \approx \hat\beta_{\text{Lon}}\)이므로 \(\delta_{\text{Lat}} \approx \delta_{\text{Lon}} = \delta\)로 놓고 두 행의 \(\delta\)를 구하시오. 샌프란시스코 \((37.8,\,-122.4)\), 로스앤젤레스 \((34.1,\,-118.2)\), 프레즈노 \((36.7,\,-119.8)\)의 \(\text{Lat} + \text{Lon}\)을 계산해 그 부호가 "내륙"을 뜻하는지 확인하고, 보기 4 의 서술이 수로 지지되는지 판정하시오.
풀이
(1) 남긴 변수가 \(K = \{\text{const}, \text{MedInc}, \text{AveRooms}, \text{AveOccup}\}\), 뺀 변수가 \(D = \{\text{Lat}, \text{Lon}\}\)이다. AveRooms 행은
곧
이고, MedInc 행은
이다. 여기서 \(\delta_{\text{Lat}}\)은 Latitude 를 \(K\)에 회귀시킨 계수 가운데 그 행에 해당하는 것이다.
(2) 두 등식의 왼쪽은 \(\delta_{\text{Lat}}, \delta_{\text{Lon}}\)의 양수 가중치 가중합이다(\(0.49802 > 0\), \(0.51169 > 0\)). 그러므로
- AveRooms 행: 가중합이 \(+0.053339 > 0\)이므로 \(\delta_{\text{Lat}}, \delta_{\text{Lon}}\) 가운데 적어도 하나는 양수다.
- MedInc 행: 가중합이 \(-0.075667 < 0\)이므로 적어도 하나는 음수다.
곧 "방이 많아지면 위도·경도가 (가중평균의 뜻에서) 커지고, 소득이 높아지면 작아진다"는 것은 근사가 아니라 항등식에서 바로 읽히는 사실이다. 부호가 뒤집힌 이유를 찾을 때 자료를 다시 보지 않고 보고된 네 계수만으로 여기까지 올 수 있다는 것이 보기 4 항등식의 힘이다.
(3) \(\delta_{\text{Lat}} = \delta_{\text{Lon}} = \delta\)로 놓으면 가중치의 합이 \(0.49802 + 0.51169 = 1.00971\)이므로
이다. 세 도시의 \(\text{Lat} + \text{Lon}\)은
이다. 해안 대도시가 \(-84\) 근처, 내륙의 프레즈노가 \(-83.1\)로 \(\text{Lat} + \text{Lon}\)이 클수록 내륙이다(보기 5 의 Location은 이 값의 절반이다).
그러므로 AveRooms 가 \(1\) 늘면 \(\text{Lat} + \text{Lon}\)이 \(2 \times 0.05283 = 0.106\) 커진다. 방이 많은 동네는 내륙 쪽이다. 보기 5 가 보고한 Location의 계수가 \(-0.9991\)이므로 내륙으로 갈수록 집값이 떨어지고, 위치를 모형에서 빼면 그 하락이 AveRooms 의 몫으로 넘어온다. 넘어온 양이 바로 \(0.05283 \times (-1.00971) = -0.05334\)이고, \(+0.015013\)에 더하면 \(-0.038326\)이다. 보기 4 의 서술이 수로 정확히 지지된다.
MedInc 는 반대쪽이다. \(\delta = -0.07494\)이므로 소득이 \(1\)(만 $) 오르면 \(\text{Lat} + \text{Lon}\)이 \(0.150\) 작아진다, 곧 해안 쪽이다. 해안이 비싼데 위치를 빼 버리면 그 공로까지 소득이 받아 계수가 \(0.359\)에서 \(0.435\)로 커진다. 같은 하나의 누락이 한 계수는 깎고 다른 계수는 키운다. 뺀 변수와 어느 쪽으로 얽혀 있었는지가 방향을 정한다.
연습문제 7. 보기 6 은 \(\mathbf X_c^\top \mathbf X_c\)의 고윳값을 \(d = (2226360.5,\ 172828.2,\ 139581.8,\ 59862.2,\ 5540.9)\)로, 보기 7 은 같은 다섯 변수의 표본공분산행렬의 고윳값을 \(\lambda = (107.871529,\ 8.373863,\ 6.763014,\ 2.900441,\ 0.268466)\)으로 보고했다.
(1) 두 목록의 관계를 쓰고 표본크기 \(n\)을 복원하시오.
(2) 보기 7 의 표준화 뒤 설명비율 \((0.386895,\ 0.265062,\ 0.200103,\ 0.135386,\ 0.012553)\)으로부터 표준화한 설계행렬의 \(\mathbf X_s^\top \mathbf X_s\)의 고윳값을 모두 구하시오(상관행렬의 대각합이 \(p\)임을 쓴다). 표준화 뒤에도 alpha=1.0의 능형이 거의 아무 일도 하지 않는다는 보기 6 의 말을 수로 확인하시오.
(3) 가장 작은 고윳값 방향의 수축비를 정확히 \(1/2\)로 만드는 \(\lambda\)를 표준화 전과 후로 각각 구하시오. 그 \(\lambda\)에서 가장 큰 방향의 수축비는 얼마인가. alpha=1.0과 몇 배 차이인가.
풀이
(1) 표본공분산행렬은 \(S = \mathbf X_c^\top \mathbf X_c/(n-1)\)이므로 고윳값도 같은 상수배다.
가장 큰 쌍으로 \(2226360.5/107.871529 = 20639.0\), 가장 작은 쌍으로 \(5540.9/0.268466 = 20639.1\)을 얻는다. 대각합으로 확인하면 \(\sum_k d_k = 2{,}604{,}173.6\), \(\sum_k \lambda_k = 126.177313\)이고 비가 역시 \(20639.0\)이다. 따라서
이고 이는 캘리포니아 주택 자료의 실제 크기다. 다섯 고윳값이 모두 같은 인자로 맞아떨어지는 것은 두 보기가 같은 행렬을 서로 다른 척도로 본 것일 뿐임을 말한다.
(2) 표준화는 각 열을 표본표준편차(자유도 \(n-1\))로 나누는 것이므로 \(\mathbf X_s^\top \mathbf X_s = (n-1)\mathbf R\)이고, \(\mathbf R\)은 상관행렬이다. \(\operatorname{tr} \mathbf R = p = 5\)이므로 상관행렬의 고윳값은 설명비율의 \(5\)배다.
여기에 \(n - 1 = 20639\)를 곱하면
이다. \(\lambda = 1\)에서 가장 작은 방향의 수축비는
로, 가장 공선인 방향조차 \(0.08\%\)만 줄어든다. 표준화가 척도 문제를 고쳐 주지 않는 까닭은 분명하다. 표준화는 각 열의 분산을 \(1\)로 만들 뿐이고 \(\mathbf X_s^\top \mathbf X_s\)의 고윳값은 여전히 \(n\)에 비례해 \(10^3\) 자리에 있다. \(\lambda = 1\)은 그에 견주어 미미하다.
(3) 수축비가 \(1/2\)이려면
이다. 표준화 전에는 \(\lambda = 5540.9\), 표준화 뒤에는 \(\lambda = 1295.4\)다. 그 \(\lambda\)에서 가장 큰 방향의 수축비는
이다. alpha=1.0과 견주면 표준화 전은 \(5541\)배, 표준화 뒤는 \(1295\)배 큰 값이다.
이 수들이 능형의 성격을 그대로 보여 준다. 공선 방향을 절반으로 줄이는 벌점을 걸어도 가장 튼튼한 방향은 \(99.8\%\)(표준화 뒤 \(96.9\%\)) 그대로 남는다. 선택적 수축이라는 말이 비유가 아니라 산술이다. 동시에 alpha라는 수에는 절대적 뜻이 없다는 것도 분명하다. \(d_k \propto n\)이므로 같은 모집단에서 표본을 \(10\)배로 늘리면 쓸모 있는 \(\lambda\)도 \(10\)배가 된다. 벌점은 언제나 \(d_{\min}\) 같은 자료의 양과 견주어 정해야 하고, 실무에서 교차검증(cross-validation)으로 \(\lambda\)를 고르는 이유가 이것이다.
연습문제 8.
보기 5 는 \(S = (L_1 + L_2)/2\)(Location)와 \(D = (L_1 - L_2)/2\)(Diff)를 만들어 축소모형에 하나씩 넣고 계수 \(-0.9991\)과 \(-0.0130\)을 얻었다. 완전모형(OLS)의 계수는 \(\hat\beta_{\text{Lat}} = -0.49802\), \(\hat\beta_{\text{Lon}} = -0.51169\)다.
(1) \(\{L_1, L_2\}\)와 \(\{S, D\}\)가 같은 열공간을 펼치므로 완전모형이 바뀌지 않음을 쓰고, \(S\)와 \(D\)에 대한 계수 \(\beta_S, \beta_D\)를 구하시오.
(2) 보기 5 가 보고한 \(-0.0130\)은 \(\beta_D\)와 부호가 반대다. 어느 쪽이 틀렸는가. 보기 4 의 항등식으로 두 수를 화해시키고, 그 과정에 나오는 양 \(\delta\)를 수로 구하시오.
(3) Location 쪽에서는 왜 같은 불일치가 눈에 띄지 않는가. 그쪽의 양 \(\delta'\)도 구하고, \(\delta\delta'\)이 (남긴 변수들을 통제한) \(S\)와 \(D\)의 부분상관의 제곱임을 보여 두 수가 서로 모순이 아님을 확인하시오.
풀이
(1) \(L_1 = S + D\), \(L_2 = S - D\)이고 거꾸로 \(S = (L_1+L_2)/2\), \(D = (L_1-L_2)/2\)이므로 두 쌍은 서로의 선형결합이다. 가역 선형변환은 열공간을 바꾸지 않으므로 사영행렬 \(H\)가 같고, 따라서 적합값·잔차·\(R^2\)·\(\sigma^2\) 추정이 모두 같다. 계수만 다시 표현된다.
이므로
이다. \(\beta_S\)는 보기 5 가 찍은 완전모형 계수합 \(-1.0097\)과 같다. (보기 6 이 찍은 수 \(-0.49794,\ -0.51161\)은 alpha=1.0 능형의 계수로, 공선 방향이 \(0.018\%\) 줄어 OLS 와 다섯째 자리에서 갈린다. 여기서는 OLS 값을 쓴다.)
(2) 어느 쪽도 틀리지 않았다. 두 수는 서로 다른 모형의 계수다. \(-0.0130\)은 \(S\)를 넣지 않고 \(D\)만 넣은 모형의 계수이므로 보기 4 의 누락변수 항등식이 그대로 적용된다. 남긴 변수를 \(K' = \{\text{const}, \text{MedInc}, \text{AveRooms}, \text{AveOccup}, D\}\), 뺀 변수를 \(S\) 하나로 보면
이고 \(\delta\)는 \(S\)를 \(K'\)에 회귀시킨 계수 가운데 \(D\)의 것이다. 수를 넣으면
이다. 곧 \(D\)가 \(1\) 늘 때 \(S\)가 \(0.0265\) 느는 아주 약한 연관이 있고, 이것이 \(\beta_S = -1.01\)을 타고 \(0.02645 \times (-1.00971) = -0.02670\)의 편향을 만든다. \(+0.01367\)에 더하면 \(-0.0130\)이다. 참 효과가 \(0.014\)밖에 안 되는 계수는 \(0.026\)짜리 공선성만으로도 부호가 뒤집힌다.
(3) Location만 넣은 모형에서는 \(D\)가 빠진 것이므로
이다. \(\delta'\)는 \(\delta\)의 \(29\)배인데도 편향은 \(0.7746 \times 0.01367 = 0.0106\)로 \(\beta_S\)의 \(1\%\)에 지나지 않는다. 곱하는 상대 \(\beta_D\)가 작기 때문이다.
두 수가 모순이 아님은 잔차화로 보인다. \(\tilde S, \tilde D\)를 각각 \(K\)(공통으로 남긴 상수항·MedInc·AveRooms·AveOccup)에 회귀시킨 잔차라 하면
이다. 수로는 \(0.02645 \times 0.7746 = 0.02049\), 곧 \(\lvert \tilde r \rvert = 0.1431\)다. \([0,1]\) 안의 값이므로 두 \(\delta\)는 양립한다. 비 \(\delta'/\delta = \lVert \tilde D \rVert^2/\lVert \tilde S \rVert^2 = 29.3\)인데, 보기 5 의 \(\operatorname{sd}(D)/\operatorname{sd}(S) = 2.0304/0.4069 = 4.99\)를 제곱하면 \(24.9\)다. 두 수의 차이는 \(K\)를 통제한 몫이며 자릿수가 같다. 요컨대 \(S\)와 \(D\)의 얽힘은 \(\lvert \tilde r \rvert = 0.143\) 하나로 요약되는데, 그 하나가 \(S\)의 계수에는 \(1\%\)의 편향을, \(D\)의 계수에는 부호를 뒤집는 편향을 준다.
보기 4 의 "둘 중 하나라도 0 이면 편향이 없다"의 반대쪽을 보여 주는 셈이다. 편향의 절대 크기는 \(\delta\beta\)로 같은 공선성에서 나오지만, 아픈 쪽은 자기 계수에 견주어 그 곱이 큰 쪽이다. 작은 계수는 작은 공선성에도 부서진다.
연습문제 9. 핵심 개념 2 는 "비슷한 자료에 대한 예측은 여전히 신뢰할 만하다"고 했고, 보기 2 는 \(\hat{\mathbf y}\)의 분산 합이 \(\sigma^2 \operatorname{tr}(H) = p\sigma^2\)로 공선성과 무관하다고 했다. 그 단서 "비슷한"을 수로 재자. 아래에서 \(\mathbf X_c\)는 중심화한 설계행렬, \(d_1 \ge \cdots \ge d_5\)는 보기 6 의 고윳값, \(\mathbf v_k\)는 대응하는 단위 고윳벡터다. 이 자료의 평균은 Latitude \(35.63\), Longitude \(-119.57\)이다.
(1) \(\operatorname{Var}(\hat y_i) = \sigma^2 h_{ii}\)이고 \(\sum_i h_{ii} = p\)임을 보이시오.
(2) 새 점 \(\mathbf x_0\)(중심화 좌표)에서 \(\operatorname{Var}(\mathbf x_0^\top \hat{\boldsymbol\beta}) = \sigma^2 \mathbf x_0^\top (\mathbf X_c^\top \mathbf X_c)^{-1}\mathbf x_0\)이고 \(\mathbf x_0 = \mathbf v_k\)이면 그 값이 \(\sigma^2/d_k\)임을 보이시오. 길이가 같은 두 방향 사이에서 이 분산의 최대 비를 이 자료에서 구하시오.
(3) 보기 5 의 \(\operatorname{sd}(S) = 0.4069\), \(\operatorname{sd}(D) = 2.0304\)를 써서, 위도와 경도를 같은 쪽으로 \(1\)도씩 옮긴 점과 반대쪽으로 \(1\)도씩 옮긴 점이 자료 구름에서 각각 몇 표준편차인지 재시오. 또 위도 \(40\), 경도 \(-117\)인 점이 각 좌표만 보면 자료 범위 안인데 \(S\)로 재면 몇 표준편차인지 구하고, "비슷한 자료"가 무엇을 뜻하는지 한 줄로 쓰시오.
풀이
(1) \(\hat{\mathbf y} = H\mathbf y\)이고 \(H = \mathbf X(\mathbf X^\top\mathbf X)^{-1}\mathbf X^\top\)는 대칭 멱등이다. \(\operatorname{Var}(\mathbf y) = \sigma^2 \mathbf I\)이므로
이고 대각원소를 읽으면 \(\operatorname{Var}(\hat y_i) = \sigma^2 h_{ii}\)다. 또
이다. \((\mathbf X^\top\mathbf X)^{-1}\)이 아무리 험한 행렬이어도 대각합은 \(p\)로 고정된다. 공선성이 들어올 틈이 없다. 완전모형은 \(p = 6\)(상수항 포함)이고 \(n = 20640\)이므로 관측점에서의 평균 예측분산은
로, 설명변수들이 얼마나 얽혔는지와 무관하다.
(2) \(\operatorname{Var}(\hat{\boldsymbol\beta}) = \sigma^2 (\mathbf X_c^\top \mathbf X_c)^{-1}\)이므로
이다. \(\mathbf x_0 = \mathbf v_k\)를 넣으면 \((\mathbf X_c^\top\mathbf X_c)^{-1}\mathbf v_k = d_k^{-1}\mathbf v_k\)이고 \(\mathbf v_k^\top \mathbf v_k = 1\)이므로 값이 \(\sigma^2/d_k\)다. 길이 \(1\)의 방향들 가운데 최대는 \(k = 5\), 최소는 \(k = 1\)이고 비는
이다. 수로는 가장 나쁜 방향이 \(1.805 \times 10^{-4}\sigma^2\), 가장 좋은 방향이 \(4.49 \times 10^{-7}\sigma^2\)다. 자료에서 같은 거리를 움직였는데도 예측의 불확실성이 \(402\)배 다르다.
(3) \((\Delta L_1, \Delta L_2) = (1,1)\)이면 \(S\)가 \(1\) 변하고 \(D\)는 그대로이므로 그 점은
만큼 벗어난다. \((1,-1)\)이면 \(D\)가 \(1\) 변하므로
다. 같은 유클리드 거리를 움직였는데 한쪽이 다섯 배 더 "자료 밖"이다(\(2.0304/0.4069 = 4.99\)로 (2)의 \(\sqrt{401.8} = 20\)보다는 작다. 두 좌표 평면 안에서만 재었고 다른 세 변수를 통제하지 않았기 때문이다).
위도 \(40\), 경도 \(-117\)인 점을 보자. 캘리포니아의 위도는 대략 \(32.5\)에서 \(42\), 경도는 \(-124.3\)에서 \(-114.3\)이므로 두 좌표 모두 각각으로는 자료 범위 안이다. 그런데
이므로
다. 참고로 \(D\) 쪽은 \(D_0 = 78.5\), \(\bar D = 77.60\)으로 \((78.5 - 77.60)/2.0304 = 0.44\) 표준편차에 불과하다. 한 좌표도 범위를 벗어나지 않았는데 결합으로는 \(8.5\) 표준편차 밖이다. 그 점은 캘리포니아 북동 모서리 밖, 네바다 사막이다.
그러므로 "비슷한 자료"는 "각 변수가 관측된 범위 안"이 아니라 "변수들 사이의 선형관계를 그대로 지키는"이라는 뜻이다. 공선성은 예측을 평균적으로 해치지 않지만, 자료가 얇은 방향으로 한 걸음 나가는 순간 분산이 수백 배가 되고 그 걸음은 변수를 하나씩 볼 때는 보이지 않는다.
연습문제 10. 보기 2 는 VIF 로, 보기 7 은 고윳값과 조건수로 같은 자료를 진단했다. 두 진단이 얼마나 묶여 있는지 보자. 설명변수들의 표본상관행렬을 \(\mathbf R\)(\(p \times p\), 양정치), 그 고윳값을 \(\mu_1 \ge \cdots \ge \mu_p > 0\)이라 하고 모형에는 상수항이 있다고 한다.
(1) \(\text{VIF}_j = (\mathbf R^{-1})_{jj}\)임을 보이시오.
(2) 다음을 보이시오.
(3) 보기 7 의 표준화 뒤 설명비율로 \(\mu_5\)를 구하고 (2)의 두 끝을 계산해, 보기 2 의 최대 VIF \(8.1845\)가 그 사이에 드는지 확인하시오.
(4) 보기 1 의 자료는 \(p = 11\), 최대 VIF \(98068.6\)이었고 쌍별 상관은 모두 \(0.36\) 이하였다. (2)로 \(\mu_{11}\)을 가두고 \(\mu_1 \ge 1\)임을 써서 조건수 \(\kappa = \sqrt{\mu_1/\mu_{11}}\)의 하한을 구하시오. 보기 1 의 "상관행렬이 완전히 눈이 멀었다"는 말은 어떻게 고쳐 읽어야 하는가.
풀이
(1) 설명변수를 표준화해도 VIF 는 변하지 않는다. \(R_j^2\)은 척도에 무관하기 때문이다. 표준화한 변수들로 \(X_j\)를 나머지에 회귀시키면 모든 평균이 \(0\)이라 상수항이 떨어지고, 정규방정식은
이다(반응의 분산이 \(1\)이므로 설명된 분산이 그대로 \(R_j^2\)이다). 분할역행렬의 슈어 보수 공식에서 \(\mathbf R^{-1}\)의 \((j,j)\) 원소는
이다(\(R_{jj} = 1\)). 확인삼아 \(p = 2\)를 넣으면 \(\mathbf R^{-1}\)의 대각이 \(1/(1-r^2)\)로 보기 3(1)의 두 변수 공식과 맞는다. VIF 들은 상관행렬의 역행렬의 대각이며, 상관행렬이 가진 정보의 일부다. \(\square\)
(2) 위쪽은 레일리 몫이다 — 대칭행렬 \(A\)와 단위벡터 \(\mathbf e\)에 대해 \(\mathbf e^\top A\mathbf e\)는 \(A\)의 가장 큰 고윳값을 넘지 못한다. \(\mathbf R^{-1}\)의 고윳값이 \(1/\mu_p \ge \cdots \ge 1/\mu_1\)이므로
이고 모든 \(j\)에 대해 성립하므로 최대값에도 성립한다. 아래쪽은 최대값이 평균 이상이라는 사실과 대각합이다.
\(\square\)
두 부등식 모두 \(\mu_p\) 하나에만 걸려 있다. 가장 작은 고윳값을 알면 최대 VIF 를 \(p\)배 안에서 가둘 수 있고, 거꾸로 최대 VIF 를 알면 \(\mu_p\)를 \(p\)배 안에서 가둘 수 있다. 보기 2 의 진단과 보기 7 의 진단은 같은 것을 두 척도로 읽은 셈이다.
(3) \(\operatorname{tr}\mathbf R = p = 5\)이므로 \(\mu_5 = 5 \times 0.012553 = 0.062765\)다. 두 끝은
이고 보기 2 의 최대 VIF \(8.1845\)가 \(3.19 < 8.18 < 15.93\)으로 그 사이에 든다. 조건수도 같은 수들로 나온다. \(\mu_1 = 5 \times 0.386895 = 1.93448\)이므로 \(\kappa = \sqrt{1.93448/0.062765} = 5.55\)로 보기 7 의 \(5.552\)와 같다.
(4) (2)의 위쪽 부등식에서 \(98068.6 \le 1/\mu_{11}\), 아래쪽에서 \(1/(11\mu_{11}) \le 98068.6\)이므로
이다. 한편 \(\operatorname{tr}\mathbf R = p = 11\)이므로 고윳값의 평균이 \(1\)이고 따라서 \(\mu_1 \ge 1\)이다. 그러므로
이다. 관례의 임계값 \(30\)의 \(10\)배가 넘는다. (보기 1 의 VIF 는 상수항 없이 계산되었지만 \(\mathbf Z\)의 열이 거의 평균 \(0\)이라 차이는 무시할 만하다.)
그러므로 보기 1 의 결론은 이렇게 고쳐 읽어야 한다. 눈이 먼 것은 상관행렬이 아니라 상관행렬을 쌍별로 읽는 방식이다. 같은 행렬의 \(\binom{11}{2} = 55\)개 비대각 칸을 아무리 훑어도 \(0.36\) 이상은 나오지 않지만, 그 행렬의 고윳값 \(11\)개를 보면 \(\mu_{11} \le 10^{-5}\), \(\kappa \ge 313\)으로 즉시 걸린다. 공선성은 상관행렬의 한 칸이 아니라 거의 영인 고윳방향이라는 전역적 성질이고, 이를 읽는 척도가 VIF 와 조건수다. 둘은 (2)에서 본 대로 \(p\)배 안에서 같은 말을 한다.
정리하며
다중공선성을 이해하는 일은 실무에서 통계 방법을 올바르게 적용하는 데 필수적이다. VIF로 탐지하고, 모형화 목표에 어떤 결과를 미치는지 이해하며, 맥락에 맞는 대책을 고르라.
다음 쪽 영향점과 지렛대 (쿡 거리, DFFITS)로 넘어간다. 다중공선성이 설명변수들끼리의 문제라면, 거기서는 관측값 하나가 적합 전체를 끌고 가는 자리를 본다.