일표본 비율 신뢰구간의 계산
개요
이 페이지에서는 단일 모비율 \(p\)의 신뢰구간을 실제로 계산하는 방법을 다룬다. 네 가지 방법 — Wald 구간, Wilson score 구간, Agresti–Coull 구간, Clopper–Pearson 정확 구간 — 을 다룬다. Python 구현은 성공/실패 개수나 0/1 값이 담긴 CSV 파일 어느 쪽이든 받으며 임의의 신뢰수준을 지원한다.
Wald 구간
독립인 베르누이 시행 \(n\)번에서 성공이 \(k\)번이면 표본비율은 \(\hat{p} = k/n\)이다. Wald \((1-\alpha)100\%\) 신뢰구간은
가장 단순한 방법이지만 \(n\)이 작거나 \(\hat{p}\)가 0 또는 1에 가까우면 이항분포에 대한 정규근사가 무너지므로 포함확률이 크게 부족할 수 있다.
Wilson score 구간
Wilson 구간은 score 검정을 뒤집어 얻는다. \(z = z_{\alpha/2}\)라 하면 구간의 끝점은
분모 \(1 + z^2/n\)이 구간을 \(1/2\) 쪽으로 축소하여 \(p\)의 전 범위에서 포함확률을 개선한다. Wilson 구간은 대부분의 실무에서 권장되는 기본값이다.
Agresti–Coull 구간
가상의 성공 \(z^2/2\)개와 가상의 실패 \(z^2/2\)개를 더해 보정된 양을 만든다:
그다음 \(\tilde{p}\)와 \(\tilde{n}\)으로 Wald 공식을 적용한다:
95% 수준에서는 성공과 실패를 각각 약 2개씩 더하는 셈이다("plus-four" 규칙). 계산이 더 간단하면서도 포함확률은 Wilson과 매우 가깝다.
Clopper–Pearson (정확) 구간
Clopper–Pearson 구간은 베타 분위수로 두 개의 단측 이항검정을 뒤집는다:
\(k = 0\)이면 하한을 0으로, \(k = n\)이면 상한을 1로 두는 관례를 따른다. 이 구간은 모든 \(p\)에서 적어도 \((1-\alpha)100\%\)의 포함확률을 보장하지만 (필요보다 넓게) 보수적이다.
CSV에서 자료 읽기
보기 1. CSV에서 자료 읽기. 베르누이 자료가 담긴 CSV 파일에 1,0,0,1,0 과 1,0,0,0,0 두 줄이 적혀 있다.
(1) 표본크기 \(n\), 성공 횟수 \(k\), 표본비율 \(\hat p\)를 구하시오.
(2) 0/1 값을 읽는 함수를 만들어 (1)을 확인하시오. 함수가 0 과 1 이 아닌 값을 만났을 때 끊어야 하는 까닭을 구체적인 예로 보이시오.
풀이
(1) 세는 것이 전부다. 값은 열 개이므로 \(n = 10\)이고, \(1\)인 것이 세 개이므로 \(k = 3\), 따라서
이다. 비율 자료의 요약은 \((n, k)\) 두 수로 끝난다. 평균의 구간에서는 \(\bar x\)와 \(s\)를 따로 구해야 했지만, 베르누이에서는 분산 \(p(1-p)\)가 평균에 딸려 오므로 표준오차까지 이 두 수에서 나온다. 그러므로 원자료를 읽는 일의 전부는 이 두 수를 바르게 세는 것이다.
(2) 구현과 확인.
import csv
import numpy as np

def load_data(csv_path):
    """비율 추정을 위해 CSV에서 0/1 값을 읽는다."""
    arr = []
    with open(csv_path, "r", newline="") as f:
        reader = csv.reader(f)
        for row in reader:
            for item in row:
                item = item.strip()
                if item:
                    v = float(item)
                    # 0과 1 외의 값이 섞이면 여기서 끊는다.
                    # 그냥 두면 sum()이 성공 횟수가 아니게 되어
                    # p_hat이 1을 넘는 식으로 조용히 망가진다.
                    if v not in (0, 1):
                        raise ValueError("CSV must contain only 0/1 values.")
                    arr.append(v)
    if len(arr) == 0:
        raise ValueError("No values found in CSV.")
    return np.array(arr, dtype=float)


# 임시 파일로 확인한다. 성공 횟수 k와 표본크기 n만 있으면 구간을 만들 수 있다.
import tempfile, os
with tempfile.TemporaryDirectory() as d:
    path = os.path.join(d, "bernoulli.csv")
    with open(path, "w") as f:
        f.write("1,0,0,1,0\n1,0,0,0,0\n")
    y = load_data(path)
print(f"n = {len(y)}, k = {int(y.sum())}, p_hat = {y.mean()}")
출력:
n = 10, k = 3, p_hat = 0.3
(1)과 맞는다. \(n = 10\), \(k = 3\), \(\hat p = 0.3\) 이다. 줄을 어떻게 나누었든 값의 개수와 합만 세므로 결과가 같다.
0/1 이 아닌 값에서 끊어야 하는 까닭. 이 함수가 하는 일은 결국 len 과 sum 두 가지인데, sum 이 성공 횟수라는 보장은 값이 0/1 일 때만 성립한다. 다른 값이 섞이면 조용히 틀린다.
- 값 하나가
2라면 \(k = 4\), \(\hat p = 0.4\) 가 된다. 그럴듯한 수라서 알아챌 길이 없다. - 결측을
99로 코딩한 자료가 섞이면 \(k = 102\), \(\hat p = 10.2\) 가 된다. 이때 표준오차 안의 \(\hat p(1-\hat p) = 10.2 \times (-9.2) = -93.84\) 가 음수가 되어 \(\sqrt{\cdot}\) 가nan을 준다. 구간이(nan, nan)으로 나오므로 그나마 눈에 띈다.
눈에 띄는 쪽이 운이 좋은 경우다. 첫째 예처럼 틀린 값이 유효 범위 안에 떨어지면 끝까지 아무 신호가 없다. 그래서 검사를 계산 뒤가 아니라 읽는 자리에 둔다.
신뢰구간의 계산
보기 2. 비율 신뢰구간 계산기 — 네 방법. 시행 \(n = 50\)번에서 성공이 \(k = 12\)번 나왔다.
(1) 네 구간을 \(95\%\)에서 모두 계산하시오. 윌슨 구간과 아그레스티–쿨 구간의 중심이 정확히 같다는 것을 보이고, 두 구간이 갈라지는 곳이 어디인지 닫힌 꼴로 적으시오.
(2) 네 구간의 폭을 비교하시오. "보수적인 구간이 넓다"는 통념이 어디까지 맞는가.
풀이
(1) 네 구간. \(\hat p = 12/50 = 0.24\), \(z = 1.95996\), \(z^2 = 3.84146\), \(\tilde n = n + z^2 = 53.84146\) 이다.
왈드. \(\text{SE} = \sqrt{0.24 \times 0.76/50} = 0.0603987\), \(\text{MOE} = 0.1183793\) 이므로 \((0.1216,\ 0.3584)\).
윌슨. 중심과 반폭이
이므로 \((0.1430,\ 0.3741)\).
아그레스티–쿨. \(\tilde p = (k + z^2/2)/\tilde n = 13.92073/53.84146 = 0.2585504\), 반폭 \(z\sqrt{\tilde p(1-\tilde p)/\tilde n} = 0.1169475\) 이므로 \((0.1416,\ 0.3755)\).
클로퍼–피어슨. \(\text{Beta}(0.025;\ 12,\ 39) = 0.1306\), \(\text{Beta}(0.975;\ 13,\ 38) = 0.3817\) 이므로 \((0.1306,\ 0.3817)\).
중심이 같은 것은 우연이 아니다. 윌슨 중심의 분자와 분모에 \(n\)을 곱하면
로 아그레스티–쿨의 \(\tilde p\)와 같은 식이다. 둘 다 성공 \(z^2/2 = 1.92\)회와 실패 \(1.92\)회를 가상으로 더한 비율이고, \(95\%\)에서 이것을 \(2\)로 반올림한 것이 "plus-four" 규칙이다.
갈라지는 곳은 반폭 하나뿐이다. 두 반폭을 같은 분모 \(\tilde n\)으로 정리하면
이다(윌슨 쪽은 \(\frac{z}{1+z^2/n} = \frac{zn}{\tilde n}\) 임을 쓰고 \(n\)을 근호 안으로 넣으면 나온다). 근호 안을 비교하면 \(10.0804\) 대 \(10.3211\) 로 아그레스티–쿨이 조금 크다. 윌슨은 산포를 관측된 \(k\)로 재고, 아그레스티–쿨은 \(1/2\) 쪽으로 당겨진 \(\tilde p\)로 재기 때문이다. \(\tilde p\)가 \(0.5\)에 더 가까우므로 \(\tilde p(1-\tilde p)\)가 더 크다.
(2) 폭. 네 구간의 폭은
| 방법 | 구간 | 폭 | 윌슨 대비 |
|---|---|---|---|
| 왈드 | \((0.1216,\ 0.3584)\) | \(0.2368\) | \(1.024\) |
| 윌슨 | \((0.1430,\ 0.3741)\) | \(0.2312\) | 기준 |
| 아그레스티–쿨 | \((0.1416,\ 0.3755)\) | \(0.2339\) | \(1.012\) |
| 클로퍼–피어슨 | \((0.1306,\ 0.3817)\) | \(0.2511\) | \(1.086\) |
통념이 맞는 것은 클로퍼–피어슨뿐이다. 폭이 윌슨보다 \(8.6\%\) 넓고, 그 대가로 모든 \(p\)에서 포함률 \(0.95\) 이상을 보장한다. 여기서는 "보수적 = 넓다"가 성립한다.
왈드는 통념에 맞지 않는다. 포함률이 가장 나쁜데 폭은 윌슨보다 \(2.4\%\) 넓다. 좁아서 부정확한 것이 아니라 엉뚱한 자리에 놓여서 부정확하다는 뜻이다.
다만 왈드가 언제나 더 넓은 것은 아니다. 두 폭의 비를 풀면 \(n = 50\)에서 \(\hat p\)가
일 때 윌슨이 더 좁고, 그 바깥에서만 왈드가 좁아진다. 그런데 그 바깥이 바로 \(\sqrt{\hat p(1-\hat p)}\)가 작아져 왈드가 무너지는 자리다. 왈드가 좁아지는 곳과 왈드가 실패하는 곳이 같은 곳이다.
확인.
import math
from scipy.stats import norm, beta

def ci_proportion(k, n, method="wilson", cl=0.95):
    """모비율에 대한 일표본 신뢰구간. 네 가지 방법을 한 함수에 모았다.

    기본값이 wald가 아니라 wilson인 것에 주의하라.
    Wald는 교과서에 먼저 나오지만 실무 기본값으로 삼을 만한 방법이 아니다.

    k : 성공 횟수
    n : 표본크기
    method : 'wald', 'wilson', 'ac', 'cp'
    cl : 신뢰수준 (기본 0.95)
    """
    alpha = 1 - cl
    z = norm.ppf(1 - alpha / 2)
    phat = k / n

    if method == "wald":
        se = math.sqrt(phat * (1 - phat) / n)
        lo = phat - z * se
        hi = phat + z * se
    elif method == "wilson":
        denom = 1 + z * z / n
        center = (phat + z * z / (2 * n)) / denom
        half = z * math.sqrt(phat * (1 - phat) / n + z * z / (4 * n * n)) / denom
        lo, hi = center - half, center + half
    elif method == "ac":
        n_tilde = n + z * z
        p_tilde = (k + 0.5 * z * z) / n_tilde
        se_tilde = math.sqrt(p_tilde * (1 - p_tilde) / n_tilde)
        lo = p_tilde - z * se_tilde
        hi = p_tilde + z * se_tilde
    else:  # cp (Clopper-Pearson)
        # 정규근사를 아예 쓰지 않고 이항분포를 직접 뒤집는다.
        # Beta가 나오는 것은 이항 꼬리확률과 Beta 누적분포가 같은 식이기 때문이다.
        # k=0이나 k=n이면 한쪽 Beta의 모수가 0이 되어 정의되지 않으므로 관례를 따른다.
        lo = 0.0 if k == 0 else beta.ppf(alpha / 2, k, n - k + 1)
        hi = 1.0 if k == n else beta.ppf(1 - alpha / 2, k + 1, n - k)

    # Wald는 끝점이 [0,1]을 벗어날 수 있다. 나머지 셋은 그럴 일이 없다.
    lo = max(0.0, lo)
    hi = min(1.0, hi)
    return lo, hi

# 50번 중 12번 성공에 대한 95% Wilson 구간
lo, hi = ci_proportion(k=12, n=50, method="wilson", cl=0.95)
print(f"95% Wilson CI: ({lo:.4f}, {hi:.4f})")

# 같은 자료의 99% Clopper-Pearson 구간
lo, hi = ci_proportion(k=12, n=50, method="cp", cl=0.99)
print(f"99% Clopper-Pearson CI: ({lo:.4f}, {hi:.4f})")

# (1),(2) 신뢰수준을 95%로 맞추고 네 방법을 나란히 둔다.
print()
print(f"{'방법':>6}{'하한':>10}{'상한':>10}{'중심':>10}{'폭':>10}{'윌슨대비':>10}")
base = None
for name in ("wald", "wilson", "ac", "cp"):
    lo, hi = ci_proportion(k=12, n=50, method=name, cl=0.95)
    if name == "wilson":
        base = hi - lo
for name in ("wald", "wilson", "ac", "cp"):
    lo, hi = ci_proportion(k=12, n=50, method=name, cl=0.95)
    print(f"{name:>6}{lo:>10.4f}{hi:>10.4f}{(lo + hi) / 2:>10.7f}"
          f"{hi - lo:>10.4f}{(hi - lo) / base:>10.3f}")
출력:
95% Wilson CI: (0.1430, 0.3741)
99% Clopper-Pearson CI: (0.1056, 0.4255)

    방법        하한        상한        중심         폭      윌슨대비
  wald    0.1216    0.3584 0.2400000    0.2368     1.024
wilson    0.1430    0.3741 0.2585504    0.2312     1.000
    ac    0.1416    0.3755 0.2585504    0.2339     1.012
    cp    0.1306    0.3817 0.2561503    0.2511     1.086
(1)과 (2)가 모두 맞는다. 네 구간의 끝점과 폭이 손 계산과 같고, 윌슨과 아그레스티–쿨의 중심이 소수 일곱째 자리까지 \(0.2585504\) 로 같다. 왈드의 중심만 \(\hat p = 0.24\) 그대로다. 클로퍼–피어슨의 중심 \(0.2562\) 는 셋 중 어느 것과도 다른데, 이 구간은 중심을 먼저 정하고 폭을 더하는 꼴로 만들어진 것이 아니라 양쪽 꼬리를 따로 뒤집어 만든 것이라 대칭일 이유가 없기 때문이다.
폭의 비도 표와 같다. 왈드 \(1.024\), 아그레스티–쿨 \(1.012\), 클로퍼–피어슨 \(1.086\) 이다.
두 구간의 신뢰수준이 다르므로 너비를 곧바로 비교할 수는 없다. 같은 95%로 맞추면 Wilson이 \((0.1430, 0.3741)\), Clopper–Pearson이 \((0.1306, 0.3817)\)로 후자가 약 9% 넓다. 이것이 "모든 \(p\)에서 95% 아래로 내려가지 않는다"는 보장의 값이다.
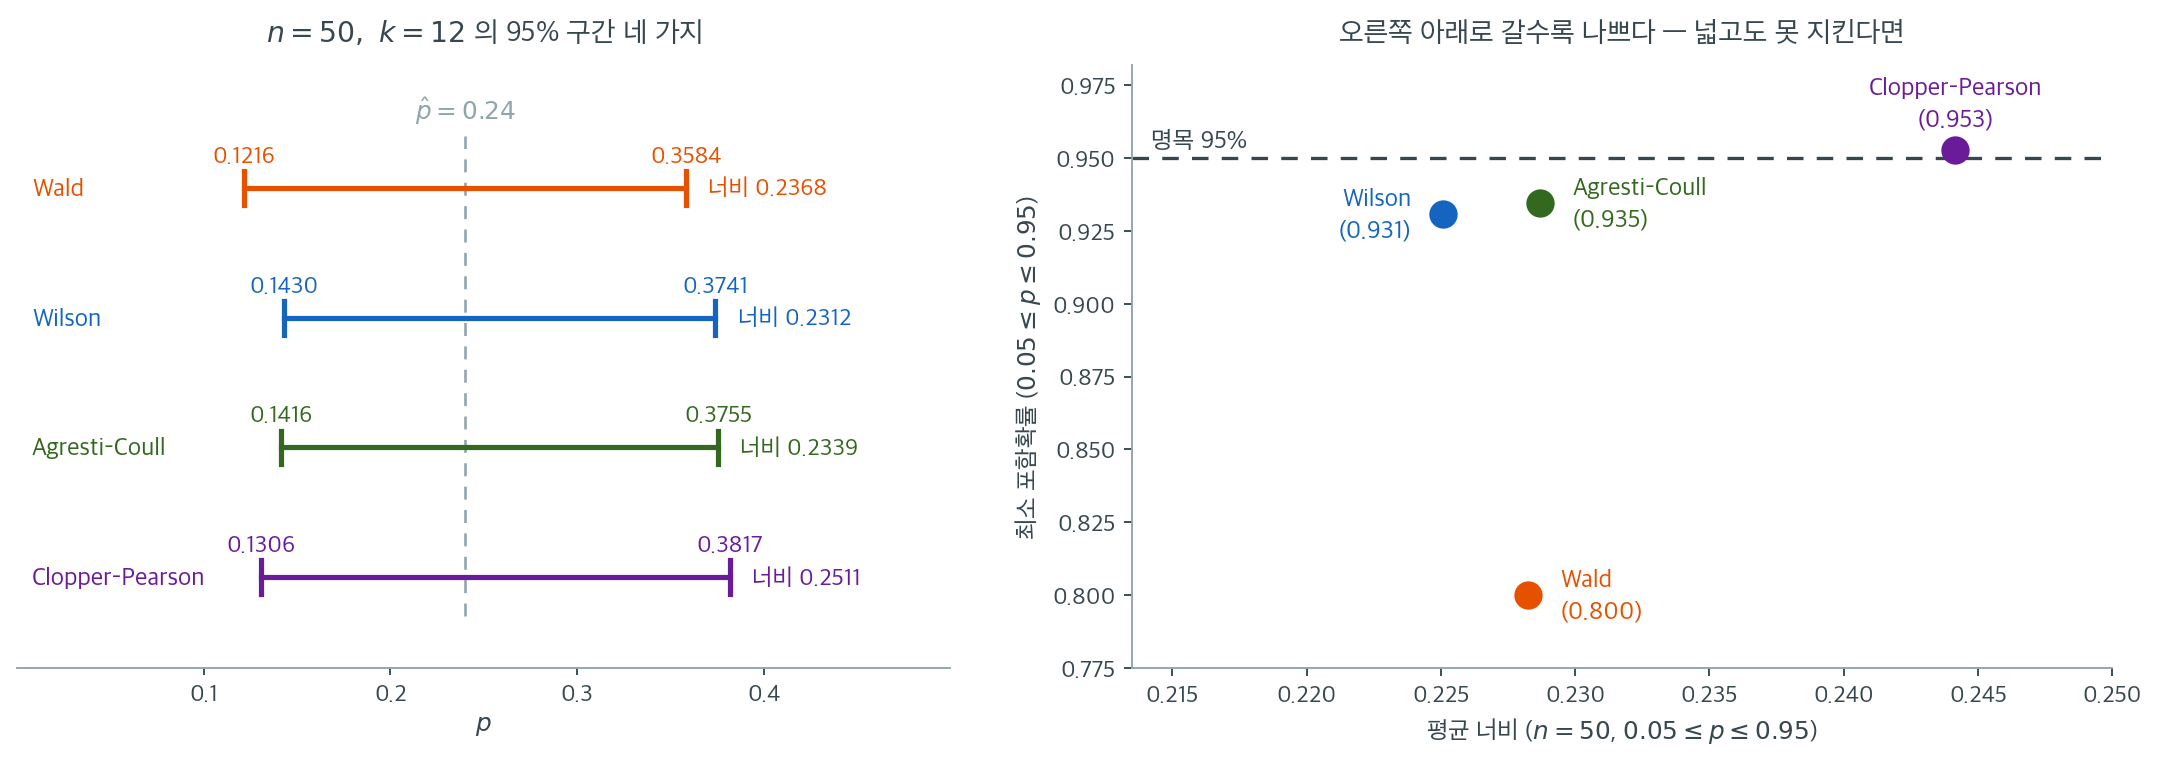
왼쪽은 \(n = 50\), \(k = 12\)라는 하나의 자료에 네 방법을 모두 적용한 결과다. Wald \((0.1216,\ 0.3584)\), Wilson \((0.1430,\ 0.3741)\), Agresti–Coull \((0.1416,\ 0.3755)\), Clopper–Pearson \((0.1306,\ 0.3817)\). 네 구간이 꽤 닮아 보이지만 위치가 조금씩 다르다. Wald만 \(\hat p = 0.24\)를 정확히 가운데 두고, 나머지 셋은 중심이 오른쪽(곧 \(0.5\) 쪽)으로 밀려 있다. 자료 하나만 보아서는 어느 쪽이 옳은지 판단할 방법이 없다.
판단은 오른쪽 그림처럼 모든 \(p\)를 한꺼번에 볼 때만 가능하다. 가로축은 평균 너비, 세로축은 \(0.05 \le p \le 0.95\) 구간에서의 최소 포함확률이다. 좋은 방법은 왼쪽 위(좁으면서 약속을 지킴)에 있다. Clopper–Pearson만 95% 선 위에 있고(\(0.953\)), 그 대가로 평균 너비 \(0.244\)로 가장 넓다. Wilson은 \(0.931\)까지 내려가지만 너비가 \(0.225\)로 가장 좁고, Agresti–Coull이 \(0.935\)와 \(0.229\)로 그 사이에 있다. Wald는 너비가 \(0.228\)로 Wilson보다도 넓으면서 최소 포함확률이 \(0.800\)이다. 넓기까지 한데 약속도 못 지킨다 — 오른쪽 아래, 고를 이유가 없는 자리다.
이 그림이 "Clopper–Pearson은 보수적이다"라는 말의 정확한 뜻이다. 95% 보장은 가장 나쁜 \(p\)에서도 95%를 지킨다는 뜻이고, 그러려면 대부분의 \(p\)에서는 95%보다 넉넉히 덮어야 한다. 실제로 같은 자료에서 Clopper–Pearson의 너비 \(0.2511\)은 Wilson의 \(0.2312\)보다 8.6% 넓다. 이것이 보장의 값이다.
그래서 기본값을 고를 때의 기준은 "누가 이기는가"가 아니라 어떤 실패를 감당할 수 있는가이다. 규제나 안전처럼 명목 수준을 반드시 지켜야 하면 Clopper–Pearson, 일반적인 보고에는 Wilson, 손으로 계산해야 하면 Agresti–Coull이다. ci_proportion의 기본값이 wald가 아니라 wilson인 것은 이 그림에서 Wald가 놓인 자리 때문이다.
명령줄 사용법
함께 제공되는 스크립트 ci_prop_calc.py는 명령줄 인자를 지원한다:
# 도수로부터 Wilson 구간
python ci_prop_calc.py --k 12 --n 50 --method wilson

# 0/1 값이 든 CSV 로부터 Clopper-Pearson 구간
python ci_prop_calc.py --csv bernoulli.csv --method cp

# 신뢰수준 99%
python ci_prop_calc.py --k 12 --n 50 --method wilson --cl 0.99
해석
- Wald 구간은 계산하기 쉽지만 \(\hat{p}\)가 0이나 1에 가까우면 말이 안 되는 결과(음수인 끝점이나 1을 넘는 끝점)를 낼 수 있다. 끝점을 \([0, 1]\)로 자르더라도 이런 경우 포함확률은 여전히 나쁘다.
- Wilson score 구간은 중심을 \(1/2\) 쪽으로 조정하며 일반적인 용도로 권장된다. 표본크기가 중간이거나 비율이 극단적이어도 좋은 포함확률을 유지한다.
- Agresti–Coull 구간은 표본크기를 \(z^2\)만큼 부풀리고 \(\hat{p}\)를 다시 중심화하는 더 간단한 장치로 Wilson에 필적하는 포함확률을 얻는다. 손으로 계산하기 쉬워야 할 때 실용적인 선택이다.
- Clopper–Pearson 구간은 모든 \(p\)에서 적어도 \((1-\alpha)100\%\)의 포함확률을 보장하는 유일한 방법이지만 그 대가로 너비가 커진다. \(n\)이 크면 보수성이 약하지만 \(n\)이 작으면 상당할 수 있다.
연습문제
연습문제 1. 품질관리 표본에서 200개 중 8개가 불량이다. 불량률 \(p\)의 95% Wald와 Wilson 신뢰구간을 계산하라. 차이를 논하라.
풀이
여기서 \(k = 8\), \(n = 200\), \(\hat{p} = 0.04\), \(z = 1.96\)이다.
Wald: \(\text{SE} = \sqrt{0.04 \times 0.96 / 200} = \sqrt{0.000192} = 0.01386\). 신뢰구간: \(0.04 \pm 1.96 \times 0.01386 = 0.04 \pm 0.02716 = (0.0128, 0.0672)\).
Wilson: 분모: \(1 + 1.96^2/200 = 1 + 0.01921 = 1.01921\). 중심: \((0.04 + 3.8416/400)/1.01921 = 0.04960/1.01921 = 0.04868\). 반너비: \(1.96 \times \sqrt{0.04 \times 0.96/200 + 3.8416/160000}/1.01921 = 1.96 \times \sqrt{0.000192 + 0.000024}/1.01921 = 1.96 \times 0.01470/1.01921 = 0.02826\). 신뢰구간: \((0.0204, 0.0770)\).
Wilson 구간은 오른쪽으로 옮겨져 있고(중심 0.049 대 0.040) 약간 더 넓다. \(n\hat{p} = 8 < 10\)이므로 Wald 구간의 바탕인 정규근사가 아슬아슬하며, Wilson 구간이 더 믿을 만한 포함확률을 준다. \(\square\)
연습문제 2. \(\hat{p} = 0\)이거나 \(\hat{p} = 1\)일 때 Wald 구간의 너비가 0임을 보이고 왜 문제인지 설명하라.
풀이
\(\hat{p} = 0\)(즉 \(k = 0\))이면 표준오차는
이므로 Wald 구간이 한 점 \([0, 0]\)으로 무너진다. \(\hat{p} = 1\)일 때도 마찬가지로 구간이 \([1, 1]\)이 된다.
이것이 문제인 이유는 \(n\)번 시행에서 성공을 \(k = 0\)번 관측했다고 해서 \(p = 0\)이 확실한 것은 아니기 때문이다. 예를 들어 \(p = 0.01\)이고 \(n = 50\)이면 \(k = 0\)을 관측할 확률이 \((1 - 0.01)^{50} \approx 0.605\)로 결코 무시할 수 없다. 0에서 퇴화한 구간은 \(p\)의 어떤 양수 값도 담지 못하므로 포함확률이 명목 수준보다 크게 떨어진다. Wilson과 Clopper–Pearson 방법은 \(k = 0\)이나 \(k = n\)일 때도 너비가 양수인 구간을 만들어 이 퇴화를 피한다. \(\square\)
연습문제 3. 어떤 조사에서 응답자 1000명 중 540명이 어떤 정책을 지지한다. 네 가지 방법(Wald, Wilson, Agresti–Coull, Clopper–Pearson)으로 95% 신뢰구간을 계산하고 너비를 비교하라.
풀이
여기서 \(k = 540\), \(n = 1000\), \(\hat{p} = 0.54\), \(z = 1.96\)이다.
Wald: \(\text{SE} = \sqrt{0.54 \times 0.46/1000} = \sqrt{0.000248} = 0.01576\). 신뢰구간: \(0.54 \pm 0.03089 = (0.5091, 0.5709)\). 너비 = 0.0618.
Wilson: 분모 \(= 1 + 3.8416/1000 = 1.003842\). 중심 \(= (0.54 + 0.001921)/1.003842 = 0.5398\). 반너비 \(= 1.96 \times \sqrt{0.000248 + 0.00000096}/1.003842 = 1.96 \times 0.01578/1.003842 = 0.03082\). 신뢰구간: \((0.5090, 0.5706)\). 너비 = 0.0616.
Agresti–Coull: \(\tilde{n} = 1003.84\), \(\tilde{p} = (540 + 1.9208)/1003.84 = 0.5398\). 표준오차 \(= \sqrt{0.5398 \times 0.4602/1003.84} = 0.01574\). 신뢰구간: \(0.5398 \pm 0.03085 = (0.5090, 0.5707)\). 너비 = 0.0617.
Clopper–Pearson: \(L = \text{Beta}(0.025;\,540,\,461) = 0.5087\). \(U = \text{Beta}(0.975;\,541,\,460) = 0.5712\). 너비 = 0.0625.
\(n = 1000\)이고 \(\hat{p}\)가 \(0.5\) 근처이므로 네 방법이 거의 같은 구간을 준다. Clopper–Pearson이 조금 더 넓다(0.0625 대 나머지 약 0.0617). \(n\)이 크고 \(p\)가 경계에서 멀면 방법의 선택이 거의 중요하지 않다. \(\square\)
연습문제 4. 어떤 임상시험에서 환자 30명 중 중대한 이상반응이 0건이다. Clopper–Pearson 방법으로 \(p\)의 단측 95% 상한을 계산하고 "3의 법칙" 근사를 진술하라.
풀이
\(k = 0\), \(n = 30\)이면 Clopper–Pearson 양측 95% 구간의 하한은 0이다. 상한은:
더 정확히는 \(U = \text{Beta}(0.975;\, 1,\, 30) = 1 - 0.025^{1/30}\)을 쓴다. 계산하면 \(\ln(0.025)/30 = -3.6889/30 = -0.12296\)이므로 \(U = 1 - e^{-0.12296} = 1 - 0.8843 = 0.1157\)이다.
단측 95% 상한(위쪽 꼬리에만 \(\alpha = 0.05\)를 두는 경우)은:
3의 법칙은 빠른 근사를 준다: \(k = 0\)일 때 95% 단측 상한은 대략 \(3/n\)이다. 여기서는 \(3/30 = 0.10\)으로 정확한 값 0.0951에 가깝다. 3의 법칙은 근사 \(1 - \alpha^{1/n} \approx -\ln(\alpha)/n\)과 \(-\ln(0.05) \approx 3\)이라는 사실에서 나온다. \(\square\)
연습문제 5. 95% 수준에서 \(k = 7\), \(n = 25\)일 때 Wilson과 Agresti–Coull 구간이 거의 같음을 수치로 확인하고, 왜 가깝지만 정확히 같지는 않은지 대수적으로 설명하라.
풀이
\(k = 7\), \(n = 25\), \(\hat{p} = 0.28\), \(z = 1.96\)일 때:
Wilson: 분모 \(= 1 + 3.8416/25 = 1.15366\). 중심 \(= (0.28 + 0.07683)/1.15366 = 0.3093\). 반너비 \(= 1.96 \times \sqrt{0.28 \times 0.72/25 + 3.8416/2500}/1.15366 = 1.96 \times \sqrt{0.008064 + 0.001537}/1.15366 = 1.96 \times 0.09798/1.15366 = 0.1664\). 신뢰구간: \((0.1429, 0.4757)\).
Agresti–Coull: \(\tilde{n} = 25 + 3.8416 = 28.8416\). \(\tilde{p} = (7 + 1.9208)/28.8416 = 0.3093\). 표준오차 \(= \sqrt{0.3093 \times 0.6907/28.8416} = \sqrt{0.007408} = 0.08607\). 신뢰구간: \(0.3093 \pm 1.96 \times 0.08607 = 0.3093 \pm 0.1687 = (0.1406, 0.4780)\).
중심이 사실상 같고(둘 다 0.3093) 반너비는 0.002 정도만 다르다.
대수적 설명. 두 방법 모두 중심을 \(\tilde{p} = (k + z^2/2)/(n + z^2)\)으로 조정한다. Wilson 구간은 정확한 표준오차 \(\sqrt{\hat{p}(1-\hat{p})/n + z^2/(4n^2)}\)을 \(1 + z^2/n\)으로 나누어 쓰는 반면, Agresti–Coull은 \(\sqrt{\tilde{p}(1-\tilde{p})/\tilde{n}}\)을 쓴다. 차이는 Wilson의 반너비가 근호 안에 (보정하지 않은) \(\hat{p}\)를 쓰고 Agresti–Coull은 \(\tilde{p}\)를 쓰는 데서 온다. \(n\)이 적당하면 \(\hat{p}\)와 \(\tilde{p}\)가 가까우므로 두 구간이 거의 일치한다. \(n\)이 아주 작거나 \(\hat{p}\)가 극단적이면 차이가 더 눈에 띈다. \(\square\)
연습문제 6. 제프리스 구간(사전분포 \(\text{Beta}(1/2,1/2)\)의 사후 동등꼬리 구간)을 설명하고, \(n=30\), \(k=3\)에서 윌슨·클로퍼-피어슨과 비교하라.
풀이
구성. 이항가능도에 제프리스 사전분포 \(\text{Beta}(1/2,1/2)\)를 곱하면 사후분포가
이다. 그 2.5% 및 97.5% 분위수를 취한다.
왜 \(\text{Beta}(1/2,1/2)\)인가. 이것이 이항모형의 제프리스 사전분포, 즉 \(\sqrt{I(p)}\propto p^{-1/2}(1-p)^{-1/2}\)에 비례하는 분포다. 모수 변환에 불변이라는 성질을 가져, 로짓으로 다시 매개화해도 같은 결론을 준다.
import numpy as np
from scipy import stats

n, k = 30, 3
z = stats.norm.ppf(0.975)
ph = k / n

jl, jh = stats.beta.ppf([0.025, 0.975], k + 0.5, n - k + 0.5)
d = 1 + z**2 / n
c = (ph + z**2 / (2 * n)) / d
h = z / d * np.sqrt(ph * (1 - ph) / n + z**2 / (4 * n**2))
cl = stats.beta.ppf(0.025, k, n - k + 1)
ch = stats.beta.ppf(0.975, k + 1, n - k)

for name, lo, hi in [("제프리스", jl, jh), ("윌슨", c - h, c + h),
                     ("클로퍼-피어슨", cl, ch)]:
    print(f"{name:12s} ({lo:.4f}, {hi:.4f})  폭 {hi - lo:.4f}")

# k = 0일 때
print()
print(f"k=0 제프리스      (0.0000, {stats.beta.ppf(0.95, 0.5, n + 0.5):.4f})  단측 95% 상한")
print(f"k=0 클로퍼-피어슨 (0.0000, {stats.beta.ppf(0.95, 1, n):.4f})  단측 95% 상한")
제프리스         (0.0290, 0.2434)  폭 0.2144
윌슨           (0.0346, 0.2562)  폭 0.2216
클로퍼-피어슨      (0.0211, 0.2653)  폭 0.2442

k=0 제프리스      (0.0000, 0.0615)  단측 95% 상한
k=0 클로퍼-피어슨 (0.0000, 0.0950)  단측 95% 상한
읽기.
- 제프리스가 가장 좁다. 윌슨보다 3%, 클로퍼-피어슨보다 12% 짧다.
- 세 구간 모두 \((0,1)\) 안에 있다. 왈드와 달리 경계를 넘지 않는다.
- \(k=0\)에서도 유한한 상한을 준다. 다만 클로퍼-피어슨보다 낮아, 덜 보수적이다.
빈도주의 성질. 제프리스는 베이즈 구간이지만 빈도주의 포함확률도 좋다. 평균 포함확률이 명목에 매우 가깝고, 브라운·카이·다스굽타의 비교에서 윌슨과 함께 권장된다.
세 구간의 성격.
| 방법 | 원리 | 성격 |
|---|---|---|
| 윌슨 | 점수검정의 역전 | 빈도주의, 균형 |
| 클로퍼-피어슨 | 정확검정의 역전 | 보장, 보수적 |
| 제프리스 | 베이즈 사후 | 짧음, 평균적으로 정확 |
주의. \(k=0\)일 때 제프리스의 하한은 0이 아니라 아주 작은 양수다(동등꼬리 구간이므로). 실무에서는 \(k=0\)이나 \(k=n\)이면 그쪽 끝을 0 또는 1로 두는 수정판을 쓴다.
연습문제 7. 연속성 수정을 넣은 왈드 구간을 정의하고, 수정이 포함확률과 폭에 어떤 영향을 주는지 \(n=30\)에서 확인하라.
풀이
정의. 이항은 이산인데 정규는 연속이므로, \(\pm\frac1{2n}\)만큼 넓히는 것이 연속성 수정이다.
import numpy as np
from scipy import stats

n, z = 30, stats.norm.ppf(0.975)
k = np.arange(n + 1)
ph = k / n
se = np.sqrt(ph * (1 - ph) / n)

lo0, hi0 = ph - z * se, ph + z * se                       # 왈드
lo1, hi1 = ph - z * se - 1 / (2 * n), ph + z * se + 1 / (2 * n)   # 연속성 수정
d = 1 + z**2 / n
c = (ph + z**2 / (2 * n)) / d
h = z / d * np.sqrt(ph * (1 - ph) / n + z**2 / (4 * n**2))

def cover(lo, hi, p):
    inside = (lo <= p) & (p <= hi)
    return stats.binom.pmf(k, n, p)[inside].sum()

print(f"{'p':>6s} {'왈드':>8s} {'수정 왈드':>10s} {'윌슨':>8s}")
for p in [0.05, 0.10, 0.20, 0.35, 0.50]:
    print(f"{p:6.2f} {cover(lo0, hi0, p):8.4f} "
          f"{cover(lo1, hi1, p):10.4f} {cover(c - h, c + h, p):8.4f}")

w = stats.binom.pmf(k, n, 0.2)
print()
print(f"p=0.2 기대 폭   왈드 {((hi0 - lo0) * w).sum():.4f}  "
      f"수정 {((hi1 - lo1) * w).sum():.4f}  윌슨 {((c + h - (c - h)) * w).sum():.4f}")
     p       왈드      수정 왈드       윌슨
  0.05   0.7821     0.7848   0.9392
  0.10   0.8085     0.9556   0.9742
  0.20   0.9463     0.9463   0.9639
  0.35   0.9113     0.9644   0.9467
  0.50   0.9572     0.9572   0.9572

p=0.2 기대 폭   왈드 0.2782  수정 0.3115  윌슨 0.2721
읽기.
- 수정이 포함확률을 낮추지는 않는다. 구간을 넓히기만 하므로 모든 \(p\)에서 왈드 이상이다.
- 그러나 효과가 들쭉날쭉하다. \(p=0.10\)에서는 0.81 → 0.96으로 크게 좋아지지만, \(p=0.05\)에서는 0.782 → 0.785로 거의 바뀌지 않는다. 경계 근처에서 왈드가 실패하는 근본 원인(\(k\)가 작을 때 구간이 쪼그라드는 것)을 \(\frac1{2n}\) 한 조각으로는 메울 수 없기 때문이다.
- 과잉보정되는 곳도 있다. \(p=0.35\)에서 0.964로 윌슨(0.947)보다 보수적이다.
- 폭이 늘어난다. \(p=0.2\)에서 기대 폭이 0.278 → 0.312로 12% 넓어져, 윌슨(0.272)보다 15% 넓다.
결론. 연속성 수정은 어중간한 절충이다. 윌슨이 더 좁으면서 포함확률도 더 고르다. 역사적으로는 계산기가 없던 시절 손으로 할 수 있는 개선책이었으나, 지금은 쓸 이유가 없다.
일반 원리. 연속성 수정은 이산분포를 연속으로 근사할 때 한 방향의 오차만 잡는다. 근사 자체가 나쁜 영역(꼬리, 경계)에서는 도움이 되지 않는다.
연습문제 8. 여러 신뢰수준의 구간을 겹쳐 그리면 신뢰분포(또는 \(p\)-값 함수)를 얻는다. \(n=50\), \(k=18\)에서 이를 계산하고, 하나의 구간만 보고하는 것보다 무엇이 나은지 설명하라.
풀이
착안. 신뢰수준 \(1-\alpha\)를 0에서 1까지 움직이며 구간을 그리면 중첩된 구간들의 족이 나온다. 이를 \(p\)의 함수로 보면
이 되며, 각 \(p_0\)에 대한 단측 \(p\)-값 곡선이다.
import numpy as np
from scipy import stats

n, k = 50, 18
ph = k / n
z0 = stats.norm.ppf(0.975)

print(f"{'수준':>6s} {'윌슨 구간':>22s} {'폭':>8s}")
for lv in [0.50, 0.80, 0.90, 0.95, 0.99]:
    z = stats.norm.ppf(0.5 + lv / 2)
    d = 1 + z**2 / n
    c = (ph + z**2 / (2 * n)) / d
    h = z / d * np.sqrt(ph * (1 - ph) / n + z**2 / (4 * n**2))
    print(f"{lv:6.0%}   ({c - h:.4f}, {c + h:.4f})       {2 * h:.4f}")

print()
print("양측 p-값 곡선")
for p0 in [0.25, 0.30, 0.36, 0.40, 0.45, 0.50]:
    se = np.sqrt(p0 * (1 - p0) / n)
    pv = 2 * stats.norm.sf(abs(ph - p0) / se)
    print(f"  H0: p = {p0:.2f}   p-값 {pv:.4f}")
    수준                  윌슨 구간        폭
   50%   (0.3157, 0.4069)       0.0912
   80%   (0.2787, 0.4502)       0.1714
   90%   (0.2582, 0.4762)       0.2180
   95%   (0.2414, 0.4986)       0.2572
   99%   (0.2113, 0.5415)       0.3302

양측 p-값 곡선
  H0: p = 0.25   p-값 0.0724
  H0: p = 0.30   p-값 0.3545
  H0: p = 0.36   p-값 1.0000
  H0: p = 0.40   p-값 0.5637
  H0: p = 0.45   p-값 0.2008
  H0: p = 0.50   p-값 0.0477
하나의 구간보다 나은 점.
-
문턱의 임의성이 사라진다. 95%만 보면 "구간 안이냐 밖이냐"의 이분법이 생긴다. 곡선은 연속적인 증거의 강도를 보여 준다. 위 예에서 \(p=0.25\)의 \(p\)-값 0.072와 \(p=0.50\)의 0.048은 증거의 강도가 사실상 비슷한데, 95% 구간만 보면 전자는 "안", 후자는 "밖"으로 정반대 판정을 받는다.
-
경계 근처가 보인다. \(p=0.50\)의 \(p\)-값이 0.0477로 간신히 기각이다. 95% 구간만 보면 "0.5는 밖"이라고만 알 뿐, 그것이 아슬아슬한지 명백한지 알 수 없다.
-
점추정값이 자연스럽게 나온다. \(p\)-값이 1이 되는 곳(\(p=0.36\))이 곧 \(\hat p\)다.
-
비대칭이 드러난다. 구간이 \(\hat p=0.36\)을 중심으로 대칭이 아니다. 95% 구간에서 하한까지 0.119, 상한까지 0.139다.
관련 개념. 이 곡선의 도함수가 신뢰밀도이고, 베이즈 사후분포와 형태가 비슷하지만 해석이 다르다. 피셔의 신뢰분포(fiducial distribution) 개념의 현대적 형태이기도 하다.
실무. 논문에 \(p\)-값 곡선을 싣는 관행이 역학 분야에서 늘고 있다. 그림 하나가 "유의/비유의"의 이분법을 대체한다.
연습문제 9. \(n=10{,}000\), \(k=5{,}400\)일 때 다섯 방법의 구간을 계산하고, 소표본에서 보였던 차이가 왜 사라지는지 설명하라.
풀이
import numpy as np
from scipy import stats

n, k = 10_000, 5_400
z = stats.norm.ppf(0.975)
ph = k / n

se = np.sqrt(ph * (1 - ph) / n)
d = 1 + z**2 / n
c = (ph + z**2 / (2 * n)) / d
h = z / d * np.sqrt(ph * (1 - ph) / n + z**2 / (4 * n**2))
nt = n + z**2
pt = (k + z**2 / 2) / nt
sea = np.sqrt(pt * (1 - pt) / nt)

rows = [("왈드", ph - z * se, ph + z * se),
        ("윌슨", c - h, c + h),
        ("애그레스티-콜", pt - z * sea, pt + z * sea),
        ("클로퍼-피어슨", stats.beta.ppf(0.025, k, n - k + 1),
         stats.beta.ppf(0.975, k + 1, n - k)),
        ("제프리스", *stats.beta.ppf([0.025, 0.975], k + 0.5, n - k + 0.5))]
for name, lo, hi in rows:
    print(f"{name:13s} ({lo:.6f}, {hi:.6f})  폭 {hi - lo:.6f}")
왈드            (0.530232, 0.549768)  폭 0.019537
윌슨            (0.530218, 0.549751)  폭 0.019533
애그레스티-콜       (0.530218, 0.549751)  폭 0.019533
클로퍼-피어슨       (0.530171, 0.549806)  폭 0.019634
제프리스          (0.530221, 0.549756)  폭 0.019534
다섯째 자리까지 같다. 실무적으로 완전히 동일하다.
왜 사라지는가. 방법들의 차이는 \(z^2\) 정도의 유사관측값을 더하느냐로 요약되는데, 그 효과가 \(O(1/n)\)이다.
| 차이의 원천 | 크기 |
|---|---|
| 윌슨의 중심 이동 \(\frac{z^2/2}{n+z^2}\) | \(0.00019\) |
| 애그레스티-콜의 \(+2\) 성공 | \(0.00019\) |
| 클로퍼-피어슨의 보수성(폭 차이) | \(0.00010\) |
| 구간의 폭 | \(0.01954\) |
보정항이 폭의 1%에 불과하다. \(\hat p\)가 0.5 근처라 \(p(1-p)\)가 평탄한 것도 근사를 돕는다.
언제 다시 차이가 나는가. \(n\)이 커도 \(np\)나 \(n(1-p)\)가 작으면 여전히 다르다. \(n=10{,}000\), \(k=3\)이면
- 왈드: \((-0.000039,\ 0.000639)\) — 하한이 음수
- 클로퍼-피어슨: \((0.000062,\ 0.000876)\)
으로 크게 다르다. 관건은 \(n\)이 아니라 \(\min(np,n(1-p))\) 다. 흔한 지침은 이 값이 5 이상이어야 정규근사가 쓸 만하다는 것이며, 위의 \(k=3\)은 이를 크게 벗어난다.
연습문제 10. 비율의 구간을 총 개수의 구간으로 바꾸는 법을 설명하라. 모집단 \(N=45{,}000\), 표본 \(n=600\)에서 \(k=138\)일 때 해당하는 총 개수의 95% 구간을 구하라.
풀이
원리. 총 개수는 \(T=Np\)이고 \(N\)이 알려진 상수이므로, \(p\)의 구간에 \(N\)을 곱하면 된다. 선형변환이므로 구간이 그대로 옮겨 간다(앞서 본 아핀 불변성).
import numpy as np
from scipy import stats

N, n, k = 45_000, 600, 138
z = stats.norm.ppf(0.975)
ph = k / n
fpc = np.sqrt((N - n) / (N - 1))               # 표집비율 1.3%, 거의 1

d = 1 + z**2 / n
c = (ph + z**2 / (2 * n)) / d
h = z / d * np.sqrt(ph * (1 - ph) / n + z**2 / (4 * n**2)) * fpc

print(f"비율 추정 {ph:.4f}   95% 구간 ({c - h:.4f}, {c + h:.4f})")
print(f"총 개수 추정 {N * ph:,.0f}명   "
      f"95% 구간 ({N * (c - h):,.0f}, {N * (c + h):,.0f})명")
print(f"구간의 폭 {N * 2 * h:,.0f}명   FPC {fpc:.4f}")
비율 추정 0.2300   95% 구간 (0.1983, 0.2651)
총 개수 추정 10,350명   95% 구간 (8,925, 11,930)명
구간의 폭 3,005명   FPC 0.9933
보고. "대상자가 약 1만 350명으로 추정되며, 95% 신뢰구간은 8,900명에서 11,900명이다."
주의할 점.
-
반올림. 8,925.4명 같은 소수는 무의미하다. 정밀도에 맞춰 백 단위로 반올림하는 것이 정직하다. 폭이 3,000명인데 1명 단위로 적으면 없는 정밀도를 주장하는 것이다.
-
\(N\)이 정확한가. \(N\)도 추정값이라면(인구추계 등) 그 불확실성을 더해야 한다. \(T=\hat N\hat p\)의 분산은 델타법으로
$$ \operatorname{Var}(T)\approx N^2\operatorname{Var}(\hat p)+p^2\operatorname{Var}(\hat N) $$
이며, \(N\)의 상대오차가 비율의 상대오차보다 크면 그쪽이 지배한다.
-
FPC. 표집비율이 1.3%라 수정이 거의 필요 없다(0.9933). \(n/N\)이 5%를 넘으면 반영한다.
-
비대칭. 윌슨 구간은 \(\hat p\)를 중심으로 대칭이 아니다. 총 개수로 바꿔도 비대칭이 그대로 남는다. \(10{,}350-8{,}925=1{,}425\), \(11{,}930-10{,}350=1{,}580\)으로 위쪽이 더 길다.
실무적 쓰임. 감사에서 오류 금액의 총액 추정, 역학에서 감염자 수 추정, 재고조사에서 불량품 총수 추정이 모두 이 형태다. 이때 관심은 비율이 아니라 총액/총수이므로, 처음부터 그 척도로 보고하는 것이 낫다.
정리하며
비율 구간 네 가지의 계산 절차를 모았다.
- 입력이 두 수뿐이다. 성공 횟수 \(k\) 와 시행 수 \(n\) 만 있으면 네 방법 모두 계산된다. 0/1 자료가 있으면 합과 길이를 세면 된다.
- 왈드만 손으로 쉽게 적힌다. 나머지 셋은 이차방정식(윌슨), 보정 후 왈드(아그레스티–쿨), 베타분포 분위수(클로퍼–피어슨)를 쓴다.
scipy가 모두 제공한다. - 어느 것을 고를 것인가. 일상적으로는 윌슨, 규제·안전처럼 보수적이어야 하면 클로퍼–피어슨, 손으로 빠르게 어림할 때만 왈드다.
- \(k=0\) 이나 \(k=n\) 을 반드시 확인하라. 왈드는 한 점으로 붕괴하지만 윌슨과 클로퍼–피어슨은 합리적인 한쪽 열린 구간을 준다. 드문 사건을 다룰 때 실제로 자주 마주치는 경우다.
- "3의 법칙"이 유용하다. \(n\) 번 시행에서 사건이 한 번도 없었다면 \(p\) 의 \(95\%\) 상한이 대략 \(3/n\) 이다.
다음 절부터 두 표본으로 넘어간다. 두 집단의 차이에 대한 구간이 주제다.