영향점
개요
분산분석에서 어떤 자료점은 결과에 지나치게 큰 영향을 주어 결론을 왜곡할 수 있다. 이런 영향점은 이상점(특이한 반응값)일 수도 있고 지렛점(특이한 설명변수값)일 수도 있으며, 추정된 집단 평균과 분산, 전체 F-통계량에 상당한 영향을 줄 수 있다. 이런 점들을 찾아 다루는 일은 분산분석 결과의 로버스트성을 확보하는 데 결정적이다.
설정
보기 1. 영향점을 찾기에 앞서, 그 점이 실제로 무엇을 바꾸는가를 먼저 재어 둔다.
(1) 집단 \(g\) 에 속한 관측 \(i\) 를 빼면 그 집단의 평균이 정확히
만큼 움직임을 보이시오(\(e_i = y_i - \bar y_g\)). 다른 집단의 평균은 전혀 움직이지 않음도 밝히시오.
(2) 이 자료에서 그 값을 계산하고, 관측 \(59\) 번을 뺀 자료로 분산분석을 다시 돌려 \(F\), p-값, \(\hat\sigma\), \(\eta^2\) 가 어떻게 바뀌는지 보이시오. 결론이 뒤집히는가?
풀이
(1) 해석적으로. 관측 \(i\) 를 빼면 집단 \(g\) 의 합이 \(y_i\) 만큼, 개수가 하나 줄므로
이다. 원래 평균을 빼면
를 얻는다. \(\square\)
다른 집단은 움직이지 않는다. 일원배치의 최소제곱 적합값이 집단마다 그 집단의 자료만으로 정해지기 때문이다(\(\hat\mu_g = \bar y_g\)). 회귀와 결정적으로 다른 점이다. 회귀에서는 한 점을 빼면 기울기가 움직여 모든 적합값이 바뀐다.
식의 꼴에서 두 가지를 읽을 수 있다. 첫째, 움직임의 크기는 잔차 \(e_i\) 하나로 정해진다. 값이 크냐 작냐가 아니라 자기 집단 평균에서 얼마나 떨어졌느냐다. 둘째, \(n_g\) 가 작을수록 크게 움직인다. 같은 잔차라도 \(n_g = 5\) 면 \(e_i/4\), \(n_g = 20\) 이면 \(e_i/19\) 로 다섯 배 가까이 차이 난다. 이것이 뒤에 나올 지렛값 \(h_{ii} = 1/n_g\) 의 다른 얼굴이다.
(2) 수치적으로. 먼저 이 쪽이 쓸 자료를 만들고 민감도 분석을 돌린다.
import numpy as np
import pandas as pd
from statsmodels.formula.api import ols

rng = np.random.default_rng(42)
n = 20
response = np.concatenate([
    rng.normal(10.0, 1.0, n), rng.normal(10.8, 1.3, n), rng.normal(12.0, 1.6, n)])
response[-1] = 20.0
data = pd.DataFrame({"group": np.repeat(["A", "B", "C"], n), "response": response})

full = ols("response ~ C(group)", data=data).fit()
drop = ols("response ~ C(group)", data=data.drop(index=59)).fit()
e59 = full.resid.values[-1]

print(f"e_59 = {e59:.6f}")
print(f"공식  집단 C 평균의 변화 = -e_59/(n-1) = {-e59 / (n - 1):.6f}")
print(f"실제  {response[40:59].mean():.6f} - {response[40:].mean():.6f} = "
      f"{response[40:59].mean() - response[40:].mean():.6f}")

print(f"\n{'':>8}{'F':>10}{'p':>12}{'sigma_hat':>12}{'eta^2':>9}{'평균 C':>11}")
print(f"{'전체 60':>8}{full.fvalue:>10.4f}{full.f_pvalue:>12.3e}"
      f"{np.sqrt(full.mse_resid):>12.4f}{full.rsquared:>9.4f}{response[40:].mean():>11.4f}")
print(f"{'59 빼고':>8}{drop.fvalue:>10.4f}{drop.f_pvalue:>12.3e}"
      f"{np.sqrt(drop.mse_resid):>12.4f}{drop.rsquared:>9.4f}{response[40:59].mean():>11.4f}")
출력:
e_59 = 7.486540
공식  집단 C 평균의 변화 = -e_59/(n-1) = -0.394028
실제  12.119432 - 12.513460 = -0.394028

                 F           p   sigma_hat    eta^2       평균 C
   전체 60   16.1314   2.808e-06      1.4306   0.3614    12.5135
   59 빼고   21.9577   9.111e-08      1.0146   0.4395    12.1194
공식과 실제가 소수점 여섯째 자리까지 같다. 잔차 \(7.486540\) 을 \(19\) 로 나눈 \(0.394028\) 이 집단 C 평균이 내려오는 거리다.
그런데 둘째 표가 뜻밖이다. 이상점을 빼면 결과가 더 강해진다.
| 전체 \(60\) | \(59\) 빼고 | |
|---|---|---|
| \(F\) | \(16.13\) | \(\mathbf{21.96}\) |
| p-값 | \(2.8\times10^{-6}\) | \(\mathbf{9.1\times10^{-8}}\) |
| \(\hat\sigma\) | \(1.4306\) | \(1.0146\) |
| \(\eta^2\) | \(0.3614\) | \(0.4395\) |
까닭은 두 몫이 서로 다른 방향으로 작용하기 때문이다. 그 점을 빼면
- 분자 쪽: 집단 C 평균이 \(12.51 \to 12.12\) 로 내려와 집단 간 차이가 줄어든다.
- 분모 쪽: \(\hat\sigma\) 가 \(1.4306 \to 1.0146\) 으로 \(29\%\) 줄어든다.
그리고 분모의 효과가 훨씬 크다. 분자는 \(\eta^2\) 로 보면 미미하게 줄 뿐인데 분모는 제곱으로 들어가므로, 결국 \(F\) 가 \(36\%\) 커진다. 보기 3·4에서 보듯 그 한 점이 \(\hat\sigma^2\) 의 절반 가까이를 혼자 내고 있었기 때문이다.
그래서 이 자료의 민감도 분석 결론은 "결과가 로버스트하다"이다. 그 점을 넣든 빼든 세 평균이 다르다는 결론은 바뀌지 않으며, 오히려 넣은 쪽이 보수적이다. 이것이 중요한 까닭은, 영향점을 찾았다고 해서 자동으로 결과를 의심할 일이 아니기 때문이다. 영향점이 결론을 만들어 낸 경우와 결론을 가리고 있던 경우는 전혀 다르게 다루어야 한다. 여기는 뒤쪽이다.
다만 이 쪽에서 앞으로 보게 될 진단량들(\(\hat\sigma\) 로 나누는 모든 것)은 부풀려진 \(1.4306\) 을 기준자로 쓴다는 사실을 기억해 두어야 한다. 그 자가 이상점 자신 때문에 늘어났으므로, 이상점은 자기를 재는 자를 스스로 늘여 덜 튀어 보이게 만든다. 보기 4에서 볼 외부 스튜던트화 잔차가 그 순환을 끊는 장치다.
이 쪽의 모형. 아래 진단은 모두 이 model 하나를 놓고 수행한다.
import numpy as np
import pandas as pd
from statsmodels.formula.api import ols

# 이 페이지의 진단은 모두 아래 모형 하나를 놓고 수행한다.
# 집단마다 표준편차를 1.0, 1.3, 1.6으로 다르게 주었고,
# 집단 C에 이상점을 하나 심어 두었다.
rng = np.random.default_rng(42)
n = 20
response = np.concatenate([
    rng.normal(10.0, 1.0, n),
    rng.normal(10.8, 1.3, n),
    rng.normal(12.0, 1.6, n),
])
response[-1] = 20.0                     # 마지막 관측값을 이상점으로 만든다
data = pd.DataFrame({
    "group": np.repeat(["A", "B", "C"], n),
    "response": response,
})
group1 = data.loc[data["group"] == "A", "response"]
group2 = data.loc[data["group"] == "B", "response"]
group3 = data.loc[data["group"] == "C", "response"]

model = ols("response ~ C(group)", data=data).fit()

print(data.groupby("group").response.agg(["count", "mean", "std"]).round(3))
print(f"\nF = {model.fvalue:.4f}, p = {model.f_pvalue:.4f}")
출력:
       count    mean    std
group
A         20   9.967  0.870
B         20  10.942  1.034
C         20  12.513  2.077

F = 16.1314, p = 0.0000
이상점 하나가 집단 C의 표준편차를 1.15에서 2.08로 키웠다. 아래 진단들이 이것을 잡아내는지 보라.
Cook의 거리
Cook의 거리는 각 관측값의 잔차와 지렛값을 결합하여 적합된 모형에 대한 전체적인 영향을 평가한다. 관측값 \(i\)를 제거했을 때 적합값이 얼마나 변하는지를 잰다:
여기서 \(r_i\)는 표준화 잔차, \(h_{ii}\)는 지렛값, \(p\)는 모형의 모수 개수(일원배치 분산분석에서는 집단의 수)이다.
보기 2. Cook의 거리. 위의 식은 정의가 아니라 결과다. 정의는 삭제로 적혀 있다.
(\(\hat y_{j(i)}\) 는 관측 \(i\) 를 빼고 적합한 모형이 관측 \(j\) 에 주는 적합값이다.)
(1) 보기 1의 결과를 써서, 균형 일원배치에서 이 정의가
이 됨을 보이시오. 분자의 합에 항이 몇 개 남는가.
(2) 이것이 쪽 위의 \(D_i = \dfrac{r_i^2}{p}\cdot\dfrac{h_{ii}}{1-h_{ii}}\) 와 같음을 보이시오.
(3) 실제로 한 점씩 빼고 다시 적합해 정의대로 계산한 값이 cooks_distance 와 같은지 확인하시오.
풀이
(1) 해석적으로. 보기 1에서 관측 \(i\) 를 빼면 그 집단의 평균만 움직이고 그 크기가 \(-\dfrac{e_i}{n-1}\) 임을 보았다. 일원배치의 적합값은 곧 집단평균이므로
이다. 곧 분자의 \(N\) 개 항 가운데 \(n\) 개만 살아남고 그 \(n\) 개가 모두 같은 값이다(자기 자신 \(j = i\) 도 포함한다). 따라서
이고
를 얻는다. \(\square\)
(2) 해석적으로. 잔차 분석 쪽에서 본 \(r_i = \dfrac{e_i}{\hat\sigma\sqrt{1-h_{ii}}}\) 와 \(h_{ii} = 1/n\) 을 쓰면
로 (1)과 같다. \(\square\)
두 식이 같다는 사실이 Cook 거리에 뜻을 준다. \(\frac{r_i^2}{p}\frac{h}{1-h}\) 만 보면 "표준화 잔차와 지렛값을 적당히 섞은 양"으로 보이지만, 그 섞음은 임의가 아니라 "이 점을 빼면 적합값들이 얼마나 움직이는가"를 \(p\hat\sigma^2\) 으로 잰 것이다. 분모의 \(p\hat\sigma^2\) 은 회귀계수의 신뢰영역이 쓰는 척도이므로, \(D_i\) 는 "관측 \(i\) 를 빼면 추정값이 신뢰영역 몇 개만큼 이동하는가"로도 읽힌다. 이것이 \(D_i > 1\) 이라는 보수적 문턱의 출처다.
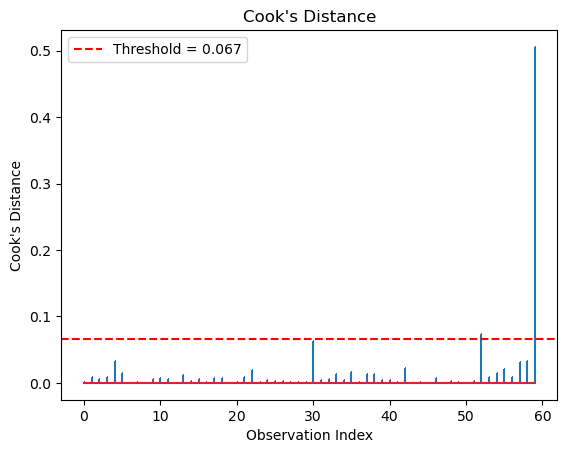
(3) 수치적으로. 먼저 쪽의 그림과 요약이다.
import numpy as np
import matplotlib.pyplot as plt

# 관측값마다 Cook 의 거리를 막대로 세운다. 유독 솟은 막대가 있는지를 본다.
influence = model.get_influence()
cooks_d = influence.cooks_distance[0]

plt.stem(range(len(cooks_d)), cooks_d, markerfmt=",")
plt.xlabel("Observation Index")
plt.ylabel("Cook's Distance")
plt.title("Cook's Distance")
plt.axhline(y=4/len(cooks_d), color='r', linestyle='--', label=f'Threshold = {4/len(cooks_d):.3f}')
plt.legend()
plt.show()

print(f"threshold = {4/len(cooks_d):.4f}")
print(f"max Cook's D = {cooks_d.max():.4f} at obs {cooks_d.argmax()}")
print(f"flagged = {np.where(cooks_d > 4/len(cooks_d))[0]}")
출력:
threshold = 0.0667
max Cook's D = 0.5058 at obs 59
flagged = [52 59]
이제 정의 그대로 한 점씩 빼고 다시 적합해 본다.
import numpy as np
import pandas as pd
from statsmodels.formula.api import ols

rng = np.random.default_rng(42)
n, k = 20, 3
response = np.concatenate([
    rng.normal(10.0, 1.0, n), rng.normal(10.8, 1.3, n), rng.normal(12.0, 1.6, n)])
response[-1] = 20.0
data = pd.DataFrame({"group": np.repeat(["A", "B", "C"], n), "response": response})
model = ols("response ~ C(group)", data=data).fit()
e = model.resid.values
fit = model.fittedvalues.values
s2 = model.mse_resid
D = model.get_influence().cooks_distance[0]

def cook_by_deletion(i):
    """정의 그대로: i 를 빼고 다시 적합해 60 개 적합값이 얼마나 움직였는지 잰다."""
    refit = ols("response ~ C(group)", data=data.drop(index=i)).fit()
    moved = fit - refit.predict(data).values
    return (moved ** 2).sum() / (k * s2)

print(f"{'관측':>6}{'e_i':>11}{'삭제 정의':>13}{'공식':>13}{'cooks_distance':>16}")
for i in [59, 52, 30, 0]:
    formula = n * e[i] ** 2 / (k * s2 * (n - 1) ** 2)
    print(f"{i:>6}{e[i]:>11.4f}{cook_by_deletion(i):>13.8f}{formula:>13.8f}{D[i]:>16.8f}")

# 59 번을 뺐을 때 실제로 움직인 적합값
refit = ols("response ~ C(group)", data=data.drop(index=59)).fit()
moved = fit - refit.predict(data).values
print(f"\n59 번을 뺐을 때 적합값이 움직인 집단: "
      f"{sorted(set(data['group'][np.abs(moved) > 1e-12]))}")
print(f"  움직인 크기 = {moved[-1]:.6f}  (= e_59/(n-1) = {e[-1] / (n - 1):.6f})")
print(f"  움직인 관측 수 = {(np.abs(moved) > 1e-12).sum()}")
print(f"  제곱합 = {(moved ** 2).sum():.6f} = n*(e/(n-1))^2 = {n * (e[-1] / (n - 1)) ** 2:.6f}")
print(f"  p*sigma^2 = {k * s2:.6f}")
print(f"  나누면 {(moved ** 2).sum() / (k * s2):.8f}")
출력:
    관측        e_i        삭제 정의           공식  cooks_distance
    59     7.4865   0.50577484   0.50577484      0.50577484
    52    -2.8449   0.07303512   0.07303512      0.07303512
    30     2.6418   0.06298082   0.06298082      0.06298082
     0     0.3376   0.00102879   0.00102879      0.00102879

59 번을 뺐을 때 적합값이 움직인 집단: ['C']
  움직인 크기 = 0.394028  (= e_59/(n-1) = 0.394028)
  움직인 관측 수 = 20
  제곱합 = 3.105168 = n*(e/(n-1))^2 = 3.105168
  p*sigma^2 = 6.139427
  나누면 0.50577484
네 관측 모두에서 삭제 정의, (1)의 공식, statsmodels 의 cooks_distance 가 소수점 여덟째 자리까지 같다. 유도가 맞는다.
아래 줄들이 그 정의를 분해해 보여 준다. \(59\) 번을 빼면 집단 C 의 적합값만 움직이고(\(20\) 개), 하나하나가 \(0.394028\) 씩 움직인다. 보기 1의 \(e_{59}/(n-1)\) 과 같은 값이다. 제곱해 더하면 \(20 \times 0.394028^2 = 3.105168\) 이고 이것을 \(p\hat\sigma^2 = 3 \times 2.046476 = 6.139427\) 로 나누면 \(0.5058\) 이다.
\(D_{59} = 0.506\) 을 어떻게 읽을 것인가. 쪽의 본문이 "문턱 \(0.067\) 의 여덟 배"라 한 것은 맞지만, 보수적 문턱 \(D_i > 1\) 로 보면 아직 절반에 못 미친다. 그리고 보기 1에서 실제로 그 점을 빼 보았더니 결론이 뒤집히기는커녕 더 강해졌다. 두 사실이 서로 맞는다. \(D_i\) 가 재는 것은 추정값이 움직이는 거리이지 결론이 뒤집히는 정도가 아니다.
끝으로 표의 둘째·셋째 줄에 눈길을 줄 만하다. \(52\) 번의 잔차는 \(-2.8449\) 로 음수이고 \(30\) 번은 \(+2.6418\) 인데, \(D\) 가 \(0.0730\) 과 \(0.0630\) 으로 거의 같다. \(D_i\) 가 \(e_i^2\) 에만 의존하므로 부호를 보지 않기 때문이다. 영향력의 크기만 알려 주고 방향은 알려 주지 않으므로, 어느 쪽으로 끄는지 알려면 잔차나 다음에 볼 DFFITS 를 보아야 한다.
막대 하나가 압도적으로 높다. 마지막 관측값(59번)의 Cook 거리 0.506은 문턱 0.067의 여덟 배에 가깝다. 52번도 문턱을 넘지만 값이 훨씬 작다.
문턱 \(4/n\)은 넉넉하게 잡은 기준이라 이렇게 몇 개가 걸리는 것이 보통이다. 걸린 점을 모두 문제 삼는 것이 아니라, 다른 점들과 얼마나 벌어져 있는지를 보는 것이 요령이다.
영향점을 찾는 데 흔히 쓰는 문턱:
- \(D_i > 4/n\): 흔히 쓰이는 경험 법칙.
- \(D_i > 1\): 더 보수적인 문턱.
- \(D_i > F_{0.50}(p, n-p)\): \(F\)-분포의 중앙값에 근거한 문턱.
지렛값
지렛값은 관측값의 설명변수값이 설명변수 평균에서 얼마나 떨어져 있는지를 잰다. 일원배치 분산분석에서 지렛값은 집단 크기에 의존한다:
여기서 \(n_i\)는 관측값 \(i\)가 속한 집단의 크기이다. 작은 집단에 속한 점일수록 지렛값이 크다.
지렛값이 큰 점이 반드시 영향점인 것은 아니다. 잔차가 클 때에만 영향점이 된다.
보기 3. 지렛값은 무엇을 더하고 무엇을 더하지 않는가.
(1) 모자행렬 \(H = X(X^\top X)^{-1}X^\top\) 가 멱등(\(H^2 = H\))이고 대칭임을 쓰고, 그로부터
임을 보이시오.
(2) 일원배치에서 \(h_{ii} = 1/n_i\) 임을 쓰고, \(\sum_i h_{ii} = p\) 가 집단 수 \(k\) 와 맞아떨어짐을 확인하시오.
(3) 균형설계에서 그림이 세로선 하나가 되는 것을 수로 확인하고, \(n = (5, 20, 35)\) 인 불균형설계에서는 어떻게 달라지는지 보이시오. 똑같이 \(\lvert r\rvert = 2\) 인 점이라도 집단에 따라 Cook 거리가 얼마나 다른가.
풀이
(1) 해석적으로. \(H\) 가 열공간 위로의 직교사영이므로 \(H^2 = H\) 이고 \(H^\top = H\) 다. 대각합은
로 \(\operatorname{tr}(AB) = \operatorname{tr}(BA)\) 를 한 번 쓴 결과다. 따라서 \(\sum_i h_{ii} = p\) 이고 평균은 \(p/N\) 이다. (멱등행렬의 대각합이 계수와 같다는 일반 사실의 특수한 경우다.)
범위는 멱등성에서 나온다. \(H = H^2 = H^\top H\) 의 \((i,i)\) 성분을 쓰면
이다. \(h_{ii} \ge h_{ii}^2\) 는 \(0 \le h_{ii} \le 1\) 과 같다. \(\square\) (덤으로, \(h_{ii} = 1\) 이면 \(j \ne i\) 인 모든 \(h_{ij}\) 가 \(0\) 이어서 그 점의 잔차가 항상 \(0\), 곧 모형이 그 점을 완벽히 지나간다는 뜻이다. 자기 집단에 혼자뿐인 관측이 그 경우다.)
(2) 해석적으로. 잔차 분석 쪽 보기 3에서 보았듯 일원배치의 \(H\) 는 블록대각이고 집단 \(i\) 의 블록이 \(\frac{1}{n_i}J_{n_i}\) 이므로 \(h_{ii} = 1/n_i\) 다. 집단 \(i\) 에 그런 관측이 \(n_i\) 개 있으므로 그 집단의 몫이 \(n_i \cdot \frac{1}{n_i} = 1\) 이고
로 (1)과 맞는다. \(\square\) 집단마다 정확히 지렛값 \(1\) 어치씩을 나눠 갖는다는 것이 일원배치의 지렛값 구조 전부다. 큰 집단은 그 \(1\) 을 여럿이 나누고 작은 집단은 몇이서 나눈다.
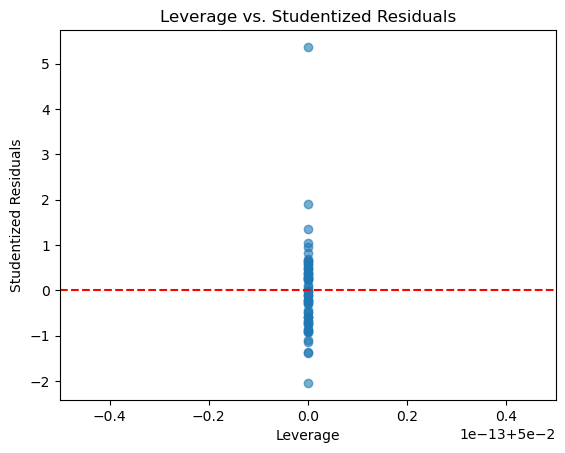
(3) 수치적으로. 먼저 쪽의 그림이다.
# 지렛값은 설명변수 쪽에서 그 점이 얼마나 외따로 있는지를 잰다.
# 지렛값이 크고 잔차도 큰 점이 가장 위험하다. 그 둘을 곱해 놓은 것이
# 앞의 Cook 거리라고 보면 된다.
leverage = influence.hat_matrix_diag

plt.scatter(leverage, influence.resid_studentized_internal, alpha=0.6)
plt.xlabel("Leverage")
plt.ylabel("Studentized Residuals")
plt.title("Leverage vs. Studentized Residuals")
plt.axhline(y=0, color='r', linestyle='--')
plt.show()

print(f"leverage: min = {leverage.min():.4f}, max = {leverage.max():.4f}")
출력:
leverage: min = 0.0500, max = 0.0500
이제 (1)·(2)를 수로 확인하고, 설계를 불균형으로 바꿔 본다.
import numpy as np
import pandas as pd
from statsmodels.formula.api import ols

rng = np.random.default_rng(42)
n, k = 20, 3
response = np.concatenate([
    rng.normal(10.0, 1.0, n), rng.normal(10.8, 1.3, n), rng.normal(12.0, 1.6, n)])
response[-1] = 20.0
data = pd.DataFrame({"group": np.repeat(["A", "B", "C"], n), "response": response})
h = ols("response ~ C(group)", data=data).fit().get_influence().hat_matrix_diag
N = len(h)

print(f"균형설계 n=(20,20,20)")
print(f"  서로 다른 h = {np.unique(np.round(h, 12))}")
print(f"  sum h = {h.sum():.10f}  (= p = {k})")
print(f"  mean h = {h.mean():.10f}  (= p/N = {k / N})")
print(f"  std h = {h.std(ddof=1):.3e}")

# 불균형 설계에서는 어떻게 되는가
ns = [5, 20, 35]
rg = np.random.default_rng(11)
y2 = np.concatenate([rg.normal(10.0, 1.0, ns[0]),
                     rg.normal(10.8, 1.0, ns[1]),
                     rg.normal(12.0, 1.0, ns[2])])
d2 = pd.DataFrame({"group": np.repeat(["A", "B", "C"], ns), "response": y2})
inf2 = ols("response ~ C(group)", data=d2).fit().get_influence()
h2, r2 = inf2.hat_matrix_diag, inf2.resid_studentized_internal
D2 = inf2.cooks_distance[0]

print(f"\n불균형설계 n=(5,20,35)")
print(f"{'집단':>5}{'n_i':>5}{'h_ii':>10}{'1/n_i':>10}{'n_i*h_ii':>10}")
for i, (g, m) in enumerate(zip("ABC", ns)):
    hi = h2[np.array(d2["group"]) == g][0]
    print(f"{g:>5}{m:>5}{hi:>10.6f}{1 / m:>10.6f}{m * hi:>10.6f}")
print(f"  sum h = {h2.sum():.10f}  (= p = {k})")
print(f"  같은 |r| = 2 라도 Cook 거리는 집단마다 다르다:")
for g, m in zip("ABC", ns):
    hi = h2[np.array(d2["group"]) == g][0]
    print(f"    집단 {g}: D = (2^2/3)*h/(1-h) = {(4 / k) * hi / (1 - hi):.6f}")
print(f"  문턱 4/N = {4 / len(h2):.6f}")
출력:
균형설계 n=(20,20,20)
  서로 다른 h = [0.05]
  sum h = 3.0000000000  (= p = 3)
  mean h = 0.0500000000  (= p/N = 0.05)
  std h = 2.099e-17

불균형설계 n=(5,20,35)
   집단  n_i      h_ii     1/n_i  n_i*h_ii
    A    5  0.200000  0.200000  1.000000
    B   20  0.050000  0.050000  1.000000
    C   35  0.028571  0.028571  1.000000
  sum h = 3.0000000000  (= p = 3)
  같은 |r| = 2 라도 Cook 거리는 집단마다 다르다:
    집단 A: D = (2^2/3)*h/(1-h) = 0.333333
    집단 B: D = (2^2/3)*h/(1-h) = 0.070175
    집단 C: D = (2^2/3)*h/(1-h) = 0.039216
  문턱 4/N = 0.066667
균형설계에서 \(\sum h_{ii} = 3.0000000000\) 이 정확히 \(p = 3\) 이고 평균이 \(p/N = 0.05\) 다. 표준편차가 \(2 \times 10^{-17}\) 이므로 \(60\) 개가 모두 같은 값이고, 그래서 그림이 세로선 하나가 된다.
불균형설계의 표가 이 보기의 요점이다. \(h_{ii}\) 가 \(0.2\), \(0.05\), \(0.0286\) 으로 갈리고 \(1/n_i\) 와 정확히 같다. 집단마다 \(n_i h_{ii} = 1\) 로 지렛값 \(1\) 어치씩 가져가는 것도 확인된다. 합은 여전히 정확히 \(3\) 이다.
그리고 마지막 세 줄이 결과를 말한다. 똑같이 \(\lvert r\rvert = 2\) 인 점이라도
| 집단 | \(n_i\) | \(h_{ii}\) | \(D\) | \(4/N = 0.0667\) 을 넘는가 |
|---|---|---|---|---|
| A | \(5\) | \(0.2000\) | \(\mathbf{0.3333}\) | 넘는다 (다섯 배) |
| B | \(20\) | \(0.0500\) | \(0.0702\) | 겨우 넘는다 |
| C | \(35\) | \(0.0286\) | \(0.0392\) | 못 넘는다 |
로 Cook 거리가 여덟 배 넘게 벌어진다. 작은 집단의 관측은 자기 집단 평균을 혼자 많이 끌고 가므로 같은 표준화 잔차라도 영향이 크다. 여기서 비로소 Cook 거리가 표준화 잔차와 다른 말을 한다.
거꾸로 균형설계에서는 그 차이가 사라진다. 이 쪽의 자료가 바로 그 경우이고, 본문이 "지렛값은 영향점을 가려내는 데 아무 역할도 하지 못한다"고 한 것이 정확하다. 그러므로 이 쪽의 그림 두 장(Cook 막대와 지렛값 산점도)은 서로 다른 정보를 주지 않는다. 그렇다고 지렛값을 보지 말라는 뜻은 아니다. 지렛값을 그려 보고 "세로선 하나"임을 확인하는 일 자체가 "이 설계에서는 Cook 거리를 잔차로 읽어도 된다"는 허가이기 때문이다. 그 확인 없이 균형설계의 Cook 거리를 "지렛값까지 고려한 종합 지표"로 소개하면 없는 정보를 있다고 말하는 것이 된다.
지렛값이 60개 모두 정확히 0.05다. 균형 설계라 모든 집단의 크기가 \(n_i = 20\)이고 \(h_{ii} = 1/20 = 0.05\)이기 때문이다.
그래서 그림의 점들이 하나의 세로선 위에 늘어선다. 균형 잡힌 일원배치 분산분석에서 지렛값은 영향점을 가려내는 데 아무 역할도 하지 못한다. 영향의 차이는 오직 잔차에서 온다. 지렛값이 의미를 갖는 것은 집단 크기가 다르거나 연속형 설명변수가 있을 때다.
DFFITS
DFFITS는 각 관측값이 자기 자신의 적합값에 주는 영향을 잰다:
여기서 \(r_i^*\)는 외부 스튜던트화 잔차이다. 흔한 문턱은 \(|\text{DFFITS}_i| > 2\sqrt{p/n}\)이다.
영향점 다루기
영향점을 찾았을 때 고려할 수 있는 전략은 여럿이다:
조사: 어떤 조치를 취하기 전에 왜 그 점이 영향력이 큰지 조사한다. 자료 입력 오류인가? 측정 이상인가? 아니면 과학적으로 의미 있는 정말로 특이한 관측인가?
민감도 분석: 영향점을 포함한 경우와 제외한 경우로 분산분석을 각각 수행한다. 결론이 크게 달라지면 결과가 그 관측값에 로버스트하지 않다는 뜻이므로 이를 보고해야 한다.
제거: 실질적인 근거(예: 알려진 자료 오류)가 있을 때에만 영향점을 제거한다. 단지 불편하다는 이유로 점을 제거해서는 안 된다.
변환: 자료에 변환(예: 로그, 제곱근)을 적용하면 척도가 압축되어 극단값의 영향이 줄어들 수 있다.
로버스트 분산분석 방법: 절사평균, 윈저화 평균, M-추정량 같은 방법은 이상점의 영향을 낮추어 더 신뢰할 만한 결과를 준다. 붓스트랩 방법도 영향점에 대한 로버스트성을 제공한다.
보기 4. 완전한 영향 진단. summary_frame 의 네 열이 서로 어떤 관계인지 식으로 적을 수 있다.
(1) 균형 일원배치에서
임을 보이시오(\(t_i\) 는 외부 스튜던트화 잔차).
(2) 문턱 \(\lvert\text{DFFITS}_i\rvert > 2\sqrt{p/N}\) 이 \(\lvert t_i\rvert > 2\sqrt{1 - p/N}\) 과 같음을 보이시오. 분산분석 진단 쪽에서 본 Cook 의 \(4/N\) 문턱과 견주면?
(3) 잔차 분석 쪽에서 본 \(\sum_i r_i^2 = N\) 을 써서 Cook 거리의 평균이 자료와 무관하게 정확히 \(\dfrac{1}{N-k}\) 임을 보이시오.
(4) 세 결과를 확인하고, describe() 표의 네 열을 읽으시오.
풀이
(1) 해석적으로. \(h_{ii} = 1/n\) 이므로
이고 곧바로 \(\text{DFFITS}_i = t_i/\sqrt{n-1}\) 이다. \(\square\) \(n = 20\) 이면 \(\sqrt{19} = 4.358899\) 로 나누는 것이다.
DFFITS 가 Cook 거리와 다른 점이 둘이다. 첫째, 부호가 있다. 그 관측이 자기 적합값을 위로 끄는지 아래로 끄는지 알려 준다. 둘째, 외부 스튜던트화 잔차를 쓴다. 그 관측을 뺀 적합에서 추정한 \(\hat\sigma_{(i)}\) 로 나누므로, 보기 1에서 말한 "이상점이 자기를 재는 자를 늘이는" 순환이 끊긴다.
(2) 해석적으로. (1)에서 \(\lvert\text{DFFITS}_i\rvert = \lvert t_i\rvert/\sqrt{n-1}\) 이므로
이다. \(p = k\), \(N = kn\) 이므로
이고 둘을 합치면
다. \(\square\) \(N = 60\), \(p = 3\) 에서 \(2\sqrt{0.95} = 1.949359\) 다.
분산분석 진단 쪽 보기 5에서 Cook 의 \(D_i > 4/N\) 이 \(\lvert r_i\rvert > 2\sqrt{1 - k/N} = 1.949359\) 와 같음을 보았다. 같은 수다. 두 문턱은 같은 경계를 서로 다른 잔차에 적용한다. \(\lvert r\rvert > 1\) 인 범위에서 \(\lvert t\rvert > \lvert r\rvert\) 이므로 DFFITS 쪽이 조금 더 많이 걸러 낸다.
(3) 해석적으로. 보기 2에서 \(D_i = r_i^2/(N-k)\) 였고, 잔차 분석 쪽에서 \(\sum_i r_i^2 = N\) 이었으므로
다. \(\square\) 자료가 무엇이든 균형 일원배치에서 Cook 거리의 평균은 \(1/(N-k)\) 로 고정된다. 이 자료에서는 \(1/57 = 0.017544\) 다.
그러므로 describe() 의 mean 칸은 자료에 대해 아무것도 말해 주지 않는다. 쓸모 있는 것은 mean 이 아니라 max 와 분위수의 간격이다.
(4) 수치적으로. 먼저 쪽의 요약표다.
import statsmodels.api as sm
from statsmodels.formula.api import ols

model = ols('response ~ group', data=data).fit()

influence = model.get_influence()
# summary_frame은 진단량을 한 표에 모아 준다.
summary = influence.summary_frame()
print(summary[['hat_diag', 'cooks_d', 'dffits', 'student_resid']].describe())
출력:
           hat_diag    cooks_d     dffits  student_resid
count  6.000000e+01  60.000000  60.000000      60.000000
mean   5.000000e-02   0.017544   0.008298       0.036170
std    5.411161e-17   0.065539   0.281456       1.226837
min    5.000000e-02   0.000002  -0.481894      -2.100527
25%    5.000000e-02   0.001276  -0.139287      -0.607140
50%    5.000000e-02   0.005002  -0.015728      -0.068558
75%    5.000000e-02   0.012359   0.097065       0.423097
max    5.000000e-02   0.505775   1.736734       7.570250
이제 (1)–(3)을 확인한다.
import numpy as np
import pandas as pd
from statsmodels.formula.api import ols

rng = np.random.default_rng(42)
n, k = 20, 3
response = np.concatenate([
    rng.normal(10.0, 1.0, n), rng.normal(10.8, 1.3, n), rng.normal(12.0, 1.6, n)])
response[-1] = 20.0
data = pd.DataFrame({"group": np.repeat(["A", "B", "C"], n), "response": response})
inf = ols("response ~ group", data=data).fit().get_influence()
sf = inf.summary_frame()
N = 3 * n
r, t = inf.resid_studentized_internal, inf.resid_studentized_external

print(f"sum r^2 = {(r ** 2).sum():.6f}  (= N = {N})")
print(f"cooks_d 의 평균 = {sf['cooks_d'].mean():.10f},  1/(N-k) = {1 / (N - k):.10f}")

print(f"\nDFFITS = t * sqrt(h/(1-h)) = t / sqrt(n-1) = t / {np.sqrt(n - 1):.6f}")
print(f"  최대 t = {t.max():.6f}  ->  {t.max() / np.sqrt(n - 1):.6f}")
print(f"  summary_frame 의 dffits 최대 = {sf['dffits'].max():.6f}")

thr_d = 2 * np.sqrt(k / N)
print(f"\nDFFITS 문턱 2*sqrt(p/N) = {thr_d:.6f}")
print(f"  |t| 로 옮기면 {thr_d * np.sqrt(n - 1):.6f} = 2*sqrt(1 - p/N)")
print(f"  걸린 관측 = {np.where(np.abs(sf['dffits'].values) > thr_d)[0]}")
print(f"  Cook 4/N 으로 걸린 관측 = {np.where(sf['cooks_d'].values > 4 / N)[0]}")

print(f"\nstudent_resid: 평균 {t.mean():.6f} (0 이 아니다), "
      f"최대 {t.max():.4f}, 최소 {t.min():.4f}")
print(f"  가장 큰 것을 뺀 |t| 의 최대 = {np.sort(np.abs(t))[-2]:.4f}")
print(f"cooks_d: 3사분위 {sf['cooks_d'].quantile(0.75):.6f}, "
      f"최대 {sf['cooks_d'].max():.6f}  ({sf['cooks_d'].max() / sf['cooks_d'].quantile(0.75):.1f} 배)")
출력:
sum r^2 = 60.000000  (= N = 60)
cooks_d 의 평균 = 0.0175438596,  1/(N-k) = 0.0175438596

DFFITS = t * sqrt(h/(1-h)) = t / sqrt(n-1) = t / 4.358899
  최대 t = 7.570250  ->  1.736734
  summary_frame 의 dffits 최대 = 1.736734

DFFITS 문턱 2*sqrt(p/N) = 0.447214
  |t| 로 옮기면 1.949359 = 2*sqrt(1 - p/N)
  걸린 관측 = [52 59]
  Cook 4/N 으로 걸린 관측 = [52 59]

student_resid: 평균 0.036170 (0 이 아니다), 최대 7.5702, 최소 -2.1005
  가장 큰 것을 뺀 |t| 의 최대 = 2.1005
cooks_d: 3사분위 0.012359, 최대 0.505775  (40.9 배)
세 결과가 모두 맞는다. cooks_d 의 평균이 \(0.0175438596\) 으로 \(1/57\) 과 열째 자리까지 같고, DFFITS 의 최대가 \(7.570250/4.358899 = 1.736734\) 로 표의 max 와 같으며, DFFITS 문턱이 \(\lvert t\rvert > 1.949359\) 로 Cook 의 \(4/N\) 문턱이 주는 수와 정확히 같다. 두 규칙이 이 자료에서는 같은 두 관측 \(\{52, 59\}\) 를 걸러 낸다.
표를 읽으면 이렇다.
hat_diag: 표준편차 \(5.4\times10^{-17}\) 으로 \(60\) 개가 모두 \(0.05\) 다. 보기 3에서 본 대로다. 이 열은 이 설계에서 아무 정보도 담고 있지 않다.cooks_d의mean: \(0.017544\) 는 (3)에서 보았듯 어떤 자료에서도 \(1/57\) 로 나온다. 자료를 읽은 값이 아니다.cooks_d의max와75%: \(0.505775\) 와 \(0.012359\) 로 \(40.9\) 배 차이 난다. 이 간격이 "영향점이 하나 있다"를 말해 주는 실제 증거다.student_resid: 최대 \(7.5702\), 그다음은 \(2.1005\) 다. 둘째와 셋 배 넘게 벌어져 있다. 그리고min이 \(-2.1005\) 로 둘째로 큰 것과 같은 값이므로, 양쪽 꼬리를 통틀어 \(\lvert t\rvert\) 가 \(2.11\) 을 넘는 것은 그 하나뿐이다.student_resid의mean이 \(0.036170\) 으로 \(0\) 이 아니다. 보통의 잔차는 합이 정확히 \(0\) 인데, 외부 스튜던트화 잔차는 관측마다 다른 \(\hat\sigma_{(i)}\) 로 나누므로 그 성질이 깨진다. 이상점의 \(t\) 가 유난히 크게 나오는 것이 바로 그 때문이고, 따라서 \(t\) 들의 합이나 평균을 보는 일에는 뜻이 없다.
마지막으로 네 열의 관계를 정리하면 이렇다. 균형 일원배치에서는
로 네 열이 모두 잔차 \(e_i\) 하나의 단조변환이다. 표가 네 가지를 재는 것처럼 보이지만 실제로 재는 것은 하나이고, 다른 것은 눈금과 기준 분포뿐이다. \(t_i\) 만이 \(t_{N-k-1}\) 분포를 가져 p-값을 붙일 수 있다는 점에서 질적으로 다르다. 이 관계가 깨지는 것은 지렛값이 관측마다 달라질 때, 곧 불균형 설계나 연속형 설명변수가 있을 때다.
세 가지를 읽을 수 있다.
hat_diag의 표준편차가 \(5 \times 10^{-17}\)이다. 사실상 0이며, 균형 설계에서 지렛값이 모두 같다는 것을 부동소수점 오차 수준까지 확인해 준다.student_resid의 최댓값이 7.57이다. 나머지가 \(\pm 2.1\) 안에 있는데 이 하나만 7을 넘는다. 외부 스튜던트화 잔차는 해당 관측값을 빼고 적합한 모형에서 계산하므로, 이상점 자신이 자기 잔차를 줄이는 효과가 제거되어 이렇게 큰 값이 나온다.cooks_d의 4분위수는 모두 0.013 아래인데 최댓값만 0.506이다. 분포의 꼬리가 얼마나 극단적인지 보여준다.
연습문제
연습문제 1. 집단이 셋이고 각각 \(n = 10\)인 일원배치 분산분석에서 어떤 관측값의 Cook의 거리가 \(D_i = 1.2\)이다. 흔히 쓰는 문턱은 \(D_i > 4/N\)이다. 이 점이 영향점인지 판정하고 Cook의 거리가 무엇을 재는지 설명하라.
풀이
문턱은 \(4/N = 4/30 \approx 0.133\)이다. \(D_i = 1.2 \gg 0.133\)이므로 이 관측값은 영향력이 매우 크다.
Cook의 거리는 관측값 \(i\)가 모든 적합값에 동시에 주는 전체적인 영향을 잰다. 지렛값(설명변수값이 얼마나 특이한지)과 잔차의 크기(적합 모형에서 얼마나 떨어져 있는지)를 결합한다. Cook의 거리가 크다는 것은 그 관측값을 제거하면 추정된 집단 평균과 F-통계량이 상당히 달라진다는 뜻이다.
연습문제 2. 분산분석의 맥락에서 이상점, 지렛점, 영향점을 구별하라. 지렛값은 크지만 영향점이 아닌 예를 들어라.
풀이
- 이상점: 잔차가 유별나게 큰(자기 집단 평균에서 멀리 떨어진) 관측값.
- 지렛점: 설명변수값이 특이한 관측값. 분산분석에서는 보통 관측값이 아주 적은 집단에 속해 집단 평균에 더 큰 영향을 주는 경우를 뜻한다.
- 영향점: 제거하면 결과가 상당히 달라지는 관측값. 대체로 지렛값도 크고 잔차도 크다.
지렛값은 크지만 영향점이 아닌 예: 일원배치 분산분석에서 한 집단만 \(n = 3\)이고 다른 집단은 \(n = 30\)이라면 작은 집단의 각 관측값은 지렛값(햇값)이 크다. 그러나 그 관측값들이 자기 집단 평균에 가까우면 잔차가 작아 영향점이 아니다(Cook의 거리가 낮게 유지된다).
연습문제 3. 집단 B의 어떤 관측값에서 DFFITS 값이 \(2\sqrt{p/n}\)을 넘었다. DFFITS가 무엇을 재는지, Cook의 거리와 어떻게 다른지 설명하라.
풀이
DFFITS는 관측값 \(i\)를 삭제했을 때 그 관측값의 적합값이 얼마나 변하는지를 표준오차로 나누어 잰다. 형식적으로
이며 \(\hat{Y}_{i(i)}\)는 관측값 \(i\)를 제외했을 때의 적합값이다.
Cook의 거리와의 핵심 차이는, DFFITS가 하나의 적합값(그 관측값 자신의 예측)에 대한 효과에 초점을 두는 반면 Cook의 거리는 모든 적합값에 대한 효과를 동시에 잰다는 점이다. 영향이 국소적이면 DFFITS는 크지만 Cook의 거리는 중간 정도일 수 있다.
연습문제 4. 이상점 하나를 무한히 키우면 \(F\) 통계량은 어디로 가는가? 답을 유도하고 수치로 확인하라.
풀이
사고실험. 모든 관측이 0이고 첫 관측만 \(\delta\)라 하자(\(k\)개 집단, 집단당 \(n\)개).
이므로
따라서
\(k\)와 \(n\)에 무관하게 정확히 1이다.
import numpy as np
from scipy import stats

print("자료를 모두 0 으로 두고 첫 관측만 δ 로 바꾼다")
print(f"{'k':>3s} {'n':>4s} {'δ=10':>8s} {'δ=100':>8s} {'δ=10^4':>9s} "
      f"{'극한 F':>9s} {'임계값':>8s} {'유의?':>6s}")
for k, n in [(3, 5), (3, 10), (3, 20), (5, 10), (2, 10)]:
    row = []
    for d in [10, 100, 1e4, 1e12]:
        gs = [np.zeros(n) for _ in range(k)]
        gs[0] = gs[0].copy()
        gs[0][0] = d
        row.append(stats.f_oneway(*gs).statistic)
    crit = stats.f.ppf(0.95, k - 1, k * (n - 1))
    print(f"{k:3d} {n:4d} {row[0]:8.3f} {row[1]:8.3f} {row[2]:9.3f} "
          f"{row[3]:9.3f} {crit:8.3f} {'예' if row[3] > crit else '아니오':>6s}")
자료를 모두 0 으로 두고 첫 관측만 δ 로 바꾼다
  k    n     δ=10    δ=100    δ=10^4      극한 F      임계값    유의?
  3    5    1.000    1.000     1.000     1.000    3.885    아니오
  3   10    1.000    1.000     1.000     1.000    3.354    아니오
  3   20    1.000    1.000     1.000     1.000    3.159    아니오
  5   10    1.000    1.000     1.000     1.000    2.579    아니오
  2   10    1.000    1.000     1.000     1.000    4.414    아니오
\(\delta=10\)에서 이미 정확히 1이다. 이 예에서는 다른 관측이 모두 0이므로 처음부터 \(F=1\)이다.
실제 잡음이 있으면 어떻게 되는가.
import warnings
warnings.filterwarnings("ignore")

rng = np.random.default_rng(10003)
B = 4_000
print("k=3, n=10, σ=1. 한 관측에 δ 를 더한다")
print(f"{'δ':>6s} {'F 의 중앙값':>11s} {'p<0.05 비율':>11s}")
for d in [0, 1, 2, 3, 4, 5, 7, 10, 20, 50, 200]:
    Fs, hit = [], 0
    for _ in range(B):
        gs = [rng.normal(0, 1, 10) for _ in range(3)]
        gs[0] = gs[0].copy()
        gs[0][0] += d
        r = stats.f_oneway(*gs)
        Fs.append(r.statistic)
        hit += r.pvalue < 0.05
    print(f"{d:6d} {np.median(Fs):11.4f} {hit / B:11.4f}")
k=3, n=10, σ=1. 한 관측에 δ 를 더한다
     δ     F 의 중앙값   p<0.05 비율
     0      0.7391      0.0558
     1      0.7081      0.0517
     2      0.7004      0.0510
     3      0.7237      0.0435
     4      0.7492      0.0420
     5      0.7822      0.0382
     7      0.8213      0.0235
    10      0.8993      0.0095
    20      0.9651      0.0000
    50      0.9947      0.0000
   200      0.9992      0.0000
\(\delta\)가 커질수록 \(F\)의 중앙값이 1로 수렴하고 기각률은 0으로 간다.
| \(\delta\) | \(F\) 중앙값 | 기각률 |
|---|---|---|
| 0 | 0.739 | 0.056 |
| 5 | 0.782 | 0.038 |
| 10 | 0.899 | 0.010 |
| \(\geq20\) | 0.965~0.999 | 0.000 |
놀라운 결론 — 큰 이상점 하나는 \(F\) 검정을 "유의하게" 만들지 못한다. 오히려 완전히 무력화한다.
왜 그런가. 이상점이 SSB와 SSE를 같은 비율로 부풀리기 때문이다. \(\delta^2\)이 분자와 분모에서 상쇄되어 \(F\to1\)이다.
그러나 이것은 "안전하다"는 뜻이 아니다.
| 상황 | 결과 |
|---|---|
| 참 차이가 없다 | 이상점이 오류율을 낮춘다(무해) |
| 참 차이가 있다 | 이상점이 \(F\)를 1로 눌러 차이를 지운다 |
두 번째가 진짜 위험이다. 이상점 하나가 실재하는 집단 차이를 감춘다. 연습문제 8의 예에서 \(p=0.28\)이 이상점을 빼면 \(p=0.011\)이 된다.
정리. 분산분석에서 이상점의 주된 해악은 거짓 양성이 아니라 거짓 음성이다. "이상점 때문에 유의하게 나왔다"보다 "이상점 때문에 유의하지 않게 나왔다"가 훨씬 흔하다.
연습문제 5. 이상점이 둘 이상이면 탐지가 실패한다(가림 현상). 모의실험으로 확인하라.
풀이
import warnings
warnings.filterwarnings("ignore")

import numpy as np
import pandas as pd
from scipy import stats
from statsmodels.formula.api import ols

rng = np.random.default_rng(10002)
B = 3_000
N = 24
tb = stats.t.ppf(1 - 0.05 / (2 * N), N - 3 - 1)   # 본페로니 임계값
print(f"집단 크기 (8,8,8), 첫 집단에 크기 δ 의 이상점을 1개 또는 2개 넣는다")
print(f"본페로니 임계값 = {tb:.4f}")
print(f"{'δ':>5s} {'이상점 1개 탐지율':>15s} {'2개 중 하나라도':>15s} {'2개 모두':>10s}")
for D in [3.0, 4.0, 5.0, 6.0]:
    a = b = c = 0
    for _ in range(B):
        base = [rng.normal(0, 1, 8) for _ in range(3)]

        gs = [x.copy() for x in base]
        gs[0][0] += D
        df = pd.DataFrame({"y": np.concatenate(gs),
                           "g": np.repeat([0, 1, 2], 8).astype(str)})
        te = (ols("y ~ C(g)", data=df).fit()
              .get_influence().resid_studentized_external)
        a += abs(te[0]) > tb

        gs = [x.copy() for x in base]
        gs[0][0] += D
        gs[0][1] += D
        df = pd.DataFrame({"y": np.concatenate(gs),
                           "g": np.repeat([0, 1, 2], 8).astype(str)})
        te = (ols("y ~ C(g)", data=df).fit()
              .get_influence().resid_studentized_external)
        b += (abs(te[0]) > tb) or (abs(te[1]) > tb)
        c += (abs(te[0]) > tb) and (abs(te[1]) > tb)
    print(f"{D:5.1f} {a / B:15.4f} {b / B:15.4f} {c / B:10.4f}")
집단 크기 (8,8,8), 첫 집단에 크기 δ 의 이상점을 1개 또는 2개 넣는다
본페로니 임계값 = 3.5342
    δ      이상점 1개 탐지율       2개 중 하나라도      2개 모두
  3.0          0.2780          0.1463     0.0000
  4.0          0.5893          0.2540     0.0000
  5.0          0.8500          0.4123     0.0000
  6.0          0.9690          0.5167     0.0000
이상점이 둘이면 탐지율이 절반으로 떨어진다.
| \(\delta\) | 1개일 때 | 2개 중 하나라도 | 2개 모두 |
|---|---|---|---|
| 4 | 0.589 | 0.254 | 0.000 |
| 5 | 0.850 | 0.412 | 0.000 |
| 6 | 0.969 | 0.517 | 0.000 |
두 이상점을 모두 찾는 경우는 단 한 번도 없다. 12,000번의 모의실험에서 0회다.
왜 그런가 — 가림 현상. 이상점이 둘이면
- 집단 평균이 두 점 쪽으로 크게 이동하고
- 두 점의 잔차가 작아지며
- \(\hat\sigma\)도 커져 분모까지 부푼다
\(\delta=6\), \(n=8\)이면 두 점이 평균을 \(2\times6/8=1.5\)만큼 끌어올린다. 각 점의 잔차가 \(6-1.5=4.5\)로 줄고, 나머지 여섯 점의 잔차는 \(-1.5\)가 된다.
삭제 잔차도 막지 못한다. 한 점을 빼도 다른 이상점이 남아 \(\hat\sigma_{(i)}\)가 여전히 크기 때문이다.
\(\delta=3\)에서 "2개 중 하나라도"가 1개일 때보다 낮다(0.146 대 0.278). 둘째 이상점이 첫째를 적극적으로 감춘다.
반대 현상도 있다 — 늪 현상(swamping). 이상점이 평균을 끌어당기면 정상 관측이 이상점으로 표시될 수 있다. 잔차 분석 페이지 연습문제 8에서 본 잔차의 음의 상관이 원인이다.
처방 넷.
| 방법 | 내용 |
|---|---|
| 로버스트 추정으로 시작 | MM-추정, 절사평균으로 적합한 뒤 잔차를 본다 |
| 집단별 중앙값·MAD | 최소제곱의 영향을 받지 않는다 |
| 순차적 제거 | 하나씩 빼며 반복(가림을 조금 완화, 다중성 주의) |
| 그림으로 본다 | 상자그림·점 그림이 검정보다 나을 때가 많다 |
첫 번째가 원칙적인 해법이다. 이상점을 찾으려고 이상점에 영향받는 추정량을 쓰는 것이 문제의 근원이다.
연습문제 6. 이상점이 섞인 자료에서 \(F\) 검정·크러스컬-월리스·절사평균 웰치의 검정력을 비교하라.
풀이
import numpy as np
from scipy import stats

def trim_welch(gs, tr=0.2):
    """20% 절사평균에 웰치 구조를 씌운 검정."""
    st = []
    for g in gs:
        x = np.sort(g)
        n = len(x)
        k = int(np.floor(tr * n))
        win = np.clip(x, x[k], x[n - k - 1])
        d = win.var(ddof=1) * (n - 1) / ((n - 2 * k - 1) * (n - 2 * k))
        st.append((x[k:n - k].mean(), d, n - 2 * k))
    m = np.array([s[0] for s in st])
    d = np.array([s[1] for s in st])
    h = np.array([s[2] for s in st], float)
    k = len(gs)
    w = 1 / d
    W = w.sum()
    mt = (w * m).sum() / W
    lam = ((1 - w / W)**2 / (h - 1)).sum()
    F = ((w * (m - mt)**2).sum() / (k - 1)
         / (1 + 2 * (k - 2) / (k**2 - 1) * lam))
    return stats.f.sf(F, k - 1, (3 / (k**2 - 1) * lam)**-1)

rng = np.random.default_rng(10004)
B = 4_000
print("k=3, n=20, 참 평균 (0, 0.6, 1.2), 오차 σ=1 에 오염을 섞는다")
print(f"{'오염':>22s} {'F 검정':>8s} {'크러스컬-월리스':>14s} {'20% 절사 웰치':>13s}")
for lab, eps, sc in [("없음", 0.0, 1), ("5% 가 σ=5 인 정규", 0.05, 5),
                     ("10% 가 σ=5 인 정규", 0.10, 5),
                     ("5% 가 σ=10 인 정규", 0.05, 10)]:
    a = b = c = 0
    for _ in range(B):
        gs = []
        for mu in [0, 0.6, 1.2]:
            x = rng.normal(mu, 1, 20)
            m = rng.random(20) < eps
            x[m] = mu + rng.normal(0, sc, m.sum())
            gs.append(x)
        a += stats.f_oneway(*gs).pvalue < 0.05
        b += stats.kruskal(*gs).pvalue < 0.05
        c += trim_welch(gs) < 0.05
    print(f"{lab:>22s} {a / B:8.4f} {b / B:14.4f} {c / B:13.4f}")
k=3, n=20, 참 평균 (0, 0.6, 1.2), 오차 σ=1 에 오염을 섞는다
                    오염     F 검정       크러스컬-월리스     20% 절사 웰치
                    없음   0.9257         0.9062        0.8502
         5% 가 σ=5 인 정규   0.6410         0.8380        0.7977
        10% 가 σ=5 인 정규   0.4990         0.7775        0.7582
        5% 가 σ=10 인 정규   0.4128         0.8200        0.8005
오염 5%만으로 \(F\) 검정의 검정력이 0.926에서 0.641로 떨어진다.
| 오염 | \(F\) | KW | 절사 웰치 |
|---|---|---|---|
| 없음 | 0.926 | 0.906 | 0.850 |
| 5%, \(\sigma=5\) | 0.641 | 0.838 | 0.798 |
| 10%, \(\sigma=5\) | 0.499 | 0.778 | 0.758 |
| 5%, \(\sigma=10\) | 0.413 | 0.820 | 0.801 |
오염의 크기가 커져도 로버스트 방법은 거의 영향받지 않는다. \(\sigma=5\)에서 \(\sigma=10\)으로 두 배 키워도 크러스컬-월리스는 0.838 → 0.820이다. \(F\)는 0.641 → 0.413으로 무너진다.
왜 그런가. 로버스트 방법은 극단값의 크기를 보지 않는다.
| 방법 | 극단값이 미치는 영향 |
|---|---|
| \(F\) | \(\delta^2\)에 비례해 MSE를 부풀림 |
| 크러스컬-월리스 | 순위가 1 바뀔 뿐 |
| 20% 절사 | 아예 잘려 나감 |
오염이 없을 때의 손실은 작다.
| 방법 | 오염 없을 때 | 상대 손실 |
|---|---|---|
| \(F\) | 0.926 | 기준 |
| 크러스컬-월리스 | 0.906 | \(-2\%\) |
| 20% 절사 웰치 | 0.850 | \(-8\%\) |
크러스컬-월리스의 보험료가 2%로 매우 싸다. 오염이 조금이라도 의심되면 유리하다.
절사 웰치의 손실이 큰 이유. 20% 절사는 \(n=20\)에서 각 집단에서 8개를 버린다. 정보 손실이 크다. tr=0.1이면 손실이 줄지만 로버스트성도 줄어든다.
그러나 셋은 다른 모수를 검정한다(정규성 페이지 연습문제 7·9).
| 방법 | 모수 |
|---|---|
| \(F\) | 평균 |
| 크러스컬-월리스 | 확률적 우위 |
| 절사 웰치 | 절사평균 |
"평균"이 관심사인데 오염이 있다면, 순열검정이나 평균에 대한 부트스트랩을 쓰는 것이 모수를 바꾸지 않는 해법이다.
연습문제 7. 연습문제 3(및 가정 위반 처리 페이지)이 경고한 "이상점을 그냥 제거하는 것"의 대가를 정량화하라.
풀이
import numpy as np
from scipy import stats

def p_after_removing(gs, howmany):
    """가장 큰 |표준화 잔차| 를 howmany 개 제거한 뒤 F 검정."""
    y = np.concatenate(gs)
    lab = np.repeat([0, 1, 2], [len(g) for g in gs])
    for _ in range(howmany):
        mm = np.array([y[lab == i].mean() for i in range(3)])
        s = np.array([y[lab == i].std(ddof=1) for i in range(3)])
        z = (y - mm[lab]) / s[lab]
        j = np.argmax(np.abs(z))
        y = np.delete(y, j)
        lab = np.delete(lab, j)
    return stats.f_oneway(*[y[lab == i] for i in range(3)]).pvalue

rng = np.random.default_rng(10005)
B = 6_000
print("모든 집단의 참 평균이 같음 (k=3, n=15), 이상점 없음. 명목 0.05")
print(f"{'절차':>34s} {'실제 오류율':>11s}")
for lab, how in [("제거 없음", 0), ("가장 큰 잔차 1개 제거", 1),
                 ("2개 제거", 2), ("3개 제거", 3)]:
    a = sum(p_after_removing([rng.normal(0, 1, 15) for _ in range(3)], how) < 0.05
            for _ in range(B))
    print(f"{lab:>34s} {a / B:11.4f}")
모든 집단의 참 평균이 같음 (k=3, n=15), 이상점 없음. 명목 0.05
                                절차      실제 오류율
                             제거 없음      0.0495
                     가장 큰 잔차 1개 제거      0.0913
                             2개 제거      0.1152
                             3개 제거      0.1538
잔차가 가장 큰 관측을 하나만 지워도 오류율이 0.05에서 0.091로 두 배가 된다.
| 제거 개수 | 오류율 | 명목 대비 |
|---|---|---|
| 0 | 0.050 | 1.0배 |
| 1 | 0.091 | 1.8배 |
| 2 | 0.115 | 2.3배 |
| 3 | 0.154 | 3.1배 |
왜 그런가. 제거 기준이 자료에 의존하기 때문이다. 가장 큰 잔차를 지우면
- MSE가 체계적으로 작아지고(\(F\)의 분모)
- 집단 평균은 거의 그대로(\(F\)의 분자)
그 결과 \(F\)가 인위적으로 커진다. 자유도는 \(N-k\)에서 \(N-k-1\)로 1만 줄어드는데, MSE는 그보다 훨씬 많이 줄어든다.
이것이 "이상점 제거"의 숨은 비용이다. 제거 자체가 나쁜 것이 아니라, 자료를 보고 제거 기준을 정하는 것이 나쁘다.
정당한 제거와 부당한 제거.
| 제거 근거 | 정당한가 |
|---|---|
| 기록 오류를 확인(원 기록과 대조) | 정당 |
| 다른 모집단에서 옴(장비 고장, 다른 프로토콜) | 정당 |
| 사전에 정한 규칙(예: 물리적으로 불가능한 값) | 정당 |
| 쿡 거리가 크다 | 부당 |
| 잔차가 크다 | 부당 |
| 제거하면 유의해진다 | 명백히 부당 |
정당한 근거의 공통점은 "\(y\) 값을 보지 않고도 판단할 수 있다"는 것이다.
그럼 이상점이 진짜 있으면 어떻게 하나.
| 방법 | 왜 |
|---|---|
| 로버스트 방법 | 제거하지 않고 영향을 줄인다 |
| 민감도 분석 | 있을 때와 없을 때를 모두 보고(연습문제 8) |
| 순열검정 | 이상점을 포함한 채 영분포를 만든다 |
| 절사평균 검정 | 절사 규칙을 사전에 고정 |
네 번째가 중요하다. 20% 절사를 자료를 보기 전에 정하면 문제가 없다. 20%를 자를지 10%를 자를지를 결과를 보고 고르면 같은 문제가 생긴다.
연습문제 8. 민감도 분석을 구현하라. 영향점이 결론을 바꾸는 구체적인 예를 만들어 보고 형식까지 제시하라.
풀이
import warnings
warnings.filterwarnings("ignore")

import numpy as np
import pandas as pd
from scipy import stats
import statsmodels.api as sm
from statsmodels.formula.api import ols

rng = np.random.default_rng(10006)
rows = [pd.DataFrame({"y": np.round(rng.normal(mu, 2.0, n), 2), "g": f"G{g}"})
        for g, (n, mu) in enumerate([(12, 20.0), (12, 22.5), (12, 21.0)])]
df = pd.concat(rows, ignore_index=True)
df.loc[5, "y"] = 31.0                       # G0 에 이상점 하나

def report(d, tag):
    f = ols("y ~ C(g)", data=d).fit()
    t = sm.stats.anova_lm(f, typ=2)
    mse = t.loc["Residual", "sum_sq"] / t.loc["Residual", "df"]
    m = d.groupby("g").y.mean().round(3)
    return (f"{tag:>22s}  F={t.loc['C(g)', 'F']:7.4f}  "
            f"p={t.loc['C(g)', 'PR(>F)']:.4f}  MSE={mse:7.4f}  평균={list(m)}")

print(report(df, "전체 자료"))

inf = ols("y ~ C(g)", data=df).fit().get_influence()
D = inf.cooks_distance[0]
te = inf.resid_studentized_external
order = np.argsort(-D)[:3]
N = len(df)
tb = stats.t.ppf(1 - 0.05 / (2 * N), N - 3 - 1)
print(f"\n쿡 거리 상위 3: 행 {list(order)},  D = {np.round(D[order], 4).tolist()}")
print(f"  해당 스튜던트화 잔차 = {np.round(te[order], 3).tolist()}")
print(f"  본페로니 임계값 = {tb:.4f}  →  "
      f"이상점 판정: {[bool(abs(te[i]) > tb) for i in order]}")
print()
print(report(df.drop(index=order[0]), "최대 D 제거"))
print(report(df.drop(index=list(order[:2])), "상위 2개 제거"))
w = df.copy()
w.loc[order[0], "y"] = df.groupby("g").y.median()[df.loc[order[0], "g"]]
print(report(w, "중앙값으로 대체"))
                 전체 자료  F= 1.3215  p=0.2805  MSE= 7.5736  평균=[20.543, 22.31, 21.025]

쿡 거리 상위 3: 행 [5, 35, 10],  D = [0.4773, 0.102, 0.0812]
  해당 스튜던트화 잔차 = [5.405, -1.907, -1.682]
  본페로니 임계값 = 3.5010  →  이상점 판정: [True, False, False]

               최대 D 제거  F= 5.1898  p=0.0112  MSE= 4.0827  평균=[19.593, 22.31, 21.025]
              상위 2개 제거  F= 6.4731  p=0.0045  MSE= 3.3917  평균=[19.593, 22.31, 21.465]
              중앙값으로 대체  F= 5.5840  p=0.0082  MSE= 3.9590  평균=[19.597, 22.31, 21.025]
결론이 완전히 뒤집힌다. 전체 자료에서 \(p=0.28\)(유의하지 않음), 이상점 하나를 빼면 \(p=0.011\)(유의함)이다.
| 자료 | \(F\) | \(p\) | MSE |
|---|---|---|---|
| 전체 | 1.32 | 0.281 | 7.57 |
| 최대 \(D\) 제거 | 5.19 | 0.011 | 4.08 |
| 상위 2개 제거 | 6.47 | 0.005 | 3.39 |
| 중앙값 대체 | 5.58 | 0.008 | 3.96 |
MSE가 7.57에서 4.08로 반토막난다. 연습문제 4에서 본 대로 이상점이 \(F\)를 1 쪽으로 눌렀던 것이다.
\(D=0.4773\)은 \(4/N=0.111\)을 훨씬 넘지만 \(1\)보다는 작다. 그런데도 결론이 바뀐다. \(D>1\) 기준은 너무 관대할 수 있다.
스튜던트화 잔차 5.405가 본페로니 임계값 3.501을 넘는다. 이 관측은 형식적 검정으로도 이상점이다.
보고 형식.
관측 #5 (G0, y = 31.0) 이 영향점으로 확인되었다.
  · 쿡 거리 D = 0.477 (다음으로 큰 값은 0.102)
  · 외적 스튜던트화 잔차 t = 5.41, 본페로니 보정 p < 0.01

이 관측의 포함 여부에 따라 결론이 달라진다.
  · 포함: F(2, 33) = 1.32,  p = 0.281
  · 제외: F(2, 32) = 5.19,  p = 0.011

기록을 확인한 결과 [측정 오류로 판명 / 오류를 발견하지 못함].
따라서 [제외한 결과를 / 두 결과를 모두] 보고한다.
대괄호 부분이 통계가 답할 수 없는 부분이다. 기록을 확인하는 것은 연구자의 일이다.
민감도 분석의 절차 다섯.
- 쿡 거리를 크기순으로 정렬해 상위 몇 개를 고른다.
- 각각에 대해 본페로니 보정 이상점 검정을 한다.
- 빼고 다시 적합해 \(F\), \(p\), 효과크기, MSE를 비교한다.
- 대체(중앙값·윈저화) 결과도 함께 본다.
- 결론이 바뀌면 모든 결과를 보고하고, 바뀌지 않으면 그 사실을 한 줄로 쓴다.
네 번째가 유용하다. 제거와 대체가 같은 결론을 주면(여기서는 \(p=0.011\)과 \(0.008\)) 처리 방식에 민감하지 않다는 뜻이다.
연습문제 9. 연습문제 3의 DFFITS 외에 DFBETAS가 있다. 무엇을 재며 언제 유용한지 연습문제 8의 자료로 보여라.
풀이
정의. 관측 \(i\)를 뺐을 때 계수 \(\beta_j\)가 얼마나 움직이는지를 표준오차 단위로 잰다.
관례적 문턱은 \(2/\sqrt N\)이다.
import warnings
warnings.filterwarnings("ignore")

import numpy as np
import pandas as pd
from statsmodels.formula.api import ols

rng = np.random.default_rng(10006)
rows = [pd.DataFrame({"y": np.round(rng.normal(mu, 2.0, n), 2), "g": f"G{g}"})
        for g, (n, mu) in enumerate([(12, 20.0), (12, 22.5), (12, 21.0)])]
df = pd.concat(rows, ignore_index=True)
df.loc[5, "y"] = 31.0

fit = ols("y ~ C(g)", data=df).fit()
inf = fit.get_influence()
db = inf.dfbetas
names = list(fit.params.index)
order = np.argsort(-inf.cooks_distance[0])[:3]
N = len(df)

print(f"{'행':>4s} " + " ".join(f"{n:>16s}" for n in names))
for i in order:
    print(f"{i:4d} " + " ".join(f"{db[i, j]:16.4f}" for j in range(len(names))))
print(f"\n문턱 2/√N = {2 / np.sqrt(N):.4f}")
   행        Intercept       C(g)[T.G1]       C(g)[T.G2]
   5           1.6297          -1.1524          -1.1524
  35           0.0000          -0.0000          -0.4066
  10          -0.5071           0.3586           0.3586

문턱 2/√N = 0.3333
행 5가 세 계수를 모두 크게 움직인다. 절편을 \(+1.63\) 표준오차, 두 집단 대비를 각각 \(-1.15\) 표준오차만큼 이동시킨다.
| 행 | 절편 | \(G_1\) 대비 | \(G_2\) 대비 |
|---|---|---|---|
| 5 | 1.630 | \(-1.152\) | \(-1.152\) |
| 35 | 0.000 | 0.000 | \(-0.407\) |
| 10 | \(-0.507\) | 0.359 | 0.359 |
행 35의 절편 DFBETAS가 정확히 0이다. 이 관측은 \(G_2\)에 속하는데, 처리 대비에서 절편은 \(G_0\)의 평균이므로 \(G_2\)의 관측을 빼도 절편이 움직이지 않는다.
행 5의 \(G_1\)·\(G_2\) 대비가 같은 값인 것도 같은 이유다. 행 5는 \(G_0\)에 속하고, 두 대비는 모두 \(G_0\)을 기준으로 하므로 같은 크기로 같은 방향으로 흔들린다.
DFBETAS의 고유한 가치 — 어느 계수가 흔들리는지 알려 준다.
| 지표 | 알려 주는 것 | 개수 |
|---|---|---|
| 쿡 거리 | 계수 전체의 이동 | 관측당 1개 |
| DFFITS | 그 관측의 적합값 이동 | 관측당 1개 |
| DFBETAS | 계수별 이동 | 관측당 \(p\)개 |
쿡 거리는 요약, DFBETAS는 분해다. \(D_i\)가 크면 "어딘가 흔들린다"를 알고, DFBETAS를 보면 "어느 대비가 흔들리는지"를 안다.
언제 유용한가.
| 상황 | DFBETAS가 도움이 되는가 |
|---|---|
| 특정 대비가 연구의 핵심 | 그렇다(그 계수만 보면 된다) |
| 계수가 많은 회귀 | 그렇다 |
| 일원배치 분산분석, \(k\)가 작음 | 쿡 거리로 충분 |
| 요인설계의 교호작용 | 그렇다(교호작용 계수를 따로) |
분산분석에서는 대체로 쿡 거리로 충분하다. 계수가 \(k\)개뿐이고, 한 관측은 자기 집단의 계수만 흔들기 때문이다.
주의 — 처리 대비에서는 해석이 기준 수준에 의존한다. 행 5의 DFBETAS가 \(G_1\)·\(G_2\) 대비 모두에 나타난 것은 그 관측이 기준 집단 \(G_0\)에 있기 때문이다. 합 대비를 쓰면 다른 패턴이 나온다.
연습문제 10. 영향점 분석의 전체 절차를 정리하라.
풀이
세 개념의 구분(연습문제 2의 정리).
| 개념 | 정의 | 분산분석에서 |
|---|---|---|
| 이상점 | \(y\)가 모형 예측에서 크게 벗어남 | 스튜던트화 잔차 |
| 지렛점 | \(x\)가 극단적 | \(h_{ii}=1/n_i\) — 집단 크기만 반영 |
| 영향점 | 빼면 결론이 바뀜 | 쿡 거리, DFFITS |
분산분석에서 지렛점은 진단 대상이 아니다. 작은 집단의 모든 관측이 자동으로 지렛값이 크다. "작은 집단의 관측 하나가 더 큰 영향을 준다"는 구조적 사실일 뿐이다.
핵심 수치 다섯.
| 사실 | 값 |
|---|---|
| 이상점을 무한히 키울 때 \(F\)의 극한 | 정확히 1 |
| 이상점 2개를 모두 탐지할 확률 | 0.000 |
| 5% 오염에서 \(F\)의 검정력 손실 | 0.93 → 0.64 |
| 잔차 최대 1개 제거의 오류율 | 0.05 → 0.09 |
| 깨끗한 자료에서 \(D>4/N\) 비율 | 5% |
절차.
1. 집단별 상자그림 — 눈으로 먼저
     ↓
2. 쿡 거리를 크기순 정렬 — 뚜렷하게 튀는 점이 있는가
     ↓
3. 스튜던트화(삭제) 잔차 — 본페로니 임계값과 비교
     ↓
4. DFBETAS — 어느 대비가 흔들리는가 (필요하면)
     ↓
5. 민감도 분석 — 빼고/대체하고 다시 적합
     ↓
6. 기록 확인 — 오류인가, 다른 모집단인가, 그냥 극단값인가
     ↓
7. 보고 — 결론이 바뀌면 모든 결과를, 아니면 그 사실을
6번을 5번 뒤에 둔 것이 의도적이다. 결론이 바뀌지 않으면 굳이 파고들 필요가 없다. 바뀔 때만 기록을 확인하는 비용을 들인다.
제거의 원칙.
| 근거 | 판정 |
|---|---|
| 기록 오류 확인 | 제거 가능 |
| 다른 모집단·프로토콜 | 제거 가능(그 사실을 보고) |
| 사전에 정한 규칙 | 제거 가능 |
| 통계적 지표가 크다 | 제거 불가 |
| 제거하면 유의해진다 | 명백히 불가 |
대안 넷.
| 방법 | 내용 |
|---|---|
| 크러스컬-월리스 | 순위 기반, 보험료 2% |
| 절사평균 검정 | 절사율을 사전에 고정 |
| 윈저화 | 극단값을 자르지 않고 눌러 놓음 |
| 민감도 분석 | 제거 여부를 정하지 않고 둘 다 보고 |
흔한 오해 넷.
| 오해 | 사실 |
|---|---|
| 이상점은 거짓 양성을 만든다 | 분산분석에서는 거짓 음성이 흔하다(연습문제 4) |
| \(D>4/N\)이면 이상점 | 깨끗한 자료에도 5% 있다 |
| 큰 잔차를 지우면 깨끗해진다 | 오류율이 두 배가 된다 |
| 이상점을 다 찾을 수 있다 | 둘 이상이면 가림 현상 |
한 문장. 영향점 분석의 목표는 관측을 제거하는 것이 아니라, 결론이 몇 개의 관측에 얼마나 의존하는지 밝히는 것이다.
정리하며
관측 몇 개가 결론을 뒤집을 수 있다.
- 두 가지를 구별한다. 이상점은 반응값이 특이한 경우이고, 지렛점은 설명변수값이 특이한 경우다. 분산분석에서는 집단 배정이 설명변수이므로 주로 이상점이 문제가 된다.
- 영향은 집단 평균과 MSE 둘 다에 미친다. 한 집단의 극단값 하나가 그 집단 평균을 끌고 가면서 동시에 합동 분산을 부풀려, \(F\) 를 키울 수도 줄일 수도 있다.
- 쿡 거리와 표준화 잔차가 진단 도구다. 13장의 회귀 진단과 같은 지표를 쓰며, 분산분석이 회귀의 특수한 경우이기 때문이다.
- 작은 집단에서 특히 위험하다. 집단당 관측이 5 개인데 하나가 이상점이면 그 집단 평균의 \(20\%\) 를 한 점이 결정한다.
- 찾았다고 지우는 것이 아니다. 기록 오류인지, 드물지만 실재하는 값인지 확인해야 하며, 지운 경우에는 반드시 밝힌다. 결과가 그 결정에 좌우된다면 양쪽 결과를 모두 보고하는 것이 정직하다.
다음 절 가정 위반의 처리로 넘어간다.