유의성의 해석
회귀계수의 유의성을 해석하는 일은 선형회귀 결과를 이해하는 데 결정적인 단계이다. 유의성은 설명변수가 우연으로 기대되는 수준을 넘어 결과변수와 의미 있는 관계를 갖는지를 알려준다.
통계적 유의성과 실질적 유의성
이 두 개념을 구분하는 것이 중요하다.
- 통계적 유의성: p값이 미리 정한 문턱값(보통 0.05)보다 작으면 계수가 통계적으로 유의하다. 그 관계가 우연히 나타났을 가능성이 낮다는 뜻이다.
- 실질적 유의성: 계수가 통계적으로 유의하더라도 효과의 크기가 현실에서 의미를 갖기에는 너무 작을 수 있다. 실질적 유의성은 관계의 크기와 그것이 맥락 안에서 의미 있는지를 따진다.
작지만 유의한 효과
교육 연수로 연봉을 예측하는 모형에서 통계적으로 유의한 계수가 교육 1년 추가가 연봉 $100 증가와 연관됨을 나타낼 수 있다. 그러나 교육 비용이 이 금액을 훨씬 웃돈다면 그 효과는 실질적으로 의미 있다고 하기 어렵다.
유의성 판단을 위한 p값 해석
p값은 귀무가설(\(\beta_i = 0\)) 아래에서 관측된 관계(또는 더 극단적인 관계)가 나타날 확률이다.
| p값 | 결론 |
|---|---|
| \(< 0.01\) | \(H_0\)에 반하는 강한 증거 — 매우 유의함 |
| \(< 0.05\) | 충분한 증거 — 통계적으로 유의함 |
| \(\geq 0.05\) | 증거 부족 — 통계적으로 유의하지 않음 |
문턱값은 임의적이다
0.05라는 문턱값은 관행이지 자연법칙이 아니다. 의학 시험처럼 어떤 맥락에서는 0.01 같은 더 엄격한 문턱값을 쓴다. p값이 작다는 것은 유의함을 나타낼 뿐, 효과의 크기나 실질적 중요성에 대해서는 아무 정보도 주지 않는다.
신뢰구간과 유의성
신뢰구간은 유의성을 보는 또 다른 관점을 제공한다. 95% 신뢰구간은 참 모집단 계수가 놓일 가능성이 높은 범위를 준다.
| 경우 | 95% 신뢰구간 | 결론 |
|---|---|---|
| 설명변수 A | (1.5, 3.5) | 유의함 — 구간이 0을 배제한다 |
| 설명변수 B | (−0.5, 2.5) | 유의하지 않음 — 구간이 0을 포함한다 |
신뢰구간의 폭은 정밀도도 나타낸다. 구간이 좁을수록 추정이 정밀하다.
효과 크기와 실질적 해석
통계적 유의성을 넘어, 효과 크기는 설명변수가 결과변수를 얼마나 변화시키는지를 잰다. 표본이 크면 효과가 무시할 만한 설명변수에서도 아주 작은 p값이 나올 수 있다.
큰 표본, 작은 효과
관측값이 10,000개인 연구에서 \(p = 0.001\)로 유의한 설명변수를 찾았더라도, 실제 효과는 설명변수 한 단위 증가당 0.01 단위 변화 정도로 작을 수 있다. 통계적으로는 유의하지만 실질적으로는 의미가 없다.
p값과 함께 효과 크기를 보고하면 설명변수의 중요성을 더 온전히 보여줄 수 있다.
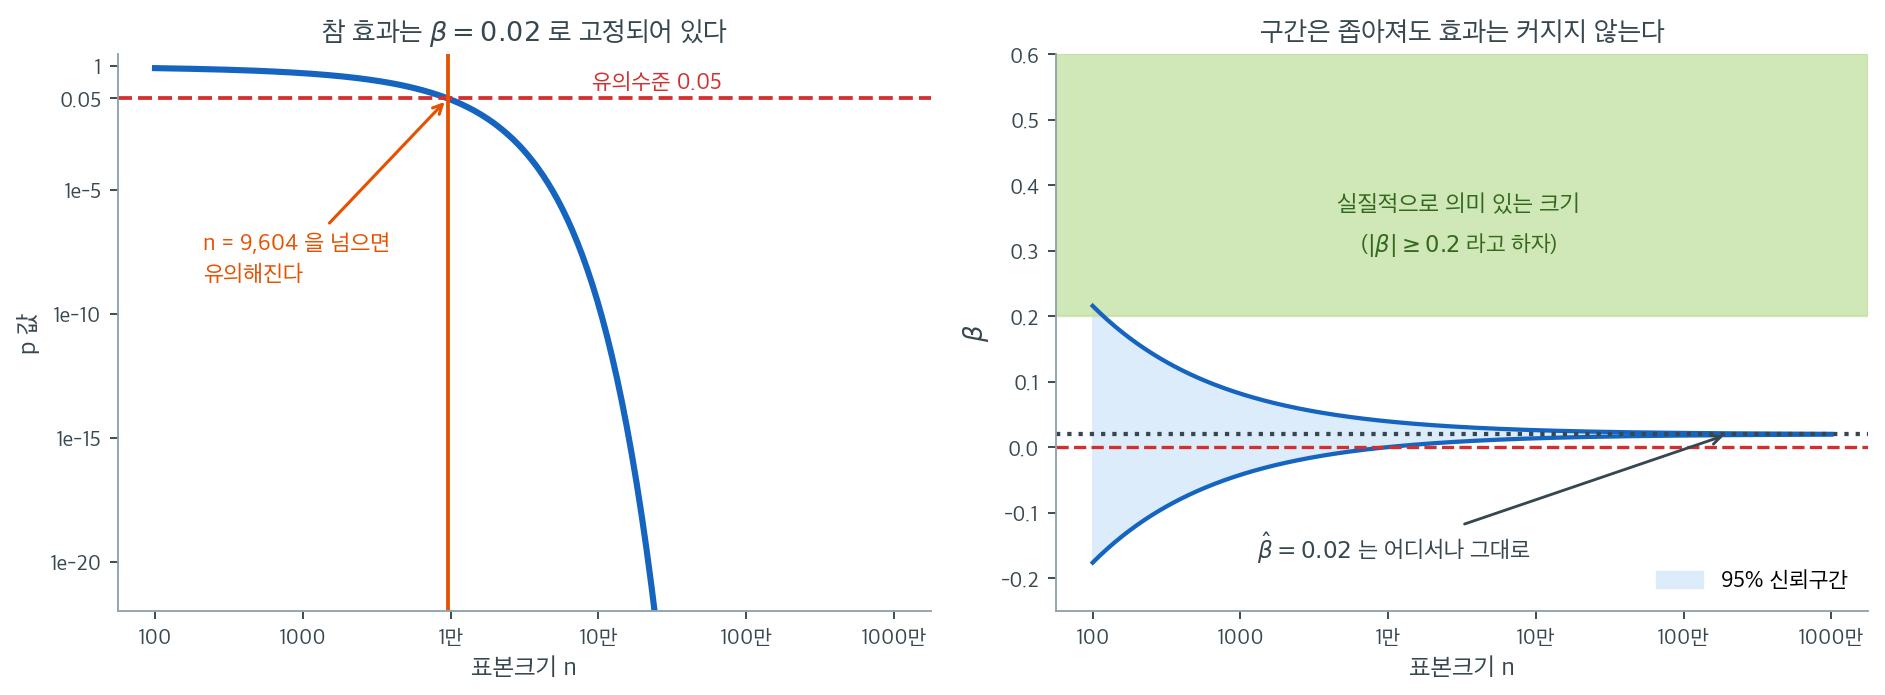
위 상자의 이야기를 수로 따라가 보자. 참 효과를 \(\beta = 0.02\)로, 오차의 표준편차를 \(\sigma = 1\)로 고정해 두고 표본크기만 키운다. 세상은 조금도 변하지 않는다. 변하는 것은 우리가 가진 자료의 양뿐이다.
왼쪽이 \(p\)값의 행로다. \(n = 1000\)에서는 \(\mathrm{SE} = 0.0316\), \(t = 0.63\), \(p = 0.53\)으로 전혀 유의하지 않다. \(n\)이 \(9{,}604\)를 넘어서면 \(p\)가 \(0.05\) 아래로 내려가고, 그 뒤로는 걷잡을 수 없이 떨어진다. \(n = 10^6\)에서 \(t = 20.0\), \(p \approx 5.5 \times 10^{-89}\)이고 \(n = 10^7\)에서는 \(t = 63.3\)이다. 세로축이 로그 눈금인데도 곡선이 화면 아래로 곤두박질친다. \(p\)값은 표본크기의 함수이지 효과 크기의 함수가 아니다. 참 효과가 \(0\)이 아니기만 하면, 자료를 충분히 모았을 때 유의해지지 않는 계수란 없다.
오른쪽이 신뢰구간의 행로다. 여기서는 전혀 다른 이야기가 들린다. 구간은 좁아지지만 언제나 \(0.02\) 둘레를 감싼 채로 좁아진다. \(n = 10^4\)에서 \((0.0004,\ 0.0396)\), \(n = 10^6\)에서 \((0.0180,\ 0.0220)\), \(n = 10^7\)에서 \((0.0194,\ 0.0206)\)이다. 초록으로 칠한 영역은 이 문제에서 실질적으로 의미 있다고 합의한 크기(\(|\beta| \geq 0.2\))인데, 구간은 자라기는커녕 그쪽으로 다가가지도 않는다. 오히려 \(n\)이 커질수록 "이 효과는 \(0.02\) 근처이고 \(0.2\) 근처가 결코 아니다"라고 더 단호하게 말해 준다.
여기서 실무 규칙이 나온다. 큰 자료에서 \(p\)값은 거의 정보를 주지 않는다. \(p < 0.001\)이라는 사실은 "표본이 컸다"는 말과 구별되지 않는다. 반면 신뢰구간은 \(n\)이 커질수록 유용해진다. 효과의 크기를 점점 더 좁은 범위로 못 박아 주기 때문이다. 그러므로 대규모 자료를 다룰 때는 유의성 판정을 아예 건너뛰고 구간을 보고한 뒤, 그 구간 전체가 실질적 의미의 문턱 아래에 있는지를 묻는 편이 낫다. 이 그림에서는 \(n = 10^7\)의 구간 \((0.0194,\ 0.0206)\) 전체가 문턱 \(0.2\)의 10분의 1에도 못 미치므로, "통계적으로 지극히 유의하지만 실질적으로는 무시할 만하다"는 결론이 자료 자체에서 곧바로 읽힌다.
여러 설명변수와 결합 유의성
설명변수가 여럿인 모형에서는 모형 전체가 유의한 분산을 설명하더라도 개별 설명변수가 유의하지 않을 수 있다. F-검정이 결합 유의성을 평가한다.
- F-검정은 적어도 하나의 설명변수가 결과에 유의한 효과를 갖는지를 평가한다.
- F-검정이 유의하면(\(p < 0.05\)) 개별 설명변수 중 일부가 유의하지 않더라도 모형 전체는 통계적으로 유의하다.
이는 설명변수들이 상관되어 다중공선성이 개별 유의성을 가릴 수 있는 모형에서 특히 중요하다.
유의성 해석의 흔한 함정
1. p값에 대한 과도한 의존
p값은 유용하지만 유일한 기준이 되어서는 안 된다. 실질적 유의성과 효과 크기도 똑같이 중요하다.
2. 다중비교 문제
설명변수를 여럿 검정하면 우연히 유의한 결과를 얻을 확률이 커진다. Bonferroni 보정 같은 조정으로 거짓양성률을 통제할 수 있다.
여기서 \(m\)은 비교 횟수이다.
3. 맥락 무시
통계적 유의성이 언제나 실질적 중요성을 뜻하지는 않는다. 유의성은 항상 문제의 맥락 안에서 해석하고 현실적 함의를 고려해야 한다.
연습문제
연습문제 1. 관측값이 \(n = 100{,}000\)개인 회귀에서 어떤 설명변수가 \(\hat{\beta} = 0.002\), \(p < 0.001\)이다. 이 결과는 실질적으로 유의한가? 통계적 유의성과 실질적 유의성의 차이를 설명하라.
풀이
이 결과는 통계적으로 유의하다(계수가 0과 확실히 다르다). 그러나 실질적으로 유의하지 않을 수 있다(0.002라는 효과 크기가 맥락 안에서 의미를 갖기에 너무 작을 수 있다).
\(n = 100{,}000\)이면 표준오차가 \(1/\sqrt{n}\)의 속도로 줄어들기 때문에 아주 작은 효과도 통계적으로 유의해진다. 통계적 유의성은 "0이 아닐 가능성이 높다"는 뜻이고, 실질적 유의성은 "의사결정에 영향을 줄 만큼 크다"는 뜻이다. 연구자는 \(X\)가 한 단위 변할 때 \(Y\)가 0.002 단위 변하는 것이 해당 응용 분야에서 의미 있는지를 판단해야 한다.
연습문제 2. 유의하지 않은 p값(\(p = 0.15\))이 계수가 0임을 증명하지 않는 이유를 설명하라. 실제로는 무엇을 뜻하는가?
풀이
p값 0.15는 \(\beta = 0\)일 때 얻은 것만큼 또는 그보다 더 극단적인 검정통계량을 관측할 확률이 15%라는 뜻이다. 이는 \(\beta = 0\)이라는 증명이 아니며, \(H_0\)을 기각할 증거가 부족하다는 뜻일 뿐이다.
기각하지 못한 이유는 다음 중 하나일 수 있다. (1) 참 효과가 정말로 0이거나 아주 작다, (2) 실제 효과를 탐지하기에 표본크기가 너무 작다(검정력 부족), (3) 자료의 분산이 커서 진짜 관계를 가리고 있다. 검정력 분석이나 신뢰구간이 p값 하나보다 훨씬 많은 정보를 준다.
연습문제 3. 설명변수가 다섯 개인 모형에서 개별 \(t\) 검정은 모두 유의하지 않은데(\(p > 0.05\)) 전체 \(F\) 검정은 유의하다(\(p = 0.01\)). 모순처럼 보이는 이 결과를 해석하라.
풀이
이 겉보기 모순은 다중공선성에서 비롯된다. 다섯 설명변수가 서로 상관되어 있을 가능성이 높아, 나머지를 고려한 뒤 각 설명변수가 고유하게 기여하는 몫(\(t\) 검정이 재는 것)은 작다. 그러나 다 함께 놓고 보면 \(Y\)의 분산을 유의하게 설명한다(\(F\) 검정이 탐지하는 것).
\(F\) 검정은 다섯 계수가 동시에 0인지를 검정하며 결합 효과를 탐지하는 데 더 큰 검정력을 갖는다. 개별 \(t\) 검정은 다중공선성으로 표준오차가 부풀려져 검정력이 떨어진다. 대책으로는 중복된 설명변수를 빼거나, 정칙화를 쓰거나, VIF 값을 계산해 공선적인 쌍을 찾아내는 방법이 있다.
정리하며
| 도구 | 알려주는 것 |
|---|---|
| p값 | 설명변수가 통계적으로 유의한 효과를 갖는지 |
| 신뢰구간 | 그럴듯한 값의 범위와 추정의 정밀도 |
| 효과 크기 | 효과의 크기와 실질적 중요성 |
| F-검정 | 모형 안 모든 설명변수의 결합 유의성 |
이 도구들을 함께 쓰고 각각의 한계를 이해할 때, 선형회귀에서 설명변수와 결과의 관계에 대해 더 나은 판단을 내릴 수 있다.