로지스틱 회귀의 L1·L2 정칙화
1. p 가 n 에 비해 크면 최대가능도가 과적합한다
교차검증(cross-validation)이 고른 벌점이 \(C = 1.6238\) 이라고 적혀 있다. 그런데 격자의 이웃 점은 \(C_9 = 0.6158\) 과 \(C_{11} = 4.2813\) 이어서 한 칸이 \(2.637\) 배다 — 고른 값의 분해능이 \(2.6\) 배인데 소수 넷째 자리까지 적힌 것이다. 격자가 로그 척도라는 것을 모르면 그 \(1.6238\) 이 어디서 왔는지 영영 알 수 없다. 벌점의 세기를 자료로 고른다는 말은 무엇을 고르는 일이며, 고른 그 수를 어디까지 믿어도 되는가.
설명변수(explanatory variable)의 개수 \(p\)가 표본크기 \(n\)에 비해 크면 로지스틱 회귀(logistic regression)의 최대가능도 추정량은 과적합할 수 있다. 훈련 범주를 최대한 날카롭게 가르기 위해 계수가 커지고, 그 결과 예측확률이 극단으로 몰려 일반화 성능이 나빠진다. 정칙화는 로그가능도에 벌점을 더해 계수를 0 쪽으로 축소함으로써, 편향을 조금 늘리는 대가로 분산을 크게 줄인다.
2. 벌점 로그가능도
정칙화 추정량은
를 최대화한다. 여기서 \(\ell(\boldsymbol{\theta})\)는 벌점 없는 로그가능도, \(\lambda \ge 0\)은 벌점의 강도, \(\Omega(\boldsymbol{\theta})\)는 벌점함수다. 절편(intercept) \(\theta_0\)에는 벌점을 주지 않고 기울기 계수 \(\theta_1, \ldots, \theta_{p-1}\)만 축소한다.
3. L2 벌점(능형 로지스틱 회귀)
L2 벌점은 계수 제곱의 합이다.
벌점 로그가능도는
가 된다. 능형 정칙화는 모든 계수를 0 쪽으로 축소하지만 어느 것도 정확히 0으로 만들지는 않는다. 설명변수들이 상관되어 있을 때(다중공선성(multicollinearity)) 추정치를 안정화하므로 특히 유용하다.
베이즈 해석
L2 벌점은 각 계수에 대한 정규 사전분포(prior distribution) \(\theta_j \sim \mathcal{N}(0, 1/\lambda)\)에 대응한다. 따라서 능형 추정량은 이 사전분포 아래의 사후최빈값(MAP) 추정치다.
보기 1. 능형 해가 반드시 만족하는 등식. 변수 \(p = 20\)개 가운데 앞 다섯만 참으로 쓰인 자료를 \(n = 200\) 생성하고 C=1.0의 L2 로지스틱을 적합한다.
(1) 능형 로지스틱의 최적해가 만족하는 정상조건을 적고, \(C = 1\)에서 그것이 "잔차와 \(j\)번째 설명변수의 내적이 \(\hat\beta_j\)와 같다"는 말이 됨을 보이시오.
(2) 그 등식을 자료에서 확인하고, 벌점 없는 최대가능도추정(maximum likelihood estimation)과 견주어 축소의 크기를 재시오.
풀이
(1) 해석적으로. 최소화할 목적함수는
이다. 로지스틱 로그가능도의 기울기는 잘 알려진 대로
이므로 \(\nabla J = 0\)에서
를 얻는다. \(C = 1\)이면 오른쪽이 그냥 \(\hat{\boldsymbol\beta}\)이므로
이다. 벌점이 없다면 오른쪽이 \(0\)이어서 잔차가 모든 설명변수와 직교한다. 벌점은 그 직교성을 깨뜨리고, 깨뜨린 만큼이 정확히 계수다. 계수가 큰 변수일수록 잔차와 더 많이 상관되어 남는다는 뜻이고, 이것이 축소의 대가다.
한편 절편은 벌점을 받지 않는다(sklearn의 기본 동작). 그래서 절편에 대한 정상조건은 벌점 없는 경우와 같은
이다. 곧 잔차의 합은 여전히 \(0\)이지만 각 열과의 내적은 \(0\)이 아니다.
(2) 수치적으로.
from sklearn.linear_model import LogisticRegression
import numpy as np

# 변수 20개 중 참으로 쓰이는 것은 앞의 다섯뿐이다. 세 벌점이 이 다섯을
# 어떻게 다루는지 견준다.
np.random.seed(42)
n, p = 200, 20
X = np.random.randn(n, p)
true_beta = np.zeros(p)
true_beta[:5] = [1.5, -1.0, 0.8, -0.5, 0.3]
logit = X @ true_beta
prob = 1 / (1 + np.exp(-logit))
y = np.random.binomial(1, prob)

# sklearn 에서 C 는 벌점의 역수다. C 가 작을수록 벌점이 세다 —
# 다른 책의 lambda 와 방향이 반대이니 헷갈리기 쉽다.
ridge_model = LogisticRegression(penalty='l2', C=1.0, solver='lbfgs',
                                  max_iter=1000)
ridge_model.fit(X, y)
print("Ridge coefficients:", np.round(ridge_model.coef_[0], 3))

# 정상조건 X^T r = beta/C 를 직접 확인한다.
r = y - ridge_model.predict_proba(X)[:, 1]
print(f"\n잔차의 합 = {r.sum():.3e}   (절편은 벌점을 받지 않는다)")
print(f"X^T r  첫 5개 = {np.round(X.T @ r, 4)[:5]}")
print(f"beta   첫 5개 = {np.round(ridge_model.coef_[0], 4)[:5]}")
print(f"max |X^T r - beta| = {np.abs(X.T @ r - ridge_model.coef_[0]).max():.3e}")

# 수렴 기준을 조이면 등식이 더 정확해진다 — 불일치는 수학이 아니라 해법기다.
tight = LogisticRegression(penalty='l2', C=1.0, solver='lbfgs',
                           max_iter=20000, tol=1e-8).fit(X, y)
r2 = y - tight.predict_proba(X)[:, 1]
print(f"tol=1e-8 로 다시: max |X^T r - beta| = "
      f"{np.abs(X.T @ r2 - tight.coef_[0]).max():.3e}")

# 벌점을 완전히 끈 최대가능도와 견준다.
mle = LogisticRegression(penalty=None, solver='lbfgs', max_iter=5000).fit(X, y)
print(f"\nMLE  첫 5개 = {np.round(mle.coef_[0], 3)[:5]}")
print(f"능형 노름 {np.linalg.norm(ridge_model.coef_[0]):.4f}, "
      f"MLE 노름 {np.linalg.norm(mle.coef_[0]):.4f}, "
      f"비 {np.linalg.norm(ridge_model.coef_[0]) / np.linalg.norm(mle.coef_[0]):.4f}")
출력:
Ridge coefficients: [ 1.346 -1.162  0.955 -0.593 -0.031 -0.187 -0.009 -0.243  0.359  0.041
 -0.176  0.021  0.069  0.145  0.398  0.04   0.047  0.095 -0.046 -0.166]

잔차의 합 = -3.266e-03   (절편은 벌점을 받지 않는다)
X^T r  첫 5개 = [ 1.3531 -1.1535  0.9554 -0.5991 -0.0282]
beta   첫 5개 = [ 1.3458 -1.1624  0.9554 -0.5931 -0.031 ]
max |X^T r - beta| = 8.861e-03
tol=1e-8 로 다시: max |X^T r - beta| = 6.020e-06

MLE  첫 5개 = [ 1.519 -1.318  1.071 -0.673 -0.054]
능형 노름 2.2160, MLE 노름 2.5020, 비 0.8857
유도한 등식 \(\mathbf x_{(j)}^\top\mathbf r = \hat\beta_j\)가 맞는다. 기본 설정에서 최대 불일치가 \(8.9\times10^{-3}\)이고, 수렴 기준을 tol=1e-8로 조이면 \(6.0\times10^{-6}\)으로 떨어진다. 차이가 수학이 아니라 해법기(solver)의 정지 조건에서 왔다는 증거다. 잔차의 합도 같은 이유로 \(-3.3\times10^{-3}\)이지 정확한 \(0\)이 아니다.
축소의 크기는 노름으로 재면 분명하다. 벌점 없는 최대가능도의 \(\lVert\hat{\boldsymbol\beta}\rVert_2 = 2.5020\)이 C=1.0에서 \(2.2160\)으로 줄어, \(11.4\%\)가 깎였다. 첫 다섯 개만 보아도 \(1.519 \to 1.346\), \(-1.318 \to -1.162\)로 한결같이 \(0\) 쪽으로 당겨져 있다.
참값과 견주면 이야기가 더 재미있다. 강한 신호 넷은 잘 잡았지만 가장 약한 신호 \(\beta_5 = 0.3\)은 부호까지 틀려 \(-0.031\)이 되었다. 이는 벌점 탓이 아니다. 벌점을 끈 MLE도 \(-0.054\)로 똑같이 음수이기 때문이다. \(n = 200\)에서 계수 하나의 표준오차가 \(0.2\) 수준이라 크기 \(0.3\)인 효과는 잡음에 묻힌다. 잡음변수 \(15\)개의 계수가 최대 \(0.398\)까지 올라오는 것도 같은 사정이다.
AI로 보는 통계학 1. 이 벌점이 기계 쪽에서 불리는 이름 — 가중치 감쇠
이 절의 \(L_2\) 벌점은 오늘 학습되는 신경망(neural network)에서 거의 예외 없이 켜져 있는데, 거기서는 벌점이라 부르지 않고 가중치 감쇠(weight decay)라 부른다. 다른 것이 아니라 같은 식에 붙은 다른 이름이고, 그 이름은 기울기 한 걸음을 적어 보면 바로 나온다.
벌점이 붙은 목적함수를 \(\ell(\theta) - \lambda\theta^2\) 라 두고, 보폭(학습률, learning rate) \(\eta\) 로 기울기 방향으로 한 걸음을 옮기면
곧 걸음마다 계수에 \(1\) 보다 작은 수를 한 번 곱하고 나서 자료가 미는 만큼 더한다. 벌점이 하는 일이 매 걸음의 곱셈 하나인 것이다. 계수가 저절로 꺼져 가므로 감쇠다.
import numpy as np

eta, lam = 0.10, 0.01          # 보폭과 벌점의 세기
keep = 1 - 2 * eta * lam       # 한 걸음마다 곱해지는 수

print(f"  한 걸음의 곱  1 - 2*eta*lam = {keep:.4f}")
print(f"  반감기        ln2 / (2*eta*lam) = {np.log(2)/(2*eta*lam):.1f} 걸음\n")

def run(g, steps=2000, th=1.0):
    """자료 기울기가 g 로 일정할 때 벌점이 붙은 한 걸음을 반복한다."""
    for _ in range(steps):
        th = keep * th + eta * g       # 줄이고 나서 자료가 미는 만큼 더한다
    return th

print("  자료 기울기 g   2000 걸음 뒤 θ    g/(2λ) (평형)")
for g in (0.0, 0.002, 0.01, 0.05):
    print(f"      {g:5.3f}        {run(g):10.4f}      {g/(2*lam):10.4f}")

print("\n  신호가 없는 계수는 얼마나 빨리 꺼지는가 (g = 0, θ0 = 1)")
th = 1.0
for t in range(1, 2001):
    th *= keep
    if t in (100, 347, 1000, 2000):
        print(f"    {t:4d} 걸음 → θ = {th:.4f}")
출력:
  한 걸음의 곱  1 - 2*eta*lam = 0.9980
  반감기        ln2 / (2*eta*lam) = 346.6 걸음

  자료 기울기 g   2000 걸음 뒤 θ    g/(2λ) (평형)
      0.000            0.0182          0.0000
      0.002            0.1164          0.1000
      0.010            0.5091          0.5000
      0.050            2.4726          2.5000

  신호가 없는 계수는 얼마나 빨리 꺼지는가 (g = 0, θ0 = 1)
     100 걸음 → θ = 0.8186
     347 걸음 → θ = 0.4992
    1000 걸음 → θ = 0.1351
    2000 걸음 → θ = 0.0182
아래쪽이 이름의 뜻이다. 미는 자료가 하나도 없는 계수는 걸음마다 \(0.998\) 이 곱해져 \(347\) 걸음에 절반으로(\(0.4992\)), \(2{,}000\) 걸음에 \(0.0182\) 로 꺼진다. \(\ln 2/(2\eta\lambda)\) 가 반감기인 셈이다. 위쪽은 미는 자료가 있을 때인데, 꺼지는 힘과 미는 힘이 맞서다가 \(\nabla\ell = 2\lambda\theta\) 인 자리, 곧 \(\theta = g/(2\lambda)\) 에서 멈춘다. 계수의 크기를 정하는 것은 신호의 세기 혼자가 아니라 신호와 벌점의 비다.
여기서 조심할 것이 둘이다. 하나, 곱해지는 수가 \(1-2\eta\lambda\) 이므로 보폭을 바꾸면 벌점의 세기도 같이 바뀐다. 보폭만 키웠는데 계수가 더 줄어드는 일이 그래서 생긴다. 둘, 위 표의 \(2{,}000\) 걸음은 반감기 여섯 번이 채 안 되므로 \(0.5091\) 이 평형값 \(0.5000\) 에 아직 닿지 않았다. 벌점이 센 계수일수록 평형에 늦게 도착하므로, 학습을 일찍 끊으면 그 자체가 또 하나의 축소로 작동한다. 벌점을 끄고 일찍 멈추는 것만으로도 비슷한 효과가 나는 까닭이 이것이다.
4. L1 벌점(라쏘 로지스틱 회귀)
L1 벌점은 절댓값의 합이다.
벌점 로그가능도는
이다. L1 벌점은 희소한 해를 만든다. \(\lambda\)가 충분히 크면 일부 계수가 정확히 0이 된다. 그래서 L1 로지스틱 회귀는 분류기이자 동시에 변수선택기다.
베이즈 해석
L1 벌점은 독립인 라플라스 사전분포 \(\theta_j \sim \text{Laplace}(0, 1/\lambda)\)에 대응한다. 0에서의 뾰족한 봉우리와 두꺼운 꼬리가 희소성을 유도한다.
보기 2. 어떤 계수가 \(0\)이 되는가를 미리 말할 수 있다. 같은 자료에 penalty='l1', C=1.0을 적합한다.
(1) 절댓값 벌점은 \(0\)에서 미분되지 않는다. 열미분(subgradient, 하위미분)으로 최적조건을 적고, \(\hat\beta_j = 0\)이 될 조건과 \(\hat\beta_j \ne 0\)일 때 반드시 성립하는 등식을 각각 구하시오.
(2) 그 두 조건을 자료에서 확인하시오. \(0\)이 된 계수가 셋이라면, 그 셋의 잔차 내적은 얼마여야 하는가?
풀이
(1) 해석적으로. 목적함수는
이다. \(\lvert\beta_j\rvert\)는 \(\beta_j \ne 0\)에서 미분값이 \(\operatorname{sign}(\beta_j)\)이고, \(\beta_j = 0\)에서는 미분 대신 열미분 집합 \([-1, 1]\)을 갖는다. 볼록함수의 최솟값 조건은 "\(0\)이 열미분 집합에 들어 있다"이므로, \(s_j := \mathbf x_{(j)}^\top\mathbf r\)라 쓰면
이다. 살아남은 계수는 전부 \(\lvert s_j\rvert\)가 정확히 \(1/C\)다. 능형에서 \(s_j\)가 계수에 비례해 제각각이던 것과 완전히 다르다. L1에서는 \(1/C\)가 임계값으로 작동해, 잔차와의 상관이 그 임계값에 닿지 못하는 변수는 통째로 떨어져 나간다. 이것이 희소성의 정체이며, \(0\)에서 꺾인 모서리가 그 임계값을 만든다.
\(C = 1\)이므로 이 자료에서는
- \(0\)이 아닌 계수: \(\lvert s_j\rvert = 1\) (부호는 계수와 같다)
- \(0\)인 계수: \(\lvert s_j\rvert \le 1\)
이어야 한다.
같은 꺾임이 lbfgs를 못 쓰게 만드는 이유이기도 하다. lbfgs는 기울기가 어디에나 있다고 가정하는 준뉴턴법이라 \(0\)에서 멈출 수가 없다. saga나 좌표하강처럼 근접 연산자(proximal operator)를 쓰는 해법기가 필요하다.
(2) 수치적으로.
# L1 벌점은 lbfgs 로 풀 수 없다. 0 에서 미분이 되지 않기 때문이며,
# 그래서 saga 같은 다른 해법기를 써야 한다.
lasso_model = LogisticRegression(penalty='l1', C=1.0, solver='saga',
                                  max_iter=5000)
lasso_model.fit(X, y)
print("Lasso coefficients:", np.round(lasso_model.coef_[0], 3))
print(f"Non-zero coefficients: {np.sum(lasso_model.coef_[0] != 0)} / {p}")

r1 = y - lasso_model.predict_proba(X)[:, 1]
s = X.T @ r1
nz = lasso_model.coef_[0] != 0
print(f"\n0 이 된 계수의 번호: {np.where(~nz)[0]}")
print(f"그 셋의 |s_j| = {np.round(np.abs(s[~nz]), 4)}   (모두 1 이하여야 한다)")
print(f"0 이 아닌 {nz.sum()}개의 |s_j| 범위 = "
      f"[{np.abs(s[nz]).min():.4f}, {np.abs(s[nz]).max():.4f}]")
print(f"그 중 1 에서 가장 많이 벗어난 값 = "
      f"{np.abs(np.abs(s[nz]) - 1.0).max():.4f}")
print(f"부호가 계수와 일치하는가: "
      f"{bool(np.all(np.sign(s[nz]) == np.sign(lasso_model.coef_[0][nz])))}")
출력:
Lasso coefficients: [ 1.34  -1.146  0.94  -0.579  0.    -0.158  0.    -0.211  0.344  0.028
 -0.134  0.     0.023  0.092  0.37   0.006  0.007  0.055 -0.003 -0.127]
Non-zero coefficients: 17 / 20

0 이 된 계수의 번호: [ 4  6 11]
그 셋의 |s_j| = [0.8042 0.2508 0.6809]   (모두 1 이하여야 한다)
0 이 아닌 17개의 |s_j| 범위 = [0.9985, 1.0023]
그 중 1 에서 가장 많이 벗어난 값 = 0.0023
부호가 계수와 일치하는가: True
두 조건이 모두 맞는다. \(0\)이 아닌 \(17\)개의 \(\lvert s_j\rvert\)가 \([0.9985,\ 1.0023]\)에 모두 들어 있어 이론값 \(1/C = 1\)에서 최대 \(0.0023\)밖에 벗어나지 않고, 부호도 전부 계수와 같다. \(0\)이 된 셋은 \(0.8042\), \(0.2508\), \(0.6809\)로 셋 다 임계값 \(1\)을 넘지 못했다.
어느 셋이 떨어졌는지도 뜻이 있다. 번호 \(4\)는 참 계수가 \(0.3\)인 가장 약한 신호이고 나머지 둘은 잡음변수다. 신호 하나를 버리고 잡음 둘을 버린 셈인데, \(\lvert s_4\rvert = 0.8042\)가 임계값에 가장 가까웠다는 것이 그 변수가 "거의 살아남을 뻔했다"는 뜻이다.
전체로는 \(20\)개 중 \(17\)개가 살아 있다. \(C = 1.0\)에서는 벌점이 아직 약해 잡음변수 대부분이 임계값을 넘는다. 잡음변수를 떨어뜨리려면 \(C\)를 줄여 임계값 \(1/C\)를 올려야 한다(연습문제 5).
5. 엘라스틱넷
엘라스틱넷은 두 벌점을 결합한다.
여기서 \(\alpha \in [0,1]\)이 배합을 조절한다. \(\alpha = 1\)이면 라쏘, \(\alpha = 0\)이면 능형이 된다. 엘라스틱넷은 L1의 희소성을 물려받으면서 상관된 설명변수를 순수 라쏘보다 잘 다룬다.
보기 3. 임계값이 절반으로 낮아진다. l1_ratio=0.5, C=1.0으로 엘라스틱넷을 적합한다.
(1) 보기 1과 보기 2의 조건을 합쳐 엘라스틱넷의 최적조건을 적고, \(\hat\beta_j = 0\)이 되는 임계값이 얼마인지 구하시오.
(2) 그 조건을 확인하고, 세 벌점의 \(0\)이 아닌 계수 개수가 왜 \(20 > 19 > 17\) 순서로 놓이는지 설명하시오.
풀이
(1) 해석적으로. $\alpha = $ l1_ratio라 쓰면 목적함수는
이다. 벌점이 두 조각의 합이므로 열미분도 두 조각의 합이고, \(s_j = \mathbf x_{(j)}^\top\mathbf r\)에 대해
이다. \(\beta_j = 0\)에서는 L2 조각의 미분이 \(0\)이라 임계값을 만드는 것은 L1 조각뿐이다. 그래서 임계값이 \(1/C\)가 아니라
로 절반으로 낮아진다. 임계값이 낮으면 더 많은 변수가 살아남으므로, \(0\)이 아닌 계수의 개수는 라쏘보다 많고 능형(\(20\)개, 임계값이 없다)보다는 적거나 같다. \(C = 1\), \(\alpha = 0.5\)에서 \(0\)이 아닌 계수는
를 만족해야 한다.
(2) 수치적으로.
# 엘라스틱넷은 l1_ratio 로 두 벌점의 배합비를 정한다. 0.5 면 절반씩이다.
enet_model = LogisticRegression(penalty='elasticnet', C=1.0,
                                 solver='saga', l1_ratio=0.5,
                                 max_iter=5000)
enet_model.fit(X, y)
print("Elastic Net coefficients:", np.round(enet_model.coef_[0], 3))

be = enet_model.coef_[0]
re = y - enet_model.predict_proba(X)[:, 1]
se = X.T @ re
nze = be != 0
pred = 0.5 * be[nze] + 0.5 * np.sign(be[nze])
print(f"\n0 이 된 계수의 번호: {np.where(~nze)[0]}, "
      f"|s_j| = {np.round(np.abs(se[~nze]), 4)}  (임계값 0.5 이하)")
print(f"0 이 아닌 {nze.sum()}개:  "
      f"max |s_j - (0.5 b + 0.5 sign b)| = {np.abs(se[nze] - pred).max():.4f}")

bl, br = lasso_model.coef_[0], ridge_model.coef_[0]
print(f"\n0 이 아닌 개수   능형 {int((br != 0).sum())}  "
      f"엘넷 {int(nze.sum())}  라쏘 {int((bl != 0).sum())}")
print(f"L1 노름         능형 {np.abs(br).sum():.4f}  "
      f"엘넷 {np.abs(be).sum():.4f}  라쏘 {np.abs(bl).sum():.4f}")
print(f"|라쏘| <= |엘넷| 이 20개 모두 성립: "
      f"{bool(np.all(np.abs(bl) <= np.abs(be) + 1e-9))}")
print(f"|엘넷| <= |능형| 이 20개 모두 성립: "
      f"{bool(np.all(np.abs(be) <= np.abs(br) + 1e-9))}")
출력:
Elastic Net coefficients: [ 1.342 -1.153  0.947 -0.585 -0.012 -0.172  0.    -0.229  0.351  0.035
 -0.154  0.006  0.046  0.118  0.385  0.022  0.027  0.074 -0.026 -0.146]

0 이 된 계수의 번호: [6], |s_j| = [0.0184]  (임계값 0.5 이하)
0 이 아닌 19개:  max |s_j - (0.5 b + 0.5 sign b)| = 0.0014

0 이 아닌 개수   능형 20  엘넷 19  라쏘 17
L1 노름         능형 6.1297  엘넷 5.8315  라쏘 5.5625
|라쏘| <= |엘넷| 이 20개 모두 성립: True
|엘넷| <= |능형| 이 20개 모두 성립: True
최적조건이 맞는다. \(0\)이 아닌 \(19\)개가 \(s_j = 0.5\hat\beta_j + 0.5\operatorname{sign}(\hat\beta_j)\)를 최대 \(0.0014\) 오차로 만족하고, \(0\)이 된 번호 \(6\)은 \(\lvert s_6\rvert = 0.0184\)로 임계값 \(0.5\)에 한참 못 미친다.
개수의 순서 \(20 > 19 > 17\)은 임계값의 순서 그대로다. 능형은 임계값이 아예 없어 \(20\)개가 모두 살고, 엘라스틱넷은 임계값 \(\alpha/C = 0.5\)라 하나가 떨어지며, 라쏘는 임계값 \(1/C = 1\)이라 셋이 떨어진다. 보기 2에서 떨어진 셋의 \(\lvert s_j\rvert\)가 \(0.8042\), \(0.2508\), \(0.6809\)였는데, 임계값이 \(0.5\)로 내려오자 \(0.2508\)짜리 하나만 남았다(그것이 번호 \(6\)이다). 임계값을 반으로 낮춘 결과가 "둘이 되살아났다"로 그대로 나타난다.
크기 쪽에서도 세 해가 가지런히 늘어선다. \(L_1\) 노름이 \(6.1297 > 5.8315 > 5.5625\)이고, \(20\)개 계수 전부에서 \(\lvert\hat\beta^{\text{lasso}}_j\rvert \le \lvert\hat\beta^{\text{enet}}_j\rvert \le \lvert\hat\beta^{\text{ridge}}_j\rvert\)가 성립한다. 다만 이것은 이 자료에서 확인된 사실이지 일반적으로 보장되는 성질이 아니다. 설명변수가 서로 상관되어 있으면 순서가 뒤집히는 좌표가 나올 수 있다. 여기서는 \(\mathbf X\)의 열이 독립인 표준정규라 그런 일이 없었다.
6. scikit-learn의 C 모수
scikit-learn의 LogisticRegression은 벌점 강도를 \(C = 1/\lambda\)로 모수화한다. \(C\)가
클수록 정칙화가 약하고(벌점 없는 MLE에 가깝고), 작을수록 정칙화가 강하다.
LogisticRegression 인자 |
대응 |
|---|---|
penalty='l2', C=1.0 |
\(\lambda = 1\)인 능형 |
penalty='l1', C=0.1, solver='liblinear' |
\(\lambda = 10\)인 라쏘 |
penalty='elasticnet', l1_ratio=0.5, C=1.0, solver='saga' |
\(\alpha = 0.5\), \(\lambda = 1\)인 엘라스틱넷 |
특성 표준화
벌점은 모든 계수를 동등하게 취급하므로, 정칙화 모형을 적합하기 전에 설명변수를 표준화(평균 0, 분산 1)해야 한다. 그러지 않으면 척도가 큰 특성의 계수가 더 심하게 벌을 받아 결과가 왜곡된다.
7. 최적화
L2 벌점 로그가능도는 여전히 강오목이므로 헤세행렬에 \(\lambda\mathbf{I}\)를 더해 뉴턴–랩슨이나 IRLS로 최대화할 수 있다. L1 벌점 목적함수는 \(\theta_j = 0\)에서 미분 불가능하므로 전용 알고리즘이 필요하다.
- 좌표하강: 연성 임계화를 이용해 계수를 하나씩 갱신한다.
glmnet과 scikit-learn의saga해법기가 쓰는 방식이다. - 근접기울기법(proximal gradient method): 매끄러운 부분에 대한 기울기 단계와 L1 항에 대한 근접 연산자를 결합한다.
8. 정칙화 경로
\(\lambda\) 격자를 큰 값에서 작은 값으로 훑으며 모형을 적합하면 정칙화 경로가 나온다. \(\lambda\)가 줄어들면서 각 계수가 곡선을 그린다. L2 경로는 매끄럽고, L1 경로는 계수가 하나씩 모형에 들어오는 꺾인 모양이다.
로지스틱 라쏘 경로는 조각별 선형이 아니다
최소제곱 라쏘의 경로는 조각별 선형이지만, 로지스틱 라쏘의 경로는 그렇지 않다. 조각별 선형성은 손실이 조각별 이차이고 벌점이 조각별 선형일 때에만 성립한다(Rosset & Zhu, 2007). 로지스틱 손실은 이차가 아니므로, 활성집합이 변하지 않는 구간 안에서도 계수가 \(\lambda\)에 대해 곡선을 그린다. 연습문제 4에서 수치로 확인한다. 꺾이는 지점(활성집합이 바뀌는 곳)이 있다는 점만 두 경우가 같다.
같은 자료, 두 벌점
두 벌점의 차이는 경로를 나란히 그려 보면 한눈에 들어온다. 아래는 \(n = 200\), \(p = 10\)인 인공자료로, 참으로 0이 아닌 계수는 \(x_1 = 1.6\), \(x_3 = -1.3\), \(x_7 = 0.9\) 셋뿐이고 나머지 일곱 개는 순전한 잡음이다. 왼쪽이 L2, 오른쪽이 L1이며, 둘 다 왼쪽으로 갈수록 벌점이 강하다.
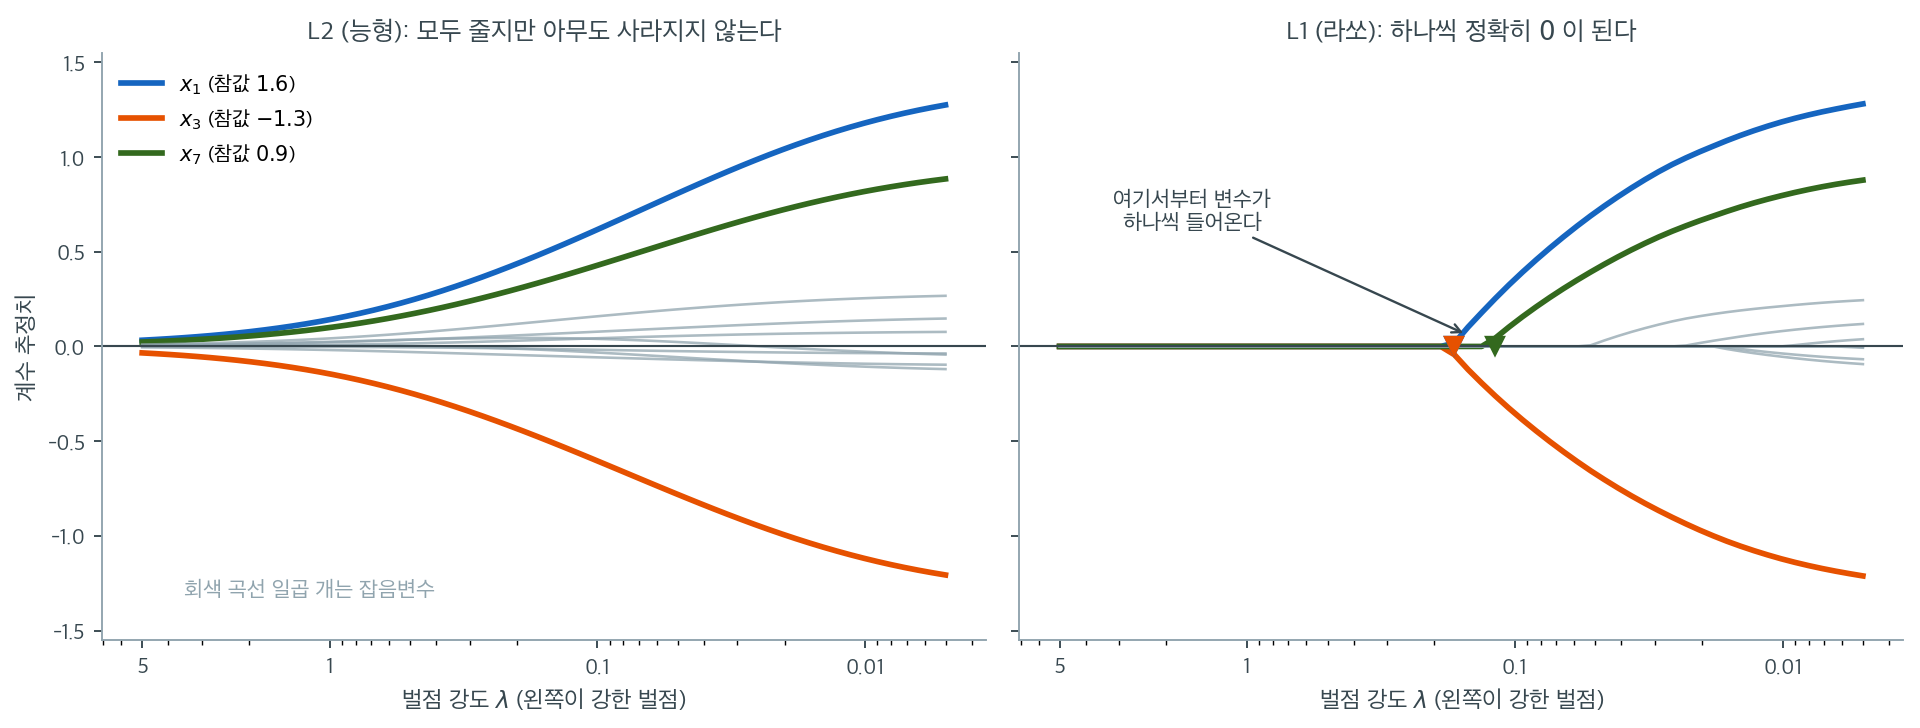
왼쪽 L2 경로에서 모든 곡선은 \(\lambda\)가 커질수록 0에 다가가지만 닿지는 않는다. \(\lambda = 1\)에서 세 참 계수는 \(0.14\), \(-0.14\), \(0.10\)까지 줄었는데, 이때도 잡음변수 일곱 개의 계수는 \(0.00\)이 아니라 \(0.02\), \(-0.02\), \(0.04\) 같은 작은 값으로 살아 있다. 벌점이 아무리 강해도 L2는 계수를 지우지 못한다. \(\Omega_{\text{L2}}\)의 도함수가 \(\theta_j\)에 비례해 \(\theta_j \to 0\)이면 밀어내는 힘도 함께 0으로 사라지기 때문이다.
오른쪽 L1 경로는 완전히 다른 모양이다. \(\lambda > 0.17\)에서는 열 개 계수가 모두 정확히 0이다. \(\lambda = 0.168\)에서 \(x_1\)과 \(x_3\)이 동시에 들어오고, \(\lambda = 0.118\)에서 \(x_7\)이 뒤따른다. 세 참 변수가 잡음변수보다 먼저, 그것도 꽤 넓은 간격을 두고 들어온다는 점이 중요하다. \(\Omega_{\text{L1}}\)의 기울기는 \(\theta_j\)가 0에 가까워져도 \(\pm 1\)로 일정하므로, 자료가 주는 신호가 그 일정한 힘을 이기지 못하면 계수가 0에 눌러앉는다. 이 "꺾이지 않는 힘"이 희소성의 기계적 정체다.
벌점을 풀면 두 그림이 다시 만난다. \(\lambda = 0.01\)에서 세 참 계수는 양쪽 모두 \(1.18\), \(-1.12\), \(0.82\) 근처이고 잡음변수도 \(0.25\) 수준까지 올라온다. 즉 벌점의 종류는 약한 벌점 쪽에서는 거의 차이를 만들지 않고, 강한 벌점 쪽에서 해의 모양 자체를 가른다. 축소만 원하면 L2, 변수선택까지 원하면 L1을 쓰라는 실무 지침이 이 그림에서 나온다.
보기 4. 경로의 양 끝은 무엇인가. \(C\)를 \(10^{-3}\)에서 \(10^3\)까지 훑으며 L2 계수 \(20\)개의 경로를 그린다.
(1) 그림의 왼쪽 끝과 오른쪽 끝에서 경로가 무엇에 수렴하는지 말하고, 그림에서 읽히는 끝값을 보기 1의 수와 맞춰 보시오.
(2) 이 그림이 보여 주지 못하는 것은 무엇인가. 참으로 쓰인 다섯 변수를 굵게 그렸는데, 그 다섯을 그림만 보고 가려낼 수 있는가?
풀이
(1) 양 끝은 둘 다 답이 정해져 있다.
\(C \to 0\)이면 벌점 \(\frac{1}{2C}\lVert\boldsymbol\beta\rVert^2\)가 로그가능도를 압도하므로 \(\hat{\boldsymbol\beta} \to \mathbf 0\)이다. 그림의 왼쪽 끝 \(\log_{10} C = -3\)에서 \(20\)개 선이 모두 \(0\)에 붙어 있는 것이 그것이다. 이때 모형은 절편만 남아 모든 사람에게 같은 확률 \(\bar y = 0.505\)를 준다.
\(C \to \infty\)이면 벌점이 사라져 벌점 없는 최대가능도에 수렴한다. 보기 1에서 구한 MLE가 첫 다섯 개에 대해 \((1.519,\ -1.318,\ 1.071,\ -0.673,\ -0.054)\)였으니, 그림의 오른쪽 끝에서 굵은 선들이 \(1.52\), \(-1.32\), \(1.07\), \(-0.67\), 그리고 \(0\) 근처에 눕는 것과 맞는다. 읽어 보면 파란 선이 \(1.5\) 조금 위, 주황 선이 \(-1.3\) 근처, 초록 선이 \(1.07\), 빨간 선이 \(-0.67\) 자리다.
아래 코드가 양 끝의 수를 찍어 그 읽기를 확인한다.
import matplotlib.pyplot as plt

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False

# C 를 키우며 계수 경로를 그린다. 참으로 쓰인 다섯 변수는 굵게, 나머지는
# 흐리게 그려 어느 쪽이 먼저 살아나는지 보이게 한다.
C_values = np.logspace(-3, 3, 50)
coefs = []

for C in C_values:
    model = LogisticRegression(penalty='l2', C=C, solver='lbfgs',
                                max_iter=2000)
    model.fit(X, y)
    coefs.append(model.coef_[0])

coefs = np.array(coefs)

plt.figure(figsize=(10, 5))
for j in range(p):
    plt.plot(np.log10(C_values), coefs[:, j],
             linewidth=2 if j < 5 else 0.8,
             alpha=1.0 if j < 5 else 0.3)
plt.xlabel('log10(C)')
plt.ylabel('Coefficient value')
plt.title('Ridge Logistic Regression: Coefficient Paths')
plt.axhline(0, color='black', linestyle='--', linewidth=0.5)
plt.tight_layout()
plt.show()

# 그림의 양 끝에서 읽어야 할 수.
print(f"왼쪽 끝 log10(C) = -3:  max |beta| = {np.abs(coefs[0]).max():.5f}")
print(f"오른쪽 끝 log10(C) = 3: 첫 5개 = {np.round(coefs[-1][:5], 3)}")
print(f"                        MLE 첫 5개 = {np.round(mle.coef_[0][:5], 3)}")
print(f"잡음 15개의 끝값 범위 = [{coefs[-1][5:].min():.3f}, "
      f"{coefs[-1][5:].max():.3f}]")
print(f"그 가운데 절댓값이 가장 큰 것 = "
      f"{np.abs(coefs[-1][5:]).max():.3f} (번호 "
      f"{5 + int(np.argmax(np.abs(coefs[-1][5:])))})")
print(f"참 신호 5번(beta5=0.3)의 끝값 = {coefs[-1][4]:.3f}")
출력:
왼쪽 끝 log10(C) = -3:  max |beta| = 0.03406
오른쪽 끝 log10(C) = 3: 첫 5개 = [ 1.519 -1.318  1.07  -0.673 -0.054]
                        MLE 첫 5개 = [ 1.519 -1.318  1.071 -0.673 -0.054]
잡음 15개의 끝값 범위 = [-0.271, 0.436]
그 가운데 절댓값이 가장 큰 것 = 0.436 (번호 14)
참 신호 5번(beta5=0.3)의 끝값 = -0.054
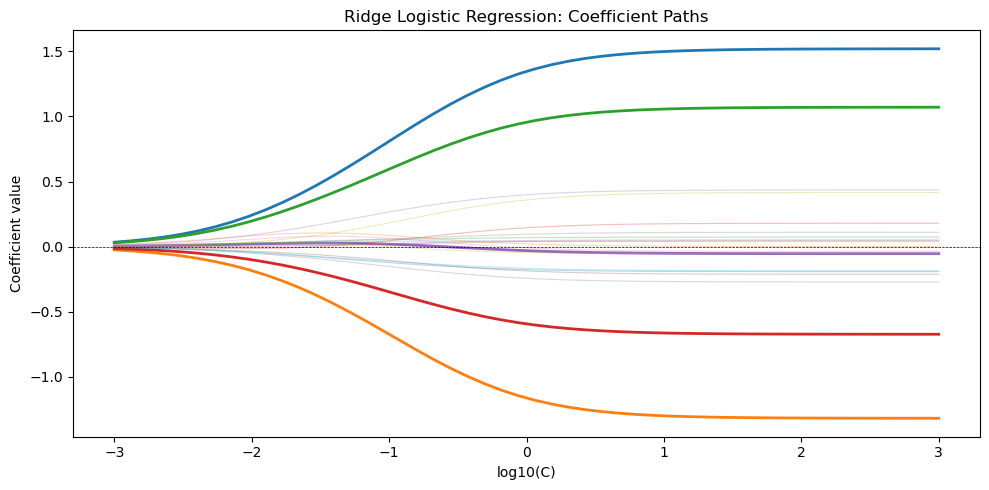
왼쪽 끝에서 가장 큰 계수조차 \(0.0341\)로 사실상 \(0\)이고, 오른쪽 끝의 다섯 값이 보기 1의 MLE와 소수 둘째 자리까지 같다. 유도한 두 극한이 그대로 확인된다. 셋째 변수만 \(1.070\) 대 \(1.071\)로 한 자리 어긋나는데, 이는 \(C = 10^3\)에서 벌점 \(\frac{1}{2C} = 5\times10^{-4}\)이 아직 완전히 \(0\)은 아니기 때문이다. 경로의 오른쪽 끝은 MLE에 가까운 것이지 MLE 그 자체가 아니다.
(2) 이 그림은 세 가지를 보여 주지 못한다.
첫째, 어느 선이 어느 변수인지 알 수 없다. 범례가 없어서, 오른쪽 끝의 \(1.52\)가 \(\beta_1\)인지 \(\beta_3\)인지 그림만으로는 정할 수 없다. 계수 경로 그림에서는 오른쪽 가장자리에 변수 이름을 직접 적어 주는 것이 관례다.
둘째, 굵은 선 다섯 가운데 하나는 눈에 띄지 않는다. 참으로 쓰인 다섯을 linewidth=2로 굵게 그렸는데, \(\beta_5 = 0.3\)에 해당하는 선은 끝값이 \(-0.054\)라 \(0\) 주위의 흐린 잡음선 다발에 통째로 묻힌다. 거꾸로 잡음변수 가운데 \(14\)번은 끝값이 \(0.436\)까지 올라가 \(\beta_5\)보다 여덟 배 크다. 곧 "굵은 선 다섯이 위로 솟고 흐린 선 열다섯이 바닥에 깔린다"는 그림이 아니다. 굵게 칠해 놓았으니 다섯을 가려낼 수 있어 보이지만, 그것은 답을 알고 그린 사람의 특권이지 그림이 알려 준 것이 아니다. 실제 자료에서는 참 계수를 모르므로 이 그림만으로 변수선택을 할 수 없다.
셋째, 가로축의 왼쪽 끝이 "벌점 없음"이 아니다. \(\log_{10} C\) 축이라 왼쪽이 강한 벌점, 오른쪽이 약한 벌점이다. \(\lambda = 1/C\)에 익숙한 사람은 방향을 거꾸로 읽기 쉽다. 또 오른쪽 끝 \(\log_{10}C = 3\)에서 이미 MLE에 수렴했으므로 \(C\)를 더 키워도 아무 일도 일어나지 않는다. 경로의 오른쪽 \(1\)개 눈금은 사실상 쓸모없는 여백이다.
최적 \(\lambda\)는 교차검증으로 고른다.
보기 5. \(1.6238\)은 어디서 온 수인가. Cs=20으로 5겹 교차검증을 돌리면 최적 \(C = 1.6238\), 교차검증 정확도 \(0.7450\)이 나온다.
(1) Cs=20이 만드는 격자를 적고, \(1.6238\)이 그 가운데 몇 번째 점인지 지수로 정확히 맞히시오.
(2) 교차검증 정확도 \(0.7450\)은 몇 건을 맞힌 것인가. 같은 \(C\)에서 훈련 정확도와 다수범주 기준선을 함께 구해 세 수를 견주시오.
풀이
(1) 해석적으로. LogisticRegressionCV에 Cs를 정수로 주면 scikit-learn은 \(10^{-4}\)부터 \(10^{4}\)까지를 로그 척도로 균등하게 나눈 격자를 쓴다. 곧 np.logspace(-4, 4, 20)이고 \(k\)번째(\(k = 0, \dots, 19\)) 점은
이다. \(1.6238\)을 넣어 보면
로 정확히 \(k = 10\)이다. 확인하면
이다. 격자가 로그 척도라는 것을 모르면 \(1.6238\)이 어디서 왔는지 영영 알 수 없다. 격자의 이웃 점은 \(C_9 = 0.6158\)과 \(C_{11} = 4.2813\)이므로 한 칸 간격이 \(10^{8/19} = 2.637\)배다. 곧 교차검증이 고른 \(C\)의 분해능이 \(2.6\)배 수준이며, "최적 \(C\)가 \(1.6238\)이다"를 소수 넷째 자리까지 믿을 이유가 전혀 없다.
(2) 수치적으로.
from sklearn.linear_model import LogisticRegressionCV

# C 는 교차검증으로 고른다. Cs=20 은 격자 점의 개수이며, sklearn 이
# 알아서 로그 척도로 펼친다.
model_cv = LogisticRegressionCV(
    Cs=20, penalty='l2', cv=5, scoring='accuracy',
    solver='lbfgs', max_iter=2000
)
model_cv.fit(X, y)
print(f"Best C: {model_cv.C_[0]:.4f}")
print(f"Best CV accuracy: {model_cv.scores_[1].mean(axis=0).max():.4f}")

grid = np.logspace(-4, 4, 20)
print(f"\nCs_ 가 logspace(-4, 4, 20) 인가: "
      f"{bool(np.allclose(model_cv.Cs_, grid))}")
k = int(np.argmin(np.abs(grid - model_cv.C_[0])))
print(f"고른 점은 k = {k},  10^(-4 + 8*{k}/19) = {10 ** (-4 + 8 * k / 19):.6f}")
print(f"이웃 격자점 C_9 = {grid[9]:.4f}, C_11 = {grid[11]:.4f}  "
      f"(한 칸 {10 ** (8 / 19):.3f}배)")

mean_scores = model_cv.scores_[1].mean(axis=0)
print(f"\n격자별 CV 정확도 = {np.round(mean_scores, 3)}")
print(f"최댓값 {mean_scores.max():.4f} 를 주는 격자점 = "
      f"{np.where(mean_scores == mean_scores.max())[0]}")
print(f"맞힌 건수 = {mean_scores.max():.4f} * {len(y)} = "
      f"{mean_scores.max() * len(y):.0f}")

refit = LogisticRegression(penalty='l2', C=model_cv.C_[0],
                           solver='lbfgs', max_iter=2000).fit(X, y)
print(f"\n훈련 정확도   {refit.score(X, y):.4f}")
print(f"교차검증 정확도 {mean_scores.max():.4f}")
print(f"다수범주 기준선 {max(y.mean(), 1 - y.mean()):.4f}")
출력:
Best C: 1.6238
Best CV accuracy: 0.7450

Cs_ 가 logspace(-4, 4, 20) 인가: True
고른 점은 k = 10,  10^(-4 + 8*10/19) = 1.623777
이웃 격자점 C_9 = 0.6158, C_11 = 4.2813  (한 칸 2.637배)

격자별 CV 정확도 = [0.535 0.555 0.645 0.71  0.72  0.72  0.72  0.73  0.74  0.74  0.745 0.745
 0.74  0.735 0.735 0.735 0.735 0.735 0.735 0.735]
최댓값 0.7450 를 주는 격자점 = [10 11]
맞힌 건수 = 0.7450 * 200 = 149

훈련 정확도   0.8000
교차검증 정확도 0.7450
다수범주 기준선 0.5050
유도한 \(k = 10\)과 \(C_{10} = 1.623777\)이 정확히 맞는다. 그리고 격자별 점수를 펼쳐 보면 \(k = 10\)과 \(k = 11\)이 둘 다 \(0.745\)로 똑같다. argmax가 앞의 것을 집었을 뿐이며, 만약 자료가 한 건만 달랐어도 \(4.2813\)이 "최적 \(C\)"로 보고되었을 것이다. 소수 넷째 자리까지 적는 관행이 얼마나 공허한지가 여기 드러난다.
세 정확도의 순서도 교과서대로다.
\(0.7450\)은 \(200\)건 가운데 \(149\)건을 맞혔다는 뜻이다. 훈련 정확도 \(0.8000\)이 교차검증보다 \(0.055\) 높은 것이 낙관 편향이고, \(p = 20\) 가운데 \(15\)개가 잡음인 자료에서 그 정도가 나온다. 보고할 수는 \(0.8000\)이 아니라 \(0.7450\)이다.
scores_의 키에 주의
model_cv.scores_는 범주 이름표를 키로 하는 딕셔너리다. 위 코드의 scores_[1]은 이름표가
정수 1인 범주를 가리키므로, 이름표가 문자열('yes')이거나 다른 값이면 KeyError가 난다.
범주에 무관하게 쓰려면 next(iter(model_cv.scores_.values()))를 쓰라. 이항 분류에서는
두 범주의 점수 배열이 어차피 같다.
연습문제
연습문제 1. L2 벌점이 정규 사전분포 \(\theta_j \sim \mathcal{N}(0, 1/\lambda)\)의 MAP 추정에 대응함을 유도하라. L1 벌점의 경우 라플라스 척도모수는 얼마인가?
풀이
사전분포 \(\pi(\boldsymbol{\theta})\) 아래의 로그사후는
이다. MAP 추정은 이를 최대화한다.
정규 사전분포. \(\theta_j \sim \mathcal{N}(0, \sigma_0^2)\)이면
이므로 벌점 \(-\frac{\lambda}{2}\sum_j\theta_j^2\)과 비교하면 \(\frac{1}{\sigma_0^2} = \lambda\), 즉 \(\sigma_0^2 = 1/\lambda\)이다.
라플라스 사전분포. \(\theta_j \sim \text{Laplace}(0, b)\)의 밀도는 \(\frac{1}{2b}e^{-|\theta_j|/b}\)이므로
이고, 벌점 \(-\lambda\sum_j|\theta_j|\)과 비교하면 \(b = 1/\lambda\)이다.
배율에 주의
이 대응은 목적함수를 표본 크기로 나누지 않았을 때 성립한다. 18장처럼 손실을 \(\frac{1}{2n}\|y-X\beta\|^2\)로 쓰면 \(\lambda\)의 의미가 달라지고 척도모수도 그에 맞게 바뀐다. 사전분포의 척도를 읽을 때는 반드시 목적함수의 배율을 먼저 확인하라.
두 경우 모두 \(\lambda \to 0\)이면 사전분포가 평평해져 MLE로 돌아가고, \(\lambda \to \infty\) 이면 사전분포가 0에 집중되어 모든 계수가 0이 된다. \(\square\)
연습문제 2. 왜 절편에는 벌점을 주지 않는가? 절편에도 벌점을 주면 무슨 일이 일어나는가?
풀이
두 가지 이유가 있다.
첫째, 평행이동 불변성. 반응변수의 기저율은 모형이 반드시 맞혀야 하는 값이지 축소할 대상이 아니다. 절편에 벌점을 주면 예측확률이 \(0.5\) 쪽으로 끌려간다. \(\theta_0 \to 0\)이면 \(\sigma(0) = 0.5\)이기 때문이다. 사건이 드문 자료(\(\bar y = 0.02\))에서 이는 심각한 편향이다.
둘째, 표준화와의 정합성. 설명변수를 표준화하면 각 \(x_j\)의 평균이 0이 되어, 절편은 "평균적인 관측치의 로그오즈"라는 자연스러운 의미를 갖는다. 이 값은 자료의 단위나 중심화 방식과 무관하게 정해져야 하는데, 벌점을 주면 다른 계수들이 축소되는 정도에 따라 절편까지 끌려다니게 된다.
절편에 벌점을 주면: \(\lambda \to \infty\)일 때 모든 계수가 0이 되어 모든 예측확률이 정확히 \(0.5\)가 된다. 벌점을 주지 않으면 \(\hat\theta_0 \to \operatorname{logit}(\bar y)\)가 되어 영모형, 즉 절편만 있는 모형으로 수렴한다. 후자가 옳은 극한이다.
scikit-learn에서는 해법기에 따라 다르다. lbfgs, newton-cg, sag, saga는
관례대로 절편에 벌점을 주지 않지만, liblinear는 절편에도 벌점을 준다(절편을 합성
특성으로 다루기 때문이며, intercept_scaling 인자가 그 영향을 완화하기 위해 있다).
\(\bar y = 0.115\)인 자료에 \(C = 10^{-6}\)(사실상 무한대의 벌점)을 걸고 확인해 보면,
| 해법기 | \(\hat\theta_0\) |
|---|---|
lbfgs |
\(-2.0406\) |
liblinear |
\(-0.0002\) |
이고 \(\operatorname{logit}(\bar y) = -2.0407\)이다. lbfgs는 올바른 극한인 영모형으로
수렴하지만 liblinear는 절편까지 0으로 눌러 모든 예측확률을 \(0.5\)로 만든다. L1 벌점을
쓸 때 liblinear를 고르는 경우가 많으므로 특히 주의해야 한다. \(\square\)
연습문제 3. scikit-learn의 \(C\)와 이 절의 \(\lambda\) 사이의 관계를 유도하라. \(n\)이 커지면 같은 \(C\)가 정칙화의 강도 면에서 어떻게 달라지는가?
풀이
scikit-learn은
를 최소화한다. 양변을 \(C\)로 나누면
이 되어 이 절의 표기와 비교하면 \(\lambda = 1/C\)이다.
\(n\)과의 관계가 중요하다. 위 식에서 손실은 합이지 평균이 아니다. 따라서 \(n\)이 커지면 손실 항이 \(n\)에 비례해 커지는 반면 벌점은 그대로다. 즉 같은 \(C\)라도 \(n\)이 크면 상대적으로 정칙화가 약해진다.
실무적 함의는 두 가지다.
- 표본 크기가 다른 자료 사이에서 \(C\) 값을 그대로 옮겨 쓰면 안 된다. \(n\)이 10배 커지면 같은 상대적 정칙화를 얻기 위해 \(C\)를 10분의 1로 줄여야 한다.
- 교차검증에서 겹의 크기가 전체 자료와 다르므로 미세한 불일치가 생긴다. 겹마다 훈련 표본이 \(n(K-1)/K\)이므로 최적 \(C\)가 전체 자료에 대한 최적값과 조금 다르다. \(K\)가 크면 무시할 만하다.
glmnet은 손실을 평균으로 쓰므로 이 문제가 없다. 두 도구의 \(\lambda\)를 비교할 때는
\(n\) 배율을 반드시 맞춰야 한다. \(\square\)
연습문제 4. 로지스틱 라쏘 경로가 조각별 선형이 아님을 수치로 확인하라. 활성집합이 변하지 않는 \(\lambda\) 구간에서 계수의 증분이 일정한지 살펴보라.
풀이
import numpy as np
from sklearn.linear_model import LogisticRegression

rng = np.random.default_rng(5)
n, p = 200, 3
X = rng.normal(size=(n, p))
z = 1.5 * X[:, 0] - 1.0 * X[:, 1]          # x3 is noise
y = (rng.random(n) < 1 / (1 + np.exp(-z))).astype(int)

for lam in np.arange(0.04, 0.17, 0.02):
    m = LogisticRegression(penalty='l1', C=1 / (lam * n),
                           solver='liblinear', max_iter=10000,
                           tol=1e-10).fit(X, y)
    print(f"lambda={lam:.2f}  {np.round(m.coef_[0], 5)}")
출력:
lambda=0.04  [ 0.91379 -0.59897  0.     ]
lambda=0.06  [ 0.75432 -0.47237  0.     ]
lambda=0.08  [ 0.61828 -0.36294  0.     ]
lambda=0.10  [ 0.49857 -0.26526  0.     ]
lambda=0.12  [ 0.39045 -0.17568  0.     ]
lambda=0.14  [ 0.29051 -0.09154  0.     ]
lambda=0.16  [ 0.19604 -0.01074  0.     ]
| \(\lambda\) | \(\hat\theta_1\) | \(\hat\theta_2\) | \(\Delta\hat\theta_1\) |
|---|---|---|---|
| 0.04 | \(0.91379\) | \(-0.59897\) | |
| 0.06 | \(0.75432\) | \(-0.47237\) | \(-0.15947\) |
| 0.08 | \(0.61828\) | \(-0.36294\) | \(-0.13604\) |
| 0.10 | \(0.49857\) | \(-0.26526\) | \(-0.11971\) |
| 0.12 | \(0.39045\) | \(-0.17568\) | \(-0.10812\) |
| 0.14 | \(0.29051\) | \(-0.09154\) | \(-0.09994\) |
| 0.16 | \(0.19604\) | \(-0.01074\) | \(-0.09447\) |
이 구간 내내 활성집합은 \(\{x_1, x_2\}\)로 고정되어 있다(\(x_3\)은 \(\lambda \ge 0.04\)에서 계속 0이다). 경로가 조각별 선형이라면 \(\lambda\) 간격이 일정하므로 증분 \(\Delta\hat\theta_1\)도 일정해야 한다. 그러나 실제 증분은 \(-0.159\)에서 \(-0.094\)로 단조롭게 줄어든다. 경로가 휘어 있다.
최소제곱 라쏘라면 이 구간에서 증분이 정확히 일정하다. 차이는 손실함수에서 온다. 제곱손실의 KKT 조건은 활성 좌표에 대해 \(\lambda\)에 관한 선형계를 주지만, 로지스틱 손실의 조건은 \(\hat p_i\)를 통해 \(\boldsymbol{\theta}\)에 비선형으로 의존한다.
실무적 함의: LARS처럼 꺾인 지점만 계산해 경로 전체를 얻는 알고리즘은 로지스틱 회귀에
쓸 수 없다. glmnet이 \(\lambda\) 격자를 잡고 온기 시작(warm start, 이웃 \(\lambda\) 의 해를 출발점으로 쓰는 것)으로 각 점을 따로 푸는 이유가
이것이다. \(\square\)
연습문제 5. \(n = 200\), \(p = 50\)이고 처음 5개 특성만 참 계수가 0이 아닌 자료를 생성하라. \(C \in \{0.01, 0.1, 1.0, 10.0\}\)에 대해 L1 정칙화 로지스틱 회귀를 적합하고, 각 \(C\)에서 0이 아닌 추정 계수의 개수를 보고하라.
풀이
import numpy as np
from sklearn.linear_model import LogisticRegression

np.random.seed(42)
n, p = 200, 50
X = np.random.randn(n, p)
true_beta = np.zeros(p)
true_beta[:5] = [2.0, -1.5, 1.0, -0.8, 0.5]
logit = X @ true_beta
prob = 1 / (1 + np.exp(-logit))
y = np.random.binomial(1, prob)

for C in [0.01, 0.1, 1.0, 10.0]:
    model = LogisticRegression(penalty='l1', C=C, solver='saga',
                                max_iter=5000)
    model.fit(X, y)
    nnz = np.sum(model.coef_[0] != 0)
    print(f"C = {C:5.2f}: {nnz} non-zero coefficients out of {p}")
출력:
C =  0.01: 0 non-zero coefficients out of 50
C =  0.10: 4 non-zero coefficients out of 50
C =  1.00: 36 non-zero coefficients out of 50
C = 10.00: 48 non-zero coefficients out of 50
| \(C\) | 0이 아닌 계수 | 그중 참 신호 | 그중 잡음 |
|---|---|---|---|
| 0.01 | 0 | 0 | 0 |
| 0.10 | 4 | 4 | 0 |
| 1.00 | 36 | 5 | 31 |
| 10.00 | 48 | 5 | 43 |
\(C\)가 커질수록(벌점이 약할수록) 0이 아닌 계수가 늘어난다. \(C = 0.01\)에서는 벌점이 너무 강해 모든 계수가 0인 영모형이 되고, \(C = 10\)에서는 사실상 벌점 없는 적합에 가까워 잡음변수 43개가 함께 들어온다.
가장 흥미로운 지점은 \(C = 0.1\)이다. 정확히 4개가 선택되었고 모두 참 신호이며 위양성이 하나도 없다. 놓친 하나는 가장 약한 신호 \(\beta_5 = 0.5\)다. 이것이 라쏘의 전형적인 행동이다. 위양성을 0으로 유지할 만큼 벌점을 강하게 걸면 약한 참 신호도 함께 잘려 나간다. 희소성과 검정력 사이의 절충은 피할 수 없다. \(\square\)
연습문제 6. L1 벌점은 희소한 해를 만드는데 L2 벌점은 그렇지 않은 이유를 기하학적으로 설명하라.
풀이
L1의 제약영역은 마름모(2차원에서는 집합 \(\{(\beta_1, \beta_2) : |\beta_1| + |\beta_2| \leq t\}\))로, 좌표축 위에 꼭짓점이 있다. L2의 제약영역은 원(\(\beta_1^2 + \beta_2^2 \leq t^2\))으로 어디서나 매끄럽다.
로그가능도의 등고선은 대개 타원이다. 제약 최적해는 등고선이 제약영역에 처음 닿는 곳이다. 마름모라면 이 접점이 좌표가 정확히 0인 꼭짓점에서 일어날 가능성이 훨씬 크다. 원이라면 좌표축 위의 점에서 접하려면 특별한 정렬이 필요한데, 일반적인 자료에서 그럴 확률은 0이다.
이 기하학적 논증은 고차원으로 일반화된다. \(p\)차원에서 L1 공은 \(2^p\)개의 꼭짓점을 가지며, 접점은 대개 여러 좌표가 0이 되는 꼭짓점이나 면 위에 놓인다.
열미분으로 본 같은 이야기. \(\beta_j = 0\)에서 \(|\beta_j|\)의 열미분 집합(보기 2)은 구간 \([-1, 1]\) 전체이므로, 최적성 조건 \(|\partial\ell/\partial\beta_j| \le \lambda\)를 만족하는 한 \(\beta_j = 0\)이 최적으로 유지된다. 반면 \(\beta_j^2\)의 도함수는 \(\beta_j = 0\)에서 정확히 0이므로, 기울기가 조금이라도 0이 아니면 곧바로 0에서 벗어난다. 꼭짓점의 뾰족함이 곧 열미분의 구간이다. \(\square\)
연습문제 7.
연습문제 5의 자료에 LogisticRegressionCV를 penalty='l1', solver='saga', 5-겹
교차검증으로 적용해 최적 \(C\)를 찾아라. 선택된 \(C\)와 그때의 교차검증 정확도를 보고하라.
풀이
from sklearn.linear_model import LogisticRegressionCV

model_cv = LogisticRegressionCV(
    Cs=20, penalty='l1', cv=5, scoring='accuracy',
    solver='saga', max_iter=5000
)
model_cv.fit(X, y)
print(f"Best C: {model_cv.C_[0]:.4f}")

best_idx = np.argmax(model_cv.scores_[1].mean(axis=0))
best_acc = model_cv.scores_[1].mean(axis=0)[best_idx]
print(f"Best CV accuracy: {best_acc:.4f}")
print(f"Non-zero coefficients: "
      f"{np.sum(model_cv.coef_[0] != 0)} / {p}")
출력:
Best C: 0.0886
Best CV accuracy: 0.8000
Non-zero coefficients: 4 / 50
선택된 \(C = 0.0886\), 교차검증 정확도 \(0.8000\), 0이 아닌 계수는 4개이고 모두 참 신호다(위양성 0개).
이는 연습문제 5의 \(C = 0.1\) 결과와 사실상 같은 지점이다. 눈여겨볼 것은, 교차검증이 정확도를 기준으로 골랐는데도 여기서는 매우 희소한 모형을 선택했다는 점이다. 18장의 회귀 보기에서 교차검증이 늘 지나치게 조밀한 모형을 고르던 것과 대비된다.
차이의 원인은 기준의 성질이다. 정확도는 계단함수라 예측 이름표가 바뀌지 않는 한
잡음변수를 하나 더 넣어도 값이 전혀 변하지 않는다. 반면 이탈도나 로그손실은 연속적이라
잡음변수를 넣어 훈련 적합을 조금이라도 개선하면 값이 미세하게 좋아진다. 즉 scoring을
'neg_log_loss'로 바꾸면 더 조밀한 모형이 선택될 가능성이 높다. 채점 기준이 곧 선택
기준이다. \(\square\)
연습문제 8. 엘라스틱넷 벌점
이 임의의 \(\alpha \in [0,1]\)에 대해 \(\boldsymbol\beta\)의 볼록함수임을 증명하라.
풀이
\(\|\boldsymbol\beta\|_1 = \sum_j |\beta_j|\)와 \(\|\boldsymbol\beta\|_2^2 = \sum_j \beta_j^2\)은 모두 \(\boldsymbol\beta\)의 볼록함수다. L1 노름은 볼록함수 \(|\beta_j|\)들의 합이므로 볼록이고, L2 노름의 제곱은 헤세행렬이 \(2I\)로 양정치이므로 강볼록이다.
볼록함수들의 음이 아닌 가중합은 볼록이다. \(\alpha \geq 0\)이고 \((1-\alpha)/2 \geq 0\)이므로 엘라스틱넷 벌점
은 볼록이다. 나아가 \(\alpha < 1\)이면 L2 항이 \(P\)를 강볼록으로 만들어 벌점 손실의 최소점이 유일함을 보장한다.
\(\alpha = 1\)일 때도 유일할 수 있다
\(\alpha = 1\)(순수 라쏘)이면 벌점 자체는 강볼록이 아니지만, 목적함수 전체의 유일성은 손실 항의 곡률에도 달려 있다. 설계행렬이 완전열계수이고 분리가 없으면 \(-\ell\)이 강볼록이므로 라쏘 해도 유일하다. \(p > n\)이거나 열이 중복될 때 비로소 유일성이 깨진다. \(\square\)
연습문제 9. L2 벌점 로지스틱 회귀에서는 자료가 완전히 분리 가능해도 해가 존재하고 유일함을 보여라.
풀이
벌점 목적함수를 최소화 형태로 쓰면
이다.
존재성. \(-\ell(\boldsymbol{\theta}) \ge 0\)이고 \(\frac{\lambda}{2}\lVert\boldsymbol{\theta}_{-0}\rVert^2 \to \infty\)이므로, \(\lVert\boldsymbol{\theta}_{-0}\rVert \to \infty\)일 때 \(f \to \infty\)다. 즉 \(f\)는 강제적(coercive)이고 연속이므로 최소점이 존재한다. 분리 가능한 자료에서 벌점 없는 MLE가 존재하지 않았던 이유가 \(\lVert\boldsymbol{\theta}\rVert \to \infty\)를 막을 것이 없었기 때문인데, 벌점이 정확히 그 역할을 한다.
유일성. \(-\ell\)의 헤세행렬은 \(A^\top B A\)(\(A\)는 설계행렬, \(B\)는 \(\hat p_i(1-\hat p_i)\)를 대각에 둔 행렬)로 양반정치이고, 벌점 항의 헤세행렬은 \(\lambda I\)(절편 성분은 0)이다. 기울기 좌표에 대해서는 합이 양정치이므로 그 방향으로 강볼록이다. 절편이 벌점을 받지 않아 엄밀한 유일성에는 \(A\)의 첫 열에 대한 조건이 필요하지만, 절편 열이 다른 열들과 일차독립인 통상적인 경우에는 해가 유일하다.
이것이 실무적으로 매우 중요한 이유는, 분리는 드문 사건이 아니기 때문이다. \(p\)가 \(n\)에 가깝거나 범주형 변수의 수준이 세분화되어 있으면 흔히 발생한다. 작은 \(\lambda\) 하나만 넣어도 문제가 사라진다. \(\square\)
정리하며
로지스틱 회귀에도 정칙화가 필요하다.
- \(p\) 가 \(n\) 에 비해 크면 과적합한다. 훈련 범주를 날카롭게 가르려고 계수가 커지고 예측확률이 \(0\) 과 \(1\) 로 몰린다.
- 완전분리에서는 최대가능도가 발산한다. 두 범주를 완벽히 가르는 선형결합이 있으면 계수가 무한대로 가며, 정칙화가 그 문제를 원천적으로 없앤다.
- 18장의 벌점이 그대로 쓰인다. \(L_2\) 는 계수를 축소하고 \(L_1\) 은 변수를 선택하며, 엘라스틱넷이 둘을 섞는다.
sklearn의C는 \(\lambda\) 의 역수다. \(C\) 가 작을수록 벌점이 강하며, 기본값 \(C=1\) 이 이미 정칙화를 켜 놓은 상태라는 점을 놓치기 쉽다.- 표준화가 필수다. 벌점이 척도에 의존하기 때문이며, 절편은 벌점에서 제외한다.
다음 절 변수선택으로 넘어간다.