교호작용 효과 그림
개요
교호작용 그림은 요인 설계에서 한 요인의 효과가 다른 요인의 수준에 의존하는지 진단하는 대표적인 시각 도구이다. 그림의 선들이 평행하면 교호작용이 없고, 평행하지 않으면 교호작용이 있다. 이 페이지에서는 두 요인이 보충제 종류(OJ, VC)와 용량 수준(0.5, 1.0, 2.0)인 ToothGrowth 자료로 교호작용 그림을 그리고 해석하는 방법을 설명한다.
교호작용이란
이원배치 요인 모형
에서 교호작용 항 \((\alpha\beta)_{ij}\)는 요인 \(A\)와 \(B\)의 결합 효과가 각각의 개별 효과의 합과 얼마나 다른지를 담는다. 형식적으로 교호작용이 없다는 것은
이고, 이는 칸 평균을 \(\mu_{ij} = \mu + \alpha_i + \beta_j\)(순수하게 가법적인 모형)로 쓸 수 있다는 말과 같다.
그림 그리기
교호작용 그림은 다음을 보여준다:
- 가로축: 한 요인의 수준(예: 용량).
- 세로축: 반응의 칸 평균(예: 평균 치아 길이).
- 별도의 선: 두 번째 요인의 각 수준마다 하나씩(예: 보충제 종류).
보기 1. 이 두 선은 교차하는가. ToothGrowth 의 교호작용 그림을 그린다.
(1) 그림이 그리는 여섯 칸평균과 세 수준에서의 격차 \(\delta_j = \bar y_{\text{OJ},j} - \bar y_{\text{VC},j}\) 를 수치로 적으시오.
(2) 위 표에서 "교차하는 선 = 비순서형 교호작용"이라 했다. 표본에서 격차의 부호가 바뀌는가? 바뀐다면 이 자료를 비순서형이라 불러야 하는가. 판정에 필요한 양을 계산해 답하시오.
풀이
유도할 답이 있는 문제가 아니다. 그러나 "교차하는가"는 눈이 아니라 수로 답해야 하는 물음이고, 그 수를 구하는 것이 이 보기의 몫이다.
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.graphics.factorplots import interaction_plot

url = ('https://raw.githubusercontent.com/vincentarelbundock/'
       'Rdatasets/1dcc2bf5f955cc1224a3e1307256e1fe86b68dae/csv/datasets/ToothGrowth.csv')
df = pd.read_csv(url, usecols=[1, 2, 3])

# 가로축이 한 요인, 선의 색이 다른 요인, 세로축이 반응의 평균이다.
# 두 선이 평행이면 교호작용이 없고, 벌어지거나 엇갈리면 있는 것이다.
fig, ax = plt.subplots(figsize=(10, 4))
interaction_plot(df['dose'], df['supp'], df['len'],
                 ax=ax, markers=['o', 's'], linestyles=['--', '-.'])
ax.set_title("Interaction: dose x supp on tooth length")
ax.set_xlabel("dose")
ax.set_ylabel("len")
plt.tight_layout()
plt.show()
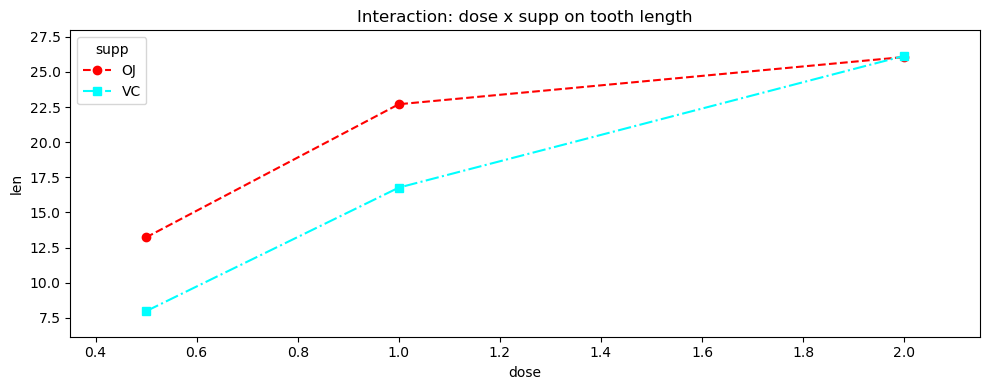
두 선이 모두 오른쪽 위로 향하지만 기울기가 다르다. VC(점선)가 더 가파르게 올라 용량 2.0에서 OJ를 따라잡는다. 용량 0.5와 1.0에서는 OJ가 위에 있다가 2.0에서 두 점이 거의 겹친다.
눈으로 본 것을 수로 바꾼다.
import numpy as np
from scipy import stats

MSE, c = 13.187148, 10          # 이원배치 잔차 평균제곱과 칸 크기
M = df.pivot_table(index='supp', columns='dose', values='len', aggfunc='mean')
print("칸평균")
print(M)

se_gap = np.sqrt(2 * MSE / c)
t_crit = stats.t.ppf(0.975, 54)
print(f"\n격차의 표준오차 = sqrt(2*MSE/n) = {se_gap:.4f},  t(0.975,54) = {t_crit:.4f}")
print(f"{'dose':>6}{'OJ':>8}{'VC':>8}{'OJ-VC':>9}{'95% CI':>22}")
for d in (0.5, 1.0, 2.0):
    g = M.loc['OJ', d] - M.loc['VC', d]
    lo, hi = g - t_crit * se_gap, g + t_crit * se_gap
    print(f"{d:>6}{M.loc['OJ', d]:>8.2f}{M.loc['VC', d]:>8.2f}{g:>9.2f}"
          f"   ({lo:>6.2f}, {hi:>6.2f})")

# 표본에서 격차의 부호가 바뀌는가.
gaps = (M.loc['OJ'] - M.loc['VC']).values
print(f"\n격차의 부호: {np.sign(gaps)}  ->  표본 평균선은 실제로 교차한다")
print(f"다만 마지막 격차 -0.08 은 표준오차 {se_gap:.2f} 의 {abs(gaps[-1]) / se_gap:.3f} 배다")

for s in ('OJ', 'VC'):
    print(f"{s}: 0.5->1.0 {M.loc[s, 1.0] - M.loc[s, 0.5]:+.2f}, "
          f"1.0->2.0 {M.loc[s, 2.0] - M.loc[s, 1.0]:+.2f}")
출력:
칸평균
dose    0.5    1.0    2.0
supp
OJ    13.23  22.70  26.06
VC     7.98  16.77  26.14

격차의 표준오차 = sqrt(2*MSE/n) = 1.6240,  t(0.975,54) = 2.0049
  dose      OJ      VC    OJ-VC                95% CI
   0.5   13.23    7.98     5.25   (  1.99,   8.51)
   1.0   22.70   16.77     5.93   (  2.67,   9.19)
   2.0   26.06   26.14    -0.08   ( -3.34,   3.18)

격차의 부호: [ 1.  1. -1.]  ->  표본 평균선은 실제로 교차한다
다만 마지막 격차 -0.08 은 표준오차 1.62 의 0.049 배다
OJ: 0.5->1.0 +9.47, 1.0->2.0 +3.36
VC: 0.5->1.0 +8.79, 1.0->2.0 +9.37
(1) 읽히는 수. 격차가 \(5.25 \to 5.93 \to -0.08\) 이다. 앞의 둘은 신뢰구간이 \(0\) 을 품지 않으므로 뚜렷한 차이이고, 마지막은 \((-3.34,\ 3.18)\) 로 \(0\) 을 넉넉히 품는다. 두 선의 기울기도 다르다. \(1.0 \to 2.0\) 구간에서 OJ 는 \(+3.36\) 만 오르는데 VC 는 \(+9.37\) 오른다. 용량을 올려 얻는 이득이 OJ 쪽에서 먼저 포화한다.
(2) 표본에서는 부호가 바뀐다. 격차의 부호가 \((+,+,-)\) 이므로 그려진 두 선은 용량 \(1.0\) 과 \(2.0\) 사이 어딘가에서 실제로 교차한다. 그림에서 두 점이 겹쳐 보여 교차가 눈에 띄지 않을 뿐이다. 그러니 "선이 교차하지 않는다"는 말은 그림에 대한 서술로는 정확하지 않다.
그래도 비순서형이라 부르면 안 된다. 마지막 격차 \(-0.08\) 은 그 격차의 표준오차 \(1.6240\) 의 \(0.049\) 배다. 곧 \(t = -0.05\) 이고, 자유도 \(54\) 에서 이보다 큰 값은 심심하면 나온다. 신뢰구간 \((-3.34,\ 3.18)\) 은 \(\delta_3\) 가 \(+3\) 일 수도 \(-3\) 일 수도 있다고 말하므로, 어느 쪽이 위인지 이 자료는 알지 못한다. 표본평균이 교차했다는 것은 모평균이 교차했다는 증거가 못 된다.
정리하면 올바른 서술은 이렇다. 용량 \(0.5\) 와 \(1.0\) 에서는 OJ 가 \(5\)–\(6\) 만큼 분명히 앞서고, 용량 \(2.0\) 에서는 둘을 구별할 수 없다. 순서형이냐 비순서형이냐는 이 자료로 가릴 수 없는 물음이며, 가리고 싶다면 용량 \(2.0\) 근처에서 표본을 더 모아야 한다.
덧붙여, 순서형/비순서형의 구분 자체가 관측한 수준 범위에 매여 있다는 점도 기억할 만하다. 여기서 재지 않은 용량 \(3.0\) 에서 VC 가 OJ 를 앞선다면 같은 자료생성구조가 비순서형으로 불릴 것이다. 분류는 모형의 성질이 아니라 설계의 성질이다.
그림 읽기
| 패턴 | 해석 |
|---|---|
| 평행한 선 | 교호작용 없음. 용량의 효과가 두 보충제에서 같다 |
| 평행하지 않은 선(수렴/발산) | 순서형 교호작용. 효과의 방향은 같고 크기가 다르다 |
| 교차하는 선 | 비순서형(교차) 교호작용. 효과의 방향이 뒤집힌다 |
ToothGrowth 자료에서는 OJ와 VC의 선이 용량 2.0에서 수렴하여 순서형 교호작용을 나타낸다. 두 보충제 모두 용량과 함께 치아 길이를 늘리지만, VC에 대한 OJ의 우위가 가장 높은 용량에서 줄어든다.
교호작용의 수치화
각 요인의 특정 두 수준에 대한 교호작용 대비는
이다. \(\psi = 0\)이면 \(A\)의 수준 사이 차이가 \(B\)의 두 수준에서 같다(선이 평행하다). 이원배치 분산분석의 형식적 교호작용 \(F\)-검정은 \(H_0: \text{모든 } (\alpha\beta)_{ij} = 0\)을 동시에 검정한다.
해석
- 평행한 선은 두 요인이 독립적으로 작동함을 뜻한다. 주효과를 그 자체로 해석할 수 있다.
- 평행하지 않은 선은 한 요인의 효과가 다른 요인의 수준에 따라 달라짐을 뜻한다. 질적으로 다른 효과들을 평균 내므로 주효과 평균이 오도할 수 있다.
- 교차하는 선은 요인 수준의 순위가 뒤집히는 특히 강한 교호작용을 나타낸다. 이런 경우 주효과만 보고하면 적극적으로 오도하게 된다.
- 교호작용 그림은 시각적 안내이다. 언제나 이원배치 분산분석표의 형식적 교호작용 \(F\)-검정으로 확인하라.
연습문제
연습문제 1. 다음은 \(2 \times 3\) 요인 설계의 칸 평균이다. 교호작용 그림을 그려 보고 교호작용이 순서형인지 비순서형인지 판정하라.
| \(B_1\) | \(B_2\) | \(B_3\) | |
|---|---|---|---|
| \(A_1\) | 5 | 10 | 15 |
| \(A_2\) | 8 | 10 | 12 |
풀이
가로축에 \(B\)의 수준(1, 2, 3), 세로축에 칸 평균을 둔다.
- \(A_1\)의 선: 5, 10, 15(\(B\) 한 단위당 기울기 5).
- \(A_2\)의 선: 8, 10, 12(\(B\) 한 단위당 기울기 2).
두 선은 \(B_2\)에서 만난다(\(B_1\)에서는 \(A_1\)이 아래에 있지만 \(B_3\)에서는 위로 올라선다). \(B\)의 수준에 따라 \(A_1\)과 \(A_2\)의 순위가 뒤집히므로 비순서형(교차) 교호작용이다.
연습문제 2. \(2 \times 2\) 요인 설계에서 교호작용의 자유도가 정확히 1임을 증명하라. 교호작용 제곱합을 네 칸 평균으로 표현하라.
풀이
\(A\)의 수준이 \(a = 2\)개, \(B\)의 수준이 \(b = 2\)개이므로 교호작용의 자유도는 \((a-1)(b-1) = 1 \times 1 = 1\)이다.
칸 \((i,j)\)의 교호작용 효과는 \((\alpha\beta)_{ij} = \mu_{ij} - \mu_{i\cdot} - \mu_{\cdot j} + \mu_{\cdot\cdot}\)이다. 칸당 관측값이 \(n\)개인 균형 설계에서 교호작용 제곱합은
이다. 네 항이 각각 \(\pm \delta\)이고 \(\delta = (\bar{y}_{11} - \bar{y}_{12} - \bar{y}_{21} + \bar{y}_{22})/4\)이므로
이 된다. 제곱된 대비 하나이므로 자유도가 1임이 확인된다. \(\square\)
연습문제 3. 유의한 비순서형 교호작용이 있을 때 주효과를 해석하는 것이 왜 오도할 수 있는지 설명하라. ToothGrowth 예로 예시하라.
풀이
어떤 요인의 주효과는 다른 요인의 모든 수준에 걸쳐 평균 낸 주변평균의 차이이다. 비순서형 교호작용이 있으면 한 요인의 효과 방향이 다른 요인의 수준에 따라 뒤집히므로, 각 수준에서 효과가 크더라도 평균은 0 근처가 될 수 있다.
ToothGrowth 맥락에서 (가상으로) OJ가 낮은 용량에서는 VC보다 긴 치아를 낳고 높은 용량에서는 더 짧은 치아를 낳는다고 하자. OJ와 VC의 주변평균이 거의 같아져 보충제의 주효과가 유의하지 않게 나올 수 있다. 그러나 보충제는 분명히 중요하다. 그 효과가 용량에 의존할 뿐이다. "보충제에 유의한 효과가 없다"고 보고하면 오도하게 된다. 올바른 해석은 조건부이다. 낮은 용량에서는 OJ가 낫고 높은 용량에서는 VC가 나으며, 교호작용이 핵심 발견이다.
연습문제 4. 어떤 연구자가 교호작용 그림에서 평행하지 않은 선을 관측했지만 분산분석의 교호작용 \(F\)-검정은 \(p = 0.23\)을 준다. 어떻게 이런 일이 생기며 연구자는 무엇을 결론지어야 하는가?
풀이
교호작용 그림에서 평행하지 않은 선은 표집 변동의 영향을 받는 표본 칸 평균을 반영한다. 모집단 수준에서 교호작용이 없어도 무작위 요동 때문에 표본의 선들은 조금씩 평행하지 않게 된다. \(F\)-검정이 유의하지 않다는 것(\(p = 0.23\))은 관측된 비평행성이 우연만으로 기대되는 정도와 부합한다는 뜻이다.
연구자는 선택한 유의수준에서 교호작용의 증거가 충분하지 않다고 결론지어야 한다. 그림의 비평행성은 가법성으로부터의 의미 있는 이탈을 나타내지 않는다. 가능한 이유는 (1) 실제로 교호작용이 없거나, (2) 실재하지만 약한 교호작용을 탐지하기에 표본크기가 작거나(검정력 부족), (3) 교호작용 효과가 존재하나 집단 내 변동에 비해 작기 때문이다. 연구자는 \(p\)-값에만 의존하지 말고 교호작용 대비의 효과크기와 신뢰구간을 함께 보고하는 편이 좋다.
연습문제 5. \(2 \times 2\) 교호작용 그림에서 선이 정확히 평행할 조건을 유도하라. 칸 평균 \(\mu_{11}, \mu_{12}, \mu_{21}, \mu_{22}\)에서 시작하여 대수적 조건을 보여라.
풀이
교호작용 그림의 가로축에 요인 \(B\)의 수준 \(B_1\), \(B_2\)를 두고 \(A_1\)과 \(A_2\)에 대해 각각 선을 그린다.
- \(A_1\)의 선: 점 \((B_1, \mu_{11})\)과 \((B_2, \mu_{12})\)를 지나며 기울기는 \(\mu_{12} - \mu_{11}\).
- \(A_2\)의 선: 점 \((B_1, \mu_{21})\)과 \((B_2, \mu_{22})\)를 지나며 기울기는 \(\mu_{22} - \mu_{21}\).
두 선이 평행할 필요충분조건은 기울기가 같은 것이다:
정리하면
이다. 이것이 바로 \(2 \times 2\)의 경우 모든 \(i, j\)에 대한 \((\alpha\beta)_{ij} = 0\) 조건이다. 동등하게 교호작용 대비 \(\psi = \mu_{11} - \mu_{12} - \mu_{21} + \mu_{22}\)가 0이라는 뜻이며, 이것이 \(2 \times 2\) 설계에서 자유도 1인 교호작용이다. \(\square\)
연습문제 6. 교호작용이 전혀 없는 자료에서도 그림의 선은 평행하지 않다. 표본 크기별로 "비평행해 보이는" 정도를 모의실험으로 재고, 그림에 오차막대를 반드시 붙여야 하는 이유를 설명하라.
풀이
문제의 핵심. 교호작용 그림이 그리는 것은 모수 \(\mu_{ij}\)가 아니라 추정값 \(\bar y_{ij}\)다. \((\alpha\beta)_{ij}=0\)이어도 표본 평균은 흔들리므로 선이 정확히 평행하게 나올 확률은 0이다.
\(2\times2\)에서 비평행 정도를 재는 대비는
이고, \(\sum c_i^2=4\)이므로 칸 평균 하나의 표준오차보다 2배 크다.
import numpy as np

rng = np.random.default_rng(2468)
sigma = 1.0

print(f"{'n':>4s} {'SE(ψ̂)':>9s} {'평균|ψ̂|':>9s} {'|ψ̂|>1 비율':>11s}")
for n in [5, 10, 20, 40]:
    M = 4_000
    se = sigma * np.sqrt(4 / n)
    psi = []
    for _ in range(M):
        m = rng.normal(0, sigma / np.sqrt(n), 4)   # 참 교호작용은 0
        psi.append(abs((m[0] - m[1]) - (m[2] - m[3])))
    psi = np.array(psi)
    print(f"{n:4d} {se:9.4f} {psi.mean():9.4f} {(psi > 1).mean():11.4f}")
   n    SE(ψ̂)    평균|ψ̂|   |ψ̂|>1 비율
   5    0.8944    0.7197      0.2660
  10    0.6325    0.5019      0.1138
  20    0.4472    0.3541      0.0248
  40    0.3162    0.2543      0.0020
\(n=5\)에서는 네 번에 한 번꼴로 \(|\hat\psi|>1\)이다. 효과가 0인데도 표준편차 하나만큼 벌어진 그림이 나온다는 뜻이다.
\(n\)을 4배 늘려야 비평행 정도가 절반이 된다(\(\operatorname{SE}\propto1/\sqrt n\)). 0.894 → 0.447로 줄이는 데 \(n\)이 5에서 20으로 가야 한다.
그래서 오차막대가 필수다. 칸 평균 하나의 오차막대는
오차막대를 읽는 법.
| 관측 | 해석 |
|---|---|
| 오차막대가 넉넉히 겹침 | 비평행이 잡음일 수 있다 |
| 오차막대가 전혀 겹치지 않음 | 차이가 실질적 |
| 겹치지만 조금만 | 판단 불가 — \(F\) 검정으로 |
마지막 줄이 중요하다. "오차막대가 겹치면 유의하지 않다"는 흔한 오해다. 두 평균의 95% 구간이 조금 겹쳐도 차이의 95% 구간은 0을 포함하지 않을 수 있다. 차이를 보고 싶으면 차이의 구간을 그려야 한다.
실무 지침 넷.
- 오차막대 없는 교호작용 그림은 발표하지 않는다.
- 무엇을 그린 막대인지 반드시 명시한다(표준편차? 표준오차? 95% 구간?).
- 오차막대는 MSE를 써서 만든다. 칸별 \(s_{ij}\)보다 자유도가 훨씬 크다.
- 그림은 안내일 뿐 결론은 \(F\) 검정과 대비의 신뢰구간이 낸다.
연습문제 7. 같은 자료로 가로축과 선을 바꿔 교호작용 그림을 두 가지로 그릴 수 있다. 두 배치가 담는 정보가 같음을 확인하고, 어느 쪽을 고를지 기준을 세워라.
풀이
import numpy as np
import pandas as pd

tooth = [4.2, 11.5, 7.3, 5.8, 6.4, 10, 11.2, 11.2, 5.2, 7,
         16.5, 16.5, 15.2, 17.3, 22.5, 17.3, 13.6, 14.5, 18.8, 15.5,
         23.6, 18.5, 33.9, 25.5, 26.4, 32.5, 26.7, 21.5, 23.3, 29.5,
         15.2, 21.5, 17.6, 9.7, 14.5, 10, 8.2, 9.4, 16.5, 9.7,
         19.7, 23.3, 23.6, 26.4, 20, 25.2, 25.8, 21.2, 14.5, 27.3,
         25.5, 26.4, 22.4, 24.5, 24.8, 30.9, 26.4, 27.3, 29.4, 23]
df = pd.DataFrame({
    "len": tooth,
    "supp": ["VC"] * 30 + ["OJ"] * 30,
    "dose": ([0.5] * 10 + [1.0] * 10 + [2.0] * 10) * 2,
})

m = df.groupby(["supp", "dose"]).len.mean().unstack()
print(m.round(3))

print("\n배치 A (가로축 dose, 선 supp) — 선의 구간별 기울기")
for s in ["OJ", "VC"]:
    r = m.loc[s]
    print(f"  {s}: 0.5→1.0 {(r[1.0] - r[0.5]) / 0.5:+7.3f},  "
          f"1.0→2.0 {(r[2.0] - r[1.0]) / 1.0:+7.3f}")

print("\n배치 B (가로축 supp, 선 dose) — VC→OJ 의 증가량")
for d in [0.5, 1.0, 2.0]:
    print(f"  dose {d}: {m.loc['OJ', d] - m.loc['VC', d]:+7.3f}")

print("\n교호작용 대비 (dose 0.5 vs 2.0) × (OJ vs VC)")
psi_B = (m.loc['OJ', 0.5] - m.loc['VC', 0.5]) - (m.loc['OJ', 2.0] - m.loc['VC', 2.0])
psi_A = (m.loc['OJ', 0.5] - m.loc['OJ', 2.0]) - (m.loc['VC', 0.5] - m.loc['VC', 2.0])
print(f"  배치 A 로 읽기: {psi_A:+.3f}")
print(f"  배치 B 로 읽기: {psi_B:+.3f}")
dose    0.5    1.0    2.0
supp
OJ    13.23  22.70  26.06
VC     7.98  16.77  26.14

배치 A (가로축 dose, 선 supp) — 선의 구간별 기울기
  OJ: 0.5→1.0 +18.940,  1.0→2.0  +3.360
  VC: 0.5→1.0 +17.580,  1.0→2.0  +9.370

배치 B (가로축 supp, 선 dose) — VC→OJ 의 증가량
  dose 0.5:  +5.250
  dose 1.0:  +5.930
  dose 2.0:  -0.080

교호작용 대비 (dose 0.5 vs 2.0) × (OJ vs VC)
  배치 A 로 읽기: +5.330
  배치 B 로 읽기: +5.330
두 배치의 교호작용 대비가 정확히 같다(\(+5.330\)). 당연하다. 대비는
로 괄호를 어느 방향으로 묶든 같은 값이기 때문이다. 교호작용은 대칭적이다. "용량의 효과가 보충제에 따라 다르다"와 "보충제의 효과가 용량에 따라 다르다"는 같은 문장이다.
그런데 읽기 쉬움은 전혀 다르다.
| 배치 A (x=dose) | 배치 B (x=supp) | |
|---|---|---|
| 선의 개수 | 2 | 3 |
| 한 선의 점 개수 | 3 | 2 |
| 용량-반응 곡선 | 보인다 | 안 보인다 |
| 보충제 차이의 추이 | 간격으로 읽음 | 선의 기울기로 바로 |
배치 A가 낫다. 용량은 순서형(양적) 요인이므로 가로축에 놓으면 용량-반응 관계의 모양(0.5→1.0에서 가파르고 1.0→2.0에서 완만한 포화)이 드러난다. 배치 B는 각 선이 점 두 개뿐이라 이 정보가 사라진다.
선택 기준 넷.
- 양적·순서형 요인을 가로축에. 그래야 곡선의 모양이 보인다.
- 둘 다 질적이면 수준이 많은 쪽을 가로축에. 선이 적을수록 읽기 쉽다.
- 관심 요인을 선으로. 선 사이 간격이 곧 그 효과다.
- 애매하면 두 배치를 모두 그려 본다. 정보는 같지만 눈에 띄는 것이 다르다.
배치 B에서만 보이는 것도 있다. 용량 2.0의 선이 거의 수평(\(-0.08\))이라는 사실은 배치 B에서 한눈에 들어온다. 배치 A에서는 두 점이 겹쳐 있는 것으로 읽어야 한다.
연습문제 8. 교호작용 그림의 평행 여부는 측정 척도에 의존한다. 곱셈형 자료를 만들어 원 척도에서는 비평행, 로그 척도에서는 평행이 됨을 보여라.
풀이
설정. 칸 평균이 곱셈형으로 정해지는 자료를 만든다.
왼쪽은 가법이 아니지만 오른쪽은 완벽하게 가법이다.
import numpy as np
import pandas as pd
import statsmodels.api as sm
from statsmodels.formula.api import ols

rng = np.random.default_rng(1357)
A = np.array([0.0, 0.8])
B = np.array([0.0, 0.5, 1.0])
n = 12

rows = []
for i, a in enumerate(A):
    for j, b in enumerate(B):
        mu = np.exp(a + b)
        # 오차도 곱셈형: y = μ · exp(ε)
        rows.append(pd.DataFrame({"y": mu * np.exp(rng.normal(0, 0.25, n)),
                                  "A": i, "B": j}))
df = pd.concat(rows, ignore_index=True)

print("원 척도 칸 평균")
print(df.groupby(["A", "B"]).y.mean().unstack().round(3))
print(sm.stats.anova_lm(ols("y ~ C(A)*C(B)", data=df).fit(), typ=2).round(4))

df["ly"] = np.log(df.y)
print("\n로그 척도 칸 평균")
print(df.groupby(["A", "B"]).ly.mean().unstack().round(3))
print(sm.stats.anova_lm(ols("ly ~ C(A)*C(B)", data=df).fit(), typ=2).round(4))

m = df.groupby(["A", "B"]).y.mean().unstack()
ml = df.groupby(["A", "B"]).ly.mean().unstack()
print("\n원 척도 A 의 단순효과:", (m.loc[1] - m.loc[0]).round(3).tolist())
print("로그 척도 A 의 단순효과:", (ml.loc[1] - ml.loc[0]).round(3).tolist())
원 척도 칸 평균
B      0      1      2
A
0  1.212  1.728  2.852
1  2.033  3.396  5.337
            sum_sq    df        F  PR(>F)
C(A)       49.4801   1.0  73.6164  0.0000
C(B)       74.7443   2.0  55.6022  0.0000
C(A):C(B)   8.2963   2.0   6.1716  0.0035
Residual   44.3609  66.0      NaN     NaN

로그 척도 칸 평균
B      0      1      2
A
0  0.146  0.529  0.976
1  0.684  1.204  1.649
           sum_sq    df        F  PR(>F)
C(A)       7.1135   1.0  97.6776  0.0000
C(B)       9.6745   2.0  66.4218  0.0000
C(A):C(B)  0.0740   2.0   0.5079  0.6041
Residual   4.8066  66.0      NaN     NaN

원 척도 A 의 단순효과: [0.822, 1.668, 2.485]
로그 척도 A 의 단순효과: [0.538, 0.675, 0.673]
같은 자료에서 결론이 뒤집힌다.
| 척도 | 교호작용 \(F\) | \(p\) | 그림 |
|---|---|---|---|
| 원 척도 | 6.17 | 0.0035 | 발산하는 선 |
| 로그 척도 | 0.51 | 0.604 | 평행한 선 |
A의 단순효과를 보면 이유가 뚜렷하다. 원 척도에서 \(0.82\to1.67\to2.49\)로 3배 커진다. 로그 척도에서는 \(0.54\to0.68\to0.67\)로 거의 일정하다.
원 척도의 "교호작용"은 실은 비율이 일정하다는 사실의 부작용이다. A가 언제나 배율 \(e^{0.8}\approx2.23\)만큼 곱하므로, \(\mu\)가 클수록 차이의 절대값도 커진다.
철학적으로 무거운 함의가 있다. "교호작용이 있다/없다"는 자연의 사실이 아니라 척도에 상대적인 진술이다. 무엇이 옳은 척도인지 정하는 것은 통계가 아니라 과학의 몫이다.
어느 척도를 쓸까.
| 상황 | 척도 |
|---|---|
| 효과가 비율로 작동함(성장, 농도, 소득) | 로그 |
| 효과가 절대량으로 작동함(점수, 온도 차) | 원 척도 |
| 오차의 산포가 평균에 비례 | 로그(등분산도 함께 회복) |
| 이론이 특정 척도를 지정 | 이론을 따른다 |
부수적 이득. 로그 변환은 여기서 등분산도 함께 회복시킨다. 원 척도의 잔차 제곱합 44.36은 큰 칸에서 집중되어 있지만, 로그 척도의 4.81은 칸에 고르게 퍼진다. 교호작용과 이분산은 같은 뿌리(곱셈형 구조)에서 나올 때가 많다.
주의. 변환은 자료를 보기 전에 정하는 것이 원칙이다. "교호작용이 사라질 때까지 변환을 찾는" 것은 \(p\)-해킹이다.
연습문제 9. 보기 1의 ToothGrowth 그림에서 "용량 2.0에서 두 선이 만난다"는 눈으로 읽은 인상을 단순효과의 신뢰구간으로 확인하라.
풀이
그림이 말하는 것. OJ와 VC의 차이가 용량 0.5·1.0에서는 뚜렷하고 2.0에서는 사라진다. 이것을 수치로 검증한다.
각 용량에서 OJ \(-\) VC의 차이와 그 신뢰구간을 공통 MSE로 구한다.
import numpy as np
import pandas as pd
from scipy import stats
import statsmodels.api as sm
from statsmodels.formula.api import ols

tooth = [4.2, 11.5, 7.3, 5.8, 6.4, 10, 11.2, 11.2, 5.2, 7,
         16.5, 16.5, 15.2, 17.3, 22.5, 17.3, 13.6, 14.5, 18.8, 15.5,
         23.6, 18.5, 33.9, 25.5, 26.4, 32.5, 26.7, 21.5, 23.3, 29.5,
         15.2, 21.5, 17.6, 9.7, 14.5, 10, 8.2, 9.4, 16.5, 9.7,
         19.7, 23.3, 23.6, 26.4, 20, 25.2, 25.8, 21.2, 14.5, 27.3,
         25.5, 26.4, 22.4, 24.5, 24.8, 30.9, 26.4, 27.3, 29.4, 23]
df = pd.DataFrame({
    "len": tooth,
    "supp": ["VC"] * 30 + ["OJ"] * 30,
    "dose": ([0.5] * 10 + [1.0] * 10 + [2.0] * 10) * 2,
})

tab = sm.stats.anova_lm(ols("len ~ C(supp)*C(dose)", data=df).fit(), typ=2)
MSE = tab.loc["Residual", "sum_sq"] / tab.loc["Residual", "df"]
dfe, n = int(tab.loc["Residual", "df"]), 10
se = np.sqrt(2 * MSE / n)
print(f"MSE = {MSE:.4f},  df = {dfe},  SE(차이) = {se:.4f}")

print(f"\n{'dose':>5s} {'OJ':>7s} {'VC':>7s} {'OJ-VC':>8s} "
      f"{'95% CI':>20s} {'p':>9s} {'Bonf p':>9s}")
for d in [0.5, 1.0, 2.0]:
    a = df[(df.supp == "OJ") & (df.dose == d)].len.mean()
    b = df[(df.supp == "VC") & (df.dose == d)].len.mean()
    diff = a - b
    t = diff / se
    p = 2 * stats.t.sf(abs(t), dfe)
    h = stats.t.ppf(0.975, dfe) * se
    print(f"{d:5.1f} {a:7.2f} {b:7.2f} {diff:8.2f}  "
          f"[{diff - h:7.2f},{diff + h:7.2f}] {p:9.4f} {min(1, 3 * p):9.4f}")

half = stats.t.ppf(0.975, dfe) * np.sqrt(MSE / n)
print(f"\n칸 평균의 SE = {np.sqrt(MSE / n):.4f}  (오차막대 ±{half:.4f})")
MSE = 13.1871,  df = 54,  SE(차이) = 1.6240

 dose      OJ      VC    OJ-VC               95% CI         p    Bonf p
  0.5   13.23    7.98     5.25  [   1.99,   8.51]    0.0021    0.0063
  1.0   22.70   16.77     5.93  [   2.67,   9.19]    0.0006    0.0018
  2.0   26.06   26.14    -0.08  [  -3.34,   3.18]    0.9609    1.0000

칸 평균의 SE = 1.1484  (오차막대 ±2.3023)
그림의 인상이 정확히 확인된다.
| 용량 | OJ \(-\) VC | 본페로니 \(p\) | 판정 |
|---|---|---|---|
| 0.5 | \(+5.25\) | 0.006 | OJ 우위 |
| 1.0 | \(+5.93\) | 0.002 | OJ 우위 |
| 2.0 | \(-0.08\) | 1.000 | 차이 없음 |
용량 2.0의 차이 추정값이 \(-0.08\)로 거의 정확히 0이다. 구간 \([-3.34,\,3.18]\)이 0을 한가운데 둔다.
그러나 "차이가 없음을 증명했다"고 말할 수는 없다. 구간의 폭이 \(\pm3.3\)이다. 임상적으로 의미 있는 차이가 3 이하라면 이 자료는 동등성을 지지하지만, 그 기준을 정하는 것은 자료가 아니라 분야의 지식이다.
오차막대는 얼마나 크게 그릴까. 칸 평균의 95% 오차막대는 \(\pm2.30\)이다.
- 용량 0.5: OJ 13.23, VC 7.98 → 막대가 \([10.93,15.53]\)과 \([5.68,10.28]\)로 겹치지 않는다.
- 용량 2.0: 26.06과 26.14 → 거의 완전히 겹친다.
여기서는 오차막대의 겹침과 유의성 판정이 일치하지만, 늘 그렇지는 않다(연습문제 6 참조). 차이가 궁금하면 차이의 구간을 보라.
왜 본페로니인가. 단순효과 세 개를 모두 검정하므로 다중비교다. 보정 전 \(p=0.0021\)이 보정 후 \(0.0063\)이 되지만 결론은 바뀌지 않는다. 결론이 보정에 민감하지 않다는 것도 보고할 가치가 있는 사실이다.
최종 서술. "OJ가 VC보다 효과적이나 그 우위는 용량 2.0에서 사라진다(순서형 교호작용, \(F(2,54)=4.11\), \(p=0.022\)). 용량 0.5와 1.0에서 OJ의 우위는 각각 5.25 \([1.99,8.51]\), 5.93 \([2.67,9.19]\)이고, 2.0에서는 \(-0.08\) \([-3.34,3.18]\)이다."
연습문제 10. 교호작용 그림을 그리고 읽는 절차를 정리하라.
풀이
그림이 담는 것. 가로축 요인의 각 수준에서 칸 평균 \(\bar y_{ij}\)를 찍고, 다른 요인의 수준마다 선으로 잇는다. 선 사이의 간격이 두 번째 요인의 효과, 선의 기울기가 가로축 요인의 효과, 기울기의 차이가 교호작용이다.
그리기 절차 여섯.
- 양적·순서형 요인을 가로축에 놓는다(연습문제 7).
- 칸 평균을 찍는다. 표본이 불균형이면 \(n\)도 함께 표시한다.
- 오차막대를 반드시 붙인다. MSE로 만들고, 무엇인지 범례에 쓴다(연습문제 6).
- 점을 겹치지 않게 가로로 살짝 어긋나게(dodge) 배치한다.
- 원자료를 옅게 겹쳐 그리면 산포와 이상값이 함께 보인다.
- 축을 0에서 시작할 필요는 없지만, 잘린 축은 명시한다.
읽기 절차 다섯.
| 순서 | 볼 것 |
|---|---|
| 1 | 선이 교차하는가 → 비순서형 의심 |
| 2 | 오차막대에 비해 비평행이 큰가 |
| 3 | \(F\) 검정과 효과크기로 확인 |
| 4 | 유의하면 단순효과와 그 구간(연습문제 9) |
| 5 | 척도를 바꾸면 사라지는가(연습문제 8) |
흔한 오독 다섯.
| 오독 | 바로잡기 |
|---|---|
| 비평행 = 교호작용 있음 | 표본 변동일 수 있다. \(n=5\)면 26%가 \(\lvert \hat\psi\rvert>1\) |
| 평행 = 교호작용 없음 | 검정력 부족일 수 있다 |
| 오차막대 겹침 = 유의하지 않음 | 차이의 구간을 보라 |
| 교차 = 항상 비순서형 | 관측 범위 밖의 교차는 외삽이다 |
| 그림만으로 결론 | 그림은 가설을 만드는 도구, 검정이 답한다 |
그림과 표의 역할 분담.
| 매체 | 담는 것 |
|---|---|
| 그림 | 패턴의 모양, 교차 여부, 곡선의 형태 |
| 표 | 칸별 \(n\)·평균·표준편차, 대비와 구간 |
| 분산분석표 | \(F\), df, \(p\), 효과크기 |
셋을 모두 보고하는 것이 원칙이다. 그림만 있으면 재현할 수 없고, 표만 있으면 패턴이 보이지 않는다.
한 문장. 교호작용 그림은 "효과가 조건에 따라 달라지는가"를 눈으로 묻는 도구이고, 그 답은 오차막대와 검정이 함께 낸다.
정리하며
교호작용 그림은 선의 평행 여부로 읽는다.
- 평행하면 교호작용이 없다. 한 요인의 효과가 다른 요인의 수준과 무관하다는 뜻이며, 두 선의 간격이 일정하게 유지된다.
- 평행하지 않으면 교호작용이 있다. 간격이 벌어지거나 좁아지면 크기의 교호작용, 선이 교차하면 방향까지 뒤집히는 교호작용이다. 후자가 해석상 더 중요하다.
- 눈으로 본 비평행은 표집변동일 수 있다. 그림만으로 판단하지 말고 \(F\) 검정과 함께 보아야 하며, 반대로 유의한 교호작용도 그림 없이는 어떻게 다른지 알 수 없다.
- 축을 바꿔 두 번 그려 보는 것이 좋다. 어느 요인을 가로축에 두느냐에 따라 읽히는 이야기가 달라진다.
- 오차막대를 함께 그린다. 선이 갈라져 보여도 불확실성이 크면 결론을 내기 어렵다.
다음 절부터 사후비교로 넘어간다. \(F\) 검정이 기각한 뒤 어느 집단이 다른지 찾는 방법들이다.