대응 부호검정
같은 피험자에게서 처치 전후를 측정하는 것처럼 대응 관측값 \((X_i, Y_i)\)을 얻었다면, 자연스러운 접근은 자료를 차이 \(D_i = X_i - Y_i\)로 줄인 뒤 중앙값 차이가 0인지 검정하는 것이다. 대응 부호검정은 이 차이들에 부호검정을 적용하며, 각 차이의 방향(양수 또는 음수)만 쓰고 크기는 무시한다.
대응 부호검정은 분포 가정을 사실상 하지 않으므로 대응자료에 대한 가장 안전한 비모수 선택이다. 대가는 크기 정보까지 활용하는 대응 Wilcoxon 부호순위검정에 비해 검정력이 낮다는 것이다.
가설
\(i = 1, 2, \ldots, n\)에 대해 \(D_i = X_i - Y_i\)라 두고 \(p = P(D_i > 0)\)이라 하자. \(H_0\) 아래에서 중앙값 차이가 0이며 이는 \(p = 0.5\)를 뜻한다.
| 검정 유형 | \(H_0\) | \(H_a\) |
|---|---|---|
| 양측 | \(p = 0.5\) | \(p \ne 0.5\) |
| 왼쪽 꼬리 | \(p = 0.5\) | \(p < 0.5\) (처치가 결과를 악화시킨다) |
| 오른쪽 꼬리 | \(p = 0.5\) | \(p > 0.5\) (처치가 결과를 개선한다) |
절차
1단계. 대응차이 \(D_i = X_i - Y_i\)를 계산한다.
2단계. \(D_i = 0\)인 쌍을 모두 버린다. 남은(0이 아닌) 차이의 개수를 \(n\)이라 하자.
3단계. 양의 차이 개수 \(n_+\)와 음의 차이 개수 \(n_-\)를 센다.
4단계. \(H_0\) 아래에서 양의 부호 개수는
를 따른다.
5단계. \(p\)값을 계산한다. \(S \sim \text{Binomial}(n, 0.5)\)일 때
- 양측: \(p\text{값} = 2\min\!\bigl(P(S \le n_+),\; P(S \ge n_+)\bigr)\)
- 오른쪽 꼬리: \(p\text{값} = P(S \ge n_+)\)
- 왼쪽 꼬리: \(p\text{값} = P(S \le n_+)\)
\(n\)이 크면 정규근사가
를 준다.
보기 1. 운동 프로그램과 안정시 심박수. 참가자 10명을 대상으로 12주 프로그램 전후의 안정시 심박수(bpm)를 측정하여 운동 프로그램을 평가한다.
| 참가자 | 전 (\(X_i\)) | 후 (\(Y_i\)) | \(D_i = X_i - Y_i\) | 부호 |
|---|---|---|---|---|
| 1 | 72 | 68 | 4 | \(+\) |
| 2 | 80 | 75 | 5 | \(+\) |
| 3 | 68 | 70 | \(-2\) | \(-\) |
| 4 | 76 | 74 | 2 | \(+\) |
| 5 | 85 | 78 | 7 | \(+\) |
| 6 | 74 | 74 | 0 | (동점) |
| 7 | 90 | 82 | 8 | \(+\) |
| 8 | 78 | 76 | 2 | \(+\) |
| 9 | 82 | 79 | 3 | \(+\) |
| 10 | 70 | 72 | \(-2\) | \(-\) |
풀이
1단계. 위에서 차이를 계산했다. 동점 하나(\(D_6 = 0\))를 제외한다.
2단계. 남은 것: \(n = 9\), \(n_+ = 7\), \(n_- = 2\).
3단계. \(H_0\) 아래에서 \(n_+ \sim \text{Binomial}(9, 0.5)\)이다.
4단계. 오른쪽 꼬리 \(p\)값(\(H_a\): 프로그램이 심박수를 낮추므로 \(D_i > 0\)이 기대된다):
\(\alpha = 0.05\)에서 \(H_0\)을 기각하지 못한다. 동점이 아닌 9쌍 중 7쌍이 개선을 보였는데도 표본이 너무 작아 부호검정이 유의성에 이르지 못했다. 소표본에서 부호검정의 검정력이 낮음을 보여 주는 예이다.
검정력에 대한 고려
같은 자료에 대응 Wilcoxon 부호순위검정을 적용하면 차이의 크기를 쓰므로(큰 양의 차이가 더 큰 가중치를 받는다) \(p\)값이 더 작아질 수 있다. 대칭성 가정이 그럴듯하다면 대응 Wilcoxon 검정이 낫다.
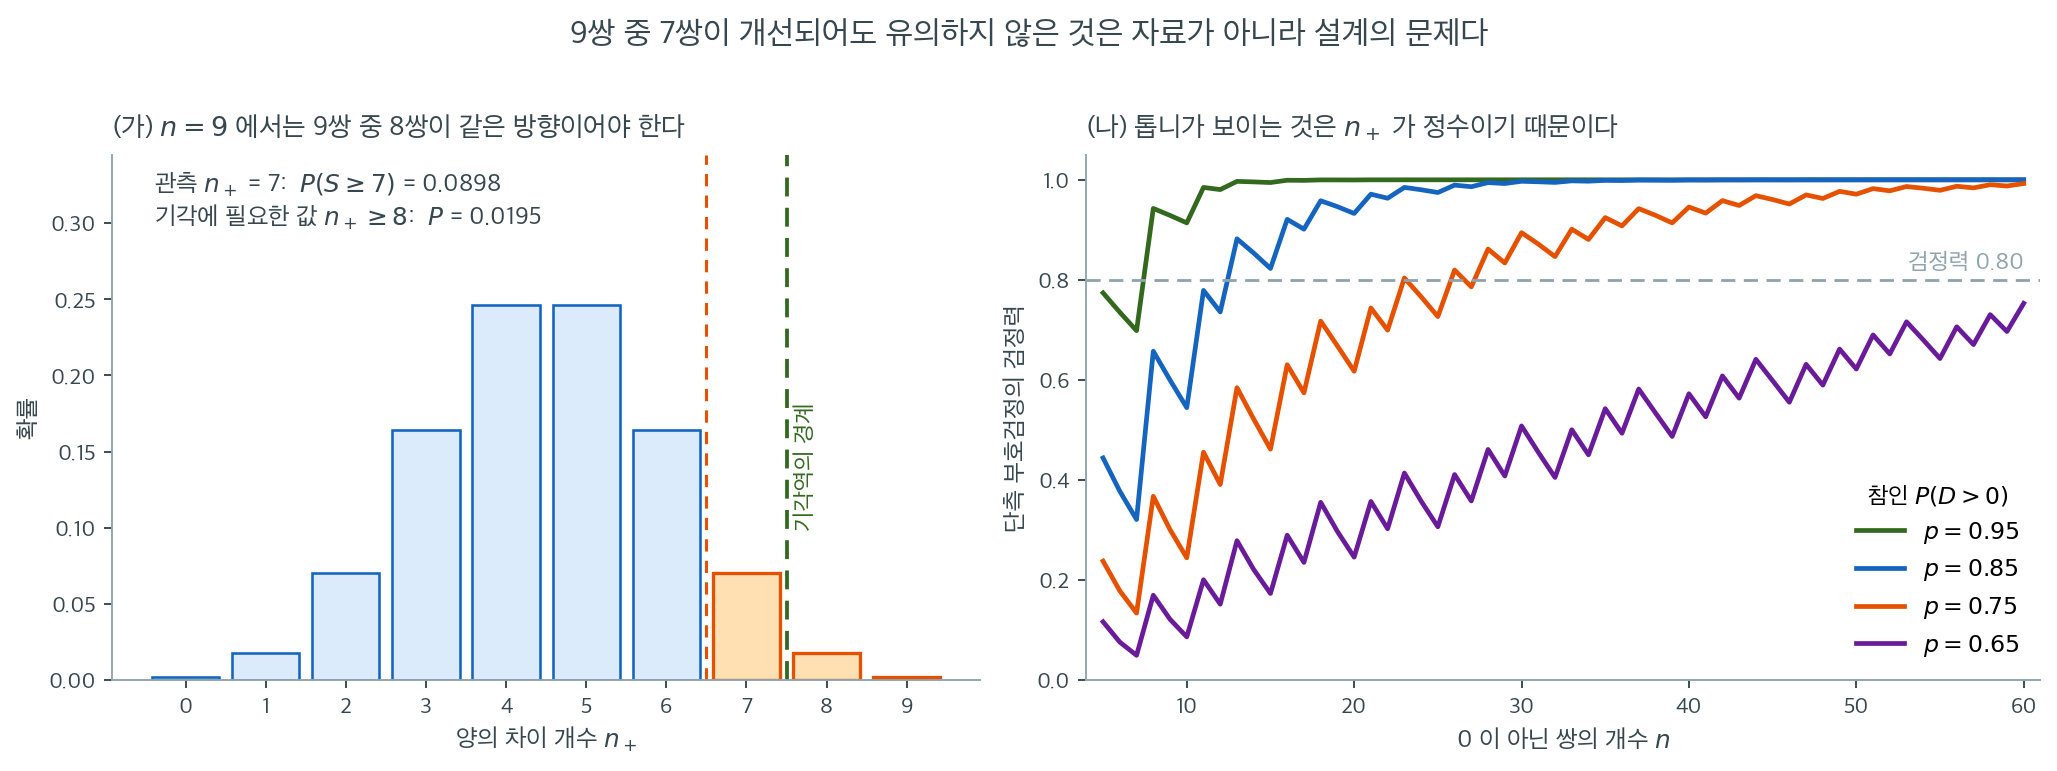
"표본이 너무 작아 유의성에 이르지 못했다"는 말이 얼마나 구체적인 제약인지 그림으로 확인해 두자.
(가)가 \(n = 9\)의 정확 귀무분포 \(\text{Binomial}(9,\,0.5)\)이다. 관측된 \(n_+ = 7\)부터 오른쪽 꼬리를 더하면 \(0.0898\)이다. 초록 점선이 기각역의 경계인데, \(\alpha = 0.05\) 단측검정에서 기각하려면 \(n_+ \ge 8\)이어야 하고 그때의 확률은 \(0.0195\)이다. 즉 아홉 쌍 중 여덟 쌍이 같은 방향이어야 한다. \(7\)과 \(8\) 사이에 중간 단계가 없으므로, 관측값이 경계 바로 아래에 있었다는 것 외에 달리 해석할 여지가 없다.
(나)가 처방을 준다. 참인 \(P(D > 0)\)을 \(0.65\)에서 \(0.95\)까지 바꿔 가며 단측 부호검정의 검정력을 표본크기별로 계산한 것이다. 심박수 자료의 관측 비율 \(7/9 \approx 0.78\)과 가까운 주황 곡선(\(p = 0.75\))을 보면, 검정력 \(0.80\)에 이르려면 \(0\)이 아닌 쌍이 \(23\)개 필요하다. \(9\)쌍으로는 애초에 승산이 없었다는 뜻이다.
곡선이 매끄럽지 않고 톱니처럼 흔들리는 것도 같은 이산성 때문이다. \(n\)이 하나 늘 때마다 임계값 \(c\)가 그대로일 수도 있고 하나 올라갈 수도 있는데, 올라가는 해에는 기각역이 좁아져 검정력이 오히려 떨어진다. \(n = 6\)보다 \(n = 7\)이 나빠 보이는 구간이 그런 자리이다. 대응설계의 표본크기를 정할 때 연속 공식을 믿지 말고 이런 표를 직접 계산해 봐야 하는 이유가 여기에 있다.
대응 부호검정을 언제 쓰는가
대응 부호검정은 다음 상황에 적절하다.
- 변화의 방향만 알 때. 예를 들어 환자가 변화의 정도를 수치화하지 않고 "호전" 또는 "악화"만 보고하는 경우.
- 차이가 순서형일 때. 측정 척도가 의미 있는 산술을 지원하지 않으면(예: Likert 척도) 크기에 신뢰성 있게 순위를 매길 수 없다.
- 대칭성이 의심스러울 때. Wilcoxon 부호순위검정은 차이 분포의 대칭성을 가정한다. 차이가 심하게 치우쳐 있다면 부호검정이 이 가정을 피한다.
대안과의 비교
| 특징 | 대응 \(t\) 검정 | 대응 Wilcoxon | 대응 부호검정 |
|---|---|---|---|
| 차이에 대한 가정 | 정규 | 대칭, 연속 | 연속 |
| 사용하는 정보 | 원값 | 부호 + 순위 | 부호만 |
| 검정력 (정규자료) | 최고 | 높음 (ARE \(\approx 0.955\)) | 낮음 (ARE \(\approx 0.637\)) |
| 이상치에 대한 로버스트성 | 낮음 | 높음 | 매우 높음 |
| 순서형 자료 적용 | 불가 | 때때로 | 가능 |
연습문제
연습문제 1. 위 심박수 자료에 대응 부호검정, 대응 Wilcoxon 부호순위검정, 대응 \(t\) 검정, 대응 순열검정을 모두 적용하여 단측 \(p\)값을 비교하라. 결론이 갈리는가?
풀이
import numpy as np, itertools
from scipy import stats
d = np.array([4, 5, -2, 2, 7, 0, 8, 2, 3, -2])
nz = d[d != 0]          # 동점 제외, n = 9

print(stats.binomtest(int((nz > 0).sum()), len(nz),
                      alternative='greater').pvalue)          # 0.0898
print(stats.wilcoxon(nz, alternative='greater',
                     method='exact').pvalue)                  # 0.0195
print(stats.ttest_1samp(nz, 0, alternative='greater').pvalue) # 0.0165

a = np.abs(nz); T = nz.sum()
allT = np.array([np.dot(s, a) for s in itertools.product([-1, 1], repeat=9)])
print((allT >= T).mean())                                     # 0.0254
출력:
0.08984375
0.01953125
0.01652701624852805
0.025390625
| 검정 | 단측 \(p\)값 | \(\alpha = 0.05\) 결론 |
|---|---|---|
| 대응 부호검정 | \(0.0898\) | 기각 못 함 |
| 대응 순열검정 | \(0.0254\) | 기각 |
| 대응 Wilcoxon | \(0.0195\) | 기각 |
| 대응 \(t\) | \(0.0165\) | 기각 |
부호검정만 결론이 다르다. 나머지 셋은 모두 유의하다고 판정한다.
이유는 이 자료의 구조에 있다. 음의 차이 두 개는 모두 \(-2\)로 절댓값이 가장 작다. 양의 차이는 \(4, 5, 2, 7, 8, 2, 3\)으로 \(8\)까지 올라간다. 크기를 쓰는 세 검정은 "반대 방향 증거가 있긴 하나 모두 미미하다"를 읽어 내지만, 부호검정에게는 \(-2\)가 \(-200\)과 같은 한 개의 음수일 뿐이다.
순열검정(\(0.0254\))이 Wilcoxon(\(0.0195\))보다 \(p\)값이 살짝 크다는 점도 흥미롭다. 순열검정은 원래 값을 쓰므로 이 자료에서 순위보다 정보를 더 쓰는데도 그렇다. \(n = 9\)에서 순열분포가 \(2^9 = 512\)개의 값밖에 갖지 못해 이산성이 크기 때문이며, 이 정도 차이는 잡음 범위이다.
연습문제 2. 대응 부호검정에서 동점(\(D_i = 0\))이 많으면 어떤 문제가 생기는가? 보기 자료의 동점 개수를 1개에서 5개로 늘려 가며 \(p\)값의 변화를 관찰하라.
풀이
from scipy import stats
# n+ = 7 은 고정, 동점만 늘려 전체 쌍 수를 키운다
for extra in range(0, 5):
    n = 9                # 0이 아닌 쌍의 수는 변하지 않는다
    print(10 + extra, n, stats.binomtest(7, n, alternative='greater').pvalue)
출력:
10 9 0.08984375
11 9 0.08984375
12 9 0.08984375
13 9 0.08984375
14 9 0.08984375
출력은 모두 \(0.0898\)이다. 동점을 아무리 많이 붙여도 부호검정의 \(p\)값은 전혀 변하지 않는다.
이것이 부호검정의 동점 처리가 가진 근본적 성질이자 위험이다. 참가자 100명 중 91명이 변화가 없고 7명이 개선, 2명이 악화했다고 하자. 부호검정은 여전히 \(p = 0.0898\)을 준다. 하지만 "100명 중 7명만 개선"이라는 사실은 실질적으로 프로그램의 효과가 미미함을 강하게 시사한다.
부호검정이 검정하는 귀무가설이 "\(D \ne 0\)인 쌍들 중에서" \(P(D > 0) = P(D < 0)\)이기 때문이다. 변화가 없는 쌍은 이 조건부 확률에 대해 아무 정보도 주지 않으므로 옳게 버려지는 것이다.
실무 권고: 동점 비율이 높으면 부호검정 \(p\)값과 함께 동점 비율을 반드시 함께 보고해야 한다. 검정 결과만 보고하면 효과의 실질적 크기를 완전히 오도한다. 효과 크기가 관심사라면 \(\hat{p} = n_+/(n_+ + n_-)\)가 아니라 \(n_+/N\)을 보는 것이 낫다.
연습문제 3. 대응 부호검정에서 중앙값 차이의 신뢰구간을 어떻게 구하는가? 보기 자료로 95% 신뢰구간을 계산하라.
풀이
부호검정을 역전시키면 중앙값의 신뢰구간이 나온다. 차이를 정렬한 순서통계량 \(D_{(1)} \le \cdots \le D_{(n)}\)에 대해 구간은
이며, \(k\)는 \(2P(S \le k) \le \alpha\)를 만족하는 가장 큰 정수이다(\(S \sim \text{Binomial}(n, 0.5)\)).
import numpy as np
from scipy import stats
d = np.array([4, 5, -2, 2, 7, 0, 8, 2, 3, -2])
nz = np.sort(d[d != 0]); n = len(nz)     # n = 9
for k in range(0, 4):
    print(k, 2 * stats.binom.cdf(k, n, 0.5))
# k=0: 0.0039, k=1: 0.0391, k=2: 0.1797  →  k = 1
print(nz)                     # [-2 -2  2  2  3  4  5  7  8]
print(nz[1], nz[n - 2])       # -2, 7
출력:
0 0.00390625
1 0.0390625
2 0.1796875
3 0.5078125
[-2 -2  2  2  3  4  5  7  8]
-2 7
\(k = 1\)이므로 95% 신뢰구간은 \(\bigl(D_{(2)}, D_{(8)}\bigr) = (-2, \; 7)\)이다.
구간이 \(0\)을 포함하므로 검정 결과(\(p = 0.0898\), 기각 못 함)와 일관된다. 구간과 검정이 이렇게 맞물리는 것은 구간이 검정을 역전시켜 만들어졌기 때문이다.
구간이 매우 넓다는 점에 주목하라. 폭이 \(9\) bpm으로, 자료 전체 범위(\(-2\)에서 \(8\))와 거의 같다. \(n = 9\)에서 부호검정 기반 구간이 쓸 수 있는 것은 \(k = 1\)뿐이므로 양 끝에서 하나씩만 잘라 낼 수 있다. 실제 포함확률은 \(1 - 0.0391 = 0.961\)로 명목값보다 높다. 소표본에서 부호검정 구간이 지나치게 보수적인 이유이다.
연습문제 4. 대응자료를 대응으로 다루지 않고 두 독립표본처럼 분석하면 무슨 일이 일어나는가? 보기 자료로 Mann-Whitney 검정을 수행하고 대응 부호검정과 비교하라.
풀이
import numpy as np
from scipy import stats
before = np.array([72, 80, 68, 76, 85, 74, 90, 78, 82, 70])
after  = np.array([68, 75, 70, 74, 78, 74, 82, 76, 79, 72])
print(stats.mannwhitneyu(before, after, alternative='greater'))
print(np.corrcoef(before, after)[0, 1])
출력:
MannwhitneyuResult(statistic=61.0, pvalue=0.2128050157999556)
0.9232351791538461
| 분석 | 단측 \(p\)값 |
|---|---|
| 대응 부호검정 | \(0.0898\) |
| 대응 Wilcoxon | \(0.0195\) |
| Mann-Whitney (대응 무시) | \(0.2128\) |
대응 구조를 무시하면 \(p\)값이 \(0.213\)으로 크게 나빠진다. 대응 Wilcoxon의 \(0.0195\)와 비교하면 11배이다. 이유는 두 측정값의 상관이 \(0.923\)으로 매우 높기 때문이다.
직관은 이렇다. 참가자들의 기저 심박수가 \(68\)에서 \(90\)까지 넓게 퍼져 있다. 두 집단을 독립으로 보면 이 개인차가 모두 잡음으로 들어간다. 대응 분석은 각 참가자 안에서 차이를 계산하여 개인차를 통째로 소거하고, 남은 것은 처치 효과뿐이다.
이것이 대응설계의 존재 이유이며, 대응자료를 독립표본으로 분석하는 것이 흔하면서도 값비싼 실수인 이유이다. 반대 방향의 실수(독립자료를 억지로 짝지어 대응 분석) 역시 위험하다. 이 경우 자유도를 절반으로 잃으면서 아무것도 얻지 못한다.
정리하며
대응 부호검정은 대응 관측값을 양·음 부호의 수열로 줄이고 이항분포를 써서 중앙값 차이가 0인지 검정한다. 독립성과 연속성 외에 분포 가정이 필요 없어 가장 로버스트한 대응표본 검정이다. 대응 Wilcoxon 검정이나 대응 \(t\) 검정에 비해 검정력이 낮은 것은 크기를 무시하며 버린 정보의 대가이다. 크기 정보를 쓸 수 있고 대칭성 가정이 합리적이라면 대응 Wilcoxon 부호순위검정이 대체로 낫다.