OLS 회귀 출력 재현
개요
들어가는 이야기 — 그 표를 보고 예산을 옮긴다
summary() 한 번이면 계수와 표준오차와 \(t\) 와 \(p\) 와 신뢰구간이 한 표로 쏟아진다. 그 표를 보고 광고 예산을 어느 매체로 옮길지 정하게 되는데, 열들이 어디서 나온 수인지 모르면 어느 열이 먼저 무너지는지도 모른다.
그래서 이 쪽은 그 표를 정규방정식(normal equations)에서 손으로 다시 만들어 꾸러미의 것과 맞대 본다. 표준오차는 \(s^2(\mathbf X^\top\mathbf X)^{-1}\) 의 대각원소에 뿌리를 씌운 것이고 \(t\) 는 계수를 그것으로 나눈 것이다. 매출을 TV·라디오·신문 광고비에 회귀한 자료에서 계수의 최대 차이가 \(4.4 \times 10^{-14}\), 표준오차가 \(6.7 \times 10^{-16}\), \(t\) 가 \(1.3 \times 10^{-13}\) 이다.
이 작음은 식이 맞았다는 증거가 아니다. 같은 식을 같은 자료에 두 번 쓴 것이니 당연히 같아야 하고, 남는 차이는 배정밀도 수의 반올림 한 단위가 \(10^{-16}\) 쯤이라는 데서 오는 누적일 뿐이다. 식이 틀렸다면 두 쪽이 똑같이 틀린 수를 내놓았을 것이다.
맞대어 보는 값어치는 다른 데 있다. 열마다 어떤 양이 들어가는지 손으로 한 번 짚어 두면 표가 조용히 틀릴 자리를 알게 된다. 자료가 나빠질 때 어느 열이 먼저 흔들리는지를 안다 — 계수는 버티는데 표준오차가 먼저 커지고, 설명변수들이 서로 닮으면 역행렬을 만드는 자리에서 반올림이 자란다.
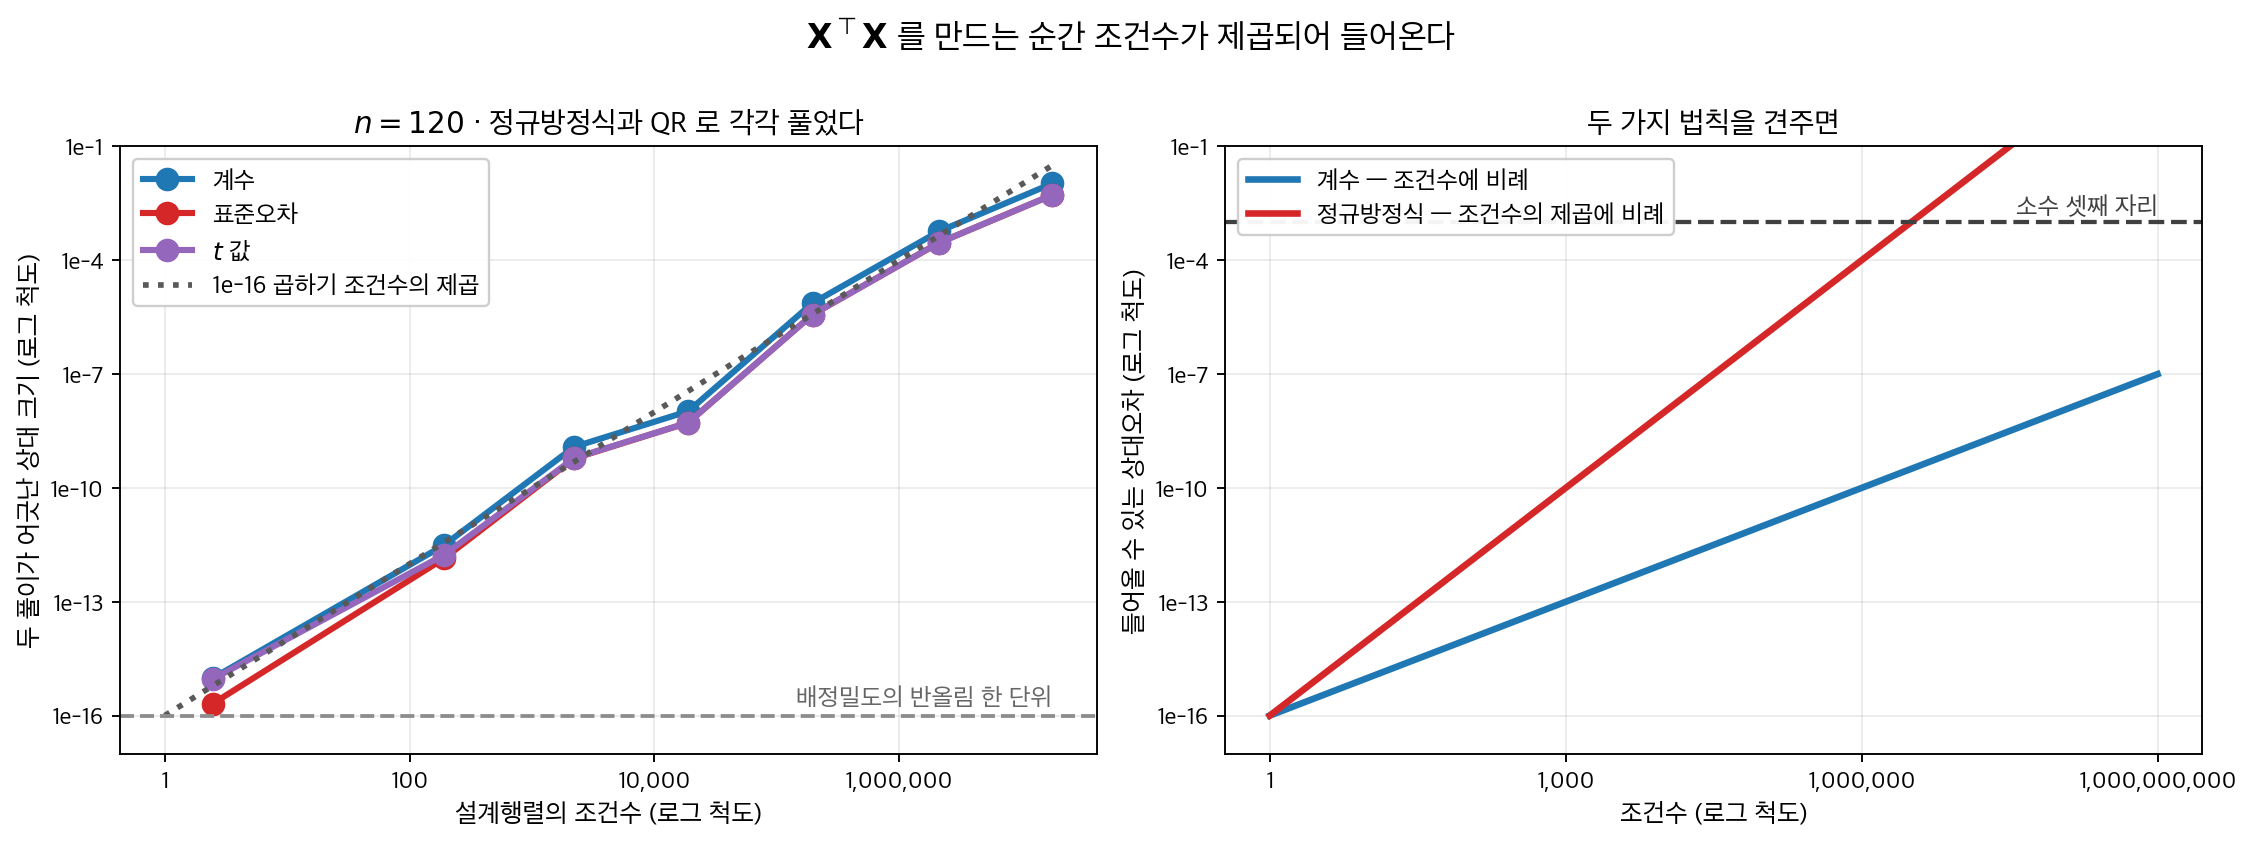
같은 자료를 두 가지로 풀었다 — \(\mathbf X^\top\mathbf X\) 를 만들어 푸는 정규방정식과, \(\mathbf X\) 를 직접 분해하는 QR 이다. 왼쪽. 설계행렬이 특이에 가까워질수록 두 답이 벌어지는데, 그 크기가 조건수가 아니라 조건수의 제곱(점선)을 따라간다. 조건수 \(10^7\) 이면 불일치가 소수 둘째 자리까지 올라온다. 오른쪽. 까닭은 \(\mathbf X^\top\mathbf X\) 를 만드는 순간 조건수가 제곱되기 때문이다. 표가 다섯째 자리까지 같은 것은 식이 맞았다는 증거가 아니라 그 자료의 조건수가 작다는 증거다.
표의 각 열은 어떤 식에서 나오며, 그 식은 어느 자리에서 수치로 무너지기 시작하는가. 아래 상자가 열일곱 점짜리 옛 자료로 같은 맞대보기를 해 둔다.
확인한 곳 — 이 쪽 「표가 다섯째 자리까지 같을 때 — 포브스의 열일곱 점」 상자와 그 출처 줄
이 페이지는 정규방정식을 써서 OLS 회귀 요약표 전체를 밑바닥부터 재현하는 방법을 보인다. Advertising 자료(Sales를 TV, Radio, Newspaper에 회귀)에서 출발하여, 미리 만들어진 회귀 요약 함수에 기대지 않고 계수, 표준오차, \(t\) 통계량, \(p\) 값, 95% 신뢰구간을 직접 계산한다.
1. 수학적 배경 — 정규방정식에서 회귀표까지
행렬 형태의 다중선형회귀 모형은
OLS 추정량은 정규방정식으로 얻는다.
잔차 표준오차는
여기서 \(k\)는 (절편(intercept)을 포함한) 모수의 개수이다. \(j\)번째 계수의 표준오차는
\(H_0\colon \beta_j = 0\)을 검정하는 \(t\) 통계량과 \(p\) 값은
\(\beta_j\)의 95% 신뢰구간은 \(\hat{\beta}_j \pm t^*_{n-k,\,0.025} \cdot \mathrm{SE}(\hat{\beta}_j)\)이다.
정규방정식으로 OLS 적합하기
보기 1. OLS 적합 함수. 정규방정식으로 \(\hat{\boldsymbol\beta}\) 와 \(s\), 그리고 \((\mathbf X^\top\mathbf X)^{-1}\) 을 돌려준다.
(1) \(\operatorname{Var}(\hat{\boldsymbol\beta})\) 를 유도하여, 함수가 cov_matrix 라 부르는 것이 계수의 공분산행렬이 아님을 밝히시오. 참 공분산행렬은 어떻게 만드는가.
(2) 최소제곱 해는 \(\mathbf X^\top \mathbf e = \mathbf 0\) 을 만족한다. 그것을 유도하고 수로 확인하시오. 그리고 np.linalg.inv 로 푼 해가 lstsq 의 해와 몇 자리까지 같은지 보시오.
풀이
(1) 참 공분산행렬에는 \(\sigma^2\) 이 곱해져 있다. \(\hat{\boldsymbol\beta} = (\mathbf X^\top\mathbf X)^{-1}\mathbf X^\top\mathbf y\) 이고 \(\mathbf A = (\mathbf X^\top\mathbf X)^{-1}\mathbf X^\top\) 라 쓰면 \(\hat{\boldsymbol\beta} = \mathbf A\mathbf y\) 로 \(\mathbf y\) 의 선형변환이다. \(\operatorname{Var}(\mathbf y) = \sigma^2\mathbf I\) 이므로
가운데 셋이 약분되어 \((\mathbf X^\top\mathbf X)^{-1}\) 하나만 남는 것이 요점이다.
그러므로 함수가 돌려주는 cov_matrix 는 \((\mathbf X^\top\mathbf X)^{-1}\) 로 \(\sigma^2\) 이 빠진 껍데기다. 척도조차 맞지 않는다. 참 공분산행렬의 추정값은
이고, 함수가 s 를 따로 돌려주는 까닭이 바로 이것이다. 그래서 표준오차가 s * np.sqrt(cov_matrix[j, j]) 로 만들어진다. 이름을 xtx_inv 라 했으면 오해가 없었을 것이다.
(2) 직교성은 미분에서 바로 나온다. 목적함수 \(\|\mathbf y - \mathbf X\boldsymbol\beta\|^2\) 를 \(\boldsymbol\beta\) 로 미분해 \(\mathbf 0\) 으로 두면
이다. 곧 잔차는 설계행렬의 모든 열과 직교한다. 정규방정식 \(\mathbf X^\top\mathbf X\hat{\boldsymbol\beta} = \mathbf X^\top\mathbf y\) 와 같은 식을 다르게 적은 것이다.
첫 열이 \(\mathbf 1\) 이면 그 성분이
이므로 절편이 있는 모형에서 잔차의 합은 \(0\) 이다. 이것이 앞 절에서 절편 누락을 잡아내는 데 쓴 신호다.
inv 와 lstsq 는 같은 해를 다르게 계산한다. lstsq 는 SVD 를, inv 는 LU 분해로 역행렬을 만든다. 연습문제 4 가 말하는 대로 조건이 좋으면 기계 정밀도 수준으로 일치해야 한다. \(\mathbf X^\top\mathbf X\) 의 조건수를 함께 보면 그 "기계 정밀도 수준" 이 몇 자리인지 가늠할 수 있다.
import numpy as np
from scipy import stats

def fit_ols(X, y):
    """최소제곱 추정값과, 표준오차를 만드는 데 필요한 두 조각을 돌려준다.

    s 는 잔차의 표준편차(자유도 n-k), cov_matrix 는 (X'X)^-1 이다.
    계수 j 의 표준오차는 s * sqrt(cov_matrix[j, j]) 로 만들어진다.
    """
    n, k = X.shape
    beta_hat = np.linalg.inv(X.T @ X) @ X.T @ y
    y_hat = X @ beta_hat
    residuals = y - y_hat
    s = np.sqrt(np.sum(residuals ** 2) / (n - k))
    cov_matrix = np.linalg.inv(X.T @ X)
    return beta_hat, s, cov_matrix
# 보기 3 의 자료를 여기서 미리 읽어 둔다(보기 3 에서 다시 읽어도 결과는 같다).
import pandas as pd

url = ('https://raw.githubusercontent.com/justmarkham/'
       'scikit-learn-videos/8545c74961398def7724501648fd504dbf061b41/data/Advertising.csv')
data = pd.read_csv(url, usecols=[1, 2, 3, 4])
training_data = data.iloc[:int(len(data) * 0.7)]
y = np.array(training_data.Sales).reshape(-1, 1)
n = y.shape[0]
X = np.concatenate((np.ones((n, 1)), np.array(training_data.iloc[:, :-1])), axis=1)
k = X.shape[1]
beta_hat, s, cov_matrix = fit_ols(X, y)

residuals = y - X @ beta_hat
print(f"n = {n},  k = {k},  s = {s:.6f},  s^2 = {s ** 2:.6f}")
print("(X'X)^-1 의 대각 =", np.diag(cov_matrix).round(8))
print("표준오차 = s * sqrt(diag) =", (s * np.sqrt(np.diag(cov_matrix))).round(6))
print(f"X'e 의 최대 절대값 = {np.abs(X.T @ residuals).max():.3e}")
print(f"잔차의 합          = {residuals.sum():.3e}")

beta_lstsq = np.linalg.lstsq(X, y, rcond=None)[0]
print(f"inv 와 lstsq 의 최대 차이 = {np.abs(beta_lstsq - beta_hat).max():.3e}")
print(f"X'X 의 조건수 = {np.linalg.cond(X.T @ X):.4e},  X 의 조건수 = {np.linalg.cond(X):.4e}")
출력:
n = 140,  k = 4,  s = 1.736514,  s^2 = 3.015479
(X'X)^-1 의 대각 = [5.077908e-02 9.600000e-07 3.855000e-05 1.632000e-05]
표준오차 = s * sqrt(diag) = [0.39131  0.001701 0.010782 0.007015]
X'e 의 최대 절대값 = 1.247e-10
잔차의 합          = -1.790e-12
inv 와 lstsq 의 최대 차이 = 4.041e-14
X'X 의 조건수 = 2.0924e+05,  X 의 조건수 = 4.5743e+02
(1)이 수로 확인된다. cov_matrix 의 대각이 \((0.0508,\ 9.6 \times 10^{-7},\ 3.9 \times 10^{-5},\ 1.6 \times 10^{-5})\) 다. 이 수들의 제곱근을 그대로 표준오차로 쓰면 TV 의 표준오차가 \(0.00098\) 이 되어 참값 \(0.001701\) 의 \(58\%\) 다. \(s = 1.7365\) 를 곱해야 비로소 맞는다. 곧 cov_matrix 를 공분산행렬로 착각하면 표준오차를 \(1.74\) 배 작게 보고하고, \(t\) 값을 \(1.74\) 배 크게 보고한다. 유의성 판정이 뒤집힐 수 있는 크기다.
(2) 직교성이 성립한다. \(\mathbf X^\top\mathbf e\) 의 최대 절대값이 \(1.2 \times 10^{-10}\) 이다. 정확한 \(0\) 이 아니라 부동소수점의 \(0\) 이다. \(\mathbf X\) 의 원소가 \(10^2\) 규모이고 \(\mathbf y\) 가 \(10^1\) 규모이니, \(140\) 개를 더하는 동안 쌓인 상대오차 \(10^{-14}\) 쯤에 해당한다. 잔차의 합은 \(-1.8 \times 10^{-12}\) 로 더 작다.
inv 와 lstsq 의 차이는 \(4.0 \times 10^{-14}\) 다. 계수의 크기가 \(10^{-3}\) 에서 \(10^0\) 사이이므로 열 자리 이상 일치한다. 이 자료에서는 두 방법이 사실상 같다는 뜻이다.
조건수를 읽어 두자. \(\mathbf X\) 의 조건수가 \(457\) 이고 \(\mathbf X^\top\mathbf X\) 의 것이 그 제곱인 \(2.09 \times 10^5\) 다. 역행렬을 명시적으로 만드는 방식은 조건수를 제곱하는 쪽에서 계산하므로 정밀도를 절반 잃는다. 여기서는 \(10^5\) 에 \(10^{-16}\) 을 곱해 \(10^{-11}\) 이 남으니 넉넉하지만, 공선성이 심한 자료에서는 이 제곱이 치명적이 된다. 그래서 lstsq 를 쓰는 것이 권장된다(연습문제 4).
덧붙여 이 함수는 np.linalg.inv(X.T @ X) 를 두 번 부른다. 결과가 같으므로 틀린 것은 아니지만 계산이 두 배다. 한 번 계산해 변수에 담아 쓰는 것이 옳다.
회귀표 만들기
보기 2. 회귀 출력표 만들기. 계수·표준오차·\(t\)·\(p\) 값·신뢰구간을 차례로 만들어 한 줄씩 찍는 함수다.
(1) 이 함수가 찍는 세 가지 판정 — \(p < 0.05\), \(|t| > t^*\), 신뢰구간이 \(0\) 을 품지 않음 — 이 서로 완전히 같은 조건임을 증명하고 네 행에서 확인하시오.
(2) SE={se:.3f} 라는 서식에 결함이 있다. 찍힌 수만 가지고 \(t\) 값을 되살릴 수 있는지 TV 행에서 확인하시오.
풀이
(1) 세 조건은 같은 조건이다. 자유도 \(\nu = n - k\) 의 \(t\) 분포에서 \(t^* = t_{0.975,\,\nu}\) 라 하자. 먼저 \(p\) 값과 \(|t|\) 의 관계는
이다. 중간 단계에서 \(P(T_\nu > \cdot)\) 가 감소함수라는 것만 썼다.
다음으로 신뢰구간과 \(|t|\) 의 관계는 구간이
이므로, 이 구간이 \(0\) 을 품는 것은 \(|\hat\beta| \le t^*\,\mathrm{SE}\), 곧
과 같다. 그러므로 구간이 \(0\) 을 배제하는 것이 \(|t| > t^*\) 와 같다.
셋을 이으면
\(p\) 값과 신뢰구간은 같은 계산의 두 표현이다. 둘 다 찍는 것이 중복처럼 보이지만, \(p\) 값은 "\(0\) 인가" 에만 답하고 신뢰구간은 "그럼 얼마인가" 에도 답한다는 점이 다르다.
(2) 되살릴 수 없다. TV 의 계수는 \(0.0470\) 으로 찍히고 표준오차는 소수 셋째 자리까지라 \(0.002\) 로 찍힌다. 그 둘로 \(t\) 를 셈하면
인데 표에 찍힌 \(t\) 는 \(27.653\) 이다. \(18\%\) 어긋난다. 참 표준오차가 \(0.0017\) 인데 \(0.002\) 로 반올림되면서 \(18\%\) 커진 탓이다.
설명변수(explanatory variable)의 값의 규모가 크면 계수와 표준오차가 작아지므로, 고정 소수점 서식은 그 자리에서 무너진다. statsmodels 가 std err 를 세 자리로 찍는 것도 같은 한계를 지니며(표에 \(0.002\) 로 나온다), 그래서 results.bse 를 속성으로 꺼내 쓰라고 권하는 것이다.
def regression_table(beta_hat, s, cov_matrix, n, k, var_names):
    """회귀 출력표를 직접 만든다.

    statsmodels 의 summary() 가 찍어 주는 계수 표와 같은 내용이다.
    계수 → 표준오차 → t → p 값 → 신뢰구간이 어떤 순서로 만들어지는지를
    보이려고 풀어 썼다.
    """
    df = n - k
    t_crit = stats.t(df).ppf(0.975)

    for name, j in zip(var_names, range(k)):
        coef = beta_hat[j, 0]
        v_j = cov_matrix[j, j]
        se = s * np.sqrt(v_j)
        t_stat = coef / se
        p_val = 2 * stats.t(df).sf(np.abs(t_stat))
        ci_lo = coef - t_crit * se
        ci_hi = coef + t_crit * se
        print(f"{name:10}  coef={coef:.4f}  SE={se:.3f}  "
              f"t={t_stat:.3f}  p={p_val:.3f}  "
              f"CI=({ci_lo:.3f}, {ci_hi:.3f})")
df = n - k
t_crit = stats.t(df).ppf(0.975)
print(f"자유도 = {df},  t 임계값 = {t_crit:.6f}")

names = ["Intercept", "TV", "Radio", "Newspaper"]
for j, nm in enumerate(names):
    se = s * np.sqrt(cov_matrix[j, j])
    t_stat = beta_hat[j, 0] / se
    p_val = 2 * stats.t(df).sf(abs(t_stat))
    lo, hi = beta_hat[j, 0] - t_crit * se, beta_hat[j, 0] + t_crit * se
    print(f"  {nm:10s} |t|>t* {str(abs(t_stat) > t_crit):5s}  "
          f"p<0.05 {str(p_val < 0.05):5s}  CI 가 0 을 배제 {str(not (lo < 0 < hi)):5s}  "
          f"(t={t_stat:+.4f}, p={p_val:.3e})")

se_tv = s * np.sqrt(cov_matrix[1, 1])
print(f"TV 의 표준오차: 참값 {se_tv:.6f},  세 자리로 찍으면 {se_tv:.3f}")
print(f"찍힌 수로 셈한 t = 0.0470/0.002 = {0.0470 / 0.002:.2f},  참 t = {beta_hat[1, 0] / se_tv:.4f}")
출력:
자유도 = 136,  t 임계값 = 1.977561
  Intercept  |t|>t* True   p<0.05 True   CI 가 0 을 배제 True   (t=+7.7819, p=1.609e-12)
  TV         |t|>t* True   p<0.05 True   CI 가 0 을 배제 True   (t=+27.6535, p=1.092e-57)
  Radio      |t|>t* True   p<0.05 True   CI 가 0 을 배제 True   (t=+16.6646, p=1.161e-34)
  Newspaper  |t|>t* False  p<0.05 False  CI 가 0 을 배제 False  (t=-0.4285, p=6.690e-01)
TV 의 표준오차: 참값 0.001701,  세 자리로 찍으면 0.002
찍힌 수로 셈한 t = 0.0470/0.002 = 23.50,  참 t = 27.6535
(1) 네 행 모두에서 세 판정이 일치한다. 앞의 셋은 True True True, Newspaper 는 False False False 다. 유도한 동치관계가 예외 없이 지켜진다.
임계값은 \(t_{0.975,\,136} = 1.977561\) 이다. 정규분포의 \(1.96\) 보다 \(0.9\%\) 크다. 자유도가 \(136\) 이면 \(t\) 와 정규의 차이가 이 정도이므로, 표본이 수백 이상이면 \(\pm 2\,\mathrm{SE}\) 라는 근사가 실용적으로 충분하다.
그래도 \(p\) 값과 신뢰구간을 둘 다 보아야 하는 까닭을 Newspaper 가 보여 준다. \(p = 0.669\) 는 "\(0\) 이라는 가설을 기각할 수 없다" 는 것만 말한다. 신뢰구간 \((-0.0169,\ 0.0109)\) 은 그보다 많은 것을 말한다. 참 효과가 \(-0.017\) 과 \(0.011\) 사이이므로 부호조차 정하지 못했고, 동시에 \(\pm 0.017\) 보다 큰 효과는 배제되었다는 것이다. 후자가 "효과가 없다" 라는 결론에 다가가는 유일한 길이다.
(2) 되살릴 수 없음이 확인된다. 찍힌 수로 셈하면 \(23.50\) 이고 참 \(t\) 는 \(27.6535\) 다. 표준오차의 참값이 \(0.001701\) 인데 \(0.002\) 로 반올림된 탓이다.
고치는 방법은 서식을 유효숫자 기준으로 바꾸는 것이다. SE={se:.3g} 로 하면 \(0.0017\) 로 찍혀 셈이 맞는다. 표를 사람이 읽을 때는 보기 좋은 반올림이 좋지만, 그 표에서 다른 수를 되살려야 한다면 유효숫자를 지켜야 한다.
Advertising 자료에서 실행하기
보기 3. 광고 자료에 적용하기. Advertising 자료 \(200\) 행 가운데 앞 \(70\%\) 로 매출을 TV·Radio·Newspaper 에 회귀하고, 보기 1·2 의 함수로 표를 찍는다.
(1) 손으로 만든 네 열이 statsmodels 의 계수표와 몇 자리까지 같은지 확인하시오.
(2) 이 코드는 data.iloc[:int(len(data) * 0.7)] 로 파일 앞머리 140 행을 쓴다. 무작위 표본이 아니다. 전체 \(200\) 행과 무작위 \(140\) 행으로 적합한 것을 견주어 그 선택이 결론을 바꾸는지 보시오.
풀이
(1) 같아야 한다. 보기 1·2 의 계산은 statsmodels 가 쓰는 식과 글자 그대로 같다. 계수는 정규방정식, 표준오차는 \(s\sqrt{[(\mathbf X^\top\mathbf X)^{-1}]_{jj}}\), \(t\) 는 둘의 비, \(p\) 는 \(t_{136}\) 의 양측 꼬리다. 다른 것은 푸는 경로뿐이다. 우리는 np.linalg.inv 로 역행렬을 만들고 statsmodels 는 pinv 를 쓴다. 그러므로 반올림 오차만큼 다를 것이고, 조건수가 \(2.1 \times 10^5\) 이니 상대오차 \(10^{-11}\) 쯤까지는 믿을 수 있다.
(2) 앞머리를 떼는 것은 위험한 습관이다. 자료가 어떤 순서로 정렬되어 있으면 앞 \(70\%\) 가 특정 집단으로 뭉친다. 13.11절 무엇을 언제 쓸 것인가의 Boston 자료에서 그 때문에 교차검증(cross-validation) \(R^2\) 가 \(0.66\) 에서 \(0.43\) 으로 떨어지는 것을 본다.
Advertising 은 시장 \(200\) 곳을 번호로 나열한 자료이고 번호에 뜻이 없어 보이지만, 그것을 확인하지 않고 가정할 수는 없다. 확인하는 방법은 같은 크기의 무작위 표본과 견주는 것이다. 세 적합이 비슷하면 순서에 뜻이 없다는 증거이고, 다르면 순서가 무언가를 담고 있다는 뜻이다.
import pandas as pd

url = ('https://raw.githubusercontent.com/justmarkham/'
       'scikit-learn-videos/8545c74961398def7724501648fd504dbf061b41/data/Advertising.csv')
data = pd.read_csv(url, usecols=[1, 2, 3, 4])
# 앞 70%만 훈련에 쓴다.
training_data = data.iloc[:int(len(data) * 0.7)]

y = np.array(training_data.Sales).reshape(-1, 1)
n = y.shape[0]
# 1 로 채운 열을 앞에 붙여 절편을 만든다. 마지막 열이 반응(Sales)이므로
# iloc[:, :-1] 로 설명변수만 고른다.
X = np.concatenate(
    (np.ones((n, 1)), np.array(training_data.iloc[:, :-1])), axis=1
)
k = X.shape[1]

beta_hat, s, cov_matrix = fit_ols(X, y)
var_names = ["Intercept", "TV", "Radio", "Newspaper"]
regression_table(beta_hat, s, cov_matrix, n, k, var_names)
출력:
Intercept   coef=3.0451  SE=0.391  t=7.782  p=0.000  CI=(2.271, 3.819)
TV          coef=0.0470  SE=0.002  t=27.653  p=0.000  CI=(0.044, 0.050)
Radio       coef=0.1797  SE=0.011  t=16.665  p=0.000  CI=(0.158, 0.201)
Newspaper   coef=-0.0030  SE=0.007  t=-0.428  p=0.669  CI=(-0.017, 0.011)
요약표의 각 열을 따로 꺼내 인쇄했다. 계수, 표준오차, \(t\), p 값, 신뢰구간이 어떻게 맞물리는지 한 줄로 볼 수 있다.
출력(\(n = 140\), \(k = 4\)):
Intercept   coef=3.0451  SE=0.391  t=7.782   p=0.000  CI=(2.271, 3.819)
TV          coef=0.0470  SE=0.002  t=27.653  p=0.000  CI=(0.044, 0.050)
Radio       coef=0.1797  SE=0.011  t=16.665  p=0.000  CI=(0.158, 0.201)
Newspaper   coef=-0.0030 SE=0.007  t=-0.428  p=0.669  CI=(-0.017, 0.011)
import statsmodels.api as sm

ref = sm.OLS(y, X).fit()
se_hand = s * np.sqrt(np.diag(cov_matrix))
t_hand = beta_hat.ravel() / se_hand
p_hand = 2 * stats.t(n - k).sf(np.abs(t_hand))
print(f"계수   최대 차이 = {np.abs(ref.params - beta_hat.ravel()).max():.3e}")
print(f"표준오차 최대 차이 = {np.abs(ref.bse - se_hand).max():.3e}")
print(f"t      최대 차이 = {np.abs(ref.tvalues - t_hand).max():.3e}")
print(f"p 값   최대 차이 = {np.abs(ref.pvalues - p_hand).max():.3e}")
print(f"X'X 의 조건수 = {np.linalg.cond(X.T @ X):.4e}")

def coef_and_se(d):
    yy = np.array(d.Sales).reshape(-1, 1)
    nn = len(yy)
    XX = np.concatenate((np.ones((nn, 1)), np.array(d.iloc[:, :-1])), axis=1)
    bb, ss, VV = fit_ols(XX, yy)
    return bb.ravel(), ss * np.sqrt(np.diag(VV))

b_tr, se_tr = coef_and_se(training_data)
b_all, se_all = coef_and_se(data)
rng = np.random.RandomState(0)
b_rnd, se_rnd = coef_and_se(data.iloc[rng.permutation(len(data))[:140]])
print("앞 70%    :", b_tr.round(4), " SE", se_tr.round(4))
print("전체 200행 :", b_all.round(4), " SE", se_all.round(4))
print("무작위 70% :", b_rnd.round(4), " SE", se_rnd.round(4))
print(f"Newspaper 의 t: 앞70% {b_tr[3] / se_tr[3]:.3f},  "
      f"전체 {b_all[3] / se_all[3]:.3f},  무작위70% {b_rnd[3] / se_rnd[3]:.3f}")
출력:
계수   최대 차이 = 4.396e-14
표준오차 최대 차이 = 6.661e-16
t      최대 차이 = 1.252e-13
p 값   최대 차이 = 1.410e-14
X'X 의 조건수 = 2.0924e+05
앞 70%    : [ 3.0451e+00  4.7000e-02  1.7970e-01 -3.0000e-03]  SE [0.3913 0.0017 0.0108 0.007 ]
전체 200행 : [ 2.9389e+00  4.5800e-02  1.8850e-01 -1.0000e-03]  SE [0.3119 0.0014 0.0086 0.0059]
무작위 70% : [ 2.9924e+00  4.7700e-02  1.7650e-01 -2.7000e-03]  SE [0.3595 0.0017 0.0107 0.0068]
Newspaper 의 t: 앞70% -0.428,  전체 -0.177,  무작위70% -0.399
(1) 열세 자리까지 같다. 계수의 최대 차이가 \(4.4 \times 10^{-14}\), 표준오차가 \(6.7 \times 10^{-16}\), \(t\) 가 \(1.3 \times 10^{-13}\), \(p\) 값이 \(1.4 \times 10^{-14}\) 다. 유도한 대로 반올림 한계이고, 조건수 \(2.1 \times 10^5\) 에 비추어 기대한 수준이다. 손으로 만든 표가 statsmodels 의 표와 같은 수임이 확인되었다.
(2) 앞 70% 는 이 자료에서 무해하다. 세 적합의 계수를 견주면
| Intercept | TV | Radio | Newspaper | |
|---|---|---|---|---|
| 앞 \(70\%\) | \(3.0451\) | \(0.0470\) | \(0.1797\) | \(-0.0030\) |
| 전체 \(200\) | \(2.9389\) | \(0.0458\) | \(0.1885\) | \(-0.0010\) |
| 무작위 \(70\%\) | \(2.9924\) | \(0.0477\) | \(0.1765\) | \(-0.0027\) |
로 모두 비슷하다. 앞 \(70\%\) 의 TV 계수 \(0.0470\) 이 무작위 \(70\%\) 의 \(0.0477\) 과 표준오차 \(0.0017\) 의 절반 안에 있고, 전체 자료의 \(0.0458\) 과도 표준오차 하나 안에 있다. 순서에 뜻이 없다는 증거다.
표준오차는 자료가 많은 쪽이 작다. 전체 \(200\) 행의 표준오차가 앞 \(140\) 행의 대략 \(\sqrt{140/200} = 0.837\) 배인데, TV 에서 \(0.0014\) 대 \(0.0017\) 로 \(0.82\) 배이니 거의 맞는다.
Newspaper 의 \(t\) 값은 세 경우에 \(-0.428\), \(-0.177\), \(-0.399\) 로 모두 \(0\) 근처다. 어느 표본을 쓰든 신문 광고의 효과를 가려낼 수 없다는 결론이 흔들리지 않는다. 표본을 바꿔도 결론이 같다는 것이 가장 든든한 확인이다.
그래도 원칙은 남는다. 자료를 떼어 낼 때는 섞어서 떼라. 이 자료가 괜찮았던 것은 운이고, 확인하는 데 코드 세 줄이 들었을 뿐이다.
이 값들은 statsmodels의 sm.OLS(y, X).fit().summary()가 내놓는 계수표와 정확히 일치한다.
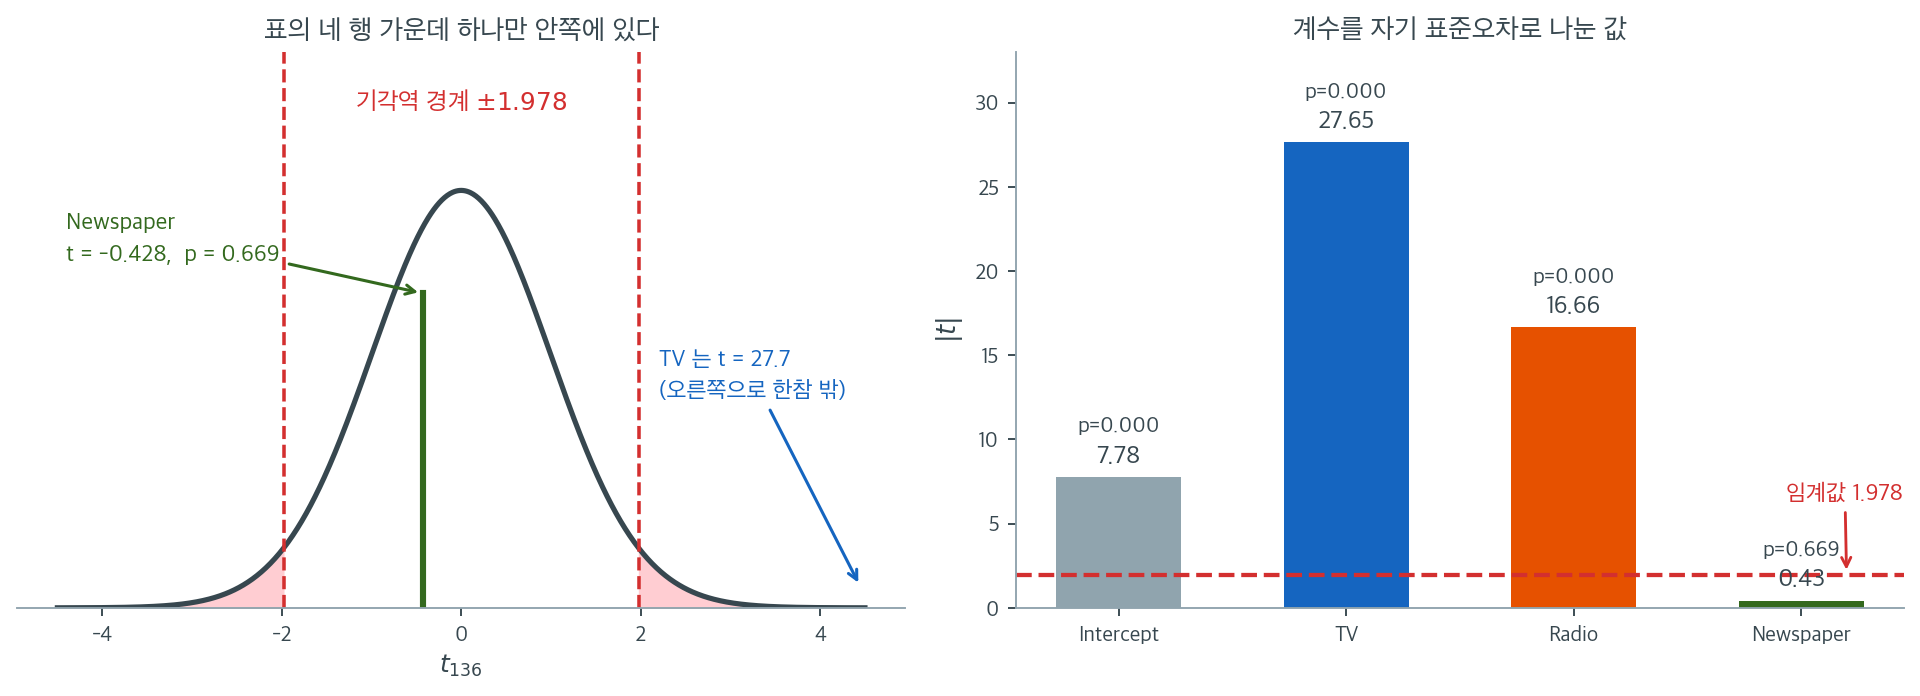
표를 수로만 읽으면 네 행이 다 비슷해 보인다. 그림으로 옮기면 한 행만 성격이 다르다는 것이 즉시 보인다. 왼쪽은 \(H_0\colon \beta_j = 0\)이 참일 때 \(t\)가 따르는 분포 \(t_{136}\)(\(=t_{n-k}\), \(n = 140\), \(k = 4\))이고, 붉게 칠한 양쪽 꼬리가 유의수준 5%의 기각역(rejection region)이다. 그 경계가 \(\pm 1.978\)이다. 네 행의 \(t\) 값 가운데 Newspaper만 \(-0.428\)로 분포의 한복판에 앉아 있다. 나머지 셋은 \(7.78\), \(27.65\), \(16.67\)로 화면 밖 아주 먼 곳에 있어 아예 그릴 수조차 없다.
오른쪽 막대가 네 \(|t|\)를 나란히 놓은 것이다. TV의 \(27.65\)는 임계값의 열네 배에 이른다. 여기서 표를 읽는 요령이 하나 나온다. 계수 크기 자체는 유의성과 아무 상관이 없다는 것이다. TV의 계수는 \(0.0470\)으로 Radio의 \(0.1797\)보다 네 배 작지만, 표준오차가 \(0.002\) 대 \(0.011\)로 훨씬 더 작아 \(t\)는 오히려 더 크다. 표준오차로 나누기 전의 계수를 서로 견주는 것은 단위가 다른 자를 견주는 일이다.
Newspaper 행은 \(p = 0.669\)이고 95% 신뢰구간이 \((-0.0169,\ 0.0109)\)로 \(0\)을 넉넉히 품는다. 이 구간이 \(p\) 값보다 훨씬 많은 것을 말해 준다. 신문 광고비 1천 달러당 매출 효과는 \(-0.017\)에서 \(0.011\) 사이 어딘가이며, 부호조차 정하지 못했다는 뜻이다. 대조적으로 TV의 구간은 \((0.0437,\ 0.0504)\)으로 아주 좁다. 효과가 있다는 것뿐 아니라 그 크기가 \(0.044\)와 \(0.050\) 사이라고 못 박는다. "유의하다/아니다"라는 두 글자보다 이 범위가 의사결정에 훨씬 쓸모 있다.
2. 표의 한 줄을 어떻게 읽는가
- 회귀표의 각 행은 설명변수 하나에 대응한다. 계수 추정값 \(\hat{\beta}_j\)는 다른 설명변수를 고정했을 때 그 설명변수가 한 단위 늘어날 때 기대되는 Sales의 변화를 준다.
- 표준오차는 각 추정의 정밀도를 수량화한다. SE가 작을수록 정밀한 추정이다.
- \(t\) 통계량은 계수가 0에서 표준오차 몇 개만큼 떨어져 있는지를 잰다. 절댓값이 크면 통계적 유의성을 나타낸다.
- \(p\) 값은 \(H_0\colon \beta_j = 0\) 아래에서 적어도 그만큼 극단적인 \(t\) 통계량을 관측할 확률이다. 0.05 미만이면 관행적으로 유의하다고 본다.
- 95% 신뢰구간은 참 계수가 취할 만한 값의 범위를 준다. 0을 배제하면 그 설명변수는 유의수준 5%에서 유의하다.
그림으로 보는 통계학 1. 표가 다섯째 자리까지 같을 때 — 포브스의 열일곱 점
위의 다섯 줄은 표를 읽는 법이다. 표에 없는 것은 읽을 수 없다는 것이 이 상자의 이야기다.
\(1857\) 년, 에든버러 대학의 자연철학 교수 제임스 D. 포브스가 「끓는점으로 높이를 재는 일에 관한 추가 실험과 소견」을 왕립 에든버러 학회지에 실었다. 산에서 기압계는 깨지기 쉽고 무거웠으므로, 물을 끓여 그 온도로 기압을 — 따라서 고도를 — 대신 재려던 것이다. 그가 알프스의 \(17\) 곳에서 끓는점(화씨)과 기압(수은주 인치)을 짝지어 적은 표가 지금도 R 의 MASS::forbes 로 전해진다.
그 열일곱 점에 직선을 긋고 이 쪽에서 만든 회귀표를 뽑아 보자. 결정계수(coefficient of determination)가 \(R^2 = 0.99443\) 이다. 이제 기압 대신 \(100\log_{10}(\text{기압})\) 을 반응으로 놓고 같은 일을 하면 \(R^2 = 0.99496\) 이다. 두 모형은 다섯째 자리에서 갈린다. 계수의 \(t\) 도, \(p\) 값도, 신뢰구간도 양쪽 다 압도적으로 유의하다. 표를 아무리 들여다보아도 어느 쪽이 옳은 척도인지 알 수 없다.
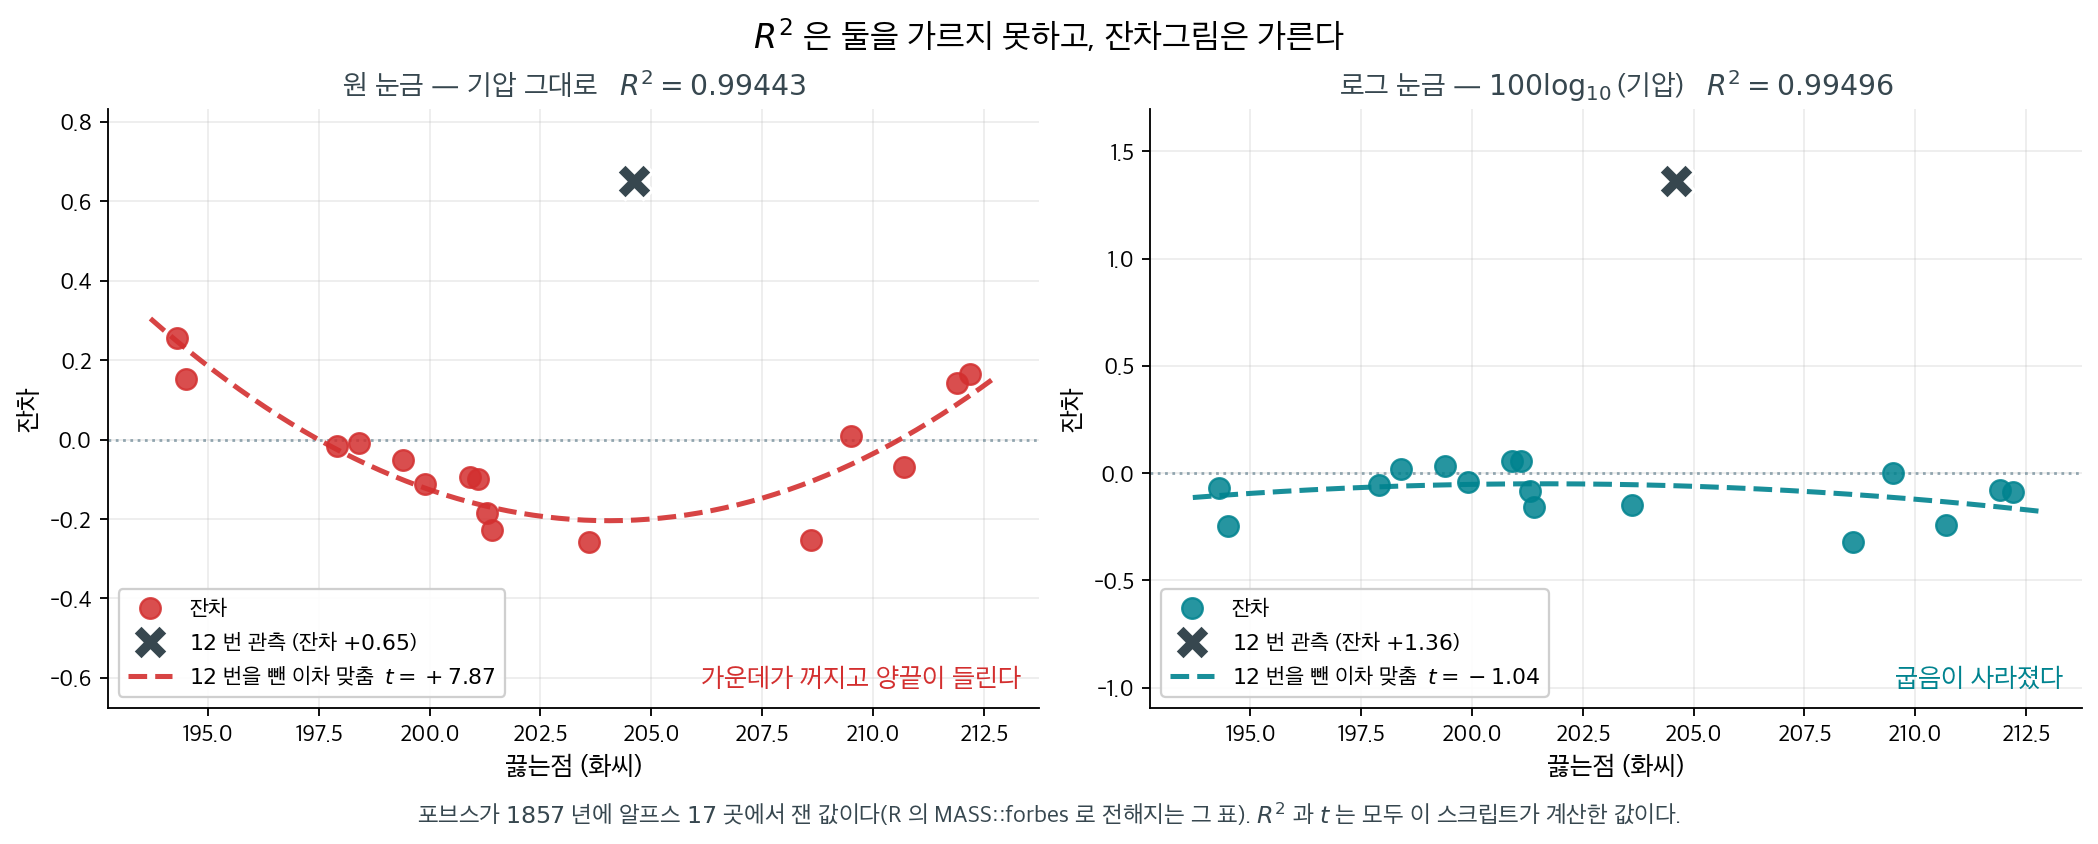
잔차를 그리면 \(1\) 초면 갈린다. 왼쪽, 기압을 그대로 쓴 쪽은 가운데가 꺼지고 양 끝이 들린 그릇 모양이다. 직선이 잡지 못한 굽음이 그대로 남아 있다는 뜻이다. 오른쪽, 로그로 바꾼 쪽은 \(0\) 둘레에 평평하다. 물리학이 말하는 것도 로그 쪽이다 — 증기압은 온도에 지수적으로 자라므로 직선이 되는 것은 기압이 아니라 그 로그다.
굽음에 수를 붙이려면 잔차를 끓는점의 이차식에 맞춰 이차항의 \(t\) 를 보면 된다.
| 척도 | \(R^2\) | 굽음의 \(t\) (\(12\) 번 빼고) | \(p\) |
|---|---|---|---|
| 기압 그대로 | \(0.99443\) | \(+7.87\) | \(< 0.0001\) |
| \(100\log_{10}\)(기압) | \(0.99496\) | \(-1.04\) | \(0.318\) |
여기에 함정이 하나 더 있다. 위 표의 \(t\) 는 \(12\) 번 관측을 빼고 잰 것이다. 그 점을 그대로 둔 채 같은 검정을 하면 기압 쪽의 \(t\) 가 \(+7.87\) 에서 \(+1.55\) (\(p = 0.143\)) 로 내려앉는다. 굽음이 유의하지 않다는 결론이 나온다. 까닭은 그림의 \(\times\) 표다. 그 점의 잔차는 \(+0.650\) 으로, 나머지 열여섯 점의 최대 절댓값 \(0.257\) 의 두 배 반이다. 이상치(outlier) 하나가 \(s\) 를 키워 제 분모로 굽음을 지운다. 포브스의 실험 노트에 무슨 일이 있었는지는 알 수 없다.
그래서 이 쪽이 만든 표에는 두 줄을 덧붙여야 한다. 표가 좋아 보이는 것과 모형이 맞는 것은 다른 일이다. 그리고 잔차를 보기 전에는 굽음 검정도 믿을 수 없다. 13.6절 가정 점검이 이 두 줄을 이어받는다.
확인한 곳 — 포브스의 논문 서지(「XIV.—Further Experiments and Remarks on the Measurement of Heights by the Boiling Point of Water」, James D. Forbes, Professor of Natural Philosophy in the University of Edinburgh, Transactions of the Royal Society of Edinburgh \(21\)(\(2\)), \(1857\), \(235\)–\(243\))와 그 초록이 밝힌 목적(「끓는점으로 높이를 재는 더 쓸 만한 장치와 계산식」)은 Cambridge Core 의 서지 항목에서 읽었다. 논문 본문은 읽지 못했다 · 관측이 \(17\) 개이고 알프스에서 잰 것이며 bp 가 화씨 끓는점, pres 가 수은주 인치 기압이라는 것, 그리고 \(100\log_{10}(\text{pres})\) 가 alr4 에 lpres 라는 열로 함께 실린다는 것은 MASS::forbes 와 alr4::Forbes 의 설명 문서에서 읽었다 · \(R^2\), 이차항의 \(t\) 와 \(p\), 잔차는 모두 그 열일곱 쌍으로 직접 계산한 값이다
연습문제
연습문제 1. \(\hat{\boldsymbol{\beta}} = (\mathbf{X}^\top \mathbf{X})^{-1}\mathbf{X}^\top \mathbf{y}\)가 정규방정식 \(\mathbf{X}^\top \mathbf{X}\hat{\boldsymbol{\beta}} = \mathbf{X}^\top \mathbf{y}\)를 만족함을 수치적으로 확인하라.
풀이
lhs = X.T @ X @ beta_hat
rhs = X.T @ y
print(np.allclose(lhs, rhs))  # True
출력:
True
True가 나온다. 적합된 계수가 정규방정식 \(\mathbf X^\top\mathbf X\hat{\boldsymbol\beta} = \mathbf X^\top\mathbf y\) 를 정확히 푼다는 확인이다.
구성상 \(\hat{\boldsymbol{\beta}} = (\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\mathbf{y}\)의 양변에 왼쪽에서 \(\mathbf{X}^\top\mathbf{X}\)를 곱하면 \(\mathbf{X}^\top\mathbf{X}\hat{\boldsymbol{\beta}} = \mathbf{X}^\top\mathbf{y}\)가 된다. \(\square\)
연습문제 2. 잔차에서 \(R^2\)와 수정 \(R^2\)(adjusted \(R^2\))를 계산하라. \(R^2 = 1 - \mathrm{RSS}/\mathrm{TSS}\)임을 보여라.
풀이
y_hat = X @ beta_hat
RSS = np.sum((y - y_hat) ** 2)
TSS = np.sum((y - y.mean()) ** 2)
R2 = 1 - RSS / TSS
adj_R2 = 1 - (1 - R2) * (n - 1) / (n - k)
print(f"R^2 = {R2:.4f}, Adjusted R^2 = {adj_R2:.4f}")
출력:
R^2 = 0.8937, Adjusted R^2 = 0.8914
\(R^2 = 0.894\), 수정 \(R^2 = 0.891\)이다. 수정 \(R^2\)가 조금 작은 것은 설명변수 개수에 대한 벌점 때문이며, 변수를 늘려도 적합이 그만큼 좋아지지 않으면 수정 \(R^2\)는 오히려 떨어진다.
이 자료에서는 \(R^2 = 0.8937\), 수정 \(R^2 = 0.8914\)가 나온다.
정의에 따라 \(\mathrm{TSS} = \sum(y_i - \bar{y})^2\), \(\mathrm{RSS} = \sum(y_i - \hat{y}_i)^2\)이고 \(R^2 = 1 - \mathrm{RSS}/\mathrm{TSS}\)는 모형이 설명하는 분산의 비율을 잰다. 수정 \(R^2\)는 \(1 - \frac{n-1}{n-k}(1 - R^2)\)로 설명변수의 개수에 벌점을 준다. \(\square\)
연습문제 3. \(s^2\)의 분모로 \(n\) 대신 \(n - k\)를 쓰면 왜 \(\sigma^2\)의 불편추정량(unbiased estimator)이 되는지 설명하라.
풀이
잔차벡터는 \(\mathbf{e} = \mathbf{M}\mathbf{y}\)이며 \(\mathbf{M} = \mathbf{I} - \mathbf{X}(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\)이다. 모형 아래에서 \(\mathbf{e} = \mathbf{M}\boldsymbol{\varepsilon}\)이므로
\(\mathbf{M}\)이 멱등이고 \(\operatorname{tr}(\mathbf{M}) = n - k\)이기 때문이다. \(n - k\)로 나누면 \(E[s^2] = \sigma^2\)을 얻는다. \(\square\)
연습문제 4. \(\mathbf{X}^\top\mathbf{X}\)를 명시적으로 역행렬 계산하는 대신 numpy.linalg.lstsq로 회귀표를 다시 계산하라. lstsq가 수치적으로 선호되는 이유를 논하라.
풀이
beta_lstsq, residuals, rank, sv = np.linalg.lstsq(X, y, rcond=None)
lstsq는 SVD 를 쓰는데, 이는 \((\mathbf{X}^\top\mathbf{X})^{-1}\)을 명시적으로 계산하는 것보다 수치적으로 안정적이다. \(\mathbf{X}^\top\mathbf{X}\)의 조건이 나쁘면(거의 특이행렬이면) 직접 역행렬을 구하는 것은 부동소수점 오차를 증폭시키지만, SVD는 거의 공선인 상황을 매끄럽게 처리한다. 조건이 좋은 문제에서는 두 결과가 기계 정밀도 수준으로 일치한다. \(\square\)
연습문제 5. \(j\)번째 계수의 \(t\) 통계량을 \(t_j = \hat{\beta}_j \sqrt{[(\mathbf{X}^\top\mathbf{X})]_{jj}} / s\)로 쓸 수 있는 것은 설명변수들이 직교할 때뿐임을 증명하라. 일반적으로는 어떻게 되는가?
풀이
설명변수들이 직교하면 \(\mathbf{X}^\top\mathbf{X}\)가 대각행렬이므로 \([(\mathbf{X}^\top\mathbf{X})^{-1}]_{jj} = 1/[(\mathbf{X}^\top\mathbf{X})]_{jj}\)이다. 이때
일반적으로 \((\mathbf{X}^\top\mathbf{X})^{-1}\)은 대각원소의 역수가 아니다. \(\mathbf{X}^\top\mathbf{X}\)의 비대각원소(설명변수 사이의 상관)가 역행렬의 대각원소를 부풀리기 때문이다. 이 팽창을 재는 것이 분산팽창인자(VIF)이다. \(\square\)
연습문제 6. 보기 3 의 표에서 TV 행은 계수 \(0.0470\), 표준오차 \(0.001701\), \(t = 27.6535\) 였다. TV 열은 광고비를 $1,000 단위로 적은 것이다. 단위를 $1,000 에서 $1,000/c 로 바꾸면 설계행렬의 TV 열이 \(c\) 배가 된다.
(1) \(\mathbf D\) 를 \(j\) 번째 대각원소만 \(c\) 이고 나머지는 \(1\) 인 대각행렬이라 하고 \(\tilde{\mathbf X} = \mathbf X\mathbf D\) 로 두자. \(\hat\beta_j\), \(\mathrm{SE}(\hat\beta_j)\), \(t_j\), \(p\) 값, 신뢰구간, \(s\), \(R^2\) 가 각각 어떻게 바뀌는지 유도하시오.
(2) 보기 2 의 서식 coef={coef:.4f} SE={se:.3f} 는 \(c\) 가 커지면 TV 행을 무의미하게 만든다. 표준오차가 0.000 으로 찍히기 시작하는 \(c\) 와 계수가 0.0000 으로 찍히기 시작하는 \(c\) 를 각각 구하시오.
풀이
(1) 척도는 계수와 표준오차만 움직인다. \(\tilde{\mathbf X} = \mathbf X\mathbf D\) 이므로 \(\tilde{\mathbf X}^\top\tilde{\mathbf X} = \mathbf D\mathbf X^\top\mathbf X\mathbf D\) 이고, \(\mathbf D\) 가 대각이라 \(\mathbf D^\top = \mathbf D\) 임을 썼다. 그러므로
로 \(\tilde\beta_j = \hat\beta_j/c\) 이고 나머지 계수는 그대로다. 적합값은
로 한 치도 움직이지 않는다. 잔차가 같으니 \(\mathrm{RSS}\), \(s\), \(R^2\), 수정 \(R^2\) 가 모두 불변이다. 역행렬 쪽은
이므로 \(\mathrm{SE}(\tilde\beta_j) = \mathrm{SE}(\hat\beta_j)/c\) 다. 계수와 표준오차가 같은 \(1/c\) 배로 줄므로
로 \(t\) 는 불변이고, 자유도도 \(n-k\) 그대로이니 \(p\) 값도 불변이다. 신뢰구간은 양 끝이 \(1/c\) 배 되어 폭만 줄어든다. TV 를 $250 단위로 적으면(\(c = 4\)) 계수가 \(0.0470487/4 = 0.0117622\), 표준오차가 \(0.00170137/4 = 0.00042534\) 이고 \(t\) 는 \(27.6535\) 그대로다.
(2) 표준오차는 \(c > 3.40\) 에서, 계수는 \(c > 941\) 에서 무너진다. :.3f 가 0.000 을 찍는 것은 값이 \(0.0005\) 미만일 때다.
곧 단위를 $1,000 에서 $250 로 바꾸는 것만으로 표준오차 칸이 비어 버린다. :.4f 가 0.0000 을 찍는 것은 값이 \(0.00005\) 미만일 때이므로
이다. 광고비를 달러 단위로 적으면(\(c = 1000\)) TV 행은 coef=0.0000 SE=0.000 t=27.653 이 된다. 척도에 딸린 두 수는 사라지고 척도에 불변인 \(t\) 만 살아남는다. 보기 2 (2) 에서 본 서식 결함의 극단이며, 고치는 길도 같다. 유효숫자 서식 :.3g 를 쓰는 것이다.
덧붙여 수치 안정성은 척도에 불변이 아니다. \(c = 1000\) 이면 \(\operatorname{cond}(\mathbf X^\top\mathbf X)\) 가 보기 1 의 \(2.09 \times 10^5\) 에서 \(2.00 \times 10^{11}\) 로 \(10^6\) 배 나빠진다. 다만 실제로 잃는 자리는 하나뿐이다(inv 와 lstsq 의 상대차가 \(3.4 \times 10^{-14}\) 에서 \(4.5 \times 10^{-13}\) 으로). 조건수는 상한이므로 나빠진 조건수가 곧 나빠진 답은 아니다.
연습문제 7. 연습문제 2 는 \(R^2 = 0.893710\), 수정 \(R^2 = 0.891366\) 을 얻었고 보기 2 는 Newspaper 의 \(t = -0.4285\) 를 얻었다. Newspaper 를 뺀 세 변수 모형을 적합하여 \(\mathrm{RSS}\), \(R^2\), 수정 \(R^2\), \(s\) 를 네 변수 모형과 견주시오.
그리고 다음 두 항등식이 소수 여덟째 자리까지 맞는지 확인하시오(\(j\) 는 뺀 변수, \(t_j\) 는 네 변수 모형에서의 값).
풀이
X3 = X[:, :3]                      # Newspaper 열을 버린다
b3, s3, V3 = fit_ols(X3, y)

TSS = np.sum((y - y.mean()) ** 2)
RSS_full = np.sum((y - X @ beta_hat) ** 2)
RSS_red = np.sum((y - X3 @ b3) ** 2)


def r2_pair(RSS, kk):
    R2 = 1 - RSS / TSS
    return R2, 1 - (1 - R2) * (n - 1) / (n - kk)


R2_f, adj_f = r2_pair(RSS_full, 4)
R2_r, adj_r = r2_pair(RSS_red, 3)
print(f"4 변수: RSS={RSS_full:.4f}  R^2={R2_f:.6f}  수정R^2={adj_f:.6f}  s={s:.6f}")
print(f"3 변수: RSS={RSS_red:.4f}  R^2={R2_r:.6f}  수정R^2={adj_r:.6f}  s={s3:.6f}")

t_np = beta_hat[3, 0] / (s * np.sqrt(cov_matrix[3, 3]))
print(f"Newspaper 의 t = {t_np:.4f},  t^2 = {t_np ** 2:.4f}")
print(f"RSS 비     : 실제 {RSS_red / RSS_full:.8f},  1+t^2/(n-k) = {1 + t_np ** 2 / (n - k):.8f}")
print(f"R^2 감소량 : 실제 {R2_f - R2_r:.6e},  (1-R^2)t^2/(n-k) = {(1 - R2_f) * t_np ** 2 / (n - k):.6e}")
print(f"s^2 의 비  : 실제 {(s3 / s) ** 2:.8f},  (n-k+t^2)/(n-k+1) = {(n - k + t_np ** 2) / (n - k + 1):.8f}")
print(f"수정 R^2 는 {adj_f:.6f} -> {adj_r:.6f} 로 {'올랐다' if adj_r > adj_f else '내렸다'}")

print("남은 세 계수  4 변수:", beta_hat.ravel()[:3].round(6))
print("              3 변수:", b3.ravel().round(6))
print("남은 표준오차 4 변수:", (s * np.sqrt(np.diag(cov_matrix)))[:3].round(6))
print("              3 변수:", (s3 * np.sqrt(np.diag(V3))).round(6))
출력:
4 변수: RSS=410.1052  R^2=0.893710  수정R^2=0.891366  s=1.736514
3 변수: RSS=410.6588  R^2=0.893567  수정R^2=0.892013  s=1.731332
Newspaper 의 t = -0.4285,  t^2 = 0.1836
RSS 비     : 실제 1.00134994,  1+t^2/(n-k) = 1.00134994
R^2 감소량 : 실제 1.434851e-04,  (1-R^2)t^2/(n-k) = 1.434851e-04
s^2 의 비  : 실제 0.99404082,  (n-k+t^2)/(n-k+1) = 0.99404082
수정 R^2 는 0.891366 -> 0.892013 로 올랐다
남은 세 계수  4 변수: [3.045142 0.047049 0.179683]
              3 변수: [2.988088 0.047058 0.177991]
남은 표준오차 4 변수: [0.39131  0.001701 0.010782]
              3 변수: [0.36686  0.001696 0.010003]
두 항등식이 소수 여덟째 자리까지 맞는다. \(\mathrm{RSS}\) 비가 양쪽 모두 \(1.00134994\) 이고 \(s^2\) 비가 양쪽 모두 \(0.99404082\) 다. 첫 항등식은 \(t_j^2\) 가 자유도 \((1,\,n-k)\) 의 \(F\) 통계량과 같다는 사실의 다른 표현이고, 둘째는 첫째를 \(n-k\) 와 \(n-k+1\) 로 나눈 것이다.
\(R^2\) 는 내려가고 수정 \(R^2\) 는 올라간다. \(R^2\) 는 \(0.893710 \to 0.893567\) 로 \(1.43 \times 10^{-4}\) 만큼 내려갔다. 열을 버리면 최소화하는 범위가 좁아지므로 \(\mathrm{RSS}\) 는 반드시 늘고 \(R^2\) 는 반드시 준다. 반면 수정 \(R^2\) 는 \(0.891366 \to 0.892013\) 로 올랐다. 잔차 표준오차도 \(1.736514 \to 1.731332\) 로 작아졌다. 왜 하필 올라갔는지는 연습문제 8 에서 가른다.
남은 계수가 거의 움직이지 않는 것도 눈여겨볼 만하다. TV 는 \(0.047049 \to 0.047058\) 로 표준오차 \(0.0017\) 의 \(180\) 분의 \(1\) 만큼, Radio 는 \(0.179683 \to 0.177991\) 로 표준오차 \(0.0108\) 의 \(6\) 분의 \(1\) 만큼 움직였다. Newspaper 가 다른 두 변수와 거의 직교하기 때문이며, 그래서 Radio 의 표준오차가 \(0.010782 \to 0.010003\) 로 조금 줄기까지 한다. 공선성이 심한 변수를 뺄 때는 남은 계수가 크게 뛰므로, 이 안정성 자체가 "빼도 된다" 는 또 하나의 신호다.
연습문제 8. 연습문제 7 에서 \(R^2\) 는 내려갔는데 수정 \(R^2\) 는 올라갔다. 일반적으로 설계행렬에서 열 하나를 빼면 수정 \(R^2\) 가 올라가는 것은 \(\lvert t_j \rvert < 1\) 일 때뿐임을 증명하시오. 연습문제 7 의 항등식 \(\mathrm{RSS}_{-j} = \mathrm{RSS}\,(1 + t_j^2/(n-k))\) 는 써도 된다.
그리고 이 기준을 \(p < 0.05\) 의 기준 \(\lvert t_j \rvert > 1.977561\) 과 견주고, 보기 2 의 네 행이 두 경계 가운데 어디에 놓이는지 말하시오.
풀이
수정 \(R^2\) 는 \(s^2\) 의 거울이다. 정의를 풀어 쓰면
이다. 열을 빼도 \(\mathbf y\) 는 그대로이므로 \(\mathrm{TSS}\) 와 \(n\) 이 변하지 않는다. 그러므로
로, 수정 \(R^2\) 가 오르는 것은 잔차분산 추정값이 줄어드는 것과 같다. 수정 \(R^2\) 를 쓰는 까닭이 바로 이것이다.
이제 두 \(s^2\) 를 견준다. 줄어든 모형의 모수는 \(k-1\) 개이므로 자유도가 \(n-k+1\) 이고
이다. 비를 만들면 \(\mathrm{RSS}\) 가 약분되어
를 얻는다. 분자와 분모를 견주면
이다. \(n\) 과 \(k\) 가 약분되어 경계가 표본크기와 무관한 \(\lvert t_j \rvert = 1\) 하나로 떨어지는 것이 요점이다. \(\square\)
Newspaper 로 확인하면 \(n-k = 136\), \(t_j^2 = 0.1836\) 이므로 비가 \(136.1836/137 = 0.9940408\) 이고, 연습문제 7 의 출력 \(0.99404082\) 와 소수 여덟째 자리까지 같다. \(\lvert t_j \rvert = 0.4285 < 1\) 이니 수정 \(R^2\) 가 오를 수밖에 없었다.
두 경계가 다르다는 것이 이 문제의 핵심이다. \(t_{136}\) 에서 \(\lvert t \rvert = 1\) 은 양측 \(p = 0.3191\) 에 해당한다. 그러므로 변수를 지키라는 수정 \(R^2\) 의 기준은 \(p < 0.3191\) 이고, 유의성의 기준은 \(p < 0.05\) 다. 보기 2 의 네 행은 \(\lvert t \rvert = 7.7819,\ 27.6535,\ 16.6646,\ 0.4285\) 로 셋은 \(1.977561\) 바깥, Newspaper 만 \(1\) 안쪽이어서 두 기준이 같은 답을 준다.
그러나 \(1 < \lvert t_j \rvert < 1.977561\) 에 놓인 변수는 두 기준이 엇갈린다. 예컨대 \(\lvert t_j \rvert = 1.5\) 라면 \(p = 0.1359\) 로 유의하지 않은데, 그것을 빼면 수정 \(R^2\) 는 떨어진다. 불일치가 아니라 다른 질문에 답하고 있는 것이다. \(p\) 값은 "계수가 \(0\) 이라고 말할 수 있는가" 를 묻고 수정 \(R^2\) 는 "이 열이 예측오차를 줄이는가" 를 묻는다. 유의하지 않은 변수를 기계적으로 버리면 수정 \(R^2\) 가 나빠지는 일이 흔한 까닭이다.
연습문제 9. 보기 2 에서 Newspaper 의 95% 신뢰구간은 \((-0.0169,\ 0.0109)\) 였다. 반폭이 \(t^*\,\mathrm{SE} = 1.977561 \times 0.00701454 = 0.0138717\) 이다. "신문 광고의 효과는 계수 척도로 \(\pm 0.005\) 안에 있다" 고 못 박으려면 — 곧 반폭을 \(0.005\) 로 줄이려면 — 같은 성질의 시장을 몇 곳 모아야 하는가?
\(\mathrm{SE} \propto 1/\sqrt{n}\) 을 쓰되, \(t^*\) 가 자유도에 따라 변하는 것까지 넣어 두 걸음으로 답하시오. 그리고 \(p\) 값 \(0.669\) 를 더 키우는 것으로는 이 결론에 다가갈 수 없는 까닭을 말하시오.
풀이
첫 걸음: \(t^*\) 를 붙잡아 둔다. 설명변수의 산포가 그대로라면 \(\mathrm{SE}\) 는 \(n^{-1/2}\) 로 줄어든다.
\(t^*\) 를 \(1.977561\) 로 고정하고 반폭을 \(0.005\) 로 두면
로 약 \(1{,}078\) 곳이다.
두 걸음: \(t^*\) 가 작아지는 것을 되먹인다. 자유도가 \(136\) 에서 \(1{,}074\) 로 커지면 \(t^*\) 가 \(1.977561\) 에서 \(1.9622\) 로 내려간다. 그러면 필요한 표준오차가
로 조금 느슨해지므로
곧 \(n = 1{,}061\) 이면 된다. 확인하면 \(\mathrm{SE} = 0.00701454\sqrt{140/1061} = 0.0025480\), \(t^*_{1057} = 1.96221\), 반폭 \(= 0.0049998 < 0.005\) 다. 답은 약 \(1{,}060\) 곳으로, 지금 자료의 \(7.6\) 배다.
두 걸음의 답이 \(1{,}078\) 과 \(1{,}061\) 로 \(1.6\%\) 밖에 다르지 않다. \(t^*\) 의 되먹임은 작은 손질일 뿐이고, 자료량을 지배하는 것은 \(\sqrt{n}\) 이라는 느린 속도다. 반폭을 \(2.77\) 배 줄이려고 자료를 \(7.7\) 배 모아야 한다. 정밀도를 한 자리 올리려면 자료가 백 배 든다는 뜻이다.
\(p\) 값으로는 갈 수 없다. \(p = 0.669\) 는 "\(\beta_{\text{News}} = 0\) 이라는 가설이 자료와 어긋나지 않는다" 만 말한다. 더구나 \(H_0\) 가 참이면 \(p\) 값은 \(n\) 과 무관하게 \((0,1)\) 에서 균등분포이므로, 시장을 \(1{,}061\) 곳으로 늘려도 \(p\) 가 \(0.669\) 에서 \(0.99\) 쪽으로 커지지 않는다. 큰 \(p\) 값은 증거가 없다는 뜻이고 효과가 없다는 뜻이 아니다.
할 수 있는 말은 "효과가 \(0\) 이다" 가 아니라 "효과가 \(\pm 0.005\) 보다 작다" 이고, 그 말을 만드는 것은 오직 신뢰구간의 폭이다. 보기 2 의 풀이가 "후자가 효과가 없다는 결론에 다가가는 유일한 길" 이라 한 것을 수로 옮기면 이렇게 된다. 미리 "얼마보다 작으면 없는 것으로 보겠다" 를 정하고, 그 폭을 얻을 \(n\) 을 설계 단계에서 셈해 두어야 한다.
연습문제 10. 보기 1 은 \(\operatorname{cond}(\mathbf X^\top\mathbf X) = \operatorname{cond}(\mathbf X)^2 = 2.09 \times 10^5\) 를 보이고 "공선성이 심한 자료에서는 이 제곱이 치명적" 이라 했고, 연습문제 4 는 lstsq 가 안전하다고만 했다. 수로 확인하시오.
네 번째 열(Newspaper)을 \(\mathbf x_{\text{TV}} + \delta\mathbf z\) 로 바꾸고(\(\mathbf z\) 는 한 번 뽑아 고정한 표준정규 벡터) \(\delta\) 를 \(10^{-1}\) 에서 \(10^{-7}\) 까지 줄여 가며
(1) \(\operatorname{cond}(\mathbf X^\top\mathbf X)\), inv 해와 lstsq 해의 최대 차이, 두 해의 \(s\) 를 재어 inv 가 무너지기 시작하는 조건수를 찾으시오.
(2) lstsq 해에서 TV 계수와 네 번째 계수의 합을 보시오. 개별 계수를 못 믿게 되었는데 그 합은 왜 멀쩡한지 설명하고, \(\mathrm{SE}(\hat\beta_{\text{TV}})\) 가 어떻게 되는지 연습문제 5 의 VIF 와 이어 말하시오.
풀이
rng = np.random.default_rng(0)
z = rng.standard_normal((n, 1))        # 한 번만 뽑아 모든 delta 에 돌려 쓴다

print("  delta   cond(X'X)   |b_inv-b_lstsq|      s(inv)   s(lstsq)"
      "          b_TV  b_TV+b_4    SE(TV)")
for delta in [1e-1, 1e-3, 1e-5, 1e-7]:
    Xc = X.copy()
    Xc[:, 3:4] = X[:, 1:2] + delta * z   # 네 번째 열을 TV 로 밀어 붙인다
    b_inv = np.linalg.inv(Xc.T @ Xc) @ Xc.T @ y
    b_ls = np.linalg.lstsq(Xc, y, rcond=None)[0]
    s_inv = np.sqrt(np.sum((y - Xc @ b_inv) ** 2) / (n - k))
    s_ls = np.sqrt(np.sum((y - Xc @ b_ls) ** 2) / (n - k))
    se_tv = s_ls * np.sqrt(np.abs(np.linalg.inv(Xc.T @ Xc)[1, 1]))
    print(f"{delta:7.0e}  {np.linalg.cond(Xc.T @ Xc):.2e}  "
          f"{np.abs(b_inv - b_ls).max():15.1e}  {s_inv:10.4g} {s_ls:10.4f}  "
          f"{b_ls[1, 0]:14.4f}  {b_ls[1, 0] + b_ls[3, 0]:8.4f}  {se_tv:.2e}")
출력:
  delta   cond(X'X)   |b_inv-b_lstsq|      s(inv)   s(lstsq)          b_TV  b_TV+b_4    SE(TV)
  1e-01  1.22e+07          1.2e-08       1.738     1.7377         -0.0110    0.0471  1.52e+00
  1e-03  1.22e+11          1.7e-04       1.738     1.7377         -5.7544    0.0471  1.52e+02
  1e-05  1.11e+15          4.9e+01       1.773     1.7377       -580.1023    0.0471  1.45e+04
  1e-07  2.60e+18          5.1e+06   1.212e+04     1.7377     -58014.9995    0.0471  1.42e+07
(1) inv 는 조건수 \(10^{11}\) 에서 자리를 잃고 \(10^{15}\) 에서 답이 아니게 된다. 어림셈이 먼저다. 상대오차는 대략 \(\operatorname{cond} \times \varepsilon\) 이고 배정밀도에서 \(\varepsilon = 2.2 \times 10^{-16}\) 이니, 조건수가 \(10^{11}\) 이면 상대오차 \(10^{-5}\), \(10^{15}\) 이면 상대오차 \(1\) — 곧 유효숫자가 하나도 남지 않는다. 표가 그대로 말해 준다.
- \(\delta = 10^{-1}\): 조건수 \(1.22 \times 10^7\), 두 해의 차이 \(1.2 \times 10^{-8}\). 아직 같은 답이다.
- \(\delta = 10^{-3}\): 조건수 \(1.22 \times 10^{11}\), 차이 \(1.7 \times 10^{-4}\). 계수가 \(10^0\) 규모이니 유효자리 넷을 잃었다. 그래도 두 \(s\) 는 \(1.738\) 로 같다.
- \(\delta = 10^{-5}\): 조건수 \(1.11 \times 10^{15}\), 차이 \(4.9 \times 10^1\).
inv의 \(s\) 가 \(1.773\) 으로lstsq의 \(1.7377\) 보다 커졌다. \(s\) 는 최소제곱 해에서 최소이므로,inv가 돌려준 것은 더 이상 최소제곱 해가 아니다. - \(\delta = 10^{-7}\): 조건수 \(2.60 \times 10^{18}\),
inv의 \(s\) 가 \(1.21 \times 10^4\). 잔차가 \(7000\) 배 커졌으니 완전한 쓰레기다.lstsq의 \(s\) 는 네 줄 모두 \(1.7377\) 로 꿈쩍하지 않는다.
보기 1 의 자료가 안전했던 까닭도 여기서 분명해진다. 조건수 \(2.09 \times 10^5\) 에 \(\varepsilon\) 을 곱하면 \(10^{-11}\) 이고, 실제로 관찰된 차이가 \(4.0 \times 10^{-14}\) 였다. 조건수가 \(\varepsilon^{-1} = 4.5 \times 10^{15}\) 에 다가가는지를 보는 것이 inv 를 써도 되는지 가리는 기준이다.
(2) 자료가 정하는 것은 합이고 분해가 아니다. 네 번째 열이 \(\mathbf x_{\text{TV}} + \delta\mathbf z\) 이므로 적합값의 그 부분은
로 다시 묶인다. 자료가 보는 것은 \(\beta_{\text{TV}} + \beta_4\) 와 \(\delta\beta_4\) 둘뿐이다. 앞의 것은 잘 추정되고, 뒤의 것에서 \(\beta_4\) 를 뽑으려면 \(\delta\) 로 나누어야 하니 \(\delta \to 0\) 에서 터진다. 표의 b_TV 가 \(-0.011 \to -5.75 \to -580 \to -58015\) 로 발산하는데도(뒤쪽 세 줄에서 \(\delta\) 가 \(100\) 배 줄 때마다 꼭 \(100\) 배씩 커지므로 \(\delta^{-1}\) 꼴이다) b_TV+b_4 는 네 줄 모두 \(0.0471\) 로 보기 3 의 TV 계수 \(0.0470\) 과 소수 셋째 자리까지 같다. 두 계수가 정확히 상쇄하도록 맞물려 움직이는 것이다.
표준오차는 그 사정을 정직하게 보고한다. \(\mathrm{SE}(\hat\beta_{\text{TV}})\) 가 \(1.52 \to 152 \to 1.45\times10^4 \to 1.42\times10^7\) 로 커진다. 앞의 세 값은 \(\delta\) 가 \(100\) 배 줄 때 \(100\) 배 안팎으로 커지는 \(\delta^{-1}\) 꼴이고, 보기 1 의 \(0.001701\) 에 비하면 \(10^3\) 배에서 \(10^{10}\) 배다. \(t\) 값은 \(0\) 에 붙어 "이 계수는 모른다" 가 된다. 이것이 연습문제 5 가 말한 비대각원소가 \((\mathbf X^\top\mathbf X)^{-1}\) 의 대각을 부풀리는 것의 극단이며, VIF 가 재는 바로 그 팽창이다. (맨 아래 줄의 \(1.42\times10^7\) 은 거의 특이한 역행렬로 셈한 값이라 자릿수만 믿을 것이다. 음수 대각이 나올 수 있어 코드가 np.abs 를 씌워 두었다.)
요점은 둘이 다른 병이라는 것이다. 수치 안정성은 lstsq 가 고쳐 준다. 식별가능성은 고쳐 주지 못한다. lstsq 는 \(s = 1.7377\) 로 예측을 멀쩡히 해내면서 개별 계수에는 거대한 표준오차를 붙여 준다. 예측은 되는데 해석은 안 되는 상태이며, 그 경계를 알려 주는 것이 바로 표준오차다.
정리하며
회귀 요약표 전체를 손으로 재현했다.
- 모든 열이 \((\mathbf X^\top\mathbf X)^{-1}\) 에서 나온다. 계수는 \((\mathbf X^\top\mathbf X)^{-1}\mathbf X^\top\mathbf y\), 표준오차는 그 역행렬 대각원소의 제곱근에 \(s\) 를 곱한 것, \(t\) 는 둘의 비, \(p\) 값은 \(t_{n-k}\) 의 양측 꼬리다(\(k\) 는 절편을 포함한 모수의 개수).
- 직접 계산해 보면 요약표가 블랙박스가 아니게 된다. 어떤 수가 어디서 오는지 알면 이상한 값이 나왔을 때 원인을 짚을 수 있다.
- 표준오차가 핵심 고리다. 계수만으로는 아무 판단도 못 하며, 표준오차가 계수를 해석 가능하게 만든다.
- 신뢰구간과 \(p\) 값이 같은 계산의 두 표현이다. 구간이 \(0\) 을 포함하는 것과 \(p>\alpha\) 가 동치다.
statsmodels결과와 대조해 검산한다. 맞지 않으면 대개 절편 열을 빠뜨렸거나 자유도를 잘못 잡은 것이다.
다음 절 교호작용 항부터 13.5절은 모형의 꼴을 넓힌다. 한 변수의 효과가 다른 변수에 따라 달라지는 자리를 곱셈 항으로 적는다.