Bessel 수정
들어가며
Bessel 수정은 표본분산 공식의 분모에 \(n\) 대신 \(n-1\)을 쓰는 것을 말하며, 그 결과 모분산의 불편추정량을 얻는다. Friedrich Bessel의 이름을 딴 이 수정은 같은 자료로 평균을 추정하느라 자유도 하나가 "소모"되어 소박한 추정량(\(n\)으로 나누기)이 참 분산을 체계적으로 과소추정한다는 사실을 보정한다.
정의 1. Bessel 수정 표본분산
Bessel 수정 표본분산은:
대부분의 통계 소프트웨어에서 쓰는 표준적인 "표본분산"이다(예: numpy.var(ddof=1), R의 var()).
불편성의 증명
주요 결과
증명
핵심 항등식에서 출발한다:
기댓값을 취하면:
따라서:
왜 n-1인가? 자유도 논증
\(n\)개의 편차 \(d_i = X_i - \bar{X}\)는 다음 제약을 받는다:
즉 편차 중 \(n-1\)개만이 독립적으로 자유롭게 변할 수 있다. 이를 두고 자유도가 \(n-1\)이라고 한다. 관측값의 개수(\(n\))가 아니라 자유도(\(n-1\))로 나누면 편향이 보정된다.
일반 원리: 추정한 모수가 \(k\)개일 때 분산을 추정하려면 \(n - k\)로 나눈다:
- 평균을 모르고 \(X\)의 분산을 추정: \(n - 1\)로 나눈다
- 계수가 \(p\)개인 회귀: 잔차분산은 \(n - p\)를 쓴다
"자유도 하나를 소모한다"는 말은 추상적으로 들리지만 실제로는 아주 구체적인 일이다. \(n = 5\)짜리 표본 하나의 편차를 그려 보면 바로 보인다.
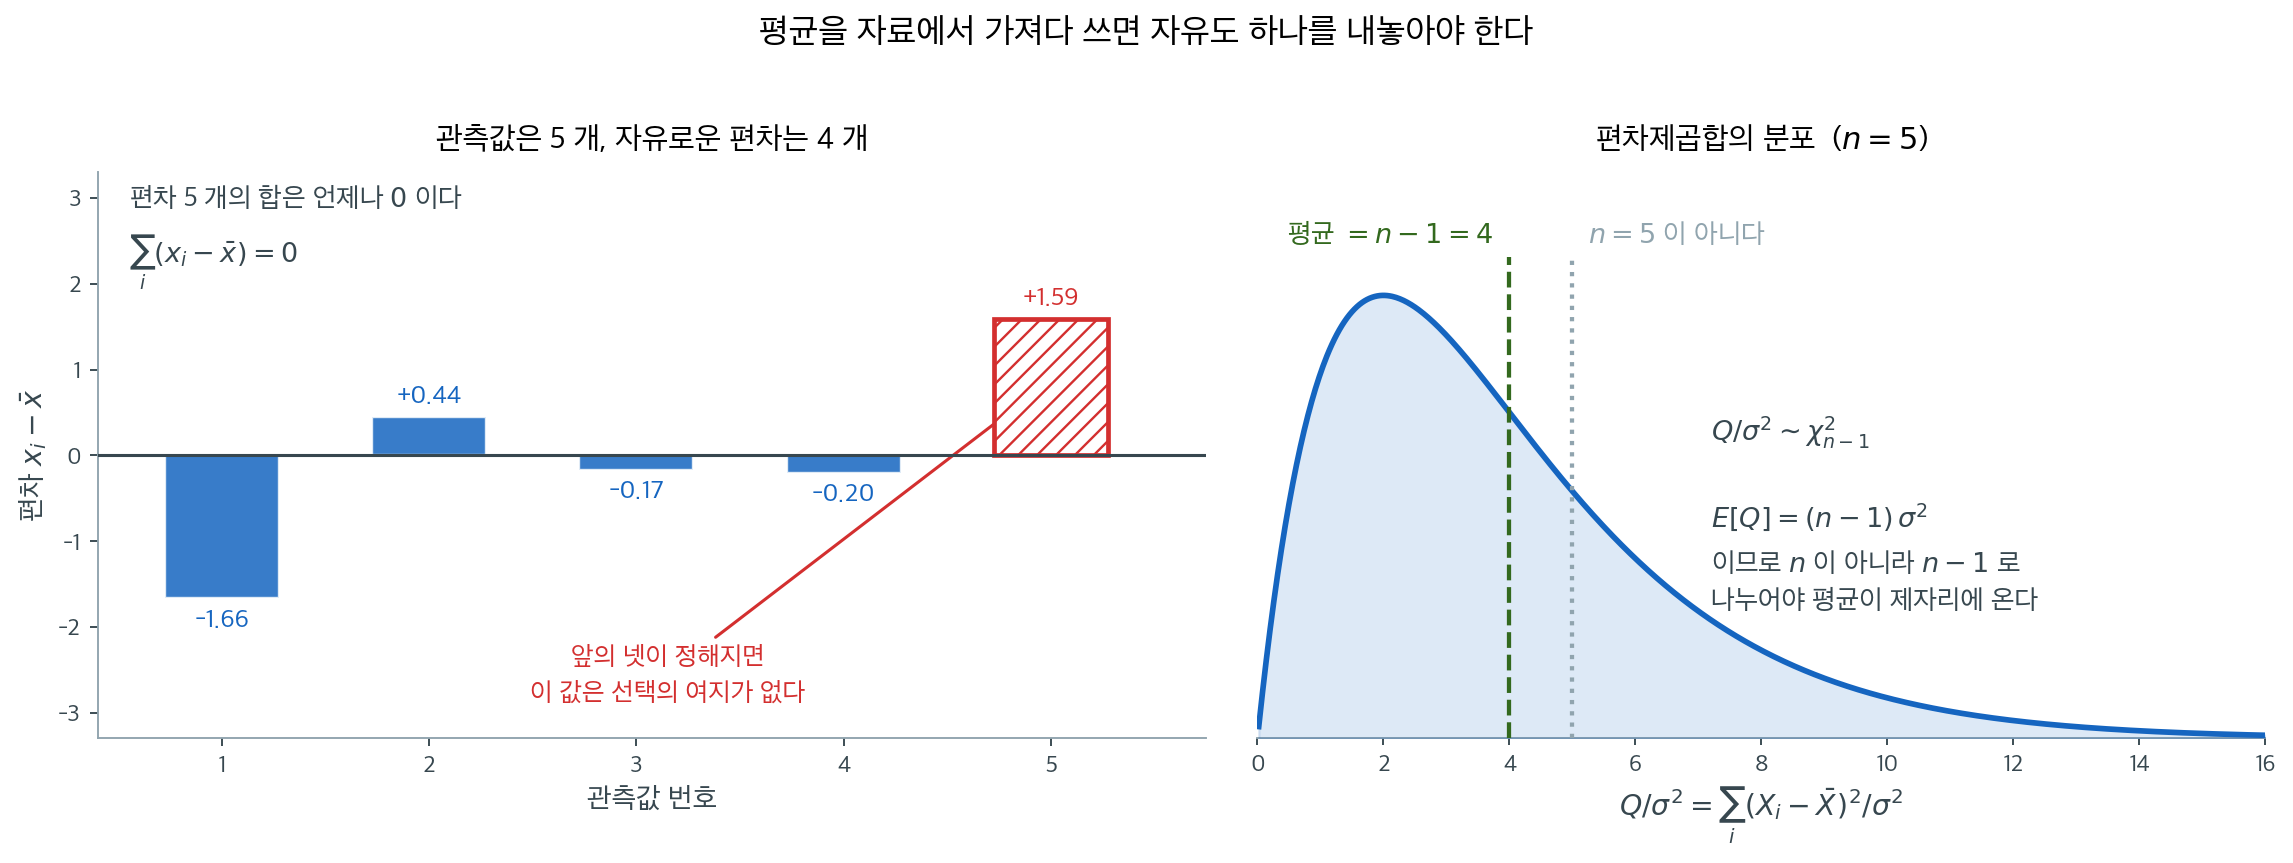
왼쪽 막대가 이 표본의 편차 \(x_i - \bar{x}\)다. 값은 \(-1.66,\; +0.44,\; -0.17,\; -0.20,\; +1.59\)이고 합은 정확히 \(0\)이다. 여기서 중요한 것은 다섯 번째 막대에 선택의 여지가 없다는 점이다. 앞의 네 값을 알면 마지막 값은 \(-(-1.66 + 0.44 - 0.17 - 0.20) = +1.59\)로 자동으로 결정된다. 빗금으로 그린 이유가 그것이다. 관측값은 다섯 개지만 흩어짐에 대해 말해 주는 독립적인 숫자는 넷뿐이다.
오른쪽이 그 결과다. 정규성 아래에서 \(Q/\sigma^2 = \sum_i (X_i-\bar{X})^2/\sigma^2\)은 자유도 \(4\)인 카이제곱분포를 따르고, 그 분포의 평균은 \(4\)다. 관측값 개수인 \(5\)가 아니다. 분포가 통째로 왼쪽으로 한 칸 밀려 있는 셈인데, 이 "한 칸"이 곧 \(\sigma^2\) 하나만큼의 편향이다. \(Q\)를 \(n = 5\)로 나누면 평균이 \(0.8\sigma^2\)에 오고, \(n - 1 = 4\)로 나누어야 정확히 \(\sigma^2\)에 온다.
이렇게 보면 Bessel 수정은 "\(n\)이 작을 때 쓰는 보정"이 아니라 나눌 때 세는 단위를 관측값 개수에서 자유도로 바꾼 것이다. 회귀에서 \(n - p\)로 나누는 것도, 분산분석에서 각 제곱합에 저마다 다른 자유도가 붙는 것도 전부 같은 규칙의 반복이다.
S-squared의 분포
정규모집단의 경우
\(X_i \sim N(\mu, \sigma^2)\)이면,
이 정확한 분포 결과로부터:
X-bar와 S-squared의 독립성
정규모집단에서 \(\bar{X}\)와 \(S^2\)은 독립이다. 이는 (Cochran 정리에 의해) 정규분포에만 있는 놀라운 성질이며, 가설검정에 쓰이는 \(t\)-분포를 유도하는 데 결정적이다.
성질
분산과 평균제곱오차
정규모집단에서:
일치성
\(S^2\)은 \(\sigma^2\)에 대해 일치한다:
대안과의 평균제곱오차 비교
정규모집단에서:
불편추정량이 편향된 소박한 추정량보다 평균제곱오차가 크다. 불편성이 분산 증가라는 대가를 치르며, (평균제곱오차 관점에서) 그 분산 증가가 편향 감소보다 크기 때문이다.
실질적 의의
언제 중요한가?
\(n\)으로 나누는 것과 \(n-1\)로 나누는 것의 차이:
| \(n\) | \((n-1)/n\) | 상대오차 |
|---|---|---|
| 3 | 0.667 | 33.3% |
| 5 | 0.800 | 20.0% |
| 10 | 0.900 | 10.0% |
| 30 | 0.967 | 3.3% |
| 100 | 0.990 | 1.0% |
| 1000 | 0.999 | 0.1% |
\(n > 30\)이면 실질적인 차이가 작다. \(n < 10\)이면 수정이 상당하다.
표준편차의 편향
\(S^2\)은 \(\sigma^2\)에 대해 불편이지만, 표본표준편차 \(S = \sqrt{S^2}\)은 \(\sigma\)에 대해 불편이 아니다. (\(\sqrt{\cdot}\)가 오목이므로) Jensen 부등식에 의해:
정규모집단에서:
보정인자 \(c_4 = \sqrt{2/(n-1)} \cdot \Gamma(n/2)/\Gamma((n-1)/2)\)를 쓰면 \(\sigma\)의 불편추정량 \(\hat{\sigma} = S/c_4\)를 얻을 수 있다.
소프트웨어 구현
소프트웨어마다 기본값이 다르다:
| 소프트웨어 | var() 기본값 |
나누는 수 |
|---|---|---|
Python numpy.var() |
\(n\) (모집단) | ddof=0 |
Python numpy.var(ddof=1) |
\(n-1\) (표본) | ddof=1 |
R var() |
\(n-1\) (표본) | — |
Excel VAR.S() |
\(n-1\) (표본) | — |
Excel VAR.P() |
\(n\) (모집단) | — |
pandas .var() |
\(n-1\) (표본) | ddof=1 |
흔한 함정: ddof=1 없이 numpy.var()를 쓰면 편향된(소박한) 추정량이 나온다. 불편 표본분산을 원한다면 항상 ddof=1을 지정하라.
일반화: 회귀에서의 자유도
선형회귀 \(Y = X\beta + \epsilon\)에서 잔차분산추정량은:
여기서 \(p\)는 추정한 계수의 개수이다. 이는 Bessel 수정을 일반화한 것이다: 추정한 모수 하나마다 자유도 하나를 잃는다.
금융과의 연결
-
실현변동성: 일중 수익률로 일별 실현변동성을 계산할 때는 \(n\)이냐 \(n-1\)이냐가 대개 무의미하다(관측값이 많다). 그러나 일별 자료로 월별 변동성을 구할 때(약 21개 관측값)는 수정이 의미가 있다.
-
추적오차: 포트폴리오와 벤치마크의 추적오차는 Bessel 수정을 써서 \(S = \sqrt{\frac{1}{n-1}\sum(r_p - r_b)^2}\)로 계산한다.
-
위험 배분: 포트폴리오 위험의 분산분해는 \(n-1\)로 나누는 불편 공분산행렬을 쓴다.
요약
Bessel 수정(분모의 \(n-1\))은 모분산의 불편추정량을 만든다. 이 수정은 평균을 추정하느라 "잃어버린" 자유도를 보상한다. 불편추정량이 소박한 추정량보다 평균제곱오차가 크기는 하지만, 이론적 성질 덕분에 불편성이 흔히 선호되며 대부분의 통계 소프트웨어에서 표준이다. 큰 표본에서는 \(n\)과 \(n-1\) 중 무엇을 택하든 중요하지 않다.
핵심 공식
| 양 | 공식 |
|---|---|
| Bessel 수정 분산 | \(S^2 = \frac{1}{n-1}\sum(X_i - \bar{X})^2\) |
| 불편성 | \(E[S^2] = \sigma^2\) |
| 분포 (정규) | \((n-1)S^2/\sigma^2 \sim \chi^2_{n-1}\) |
| 분산 (정규) | \(\text{Var}(S^2) = 2\sigma^4/(n-1)\) |
| \(S\)는 \(\sigma\)에 대해 편향 | \(E[S] < \sigma\) (Jensen 부등식) |
| 일반적인 회귀 | \(\hat{\sigma}^2 = \text{RSS}/(n-p)\) |
연습문제
연습문제 1. 정규 자료에서 \(S^2\)의 카이제곱분포. (a) \((n-1)S^2/\sigma^2 \sim \chi^2_{n-1}\)임을 보여라. (b) \(n = 20, S^2 = 16\)일 때 \(\sigma^2\)의 95% 신뢰구간. (c) 왜 비대칭인가?
풀이
(a) \(\sum(X_i - \bar X)^2/\sigma^2 = \sum(X_i - \mu)^2/\sigma^2 - n(\bar X - \mu)^2/\sigma^2\). 첫 항은 \(\chi^2_n\), 둘째 항은 \(\chi^2_1\)이며 (Cochran 정리에 의해) 서로 독립이다. 따라서 그 차이는 \(\chi^2_{n-1}\)이다.
(b) \(\chi^2_{19, 0.025} = 8.907\), \(\chi^2_{19, 0.975} = 32.852\). 신뢰구간: \((19 \cdot 16/32.852, 19 \cdot 16/8.907) = (9.25, 34.13)\).
(c) 카이제곱분포는 오른쪽으로 치우쳐 있어 분위수가 비대칭이다. 상한이 하한보다 \(S^2\)에서 멀다. \(n \to \infty\)이면 비대칭성이 줄어든다(표준정규 제곱에 중심극한정리를 적용하면 카이제곱이 정규에 가까워진다).
연습문제 2. \(S\)의 편향. (a) \(\mathbb{E}[S] < \sigma\)인 이유. (b) \(n = 5\)일 때 \(c_4\)를 계산하라. (c) 실무에서 쓰이는가?
풀이
(a) \(\sqrt{\cdot}\)는 오목이다. Jensen: \(\mathbb{E}[\sqrt{S^2}] < \sqrt{\mathbb{E}[S^2]} = \sigma\). \(S^2\)의 분산이 0이 아니므로 부등호는 엄격하다.
(b) \(c_4 = \sqrt{2/(n-1)} \cdot \Gamma(n/2)/\Gamma((n-1)/2)\). \(n = 5\)일 때: \(c_4 = \sqrt{2/4} \cdot \Gamma(2.5)/\Gamma(2) = (1/\sqrt 2) \cdot (3\sqrt\pi/4)/1 \approx 0.940\).
편향 보정 표준편차: \(S/c_4\).
(c) 거의 쓰이지 않는다. 편향이 작기 때문이다(\(n = 5\)에서 약 6%, \(n \ge 30\)에서 1% 미만). 통계적 공정관리(Shewhart) 관리도는 \(c_4\)를 쓰지만, 다른 대부분의 응용에서는 보정하지 않은 \(S\)를 보고한다.
연습문제 3. 실현변동성. 하루에 5분 수익률 78개. (a) 소박한 추정량의 편향 비율. (b) Bessel 수정이 중요한가? (c) 21일 이동창은?
풀이
(a) 소박한 추정량의 편향 = \(-\sigma^2/n = -\sigma^2/78\)로 참 분산의 약 \(-1.3\%\). 무시할 만하다.
(b) Bessel 수정의 인자는 \(78/77 \approx 1.013\)이다. 미시구조 잡음이나 일중 변동성 패턴보다 작다. 중요하지 않다.
(c) 21일 이동창은 일별 분산추정값 21개이다. 평균 분산추정값의 표준오차: \(\sqrt{2 \sigma^4/(n_{\text{day}} - 1)}/\sqrt{21}\). 맞바꿈: 추정값이 매끄러워지지만 변동성 국면 전환을 평균 10일 뒤늦게 반영한다. 국면 전환의 반감기: 약 10일.
연습문제 4. Bessel 수정의 일반화. 모수가 \(p\)개인 회귀에서 잔차분산추정량은 \(n - p\)로 나눈다. 왜인가?
풀이
잔차 \(e_i = Y_i - \hat Y_i\)는 선형 제약(정규방정식: \(\mathbf X^\top \mathbf e = 0\))을 만족한다. \(\mathbf X\)의 열이 \(p\)개이므로 선형 제약이 \(p\)개이고, 유효 자유도는 \(n - p\)가 남는다.
\(\mathbb{E}[\mathrm{SSE}/\sigma^2] = n - p\)이다(정규성 아래에서 카이제곱분포). 따라서 \(\hat\sigma^2 = \mathrm{SSE}/(n - p)\)는 불편이다.
Bessel 수정의 일반화이다: \(n - 1\)은 \(p = 1\)(절편만)인 경우이다.
t-검정/F-검정과의 연결: 자유도가 \(n - p\)인 잔차분산이 적절한 \(t\) 임계값(자유도 \(= n - p\))을 결정한다.
연습문제 5. 하필 \(n - 1\)로 나누는 이유는? 다른 분모를 정당화할 수 있는가?
풀이
불편성: \(n - 1\)은 \(S^2\)을 불편으로 만드는 유일한 분모이다.
평균제곱오차 최적: \(n + 1\)이 평균제곱오차를 최소화한다(앞 절의 연습문제).
MLE: (정규 자료에서) \(n\)이 MLE의 분모이다.
\(n - 1\)의 정당화: 불편성은 "깔끔한" 성질이다 — 불편추정량들의 평균은 불편이고, 기댓값은 해석하기 쉽다. 평균제곱오차 최적은 아니지만 통계학의 관례는 \(n - 1\)을 선호한다.
분야마다 선택이 다르다:
- 공학 / 통계적 공정관리: 표본분산에 \(n - 1\), 표준편차에 \(c_4\) 보정.
- 기계학습: 편향을 신경 쓰지 않고 흔히 \(n\)(MLE)을 쓴다.
- Bayes: \(\chi^2_{n-1}\)에 기반한 사후 신용구간.
- 로버스트 통계: 중앙값 절대편차 — 분모 선택이 무관하다.
연습문제 6. 아주 작은 표본에서는 편향 보정이 중요하지만 큰 표본에서는 그렇지 않은 이유. \(n = 3, 10, 100\)으로 구체적으로 보여라.
풀이
소박한 추정량과 불편추정량의 차이: \(\hat\sigma^2_{\text{naive}}/\hat\sigma^2_{\text{unbiased}} = (n-1)/n\).
| \(n\) | \((n-1)/n\) | 차이 |
|---|---|---|
| 3 | 0.667 | 33% |
| 10 | 0.900 | 10% |
| 100 | 0.990 | 1% |
| 1000 | 0.999 | 0.1% |
\(n = 3\)일 때: Bessel 수정을 빠뜨리면 분산을 1/3만큼 과소추정한다 — 심각한 오류이다.
\(n = 100\)일 때: 1% — 대부분의 측정에서 반올림 오차 수준이다. Bessel 수정은 거의 관례에 가깝다.
실무적 함의: 작은 표본(30 미만)에서는 항상 Bessel 수정을 쓰라. 큰 표본(100 초과)에서는 선택이 거의 학술적이다. 실제 자료의 잡음이 이 작은 편향 보정을 대개 압도한다.
연습문제 7. Bessel 수정은 평균을 추정했기 때문에 필요하다. 평균 대신 중앙값을 중심으로 편차를 재면 분모를 어떻게 해야 하는가? 일반적인 답이 있는가?
풀이
왜 \(n-1\)인가 다시 보기. \(\sum(X_i-\bar X)^2\)의 기대값이 \((n-1)\sigma^2\)인 것은 \(\bar X\)가 그 제곱합을 최소로 하는 값이기 때문이다. 어떤 고정된 \(c\)에 대해서도
이고, 그 "절약된" 양이 정확히 \(n(\bar X-\mu)^2\)이며 기대값이 \(\sigma^2\)이다. 자유도 하나를 잃는다.
중앙값으로 바꾸면. \(\sum(X_i-\tilde X)^2\)은 \(\sum(X_i-\bar X)^2\)보다 크다. 중앙값은 제곱합이 아니라 절대편차합을 최소로 하기 때문이다. 따라서
이고, 정규분포에서 계산하면 \(n\)이 클 때 대략
이다. \(\bar X\) 대신 \(\tilde X\)를 쓴 대가로 \(\pi/2-1 \approx 0.571\)만큼 더 늘어난다(\(\tilde X\)의 점근분산이 \(\pi\sigma^2/(2n)\)이므로).
일반적인 답은 없다. 보정 인수가
- 모집단 분포에 의존한다(위 계산은 정규 가정).
- 표본크기에 의존한다(점근이 아니라 유한표본에서는 더 복잡).
즉 \(n-1\)처럼 분포와 무관한 깔끔한 보정이 존재하지 않는다.
실무적 함의.
- 중심을 중앙값으로 바꾸면서 분산은 제곱편차로 재는 혼합 방식은 권장되지 않는다. 중심과 척도를 일관되게 고르는 편이 낫다.
- 강건 중심을 쓰려면 강건 척도를 함께 쓴다. 중앙값 + MAD가 자연스러운 짝이고, 그때 보정 인수 1.4826이 정규분포에서의 일치성을 준다.
- 일반적으로 "자유도 \(n-k\)"라는 규칙이 성립하는 것은 최소제곱 계열에서뿐이다. 최대가능도나 강건 추정에서는 편향 보정을 따로 유도하거나 부트스트랩에 맡겨야 한다.
연습문제 8. \(\sigma^2\)이 아니라 \(\sigma\)를 보고해야 할 때 Bessel 수정만으로는 부족하다. 필요한 추가 보정과 그 크기를 적어라.
풀이
문제. \(E[S^2]=\sigma^2\)이지만 \(E[S] \ne \sigma\)다. 제곱근이 오목함수이므로 옌센 부등식에서
로 과소추정한다.
보정 인수. 정규모집단에서
이므로 \(S/c_4\)가 불편이다.
| \(n\) | \(c_4\) | 편향 |
|---|---|---|
| 2 | 0.7979 | \(-20.2\%\) |
| 5 | 0.9400 | \(-6.0\%\) |
| 10 | 0.9727 | \(-2.7\%\) |
| 25 | 0.9896 | \(-1.0\%\) |
| 50 | 0.9949 | \(-0.5\%\) |
어림 공식. \(c_4 \approx 1-\dfrac{1}{4(n-1)}\)로, \(n\ge10\)이면 소수 넷째 자리까지 맞는다. 편향이 대략 \(-1/\{4(n-1)\}\)이다.
언제 중요한가.
- \(n\)이 아주 작을 때. \(n=2\)면 20%나 된다. 쌍 자료나 반복 측정이 두 번뿐인 경우.
- 여러 작은 표본의 \(s\)를 평균낼 때. 편향이 상쇄되지 않고 그대로 쌓인다. 관리도에서 부분군별 \(s\)를 평균해 \(\bar s/c_4\)로 \(\sigma\)를 추정하는 관행이 이 때문이다.
- 공정능력지수 계산. \(C_p = (\text{USL}-\text{LSL})/(6\sigma)\)에서 \(\sigma\)를 과소추정하면 \(C_p\)를 과대평가해 공정이 실제보다 좋아 보인다.
언제 무시해도 되는가. \(n\ge25\)면 1% 미만이라 실무적으로 무의미하다. 게다가 \(S/c_4\)는 불편이지만 평균제곱오차는 \(S\)보다 클 수 있다. 편향을 없애면서 분산이 늘기 때문이다.
주의. \(c_4\)는 정규모집단 공식이다. 다른 분포에서는 값이 다르며, 일반적인 보정 인수는 존재하지 않는다.
연습문제 9. 여러 표본의 분산을 합칠 때 Bessel 수정이 어떻게 작용하는지 설명하라. 합동분산의 분모가 \(\sum(n_i-1)\)인 이유는?
풀이
합동분산.
여기서 \(N=\sum n_i\)다.
왜 \(N-k\)인가. 집단마다 평균을 하나씩 추정했으므로 자유도를 \(k\)개 잃는다. 각 집단에서 \(n_i-1\)씩 남고 그 합이 \(N-k\)다.
불편성. 각 \(s_i^2\)이 불편이므로
로 어떤 \(\{n_i\}\)에서도 불편이다.
왜 자유도로 가중하는가. 정규모집단에서 \(\operatorname{Var}(s_i^2)=2\sigma^4/(n_i-1)\)이므로 정밀도가 자유도에 비례한다. 앞서 본 정밀도 가중 원리에 따라 자유도 가중이 최소분산을 준다.
단순평균 \(\frac1k\sum s_i^2\)도 불편이지만 분산이 더 크다. \(n_i\)가 크게 다를수록 차이가 벌어진다.
일반화. 같은 원리가 곳곳에 나타난다.
| 맥락 | 분모 |
|---|---|
| 한 표본 | \(n-1\) |
| \(k\)개 집단(분산분석 MSE) | \(N-k\) |
| 회귀(\(p\)개 모수) | \(n-p\) |
| 이원배치 분산분석 | \(N-(\text{모수 수})\) |
한 문장으로. 자료에서 추정한 모수 하나마다 자유도를 하나씩 뺀다. 이것이 "자유도"라는 개념의 실용적 정의이며, 분산 추정을 불편으로 만드는 장치다.
주의. 합동분산은 모든 집단의 참 분산이 같다는 가정 위에 있다. 그렇지 않으면 \(s_p^2\)이 무엇을 추정하는지 불분명해지고, 앞서 본 대로 합동 \(t\) 검정의 오류율이 어긋난다. 등분산이 의심스러우면 합동하지 않는 웰치식 접근을 쓴다.
연습문제 10. Bessel 수정이 불편성을 주지만 평균제곱오차를 최소로 하지는 않는다. 이 긴장을 정리하고, 실무에서 \(n-1\)이 표준으로 남은 이유를 적어라.
풀이
세 후보의 비교(정규모집단, \(\hat\sigma^2_c = \text{SS}/c\)).
| \(c\) | 편향 | MSE(\(\sigma^4\) 단위) | \(n=10\) |
|---|---|---|---|
| \(n-1\) | 0 | \(2/(n-1)\) | 0.2222 |
| \(n\) | \(-\sigma^2/n\) | \((2n-1)/n^2\) | 0.1900 |
| \(n+1\) | \(-2\sigma^2/(n+1)\) | \(2/(n+1)\) | 0.1818 |
불편추정량이 셋 중 가장 나쁘다. MSE 기준으로는 \(n+1\)이 최적이다.
그럼에도 \(n-1\)이 표준인 이유.
-
불편성이 결합될 때 좋은 성질을 준다. 합동분산, 분산분석표, 변량효과 모형에서 여러 분산 추정값을 더하고 나눈다. 불편이면 그 조합도 불편이지만, 편향이 있으면 누적되고 상쇄되지 않는다.
-
\(n+1\)의 최적성은 정규 가정에 의존한다. 앞서 본 대로 일반 모집단에서 최적 \(c\)는 첨도에 의존해 \(c^* \approx n+1+n\gamma_2/2\)다. 꼬리가 두꺼우면 \(n+1\)도 부족하고 가벼우면 과하다. 분포에 무관하게 불편인 \(n-1\)이 더 보편적이다.
-
차이가 빠르게 사라진다. \(n=10\)에서도 MSE 차이가 18%이고, \(n=50\)이면 4%다. 실무적으로 대개 무시할 만하다.
-
해석과 소통. "\(n-1\)로 나눈다"는 규칙이 자유도라는 일관된 개념으로 설명되고, 회귀·분산분석과 통일된다. \(n+1\)은 그런 해석이 없다.
-
관습의 힘. 모든 소프트웨어의 기본값(R의
var, NumPy의ddof=1관행)이고, 교과서와 논문이 이를 전제한다. 바꾸면 비교와 재현이 어려워진다.
한 문장으로. \(n-1\)은 MSE 최적이 아니지만, 분포에 무관하고 조합에 안전하며 해석이 일관되다는 점에서 더 나은 기본값이다. MSE가 정말 중요한 특수한 상황(단일 추정, 정규성 확신, 작은 \(n\))에서는 \(n+1\)이나 축소 추정을 고려할 수 있다.
정리하며
베셀 수정은 분모를 \(n-1\) 로 바꾸어 편향을 정확히 상쇄한다.
- 분산이 유한한 모든 분포에서 성립한다. 정규성은 필요 없다. 증명에 쓰이는 것은 \(\mathbb{E}[(X_i-\bar X)^2]\) 의 대수뿐이다.
- \(n-1\) 이 자유도다. 편차들이 합이 \(0\) 이라는 제약을 받아 독립적인 방향이 하나 줄어든 것이며, 0장에서 본 사영의 기하와 같은 이야기다.
- 소프트웨어 기본값이 갈린다.
numpy.var()는ddof=0(즉 \(n\))이고pandas.var()와 R 의var()는 \(n-1\) 이다. 같은 자료에서 다른 값이 나오므로 반드시 확인해야 한다. - \(S\) 는 \(\sigma\) 의 불편추정량이 아니다. 제곱근이 오목하므로 옌센 부등식에 의해 \(\mathbb{E}[S]<\sigma\) 다. 불편성은 제곱 척도에서만 성립하며 변환을 견디지 못한다.
- 불편이라고 최선은 아니다. 다음 절에서 보듯 MSE 를 기준으로 삼으면 \(n-1\) 이 이기지 못한다.
다음 절 분산추정량의 평균제곱오차로 넘어간다.