일대일(OvO) 접근
착상
일대일(OvO) 전략은 \(C\)범주 문제를 범주 쌍마다 하나씩 \(\binom{C}{2} = C(C-1)/2\)개의 이항 부분문제로 분해한다. 각 이항 분류기는 자신이 구별하는 두 범주의 사례만으로 학습되므로 부분문제가 작아지고 대체로 풀기 쉬워진다. 예측 시점에는 분류기들이 투표하고 표를 가장 많이 받은 범주가 이긴다.
학습 절차
\(1 \le c < c' \le C\)인 각 쌍 \((c, c')\)에 대해,
- 범주 \(c\) 또는 \(c'\)에 속하는 훈련자료 부분집합을 추출한다.
- \(\mathcal{D}_{c,c'}\)로 이항 분류기 \(f_{c,c'}\)를 학습시킨다. 범주 \(c\)를 양성, \(c'\)를 음성으로 둔다.
분류기의 총 개수는
이다. \(C = 10\)이면 45개, \(C = 26\)(예: 알파벳 인식)이면 325개다.
다수결 예측
검정 시점에 \(C(C-1)/2\)개의 분류기가 각자 두 범주 중 하나에 표를 던진다. 범주 \(c\)가 받은 표 수를 \(v_c\)라 하면
이고 예측 범주는
이다. 각 범주는 \(C - 1\)번의 쌍별 대결에 참여하므로 한 범주가 얻을 수 있는 최대 표 수는 \(C - 1\)이다.
동점 처리
두 개 이상의 범주가 같은 표 수를 받는 동점이 생길 수 있다. 흔한 동점 처리 전략은 다음과 같다.
- 총 확신도가 가장 높은 범주를 예측한다(그 범주가 참여한 모든 쌍별 분류기의 예측확률 합).
- 색인이 가장 작은 범주를 예측한다(임의적이지만 결정론적이다).
계산 비용
| 양 | OvR | OvO |
|---|---|---|
| 분류기 개수 | \(C\) | \(C(C-1)/2\) |
| 분류기당 훈련 표본 | \(n\) | 평균 약 \(2n/C\) |
| 총 학습 비용 | \(C \cdot T(n, p)\) | \(\frac{C(C-1)}{2}\cdot T(2n/C, p)\) |
여기서 \(T(m, p)\)는 특성 \(p\)개인 사례 \(m\)개로 이항 분류기 하나를 학습시키는 비용이다. OvO의 각 분류기는 자료의 일부만 쓰므로 분류기당 학습 시간이 훨씬 짧다. 학습 비용이 \(n\)에 대해 초선형인 알고리즘(예: \(O(n^2)\)--\(O(n^3)\)인 SVM)에서는 분류기 수가 더 많음에도 OvO가 전체적으로 더 빠를 수 있다.
학습이 대략 \(O(np)\)인 로지스틱 회귀에서는 OvO의 총 비용이 \(C(C-1)/2 \cdot O(2np/C) = O((C-1)np)\)로 OvR의 \(O(Cnp)\)와 비슷하다.
장점과 단점
| 측면 | 평가 |
|---|---|
| 부분문제 크기 | 작다(분류기당 두 범주만) |
| 초선형 알고리즘의 학습 속도 | 대체로 OvR보다 빠르다 |
| 분류기 개수 | \(C\)에 대해 이차. 매우 많아질 수 있다 |
| 예측 속도 | \(C(C-1)/2\)개 분류기를 모두 평가해야 한다 |
| 범주 불균형 | OvR보다 덜 심각하다(이항 부분문제가 균형적) |
| 확률 추정 | 직접 얻을 수 없고 집계가 필요하다 |
OvO가 빛나는 경우
libsvm과 scikit-learn의 SVC 같은 여러 라이브러리에서 SVM의 기본 전략이 OvO다. SVM은 \(n\)에
대한 확장성이 나쁜데, OvO의 작은 부분문제가 이차적으로 늘어난 분류기 수를 상쇄하기 때문이다.
로지스틱 회귀에서는 이 이점이 뚜렷하지 않으며 고유 소프트맥스 회귀가 대개 낫다.
보기: 4범주 OvO
범주 \(C = 4\)개(A, B, C, D)를 생각하자. 분류기 개수는 \(\binom{4}{2} = 6\)이다.
| 분류기 | 범주 | 학습 부분집합 크기 |
|---|---|---|
| \(f_{A,B}\) | A 대 B | \(n_A + n_B\) |
| \(f_{A,C}\) | A 대 C | \(n_A + n_C\) |
| \(f_{A,D}\) | A 대 D | \(n_A + n_D\) |
| \(f_{B,C}\) | B 대 C | \(n_B + n_C\) |
| \(f_{B,D}\) | B 대 D | \(n_B + n_D\) |
| \(f_{C,D}\) | C 대 D | \(n_C + n_D\) |
새로운 점 \(\mathbf{x}_*\)에 대해 투표 결과가 다음과 같다고 하자.
| 분류기 | 승자 |
|---|---|
| \(f_{A,B}\) | A |
| \(f_{A,C}\) | A |
| \(f_{A,D}\) | D |
| \(f_{B,C}\) | B |
| \(f_{B,D}\) | B |
| \(f_{C,D}\) | D |
표 집계: A = 2, B = 2, C = 0, D = 2. 세 범주가 2표로 동점이다. 최종 예측을 내려면 동점 처리 규칙(예: 총 확신도 최대)이 필요하다. 연습문제 2에서 이 보기가 단순한 동점보다 더 근본적인 문제를 담고 있음을 본다.
동점은 사고가 아니라 구조다
위 보기의 승패표를 그림으로 옮겨 보면, 동점이 왜 생겼는지가 드러난다.
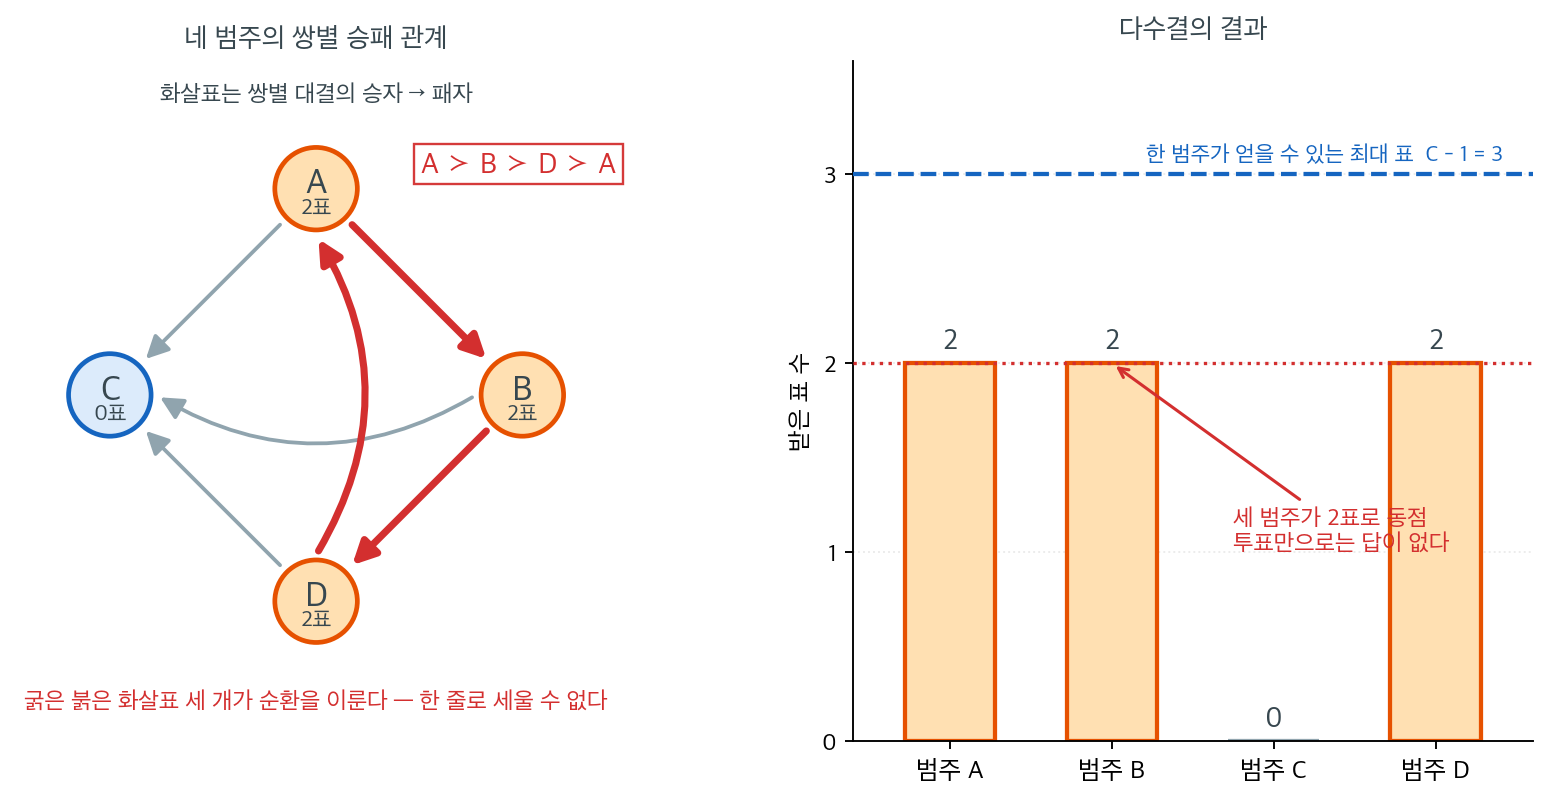
왼쪽 그림에서 화살표는 승자에서 패자로 향한다. 범주 C는 화살표를 받기만 하므로 \(0\)표이고, 나머지 세 범주는 모두 \(2\)표다. 굵은 붉은 화살표 세 개를 따라가 보라. A가 B를 이기고, B가 D를 이기고, D가 다시 A를 이긴다. \(A \succ B \succ D \succ A\)라는 순환이다. 이 순환이 있는 한 네 범주를 한 줄로 세우는 어떤 순서도 승패표와 일치할 수 없다. 화살표를 위에서 아래로 내려가도록 그릴 수가 없는 것이다.
오른쪽의 동점은 이 순환의 필연적인 결과다. 순환에 참여한 세 범주는 서로에게 한 번씩 이기고 한 번씩 졌으므로, 순환 바깥의 범주들에 대한 성적이 같으면 표 수가 반드시 같아진다. 여기서는 셋 다 C를 이기고 서로 한 번씩 나눠 가져 정확히 \(2\)표씩이다. 한 범주가 받을 수 있는 최대 표는 \(C - 1 = 3\)인데 아무도 거기에 닿지 못했다. 어떤 범주도 다른 모두를 이기지 못했다는 것이 순환의 정의이기 때문이다.
이것이 얼마나 흔한 일인지 가늠해 보자. \(C\)개 범주의 쌍별 승패 패턴은 \(2^{C(C-1)/2}\)가지이고, 그중 한 줄로 세울 수 있는(순환이 없는) 것은 \(C!\)가지뿐이다. \(C = 3\)이면 \(6/8\)로 넉넉하지만 \(C = 4\)에서 이미 \(24/64 = 37.5\%\)로 떨어지고, \(C = 5\)에서는 \(120/1024 = 11.7\%\)다. 실제 분류기들의 승패가 균등하게 무작위인 것은 아니므로 이 수치를 그대로 믿을 수는 없지만, 방향은 분명하다. 범주가 늘어날수록 순환은 예외가 아니라 기본값에 가까워진다.
그러므로 OvO의 동점 처리 규칙은 구현의 곁가지가 아니라 알고리즘의 일부다. 그리고 순환이 생겼을 때 남는 유일한 정보는 각 이항 분류기가 얼마나 확신했는가이므로, 색인 순서로 자르기보다 확신도의 합으로 가르는 편이 낫다. 소프트맥스에는 이 문제가 아예 없다. 하나의 점수 벡터 \(\mathbf{z}\)가 언제나 전순서를 정의하므로 순환이 원리적으로 불가능하다.
scikit-learn에서의 사용
scikit-learn은 OneVsOneClassifier 래퍼를 제공한다.
보기 1. 일대일 전략. 붓꽃 자료(\(n = 150\), \(C = 3\))를 층화추출로 \(7:3\)으로 나누어 OneVsOneClassifier를 적합한다.
(1) 이항 분류기는 몇 개 생기며, 각 분류기가 보는 훈련 사례는 몇 개인가. 학습 과정에서 처리되는 사례의 총 개수를 OvR과 견주어 미리 계산하시오.
(2) 검정점 하나에 던져지는 표의 총합과 한 범주가 받을 수 있는 최대 표 수를 각각 구하고, 코드로 (1)과 함께 확인하시오.
풀이
(1) 해석적으로. \(C = 3\)이므로 쌍의 개수는
이다. 쌍은 \((0,1)\), \((0,2)\), \((1,2)\)다. \(C = 3\)은 OvO와 OvR의 분류기 수가 같아지는 유일한 경우다. 비율이 \(\frac{C(C-1)/2}{C} = \frac{C-1}{2}\)이므로 \(C = 3\)에서 정확히 \(1\)이다.
훈련 자료는 \(n = 150 \times 0.7 = 105\)개이고 층화추출이므로 범주마다 \(105/3 = 35\)개씩이다. 따라서 분류기 \(f_{c,c'}\)는
개를 본다. 전체의 \(2/3\)이다. 셋을 합치면 처리되는 사례의 총 개수가
이고, OvR이라면 \(Cn = 3 \times 105 = 315\)다. OvO가 오히려 적다. 분류기 수는 같은데도 그런 것은, 각 사례가 OvR에서는 \(C = 3\)개 분류기 모두에 나타나지만 OvO에서는 자기 범주가 참여하는 \(C - 1 = 2\)개에만 나타나기 때문이다.
(2) 표의 산술. 분류기는 하나같이 둘 중 하나에 표를 주고 기권하지 않으므로, 검정점 하나가 받는 표의 총합은 분류기 개수와 같은 \(C(C-1)/2 = 3\)이다. 한 범주는 \(C - 1 = 2\)번의 대결에만 참여하므로 받을 수 있는 최대 표는 \(2\)다. \(2 + 1 + 0\) 또는 \(1+1+1\)만이 가능한 분배이고, 뒤의 것이 바로 앞에서 본 순환이 일으키는 삼중 동점이다.
수치적으로.
from itertools import combinations

import numpy as np
from sklearn.datasets import load_iris
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.multiclass import OneVsOneClassifier

X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0, stratify=y)

# 일대일(OvO)은 범주 쌍마다 이항 분류기를 하나씩 둔다. 분류기 수가
# C(C-1)/2 로 늘지만, 각 분류기가 쓰는 자료는 두 범주 것뿐이라 오히려
# 학습이 빠를 수 있다. 예측은 다수결로 정한다.
model = OneVsOneClassifier(LogisticRegression(max_iter=1000))
model.fit(X_train, y_train)
y_pred = model.predict(X_test)

# C = 3이므로 이항 분류기는 C(C-1)/2 = 3개다
print(f"이항 분류기 개수: {len(model.estimators_)}")
print(f"검정 정확도: {(y_pred == y_test).mean():.4f}")

# 각 쌍이 실제로 몇 개의 사례로 학습되었는지 센다.
counts = np.bincount(y_train)
print(f"훈련 자료 {len(y_train)}개,  범주별 {counts}")
for a, b in combinations(range(3), 2):
    m = counts[a] + counts[b]
    print(f"  f_{a}{b}: {m}개  (전체의 {m / len(y_train):.3f})")

# 다수결의 상한을 확인한다. decision_function 은 표 수에 확신도를
# 아주 작게 섞은 값이므로 반올림하면 표 수가 된다.
votes = np.floor(model.decision_function(X_test) + 0.5).astype(int)
print(f"표 수의 최댓값 {votes.max()},  행별 표 합 {set(votes.sum(axis=1))}")
출력:
이항 분류기 개수: 3
검정 정확도: 1.0000
훈련 자료 105개,  범주별 [35 35 35]
  f_01: 70개  (전체의 0.667)
  f_02: 70개  (전체의 0.667)
  f_12: 70개  (전체의 0.667)
표 수의 최댓값 2,  행별 표 합 {3}
셈이 모두 맞는다. 분류기 \(3\)개, 각 \(70\)개 사례로 전체의 \(0.667 = 2/3\), 표의 총합은 모든 검정점에서 예외 없이 \(3\)이고 최댓값은 \(2 = C-1\)이다. 검정 정확도는 \(1.0000\)으로 \(45\)개를 모두 맞혔다.
눈여겨볼 것은 앞 절의 OvR이 똑같은 분할에서 \(0.9333\)을 냈다는 점이다. 틀린 \(3\)개는 모두 참값이 versicolor인데 virginica로 예측된 것이다. 가운데에 놓인 versicolor를 OvR은 "versicolor 대 setosa \(\cup\) virginica"라는 선형으로 분리되지 않는 문제로 풀어야 하지만, OvO는 그 범주를 한 번에 하나씩만 상대하므로 그런 부담이 없다. 다만 소프트맥스도 같은 분할에서 \(1.0000\)을 내니, 이 한 번의 비교가 OvO의 우월함을 말해 주지는 않는다. 검정 사례가 \(45\)개뿐이어서 \(0.9333\)과 \(1.0000\)의 차이가 세 사례에 걸려 있다는 것도 함께 기억해야 한다. 전략 사이의 체계적인 비교는 소프트맥스와의 비교에 있다.
SVM에서는 OvO가 SVC의 기본 동작이므로 별도의 래퍼가 필요 없다.
OvO, OvR, 고유 소프트맥스 회귀 중 무엇을 고를지는 소프트맥스와의 비교를 보라.
연습문제
연습문제 1. \(C = 3, 10, 26, 100, 1000\)에 대해 OvO 분류기의 개수를 계산하고 OvR의 \(C\)개와 비교하라. 전체 학습에 처리되는 사례의 총 개수도 두 방식에 대해 각각 구하라.
풀이
| \(C\) | OvR 분류기 | OvO 분류기 | 비율 |
|---|---|---|---|
| 3 | 3 | 3 | \(1.0\) |
| 10 | 10 | 45 | \(4.5\) |
| 26 | 26 | 325 | \(12.5\) |
| 100 | 100 | 4,950 | \(49.5\) |
| 1000 | 1,000 | 499,500 | \(499.5\) |
비율은 \(\frac{C(C-1)/2}{C} = \frac{C-1}{2}\)로 \(C\)에 선형으로 증가한다.
처리되는 사례의 총 개수. 범주가 균형 잡혀 각 범주에 \(n/C\)개가 있다고 하자.
- OvR: 분류기마다 전체 \(n\)개를 쓰므로 총 \(C \cdot n = Cn\).
- OvO: 분류기마다 \(2n/C\)개를 쓰고 분류기가 \(C(C-1)/2\)개이므로
$$ \frac{C(C-1)}{2}\cdot\frac{2n}{C} = (C-1)\,n $$
두 값이 거의 같다는 점이 흥미롭다. \(Cn\) 대 \((C-1)n\)으로 차이가 1인 인자뿐이다. 이는 우연이 아니다. 각 사례는 OvR에서 \(C\)개 분류기 모두에 나타나고, OvO에서는 자기 범주가 참여하는 \(C-1\)개 분류기에 나타난다.
따라서 학습 비용의 차이는 사례 수가 아니라 비용함수의 모양에서 온다. \(T\)가 \(n\)에 선형이면 두 방식이 비슷하고, \(T\)가 초선형이면 작은 문제 여러 개(OvO)가 큰 문제 몇 개(OvR) 보다 싸다. \(T(m) = m^2\)이라면 OvR은 \(C n^2\), OvO는 \(\frac{C(C-1)}{2}(2n/C)^2 = \frac{2(C-1)n^2}{C} \approx 2n^2\)으로, OvO가 \(C/2\)배 빠르다. \(\square\)
연습문제 2. 위 보기의 투표 결과를 쌍별 승패 관계로 정리하라. 일관된 순위가 존재하는가?
풀이
승패 관계를 정리하면
이다. 여기서 \(A \succ B\)는 "쌍별 대결에서 A가 B를 이겼다"는 뜻이다.
일관된 순위는 없다. 실제로
라는 순환이 존재한다. A가 B를 이기고, B가 D를 이기고, D가 A를 이긴다. 이런 순환이 있으면 "A가 B보다 낫고 B가 D보다 낫다"에서 "A가 D보다 낫다"를 이끌어 낼 수 없으므로, 범주들을 한 줄로 세우는 어떤 순위도 이 승패표와 일치하지 않는다.
이는 사회선택이론의 콩도르세 역설과 정확히 같은 현상이다. 쌍별 다수결이 개별적으로는 합리적이면서 전체적으로는 이행성을 잃을 수 있다는 것이다.
OvO에 대한 함의.
- 동점은 우연한 사고가 아니라 구조적으로 발생한다. \(C \ge 3\)이면 순환이 가능하고, 순환이 있으면 반드시 동점이 생긴다.
- 따라서 동점 처리 규칙은 부수적인 세부사항이 아니라 알고리즘의 필수 구성요소다.
- 확신도의 합으로 동점을 처리하는 것이 색인 순서보다 나은 이유도 여기 있다. 순환이 있을 때 이항 분류기들이 얼마나 확신했는지가 유일하게 남은 정보이기 때문이다.
- 소프트맥스에는 이 문제가 없다. 하나의 점수 벡터 \(\mathbf{z}\)가 항상 전순서를 정의하므로 순환이 원리적으로 불가능하다. \(\square\)
연습문제 3. 균형 잡힌 범주에서 OvO 각 부분문제의 표본 크기가 \(2n/C\)임을 보여라. 범주가 불균형하면 어떻게 되는가?
풀이
범주 \(c\)의 크기를 \(n_c\)라 하면 분류기 \(f_{c,c'}\)의 훈련 표본은 \(n_c + n_{c'}\)개다.
균형 잡힌 경우. 모든 \(n_c = n/C\)이므로
이다. 모든 부분문제의 크기가 정확히 같다.
불균형한 경우. 부분문제의 크기가 \(n_c + n_{c'}\)로 쌍마다 달라진다. 더 중요한 것은 각 부분문제 안에서의 균형이다. 이항 문제의 양성 비율은 \(n_c/(n_c + n_{c'})\)이므로, 두 범주의 크기가 크게 다르면 그 쌍은 여전히 불균형하다.
예를 들어 \(n_A = 10{,}000\), \(n_B = 100\)이면 \(f_{A,B}\)의 양성 비율이 \(99\%\)다. 다만 이는 OvR보다는 훨씬 나은 상황이다. OvR에서 범주 B의 분류기는 \(100\) 대 \(10{,}000+\cdots\)를 상대해야 하기 때문이다.
OvO의 실질적 이점. 범주 크기의 최대/최소 비가 \(r\)이면, OvO 부분문제의 불균형은 최악의 경우에도 \(r\)을 넘지 않는다. 반면 OvR에서 가장 작은 범주의 불균형은 \((n - n_{\min})/n_{\min}\)으로, 범주 수가 많아지면 \(r\)보다 훨씬 커진다. 이것이 표에서 "범주 불균형: OvR보다 덜 심각"이라고 한 이유다. \(\square\)
연습문제 4. 예측 시점의 계산 비용을 OvR, OvO, 소프트맥스에 대해 비교하라. \(C = 1000\), \(p = 512\)일 때 각각 몇 번의 곱셈이 필요한가?
풀이
입력 하나를 분류하는 데 필요한 내적 계산은,
| 방식 | 평가할 분류기 | 곱셈 횟수 |
|---|---|---|
| 소프트맥스 | 1개(행렬곱) | \(pC\) |
| OvR | \(C\)개 | \(pC\) |
| OvO | \(C(C-1)/2\)개 | \(p\,C(C-1)/2\) |
소프트맥스와 OvR은 곱셈 횟수가 같다. 소프트맥스가 한 번의 행렬곱 \(\mathbf{x}^\top\mathbf{W}\)(\(p \times C\))로 처리하는 것을 OvR은 \(C\)번의 내적으로 나누어 할 뿐이다. 실제로는 행렬곱이 BLAS로 최적화되어 있어 소프트맥스가 상수배 빠르다.
\(C = 1000\), \(p = 512\)일 때:
| 방식 | 곱셈 횟수 |
|---|---|
| 소프트맥스 | \(512 \times 1000 = 5.12 \times 10^5\) |
| OvR | \(5.12 \times 10^5\) |
| OvO | \(512 \times 499{,}500 = 2.56 \times 10^8\) |
OvO가 500배 비싸다. 게다가 모형 저장 공간도 그만큼 커서, 각 이항 모형이 \(p+1\)개의 실수를 가지면 OvO 전체가 \(499{,}500 \times 513 \approx 2.6 \times 10^8\)개의 모수, 배정도로 2GB가 넘는다.
결론: 범주 수가 많으면 OvO는 실용적이지 않다. OvO가 매력적인 것은 \(C\)가 작고(\(\le 10\) 정도) 기저 알고리즘의 학습 비용이 \(n\)에 초선형일 때뿐이다. 그마저도 학습 시간의 이야기이며, 예측 비용은 언제나 OvO가 가장 나쁘다. \(\square\)
연습문제 5. OvO에서 확률 추정을 얻으려면 어떻게 해야 하는가? 쌍별 확률 \(r_{cc'} = P(y = c \mid y \in \{c,c'\}, \mathbf{x})\) 로부터 \(p_c = P(y = c \mid \mathbf{x})\)를 복원하는 문제를 논하라.
풀이
쌍별 분류기가 확률을 낸다면 \(r_{cc'} \approx \dfrac{p_c}{p_c + p_{c'}}\)가 성립해야 한다. 미지수는 \(p_1, \ldots, p_C\)(\(C-1\)개의 자유도)인데 방정식은 \(C(C-1)/2\)개이므로, \(C \ge 3\)이면 과결정계다. 쌍별 추정치가 서로 완벽히 일관되지 않으면 정확한 해가 없다.
표준 해법(하스티-팁시라니 결합, 그리고 우와 린 확장). 다음을 푼다.
이는 쌍별 추정치에 가장 잘 맞는 확률벡터를 찾는 것이며, 반복 알고리즘으로 푼다.
scikit-learn의 SVC(probability=True)가 내부적으로 이 방식을 쓴다.
문제점 세 가지.
- 비쌈. 예측마다 반복 최적화를 풀어야 한다.
- 불일치가 정보를 담고 있다. 쌍별 추정치가 서로 크게 어긋난다는 것은 모형이 이 입력을 잘 다루지 못한다는 신호인데, 결합 과정에서 그 정보가 하나의 확률벡터로 뭉개진다. 연습문제 2의 순환이 극단적인 예다.
- 보정이 이중으로 필요하다. 각 쌍별 분류기의 \(r_{cc'}\)가 이미 잘 보정되어 있어야 결합 결과도 보정된다. 각각을 플랫 척도화로 보정한 뒤 다시 결합해야 한다.
대조: 소프트맥스는 확률을 직접 최적화 대상으로 삼는다. 복원 문제도, 과결정계도, 이중 보정도 없다. 확률이 필요한 응용에서 고유 소프트맥스를 선호하는 가장 강한 이유다. \(\square\)
정리하며
일대일은 범주 쌍마다 분류기를 둔다.
- \(\binom C2\) 개의 분류기가 필요하다. \(C=10\) 이면 45 개로, 일대다의 10 개보다 훨씬 많다.
- 그런데 각각이 작다. 두 범주의 자료만 쓰므로 개별 학습이 빠르며, 학습 시간이 범주 수에 대해 초선형으로 늘지 않는 경우가 많다. SVM 처럼 학습 비용이 표본 크기에 초선형인 알고리즘에서 특히 유리하다.
- 예측은 다수결이다. 각 분류기가 한 표씩 던지며, 동점 처리 규칙이 필요하다.
- 불균형 문제가 덜하다. 두 범주만 비교하므로 일대다의 구조적 불균형이 없다.
- 관련 없는 분류기도 투표한다는 것이 약점이다. 실제 범주가 3 인 사례에 대해 "1 대 2" 분류기도 표를 던지며, 그것이 잡음이 된다.
이것으로 20장이 끝난다. 이항에서 다범주로의 확장, 소프트맥스와 교차엔트로피, 최적화와 정칙화, 다범주 평가지표, 그리고 일대다·일대일 전략까지 보았다.
다음 장 생존 모형으로 넘어간다. 반응이 사건까지의 시간이며, 아직 사건이 일어나지 않은 관측을 어떻게 다루느냐가 핵심이다.