일반 OLS 추정량의 표집분포
개요
이 절은 단순선형회귀의 추론 결과를 행렬 표기를 써서 다중선형회귀 상황으로 확장한다. OLS 계수벡터 \(\hat{\beta}\), 잔차분산 추정량 \(s^2\), 개별 계수를 검정하는 \(t\) 통계량의 표집분포를 유도한다.
준비: 다중선형회귀 모형
행렬 형태의 모형을 생각하자.
여기서
- \(\mathbf{y}\)는 \(N \times 1\) 반응벡터,
- \(\mathbf{X}\)는 \(N \times (p+1)\) 설계행렬(절편 열을 포함한다),
- \(\beta\)는 \((p+1) \times 1\) 미지 계수벡터,
- \(\varepsilon \sim N(\mathbf{0}, \sigma^2 I_N)\)는 오차벡터이다.
OLS 추정량은
1. 베타 추정량의 표집분포
정리
선형회귀 모형의 가정 아래에서
곧 \(\hat{\beta}\)는 다음의 정규분포를 따른다.
- 평균: \(E(\hat{\beta}) = \beta\) (불편),
- 공분산: \(\text{Var}(\hat{\beta}) = \sigma^2 (\mathbf{X}^\top \mathbf{X})^{-1}\).
증명
OLS 공식에 \(\mathbf{y} = \mathbf{X}\beta + \varepsilon\)을 대입하면
불편성: \(E(\varepsilon) = \mathbf{0}\)이므로
공분산: \(\mathbf{A} = (\mathbf{X}^\top \mathbf{X})^{-1} \mathbf{X}^\top\)라 두면 \(\hat{\beta} - \beta = \mathbf{A}\varepsilon\)이고
\(\mathbf{A}\mathbf{A}^\top\)를 계산하면
따라서 \(\text{Var}(\hat{\beta}) = \sigma^2(\mathbf{X}^\top\mathbf{X})^{-1}\)이다.
정규성: \(\hat{\beta} - \beta = \mathbf{A}\varepsilon\)은 다변량정규벡터 \(\varepsilon\)의 선형변환이므로 \(\hat{\beta}\) 자체도 다변량정규이다. \(\square\)
함의
이 결과는 다중회귀의 모든 추론의 토대가 된다. 개별 계수의 신뢰구간, 결합 신뢰영역, 가설검정, 예측구간이 모두 이 분포 결과에서 따라 나온다.
2. s 제곱의 표집분포
정리
잔차분산 추정량
의 표집분포는 다음과 같다.
동등하게
주요 성질
불편성: \(E(s^2) = \sigma^2\)이므로 \(s^2\)은 오차분산의 불편추정량이다.
자유도: 자유도 \(N - p - 1\)은 관측값 \(N\)개에서 추정한 모수 \(p + 1\)개를 뺀 것을 반영한다.
\(\hat{\beta}\)와의 독립성: 정규성 가정 아래에서 \(s^2\)과 \(\hat{\beta}\)는 통계적으로 독립이다. 이 독립성은 \(t\) 검정이 타당하기 위한 필수 조건이다.
증명
1단계: 잔차를 사영으로 표현. 모자행렬 \(\mathbf{P} = \mathbf{X}(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\)와 잔차생성행렬 \(\mathbf{M} = I_N - \mathbf{P}\)를 정의하자. 잔차벡터는
마지막 등식에는 \(\mathbf{M}\mathbf{X} = \mathbf{0}\)을 썼다.
2단계: 잔차제곱합을 이차형식으로.
\(\mathbf{M}\)이 대칭이고 멱등(\(\mathbf{M}^2 = \mathbf{M}\))이기 때문이다.
3단계: 카이제곱분포. \(\varepsilon \sim N(\mathbf{0}, \sigma^2 I_N)\)이고 \(\mathbf{M}\)이 계수 \(\text{tr}(\mathbf{M}) = N - (p+1) = N - p - 1\)인 대칭 멱등행렬이므로
4단계: 결론. 자유도로 나누면
3. 개별 회귀계수의 t 통계량
정리
귀무가설 \(H_0: \beta_j = 0\) 아래에서 검정통계량
이다. 여기서 \(v_j = \left((\mathbf{X}^\top\mathbf{X})^{-1}\right)_{jj}\)는 \((\mathbf{X}^\top\mathbf{X})^{-1}\)의 \(j\)번째 대각원소이다.
해석
\(t\) 통계량 \(t_j\)는 다른 모든 설명변수를 고려한 뒤에도 \(j\)번째 설명변수가 모형에 기여하는지를 검정한다. 절댓값이 크면 \(\beta_j \neq 0\)이라는 증거, 곧 \(j\)번째 변수가 \(y\)에 통계적으로 유의한 부분효과를 갖는다는 증거가 된다.
분모 \(s\sqrt{v_j}\)가 \(\hat{\beta}_j\)의 표준오차이다.
증명
1단계: \(H_0\) 아래 \(\hat{\beta}_j\)의 분포. \(\hat{\beta}\)의 표집분포에서 각 성분은
\(H_0: \beta_j = 0\) 아래에서는
2단계: 분모의 독립 카이제곱. \(s^2\)의 분포에서
이고 이는 \(\hat{\beta}_j\)와 독립이다(\(\hat{\beta}\)는 \(\mathbf{P}\varepsilon\)에, \(s^2\)은 \(\mathbf{M}\varepsilon\)에 의존하며 \(\mathbf{PM} = \mathbf{0}\)이기 때문이다).
3단계: \(t\) 비 만들기. \(t\) 분포의 정의에 따라
일반 신뢰구간
\(\beta_j\)에 대한 \((1 - \alpha)\) 신뢰구간은
개별 구간이 놓치는 것
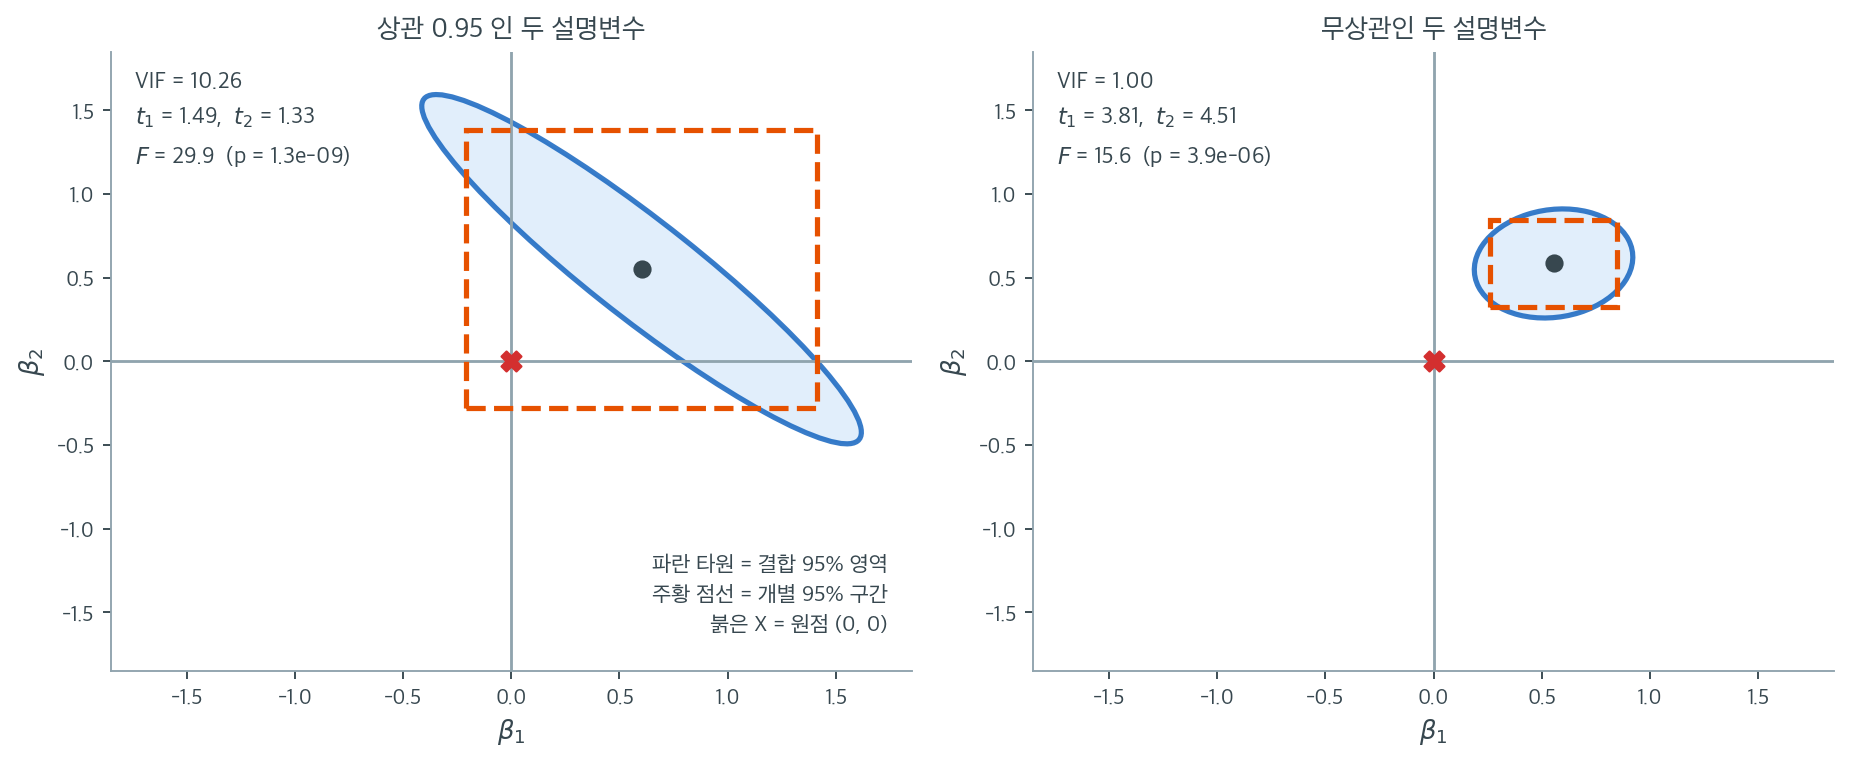
개별 \(t\) 검정을 나란히 늘어놓으면 마치 계수들을 하나씩 따로 본 것처럼 느껴진다. 그러나 \((\mathbf{X}^\top\mathbf{X})^{-1}\)의 비대각 원소가 0이 아닌 한 추정값들은 서로 얽혀 있고, 그 얽힘은 개별 구간에 전혀 나타나지 않는다. 위 그림이 그 어긋남이다. 두 패널 모두 \(n = 60\), 참 계수 \(\beta_1 = \beta_2 = 0.6\), \(\sigma = 1\)로 같고 다른 것은 두 설명변수의 상관뿐이다. 파란 타원이 \((\beta_1, \beta_2)\)의 결합 95% 신뢰영역이고, 주황 점선 네모는 두 개별 95% 신뢰구간을 곱해 만든 직사각형이며, 붉은 X가 원점 \((0, 0)\)이다.
왼쪽은 두 설명변수의 상관이 \(0.95\)인 경우다. VIF \(= 1/(1-0.95^2) = 10.26\)이므로 표준오차가 공선이 없을 때의 \(\sqrt{10.26} \approx 3.2\)배로 부풀어 \(\mathrm{SE}\)가 \(0.404\)와 \(0.415\)가 되었고, \(t_1 = 1.49\), \(t_2 = 1.33\)으로 둘 다 유의하지 않다. 그런데 두 계수가 동시에 0이라는 결합가설의 \(F\) 검정은 \(F = 29.9\), \(p = 1.3\times10^{-9}\)로 압도적으로 기각된다. 그림이 그 모순을 풀어 준다. 붉은 X는 주황 네모 안에 있지만(각 계수를 따로 보면 0이 배제되지 않는다) 파란 타원 밖에 있다(두 계수가 동시에 0인 것은 배제된다). 타원이 오른쪽 아래로 길게 누운 것은 \(\hat{\beta}_1\)과 \(\hat{\beta}_2\)의 상관이 \(-0.95\)라는 뜻이다. 자료는 \(\beta_1 + \beta_2\)가 얼마인지는 아주 잘 알지만 그 합을 둘로 어떻게 나눌지는 거의 모른다.
오른쪽은 같은 실험을 상관 0인 설계로 한 것이다. VIF \(= 1.00\)이고 표준오차가 \(0.146\), \(0.130\)으로 3분의 1 안팎까지 줄어 \(t_1 = 3.81\), \(t_2 = 4.51\)이 되었다. 타원이 거의 원에 가깝고 네모와 포개져, 개별 구간을 보나 결합 영역을 보나 결론이 같다. 비대각 원소가 0일 때만 개별 구간을 나란히 읽어도 된다는 것을 이 대비가 말해 준다. 그러므로 회귀표에서 모든 \(t\)가 작다는 이유로 "쓸모 있는 변수가 없다"고 결론짓기 전에, 전체 \(F\) 검정과 설명변수들 사이의 상관을 반드시 함께 보아야 한다.
문제: 선형회귀 출력 재현
문제 1.
Advertising 자료를 써서 모형 \(\text{Sales} \sim \text{TV} + \text{Radio} + \text{Newspaper}\)의 주요 회귀 출력 — 계수, 표준오차, \(t\) 통계량, \(p\)값, 신뢰구간 — 을 밑바닥부터 계산해 재현하라.
풀이
구현
import numpy as np
import pandas as pd
from scipy import stats

# 광고비와 매출 자료를 읽는다
dataset_url = (
    'https://raw.githubusercontent.com/justmarkham/'
    'scikit-learn-videos/8545c74961398def7724501648fd504dbf061b41/data/Advertising.csv'
)
advertising_data = pd.read_csv(dataset_url, usecols=[1, 2, 3, 4])

# 훈련 70%, 시험 30% 로 나눈다
total_observations = advertising_data.shape[0]
test_set_ratio = 0.3
train_count = int(total_observations * (1 - test_set_ratio))
training_data = advertising_data.iloc[:train_count]

# 반응벡터 y 와 설계행렬 X. 첫 열의 1 이 절편에 대응한다
y = np.array(training_data.Sales).reshape(-1, 1)
n = y.shape[0]
X = np.concatenate(
    (np.ones((n, 1)), np.array(training_data.iloc[:, :-1])),
    axis=1
)
p_plus_1 = X.shape[1]  # number of parameters (including intercept)

# 최소제곱해: beta_hat = (X'X)^-1 X'y
beta_hat = np.linalg.inv(X.T @ X) @ X.T @ y

# 적합값과 잔차 표준오차
y_hat = X @ beta_hat
s = np.sqrt(np.sum((y - y_hat) ** 2) / (n - p_plus_1))

# 분산-공분산 행렬 (X'X)^-1. 계수의 표준오차가 여기 대각선에서 나온다
cov_matrix = np.linalg.inv(X.T @ X)

# 회귀 출력표를 찍는다
print("=" * 100)
print("\t\t    coef    std err \t     t      P>|t|"
      "     [0.025      0.975] ")
print("-" * 100)

variable_names = ["Intercept", "TV", "Radio", "Newspaper"]

for name, j in zip(variable_names, range(p_plus_1)):
    coef = beta_hat[j, 0]
    v_j = cov_matrix[j, j]
    se = s * np.sqrt(v_j)
    t_stat = coef / se
    p_val = 2 * stats.t(n - p_plus_1).sf(np.abs(t_stat))
    ci_lower = coef - stats.t(n - p_plus_1).ppf(0.975) * se
    ci_upper = coef + stats.t(n - p_plus_1).ppf(0.975) * se
    print(f"{name:10}    {coef:10.4f} {se:10.3f} "
          f"{t_stat:10.3f} {p_val:10.3f} "
          f"{ci_lower:10.3f} {ci_upper:10.3f}")

print("=" * 100)
출력:
====================================================================================================
            coef    std err          t      P>|t|     [0.025      0.975]
----------------------------------------------------------------------------------------------------
Intercept         3.0451      0.391      7.782      0.000      2.271      3.819
TV                0.0470      0.002     27.653      0.000      0.044      0.050
Radio             0.1797      0.011     16.665      0.000      0.158      0.201
Newspaper        -0.0030      0.007     -0.428      0.669     -0.017      0.011
====================================================================================================
계수마다 추정값, 표준오차, \(t\), p-값을 나란히 놓은 표다. \(t = \hat\beta / \text{SE}(\hat\beta)\)라는 정의를 표에서 직접 확인할 수 있다.
출력(훈련자료 140개 관측값):
                coef    std err        t      P>|t|     [0.025      0.975]
Intercept     3.0451      0.391      7.782      0.000      2.271      3.819
TV            0.0470      0.002     27.653      0.000      0.044      0.050
Radio         0.1797      0.011     16.665      0.000      0.158      0.201
Newspaper    -0.0030      0.007     -0.428      0.669     -0.017      0.011
이 값들은 statsmodels의 sm.ols('Sales ~ TV + Radio + Newspaper', train_data).fit().summary()가 내놓는 표와 정확히 일치한다.
출력 읽기
회귀표의 각 행은 다음을 담고 있다.
- coef: OLS 추정값 \(\hat{\beta}_j\).
- std err: 표준오차 \(s\sqrt{v_j}\). 여기서 \(v_j = ((\mathbf{X}^\top\mathbf{X})^{-1})_{jj}\)이다.
- t: \(t\) 통계량 \(t_j = \hat{\beta}_j / (s\sqrt{v_j})\).
- P>|t|: \(t_{N-p-1}\)에서 얻은 양측 \(p\)값.
- [0.025, 0.975]: 95% 신뢰구간 \(\hat{\beta}_j \pm t_{N-p-1}(0.975) \cdot s\sqrt{v_j}\).
\(p\)값이 0.05보다 작으면, 동등하게 95% 신뢰구간이 0을 포함하지 않으면 그 설명변수는 유의수준 5%에서 통계적으로 유의하다. 위 표에서 Newspaper는 \(p = 0.669\)이고 신뢰구간 \((-0.017, 0.011)\)이 0을 포함하므로 유의하지 않다.
참고
연습문제
연습문제 1. 설명변수가 \(p = 4\)개이고 \(n = 50\)인 다중회귀에서 개별 계수의 \(t\) 검정과 전체 유의성 \(F\) 검정의 자유도를 유도하라.
풀이
-
개별 계수 \(\beta_j\)의 \(t\) 검정: \(H_0: \beta_j = 0\) 아래에서 \(t = \hat{\beta}_j / \text{SE}(\hat{\beta}_j) \sim t_{n-p-1} = t_{45}\)이다.
-
전체 유의성 \(F\) 검정: \(H_0: \beta_1 = \beta_2 = \beta_3 = \beta_4 = 0\)을 검정한다. \(H_0\) 아래에서 \(F = (\text{SSR}/p) / (\text{SSE}/(n-p-1)) \sim F_{p, n-p-1} = F_{4, 45}\)이다.
연습문제 2. 어떤 회귀 출력에서 설명변수 \(X_3\)이 \(\hat{\beta}_3 = 2.1\), \(p = 0.04\)였는데, 모형에 \(X_4\)를 넣으니 \(\hat{\beta}_3\)이 \(0.3\)으로 바뀌고 \(p = 0.72\)가 되었다. 이 현상을 설명하라.
풀이
다중공선성 또는 교란의 결과이다. \(X_4\)를 넣으면
-
\(X_3\)과 \(X_4\)가 상관되어 있다면 \(X_4\)가 이전에 \(X_3\)이 설명하던 변동을 "흡수"한다. (\(X_4\)를 고정한) \(X_3\)의 부분효과는 (\(X_4\)를 무시한) 주변효과보다 훨씬 작다.
-
다중공선성 때문에 \(\hat{\beta}_3\)의 표준오차가 커지고(VIF가 커지고) \(t\) 통계량이 더욱 작아진다.
이는 계수 추정값과 그 유의성이 모형에 어떤 다른 설명변수가 들어 있는지에 달려 있음을 보여준다. 유의하던 것이 유의하지 않게 바뀌었다는 것은 \(X_3\)의 겉보기 효과가 부분적으로(또는 상당 부분) \(X_4\)와의 상관에서 비롯되었음을 시사한다.
연습문제 3. 전체 모형의 \(F\) 검정이 유의하더라도 어떤 개별 설명변수의 \(t\) 검정이 유의하리라는 보장은 없다. 그 이유를 설명하고 개념적인 예를 구성하라.
풀이
\(F\) 검정은 결합가설 \(H_0: \beta_1 = \cdots = \beta_p = 0\)을 검정한다. 개별 \(t\) 검정은 각 \(\beta_j = 0\)을 따로 검정한다. 설명변수들이 강하게 상관되어 있으면 둘은 어긋날 수 있다.
예: 상관이 \(r = 0.95\)인 두 설명변수 \(X_1\)과 \(X_2\)가 모두 \(Y\)를 잘 예측한다고 하자. 둘이 함께 상당한 분산을 설명하므로 \(F\) 검정은 유의하다. 그러나 개별적으로는 공유된 분산이 둘로 갈라지고 다중공선성으로 표준오차가 부풀려져(\(\text{VIF} = 1/(1-0.95^2) \approx 10.3\)) 두 \(t\) 검정 모두 유의하지 않을 수 있다. 어느 쪽도 상대를 넘어서는 기여를 별로 하지 못하지만, 함께 보면 분명히 중요하다.
정리하며
다중회귀의 추론을 행렬 표기로 일반화했다.
- \((\mathbf X^\top\mathbf X)^{-1}\) 의 대각원소가 각 계수의 분산을 준다. 비대각 원소는 계수들 사이의 공분산이며, \(0\) 이 아니면 추정값들이 얽혀 있다.
- \(s^2=\text{RSS}/(n-p-1)\) 이 \(\sigma^2\) 의 불편추정량이다. 자유도가 추정한 모수 수만큼 줄어든다.
- 개별 \(t\) 검정은 "다른 변수를 모두 넣은 상태에서" 그 변수가 필요한가를 묻는다. 그래서 변수들이 공선이면 둘 다 개별적으로는 유의하지 않은데 함께 넣으면 \(F\) 가 유의한 일이 생긴다.
- \(F\) 검정과 \(t\) 검정은 다른 물음이다. \(F\) 는 전체 모형, \(t\) 는 개별 계수다.
- 다중검정 문제가 여기에도 있다. 계수 \(p\) 개를 각각 검정하면 9장의 논의가 그대로 적용된다.
다음 절 기울기 신뢰구간 보기로 넘어간다.