사례 연구: 절단점 하나가 결론을 바꾼다
앞 절에서는 성별과 생존을 보았다. 성별은 자연히 둘로 나뉘어 있어서 분할표를 만드는 데 아무 선택도 필요 없었다.
이번에는 나이를 본다. 나이는 연속형이므로 분할표를 만들려면 어딘가에서 잘라야 하고, 어디서 자를지는 분석자가 정한다. 이 절의 질문은 그래서 두 겹이다.
나이와 생존은 관계가 있는가? 그리고 그 답은 절단점에 얼마나 의존하는가?
결론부터 말하면 두 번째 질문의 답이 놀랍다. 같은 자료, 같은 질문인데 절단점에 따라 두 집단의 생존율 차이가 \(+46\)%포인트에서 \(+0.02\)%포인트까지 움직인다. 이 절은 그 이유를 다룬다.
앞 절과 이어 읽기
자료와 도구는 타이타닉 생존과 성별 절과 같다. 분할표와 오즈비를 읽는 법은 거기에 설명해 두었으므로 여기서는 되풀이하지 않는다.
다른 것은 이야기다. 앞 절이 "하나의 표를 다섯 가지로 요약하기"였다면, 이 절은 "표 자체를 어떻게 만들 것인가"다.
이 절도 탐색까지만 한다. 절단점을 훑어보고 가장 좋은 것을 고르면 어떤 일이 벌어지는지는 확률과 검정이 필요하며, p-해킹 시연 - 타이타닉 절단점 탐색 절에서 다룬다.
1. 절단점 21에서 시작한다
보기 1. 스물한 살을 기준으로 나누면. 나이가 기록된 \(714\)명을 \(21\)세에서 둘로 가른다.
(1) 두 집단의 생존율과 그 차이, 오즈비를 유리수로 구하시오.
(2) 어린 쪽의 비율을 \(\pi\), 전체 생존율을 \(\bar y\)라 할 때 파이 계수가
임을 보이시오. 이 식이 이 절 전체를 설명한다.
풀이
(1) 해석적으로. 네 칸의 도수가 어린 쪽 생존 \(82\)·사망 \(98\), 나이 든 쪽 생존 \(208\)·사망 \(326\)이다. 그러므로
이고 차이는 \(0.066042\)다. 오즈비는 대각선 곱의 비이므로
이다.
(2) 해석적으로. \(X = \mathbf 1(\text{나이} < c)\), $Y = $ 생존 여부로 둔다. 둘 다 \(0/1\)이므로 앞 절 보기 2에서처럼 평균이 곧 비율이고 분산이 \(p(1-p)\)다.
(마지막 식은 \(XY = 1\)인 사람이 "어리고 살아남은" 사람뿐이기 때문이다.) 그러므로 공분산이
인데, 전체 생존율이 두 집단의 가중평균 \(\bar y = \pi r_{<c} + (1-\pi) r_{\ge c}\)이므로
이다. 둘을 합치면 공분산이 깔끔해진다.
표준편차는 \(s_X = \sqrt{\pi(1-\pi)}\), \(s_Y = \sqrt{\bar y(1-\bar y)}\)이므로
를 얻는다.
이 식이 이 절의 열쇠다. \(\varphi\)는 생존율 차이 \(\Delta\)를 그대로 쓰지 않고 \(\sqrt{\pi(1-\pi)}\)만큼 줄여서 쓴다. 절단점을 양 끝으로 밀면 \(\pi\)가 \(0\)이나 \(1\)에 가까워져 이 계수가 \(0\)으로 내려가므로, \(\Delta\)가 아무리 커도 \(\varphi\)는 커지지 않는다. 4절에서 "차이가 \(46\)%포인트"인 절단점이 나오는데도 연관이 강해 보이지 않는 까닭이 바로 이것이다.
수를 넣어 보면 \(\pi = 180/714 = 0.252101\), \(\bar y = 0.406162\)이므로
이다.
(3) 수치적으로.
import warnings
warnings.filterwarnings("ignore")

import numpy as np
import pandas as pd

URL = ("https://raw.githubusercontent.com/datasciencedojo/"
       "datasets/f0ccab6a7ceafdff780052166fb6fab3311398eb/titanic.csv")
df = pd.read_csv(URL, index_col="PassengerId")

# 나이가 없는 177명은 이 절의 분석에서 아예 쓸 수 없다.
# 앞 절 연습문제 3에서 보았듯 이들은 무작위로 빠진 것이 아니다.
d = df.dropna(subset=["Age"]).copy()
print(f"전체 {len(df)}명 중 나이가 있는 {len(d)}명으로 분석한다")
print(f"나이 범위 {d['Age'].min():.2f} ~ {d['Age'].max():.2f}세\n")

CUT = 21                                   # ← 이 한 줄이 이 절의 주제다
d["Age_Group"] = np.where(d["Age"] < CUT, f"<{CUT}", f">={CUT}")
ORDER = [f"<{CUT}", f">={CUT}"]

tab = pd.crosstab(d["Age_Group"], d["Survived"]).reindex(ORDER)
print("도수")
print(tab.to_string())

pct = pd.crosstab(d["Age_Group"], d["Survived"],
                  normalize="index").reindex(ORDER) * 100
print("\n집단 안에서의 생존율 (%)")
print(pct.round(2).to_string())

lo = d["Age"] < CUT
r_lo, r_hi = d.loc[lo, "Survived"].mean(), d.loc[~lo, "Survived"].mean()
print(f"\n{CUT}세 미만 {lo.sum():3d}명  생존율 {r_lo:.4f}")
print(f"{CUT}세 이상 {(~lo).sum():3d}명  생존율 {r_hi:.4f}")
print(f"차이 {r_lo - r_hi:+.4f}")

print(f"\n상관계수(파이) {np.corrcoef(d['Survived'], lo.astype(int))[0, 1]:+.4f}")

a, b = tab.iloc[0, 1], tab.iloc[0, 0]      # 어린 쪽 생존/사망
c, e = tab.iloc[1, 1], tab.iloc[1, 0]      # 나이 든 쪽 생존/사망
print(f"오즈비 {(a * e) / (b * c):.4f}")

# --- 파이 계수를 생존율 차이로부터 다시 만들어 본다 ---
# phi = sqrt(pi(1-pi)) / sqrt(ybar(1-ybar)) * (r_lo - r_hi),  pi = 어린 쪽 비율
n = len(d)
pi = lo.sum() / n
ybar = d["Survived"].mean()
print(f"\npi = {lo.sum()}/{n} = {pi:.6f},  ybar = {ybar:.6f}")
print(f"  sqrt(pi(1-pi))       = {np.sqrt(pi * (1 - pi)):.6f}")
print(f"  sqrt(ybar(1-ybar))   = {np.sqrt(ybar * (1 - ybar)):.6f}")
print(f"  차이 Delta           = {r_lo - r_hi:.6f}")
print(f"  식이 주는 phi        = {np.sqrt(pi * (1 - pi)) / np.sqrt(ybar * (1 - ybar)) * (r_lo - r_hi):.6f}")
print(f"  numpy 가 준 phi      = {np.corrcoef(d['Survived'], lo.astype(int))[0, 1]:.6f}")
print(f"  오즈비를 유리수로     = {a * e}/{b * c} = {(a * e) / (b * c):.6f}")
전체 891명 중 나이가 있는 714명으로 분석한다
나이 범위 0.42 ~ 80.00세

도수
Survived     0    1
Age_Group
<21         98   82
>=21       326  208

집단 안에서의 생존율 (%)
Survived       0      1
Age_Group
<21        54.44  45.56
>=21       61.05  38.95

21세 미만 180명  생존율 0.4556
21세 이상 534명  생존율 0.3895
차이 +0.0660

상관계수(파이) +0.0584
오즈비 1.3114

pi = 180/714 = 0.252101,  ybar = 0.406162
  sqrt(pi(1-pi))       = 0.434219
  sqrt(ybar(1-ybar))   = 0.491116
  차이 Delta           = 0.066042
  식이 주는 phi        = 0.058391
  numpy 가 준 phi      = 0.058391
  오즈비를 유리수로     = 26732/20384 = 1.311421
(1)의 유리수 값이 그대로 나온다. \(41/90 = 0.4556\), \(104/267 = 0.3895\), \(6683/5096 = 1.3114\)다.
(2)의 항등식도 소수 여섯째 자리까지 맞는다. 손으로 세운 식이 \(0.058391\)을 주고 numpy 의 상관계수도 \(0.058391\)이다.
줄어드는 계수 \(\sqrt{\pi(1-\pi)}/\sqrt{\bar y(1-\bar y)} = 0.434219/0.491116 = 0.884\)를 눈여겨보라. 여기서는 \(\pi = 0.25\)라 계수가 아직 \(1\)에 가깝지만, 절단점을 \(2\)세로 옮기면 \(\pi = 0.0196\)이 되어 계수가 \(0.283\)까지 떨어진다. 같은 \(\Delta\)라도 절단점이 끝으로 갈수록 \(\varphi\)가 작아진다. 4절에서 그 효과를 직접 보게 된다.
자료가 \(891\)명이 아니라 \(714\)명인 것도 기억해 두어야 한다. 나이가 빠진 \(177\)명은 무작위로 빠진 것이 아니고(앞 절 보기 5에서 보았다) 생존율이 \(0.2938\)로 낮다. 이들을 어떻게 다루느냐가 답을 바꾸는지는 보기 3에서 수로 확인한다.
차이가 거의 없다.
| 지표 | 값 |
|---|---|
| 생존율 | 45.56% 대 38.95% |
| 차이 | \(+6.60\)%포인트 |
| 오즈비 | 1.31 |
| \(\varphi\) | \(+0.0584\) |
앞 절의 성별과 견주면 규모가 전혀 다르다. 성별은 차이 55.31%포인트에 오즈비 12.35였는데, 여기는 6.60%포인트에 1.31이다. \(\varphi\)도 0.5434 대 0.0584로 열 배 가까이 작다.
"나이는 생존과 관계가 없다"고 결론지어도 되는가. 이 절의 나머지는 그 결론이 절단점 21에 대해서만 성립한다는 것을 보인다.
이 \(+6.60\)%포인트가 우연으로 설명되는지는 6절에서 짚는다. 미리 말해 두면 우연으로 설명될 수 있는 크기다.
2. 같은 표를 네 가지로 그리면
보기 2. 그림도 "관계가 약하다"고 말한다. 절단점 \(21\)세의 표를 도수 막대, 생존율 막대, 누적 막대, 비율 열지도로 그린다.
(1) 네 그림을 그리고 각각이 말하는 것을 수치와 함께 적으시오.
(2) 생존율 막대의 세로축을 \([0, 60]\) 대신 \([38, 46]\)으로 잘라 놓으면 그려지는 막대 높이의 비가 얼마에서 얼마로 바뀌는가.
풀이
유도할 식은 없다. 네 그림이 같은 네 수에서 나왔는데 무엇을 보여 주는가가 이 보기의 몫이다.
(2) 해석적으로. 세로축이 \([\ell, h]\)일 때 값 \(v\)인 막대가 그림에서 차지하는 높이의 비율은 \((v - \ell)/(h - \ell)\)이다. 두 생존율 \(45.56\%\)와 \(38.95\%\)에 넣으면
이다. \(1.17\)배가 \(7.94\)배로 보이게 된다. 자료는 한 글자도 바뀌지 않았고 축의 아래끝만 \(0\)에서 \(38\)로 옮겼다. 막대의 길이가 값에 비례하려면 아래끝이 \(0\)이어야 하고, 그렇지 않으면 길이의 비가 값의 비와 아무 관계가 없어진다.
(1) 수치적으로.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import seaborn as sns

# 그림에 한글을 쓰므로 한글 글꼴을 지정한다. 맥이면 'Apple SD Gothic Neo',
# 윈도우면 'Malgun Gothic', 리눅스면 'NanumGothic' 정도가 무난하다.
# 글꼴을 바꾸면 마이너스 기호가 깨지므로 unicode_minus 도 함께 꺼 준다.
plt.rcParams["font.family"] = "Apple SD Gothic Neo"
plt.rcParams["axes.unicode_minus"] = False

KO = [f"{CUT}세 미만", f"{CUT}세 이상"]
DIED, LIVED = "#90A4AE", "#1565C0"

fig, ax = plt.subplots(2, 2, figsize=(13, 9))

# (1) 도수 -- 두 집단의 크기가 크게 다르다 (180 대 534)
sns.countplot(data=d, x="Age_Group", hue="Survived", order=ORDER,
              ax=ax[0, 0], palette=[DIED, LIVED])
ax[0, 0].set_title(f"(1) 나이 집단별 도수 (절단점 {CUT}세)")
ax[0, 0].set_xlabel("나이 집단"); ax[0, 0].set_ylabel("사람 수")
ax[0, 0].set_xticks([0, 1]); ax[0, 0].set_xticklabels(KO)
ax[0, 0].legend(["사망", "생존"], title="생존 여부")

# (2) 생존율 -- 막대 두 개의 높이가 비슷하다
rate = d.groupby("Age_Group")["Survived"].mean().reindex(ORDER) * 100
rate.plot(kind="bar", ax=ax[0, 1], color=["#E65100", "#1565C0"],
          edgecolor="black", width=0.7)
ax[0, 1].set_title(f"(2) 나이 집단별 생존율 (%) (절단점 {CUT}세)")
ax[0, 1].set_xlabel("나이 집단"); ax[0, 1].set_ylabel("생존율 (%)")
ax[0, 1].set_xticks([0, 1]); ax[0, 1].set_xticklabels(KO)
ax[0, 1].tick_params(axis="x", rotation=0)
ax[0, 1].grid(True, alpha=0.3, axis="y"); ax[0, 1].set_ylim(0, 60)
for i, v in enumerate(rate):
    ax[0, 1].text(i, v + 1.5, f"{v:.1f}%", ha="center", fontweight="bold")

# (3) 누적 막대
tab.plot(kind="bar", stacked=True, ax=ax[1, 0],
         color=["#D32F2F", "#33691E"], edgecolor="black", width=0.7)
ax[1, 0].set_title("(3) 누적 막대 (도수)")
ax[1, 0].set_xlabel("나이 집단"); ax[1, 0].set_ylabel("사람 수")
ax[1, 0].set_xticks([0, 1]); ax[1, 0].set_xticklabels(KO)
ax[1, 0].tick_params(axis="x", rotation=0)
ax[1, 0].legend(["사망", "생존"], title="생존 여부")

# (4) 비율 열지도 -- 색 범위를 0~1 로 고정한다
prop = pd.crosstab(d["Age_Group"], d["Survived"],
                   normalize="index").reindex(ORDER)
sns.heatmap(prop, annot=True, fmt=".2%", cmap="Blues", ax=ax[1, 1],
            vmin=0, vmax=1, cbar_kws={"label": "비율"},
            linewidths=2, linecolor="black")
ax[1, 1].set_title("(4) 비율 열지도")
ax[1, 1].set_xlabel("생존 여부"); ax[1, 1].set_ylabel("나이 집단")
ax[1, 1].set_xticklabels(["사망", "생존"])
ax[1, 1].set_yticklabels(KO, rotation=0)

fig.suptitle(f"타이타닉: 나이 집단과 생존, 절단점 {CUT}세", y=1.00)
fig.tight_layout()
fig.savefig("titanic_age21_four.png", dpi=170, facecolor="white",
            bbox_inches="tight")

# --- 세로축을 자르면 막대 높이의 비가 어떻게 바뀌는가 ---
for lohi in [(0, 60), (38, 46)]:
    l, h = lohi
    h1 = (rate.iloc[0] - l) / (h - l)
    h2 = (rate.iloc[1] - l) / (h - l)
    print(f"세로축 [{l}, {h}]: 그려지는 높이 {h1:.4f} 대 {h2:.4f},  비 {h1 / h2:.2f}")
print(f"생존율 자체의 비 = {rate.iloc[0] / rate.iloc[1]:.4f}")
print(f"\n두 집단의 크기 {int(tab.iloc[0].sum())}명 대 {int(tab.iloc[1].sum())}명 "
      f"({tab.iloc[1].sum() / tab.iloc[0].sum():.2f} 배)")
세로축 [0, 60]: 그려지는 높이 0.7593 대 0.6492,  비 1.17
세로축 [38, 46]: 그려지는 높이 0.9444 대 0.1189,  비 7.94
생존율 자체의 비 = 1.1696

두 집단의 크기 180명 대 534명 (2.97 배)
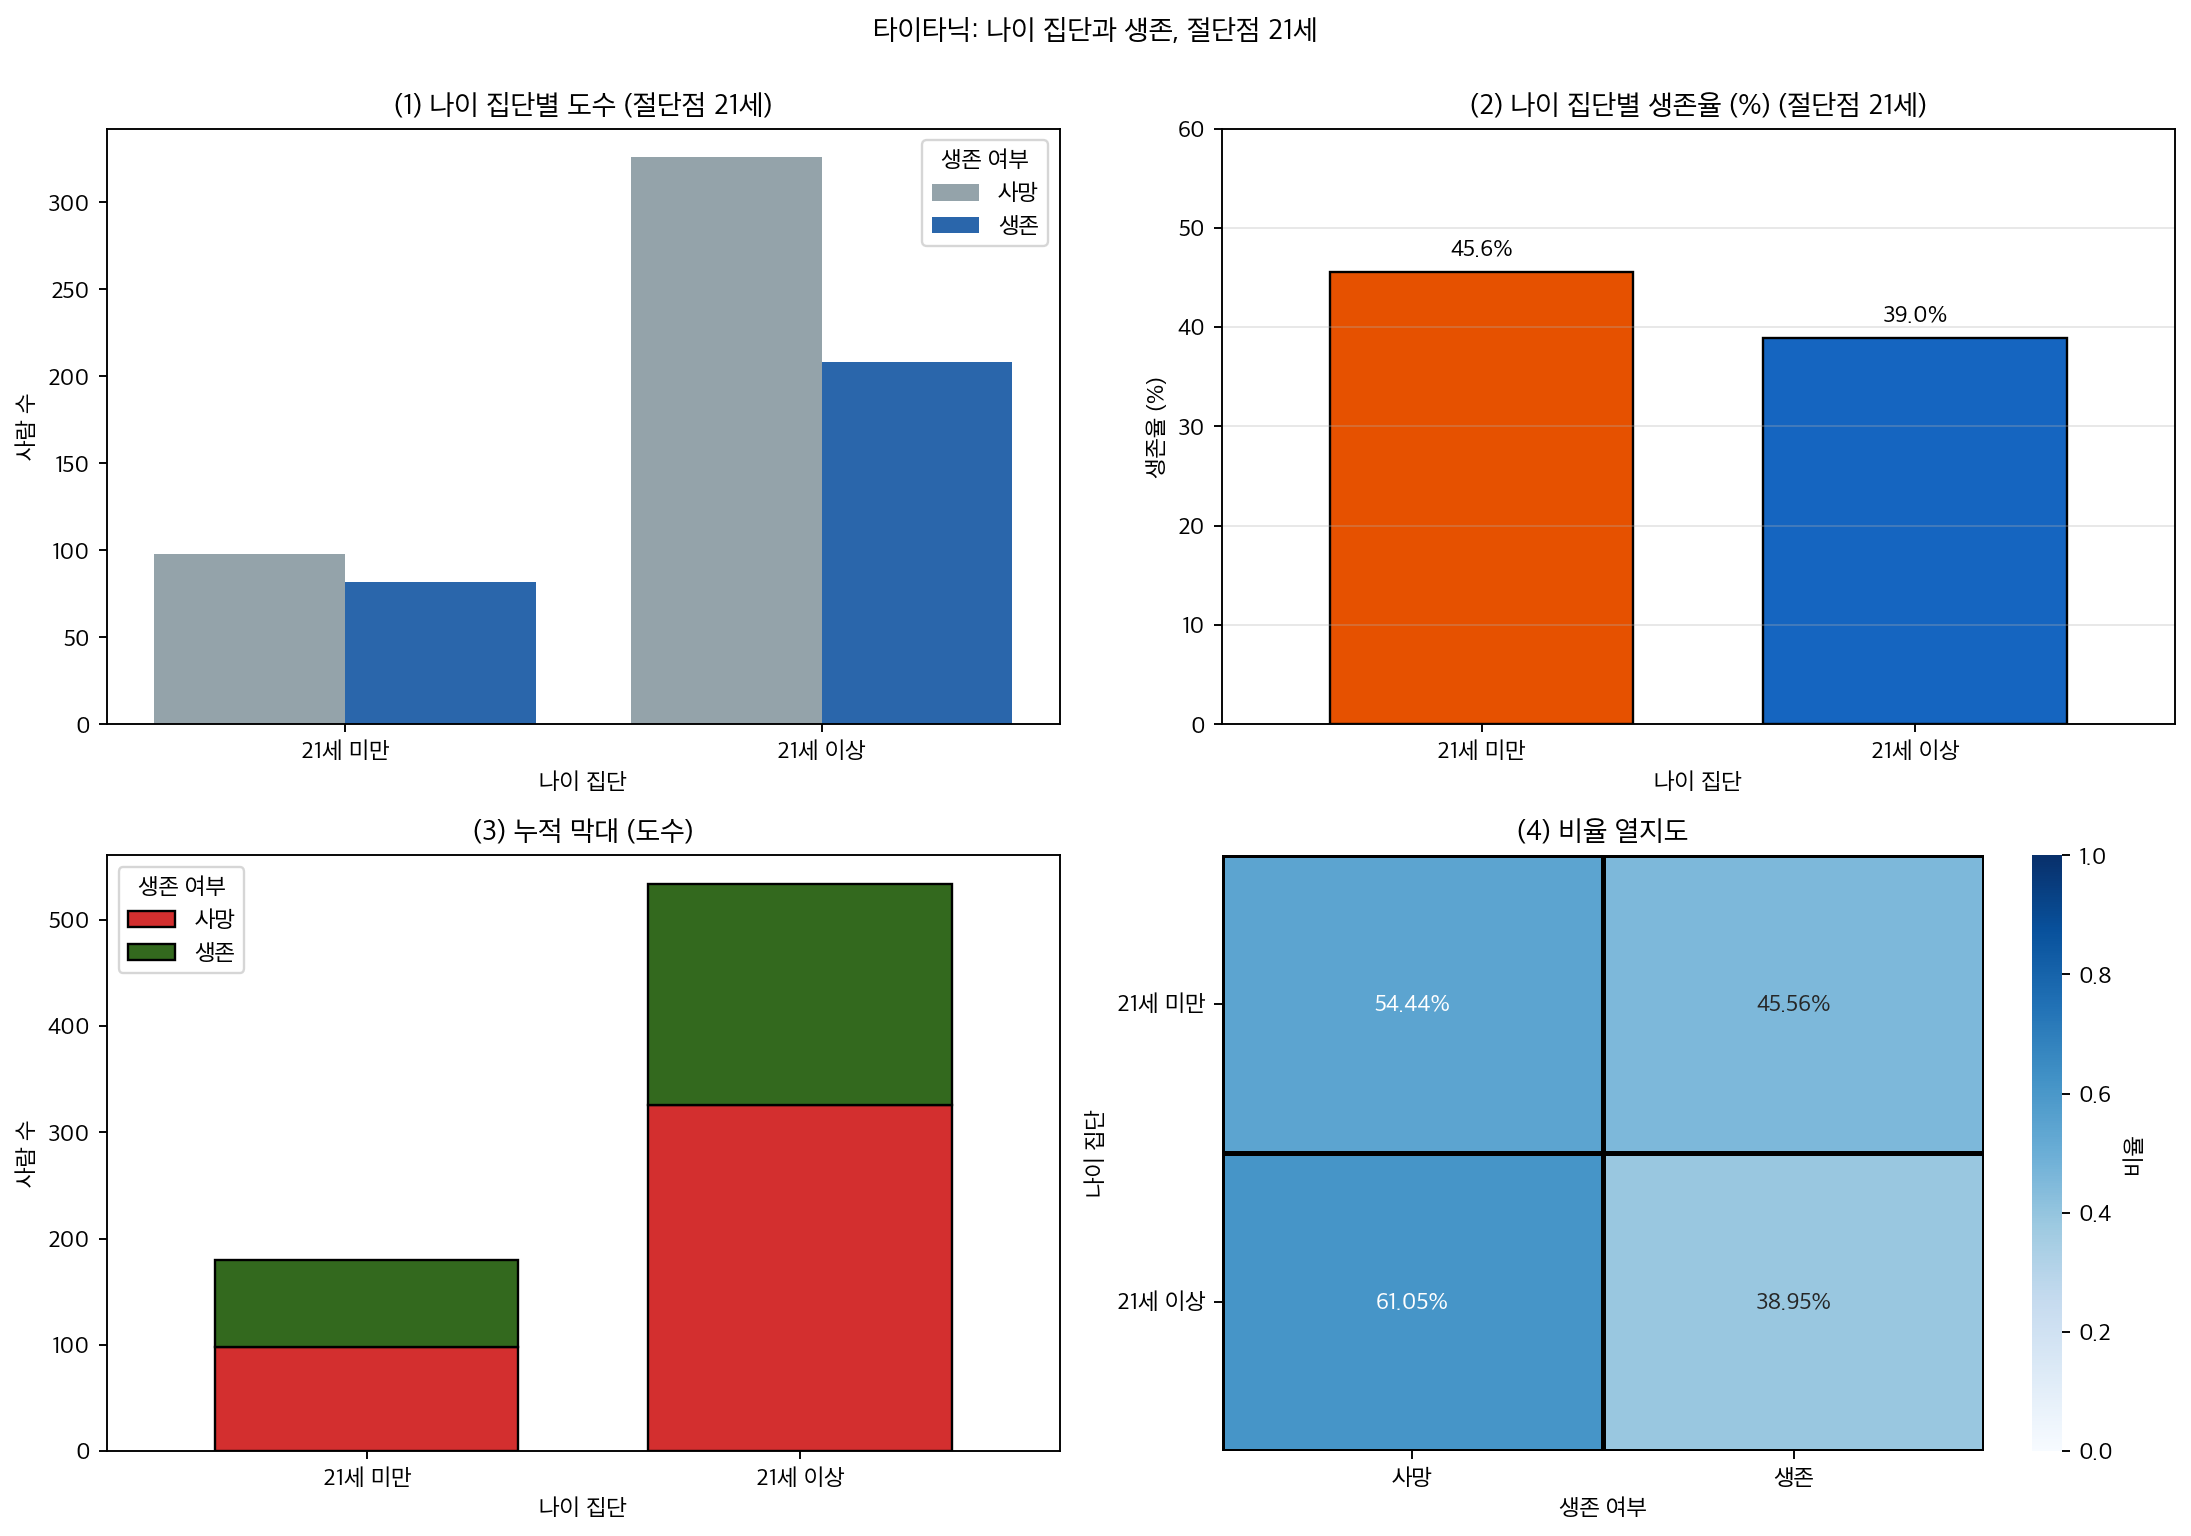
네 그림 모두 "차이가 거의 없다"고 말한다. (2)의 막대 두 개는 45.6%와 39.0%로 눈에 띄게 다르지 않고, (4)의 네 칸은 색이 비슷하다.
(2)의 예측이 확인된다. 세로축 \([0, 60]\)에서는 그려지는 높이의 비가 \(1.17\)로 생존율 자체의 비 \(1.1696\)과 거의 같다. 축을 \([38, 46]\)으로 자르면 그 비가 \(7.94\)가 된다. 똑같은 자료가 극적인 차이로 보인다. 막대그림의 세로축은 반드시 \(0\)에서 시작해야 한다는 원칙이 여기서 실질적으로 작동한다.
(1)번 그림이 중요한 정보를 준다. 두 집단의 크기가 \(180\)명과 \(534\)명으로 \(2.97\)배 차이다. 어린 쪽 표본이 작으므로 그쪽 생존율의 불확실성이 크다. 비율 그림 (2)만 보면 이 사실이 사라진다.
(4)번 열지도가 가리는 것도 같은 것이다. 네 칸이 \(54.44\%\), \(45.56\%\), \(61.05\%\), \(38.95\%\)로 정확하게 적혀 있지만, 그 비율이 각각 몇 명에서 나온 것인지는 어디에도 없다. 색의 진하기도 \(n\)을 반영하지 않는다.
3. 자르기 전에 나이를 그대로 본다
분할표를 만드는 순간 나이는 0과 1이 된다. 그 전에 원래 분포를 보는 것이 순서다.
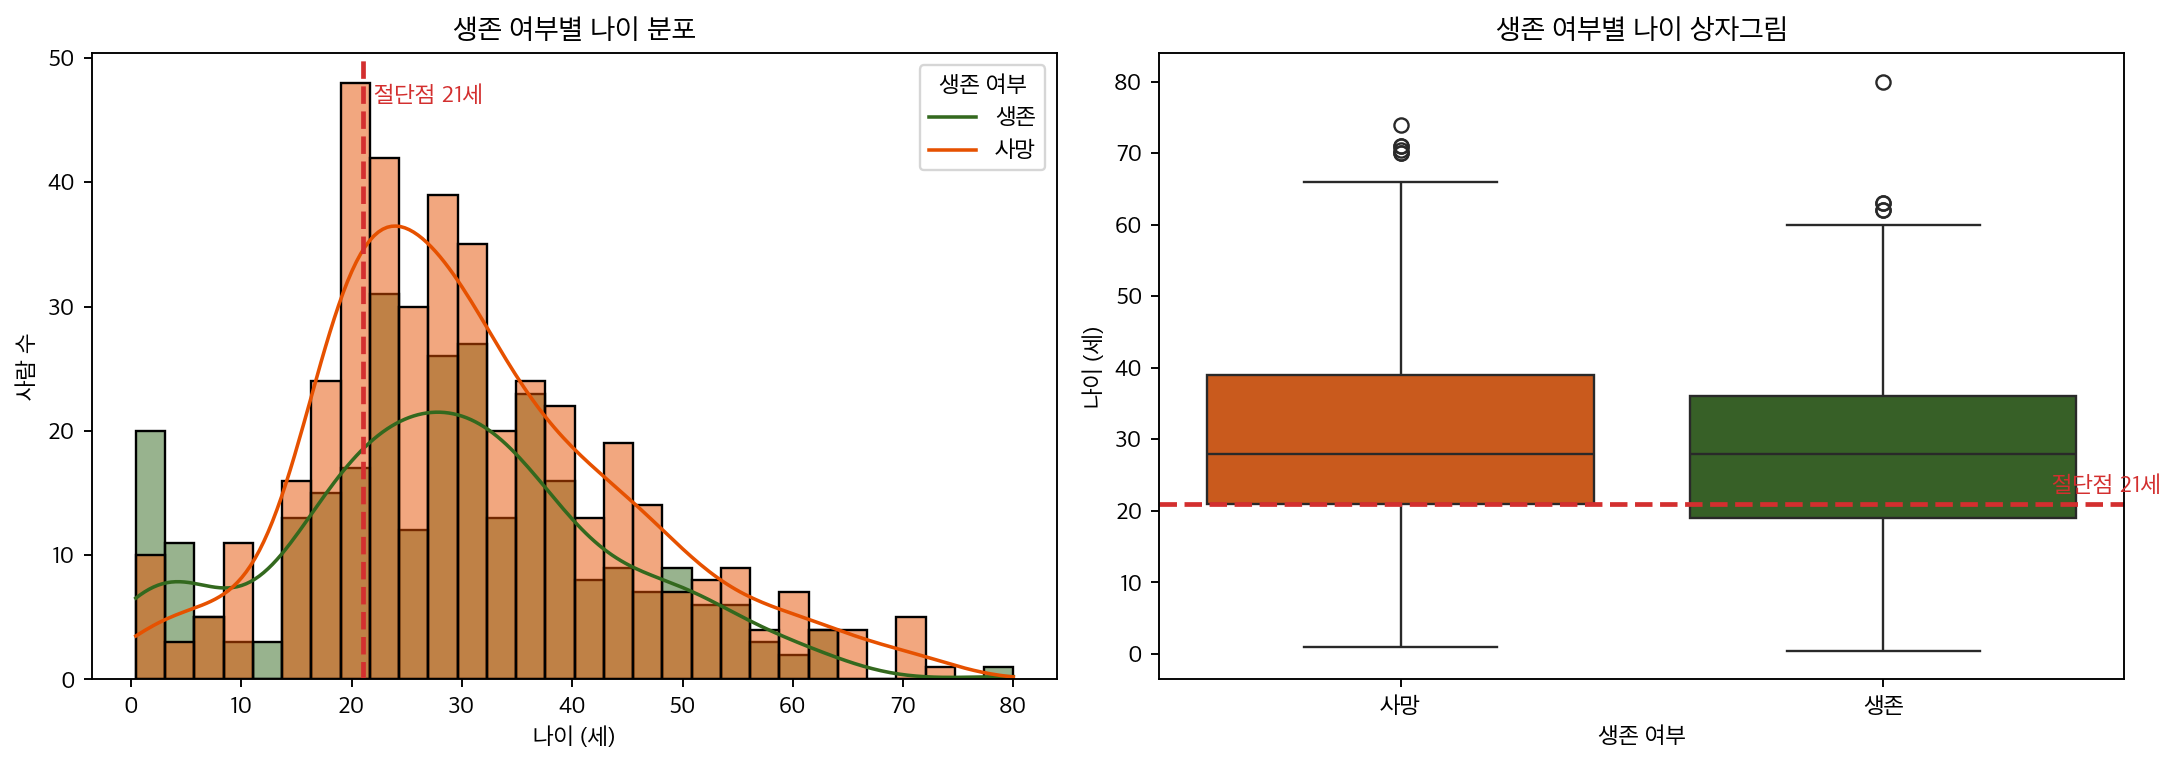
보기 3. 자르기 전에 나이를 그대로 본다. 생존자와 사망자의 나이 분포를 히스토그램과 상자그림으로 겹쳐 본다.
(1) 두 집단의 다섯 수치 요약은 거의 같다. 그런데 평균은 \(2.28\)세 차이가 난다. 그 차이가 어느 나이대에서 오는지 밝히시오.
(2) 상자그림이 그 사실을 놓치는 까닭을 울타리 위치로 설명하시오.
(3) 나이가 빠진 \(177\)명을 버리는 대신 메우면 보기 1의 답이 바뀌는가.
풀이
(1)·(2) 해석적으로. 평균은 모든 관측값에 같은 무게를 주므로, 한쪽 끝에 몰린 작은 덩어리도 그 크기만큼 평균을 움직인다. 반면 중앙값과 사분위수는 순위만 보므로 꼬리 쪽 덩어리를 거의 느끼지 못한다. 두 집단의 중앙값이 둘 다 \(28.00\)세인데 평균이 \(2.28\)세 벌어져 있다면, 차이를 만든 것은 가운데가 아니라 꼬리다.
상자그림이 그리는 것은 다섯 수와 울타리뿐이다. 아래쪽 울타리는 \(Q_1 - 1.5\,\mathrm{IQR}\)인데 두 집단 모두
로 음수다. 나이는 음수가 될 수 없으므로 아래쪽 이상치가 원리적으로 하나도 찍히지 않는다. 어린아이들은 전부 수염 안에 들어가 사라진다. 상자그림이 어린아이 덩어리를 놓치는 것이 우연이 아니라 구조적인 것이다.
(3) 해석적으로. 결측을 메우는 흔한 방법들 — 전체 중앙값, 전체 평균, 성별·등급별 중앙값 — 이 주는 값은 모두 \(21\)세보다 크다. 성별·등급별 중앙값 가운데 가장 작은 것이 3등실 여성의 \(21.5\)세다. 그러므로 어떤 방법을 쓰든 메워진 \(177\)명은 전원 "\(21\)세 이상" 칸으로 간다. 그들의 생존율이 \(0.2938\)로 낮으므로 \(r_{\ge 21}\)이 내려가고 차이 \(\Delta\)는 커질 수밖에 없다.
(4) 수치적으로.
fig, ax = plt.subplots(1, 2, figsize=(13, 4.6))
PALETTE = ["#E65100", "#33691E"]          # 사망 / 생존

# 생존/사망 각각의 나이 분포를 겹쳐 그린다.
sns.histplot(data=d, x="Age", hue="Survived", kde=True, ax=ax[0],
             palette=PALETTE, bins=30)
ax[0].axvline(CUT, color="#D32F2F", ls="--", lw=2)
ax[0].text(CUT + 1, ax[0].get_ylim()[1] * 0.92, f"절단점 {CUT}세",
           color="#D32F2F", fontweight="bold")
ax[0].set_title("생존 여부별 나이 분포")
ax[0].set_xlabel("나이 (세)"); ax[0].set_ylabel("사람 수")
ax[0].legend(["생존", "사망"], title="생존 여부")

sns.boxplot(data=d, x="Survived", y="Age", ax=ax[1], hue="Survived",
            palette=PALETTE, legend=False)
ax[1].axhline(CUT, color="#D32F2F", ls="--", lw=2)
ax[1].text(1.35, CUT + 1.5, f"절단점 {CUT}세", color="#D32F2F",
           fontweight="bold")
ax[1].set_title("생존 여부별 나이 상자그림")
ax[1].set_xlabel("생존 여부"); ax[1].set_ylabel("나이 (세)")
ax[1].set_xticks([0, 1])
ax[1].set_xticklabels(["사망", "생존"])

fig.tight_layout()
fig.savefig("titanic_age_dist.png", dpi=170, facecolor="white",
            bbox_inches="tight")

# 그림이 말하는 것을 수치로도 확인한다.
print(f"{'':14s}{'n':>6s}{'평균':>8s}{'중앙값':>8s}{'Q1':>7s}{'Q3':>7s}")
for lab, v in [("사망", d.loc[d["Survived"] == 0, "Age"]),
               ("생존", d.loc[d["Survived"] == 1, "Age"])]:
    print(f"{lab:14s}{len(v):>6d}{v.mean():>8.2f}{v.median():>8.2f}"
          f"{v.quantile(.25):>7.2f}{v.quantile(.75):>7.2f}")

# --- 상자그림의 수염과 울타리: 어린아이는 이상치로도 찍히지 않는다 ---
print("\n상자그림이 그리는 것 (울타리 = Q1-1.5IQR, Q3+1.5IQR)")
for lab, v in [("사망", d.loc[d["Survived"] == 0, "Age"]),
               ("생존", d.loc[d["Survived"] == 1, "Age"])]:
    q1, q3 = v.quantile(.25), v.quantile(.75)
    iqr = q3 - q1
    print(f"  {lab}: 최솟값 {v.min():5.2f},  아래 울타리 {q1 - 1.5 * iqr:6.2f}"
          f"  ->  아래쪽 이상치 {int((v < q1 - 1.5 * iqr).sum())}명")

# --- 평균 차이가 어디서 오는가 ---
m0 = d["Survived"] == 0
dm = d.loc[~m0, "Age"].mean() - d.loc[m0, "Age"].mean()
sp = np.sqrt(((m0.sum() - 1) * d.loc[m0, "Age"].var()
              + ((~m0).sum() - 1) * d.loc[~m0, "Age"].var()) / (len(d) - 2))
print(f"\n평균 차이 (생존 - 사망) = {dm:+.4f}세,  합동 표준편차 {sp:.4f},  표준화 차이 {dm / sp:+.4f}")
big = d[d["Age"] >= 10]
m0b = big["Survived"] == 0
print(f"  10세 미만 {int((d['Age'] < 10).sum())}명을 빼면 평균 차이 = "
      f"{big.loc[~m0b, 'Age'].mean() - big.loc[m0b, 'Age'].mean():+.4f}세")
print(f"  10세 미만의 생존율 {d.loc[d['Age'] < 10, 'Survived'].mean():.4f}"
      f"  (전체 {d['Survived'].mean():.4f})")
print(f"  생존자 중 10세 미만 비율 {(d.loc[~m0, 'Age'] < 10).mean():.4f},"
      f"  사망자 중 {(d.loc[m0, 'Age'] < 10).mean():.4f}")

# --- 결측 177명을 버리는 대신 메우면 답이 바뀌는가 ---
def cut21(age, sur, tag):
    m = age < CUT
    a, b = sur[m].sum(), m.sum() - sur[m].sum()
    c, e = sur[~m].sum(), (~m).sum() - sur[~m].sum()
    print(f"  {tag:26s} n={len(age):3d}  n<21={m.sum():3d}  r<={sur[m].mean():.4f}"
          f"  r>={sur[~m].mean():.4f}  차 {sur[m].mean() - sur[~m].mean():+.4f}"
          f"  OR {(a * e) / (b * c):.4f}")

print("\n결측 177명을 어떻게 다루는가")
cut21(d["Age"].to_numpy(), d["Survived"].to_numpy(), "(ㄱ) 버린다")
med = d["Age"].median()
cut21(df["Age"].fillna(med).to_numpy(), df["Survived"].to_numpy(),
      f"(ㄴ) 중앙값 {med:.1f} 로 메운다")
by = df.groupby(["Sex", "Pclass"])["Age"].transform(lambda s: s.fillna(s.median()))
cut21(by.to_numpy(), df["Survived"].to_numpy(), "(ㄷ) 성별·등급 중앙값")
print(f"  성별·등급 중앙값은 모두 21세 이상이라 메운 177명이 전원 '21세 이상' 으로 간다")
print(f"  중앙값으로 메우면 28.0세인 사람이 {int((d['Age'] == med).sum())}명에서 "
      f"{int((df['Age'].fillna(med) == med).sum())}명으로 늘어난다")
                   n      평균     중앙값     Q1     Q3
사망               424   30.63   28.00  21.00  39.00
생존               290   28.34   28.00  19.00  36.00

상자그림이 그리는 것 (울타리 = Q1-1.5IQR, Q3+1.5IQR)
  사망: 최솟값  1.00,  아래 울타리  -6.00  ->  아래쪽 이상치 0명
  생존: 최솟값  0.42,  아래 울타리  -6.50  ->  아래쪽 이상치 0명

평균 차이 (생존 - 사망) = -2.2825세,  합동 표준편차 14.4933,  표준화 차이 -0.1575
  10세 미만 62명을 빼면 평균 차이 = -0.0680세
  10세 미만의 생존율 0.6129  (전체 0.4062)
  생존자 중 10세 미만 비율 0.1310,  사망자 중 0.0566

결측 177명을 어떻게 다루는가
  (ㄱ) 버린다                    n=714  n<21=180  r<=0.4556  r>=0.3895  차 +0.0660  OR 1.3114
  (ㄴ) 중앙값 28.0 로 메운다         n=891  n<21=180  r<=0.4556  r>=0.3657  차 +0.0899  OR 1.4514
  (ㄷ) 성별·등급 중앙값              n=891  n<21=180  r<=0.4556  r>=0.3657  차 +0.0899  OR 1.4514
  성별·등급 중앙값은 모두 21세 이상이라 메운 177명이 전원 '21세 이상' 으로 간다
  중앙값으로 메우면 28.0세인 사람이 25명에서 202명으로 늘어난다
두 분포가 거의 포개진다. 중앙값이 둘 다 28.00세로 같고, 평균은 30.63세와 28.34세로 2.3세 차이다. 상자그림의 두 상자가 거의 같은 높이에 있다.
(1)의 답은 "전부 10세 미만에서 온다"이다. 그것도 아슬아슬한 수준이 아니라 거의 전부다. \(10\)세 미만 \(62\)명을 빼고 다시 재면 평균 차이가 \(-2.2825\)세에서 \(-0.0680\)세로 \(97\%\) 사라진다. 그 \(62\)명의 생존율이 \(0.6129\)로 전체 \(0.4062\)보다 훨씬 높고, 생존자의 \(13.10\%\)가 \(10\)세 미만인 반면 사망자는 \(5.66\%\)뿐이기 때문이다.
표준화 차이로 보면 \(-0.158\)에 지나지 않는다. "평균 나이가 2.3세 다르다"는 요약은 사실상 아무 정보가 없는 말이고, 실제 정보는 전부 꼬리에 있다.
(2)의 답도 수가 보여 준다. 아래 울타리가 \(-6.00\)과 \(-6.50\)으로 음수여서 아래쪽 이상치가 양쪽 모두 \(0\)명이다. 나이는 음수가 될 수 없으니 이 상자그림에서는 아무리 어린 아이도 이상치로 찍힐 수 없다. 히스토그램의 왼쪽 끝에서 초록(생존)이 주황(사망)보다 높게 솟은 그 덩어리가 상자그림에서는 완전히 사라진다.
히스토그램이 상자그림보다 많은 것을 말한 사례다. 요약통계가 같아도 분포가 다를 수 있다는 것을 히스토그램과 밀도 그림 절에서 다루었다.
(3)의 답은 "바뀐다"이다. 생존율 차이가 \(+0.0660\)에서 \(+0.0899\)로 \(36\%\) 커지고 오즈비가 \(1.3114\)에서 \(1.4514\)로 오른다. 세 가지 메우기 방법이 똑같은 답을 주는데, 이는 (3)의 예측대로 어느 방법도 메운 사람을 \(21\)세 미만으로 보내지 못하기 때문이다. \(177\)명 전원이 생존율 낮은 쪽 칸에 더해지니 차이가 커지는 방향으로만 움직인다.
메우기가 답을 "고쳐 준" 것이 아니라는 점을 분명히 해 두어야 한다. 중앙값으로 메우면 \(28.0\)세인 사람이 \(25\)명에서 \(202\)명으로 여덟 배가 되어, 보기 3이 그린 바로 그 분포에 없던 뾰족한 봉우리가 생긴다. 분포를 보려고 그린 그림이 메우기 때문에 망가지는 것이다. 결측을 버릴지 메울지는 결과를 바꾸는 선택이며, 절단점과 마찬가지로 분석자가 정한다.
4. 절단점을 바꾸면 결론이 바뀐다
21은 어디서 왔는가. 아무 데서도 오지 않았다. 미국 음주 연령이기도 하고 성년의 기준이기도 하지만, 1912년 타이타닉에는 아무 의미가 없는 숫자다.
보기 4. 가능한 모든 절단점을 훑어본다. 양쪽에 \(10\)명 이상 남는 절단점 \(64\)개를 전부 시험한다.
(1) 생존율 차이가 절단점에만 의존하는 두 양으로 적힘을 보이시오. 곧
임을 보이고, 절단점이 끝으로 갈수록 \(\Delta\)가 커지는 까닭을 말하시오.
(2) 그렇다면 "차이가 가장 큰 절단점"과 "연관이 가장 센(= \(\lvert\varphi\rvert\)가 가장 큰) 절단점"은 같은가.
풀이
(1) 해석적으로. 보기 1에서 이미 절반을 했다. 전체 생존율이 가중평균
이므로 \(r_{\ge c}\)를 풀어내면
이고, 따라서
이다. \(\bar y\)는 절단점과 무관한 상수이므로, \(\Delta\)를 움직이는 것은 두 가지뿐이다. 어린 쪽 집단의 생존율이 전체에서 얼마나 벗어나 있는가(\(r_{<c} - \bar y\))와, 그 집단이 얼마나 작은가(\(1-\pi\)).
여기서 \(\Delta\)가 끝에서 커지는 까닭이 드러난다. 절단점을 왼쪽 끝으로 밀면 \(\pi \to 0\)이므로 분모 \(1-\pi \to 1\)이고 \(\Delta \approx r_{<c} - \bar y\)인데, 작은 집단일수록 평균에서 멀리 떨어질 수 있다. 반대로 오른쪽 끝으로 밀면 \(\pi \to 1\)이라 분모가 \(0\)으로 가면서 아주 작은 \(r_{<c} - \bar y\)도 크게 증폭된다. \(c = 65\)에서 \(r_{<65} - \bar y\)가 \(0.0049\)밖에 안 되는데 \(\Delta\)가 \(0.3202\)인 것이 그 예다.
(2) 해석적으로. 같지 않다. 보기 1의 항등식
에 (1)을 넣으면 분모의 \(1-\pi\)가 일부 약분되어
가 된다. \(\Delta\)를 키우는 요인(\(1-\pi\)가 작음)과 \(\varphi\)를 키우는 요인이 서로 다르게 작동한다. 왼쪽 끝에서는 \(\pi \to 0\)이 \(\varphi\)를 눌러 버리므로, \(\Delta\)가 가장 큰 절단점이 \(\varphi\)도 가장 크게 하리라는 보장이 없다.
(3) 수치적으로.
age = d["Age"].to_numpy()
sur = d["Survived"].to_numpy()

# 양쪽에 최소 10명은 남는 절단점만 고려한다.
CUTS = [c for c in range(1, 80)
        if (age < c).sum() >= 10 and (age >= c).sum() >= 10]
print(f"검사 대상 절단점 {len(CUTS)}개 ({CUTS[0]}세 ~ {CUTS[-1]}세)\n")

print(f"{'절단점':>7s}{'n<c':>6s}{'n>=c':>6s}{'생존율<':>9s}"
      f"{'생존율>=':>10s}{'차이':>9s}{'오즈비':>9s}")
gaps = []
for c in CUTS:
    m = age < c
    lo_r, hi_r = sur[m].mean(), sur[~m].mean()
    gaps.append((c, lo_r - hi_r))
    if c % 5 == 0:                           # 5세 간격만 출력한다
        odds = (lo_r / (1 - lo_r)) / (hi_r / (1 - hi_r))
        print(f"{c:>7d}{m.sum():>6d}{(~m).sum():>6d}{lo_r:>9.4f}"
              f"{hi_r:>10.4f}{lo_r - hi_r:>+9.4f}{odds:>9.4f}")

wide = max(gaps, key=lambda z: z[1])
narrow = min(gaps, key=lambda z: abs(z[1]))
print(f"\n차이가 가장 큰 절단점:   {wide[0]}세, {wide[1]:+.4f}")
print(f"차이가 가장 작은 절단점: {narrow[0]}세, {narrow[1]:+.4f}")
print(f"차이가 10%포인트를 넘는 절단점 "
      f"{sum(1 for c, g in gaps if abs(g) > 0.10)}개 / {len(CUTS)}개")

# --- Delta 를 ybar 와 pi 만으로 다시 쓴다 ---
# Delta(c) = (r_<c - ybar) / (1 - pi(c)),  pi(c) = (age<c) 의 비율
# phi(c)   = sqrt(pi(1-pi)/(ybar(1-ybar))) * Delta(c)
ybar = sur.mean()
print(f"\n{'c':>4}{'pi':>9}{'r<c':>9}{'Delta':>10}{'(r<c-y)/(1-pi)':>17}{'phi':>9}{'numpy phi':>11}")
for c in (2, 5, 21, 30, 65):
    m = age < c
    pi = m.mean()
    dl = sur[m].mean() - sur[~m].mean()
    ph = np.sqrt(pi * (1 - pi) / (ybar * (1 - ybar))) * dl
    print(f"{c:>4}{pi:>9.4f}{sur[m].mean():>9.4f}{dl:>+10.4f}"
          f"{(sur[m].mean() - ybar) / (1 - pi):>+17.4f}{ph:>+9.4f}"
          f"{np.corrcoef(sur, m.astype(int))[0, 1]:>+11.4f}")

# --- 차이가 가장 큰 절단점과 연관이 가장 센 절단점은 다르다 ---
rows = []
for c in CUTS:
    m = age < c
    pi = m.mean()
    dl = sur[m].mean() - sur[~m].mean()
    rows.append((c, pi, dl, np.sqrt(pi * (1 - pi) / (ybar * (1 - ybar))) * dl))
bd = max(rows, key=lambda z: abs(z[2]))
bp = max(rows, key=lambda z: abs(z[3]))
print(f"\n|Delta| 가 가장 큰 절단점: {bd[0]}세  pi={bd[1]:.4f}  Delta={bd[2]:+.4f}  phi={bd[3]:+.4f}")
print(f"|phi|   가 가장 큰 절단점: {bp[0]}세  pi={bp[1]:.4f}  Delta={bp[2]:+.4f}  phi={bp[3]:+.4f}")
print("|phi| 상위 다섯:", [(c, round(p, 4)) for c, _, _, p in sorted(rows, key=lambda z: -abs(z[3]))[:5]])
print("|Delta| 상위 다섯:", [(c, round(g, 4)) for c, _, g, _ in sorted(rows, key=lambda z: -abs(z[2]))[:5]])
검사 대상 절단점 64개 (2세 ~ 65세)

    절단점   n<c  n>=c     생존율<     생존율>=       차이      오즈비
      5    40   674   0.6750    0.3902  +0.2848   3.2457
     10    62   652   0.6129    0.3865  +0.2264   2.5132
     15    78   636   0.5769    0.3852  +0.1917   2.1763
     20   164   550   0.4817    0.3836  +0.0981   1.4932
     25   278   436   0.4245    0.3945  +0.0300   1.1320
     30   384   330   0.4062    0.4061  +0.0002   1.0008
     35   479   235   0.4092    0.4000  +0.0092   1.0389
     40   551   163   0.4156    0.3742  +0.0414   1.1892
     45   599   115   0.4124    0.3739  +0.0384   1.1749
     50   640    74   0.4109    0.3649  +0.0461   1.2144
     55   672    42   0.4122    0.3095  +0.1027   1.5644
     60   688    26   0.4113    0.2692  +0.1421   1.8966
     65   703    11   0.4111    0.0909  +0.3202   6.9807

차이가 가장 큰 절단점:   2세, +0.4600
차이가 가장 작은 절단점: 30세, +0.0002
차이가 10%포인트를 넘는 절단점 29개 / 64개

   c       pi      r<c     Delta   (r<c-y)/(1-pi)      phi  numpy phi
   2   0.0196   0.8571   +0.4600          +0.4600  +0.1299    +0.1299
   5   0.0560   0.6750   +0.2848          +0.2848  +0.1334    +0.1334
  21   0.2521   0.4556   +0.0660          +0.0660  +0.0584    +0.0584
  30   0.5378   0.4062   +0.0002          +0.0002  +0.0002    +0.0002
  65   0.9846   0.4111   +0.3202          +0.3202  +0.0803    +0.0803

|Delta| 가 가장 큰 절단점: 2세  pi=0.0196  Delta=+0.4600  phi=+0.1299
|phi|   가 가장 큰 절단점: 7세  pi=0.0658  Delta=+0.3168  phi=+0.1600
|phi| 상위 다섯: [(7, 0.16), (6, 0.1557), (8, 0.153), (9, 0.1517), (16, 0.136)]
|Delta| 상위 다섯: [(2, 0.46), (64, 0.3353), (65, 0.3202), (6, 0.318), (7, 0.3168)]
(1)의 항등식이 다섯 절단점 모두에서 소수 넷째 자리까지 Delta 열과 같다. \(\varphi\) 쪽도 손으로 세운 식과 numpy 의 상관계수가 일치한다.
\(c = 30\)에서 차이가 \(+0.0002\)로 거의 \(0\)인 것도 식이 설명해 준다. \(r_{<30} = 0.4062\)가 전체 생존율 \(\bar y = 0.4062\)와 사실상 같기 때문이다. 분자가 \(0\)이면 분모가 무엇이든 \(\Delta\)가 \(0\)이다. "\(30\)세에서 나이는 생존과 완벽히 무관하다"는 인상은 자료의 성질이 아니라 \(30\)세 아래 집단의 평균이 마침 전체 평균과 같다는 사실일 뿐이다.
(2)의 답은 "같지 않다"이다. \(\lvert\Delta\rvert\)가 가장 큰 절단점은 \(2\)세(\(\Delta = +0.4600\))인데, 그때 \(\varphi\)는 \(+0.1299\)에 지나지 않는다. \(\lvert\varphi\rvert\)가 가장 큰 절단점은 \(7\)세(\(\varphi = +0.1600\))이고 그때 \(\Delta\)는 \(+0.3168\)로 더 작다. 두 순위가 아예 다르다. \(\lvert\varphi\rvert\) 상위는 \(7, 6, 8, 9, 16\)세로 모여 있는 반면 \(\lvert\Delta\rvert\) 상위는 \(2, 64, 65, 6, 7\)세로 양 끝에 흩어져 있다.
까닭은 \(c = 2\)에서 어린 쪽이 \(14\)명뿐이라는 데 있다. \(\pi = 0.0196\)이면 \(\sqrt{\pi/(1-\pi)} = 0.141\)이라 \(\varphi\)가 크게 눌린다. "차이가 46%포인트"라는 말은 \(14\)명의 생존율이 \(0.857\)이었다는 말이고, 그것만으로 강한 연관이라 할 수 없다. 어느 요약을 쓰느냐에 따라 "가장 좋은 절단점"이 달라지며, 이것 또한 분석자의 선택이다.
(참고로 \(\lvert\varphi\rvert\)를 최대로 하는 \(7\)세가 p-해킹 시연 - 타이타닉 절단점 탐색 절에서 "탐색으로 고른 절단점"으로 쓰이는 값이다.)
같은 자료에서 생존율 차이가 \(+46\)%포인트부터 \(+0.02\)%포인트까지 나온다.
| 절단점 | 생존율 차이 | 오즈비 | 읽히는 이야기 |
|---|---|---|---|
| 2세 | \(+0.4600\) | — | 압도적인 차이 |
| 5세 | \(+0.2848\) | 3.24 | 큰 차이 |
| 20세 | \(+0.0981\) | 1.49 | 제법 차이 |
| 21세 | \(+0.0660\) | 1.31 | 작은 차이 |
| 30세 | \(+0.0002\) | 1.00 | 차이가 전혀 없음 |
| 65세 | \(+0.3202\) | 6.98 | 큰 차이 |
30세에서는 두 집단의 생존율이 0.4062와 0.4061로 소수점 셋째 자리까지 같다. 오즈비가 1.0008이다. 30세를 기준으로 나누면 나이는 생존과 완벽하게 무관해 보인다.
큰 차이가 양 끝에 몰려 있다. 어린 쪽과 아주 나이 든 쪽이다. 가운데는 전부 차이가 거의 없다.
절단점을 옮기는 것만으로 "오즈비 6.98"과 "오즈비 1.00"을 둘 다 얻을 수 있다. 자료는 하나도 바뀌지 않았다.
5. 왜 그런가 — 관계가 단조가 아니다
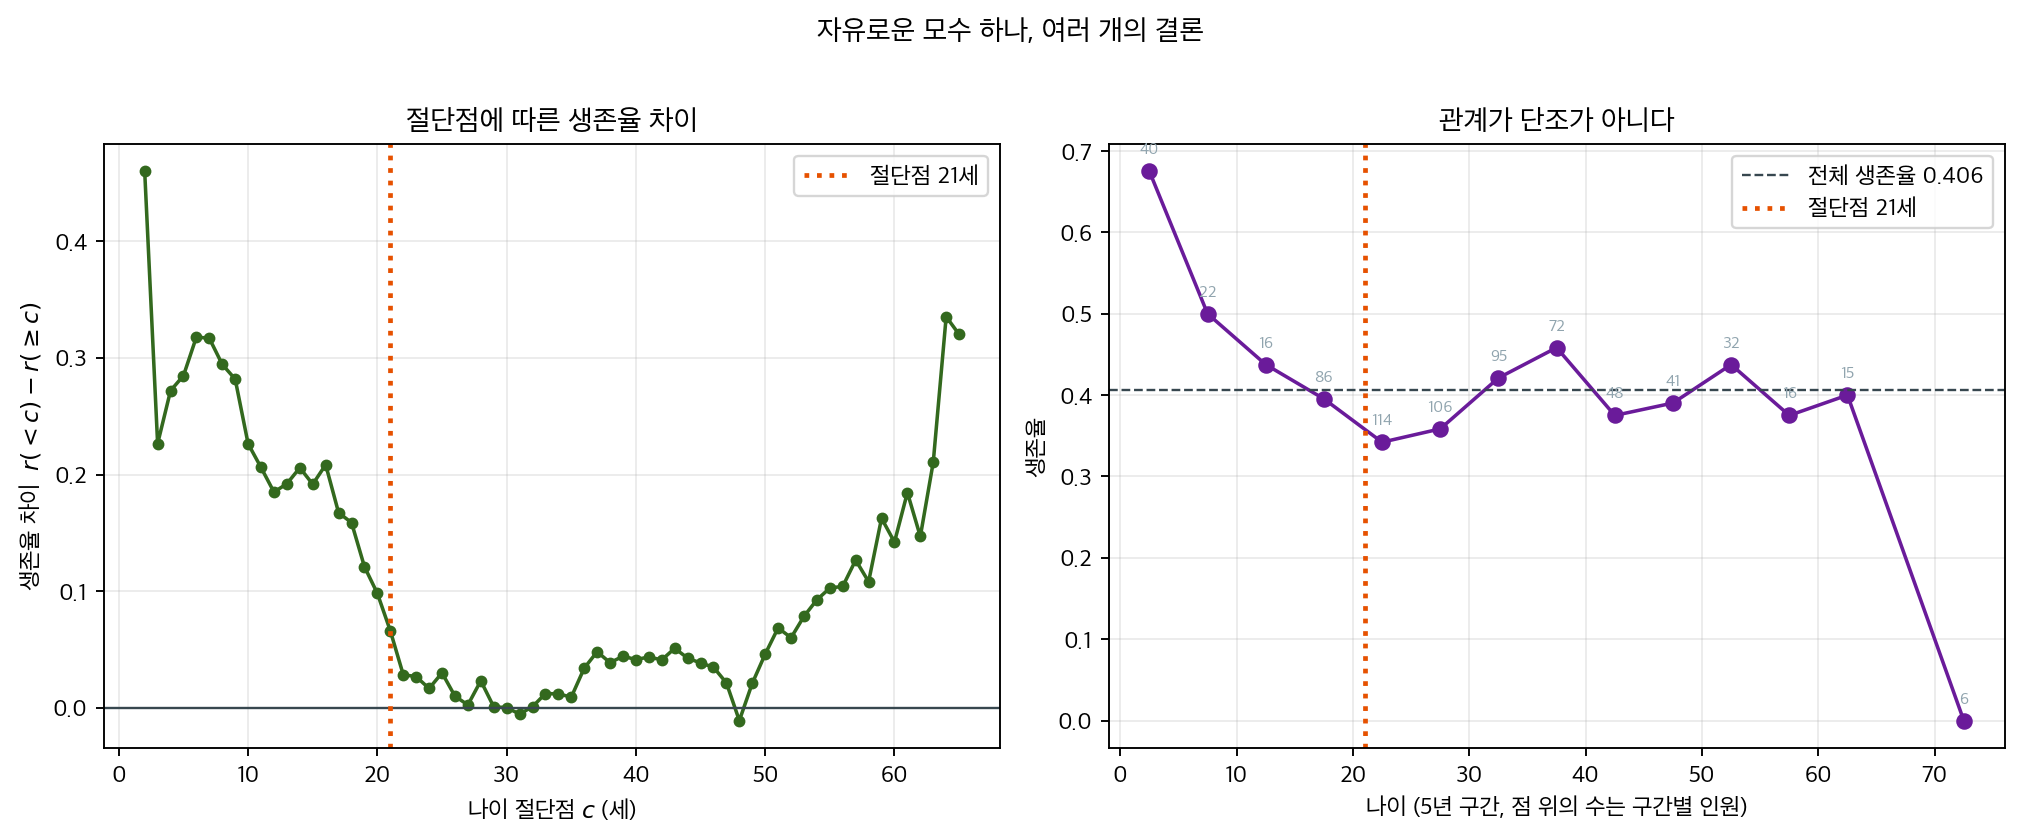
보기 5. 나이와 생존의 실제 모양. 절단점에 따른 차이 곡선과 \(5\)년 구간별 생존율을 나란히 그린다.
(1) \(10\)년 구간별 생존율을 보고, 관계가 단조가 아님을 보이시오.
(2) \(21\)세 미만 집단의 생존율 \(0.4556\)을 \(10\)세 미만과 \(10\)–\(21\)세의 가중평균으로 분해하여, \(21\)세가 왜 하필 나쁜 자리인지 수로 설명하시오.
풀이
(2) 해석적으로. 보기 1에서 쓴 가중평균을 한 번 더 쓴다. \(21\)세 미만을 \(10\)세에서 다시 가르면
이다. 그런데 두 조각의 생존율이 \(0.6129\)와 \(0.3729\)로 아주 다르다. 앞 조각은 전체 평균 \(0.4062\)보다 훨씬 높고 뒤 조각은 낮다. 섞으면 서로 상쇄되어 가운데 어딘가가 나온다.
실제로 \(n_{<10} = 62\), \(n_{[10,21)} = 118\)이므로 무게가 \(0.3444\)와 \(0.6556\)이고
이다. \(10\)세 미만의 강한 신호가 \(10\)–\(21\)세의 약한 신호에 묻혀 \(0.613\)이 \(0.456\)으로 희석된다. 절단점을 \(10\)세 근처에 두면 앞 조각만 분리되어 신호가 살아나고, \(21\)세에 두면 두 조각이 섞여 버린다.
(1)·(2) 수치적으로.
fig, ax = plt.subplots(1, 2, figsize=(12, 4.8))

dif = [sur[age < c].mean() - sur[age >= c].mean() for c in CUTS]

# (1) 절단점에 따른 생존율 차이
ax[0].plot(CUTS, dif, "o-", ms=4, color="#33691E")
ax[0].axhline(0, color="#37474F", lw=1)
ax[0].axvline(21, color="#E65100", ls=":", lw=2, label="절단점 21세")
ax[0].set_xlabel("나이 절단점 $c$ (세)")
# mathtext 는 \ge 를 모른다. \geq 로 써야 한다.
ax[0].set_ylabel("생존율 차이  $r(<c) - r(\\geq c)$")
ax[0].set_title("절단점에 따른 생존율 차이")
ax[0].legend(); ax[0].grid(alpha=0.25)

# (2) 5년 구간별 생존율 -- 자르지 않고 본 실제 모양
edges = np.arange(0, 85, 5)
mid, rt, cnt = [], [], []
for i in range(len(edges) - 1):
    m = (age >= edges[i]) & (age < edges[i + 1])
    if m.sum() >= 5:
        mid.append((edges[i] + edges[i + 1]) / 2)
        rt.append(sur[m].mean()); cnt.append(m.sum())
ax[1].plot(mid, rt, "o-", color="#6A1B9A", ms=6)
for x_, y_, n_ in zip(mid, rt, cnt):        # 각 점 위에 표본 크기를 적는다
    ax[1].annotate(f"{n_}", (x_, y_), textcoords="offset points",
                   xytext=(0, 7), ha="center", fontsize=7, color="#90A4AE")
ax[1].axhline(sur.mean(), color="#37474F", ls="--", lw=1,
              label=f"전체 생존율 {sur.mean():.3f}")
ax[1].axvline(21, color="#E65100", ls=":", lw=2, label="절단점 21세")
ax[1].set_xlabel("나이 (5년 구간, 점 위의 수는 구간별 인원)")
ax[1].set_ylabel("생존율")
ax[1].set_title("관계가 단조가 아니다")
ax[1].legend(); ax[1].grid(alpha=0.25)

fig.suptitle("자유로운 모수 하나, 여러 개의 결론", y=1.02)
fig.tight_layout()
fig.savefig("titanic_cutoff_sweep.png", dpi=170, facecolor="white",
            bbox_inches="tight")

# 10년 단위로 묶어 숫자로도 본다.
g = d.groupby(pd.cut(d["Age"], [0, 10, 20, 30, 40, 50, 60, 81],
                     right=False))["Survived"].agg(["count", "sum", "mean"])
print(g.round(4).to_string())

# --- 21세 미만의 생존율을 두 조각의 가중평균으로 분해한다 ---
m1 = age < 10
m2 = (age >= 10) & (age < 21)
w1 = m1.sum() / (m1 | m2).sum()
print(f"\n10세 미만   n={m1.sum():3d}  생존 {int(sur[m1].sum()):3d}  r={sur[m1].mean():.6f}")
print(f"10~21세     n={m2.sum():3d}  생존 {int(sur[m2].sum()):3d}  r={sur[m2].mean():.6f}")
print(f"  가중평균 {w1:.6f}*{sur[m1].mean():.6f} + {1 - w1:.6f}*{sur[m2].mean():.6f}"
      f" = {w1 * sur[m1].mean() + (1 - w1) * sur[m2].mean():.6f}")
print(f"  실제 21세 미만 생존율                                      = {sur[m1 | m2].mean():.6f}")
print(f"  전체 생존율 ybar = {sur.mean():.6f}")
          count  sum    mean
Age
[0, 10)      62   38  0.6129
[10, 20)    102   41  0.4020
[20, 30)    220   77  0.3500
[30, 40)    167   73  0.4371
[40, 50)     89   34  0.3820
[50, 60)     48   20  0.4167
[60, 81)     26    7  0.2692

10세 미만   n= 62  생존  38  r=0.612903
10~21세     n=118  생존  44  r=0.372881
  가중평균 0.344444*0.612903 + 0.655556*0.372881 = 0.455556
  실제 21세 미만 생존율                                      = 0.455556
  전체 생존율 ybar = 0.406162
관계가 단조가 아니다.
내려갔다가 올라갔다가 다시 내려간다. 10세 미만이 0.613으로 가장 높고, 20대가 0.350으로 바닥이고, 60세 이상이 0.269로 다시 낮다.
단 하나의 절단점으로는 이런 모양을 잡을 수 없다. 절단점 하나는 자료를 "왼쪽 평균 대 오른쪽 평균"으로만 요약하는데, 왼쪽에 높은 값과 낮은 값이 섞여 있으면 서로 상쇄된다.
21세가 하필 가장 나쁜 자리다.
21세 미만 = [0~10세의 0.613]  +  [10~20세의 0.402]  -> 섞여서 0.456
21세 이상 = 20대부터 60대까지 대체로 0.35~0.44   -> 0.390

두 평균이 비슷해진다 -> 차이 +0.066
(2)의 분해가 그것을 소수 여섯째 자리까지 확인해 준다. \(0.344444 \times 0.612903 + 0.655556 \times 0.372881 = 0.455556\)이다. \(10\)세 미만의 \(0.613\)이 \(10\)–\(21\)세의 \(0.373\)과 섞여 \(0.456\)으로 주저앉았고, 그 값이 전체 평균 \(0.4062\)에서 겨우 \(0.049\) 떨어져 있다. 보기 4의 식 \(\Delta = (r_{<c} - \bar y)/(1-\pi)\)에 넣으면 \(0.049394/0.747899 = 0.0660\)이다.
어린 쪽 절단점에서 차이가 가장 커지는 이유도 같다. 5세 미만은 거의 전부 어린아이라 생존율이 높고, 그 위는 전부 섞여 있다. 어린아이 효과를 가장 순수하게 분리하는 자리가 그쪽이다.
64~65세에서 차이가 다시 커지는 것은 반대쪽 끝이다. 노인의 생존율이 낮아서다. 다만 65세 이상이 11명뿐이므로 이 값은 매우 불안정하다. 오른쪽 그림에서 그 점 위에 적힌 표본 크기가 그 사실을 알려 준다.
왼쪽 그림의 U자 모양이 이 모든 것을 요약한다. 절단점을 양 끝으로 밀수록 차이가 커지고, 가운데(30세 근처)에서 정확히 0이 된다.
6. "가장 좋은" 절단점을 고르면
그전에 — "차이가 있다"는 것을 어떻게 정하는가
4절의 표를 다시 보면 이상한 자리가 하나 있다. 20세와 21세다. 한 살 차이인데 이야기가 갈린다.
| 절단점 | 어린 쪽 | 나이 든 쪽 | 차이 |
|---|---|---|---|
| 20세 | 48.17% (164명) | 38.36% (550명) | \(+9.81\)%포인트 |
| 21세 | 45.56% (180명) | 38.95% (534명) | \(+6.60\)%포인트 |
둘 다 "어린 쪽이 더 살아남았다"고 말한다. 차이의 크기도 9.8%포인트와 6.6%포인트로 크게 다르지 않다. 그런데 이 차이를 믿어도 되는가.
표본이 714명뿐이고, 생존에는 우연이 섞여 있다. 차이가 0이 아니라는 것만으로는 부족하다. 우연히 이 정도 차이가 생길 수도 있기 때문이다.
이 물음에 답하는 도구가 \(p\)값이다. "나이와 생존이 정말 무관하다면, 이만한 차이가 우연히 생길 확률은 얼마인가"를 재는 수다.
| 절단점 | 차이 | \(p\)값 | 관례적 판정(\(\alpha=0.05\)) |
|---|---|---|---|
| 20세 | \(+9.81\)%포인트 | 0.025 | 우연으로 보기 어렵다 |
| 21세 | \(+6.60\)%포인트 | 0.119 | 우연으로 설명될 수 있다 |
한 살 차이로 판정이 뒤집힌다. 이것이 이 절 제목의 뜻이기도 하다.
\(p\)값은 9장에서 제대로 배운다
여기서는 결과만 빌려 왔다. \(p\)값이 무엇이고 왜 그렇게 계산되는지는 검정통계량과 p-값 절에서, 이 자료를 끝까지 계산하는 것은 p-해킹 시연 - 타이타닉 절단점 탐색 절에서 다룬다.
숫자를 직접 확인할 때 주의할 점이 있다. scipy.stats.chi2_contingency 는 \(2\times2\) 표에 예이츠 연속성 보정을 기본으로 건다(correction=True). 이 책은 보정 없는 값을 쓴다.
| 절단점 | 보정 없음 (이 책) | scipy 기본값 |
|---|---|---|
| 20세 | 0.025 | 0.031 |
| 21세 | 0.119 | 0.141 |
판정은 어느 쪽이든 같다. 이 책이 보정 없는 값을 쓰는 이유는 \(\chi^2=n\varphi^2\) 같은 대수적 관계가 보정 없는 통계량에서만 성립하기 때문이다. 자세한 것은 독립성 검정 - 타이타닉 생존과 성별 절 보기 3에 있다.
재판이 하는 일과 같다
\(p\)값의 논리는 형사재판의 논리와 같은 모양이다.
재판                          통계적 검정
──────────────────────────    ──────────────────────────
피고는 무죄라고 가정한다        나이와 생존은 무관하다고 가정한다
     ↓                             ↓
증거가 차고 넘쳐야 유죄         자료가 충분히 치우쳐야 "관계 있다"
     ↓                             ↓
증거 부족 -> 무죄 평결          p값이 크다 -> 관계를 주장하지 않는다
두 가설이 대등하지 않다는 것이 핵심이다. 재판은 무죄를 기본으로 놓고, 유죄를 주장하는 쪽이 증거를 대야 한다. 검정도 "관계 없음"을 기본으로 놓고, 관계를 주장하려면 자료가 증거를 대야 한다.
그래서 "무죄 평결"이 "결백의 증명"이 아니다. 증거가 부족했다는 뜻일 뿐이다. 마찬가지로 \(p=0.119\)는 "나이가 생존과 무관하다"를 뜻하지 않는다. 이 자료로는 관계를 주장할 만큼 증거가 모이지 않았다는 뜻이다.
증거의 문턱은 하나가 아니다
O. J. 심슨은 1995년 형사재판에서 무죄 평결을 받았지만, 1997년 민사재판에서는 배상 책임이 인정되었다. 같은 사건, 같은 증거인데 결론이 갈렸다.
형사재판은 "합리적 의심을 넘어서는" 증거를 요구하고 민사재판은 "증거의 우위"만 요구하기 때문이다. 문턱을 어디에 두느냐가 결론을 바꾼다.
통계에서 \(\alpha\)가 그 문턱이다. \(\alpha=0.05\)는 관례일 뿐 자연법칙이 아니며, 틀렸을 때의 대가가 큰 분야에서는 훨씬 엄격한 값을 쓴다.
그렇다면 가장 좋은 절단점을 고르면 되지 않는가
절단점을 훑어보고 차이가 가장 큰 것을 고르면 되지 않을까. 2세에서 46%포인트니 대단한 발견이 아닌가.
그럴 수 없다. 64개를 시도하고 가장 좋은 것을 골랐기 때문이다.
이유를 정확히 말하려면 "나이와 생존이 정말 무관하다면 이런 일이 얼마나 자주 일어나는가"를 재야 하고, 그것은 확률과 표본분포가 필요한 일이다. 답만 미리 말해 두면 이렇다.
나이와 생존이 완전히 무관한 자료에서도, 절단점을 64개 훑어보면 52%의 확률로 "유의한 절단점"이 하나쯤 발견된다.
절반이 넘는다. 그러니까 "가장 좋은 절단점을 찾았다"는 말은 그 자체로는 아무 증거도 아니다. 절단점을 자료를 보고 고르는 순간, 그 뒤에 붙는 어떤 숫자도 액면 그대로 읽을 수 없게 된다.
이 52%가 어디서 나오는지, 어떻게 보정하는지, 그리고 이 자료의 신호는 보정 후에도 살아남는지는 p-해킹 시연 - 타이타닉 절단점 탐색 절에서 다룬다.
절단점은 자료 밖에서 와야 한다
자료를 보기 전에 절단점을 정했다면 아무 문제가 없다. 임상 기준, 법적 정의, 사전에 등록한 분석 계획이 그런 경우다.
자료를 보고 정했다면 그 절단점으로 얻은 결과는 발견이 아니라 탐색의 부산물이다. 보고할 때 반드시 몇 개를 시도했는지 밝혀야 한다.
2장에서 할 수 있는 일은 여기까지다 — 절단점에 따라 답이 요동친다는 사실을 아는 것, 그리고 그것을 숨기지 않는 것이다.
7. 애초에 자르지 않으면 된다
지금까지의 문제는 전부 자른다는 결정에서 나왔다. 자르지 않으면 절단점을 고를 일도 없다.
5절의 오른쪽 그림이 이미 답이다. 5년 구간별 생존율 곡선은 절단점 하나 없이도 나이와 생존의 관계를 훨씬 충실하게 보여 준다 — 어린아이에서 높고, 20대에서 바닥이고, 30대에서 조금 올라오고, 노년에서 다시 떨어진다. 절단점 하나로 만든 두 집단 요약("45.6% 대 39.0%")은 이 모양을 전부 뭉개 버린다.
일반적으로도 그렇다. 연속형 변수를 둘로 자르면 같은 집단 안의 차이를 전부 버린다. 3세와 20세가 같은 칸에 들어가고, 22세와 80세가 같은 칸에 들어간다.
이 손실이 얼마나 큰지 — 이분화가 검정력에서 치르는 대가와 모형 비교 — 는 p-해킹 시연 - 타이타닉 절단점 탐색 절에서 정량적으로 다룬다. 미리 말해 두면 중앙값 분할만으로도 자료의 3분의 1을 버리는 것과 같다.
그래도 이분화해야 하는 경우
이분화가 언제나 나쁜 것은 아니다. 정당한 이유가 하나 있다.
| 이유 | 정당한가 |
|---|---|
| 임상적·법적 절단점이 미리 정해져 있다 | 그렇다 |
| 해석이 쉬워서 | 아니다. 구간별 비율도 충분히 쉽다 |
| 정규성 가정을 피하려고 | 아니다. 이분화가 정규성을 주지 않는다 |
| 관계가 비선형이라서 | 아니다. 구간을 여럿 두면 된다 |
| 자료를 보고 최적점을 찾아서 | 절대 아니다(6절) |
핵심은 절단점이 어디서 왔느냐다. 타이타닉에서 "여성과 어린이 먼저"의 어린이가 당시 규정으로 몇 살이었는지 문서로 확인된다면, 그 나이를 절단점으로 쓰는 것은 정당하다. 자료가 아니라 자료 밖의 지식이 절단점을 정할 때만 그렇다.
정리하며
연속형 변수를 둘로 잘라 분할표를 만드는 일은 보기보다 훨씬 위험하다.
- 절단점은 자료가 아니라 분석자가 정한다. 2세에서 차이 \(+46\)%포인트, 21세에서 \(+6.6\)%포인트, 30세에서 \(+0.02\)%포인트다.
- 오즈비도 함께 요동친다. 65세에서 6.98, 21세에서 1.31, 30세에서 1.00이다. 같은 자료에서 "여섯 배"와 "차이 없음"을 둘 다 얻을 수 있다.
- 나이와 생존의 관계는 단조가 아니다. \(0.613\to0.350\to0.437\to0.269\)으로 오르내리므로, 절단점 하나로는 표현할 수 없다.
- 21세가 하필 가장 나쁜 자리다. 생존율이 높은 0~10세와 낮은 10~20세를 한 칸에 섞어 버려 두 집단의 평균이 비슷해진다.
- 자르지 않으면 모양이 보인다. 5년 구간별 생존율 곡선은 절단점 하나 없이 관계 전체를 보여 준다.
- "가장 좋은 절단점"을 고르는 것은 발견이 아니다. 무관한 자료에서도 절반이 넘는 확률로 그런 절단점이 나온다.
- 자를 정당한 이유는 자료 밖에서 정해진 절단점이 있을 때뿐이다.
앞 절과 묶어 보면 교훈이 하나로 모인다. 분할표는 자료가 주는 것이 아니라 우리가 만드는 것이며, 만드는 과정의 선택이 결론에 그대로 흘러든다.
연습문제
연습문제 1. 보기 4에서 30세 절단점의 \(\chi^2\)이 0.000이었다. 생존율이 정확히 같아지는 절단점이 존재함을 설명하고, 그런 절단점을 모두 찾아라.
풀이
중간값 정리와 같은 발상이다. 절단점 \(c\)에 대해
를 생각하자. 4절에서 보았듯 \(g\)는 작은 \(c\)에서 양수(\(+0.28\))이고 30세 근처에서 0을 지나며, 다시 양수가 된다. \(g\)가 부호를 바꾸는 지점에 \(g=0\)인 절단점이 있다.
다만 \(g\)는 연속함수가 아니라 계단함수다. 관측된 나이 값에서만 뛰므로, 정확히 0이 되는 보장은 없고 0에 가장 가까운 계단이 있을 뿐이다.
age = d["Age"].to_numpy()
sur = d["Survived"].to_numpy()
CUTS = [c for c in range(1, 80)
        if (age < c).sum() >= 10 and (age >= c).sum() >= 10]

gaps = [(c, sur[age < c].mean() - sur[age >= c].mean()) for c in CUTS]
gaps.sort(key=lambda z: abs(z[1]))
print("생존율 차이가 0에 가장 가까운 절단점 다섯")
print(f"{'절단점':>7s}{'n<c':>6s}{'생존율<':>9s}{'생존율>=':>10s}{'차이':>11s}")
for c, g in gaps[:5]:
    print(f"{c:>7d}{(age < c).sum():>6d}{sur[age < c].mean():>9.4f}"
          f"{sur[age >= c].mean():>10.4f}{g:>+11.6f}")

# 부호가 바뀌는 곳을 찾는다.
seq = [(c, sur[age < c].mean() - sur[age >= c].mean()) for c in CUTS]
print("\n차이의 부호가 바뀌는 구간")
for i in range(1, len(seq)):
    if np.sign(seq[i][1]) != np.sign(seq[i - 1][1]):
        print(f"  {seq[i-1][0]}세 ({seq[i-1][1]:+.6f}) "
              f"-> {seq[i][0]}세 ({seq[i][1]:+.6f})")
생존율 차이가 0에 가장 가까운 절단점 다섯
    절단점   n<c     생존율<     생존율>=         차이
     30   384   0.4062    0.4061  +0.000189
     29   364   0.4066    0.4057  +0.000879
     32   428   0.4065    0.4056  +0.000948
     27   319   0.4075    0.4051  +0.002460
     31   411   0.4039    0.4092  -0.005348

차이의 부호가 바뀌는 구간
  30세 (+0.000189) -> 31세 (-0.005348)
  31세 (-0.005348) -> 32세 (+0.000948)
  47세 (+0.021336) -> 48세 (-0.010930)
  48세 (-0.010930) -> 49세 (+0.021017)
30세에서 차이가 \(+0.000189\)이다. 정확히 0은 아니지만 소수점 셋째 자리까지는 0이다.
| 절단점 | 차이 |
|---|---|
| 30세 | \(+0.000189\) |
| 29세 | \(+0.000879\) |
| 31세 | \(-0.005348\) |
30세와 31세 사이에서 부호가 바뀐다. 만약 나이가 연속적으로 관측되었다면 그 사이 어딘가에 정확히 \(g=0\)인 점이 있었을 것이다.
이것이 절단점 방법의 근본적인 취약성을 드러낸다. "30세를 기준으로 나누면 나이는 생존과 무관하다"는 문장은 참이지만, 완전히 오해를 부른다. 자료에는 분명한 나이 효과가 있는데(어린이 0.613, 노인 0.269) 절단점이 그것을 정확히 상쇄하는 자리에 놓였을 뿐이다.
비단조 관계에서는 이런 "우연의 영점"이 반드시 존재한다. 관계가 단조라면 \(g(c)\)가 부호를 바꾸지 않으므로 이런 일이 없다. \(\square\)
연습문제 2. 성별을 함께 고려하면 나이의 효과가 어떻게 보이는가? 앞 절의 결과와 이어 보라.
풀이
import numpy as np
import pandas as pd

print("성별로 나눈 나이대별 생존율")
bins = [0, 10, 20, 30, 40, 50, 81]
d["AgeBin"] = pd.cut(d["Age"], bins, right=False)
t = d.pivot_table(index="AgeBin", columns="Sex",
                  values="Survived", aggfunc=["count", "mean"],
                  observed=True)
print(t.round(4).to_string())
성별로 나눈 나이대별 생존율
          count         mean
Sex      female male  female    male
AgeBin
[0, 10)      30   32  0.6333  0.5938
[10, 20)     45   57  0.7556  0.1228
[20, 30)     72  148  0.7222  0.1689
[30, 40)     60  107  0.8333  0.2150
[40, 50)     32   57  0.6875  0.2105
[50, 81)     22   52  0.9091  0.1346
성별로 나누면 이야기가 완전히 달라진다.
| 나이대 | 여성 | 남성 | 차이 |
|---|---|---|---|
| 0–10 | 0.633 | 0.594 | 0.04 |
| 10–20 | 0.756 | 0.123 | 0.63 |
| 20–30 | 0.722 | 0.169 | 0.55 |
| 30–40 | 0.833 | 0.215 | 0.62 |
| 40–50 | 0.688 | 0.211 | 0.48 |
| 50+ | 0.909 | 0.135 | 0.77 |
10세 미만에서만 남녀 차이가 사라진다(0.633 대 0.594). 나머지 모든 구간에서 여성이 0.48~0.77만큼 높다.
"여성과 어린이 먼저"가 자료에 그대로 찍혀 있다.
남자아이(10세 미만) 생존율 0.594
남자   (10세 이상) 생존율 0.123 ~ 0.215

-> 남성에게는 '어린이' 지위가 결정적이었다
여성에게는 나이가 오히려 반대로 작용한다. 여자아이가 0.633으로 가장 낮고 50세 이상이 0.909로 가장 높다. 성인 여성일수록 잘 살아남았다.
나이의 방향이 성별에 따라 반대다. 표의 두 열을 위에서 아래로 훑어보면 곧바로 보인다.
# 두 열이 각각 어느 쪽으로 움직이는지 첫 구간과 끝 구간으로 견준다.
rates = t["mean"]
for sex in ["female", "male"]:
    col = rates[sex]
    print(f"{sex:7s} 10세 미만 {col.iloc[0]:.4f}  ->  "
          f"50세 이상 {col.iloc[-1]:.4f}   "
          f"({col.iloc[-1] - col.iloc[0]:+.4f})")
    print(f"{'':7s} 최소 {col.min():.4f}, 최대 {col.max():.4f}")
female  10세 미만 0.6333  ->  50세 이상 0.9091   (+0.2758)
        최소 0.6333, 최대 0.9091
male    10세 미만 0.5938  ->  50세 이상 0.1346   (-0.4591)
        최소 0.1228, 최대 0.5938
여성은 나이가 많을수록 생존율이 올라가고, 남성은 내려간다.
| 집단 | 10세 미만 | 50세 이상 | 방향 |
|---|---|---|---|
| 여성 | 0.6333 | 0.9091 | ↑ \(+0.28\) |
| 남성 | 0.5938 | 0.1346 | ↓ \(-0.46\) |
여성에게는 나이가 오히려 유리하게 작용했다. 여자아이가 0.633으로 가장 낮고 50세 이상이 0.909로 가장 높다.
남성에게는 10세가 절벽이다. 남자아이 0.594에서 10대 0.123으로 한 칸 만에 떨어진다.
4절에서 본 "나이 효과"의 정체가 여기서 밝혀진다.
전체에서 본 나이 효과 (21세 절단점에서 차이 +0.066, 아주 약함)
  = 여성의 상승 추세  와  남성의 하강 추세  를 뭉뚱그린 결과

-> 방향이 반대인 두 흐름이 서로 상쇄되어 약해진 것이다
교훈. 전체에서 본 약한 나이 효과는 방향이 반대인 두 흐름을 평균낸 허상이다. 하나씩 따로 보는 이변량 탐색의 한계이며, 층화가 그것을 드러낸다.
이 상쇄를 하나의 모형으로 다루려면 상호작용항이 필요하고, 그것이 정말 우연이 아닌지 판정하는 일은 로지스틱 회귀의 몫이다. \(\square\)
연습문제 3. 보기 3에서 두 집단의 나이 중앙값이 28.00세로 같았다. 이것이 "나이 차이가 없다"는 뜻인가?
풀이
아니다. 중앙값이 같다는 것은 분포의 한 지점이 같다는 뜻일 뿐이다.
import numpy as np

a = d.loc[d["Survived"] == 0, "Age"].to_numpy()
b = d.loc[d["Survived"] == 1, "Age"].to_numpy()

print(f"{'분위수':>8s}{'사망':>9s}{'생존':>9s}{'차이':>9s}")
for q in [0.05, 0.10, 0.25, 0.50, 0.75, 0.90, 0.95]:
    qa, qb = np.quantile(a, q), np.quantile(b, q)
    print(f"{q:>8.2f}{qa:>9.2f}{qb:>9.2f}{qb - qa:>+9.2f}")

print(f"\n{'평균':>8s}{a.mean():>9.2f}{b.mean():>9.2f}{b.mean() - a.mean():>+9.2f}")
print(f"{'표준편차':>8s}{a.std(ddof=1):>9.2f}{b.std(ddof=1):>9.2f}")

# 차이가 어느 구간에 몰려 있는지 센다.
print(f"\n10세 미만 비율   사망 {(a < 10).mean():.4f}   생존 {(b < 10).mean():.4f}")
print(f"20~50세 비율    사망 {((a >= 20) & (a < 50)).mean():.4f}   "
      f"생존 {((b >= 20) & (b < 50)).mean():.4f}")
     분위수       사망       생존       차이
    0.05     9.00     2.45    -6.55
    0.10    16.00     5.00   -11.00
    0.25    21.00    19.00    -2.00
    0.50    28.00    28.00    +0.00
    0.75    39.00    36.00    -3.00
    0.90    50.00    49.00    -1.00
    0.95    58.00    54.00    -4.00

      평균    30.63    28.34    -2.28
    표준편차    14.17    14.95

10세 미만 비율   사망 0.0566   생존 0.1310
20~50세 비율    사망 0.6887   생존 0.6345
중앙값은 같지만 아래쪽 꼬리가 크게 다르다.
| 분위수 | 사망 | 생존 | 차이 |
|---|---|---|---|
| 0.05 | 9.00 | 2.45 | \(-6.55\) |
| 0.10 | 16.00 | 5.00 | \(-11.00\) |
| 0.25 | 21.00 | 19.00 | \(-2.00\) |
| 0.50 | 28.00 | 28.00 | 0.00 |
| 0.75 | 39.00 | 36.00 | \(-3.00\) |
| 0.95 | 58.00 | 54.00 | \(-4.00\) |
생존자의 10분위수가 5.00세, 사망자는 16.00세로 11세나 차이 난다. 반면 중앙값은 정확히 같다. 차이가 아래쪽 꼬리에만 있다.
차이가 몰려 있는 곳이 어디인지 마지막 두 줄이 말해 준다.
| 구간 | 사망 | 생존 |
|---|---|---|
| 10세 미만 | 0.0566 | 0.1310 |
| 20~50세 | 0.6887 | 0.6345 |
10세 미만이 생존자에서는 13.1%, 사망자에서는 5.7%로 두 배 넘게 차이난다. 가운데(20~50세)는 0.69 대 0.63으로 거의 같다.
요약통계가 놓치는 자리가 바로 여기다.
| 요약 | 사망 | 생존 | 차이를 잡는가 |
|---|---|---|---|
| 중앙값 | 28.00 | 28.00 | 전혀 못 잡는다 |
| 사분위수 \(Q_1,Q_3\) | 21, 39 | 19, 36 | 거의 못 잡는다 |
| 평균 | 30.63 | 28.34 | 조금 잡는다 |
| 0.10분위 | 16.00 | 5.00 | 잘 잡는다 |
평균이 중앙값보다 조금 낫다. 평균은 극단값에 끌리므로 아래쪽 꼬리의 어린아이들이 생존자 평균을 2.3세 끌어내렸다. 중앙값은 그 영향을 받지 않도록 설계된 통계량이라 정확히 같게 나온다.
강건성이 여기서는 단점이 된다. 중앙값의 강건함은 이상치에 흔들리지 않는다는 장점이지만, 신호 자체가 꼬리에 있을 때는 그 신호까지 무시한다.
교훈 셋.
- 요약통계 하나로 "차이 없음"을 말하면 안 된다. 중앙값이 같아도 분포는 다르다.
- 요약통계는 자기가 민감한 방향에만 민감하다. 중앙값·평균·분위수가 서로 다른 것을 본다.
- 분위수 표가 요약 하나보다 훨씬 많은 것을 말한다. "0.10분위가 5세 대 16세"라는 한 줄이 가장 유용하다.
두 분포가 "우연으로 설명될 만큼만 다른지"를 판정하는 방법 — 그리고 어떤 검정을 고르느냐에 따라 답이 달라진다는 것 — 은 비모수 검정 장에서 다룬다. 신호가 꼬리에 있는 이 자료가 그 장의 좋은 예가 된다. \(\square\)
연습문제 4. 절단점을 하나가 아니라 둘로 늘려 세 집단을 만들면 나아지는가?
풀이
import numpy as np
import pandas as pd

print("두 절단점 (c1, c2) 로 세 집단을 만든다")
print(f"{'c1':>4s}{'c2':>4s}{'n1':>5s}{'n2':>5s}{'n3':>5s}"
      f"{'r1':>8s}{'r2':>8s}{'r3':>8s}{'최대차':>8s}")
for c1 in [5, 10, 15]:
    for c2 in [20, 30, 40, 50, 60]:
        g = np.digitize(age, [c1, c2])
        ns = [(g == k).sum() for k in range(3)]
        if min(ns) < 10:
            continue
        rs = [sur[g == k].mean() for k in range(3)]
        if c1 == 10 or c2 == 60:
            print(f"{c1:>4d}{c2:>4d}{ns[0]:>5d}{ns[1]:>5d}{ns[2]:>5d}"
                  f"{rs[0]:>8.4f}{rs[1]:>8.4f}{rs[2]:>8.4f}"
                  f"{max(rs) - min(rs):>8.4f}")

# 단일 절단점 10세로 만든 두 집단과 견준다.
m = age < 10
print(f"\n단일 절단점 10세: {m.sum()}명 {sur[m].mean():.4f}  "
      f"vs  {(~m).sum()}명 {sur[~m].mean():.4f}  "
      f"(차이 {sur[m].mean() - sur[~m].mean():+.4f})")
두 절단점 (c1, c2) 로 세 집단을 만든다
  c1  c2   n1   n2   n3      r1      r2      r3     최대차
   5  60   40  648   26  0.6750  0.3951  0.2692  0.4058
  10  20   62  102  550  0.6129  0.4020  0.3836  0.2293
  10  30   62  322  330  0.6129  0.3665  0.4061  0.2464
  10  40   62  489  163  0.6129  0.3906  0.3742  0.2387
  10  50   62  578   74  0.6129  0.3893  0.3649  0.2480
  10  60   62  626   26  0.6129  0.3914  0.2692  0.3437
  15  60   78  610   26  0.5769  0.3902  0.2692  0.3077

단일 절단점 10세: 62명 0.6129  vs  652명 0.3865  (차이 +0.2264)
둘째 절단점이 대개 아무 일도 하지 않는다.
(10, 20) 조합을 보라. 10~20세가 0.4020, 20세 이상이 0.3836이다. 두 집단의 생존율이 사실상 같으므로, 20세라는 경계는 그냥 그은 선이다. 세 집단으로 나눈 보람이 없다.
| 조합 | 세 생존율 | 둘째 경계가 하는 일 |
|---|---|---|
| (10, 20) | 0.613 / 0.402 / 0.384 | 거의 없음 |
| (10, 40) | 0.613 / 0.391 / 0.374 | 거의 없음 |
| (5, 60) | 0.675 / 0.395 / 0.269 | 노인을 분리 |
예외는 둘째 절단점을 60세에 둘 때다. 셋째 집단의 0.2692가 노인 효과를 잡아내 최대차가 0.41까지 벌어진다. 5절에서 본 U자의 오른쪽 끝이다.
그러나 그 집단은 26명뿐이다. 표본이 작아 값이 불안정하다. 절단점을 늘릴수록 각 집단의 \(n\)이 줄어드는 것이 근본적인 대가다.
| 절단점 수 | 얻는 것 | 잃는 것 |
|---|---|---|
| 1 | 가장 단순 | 비단조를 못 잡음 |
| 2~3 | 비단조 표현 가능 | 각 집단의 \(n\) |
| 많이 | 유연함 | 집단당 표본이 너무 작아짐 |
| 자르지 않음 | 정보 전부 | 해석이 덜 직관적 |
그리고 6절의 문제가 훨씬 심해진다. 단일 절단점이 64개 후보였다면, 두 절단점은 \(\binom{64}{2}=2016\)개다. 고를 수 있는 것이 많아질수록 "가장 좋은 조합"은 더 믿을 수 없어진다(자세한 것은 p-해킹 시연 - 타이타닉 절단점 탐색 절).
결론. 절단점을 늘리는 것은 해법이 아니다. 5절에서 한 것처럼 구간을 여럿 두고 곡선을 그리거나, 아예 자르지 않는 것이 모양을 보는 방법이다. \(\square\)
연습문제 5. 이 절의 분석은 나이가 기록된 714명만 썼다. 빠진 177명 때문에 결론이 달라질 수 있는가?
풀이
가장 나쁜 경우와 가장 좋은 경우를 계산해 본다. 결측된 177명의 나이를 알 수 없으므로, 양극단을 가정해 결론의 범위를 본다.
import numpy as np
import pandas as pd

full = df.copy()
miss = full["Age"].isna()
print(f"결측 {miss.sum()}명의 생존율 {full.loc[miss, 'Survived'].mean():.4f}")
print(f"관측 {(~miss).sum()}명의 생존율 {full.loc[~miss, 'Survived'].mean():.4f}\n")

# 관측된 자료에서의 21세 분할
obs = full[~miss]
lo_n = (obs["Age"] < 21).sum(); lo_s = obs.loc[obs["Age"] < 21, "Survived"].sum()
hi_n = (obs["Age"] >= 21).sum(); hi_s = obs.loc[obs["Age"] >= 21, "Survived"].sum()
m_n = miss.sum(); m_s = full.loc[miss, "Survived"].sum()
print(f"관측:  <21  {lo_s}/{lo_n},  >=21  {hi_s}/{hi_n}")
print(f"결측:  생존 {m_s}/{m_n}\n")

print("결측자를 전부 한쪽에 몰아넣으면")
print(f"{'가정':>26s}{'rate<21':>10s}{'rate>=21':>11s}{'차이':>9s}"
      f"{'오즈비':>9s}")
for lab, (a, n1, c, n2) in {
    "관측 자료만 (실제 분석)": (lo_s, lo_n, hi_s, hi_n),
    "전부 21세 미만": (lo_s + m_s, lo_n + m_n, hi_s, hi_n),
    "전부 21세 이상": (lo_s, lo_n, hi_s + m_s, hi_n + m_n),
}.items():
    p1, p2 = a / n1, c / n2
    odds = (p1 / (1 - p1)) / (p2 / (1 - p2))
    print(f"{lab:>26s}{p1:>10.4f}{p2:>11.4f}{p1 - p2:>+9.4f}"
          f"{odds:>9.4f}")
결측 177명의 생존율 0.2938
관측 714명의 생존율 0.4062

관측:  <21  82/180,  >=21  208/534
결측:  생존 52/177

결측자를 전부 한쪽에 몰아넣으면
                        가정   rate<21   rate>=21       차이      오즈비
            관측 자료만 (실제 분석)    0.4556     0.3895  +0.0660   1.3114
                 전부 21세 미만    0.3754     0.3895  -0.0142   0.9418
                 전부 21세 이상    0.4556     0.3657  +0.0899   1.4514
두 극단이 부호부터 반대다.
| 가정 | 차이 | 오즈비 | 읽히는 이야기 |
|---|---|---|---|
| 결측자 전부 21세 미만 | \(\mathbf{-0.0142}\) | 0.94 | 어린 쪽이 오히려 덜 살아남음 |
| 관측 자료만(실제 분석) | \(+0.0660\) | 1.31 | 어린 쪽이 조금 더 살아남음 |
| 결측자 전부 21세 이상 | \(\mathbf{+0.0899}\) | 1.45 | 어린 쪽이 더 살아남음 |
결측 177명을 어떻게 가정하느냐에 따라 결론의 방향까지 바뀐다. 이것이 민감도 분석이며, 결측이 많을 때 반드시 해야 하는 점검이다.
관측 자료만 쓴 값(+0.066)이 두 극단 사이에 있다는 것도 확인해 둘 만하다. 결측을 무시한 분석은 양극단의 어딘가를 보고하는 셈이고, 그 폭이 \(-0.014\)에서 \(+0.090\)까지다.
현실적으로 어느 쪽에 가까운가. 나이를 기록하지 못한 이유를 생각하면, 3등실 성인 승객일 가능성이 높다(앞 절 연습문제 3에서 결측자의 1등실 비율이 낮았다). 그렇다면 "전부 21세 이상" 쪽에 가깝고, 나이 효과가 실제로는 더 강할 수 있다.
# 결측자의 다른 특성으로 나이를 짐작해 본다.
print("\n결측 여부에 따른 다른 변수")
for col, lab in [("Pclass", "평균 객실등급"), ("SibSp", "평균 형제자매/배우자"),
                 ("Parch", "평균 부모/자녀"), ("Fare", "평균 운임")]:
    print(f"  {lab:18s} 관측 {full.loc[~miss, col].mean():7.3f}"
          f"   결측 {full.loc[miss, col].mean():7.3f}")
결측 여부에 따른 다른 변수
  평균 객실등급            관측   2.237   결측   2.599
  평균 형제자매/배우자        관측   0.513   결측   0.565
  평균 부모/자녀           관측   0.431   결측   0.181
  평균 운임              관측  34.695   결측  22.159
결측자는 객실등급이 낮고(2.60 대 2.24) 운임이 싸며(22.2 대 34.7) 동반 자녀가 적다(0.18 대 0.43).
자녀 동반이 적다는 것이 특히 시사적이다. 어린아이는 대개 부모와 함께 탔고 부모의 Parch가 1 이상이므로, 결측자 중에 어린이는 드물 것이다. 즉 "전부 21세 이상" 쪽 시나리오에 가깝다.
보고할 때. "나이가 기록된 714명으로 분석했다"로 끝내지 말고, 결측의 규모·패턴·민감도 분석 결과를 함께 밝힌다. \(\square\)
연습문제 6. 연속형 변수를 범주로 나눌 때의 지침을 정리하라.
풀이
결정 흐름.
연속형 변수를 잘라야 하는가?
    │
    ├─ 자료 밖에서 정해진 절단점이 있는가?
    │     (진단 기준, 법적 연령, 규정된 등급)
    │     └─ 예 -> 그 값을 쓴다. 출처를 밝힌다.
    │
    ├─ 해석의 편의를 위해서인가?
    │     └─ 회귀계수도 충분히 해석 가능하다. 자르지 않는다.
    │
    ├─ 관계가 비선형이라서인가?
    │     └─ 스플라인 · 다항항 · 구간 더미를 쓴다.
    │
    └─ 자료를 보고 좋은 절단점을 찾았는가?
          └─ 절대 그대로 보고하지 않는다. (1종 오류 0.52)
             순열검정으로 보정하거나, 독립 표본에서 확인한다.
이 절의 핵심 수치 여섯.
| 사실 | 값 |
|---|---|
| 절단점 21세의 생존율 차이 | \(+0.0660\)(오즈비 1.31) |
| 절단점 2세의 생존율 차이 | \(\mathbf{+0.4600}\) |
| 절단점 30세의 생존율 차이 | \(\mathbf{+0.0002}\)(오즈비 1.00) |
| 5년 구간별 생존율 | \(0.613\to0.350\to0.437\to0.269\)(비단조) |
| 둘째 절단점을 20세에 두면 | 0.402 대 0.384(아무 일도 안 함) |
| 결측 177명 민감도 범위 | 차이 \(-0.014 \sim +0.090\)(부호가 바뀐다) |
흔한 실수 다섯.
| 실수 | 대가 |
|---|---|
| 자료를 보고 절단점 선택 | 발견이 아니라 탐색의 부산물 |
| 시도한 절단점을 보고 안 함 | 독자가 판단할 근거가 사라진다 |
| 한 절단점의 결과를 일반화 | 21세와 2세가 정반대 |
| 비단조 관계에 절단점 하나 | 효과가 상쇄된다 |
| 결측을 버리고 민감도 점검 안 함 | 결론의 부호가 뒤집힐 수 있음 |
보고 형식.
나이와 생존 (나이 기록 714/891명)

  나이를 자르지 않고 5년 구간별 생존율로 제시한다.
    0~10세 0.613, 20대 0.350, 30대 0.437, 60세 이상 0.269
    -> 비단조. 절단점 하나로는 요약할 수 없다.

  참고로 21세 기준 이분화는 45.6% 대 39.0% (차이 +6.6%포인트,
  오즈비 1.31)이나, 이 값은 절단점 21의 선택에 전적으로
  의존한다. 2세에서는 +46%포인트, 30세에서는 +0.02%포인트다.
  절단점을 해석의 근거로 삼지 않았다.

  결측 177명에 대한 민감도 분석 결과 차이의 범위는
  -0.014 ~ +0.090 으로 부호가 바뀔 수 있다.
"절단점을 쓰지 않았다"고 밝히는 것과 시도했다면 전부 보고하는 것이 이 절의 실무적 결론이다.
한 문장. 연속형 변수를 자르는 순간 자료에 없던 선택이 분석자의 손으로 들어오며, 그 선택이 결론을 좌우하므로, 자를 이유가 자료 밖에 있지 않다면 자르지 않는 것이 기본이다. \(\square\)
연습문제 7.
같은 절차를 나이 대신 운임(Fare)에 적용하라. 모든 절단점에서 생존율 차이를 구하고, 나이에서 본 불안정성이 운임에서도 나타나는지 확인하라. 결과가 다르다면 그 이유는 무엇인가?
풀이
import numpy as np, pandas as pd

URL = "https://raw.githubusercontent.com/datasciencedojo/datasets/f0ccab6a7ceafdff780052166fb6fab3311398eb/titanic.csv"
d = pd.read_csv(URL).dropna(subset=["Age"])
sur = d["Survived"].to_numpy()

for name in ("Fare", "Age"):
    v = d[name].to_numpy()
    hi = 101 if name == "Fare" else 80
    cuts = [c for c in range(1, hi)
            if (v < c).sum() >= 10 and (v >= c).sum() >= 10]
    gaps = [(c, sur[v < c].mean() - sur[v >= c].mean()) for c in cuts]
    g = [x for _, x in gaps]
    neg = sum(1 for x in g if x < 0)
    print(f"[{name}] 절단점 {len(cuts)}개 ({cuts[0]}~{cuts[-1]})")
    print(f"   차이 범위 [{min(g):+.4f}, {max(g):+.4f}]")
    print(f"   음수인 절단점 {neg}/{len(g)}개\n")
출력:
[Fare] 절단점 94개 (7~100)
   차이 범위 [-0.4167, -0.2349]
   음수인 절단점 94/94개

[Age] 절단점 64개 (2~65)
   차이 범위 [-0.0109, +0.4600]
   음수인 절단점 2/64개
운임에서는 불안정성이 사라진다. \(94\)개 절단점이 전부 같은 부호를 준다. 어디서 자르든 "운임이 높은 쪽이 더 많이 살아남았다"는 같은 결론이고, 차이의 크기도 \(23\)%포인트에서 \(42\)%포인트 사이로 안정적이다.
| 나이 | 운임 | |
|---|---|---|
| 부호가 일정한가 | 아니다(\(2/64\)가 반대) | 그렇다(\(94/94\)) |
| 차이의 범위 | \(-0.01 \sim +0.46\) | \(-0.42 \sim -0.23\) |
| 절단점 선택이 결론을 바꾸는가 | 바꾼다 | 바꾸지 않는다 |
이유는 관계의 모양이다. 운임과 생존은 단조이고 강하다. 운임이 오르면 생존율이 꾸준히 오르므로, 어디서 잘라도 "비싼 쪽이 높다"가 유지된다. 반면 5절에서 본 대로 나이와 생존의 관계는 비단조이고(어린이가 높고 중년이 낮고 노년이 다시 낮다) 약하다. 비단조인 곡선을 한 점에서 자르면, 자르는 위치에 따라 양쪽 평균의 대소가 뒤집힐 수 있다.
이 절의 결론을 정확히 다듬으면.
절단점이 결론을 바꾸는 것은 이분화 자체의 죄가 아니라, 관계가 약하고 비단조일 때 생기는 일이다.
그렇다고 운임을 잘라도 된다는 뜻은 아니다. 부호는 유지되지만 효과의 크기는 여전히 절단점에 따라 두 배 가까이 달라지고(\(0.23\) 대 \(0.42\)), 무엇보다 운임을 두 덩어리로 줄이면 "\(10\)달러와 \(500\)달러가 같은 칸"이 되는 정보 손실은 그대로다.
실무적 요령 하나. 자를지 말지 고민될 때는 모든 절단점을 훑어 부호와 크기가 안정적인지 먼저 보라. 위 코드 몇 줄이면 된다. 안정적이면 이분화가 최소한 결론을 뒤집지는 않고, 불안정하면 자르지 말아야 한다는 강한 신호다. \(\square\)
연습문제 8. 나이를 동일 폭 5구간과 동일 개수(분위수) 5구간으로 각각 나누어 구간별 생존율을 구하라. 두 방식이 같은 이야기를 하는가? 어느 쪽이 오해를 부르기 쉬운가?
풀이
import pandas as pd

URL = "https://raw.githubusercontent.com/datasciencedojo/datasets/f0ccab6a7ceafdff780052166fb6fab3311398eb/titanic.csv"
d = pd.read_csv(URL).dropna(subset=["Age"])

for name, binning in [("동일 폭", pd.cut(d.Age, bins=5)),
                      ("분위수", pd.qcut(d.Age, q=5))]:
    g = d.groupby(binning, observed=True).Survived.agg(["mean", "size"])
    print(f"[{name}]")
    for idx, row in g.iterrows():
        print(f"  {str(idx):>18}  생존율 {row['mean']:.4f}  n={int(row['size']):>4}")
    print()
출력:
[동일 폭]
      (0.34, 16.336]  생존율 0.5500  n= 100
    (16.336, 32.252]  생존율 0.3699  n= 346
    (32.252, 48.168]  생존율 0.4043  n= 188
    (48.168, 64.084]  생존율 0.4348  n=  69
      (64.084, 80.0]  생존율 0.0909  n=  11

[분위수]
       (0.419, 19.0]  생존율 0.4817  n= 164
        (19.0, 25.0]  생존율 0.3285  n= 137
        (25.0, 31.8]  생존율 0.3937  n= 127
        (31.8, 41.0]  생존율 0.4375  n= 144
        (41.0, 80.0]  생존율 0.3732  n= 142
두 방식이 다른 이야기를 한다.
동일 폭에서는 마지막 구간의 생존율이 \(9.1\%\)로 절벽처럼 떨어진다. 그림으로 그리면 "노년층이 극적으로 불리했다"는 인상을 준다. 그런데 그 칸에 \(11\)명뿐이다. 한 명이 더 살았다면 \(18.2\%\)가 되어 인상이 크게 달라진다.
분위수에서는 마지막 구간이 \(41\)세 이상 \(142\)명이고 생존율 \(37.3\%\)로, 전체 평균 \(40.4\%\)와 크게 다르지 않다. 노년의 절벽은 보이지 않는다.
| 동일 폭 | 분위수 | |
|---|---|---|
| 구간별 \(n\) | \(11 \sim 346\) (31배 차이) | \(127 \sim 164\) (고름) |
| 극단 구간의 안정성 | 매우 불안정 | 안정적 |
| 가로축이 실제 나이를 보존하는가 | 그렇다 | 아니다 |
| 오해를 부르는 지점 | 작은 칸의 극단값 | 구간 폭이 제각각 |
동일 폭이 오해를 부르기 쉽다. 꼬리가 긴 변수에서 극단 구간의 표본이 거의 없는데, 그림에서는 다른 막대와 같은 너비로 그려져 같은 무게를 가진 것처럼 보인다. 이 절 3절에서 본 대로 나이 분포는 오른쪽 꼬리가 길기 때문에 이 문제가 그대로 나타난다.
그렇다고 분위수가 언제나 낫지도 않다. 분위수 구간은 폭이 제각각이라(\(0.4\sim19\)세가 한 칸, \(19\sim25\)세가 한 칸) 가로축의 거리를 나이로 읽을 수 없다. "첫 칸이 둘째 칸보다 생존율이 높다"는 말이 \(19\)년 폭과 \(6\)년 폭을 견주는 것이라 해석이 까다롭다.
실무 지침.
- 구간별 \(n\)을 반드시 함께 보고한다. 위 출력처럼 생존율 옆에 \(n\)을 적으면 \(11\)명짜리 칸을 오해할 수 없다.
- 작은 칸은 합친다. \(64\)세 이상이 \(11\)명이면 \(48\)세 이상과 묶는 편이 낫다.
- 어느 쪽이든 자의적이라는 사실은 바뀌지 않는다. 연습문제 6의 결론대로, 구간 방식을 자료를 보고 고르면 절단점 하나를 고르는 것과 같은 문제가 생긴다. \(\square\)
연습문제 9. 4절에서 차이가 가장 큰 절단점이 \(2\)세(\(+46\)%포인트)였다. 자료의 \(80\%\)를 무작위로 뽑아 같은 탐색을 \(500\)번 반복하면 "최적 절단점"이 얼마나 흔들리는가? 그 결과를 보고 왜 이 값을 믿으면 안 되는지 말하라.
풀이
import numpy as np, pandas as pd

URL = "https://raw.githubusercontent.com/datasciencedojo/datasets/f0ccab6a7ceafdff780052166fb6fab3311398eb/titanic.csv"
d = pd.read_csv(URL).dropna(subset=["Age"])
age, sur = d["Age"].to_numpy(), d["Survived"].to_numpy()
CUTS = [c for c in range(1, 80)
        if (age < c).sum() >= 10 and (age >= c).sum() >= 10]

rng = np.random.default_rng(0)
best = []
for _ in range(500):
    i = rng.choice(len(age), int(0.8 * len(age)), replace=False)
    a, s = age[i], sur[i]
    gg = [(c, s[a < c].mean() - s[a >= c].mean()) for c in CUTS
          if (a < c).sum() >= 10 and (a >= c).sum() >= 10]
    best.append(max(gg, key=lambda z: z[1])[0])

best = np.array(best)
u, cnt = np.unique(best, return_counts=True)
for j in np.argsort(-cnt)[:6]:
    print(f"  {u[j]:>3}세 : {cnt[j]:>4}회 ({cnt[j]/5:.1f}%)")
print(f"\n  범위 {best.min()}~{best.max()}세,  서로 다른 값 {len(u)}개")

print("\n최적 절단점 주변의 집단 크기")
for c in (2, 3, 64):
    m = age < c
    print(f"  c={c:>3}: n(<c)={m.sum():>4} 생존율 {sur[m].mean():.4f} | "
          f"n(>=c)={(~m).sum():>4} 생존율 {sur[~m].mean():.4f}")
출력:
    2세 :  432회 (86.4%)
   64세 :   45회 (9.0%)
    6세 :   11회 (2.2%)
    7세 :    8회 (1.6%)
   63세 :    2회 (0.4%)
    8세 :    1회 (0.2%)

  범위 2~64세,  서로 다른 값 7개

최적 절단점 주변의 집단 크기
  c=  2: n(<c)=  14 생존율 0.8571 | n(>=c)= 700 생존율 0.3971
  c=  3: n(<c)=  24 생존율 0.6250 | n(>=c)= 690 생존율 0.3986
  c= 64: n(<c)= 701 생존율 0.4123 | n(>=c)=  13 생존율 0.0769
\(86\%\)는 \(2\)세로 안정적으로 보이지만, 나머지가 문제다. \(9\%\)의 부분표본에서는 최적 절단점이 \(64\)세로 튄다. 두 살과 예순네 살은 나이 축의 양 끝이다. 표본을 \(20\%\)만 덜어 냈을 뿐인데 "가장 중요한 나이 경계"가 유아기에서 노년기로 건너뛴다.
왜 이런 일이 생기는가 — 두 값 모두 아주 작은 집단에 얹혀 있다. \(c=2\)는 \(14\)명의 영유아가 \(85.7\%\) 살아남은 것에서 나온 값이고, \(c=64\)는 \(13\)명의 고령자가 \(7.7\%\)만 살아남은 것에서 나온 값이다. 둘 다 최소 인원 제약(\(n \ge 10\))에 걸리는 경계에 딱 붙어 있다.
"최대"를 고르는 통계량은 언제나 극단을 향한다. \(64\)개 절단점 중 차이가 가장 큰 것을 고르면, 표본이 가장 적어 가장 흔들리는 칸이 뽑힌다. 우연히 크게 나온 값이 최댓값이 될 확률이 높기 때문이다. 선택 과정 자체가 잡음을 신호로 둔갑시킨다.
그래서 \(+46\)%포인트를 효과 크기로 보고하면 안 된다.
- 이 값은 \(14\)명에 근거한다.
- \(64\)개를 훑어 그중 최댓값을 골랐다.
- 부분표본에서는 완전히 다른 절단점이 이긴다.
본문 6절이 "\(52\%\)의 확률로 유의한 절단점이 발견된다"고 한 것과 같은 현상을 안정성의 각도에서 본 것이다. 유의성만 부풀려지는 것이 아니라 어느 절단점이 최선인지조차 자료를 조금만 흔들면 바뀐다.
실무에서 쓰는 방어. 절단점을 꼭 골라야 한다면 이 재표본 실험을 함께 돌려 선택의 안정성을 보고하라. 위처럼 두 봉우리로 갈리면 "최적 절단점 \(2\)세"라는 보고는 성립하지 않는다. 17장의 부트스트랩이 이런 절차의 일반형이다. \(\square\)
연습문제 10. 자르지 않고 보는 방법으로 이동평균이 있다. 나이 순으로 정렬한 뒤 생존 여부를 창 크기 \(k\)로 이동평균하면 나이에 따른 생존율의 곡선이 나온다. \(k = 51, 101, 201\)로 각각 구하고, 창 크기가 무엇을 좌우하는지 설명하라.
풀이
import numpy as np, pandas as pd

URL = "https://raw.githubusercontent.com/datasciencedojo/datasets/f0ccab6a7ceafdff780052166fb6fab3311398eb/titanic.csv"
d = pd.read_csv(URL).dropna(subset=["Age"])
age, sur = d["Age"].to_numpy(), d["Survived"].to_numpy()

o = np.argsort(age)
a_s, s_s = age[o], sur[o]
pts = [5, 10, 20, 30, 40, 50, 60]
for k in (51, 101, 201):
    sm = pd.Series(s_s).rolling(k, center=True, min_periods=k // 2).mean().to_numpy()
    vals = [sm[np.argmin(np.abs(a_s - p))] for p in pts]
    print(f"  창 k={k:>3}: " + "  ".join(f"{p}세={v:.3f}" for p, v in zip(pts, vals)))
출력:
  창 k= 51: 5세=0.510  10세=0.510  20세=0.275  30세=0.373  40세=0.392  50세=0.451  60세=0.333
  창 k=101: 5세=0.549  10세=0.505  20세=0.307  30세=0.366  40세=0.376  50세=0.396  60세=0.368
  창 k=201: 5세=0.511  10세=0.479  20세=0.368  30세=0.403  40세=0.413  50세=0.379  60세=0.365
세 곡선이 모두 같은 모양을 말한다. 어린 나이에서 높고(\(0.51\sim0.55\)), \(20\)대에서 가장 낮으며(\(0.28\sim0.37\)), 그 뒤 완만히 오르다가 다시 내려간다. 5절에서 \(5\)년 구간으로 본 비단조 모양이 절단점 없이 그대로 나온다.
창 크기가 좌우하는 것은 매끄러움과 해상도의 맞바꿈이다.
| \(k\) | 곡선의 성격 | \(20\)세 값 |
|---|---|---|
| \(51\) | 울퉁불퉁하다, 국소 변화에 민감 | \(0.275\) |
| \(101\) | 중간 | \(0.307\) |
| \(201\) | 매끄럽다, 국소 변화가 뭉개진다 | \(0.368\) |
\(k\)가 작으면 창 안의 인원이 적어 표본 잡음이 그대로 드러난다. \(20\)세 부근에서 \(k=51\)이 \(0.275\)까지 내려가는 것은 실제 골짜기를 잡은 것일 수도, 잡음일 수도 있다.
\(k\)가 크면 잡음은 줄지만 진짜 구조도 함께 눌린다. \(k=201\)에서 \(20\)세 값이 \(0.368\)로 올라간 것은 골짜기가 이웃 구간에 섞여 평탄해진 탓이다.
이것이 이분화와 근본적으로 다른 점이 있다. 절단점은 하나의 이진 결정이고 그 결과가 "두 숫자"로 줄어든다. 이동평균은 연속적인 곡선을 주므로, 창 크기를 바꿔 가며 보면 어떤 구조가 창 크기와 무관하게 살아남는지 확인할 수 있다. 위에서 "어린이 높음, \(20\)대 낮음"은 세 창 모두에서 살아남았고, 이것이 믿을 만한 구조라는 증거다.
주의할 점 둘.
- 끝부분이 불안정하다. 나이가 아주 어리거나 많은 쪽은 창이 한쪽으로만 채워져 값이 흔들린다. 연습문제 9에서 본 극단 구간 문제가 여기서도 나타난다.
- 가로축이 나이가 아니라 순위다. 나이 순으로 정렬해 이동평균했으므로 창의 실제 나이 폭이 구간마다 다르다. \(20\)대에는 사람이 많아 창이 좁은 나이 범위를 덮고, \(60\)대에는 넓은 범위를 덮는다. 연습문제 8의 분위수 구간과 같은 성질이다.
더 나은 도구가 있다. LOWESS 같은 국소회귀나, 13장의 스플라인은 같은 일을 하되 끝부분 처리와 매끄러움 조절이 훨씬 정교하다. 나이처럼 비단조인 변수를 회귀에 넣을 때 표준적인 선택이며, 이분화는 그 목록의 맨 아래에 있다. \(\square\)