2차원 정규 조건부분포
개요
\(\rho = 0.9\) 이면 「\(a\) 를 알면 \(b\) 가 거의 결정된다」고 적고 싶어진다. 조건부 분산이 \(1\) 에서 \(0.19\) 로 \(81\%\) 줄어드니 그럴 만하다. 그런데 예측구간(prediction interval)은 분산이 아니라 표준편차로 재고, 표준편차는 \(1\) 에서 \(0.4359\) 로 \(56.4\%\) 만 줄어든다 — \(a\) 를 알고도 \(b\) 의 \(95\%\) 구간이 \(\pm 0.85\) 다. 같은 상관계수를 분산으로 읽으면 강하고 표준편차로 읽으면 약하다. 한 변수를 고정해 얻는 것이 정확히 무엇이고, 그것을 어느 척도로 재어야 하는가.
이변량 정규분포의 강력한 성질 하나는 조건부분포도 정규분포라는 것이다. \((a, b)^\top\)가 상관계수 \(\rho\)인 표준 이변량 정규분포를 따르면 이렇게 된다.
조건부 평균은 \(a_0\)의 선형함수이고, 조건부 분산 \(1 - \rho^2\)은 \(a_0\)에 의존하지 않고 오직 \(\rho\)에만 의존한다.
1. 조건부분포
정리 1. 이변량 정규의 조건부분포
\((a, b)^\top\) 가 평균 \(\mu_a, \mu_b\), 분산 \(\sigma_a^2, \sigma_b^2\), 상관계수 \(\rho\) 인 이변량 정규분포를 따르면 모든 \(a_0\) 에 대해
이다. 조건부 평균은 \(a_0\) 의 일차함수이고, 조건부 분산은 \(a_0\) 에 의존하지 않는다.
증명
표준화해 두면 계산이 짧아진다. \(u = (a-\mu_a)/\sigma_a\), \(v = (b-\mu_b)/\sigma_b\) 로 놓으면 \((u,v)\) 는 상관계수 \(\rho\) 인 표준 이변량 정규를 따르고, 그 결합밀도는
다. 조건부밀도는 \(f(v \mid u) = f(u,v)/f(u)\) 이고 \(f(u)\) 가 \(v\) 를 담지 않으므로, 지수를 \(v\) 에 대해 완전제곱으로 묶는 것만 하면 된다.
뒤 항은 \(v\) 와 무관하다. 지수에 넣으면
로 갈라지고, 뒤 인수가 평균 \(\rho u\), 분산 \(1-\rho^2\) 인 정규밀도다. 곧 \(v \mid u \sim N(\rho u,\, 1-\rho^2)\) 다.
조건부 분산이 \(u\) 와 무관한 까닭이 여기서 보인다. 완전제곱으로 묶을 때 \(u\) 는 평균을 옮기는 자리로만 들어가고, \(v\) 의 제곱에 붙는 계수 \(\frac{1}{1-\rho^2}\) 는 \(u\) 를 담지 않는다. 산포를 정하는 것은 제곱항의 계수뿐이다.
표준화를 풀면 \(v = (b-\mu_b)/\sigma_b\), \(u = (a_0-\mu_a)/\sigma_a\) 이므로
다. 평균은 위치와 척도를 되돌리고 분산은 척도의 제곱을 되돌린 것뿐이다. \(\square\)
핵심 통찰
조건부 평균은 정확히 \(a\)에 대한 \(b\)의 회귀직선이다. 조건부 분산은 선형 관계를 반영하고 남은 잔차분산이다.
보기 1. 이변량 정규분포의 조건부분포. \(\rho = 0, 0.5, 0.9\)인 표준 이변량 정규분포에서 \(a = 1\)로 자른 단면을 결합 등고선과 나란히 그린다.
(1) 결합밀도의 지수를 \(b\)에 대해 완전제곱으로 묶어 \(b \mid a = a_0 \sim N(\rho a_0,\ 1-\rho^2)\)을 유도하시오. 조건부 분산이 \(a_0\)에 의존하지 않는 까닭은 식의 어디에서 나오는가.
(2) 세 \(\rho\)에서 조건부 평균과 표준편차를 모의실험으로 확인하시오. 아래 3절의 표는 \(\rho = 0.9\)에서 "\(a\)를 알면 \(b\)가 거의 결정된다"고 한다. 분산과 표준편차 가운데 어느 쪽으로 재는 말인가.
풀이
(1) 해석적으로. 코드의 bivariate_gaussian_pdf가 쓰는 밀도는
다. 지수의 분자를 \(b\)에 대한 이차식으로 보고 완전제곱을 만든다.
\(-2\rho ab\)를 메우려고 \((\rho a)^2\)을 더했다 뺀 것뿐이다. 이것을 넣고 분모 \(2(1-\rho^2)\)로 나누면 둘째 항의 \((1-\rho^2)\)가 약분된다.
따라서 밀도가 두 인수의 곱으로 쪼개진다.
왼쪽 인수가 \(a\)만의 함수이고 \(b\)에 대해 적분하면 \(1\)이 되므로 그것이 바로 \(a\)의 주변밀도다. 그러면 \(f(b \mid a) = f(a,b)/f_A(a)\)가 오른쪽 인수이므로
이다. 한 번의 완전제곱으로 주변분포와 조건부분포가 동시에 나온다. 앞 쪽 이변량 정규분포 연습문제 4가 적분으로 구하는 주변분포도 이 쪼개기의 부산물이다.
분산이 \(a_0\)에 의존하지 않는 까닭은 식에서 분명하다. \(a\)는 오른쪽 인수에 \(b - \rho a\)라는 평행이동으로만 들어간다. 봉우리의 자리를 \(\rho a_0\)로 옮기기만 하고 폭 \(\sqrt{1-\rho^2}\)은 건드리지 않는다. 완전제곱이 깔끔하게 되는 것은 지수가 \(b\)의 이차식이고 그 이차항의 계수가 \(a\)와 무관하기 때문인데, 이 구조가 바로 회귀의 등분산 가정에 대응한다. 코드 주석이 적은 세 성질이 모두 이 한 줄의 대수에서 나온다.
(2) 해석적으로. 세 \(\rho\)에 넣으면 조건부 분산이 \(1\), \(0.75\), \(0.19\)이고 조건부 표준편차가 \(1\), \(0.8660\), \(0.4359\)다. 분산은 아래 3절 표의 숫자와 같다.
"거의 결정된다"는 분산으로 재는 말이다. \(\rho = 0.9\)이면 설명된 분산의 비율이 \(\rho^2 = 81\%\)다. 그런데 표준편차는 \(1 \to 0.4359\)로 \(56.4\%\)만 줄었다.
예측구간의 폭은 표준편차에 비례하므로, 실무에서 느끼는 개선은 \(81\%\)가 아니라 \(56\%\)다. 일반적으로
이고 뒤의 것이 늘 작다. 표준편차를 절반으로 줄이려면 \(\sqrt{1-\rho^2} = 1/2\)에서 \(\rho = \sqrt{3}/2 = 0.866\)이 필요하고, 10분의 1로 줄이려면 \(\rho = 0.995\)가 필요하다. 상관계수 \(0.9\)는 생각보다 약하다. \(R^2\)를 보고 받는 인상과 예측구간을 보고 받는 인상이 갈리는 자리다.
(2) 수치적으로. 먼저 쪽의 그림을 그린다.
import numpy as np
import matplotlib.pyplot as plt

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False

def bivariate_gaussian_pdf(x, y, rho):
    """표준화된 이변량 정규분포의 밀도. 두 주변분포가 모두 N(0,1)이고
    상관계수만 rho 인 경우다."""
    return (np.exp(-(x**2 - 2*rho*x*y + y**2) / (2*(1 - rho**2)))
            / (2 * np.pi * np.sqrt(1 - rho**2)))


def conditional_pdf(x0, y, rho):
    """X = x0 으로 조건을 걸었을 때 Y의 분포.

    이변량 정규분포의 핵심 성질 세 가지가 여기 들어 있다.
      1. 조건부분포도 **정규분포**다. (다른 분포에서는 일반적으로 성립하지 않는다.)
      2. 조건부 평균은 x0에 **선형**으로 의존한다: mu = rho * x0.
         이것이 선형회귀가 왜 정규분포 가정과 잘 맞는지의 뿌리다.
      3. 조건부 분산 1 - rho^2 은 **x0에 의존하지 않는다.**
         어디를 잘라도 폭이 같다는 뜻이며, 회귀의 등분산 가정에 대응한다.
    """
    sigma_cond = np.sqrt(1 - rho**2)
    mu_cond = rho * x0
    return (1 / (np.sqrt(2*np.pi) * sigma_cond)
            * np.exp(-0.5 * ((y - mu_cond) / sigma_cond)**2))

x = np.linspace(-3, 3, 200)
y = np.linspace(-3, 3, 200)
X, Y = np.meshgrid(x, y)

rho_vals = [0.0, 0.5, 0.9]
cond_val = 1.0  # condition on a = 1

fig, axes = plt.subplots(len(rho_vals), 2, figsize=(10, 4 * len(rho_vals)))

for i, rho in enumerate(rho_vals):
    Z = bivariate_gaussian_pdf(X, Y, rho)
    mu_cond = rho * cond_val
    sigma_cond = np.sqrt(1 - rho**2)

    # 결합분포 등고선에 자른 면을 표시
    ax = axes[i, 0]
    ax.contourf(X, Y, Z, levels=20, cmap="Blues", alpha=0.4)
    ax.axvline(cond_val, color="red", linestyle="--", lw=2, label=f"a = {cond_val}")
    ax.set_xlabel("a")
    ax.set_ylabel("b")
    ax.set_title(f"Joint PDF (ρ = {rho})")
    ax.legend(fontsize=8)
    ax.set_aspect("equal")

    # 조건부 밀도함수
    ax = axes[i, 1]
    cond_y = conditional_pdf(cond_val, y, rho)
    ax.plot(y, cond_y, "b-", lw=2)
    ax.axvline(mu_cond, color="red", linestyle="--", lw=1.5,
               label=f"E[b|a=1] = {mu_cond:.2f}")
    ax.fill_between(y, cond_y, alpha=0.15, color="blue")
    ax.set_xlabel("b")
    ax.set_ylabel("f(b | a = 1)")
    ax.set_title(f"Conditional PDF (σ = {sigma_cond:.3f})")
    ax.legend(fontsize=8)

plt.tight_layout()
plt.show()
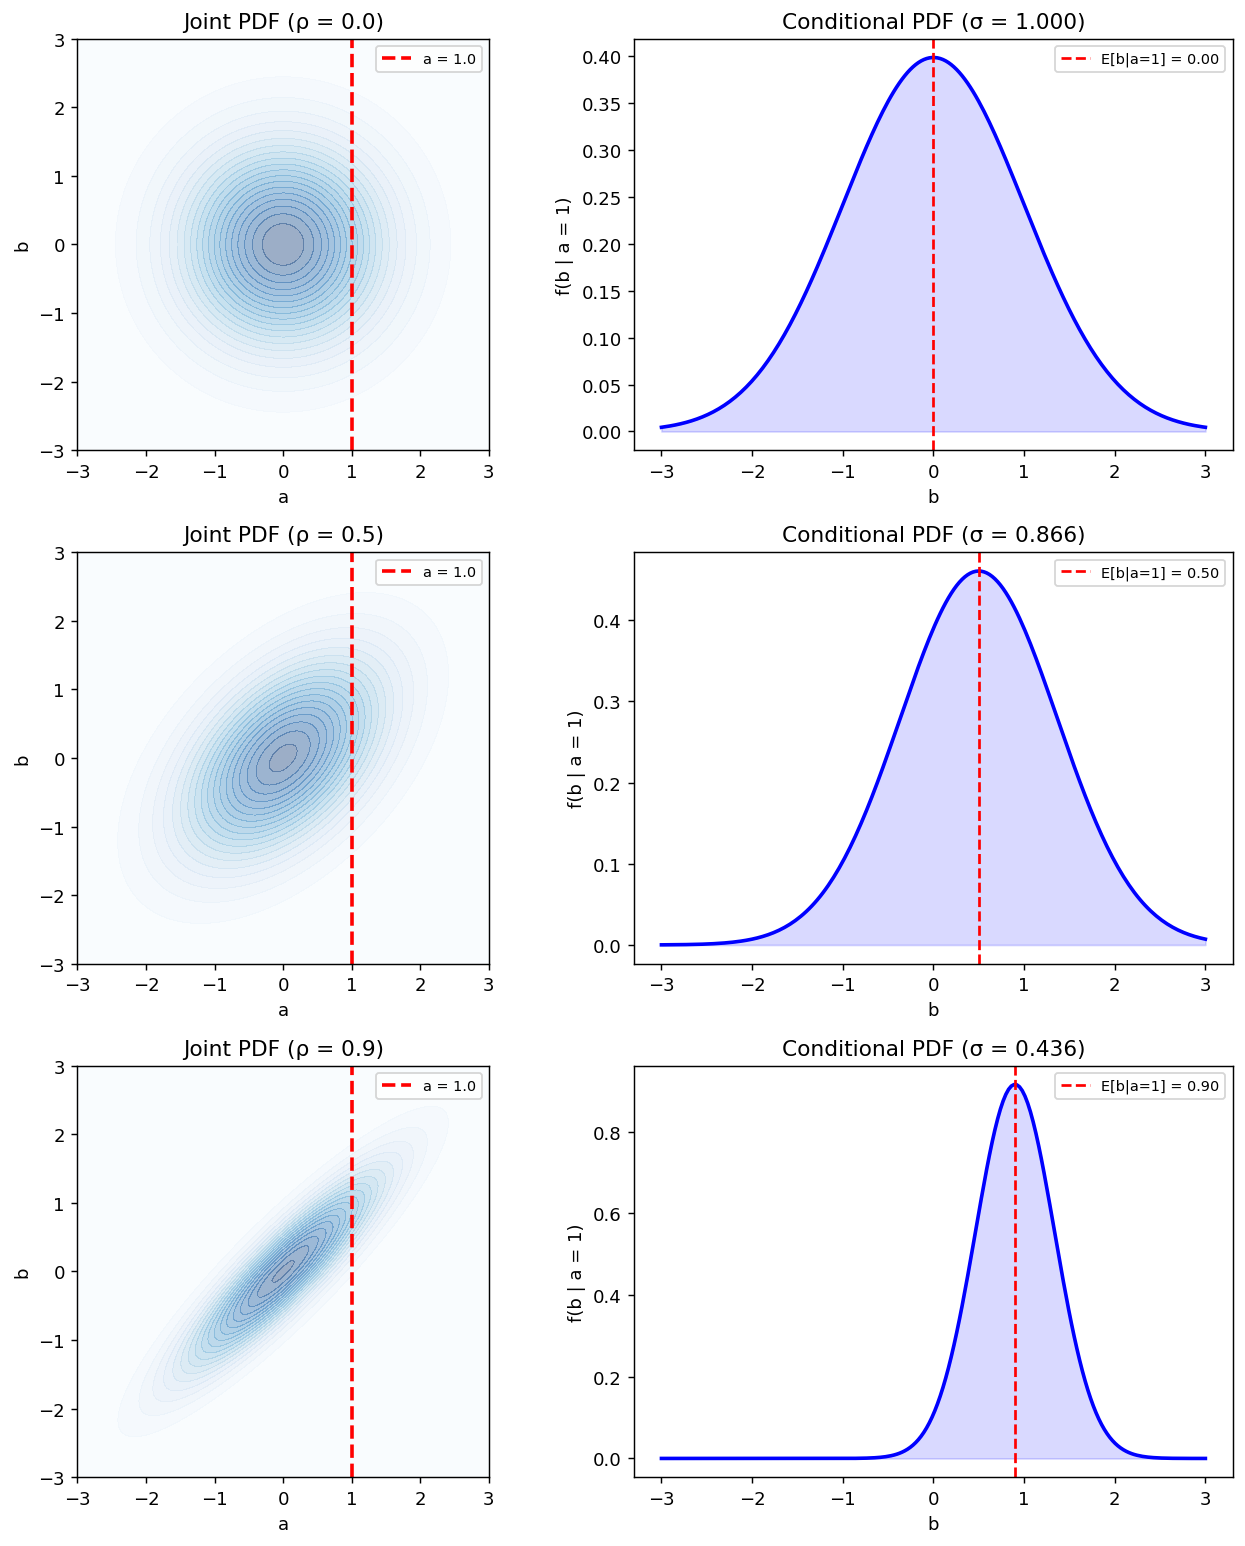
왼쪽 열의 등고선이 위에서 아래로 원 \(\to\) 기운 타원 \(\to\) 더 납작한 타원으로 바뀌고, 빨간 점선 \(a = 1\)이 자르는 자리가 점점 위로 올라간다. 오른쪽 열의 종 모양 곡선은 봉우리가 \(0 \to 0.5 \to 0.9\)로 옮겨 가면서 좁아진다. 자른 단면이 늘 정규분포 모양이라는 것이 이 그림의 요점이다.
이제 \(a\)를 \(1\) 근처로 자른 표본으로 (1)과 (2)를 확인한다.
import numpy as np
from math import sqrt

rng = np.random.default_rng(0)
N, a0, h = 4_000_000, 1.0, 0.02      # a 를 [1-h, 1+h] 띠로 자른다

print(f"{'rho':>5}{'E[b|a=1]':>10}{'Var':>8}{'SD':>8}{'설명분산':>10}{'SD 감소':>9}")
for rho in (0.0, 0.5, 0.9):
    print(f"{rho:>5}{rho*a0:>10.4f}{1-rho**2:>8.4f}{sqrt(1-rho**2):>8.4f}"
          f"{rho**2*100:>9.1f}%{(1-sqrt(1-rho**2))*100:>8.1f}%")

print(f"\n띠 폭 +-{h} 로 잘라 확인한다 (N = {N:,})")
print(f"{'rho':>5}{'띠 안 개수':>12}{'E[a|띠]':>10}{'E[b|띠]':>10}{'rho*E[a|띠]':>13}"
      f"{'SE':>9}{'z':>8}{'SD[b|띠]':>11}{'이론 SD':>10}")
Z = rng.standard_normal((N, 2))
for rho in (0.0, 0.5, 0.9):
    # b = rho*a + sqrt(1-rho^2)*Z2 로 만들면 정확히 Corr(a, b) = rho 다.
    a = Z[:, 0]
    b = rho * a + sqrt(1 - rho**2) * Z[:, 1]
    m = np.abs(a - a0) <= h
    n = int(m.sum())
    ea, eb, sb = a[m].mean(), b[m].mean(), b[m].std()
    se = sqrt(1 - rho**2) / sqrt(n)
    print(f"{rho:>5}{n:>12}{ea:>10.5f}{eb:>10.5f}{rho*ea:>13.5f}"
          f"{se:>9.5f}{(eb-rho*ea)/se:>8.3f}{sb:>11.5f}{sqrt(1-rho**2):>10.5f}")
출력:
  rho  E[b|a=1]     Var      SD      설명분산    SD 감소
  0.0    0.0000  1.0000  1.0000      0.0%     0.0%
  0.5    0.5000  0.7500  0.8660     25.0%    13.4%
  0.9    0.9000  0.1900  0.4359     81.0%    56.4%

띠 폭 +-0.02 로 잘라 확인한다 (N = 4,000,000)
  rho      띠 안 개수    E[a|띠]    E[b|띠]   rho*E[a|띠]       SE       z    SD[b|띠]     이론 SD
  0.0       38601   0.99991  -0.00394      0.00000  0.00509  -0.774    0.99932   1.00000
  0.5       38601   0.99991   0.49654      0.49996  0.00441  -0.774    0.86544   0.86603
  0.9       38601   0.99991   0.89820      0.89992  0.00222  -0.774    0.43569   0.43589
(1)과 (2)가 모두 맞는다.
조건부 평균. 띠 안에서 잰 \(E[b \mid \text{띠}]\)가 \(-0.0039\), \(0.4965\), \(0.8982\)이고 예측값 \(\rho\,E[a \mid \text{띠}]\)가 \(0\), \(0.4999\), \(0.8999\)다. \(z\)가 세 줄 모두 \(-0.774\)로 \(1\) SE 안이다. 띠의 폭을 \(\pm 0.02\)로 좁게 잡았으므로 \(E[a \mid \text{띠}] = 0.99991\)이 \(a_0 = 1\)과 거의 같고, \(\rho\)를 곱한 값으로 비교한 것은 그 남은 \(0.00009\)까지 치워 두기 위함이다.
조건부 표준편차. \(0.99932\), \(0.86544\), \(0.43569\)가 이론값 \(1\), \(0.86603\), \(0.43589\)와 소수점 셋째 자리까지 맞는다. 세 값 모두 이론보다 아주 조금 작은데, \(38601\)개 표본의 표준편차 추정이 \(1/\sqrt{2n} = 0.0036\) 수준으로 흔들리니 그 안이다.
\(z\)가 세 줄 모두 똑같은 것이 우연이 아니다. 코드가 \(b = \rho a + \sqrt{1-\rho^2}\,Z_2\)로 만들었으므로
로 \(\rho\)가 깨끗이 약분된다. 띠를 고르는 조건이 \(a\)만 보므로 \(Z_2\)의 띠 안 평균은 \(\rho\)와 무관하고, 세 줄이 같은 잡음을 재사용한 셈이다. 세 줄의 일치를 "세 번 독립으로 확인했다"고 읽으면 안 된다. 확인된 것은 \(\rho\)를 바꿀 때 식이 예측하는 배율 \(\sqrt{1-\rho^2}\)이 맞다는 것이다.
"거의 결정된다"의 척도. 마지막 두 열이 (2)의 요점을 보인다. \(\rho = 0.9\)에서 분산은 \(1 \to 0.19\)로 \(81\%\) 줄었지만 표준편차는 \(1 \to 0.436\)으로 \(56\%\)만 줄었다. \(a\)를 알고도 \(b\)의 \(95\%\) 예측구간이 \(\pm 1.96 \times 0.436 = \pm 0.85\)나 된다. \(a\)를 모를 때의 \(\pm 1.96\)에 비해 좁아지기는 했지만 "거의 결정"이라 하기에는 넉넉한 폭이다.
그림으로 보는 통계학 1. 타원은 그렸는데 선은 긋지 않았다
정리 1 이 말하는 것은 두 가지다. 조건부 평균이 직선이라는 것과, 조건부 분산이 자르는 자리에 의존하지 않는다는 것. 그런데 이 정리가 딛고 선 밀도는 \(1846\) 년에 이미 적혀 있었다. 그리고 그것을 적은 사람은 이 두 문장에 끝내 닿지 못했다.
오귀스트 브라베는 프랑스의 물리학자이자 측지학자였다. 바다와 산에서 한 점의 위치를 재던 사람이라, 「재어 둔 점이 참 위치에서 얼마나 어긋나는가」가 그의 실제 문제였다. \(1846\) 년 논문에서 그는 두 방향의 오차가 서로 얽혀 있을 때의 밀도를 적고, 그 등고선이 기울어진 타원임을 보이고, 타원의 주축이 어느 쪽을 향하는지까지 구했다.
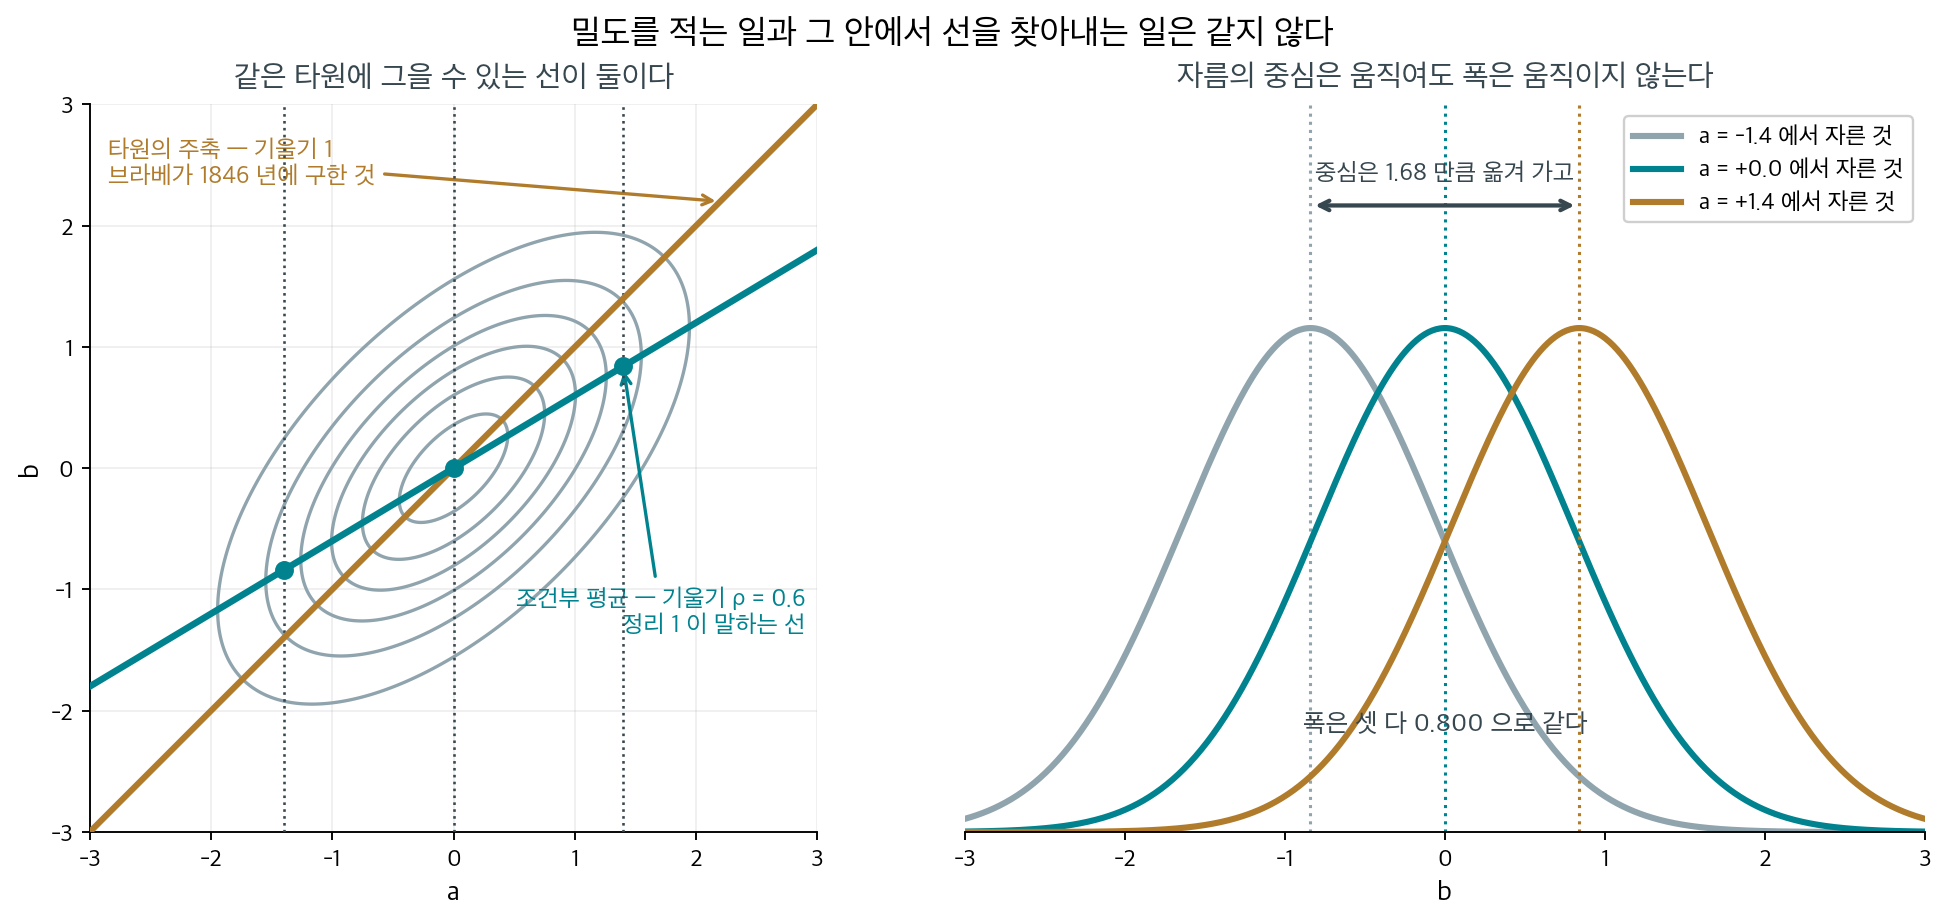
\(\rho = 0.6\) 일 때다. 타원의 주축(황갈색)과 조건부 평균선(청록)은 같은 그림 위의 다른 선이다. 전자는 「타원이 어느 쪽으로 길쭉한가」에 답하고, 후자는 「\(a\) 를 알 때 \(b\) 를 얼마로 짐작할까」에 답한다. 브라베가 구한 것은 앞의 것이다.
두 선은 왜 다른가. 주축은 두 변수를 대등하게 놓고 구름 전체의 모양을 묻는다. 조건부 평균선은 한쪽을 주어진 것으로 놓고 다른 쪽을 묻는다. 물음이 대칭이 아니니 답도 대칭일 수 없다. 측지학자에게는 앞의 물음이 전부였다 — 점은 하나뿐이고, 가로와 세로 중 어느 쪽이 「주어진 것」일 까닭이 없었으니까.
\(\rho\) 라는 수가 두 변수 사이의 관계의 세기를 재는 척도가 된 것은 그로부터 사십 년 뒤, 아버지의 키로 아들의 키를 맞혀 보려던 사람들의 손에서였다. 브라베의 식에 이미 그 수가 들어 있었는데도 그랬다.
뒷이야기가 있다. 칼 피어슨은 처음에 상관계수를 브라베의 것으로 돌렸고, 그래서 유럽 일부에서는 오래도록 「브라베–피어슨 계수」라 불렸다. 그러다 \(1920\) 년 상관의 역사를 돌아보는 글에서 피어슨은 그 공로 표시를 스스로 거두어들인다. 브라베는 밀도를 적었을 뿐 상관이라는 개념에는 이르지 못했다는 것이 그 까닭이었다.
식을 손에 쥐는 일과 그 식이 무엇을 말하는지 알아보는 일은 같지 않다. 오늘날 브라베의 이름은 통계학이 아니라 결정학에서 더 자주 불린다. 결정의 격자를 분류한 그 브라베다.
확인한 곳 — 브라베의 \(1846\) 년 논문이 이변량 오차분포와 그 타원의 주축을 다루었다는 것, 피어슨이 처음 브라베에게 돌렸던 공로를 \(1920\) 년의 상관 역사 글에서 거두었다는 것은 통계사에서 거듭 다루어져 온 일화다 · 그림의 두 기울기 \(1\) 과 \(\rho = 0.6\), 조건부 표준편차 \(\sqrt{1-\rho^2} = 0.8\) 은 정리 1 에서 이 쪽이 직접 그렸다
2. 분산의 분해
조건부 분산이 \(\sigma_b^2\) 에서 \(\sigma_b^2(1-\rho^2)\) 로 줄어든 만큼이 \(a\) 가 알려 준 것이다. 이 장부가 정확히 맞는다.
정리 2. 설명된 분산과 남은 분산
정리 1 의 설정에서
이고 둘을 더하면 \(\sigma_b^2\) 다. 곧 \(\rho^2\) 은 \(a\) 가 설명하는 \(b\) 의 분산 비율이다.
증명
정리 1 에서 \(E[b \mid a] = \mu_b + \rho\frac{\sigma_b}{\sigma_a}(a - \mu_a)\) 는 \(a\) 의 일차함수다. 상수항은 분산에 영향을 주지 않고 계수는 제곱으로 나오므로
다. 또 \(\operatorname{Var}(b \mid a) = \sigma_b^2(1-\rho^2)\) 가 \(a\) 에 의존하지 않는 상수이므로 그 기댓값도 그 자신이다.
두 값을 더하면 \(\rho^2\sigma_b^2 + (1-\rho^2)\sigma_b^2 = \sigma_b^2 = \operatorname{Var}(b)\) 이고, 이것이 전체분산 정리(law of total variance) \(\operatorname{Var}(b) = \operatorname{Var}(E[b\mid a]) + E[\operatorname{Var}(b\mid a)]\) 가 성립하는 모습이다. \(\square\)
\(\rho^2\) 이 결정계수다. 13장의 단순회귀(simple linear regression)에서 \(R^2\) 이 "설명된 분산의 비율"로 등장하는데, 이변량 정규에서는 그것이 모수 \(\rho\) 의 제곱과 정확히 같다. 회귀가 조건부 평균을 추정하는 일이라는 것을 여기서 미리 볼 수 있다.
3. 상관이 1 에 가까워지면 조건부분산이 0 으로 간다
| \(\rho\) | \(E[b \mid a=1]\) | \(\text{Var}(b \mid a=1)\) | 효과 |
|---|---|---|---|
| 0 | 0 | 1 | \(a\)로 조건화해도 \(b\)에 대한 정보가 없다 |
| 0.5 | 0.5 | 0.75 | 불확실성이 중간 정도로 줄어든다 |
| 0.9 | 0.9 | 0.19 | \(a\)를 알면 \(b\)가 거의 결정된다 |
\(|\rho| \to 1\)일 때 조건부분포는 회귀직선 주위로 모이고 조건부 분산은 0에 가까워진다.
연습문제
연습문제 1. \(\rho = 0.8\)인 표준 이변량 정규분포에서 \(a = 2\)가 주어졌을 때 \(b\)의 조건부 평균과 분산을 계산하라.
풀이
따라서 \(b \mid a = 2 \sim N(1.6, 0.36)\)이고 조건부 표준편차는 \(0.6\)이다.
연습문제 2. \(\rho = 0\)이면 조건부분포는 무엇이 되는가? 이를 독립성(independence) 개념과 연결하라.
풀이
\(\rho = 0\)이면 \(E[b \mid a = a_0] = 0\)이고 \(\text{Var}(b \mid a = a_0) = 1\)이다. 조건부분포 \(b \mid a \sim N(0, 1)\)은 \(a_0\)에 전혀 의존하지 않으며, \(b\)의 주변분포와 같다.
이것이 독립성의 정의이다. 모든 \(a\)에 대해 \(f(b \mid a) = f(b)\)인 것이다. 이변량 정규분포에서 \(\rho = 0\)은 독립성의 필요충분조건이다.
연습문제 3. 표준 이변량 정규분포의 조건부분포 공식 \(b \mid a = a_0 \sim N(\rho a_0, 1 - \rho^2)\)을 증명하라.
풀이
결합밀도는 이렇게 된다.
\(a\)의 주변분포는 \(f_a(a) = \frac{1}{\sqrt{2\pi}}e^{-a^2/2}\)이다. 따라서 \(b\)에 대해 완전제곱식을 만들면 이렇게 된다.
이는 \(N(\rho a_0, 1-\rho^2)\)의 핵(kernel), 곧 정규화 상수를 뺀 밀도의 꼴이다. \(b\) 에 대해 적분해 1 이 되어야 하므로 상수는 저절로 정해진다. \(\square\)
연습문제 4. 조건부 평균 \(E[b \mid a] = \rho \cdot a\)와 \(a\)에 대한 \(b\)의 단순선형회귀 사이의 연결을 설명하라.
풀이
표준화된 변수(평균 0, 분산 1)에 대해 \(a\)에 대한 \(b\)의 단순선형회귀에서 회귀직선은 \(\hat{b} = \rho \cdot a\)이며 \(\rho\)는 상관계수이다. 이변량 정규분포에서는 이 회귀직선이 단지 최선의 선형 예측자인 데 그치지 않고 조건부 기댓값 \(E[b \mid a]\) 그 자체이다. 일반적으로 \(E[Y \mid X]\)는 비선형일 수 있지만, 이변량 정규분포에서는 정확히 선형이다.
연습문제 5. 성인 남성의 키(cm)와 몸무게(kg)가 이변량 정규분포를 따르고 \(\mu = (170, 65)\), \(\sigma = (6, 8)\), \(\rho = 0.6\)이다. 키가 182cm인 사람의 몸무게에 대한 조건부분포와 95% 예측구간을 구하라.
풀이
일반 공식에 대입한다.
이므로 \(W \mid H=182 \sim N(74.6,\ 6.4^2)\)이다. 95% 예측구간은
이다.
세 가지를 확인해 둔다. 첫째, 기울기 \(0.8\)은 "키가 1cm 크면 평균 몸무게가 0.8kg 늘어난다"는 뜻이며, 이것이 몸무게를 키에 회귀한 최소제곱 기울기와 같다. 둘째, 조건부 표준편차 6.4는 주변 표준편차 8보다 작다. 키를 알면 불확실성이 표준편차로 20% 줄어든다. 셋째, 조건부 표준편차는 182라는 값에 의존하지 않는다. 키가 155cm인 사람에게도 같은 6.4를 쓴다.
연습문제 6. 연습문제 5에서 키가 182cm(평균보다 \(2\sigma\) 위)인데 예측된 몸무게는 74.6kg으로 평균보다 \(1.2\sigma\) 위에 그친다. 이 현상을 설명하고 "평균으로의 회귀"라는 이름의 유래를 밝혀라.
풀이
표준화해서 보면 분명해진다. 조건부 평균 공식을 \(z\) 척도로 쓰면
이다. \(|\rho| < 1\)이므로 예측된 표준점수는 언제나 주어진 표준점수보다 0에 가깝다. 키의 \(z_H = 2\)가 몸무게의 \(z_W = 0.6 \times 2 = 1.2\)로 줄어든 것이 그것이다.
직관은 이렇다. 아주 키가 큰 사람의 몸무게에는 키가 주는 몫과 키와 무관한 몫이 함께 들어 있는데, 후자는 평균적으로 0이다. 따라서 극단적인 키에 대응하는 몸무게의 평균은 키만큼 극단적이지 않다.
이름의 유래. 골턴이 부모와 자식의 키를 조사하다 발견했다. 키가 아주 큰 부모의 자식은 평균적으로 부모보다 작고, 아주 작은 부모의 자식은 부모보다 크다. 그는 이를 "평범으로의 회귀(regression towards mediocrity)"라 불렀고, 회귀분석이라는 이름 자체가 여기서 나왔다. 오늘날 "회귀"라는 말에는 이 원래 뜻이 거의 남아 있지 않다.
회귀의 오류. 이것을 인과로 읽으면 안 된다. 세대가 지날수록 키가 평균으로 수렴하는 것이 아니다. 방향을 뒤집어도 같은 일이 일어난다. 아주 키가 큰 자식의 부모 역시 평균적으로 자식보다 작다. 순전히 통계적 현상이다.
실무의 함정으로 이어진다. 성적이 가장 나쁜 학급에 특별 프로그램을 넣고 이듬해 성적이 오르면 프로그램 덕분이라고 결론짓기 쉽지만, 아무것도 하지 않아도 평균으로 되돌아왔을 것이다. 극단값을 기준으로 집단을 고른 뒤 효과를 재려면 반드시 대조군이 필요하다.
연습문제 7. 전체분산 정리 \(\operatorname{Var}(b) = E\{\operatorname{Var}(b\mid a)\} + \operatorname{Var}\{E[b\mid a]\}\)를 표준 이변량 정규분포에서 확인하고, 각 항이 회귀분석의 무엇에 대응하는지 밝혀라.
풀이
표준 이변량 정규분포에서 \(\operatorname{Var}(b\mid a) = 1-\rho^2\)은 상수이므로
이고, \(E[b\mid a] = \rho a\)이며 \(\operatorname{Var}(a) = 1\)이므로
이다. 둘을 더하면
로 확인된다. \(\square\)
회귀분석과의 대응. 이 항등식이 바로 제곱합(sum of squares)의 분해다.
| 전체분산 정리 | 회귀분석 |
|---|---|
| \(\operatorname{Var}(b)\) | 총제곱합 SST |
| \(\operatorname{Var}\{E[b\mid a]\} = \rho^2\) | 회귀제곱합 SSR (설명된 몫) |
| \(E\{\operatorname{Var}(b\mid a)\} = 1-\rho^2\) | 잔차제곱합 SSE (남은 몫) |
따라서
이다. 단순회귀에서 \(R^2\)이 상관계수의 제곱인 이유가 여기 있다. \(\rho = 0.6\)이면 \(R^2 = 0.36\)으로, 몸무게 변동의 36%만 키로 설명되고 64%는 남는다. 상관이 0.6이면 꽤 강해 보이지만 설명력은 절반도 안 된다는 점을 기억할 일이다.
연습문제 8. \(b\)를 \(a\)에 회귀한 직선과 \(a\)를 \(b\)에 회귀한 직선은 서로 다르다. 두 기울기를 구하고 그 곱이 \(\rho^2\)임을 보여라. 두 직선이 일치하는 경우는 언제인가?
풀이
조건부 평균 공식에서 \(b\)를 \(a\)에 회귀한 기울기는
이고, 역할을 바꾸면 \(a\)를 \(b\)에 회귀한 기울기는
이다. 곱하면 \(\sigma\)들이 약분되어
이다. \(\square\)
연습문제 5의 수치로는 \(0.8 \times 0.45 = 0.36 = 0.6^2\)이다.
왜 다른가. \((a,b)\) 평면에서 보면 첫 직선은 세로 방향 거리(즉 \(b\)의 오차)를 최소로 하고, 둘째 직선은 가로 방향 거리를 최소로 한다. 무엇을 오차로 보느냐가 다르니 답도 다르다. 두 직선은 점 \((\mu_a, \mu_b)\)에서 만나고, \(a\)-\(b\) 평면에서 둘째 직선을 \(b\)에 대해 풀면 기울기가 \(\sigma_b/(\rho\sigma_a)\)로 첫 직선보다 가파르다. 즉 두 직선이 타원의 장축을 사이에 두고 벌어져 있다.
일치하는 경우는 \(\beta_{b\cdot a} = 1/\beta_{a\cdot b}\)일 때이므로 \(\rho^2 = 1\), 즉 \(|\rho| = 1\)뿐이다. 완전상관이면 모든 점이 한 직선 위에 있어 어느 방향으로 재든 오차가 0이다. 반대로 \(\rho \to 0\)이면 두 직선이 각각 수평선과 수직선으로 가며 직각으로 벌어진다.
실무의 교훈은 분명하다. "\(x\)와 \(y\)의 회귀직선"이라는 말은 어느 쪽을 반응변수로 두었는지 밝히지 않으면 뜻이 없다. 둘을 대칭적으로 다루고 싶다면 회귀가 아니라 주성분분석(principal component analysis)의 첫 주축(직교 거리를 최소로 하는 직선)을 써야 한다.
연습문제 9. 연습문제 5의 상황에서 \(P(W > 80)\)과 \(P(W > 80 \mid H = 182)\)를 각각 구하고, 두 값이 크게 다른 것이 실무에서 어떤 오해를 낳는지 설명하라.
풀이
주변확률. \(W \sim N(65, 8^2)\)이므로
조건부확률(conditional probability). \(W \mid H=182 \sim N(74.6,\ 6.4^2)\)이므로
3%에서 20%로 여섯 배 넘게 뛴다. 키를 알았다는 정보가 중심을 옮기고(65 → 74.6) 동시에 폭을 좁혔다(8 → 6.4).
낳는 오해. 두 확률을 섞어 쓰는 것이 실무에서 가장 흔한 오류 중 하나다.
- 기저율 무시. "이 사람은 키가 182cm이니 몸무게가 80kg을 넘을 확률이 20%"는 맞지만, 여기서 "전체 인구의 20%가 80kg을 넘는다"로 넘어가면 틀린다. 조건이 걸린 집단은 전체의 일부일 뿐이다.
- 조건의 방향 혼동. \(P(W>80\mid H=182)\)와 \(P(H=182\mid W>80)\)은 전혀 다른 양이다. 의료검사에서 민감도 \(P(\text{양성}\mid\text{질병})\)와 양성예측도 \(P(\text{질병}\mid\text{양성})\)을 혼동하는 것이 같은 오류이며, 유병률이 낮으면 두 값이 극적으로 갈린다.
- 예측구간을 신뢰구간으로 읽기. 연습문제 5의 \((62.1, 87.1)\)은 키가 182cm인 한 사람의 몸무게 구간이지, 그 집단의 평균 몸무게 구간이 아니다. 후자는 훨씬 좁다.
조건부확률을 쓸 때는 언제나 "무엇을 알고 있다고 가정하는가"를 명시하는 습관이 안전하다.
연습문제 10. 다변량 정규분포 \(\mathbf{X} = (\mathbf{X}_1, \mathbf{X}_2)\)에서 조건부분포가
임을 이변량 공식과 견주어 확인하고, 조건부 공분산행렬의 구조를 설명하라.
풀이
이변량으로 특수화. \(\mathbf{X}_1 = a\), \(\mathbf{X}_2 = b\)인 1차원끼리라면 \(\Sigma_{11} = \sigma_a^2\), \(\Sigma_{21} = \rho\sigma_a\sigma_b\), \(\Sigma_{22} = \sigma_b^2\)이다. 대입하면
으로 본문 공식과 정확히 일치한다.
조건부 공분산의 구조. \(\Sigma_{22\cdot1} = \Sigma_{22} - \Sigma_{21}\Sigma_{11}^{-1}\Sigma_{12}\)는 블록행렬 \(\Sigma\)에서 \(\Sigma_{11}\)에 대한 슈어 보수(Schur complement)다. 읽는 법은 이렇다.
- \(\Sigma_{22}\)는 \(\mathbf{X}_2\)의 원래 공분산.
- \(\Sigma_{21}\Sigma_{11}^{-1}\Sigma_{12}\)는 \(\mathbf{X}_1\)이 설명해 주는 몫. \(\Sigma_{21}\Sigma_{11}^{-1}\)이 회귀계수(regression coefficient) 행렬이므로, 이 항은 "회귀로 설명된 공분산"이다.
- 그 차이가 남은 공분산이며, 언제나 양반정치(positive semidefinite)다. 조건을 걸면 불확실성이 늘어날 수 없다는 뜻이다.
그리고 \(\mathbf{x}_1\)에 전혀 의존하지 않는다. 정규분포의 매우 특별한 성질이며, 여기서 등분산성(homoscedasticity)이 따라 나온다.
부분상관. \(\Sigma_{22\cdot1}\)을 상관행렬로 바꾼 것이 \(\mathbf{X}_1\)을 통제한 부분상관(partial correlation)이다. 즉 "다른 변수의 영향을 걷어 낸 뒤의 상관"이 조건부 공분산행렬에서 직접 읽힌다. 또 알려진 항등식으로 \(\Sigma^{-1}\)의 \((2,2)\) 블록이 \(\Sigma_{22\cdot1}^{-1}\)과 같은데, 그래서 공분산행렬의 역행렬인 정밀도행렬(precision matrix)의 비대각 성분이 0이라는 것이 나머지 변수를 모두 통제했을 때의 조건부 독립과 같아진다. 변수를 점으로, 0이 아닌 비대각 성분을 선으로 그려 의존구조를 나타내는 가우스 그래프모형(Gaussian graphical model)의 출발점이다.
정리하며
이변량 정규분포의 조건부분포도 정규분포이며, 이 사실 하나에서 회귀가 통째로 나온다.
- 조건부 평균이 곧 회귀직선이다. 기울기 \(\rho\,\sigma_b/\sigma_a\) 는 최소제곱 기울기와 정확히 같다. 3장에서 \(\mathbb{E}[Y\mid X]\) 가 최적 예측임을 보았는데, 정규분포에서는 그 최적 예측이 마침 선형이다.
- 조건부 분산 \(\sigma_b^2(1-\rho^2)\) 은 \(a_0\) 에 의존하지 않는다. 회귀분석이 가정하는 등분산성이 여기서는 결과로 따라 나온다.
- \(1-\rho^2\) 이 설명되지 않고 남은 비율이다. 회귀의 \(R^2=\rho^2\) 라는 익숙한 관계가 그대로 읽힌다.
- 조건을 걸면 분산이 줄어든다. \(|\rho|\) 가 클수록 많이 줄고, \(\rho=0\) 이면 전혀 줄지 않는다. 정보를 얻는다는 것이 곧 불확실성이 준다는 뜻임을 정량적으로 보여 준다.
다음 절 2차원 정규분포 고유분해는 같은 분포를 좌표 없이 본다. 타원의 축이 어디를 향하고 얼마나 긴지를 공분산행렬의 고유벡터와 고윳값이 직접 알려 준다.