치우친 분포
치우침이 추정에서 중요한 이유
현실의 많은 자료는 비대칭이다. 가계소득은 위쪽 꼬리가 긴 오른쪽 치우침을 보이고, 고장시간 자료와 보험 청구액은 흔히 지수분포나 log-normal 분포를 따른다. 바탕 분포가 치우쳐 있으면 대칭성이나 정규성을 전제로 만들어진 보통의 추정 방법이 잘 작동하지 않을 수 있다. 표본평균이 꼬리의 극단값에 지나치게 휘둘리고, 중심극한정리에 기반한 신뢰구간의 수렴이 느려지며, 중심의 척도로 평균과 중앙값 중 무엇을 쓸지가 실질적인 문제가 된다. 이 페이지에서는 치우침이 추정에 어떤 영향을 주는지, 그리고 이를 다룰 어떤 도구가 있는지 살펴본다.
치우침의 측정
영향을 논하기 전에 정확한 정의가 필요하다. 평균이 \(\mu\)이고 표준편차가 \(\sigma\)인 확률변수 \(X\)의 왜도 계수는
- \(\gamma_1 > 0\): 분포가 오른쪽으로 치우친다(오른쪽 꼬리가 더 길거나 무겁다).
- \(\gamma_1 < 0\): 분포가 왼쪽으로 치우친다(왼쪽 꼬리가 더 길거나 무겁다).
- \(\gamma_1 = 0\): 분포가 평균을 중심으로 대칭이다.
\(\gamma_1\)을 추정하는 표본왜도는
치우침이 위치 측도에 미치는 영향
흔한 단봉분포에서는 치우침이 중앙값에 비해 평균을 긴 꼬리 쪽으로 끌어당긴다:
- 오른쪽 치우침 (\(\gamma_1 > 0\)): 평균이 중앙값보다 큰 경향(예: 소득 자료, 지수 대기시간).
- 왼쪽 치우침 (\(\gamma_1 < 0\)): 평균이 중앙값보다 작은 경향.
이것은 정리가 아니라 경험적 규칙이다
오른쪽으로 치우친 분포에서 평균 > 중앙값 > 최빈값이라는 순서는 널리 인용되지만 항상 참은 아니다. 다봉분포나 이산분포 중에 반례가 있다. 이 관계는 여러 표준적인 단봉 연속분포(지수, log-normal, gamma)에서는 안정적으로 성립하지만, 임의의 자료에 무턱대고 적용해서는 안 된다.
지수분포
비율 \(\lambda > 0\)인 \(X \sim \text{Exp}(\lambda)\)를 생각하자. 평균은 \(1/\lambda\), 중앙값은 \(\ln 2 / \lambda \approx 0.693/\lambda\), 최빈값은 0이다. 따라서
왜도 계수는 \(\lambda\)와 무관하게 \(\gamma_1 = 2\)로, 상당한 오른쪽 치우침을 확인해 준다.
추정에서 고려할 점
불편성 대 효율성
표본평균 \(\bar{X}\)는 분포의 모양과 무관하게 모평균 \(\mu = E[X]\)의 불편추정량이다 — 기댓값의 선형성에서 곧바로 나오며 정규성이나 대칭성이 필요 없다. 그러나 불편성은 추정의 정밀도에 대해서는 아무 말도 해 주지 않는다.
치우친 분포에서는 긴 꼬리의 극단 관측값이 \(\bar{X}\)에 불균형하게 기여하므로 표본평균의 분산이 클 수 있다. 표본중앙값은 평균에 대해서는 편향될 수 있지만, 자료가 심하게 치우쳐 있을 때는 평균제곱오차 관점에서 분포의 중심을 더 효율적으로 추정할 수 있다.
중심극한정리의 수렴 속도
중심극한정리는 \(\bar{X}\)가 점근적으로 정규임을 보장하지만, 수렴 속도는 분포의 모양에 달려 있다. Berry-Esseen 정리는 근사오차의 상한을 준다:
여기서 \(C \leq 0.4748\)이다. 심하게 치우친 분포에서는 \(E[|X - \mu|^3]/\sigma^3\)이 크므로 정규근사가 믿을 만해지기까지 더 큰 표본이 필요하다. 흔한 경험칙은 약하게 치우친 자료에는 \(n \geq 30\)이면 충분하지만 강하게 치우친 분포에서는 \(n \geq 100\) 이상이 필요할 수 있다는 것이다.
이 두 가지 — 치우침이 중심을 가르는 것과 정규근사를 늦추는 것 — 를 \(\text{LogNormal}(0,1)\) 하나로 확인해 보자.
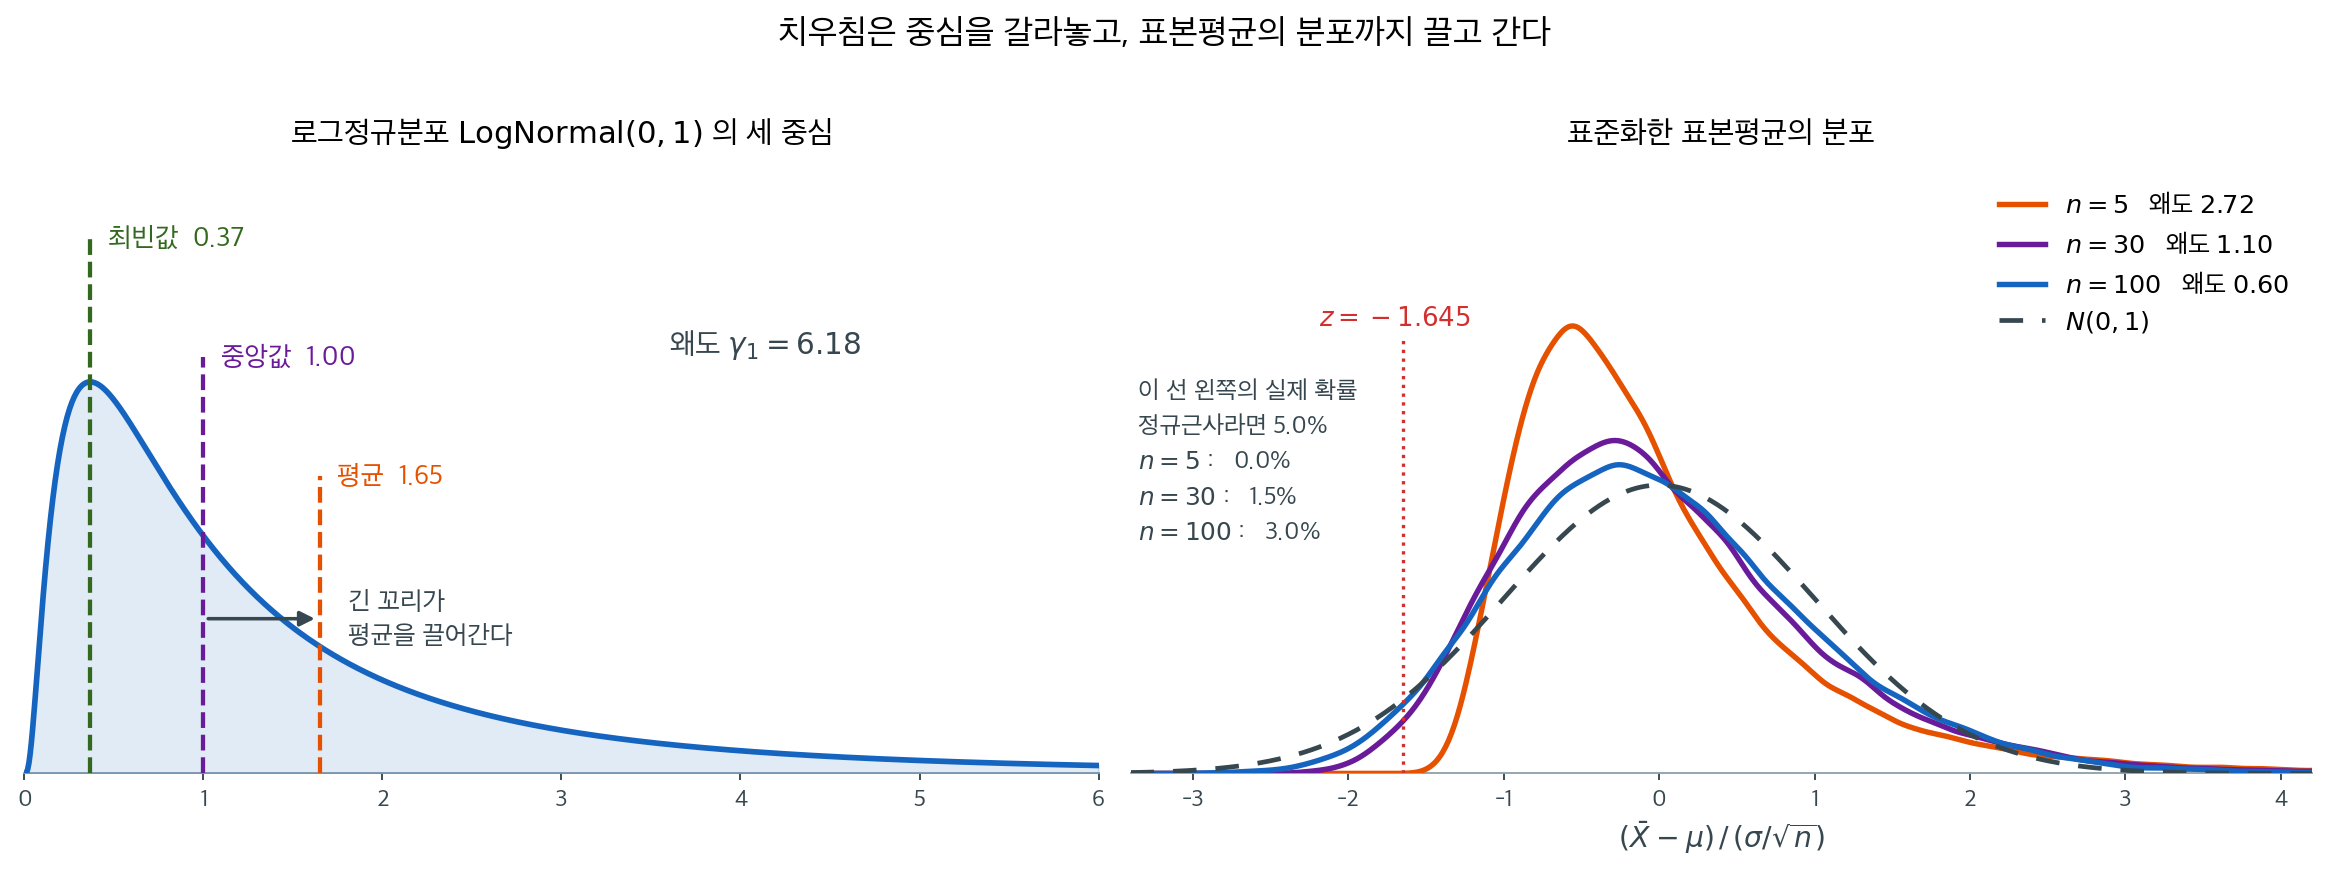
왼쪽이 모집단이다. 최빈값 \(0.37\), 중앙값 \(1.00\), 평균 \(1.65\)로 세 중심이 앞에서 말한 순서대로 갈라져 있다. 평균만 오른쪽으로 밀려나 있다는 점이 중요하다. 관측값의 대다수는 \(1\) 부근에 모여 있는데도 평균이 \(1.65\)인 것은, 아주 드물게 나타나는 큰 값들이 평균을 혼자 끌고 가기 때문이다. 이 분포의 왜도는 \(\gamma_1 = 6.18\)로 정규분포의 \(0\)과 비교가 되지 않는다.
오른쪽은 그 모집단에서 뽑은 표본평균을 표준화해 \(30\)만 번 그린 것이다. 검은 파선이 중심극한정리가 약속하는 \(N(0,1)\)이다. \(n = 30\)에서도(보라색) 곡선은 여전히 눈에 띄게 치우쳐 있다. 표본평균의 왜도는 \(\gamma_1/\sqrt{n}\)로 줄어드는데, \(6.18/\sqrt{30} = 1.13\)이라 아직 정규와 거리가 멀다. \(n = 100\)에서도 \(0.62\)이다. 왜도를 \(0.2\) 아래로 낮추려면 \((6.18/0.2)^2 \approx 955\), 즉 관측값 천 개가 필요하다.
이것이 실무에서 어떻게 드러나는지는 꼬리 확률로 보는 편이 분명하다. \(z = -1.645\) 왼쪽에 놓일 확률은 정규근사대로라면 \(5.0\%\)여야 하는데, 실제로는 \(n = 30\)에서 \(1.5\%\), \(n = 100\)에서도 \(3.0\%\)에 그친다. \(n = 5\)에서는 아예 \(0\%\)다 — 로그정규 관측값은 음수가 될 수 없으므로 \(\bar{X} \geq 0\)이고, 표준화한 값이 \(-1.71\)보다 작아지는 일 자체가 불가능하다. 반대쪽 꼬리는 \(n = 30\)에서 \(6.2\%\)로 넘친다. 양쪽 오차가 서로 상쇄되지 않고 한쪽으로 몰린다는 것이 문제의 핵심이며, 그래서 치우친 자료에서는 대칭인 \(\bar{X} \pm z\,\text{SE}\) 구간보다 붓스트랩이나 로그 변환 쪽이 안전하다.
치우침을 줄이는 변환
오른쪽으로 치우친 자료를 다룰 때 오목변환을 적용하면 긴 오른쪽 꼬리를 끌어당겨 대칭에 더 가까운 분포를 얻을 수 있다.
로그 변환
오른쪽으로 치우친 양수 자료에 가장 단순한 접근은 로그 변환이다: 각 관측값 \(x_i\)를 \(\log x_i\)로 바꾼다. \(X\)가 log-normal 분포를 따르면 \(\log X\)는 정확히 정규이므로 변환된 자료에 표준적인 방법을 그대로 적용할 수 있다.
Log-정규 자료
\(X \sim \text{LogNormal}(\mu, \sigma^2)\)이면 \(\gamma_1 = (e^{\sigma^2} + 2)\sqrt{e^{\sigma^2} - 1}\)로 매우 커질 수 있다. 로그 변환 후에는 \(Y = \log X \sim N(\mu, \sigma^2)\)이고 \(\gamma_1 = 0\)이다.
Box-Cox 변환
Box-Cox 계열은 변환의 강도를 조절하는 모수 \(\lambda\)를 도입하여 로그 변환을 일반화한다. 순양수 자료(\(y > 0\))에 대해:
모수 \(\lambda\)는 보통 최대가능도로 고른다: 후보 \(\lambda\)마다 자료를 변환하고, 변환된 자료에 정규 모형을 적합하여, 프로파일 로그가능도를 최대화하는 \(\lambda\)를 택한다. 흔한 특수 경우로 \(\lambda = 1\)(변환 없음), \(\lambda = 0.5\)(제곱근), \(\lambda = 0\)(로그), \(\lambda = -1\)(역수)이 있다.
변환 후의 해석
변환을 적용하고 나면 추론은 변환된 척도 위에서 이루어진다. 점추정값을 원래 척도로 되돌릴 때는 주의해야 한다: \(\log X\)의 평균은 \(X\)의 평균의 로그가 아니다. Log-normal의 경우 역변환한 평균은 \(\exp(\hat{\mu})\)가 아니라 \(\exp(\hat{\mu} + \hat{\sigma}^2/2)\)이다.
평균과 중앙값 중 무엇을 쓸 것인가
중심의 요약으로 평균과 중앙값 중 무엇을 택할지는 분석의 목적에 달려 있다:
- 평균: 기댓값을 추정하는 것이 목표일 때 적절하다(예: 평균 비용, 총매출 예측). 이상점과 꼬리 거동에 민감하다.
- 중앙값: "전형적인" 관측값을 기술하는 것이 목표일 때 적절하다. 이상점에 로버스트하고 자료의 단조변환에 불변이다.
총액이나 평균에 의존하는 정책·사업 의사결정에서는 평균이 자연스러운 목표이다. "전형적인" 개인이 겪는 바를 기술하려면, 치우침이 있을 때 중앙값이 흔히 더 유익하다.
연습문제
연습문제 1. 비율이 \(\lambda\)인 지수분포의 왜도는 (\(\lambda\)와 무관하게) 2이다. 지수분포가 언제나 오른쪽으로 치우치는 이유를 직관적으로 설명하라.
풀이
지수분포는 \([0, \infty)\) 위에서 밀도 \(f(x) = \lambda e^{-\lambda x}\)를 갖는다. 최빈값은 \(x = 0\)이고(밀도가 0에서 가장 높다) 평균은 \(1/\lambda > 0\)이다. 0이라는 단단한 경계가 있지만 꼬리가 무한대까지 길게 뻗으므로, 확률질량이 0 근처에 몰려 있고 이따금 나타나는 큰 값이 평균을 오른쪽으로 끌어당긴다.
이 오른쪽 치우침(왜도 = 2)은 한쪽만 열린 받침의 결과이다: 분포가 0 아래로 갈 수 없으므로 모든 "극단" 관측값이 오른쪽에 있게 되어 오른쪽 꼬리가 왼쪽보다 긴 비대칭이 만들어진다.
연습문제 2. 치우친 분포에서 뽑은 표본에서 표본평균과 표본중앙값이 크게 다를 수 있는 이유를 설명하라. 오른쪽으로 치우친 소득 자료에서는 어느 쪽이 중심경향의 더 나은 측도인가?
풀이
표본평균은 (극단값을 포함한) 모든 값을 더해 \(n\)으로 나누므로 긴 꼬리 쪽으로 끌려간다. 표본중앙값은 가운데 순서통계량이므로 가장 큰 값이 얼마나 극단적인지에 영향받지 않는다.
오른쪽으로 치우친 소득 자료에서는 소수의 고소득자가 평균을 부풀린다. 예를 들어 99명이 $5만을 벌고 한 명이 $1000만을 번다면 평균은 약 $14.9만(오해를 부른다)인 반면 중앙값은 $5만(전형적인 사람을 대표한다)이다.
오른쪽으로 치우친 소득 자료에서는 중앙값이 중심경향의 더 나은 측도이다. 전형적인 개인의 경험을 기술하기 때문이다. 평균은 다른 목적(예: 총소득을 인구로 나누기)에는 유용하지만 분포의 "중심"을 잘못 나타낸다.
연습문제 3. 로그 변환은 오른쪽 치우침을 줄이는 데 흔히 쓰인다. \(X\)가 log-normal이고 \(\log X \sim N(\mu, \sigma^2)\)이면 \(\log X\)의 분포는 무엇인가? 이 변환이 추론에 도움이 되는 이유는?
풀이
정의에 의해 \(\log X \sim N(\mu, \sigma^2)\)이며 대칭이다. 로그 변환은 오른쪽으로 치우친 log-normal 분포를 대칭인 정규분포로 옮긴다.
많은 통계 방법(t-검정, 선형회귀, 분산분석)이 정규성 또는 적어도 근사적인 대칭성을 가정하므로 이 변환은 추론에 도움이 된다. 로그 변환 후에는:
- \(\log X\) 값에 정규이론 t-검정을 타당하게 적용할 수 있다.
- \(\mu = E[\log X]\)에 대한 신뢰구간이 대칭이고 의미가 있다.
- \(e^{\hat{\mu}}\)로 역변환하면 \(X\)의 기하평균을 얻는데, 이는 오른쪽으로 치우친 양수 자료의 자연스러운 중심경향 측도이다.
이 변환은 자료가 근사적으로 log-normal일 때 잘 작동하며, 소득, 주가, 생물학적 측정값에서 흔한 경우이다.
연습문제 4. 왜도 계수는 \(\gamma_1 = E[(X - \mu)^3]/\sigma^3\)이다. Bernoulli\((p)\) 분포의 \(\gamma_1\)을 계산하고 어느 \(p\)에서 분포가 대칭인지 구하라.
풀이
\(X \sim \text{Bernoulli}(p)\)에서 \(\mu = p\), \(\sigma^2 = p(1-p)\)이다.
\(\gamma_1 = 0\)일 때 대칭이므로 \(1 - 2p = 0\), 즉 \(p = 1/2\)이다. \(p < 1/2\)이면 왜도가 양수(오른쪽 치우침)이고, \(p > 1/2\)이면 음수(왼쪽 치우침)이다.
연습문제 5. 표본왜도 \(g_1 = m_3/m_2^{3/2}\)의 표집분포를 논하라. 정규모집단에서 표준오차는 얼마이고, 왜 소표본에서 믿기 어려운가?
풀이
정규모집단에서의 표준오차.
| \(n\) | \(\operatorname{SE}(g_1)\) |
|---|---|
| 10 | 0.687 |
| 30 | 0.427 |
| 100 | 0.241 |
| 500 | 0.109 |
\(n=30\)에서 표준오차가 0.43이다. 참 왜도가 0인데도 표본왜도가 \(\pm0.85\) 범위에서 흔들린다. "왜도가 0.6이니 치우쳤다"고 말할 수 없다.
왜 소표본에서 믿기 어려운가.
- 표준오차가 크다. 위 표가 보여 준다.
- 분포가 치우쳐 있다. \(g_1\) 자체의 표집분포가 정규가 아니며, 소표본에서 심하게 비대칭이다. 대칭 구간을 쓰면 안 된다.
- 범위가 제한된다. \(|g_1| \le (n-2)/\sqrt{n-1}\)이라는 대수적 상한이 있다. \(n=10\)이면 \(|g_1|\le2.67\)이라, 참 왜도가 6인 지수분포에서도 그 값을 볼 수 없다.
- 6차 적률이 필요하다. \(g_1\)의 분산 공식이 유효하려면 모집단의 6차 적률이 존재해야 한다. 꼬리가 두꺼우면 표준오차 자체가 무의미하다.
- 이상치에 극도로 민감하다. 세제곱이 들어가므로 관측값 하나가 \(g_1\)을 지배할 수 있다.
대안.
- L-왜도. 앞서 본 대로 1차 적률만 있으면 되고 표집변동이 훨씬 작다. 범위도 \([-1,1]\)로 해석이 쉽다.
- 분위수 기반 왜도. 보울리의 왜도
$$ \frac{(Q_3-Q_2)-(Q_2-Q_1)}{Q_3-Q_1} $$
는 강건하고 \([-1,1]\)에 갇혀 있다. - 그림. 히스토그램과 Q-Q 그림이 숫자 하나보다 훨씬 많은 것을 말해 준다.
권고. 표본왜도를 보고할 때는 반드시 \(n\)과 표준오차를 함께 적는다. \(n<50\)이면 값 자체를 해석하지 않는 것이 안전하다.
연습문제 6. 치우친 자료에서 \(t\) 검정의 제1종 오류율이 어떻게 어긋나는지 방향과 크기를 논하라. 단측과 양측 중 어느 쪽이 위험한가?
풀이
방향. 모집단이 오른쪽으로 치우쳐 있으면(\(\gamma_1>0\)) \(t\) 통계량의 분포가 왼쪽으로 치우친다.
이유는 앞서 본 \(\operatorname{Cov}(\bar X,S^2)=\mu_3/n>0\)이다. \(\bar X\)가 클 때 \(S\)도 커서 \(t\)가 눌리고, \(\bar X\)가 작을 때 \(S\)도 작아 \(t\)가 과장된다. 그 결과 \(t\)가 아주 음수인 쪽으로 긴 꼬리를 갖는다.
오류율의 어긋남. 에지워스 전개에서
이다. \(t=-1.645\)(단측 5% 임계값)에서 계산하면, \(\gamma_1=2\)(지수분포), \(n=30\)일 때 보정항이
로 왼쪽 꼬리 확률이 0.05에서 0.09로 커진다.
단측이 위험하다.
| 검정 | 명목 | 실제(근사) |
|---|---|---|
| 단측(왼쪽) | 5% | 9% |
| 단측(오른쪽) | 5% | 2% |
| 양측 | 5% | 5.5%쯤 |
양측에서는 두 꼬리의 오차가 반대 방향이라 상당 부분 상쇄된다. 단측에서는 그대로 남는다.
실무적 함의.
- 치우친 자료에 단측 \(t\) 검정을 쓰면 오류율이 두 배 가까이 될 수 있다. 방향을 미리 정한 검정이 오히려 더 위험하다는 점이 직관에 어긋난다.
- 어느 쪽 꼬리인지가 중요하다. 오른쪽으로 치우친 자료에서 "평균이 \(\mu_0\)보다 작다"를 검정하면 과대기각, "크다"를 검정하면 과소기각이다.
- \(n\)을 늘리면 \(n^{-1/2}\)로 줄지만 느리다. 지수분포에서 \(n=200\)이어도 여전히 6%쯤이다.
대처. 부트스트랩-\(t\), 존슨의 왜도 보정 \(t\), 변환, 또는 순열검정. 양측 검정으로 바꾸는 것만으로도 상당히 개선된다.
연습문제 7. 치우친 자료를 대칭화하는 변환을 고르는 박스-콕스 절차를 설명하고, 그 한계를 적어라.
풀이
변환족.
\(\lambda=1\)이 항등(변환 없음), \(\lambda=0\)이 로그, \(\lambda=0.5\)가 제곱근, \(\lambda=-1\)이 역수다. 연속적으로 이어진다는 것이 이 족의 장점이다.
\(\lambda\) 고르기. 변환된 자료가 정규라고 가정하고 가능도를 최대화한다. 야코비안을 포함한 프로파일 로그가능도가
이며, 격자에서 최대를 찾는다. 마지막 항이 야코비안이고, 이것을 빠뜨리면 \(\lambda\)가 항상 작은 쪽으로 쏠린다.
실무 요령. \(\hat\lambda\)가 0.03으로 나왔다고 \(y^{0.03}\)을 쓰지 않는다. 해석 가능한 가까운 값(0, 0.5, 1, \(-1\))으로 반올림한다. 프로파일 가능도 구간이 그 값을 담는지 확인하면 근거가 된다.
한계.
-
양수 자료에만 쓸 수 있다. 0이나 음수가 있으면 이동해야 하고(\(y+c\)), \(c\)의 선택이 결과를 바꾼다. 여-존슨 변환이 이를 해결한 확장이다.
-
\(\hat\lambda\)의 불확실성이 무시된다. 변환을 고르고 나면 그것을 주어진 것처럼 다루므로, 뒤의 추론이 낙관적이다. 프로파일 구간이 넓은 경우가 흔하다.
-
추정 대상이 바뀐다. 앞서 본 대로 변환 척도의 평균을 되돌리면 원 척도의 평균이 아니다. \(\lambda\)가 0이 아닌 일반적인 경우에는 되돌린 값에 이름조차 붙이기 어렵다.
-
모든 것을 동시에 고칠 수 없다. 정규성, 등분산, 선형성 중 하나를 맞추면 다른 것이 깨질 수 있다. 박스-콕스는 정규성(또는 잔차 정규성)을 겨냥한다.
-
이상치에 민감하다. 가능도 기반이라 극단값 몇 개가 \(\hat\lambda\)를 크게 움직인다.
대안. 일반화선형모형(적절한 연결함수와 분산함수), 분위수회귀, 비모수 방법. 원 척도에서 모형화하면 해석 문제가 생기지 않는다는 것이 큰 장점이며, 요즘은 변환보다 이쪽을 권하는 경우가 많다.
연습문제 8. 치우친 분포에서 신뢰구간의 비대칭성을 다루는 방법을 세 가지 적어라.
풀이
문제. \(\bar X\)의 분포가 치우쳐 있으면 \(\bar x\pm t\,s/\sqrt n\)이 중심에서 어긋나고, 양쪽 꼬리 확률이 같지 않다.
방법 1 — 부트스트랩 BCa. 부트스트랩 분포의 백분위를 쓰되 편향(\(z_0\))과 가속(\(a\)) 으로 조정한다.
- 장점: 비대칭을 자동으로 반영하고, 변환 불변이며, 이차정확이다.
- 단점: 계산이 무겁고 \(B\ge2000\)이 필요하다. 잭나이프로 \(a\)를 추정해야 한다.
- 가장 널리 권장되는 방법이다.
방법 2 — 변환 후 되돌리기. 로그 척도에서 대칭 구간을 만들고 지수를 취한다.
- 장점: 간단하고 비대칭 구간이 자동으로 나온다.
- 단점: 이것이 담는 것은 기하평균이지 산술평균이 아니다. 무엇을 추정하는지 바뀐다.
방법 3 — 왜도 보정 \(t\). 존슨의 수정 통계량
을 쓰거나, 에지워스 전개로 임계값을 보정한다.
- 장점: 계산이 가볍고 이론적 근거가 명확하다.
- 단점: \(\hat\gamma_1\)의 추정오차가 크다. 앞서 본 대로 소표본에서 왜도 추정 자체가 불안정하다.
방법 4 — 비모수. 중앙값에 대한 순서통계량 구간을 쓴다. 분포무관이고 정확하지만, 추정 대상이 중앙값이라는 점을 명시해야 한다.
권고. BCa 부트스트랩이 기본값이다. 계산이 부담되면 변환을 쓰되 무엇을 추정하는지 밝힌다. 왜도 보정은 \(n\)이 충분히 클 때만 믿을 만하다.
연습문제 9. 치우침이 실제 현상인지 이상치 때문인지 구별하는 방법을 적고, 각각에 대한 대처가 어떻게 다른지 밝혀라.
풀이
구별 방법.
- 히스토그램과 Q-Q 그림.
- 매끄럽게 이어지는 긴 꼬리 → 치우침. Q-Q 그림이 부드럽게 휜다.
-
본체에서 뚝 떨어진 몇 점 → 이상치. Q-Q 그림이 대체로 직선이다가 끝의 몇 점만 벗어난다.
-
점진적 제거. 상위 1%, 5%를 차례로 빼며 왜도를 다시 계산한다.
- 이상치면 몇 점만 빼도 왜도가 급격히 떨어진다.
-
치우침이면 계속 빼도 왜도가 서서히만 준다.
-
로그 변환 후 확인. 로그를 취해 대칭이 되면 곱셈적 구조이지 이상치가 아니다.
-
맥락 지식. 소득, 도시 인구, 보험 청구액, 파일 크기는 본질적으로 치우친 양이다. 반면 측정 오차나 입력 실수는 이상치를 만든다.
-
원자료 확인. 극단값의 기록을 직접 본다. 단위 혼동(미터/피트), 자릿수 실수, 결측 코드(-999)가 흔한 원인이다.
대처의 차이.
| 이상치 | 치우침 | |
|---|---|---|
| 원인 | 오염, 기록 오류, 다른 모집단 | 분포의 본질 |
| 로버스트 추정 | 적절 | 부적절(추정 대상이 바뀜) |
| 변환 | 도움 안 됨 | 적절 |
| 제거 | 확인 후 가능 | 절대 안 됨 |
| 모형 | 오염 혼합, \(t\) 잡음 | 로그정규, 감마, 파레토 |
| 보고 | 평균(오염 제거 후) | 중앙값 또는 목적에 맞는 양 |
가장 흔한 실수. 치우친 자료의 큰 값들을 이상치로 보고 잘라 내는 것이다. 소득 상위 1%를 지우고 "평균 소득"을 보고하면 그것은 평균이 아니다. 반대로 진짜 오염을 치우침으로 오인해 로그 변환하면 오염이 그대로 남는다.
권고. 둘이 함께 있는 경우도 흔하다. 치우친 분포에 오염이 섞이면 적절한 분포족(로그정규)을 강건하게 적합하는 것이 답이다. 로그를 취한 뒤 로버스트 추정을 적용하는 이단계 방식이 실용적이다.
연습문제 10. 치우친 자료를 보고할 때 무엇을 어떻게 제시해야 하는지 정리하라.
풀이
1 — 분포를 보여 준다. 요약통계만으로는 치우침을 전달할 수 없다.
- 히스토그램이나 커널밀도. 필요하면 로그 가로축.
- 상자그림(여러 집단 비교에 유용).
- 바이올린 그림이나 벌떼 그림(\(n\)이 적당할 때).
2 — 여러 중심 측도를 함께.
| 측도 | 언제 |
|---|---|
| 평균 | 총액이 관심일 때 |
| 중앙값 | 전형적인 값이 관심일 때 |
| 기하평균 | 곱셈적 성장률 |
평균과 중앙값을 모두 적으면 독자가 치우침의 정도를 바로 안다. 둘의 비가 클수록 치우쳤다.
3 — 분위수를 제시한다. 표준편차 하나보다 \(Q_1\), \(Q_2\), \(Q_3\), 그리고 필요하면 \(P_{90}\), \(P_{95}\), \(P_{99}\)가 훨씬 유익하다. 치우친 분포에서는 \(\mu\pm\sigma\)가 의미 없는 구간이다(음수가 나오거나 확률이 68%가 아니다).
4 — 비대칭 구간을 쓴다. 앞서 본 BCa나 변환 기반 구간. 대칭 구간을 쓸 것이면 왜 괜찮은지 근거를 대야 한다.
5 — 척도를 명시한다. 로그 척도에서 분석했다면
- 결과를 어느 척도로 보고하는지,
- 되돌렸다면 무엇을 추정한 것인지(기하평균인지 산술평균인지, 스미어링 보정을 했는지)
를 밝힌다.
6 — 극단값의 영향을 밝힌다. "상위 1%를 제외하면 평균이 X에서 Y로 바뀐다"는 한 문장이 독자에게 큰 정보를 준다.
하지 말 것.
- 평균과 표준편차만 적고 끝내기.
- "\(\mu\pm\sigma\)" 형태로 요약하기.
- 치우침을 언급하지 않고 \(t\) 검정 결과만 보고하기.
- 이상치 제거 여부와 기준을 밝히지 않기.
정리하며
치우친 자료에서는 정규성을 전제로 만든 도구 대부분이 흔들린다.
- 왜도 \(\gamma_1=\mathbb{E}[(X-\mu)^3]/\sigma^3\) 이 비대칭의 척도다. 소득·고장시간·보험청구액이 모두 오른쪽으로 치우쳐 있다.
- 평균과 중앙값이 갈린다. 오른쪽 치우침이면 평균 > 중앙값이며, "대푯값"으로 무엇을 쓸지가 실질적인 정책 문제가 된다. 평균 소득과 중앙값 소득이 다른 이야기를 하는 이유다.
- 중심극한정리의 수렴이 느려진다. 표준화 표본평균의 왜도가 \(\gamma_1/\sqrt n\) 이므로, \(\gamma_1\) 이 크면 \(n\ge30\) 으로는 턱없이 부족하다. 3장에서 로그정규는 \(n\approx1300\) 이 필요했다.
- 신뢰구간이 한쪽으로 어긋난다. 대칭 구간을 쓰면 포함확률이 명목값에 못 미치며, 특히 한쪽 꼬리에서 어긋남이 크다.
- 처방. 로그 변환으로 대칭에 가깝게 만들거나, 분위수를 쓰거나, 부트스트랩으로 근사를 피한다. 로그 변환은 곱셈적 구조를 덧셈적으로 바꾸는 것이라 자료의 성격과 맞을 때만 정당하다.
다음 절 수익률 추정은 이 문제가 금융에서 어떻게 나타나는지를 구체적으로 다룬다.