표본조사
표본조사는 전체에 대한 추론을 뒷받침하기 위해 모집단의 대표성 있는 부분집합에서 자료를 수집한다. 표집 설계 — 부분집합을 어떻게 고르는가 — 의 선택은 적어도 표본 크기만큼이나 정확도에 큰 영향을 미친다. 작은 확률표본이 큰 편의표본을 안정적으로 능가한다. 이 절에서는 네 가지 표준 확률표집 설계와 그 정밀도 성질, 그리고 실무에서 설계 선택을 좌우하는 고려사항을 다룬다.
정의 1. 표본조사
표본조사(sample survey) 는 정해진 표집 설계에 따라 모집단에서 단위를 선택하고, 선택된 각 단위에 대해 관심 변수를 측정한다. 확률표본(probability sample) 은 모든 단위가 알려진 0이 아닌 선택 확률을 갖는 표본이며, 바로 이 성질이 타당한 추론을 가능하게 한다. 네 가지 표준 설계는 다음과 같다.
| 방법 | 절차 | 장점 | 위험 |
|---|---|---|---|
| 단순무작위 | 모든 단위가 동일한 확률 | 이론이 가장 단순하고 불편 | 작은 하위집단이 과소대표될 수 있음 |
| 층화 | 층으로 나눈 뒤 각 층에서 표집 | 하위집단 포괄 보장, 정밀도 향상 가능 | 표집틀에 층 정보가 있어야 함 |
| 집락 | 온전한 집단을 무작위로 선택 | 흩어진 모집단에 비용 효율적 | 집락 내부가 동질적이면 분산이 커짐 |
| 계통 | 목록에서 \(k\)번째마다 선택 | 실행이 쉽고 표본이 표집틀 전체에 퍼짐 | 목록에 숨은 주기성이 있으면 편향 |
표집틀
모든 확률 설계는 표집틀(frame) — 모집단 단위를 열거한 목록 — 에서 출발한다. 표집틀의 결함은 곧바로 표집편향으로 이어진다.
- 과소포괄: 단위가 존재하는데 표집틀에 없다(전화 표집틀에서의 노숙 인구).
- 과대포괄: 자격 없는 단위가 표집틀에 들어 있다(선거인명부의 사망자).
- 중복: 한 단위가 서로 다른 선택 확률로 두 번 이상 나타난다.
조사 정확도의 결정적 제약은 표본 크기가 아니라 표집틀의 품질이다. 1936년 《Literary Digest》 여론조사는 전화번호부·자동차 등록부·자체 구독자 명단에서 뽑은 \(1{,}000\)만 명에게 모의 투표용지를 보내 약 \(240\)만 장을 회수했는데도 미국 대통령 당선자를 틀리게 예측했다. 그 표집틀이 대공황기의 빈곤층을 배제했고, 게다가 응답률이 \(24\)% 남짓이어서 회수된 240만 장 자체가 다시 한 번 걸러진 표본이었기 때문이다. 표집틀 편향과 무응답 편향이 같은 방향으로 겹친 것이다(1.4절 편향과 무응답 참조).
단순무작위표집(SRS)
크기 \(n\)인 모든 부분집합이 동일한 확률을 갖는다. 추정량은 불편이고, 표본평균의 분산은
이다. 여기서 유한모집단 수정 \((1 - n/N)\)은 \(n/N\)이 작을 때 무시할 수 있게 된다. 이 책의 관례는 표본이 모집단의 \(5\)% 이하이면 무시한다는 것이다(\(n/N \le 0.05\)이면 표준오차에 붙는 인자가 \(\sqrt{1 - n/N} \ge \sqrt{0.95} = 0.9747\)이라, 수정을 빼먹어도 표준오차를 \(2.6\)% 넘게 부풀리지는 않는다). 반대로 \(n/N\)이 크면 수정이 실질적으로 작동한다. 예컨대 \(N = 2{,}000\)인 조직에서 \(1{,}000\)명을 조사하면 \(n/N = 0.5\)라 표준오차가 \(\sqrt{0.5} = 0.707\)배로, 곧 \(30\)% 가까이 줄어든다. 비율의 경우에 대한 정확한 형태 \(\sqrt{(N-n)/(N-1)}\)과 자세한 수치는 5.3절 비율의 표본분포에서 다룬다.
SRS는 이론적으로 깔끔하지만 크고 흩어진 모집단에서는 운영상 다루기 불편하다.
층화표집
모집단을 층(예: 연령대, 지역)으로 분할하고 각 층 안에서 표집한다. 비례 배분 \(n_h = n \cdot N_h / N\)을 쓰면
이며, 층 평균 \(\mu_h\)가 모두 같을 때만 등호가 성립한다(연습문제 2에서 유도한다). 층 내부 분산 \(\sigma_h^2\)이 작고 층 간 평균이 크게 다를수록 이득이 커진다. 층별 분산이 뚜렷하게 다를 때는 네이만 배분 \(n_h \propto N_h \sigma_h\)이 분산을 더 줄인다.
집락표집
온전한 집락(도시 구역, 학교)을 무작위로 선택하고 선택된 집락 안의 모든 단위를 조사한다. 방문할 곳이 몇 군데뿐이므로 운영 비용이 훨씬 싸지만, 한 집락 안의 단위들은 서로 비슷한 경향이 있다. 이 집락 내 상관 \(\rho\)가 설계효과만큼 분산을 부풀린다.
여기서 \(m\)은 집락 크기다. 집락표집은 통계적 효율을 내주고 비용 절감을 얻는 셈이며, 실무에서는 거의 언제나 층화와 결합해 쓴다.
계통표집
\(\{1, \ldots, k\}\)에서 무작위 시작점을 고르고 \(k\)번째마다 표집한다. 목록 순서가 무작위이면 SRS와 동등하고, 목록에 \(k\)와 맞아떨어지는 주기성이 있으면 편향된다(교과서적 예: 7번째 집마다 방문하면 쓰레기 수거 요일 하루를 통째로 놓친다).
네 설계를 같은 모집단 위에 겹쳐 보면
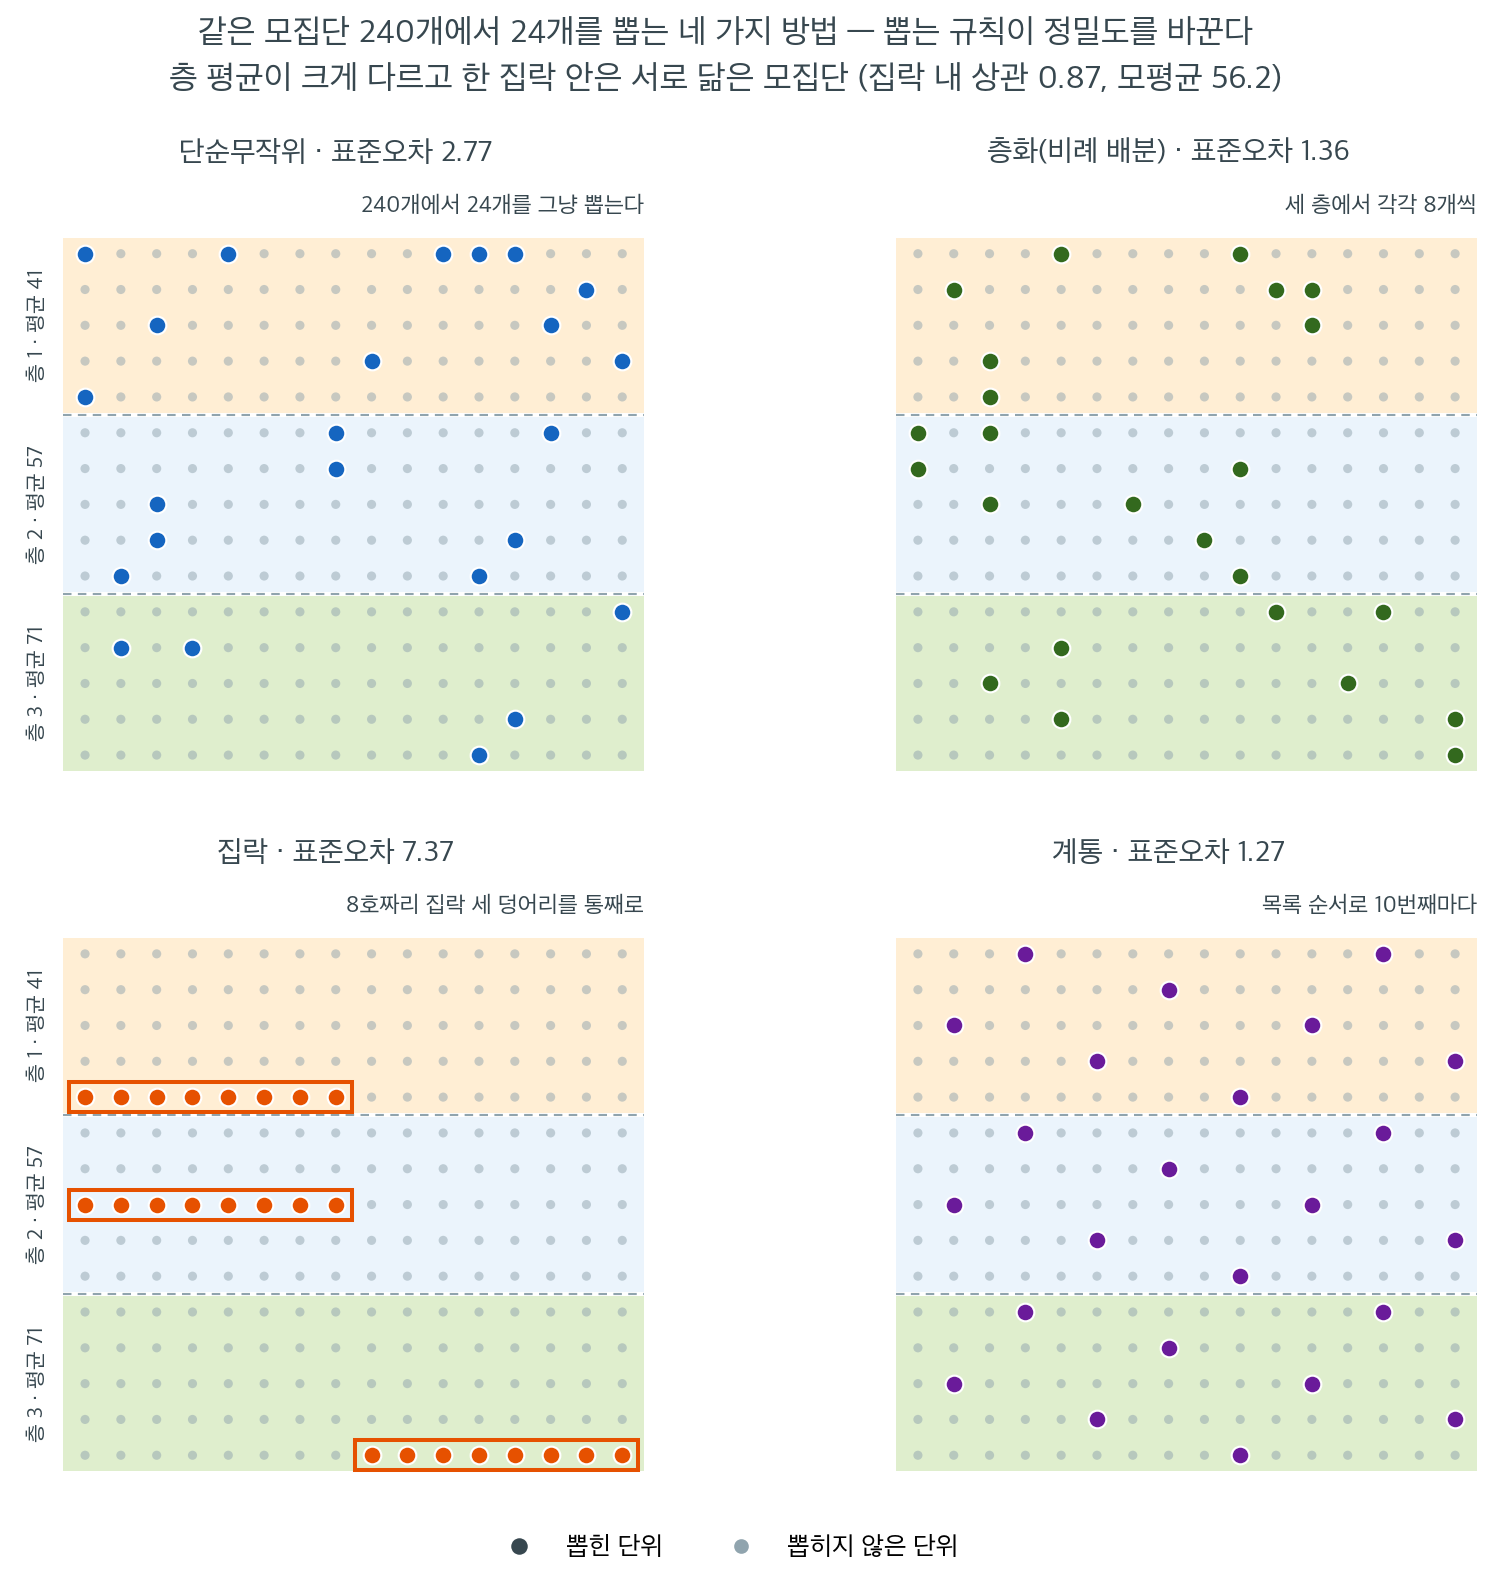
네 설계는 말로 설명하면 비슷비슷하게 들리지만 같은 모집단 위에 겹쳐 그리면 단번에 갈린다. 240개 단위를 16열짜리 목록으로 늘어놓고 5행씩 묶어 세 층을 만들었다. 층 평균은 \(40.7\), \(57.1\), \(71.0\)으로 뚜렷이 다르고, 한 행의 왼쪽 여덟 칸과 오른쪽 여덟 칸이 각각 하나의 집락이다. 집락 안은 서로 닮아서 집락 내 상관이 \(\rho = 0.87\)이다(집락이 층 안에 통째로 들어 있으므로 층 사이의 차이도 집락 간 변동에 포함된다). 네 판 모두 뽑는 개수는 똑같이 24개다. 달라지는 것은 제목에 적힌 표준오차뿐이다.
단순무작위는 24개가 세 층에 몇 개씩 들어갈지를 우연에 맡긴다. 그림에 그린 표본은 층 1에 11개, 층 2에 8개, 층 3에 5개가 들어갔다. 비례 배분이라면 세 층 모두 8개씩이었을 것이다. 층 평균이 \(30\) 가까이 벌어져 있으니 이 구성비의 흔들림이 그대로 추정값의 흔들림이 된다. 표준오차 \(2.77\)이 그 대가다. 오른쪽 위의 층화는 각 층에서 정확히 8개씩 뽑아 그 흔들림을 원천에서 지운다. 표준오차가 \(1.36\)으로 절반 아래이고, 분산으로는 \(4.13\)배 차이다.
왼쪽 아래의 집락표집은 같은 24개를 세 덩어리로 몰아서 뽑는다. 이웃한 여덟 집을 통째로 조사하니 방문 비용은 싸지만 한 집락 안에서 얻는 이야기는 거의 중복이다. 표준오차가 \(7.37\)로 단순무작위의 \(2.66\)배, 분산으로는 \(7.07\)배다. 설계효과 공식 \(1 + (m-1)\rho\)에 \(m = 8\), \(\rho = 0.87\)을 넣으면 \(1 + 7 \times 0.87 = 7.09\)가 나와 모의실험값 \(7.07\)과 거의 같다. 유효 표본 크기는 \(24 / 7.07 \approx 3.4\)다. 240개 중 24개를 조사하고도 손에 든 정보는 무작위로 서너 개 뽑은 것과 같다.
오른쪽 아래의 계통표집은 이 그림에서 가장 정밀하다(\(1.27\)). 우연이 아니다. 목록이 층 순서로 정렬돼 있고 간격 \(k = 10\)이 층 크기 \(80\)을 정확히 나누므로, 시작점이 무엇이든 각 층에서 정확히 8개가 뽑힌다. 층화와 똑같은 배분이 공짜로 따라오는 것이다. 게다가 간격 \(10\)과 행 길이 \(16\)이 맞물려 같은 집락을 두 번 건드리는 일이 시작점 열 개 어디에서도 일어나지 않아, 층화보다 오히려 조금 더 정밀하다. 가능한 시작점이 열 개뿐이므로 나올 수 있는 표본평균도 열 개뿐인데, 그 값들은 \(54.61\)부터 \(58.54\)까지로 모평균 \(56.24\) 둘레에 모여 있다. 이 열 개의 표준편차 \(1.27\)이 곧 계통표집의 정확한 표준오차다 — 모의실험이 필요 없다.
계통표집의 성질을 결정하는 것은 뽑는 규칙이 아니라 목록의 순서다. 여기서는 순서가 층과 나란해서 이득을 보았지만, 순서에 간격과 맞아떨어지는 주기가 숨어 있으면 똑같은 규칙이 정반대로 무너진다(연습문제 8). 그리고 어느 경우든 한 표본만 손에 쥐고 있으면 자신이 어느 쪽에 걸렸는지 알 수 없다.
표본 크기의 수확체감
SRS에서 \(\mathrm{SE}(\bar y) = \sigma/\sqrt{n}\)이다. \(n\)을 네 배로 하면 표준오차는 절반이 된다. 오차한계를 절반으로 줄이려면 자료가 네 배 필요하며, 이 기본적인 경제학이 조사 예산을 좌우한다.
비율을 조사할 때 이 관계는 곧바로 숫자가 된다. 95% 오차한계는 \(1.96\sqrt{\hat p(1-\hat p)/n}\)이고, 최악의 경우인 \(\hat p = 0.5\)에서 \(1.96/(2\sqrt{n}) = 0.98/\sqrt{n}\)이다. \(n = 1{,}000\)이면 \(3.10\)%, \(n = 4{,}000\)이면 \(1.55\)%다. 여론조사 보도에 늘 따라붙는 "\(\pm 3\)%포인트"가 여기서 나온다(연습문제 6). 이 값들이 왜 그런 모양인지는 5.3절 비율의 표본분포에서, 구간 자체를 어떻게 만드는지는 8장에서 다룬다.
보기 1. 표본조사. 젊은 층 \(70\%\)(소득 평균 \(4\)만, 표준편차 \(1\)만)와 나이 든 층 \(30\%\)(평균 \(7\)만, 표준편차 \(1.5\)만)로 이루어진 \(1\)만 명에서 \(200\)명을 뽑는다. 단순무작위추출과 비례 층화추출을 견준다.
(1) 두 방법의 표준오차를 이론적으로 구하시오. 총분산의 법칙으로 층내분산과 층간분산을 나누어 계산하고, 층화가 분산을 몇 분의 1로 줄이는지 말하시오.
(2) 한 번 뽑은 결과만으로 그 이득을 볼 수 있는가. 되풀이해 확인하시오.
풀이
(1) 해석적으로. 층의 가중치를 \(w_h\), 층평균을 \(\mu_h\), 층내 표준편차를 \(\sigma_h\)라 하자. 총분산의 법칙은
이다. 전체 평균은 \(\mu = 0.7\times 40{,}000 + 0.3\times 70{,}000 = 49{,}000\)이고
이므로 \(\sigma^2 = 3.265\times 10^8\), \(\sigma = 18{,}069\)다.
단순무작위추출의 분산은 \(\sigma^2/n\)이고, 비례 배분한 층화추출의 분산은 층내 몫만 남는다.
층화가 하는 일이 바로 이것이다. 층의 구성비를 표본에서 고정해 버리므로 층간분산이 통째로 사라진다. 수로 쓰면
이고 분산비(설계효과)는 \(1.375/3.265 = 0.4211\)이다. 분산이 \(42\%\)로, 표준오차가 \(65\%\)로 줄어든다. 같은 정밀도를 단순무작위추출로 얻으려면 표본이 \(1/0.4211 = 2.4\)배 필요하다.
(2) 해석적으로. 한 번 뽑아서는 볼 수 없다. 두 방법 모두 불편이고 차이는 오직 흔들림의 크기에 있으므로, 한 번의 추정값이 참값에 더 가까운지는 운이 정한다. 분산의 차이는 되풀이해야만 드러난다.
(1)(2) 수치적으로.
"""단순무작위추출과 층화추출을 인공 모집단에서 비교한다."""

import numpy as np
import pandas as pd

rng = np.random.default_rng(42)

# === 두 층으로 이루어진 모집단 ===
# 젊은 층 70%, 나이 든 층 30%. 두 층의 소득 분포가 뚜렷이 다르다.
#   Young: 평균 4만, 표준편차 1만
#   Old:   평균 7만, 표준편차 1.5만
# 층 안에서는 비교적 고르고 층 사이에서 크게 갈리는 이 구조가
# 층화추출이 이득을 보는 전형적인 상황이다.
n_pop = 10_000
stratum = rng.choice(["Young", "Old"], size=n_pop, p=[0.7, 0.3])
income = np.where(
    stratum == "Young",
    rng.normal(40_000, 10_000, n_pop),
    rng.normal(70_000, 15_000, n_pop),
)
pop = pd.DataFrame({"stratum": stratum, "income": income})
true_mean = pop["income"].mean()      # 추정하려는 참값

# === 방법 1: 단순무작위추출(SRS) 200명 ===
# 층을 무시하고 1만 명 중 200명을 그냥 뽑는다.
# 표본에 우연히 노년층이 많이(또는 적게) 들어올 수 있고, 그 우연이 추정값을 흔든다.
srs = pop.sample(200, random_state=1)

# === 방법 2: 비례 층화추출 200명 ===
# 각 층에서 그 층의 모집단 비율만큼 뽑는다: Young 140명, Old 60명.
# 층의 구성비를 표본에서 고정해 버리므로 "우연히 치우칠" 여지가 사라진다.
strat = pop.groupby("stratum", group_keys=False).apply(
    lambda x: x.sample(int(round(200 * len(x) / n_pop)), random_state=1)
)

print(f"True mean:        ${true_mean:,.0f}")
print(f"SRS estimate:     ${srs['income'].mean():,.0f}")
print(f"Stratified est.:  ${strat['income'].mean():,.0f}")

# --- 되풀이해 두 방법의 흔들림을 잰다 ---
w = np.array([0.3, 0.7])                 # Old, Young 의 모집단 비율
sd = np.array([15_000.0, 10_000.0])
mu = np.array([70_000.0, 40_000.0])
mu_bar = (w * mu).sum()
within = (w * sd ** 2).sum()
between = (w * (mu - mu_bar) ** 2).sum()
print(f"이론: 층내분산 {within:,.0f} + 층간분산 {between:,.0f} = 전체분산 {within + between:,.0f}")
print(f"이론 SE: SRS {np.sqrt((within + between) / 200):,.1f}, "
      f"층화 {np.sqrt(within / 200):,.1f},  설계효과 {within / (within + between):.4f}")

idx_y = np.flatnonzero(pop["stratum"].values == "Young")
idx_o = np.flatnonzero(pop["stratum"].values == "Old")
inc = pop["income"].values
reps = 2000
srs_m, str_m = np.empty(reps), np.empty(reps)
for r in range(reps):
    srs_m[r] = inc[rng.choice(n_pop, 200, replace=False)].mean()
    str_m[r] = 0.7 * inc[rng.choice(idx_y, 140, replace=False)].mean() \
             + 0.3 * inc[rng.choice(idx_o, 60, replace=False)].mean()
print(f"모의 {reps}회 SE: SRS {srs_m.std(ddof=1):,.1f}, 층화 {str_m.std(ddof=1):,.1f}, "
      f"비 {str_m.var(ddof=1) / srs_m.var(ddof=1):.4f}")
출력:
True mean:        $49,092
SRS estimate:     $49,455
Stratified est.:  $48,375
이론: 층내분산 137,500,000 + 층간분산 189,000,000 = 전체분산 326,500,000
이론 SE: SRS 1,277.7, 층화 829.2,  설계효과 0.4211
모의 2000회 SE: SRS 1,283.4, 층화 820.1, 비 0.4084
이론값이 모의실험과 맞는다. 되풀이 \(2{,}000\)회가 준 표준오차가 단순무작위 \(1{,}283.4\), 층화 \(820.1\)로 유도한 \(1{,}277.7\)과 \(829.2\)에 가깝다. 표준오차 추정의 몬테카를로 오차가 대략 \(\operatorname{SE}/\sqrt{2\times1999} = 20\)과 \(13\)이므로 둘 다 \(1\) 표준오차 안이다. 분산비도 \(0.4084\) 대 이론 \(0.4211\)로 맞는다.
한 번 뽑은 결과는 아무것도 말해 주지 않는다. 참값 \(49{,}092\)에 대해 단순무작위가 \(49{,}455\)(\(+363\)), 층화가 \(48{,}375\)(\(-717\))로 이번에는 층화 쪽이 더 많이 빗나갔다. 두 방법 모두 불편이므로 한 번의 어긋남은 운일 뿐이고, 실제로 \(\pm1{,}278\)과 \(\pm829\)라는 흔들림 안에서 각각 \(0.28\) 표준오차와 \(-0.86\) 표준오차에 지나지 않는다. 설계의 이득은 분산에 있지 한 번의 추정값에 있지 않다.
유의할 것 하나. 층화의 이득은 전적으로 층간분산이 얼마나 큰가에 달려 있다. 여기서는 두 층의 평균이 \(4\)만과 \(7\)만으로 크게 갈려 층간분산이 전체의 \(58\%\)를 차지했다. 층을 나누었는데 층평균이 서로 비슷하다면 층간분산이 0에 가깝고, 층화해도 얻을 것이 없다.
연습문제
연습문제 1. 어느 대학이 학생 만족도를 조사하려 한다. 각 상황에서 표집 방법을 식별하라.
(a) 학적과가 전체 학생 20,000명의 명단을 만들고 난수 발생기로 500명을 선택한다. (b) 대학이 학생을 1·2·3·4학년으로 나눈 뒤 각 학년에서 125명씩 무작위로 선택한다. (c) 대학이 기숙사 10곳을 무작위로 선택하고 그 기숙사의 모든 사생을 조사한다. (d) 한 연구자가 도서관 앞에 서서 지나가는 학생 200명을 순서대로 조사한다. (e) 가나다순 명부에서 무작위로 고른 위치에서 시작해 40번째마다 학생을 뽑는다.
풀이
(a) 단순무작위표집. (b) 층화무작위표집, 층 = 학년. (c) 집락표집, 집락 = 기숙사. (d) 편의표집 — 확률표본이 아니며, 그 결과 얻은 추정값에는 타당한 불확실성 측도가 없다. (e) 계통표집. 명부 순서가 만족도와 상관이 없다면 SRS와 동등하지만, 예컨대 가나다순이 출신 배경을 대리하고 만족도가 배경에 따라 다르다면 편향된다.
연습문제 2. 비례 배분 아래에서 층화 평균의 분산을 유도하고, 그것이 SRS 분산 이하임을 보여라. 총분산의 법칙을 이용해 이득이 언제 가장 큰지 밝혀라.
풀이
\(w_h = N_h/N\)이라 하자. 비례 배분 \(n_h = w_h n\) 아래에서 층화추정량은 \(\bar y_{\text{strat}} = \sum_h w_h \bar y_h\)이고
이다. SRS 분산은 \(\mathrm{Var}(\bar y_{\text{SRS}}) = \sigma^2 / n\)이다. 총분산의 법칙에 의해
따라서
이득 — 분자의 두 번째 항 — 은 층 간 분산과 같다. 층 평균 \(\mu_h\)가 뚜렷이 다르고 층 내 분산이 작을 때 층화의 효과가 가장 크다. \(\square\)
연습문제 3. 어떤 건강조사가 학교를 집락으로 하는 집락표집을 사용하며, 학교당 학생은 \(m = 30\)명이고 결과 변수의 집락 내 상관은 \(\rho = 0.10\)이다. 학교 50곳을 표집할 때 설계효과와 유효 표본 크기를 계산하라.
풀이
명목 표본 크기: \(n = 50 \times 30 = 1500\).
유효 표본 크기: \(n_{\text{eff}} = n / \mathrm{DEFF} = 1500 / 3.9 \approx 385\).
학생 1,500명의 자료를 모았는데도 정밀도는 SRS로 약 385명을 뽑은 것과 같다. SRS 1,500명의 정밀도에 맞추려면 이 집락 설계는 대략 \(1500 \times 3.9 \approx 5{,}850\)명을 표집해야 한다. 단위당 비용이 극적으로 낮을 때만 집락 설계를 택하는 이유가 여기 있다.
연습문제 4. 회수된 응답이 240만 건이었던 1936년 《Literary Digest》 여론조사가, 응답자 5만 명뿐이었던 같은 해 갤럽 조사보다 투표 의향을 훨씬 더 나쁘게 추정한 이유를 설명하라. 갤럽의 조사도 확률표본이 아니었다는 점에 주의하라.
풀이
《Literary Digest》의 표집틀은 전화 가입자, 자동차 소유자, 그리고 자기 잡지 구독자였다. 1936년에 앞의 둘은 모두 부유층에 집중된 사치품이었고, 이 집단은 공화당 지지가 불균형하게 많았다. 여기에 무응답이 겹친다. 발송한 \(1{,}000\)만 장 중 회수된 것은 \(24\)%뿐이었고, 우편 투표용지를 굳이 돌려보낸 사람은 현직 대통령에게 불만이 있는 쪽으로 기울어 있었다. 편향은 표본의 크기가 아니라 누가 표집틀에 들어갔는가와 누가 답했는가에 있었다.
표집 이론이 주는 표준오차 \(\sigma/\sqrt{n}\)은 모집단 평균이 아니라 표집틀 평균 주위의 오차다. \(n = 240\)만이면 표준오차는 사실상 0이지만, 그 추정량은 엉뚱한 목표에 대해 일치한다. 표본을 키우는 것은 과녁 한가운데를 더 촘촘히 맞히는 일이지, 과녁을 옮겨 주는 일이 아니다.
갤럽 쪽도 확률표본은 아니었다. 1936년의 갤럽은 면접원에게 성별·연령·지역·소득 구간별로 몇 명을 채워 오라고 지시하는 할당표집을 썼다. 할당표집에는 알려진 선택 확률이 없으므로 표준오차를 계산할 근거가 없고, 실제로 갤럽의 추정도 편향되어 있었다(루스벨트 득표율을 \(56\)% 정도로 보았으나 실제는 \(61\)%에 가까웠다). 그럼에도 갤럽이 이긴 것은 그 표집틀이 유권자 전체를 겨누고 있었기 때문이다. 덜 편향된 목표 주위의 큰 변동성이, 크게 편향된 목표 주위의 거의 0에 가까운 변동성을 이긴 것이다.
할당표집 자체도 결국 무너진다. 면접원에게 "누구를 만날지"의 재량이 남아 있기 때문이며, 1948년 트루먼–듀이 선거에서 갤럽이 크게 틀린 뒤 업계 전체가 확률표집으로 옮겨 갔다.
빅데이터가 나쁜 데이터를 고쳐주지는 않는다. 이것이 《Literary Digest》 교훈의 현대적 재진술이며, 분석가들이 방대하지만 대표성 없는 웹·행정 자료를 다루면서 점점 더 중요해지고 있다.
연습문제 5. 무응답은 모든 실제 조사를 괴롭힌다. 어떤 전화 조사의 응답률이 25%인데, 응답자는 모집단보다 나이가 조금 더 많고 교육 수준이 더 높다. 그 결과 생기는 편향에 대응하는 서로 다른 두 전략 — 하나는 설계 측면, 하나는 분석 측면 — 을 제시하라.
풀이
설계 측면(응답 자체를 개선):
- 하루 중 여러 시간대에 반복 재통화.
- 혼합 방식 후속 접촉(우편, 그다음 전화, 그다음 대면).
- 완료에 대한 소액 사례(예: 5달러 상품권).
- 더 짧은 설문지.
응답률이 높아지면 응답자와 무응답자가 다르더라도 무응답 편향이 줄어든다.
분석 측면(조사 후 보정):
- 사후층화 가중: 인구총조사에서 얻은 알려진 모집단 주변분포(연령, 교육, 지역)에 맞도록 응답자에게 가중치를 준다. 과대표집된 칸에 속한 30세 여성 응답자는 과소표집된 칸의 응답자보다 낮은 가중치를 받는다.
- 보조 자료로 응답 성향을 모형화할 수 있을 때의 역확률가중(IPW).
- 명시적인 결측 가정 아래 결측 결과에 대한 다중대체.
분석 측면 방법은 모두 가정(응답 모형, 가중 변수를 조건부로 한 결과의 무시가능성) 위에 서 있다. 편향을 줄이지만 없애지는 못하며, 완전히 믿을 수 있는 유일한 방어는 설계로 높은 응답률을 확보하는 것이다.
연습문제 6. 비율이 \(p\)인 이항 결과를 조사할 때 오차한계(95% 신뢰구간의 반폭)를 \(0.03\) 이하로 하고자 한다. \(p\)에 대한 사전 지식을 전혀 쓰지 않을 때 SRS에서 필요한 최소 표본 크기는 얼마인가? 이 공식은 어디서 나오는가?
풀이
95% 오차한계는 근사적으로
이다. 최악의 경우는 \(p = 1/2\)이며 이때 \(p(1-p) = 0.25\)이다. \(\mathrm{ME} \le 0.03\)으로 두면
이다. 따라서 참값 \(p\)와 무관하게 약 1,068명의 표본이면 충분하다. 전국 여론조사의 "\(n \approx 1{,}000\)" 어림법칙이 여기서 나왔다.
이것은 표집 오차만이라는 점에 유의하라. 실제 조사의 총오차에는 무응답 편향, 포괄 편향, 측정오차도 포함되며, 언론이 보도하는 ±3%포인트의 표집 오차한계를 압도할 수 있다.
연습문제 7. 본문에 언급된 네이만 배분 \(n_h \propto N_h\sigma_h\)을 유도하고, 층별 분산이 크게 다른 모집단에서 비례 배분과 비교하라.
풀이
유도. \(\sum_h n_h = n\) 제약 아래
을 최소화한다. 라그랑주 함수 \(\mathcal{L} = \sum_h W_h^2\sigma_h^2/n_h + \lambda(\sum_h n_h - n)\)을 \(n_h\)로 미분하면
이고, 제약을 써서 \(\sqrt{\lambda}\)를 없애면
를 얻는다. \(\square\)
해석. 층에 표본을 더 주어야 하는 경우는 두 가지다. 층이 크거나(\(W_h\)), 층 안이 더 흩어져 있거나(\(\sigma_h\)). 비례 배분은 앞의 것만 본다. 모든 \(\sigma_h\)가 같으면 두 배분이 일치한다.
import numpy as np

rng = np.random.default_rng(0)
N_h = np.array([5000, 3000, 2000])
mu_h = np.array([40., 55., 90.])
sd_h = np.array([5., 10., 40.])          # 분산이 층마다 크게 다르다

pop = [rng.normal(m, s, k) for m, s, k in zip(mu_h, sd_h, N_h)]
N, n = N_h.sum(), 300
W = N_h / N

prop = np.array([150, 90, 60])                          # 비례:  W_h * n
ney = np.round(n * W * sd_h / (W * sd_h).sum()).astype(int)
ney[-1] = n - ney[:-1].sum()                            # 네이만: W_h sigma_h
print(f"비례 배분:   {prop}")
print(f"네이만 배분: {ney}")

var_of = lambda a: sum(W[i] ** 2 * sd_h[i] ** 2 / a[i] for i in range(3))
print(f"\n이론 분산  비례 {var_of(prop):.5f}   네이만 {var_of(ney):.5f}"
      f"   비 {var_of(prop) / var_of(ney):.3f}")

B = 20_000
sim = lambda a: np.array([sum(W[i] * rng.choice(pop[i], a[i], replace=False).mean()
                              for i in range(3)) for _ in range(B)])
a, b = sim(prop), sim(ney)
truth = sum(W[i] * pop[i].mean() for i in range(3))
print(f"\n참값 {truth:.4f}")
print(f"비례:   평균 {a.mean():.4f}   표준오차 {a.std(ddof=1):.4f}")
print(f"네이만: 평균 {b.mean():.4f}   표준오차 {b.std(ddof=1):.4f}")
print(f"모의 분산비 {a.var() / b.var():.3f}")
출력:
비례 배분:   [150  90  60]
네이만 배분: [ 56  67 177]

이론 분산  비례 1.20833   네이만 0.60752   비 1.989

참값 54.7497
비례:   평균 54.7432   표준오차 1.0633
네이만: 평균 54.7464   표준오차 0.7492
모의 분산비 2.014
배분이 극적으로 달라진다. 비례는 \((150, 90, 60)\)인데 네이만은 \((56, 67, 177)\)이다. 가장 작은 층이 가장 흩어져 있으므로(\(\sigma_3 = 40\)) 표본의 절반 넘게 그리로 간다. 분산이 절반으로 줄어든다.
한계. 네이만 배분은 \(\sigma_h\)를 알아야 한다. 실무에서는 예비조사나 과거 자료로 추정하며, 추정이 어긋나도 비례 배분보다 크게 나빠지지는 않는다.
더 현실적인 제약은 다목적 조사다. 조사 하나로 여러 변수를 재는데 변수마다 최적 배분이 다르다. 이럴 때는 절충안을 쓰거나, 애초에 비례 배분으로 두기도 한다. 또 하나, 네이만 배분은 작은 층의 표본이 극단적으로 커질 수 있어 \(n_h \le N_h\) 제약에 걸리기도 한다. \(\square\)
연습문제 8. 계통표집이 주기성 때문에 무너지는 경우를 모의실험하라. 요일 효과가 있는 자료에서 \(k = 7\)과 \(k = 8\)을 비교하라.
풀이
import numpy as np

rng = np.random.default_rng(1)
N = 7000
day = np.arange(N) % 7
y = 50 + np.where(day == 5, 40., 0.) + rng.normal(0, 5, N)   # 토요일에 매출 급증

print(f"모평균 {y.mean():.4f}")

sys7 = [y[np.arange(s, N, 7)].mean() for s in range(7)]
print(f"\nk=7 계통표집, 시작점별 평균:")
print(f"  {np.round(sys7, 2)}")
print(f"  표준편차 {np.std(sys7):.4f}")

sys8 = [y[np.arange(s, N, 8)].mean() for s in range(8)]
print(f"\nk=8 계통표집, 시작점별 평균:")
print(f"  {np.round(sys8, 2)}")
print(f"  표준편차 {np.std(sys8):.4f}")

srs = np.array([y[rng.choice(N, 1000, replace=False)].mean() for _ in range(5000)])
print(f"\nSRS n=1000: 평균 {srs.mean():.4f}   표준오차 {srs.std(ddof=1):.4f}")
출력:
모평균 55.6948

k=7 계통표집, 시작점별 평균:
  [49.98 50.31 49.98 49.82 50.11 89.89 49.77]
  표준편차 13.9603

k=8 계통표집, 시작점별 평균:
  [55.76 55.67 55.78 55.78 55.81 55.39 55.58 55.79]
  표준편차 0.1361

SRS n=1000: 평균 55.7078   표준오차 0.4347
\(k = 7\)일 때 재앙이 일어난다. 표집 간격이 자료의 주기와 정확히 맞아떨어져, 시작점이 토요일이면 모든 표본이 토요일이고 시작점이 다른 요일이면 토요일이 하나도 없다. 추정값은 \(49.8\) 아니면 \(89.9\)이며, 참값 \(55.7\)은 결코 나오지 않는다. 시작점에 걸친 표준편차가 \(13.96\)으로 SRS의 \(0.43\)보다 \(32\)배 크다.
이것이 무작위 오차가 아니라는 점이 핵심이다. 표본 크기를 늘려도 전혀 나아지지 않는다. 간격이 \(7\)인 한 표본은 언제나 한 요일로만 채워진다.
\(k = 8\)로 바꾸면 오히려 SRS보다 낫다. 표준편차가 \(0.136\)으로 SRS의 \(0.435\)의 삼분의 일이다. 간격이 주기와 서로소여서 표본이 일곱 요일을 고르게 훑기 때문이다. 이는 사실상 요일로 층화한 것과 같은 효과다.
실무 지침.
- 표집 간격 \(k\)가 자료의 알려진 주기와 공약수를 갖지 않게 하라.
- 주기가 의심되면 반복 계통표집을 쓰라. 시작점을 여러 개 뽑아 간격을 넓히면, 표본 간 분산을 실제로 추정할 수도 있게 된다.
- 목록을 미리 무작위로 섞으면 주기성이 사라져 계통표집이 SRS와 동등해진다. 다만 목록 순서가 유용한 층화 효과를 주고 있었다면 그 이득도 함께 사라진다.
계통표집이 위험한 진짜 이유는 하나의 표본만으로는 이 문제를 알아챌 수 없다는 것이다. \(k=7\) 표본의 매출은 내부적으로 아주 안정되어 보여서, 계산한 표준오차가 작게 나온다. 자신 있게 틀리는 또 하나의 방식이다. \(\square\)
연습문제 9. 사후층화 가중을 직접 구현하라. 응답률이 연령대에 따라 다른 조사를 모의실험하고, 알려진 모집단 연령 분포로 보정했을 때 편향이 얼마나 줄어드는지 측정하라.
풀이
사후층화 추정량은 표본에서 얻은 층별 평균을 모집단의 층 비율로 가중한다.
여기서 \(W_h\)는 인구총조사 등 외부 자료에서 온 알려진 값이다.
import numpy as np

rng = np.random.default_rng(2)
N = 100_000
W_true = np.array([0.40, 0.35, 0.25])              # 알려진 모집단 연령 분포
age = rng.choice([0, 1, 2], N, p=W_true)
y = np.array([30., 50., 70.])[age] + rng.normal(0, 10, N)

p_resp = np.array([0.10, 0.25, 0.50])[age]         # 나이 많을수록 응답률↑

B = 5000
naive = np.empty(B)
post = np.empty(B)
for b in range(B):
    pool = rng.choice(N, 4000, replace=False)
    r = pool[rng.random(4000) < p_resp[pool]]      # 실제 응답자
    naive[b] = y[r].mean()
    post[b] = sum(W_true[h] * y[r][age[r] == h].mean() for h in range(3))

print(f"참 모평균 {y.mean():.4f}")
print(f"단순평균   {naive.mean():.4f}   편향 {naive.mean() - y.mean():+.4f}"
      f"   표준오차 {naive.std(ddof=1):.4f}")
print(f"사후층화   {post.mean():.4f}   편향 {post.mean() - y.mean():+.4f}"
      f"   표준오차 {post.std(ddof=1):.4f}")
출력:
참 모평균 47.0006
단순평균   56.7327   편향 +9.7320   표준오차 0.5630
사후층화   46.9737   편향 -0.0270   표준오차 0.3868
편향이 \(+9.73\)에서 \(-0.03\)으로 사실상 사라진다. 덤으로 표준오차까지 \(0.563\)에서 \(0.387\)로 줄었다. 층화가 그렇듯 사후층화도 정밀도를 함께 높이는 경우가 많다.
왜 통하는가. 응답률이 연령에 의존하므로 표본의 연령 구성이 모집단과 다르다. 여기서는 응답자의 절반 가까이가 최고령층인데 모집단에서는 \(25\%\)다. 그래서 평균이 위로 끌려간다. 층별 평균에 모집단 가중치를 다시 씌우면 이 왜곡이 지워진다.
결정적인 가정. 사후층화가 편향을 없애는 것은 연령을 조건부로 하면 응답 여부가 \(y\)와 무관할 때뿐이다. 같은 연령대 안에서도 소득이 높은 사람이 덜 응답한다면, 연령으로 아무리 가중해도 그 편향은 남는다.
이것이 실무의 어려움이다. 가중은 가중 변수로 설명되는 편향만 고친다. 그래서 조사기관은 연령·성별·지역·교육·인종을 동시에 맞추는 레이킹을 쓰고, 정치 조사에서는 과거 투표 행태까지 넣는다. 그럼에도 2016년과 2020년 미국 대선 여론조사의 오차처럼, 가중 변수로 포착되지 않는 편향은 남는다.
가중의 대가
가중치가 극단적으로 커지면 분산이 커진다. 어떤 칸의 응답자가 \(3\)명뿐인데 가중치가 \(50\)이면, 그 \(3\)명이 추정값을 좌우한다. 그래서 실무에서는 가중치를 잘라내는데(trimming), 이는 분산을 줄이는 대신 편향을 조금 되돌려 놓는 맞바꿈이다. \(\square\)
연습문제 10. 확률표본의 정의는 선택 확률이 "알려진 \(0\)이 아닌" 값이라는 것이지 같은 값이라는 것이 아니다. 선택 확률이 서로 다를 때 쓰는 호비츠–톰프슨 추정량을 구현하고, 규모비례확률(PPS) 표집이 언제 이득이고 언제 손해인지 보여라.
풀이
단위 \(i\)가 표본에 뽑힐 확률이 \(\pi_i\)일 때, 총계의 호비츠–톰프슨 추정량은
이다. 불편성 증명. 지시변수 \(I_i\)를 쓰면 \(\mathbb{E}[I_i] = \pi_i\)이므로
이다. 표집 설계가 무엇이든 \(\pi_i > 0\)이기만 하면 성립한다. \(1/\pi_i\)는 "이 응답자가 대표하는 모집단 단위의 수"로 읽으면 된다. \(\square\)
import numpy as np

rng = np.random.default_rng(3)
N, n, B = 5000, 200, 20_000
size = rng.lognormal(3, 0.8, N)          # 사업체 규모
pi = n * size / size.sum()               # 규모비례확률
cum = np.cumsum(pi)
madow = lambda u: np.searchsorted(cum, u + np.arange(n))   # 고정크기 PPS

cases = [("y 가 규모에 거의 비례", 2.5 * size + rng.normal(0, 3, N)),
         ("y 가 규모와 무관",      np.full(N, 50.) + rng.normal(0, 20, N))]

for label, y in cases:
    T = y.sum()
    ht = np.empty(B); naive = np.empty(B); srs = np.empty(B)
    for b in range(B):
        s = madow(rng.random())
        ht[b] = (y[s] / pi[s]).sum()          # 호비츠–톰프슨
        naive[b] = y[s].mean() * N            # 가중을 잊은 경우
        srs[b] = y[rng.choice(N, n, replace=False)].mean() * N
    print(f"{label}   (참 총계 {T:,.0f})")
    for nm, v in [("단순 확대", naive), ("PPS + HT", ht), ("SRS", srs)]:
        print(f"   {nm:>9}: 편향 {v.mean() - T:>+10,.0f}   표준오차 {v.std(ddof=1):>10,.0f}")
    print(f"   → HT 의 표준오차는 SRS 의 {ht.std(ddof=1) / srs.std(ddof=1):.2f}배\n")
출력:
y 가 규모에 거의 비례   (참 총계 347,672)
       단순 확대: 편향   +309,513   표준오차     23,963
    PPS + HT: 편향        +19   표준오차      1,438
         SRS: 편향       +108   표준오차     22,740
   → HT 의 표준오차는 SRS 의 0.06배

y 가 규모와 무관   (참 총계 251,386)
       단순 확대: 편향       -786   표준오차      6,175
    PPS + HT: 편향       +175   표준오차     19,796
         SRS: 편향        -11   표준오차      6,796
   → HT 의 표준오차는 SRS 의 2.91배
세 가지를 읽어야 한다.
첫째, 가중을 잊으면 재앙이다. 두 경우 모두 단순 확대는 크게 편향된다. 첫째 경우 \(+89\%\)나 어긋나는데, 큰 사업체가 뽑힐 확률이 높은데도 모두 똑같이 취급했기 때문이다. 이것이 실무에서 가장 흔한 오류다.
둘째, HT는 언제나 불편이다. 두 경우 모두 편향이 참값의 \(0.1\%\) 미만이다. 설계가 무엇이든, \(y\)와 규모의 관계가 어떻든 상관없다.
셋째, PPS의 효율은 조건부다.
| HT / SRS 표준오차 | 뜻 | |
|---|---|---|
| \(y \propto\) 규모 | \(0.06\) | \(16\)배 정밀 |
| \(y \perp\) 규모 | \(2.9\) | \(3\)배 부정확 |
\(y_i/\pi_i\)의 변동이 HT의 분산을 결정한다. \(y_i\)가 규모에 비례하면 \(y_i/\pi_i\)가 거의 상수라 분산이 사라진다. 반대로 \(y_i\)가 규모와 무관하면 작은 단위의 \(1/\pi_i\)가 거대해져 분산이 폭발한다.
실무 함의. 사업체 조사에서 매출 총계를 추정할 때는 규모비례확률이 압도적으로 유리하다. 큰 사업체 몇 곳이 총계의 대부분을 차지하므로 반드시 표본에 넣어야 한다. 반면 "사업체당 평균 만족도"처럼 규모와 무관한 양을 재려 한다면 같은 설계가 오히려 해롭다.
하나의 조사가 여러 목적을 갖는다는 것이 근본적 긴장이다. 어떤 변수에 최적인 설계가 다른 변수에는 나쁠 수 있다. 그래서 실제 조사 설계는 최적화가 아니라 절충이다. \(\square\)
정리하며
표본조사에서 정확도를 결정하는 것은 표본 크기가 아니라 설계와 표집틀이다.
- 네 가지 표준 설계. 단순무작위(이론이 가장 단순) · 층화(하위집단 포괄을 보장하고 정밀도를 높임) · 집락(비용은 싸지만 분산이 커짐) · 계통(쉽지만 목록의 주기성에 취약).
- 표집틀의 결함이 곧 편향이다. 과소포괄·과대포괄·중복 어느 쪽이든 표본을 늘려서 고칠 수 없다.
- 유한모집단 수정. \(\mathrm{Var}(\bar y)=\frac{\sigma^2}{n}\left(1-\frac nN\right)\) 에서 \(n/N\) 이 작으면 이 인자는 거의 1이다. 관례적 기준은 \(n/N \le 0.05\) 다. 그 조건 아래에서는 모집단의 크기가 정밀도에 거의 영향을 주지 않는다 — 인구 5000만의 전국 조사든 인구 100만의 도시 조사든 1000명이면 정밀도가 사실상 같다는 사실이 여기서 나온다. 조건이 깨지는 곳도 분명하다. 조합원 2000명 중 1000명을 조사하면 \(n/N = 0.5\) 라 표준오차가 \(0.707\) 배로 줄어든다.
1936년 《Literary Digest》 사례가 이 절 전체의 요약이다. 240만 명을 모으고도 틀렸고, 갤럽은 5만 명으로 맞혔다. 더 놀라운 것은 갤럽이 같은 종류의 명단에서 3000명만 뽑아 《Digest》가 무엇을 발표할지까지 맞혔다는 점이다. 편향의 방향과 크기는 설계만 알면 예측할 수 있고, 표본 크기로는 지울 수 없다.
다음 절 가진 자료를 분석하라에서 시야가 바뀐다. 지금까지는 자료를 설계해서 만들었지만, 현대의 많은 자료는 누군가 다른 목적으로 남긴 것을 주워 쓰는 것이다. 그때 무엇을 얻고 무엇을 잃는지를 본다.