동질성 검정 (scipy)
개요
카이제곱 동질성 검정은 둘 이상의 모집단이 여러 범주에 걸쳐 같은 분포를 공유하는지 평가한다. 계산은 카이제곱 독립성 검정과 완전히 같지만(둘 다 scipy.stats.chi2_contingency를 쓴다) 연구 설계와 해석이 다르다. 행은 독립적으로 추출된 모집단을 나타내고, 우리는 그 모집단들 사이에서 열의 비율이 같은지를 묻는다.
연구 설계의 구분
| 측면 | 독립성 | 동질성 |
|---|---|---|
| 표집 | 표본 하나, 두 변수를 기록 | 각 모집단에서 별도의 표본 |
| 질문 | 두 변수가 연관되어 있는가? | 모집단들의 분포가 같은가? |
| 표의 행 | 변수 A의 수준 | 모집단 |
| 표의 열 | 변수 B의 수준 | 반응의 범주 |
틀은 다르지만 검정통계량, 자유도, p-값 계산은 동일하다.
가설
- 귀무가설 (\(H_0\)): 범주에 걸친 분포가 모든 모집단에서 같다.
- 대립가설 (\(H_A\)): 적어도 한 모집단의 분포가 다르다.
검정통계량
여기서 \(E_{ij} = R_i C_j / n\)이고 \(\text{df} = (r-1)(c-1)\)이다.
보기 1. 동질성 검정 — 기본 예. 모집단 세 곳에서 각각 100 명을 뽑아 네 범주 중 하나로 응답을 받았다.
(1) 세 행의 기대도수가 완전히 같다. 왜 그런지 설명하고 기대도수를 유리수로 구하시오.
(2) \(\chi^2\) 을 유리수로 구하고 자유도와 p-값을 구해 \(\alpha = 0.05\) 에서 판정하시오.
(3) 칸별 기여와 잔차로 어디가 어긋났는지 찾으시오. 크래머 \(V\) 로 효과크기도 재시오.
풀이
(1) 행 합이 모두 같으면 기대행도 같다. 동질성의 기대도수는
곧 "모집단 \(i\) 의 표본 크기에 합동 비율을 곱한 것" 이다. 여기서는 \(R_1 = R_2 = R_3 = 100\) 이고 \(n = 300\) 이므로
가 되어 \(i\) 가 사라진다. 세 행이 글자 하나까지 같은 것이 그 때문이다.
합동 비율로 적으면 \((0.243333,\ 0.256667,\ 0.233333,\ 0.266667)\) 이다. 귀무가설은 "세 모집단의 응답 비율이 모두 이 네 수와 같다" 는 말이다.
(2) 통계량. 기대도수의 분모가 모두 3 이므로 유리수 계산이 끝까지 깔끔하다. 열두 칸을 모두 더하면
이고 자유도는 \((3-1)(4-1) = 6\) 이다. p-값은
이고 임계값은 \(\chi^2_{6,\,0.05} = 12.5916\) 이다. \(14.17 > 12.59\) 이고 \(p < 0.05\) 이므로 기각한다. 적어도 한 모집단의 응답 분포가 다르다.
수치적으로.
import numpy as np
from scipy import stats

# 모집단 3개(행), 범주 4개(열)
# 동질성 검정과 독립성 검정은 **계산이 완전히 같다**. 다른 것은 표집 설계뿐이다.
# 여기서는 모집단마다 표본을 따로 뽑았으므로 행 합계가 설계자에 의해 고정되어 있다.
observed = np.array([
    [25, 30, 20, 25],   # 모집단 1
    [18, 22, 35, 25],   # 모집단 2
    [30, 25, 15, 30],   # 모집단 3
], dtype=float)

chi2, p, df, expected = stats.chi2_contingency(observed, correction=False)

print("=== Chi-square Test of Homogeneity (scipy) ===")
print(f"chi2 = {chi2:.4f}, df = {df}, p = {p:.6f}")
print()
print("Expected counts under H0 (same proportions):")
print(expected)
출력:
=== Chi-square Test of Homogeneity (scipy) ===
chi2 = 14.1697, df = 6, p = 0.027796

Expected counts under H0 (same proportions):
[[24.33333333 25.66666667 23.33333333 26.66666667]
 [24.33333333 25.66666667 23.33333333 26.66666667]
 [24.33333333 25.66666667 23.33333333 26.66666667]]
세 행의 기대도수가 완전히 같다. 세 모집단의 표본크기가 모두 100으로 같고 \(H_0\)이 "분포가 같다"이므로 그럴 수밖에 없다. 출력의 24.33333333 등이 (1)의 \(73/3\) 과 맞고, chi2 = 14.1697, df = 6, p = 0.027796 이 (2)의 손계산과 맞는다.
(3) 어디가 어긋났는가. 전체 검정은 "적어도 한 모집단이 다르다" 까지만 말한다. 칸별로 쪼개 본다.
import numpy as np

O = np.array([[25, 30, 20, 25],
              [18, 22, 35, 25],
              [30, 25, 15, 30]], dtype=float)
R, C, n = O.sum(1), O.sum(0), O.sum()
E = np.outer(R, C) / n
contrib = (O - E) ** 2 / E
pearson = (O - E) / np.sqrt(E)
adj = (O - E) / np.sqrt(E * (1 - R[:, None] / n) * (1 - C[None, :] / n))

for name, M in [("칸별 기여  (O-E)^2/E", contrib),
                ("피어슨 잔차  (O-E)/sqrt(E)", pearson),
                ("조정 잔차", adj)]:
    print(name)
    for i, row in enumerate(M):
        print(f"  모집단 {i + 1}  " + " ".join(f"{v:+8.4f}" for v in row))
print("\n열별 기여 합  " + " ".join(f"{v:8.4f}" for v in contrib.sum(0)))
print(f"전체 chi2 = {contrib.sum():.4f}   가장 큰 칸의 몫 "
      f"{contrib.max() / contrib.sum():.3f}   범주 3 열의 몫 "
      f"{contrib.sum(0)[2] / contrib.sum():.3f}")
print(f"크래머 V = {np.sqrt(contrib.sum() / (n * 2)):.4f},   최소 기대도수 {E.min():.4f}")
출력:
칸별 기여  (O-E)^2/E
  모집단 1   +0.0183  +0.7316  +0.4762  +0.1042
  모집단 2   +1.6484  +0.5238  +5.8333  +0.1042
  모집단 3   +1.3196  +0.0173  +2.9762  +0.4167
피어슨 잔차  (O-E)/sqrt(E)
  모집단 1   +0.1351  +0.8553  -0.6901  -0.3227
  모집단 2   -1.2839  -0.7237  +2.4152  -0.3227
  모집단 3   +1.1488  -0.1316  -1.7252  +0.6455
조정 잔차
  모집단 1   +0.1903  +1.2150  -0.9652  -0.4616
  모집단 2   -1.8077  -1.0281  +3.3783  -0.4616
  모집단 3   +1.6174  -0.1869  -2.4131  +0.9232

열별 기여 합    2.9863   1.2727   9.2857   0.6250
전체 chi2 = 14.1697   가장 큰 칸의 몫 0.412   범주 3 열의 몫 0.655
크래머 V = 0.1537,   최소 기대도수 23.3333
범주 3 한 열이 전부다. 그 열의 기여 합이 \(9.2857\) 로 전체 \(14.1697\) 의 \(65.5\%\) 이고, 그중 모집단 2 의 칸 하나가 \(5.8333\) 으로 \(41.2\%\) 다. 기대 \(23.3\) 에 대해 35 가 관측되었다. 모집단 3 은 반대로 \(15\) 로 내려앉아 \(2.9762\) 를 보탠다. 범주 3 에서 모집단 2 와 3 이 서로 반대 방향으로 벌어진 것이 기각의 이유다.
잔차는 방향까지 알려 준다. 피어슨 잔차 \((O-E)/\sqrt E\) 가 모집단 2·범주 3 에서 \(+2.4152\), 모집단 3·범주 3 에서 \(-1.7252\) 다. 다만 피어슨 잔차는 분산을 과대평가한다. 주변합이 고정되어 있어 실제 분산이 \(E_{ij}\) 보다 \((1-R_i/n)(1-C_j/n)\) 배 작기 때문이다. 그 보정을 넣은 조정 잔차는 각각 \(+3.3783\) 과 \(-2.4131\) 이 되어, 표준정규의 \(\pm 1.96\) 기준으로 보면 두 칸 모두 유의하다. 피어슨 잔차만 보았다면 \(-1.7252\) 를 "유의하지 않다" 고 넘겼을 것이다.
\(p = 0.0278\)로 기각한다. 가장 크게 어긋난 곳은 모집단 2의 범주 3으로, 기대 23.3에 대해 35가 관측되었다.
다만 효과크기는 작다. 크래머 \(V = 0.1537\) 이다. \(\chi^2 = nV^2\min(r-1,c-1)\) 이므로 \(n = 300\) 이 통계량을 끌어올린 몫이 크다. 최소 기대도수가 \(23.33\) 으로 타당성 조건은 넉넉히 충족된다.
주요 출력:
chi2_contingency는 값 네 개를 돌려준다: 검정통계량, p-값, 자유도, 기대도수 행렬.correction=False로 두면 Yates 보정이 적용되지 않는다(어차피 Yates는 \(2 \times 2\) 표에만 의미가 있다).
동질성 아래의 기대도수
\(H_0\) 아래에서 각 모집단은 합동(전체) 비율과 같은 범주 비율을 가진다. 모집단 \(i\)의 범주 \(j\)에 대한 기대도수는
이다. 여기서 \(n_i = R_i\)는 모집단 \(i\)의 표본크기, \(C_j\)는 범주 \(j\)의 전체 도수, \(n\)은 총합이다. 이는 대수적으로 \(R_i C_j / n\)과 같다.
해석
모집단 3개와 범주 4개인 보기 자료에서:
- \(\text{df} = (3-1)(4-1) = 6\)
- 검정통계량과 p-값은 세 모집단 사이에서 관측된 범주 비율의 차이가 표집 변동만으로 기대되는 정도보다 큰지를 판정한다.
p-값이 \(\alpha = 0.05\)보다 작으면 적어도 한 모집단의 반응 분포가 유의하게 다르다고 결론짓는다. 이 검정은 어느 모집단이 다른지는 알려주지 않는다. 그것을 알려면 사후분석(예: 표준화 잔차 검토)이 필요하다.
귀무가설은 세 선이 겹친다는 말이다
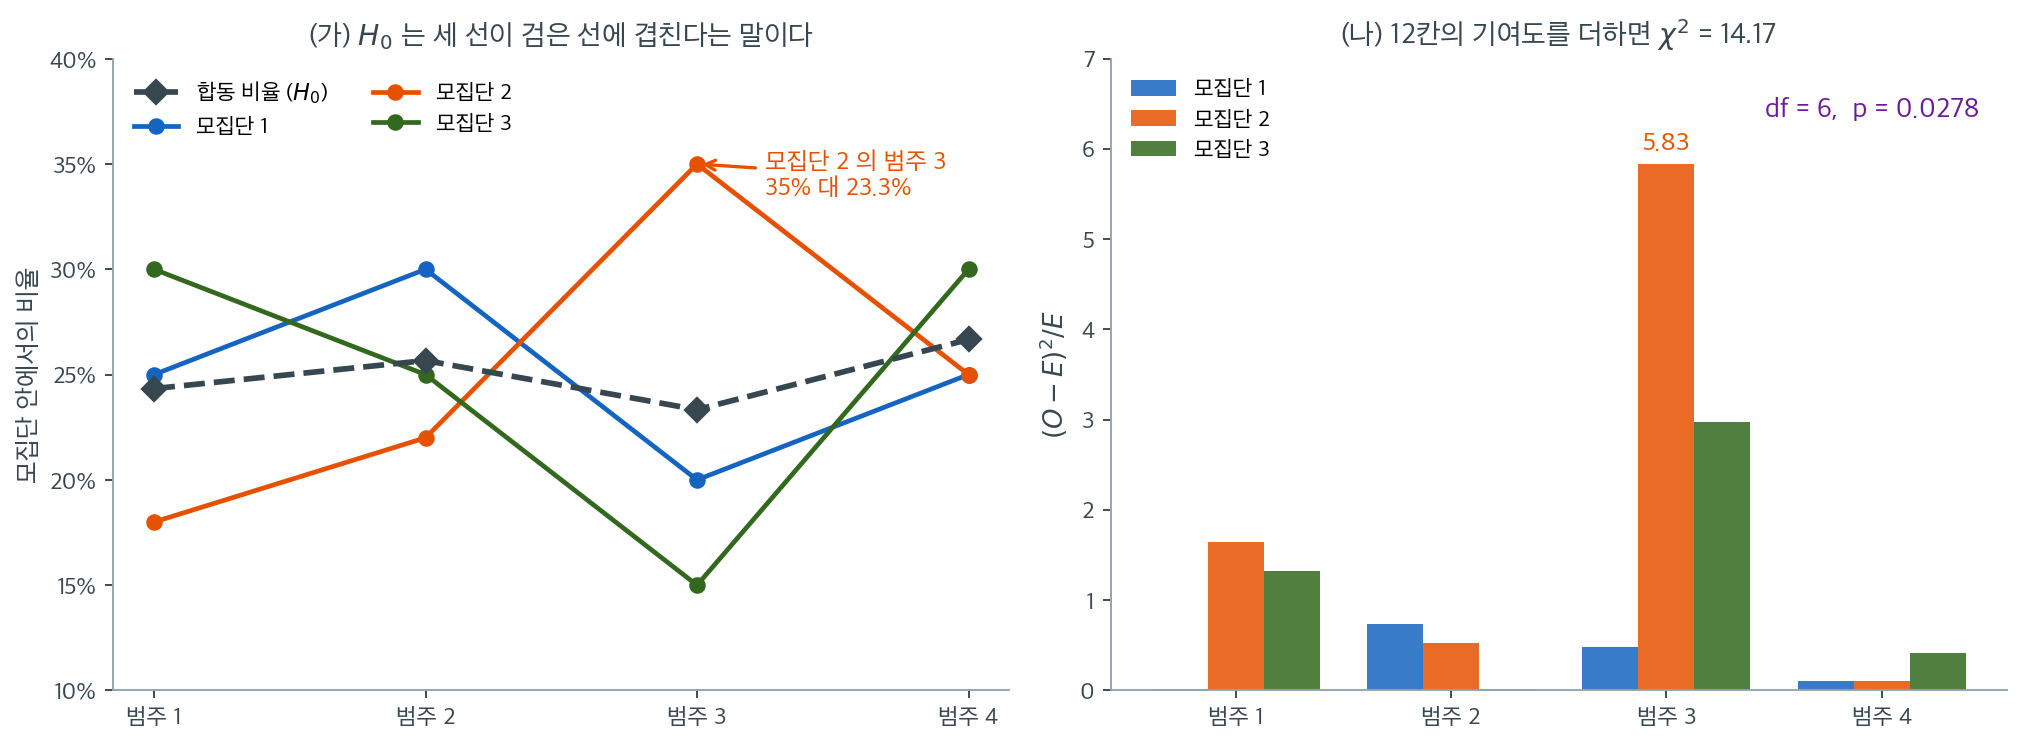
왼쪽 (가)는 세 모집단의 범주별 비율을 선으로 이은 것이다. 검은 파선이 합동 비율, 즉 24.3%, 25.7%, 23.3%, 26.7%이다. 동질성의 귀무가설은 "세 색깔 선이 모두 이 검은 선 위에 놓인다"는 말과 같다. 표를 숫자로 들여다볼 때보다 이렇게 그려 놓으면 \(H_0\)가 무엇을 주장하는지가 훨씬 분명해진다.
실제로는 세 선이 제법 벌어져 있다. 범주 3에서 모집단 2가 35%로 솟아 있고 모집단 3은 15%로 내려앉았다. 검은 선은 그 사이 23.3%에 있다. 범주 4에서는 세 선이 25%, 25%, 30%로 거의 붙어 있다. 어긋남이 표 전체에 고르게 퍼져 있는 것이 아니라 특정 칸에 몰려 있다는 뜻이다.
오른쪽 (나)가 그 몰림을 정량화한다. 12칸의 \((O-E)^2/E\)를 모두 그렸고, 이들을 더한 것이 \(\chi^2 = 14.17\)이다. 가장 큰 막대는 모집단 2의 범주 3으로 5.83이며, 이 한 칸이 통계량의 41%를 차지한다. 그다음이 모집단 3의 범주 3으로 2.98이다. 즉 검정이 기각된 이유는 거의 전부 "범주 3에서 모집단 2와 3이 반대 방향으로 벌어진 것"이다.
자유도는 \((3-1)(4-1) = 6\)이고 \(p = 0.0278\)로 5% 수준에서 기각한다. 하지만 검정이 말해 주는 것은 여기까지다. "적어도 한 모집단이 다르다"를 넘어 "어디가 어떻게 다른가"를 말하려면 이 오른쪽 그림처럼 칸별로 분해해 보아야 하고, 방향까지 읽으려면 부호가 살아 있는 표준화 잔차 \((O-E)/\sqrt{E}\)를 본다. 모집단 2의 범주 3은 \(+2.42\), 모집단 3의 범주 3은 \(-1.73\)이다.
연습문제
연습문제 1. 두 학교가 같은 시험을 치렀다. 성적 분포는 다음과 같다:
\(H_0\)(성적 분포가 같음) 아래의 기대도수와 카이제곱 통계량을 손으로 계산하라.
풀이
행 합계: \(R_1 = 100\), \(R_2 = 100\). 열 합계: \(C_A = 45\), \(C_B = 60\), \(C_C = 65\), \(C_D = 30\). 총합: \(n = 200\).
두 행 합계가 같으므로 각 기대도수는 단순히 \(C_j / 2\)이다:
자유도는 \(\text{df} = (2-1)(4-1) = 3\)이다. \(\square\)
연습문제 2.
\(2 \times 2\)보다 큰 표에서 correction=False가 적절한 선택인 이유는 무엇인가?
풀이
Yates 연속성 보정은 자유도 1인 연속 \(\chi^2\) 분포로 이산인 검정통계량 분포를 근사하는 \(2 \times 2\) 표를 위해 고안되었다. 더 큰 표에서는 검정통계량이 여러 항의 합이고 칸이 많을수록 \(\chi^2\) 근사가 좋아지므로 이산–연속 근사가 이미 상당히 좋다. 더 큰 표에 Yates 보정을 적용하면 검정이 불필요하게 보수적이 되어(p-값이 부풀려져) 좋지 않다. scipy.stats.chi2_contingency는 correction=True를 주더라도 \(2 \times 2\) 표에만 보정을 적용한다. \(\square\)
연습문제 3. 관측도수가 합동 비율과 정확히 일치하는(즉 각 범주 \(j\)에 대해 \(O_{4j} = n_4 \cdot C_j / n\)인) 네 번째 모집단을 추가한다고 하자. 전체 검정통계량은 어떻게 되는가? 설명하라.
풀이
검정통계량은 정확히 그대로이다.
새 행이 합동 비율에 비례하므로 새 열 합계는 \(C_j' = C_j + n_4 C_j/n = C_j(n + n_4)/n\)이고 새 총합은 \(n' = n + n_4\)이다. 따라서 원래 행 \(i\)의 기대도수는
으로 변하지 않는다. 새 행의 기대도수는 \(n_4 C_j'/n' = n_4 C_j/n = O_{4j}\)이므로 기여가 0이다.
다만 자유도는 \((r-1)(c-1)\)에서 \(r(c-1)\)로 커지므로, 같은 통계량에 대해 p-값은 커진다. 완벽하게 "평균적인" 모집단을 하나 더 관측하는 것은 이질성의 증거를 전혀 더하지 않으면서 기준분포만 넓히는 셈이다. \(\square\)
연습문제 4. 어떤 연구자가 5개 지역에서 각각 50명을 뽑아 브랜드 X와 브랜드 Y 중 무엇을 선호하는지 기록했다. 분할표는
이다. chi2_contingency로 \(\alpha = 0.05\)에서 동질성을 검정하고 결론을 서술하라.
풀이
import numpy as np
from scipy import stats

observed = np.array([[30,20],[28,22],[35,15],[25,25],[32,18]], dtype=float)
chi2, p, df, expected = stats.chi2_contingency(observed, correction=False)
print(f"chi2 = {chi2:.4f}, p = {p:.4f}, df = {df}")
출력:
chi2 = 4.8333, p = 0.3048, df = 4
행 합계는 모두 50이다. 열 합계: \(C_1 = 150\), \(C_2 = 100\). 총합: \(n = 250\). 전체 비율: \(\hat{p}_1 = 0.6\), \(\hat{p}_2 = 0.4\). 각 지역의 기대도수는 \((30, 20)\)이다.
\(\text{df} = (5-1)(2-1) = 4\)에서 p-값은 약 \(0.305\)이다. \(p > 0.05\)이므로 \(H_0\)을 기각하지 못한다. 지역에 따라 브랜드 선호가 다르다는 유의한 증거가 없다. \(\square\)
연습문제 5. 모든 모집단의 표본크기가 똑같이 \(n_0\)이고 모든 범주에서 관측 비율도 같다면, 모집단이나 범주의 개수와 무관하게 \(\chi^2 = 0\)임을 증명하라.
풀이
크기가 각각 \(n_0\)인 모집단이 \(r\)개 있다고 하면 \(n = r \cdot n_0\)이다. 모든 모집단의 도수가 같으면 모든 \(i\)에 대해 \(O_{ij} = O_{1j}\)이고 열 합계는 \(C_j = r \cdot O_{1j}\)이다. 행 합계는 모든 \(i\)에서 \(R_i = n_0\)이다. 기대도수는
이다. 모든 행이 같으므로 모든 칸에서 \(O_{ij} = O_{1j} = E_{ij}\)이다. 따라서
이다. 직관적으로도 자연스럽다. 모든 모집단이 정확히 같은 분포를 보인다면 동질성에 반하는 증거가 전혀 없다. \(\square\)
연습문제 6. 보기 1의 결과를 손으로 재현하고, 기대도수 공식이 왜 그런 모양인지 확인하라.
풀이
import numpy as np
from scipy import stats

obs = np.array([[25, 30, 20, 25],
                [18, 22, 35, 25],
                [30, 25, 15, 30]], dtype=float)

n = obs.sum()
row_tot, col_tot = obs.sum(1), obs.sum(0)
print(f"행 합 {row_tot.tolist()},  열 합 {col_tot.tolist()},  n = {n:.0f}")

exp = np.outer(row_tot, col_tot) / n          # E_ij = R_i C_j / n
print(f"\n기대도수\n{np.round(exp, 4)}")

chi2 = ((obs - exp)**2 / exp).sum()
df = (obs.shape[0] - 1) * (obs.shape[1] - 1)
print(f"\n손계산  χ² = {chi2:.4f},  df = {df},  "
      f"p = {stats.chi2.sf(chi2, df):.6f}")
c, p, d, e = stats.chi2_contingency(obs, correction=False)
print(f"scipy   χ² = {c:.4f},  df = {d},  p = {p:.6f}")
print(f"일치? {np.isclose(chi2, c)} / {np.isclose(exp, e).all()}")
행 합 [100.0, 100.0, 100.0],  열 합 [73.0, 77.0, 70.0, 80.0],  n = 300

기대도수
[[24.3333 25.6667 23.3333 26.6667]
 [24.3333 25.6667 23.3333 26.6667]
 [24.3333 25.6667 23.3333 26.6667]]

손계산  χ² = 14.1697,  df = 6,  p = 0.027796
scipy   χ² = 14.1697,  df = 6,  p = 0.027796
일치? True / True
기대도수 공식의 의미.
"\(i\)번 모집단의 표본크기 \(\times\) 전체에서 본 범주 \(j\)의 비율"이다. \(H_0\)이 "모든 모집단의 분포가 같다"이므로, 그 공통 분포를 전체 자료에서 추정해 각 행에 적용하는 것이다.
여기서 \(C_j/n\)이 곧 합동 비율이다.
| 범주 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| 합동 비율 \(C_j/n\) | 0.2433 | 0.2567 | 0.2333 | 0.2667 |
세 행의 기대도수가 같은 것은 우연이 아니다. \(R_1=R_2=R_3=100\)으로 설계했기 때문이다. 표본크기가 다르면 행마다 다른 기대도수가 나온다.
unequal = np.array([[25, 30, 20, 25],      # n=100
                    [36, 44, 70, 50],      # n=200
                    [15, 12,  8, 15]],     # n=50
                   dtype=float)
_, _, _, e2 = stats.chi2_contingency(unequal, correction=False)
print("표본크기가 다를 때의 기대도수")
print(np.round(e2, 3))
print(f"행 합 {unequal.sum(1).tolist()}")
print(f"각 행의 기대도수 합 {np.round(e2.sum(1), 3).tolist()}  ← 행 합과 일치")
표본크기가 다를 때의 기대도수
[[21.714 24.571 28.    25.714]
 [43.429 49.143 56.    51.429]
 [10.857 12.286 14.    12.857]]
행 합 [100.0, 200.0, 50.0]
각 행의 기대도수 합 [100.0, 200.0, 50.0]  ← 행 합과 일치
기대도수의 행 합이 언제나 관측 행 합과 같다. 열에 대해서도 마찬가지다. 이것이 자유도가 \((r-1)(c-1)\)인 이유이고, 동시에 가장 쉬운 검산이다.
손계산할 때의 순서.
- 행 합, 열 합, 총합을 구한다.
- \(E_{ij}=R_iC_j/n\)를 채운다.
- 행 합과 열 합을 검산한다.
- \(E_{\min}\)을 확인한다.
- 칸마다 \((O-E)^2/E\)를 더한다.
- \(\text{df}=(r-1)(c-1)\)로 오른쪽 꼬리를 읽는다.
연습문제 7. 동질성 검정과 독립성 검정은 계산이 같은데 표집 설계가 다르다. 그래도 두 상황에서 검정이 똑같이 작동하는지 모의실험으로 확인하라.
풀이
두 표집 설계.
| 동질성 | 독립성 | |
|---|---|---|
| 고정하는 것 | 행 합 \(R_i\) | 총합 \(n\)만 |
| 확률모형 | 행마다 독립인 다항분포 | 하나의 다항분포 |
import numpy as np
from scipy import stats

rng = np.random.default_rng(5791)
M, n = 20_000, 300
p_col = np.array([0.25, 0.26, 0.23, 0.26])
P = np.outer([1 / 3, 1 / 3, 1 / 3], p_col)     # 독립이 참

a = b = 0
for _ in range(M):
    # ① 독립성 표집: 전체 n 을 한 번에 다항으로
    t1 = rng.multinomial(n, P.ravel()).reshape(3, 4).astype(float)
    if (t1.sum(0) > 0).all() and (t1.sum(1) > 0).all():
        a += stats.chi2_contingency(t1, correction=False)[1] < 0.05

    # ② 동질성 표집: 행마다 100 씩 따로
    t2 = np.array([rng.multinomial(100, p_col) for _ in range(3)], float)
    if (t2.sum(0) > 0).all():
        b += stats.chi2_contingency(t2, correction=False)[1] < 0.05

print(f"독립성 표집(총 n 만 고정):  기각률 {a / M:.4f}")
print(f"동질성 표집(행 합 고정):    기각률 {b / M:.4f}")
독립성 표집(총 n 만 고정):  기각률 0.0521
동질성 표집(행 합 고정):    기각률 0.0508
두 설계에서 수준이 같다(0.052와 0.051). 같은 통계량, 같은 자유도, 같은 극한분포다.
왜 그런가. 다항분포를 행 합으로 조건화하면 행별 독립 다항분포가 된다. 즉 ②는 ①을 조건화한 것이고, 카이제곱 통계량의 극한분포는 그 조건화에 영향을 받지 않는다.
그래도 구분해야 하는 이유 셋.
1 — 귀무가설의 서술이 다르다.
| 설계 | \(H_0\) |
|---|---|
| 동질성 | \(P(\text{범주}=j\mid\text{집단}=i)\)가 모든 \(i\)에 대해 같다 |
| 독립성 | \(P(\text{행}=i,\ \text{열}=j)=P(\text{행}=i)P(\text{열}=j)\) |
2 — 추정할 수 있는 것이 다르다. 동질성 설계에서는 행 합을 연구자가 정했으므로 행의 주변분포를 추정할 수 없다. "전체 인구에서 집단 1의 비율"을 이 자료로 말할 수 없다.
print("동질성 설계에서 추정 가능한 것과 불가능한 것")
obs = np.array([[25, 30, 20, 25], [18, 22, 35, 25], [30, 25, 15, 30]], float)
print(f"  집단별 범주 비율(가능):\n{np.round(obs / obs.sum(1, keepdims=True), 4)}")
print(f"  전체 집단 비율(불가능): {np.round(obs.sum(1) / obs.sum(), 4).tolist()}")
print("    ← 이 값은 연구자가 1:1:1 로 정한 것이지 모집단의 성질이 아니다")
동질성 설계에서 추정 가능한 것과 불가능한 것
  집단별 범주 비율(가능):
[[0.25 0.3  0.2  0.25]
 [0.18 0.22 0.35 0.25]
 [0.3  0.25 0.15 0.3 ]]
  전체 집단 비율(불가능): [0.3333, 0.3333, 0.3333]
    ← 이 값은 연구자가 1:1:1 로 정한 것이지 모집단의 성질이 아니다
3 — 인과적 해석의 여지가 다르다. 동질성 설계에서 집단이 무작위 배정이면 인과를 말할 수 있다. 독립성 설계는 관측자료이므로 연관까지만 말한다.
결론. 계산은 같아도 결론의 서술은 설계를 따라야 한다. 소프트웨어가 구분해 주지 않으므로 사람이 기억해야 한다.
연습문제 8. 동질성을 기각한 뒤 어느 집단의 어느 비율이 얼마나 다른지를 신뢰구간으로 보이려면 어떻게 하는가?
풀이
문제. 비율이 \(r\times c\)개이므로 구간을 여럿 만들면 동시 포함률이 떨어진다.
import numpy as np
from scipy import stats

obs = np.array([[25, 30, 20, 25],
                [18, 22, 35, 25],
                [30, 25, 15, 30]], dtype=float)
k = obs.shape[0]

z_single = stats.norm.ppf(0.975)
z_bonf = stats.norm.ppf(1 - 0.025 / k)                 # 본페로니
z_sidak = stats.norm.ppf((1 + 0.95**(1 / k)) / 2)      # 시닥
print(f"임계값:  단일 {z_single:.4f}   본페로니 {z_bonf:.4f}   "
      f"시닥 {z_sidak:.4f}\n")

print("범주 3 의 집단별 비율")
for i in range(k):
    n_i = obs[i].sum()
    p_hat = obs[i, 2] / n_i
    se = np.sqrt(p_hat * (1 - p_hat) / n_i)
    print(f"  모집단{i + 1}: p̂ = {p_hat:.4f}   "
          f"단일 ({p_hat - z_single * se:.4f}, {p_hat + z_single * se:.4f})   "
          f"본페로니 ({p_hat - z_bonf * se:.4f}, {p_hat + z_bonf * se:.4f})")
임계값:  단일 1.9600   본페로니 2.3940   시닥 2.3877

범주 3 의 집단별 비율
  모집단1: p̂ = 0.2000   단일 (0.1216, 0.2784)   본페로니 (0.1042, 0.2958)
  모집단2: p̂ = 0.3500   단일 (0.2565, 0.4435)   본페로니 (0.2358, 0.4642)
  모집단3: p̂ = 0.1500   단일 (0.0800, 0.2200)   본페로니 (0.0645, 0.2355)
모집단 2의 구간이 모집단 3과 겹치지 않는다. 본페로니 기준으로도 \((0.2358,\ 0.4642)\)와 \((0.0645,\ 0.2355)\)가 떨어져 있다. 범주 3에서 모집단 2가 두드러진다는 앞선 잔차 분석과 일치한다.
본페로니와 시닥이 거의 같다(2.3940 대 2.3877). \(k\)가 작으면 두 방법의 차이가 미미하다. 시닥이 약간 덜 보수적이지만 비교들이 독립이라는 가정이 필요하다.
더 나은 방법 셋.
1 — 차이의 구간을 본다. 개별 구간의 겹침이 아니라 차이의 구간이 0을 포함하는지 본다.
from itertools import combinations
for i, j in combinations(range(k), 2):
    n_i, n_j = obs[i].sum(), obs[j].sum()
    p_i, p_j = obs[i, 2] / n_i, obs[j, 2] / n_j
    se = np.sqrt(p_i * (1 - p_i) / n_i + p_j * (1 - p_j) / n_j)
    lo, hi = (p_i - p_j) - z_bonf * se, (p_i - p_j) + z_bonf * se
    mark = "*" if not (lo <= 0 <= hi) else " "
    print(f"  모집단{i + 1} - 모집단{j + 1}: 차이 {p_i - p_j:+.4f}   "
          f"본페로니 95% CI ({lo:+.4f}, {hi:+.4f}){mark}")
  모집단1 - 모집단2: 차이 -0.1500   본페로니 95% CI (-0.2990, -0.0010)*
  모집단1 - 모집단3: 차이 +0.0500   본페로니 95% CI (-0.0784, +0.1784)
  모집단2 - 모집단3: 차이 +0.2000   본페로니 95% CI (+0.0574, +0.3426)*
차이의 구간이 훨씬 유익하다. "모집단 2가 모집단 3보다 6~34%p 높다"고 구체적으로 말할 수 있다. 모집단 1과 2의 차이는 상한이 \(-0.001\)로 0에 아슬아슬하게 못 미친다 — 이런 경계 사례일수록 구간이 \(p\) 값보다 정직하다.
2 — 윌슨 기반 구간을 쓴다. 앞 장에서 본 대로 Wald 구간은 포함률이 낮다. 비율이 0이나 1에 가까우면 특히 그렇다.
3 — 모든 칸을 보려면 \(rc\)로 보정한다. 위에서는 범주 3만 보았지만, 어느 범주를 볼지 자료를 보고 정했다면 12개 칸 전체에 대한 보정이 필요하다.
가장 흔한 실수. 어느 칸이 튀는지 본 뒤 그 칸만 검정하고 보정하지 않는 것이다. 눈으로 고른 것도 선택이다.
연습문제 9. 연습문제 3·5가 다룬 "\(\chi^2=0\)이 되는 경우"를 일반화하라. \(\chi^2\)이 취할 수 있는 최댓값은 얼마인가?
풀이
최솟값은 0이다. 모든 행의 비율이 합동 비율과 정확히 같을 때다(연습문제 5).
최댓값은 \(n\cdot(q-1)\)이다. 여기서 \(q=\min(r,c)\)다.
import numpy as np
from scipy import stats

def max_table(r, c, n):
    """완전 연관인 표: 작은 쪽의 각 수준이 큰 쪽의 서로 다른 묶음에 대응."""
    obs = np.zeros((r, c))
    if r <= c:
        for i, g in enumerate(np.array_split(np.arange(c), r)):
            obs[i, g] = n / (r * len(g))
    else:
        for j, g in enumerate(np.array_split(np.arange(r), c)):
            obs[g, j] = n / (c * len(g))
    return obs

def max_check(r, c, n):
    q = min(r, c)
    chi2, _, _, _ = stats.chi2_contingency(max_table(r, c, n),
                                           correction=False)
    return chi2, n * (q - 1), np.sqrt(chi2 / (n * (q - 1)))

print(f"{'표':>7s} {'n':>5s} {'관측 χ²':>10s} {'n(q-1)':>9s} {'V':>7s}")
for r, c, n in [(2, 2, 100), (3, 3, 300), (4, 4, 400),
                (2, 4, 200), (4, 2, 200), (3, 5, 300)]:
    got, bound, v = max_check(r, c, n)
    print(f"{f'{r}×{c}':>7s} {n:5d} {got:10.4f} {bound:9.0f} {v:7.4f}")
      표     n      관측 χ²    n(q-1)       V
    2×2   100   100.0000       100  1.0000
    3×3   300   600.0000       600  1.0000
    4×4   400  1200.0000      1200  1.0000
    2×4   200   200.0000       200  1.0000
    4×2   200   200.0000       200  1.0000
    3×5   300   600.0000       600  1.0000
여섯 경우 모두 상한에 정확히 도달한다. 그리고 그때 \(V=1\)이다.
이것이 크라메르 \(V\)의 정의가 그런 모양인 이유다. \(\chi^2\)을 그 최댓값으로 나눠 \([0,1]\)로 정규화한 것이다.
\(q=\min(r,c)\)인 이유. "완전 연관"이란 한 변수를 알면 다른 변수가 결정된다는 뜻인데, \(3\times5\) 표에서는 행이 3개뿐이라 열을 3개 묶음까지만 구분할 수 있다. 그래서 작은 쪽이 한계를 정한다.
\(2\times4\)와 \(4\times2\)가 같은 값(\(q-1=1\))인 것도 같은 이유다.
세 가지 한계 상황 정리.
| 상황 | \(\chi^2\) | \(V\) |
|---|---|---|
| 모든 행의 비율이 같음 | 0 | 0 |
| 완전 연관 | \(n(q-1)\) | 1 |
| 독립이 참, 표본 유한 | 평균 \((r-1)(c-1)\) | 평균 \(\sqrt{\frac{(r-1)(c-1)}{n(q-1)}}\) |
셋째 줄이 실무에서 중요하다. 앞 절에서 본 \(V\)의 소표본 편향이 바로 이 값이다.
\(\chi^2\)을 눈으로 판단하는 감각.
- \(\chi^2\approx\text{df}\) → 예상대로
- \(\chi^2\approx 2\sim3\times\text{df}\) → 이탈의 신호
- \(\chi^2\approx n(q-1)\) → 거의 완전 연관(자료를 의심할 만하다)
마지막 경우가 실제로 나오면 대개 자료 오류다. 같은 정보를 두 번 코딩했거나, 한 변수가 다른 변수의 함수인 경우다.
연습문제 10. 동질성 검정의 코드 작성 지침을 정리하라.
풀이
권장 함수.
import numpy as np
from scipy import stats

def homogeneity_test(obs, labels=None, alpha=0.05):
    """동질성 검정과 함께 진단 정보를 한 번에 돌려준다."""
    obs = np.asarray(obs, float)
    r, c = obs.shape
    n = obs.sum()
    chi2, p, df, exp = stats.chi2_contingency(obs, correction=False)
    v = np.sqrt(chi2 / (n * (min(r, c) - 1)))
    rp, cp = obs.sum(1) / n, obs.sum(0) / n
    adj = (obs - exp) / np.sqrt(exp * np.outer(1 - rp, 1 - cp))

    print(f"χ² = {chi2:.4f},  df = {df},  p = {p:.6f}")
    print(f"크라메르 V = {v:.4f}   (독립일 때 기댓값 ≈ "
          f"{np.sqrt(df / (n * (min(r, c) - 1))):.4f})")
    print(f"E_min = {exp.min():.3f}"
          + ("   ⚠ 5 미만" if exp.min() < 5 else ""))
    print(f"행 비율\n{np.round(obs / obs.sum(1, keepdims=True), 4)}")
    if p < alpha:
        print(f"조정 잔차 (|·| 최대 {np.abs(adj).max():.3f})\n{np.round(adj, 3)}")
    return {"chi2": chi2, "df": df, "p": p, "V": v, "adj": adj}

_ = homogeneity_test([[25, 30, 20, 25],
                      [18, 22, 35, 25],
                      [30, 25, 15, 30]])
χ² = 14.1697,  df = 6,  p = 0.027796
크라메르 V = 0.1537   (독립일 때 기댓값 ≈ 0.1000)
E_min = 23.333
행 비율
[[0.25 0.3  0.2  0.25]
 [0.18 0.22 0.35 0.25]
 [0.3  0.25 0.15 0.3 ]]
조정 잔차 (|·| 최대 3.378)
[[ 0.19   1.215 -0.965 -0.462]
 [-1.808 -1.028  3.378 -0.462]
 [ 1.617 -0.187 -2.413  0.923]]
이 한 번의 호출로 필요한 것이 다 나온다.
| 출력 | 답하는 질문 |
|---|---|
| \(\chi^2\), df, \(p\) | 이탈이 있는가 |
| 크라메르 \(V\) | 얼마나 큰가 |
| 독립일 때의 \(V\) 기댓값 | \(V\)가 정말 큰 것인가 |
| \(E_{\min}\) | 근사를 믿어도 되는가 |
| 행 비율 | 실질적으로 어떤 차이인가 |
| 조정 잔차 | 어디가 다른가 |
\(V=0.154\)가 독립일 때의 기댓값 0.100보다 1.5배다. 관례적 기준("작음")보다 이 비교가 훨씬 유익하다.
코드 작성 지침 여섯.
correction=False를 명시한다.scipy의 기본값이True라 \(2\times2\)에서 자동으로 야츠 보정이 붙는다.- 기대도수를 반드시 확인한다.
chi2_contingency의 네 번째 반환값이 그것이다. - 행 비율을 함께 출력한다. 도수만으로는 차이가 눈에 안 들어온다.
- 조정 잔차를 쓴다. 단순 표준화 잔차는 판정에 쓰면 안 된다.
- 효과크기를 자동으로 계산한다. 빼먹기 가장 쉬운 항목이다.
- \(p\)가 유의할 때만 잔차를 출력한다. 보호된 절차를 코드로 강제하는 셈이다.
점검 목록.
- [ ] 입력이 도수인가(비율·백분율이 아니라)
- [ ] 배열이 2차원인가
- [ ]
correction=False를 명시했는가 - [ ] \(E_{\min}\)을 확인했는가
- [ ] 효과크기를 보고했는가
- [ ] 사후분석에 보정을 적용했는가
- [ ] 표집 설계를 결론 서술에 반영했는가
한 문장. chi2_contingency 한 줄은 쉽지만, 그 앞뒤의 진단과 해석이 분석의 대부분이다. 함수로 감싸 두면 매번 빠뜨리지 않는다.
정리하며
동질성 검정의 구현은 독립성 검정과 같은 함수를 쓴다.
chi2_contingency하나로 둘 다 처리된다. 계산이 동일하므로 코드가 구별하지 않으며, 구별은 사람이 설계를 알고 해석에 반영해야 한다.- 행이 모집단, 열이 범주가 되도록 표를 만든다. 이 배치가 "각 모집단의 분포가 같은가"라는 물음과 맞아떨어진다.
- 각 집단의 크기는 연구자가 정한 값이다. 그래서 행 합은 확률변수가 아니며, 그 점이 독립성 검정과의 설계적 차이다.
- 결론을 집단 비교의 언어로 쓴다. "두 변수가 연관된다"가 아니라 "집단들의 분포가 다르다"이다.
- 기각한 뒤가 더 중요하다. 어느 집단의 어느 범주가 달랐는지는 다음 절의 잔차 분석이 답한다.
다음 절 동질성 잔차 열지도로 넘어간다.