부트스트랩 재표집 방법
개요
들어가는 이야기 — 공식을 유도하는 대신 자료를 다시 뽑는다
소득 자료 \(5{,}000\) 개를 줄 세워 가운데를 집으니 \(54{,}971\) 이다. 이 수가 얼마나 흔들리는지 알려면 표준오차가 필요한데 중앙값에는 쓸 공식이 없다. 그래서 공식을 유도하는 대신 자료를 다시 뽑아 산포를 잰다. 가진 \(5{,}000\) 개에서 같은 수만큼 복원추출해 중앙값을 다시 구하기를 천 번 반복하면 중앙값 천 개가 쌓이고, 그것들의 표준편차 \(756\) 이 답이다.
이 자료에는 맞춰 볼 이론값이 있어서 그 답이 옳은지 확인할 수 있다. 모집단이 지수꼴이면 중앙값의 점근 표준오차가 평균의 것과 식 자체로 같아져 둘 다 \(707.107\) 이 된다. 부트스트랩(bootstrap)이 낸 \(756\) 이 그 둘레다. 같은 계산에서 편향(bias)도 함께 나오는데 \(+37\) 로 표준오차의 \(5\%\) 에 그치니, 중앙값 추정량은 사실상 치우쳐 있지 않다.
늘 그렇게 가까운 것은 아니다. 표본을 바꾸어 가며 반복하면 중앙값의 부트스트랩 표준오차가 평균 \(684.9\), 표준편차 \(60.4\) 로 흔들리고 평균의 것은 \(703.0\), 표준편차 \(18.9\) 로 흔들린다. 둘 다 같은 \(707.107\) 을 겨누는데 중앙값 쪽의 변동이 세 배 넘게 크다. 평균 쪽의 변동은 거의 전부 반복 횟수에서 오므로 횟수를 키우면 줄지만, 중앙값 쪽은 키워도 남는다.
그러면 공식 없이 산포를 재는 이 방법은 무엇을 돌려주고 어디서 멈추는가. 이 쪽이 알고리즘을 네 단계로 적고, 거기서 읽어 내는 표준오차와 편향과 분포 모양을 갈라 세우고, 반복 횟수를 무엇이 정하는지 적은 뒤, 함정 넷과 시계열에 쓰는 변형까지 짚는다.
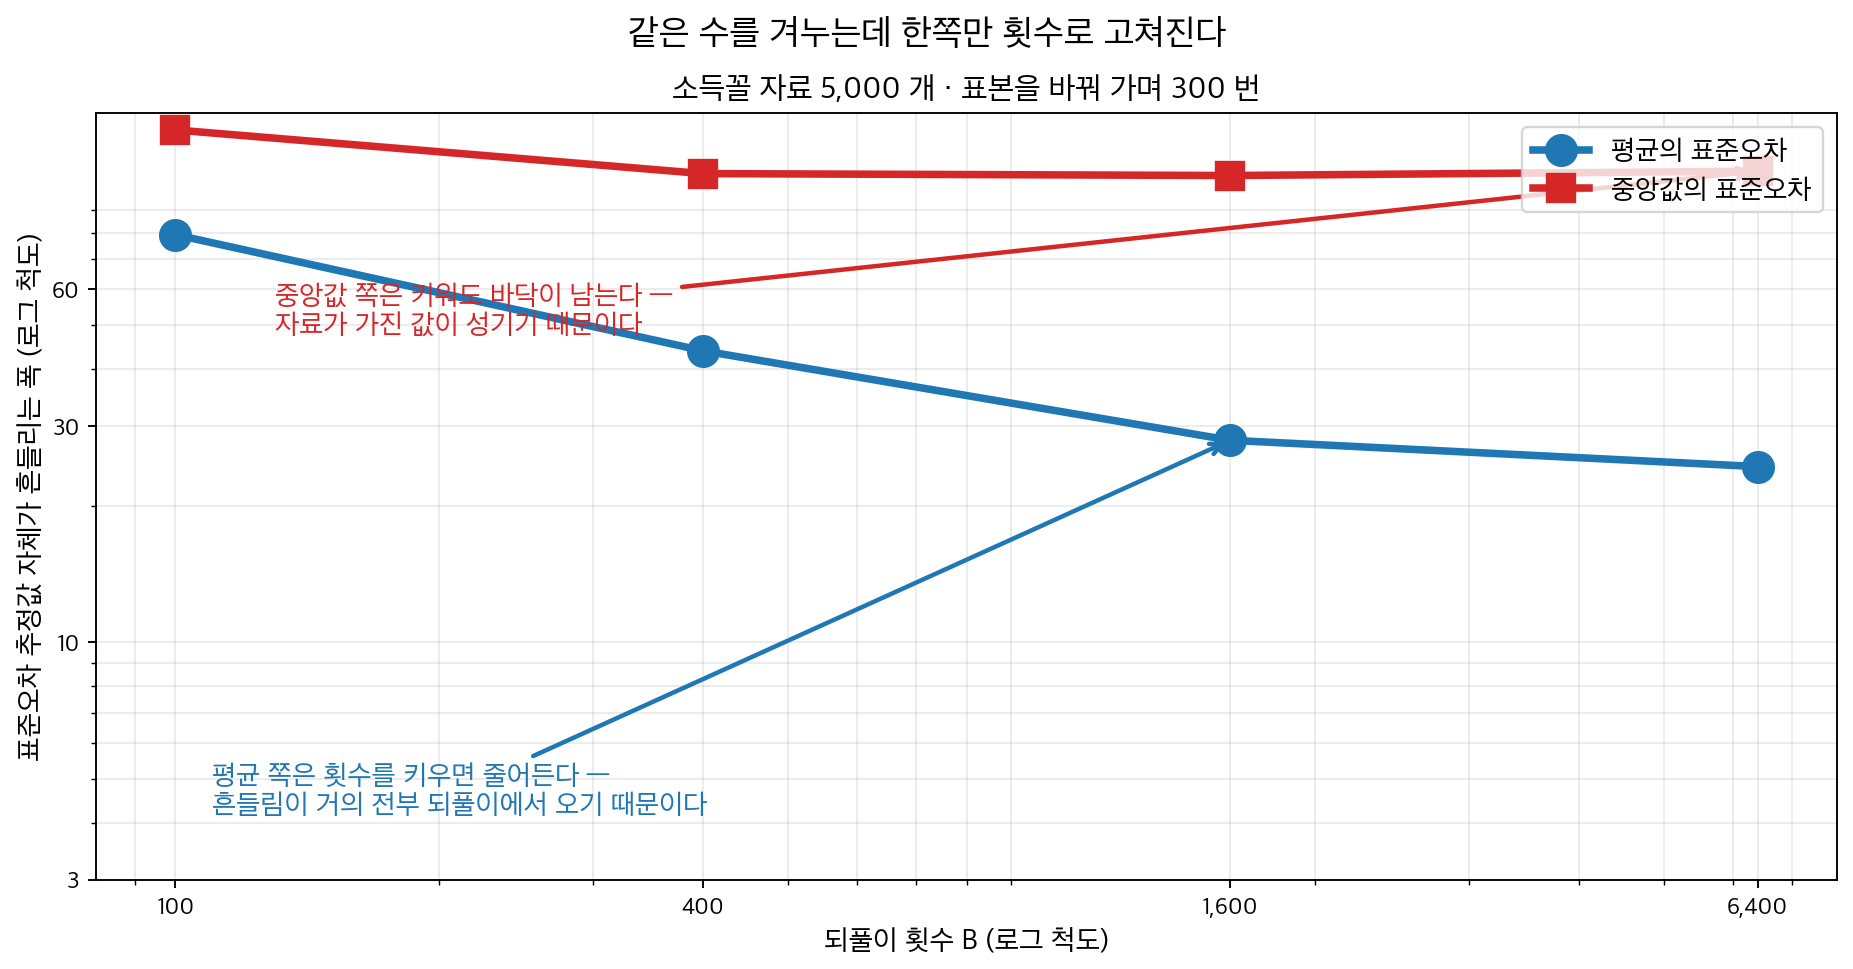
같은 자료에서 표준오차를 재는 일을 반복해, 그 추정값이 돌릴 때마다 얼마나 달라지는지를 재었다. 이론값은 둘 다 \(1{,}121.6\) 이다. 평균에서는 횟수를 키울수록 변동이 \(79.3 \to 24.4\) 로 계속 줄어든다. 중앙값에서는 \(134.9 \to 107.0\) 까지 줄고 거기서 멈춘다. 남는 것은 반복이 모자라서 생긴 변동이 아니라 표본 자체가 가진 것이라, \(B\) 를 아무리 키워도 사라지지 않는다.
부트스트랩은 모수적 가정 없이 통계량의 표집분포(sampling distribution)를 추정하는 강력한 분포무관 방법이다. 하나의 표본에서 복원추출을 반복함으로써 표집분포를 근사하고 표준오차, 신뢰구간을 비롯한 추론량을 계산할 수 있다.
1. 핵심 발상
부트스트랩은 단순한 원리에 기댄다. 표본의 경험적 분포가 참 모집단 분포의 합리적인 추정값이라는 것이다. 관측된 표본에서 복원추출을 반복하면, 계산된 통계량의 변동이 참 표집변동을 근사한다.
핵심 통찰: 부트스트랩은 강한 분포 가정을 피하는 대가로 계산량을 지불한다.
2. 부트스트랩 알고리즘
\(n\)개 관측값의 표본이 주어졌을 때 절차는 다음 네 단계다.
- 재표집: 표본에서 \(n\)개를 복원추출하여 부트스트랩 표본을 만든다.
- 계산: 부트스트랩 표본에서 관심 통계량을 계산한다.
- 반복: 1--2단계를 여러 번 반복한다(보통 \(500\)--\(10{,}000\)회).
- 분석: 계산된 통계량들의 모임이 부트스트랩 분포를 이룬다.
원표본: X₁, X₂, ..., Xₙ
    ↓
    ├→ 부트스트랩 표본 1* → 통계량 θ₁*
    ├→ 부트스트랩 표본 2* → 통계량 θ₂*
    ├→ 부트스트랩 표본 3* → 통계량 θ₃*
    └→ 부트스트랩 표본 B* → 통계량 θ_B*
    ↓
부트스트랩 분포: {θ₁*, θ₂*, ..., θ_B*}
그림으로 보는 통계학 1. 논에서 동전을 던지게 하고, 그 기록을 검정했다
위의 알고리즘은 한 줄로 줄어든다 — 공식 대신 자료를 다시 뽑아 산포를 잰다. 컴퓨터가 그 반복을 떠맡기 마흔 해 전에, 같은 생각으로 주 하나의 작황을 잰 사람이 있다.
마할라노비스는 \(1937\) 년부터 다섯 해에 걸쳐 벵골의 황마 작황을 표본으로 재는 일을 맡았다. 당시 황마는 인도 전체 수출액의 \(1/4\) 을 차지했고 그 \(85\%\) 를 벵골이 냈으며, 인도에서 난 황마의 \(90\%\) 가까이가 수출되었다. \(1941\) 년 이 조사에 들어간 인원이 \(500\) 명을 넘는다. \(1943\) 년 \(9\) 월 말에는 비하르 주 정부가 쌀 수확을 「되도록 빨리」 같은 방식으로 조사해 달라고 청했다. 전시였고 봄 수확기는 이미 깊어서 새 방법을 짤 틈이 없었으므로, 벵골에서 다듬어 둔 설계를 그대로 가져갔다.
그 설계의 핵심은 이것이다. 한 구역(약 \(50\) 제곱마일)에 뿌릴 조사단위를 똑같은 두 그룹으로 가르고, 각 그룹을 서로 독립으로 뿌렸다. 두 그룹은 구역 안에서 완전히 무작위로 엇갈려 섞인다. 비하르에서 쓴 단위는 \(4\) 에이커, 밀도는 제곱마일당 둘이었다.
왜 한 번에 뿌리지 않고 둘로 갈랐는가. 그가 적은 문장이 답이다. 「이렇게 엇갈리는 두 조사단위 망을 쓰면 각 지역마다 (작물 면적이나 수확량의) 독립인 추정값 둘을 얻을 수 있다. 이 두 독립 추정값의 차이가 유효 오차의 폭에 대한 좋은 짐작을 곧바로 주며, 따라서 그 조사가 어느 정도까지 통계적 관리 아래 수행되었는지를 알려 준다.」 반쪽 표본 사이의 변동을 모집단 안의 변동에 대한 직접적인 정보로 읽은 것이다.
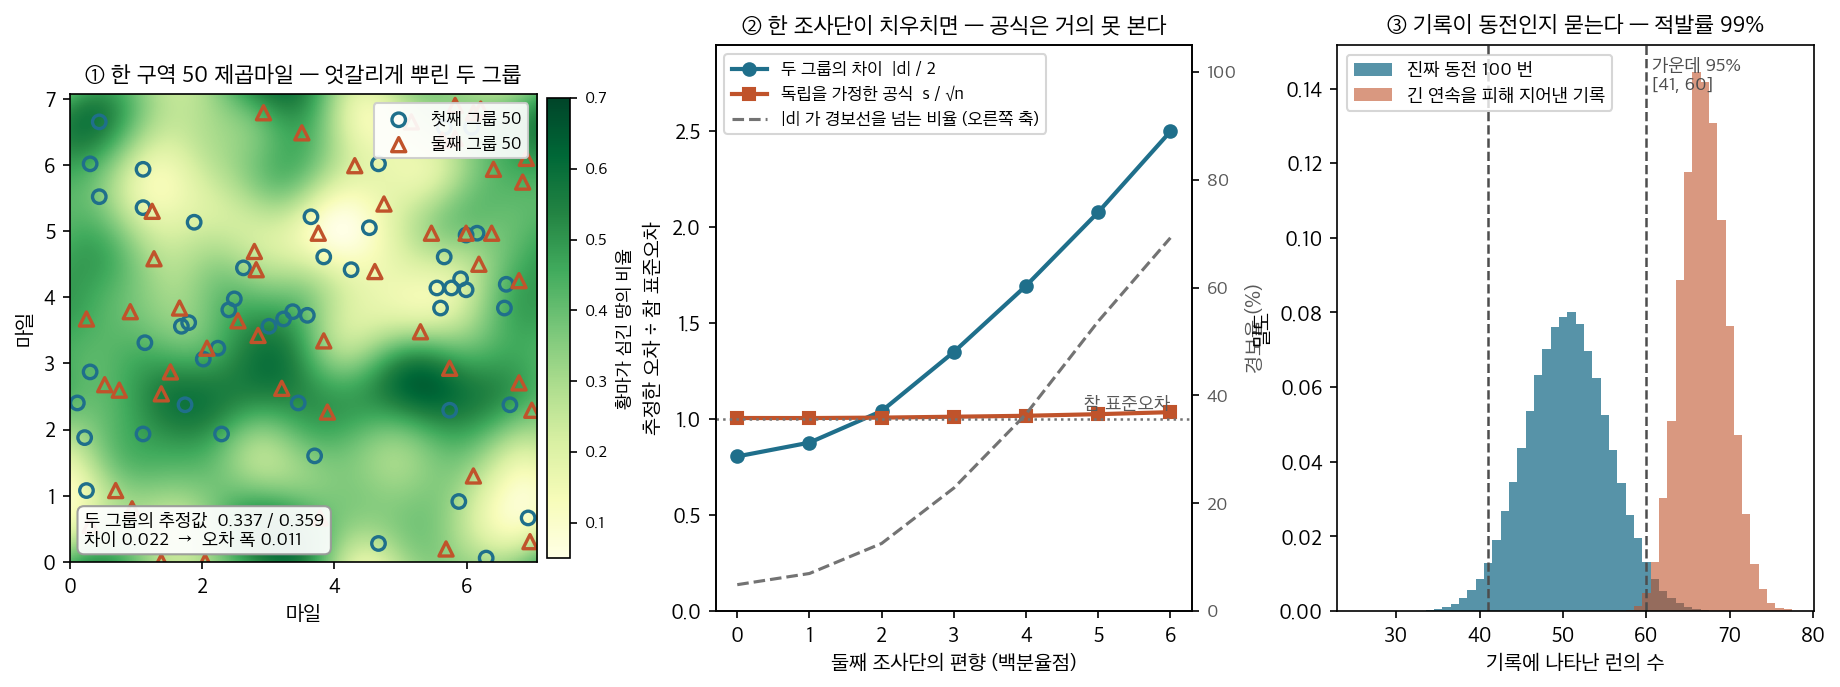
- ① 구역 하나다. \(50\) 제곱마일에 \(4\) 에이커 단위를 제곱마일당 둘 — 백 개를 쉰씩 두 그룹으로 뿌렸다. 두 그룹이 각각 내놓은 추정값은 \(0.337\) 과 \(0.359\) 다. 차이 \(0.022\) 의 절반인 \(0.011\) 이 그가 말한 오차의 폭인데, 이 구역의 참 표준오차는 \(0.0121\) 이다. 체계적으로는 조금 작다 — 차이의 절댓값은 평균이 표준편차의 \(\sqrt{2/\pi} = 0.798\) 배이기 때문이고, 모의에서 받은 비도 \(0.0097/0.0121 = 0.81\) 이다. 그래서 그는 「좋은 짐작」이라고만 했다.
- ② 여기가 두 그룹으로 가른 값어치다. 둘째 조사단이 밭을 일관되게 더 후하게 적는다고 하자. 독립을 가정한 공식 \(s/\sqrt n\) 은 편향이 \(6\) 퍼센트포인트에 이르러도 \(1.04\) 배로밖에 커지지 않는다 — 공식은 자기가 받은 수들 안에서만 산포를 세므로 두 조사단의 불일치를 거의 보지 못한다. 두 그룹의 차이는 같은 자리에서 \(2.50\) 배가 된다. 편향이 없을 때의 \(\lvert d \rvert\) 가 \(95\%\) 안에 드는 선을 경보선으로 잡으면, 경보가 울리는 비율이 \(5\% \to 69\%\) 로 오른다.
- ③ 그 조사단은 논과 보리밭에서 실제로 동전을 던져 표본 자리를 정했고, 던진 결과를 차례로 적어 내야 했다. 마할라노비스는 그 기록을 검정했다. 동전 \(100\) 번이면 런의 수가 평균 \(50.5\), 가운데 \(95\%\) 가 \([41, 60]\) 이다. 던지기 싫어 「그럴듯하게」 적은 사람은 같은 글자가 길게 이어지는 것을 피하므로 런이 많아진다 — 평균 \(66.9\) 로, \(99\%\) 가 걸린다.
③ 의 검정이 왜 필요했는지는 그의 문장에 그대로 있다. 「조사원은 ⋯ 앞뒤가 나온 차례를 기록으로 남겨야 한다. ⋯ 때때로 그러하듯 그 계열이 유의하게 무작위가 아니라면, 현장 작업이 제대로 되지 않았다고 보는 것이 합리적이다.」 두 그룹을 맡은 조사단은 서로 다른 시간에 일하게 해서 「서로 만나는 일이 없도록」 했다. 관측의 잘못이 두 그룹에 함께 섞여 들면 ② 의 차이가 그것을 못 보기 때문이다. 검정 자체는 \(16.2\) 절 런 검정에 있다.
이름에도 사연이 있다. 그는 「반쪽 표본」 대신 「이중 표본」이라 부를까 생각했다가 그만두었는데, 그렇게 부르면 「행정가들의 마음에 비용에 대한 오해를 불러일으킬」 것 같아서였다.
여기서 쪼갠 횟수는 둘이다. 부트스트랩이 바꾼 것은 그 횟수를 \(B\) 로 늘린 것, 그리고 쪼개는 일을 사람이 아니라 기계에 맡긴 것이다. 생각 자체는 논밭에서 먼저 쓰였다.
확인한 곳 — P. Hall, "A Short Prehistory of the Bootstrap", 『Statistical Science』 \(18\) 권 \(2\) 호 \(158\)–\(167\) 쪽(\(2003\)). 황마의 수출 비중과 \(1941\) 년의 인원, 비하르의 요청 시기와 쌀 수확, 구역 \(50\) 제곱마일·단위 \(4\) 에이커·제곱마일당 둘이라는 설계, 두 그룹을 독립으로 뿌렸다는 서술, 그리고 마할라노비스(\(1946\))에서 가져온 세 인용 —「이렇게 엇갈리는 두 조사단위 망을 쓰면 ⋯ 통계적 관리 아래 수행되었는지를 알려 준다」·「서로 만나는 일이 없도록 다른 시간에」·「조사원은 ⋯ 앞뒤가 나온 차례를 기록으로 남겨야 한다 ⋯」— 과 「이중 표본」이라 부르려다 그만둔 일화를 이 글에서 확인했다. 반쪽 표본 사이의 변동을 모집단의 변동에 대한 직접적인 정보로 읽었다는 평가도 같은 글의 것이다. 그림과 본문의 수는 모두 직접 계산한 값이다
자료에 이상치(outlier)가 있거나 정규분포가 아닐 때 중앙값이 특히 유용하다. 평균과 달리 중앙값에는 표준오차의 간단한 공식이 없다. 부트스트랩이 이 문제를 깔끔하게 푼다.
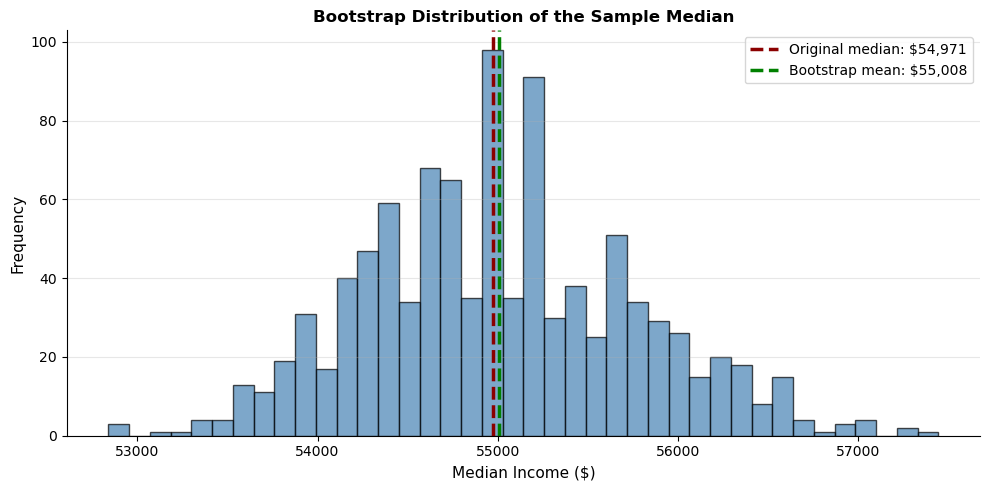
보기 1. 중앙값의 부트스트랩 분포. 모집단을 \(20{,}000 + \text{Exp}(\theta = 50{,}000)\)으로 두고 \(n = 5{,}000\)을 뽑아 중앙값의 표준오차를 부트스트랩으로 구한다. 이 모집단에서는 비교할 이론값이 있다.
(1) 표본중앙값의 점근 표준오차는 \(\dfrac{1}{2\sqrt n\, f(m)}\)이다(\(m\)은 모집단 중앙값). 이 모집단에서 \(m\)과 \(f(m)\)을 구해 그 값을 계산하고, 표본평균(sample mean)의 \(\sigma/\sqrt n\)과 견주시오. 둘이 정확히 같다. 왜 그런가.
(2) 실행해 부트스트랩 값과 (1)을 견주시오. 불일치가 \(B\) 탓인지 따지고, 표본을 바꾸어 가며 중앙값과 평균의 부트스트랩 표준오차가 각각 얼마나 흔들리는지 재어 보시오.
풀이
(1) 해석적으로. 모집단은 \(X = 20{,}000 + Y\), \(Y \sim \text{Exp}\)(평균 \(\theta\))이므로 밀도가
이다. 중앙값은 \(1 - e^{-(m-20000)/\theta} = \tfrac12\)에서
이고, 그 자리의 밀도는 \(e^{-(m-20000)/\theta} = \tfrac12\)이므로
다. 따라서
지수분포에서는 \(f(m) = 1/(2\theta)\)이고 \(\sigma = \theta\)이므로 두 표준오차가 식 자체로 같아진다. 평행이동은 둘 다에 영향을 주지 않는다. 곧
이고, 점근상대효율이 정확히 \(1\)이다. 정규분포에서 중앙값의 효율이 \(2/\pi = 0.637\)로 떨어지는 것과 대조된다. 꼬리가 두꺼울수록 중앙값이 유리해지는데, 지수분포(exponential distribution)는 꼭 분기점에 있다.
(2) 수치적으로.
import numpy as np
import pandas as pd

# 난수 씨앗 고정
np.random.seed(seed=1)

# 소득 자료를 흉내 낸다. 중앙값의 로버스트함을 보이기에 알맞은 모양이다
loans_income = pd.Series(np.random.exponential(scale=50000, size=5000) + 20000)

# 원래 표본의 중앙값
original_median = loans_income.median()
print(f"Original sample median: ${original_median:,.0f}")
# Original sample median: $54,971

# 부트스트랩: 1000번 재표집한다
bootstrap_medians = []
for nrepeat in range(1000):
    # 원래 표본과 같은 크기로 복원추출한다
    bootstrap_sample = loans_income.sample(frac=1, replace=True)
    bootstrap_medians.append(bootstrap_sample.median())

bootstrap_medians = pd.Series(bootstrap_medians)

# 재표본마다 통계량을 구한다
bootstrap_mean = bootstrap_medians.mean()
bootstrap_std = bootstrap_medians.std()
bias = bootstrap_mean - original_median

print(f"  Mean of bootstrap distribution:  ${bootstrap_mean:,.0f}")   # $55,008
print(f"  Standard error of median:        ${bootstrap_std:,.0f}")    # $756
print(f"  Bias of median estimator:        ${bias:,.0f}")             # $37
출력:
Original sample median: $54,971
  Mean of bootstrap distribution:  $55,008
  Standard error of median:        $756
  Bias of median estimator:        $37
NumPy 배열에는 .median() 메서드가 없다
np.random.exponential(...)은 ndarray를 반환하는데 ndarray에는 .median() 메서드가 없다. pd.Series로 감싸거나 np.median(...) 함수를 써야 한다. 이런 종류의 오류는 조용히 잘못된 값을 내지 않고 AttributeError로 즉시 드러나므로 그나마 다행이다.
시각화는 다음과 같이 한다.
import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(10, 5))
ax.hist(bootstrap_medians, bins=40, color='steelblue', edgecolor='black', alpha=0.7)
ax.axvline(original_median, color='darkred', linestyle='--', linewidth=2.5,
           label=f'Original median: ${original_median:,.0f}')
ax.axvline(bootstrap_mean, color='green', linestyle='--', linewidth=2.5,
           label=f'Bootstrap mean: ${bootstrap_mean:,.0f}')
ax.set_xlabel('Median Income ($)', fontsize=11)
ax.set_ylabel('Frequency', fontsize=11)
ax.set_title('Bootstrap Distribution of the Sample Median', fontsize=12, fontweight='bold')
ax.legend(fontsize=10)
ax.spines[['top', 'right']].set_visible(False)
ax.grid(True, alpha=0.3, axis='y')
plt.tight_layout()
plt.show()
이제 (1)의 이론값과 맞춰 보고, 부트스트랩 표준오차 자체가 얼마나 흔들리는지 잰다. 위 블록의 변수를 그대로 이어 쓴다.
theta, shift, n = 50000.0, 20000.0, len(loans_income)
m_pop = shift + theta * np.log(2)
f_m = 1 / (2 * theta)
print(f"모집단 중앙값 = {m_pop:,.2f},  f(m) = {f_m:.1e}")
print(f"중앙값의 점근 SE = {1 / (2 * np.sqrt(n) * f_m):,.3f}")
print(f"평균의   SE      = {theta / np.sqrt(n):,.3f}")
print(f"부트스트랩이 준 값 = {bootstrap_std:,.3f}"
      f"   (B=1000 의 몬테카를로 요동 {bootstrap_std / np.sqrt(2 * 1000):.1f})")

# 표본을 바꾸어 가며 부트스트랩 표준오차가 얼마나 흔들리는지 잰다.
rng = np.random.default_rng(7)
R, Bk = 20, 500
se_med, se_mean = [], []
for _ in range(R):
    x = rng.exponential(theta, n) + shift
    rs = x[rng.integers(0, n, (Bk, n))]
    se_med.append(np.median(rs, axis=1).std(ddof=1))
    se_mean.append(rs.mean(axis=1).std(ddof=1))
se_med, se_mean = np.array(se_med), np.array(se_mean)
print(f"\n표본 {R} 개, 각 B = {Bk}")
print(f"  중앙값 SE: 평균 {se_med.mean():.1f},  SD {se_med.std(ddof=1):.1f}"
      f"  (상대 {se_med.std(ddof=1) / se_med.mean():.3f}),"
      f"  범위 {se_med.min():.1f}~{se_med.max():.1f}")
print(f"  평균   SE: 평균 {se_mean.mean():.1f},  SD {se_mean.std(ddof=1):.1f}"
      f"  (상대 {se_mean.std(ddof=1) / se_mean.mean():.3f}),"
      f"  범위 {se_mean.min():.1f}~{se_mean.max():.1f}")
print(f"  몬테카를로 몫만이면 SD = {707.107 / np.sqrt(2 * Bk):.1f}")
출력:
모집단 중앙값 = 54,657.36,  f(m) = 1.0e-05
중앙값의 점근 SE = 707.107
평균의   SE      = 707.107
부트스트랩이 준 값 = 755.791   (B=1000 의 몬테카를로 요동 16.9)

표본 20 개, 각 B = 500
  중앙값 SE: 평균 684.9,  SD 60.4  (상대 0.088),  범위 598.8~857.9
  평균   SE: 평균 703.0,  SD 18.9  (상대 0.027),  범위 674.4~742.5
  몬테카를로 몫만이면 SD = 22.4
(1)의 두 수가 정말 같다. 중앙값과 평균의 점근 표준오차가 둘 다 \(707.107\)이다.
부트스트랩이 준 \(755.79\)는 이론값보다 \(6.9\%\) 크다. 이것을 \(B\) 탓으로 돌릴 수는 없다. \(B = 1{,}000\)에서 표준오차 추정의 몬테카를로(Monte Carlo) 요동이 \(16.9\)인데 차이는 \(48.7\)로 그 \(2.9\)배다.
까닭은 중앙값의 부트스트랩이 국소밀도에 기대기 때문이다. 부트스트랩이 실제로 재는 것은 \(\dfrac{1}{2\sqrt n\,\hat f(\hat m)}\)이고, \(\hat f\)는 표본중앙값 근처 몇 개의 간격만으로 정해지는 양이다. \(n = 5{,}000\)이어도 그 근처에 들어오는 관측은 몇십 개뿐이라 \(\hat f\)가 크게 흔들린다. 거꾸로 풀면 이 표본의 \(\hat f(\hat m) = 9.36\times10^{-6}\)으로 참값 \(10^{-5}\)보다 \(6.5\%\) 낮다.
아래 표가 그것을 직접 보여 준다. 표본을 \(20\)개 새로 뽑아 각각 부트스트랩하면
| 통계량 | 부트스트랩 SE의 평균 | 그 SD | 상대 변동 | 범위 |
|---|---|---|---|---|
| 중앙값 | \(684.9\) | \(60.4\) | \(8.8\%\) | \(598.8\)--\(857.9\) |
| 평균 | \(703.0\) | \(18.9\) | \(2.7\%\) | \(674.4\)--\(742.5\) |
로 중앙값 쪽의 변동이 세 배 넘게 크다. 둘 다 같은 이론값 \(707.107\)을 겨냥하는데도 그렇다. 평균의 \(18.9\)는 몬테카를로 몫 \(22.4\)와 비슷해 거의 전부가 \(B\)에서 오는 요동이지만, 중앙값의 \(60.4\)는 그 세 배라 \(B\)를 키워도 남는 몫이 대부분이다. 이 쪽 보기의 \(755.79\)가 범위 \(598.8\)--\(857.9\) 안에 넉넉히 들어가는 것도 확인된다.
요점. 중앙값의 표준오차를 부트스트랩으로 구하는 것은 옳지만, 그 값의 둘째 자리를 믿어서는 안 된다. \(B\)를 늘려도 좁아지지 않는 불확실성이 남아 있고, 그것은 표본크기 \(n\)이 정한다.
3. 부트스트랩 결과의 해석
표준오차
부트스트랩 분포의 표준편차가 통계량의 표준오차이다.
이는 모집단에서 표본을 반복해서 뽑았을 때 중앙값이 얼마나 변하는지를 추정한다.
편향
부트스트랩 분포의 평균이 원래 통계량과 다르면 추정량에 편향이 있다.
위 보기에서 편향은 \(+\$37\)로 표준오차 \(\$756\)의 5%에 불과하다. 중앙값 추정량이 사실상 불편(unbiased)임을 시사한다.
편향이 작다는 것을 어떻게 판단하는가
편향의 절대적 크기가 아니라 표준오차 대비 크기를 본다. \(|\widehat{\text{Bias}}| / \widehat{\text{SE}} < 0.25\)이면 무시할 만하다는 것이 흔한 경험칙이다. 여기서는 \(37/756 = 0.05\)로 그 기준을 크게 밑돈다.
부트스트랩 분포의 모양
부트스트랩 분포의 모양은 다음을 드러낸다.
- 왜도(skewness): 비대칭이면 표집분포가 비대칭이다.
- 두꺼운 꼬리: 통계량이 이상치에 민감함을 시사한다.
- 다봉성: 자료가 군집을 이루거나 모집단에 봉우리가 여럿임을 시사할 수 있다.
4. 부트스트랩의 장점
1. 분포무관
정규성(normality)이나 특정 분포형을 가정하지 않는다. 부트스트랩은 다음에 모두 통한다.
- 비정규 자료
- 치우친 분포
- 두꺼운 꼬리 분포
- 임의의 모집단 모양
2. 일반적 적용성
평균만이 아니라 어떤 통계량에도 통한다.
- 중앙값
- 상관계수
- 비 통계량
- 분위수(quantile)와 백분위수
- 사용자 정의 추정량
3. 직관적이고 투명하다
이론적 유도 없이 표집변동을 직접 추정한다. 그 결과
- 개념적으로 이해하기 쉽고
- 비전문가에게 설명하기 쉬우며
- 구현하고 검증하기 쉽다.
5. 모수적 접근과의 비교
| 측면 | 부트스트랩 | 모수적 (이론 기반) |
|---|---|---|
| 가정 | 최소 (i.i.d. 표본) | 강함 (정규성, 알려진 분산 등) |
| 적용범위 | 임의의 통계량 | 표준적인 통계량에 국한 |
| 계산 | 재표집 (집약적) | 공식 (빠름) |
| 타당성 | 점근적, \(B\)가 클수록 개선 | 정확 또는 점근적 |
| 구현 | 간단한 코드 | 수학적 지식 필요 |
6. 실무적 고려사항
표본크기 요건
부트스트랩은 원표본이 모집단을 어느 정도 대표할 것을 요구한다. 다음 경우에 잘 작동하지 않는다.
- 모집단 변동에 비해 표본크기가 매우 작을 때(\(n < 30\))
- 극단값이 표본에서 빠져 있을 때
- 표본이 편향되었거나 무작위가 아닐 때
부트스트랩 반복 횟수
무엇을 재는가가 정한다. 표준오차만 필요하면 \(B = 1{,}000\) 으로 족하지만, 신뢰구간은 꼬리 분위수를 안정시켜야 하므로 \(B = 5{,}000\)–\(10{,}000\) 이 든다. \(p\) 값은 더 비싸다 — \(\alpha = 0.05\) 에서 \(10{,}000\), \(\alpha = 0.01\) 에서는 \(50{,}000\) 이 넘어간다.
꼬리로 갈수록 같은 정밀도에 더 든다는 것이 요점이고, 그 수를 몬테카를로 오차로 유도해 표로 모은 것이 17.5절 재표집을 몇 번 해야 하는가다.
보기 2. 반복 횟수 \(B\)가 주는 차이. 같은 표본에 \(B = 100, 500, 1000, 5000\)으로 부트스트랩해 표준오차를 구한다.
(1) 부트스트랩 복제값 \(B\)개의 표본표준편차 \(\widehat{\operatorname{SE}}\)가 \(B\) 때문에 흔들리는 폭을 \(\widehat{\operatorname{SE}}\)와 \(B\)로 적으시오. 네 \(B\)에서 그 값을 구하시오.
(2) 실행해 네 결과가 그 폭 안에 드는지 보시오. 예측이 맞는지는 같은 계산을 여러 번 반복해 직접 재어 확인하시오.
풀이
(1) 해석적으로. \(\widehat{\operatorname{SE}}\)는 \(B\)개의 복제값에서 계산한 표본표준편차다. 분산이 \(\sigma^2\)이고 초과첨도가 \(\gamma_2\)인 분포에서 크기 \(B\)의 표본표준편차는
를 만족하고, 부트스트랩 분포가 거의 정규이면 \(\gamma_2 \approx 0\)이므로
이다. \(B\)를 네 배 늘려야 요동이 절반이 된다. 보기 1이 준 \(\widehat{\operatorname{SE}} \approx 756\)을 넣으면
| \(B\) | 예측 요동 \(756/\sqrt{2B}\) |
|---|---|
| \(100\) | \(53.5\) |
| \(500\) | \(23.9\) |
| \(1{,}000\) | \(16.9\) |
| \(5{,}000\) | \(7.6\) |
이다. 곧 \(B = 100\)이면 \(\pm 50\)쯤, \(B = 5{,}000\)이면 \(\pm 8\)쯤 흔들린다고 보아야 한다.
(2) 수치적으로.
# 부트스트랩 반복 횟수 B 를 늘리면 추정이 안정된다. 다만 B 는 부트스트랩
# 자체의 몬테카를로 오차만 줄일 뿐, 표본크기 n 이 주는 한계를 넘지는 못한다.
# 표준오차 추정에는 수백 번이면 족하고, 신뢰구간에는 수천 번이 필요하다.
np.random.seed(1)
income = loans_income.values

for B in [100, 500, 1000, 5000]:
    boot_medians = np.array([
        np.median(np.random.choice(income, size=len(income), replace=True))
        for _ in range(B)
    ])
    print(f"B = {B:5d}: SE = ${boot_medians.std():8,.1f}")
출력:
B =   100: SE = $   696.8
B =   500: SE = $   760.6
B =  1000: SE = $   741.7
B =  5000: SE = $   759.5
예측한 요동을 직접 재어 본다. 같은 \(B\)로 여러 번 반복해 \(\widehat{\operatorname{SE}}\)가 실제로 얼마나 흩어지는지 보면 된다.
rng = np.random.default_rng(3)
n = len(income)
print(f"{'B':>6}{'반복':>6}{'SE 평균':>12}{'SE 의 SD':>12}{'예측 SE/sqrt(2B)':>18}")
for B, R in [(100, 100), (500, 40), (1000, 30)]:
    ses = []
    for _ in range(R):
        rs = income[rng.integers(0, n, (B, n))]
        ses.append(np.median(rs, axis=1).std(ddof=0))
    ses = np.array(ses)
    print(f"{B:>6}{R:>6}{ses.mean():>12.1f}{ses.std(ddof=1):>12.1f}"
          f"{ses.mean() / np.sqrt(2 * B):>18.1f}")
출력:
     B    반복       SE 평균     SE 의 SD    예측 SE/sqrt(2B)
   100   100       746.5        57.6              52.8
   500    40       756.2        20.5              23.9
  1000    30       756.8        17.5              16.9
예측이 맞는다. 직접 잰 산포 \(57.6\), \(20.5\), \(17.5\)가 공식이 준 \(52.8\), \(23.9\), \(16.9\)와 나란히 간다(반복 횟수가 적어 잰 값 자체도 \(1/\sqrt{2R}\)만큼 흔들린다). 세 \(B\)에서 \(\widehat{\operatorname{SE}}\)의 평균이 \(746.5\), \(756.2\), \(756.8\)로 모두 같은 자리를 겨냥하는 것도 확인된다. \(B\)는 겨냥하는 값을 바꾸지 않고 과녁 주위의 산포만 줄인다.
이제 쪽의 네 숫자를 제대로 읽을 수 있다. \(696.8\), \(760.6\), \(741.7\), \(759.5\)는 각각 \(\pm 53\), \(\pm 24\), \(\pm 17\), \(\pm 8\)짜리 요동을 달고 있는 값들이다. \(B = 100\)의 \(696.8\)이 \(B = 5{,}000\)의 \(759.5\)보다 \(8\%\) 작은 것은 \(B\)가 작아서 생긴 변동이지 체계적인 차이가 아니다.
그러므로 "표준오차만 필요하면 \(B\)를 크게 할 이유가 별로 없다"는 말은 조건부로만 옳다. 표준오차를 두 자리 유효숫자로 적겠다면 \(\widehat{\operatorname{SE}}/\sqrt{2B} < 0.05\,\widehat{\operatorname{SE}}\), 곧 \(B > 200\)이면 되므로 수백 번이면 족하다. 그러나 보기 1에서 보았듯 \(B\)를 아무리 키워도 남는 불확실성이 따로 있고(\(755.79\) 대 이론값 \(707.11\)), 그것은 표본크기 \(n\)이 정한다. \(B\)로 줄일 수 있는 것과 없는 것을 갈라 읽는 것이 이 보기의 요점이다.
계산비용
현대의 컴퓨터는 표준적인 통계량에 대해 \(10{,}000\)회 부트스트랩을 쉽게 처리한다. 복잡한 모형 적합처럼 계산이 무거운 작업에서는 \(B = 500\)으로 시작하고 필요하면 늘린다.
7. 한계와 함정
- 극단값을 잘 추정하지 못한다: 표본최댓값의 경우 부트스트랩 최댓값은 언제나 관측된 최댓값 이하이다.
- 종속자료: 표준 부트스트랩은 관측값의 독립성(independence)을 가정한다. 시계열이나 군집자료에는 블록 부트스트랩 같은 수정이 필요하다.
- 작은 표본: 표본이 매우 작으면 경험적 분포가 모집단을 제대로 대변하지 못한다.
- 편향을 없애 주지는 않는다: 부트스트랩은 편향을 추정할 수 있지만(위 참조) 편향된 추정량을 자동으로 고쳐 주지는 않는다. 편향보정을 하려면 명시적으로 \(2\hat{\theta} - \bar{\hat{\theta}}^*\)를 계산해야 하며, 그러면 분산이 커진다.
부트스트랩은 편향을 추정한다
"부트스트랩은 표준오차만 추정하고 편향은 못 한다"는 서술을 종종 본다. 이는 정확하지 않다. 비모수 부트스트랩에서 보았듯 \(\widehat{\text{Bias}}_{\text{boot}} = \bar{\hat{\theta}}^* - \hat{\theta}\)가 편향의 추정값이다.
옳은 서술은 이렇다. 부트스트랩은 편향을 추정할 수 있지만, 편향보정을 자동으로 해 주지는 않으며 보정 자체가 분산을 늘릴 수 있다.
8. 확장과 변형
블록 부트스트랩
시계열이나 군집자료에 쓴다.
보기 3. 블록 부트스트랩. 주변분산이 \(1\)이고 시차 \(k\)의 자기공분산(autocovariance)이 \(\gamma_k = \rho^k\)인 AR(1) 시계열 \(n = 500\)개에 적용한다(\(\rho = 0.7\)).
(1) \(\operatorname{Var}(\bar X_n)\)을 \(\rho\)와 \(n\)으로 적고, 독립일 때의 \(1/n\)에 견주어 몇 배로 부풀어 있는지 구하시오. 길이 \(\ell\)짜리 블록 부트스트랩이 겨냥하는 값은 무엇인가.
(2) 실행해 순진한 부트스트랩과 여러 블록 길이의 결과를 참값과 견주시오. 블록을 길게 하면 언제나 좋아지는가.
풀이
(1) 해석적으로. 정상 시계열에서
이다. AR(1)에서 \(\gamma_0 = 1\), \(\gamma_k = \rho^k\)이므로 \(n\)이 크면
다. \(\rho = 0.7\)이면 괄호가 \(\frac{1.7}{0.3} = 5.667\)이므로 분산이 독립일 때의 \(5.67\)배, 표준오차는 \(\sqrt{5.667} = 2.38\)배다. 순진한 부트스트랩은 관측값을 하나씩 뽑아 순서를 부수므로 \(\gamma_1, \gamma_2, \ldots\)를 전부 \(0\)으로 만들고, 결국 \(1/n\)만 돌려준다. 곧 표준오차를 \(2.38\)분의 \(1\)로 낮잡는다.
블록 부트스트랩이 겨냥하는 값. 한 재표본은 길이 \(\ell\)짜리 블록 \(n/\ell\)개를 독립으로 이어 붙인 것이므로, 그 평균은 독립인 블록평균 \(n/\ell\)개의 평균이다. 블록평균 하나의 분산이 \(\dfrac{c(\ell)}{\ell}\)이라 두면
이다. 블록 안쪽의 상관만 살아남고 그 너머는 잘린다. \(c(\ell)\)은 자기상관을 시차 \(\ell-1\)까지만, 그것도 삼각 가중으로 더한 값이며 \(\ell \to \infty\)에서 \(\frac{1+\rho}{1-\rho}\)로 간다. \(\ell = 1\)이면 \(c = 1\)로 순진한 부트스트랩과 같아진다.
(2) 수치적으로. 함수는 이렇다.
def block_bootstrap(data, block_size, n_bootstrap, rng=None):
    """이동블록 부트스트랩. 서로 독립이 아닌 자료에 쓴다.

    보통의 부트스트랩은 관측값을 하나씩 뽑으므로 시간 순서의 구조가 모두
    부서진다. 시계열처럼 이웃한 값끼리 얽혀 있는 자료에서는 표준오차를
    크게 낮잡게 된다. 그래서 낱값이 아니라 길이 block_size 짜리 덩어리를
    통째로 뽑아, 덩어리 안의 상관은 그대로 남긴다.
    """
    rng = np.random.default_rng() if rng is None else rng
    n = len(data)
    n_blocks = int(np.ceil(n / block_size))
    samples = []
    for _ in range(n_bootstrap):
        starts = rng.integers(0, n - block_size + 1, n_blocks)
        sample = np.concatenate([data[s:s + block_size] for s in starts])[:n]
        samples.append(sample)
    return np.array(samples)
AR(1) 자료를 만들어 적용한다.
rho, n, B = 0.7, 500, 1000
rng = np.random.default_rng(0)

# AR(1) 을 주변분산 1 로 만든다.
x = np.empty(n)
x[0] = rng.normal(0, 1)
eps = rng.normal(0, np.sqrt(1 - rho ** 2), n)
for t in range(1, n):
    x[t] = rho * x[t - 1] + eps[t]

k = np.arange(1, n)
var_true = (n + 2 * np.sum((n - k) * rho ** k)) / n ** 2
print(f"표본 sd = {x.std(ddof=1):.4f},  표본 1차 자기상관 = "
      f"{np.corrcoef(x[:-1], x[1:])[0, 1]:.4f}")
print(f"참 SD(xbar)      = {np.sqrt(var_true):.5f}   (점근 "
      f"{np.sqrt((1 + rho) / (1 - rho) / n):.5f})")
print(f"독립이라면       = {np.sqrt(1 / n):.5f}   -> 팽창 "
      f"{np.sqrt(var_true * n):.4f} 배")

naive = x[rng.integers(0, n, (B, n))].mean(axis=1)
print(f"순진한 부트스트랩 SE = {naive.std(ddof=1):.5f}")

print(f"\n{'블록 길이':>9}{'블록부트스트랩 SE':>17}{'예측 sqrt(c/n)*s':>19}{'참값 대비':>11}")
for L in (1, 5, 10, 25, 50, 100):
    kk = np.arange(1, L)
    c = 1 + 2 * np.sum((1 - kk / L) * rho ** kk) if L > 1 else 1.0
    se = block_bootstrap(x, L, B, rng=np.random.default_rng(1)).mean(axis=1).std(ddof=1)
    print(f"{L:>9}{se:>17.5f}{np.sqrt(c / n) * x.std(ddof=0):>19.5f}"
          f"{se / np.sqrt(var_true):>11.3f}")
출력:
표본 sd = 0.9872,  표본 1차 자기상관 = 0.6782
참 SD(xbar)      = 0.10617   (점근 0.10646)
독립이라면       = 0.04472   -> 팽창 2.3739 배
순진한 부트스트랩 SE = 0.04391

    블록 길이       블록부트스트랩 SE     예측 sqrt(c/n)*s      참값 대비
        1          0.04396            0.04411      0.414
        5          0.07466            0.07739      0.703
       10          0.08745            0.08990      0.824
       25          0.09242            0.09906      0.871
       50          0.09254            0.10207      0.872
      100          0.08801            0.10354      0.829
(1)이 맞는다. 정확식이 준 \(\operatorname{SD}(\bar X) = 0.10617\)이 점근값 \(0.10646\)과 거의 같고, 독립일 때의 \(0.04472\)보다 \(2.3739\)배 크다. 순진한 부트스트랩은 \(0.04391\)로 참값의 \(41\%\)밖에 내놓지 못한다. 블록 길이 \(1\)이 그것과 같은 \(0.04396\)을 주는 것도 예측대로다.
블록을 늘리면 값이 올라가지만 끝까지 가지는 못한다. \(\ell = 5, 10, 25\)에서 \(0.0747 \to 0.0875 \to 0.0924\)로 참값의 \(70\%\), \(82\%\), \(87\%\)까지 간다. 예측 \(\sqrt{c(\ell)/n}\,s\)도 같은 방향으로 움직인다.
그러나 \(\ell\)을 더 키우면 오히려 나빠진다. \(\ell = 50\)에서 \(0.0925\)로 제자리걸음이고 \(\ell = 100\)에서는 \(0.0880\)으로 내려간다. 예측값은 계속 오르는데 실제는 꺾이므로 이것은 몬테카를로 요동이 아니다(\(B = 1{,}000\)에서 표준오차 추정의 요동이 \(0.0021\)인데 \(\ell = 100\)의 간극은 \(0.0155\)다).
까닭은 한 재표본에 들어가는 블록의 수가 \(n/\ell\)로 줄기 때문이다. \(\ell = 100\)이면 블록이 다섯 개뿐이라, 재표본의 평균이 서로 독립인 조각 다섯 개의 평균에 지나지 않는다. 게다가 블록을 \(n - \ell + 1\)개의 시작점에서 뽑으므로 양 끝 근처의 관측이 덜 뽑히는 가장자리 효과도 \(\ell/n\)에 비례해 커진다. 블록 길이는 편향과 분산을 맞바꾸는 조절 손잡이이며, 여기서는 \(\ell \approx 25\)에서 가장 좋다. 자기상관이 \(\rho^k\)로 꺼지는 데 걸리는 시간(\(1/(1-\rho) \approx 3.3\))의 몇 배이면서 \(n\)에 견주어 작은 값이다.
고정 블록 대 이동 블록
위 구현은 이동 블록(moving-block) 부트스트랩으로, 블록의 시작점을 임의의 위치에서 뽑는다. 자료를 겹치지 않는 고정 블록으로 미리 자르고 그 블록들을 재표집하는 방식도 있지만, 마지막 블록의 길이가 다를 수 있고 블록 경계가 고정되어 정보를 잃는다. 이동 블록이 대체로 낫다.
백분위수-t 부트스트랩
일부 통계량에서 더 정확한 신뢰구간을 준다.
보기 4. 백분위수-t 부트스트랩. 평균 \(2\)인 지수분포에서 \(n = 40\)을 뽑아 평균의 \(95\%\) 신뢰구간을 백분위수법과 백분위수-\(t\)로 각각 구한다.
(1) 지수분포에서는 비교할 정확한 구간이 있다. \(2n\bar X/\theta\)가 \(\chi^2_{2n}\)을 따름을 보이고 그 구간을 적으시오. 이 자료에서 계산해 세 구간이 \(\hat\theta\)의 좌우로 뻗는 길이를 견주시오.
(2) 실행해 확인하고, 두 부트스트랩 구간의 포함확률을 모의실험으로 재시오. 덮지 못할 때 어느 쪽으로 빗나가는지도 세시오.
풀이
(1) 해석적으로. \(X_i\)가 평균 \(\theta\)인 지수분포이면 \(\sum_i X_i \sim \text{Gamma}(n,\ \text{척도 } \theta)\)이고, 척도를 \(2\)로 맞추면 감마가 카이제곱이 된다.
이 양은 \(\theta\)를 포함하지만 그 분포가 \(\theta\)에 의존하지 않으므로 추축량(pivotal quantity)이다. 따라서
을 \(\theta\)에 대해 풀면
이고, 이것은 어떤 \(n\)에서도 포함확률이 정확히 \(0.95\)다. 분모가 거꾸로 들어가므로 구간이 오른쪽으로 길어진다.
오른쪽으로 길어져야 하는 까닭은 \(\bar X\)의 표집분포가 오른쪽으로 치우쳐 있기 때문이다. 지수분포의 왜도가 \(2\)이므로 \(n\)개 평균의 왜도가 \(2/\sqrt n = 0.3162\)다. 백분위수법은 이 왜도를 고치지 못한다. 백분위수 구간은 부트스트랩 분포의 양쪽 꼬리를 그대로 잘라 쓰는데, 부트스트랩 분포가 \(\hat\theta\) 주위에서 오른쪽으로 치우쳐 있으면 구간도 오른쪽으로 길어져 왜도를 한 번 더 같은 방향으로 적용하는 꼴이 된다. 백분위수-\(t\)는 추축량 \(t^{*} = (\hat\theta^{*} - \hat\theta)/\widehat{\operatorname{se}}^{*}\)의 분포를 쓰고 그 분위점을 \(\hat\theta\)에서 빼므로 방향이 뒤집혀 올바른 쪽으로 늘어난다.
(2) 수치적으로.
import numpy as np

rng = np.random.default_rng(0)
# 치우친 자료. 백분위수법이 어긋나기 쉬운 경우라 백분위수-t 를 쓴다.
data = rng.exponential(2.0, 40)
n, B = len(data), 2000

original_statistic = data.mean()
original_se = data.std(ddof=1) / np.sqrt(n)

# 각 부트스트랩 표본에서 통계량과 그 표준오차를 함께 계산한다
idx = rng.integers(0, n, (B, n))
resamples = data[idx]
bootstrap_statistics = resamples.mean(axis=1)
bootstrap_ses = resamples.std(axis=1, ddof=1) / np.sqrt(n)

# 백분위수-t 는 통계량 자체가 아니라 스튜던트화한 값의 분포를 쓴다.
# 이러면 비대칭이 보정되어 포함확률이 명목수준에 더 가까워진다.
# 대신 부트스트랩 표본마다 표준오차를 또 계산해야 해 비용이 든다.
bootstrap_t_stats = (bootstrap_statistics - original_statistic) / bootstrap_ses
# 위아래가 뒤집혀 들어간다. t 분포의 위쪽 분위점이 구간의 아래끝을 만든다.
ci_lower = original_statistic - np.percentile(bootstrap_t_stats, 97.5) * original_se
ci_upper = original_statistic - np.percentile(bootstrap_t_stats, 2.5) * original_se

print(f"theta_hat = {original_statistic:.4f}")
print(f"bootstrap-t CI = ({ci_lower:.4f}, {ci_upper:.4f})")
print("percentile  CI = ({:.4f}, {:.4f})".format(
    *np.percentile(bootstrap_statistics, [2.5, 97.5])))
출력:
theta_hat = 2.3157
bootstrap-t CI = (1.6976, 3.3636)
percentile  CI = (1.6498, 3.0813)
정확 구간과 견주고, 포함확률을 직접 센다. 위 블록의 변수를 그대로 이어 쓴다.
from scipy import stats

# 지수분포에서는 2n*xbar/theta ~ chi^2_{2n} 이라 정확 구간이 있다.
lo_e = 2 * n * original_statistic / stats.chi2.ppf(0.975, 2 * n)
up_e = 2 * n * original_statistic / stats.chi2.ppf(0.025, 2 * n)
pc = np.percentile(bootstrap_statistics, [2.5, 97.5])
print(f"정확 (카이제곱) CI = ({lo_e:.4f}, {up_e:.4f})")
print(f"표본평균의 왜도 (이론 2/sqrt(n)) = {2 / np.sqrt(n):.4f}")
for name, (a, b) in [("백분위수", pc), ("백분위수-t", (ci_lower, ci_upper)),
                     ("정확", (lo_e, up_e))]:
    print(f"  {name:>10}: 왼쪽 {original_statistic - a:.4f}"
          f"  오른쪽 {b - original_statistic:.4f}"
          f"  비 {(b - original_statistic) / (original_statistic - a):.3f}"
          f"  폭 {b - a:.4f}")

# 포함확률 모의실험
M, Bc, theta = 1000, 1000, 2.0
rng2 = np.random.default_rng(123)
cp = ct = ce = 0
lp = rp = lt = rt = 0
for _ in range(M):
    d = rng2.exponential(theta, n)
    th = d.mean(); se = d.std(ddof=1) / np.sqrt(n)
    rs = d[rng2.integers(0, n, (Bc, n))]
    m = rs.mean(axis=1); s = rs.std(axis=1, ddof=1) / np.sqrt(n)
    a, b = np.percentile(m, [2.5, 97.5])
    cp += (a <= theta <= b); lp += theta < a; rp += theta > b
    tt = (m - th) / s
    lo = th - np.percentile(tt, 97.5) * se
    up = th - np.percentile(tt, 2.5) * se
    ct += (lo <= theta <= up); lt += theta < lo; rt += theta > up
    le = 2 * n * th / stats.chi2.ppf(0.975, 2 * n)
    ue = 2 * n * th / stats.chi2.ppf(0.025, 2 * n)
    ce += (le <= theta <= ue)
print(f"\nM = {M}, B = {Bc}, n = {n}, theta = {theta}"
      f"   (포함률의 몬테카를로 오차 {np.sqrt(0.95 * 0.05 / M):.4f})")
print(f"백분위수   포함률 {cp / M:.3f}  (왼쪽 밖 {lp / M:.3f}, 오른쪽 밖 {rp / M:.3f})")
print(f"백분위수-t 포함률 {ct / M:.3f}  (왼쪽 밖 {lt / M:.3f}, 오른쪽 밖 {rt / M:.3f})")
print(f"정확       포함률 {ce / M:.3f}")
출력:
정확 (카이제곱) CI = (1.7374, 3.2414)
표본평균의 왜도 (이론 2/sqrt(n)) = 0.3162
        백분위수: 왼쪽 0.6659  오른쪽 0.7656  비 1.150  폭 1.4315
      백분위수-t: 왼쪽 0.6180  오른쪽 1.0480  비 1.696  폭 1.6660
          정확: 왼쪽 0.5783  오른쪽 0.9257  비 1.601  폭 1.5040

M = 1000, B = 1000, n = 40, theta = 2.0   (포함률의 몬테카를로 오차 0.0069)
백분위수   포함률 0.916  (왼쪽 밖 0.021, 오른쪽 밖 0.063)
백분위수-t 포함률 0.934  (왼쪽 밖 0.030, 오른쪽 밖 0.036)
정확       포함률 0.948
모양이 갈린다. 좌우 길이의 비가 정확 구간에서 \(1.601\)인데, 백분위수-\(t\)가 \(1.696\)으로 가깝고 백분위수법은 \(1.150\)으로 거의 대칭이다. 치우친 자료에서 대칭에 가까운 구간이 나왔다는 것 자체가 신호다.
포함률이 그 대가를 보여 준다. 명목 \(95\%\)에 대해 백분위수법이 \(0.916\), 백분위수-\(t\)가 \(0.934\), 정확 구간이 \(0.948\)이다. 몬테카를로 오차가 \(0.0069\)이므로 \(0.916\)과 \(0.934\)의 차이는 \(2.6\)배로 실재한다.
빗나가는 방향까지 보면 원인이 분명해진다. 백분위수법은 왼쪽으로 \(2.1\%\), 오른쪽으로 \(6.3\%\) 놓쳐 한쪽으로 세 배 기운다. 구간이 오른쪽으로 충분히 뻗지 않아 참값이 상한 위로 빠져나가는 일이 잦다는 뜻이다. 백분위수-\(t\)는 \(3.0\%\) 대 \(3.6\%\)로 거의 고르다.
백분위수법은 왜도를 고치지 못한다. 부트스트랩 분포의 꼬리를 그대로 잘라 쓸 뿐이라, 표집분포의 비대칭을 반대 방향으로 되돌리는 일을 하지 않는다. 백분위수-\(t\)는 추축량을 쓰므로 그 일을 하고, 대신 재표본마다 표준오차를 또 계산해야 한다. BCa 방법은 같은 문제를 다른 방식으로 — 편향 보정 \(z_0\)와 가속 \(a\)로 — 푼다.
분위수의 순서가 뒤바뀐 것처럼 보이는데 이는 실수가 아니다. \(t^* = (\hat\theta^* - \hat\theta)/\widehat{\text{SE}}^*\)의 상위 분위수가 신뢰구간의 하한에 대응한다. 자세한 내용은 부트스트랩-t 방법에서 다룬다.
연습문제
연습문제 1. 소득자료 보기에서 중앙값의 부트스트랩 표준오차 \(\$756\)을 얻었다. 같은 자료에서 평균의 부트스트랩 표준오차를 계산하고, 이론값 \(s/\sqrt{n}\)과 비교하라. 어느 통계량의 표준오차가 더 큰가?
풀이
import numpy as np, pandas as pd
np.random.seed(1)
x = pd.Series(np.random.exponential(scale=50000, size=5000) + 20000)
rng = np.random.default_rng(0)

idx = rng.integers(0, 5000, (5000, 5000))
boot_mean = x.values[idx].mean(axis=1)
boot_med  = np.median(x.values[idx], axis=1)

print("평균  부트스트랩 SE:", round(boot_mean.std(ddof=1), 1))
print("이론값 s/sqrt(n)  :", round(x.std(ddof=1) / np.sqrt(5000), 1))
print("중앙값 부트스트랩 SE:", round(boot_med.std(ddof=1), 1))
출력:
평균  부트스트랩 SE: 681.9
이론값 s/sqrt(n)  : 690.9
중앙값 부트스트랩 SE: 755.0
| 통계량 | 부트스트랩 SE | 이론값 |
|---|---|---|
| 평균 | 682 | 691 |
| 중앙값 | 755 | (공식 없음) |
평균의 부트스트랩 SE \(682\)가 이론값 \(691\)과 1.3% 이내로 일치한다. 부트스트랩 절차가 옳게 구현되었음을 확인하는 좋은 검산이다.
중앙값의 SE가 더 크다(\(755 > 682\)). 이는 지수분포에서 중앙값이 평균보다 비효율적임을 뜻한다. 실제로 밀도가 \(f\)인 분포에서 중앙값의 점근분산은 \(1/(4nf(m)^2)\)인데, 지수분포에서는
로 두 분산이 점근적으로 같아진다(\(m = \ln 2/\lambda\)에서 \(f(m) = \lambda/2\)). 관측된 비 \(755/682 = 1.107\)은 이 극한값 \(1\)에 가깝지만 유한표본 효과로 조금 크다.
주의: 이 결론은 지수분포에 특정된 것이다. 정규분포에서는 중앙값의 분산이 평균의 \(\pi/2 = 1.571\)배이고, 두꺼운 꼬리 분포에서는 중앙값이 훨씬 유리하다.
연습문제 2. 블록 부트스트랩이 필요한 이유를 보여라. AR(1) 시계열에 표준 부트스트랩을 적용하면 표준오차가 어떻게 되는가?
풀이
\(X_t = \phi X_{t-1} + \varepsilon_t\), \(\phi = 0.8\), \(\varepsilon_t \sim \mathcal{N}(0,1)\)인 시계열을 생성한다. 이 과정의 정상분산은 \(1/(1-\phi^2) = 2.778\)이고, 표본평균의 참 분산은
로 독립일 때의 9배이다.
import numpy as np
rng = np.random.default_rng(0)
n, phi, M = 500, 0.8, 2000

def ar1(n):
    e = rng.normal(0, 1, n + 200)
    x = np.zeros(n + 200)
    for t in range(1, n + 200):
        x[t] = phi * x[t-1] + e[t]
    return x[200:]

# 참 SE: 시계열을 여러 번 생성
true_se = np.array([ar1(n).mean() for _ in range(M)]).std(ddof=1)

x = ar1(n)
B = 4000
iid_se = x[rng.integers(0, n, (B, n))].mean(axis=1).std(ddof=1)

def block_se(x, L, B):
    n = len(x); nb = int(np.ceil(n / L))
    starts = rng.integers(0, n - L + 1, (B, nb))
    means = np.array([np.concatenate([x[s:s+L] for s in row])[:n].mean()
                      for row in starts])
    return means.std(ddof=1)

print("참 SE       :", round(true_se, 4))
print("표준 부트스트랩:", round(iid_se, 4))
for L in (5, 20, 50):
    print(f"블록 L={L:2d}  :", round(block_se(x, L, B), 4))
출력:
참 SE       : 0.2229
표준 부트스트랩: 0.0742
블록 L= 5  : 0.1421
블록 L=20  : 0.1996
블록 L=50  : 0.1882
| 방법 | \(\widehat{\text{SE}}(\bar{X})\) | 참값 대비 |
|---|---|---|
| 참 SE | 0.2229 | --- |
| 표준 (i.i.d.) 부트스트랩 | 0.0742 | \(-67\%\) |
| 블록 부트스트랩 \(L = 5\) | 0.1421 | \(-36\%\) |
| 블록 부트스트랩 \(L = 20\) | 0.1996 | \(-10\%\) |
| 블록 부트스트랩 \(L = 50\) | 0.1882 | \(-16\%\) |
표준 부트스트랩이 표준오차를 67% 과소평가한다. 재표집이 관측값을 무작위로 섞어 시간적 종속을 완전히 파괴하므로, \(\sqrt{9} = 3\)배만큼 작은 값이 나온다(\(0.2229/3 = 0.0743\)으로 관측값 \(0.0742\)와 거의 같다).
블록 부트스트랩은 길이 \(L\)의 연속 구간을 통째로 재표집하여 블록 안의 종속은 보존한다. \(L\)이 커질수록 편향이 줄지만 블록 개수가 줄어 분산이 커진다 — 위에서도 \(L = 50\)의 값이 \(L = 20\)보다 되레 참값에서 멀다. 일반적인 지침은 \(L \approx n^{1/3}\)이지만, 종속이 강하면(\(\phi\)가 1에 가까우면) 더 긴 블록이 필요하다.
핵심: 부트스트랩의 타당성은 재표집 방식이 자료 생성 과정의 의존 구조를 흉내 내는가에 달려 있다. i.i.d. 재표집은 i.i.d. 자료에만 맞다.
연습문제 3. "극단값을 잘 추정하지 못한다"는 한계를 정량적으로 확인하라. \(n = 200\)인 표본에서 99번째 백분위수의 부트스트랩 신뢰구간 포함확률은 얼마인가?
풀이
\(\mathcal{N}(0,1)\)에서 \(q_{0.99} = 2.3263\)이다. 중앙값 \(q_{0.5} = 0\)과 비교한다.
import numpy as np
from scipy import stats
rng = np.random.default_rng(4)
n, B, M = 200, 800, 600

for p, target in [(50, 0.0), (90, stats.norm.ppf(0.90)),
                  (99, stats.norm.ppf(0.99))]:
    cov = 0
    for _ in range(M):
        x = rng.normal(0, 1, n)
        q = np.percentile(x[rng.integers(0, n, (B, n))], p, axis=1)
        lo, hi = np.percentile(q, [2.5, 97.5])
        cov += lo <= target <= hi
    print(p, round(cov / M, 3))
출력:
50 0.942
90 0.942
99 0.857
| 백분위수 | 참값 | 부트스트랩 신뢰구간 포함확률 |
|---|---|---|
| 50 (중앙값) | 0.000 | 0.942 |
| 90 | 1.282 | 0.942 |
| 99 | 2.326 | 0.857 |
중앙값과 90번째 백분위수에서는 포함확률이 \(0.942\)로 명목값에 가깝다. 99번째 백분위수에서 \(0.857\)로 뚜렷이 떨어진다.
이유는 유효 표본크기이다. \(n = 200\)에서 99번째 백분위수는 상위 2개 관측값 근처를 가리킨다. 부트스트랩 재표집은 이 두 값을 넣거나 빼는 것뿐이라 분포가 극도로 이산적이 되고, 관측되지 않은 더 극단적인 값을 만들어 낼 수 없다.
x = rng.normal(0, 1, 200)
q = np.percentile(x[rng.integers(0, 200, (5000, 200))], 99, axis=1)
print(len(np.unique(np.round(q, 6))))   # 60  ← 5000개 복제값이 60가지 값만 갖는다
출력:
60
\(5000\)개의 부트스트랩 복제값이 서로 다른 값을 \(60\)가지밖에 갖지 못한다. 중앙값이라면 수천 가지가 나온다. 이 정도 이산성에서 \(2.5\)와 \(97.5\) 백분위수를 안정적으로 뽑기는 어렵다.
대안: 극단 분위수에는 (1) 모수적 부트스트랩, (2) 극단값 이론(GPD 적합), (3) 평활 부트스트랩(smoothed bootstrap, 관측값에 작은 잡음을 더해 재표집) 중 하나를 쓴다.
연습문제 4. 평균의 부트스트랩에는 공식으로 끝까지 풀 수 있는 자리가 있다.
(1) 경험적 분포에서 복원추출하면 \(X_1^*, \ldots, X_n^*\)가 서로 독립이고 각각 평균 \(\bar x\), 분산 \(\hat\sigma^2 = \frac1n\sum_i (x_i - \bar x)^2\)를 가진다. 이로부터 \(\operatorname{Var}_*(\bar X^*) = \hat\sigma^2/n\)임을 보이시오. 이것은 점근식이 아니라 모든 \(n\)에서 정확한 등식이다. 곧 \(B \to \infty\)에서 평균의 부트스트랩 표준오차가 겨냥하는 값은 \(s/\sqrt n\)이 아니다.
(2) 연습문제 1은 \(n = 5{,}000\), \(B = 5{,}000\)에서 평균의 부트스트랩 SE \(681.9\)와 이론값 \(s/\sqrt n = 690.9\)를 얻었다. 그 차 \(9.0\)을 (가) \(n\) 대 \(n-1\)에서 오는 몫과 (나) 유한한 \(B\)에서 오는 몫으로 가르시오. 어느 쪽이 큰가. 이 차이를 부트스트랩이 틀렸다는 증거로 볼 수 있는가.
(3) \(B = 5{,}000\)을 고정할 때 두 몫의 크기가 같아지는 \(n\)을 구하시오. 평균의 부트스트랩 SE를 코드 검산으로 쓸 때 이것이 뜻하는 바를 적으시오.
풀이
(1) 재표집은 \(\{x_1, \ldots, x_n\}\)에서 각 값을 확률 \(1/n\)로, 서로 독립으로 뽑는 것이다. 그 하나의 평균과 분산이
이므로 독립인 \(n\)개의 평균은
다. 여기에는 어떤 근사도 들어가지 않았다. 조건부 분포가 유한한 모집단 \(\{x_1,\ldots,x_n\}\)에서의 복원추출이므로 계산이 끝까지 닫힌다. \(\hat\sigma^2 = \frac{n-1}{n}s^2\)이므로 이상적인(\(B = \infty\)) 부트스트랩 표준오차는
로, 언제나 \(s/\sqrt n\)보다 조금 작다. 부트스트랩은 \(n\)으로 나눈 분산을 쓰는 쪽을 택한 셈이다.
(2) 두 몫을 각각 잰다.
(가) \(n\) 대 \(n-1\): \(\sqrt{1 - 1/5000} = 0.9998999950\)이므로 이상적인 부트스트랩 SE는
이다. 곧 이 몫의 크기는 \(690.9 - 690.83 = 0.07\)에 지나지 않는다.
(나) 유한한 \(B\): 보기 2가 준 \(\operatorname{SD}(\widehat{\operatorname{SE}}) \approx \widehat{\operatorname{SE}}/\sqrt{2B}\)에 \(B = 5{,}000\)을 넣으면 \(690.83/\sqrt{10000} = 6.91\)이다. 관측값 \(681.9\)는 겨냥하는 값 \(690.83\)에서 \(8.93\) 떨어져 있으니 \(8.93/6.91 = 1.29\)배, 곧 \(1.3\)표준편차다.
| 몫 | 크기 | 상대 크기 |
|---|---|---|
| (가) \(n\) 대 \(n-1\) | \(0.07\) | \(0.01\%\) |
| (나) 유한한 \(B\) | \(8.93\) | \(1.29\%\) |
(나)가 (가)보다 \(130\)배쯤 크다. 따라서 연습문제 1의 \(1.3\%\) 불일치는 사실상 전부 몬테카를로 요동이고, 그 크기가 \(1.3\)표준편차이므로(\(\Pr(\lvert Z\rvert > 1.3) = 0.19\)) 부트스트랩이 틀렸다는 증거가 되지 못한다. 덧붙여 \(B\)개 복제값의 표본표준편차는 그 자체로 아래로 조금 치우쳐 있는데(\(\operatorname{E}[s] \approx \sigma(1 - \frac1{4B})\), 여기서는 \(690.83/20000 = 0.03\)) 이것도 (가)와 마찬가지로 무시할 크기다.
(3) 상대 크기로 적으면 (가)는 \(1 - \sqrt{1-1/n} \approx \dfrac{1}{2n}\), (나)는 \(\dfrac{1}{\sqrt{2B}}\)다. 둘이 같아지는 곳은
이다. \(n \gtrsim 50\)이면 \(n\) 대 \(n-1\)의 차이는 몬테카를로 요동에 완전히 묻힌다. 그러므로 "평균의 부트스트랩 SE가 \(s/\sqrt n\)과 맞는가"라는 검산은 \(\pm 1/\sqrt{2B}\)보다 가는 눈금으로는 읽을 수 없다. \(B = 5{,}000\)에서 그 눈금이 \(\pm 1\%\)이니 연습문제 1의 \(1.3\%\)는 눈금 하나 안쪽이다. 검산을 더 날카롭게 하려면 \(n\)이 아니라 \(B\)를 키워야 한다. \(B = 100{,}000\)이면 눈금이 \(\pm 0.22\%\)로 줄어 그때는 \(n\) 대 \(n-1\)의 \(0.01\%\)가 여전히 보이지 않지만, 재표집 코드의 참된 결함은 드러난다.
연습문제 5. 7절의 첫 한계("표본최댓값의 경우 부트스트랩 최댓값은 언제나 관측된 최댓값 이하이다")를 끝까지 세어 보자. 서로 다른 값 \(x_{(1)} < x_{(2)} < \cdots < x_{(n)}\)으로 된 표본에서 \(M^* = \max_i X_i^*\)를 생각한다.
(1) \(\Pr_*(M^* \le x_{(k)}) = (k/n)^n\)임을 보이고, 이로부터
을 얻으시오. 특히 \(\Pr_*(M^* = x_{(n)}) = 1 - (1 - 1/n)^n \to 1 - e^{-1}\)임을 확인하시오.
(2) \(n = 4\), 표본 \(\{3, 7, 8, 12\}\)에서 \(4^4 = 256\)가지 부트스트랩 표본을 하나도 빼지 않고 열거해 (1)을 확인하고, 그 정확한 부트스트랩 분포에서 백분위수 \(95\%\) 구간을 읽으시오.
(3) 모집단이 \(\text{U}(0, \theta)\)이고 \(\theta\)를 표본최댓값으로 추정한다고 하자. 백분위수 부트스트랩 구간이 \(\theta\)를 덮을 확률은 얼마인가. \(n\)이나 \(B\)를 키우면 좋아지는가. (2)에서 본 꼭대기의 원자 질량을 근거로 답하시오.
풀이
(1) \(M^* \le x_{(k)}\)는 뽑은 \(n\)개가 모두 \(x_{(1)}, \ldots, x_{(k)}\) 안에 있다는 것과 같다. 한 번 뽑아 그 안에 들 확률이 \(k/n\)이고 \(n\)번이 독립이므로
이다. \(M^*\)는 \(x_{(1)}, \ldots, x_{(n)}\)만 값으로 가지므로 낱값의 확률은 누적확률의 차다.
\(k = n\)에서는 \(1 - (1 - 1/n)^n\)이고, \((1-1/n)^n \to e^{-1}\)이므로 극한이 \(1 - e^{-1} = 0.6321\)이다. 표본최댓값이 부트스트랩 표본에 한 번이라도 뽑힐 확률이 그것이다.
(2) 전수 열거한다.
import itertools
import numpy as np

x = np.array([3.0, 7.0, 8.0, 12.0])
n = len(x)

# 4^4 = 256 가지 부트스트랩 표본을 하나도 빼지 않고 열거한다.
maxes = [max(c) for c in itertools.product(x, repeat=n)]
vals, cnts = np.unique(maxes, return_counts=True)

print(f"부트스트랩 표본 수 = {len(maxes)} = {n}^{n}")
print(f"{'x_(k)':>7}{'도수':>7}{'확률':>11}{'(k^n-(k-1)^n)/n^n':>22}")
for k, (v, c) in enumerate(zip(vals, cnts), start=1):
    p = (k ** n - (k - 1) ** n) / n ** n
    print(f"{v:>7.1f}{c:>7d}{c / n ** n:>11.6f}{p:>22.6f}")

cdf = np.cumsum(cnts) / n ** n
print(f"\n누적확률 = {np.array2string(cdf, precision=6, floatmode='fixed')}")
lo = vals[np.searchsorted(cdf, 0.025)]
up = vals[np.searchsorted(cdf, 0.975)]
print(f"백분위수 95% 구간 = [{lo:.1f}, {up:.1f}],  표본최댓값 = {x.max():.1f}")

print(f"\n{'n':>6}{'P(max* = max)':>16}")
for m in (4, 10, 100, 1000):
    print(f"{m:>6}{1 - (1 - 1 / m) ** m:>16.6f}")
print(f"{'inf':>6}{1 - np.exp(-1):>16.6f}")
출력:
부트스트랩 표본 수 = 256 = 4^4
  x_(k)     도수         확률     (k^n-(k-1)^n)/n^n
    3.0      1   0.003906              0.003906
    7.0     15   0.058594              0.058594
    8.0     65   0.253906              0.253906
   12.0    175   0.683594              0.683594

누적확률 = [0.003906 0.062500 0.316406 1.000000]
백분위수 95% 구간 = [7.0, 12.0],  표본최댓값 = 12.0

     n   P(max* = max)
     4        0.683594
    10        0.651322
   100        0.633968
  1000        0.632305
   inf        0.632121
열거한 도수가 공식과 한 자리까지 맞는다. \(1, 15, 65, 175\)는 각각 \(1^4 - 0^4\), \(2^4 - 1^4\), \(3^4 - 2^4\), \(4^4 - 3^4\)이고 합이 \(256\)이다. 꼭대기의 질량은 \(175/256 = 0.6836\)으로 \(1 - (3/4)^4\)과 같고, \(n\)을 키우면 \(0.6513 \to 0.6340 \to 0.6323\)으로 \(1 - e^{-1} = 0.6321\)에 내려앉는다.
백분위수 구간은 누적확률 \([0.0039,\ 0.0625,\ 0.3164,\ 1]\)에서 읽는다. \(2.5\%\) 점은 누적확률이 \(0.025\)를 처음 넘는 \(x_{(2)} = 7\)이고, \(97.5\%\) 점은 \(x_{(4)} = 12\)다. 곧 \([7, 12]\)다.
(3) 포함확률은 \(0\)이다. 까닭이 둘로 갈린다.
첫째, 부트스트랩 분포의 지지집합(support)이 \(\{x_{(1)}, \ldots, x_{(n)}\}\)뿐이므로 어떤 분위점도 \(x_{(n)}\)을 넘을 수 없다. 따라서 구간의 위끝은 반드시 \(x_{(n)}\) 이하다.
둘째, 연속분포에서는 \(\Pr(x_{(n)} < \theta) = 1\)이다. 둘을 합치면 구간 전체가 확률 \(1\)로 \(\theta\)의 왼쪽에 놓인다.
\(n\)을 키워도 나아지지 않는다. 꼭대기의 원자 질량이 \(1 - (1-1/n)^n\)으로 \(n\)과 거의 무관하게 늘 \(0.63\) 부근이고, 이것이 \(\alpha/2 = 0.025\)보다 훨씬 크므로 \(97.5\%\) 분위점은 어떤 \(n\)에서도 정확히 \(x_{(n)}\)이다. \(B\)를 키우는 것도 소용없다. \(B\)는 이 정확한 분포를 더 잘 흉내 낼 뿐이고, 그 분포 자체가 \(x_{(n)}\) 위로 질량을 갖지 않는다.
이것은 수렴이 느린 문제가 아니라 부트스트랩이 아예 무너지는 자리다. 모수가 경험적 분포의 지지집합 경계에 놓여 있어서 재표집으로는 그 너머를 만들 수 없다. 옳은 길은 추축량을 손으로 찾는 것이다. \(x_{(n)}/\theta\)의 분포함수가 \(t^n\)(\(0 \le t \le 1\))이고 이것이 \(\theta\)에 의존하지 않으므로
가 포함확률 정확히 \(1-\alpha\)인 구간이다. \(n = 4\), \(\alpha = 0.05\)면 \([12,\ 12/0.05^{1/4}] = [12,\ 25.4]\)로, 부트스트랩이 준 \([7, 12]\)와는 겹치는 자리가 한 점뿐이다.
연습문제 6. 7절의 편향보정 꼴 \(2\hat\theta - \bar{\hat\theta}^*\)와 같은 뒤집기를 분위점에 적용하면 기본 구간(역백분위 구간)
이 된다. 여기서 \(\hat\theta^*_{(p)}\)는 부트스트랩 복제값의 \(p\) 분위점이다.
(1) \(\hat\theta^* - \hat\theta\)의 분포가 \(\hat\theta - \theta\)의 분포를 흉내 낸다는 가정에서 이 구간을 유도하시오. 백분위수 구간이 \([\hat\theta - a,\ \hat\theta + b]\)일 때 기본 구간이 \([\hat\theta - b,\ \hat\theta + a]\)임을 보이고, 두 구간의 폭을 견주시오.
(2) 보기 4의 자료(\(\text{Exp}(2)\)에서 \(n = 40\))에서 백분위수·기본·백분위수-\(t\)·정확 네 구간의 좌우 길이를 구하고, 네 구간의 포함확률과 빗나가는 방향을 모의로 재시오.
(3) 두 구간은 폭이 같은데 포함률이 다르다. 무엇이 그 차이를 만드는가. "기본 구간이 백분위수 구간보다 늘 낫다"고 말할 수 있는가.
풀이
(1) \(\hat\theta^*_{(p)} - \hat\theta\)는 \(\hat\theta^* - \hat\theta\)의 \(p\) 분위점이고, 가정에 따라 이것이 \(\hat\theta - \theta\)의 \(p\) 분위점을 흉내 낸다. 그러므로
이고, 가운데 \(\theta\)만 남기도록 풀면
가 나온다. 부등호의 방향이 한 번 뒤집히면서 위쪽 분위점이 아래끝으로 간다. 백분위수-\(t\)에서 위아래가 뒤집히는 것과 똑같은 뒤집기이고, 7절의 편향보정 \(2\hat\theta - \bar{\hat\theta}^*\)도 같은 꼴이다.
이제 \(a = \hat\theta - \hat\theta^*_{(\alpha/2)}\), \(b = \hat\theta^*_{(1-\alpha/2)} - \hat\theta\)로 두면 백분위수 구간이 \([\hat\theta - a,\ \hat\theta + b]\)이고 기본 구간이
다. 곧 두 구간은 \(\hat\theta\)를 거울로 한 서로의 반사이고, 폭은 둘 다 \(a + b\)로 완전히 같다. 다른 것은 긴 쪽이 어디냐 하나뿐이다.
(2) 수치적으로.
import numpy as np
from scipy import stats

rng = np.random.default_rng(0)
data = rng.exponential(2.0, 40)          # 보기 4 와 똑같은 자료
n, B = len(data), 4000
th = data.mean()
se = data.std(ddof=1) / np.sqrt(n)

rb = np.random.default_rng(101)
rs = data[rb.integers(0, n, (B, n))]
m = rs.mean(axis=1)
s = rs.std(axis=1, ddof=1) / np.sqrt(n)
a_p, b_p = np.percentile(m, [2.5, 97.5])
t_lo, t_hi = np.percentile((m - th) / s, [2.5, 97.5])
lo_c = 2 * n / stats.chi2.ppf(0.975, 2 * n)   # 정확 구간은 theta_hat 의 상수배다
up_c = 2 * n / stats.chi2.ppf(0.025, 2 * n)

cis = [("백분위수", a_p, b_p),
       ("기본", 2 * th - b_p, 2 * th - a_p),
       ("백분위수-t", th - t_hi * se, th - t_lo * se),
       ("정확", th * lo_c, th * up_c)]

print(f"theta_hat = {th:.4f},  B = {B}")
print(f"{'구간':>12}{'아래':>10}{'위':>9}{'왼쪽':>9}{'오른쪽':>10}{'오른쪽/왼쪽':>13}")
for name, a, b in cis:
    print(f"{name:>12}{a:>10.4f}{b:>9.4f}{th - a:>9.4f}{b - th:>10.4f}"
          f"{(b - th) / (th - a):>13.3f}")

# 네 구간의 포함확률을 센다. M 개의 표본을 200 개씩 묶어 한꺼번에 재표집한다.
M, Bc, theta, chunk = 50000, 500, 2.0, 200
rng2 = np.random.default_rng(2024)
names = [c[0] for c in cis]
cov = {k: 0 for k in names}
miss_lo = {k: 0 for k in names}
miss_hi = {k: 0 for k in names}
rows = np.arange(chunk)[:, None, None]
for start in range(0, M, chunk):
    mc = min(chunk, M - start)
    d = rng2.exponential(theta, (mc, n))
    thc = d.mean(axis=1)
    sec = d.std(axis=1, ddof=1) / np.sqrt(n)
    rsc = d[rows[:mc], rng2.integers(0, n, (mc, Bc, n))]
    mm = rsc.mean(axis=2)
    ss = rsc.std(axis=2, ddof=1) / np.sqrt(n)
    qa, qb = np.percentile(mm, [2.5, 97.5], axis=1)
    ta, tb = np.percentile((mm - thc[:, None]) / ss, [2.5, 97.5], axis=1)
    bands = {"백분위수": (qa, qb),
             "기본": (2 * thc - qb, 2 * thc - qa),
             "백분위수-t": (thc - tb * sec, thc - ta * sec),
             "정확": (thc * lo_c, thc * up_c)}
    for k, (a, b) in bands.items():
        cov[k] += int(np.sum((a <= theta) & (theta <= b)))
        miss_lo[k] += int(np.sum(theta < a))
        miss_hi[k] += int(np.sum(theta > b))

print(f"\nM = {M}, B = {Bc}, n = {n}, theta = {theta}"
      f"   (포함률의 몬테카를로 오차 {np.sqrt(0.93 * 0.07 / M):.4f})")
print(f"{'구간':>12}{'포함률':>10}{'왼쪽 밖':>10}{'오른쪽 밖':>11}")
for k in names:
    print(f"{k:>12}{cov[k] / M:>10.4f}{miss_lo[k] / M:>10.4f}{miss_hi[k] / M:>11.4f}")
출력:
theta_hat = 2.3157,  B = 4000
          구간        아래        위       왼쪽       오른쪽       오른쪽/왼쪽
        백분위수    1.6488   3.0741   0.6669    0.7585        1.137
          기본    1.5572   2.9826   0.7585    0.6669        0.879
      백분위수-t    1.6995   3.3739   0.6162    1.0582        1.717
          정확    1.7374   3.2414   0.5783    0.9257        1.601

M = 50000, B = 500, n = 40, theta = 2.0   (포함률의 몬테카를로 오차 0.0011)
          구간       포함률      왼쪽 밖      오른쪽 밖
        백분위수    0.9216    0.0180     0.0604
          기본    0.9096    0.0100     0.0804
      백분위수-t    0.9450    0.0215     0.0334
          정확    0.9490    0.0257     0.0254
(1)의 반사가 그대로 보인다. 백분위수 구간의 왼쪽 \(0.6669\)가 기본 구간의 오른쪽이고 거꾸로도 그렇다. 좌우 비도 \(1.137\)과 \(0.879 = 1/1.137\)로 뒤집혀 있으며, 폭은 둘 다 왼쪽과 오른쪽을 더한 \(0.6669 + 0.7585 = 1.4254\)다.
(3) 폭이 같으므로 포함률의 차이를 만드는 것은 긴 쪽이 어디냐 하나뿐이다. 정확 구간이 알려 주는 올바른 모양은 오른쪽이 왼쪽의 \(1.601\)배인 꼴이다. 까닭은 \(\bar X\)의 표집분포가 오른쪽으로 치우쳐 있어 \(\Pr(\bar X < \theta) > \tfrac12\), 곧 \(\hat\theta\)가 모수를 낮잡는 일이 더 잦기 때문이다. 그래서 오른쪽을 길게 뻗어야 한다.
| 구간 | 오른쪽/왼쪽 | 포함률 | 왼쪽 밖 | 오른쪽 밖 |
|---|---|---|---|---|
| 백분위수 | \(1.137\) | \(0.9216\) | \(0.0180\) | \(0.0604\) |
| 기본 | \(0.879\) | \(0.9096\) | \(0.0100\) | \(0.0804\) |
| 백분위수-\(t\) | \(1.717\) | \(0.9450\) | \(0.0215\) | \(0.0334\) |
| 정확 | \(1.601\) | \(0.9490\) | \(0.0257\) | \(0.0254\) |
백분위수법은 올바른 방향으로 조금(\(1.137\)) 뻗고, 기본 구간은 반대 방향으로 뻗는다(\(0.879\)). 그 대가가 오른쪽 이탈률 \(0.0604\) 대 \(0.0804\)이고 포함률 \(0.9216\) 대 \(0.9096\)이다. 몬테카를로 오차가 \(0.0011\)이니 이 차이는 실재한다. 정확 구간이 \(0.9490\)으로 명목값을 맞추는 것이 모의실험 자체의 검산이 된다.
그러나 "기본 구간이 늘 나쁘다"도 "늘 좋다"도 참이 아니다. 둘은 같은 \(1\)차 정확도를 가지며 어느 쪽이 유리한지는 통계량이 정한다. 두 방법을 가르는 성질은 오히려 단조변환에 대한 동변성이다. 백분위수 구간은 \(g\)가 증가함수일 때 \(g(\theta)\)의 구간이 정확히 원래 구간의 \(g\) 상이 되지만, 기본 구간은 \(2\hat\theta\)라는 덧셈 꼴 때문에 그렇지 않다. 곧 평균의 기본 구간을 뒤집어 비율 \(1/\theta\)의 구간을 얻을 수 없다. 왜도 자체를 고치려면 보기 4의 백분위수-\(t\)(\(0.9450\))나 BCa로 가야 한다.
연습문제 7. 보기 3은 블록 길이 \(\ell\)의 블록 부트스트랩이 겨냥하는 값이 \(c(\ell)/n\)이고
라고 했다. AR(1) 자기상관 \(\gamma_k = \rho^k\)를 그대로 쓴다.
(1) 기하급수 두 개로 합을 닫아
임을 보이시오. 모자란 몫이 \(\ell\)에 대해 \(O(1/\ell)\)로만 줄어드는 것과, 그 부호가 \(\rho\)의 부호를 따르는 것을 지적하시오.
(2) \(\rho = 0.7\)에서 \(\ell = 25\)의 \(c(\ell)\)과 \(\sqrt{c(\ell)/c(\infty)}\)를 구해 보기 3의 표와 맞추시오. 표준오차를 극한값의 \(95\%\)까지 끌어올리는 가장 작은 \(\ell\)을 구하고, \(n = 500\)에서 그것이 쓸 만한 값인지 보기 3의 결과에 비추어 판정하시오.
(3) \(\rho = -0.5\)인 AR(1)에서 순진한 부트스트랩은 표준오차를 몇 배로 틀리게 내놓는가. 연습문제 2의 결론("표준 부트스트랩이 표준오차를 과소평가한다")을 어떻게 고쳐 적어야 하는가. \(\ell = 1, 2, 3, 4, 10\)에서 \(c(\ell)\)을 구해 수렴하는 모양도 적으시오.
풀이
(1) 두 합을 따로 닫는다. \(\lvert \rho \rvert < 1\)에서
이므로
다. 앞의 두 항을 묶으면 \(\dfrac{1 + \rho - 2\rho^{\ell}}{1-\rho}\)이고, 셋째 항을 풀어 \(\rho^{\ell}\)이 붙은 것만 모으면
가 된다. 남은 것과 합치면
다. \(\square\)
첫 항은 \(c(\infty) = \dfrac{1+\rho}{1-\rho}\)로 보기 3의 극한값이고, 둘째 항이 블록을 잘라서 잃는 몫이다. \(\rho^{\ell}\)은 금세 사라지므로 모자란 몫은 사실상 \(\dfrac{2\rho}{\ell(1-\rho)^2}\), 곧 \(O(1/\ell)\)로만 줄어든다. 블록을 두 배 길게 해야 편향이 반으로 줄 뿐이다. 그리고 그 부호가 \(\rho\)의 부호를 따른다. \(\rho > 0\)이면 블록 부트스트랩이 참값을 낮잡고, \(\rho < 0\)이면 높잡는다.
(2) \(\rho = 0.7\)이면 \(c(\infty) = 1.7/0.3 = 5.6667\)이고 \(\dfrac{2\rho}{(1-\rho)^2} = \dfrac{1.4}{0.09} = 15.556\)이다. \(\ell = 25\)에서 \(\rho^{25} = 1.34\times10^{-4}\)이므로
다. 보기 3의 표에서 \(\ell = 25\)의 예측 SE가 \(0.09906\)이고 참값이 \(0.10617\)이니 그 비가 \(0.933\)인데, 예측 SE가 표본 sd \(0.9872\)를 곱해 쓰고 있으므로 \(0.9435 \times 0.9872 = 0.9315\)로 그 \(0.933\)과 맞는다. 공식이 보기 3의 표를 설명한다.
\(95\%\)를 넘기려면 \(c(\ell)/c(\infty) \ge 0.9025\)가 필요하다. \(\rho^{\ell}\)을 버리면 모자란 몫의 상대 크기가
이므로 \(\ell = 29\)가 가장 작다(\(\ell = 28\)은 \(0.9497\), \(\ell = 29\)는 \(0.9515\)).
그런데 \(n = 500\)에서 \(\ell = 29\)는 쓸 만한 값이 아니다. 보기 3은 \(\ell = 25\)에서 이미 실제 값이 예측에 못 미치고(\(0.871\) 대 \(0.933\)) \(\ell = 50\)을 넘으면 되레 내려가는 것을 보였다. 재표본 하나에 들어가는 블록이 \(n/\ell = 17\)개뿐이고 가장자리 효과가 \(\ell/n\)에 비례해 커지기 때문이다. 편향을 \(5\%\) 아래로 누르는 \(\ell\)과 분산을 지키는 \(\ell\)이 \(n = 500\)에서는 겹치지 않는다. \(\ell\)을 키우면서 \(\ell/n \to 0\)을 함께 지키려면 \(n\)을 늘리는 수밖에 없다. 블록 길이 지침이 \(n^{1/3}\)처럼 \(n\)에 따라 함께 자라는 꼴인 까닭이다.
(3) \(\rho = -0.5\)면 \(c(\infty) = 0.5/1.5 = 1/3\)이고 \(\dfrac{2\rho}{(1-\rho)^2} = \dfrac{-1}{2.25}\)이므로
다. 순진한 부트스트랩은 \(\ell = 1\), 곧 \(c = 1\)을 겨냥하므로
로 표준오차를 \(73\%\) 높잡는다. 과소평가가 아니라 과대평가다.
| \(\ell\) | \(c(\ell)\) | \(\sqrt{c(\ell)/c(\infty)}\) |
|---|---|---|
| \(1\) | \(1.00000\) | \(1.732\) |
| \(2\) | \(0.50000\) | \(1.225\) |
| \(3\) | \(0.50000\) | \(1.225\) |
| \(4\) | \(0.43750\) | \(1.146\) |
| \(10\) | \(0.37773\) | \(1.065\) |
| \(\infty\) | \(0.33333\) | \(1.000\) |
위에서 아래로 내려오지만 \(\ell = 2\)와 \(\ell = 3\)이 정확히 같다. 닫힌 꼴에서 \(\dfrac{1-(-0.5)^{\ell}}{2.25\,\ell}\)이 \(\ell = 2\)에서 \(\dfrac{0.75}{4.5}\), \(\ell = 3\)에서 \(\dfrac{1.125}{6.75}\)로 둘 다 \(1/6\)이기 때문이다. \(\rho\)가 음수면 \(\rho^{\ell}\)의 부호가 번갈아 들어 수렴이 매끄럽지 않다.
따라서 연습문제 2의 결론은 이렇게 고쳐 적어야 한다. 순진한 부트스트랩이 겨냥하는 값은 \(\gamma_0/n\)이고 참값은 \(\frac1n\sum_k \gamma_k\)다. 곧 순진한 부트스트랩은 \(\gamma_1, \gamma_2, \ldots\)를 모두 버린다. 그 합이 양수면(양의 자기상관) 표준오차를 낮잡아 구간이 좁아지는 위험한 방향으로 틀리지만, 음수면(번갈아 드는 자기상관) 높잡아 보수적인 방향으로 틀린다. 틀리는 크기는 \(\sqrt{(1-\rho)/(1+\rho)}\)이고 \(\rho = 3/5\)에서 정확히 절반, \(\rho = -0.5\)에서 \(\sqrt3\)배다. 어느 쪽이든 고치는 길은 같다. 구조를 지켜 다시 뽑는 것이다.
연습문제 8. 대응자료에서 "무엇을 다시 뽑는가"를 잘못 고르면 어떻게 되는지 잰다. 쌍 \((X_i, Y_i)\), \(i = 1, \ldots, 30\)이 \(\sigma_X = \sigma_Y = 1\), 상관 \(\rho\)인 이변량정규에서 나오고 관심은 \(\delta = \operatorname{E}[X - Y] = 0\)이다.
(1) 쌍을 지켜 첨자 하나로 두 열을 함께 뽑을 때와, 두 열에 서로 다른 첨자를 써서 따로 뽑을 때 부트스트랩이 겨냥하는 \(\operatorname{Var}(\bar X - \bar Y)\)를 각각 적고, 두 값의 비를 \(\rho\)로 나타내시오.
(2) \(\rho = 0.8,\ 0,\ -0.6\)에서 두 방법의 표준오차와 백분위수 \(95\%\) 구간의 포함률을 재시오.
(3) 쌍을 깬 쪽의 표준오차가 \(\rho\)에 거의 무관하게 나오는 까닭을 말하고, \(\rho > 0\)과 \(\rho < 0\)에서 그 잘못이 각각 어느 쪽으로 위험한지 적으시오.
풀이
(1) 쌍을 지켜 뽑으면 재표집의 단위가 차 \(D_i = X_i - Y_i\) 하나다. 연습문제 4의 정확식을 그대로 쓰면
이므로 겨냥하는 값이 \(\dfrac{2(1-\rho)}{n}\)이고, 이것이 참값이다.
두 열에 서로 다른 첨자를 쓰면 \(\bar X^*\)와 \(\bar Y^*\)가 조건부로 독립이 되어
다. 비는
로, \(\rho = 0.8\)에서 \(\sqrt5 = 2.236\)배, \(\rho = 0\)에서 \(1\)배, \(\rho = -0.6\)에서 \(1/\sqrt{1.6} = 0.791\)배다. \(\rho\)가 식에서 사라졌다는 것이 핵심이다.
(2) 수치적으로.
import numpy as np

npair, M, Bc, chunk = 30, 20000, 400, 100
rows = np.arange(chunk)[:, None, None]
print(f"M = {M} 표본,  B = {Bc},  n = {npair} 쌍,  delta = 0"
      f"   (포함률의 몬테카를로 오차 {np.sqrt(0.95 * 0.05 / M):.4f})")
print(f"{'rho':>6}{'참 SE':>9}{'쌍 SE 평균':>12}{'깬 SE 평균':>12}"
      f"{'쌍 포함률':>11}{'깬 포함률':>11}")
for rho in (0.8, 0.0, -0.6):
    rng = np.random.default_rng(777)
    se_true = np.sqrt(2 * (1 - rho) / npair)
    sp = sb = 0.0
    cp = cb = 0
    for start in range(0, M, chunk):
        mc = min(chunk, M - start)
        z1 = rng.normal(0, 1, (mc, npair))
        z2 = rng.normal(0, 1, (mc, npair))
        x, y = z1, rho * z1 + np.sqrt(1 - rho ** 2) * z2
        d = x - y
        r = rows[:mc]
        # 쌍을 지켜 뽑는다: 두 열에 같은 첨자를 쓴다
        dm = d[r, rng.integers(0, npair, (mc, Bc, npair))].mean(axis=2)
        # 쌍을 깬다: 두 열에 서로 다른 첨자를 쓴다
        bm = (x[r, rng.integers(0, npair, (mc, Bc, npair))].mean(axis=2)
              - y[r, rng.integers(0, npair, (mc, Bc, npair))].mean(axis=2))
        sp += dm.std(axis=1, ddof=1).sum()
        sb += bm.std(axis=1, ddof=1).sum()
        a, b = np.percentile(dm, [2.5, 97.5], axis=1)
        cp += int(np.sum((a <= 0) & (0 <= b)))
        a, b = np.percentile(bm, [2.5, 97.5], axis=1)
        cb += int(np.sum((a <= 0) & (0 <= b)))
    print(f"{rho:>6.1f}{se_true:>9.4f}{sp / M:>12.4f}{sb / M:>12.4f}"
          f"{cp / M:>11.4f}{cb / M:>11.4f}")
출력:
M = 20000 표본,  B = 400,  n = 30 쌍,  delta = 0   (포함률의 몬테카를로 오차 0.0015)
   rho     참 SE     쌍 SE 평균     깬 SE 평균      쌍 포함률      깬 포함률
   0.8   0.1155      0.1126      0.2524     0.9280     0.9998
   0.0   0.2582      0.2519      0.2530     0.9306     0.9369
  -0.6   0.3266      0.3188      0.2526     0.9335     0.8615
쌍을 지킨 쪽은 세 \(\rho\)에서 모두 참값의 \(97.5\%\)를 낸다. \(0.1126/0.1155 = 0.975\), \(0.2519/0.2582 = 0.976\), \(0.3188/0.3266 = 0.976\)이다. 이것은 재표집 방식의 결함이 아니라 연습문제 4가 말한 그 자리다. 부트스트랩이 겨냥하는 것은 \(\hat\sigma_D/\sqrt n\)이고 \(\operatorname{E}[\hat\sigma_D] \approx \sigma_D\sqrt{1 - 1/n}\,\left(1 - \frac1{4n}\right) = 0.975\,\sigma_D\)이므로 \(n = 30\)에서 \(2.5\%\)가 모자란 것이 맞다.
쌍을 깬 쪽은 \(\rho\)가 무엇이든 \(0.253\)을 낸다. \(0.2524\), \(0.2530\), \(0.2526\)이다. \(\rho = 0\)일 때만 맞고 나머지는 틀린다.
(3) 쌍을 깨면 부트스트랩이 보는 것은 두 주변분포뿐이다. 겨냥하는 값 \((\hat\sigma_X^2 + \hat\sigma_Y^2)/n\)에 \(\rho\)가 들어갈 자리가 없으므로, 자료에 상관이 아무리 강하게 들어 있어도 추정값은 \(\sqrt{2/30} \times 0.975 = 0.2518\) 부근에 머문다. 상관을 재지 못한 것이 아니라, 재표집 방식이 상관을 지워 버린 것이다.
| \(\rho\) | 깬 쪽/참값 | 깬 쪽 포함률 | 위험의 방향 |
|---|---|---|---|
| \(0.8\) | \(2.19\) | \(0.9998\) | 지나치게 보수적 — 검정력을 잃는다 |
| \(0.0\) | \(0.98\) | \(0.9369\) | 해롭지 않다 |
| \(-0.6\) | \(0.77\) | \(0.8615\) | 위험하다 — 명목보다 자주 틀린다 |
\(\rho > 0\)에서는 구간이 참값의 두 배 넘게 넓어져 포함률이 \(0.9998\)이 된다. 틀린 결론을 내지는 않지만 쌍으로 묶어 설계한 이득을 전부 버린다. 대응표본(paired samples) \(t\) 검정이 있는 까닭이 바로 \(\rho > 0\)을 이용하는 것이므로, 쌍을 깨는 것은 설계를 되돌리는 일이다.
\(\rho < 0\)에서는 거꾸로 구간이 좁아져 포함률이 \(0.8615\)로 떨어진다. 명목 \(95\%\)라고 적어 놓고 실제로는 \(14\%\)씩 놓치는 구간이니 이쪽이 진짜 위험한 방향이다.
쌍을 지킨 쪽의 포함률이 세 경우 모두 \(0.93\) 부근인 것은 쌍을 지킨 것과 무관한 별개의 몫이다. \(n = 30\)에서 백분위수 구간이 \(2\%\)쯤 모자라는 것인데, 보기 4가 \(n = 40\)에서 \(0.916\)을 얻은 것과 같은 결이다. 고칠 것은 구간의 종류이고, 고치지 말아야 할 것은 재표집의 단위다.
연습문제 9. 실무에서 흔히 쓰이는 경험칙 셋 — 「신뢰구간에는 \(B = 1000\), 표준오차에는 \(B \ge 500\), 극단 분위수에는 \(B \ge 5000\)」 — 을 공식으로 다시 세운다. 부트스트랩 분포가 표준편차 \(\tau\)인 정규라고 두자. 크기 \(B\) 표본의 \(p\) 분위수는 점근적으로 표준편차 \(\sqrt{p(1-p)/B}\big/f(q_p)\)로 흔들린다(\(f\)는 부트스트랩 분포의 밀도).
(1) 백분위수 구간의 아래끝(곧 \(p = \alpha/2\) 분위점)이 \(B\) 때문에 흔들리는 폭이 \(c_p\,\tau/\sqrt B\), \(c_p = \sqrt{p(1-p)}\big/\varphi(z_p)\)임을 보이고 \(p = 0.025\)에서 \(c_p\)를 구하시오. 보기 2의 \(\operatorname{SD}(\widehat{\operatorname{SE}}) = \tau/\sqrt{2B}\)와 견주면 어느 쪽이 몇 배 시끄러운가.
(2) 각 끝점의 요동을 구간 반폭 \(\lvert z_p\rvert\tau\)의 \(5\%\) 아래로 누르려면 \(B\)가 얼마여야 하는가. \(p = 0.025\)(95% 구간), \(p = 0.005\)(99% 구간), \(p = 0.001\)에서 구하고 위의 세 경험칙과 맞추시오.
(3) \(\tau\)가 식에서 사라지는 것은 무엇을 뜻하는가. 그리고 이렇게 고른 \(B\)로도 줄지 않는 오차는 무엇인가. 연습문제 3의 결과를 끌어와 답하시오.
풀이
(1) 부트스트랩 분포가 \(\mathcal N(\hat\theta, \tau^2)\)이면 \(p\) 분위점이 \(q_p = \hat\theta + z_p\tau\)이고(\(z_p = \Phi^{-1}(p)\)) 그 자리의 밀도가
다. 이것을 주어진 식에 넣으면
이다. \(p = 0.025\)에서 \(z_p = -1.9600\), \(\varphi(z_p) = 0.05844\), \(\sqrt{0.025 \times 0.975} = 0.15612\)이므로
다. 보기 2의 표준오차 쪽 요동은 \(\tau/\sqrt{2B} = 0.707\,\tau/\sqrt B\)이므로
로 끝점이 표준오차보다 \(3.8\)배 시끄럽다. 밀도가 꼬리에서 작아 같은 확률질량의 변동이 더 긴 거리로 번역되기 때문이다. 같은 상대 정밀도를 얻으려면 \(B\)를 \(3.78^2 = 14\)배 써야 한다.
(2) 조건은 \(c_p\,\tau/\sqrt B \le 0.05\,\lvert z_p\rvert\,\tau\), 곧
이다. 네 자리에서 계산하면
| \(p\) | \(\lvert z_p \rvert\) | \(\varphi(z_p)\) | \(c_p\) | 필요한 \(B\) |
|---|---|---|---|---|
| \(0.025\) | \(1.9600\) | \(0.05844\) | \(2.671\) | \(743\) |
| \(0.010\) | \(2.3263\) | \(0.02665\) | \(3.733\) | \(1{,}030\) |
| \(0.005\) | \(2.5758\) | \(0.01446\) | \(4.878\) | \(1{,}435\) |
| \(0.001\) | \(3.0902\) | \(0.00337\) | \(9.387\) | \(3{,}691\) |
이고, 표준오차 쪽은 \(\tau/\sqrt{2B} \le 0.05\,\tau\)에서 \(B \ge 200\)이다.
세 경험칙이 그대로 나온다. 표준오차에는 \(200\)이면 되니 \(B \ge 500\)은 넉넉하고, \(95\%\) 신뢰구간에는 \(743\)이 필요하니 \(B = 1{,}000\)이 맞는 자리이며, 꼬리로 더 들어가면 \(p = 0.001\)에서 \(3{,}691\)이 되어 \(B \ge 5{,}000\)이라는 말이 나온다. 경험칙은 \(\sqrt{p(1-p)}/\varphi(z_p)\)가 꼬리에서 커지는 것을 외워 둔 것이다.
(3) \(\tau\)가 약분되어 사라진 것은 필요한 \(B\)가 통계량의 크기나 단위에 전혀 의존하지 않는다는 뜻이다. 소득이든 상관계수든 같은 \(B\)면 같은 상대 정밀도를 얻는다. 다만 사라진 것은 척도뿐이고 모양은 남는다. \(c_p\)는 \(\varphi\)를 분모에 두고 있으므로, 부트스트랩 분포가 정규보다 꼬리가 두껍거나 치우쳐 그 자리의 밀도가 더 작으면 \(c_p\)가 커지고 필요한 \(B\)도 커진다. 위 표는 정규일 때의 하한으로 읽어야 한다.
그러나 이렇게 고른 \(B\)로도 손대지 못하는 오차가 있다. \(B\)는 이상적인(\(B = \infty\)) 부트스트랩 분포를 얼마나 잘 흉내 내는지만 정하고, 그 이상적인 분포가 참 표집분포와 얼마나 다른지는 표본크기 \(n\)이 정한다. 보기 1이 그것을 보였다. 중앙값의 부트스트랩 SE \(755.79\)와 이론값 \(707.11\)의 차 \(48.7\)은 \(B = 1{,}000\)의 요동 \(16.9\)로 설명되지 않는다.
연습문제 3이 더 극단적인 경우다. \(n = 200\)에서 \(99\)번째 백분위수의 부트스트랩 복제값 \(5{,}000\)개가 서로 다른 값을 \(60\)가지밖에 갖지 못했다. 이상적인 부트스트랩 분포 자체가 원자 몇십 개에 얹힌 이산분포이므로 \(B\)를 \(10^6\)으로 키워도 그 원자들의 질량을 더 정확히 세는 데 그친다. 포함률 \(0.857\)은 \(B\)의 몫이 아니라 \(n\)의 몫이고, 고치려면 재표집 방식을 바꾸어야 한다(모수적 부트스트랩, 평활 부트스트랩, 극단값 이론).
요점. \(B\)가 주는 오차는 공식으로 값을 매길 수 있고 계산시간으로 살 수 있다. \(n\)이 주는 오차는 둘 다 안 된다. 두 오차를 가려 적지 않은 부트스트랩 보고서는 읽는 이를 속인다.
연습문제 10. 7절의 넷째 함정("편향보정을 하려면 \(2\hat\theta - \bar{\hat\theta}^*\)를 계산해야 하며, 그러면 분산이 커진다")을 수로 확인한다. \(\text{Exp}(1)\)에서 \(n = 101\)을 뽑아 표본중앙값으로 모중앙값 \(\ln 2\)를 추정한다.
(1) 지수분포의 순서통계량은 \(\operatorname{E}[X_{(k)}] = \sum_{j=n-k+1}^{n} 1/j\)를 만족한다. \(n = 101\)에서 표본중앙값의 정확한 편향을 구하고, 점근 표준오차 \(1/(2\sqrt n\,f(m))\)과의 비를 3절의 경험칙 \(0.25\)와 견주시오.
(2) 부트스트랩 편향추정 \(\hat b = \bar{\hat\theta}^* - \hat\theta\)의 몬테카를로 요동은 \(\widehat{\operatorname{SE}}/\sqrt B\)쯤이다. 그것을 참 편향의 절반 아래로 누르는 \(B\)를 구하시오.
(3) \(M = 20{,}000\)개의 표본에서 \(\hat\theta\)와 \(\tilde\theta = 2\hat\theta - \bar{\hat\theta}^* = \hat\theta - \hat b\)의 편향·표준편차·RMSE를 재어 보정이 이득인지 판정하시오. \(\operatorname{Var}(\tilde\theta) = \operatorname{Var}(\hat\theta) + \operatorname{Var}(\hat b) - 2\operatorname{Cov}(\hat\theta, \hat b)\)로 갈라 어디서 손해가 나는지 짚으시오.
풀이
(1) \(\text{Exp}(1)\)의 중앙값은 \(m = \ln 2 = 0.693147\)이고 그 자리의 밀도가 \(f(m) = e^{-\ln 2} = 1/2\)이므로 점근 표준오차가
다. \(n = 101\)은 홀수이므로 표본중앙값이 \(X_{(51)}\)이고
이다. 곧 정확한 편향이 \(0.698073 - 0.693147 = +0.004926\)이다. 그 비가
로 경험칙 \(0.25\)를 다섯 배나 밑돈다. 보기 1의 \(37/756 = 0.05\)와 거의 같은 자리다. 편향은 무시해도 좋다는 뜻이고, 그러면 굳이 보정할 까닭도 없다.
(2) \(\widehat{\operatorname{SE}}/\sqrt B < 0.004926/2 = 0.002463\)에서
이다. \(B\)를 \(1{,}600\) 넘게 써야 편향추정이 참 편향의 절반보다 조용해진다. 신뢰구간용 권장값 \(B = 1{,}000\)으로도 모자란다. 편향이 작을수록 그것을 재는 데 드는 \(B\)가 커진다.
(3) 수치적으로.
import numpy as np

n = 101
m_pop = np.log(2)
e_med = (1.0 / np.arange((n + 1) // 2, n + 1)).sum()   # Exp(1) 의 E[X_(51)]
bias_true = e_med - m_pop
se_as = 1 / (2 * np.sqrt(n) * 0.5)                     # f(m) = 1/2
print(f"n = {n}:  E[표본중앙값] = {e_med:.6f},  ln 2 = {m_pop:.6f}")
print(f"참 편향 = {bias_true:.6f},  점근 SE = {se_as:.6f},"
      f"  편향/SE = {bias_true / se_as:.4f}")
for B in (200, 500, 2000):
    print(f"  B = {B:>4}: b_hat 의 몬테카를로 요동 SE/sqrt(B) = {se_as / np.sqrt(B):.6f}")

M, B, chunk = 20000, 500, 200
rng = np.random.default_rng(31)
rows = np.arange(chunk)[:, None, None]
th_all, bh_all = [], []
for start in range(0, M, chunk):
    mc = min(chunk, M - start)
    d = rng.exponential(1.0, (mc, n))
    th = np.median(d, axis=1)
    star = np.median(d[rows[:mc], rng.integers(0, n, (mc, B, n))], axis=2)
    th_all.append(th)
    bh_all.append(star.mean(axis=1) - th)
th = np.concatenate(th_all)
bh = np.concatenate(bh_all)
tc = th - bh

print(f"\nM = {M} 표본,  B = {B}")
print(f"b_hat: 평균 {bh.mean():.6f}  (참 편향 {bias_true:.6f}),"
      f"  SD {bh.std(ddof=1):.6f}")
print(f"  그 가운데 B 탓인 몫 {se_as / np.sqrt(B):.6f},"
      f"  corr(theta_hat, b_hat) = {np.corrcoef(th, bh)[0, 1]:.4f}")
print(f"{'추정량':>14}{'평균':>10}{'편향':>10}{'SD':>10}{'RMSE':>10}")
for name, v in [("보정 안 함", th), ("편향보정", tc)]:
    print(f"{name:>14}{v.mean():>10.5f}{v.mean() - m_pop:>10.5f}"
          f"{v.std(ddof=1):>10.5f}{np.sqrt(((v - m_pop) ** 2).mean()):>10.5f}")
print(f"RMSE 비 (보정/보정 안 함) = "
      f"{np.sqrt(((tc - m_pop) ** 2).mean()) / np.sqrt(((th - m_pop) ** 2).mean()):.4f}")
출력:
n = 101:  E[표본중앙값] = 0.698073,  ln 2 = 0.693147
참 편향 = 0.004926,  점근 SE = 0.099504,  편향/SE = 0.0495
  B =  200: b_hat 의 몬테카를로 요동 SE/sqrt(B) = 0.007036
  B =  500: b_hat 의 몬테카를로 요동 SE/sqrt(B) = 0.004450
  B = 2000: b_hat 의 몬테카를로 요동 SE/sqrt(B) = 0.002225

M = 20000 표본,  B = 500
b_hat: 평균 0.005130  (참 편향 0.004926),  SD 0.021969
  그 가운데 B 탓인 몫 0.004450,  corr(theta_hat, b_hat) = -0.3159
           추정량        평균        편향        SD      RMSE
        보정 안 함   0.69816   0.00501   0.09989   0.10002
          편향보정   0.69303  -0.00012   0.10885   0.10884
RMSE 비 (보정/보정 안 함) = 1.0883
부트스트랩 편향추정은 제 일을 한다. \(\hat b\)의 평균 \(0.005130\)이 (1)에서 손으로 구한 \(0.004926\)과 맞고(\(M = 20{,}000\)에서 그 평균의 요동이 \(0.0220/\sqrt{20000} = 0.00016\)이니 차 \(0.0002\)는 그 한 자리 안이다), 보정한 추정량의 편향이 \(+0.00501\)에서 \(-0.00012\)로 사라졌다.
그런데 RMSE는 나빠졌다.
| 추정량 | 편향 | SD | RMSE |
|---|---|---|---|
| 보정 안 함 \(\hat\theta\) | \(+0.00501\) | \(0.09989\) | \(0.10002\) |
| 편향보정 \(\tilde\theta\) | \(-0.00012\) | \(0.10885\) | \(0.10884\) |
RMSE가 \(8.8\%\) 늘었다. 분산으로 갈라 보면
이고 둘을 \(\operatorname{Var}(\hat\theta) = 0.09989^2 = 0.009978\)에 더하면 \(0.011847\)이다. 제곱근이 \(0.10884\)로 잰 SD \(0.10885\)와 맞는다. 보탠 분산 \(0.001869\)는 지운 편향제곱 \(0.004926^2 = 0.0000243\)의 \(77\)배다. 손익이 뒤집힐 수가 없다.
손해가 둘로 갈라지는 것도 보인다. \(\hat b\) 자체의 분산이 \(0.000483\)이고, \(\hat\theta\)와 \(\hat b\)가 \(-0.32\)로 거꾸로 움직이는 탓이 \(0.001386\)으로 그 세 배다. \(\hat b\)를 \(\hat\theta\)와 같은 표본에서 만들었으므로 둘이 독립일 수 없고, 여기서는 그 얽힘이 오차를 지우는 쪽이 아니라 키우는 쪽으로 붙었다.
\(B\)를 키워도 구제되지 않는다. \(\hat b\)의 SD \(0.021969\) 가운데 \(B\) 탓인 몫은 \(0.004450\)뿐이므로, \(B = \infty\)에서도 \(\sqrt{0.021969^2 - 0.004450^2} = 0.02151\)이 남는다. 이것은 \(\hat b\)가 표본마다 달라지는 몫이고 \(n\)이 정한다. 참 편향 \(0.004926\)의 네 배가 넘는 요동이니, \(\hat b\)는 편향을 재는 자가 아니라 잡음을 재는 자에 가깝다.
그러므로 편향보정은 조건이 맞을 때만 해야 한다. 3절의 경험칙 \(\lvert \hat b \rvert / \widehat{\operatorname{SE}} > 0.25\)를 넘고, 또 \(\hat b\) 자신이 참 편향보다 조용할 만큼 \(B\)가 클 때다(여기서는 (2)의 \(B > 1{,}632\)). 둘 중 하나라도 어긋나면 보정은 편향을 잡음과 맞바꾸는 일이 된다. 7절의 "편향을 추정할 수 있지만 자동으로 고쳐 주지는 않는다"는 말은 고치지 않는 편이 나을 때가 많다는 뜻으로 읽어야 한다.
정리하며
부트스트랩은 현대 통계학의 기초 도구이다.
- 자료에서 재표집한다는 직관적인 방법이다.
- 임의의 통계량과 임의의 분포에 널리 적용된다.
- 현대의 계산력으로 충분히 감당할 수 있다.
- 분포무관이며 가정이 최소한이다.
강한 모수적 가정을 피하는 대가로 계산량을 지불하므로, 이론 기반 방법이 부적절하거나 존재하지 않을 때 매우 값지다.
다음 절부터 백분위수법으로 넘어간다. 17.1절이 재표집으로 표집분포를 얻었다면, 17.2절은 그 분포에서 구간을 읽는 법 네 가지를 견준다. 가장 단순한 것부터 시작한다.