이탈도와 적합도
1. 로지스틱에는 잔차제곱합이 없다
선형회귀(linear regression)에는 잔차제곱합이 있어 적합도(goodness of fit)를 한 수로 적는다. 로지스틱에는 그것이 없어 「이탈도가 \(399.40\) 에서 \(246.84\) 로 줄었다」는 식으로 적고, 그 차 \(152.57\) 이 곧 가능도비(likelihood ratio) 통계량이다. 그런데 같은 이탈도를 「모형이 자료에 맞는가」를 묻는 적합도 검정(goodness-of-fit test)에 그대로 쓰면 명목 \(5\%\) 에서 실제 기각률이 \(0.513\) 이 되는 자리가 있다. 옳은 모형을 절반 넘게 기각하는 것이다. 이탈도가 무엇을 재고 무엇을 재지 못하는가.
선형회귀에서는 잔차제곱합이 모형의 적합 정도를 잰다. 로지스틱 회귀(logistic regression, 더 넓게는 일반화선형모형(generalized linear model))에서 이에 대응하는 양이 이탈도다. 이탈도는 적합모형의 로그가능도를 완벽한 모형의 로그가능도와 비교하여 전체 적합도를 하나의 수로 요약한다. 내포모형 사이의 이탈도 차이는 근사적으로 카이제곱 분포를 따르므로 형식적 가설검정이 가능하다.
2. 포화모형
포화모형은 관측치마다 모수를 하나씩 두어 자료를 그대로 재현한다. 즉 \(\hat{p}_i^{\text{sat}} = y_i\)이며, 그 로그가능도는 도달 가능한 최댓값이다. 이항 반응변수 (\(y_i \in \{0,1\}\))에서는 로그가능도의 각 항이 \(\log 1 = 0\)이므로
이다. 여기서 \(0 \log 0 = 0\)이라는 관례를 따른다.
3. 이탈도의 정의
예측확률이 \(\hat{p}_i\)인 적합모형의 이탈도는
이다. 이항 자료에서는 \(\ell_{\text{sat}} = 0\)이므로 이탈도는 적합모형 로그가능도의 \(-2\)배로 단순해진다. 전개하면
이다. 이탈도가 작을수록 적합이 좋다.
그림으로 보는 통계학 1. 한 해에 둘을 내놓고
이탈도라는 말은 1972 년에 처음 쓰였다. 존 넬더와 로버트 웨더번이 『JRSS-A』에 낸 「일반화선형모형」에서다. 그 논문이 한 일은 새 모형을 하나 더 만든 것이 아니라, 이미 있던 것들이 사실은 하나임을 보인 것이다.
그때까지 선형회귀, 로지스틱 회귀, 프로빗, 포아송 회귀, 분할표의 로그선형모형은 따로따로 배우고 따로따로 계산하는 별개의 기법이었다. 넬더와 웨더번은 그것들이 조각 세 개로 이루어진 같은 틀임을 적었다.
바꾸는 것은 \(g\) 와 \(V\) 뿐이다. 맞추는 절차는 전부 같다 — 반복재가중최소제곱이다. 그리고 적합도를 재는 자도 하나로 통일되었는데, 그것이 위 식의 이탈도다. 정규분포 가족에서는 이탈도가 잔차제곱합과 정확히 같아진다.
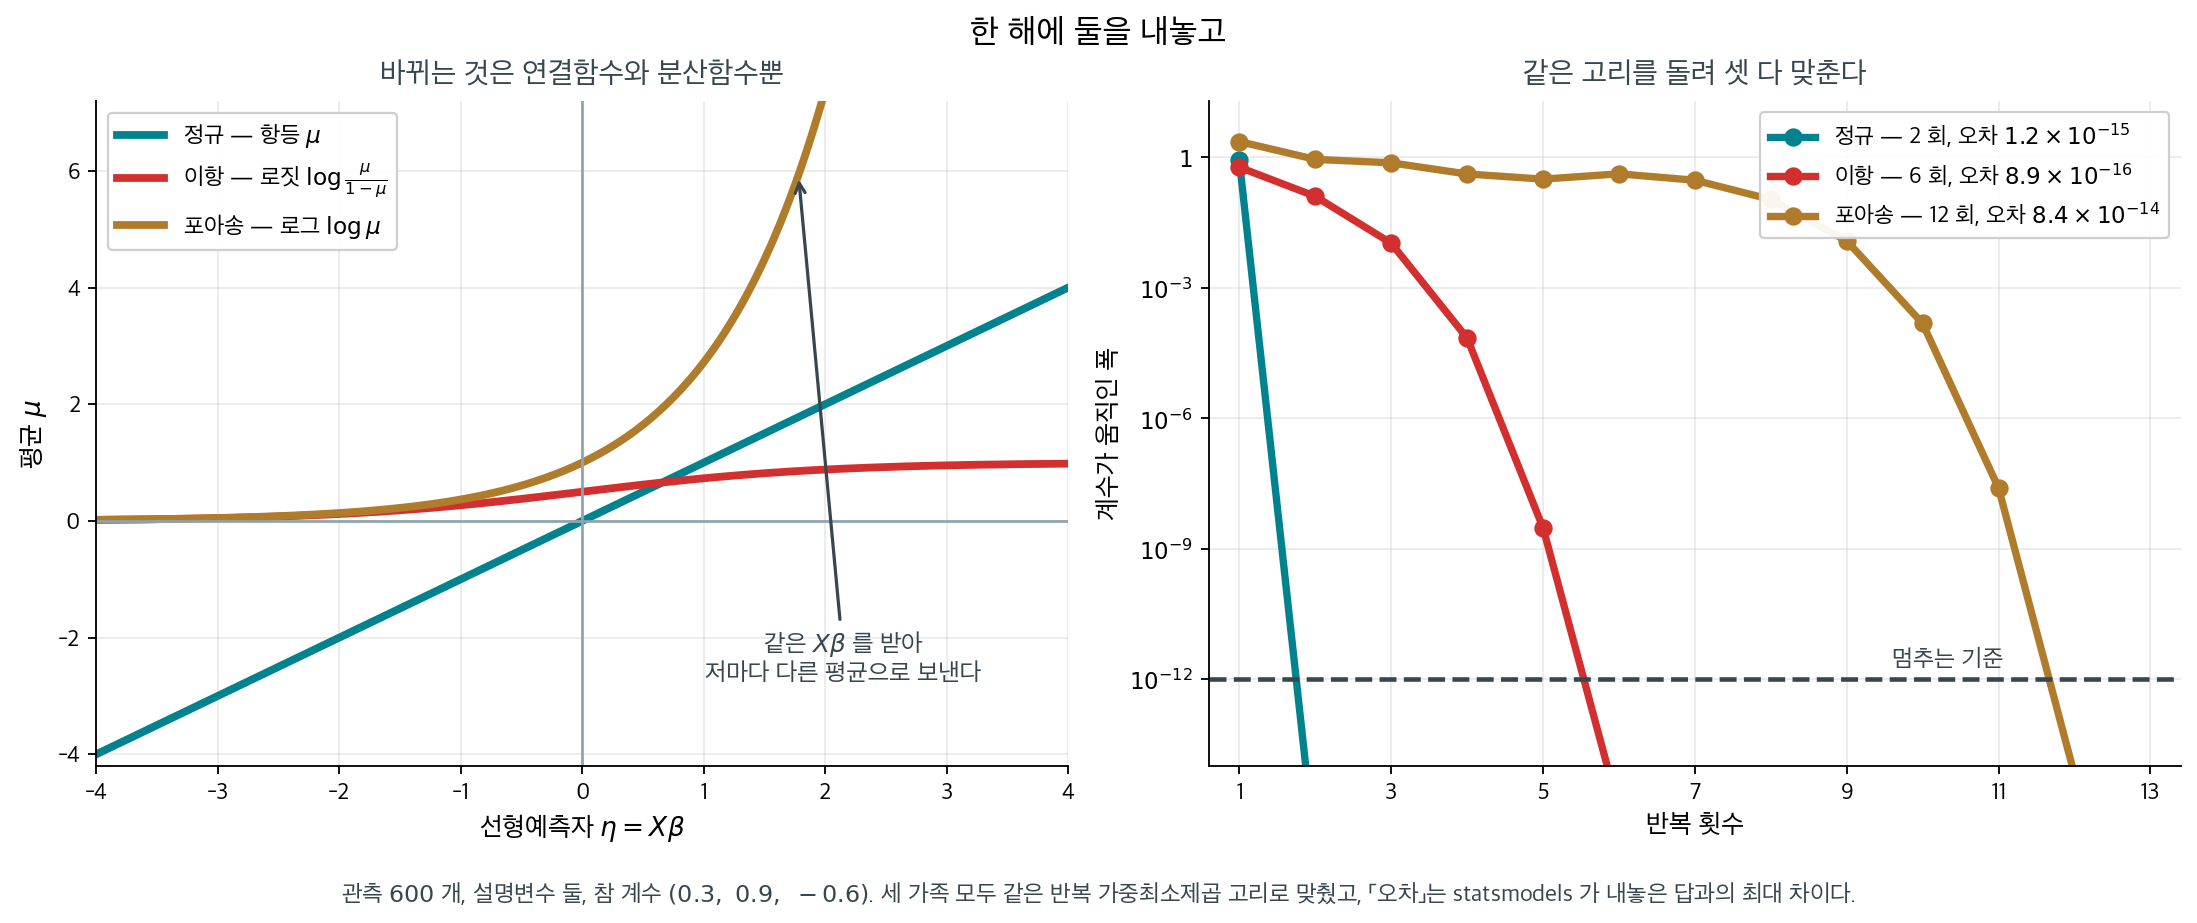
관측 \(600\) 개, 설명변수(explanatory variable) 둘. 세 가족을 반복재가중최소제곱 고리 하나로 맞췄고, 「오차」는 statsmodels 가 내놓은 답과의 최대 차이다.
말로만 하면 믿기 어려우니 재 보았다. 반복재가중최소제곱을 한 번만 적어 놓고 연결함수와 분산함수만 갈아 끼워 세 가족에 그대로 돌린 결과다.
| 가족 | 연결함수 | 분산함수 \(V(\mu)\) | 반복 | statsmodels 와의 차이 |
|---|---|---|---|---|
| 정규 | \(\mu\) | \(1\) | \(2\) 회 | \(1.2 \times 10^{-15}\) |
| 이항 | \(\log\dfrac{\mu}{1-\mu}\) | \(\mu(1-\mu)\) | \(6\) 회 | \(8.9 \times 10^{-16}\) |
| 포아송 | \(\log \mu\) | \(\mu\) | \(12\) 회 | \(8.4 \times 10^{-14}\) |
같은 코드다. 바꾼 것은 함수 두 개뿐이고, 셋 다 같은 답에 닿는다. 이 통일이 있었기에 통계
꾸러미에 glm() 이라는 함수 하나가 있고, 그 안에 family= 인자가 있다.
웨더번은 그 뒤로 오래 일하지 못했다. 1974 년에 준가능도를 — 분포를 다 적지 않고 평균과 분산함수만으로 추정하는 방법을 — 내놓았고, 1975 년 6 월 운하 여행 중에 벌레에 쏘여 과민성 쇼크로 세상을 떠났다. 스물여덟 살이었다. 넬더가 같은 학회지에 부고를 썼다.
덧붙이자면 그가 일하던 곳은 로담스테드 농업시험장이다. 반세기 전에 피셔가 묵은 수확 기록을 들여다보며 분산분석(analysis of variance)을 세운 바로 그 시험장이다.
확인한 곳 — 넬더와 웨더번의 「Generalized Linear Models」(\(1972\), 『JRSS-A』)와, 웨더번(\(1947\)–\(1975\) 년 \(6\) 월)이 로담스테드에서 일하며 \(1974\) 년에 준가능도를 내놓았고 운하 여행 중 벌레에 쏘여 과민성 쇼크로 스물여덟에 세상을 떠난 것, 넬더가 『JRSS-A』 \(138\) 권 \(4\) 호 \(587\) 쪽에 부고를 쓴 것. 표의 수는 모두 직접 돌린 값이다
4. 영이탈도와 잔차이탈도
영이탈도
영모형은 절편(intercept)만 포함한다. 즉 모든 \(i\)에 대해 \(\hat{p}_i = \bar{y}\)이며, 그 이탈도는
이다.
잔차이탈도
잔차이탈도 \(D\)는 전체 적합모형(절편과 \(p-1\)개 설명변수)의 이탈도다. 차이 \(D_0 - D\)는 설명변수가 절편만 있는 경우보다 적합을 얼마나 개선했는지를 잰다.
설명된 이탈도의 비율
선형회귀의 \(R^2\)에 빗대어
를 정의한다. 맥패든 유사 \(R^2\)라고도 하며 0과 1 사이의 값을 갖는다. 로지스틱 모형에서는 0.2에서 0.4 사이면 만족스럽다고 보는 경우가 많다.
5. 이탈도 잔차
전체 이탈도는 관측치별 기여로 분해되며, 이를 이탈도 잔차라 한다.
그러면 \(D = \sum_{i=1}^{n} d_i^2\)이다. 이탈도 잔차는 원잔차(\(y_i - \hat{p}_i\))보다 선호되는데, 모형이 옳을 때 그 분포가 표준정규에 더 가까워 진단 그림을 해석하기 쉽기 때문이다.
이탈도를 눈으로 보기
이탈도는 정의가 두 겹이라 감이 잘 잡히지 않는다. 포화모형과의 비교이면서 동시에 관측치별 기여의 합이기도 하다. 19.1절의 공부 시간 자료 300건에 적합한 결과로 두 얼굴을 함께 그려 보았다.
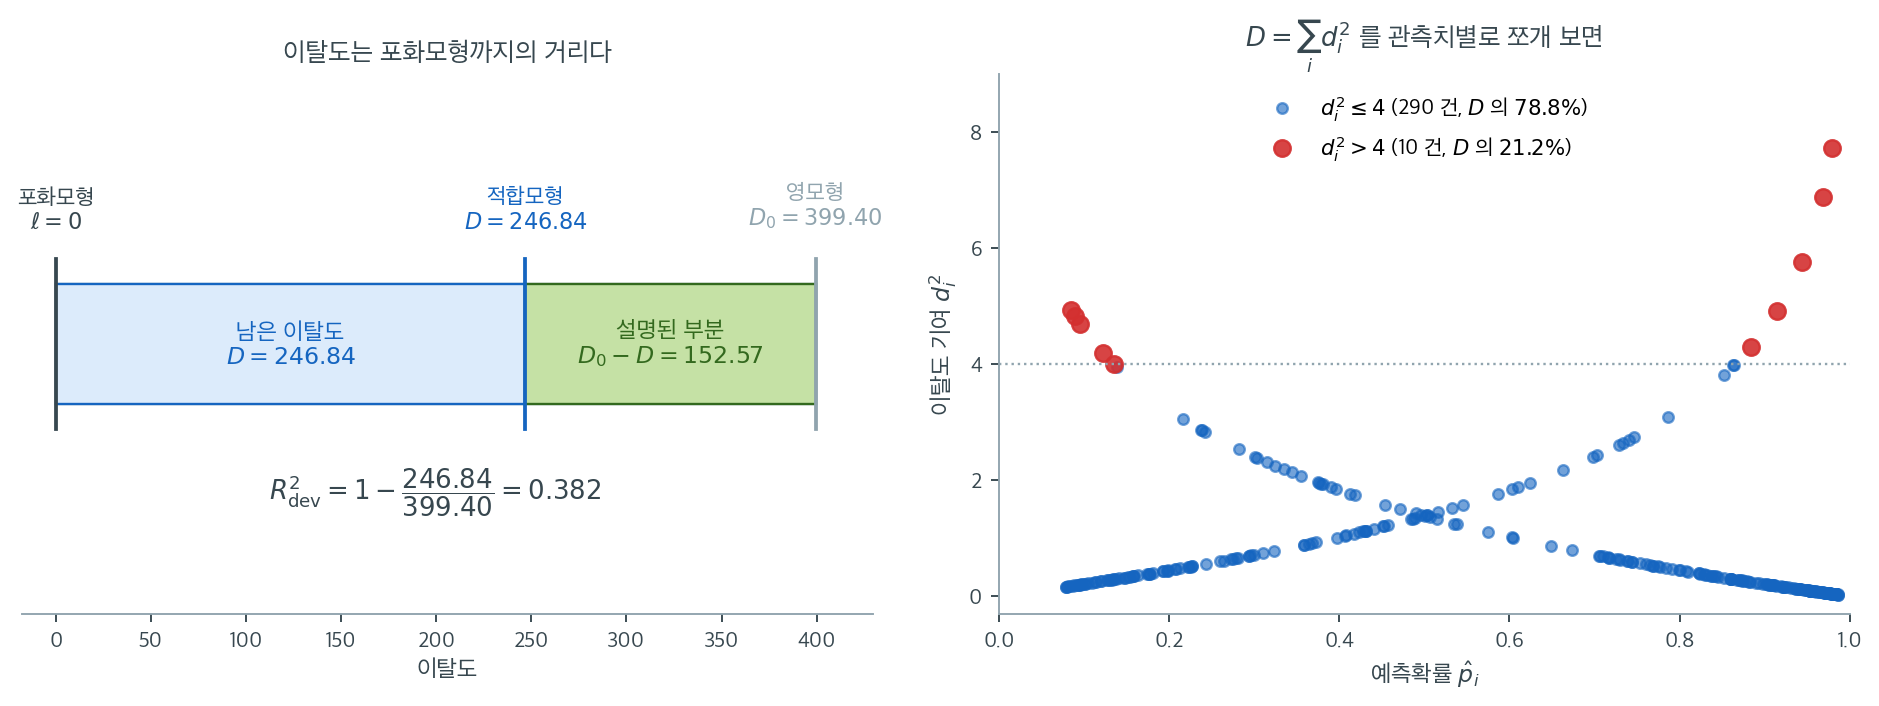
왼쪽이 첫 번째 얼굴이다. 오른쪽 끝의 영모형은 \(D_0 = 399.40\), 왼쪽 끝의 포화모형은 \(0\)이다. 이 구간이 설명 가능한 전부이며, 공부 시간 하나를 넣은 모형이 그중 \(D_0 - D = 152.57\)만큼을 가져와 \(D = 246.84\)에 도착했다. 맥패든 유사 \(R^2\)는 바로 이 초록 칸의 비율, \(1 - 246.84/399.40 = 0.382\)다. 그리고 이 \(152.57\)이라는 숫자는 로지스틱 회귀 실습에서 가능도비 검정 통계량으로 보고된 값과 같은 수다. 이탈도의 차이와 가능도비 통계량은 이름이 둘일 뿐 같은 양이다.
오른쪽이 두 번째 얼굴이다. \(D = \sum_i d_i^2\)이므로 이탈도는 300개의 조각으로 쪼개진다. 대부분의 점은 바닥에 깔려 있다. \(d_i^2 > 4\)인 관측치는 10건뿐인데 이들이 \(D\)의 \(21.2\%\)를 차지하고, \(d_i^2 \le 4\)인 나머지 290건이 \(78.8\%\)를 나눠 갖는다. 흩어진 모양이 V자인 것도 눈여겨볼 만하다. 왼쪽 위로 뻗은 붉은 점들은 \(\hat p\)가 낮은데 합격한 학생이고, 오른쪽 위로 뻗은 점들은 \(\hat p\)가 높은데 불합격한 학생이다. 즉 이탈도를 키우는 것은 언제나 모형이 확신했는데 틀린 관측치다.
이 분해가 진단의 출발점이다. 잔차이탈도가 자유도에 비해 크다면 다음 질문은 "전체적으로 나쁜가, 아니면 몇 건이 끌고 가는가"이며, 오른쪽 같은 그림이 그 답을 바로 준다. 몇 건이 지배한다면 모형을 바꾸기 전에 그 관측치들을 먼저 들여다보아야 한다.
6. 적합도 검정
적합모형이 옳고 자료에 체계적인 부적합이 없다는 귀무가설(null hypothesis) 아래에서 잔차이탈도는 근사적으로
를 따른다. 여기서 \(p\)는 추정된 모수의 개수다. 자유도 \(n - p\)에 비해 이탈도가 크면 모형이 자료를 적절히 기술하지 못한다는 신호다.
근사가 실패하는 경우
잔차이탈도의 카이제곱 근사는 묶인 자료(grouped data, 각 공변량 패턴에 여러 관측치가 있는 자료)를 전제한다. 연속형 설명변수를 갖는 묶이지 않은 이항 자료에서는 공변량 패턴이 모두 유일하여 근사가 무너진다. 이 경우에는 보정과 브라이어 점수에서 다루는 호스머–레메쇼 검정을 쓴다. 연습문제 3에서 이 실패를 모의실험으로 확인한다.
7. 이탈도를 이용한 가능도비 검정
설명변수의 부분집합이 모형을 개선하는지 검정하려면, 축소모형(이탈도 \(D_{\text{red}}\), 모수 \(p_0\)개)과 전체모형(이탈도 \(D_{\text{full}}\), 모수 \(p_1\)개)을 비교한다.
이는 추가된 설명변수의 계수가 모두 0이라는 귀무가설 아래에서 성립한다. 이것이 가능도비 검정 이며, 내포된 로지스틱 회귀 모형을 비교하는 표준적인 방법이다.
보기
절편만 있는 영모형의 이탈도가 자유도 99에서 \(D_0 = 120.5\)라고 하자. 설명변수 두 개를 추가하면(\(p_1 = 3\)) 자유도 97에서 \(D = 85.3\)이 된다.
검정통계량(test statistic)은 \(\Delta D = 120.5 - 85.3 = 35.2\)이고 자유도는 \(p_1 - p_0 = 2\)이다. \(\chi^2_2\)와 비교하면,
- \(\alpha = 0.05\)의 임계값은 \(5.99\)이다.
- \(35.2 \gg 5.99\)이므로 귀무가설을 기각하고, 두 설명변수가 모형을 유의하게 개선한다고 결론짓는다.
맥패든 유사 \(R^2\)는 \(1 - 85.3/120.5 \approx 0.29\)로 중간 정도의 개선을 나타낸다.
8. 편차에서 갈라져 나온 양들
| 양 | 공식 | 해석 |
|---|---|---|
| 이탈도 | \(D = -2\,\ell_{\text{fitted}}\) | 전체적인 부적합 |
| 영이탈도 | \(D_0 = -2\,\ell_{\text{null}}\) | 절편만 있는 모형의 적합 |
| \(\Delta D\) | \(D_{\text{red}} - D_{\text{full}}\) | 추가 설명변수에 의한 개선 |
| 이탈도 잔차 | \(d_i = \operatorname{sign}(y_i - \hat{p}_i)\sqrt{-2[\cdots]}\) | 관측치별 기여 |
| 맥패든 \(R^2\) | \(1 - D/D_0\) | 설명된 이탈도의 비율 |
연습문제
연습문제 1. \(n = 100\)이고 그중 30건이 사건인 자료의 영이탈도 \(D_0\)을 계산하라. 이 값이 가능도 절 연습문제 3의 결과와 어떻게 연결되는가?
풀이
영모형은 \(\hat p_i = \bar y = 0.3\)이므로
이다.
연결: 19.1절 로지스틱 회귀의 가능도 연습문제 3 에서 절편만 있는 모형의 최소 교차엔트로피가 \(\ell_{\min} = n\,H(\bar y)\)임을 보았다. \(D_0 = 2\,\ell_{\min} = 2n H(\bar y)\)이므로
으로 정확히 일치한다. 즉 영이탈도는 결과 자체의 엔트로피를 \(2n\)배 한 것이다. 모형이 쓸모 있으려면 이보다 이탈도를 낮춰야 하고, 낮출 수 있는 폭은 애초에 \(y\)가 얼마나 예측 불가능 했는지에 달려 있다. 사건이 아주 드물면(\(\bar y = 0.01\)) \(H(\bar y)\)가 작아 \(D_0\) 자체가 작고, 맥패든 \(R^2\)의 분모도 작아진다. \(\square\)
연습문제 2. \(D = \sum_{i=1}^n d_i^2\)임을 확인하라. 이탈도 잔차 앞의 부호함수가 왜 필요한지 설명하라.
풀이
정의에 의해
이고 \([\operatorname{sign}(\cdot)]^2 = 1\)이므로
이다. 제곱근 안의 값이 음수가 아님도 확인해야 한다. \(\hat p_i \in (0,1)\)이므로 대괄호 안은 음수이고, \(-2\)를 곱하면 양수가 된다.
부호함수가 필요한 이유: 제곱근 자체는 언제나 음이 아니므로, 부호가 없으면 모든 잔차가 양수가 되어 과대예측과 과소예측을 구분할 수 없다. 잔차 그림의 요점은 체계적 편향을 찾는 것인데, 부호가 없으면 \(\hat p_i\)가 너무 큰 구간과 너무 작은 구간이 똑같아 보인다. \(\operatorname{sign}(y_i - \hat p_i)\)를 붙이면 \(y_i = 1\)인데 \(\hat p_i\)가 작을 때 잔차가 양수, \(y_i = 0\)인데 \(\hat p_i\)가 클 때 음수가 되어 최소제곱의 원잔차와 같은 방식으로 읽힌다. \(\square\)
연습문제 3. 묶이지 않은 이항 자료에서 \(D \dot\sim \chi^2_{n-p}\) 근사가 실패함을 모의실험으로 보여라. 옳은 모형을 반복해서 적합하고 잔차이탈도의 분포를 \(\chi^2_{n-p}\)와 비교하라.
풀이
import numpy as np
import statsmodels.api as sm
from scipy import stats

rng = np.random.default_rng(3)
n, reps = 200, 300
Ds = []
for _ in range(reps):
    x = rng.normal(size=n)
    p = 1 / (1 + np.exp(-(0.5 + 1.0 * x)))
    y = (rng.random(n) < p).astype(float)
    m = sm.Logit(y, sm.add_constant(x)).fit(disp=0)
    Ds.append(-2 * m.llf)

Ds = np.array(Ds)
print(f"n - p          = {n - 2}")
print(f"mean D         = {Ds.mean():.1f}   sd = {Ds.std(ddof=1):.1f}")
print(f"chi2_198       : mean = 198   sd = {np.sqrt(2 * 198):.1f}")
print(f"reject rate at .05 = {np.mean(stats.chi2.sf(Ds, 198) < 0.05):.3f}")
출력:
n - p          = 198
mean D         = 231.3   sd = 12.4
chi2_198       : mean = 198   sd = 19.9
reject rate at .05 = 0.513
| 양 | 모의실험 | \(\chi^2_{198}\)이 예측하는 값 |
|---|---|---|
| 평균 \(D\) | \(231.3\) | \(198\) |
| 표준편차 \(D\) | \(12.4\) | \(19.9\) |
| \(\alpha = 0.05\) 기각률 | \(0.513\) | \(0.05\) |
모형이 완벽히 옳은데도 적합도 검정이 51%의 경우에 기각한다. 평균은 너무 크고 분산은 너무 작다. 근사가 평균에서도 분산에서도 틀린 것이다.
이유: 카이제곱 근사는 각 공변량 패턴의 관측치 수가 커질 때 성립하는 점근 결과다. \(x\)가 연속형이면 200개의 공변량 패턴이 모두 서로 다르고 각각 관측치가 하나뿐이므로, \(n\)을 아무리 키워도 이 점근에 도달하지 못한다. 실제로 이때 \(D\)는 모수뿐 아니라 자료의 개별 배치에도 의존하며 자유도 개념이 무의미해진다.
실무적 함의: 묶이지 않은 이항 자료에서 잔차이탈도를 \(\chi^2_{n-p}\)와 비교하지 말라. 호스머–레메쇼 검정처럼 예측확률을 구간으로 묶는 방법이나 보정 곡선을 쓰라. 반면 이탈도의 차이 \(\Delta D\)는 여전히 유효하다. 두 모형이 같은 자료에 적합되어 있으면 포화모형 항이 소거되어 점근 이론이 성립하기 때문이다. 이것이 잔차이탈도 자체는 못 믿어도 LRT는 믿을 수 있는 이유다. \(\square\)
연습문제 4. 맥패든 유사 \(R^2\)가 잘 맞는 모형에서도 왜 선형회귀의 \(R^2\)보다 훨씬 작게 나오는지 설명하라. 0.29라는 값을 어떻게 읽어야 하는가?
풀이
맥패든 \(R^2 = 1 - D/D_0\)은 분산이 아니라 로그가능도의 비율이다. 두 척도는 다른 것을 센다.
핵심은 \(D\)가 0에 가까워지려면 예측확률이 거의 0 또는 1이어야 한다는 데 있다. 모든 \(\hat p_i\)를 정확히 맞혀도, 참 확률이 \(0.5\) 근처인 관측치가 있으면 \(D\)는 0으로 갈 수 없다. 참 모형 아래에서 기대되는 이탈도는
이며, 이는 줄일 수 없는 하한이다. 즉 완벽한 모형조차 맥패든 \(R^2\)가 1에 못 미치고, 결과가 본질적으로 잘 예측되지 않는 문제에서는 상한 자체가 낮다.
0.29를 읽는 법: 맥패든 자신은 0.2--0.4 구간이 "매우 좋은 적합"에 해당한다고 했다. 선형회귀의 \(R^2 = 0.29\)가 주는 인상보다 훨씬 강한 적합이라는 뜻이다. 그러나 절대적 기준으로 쓰기보다는 같은 자료에 적합한 여러 모형을 비교하는 상대적 척도로 쓰는 편이 안전하다. 분류 성능을 판단하려면 AUC, 보정 곡선, 브라이어 점수(19.3절 보정과 브라이어 점수) 같은 지표를 함께 보라. \(\square\)
연습문제 5. 이탈도가 최소제곱의 잔차제곱합에 대응한다고 했다. 정규 선형모형에서 이탈도를 정의하면 실제로 RSS가 됨을 보여라.
풀이
분산이 \(\sigma^2\)로 알려진 정규 선형모형에서 로그가능도는
이다. 포화모형은 \(\hat\mu_i = y_i\)를 두므로 제곱합(sum of squares) 항이 사라지고 \(\ell_{\text{sat}} = -\frac{n}{2}\log(2\pi\sigma^2)\)이다. 따라서
가 된다. 즉 이탈도는 \(\sigma^2\)로 척도화한 잔차제곱합이며, 이 때문에 척도화 이탈도라고도 부른다. \(\sigma^2\)가 알려져 있으면 \(D \sim \chi^2_{n-p}\)가 근사가 아니라 정확히 성립하며, 이것이 로지스틱 회귀에서 우리가 흉내 내려 했던 결과다.
이 대비가 연습문제 3의 실패를 설명해 준다. 정규모형에서 카이제곱분포(chi-squared distribution)가 정확히 성립하는 것은 잔차가 실제로 정규이기 때문이다. 이항 자료에서는 관측치 하나가 두 값밖에 못 가지므로 그 "잔차"가 정규와 거리가 멀고, 카이제곱 근사는 여러 관측치가 한 공변량 패턴에 모여 중심극한정리(central limit theorem)가 작동할 때에만 되살아난다. \(\square\)
정리하며
이탈도는 로지스틱 회귀의 잔차제곱합에 해당한다.
- 포화모형과 비교한다. 관측마다 모수를 하나씩 주어 완벽히 맞춘 모형이 기준이며, 이탈도가 작을수록 적합이 좋다.
- 내포모형 비교에 쓴다. 두 모형의 이탈도 차이가 곧 가능도비 통계량이며 카이제곱을 따른다. 이것이 이탈도의 주된 용도다.
- 절대적 적합도 판정에는 조심해야 한다. 이진 자료에서는 잔차이탈도가 카이제곱을 따르지 않으므로, "이탈도가 자유도와 비슷하니 적합이 좋다"는 판단은 이진 반응에서 타당하지 않다.
- AIC·BIC 가 이탈도에 벌점을 더한 것이다. 13장의 모형선택이 그대로 적용된다.
- 영이탈도와 잔차이탈도의 차이가 모형이 설명한 양이며, 유사 \(R^2\) 의 재료가 된다.
다음 절부터 평가로 넘어간다.