Wilcoxon 부호순위검정
부호검정은 가설 중앙값으로부터의 편차에서 방향만 쓰고, 각 관측값이 \(m_0\)에서 얼마나 떨어져 있는지에 대한 정보를 모두 버린다. Wilcoxon 부호순위검정은 부호와 함께 절대편차의 순위까지 반영하여 \(m_0\)에서 크게 벗어난 관측값에 더 큰 가중치를 준다. 이 추가 정보 덕에, 편차의 분포가 대칭이기만 하면 더 강력한 검정이 된다.
순위합검정과 혼동하지 말 것
Wilcoxon 부호순위검정은 일표본 또는 대응자료를 위한 것이다. Wilcoxon 순위합검정(순위합검정 참조)은 독립인 두 표본을 비교하기 위한 것이다.
가정
- 관측값 \(X_1, X_2, \ldots, X_n\)이 독립이다.
- 각 \(X_i\)가 연속분포에서 나온다.
- \(H_0\) 아래에서 \(X_i - m_0\)의 분포가 0을 중심으로 대칭이다.
대칭성 가정이 부호검정에 비해 추가로 요구되는 핵심 조건이다. 대칭성이 깨지면 부호검정이 더 안전한 선택이다.
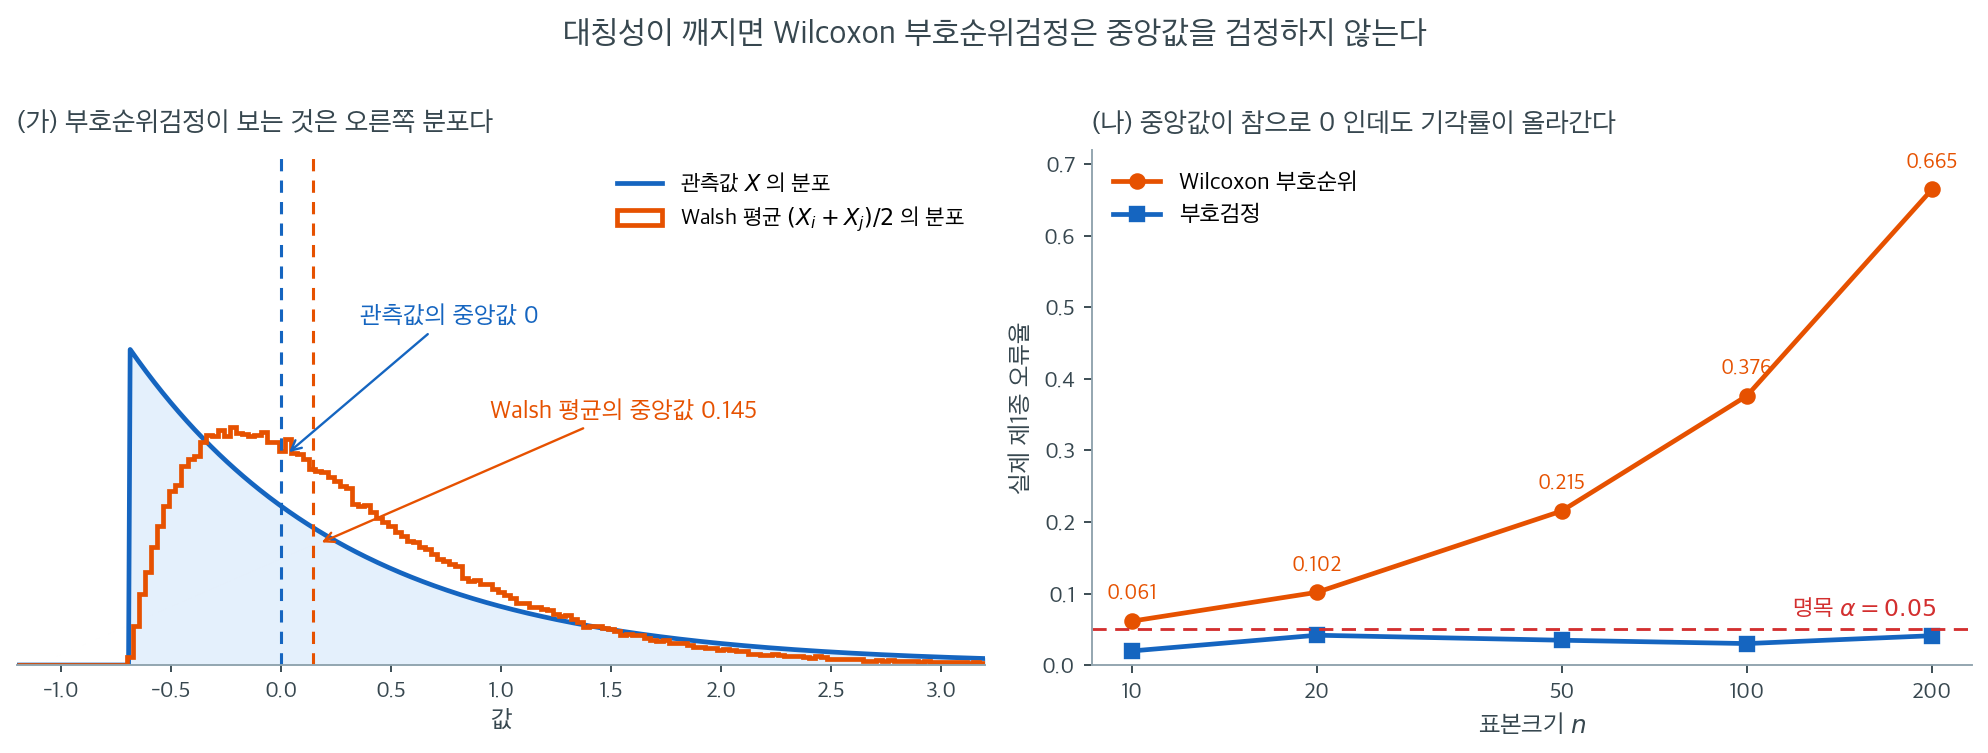
이 가정을 "웬만하면 괜찮겠지" 정도로 넘기기 쉬운데, 그러면 안 되는 이유가 위 그림에 있다. 자료는 \(\text{Exp}(1)\)에서 중앙값 \(\ln 2\)를 뺀 분포이다. 중앙값이 정확히 \(0\)이므로 귀무가설 "중앙값 \(= 0\)"은 참이다. 그런데 오른쪽으로 심하게 치우쳐 있어 대칭성은 깨져 있다.
(가)를 보라. 파란 곡선이 관측값 \(X\)의 분포이고 중앙값이 \(0\)이다. 주황 곡선은 모든 쌍의 평균 \((X_i + X_j)/2\), 즉 Walsh 평균의 분포인데 그 중앙값이 \(0.145\)로 오른쪽에 있다. 부호순위검정이 실제로 검정하는 귀무가설은 \(P(X_i + X_j > 0) = 1/2\), 곧 Walsh 평균의 중앙값이 \(0\)이라는 것이다. 대칭분포에서는 두 중앙값이 일치하지만 여기서는 \(0\)과 \(0.145\)로 갈라진다. 검정은 자기가 보는 쪽이 \(0\)이 아님을 정직하게 잡아낼 뿐이다.
(나)가 그 결과이다. 표본크기를 \(10\)에서 \(200\)까지 늘려 가며 실제 기각률을 재면 부호순위검정은 \(0.061 \to 0.102 \to 0.215 \to 0.376 \to 0.665\)로 올라간다. 근사 오차라면 \(n\)이 커질수록 \(0.05\)에 가까워져야 하는데 정반대로 간다. \(n \to \infty\)에서 기각률이 \(1\)로 수렴한다는 뜻이며, 이것은 근사의 문제가 아니라 검정이 다른 가설을 검정하고 있다는 신호이다. 같은 자료에서 부호검정은 \(0.020\)부터 \(0.042\) 사이에 머문다.
실무 지침은 간단하다. 대응차이의 히스토그램이나 Q-Q 그림에서 뚜렷한 치우침이 보이면 부호순위검정을 쓰지 말라. \(\text{ARE}\)가 \(0.955\) 대 \(0.637\)이라 아깝게 느껴지겠지만, 엉뚱한 가설을 강력하게 검정하는 것보다 옳은 가설을 약하게 검정하는 편이 낫다.
가설
가설 중앙값이 \(m_0\)인 일표본 검정에서
단측 대립가설 \(H_a \colon \text{중앙값} > m_0\) 또는 \(H_a \colon \text{중앙값} < m_0\)도 마찬가지 방식으로 다룬다.
검정통계량
1단계. 편차 \(D_i = X_i - m_0\)을 계산한다.
2단계. \(D_i = 0\)인 관측값(\(m_0\)과 같은 값)을 버린다. 남은 관측값의 개수를 \(n\)이라 하자.
3단계. 절대편차 \(|D_1|, |D_2|, \ldots, |D_n|\)을 작은 값부터 순위를 매긴다. 동점에는 중간순위를 배정한다.
4단계. 부호순위를 정의한다.
여기서 \(R_i\)는 \(|D_i|\)의 순위이다.
5단계. 양·음 순위합을 계산한다.
\(W^+ + W^- = n(n+1)/2\)임에 유의하라.
양측검정의 검정통계량은
이다. \(T\)가 작으면 \(H_0\)에 반하는 증거가 된다.
귀무분포
편차가 대칭인 \(H_0\) 아래에서 \(2^n\)가지 부호 배정이 모두 동등하게 가능하다. \(T\)(또는 동치로 \(W^+\))의 정확 귀무분포는 \(n\)이 작을 때 열거로 표를 만들 수 있다.
\(H_0\) 아래 \(W^+\)의 평균과 분산:
정규근사
\(n\)이 크면(보통 \(n \ge 20\)) 표준화된 통계량
은 근사적으로 \(\mathcal{N}(0, 1)\)을 따른다.
\(|D_i|\) 값들에 동점이 있으면 분산에 보정이 필요하다. 크기가 \(t_1, t_2, \ldots, t_g\)인 동점 집단이 \(g\)개 있을 때 보정된 분산은
이다.
보기 1. 반응시간의 윌콕슨 부호순위검정. 한 심리학자가 새 프로토콜에서 피험자 10명의 반응시간(ms)을 측정하고, 중앙값 반응시간이 \(m_0 = 250\) ms와 다른지 검정하려 한다.
| 피험자 | \(X_i\) | \(D_i = X_i - 250\) | \(\lvert D_i \rvert\) | 순위 | 부호순위 |
|---|---|---|---|---|---|
| 1 | 268 | 18 | 18 | 5 | \(+5\) |
| 2 | 241 | \(-9\) | 9 | 2 | \(-2\) |
| 3 | 273 | 23 | 23 | 7 | \(+7\) |
| 4 | 230 | \(-20\) | 20 | 6 | \(-6\) |
| 5 | 255 | 5 | 5 | 1 | \(+1\) |
| 6 | 262 | 12 | 12 | 3 | \(+3\) |
| 7 | 289 | 39 | 39 | 9 | \(+9\) |
| 8 | 237 | \(-13\) | 13 | 4 | \(-4\) |
| 9 | 295 | 45 | 45 | 10 | \(+10\) |
| 10 | 275 | 25 | 25 | 8 | \(+8\) |
순위합 계산:
풀이
검산: \(W^+ + W^- = 43 + 12 = 55 = 10(11)/2\). \(\checkmark\)
검정통계량: \(T = \min(43, 12) = 12\).
정규근사:
\(\alpha = 0.05\)에서 \(H_0\)을 기각하지 못한다. 중앙값 반응시간이 250 ms와 다르다는 증거가 충분하지 않다.
\(n = 10\)에서 정규근사는 낙관적이다
같은 자료의 정확 양측 \(p\)값은 \(0.1309\)로, 정규근사값 \(0.114\)보다 15% 크다. 연속성 보정을 넣으면 \(0.1263\)으로 정확값에 가까워진다.
import numpy as np
from scipy import stats
d = np.array([268, 241, 273, 230, 255, 262, 289, 237, 295, 275]) - 250
print(stats.wilcoxon(d, method='exact').pvalue)                     # 0.13086
print(stats.wilcoxon(d, method='approx', correction=False).pvalue)  # 0.11413
print(stats.wilcoxon(d, method='approx', correction=True).pvalue)   # 0.12628
출력:
0.130859375
0.11412832776223866
0.12627892855469777
이 보기에서는 세 값 모두 \(\alpha = 0.05\)에서 같은 결론을 주지만, 근사가 \(p\)값을 체계적으로 과소평가한다는 점은 기억해야 한다. \(n \le 20\)에서는 SciPy가 기본적으로 정확검정을 쓰며, 그 편이 옳다.
부호검정과의 비교
| 특징 | 부호검정 | Wilcoxon 부호순위 |
|---|---|---|
| 부호를 쓰는가 | 예 | 예 |
| 크기를 쓰는가 | 아니오 | 예 (순위를 통해) |
| 대칭성 가정 | 없음 | 있음 |
| \(t\) 검정 대비 ARE (정규자료) | \(2/\pi \approx 0.637\) | \(3/\pi \approx 0.955\) |
| 이상치에 대한 로버스트성 | 매우 높음 | 높음 |
부호순위검정은 정규성 아래에서 \(t\) 검정과 거의 같은 검정력(ARE \(\approx 0.955\))에 도달하며, 두꺼운 꼬리 분포에서는 \(t\) 검정을 넘어설 수 있다. 부호검정은 대칭성 가정을 받아들일 수 없거나 자료가 순수하게 순서형일 때만 선호된다.
연습문제
연습문제 1. 아래 콜레스테롤 자료로 Wilcoxon 부호순위검정을 수행하라.
| 환자 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| 차이 | 10 | 5 | \(-5\) | 15 | 2 | 5 | 10 | \(-3\) | 15 | 10 |
(a) 절대차이 \(|d_i|\)를 구해 작은 값부터 순위를 매기고 부호순위를 배정하라.
(b) 검정통계량 \(W^+ = \sum \text{(양의 차이들의 순위)}\)를 계산하라.
(c) \(n = 10\)일 때 \(H_0\) 아래 \(W^+\)의 기댓값은 \(n(n+1)/4\), 분산은 \(n(n+1)(2n+1)/24\)이다. 동점 보정을 적용하여 \(z\) 통계량과 근사 \(p\)값을 계산하라.
(d) 부호검정 결과와 결론을 비교하라.
풀이
(a) \(|d_i|\)를 정렬하면 2, 3, 5, 5, 5, 10, 10, 10, 15, 15이다.
- 2 → 순위 1
- 3 → 순위 2
- 5, 5, 5 → 위치 3, 4, 5 → 중간순위 4
- 10, 10, 10 → 위치 6, 7, 8 → 중간순위 7
- 15, 15 → 위치 9, 10 → 중간순위 9.5
| 환자 | \(d_i\) | \(\lvert d_i \rvert\) | 순위 | 부호순위 |
|---|---|---|---|---|
| 5 | 2 | 2 | 1 | \(+1\) |
| 8 | \(-3\) | 3 | 2 | \(-2\) |
| 3 | \(-5\) | 5 | 4 | \(-4\) |
| 2 | 5 | 5 | 4 | \(+4\) |
| 6 | 5 | 5 | 4 | \(+4\) |
| 1 | 10 | 10 | 7 | \(+7\) |
| 7 | 10 | 10 | 7 | \(+7\) |
| 10 | 10 | 10 | 7 | \(+7\) |
| 4 | 15 | 15 | 9.5 | \(+9.5\) |
| 9 | 15 | 15 | 9.5 | \(+9.5\) |
(b)
검산: \(W^+ + W^- = 49 + 6 = 55 = n(n+1)/2 = 10 \times 11/2\).
(c) \(H_0\) 아래에서
보정하지 않은 분산은
이다. 동점 집단은 크기 3(값 5), 크기 3(값 10), 크기 2(값 15)이므로 보정항은
이고 보정된 분산은 \(96.25 - 1.125 = 95.125\), 표준편차는 \(9.753\)이다.
단측 \(p\)값은
import numpy as np
from scipy import stats
d = np.array([10, 5, -5, 15, 2, 5, 10, -3, 15, 10])
print(stats.wilcoxon(d, alternative='greater', method='exact').pvalue)   # 0.013672
print(stats.wilcoxon(d, alternative='greater', method='approx',
                     correction=False).pvalue)                           # 0.013748
출력:
0.013671875
0.01374798396900858
정확 \(p\)값 \(0.01367\)과 거의 일치한다. 동점 보정을 빠뜨리면 \(z = 2.191\), \(p = 0.0142\)가 되어 정확값에서 조금 더 멀어진다.
(d) Wilcoxon 부호순위검정은 \(p \approx 0.0137\)로 \(\alpha = 0.05\)에서 유의한 반면, 부호검정은 \(p \approx 0.055\)로 유의하지 않았다. Wilcoxon이 유의성에 도달한 것은 차이의 크기를 쓰기 때문이다. 큰 양의 차이(10과 15)가 높은 순위를 받아 \(W^+\)에 크게 기여한다. 부호검정은 모든 양의 차이를 똑같이 취급하여 이 정보를 낭비한다.
연습문제 2. Wilcoxon 부호순위검정의 대칭성 가정이 깨지면 무슨 일이 일어나는가? 중앙값이 정확히 0인 비대칭 분포에서 제1종 오류율을 모의실험으로 확인하라.
풀이
중앙값이 0인 비대칭 분포를 만들자. \(\text{Exp}(1)\)에서 중앙값 \(\ln 2\)를 빼면 중앙값이 0이면서 오른쪽으로 치우친 분포가 된다.
import numpy as np
from scipy import stats
rng = np.random.default_rng(0)
B = 3000
for n in (10, 20, 50, 100):
    x = rng.exponential(1, (B, n)) - np.log(2)
    pw = np.array([stats.wilcoxon(x[i]).pvalue for i in range(B)])
    ps = np.array([stats.binomtest(int((x[i] > 0).sum()), n).pvalue
                   for i in range(B)])
    print(n, (pw < .05).mean(), (ps < .05).mean())
출력:
10 0.058333333333333334 0.019
20 0.109 0.03966666666666667
50 0.219 0.037
100 0.37566666666666665 0.035
| \(n\) | Wilcoxon 부호순위 | 부호검정 |
|---|---|---|
| 10 | 0.058 | 0.019 |
| 20 | 0.109 | 0.040 |
| 50 | 0.219 | 0.037 |
| 100 | 0.376 | 0.035 |
Wilcoxon 검정이 무너진다. 중앙값이 참으로 0인데도 \(n = 100\)에서 표본의 38%를 기각한다. 결정적으로, \(n\)이 커질수록 더 나빠진다. 크기가 명목수준으로 수렴하지 않고 1로 발산한다. 이것은 근사 오차가 아니라 검정이 다른 가설을 검정하고 있다는 신호이다.
이유는 이렇다. Wilcoxon 부호순위검정이 실제로 검정하는 귀무가설은 "중앙값이 0"이 아니라
즉 Hodges-Lehmann 중앙값(모든 쌍 평균 \((X_i + X_j)/2\)의 중앙값, Walsh 평균이라고도 한다)이 0이라는 것이다. 대칭분포에서는 이것이 중앙값과 같지만 비대칭분포에서는 다르다. 중앙값 이동 지수분포에서 Walsh 평균의 중앙값은 약 \(+0.147\)로 0이 아니다.
y = rng.exponential(1, 200000) - np.log(2)
w = (y[:100000] + y[100000:]) / 2
print(np.median(y), np.median(w))     # 0.0001, 0.147
출력:
0.00011479673764763776 0.147140210508641
이 \(+0.147\)이 바로 검정이 잡아내는 것이며, 표본이 커질수록 그 신호가 확실해지므로 기각률이 1로 간다.
부호검정은 이 문제에서 자유롭다. 중앙값을 직접 검정하므로 크기가 \(0.05\) 근처를 유지한다.
실무 지침: 대응차이의 히스토그램이나 Q-Q 그림이 뚜렷한 치우침을 보이면 Wilcoxon 부호순위검정을 쓰지 말라. 검정력이 낮더라도 부호검정이 옳은 답을 준다.
연습문제 3. \(W^+\)의 평균 \(n(n+1)/4\)와 분산 \(n(n+1)(2n+1)/24\)를 유도하라.
풀이
\(H_0\)(대칭성) 아래에서 각 순위 \(i\)의 부호가 독립적으로 \(\pm\) 중 하나를 확률 \(1/2\)씩 갖는다. 지시확률변수
를 두면 \(Z_1, \ldots, Z_n\)은 독립이고 \(Z_i \sim \text{Bernoulli}(1/2)\)이며
이다.
평균. \(E[Z_i] = 1/2\)이므로
분산. \(\text{Var}(Z_i) = 1/4\)이고 \(Z_i\)들이 독립이므로
독립성이 성립하는 이유가 핵심이다. 대칭성 아래에서 \(|D_i|\)와 \(\operatorname{sign}(D_i)\)가 독립이므로, 어떤 절대편차가 어떤 순위를 받았는지와 무관하게 부호가 동전던지기로 결정된다. 이것이 대칭성 가정이 필요한 정확한 지점이며, 연습문제 2에서 이 가정이 깨질 때 검정이 무너지는 이유이기도 하다.
동점이 있으면 순위 \(i\)가 중간순위 \(r_i\)로 대체되어 \(\text{Var}(W^+) = \frac{1}{4}\sum_i r_i^2\)이 된다. 이 합을 정리하면 본문의 보정식이 나온다.
연습문제 4. Wilcoxon 부호순위검정을 역전시켜 중앙값의 신뢰구간을 만들 수 있다. \(n = 10\)인 보기 자료에서 95% 신뢰구간을 구하고, \(t\) 신뢰구간과 비교하라.
풀이
부호순위검정의 신뢰구간은 Walsh 평균에 기반한다. 모든 쌍 \((i \le j)\)에 대해 \((X_i + X_j)/2\)를 계산하면 \(n(n+1)/2 = 55\)개의 값이 나온다. 정렬한 뒤 양 끝에서 \(k\)개씩 잘라내는데, \(k\)는 정확 부호순위 임계값이다.
import numpy as np
from scipy import stats
x = np.array([268, 241, 273, 230, 255, 262, 289, 237, 295, 275])
n = len(x)
walsh = np.array([(x[i] + x[j]) / 2 for i in range(n) for j in range(i, n)])
walsh.sort()
# 양측 95%: W+ <= 8 이면 기각 (2 * P(W+ <= 8) = 0.0488)
k = 8
print(len(walsh), walsh[k], walsh[-(k + 1)])   # 55 248.0 278.5
print(np.median(walsh), x.mean(), np.median(x))  # 263.0 262.5 265.0
print(stats.ttest_1samp(x, 0).confidence_interval())  # (246.90, 278.10)
출력:
55 246.0 278.5
263.0 262.5 265.0
ConfidenceInterval(low=246.89913171804932, high=278.1008682819507)
\(k\)는 \(2P(W^+ \le k) \le 0.05\)를 만족하는 가장 큰 정수이다. \(n = 10\)에서 \(2P(W^+ \le 8) = 0.0488\)이고 \(2P(W^+ \le 9) = 0.0645\)이므로 \(k = 8\)이다.
| 양 | 값 |
|---|---|
| Walsh 평균 개수 | \(55\) |
| Wilcoxon 95% 신뢰구간 | \((248.0, \; 278.5)\) |
| Hodges-Lehmann 추정값 | \(263.0\) |
| \(t\) 95% 신뢰구간 | \((246.9, \; 278.1)\) |
| 표본평균 / 표본중앙값 | \(262.5\) / \(265.0\) |
두 구간이 거의 같다. Wilcoxon 구간의 폭은 \(30.5\), \(t\) 구간의 폭은 \(31.2\)로 오히려 Wilcoxon이 살짝 좁다. 자료가 대칭에 가까워 순위 방법이 잃는 것이 거의 없기 때문이며, \(\text{ARE} = 0.955\)가 실제로 뜻하는 바이다.
두 구간 모두 \(250\)을 포함하므로 앞의 검정 결과(\(p = 0.131\), 기각 못 함)와 일관된다. 검정과 구간이 이렇게 맞물리는 것은 우연이 아니다. 신뢰구간이 검정을 역전시켜 만들어졌으므로 구조적으로 일치한다.
Hodges-Lehmann 추정값 \(263.0\)이 표본평균 \(262.5\)와 표본중앙값 \(265.0\) 사이에 놓인다는 점도 눈여겨보라. Walsh 평균의 중앙값은 평균의 효율성과 중앙값의 로버스트성 사이의 절충으로, 정규분포에서 평균 대비 효율이 \(0.955\)이면서(중앙값은 \(0.637\)) 붕괴점은 \(0.29\)이다(평균은 \(0\)).
정리하며
Wilcoxon 부호순위검정은 가설 중앙값으로부터의 절대편차에 순위를 매기고 각 부호에 그 순위만큼 가중치를 주어 부호검정을 확장한다. 편차의 분포가 대칭이면 더 강력한 검정이 되지만 가정이 하나 늘어난다는 대가를 치른다. 검정통계량 \(T = \min(W^+, W^-)\)은 소표본에서는 정확히, 대표본에서는 정규근사로 평가할 수 있다.