12장: 상관과 인과¶
개요¶
들어가는 이야기 — 열여섯 연구가 같은 말을 했는데
삼십 년쯤 전, 폐경기를 맞은 여성들이 널리 먹던 약이 있었다. 호르몬 대체요법이라 부른다 — 나이가 들며 몸에서 줄어드는 여성호르몬 에스트로겐을 약으로 채워 주는 것이다. 그 약을 먹는 사람은 심장병에 덜 걸린다는 연구가 쏟아져 나왔다. \(1991\) 년에 그때까지 나온 연구를 모아 보니 열여섯 개 가운데 열다섯 개가 같은 말을 했고, 다 합치면 약을 먹는 쪽의 심장병이 절반쯤이었다. 몸속에서 왜 그런지도 설명이 되었다. 그 연구들을 정리한 논문은 이렇게 적었다 — 「다른 이유로 설명될 것 같지는 않다.」
\(2002\) 년에 그 말을 제대로 시험해 보았다. 여성 \(16{,}608\) 명을 모아 동전을 던지듯 무작위로 반은 그 약을, 반은 가짜 약을 받게 했다. 누가 약을 먹을지를 사람이 고르지 못하게 한 것이다. \(8\) 년 반을 지켜볼 계획이었는데 \(5\) 년을 조금 넘기고 중단했다. 약을 먹은 쪽에서 심장병이 늘었기 때문이다.
왜 반대가 나왔을까. 앞선 연구들에서는 약을 먹을지 말지를 사람들이 스스로 정했다. 그런데 건강에 신경 쓰는 사람일수록 그 약도 더 챙겨 먹고, 운동도 하고, 병원에도 자주 간다. 그렇다면 약을 먹은 쪽이 심장병에 덜 걸린 것은 약 덕분이 아니라 그런 사람들이 그쪽에 모였기 때문일 수 있다.
연구자들이 게을렀던 것도 아니다. 나이도 흡연도 소득도 꼼꼼히 맞춰 보았다. 다만 맞춰 보는 일은 우리가 잰 것까지만 듣는다. 「건강에 신경 쓰는 마음」은 아무도 재지 못했고, 재지 못한 것은 맞출 수도 없다.
동전을 던져 정하면 왜 이 문제가 풀릴까. 누가 약을 먹을지를 동전이 정하면, 건강에 신경 쓰는 사람도 그렇지 않은 사람도 양쪽에 비슷하게 섞인다. 우리가 잰 것뿐 아니라 재지 못한 것까지 섞인다. 그래서 나중에 두 쪽의 결과가 다르면, 다른 이유를 대기가 어려워진다. 이것이 동전 던지기 하나가 수십 개의 큰 연구를 이긴 까닭이다.
이 일은 논문 안에서 끝나지 않았다. 미국에서 그 약의 처방은 \(1999\) 년에 한 해 \(9\) 천만 건 가까이 되었는데, 발표 뒤 \(38\%\) 가 줄었다. 먹던 여성 수백만 명이 약을 끊은 것이다. 둘이 함께 간다는 것과 하나가 다른 하나를 만든다는 것, 이 둘을 헷갈린 값이 그만큼 컸다. 이 장이 그 둘을 가르는 법을 다룬다.
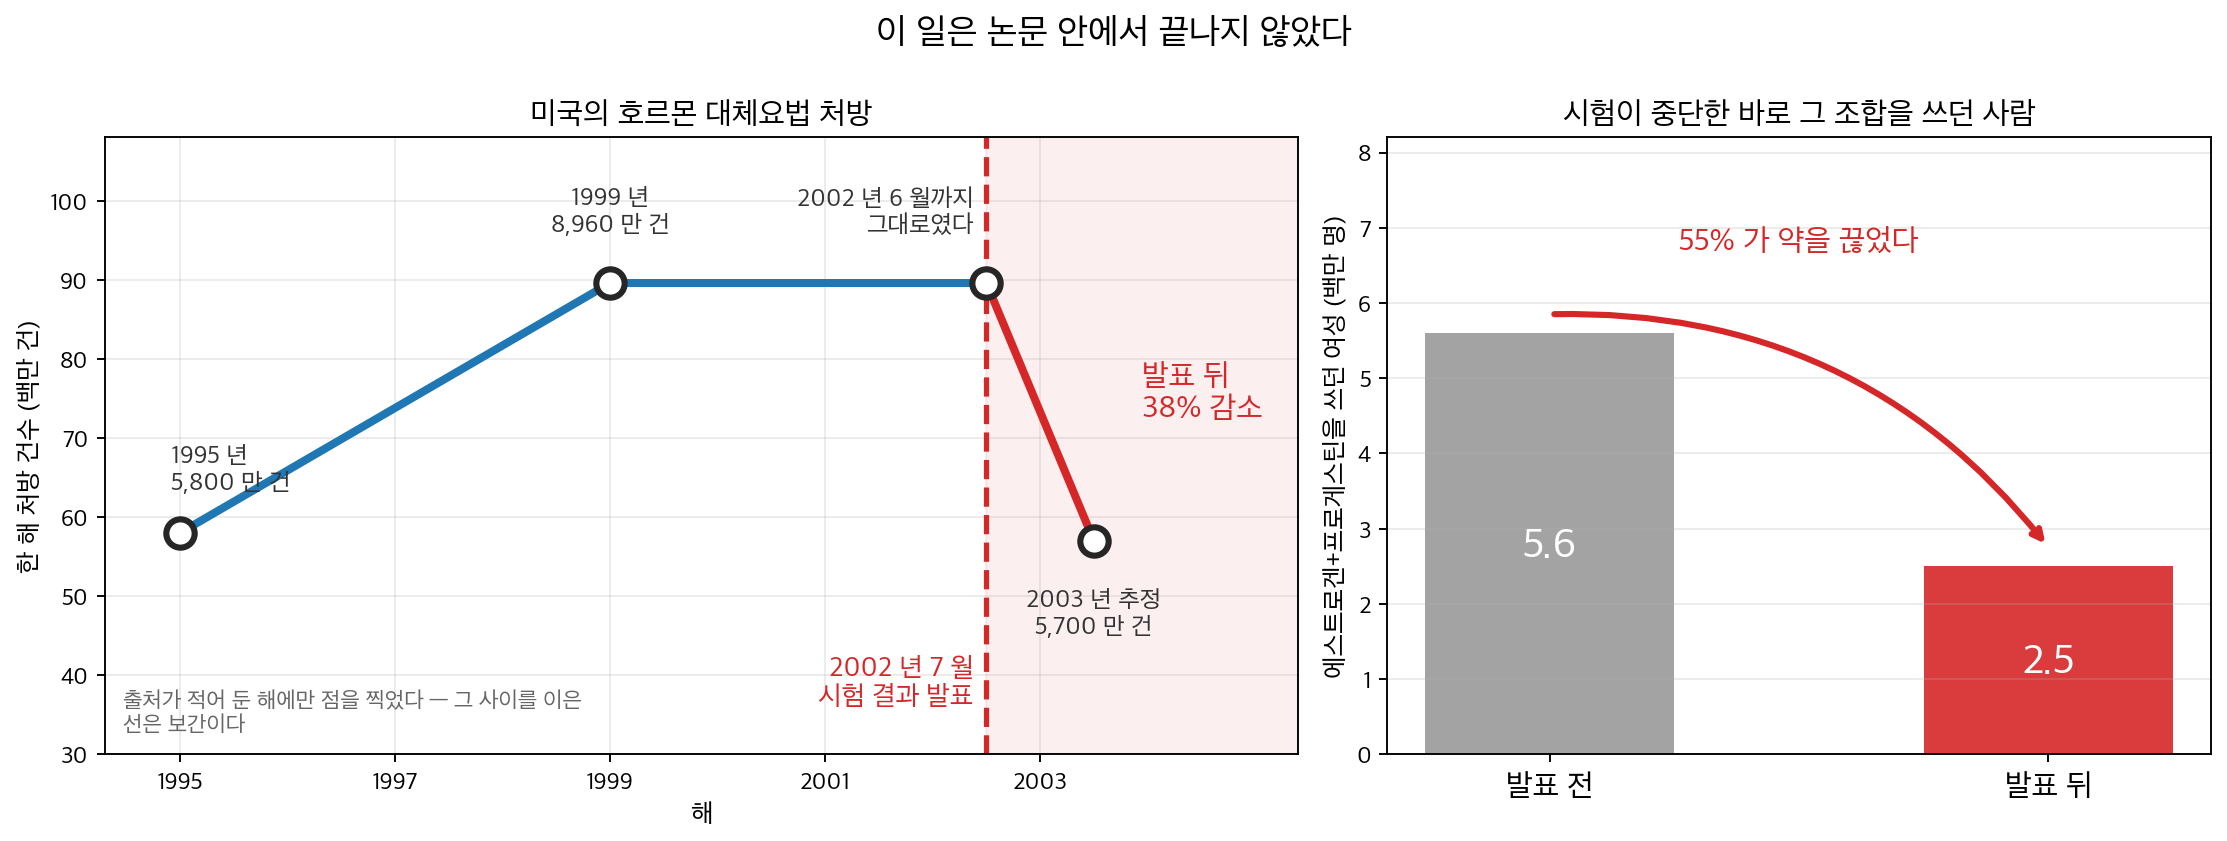
왼쪽. 처방은 \(1995\) 년 \(5{,}800\) 만 건에서 \(1999\) 년 \(8{,}960\) 만 건까지 올랐고 \(2002\) 년 \(6\) 월까지 그대로였다. 결과가 발표된 그해를 지나며 꺾여 \(2003\) 년에 \(5{,}700\) 만 건이 된다 — 팔 년 전 수준이다. 오른쪽. 시험이 중단한 바로 그 조합을 쓰던 여성은 \(560\) 만 명에서 \(250\) 만 명으로, \(55\%\) 가 약을 끊었다. 논문 한 편이 바꾼 것이 이만큼이다. 출처가 적어 둔 해에만 점을 찍었고 그 사이를 이은 선은 보간이다.
확인한 곳 — 12.3절 교란변수의 「교란으로는 설명되지 않는다고 적었다」 상자와 그 출처 줄(스탬퍼·콜디츠 \(1991\) 과 여성건강이니셔티브 \(2002\)) · 처방의 수는 Hersh · Stefanick · Stafford, 「National Use of Postmenopausal Hormone Therapy」, 『JAMA』 \(291\)(\(2004\)) \(47\) 쪽 — \(1995\) 년 \(5{,}800\) 만 건, \(1999\) 년 \(8{,}960\) 만 건, \(2002\) 년 \(6\) 월까지 유지, 발표 뒤 \(38\%\) 감소, \(2003\) 년 추정 \(5{,}700\) 만 건, 에스트로겐+프로게스틴 사용 여성 \(560\) 만 → \(250\) 만 명
이 장에서는 통계적 추론과 자료 해석의 중심에 있는 두 개념, 상관과 인과를 살펴본다. 상관은 두 변수 사이 관계의 강도와 방향을 수치화하는 반면, 인과는 한 변수의 변화가 다른 변수의 변화를 직접 낳는다는 뜻이다. 이 장은 상관을 측정하고 검정하고 시각화하는 방법, 생태학적 오류나 교란 같은 함정을 알아보는 방법, 그리고 방향성 비순환 그래프 같은 현대적 틀로 인과관계를 사고하는 방법을 다룬다.
★ 12.2~12.4 에 대하여
이 장은 두 가지 다른 일을 한다. 12.1·12.5·12.6 은 상관을 재고 검정하고 그리는 법이고, 12.2~12.4 는 「연관과 인과는 다르다」를 깊이 파는 자리다.
뒤의 셋에 ★ 를 붙인 까닭은 어려워서가 아니라 1장이 이미 그 메시지를 세웠기 때문이다. 1.1절 상관관계와 인과관계가 버클리 입학 자료를 수치까지 다루고(남성 \(44.5\%\) 대 여성 \(30.4\%\), 격차 \(14.2\) 포인트, 학과 합격률과 여성 지원 비율의 상관 \(-0.79\)), 학과가 교란요인이 아니라 매개변수일 수 있다는 대목까지 간다. 같은 쪽이 식별 전략 넷(무작위화(randomization)·층화(stratification)·도구변수·이중차분·회귀 불연속)을 나열하고 과보정도 다룬다. 그 쪽이 스스로 「이 이야기는 책 뒤에서 세 번 더 돌아온다」고 적으며 12.2 를 가리킨다 — 되돌아오는 자리라는 뜻이다.
입문 과정이라면 12.1·12.5·12.6 으로 족하다. 12.2~12.4 를 건너뛰어도 13장 이후를 따라가는 데 지장이 없다. 다만 회귀계수(regression coefficient)를 효과라고 부르려는 순간에는 12.3 으로 돌아와야 한다.
급하면 질러가도 된다
13장 선형회귀(linear regression)가 이 장에서 가져다 쓰는 것은 12.1절의 피어슨 상관 하나다. 「연관과 인과는 다르다」는 1장이 이미 세웠으므로 12.2~12.4 ★ 는 회귀를 읽는 데 필요하지 않다. 회귀가 급하면 12.1절만 보고 13장으로 넘어간 뒤 돌아와도 된다. 다만 회귀계수를 효과라고 부르고 싶어지는 순간 12.4절이 필요해진다.
1. 장의 구성¶
12.1 상관¶
두 변수 사이 연관을 재는 측도로, 고전적 접근과 순위 기반 접근을 함께 다룬다:
- 상관의 이해 --- 이 절의 들머리이자 나머지 다섯 쪽의 지도다. 식을 세우기 전에 상관계수가 \(-1\) 에서 \(+1\) 까지 바뀔 때 점구름의 모양이 어떻게 달라지는지를 눈으로 훑고, 키와 몸무게 자료로 성별을 섞으면 무슨 일이 생기는지 본다. 표본 꼴·성질·함정이 어느 쪽에 있는지는 절마다 가리켜 둔다.
- 피어슨 상관계수 --- 두 연속형 변수 사이 선형관계의 강도와 방향을 \(-1\)에서 \(+1\)까지의 값으로 수치화한다.
- 스피어만 순위상관 --- 관측값의 순위에 기반한 비모수(nonparametric) 측도로, (반드시 선형은 아닌) 단조 관계를 포착한다.
- 켄들의 타우 --- 일치쌍과 불일치쌍을 세는 순위 기반 상관계수로, 이상치(outlier)과 동점에 로버스트하다.
- 점이연 상관과 파이 계수 --- 이진 변수가 관련된 상황(하나는 연속형이고 하나는 이진이거나, 둘 다 이진인 경우)을 위한 특화된 상관 측도.
- 부분상관 --- 하나 이상의 다른 변수의 효과를 통제한 뒤 두 변수 사이의 연관을 잰다.
12.2 생태학적 상관 ★¶
집계된 자료가 개인 수준의 관계를 어떻게 오도할 수 있는지 다룬다:
- 생태학적 오류 --- 집단 수준(집계) 상관 자료로부터 개인 수준의 연관을 추론하는 잘못.
- 심슨의 역설 --- 집계 자료에서 나타나는 경향이 자료를 하위집단으로 나누면 뒤집히거나 사라지는 현상.
- 집계 편향 --- 개인 수준 자료를 상위 수준에서 요약할 때 생기는 체계적 왜곡으로, 연관의 겉보기 강도나 방향을 바꾼다.
12.3 상관, 인과, 교란 ★¶
상관만으로 인과를 말할 수 없는 이유와 숨은 변수의 역할:
- 교란변수 --- 설명변수(explanatory variable)와 결과 모두에 영향을 주어 둘 사이에 허위 연관을 만드는 제3의 변수. 그 변수를 재지 못했을 때(잠복변수·공통원인)가 왜 더 어려운지도 같은 쪽에서 다룬다.
- 허위상관 --- 진짜 인과관계가 아니라 우연, 교란, 자료 채굴에서 생기는 통계적으로 유의한 상관.
- 교란과 인과 시연 --- 앞의 두 쪽을 모의자료로 손에 쥐어 본다. 처치가 결과에 아무 효과가 없는데도 교란변수 하나가 유의한 회귀계수를 만들어 내는 자리, 그리고 소박한 처치효과 추정값의 부호가 아예 반대로 나오는 자리를 각각 만든다. 프리시–워–러벨 정리가 왜 그 둘을 같은 식으로 설명하는지도 여기 있다.
12.4 인과 ★¶
참된 인과관계를 확립하는 틀과 방법:
- 인과 추론의 기준 --- 고전적 기준(시간적 선행, 공변, 교란요인의 배제)과 무엇이 인과의 증거가 되는지에 대한 현대적 관점.
- 무작위 실험과 인과 --- 무작위 배정이 교란을 제거하여 인과 주장에 가장 강한 증거를 제공하는 방식.
- 도구변수 (입문) --- 처치에는 영향을 주지만 결과에는 직접 영향을 주지 않는 변수를 활용하여 관찰자료에서 인과효과를 추정하는 기법.
- 방향성 비순환 그래프(DAG) --- 인과 가정을 부호화하고 교란요인을 찾아내며 분석에서 무엇을 통제할지 결정하는 그래프 틀.
- 인과추론 모의실험 --- 참값을 알고 있는 자료를 만들어 교란과 심슨의 역설을 눈으로 본다. 이 절의 결론은 둘이 같은 병의 두 얼굴이라는 것이다.
12.5 상관 검정¶
여러 상관 측도의 유의성에 대한 형식적 가설검정:
- 피어슨의 \(r\) 검정 (상관에 대한 t-검정) --- 모집단 피어슨 상관이 0과 유의하게 다른지 판정하는 \(t\) 기반 검정.
- 스피어만의 \(\rho\) 검정 --- 정확법이나 근사법으로 스피어만 순위상관의 유의성을 검정한다.
- 켄들의 \(\tau\) 검정 --- 표본이 클 때 정규근사를 이용해 켄들 타우의 유의성을 검정한다.
- 두 상관의 비교 --- 두 상관계수가 서로 유의하게 다른지 검정하는 방법(예: 피셔의 \(z\) 변환).
- 세 검정을 같은 자료에서 견주기 --- 앞의 세 검정을 한 자료에 함께 돌린다. 선형·단조·이상치가 섞인 세 가지 자료를 만들어, 어느 자리에서 셋의 답이 갈리는지와 작은 표본에서 켄들이 더 믿을 만한 까닭을 본다.
12.6 상관의 시각화¶
상관을 눈으로 보는 도구. 재는 법(12.1)과 검정하는 법(12.5)에 이어 보이는 법을 모았다:
- 상관 시각화 --- 상관 구조가 알려진 네 변수를 만들어, 열지도와 산점도(scatter plot) 행렬이 선형 의존을 어떻게 한눈에 드러내는지 본다.
- 상관 타원 그림 --- 칸마다 타원의 모양·방향·크기로 상관을 부호화한다. 회색조 인쇄와 색각 이상에서도 읽히는 것이 색 열지도에 없는 값이다.
- 회귀와 상관 그림 --- \(r\) 이 기울기와 잡음 두 가지에 어떻게 의존하는지 여덟 설정으로 늘어놓는다. \(r\) 이 작다는 것이 기울기가 작다는 뜻이 아님을 눈으로 가른다.
- 상관 열지도 --- 상관행렬을 색으로 부호화한 2차원 시각화로, 여러 변수에 걸친 연관 패턴을 한꺼번에 드러낸다.
- 쌍 그림과 산점도 행렬 --- 모든 변수 쌍에 대한 이변량 산점도를 격자로 배열한 것으로, 비선형 패턴과 이상치를 찾는 데 유용하다.
연습문제 — 쪽마다 끝에 있다¶
상관의 계산과 비교, 연관의 시각화, 교란요인과 생태학적 오류의 식별, 실제 자료에 대한 상관 검정의 적용을 다루는 연습문제.
2. 선행 지식¶
이 장은 다음 내용 위에 세워진다.
- 3장 (확률의 기초) --- 확률변수와 기댓값, 결합분포와 주변분포, 공분산과 상관계수, 그리고 독립성과 무상관성의 차이.
- 4장 (분포) --- 이변량 정규분포. 결합정규일 때에만 무상관이 독립과 같아지고 조건부평균이 직선이 된다 — 12.1 이 재는 \(r\) 이 무엇을 재고 있는지가 거기서 정해진다.
- 2장 (기술통계) --- 산점도, 수치 요약, 탐색적 자료분석. 특히 기술통계를 처음부터 구현하기 §6 이 공분산과 \(r\) 을 손으로 구현해 실제 CA·NY 가격 48개월치에 적용하고, 추세를 걷어내며 \(r\) 이 \(0.9970\) 에서 \(0.0515\) 로 주저앉는 것까지 보인다. 12.1 이 그 위에서 시작한다.
- 9장 (가설검정) --- 귀무가설(null hypothesis)과 대립가설(alternative hypothesis), \(p\) 값, 유의수준.
3. 핵심 요점¶
- 상관은 변수 사이 연관의 강도와 방향을 재지만 인과를 함의하지 않는다. 교란요인, 잠복변수, 집계 효과가 모두 오도하는 상관을 만들 수 있다.
- 피어슨은 선형 연관을 포착하고, 스피어만과 켄들은 단조 연관을 포착하며 이상치와 비정규 자료에 더 로버스트하다.
- 생태학적 오류와 심슨의 역설은 집단 수준의 패턴이 개인 수준의 패턴과 극적으로 다를 수 있음을 보여주며, 자료를 신중하게 분해하는 일이 필수적임을 알려준다.
- 인과를 확립하려면 상관 이상이 필요하다. 무작위 실험, 도구변수, 방향성 비순환 그래프가 인과추론의 엄밀한 틀을 제공한다.
- 표집 변동과 진짜 연관을 구별하려면 (적절한 귀무가설과 \(p\) 값을 갖춘) 형식적 상관 검정이 필요하며, 피셔의 \(z\) 변환으로 표본 사이의 상관을 비교할 수 있다.