편향과 무응답
조사를 아무리 신중하게 설계해도, 편향이라 불리는 체계적 오차는 표본이 아무리 크든 결과를 왜곡할 수 있다. 이런 오차를 이해하는 것은 조사를 설계하고, 그 결과를 해석하며, 언론의 헤드라인 숫자에 이의를 제기하는 데 필수적이다. 이 절에서는 조사 실무에서 가장 중요한 네 가지 편향 유형과 각각을 부분적으로 완화하는 전략을 다룬다.
정의 1. 편향
편향(bias) 은 표본 통계량이 대응되는 모집단 모수를 체계적으로 과대 또는 과소 추정하는 경향이다. 형식적으로 \(\mathrm{bias}(\hat\theta) = \mathbb{E}[\hat\theta] - \theta\)이며, 기댓값은 자료가 아니라 반복적인 표집 과정에 대해 취한다. 표본을 아무리 더 뽑아도 편향은 남는다.
조사 연구의 네 가지 표준 유형은 다음과 같다.
| 유형 | 기제 | 방향 |
|---|---|---|
| 표집(포괄) 편향 | 표집틀이 목표 모집단과 일치하지 않음 | 예측 불가 |
| 무응답 편향 | 무응답자가 응답자와 체계적으로 다름 | 누가 빠지느냐에 따라 다름 |
| 응답(측정) 편향 | 응답자가 부정확하게 답함 | 흔히 사회적으로 바람직한 답 쪽으로 |
| 선택 편향 | 자료에 포함되는 것이 결과와 상관됨 | "성공한 것"만 조사함 |
표집(포괄) 편향
표집틀은 표본을 뽑는 열거된 목록이다. 표집틀에 없는 사람은 선택 확률이 0이며 분석에서 보이지 않는다. 고전적인 예로, 1936년 《Literary Digest》 여론조사는 전화번호부, 자동차 등록부, 자체 구독자 명단에서 뽑은 1,000만 명에게 모의 투표용지를 우편으로 보냈고 그중 약 240만 장을 회수했다(응답률 약 24%). 대공황기 미국에서 이 목록들은 부유층 쪽으로 치우쳤고 이들은 공화당 지지 경향이 있었다. 그 결과 조사는 랜던의 승리를 자신 있게 예측했다.
훨씬 작았던 갤럽의 확률표본은 루스벨트의 승리를 정확히 예측했다. 갤럽은 여기서 한 걸음 더 나아가, 《Literary Digest》가 쓰는 것과 같은 종류의 명단에서 단 3,000명을 뽑아 《Digest》가 무엇을 발표할지까지 미리 맞혔다.
| 표본 크기 | 루스벨트 | 랜던 | |
|---|---|---|---|
| 《Literary Digest》 예측 | 2,400,000 | 43% | 57% |
| 갤럽의 "《Digest》 예측치" 예측 | 3,000 | 44% | 56% |
| 갤럽 자신의 예측 | 50,000 | 56% | 44% |
| 실제 개표 결과 | — | 62% | 38% |
두 가지를 읽어야 한다.
첫째, 크기가 품질을 사지 못한다. 《Digest》의 표본은 갤럽의 것보다 48배 컸지만 19%p 빗나갔고 승자마저 틀렸다. 갤럽은 그 \(1/48\) 크기로 6%p 안에 들어왔다. 표본의 크기보다 표본의 품질이 더 중요하다.
둘째, 편향은 예측 가능하다. 갤럽이 3,000명만으로 《Digest》의 오답을 미리 재현했다는 것은, 그 오차가 우연이 아니라 표집 기제에 구조적으로 박혀 있었다는 뜻이다. 편향은 잡음이 아니라 신호이며, 기제를 알면 계산할 수 있다.
이 실패를 표집 편향만으로 설명하면 절반만 맞다
교과서는 보통 이 사건을 표집틀 문제로만 소개한다. 그러나 Squire(1988)가 1937년 갤럽의 사후 조사 자료로 분석한 바에 따르면, 무응답 편향이 적어도 그만큼 중요했다. 용지를 받은 사람 중 랜던 지지자가 루스벨트 지지자보다 훨씬 높은 비율로 회신했다.
Squire의 결론은 강하다. 용지를 받은 1,000만 명이 모두 회신했다면 《Digest》는 적어도 승자는 맞혔을 것이다. 즉 치우친 명단만으로는 이 정도 규모의 참사가 나오지 않았고, 24%라는 낮은 응답률이 그 위에 겹쳐져야 했다.
Lohr와 Brick(2017)의 재분석은 한 발 더 나아간다. 《Digest》가 회수한 바로 그 자료를 1932년 득표 자료로 사후층화하기만 했어도 루스벨트의 승리를 맞혔을 것이라는 계산이다. 자료가 부족했던 것이 아니라 보정하지 않았던 것이다(연습문제 4 참조).
요컨대 이 페이지의 다음 절인 무응답 편향이 같은 사건의 나머지 절반이다.
- Squire, P. (1988). "Why the 1936 Literary Digest Poll Failed." Public Opinion Quarterly, 52(1), 125–133.
- Lohr, S. L., & Brick, J. M. (2017). "Roosevelt Predicted to Win: Revisiting the 1936 Literary Digest Poll." Statistics, Politics and Policy, 8(1), 65–84.
- 표의 수치는 Freedman, Pisani, & Purves, Statistics (4th ed.), 19장의 정리를 따른 것으로 양당 득표 기준이다. 제3후보를 포함한 실제 득표율은 루스벨트 60.8%, 랜던 36.5%, 렘키 1.9%였고 선거인단은 523 대 8이었다.
표집틀을 고쳐도 남는 것: 1948년 "듀이가 트루먼을 이겼다"
《Literary Digest》의 실패 이후 여론조사 업계는 표집틀 문제를 고쳤다. 갤럽은 전화번호부 대신 할당표집(quota sampling) 을 도입했다. 조사원에게 "40대 남성 5명, 흑인 여성 2명, 농촌 거주자 3명…"처럼 인구 구성에 맞는 할당량을 주고 채워 오게 하는 방식이다. 이 방법으로 갤럽은 1936, 1940, 1944년 대선을 연달아 맞혔다.
1948년 대선에서 갤럽, 크로슬리, 로퍼 세 기관이 모두 같은 방법으로 조사했고, 모두 틀렸다.
| 트루먼 | 듀이 | |
|---|---|---|
| 크로슬리 예측 | 45% | 50% |
| 갤럽 예측 | 44% | 50% |
| 로퍼 예측 | 38% | 53% |
| 실제 개표 결과 | 50% | 45% |
《시카고 데일리 트리뷴》은 개표를 기다리지 않고 "DEWEY DEFEATS TRUMAN"이라는 1면을 인쇄했다. 이튿날 아침 트루먼이 그 신문을 들어 보이며 웃는 사진은 미국 정치사에서 가장 유명한 사진 중 하나가 되었다.
할당표집이 확률표집이 아닌 이유
할당표집은 언뜻 대표성 있어 보인다. 표본의 인구 구성이 모집단과 정확히 일치하도록 강제하니 말이다. 문제는 할당량 안에서 누구를 고를지가 조사원에게 맡겨진다는 데 있다.
조사원은 사람이다. 접근하기 편한 사람을 고른다. 더 좋은 동네, 더 깨끗한 계단, 벨을 눌렀을 때 문을 열어 줄 것 같은 집. "40대 남성 5명"이라는 할당량은 채워지지만, 그 5명은 같은 조건의 40대 남성 중에서 체계적으로 형편이 나은 쪽이다.
1948년에 그 편향은 공화당 쪽이었다. 갤럽 조사는 1936년부터 1948년까지 매번 공화당 지지를 몇 %p씩 과대추정하고 있었다. 다만 1936–1944년에는 민주당이 크게 이겨서 그 편향이 승자를 뒤집지 못했을 뿐이다. 방법은 12년 내내 틀려 있었고, 세 번은 운이 좋았다.
핵심 구별은 이것이다.
| 할당표집 | 확률표집 | |
|---|---|---|
| 누가 표본을 고르는가 | 조사원(재량) | 무작위 기제 |
| 선택 확률 | 알 수 없음 | 알려져 있고 \(> 0\) |
| 표집오차 계산 | 불가능 | 가능 |
| 편향 | 조사원의 재량만큼 | 없음(설계상) |
선택 확률을 모르면 표준오차도 신뢰구간도 정의되지 않는다. 할당표집으로 얻은 "오차범위 \(\pm 3\)%p"는 계산할 근거가 없는 숫자다.
1948년 이후 주요 여론조사 기관은 확률표집으로 전환했다. 이 사건은 표집 이론이 실무를 이긴 드문 사례이며, 오늘날 조사 통계학의 출발점이다.
다시 읽어야 할 대목: 《Literary Digest》의 교훈이 "표본을 크게 하지 말고 대표성 있게 하라"였다면, 1948년의 교훈은 한 단계 더 나아간다. "대표성 있어 보이게 만드는 것"과 "무작위로 뽑는 것"은 다르다. 표본의 겉모습(인구 구성)을 모집단에 맞추는 것만으로는 부족하다. 뽑는 과정이 무작위여야 한다.
무응답 편향
표집틀이 완벽하더라도 선택된 사람 중 일부는 응답하지 않는다. 응답자와 무응답자가 관심 변수에서 다를 때 편향이 생긴다. 고객 만족도 조사를 주로 아주 만족한 고객이나 아주 화난 고객만 작성한다면, 표본 평균은 그 사이의 모든 사람을 놓친다. 편향의 방향은 어느 하위집단이 과다 응답하느냐에 달려 있다.
현대 조사에서 응답률은 무너져 내렸다. 한때 70–80%였던 것이 이제 전화 조사에서는 흔히 10% 아래다. 추론은 관측된 공변량으로 가중한 뒤에는 응답이 "무작위 결측"이라는 가정에 의존하는데, 이는 자료만으로 검증할 수 없다.
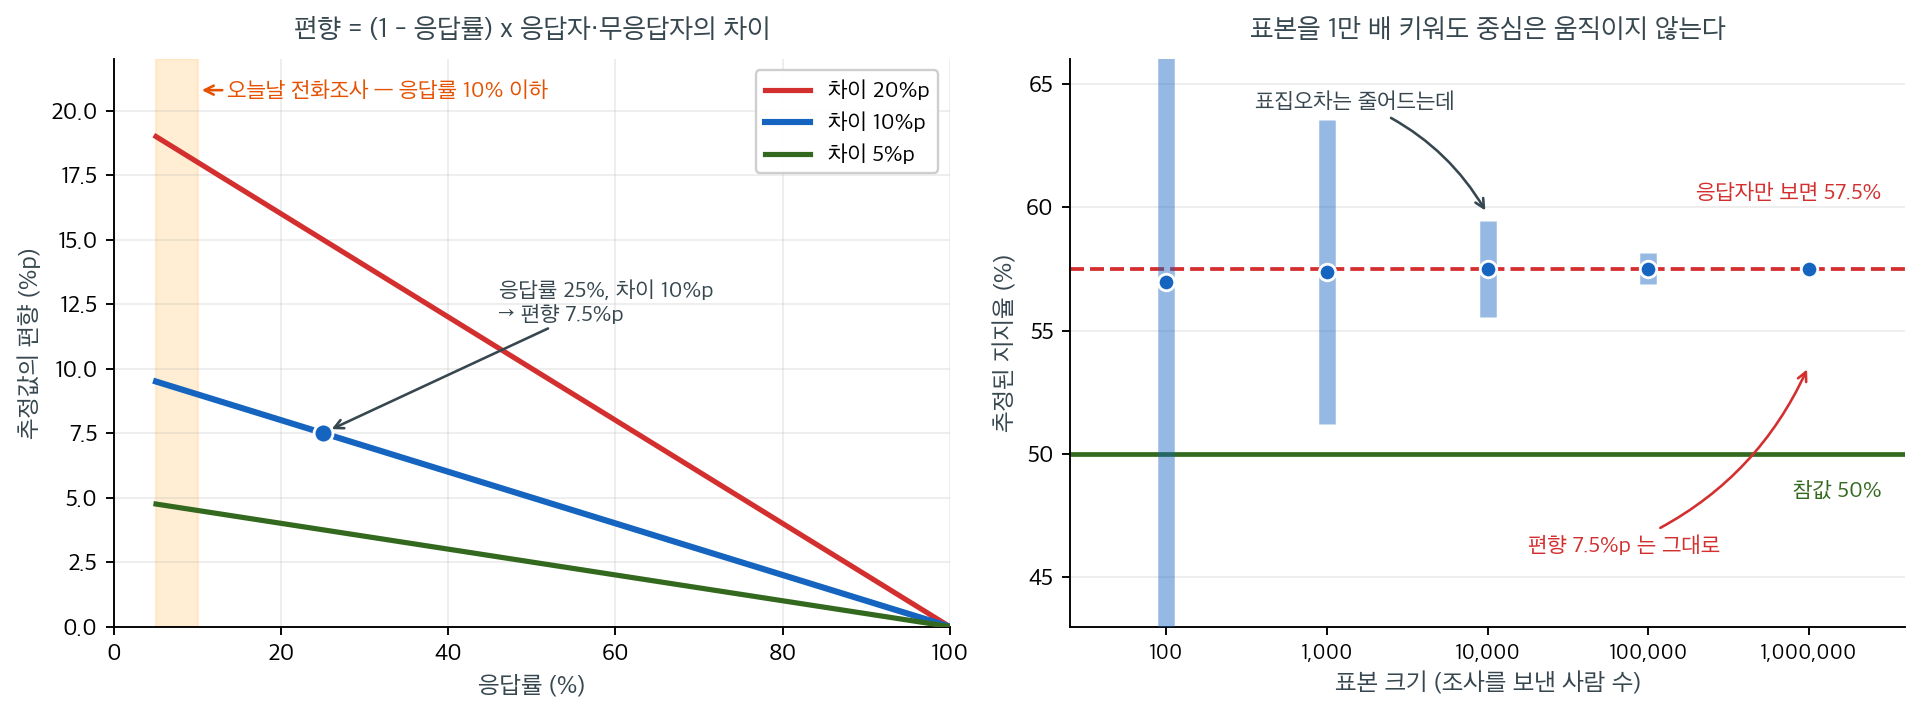
편향의 크기는 계산할 수 있다. 응답률을 \(r\), 응답자의 참 비율을 \(\mu_R\), 무응답자의 참 비율을 \(\mu_{NR}\)이라 하면 모집단 비율은 \(\mu = r\mu_R + (1-r)\mu_{NR}\)이므로, 응답자만으로 계산한 추정값의 편향은
이다. 왼쪽 그림이 이 식을 그린 것이다. 편향은 두 값의 곱이므로 어느 한쪽만 작아도 작아진다. 응답률이 100%면 무응답자가 아무리 달라도 편향이 0이고, 응답자와 무응답자가 똑같으면 응답률이 아무리 낮아도 편향이 0이다. 위험한 것은 낮은 응답률 그 자체가 아니라 낮은 응답률과 큰 차이가 겹칠 때다. 다만 응답률 10% 아래인 오늘날의 전화 조사에서는 \((1-r)\)이 거의 1이므로, 편향이 사실상 응답자·무응답자의 차이 전부가 된다.
오른쪽 그림이 이 절 전체의 요점이다. 참 지지율이 50%, 응답률이 25%, 응답자와 무응답자의 차이가 10%p인 조사를 표본 크기만 바꾸어 가며 4,000번씩 되풀이했다. 이때 응답자의 참 비율은 57.5%이고 편향은 7.5%p다. 조사 대상을 100명에서 1,000,000명으로 1만 배 늘리면 추정값의 95% 구간은 \([37.5,\,76.5]\)에서 \([57.3,\,57.7]\)로 폭이 39.0%p에서 0.39%p, 곧 100분의 1로 줄어든다. 그런데 구간의 중심은 57.49%, 57.50%, 57.50%, 57.49%, 57.50%로 한 걸음도 움직이지 않는다.
표본을 키워서 산 것은 정밀도뿐이고, 그 정밀도는 틀린 값에 대한 정밀도다. 100명 조사는 우연히 50%를 맞힐 때도 있지만 1,000,000명 조사의 95% 구간은 참값 50%를 아예 포함하지 못한다. 크게 하면 할수록 더 좁은 구간으로 더 자신 있게 틀린 답을 내놓는다. 이것이 표집오차와 편향의 결정적인 차이이며, 《Literary Digest》가 240만 부를 회수하고도 19%p를 빗나간 이유이기도 하다.
표집틀이 완벽한데도 틀리는 조사: 출구조사
출구조사는 무응답 편향을 관찰하기에 가장 깨끗한 실험실이다. 다른 조사들의 골칫거리가 여기에는 없기 때문이다.
- 표집틀 문제가 없다. 투표소에서 나오는 사람은 정의상 모두 유권자다.
- 투표 의향을 추정할 필요가 없다. 이미 투표한 사람만 있다.
- 표본이 작지 않다. 투표소마다 수백 명씩, 전국적으로 수만 명을 조사한다.
그런데도 출구조사는 자주 빗나가고, 여러 선거에 걸쳐 같은 방향으로 빗나간다. 남은 설명은 하나뿐이다. 면접원이 다가갔을 때 응하는 사람과 지나쳐 가는 사람이 정치적으로 다르다.
무엇이 응답 확률을 가르는지 생각해 보면 목록이 길다. 연령(고령 유권자가 낯선 사람의 설문을 더 자주 거절한다), 지지 후보에 대한 자신감, 자기 선택이 사회적으로 어떻게 보일지에 대한 의식, 투표소가 놓인 동네의 분위기. 이 중 어느 것이든 결과와 상관되어 있으면 그대로 편향이 된다.
핵심은 이것이다. 무응답 편향은 다른 편향을 다 없앤 뒤에도 남는다. 표집틀을 고쳐도, 표본을 키워도 사라지지 않는다. 그래서 출구조사 기관은 조사원별·투표소별 응답률을 기록하고 그것으로 보정하지만, 보정은 언제나 "관측된 특성이 같으면 응답자와 무응답자가 같다"는 검증 불가능한 가정 위에 서 있다(연습문제 4 참조).
응답(측정) 편향
응답자는 다음과 같은 이유로 부정확하게 답할 수 있다.
- 사회적 바람직성: 음주, 약물 사용, 비윤리적 행동은 축소 보고하고 투표, 기부, 운동은 과장 보고한다.
- 질문 표현: "정부가 X에 돈을 낭비해야 하는가?"와 "정부가 X에 투자해야 하는가?"는 같은 X에 대해 다른 답을 낳는다.
- 조사 방식 효과: 대면 면접은 익명 온라인 조사와 다른 답을 이끌어내며, 특히 민감한 주제에서 그렇다.
- 정박 효과와 회상 편향: 특정 사례를 떠올리게 하는 질문은 뒤따르는 답을 편향시킨다.
- 발주자 효과(sponsorship effect): 조사를 누가 의뢰했고 그 결과로 무엇을 얻는지가 표현·문항 순서·보고 방식에 스며든다.
조사를 누가 발주했는가
앞의 네 항목은 응답자 쪽의 문제다. 마지막 항목은 조사자 쪽의 문제이며, 실무에서 가장 다루기 어렵다.
대통령 지지율을 예로 들자. 지지율이 궁금한 사람 중에는 대통령실도 있다. 대통령실이 조사기관에 조사를 의뢰한다고 해 보자. 결과를 조작하는 극단적인 경우를 상정할 필요가 전혀 없다. 다음 정도면 충분하다.
- 문항 표현: "대통령이 국정 수행을 잘하고 있다고 보십니까?"와 "대통령의 국정 수행에 대해 어떻게 평가하십니까?"는 다른 숫자를 낸다. 앞쪽은 긍정 진술에 대한 동의를 묻고, 사람들은 낯선 진술에 동의하는 쪽으로 기운다(묵종 편향).
- 문항 순서: 지지율을 묻기 직전에 어떤 정책을 언급하느냐에 따라 답이 달라진다. 경제 위기를 먼저 물으면 지지율이 내려가고, 안보 성과를 먼저 물으면 올라간다.
- 보고 선택: 여러 문항을 조사한 뒤 발주자에게 유리한 문항만 발표한다. 이는 관찰연구의 체리피킹과 정확히 같은 구조이며, 조사가 여러 번 반복되면 가장 좋게 나온 회차만 발표하는 형태로도 나타난다.
세 경로 중 어느 것도 자료를 위조하지 않는다. 발표된 표본 크기와 오차범위는 모두 정직하다. 그런데도 숫자는 원하는 방향으로 움직인다.
조사 결과를 읽을 때 표본 크기보다 먼저 확인해야 할 것: 누가 발주했는가, 질문 전문이 공개되어 있는가, 몇 개의 문항 중 몇 개가 공개되었는가. 셋 중 하나라도 답할 수 없으면 그 숫자의 오차범위는 아무 의미가 없다.
선택(생존자) 편향
표본이 어떤 필터를 통과한 개체들로만 이루어지고, 걸러진 것들은 보이지 않는다. 뮤추얼펀드 수익률, 스타트업 성공 요인, 수술 결과 연구 등 많은 사례가 이에 해당하며, 생존자 편향 절에서 자세히 다룬다. 조사 실무에서 특히 자주 마주치는 세 가지는 다음과 같다.
건강근로자 효과(healthy worker effect). 취업자를 대상으로 한 연구는 거의 항상 근로자가 일반 인구보다 건강하다는 결과를 낸다. 일이 사람을 건강하게 만들어서가 아니라, 너무 아프거나 장애가 있어 일할 수 없는 사람이 "취업자" 표본에서 애초에 제외되기 때문이다. 직업병 연구에서 이 효과는 유해물질의 위험을 체계적으로 과소평가하는 방향으로 작용한다. 공장 노동자의 사망률을 일반 인구와 비교하면 유해물질에 노출되었는데도 더 낮게 나올 수 있다.
온라인 상품 리뷰. 별점이 압도적으로 높은 상품이 평균적 소비자의 경험을 반영하지는 않는다. 극도로 만족했거나 극도로 화가 난 사람이 리뷰를 남기고, 그저 무난하다고 느낀 다수는 침묵한다. 그 결과 평점 분포가 U자 모양이 된다. 여기에 판매자가 만족한 고객에게만 리뷰를 요청하면 왜곡이 한 겹 더해진다.
다이어트 프로그램 후기. 업체는 가장 성공한 참가자를 전면에 내세운다. 체중이 줄지 않았거나 중도에 그만둔 다수는 보이지 않는다. 이는 임상시험의 중도 탈락 문제(연습문제 6)와 정확히 같은 구조이며, 차이는 규제 여부뿐이다.
여론조사 기관 효과(house effect)
기관 효과는 무작위 오차가 아니라 방법론적 선택 때문에 조사 기관들 사이에 생기는 체계적 차이다. 주요 원인은 다음과 같다.
- 질문의 표현과 순서: 유도적이거나 모호한 표현이 응답을 좌우한다.
- 표집틀: 기관마다 다른 명부를 쓰면 인구 구성이 달라진다.
- 가중: 인구학적 불균형을 보정하는 통계적 조정 자체가 편향을 들여올 수 있다.
- 조사 방식: 전화, 온라인, 대면 조사는 서로 다른 성향의 응답자를 끌어들인다.
대응책은 다음과 같다.
- 여론조사 종합: 여러 기관의 결과를 평균내면(FiveThirtyEight, RealClearPolitics 등) 개별 기관의 편향이 상쇄된다.
- 질문 표현의 표준화: 기관 간 비교 가능성이 높아진다.
- 과거 정확도에 따른 가중: 실적이 좋은 기관에 더 큰 가중치를 준다.
- 방법론 공개: 전문가의 검증이 가능해진다.
- 혼합 방식 조사: 온라인·전화·대면을 결합해 응답자 층을 넓힌다.
종합이 만병통치약은 아니다
기관 효과가 서로 다른 방향이면 평균이 상쇄해 준다. 그러나 모든 기관이 같은 방향으로 틀리면 평균도 같은 방향으로 틀린다.
1948년이 정확히 그런 경우였다. 크로슬리·갤럽·로퍼가 모두 할당표집을 썼고 모두 공화당 쪽으로 치우쳤다. 셋을 평균내도 듀이가 이긴다. 2016년에도 대부분의 기관이 교육수준 가중을 하지 않아 같은 방향으로 빗나갔다.
여론조사 종합은 분산을 줄이지 편향을 줄이지 않는다. 이 페이지 첫머리의 정의로 돌아가면, 종합은 \(\mathrm{Var}(\hat\theta)\)를 낮출 뿐 \(\mathbb{E}[\hat\theta] - \theta\)에는 손대지 못한다.
완화 전략
| 편향 | 완화책 |
|---|---|
| 포괄 | 표집틀 개선, 보조 자료로 과소포괄 탐지 |
| 무응답 | 반복 재통화, 혼합 방식 후속 접촉, 사후층화 가중, IPW |
| 응답 | 익명성 보장, 질문 표현 사전시험, 가능하면 객관적 측정 |
| 선택 | 이탈 추적, 최초 등록된 모든 대상 포함(배정대로 분석) |
| 발주자 | 발주 주체 공개, 질문 전문과 조사한 문항 전체 공개, 사전등록 |
모든 완화책은 부분적이다. 편향은 자료를 더 모아도 낮출 수 없는 점근적 바닥이다.
보기 1. 편향과 무응답. 만족도 \(Y\)를 가진 \(1\)만 명에게 설문을 돌리는데, 응답할 확률이 만족도에 따라 직선으로 올라간다. \(p(y) = 0.1 + 0.08(y-1)\)이므로 \(1\)점은 \(10\%\), \(10\)점은 \(82\%\)가 답한다.
(1) 응답자 평균과 참 평균의 차이를 닫힌 꼴로 구하시오. 응답확률이 \(p(y) = a + by\) 꼴일 때 편향이 무엇으로 결정되는가.
(2) 그 식이 예측하는 편향과 모의실험이 내놓는 편향을 견주시오.
풀이
(1) 해석적으로. 응답자 집단에서 \(Y\)의 평균은 응답확률로 가중한 평균이다.
분자에 공분산의 정의 \(E[Yp(Y)] = \operatorname{Cov}(Y, p(Y)) + \mu\,E[p(Y)]\)를 넣으면
이다. 무응답 편향은 응답확률과 결과의 공분산을 응답률로 나눈 값이다. 이 한 줄이 모든 것을 말한다. 응답확률이 \(Y\)와 무관하면 공분산이 0이라 편향이 없고, 응답률이 낮을수록 같은 공분산이 더 크게 증폭된다.
응답확률이 \(p(y) = a + by\)로 직선이면 \(\operatorname{Cov}(Y, a+bY) = b\operatorname{Var}(Y)\)이고 \(E[p(Y)] = a + b\mu\)가 곧 응답률 \(r\)이므로
가 된다. 여기서는 \(p(y) = 0.02 + 0.08y\)라 \(b = 0.08\)이다. 편향이 결과의 분산에 비례한다는 점을 눈여겨볼 만하다. 모두가 비슷하게 만족한 집단이라면 누가 답하든 상관없지만, 의견이 갈릴수록 누가 답하느냐가 결정적이 된다.
(2) 수치적으로. 아래 코드가 만든 모집단에서 \(\operatorname{Var}(Y) = 3.8523\), \(E[p(Y)] = 0.4584\)이므로 예측 편향은
이다. 모의실험이 내놓은 편향은 \(+0.65\)다. 둘의 차이 \(0.027\)은 응답 여부를 동전으로 정한 데서 오는 몬테카를로 오차다. 응답자가 \(4{,}566\)명이고 그들의 만족도 표준편차가 대략 \(1.8\)이므로 응답자 평균의 표준오차가 \(1.8/\sqrt{4566} = 0.027\)이고, 어긋남이 정확히 그 한 칸이다.
응답확률을 그대로 가중치로 써서 "무한히 많이 설문했을 때의 응답자 평균"을 계산하면 \(6.1524\)가 나오는데, 이는 참값 \(5.4801\)에 예측 편향 \(0.6723\)을 더한 값과 정확히 같다. 유도한 식이 맞는다.
응답률 \(45.7\%\)는 나쁘지 않은 숫자처럼 들린다. 그런데 그 응답이 만족도와 엮여 있으므로 \(10\)점 만점에 \(0.67\)점, 곧 참값의 \(12\%\)가 부풀려졌다. 표본을 \(10\)만 명으로 늘려도 이 편향은 그대로 남는다. 표본크기는 편향을 줄이지 않는다.
"""응답 여부가 결과와 상관되면 추정값이 왜곡된다."""

import numpy as np

rng = np.random.default_rng(42)
n_pop = 10_000

# 1단계: 모집단 전체의 참 만족도. 평균 5.5의 정규분포를 1~10점으로 자른다.
# 이 값은 우리가 모의실험에서만 알 수 있다. 현실에서는 관측되지 않는다.
satisfaction = np.clip(rng.normal(5.5, 2.0, n_pop), 1, 10)

# 2단계: 무응답 편향의 핵심 — 응답 확률이 만족도에 따라 달라진다.
#   만족도 1점: 0.1 + 0.08*0  = 10% 응답
#   만족도 10점: 0.1 + 0.08*9 = 82% 응답
# 만족한 사람일수록 설문에 답할 확률이 높다. 실제 고객 설문에서 흔한 양상이다.
response_prob = 0.1 + 0.08 * (satisfaction - 1)

# 각자 자기 확률로 동전을 던져 응답 여부를 정한다
responded = rng.binomial(1, response_prob).astype(bool)

# 3단계: 진실과 우리가 보게 될 값을 비교한다.
#   true_mean   모집단 전체의 평균 (알 수 없는 참값)
#   biased_mean 응답자만의 평균   (설문 보고서에 실릴 값)
true_mean = satisfaction.mean()
biased_mean = satisfaction[responded].mean()
print(f"True population mean:    {true_mean:.2f}")
print(f"Biased survey mean:      {biased_mean:.2f}")
print(f"Bias (overestimate):     {biased_mean - true_mean:+.2f}")
print(f"Response rate:           {responded.mean():.1%}")

# --- (1) 의 공식과 맞추어 본다 ---
mu = satisfaction.mean()
var = satisfaction.var(ddof=0)
r = response_prob.mean()
print(f"Var(Y) = {var:.4f},  E[p(Y)] = {r:.4f}")
print(f"예측 편향 = b*Var(Y)/E[p] = {0.08 * var / r:.4f}")
print(f"공분산 항등식 Cov(Y,p)/E[p] = {np.cov(satisfaction, response_prob, ddof=0)[0, 1] / r:.4f}")
print(f"무한표본 응답자 평균 = {(satisfaction * response_prob).sum() / response_prob.sum():.4f}")
출력:
True population mean:    5.48
Biased survey mean:      6.13
Bias (overestimate):     +0.65
Response rate:           45.7%
Var(Y) = 3.8523,  E[p(Y)] = 0.4584
예측 편향 = b*Var(Y)/E[p] = 0.6723
공분산 항등식 Cov(Y,p)/E[p] = 0.6723
무한표본 응답자 평균 = 6.1524
더 만족한 고객이 더 많이 응답하기 때문에 보고된 평균이 참된 만족도를 과대평가한다. 응답 기제를 모형화하지 않고서는 줄일 수 없는 편향이다.
연습문제
연습문제 1. 다음 각 상황에서 편향의 유형(표집, 무응답, 응답, 선택/생존자)을 식별하라.
(a) 어떤 잡지가 구독자에게 정치 여론조사를 우편으로 보낸다. 15%만 응답했고, 응답자는 무응답자보다 의견이 더 강하다. (b) 한 뮤추얼펀드 회사가 현재 운용 중인 펀드의 우수한 성과를 광고하면서, 성과가 나빠 청산된 펀드는 언급하지 않는다. (c) 평일 업무시간에 실시한 전화 조사가 일하는 성인을 놓친다. (d) 대면 면접에서 응답자가 자신의 음주량을 축소 보고한다. (e) 직무 만족도에 관한 링크드인 설문이 트위터에서 널리 공유되는데, 트위터에서는 불만족한 직장인이 더 목소리를 낸다.
풀이
(a) 무응답 편향 — 85%의 무응답자가 체계적으로 다르다. (b) 생존자(선택) 편향 — 실패한 펀드가 평균에서 제외되었다. (c) 표집(포괄) 편향 — 통화 시간대에 표집틀이 근무 중인 사람을 배제한다. (d) 응답 편향 — 사회적 바람직성이 보고된 음주량을 낮춘다. (e) 복합적이다. 누가 설문을 보게 되는지에 대한 선택 편향(트위터에서 활발한 링크드인 사용자)과, 누가 응답하기로 선택하는지에 대한 무응답 편향(가장 목소리 큰 사람이 과다 응답)이 함께 있다.
연습문제 2. 어떤 진료소가 환자에게 통증을 조사한다. 설문은 "오늘 통증이 0–10점 척도에서 얼마나 심한가요?"라고 묻는다. 환자의 40%가 응답하지 않는다. 진료소는 응답자들의 평균 통증 점수 4.3을 계산해 이를 환자 모집단의 평균 통증으로 보고한다. 추가 정보 없이 편향의 방향에 대해 무엇을 말할 수 있는가?
풀이
방향에 대해 확정적으로 말할 수 있는 것은 없다. 분포의 양쪽 꼬리 어느 쪽이든 과다 또는 과소 응답할 수 있다.
- 통증이 아주 심한 환자는 너무 힘들어서 설문지를 작성하지 못할 수 있다 → 아래쪽으로 편향.
- 통증이 아주 심한 환자가 임상의에게 알리려는 동기가 가장 클 수도 있다 → 위쪽으로 편향.
- 통증이 약한 환자는 중요하지 않다고 여겨 설문을 건너뛸 수 있다 → 위쪽으로 편향.
보조 정보(차트에 기록된 진통제, 관찰된 찡그림, 후속 접촉)가 없으면 방향을 식별할 수 없다. 점추정값은 어느 방향으로든 편향되어 있지만, 통계 밖의 모형 없이는 어느 쪽인지 말할 수 없다.
방향은 몰라도 크기는 셀 수 있다. 본문의 공식에 응답률 \(r = 0.6\)을 넣으면
이다. 무응답자가 응답자보다 평균 \(1\)점 더 아팠다면 보고된 \(4.3\)은 참값을 \(0.4\)점 과소평가한 것이고, \(2\)점 더 아팠다면 \(0.8\)점이다.
척도가 \(0\)–\(10\)으로 유계이므로 아무 가정 없이도 경계를 그을 수 있다. \(\mu_{NR} \in [0, 10]\)을 그대로 대입하면
로, 폭이 \(0.4 \times 10 = 4\)점이다. 연습문제 8의 만스키 경계를 이 진료소 자료에 그대로 적용한 것이다. 응답률 \(60\%\)는 요즘 기준으로 나쁘지 않은데도 무가정 구간이 척도의 \(40\%\)를 덮는다.
현실적인 해법: 응답률을 80% 이상으로 끌어올리거나, 차트 자료로 응답 성향을 추정해 그에 따라 가중한다.
연습문제 3. 편향과 분산을 구분하라. 같은 편향된 표집틀에서 유권자 50명을 조사한 것과 50,000명을 조사한 것은 정밀도가 크게 다른 추정값을 준다. 어느 쪽이 "더 정확한가"?
풀이
정확도를 참값으로부터의 총오차가 작은 것으로 정의하자: \(\mathrm{MSE} = \mathrm{bias}^2 + \mathrm{variance}\). 크지만 편향된 조사는 분산이 아주 작지만(신뢰구간이 좁지만) 총오차를 편향 항이 지배한다. 작지만 불편인 조사는 분산이 크고 편향이 0이다.
편향을 측정하지 않는 한 어느 쪽이 명확히 더 "정확하다"고 할 수 없지만, 크고 편향된 조사는 더 자신 있게 틀린 답을 준다. 같은 편향된 과정을 여러 번 반복하면 50,000명 조사는 자신이 보고한 신뢰구간 밖의 추정값을 일상적으로 내놓게 되는데, 이는 그 신뢰구간이 오도한다는 증거다.
편향된 조사들의 메타분석은 더 나쁘다. 편향된 조사를 평균 내면 참값이 아니라 편향의 점근값으로 수렴한다. 해법은 조사를 더 하는 것이 아니라 표집틀을 고치는 것이다.
연습문제 4. 사후층화는 가중된 인구학적 구성이 (인구총조사 등에서 얻은) 알려진 모집단 주변분포와 일치하도록 응답자에게 다시 가중치를 주는 방법이다. 사후층화가 편향을 줄이는 경우와 줄이지 못하는 경우를 설명하라.
풀이
응답을 결정하는 변수가 사후층화에 쓰는 변수와 같을 때 편향을 줄인다. 젊은 사람이 응답을 덜 하는데 연령 자료가 있다면, 주어진 연령의 응답자가 그 연령의 모든 사람을 대표한다는 가정 아래 연령별 사후층화가 편향을 보정한다.
층 내부에 잔여 무응답이 있으면 편향을 줄이지 못한다. 도시에 사는 30세 남성 응답자는 도시에 사는 30세 남성 무응답자와 결과 변수에서 여전히 다를 수 있다. 인구학적 특성이 같다고 해서 서로 대체 가능한 것은 아니다. 관측되지 않은 어떤 특성(소득, 생활양식, 의견의 강도)이 응답과 결과 모두와 상관되어 있을 수 있다.
사후층화의 밑바탕에 있는 가정은 "사후층화 변수를 조건부로 한 무작위 결측"이다. 이것은 자료로부터 검증할 수 없다. 가중 변수를 강화하면(공변량을 늘리고 칸을 잘게 쪼개면) 일반적으로 편향은 줄지만 분산은 커진다 — 편향–분산 절충이 조사 가중에서 다시 나타나는 것이다.
연습문제 5. 2016년 미국 대통령 선거 여론조사는 트럼프 지지를 체계적으로 과소평가했으며, 특히 러스트벨트 경합주에서 그랬다. 여기에 기여한 서로 다른 두 기제를 밝히고, 선거 전에 왜 포착되지 않았는지 설명하라.
풀이
기제 1 — 차별적 무응답("수줍은 트럼프 지지자"): 트럼프 지지자는 여론조사에 응하거나 선호를 밝히기를 꺼렸을 수 있으며, 특히 트럼프 지지가 사회적으로 낙인찍힌 지역에서 그랬다. 객관적 지표가 없으니 여론조사는 낮게 표현된 선호를 그대로 참값으로 다루었다.
기제 2 — 교육수준 가중: 러스트벨트 여론조사는 대학 미진학 유권자에게 낮은 가중치를 주었다(이들은 전화 조사 응답률이 낮았고 표준적인 인구학적 가중 후에도 과소대표되었다). 대학 미진학 유권자 사이의 트럼프 지지는 역사적으로 높은 수준이었으므로, 이들에게 낮은 가중치를 주면 과소추정이 생긴다.
왜 포착되지 않았는가: 2016년 선거는 이 특정한 역학이 대규모로 나타난 첫 사례였다. 여론조사는 민주–공화 응답률과 인구학적 상관이 달랐던 2012년 양상에 맞춰 보정되어 있었다. 2016년 이후 대부분의 주요 여론조사 기관이 교육수준 가중을 추가하고 응답 편향을 보정했다. 2020년 조사는 나아졌지만 여전히 여러 주에서 바이든의 격차를 과대평가했으며, 잔여 문제가 남아 있음을 시사한다.
연습문제 6. 어떤 제약 연구가 12주 요법을 완료한 환자에게서 증상이 30% 호전되었다고 보고한다. 등록된 환자의 약 40%가 12주 전에 중도 탈락했다. 이 결론이 왜 오도할 수 있으며, 배정대로 분석(ITT) 은 이를 어떻게 다루는가?
풀이
중도 탈락한 환자는 "완료자" 표본에서 제외된다. 탈락은 무작위가 아니다. 부작용(약물 불내성), 효과가 없다고 느낌, 건강 악화가 모두 흔한 이유다. 완료자는 선택된 부분집합이며, 대체로 약이 듣거나 약을 견딜 수 있는 사람들이다. 완료자의 호전만 보고하면 그 약이 처방될 일반 모집단에 대한 효과를 과대평가하게 된다.
배정대로 분석(ITT) 은 순응이나 완료 여부와 무관하게 모든 환자를 원래 배정된 집단에 넣어 분석한다. 중도 탈락한 환자는 마지막으로 관측된 결과(또는 지정된 결측 자료 모형 아래에서 대체한 값)와 함께 분석에 남는다. 이 추정값은 처치를 온전히 받지 않은 환자를 포함하므로 효과가 희석되어 보수적이지만, "이 약을 견디며 12주를 채운 사람에게 약이 얼마나 잘 듣는가?"가 아니라 "이 약을 환자 모집단에 처방했을 때 기대되는 이익은 무엇인가?"라는 정책 질문에 답한다.
선택 편향이 보고된 효과를 부풀리는 것을 막아주기 때문에 ITT가 규제 제출의 표준인 것이다.
연습문제 7. 결측 자료는 세 가지 기제로 나뉜다. MCAR(완전 무작위 결측), MAR(관측값을 조건부로 한 무작위 결측), MNAR(비무작위 결측). 세 경우를 모의실험하고, 사후층화가 어느 것을 고칠 수 있는지 보여라.
풀이
import numpy as np

rng = np.random.default_rng(0)
n = 200_000
age = rng.normal(50, 15, n)
y = 30 + 0.5 * age + rng.normal(0, 10, n)          # 결과변수
truth = y.mean()

bins = np.digitize(age, np.quantile(age, np.linspace(0, 1, 21)[1:-1]))

def poststratify(resp):
    est = 0.0
    for b in range(21):
        cell = bins == b
        if cell.sum() and (cell & resp).sum():
            est += cell.mean() * y[cell & resp].mean()
    return est

mechanisms = [
    ("MCAR", rng.random(n) < 0.5),                                  # 응답이 무관
    ("MAR",  rng.random(n) < 1 / (1 + np.exp(-(age - 50) / 10))),   # 나이에 의존
    ("MNAR", rng.random(n) < 1 / (1 + np.exp(-(y - truth) / 10))),  # y 자체에 의존
]

print(f"참 평균 {truth:.4f}\n")
print(f"{'기제':>6}{'단순평균':>11}{'편향':>9}{'사후층화':>11}{'편향':>9}")
for label, resp in mechanisms:
    adj = poststratify(resp)
    print(f"{label:>6}{y[resp].mean():>11.4f}{y[resp].mean() - truth:>+9.4f}"
          f"{adj:>11.4f}{adj - truth:>+9.4f}")
출력:
참 평균 55.0028

    기제       단순평균       편향       사후층화       편향
  MCAR    55.0205  +0.0177    55.0209  +0.0181
   MAR    58.9392  +3.9364    55.0472  +0.0444
  MNAR    60.9772  +5.9744    59.2198  +4.2170
결과가 세 기제의 성격을 그대로 보여 준다.
| 기제 | 단순평균 편향 | 사후층화 후 |
|---|---|---|
| MCAR | \(+0.02\) | \(-\) (보정 불필요) |
| MAR | \(+3.94\) | \(+0.04\) 완치 |
| MNAR | \(+5.97\) | \(+4.22\) 거의 못 고침 |
세 기제의 정의.
- MCAR: 응답 여부가 관측값·미관측값 어느 것과도 무관하다. 응답자는 그냥 작은 무작위 표본이라 편향이 없다. 표본이 줄어드는 손해만 있다.
- MAR: 응답 여부가 관측된 변수(여기서는 나이)에만 의존한다. 그 변수로 가중하면 편향이 사라진다. 이름이 오해를 부르는데, "무작위 결측"이 아니라 "관측값을 조건부로 하면 무작위" 라는 뜻이다.
- MNAR: 응답 여부가 관측되지 않은 결과값 자체에 의존한다. 소득이 높은 사람이 소득을 밝히지 않는 경우가 전형이다. 나이로 아무리 가중해도 각 나이 층 안에서 여전히 높은 \(y\)를 가진 사람이 빠져 있으므로 편향이 남는다.
핵심은 MAR과 MNAR을 자료로 구별할 수 없다는 것이다. 응답자만 보고서는 무응답자가 어떤 값을 가졌을지 알 방법이 없다. 위 모의실험에서 두 경우의 응답률은 모두 \(0.50\)이고 응답자 자료도 겉보기에 비슷하다.
그러므로 "MAR을 가정한다"는 말은 검증된 사실이 아니라 선언이다. 다중대체, 역확률가중, 최대가능도 결측 처리 등 표준적인 방법이 모두 MAR을 전제한다. MNAR이 의심되면 민감도 분석으로 "MNAR이 얼마나 심해야 결론이 뒤집히는가"를 따져야 한다. \(\square\)
연습문제 8. 아무 가정도 하지 않으면 무응답이 있을 때 무엇을 말할 수 있는가? 이진 결과에 대한 만스키 경계를 유도하고 응답률에 따라 어떻게 넓어지는지 보여라.
풀이
모집단 비율 \(p\)를 전체 기댓값의 법칙으로 쪼개면
이다. 모르는 항은 \([0, 1]\) 안에 있다는 것밖에 말할 수 없으므로
이고, 구간의 폭은 정확히 \(1-r\), 곧 무응답률이다.
import numpy as np

rng = np.random.default_rng(0)
n, p_true = 200_000, 0.40
y = rng.random(n) < p_true

print(f"참 비율 {p_true}\n")
print(f"{'응답률':>8}{'응답자 비율':>13}{'무가정 하한':>13}{'무가정 상한':>13}{'폭':>8}")
for r in (0.9, 0.7, 0.5, 0.25):
    resp = rng.random(n) < r
    p_r, rate = y[resp].mean(), resp.mean()
    lo, hi = p_r * rate, p_r * rate + (1 - rate)
    print(f"{rate:>8.2f}{p_r:>13.4f}{lo:>13.4f}{hi:>13.4f}{hi - lo:>8.4f}")
출력:
참 비율 0.4

     응답률       응답자 비율       무가정 하한       무가정 상한       폭
    0.90       0.4008       0.3605       0.4612  0.1008
    0.70       0.3989       0.2790       0.5797  0.3007
    0.50       0.3982       0.1990       0.6992  0.5001
    0.25       0.4020       0.1007       0.8502  0.7495
여기서는 결측이 MCAR이라 응답자 비율이 언제나 \(0.40\) 근처인데도 경계는 응답률에 따라 이렇게 넓어진다.
| 응답률 | 무가정 경계 |
|---|---|
| \(90\%\) | \([0.36,\ 0.46]\) |
| \(50\%\) | \([0.20,\ 0.70]\) |
| \(25\%\) | \([0.10,\ 0.85]\) |
응답률 \(25\%\)면 경계가 \([0.10, 0.85]\)로 사실상 아무 말도 하지 못한다. 오늘날 전화 조사의 응답률이 대개 \(10\%\) 이하라는 점을 생각하면 이것이 무엇을 뜻하는지 분명하다.
이 계산의 의의. 만스키의 논점은 "그러니 조사를 믿지 말라"가 아니다. 가정 없이 얻을 수 있는 것이 얼마나 적은지를 보여 줌으로써, 발표되는 좁은 신뢰구간이 전적으로 가정에서 나온 것임을 드러내는 것이다.
발표된 \(\pm 3\%\)포인트는 응답자가 무응답자를 대표한다는(또는 가중 변수를 조건부로 그렇다는) 가정 아래에서만 성립한다. 표집 오차만 보고하고 무응답 가정을 밝히지 않는 것이 문제다.
실무에서는 두 극단 사이의 중간 가정을 쓴다. 예컨대 "무응답자의 비율이 응답자와 \(10\)%포인트 이상 다르지는 않을 것"이라고 두면 훨씬 좁은 구간을 얻는다. 요점은 가정을 명시하고, 그것을 바꾸면 결론이 얼마나 달라지는지 보이는 것이다. \(\square\)
연습문제 9. 연습문제 6의 ITT를 정량화하라. 순응하지 않는 환자가 있을 때 ITT, 프로토콜 준수 분석, CACE가 각각 무엇을 추정하는지 모의실험으로 보여라.
풀이
import numpy as np

rng = np.random.default_rng(1)
n = 200_000

complier = rng.random(n) < 0.6          # 60% 만 실제로 복용한다
Z = rng.random(n) < 0.5                 # 무작위 배정
D = Z & complier                        # 실제 복용 여부

baseline = np.where(complier, 0.0, -3.0)   # 순응자가 원래 상태가 더 좋다
tau = 5.0                                   # 순응자에 대한 참 효과
Y = 50 + baseline + tau * D + rng.normal(0, 10, n)

itt = Y[Z].mean() - Y[~Z].mean()
per_protocol = Y[D].mean() - Y[~Z].mean()
as_treated = Y[D].mean() - Y[~D].mean()
compliance = D[Z].mean() - D[~Z].mean()

print(f"순응자에 대한 참 효과 {tau}")
print(f"  ITT              {itt:.4f}   (= {tau} x 0.6 = {tau * 0.6:.2f})")
print(f"  프로토콜 준수     {per_protocol:.4f}   ← 위로 편향")
print(f"  실제 복용 기준    {as_treated:.4f}   ← 위로 편향")
print(f"  CACE = ITT/순응률 {itt / compliance:.4f}   ← 참값 회복")
print(f"  순응률 {compliance:.4f}")
출력:
순응자에 대한 참 효과 5.0
  ITT              2.9529   (= 5.0 x 0.6 = 3.00)
  프로토콜 준수     6.1279   ← 위로 편향
  실제 복용 기준    6.6512   ← 위로 편향
  CACE = ITT/순응률 4.9126   ← 참값 회복
  순응률 0.6011
세 추정값이 서로 다른 것을 추정한다.
ITT \(= 2.95\). 배정대로 분석한 값이다. 참 효과 \(5.0\)의 \(60\%\)인데, 배정된 사람의 \(60\%\)만 실제로 복용했기 때문이다. 이것은 편향이 아니라 다른 질문에 대한 정답이다. "이 약을 처방하면 무슨 일이 일어나는가"에 답한다. 순응이 완벽하지 않은 현실 세계의 정책 효과다.
프로토콜 준수 분석 \(= 6.13\). 위로 편향되어 있다. 복용한 사람은 무작위 배정으로 정해진 집단이 아니라 스스로 순응을 택한 사람들이고, 여기서는 그들이 원래 건강 상태도 좋았다. 무작위화의 이점을 통째로 버린 분석이다.
CACE \(= 4.91\). ITT를 순응률로 나누면 순응자에 대한 인과효과가 복원된다. 이는 사실 도구변수 추정과 같은 계산이며, 배정 \(Z\)를 도구로 쓴 것이다.
어느 것을 보고해야 하는가.
| 질문 | 추정량 |
|---|---|
| 이 약을 처방하면 어떻게 되는가 (정책) | ITT |
| 약 자체의 생물학적 효과는 무엇인가 | CACE |
| (거의 언제나 틀림) | 프로토콜 준수 |
규제 당국이 ITT를 기본으로 요구하는 이유는 두 가지다. 보수적이고(효과를 과대평가하지 않는다), 무작위화를 온전히 보존한다. 프로토콜 준수 분석은 좋아 보이는 결과를 만들어 내기 쉬워서 특히 경계 대상이다.
CACE의 한계도 분명하다. 이는 순응자라는 관측 불가능한 부분모집단에 대한 효과이며, 그들이 누구인지 알 수 없고 다른 상황에서 순응자 집단은 달라진다. \(\square\)
연습문제 10. 본문의 응답(측정) 편향을 설계로 해결하는 방법이 있다. 민감한 질문에 대한 무작위 응답 기법을 구현하고, 무엇을 대가로 치르는지 보여라.
풀이
절차. 응답자가 혼자 동전을 던진다.
- 앞면이면 → 민감한 질문에 진실을 답한다.
- 뒷면이면 → 동전을 한 번 더 던져 앞면이면 "예", 뒷면이면 "아니오"라고 답한다.
조사자는 동전 결과를 볼 수 없다. 따라서 어떤 개인의 "예"도 그 사람이 실제로 해당한다는 증거가 되지 못한다. 개인의 부인 가능성이 보장되므로 정직하게 답할 유인이 생긴다.
추정. "예"라고 답할 확률은
이므로 \(\hat p = 2\hat P(\text{예}) - \tfrac{1}{2}\)로 되돌린다.
import numpy as np

rng = np.random.default_rng(2)
N = 100_000

print(f"{'참 비율':>8}{'예 응답률':>11}{'추정':>9}{'SE':>9}{'직접질문 SE':>13}{'배수':>7}")
for p_true in (0.05, 0.20, 0.40):
    truth = rng.random(N) < p_true
    first = rng.random(N) < 0.5              # 첫 동전: 앞면이면 진실
    second = rng.random(N) < 0.5             # 둘째 동전
    answer = np.where(first, truth, second)

    p_hat = 2 * answer.mean() - 0.5
    se = 2 * np.sqrt(answer.mean() * (1 - answer.mean()) / N)
    se_direct = np.sqrt(p_true * (1 - p_true) / N)
    print(f"{p_true:>8.2f}{answer.mean():>11.4f}{p_hat:>9.4f}{se:>9.5f}"
          f"{se_direct:>13.5f}{se / se_direct:>7.1f}배")
출력:
    참 비율      예 응답률       추정       SE      직접질문 SE     배수
    0.05     0.2739   0.0479  0.00282      0.00069    4.1배
    0.20     0.3507   0.2014  0.00302      0.00126    2.4배
    0.40     0.4518   0.4037  0.00315      0.00155    2.0배
추정값이 참값을 정확히 되찾는다.
대가는 분산이다. 표준오차가 직접 질문의 \(2\)–\(4\)배로 커지며, 참 비율이 작을수록 손해가 크다. 같은 정밀도를 얻으려면 표본이 \(4\)–\(16\)배 필요하다.
그럼에도 쓰는 이유. 직접 질문의 답이 편향되어 있다면 아무리 표본을 키워도 소용이 없다. 앞서 여러 번 본 구조 그대로다. 분산은 표본으로 살 수 있지만 편향은 살 수 없다. 마약 사용, 탈세, 시험 부정행위, 낙인찍힌 질병처럼 축소 보고가 심한 주제에서는 이 맞바꿈이 명백히 유리하다.
한계.
- 응답자가 절차를 이해하고 믿어야 한다. 실제 조사에서 "이게 정말 익명이 맞나" 하고 의심해 그냥 "아니오"를 택하는 경우가 보고된다.
- 집단 수준 비율만 얻는다. 개인 수준 자료가 없으므로 다른 변수와의 관계를 분석하기 어렵다.
- \(\hat p\)가 \(0\)보다 작거나 \(1\)보다 큰 값으로 나올 수 있다. 참 비율이 아주 작고 표본이 작으면 실제로 일어난다.
같은 착상의 변형으로 목록 실험(민감 항목을 넣은 목록과 뺀 목록의 "해당 개수" 평균을 비교)이 있으며, 정치학과 사회학에서 널리 쓰인다. \(\square\)
정리하며
편향은 \(\mathrm{bias}(\hat\theta)=\mathbb{E}[\hat\theta]-\theta\) 이며, 기댓값이 반복 표집 과정에 대한 것이라는 점이 핵심이다. 그래서 표본을 더 뽑아도 사라지지 않는다.
- 표집(포괄) 편향. 표집틀에 없는 사람은 선택 확률이 0이고 분석에서 보이지 않는다.
- 무응답 편향. 응답률 자체보다 무응답자가 응답자와 다른 방향이 문제다. 응답률 90%라도 빠진 10%가 한쪽으로 쏠려 있으면 위험하다.
- 응답(측정) 편향. 사회적으로 바람직한 답 쪽으로 기운다. 질문 문구·순서·응답 척도가 모두 답을 바꾼다.
- 선택 편향. 자료에 포함되는 조건 자체가 결과와 상관된다. 1.4절의 나머지 세 절이 이 한 가지 주제의 변주다.
《Literary Digest》의 숫자를 다시 보라. 240만 명으로 57% 대 43%라 했고 실제는 38% 대 62%였다. 19%p 가 틀렸는데 표본은 역사상 최대급이었다. 반면 갤럽은 5만 명으로 맞혔다. 편향이 있을 때 큰 표본은 정확도가 아니라 자신감만 키운다.
다음 절 생존자 편향부터 세 절에 걸쳐, 자료가 우리를 속이는 구체적인 기제들을 하나씩 뜯어본다. 모두 "무엇이 자료에 남았는가"라는 같은 물음의 다른 얼굴이다.