대응표본 비모수 검정
대응표본 Wilcoxon 부호순위검정
대응표본 Wilcoxon 부호순위검정은 대응 관측값 사이의 중앙값 차이가 0과 유의하게 다른지 판정하는 비모수 검정이다. 자료가 정규성 가정을 만족하지 않을 때 대응 t 검정의 비모수 대안으로 쓰인다.
주요 특징
- 목적: 대응 관측값 사이의 중앙값 차이가 0인지 검정한다.
- 귀무가설 (\(H_0\)): 대응표본 차이의 중앙값이 0이다.
- 대립가설 (\(H_a\)):
- 양측: 중앙값 차이가 0이 아니다.
- 단측: 중앙값 차이가 0보다 크거나, 0보다 작다.
- 자료 요건:
- 자료가 대응되어 있고 연속형 또는 순서형이어야 한다.
- 쌍 사이의 차이가 대칭으로 분포해야 한다.
검정 절차
1단계: 차이 계산
대응 관측값 사이의 차이를 계산한다.
\(d_i = 0\)인 쌍은 무시한다(검정에서 제외된다).
2단계: 절대차이 순위 매기기
절댓값 \(|d_i|\)를 오름차순으로 순위를 매기고, 필요하면 동점 순위를 배정한다.
3단계: 순위에 부호 배정
각 차이의 부호를 대응하는 순위에 배정한다.
4단계: 검정통계량 계산
- 양의 차이들의 순위합: \(W^+\)
- 음의 차이들의 순위합: \(W^-\)
- 검정통계량: \(W = \min(W^+, W^-)\)
5단계: 유의성 판정
- 주어진 표본크기와 유의수준 \(\alpha\)에 대해 Wilcoxon 부호순위검정표의 임계값과 \(W\)를 비교한다.
- 표본이 크면(\(n > 20\)) 정규근사를 쓴다.
정규근사의 분자에는 \(W^+\)를 쓴다
표준화할 때 분자에 넣는 것은 \(W = \min(W^+, W^-)\)가 아니라 \(W^+\)(또는 \(W^-\) 중 하나를 일관되게)이다. \(\min\)을 쓰면 언제나 \(Z \le 0\)이 되어 방향 정보가 사라진다.
양측검정에서는 \(\min\)을 쓰고 \(|Z|\)를 보아도 같은 결과가 나오지만, 단측검정에서는 반드시 \(W^+\)를 써야 한다.
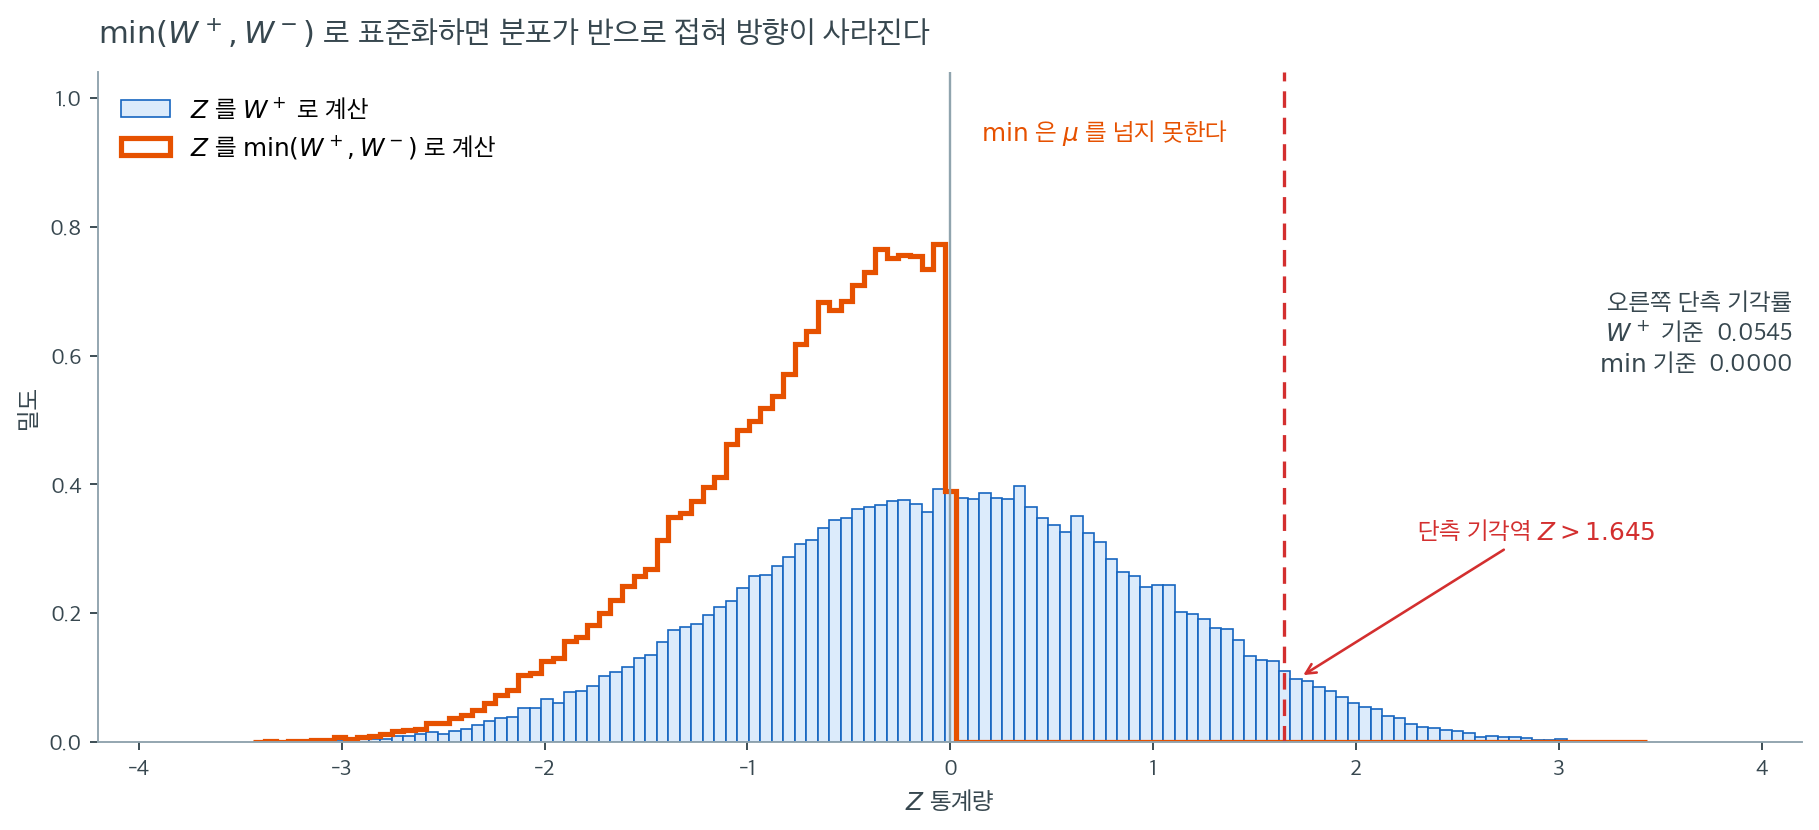
말로만 들으면 사소한 표기 문제 같지만 결과는 그렇지 않다. \(n = 15\)인 자료를 \(H_0\) 아래에서 \(60{,}000\)번 만들어 두 방식으로 \(Z\)를 계산한 것이 위 그림이다.
옅은 파란 히스토그램이 \(W^+\)로 표준화한 \(Z\)이다. \(0\)을 중심으로 좌우대칭이고 표준정규에 가깝다. 오른쪽 꼬리 \(Z > 1.645\)로 떨어지는 비율이 \(0.0545\)로 명목수준과 맞는다. 이 분포는 "양의 차이가 우세한가 음의 차이가 우세한가"를 좌우로 구별해 담고 있다.
주황 윤곽선이 \(\min(W^+, W^-)\)로 표준화한 \(Z\)이다. 모양이 전혀 다르다. \(\min\)은 정의상 \(W^+\)와 \(W^-\) 중 작은 쪽이고 둘의 합이 \(n(n+1)/2 = 120\)으로 고정되어 있으므로 \(\min \le 60 = \mu\)가 항상 성립한다. 따라서 \(Z\)가 결코 \(0\)을 넘지 못하고, 분포가 \(0\)에서 칼로 자른 듯 끊긴 채 왼쪽으로 접혀 있다. 오른쪽 단측 기각률은 \(0.0000\)이다. 오른쪽 단측검정을 \(\min\)으로 수행하면 어떤 자료가 와도 기각하지 못한다.
양측검정에서는 왜 괜찮은가. \(|Z|\)를 보는 순간 접힌 분포와 접히기 전 분포가 같은 대답을 주기 때문이다(모의실험에서 양측 기각률이 두 방식 모두 \(0.0484\)였다). 그러나 이것은 우연한 일치일 뿐 원칙이 아니다. \(W^+\)를 일관되게 쓰고 부호로 방향을 읽는 습관을 들이면 단측·양측을 가리지 않고 안전하다.
보기 1. 교수법 개선. 상황: 한 연구자가 새 교수법이 시험 점수를 높이는지 검정하려 한다. 학생 10명이 새 방법을 쓰기 전과 후에 시험을 본다. 점수가 유의하게 향상되었는지 검정하라.
자료:
| 학생 | 전 | 후 | 차이 (\(d_i\)) |
|---|---|---|---|
| 1 | 70 | 72 | 2 |
| 2 | 68 | 69 | 1 |
| 3 | 75 | 78 | 3 |
| 4 | 80 | 85 | 5 |
| 5 | 72 | 75 | 3 |
| 6 | 74 | 76 | 2 |
| 7 | 69 | 70 | 1 |
| 8 | 77 | 79 | 2 |
| 9 | 73 | 74 | 1 |
| 10 | 76 | 80 | 4 |
풀이
1단계 --- 차이: 모든 차이가 양수이다. \(d = [2, 1, 3, 5, 3, 2, 1, 2, 1, 4]\)
2단계 --- 절대차이 순위:
정렬: \([1, 1, 1, 2, 2, 2, 3, 3, 4, 5]\)
동점 순위: \([2, 2, 2, 5, 5, 5, 7.5, 7.5, 9, 10]\)
원래 순서로 배정: \([5, 2, 7.5, 10, 7.5, 5, 2, 5, 2, 9]\)
3단계 --- 부호 배정: 모든 차이가 양수이므로 모든 순위가 양수이다.
4단계 --- \(W^+\)와 \(W^-\) 계산:
- \(W^+ = 5 + 2 + 7.5 + 10 + 7.5 + 5 + 2 + 5 + 2 + 9 = 55\)
- \(W^- = 0\)
- \(W = \min(55, 0) = 0\)
5단계 --- 유의성 판정:
\(n = 10\), \(\alpha = 0.05\)(양측)에 대한 Wilcoxon 표의 임계값은 8이다. \(W = 0 < 8\)이므로 \(H_0\)을 기각한다.
결론: 새 교수법이 시험 점수를 향상시킨다는 유의한 증거가 있다.
정확 \(p\)값과 근사 \(p\)값
모든 차이가 양수인 이 자료의 정확 양측 \(p\)값은
이다. 동점 보정을 적용한 정규근사는 \(Z = (55 - 27.5)/\sqrt{95.125} = 2.820\)에서 \(p = 0.00481\)을 준다. 근사값이 정확값의 2.5배로, \(n = 10\)에서 정규근사가 얼마나 부정확한지를 보여 준다.
이 자료에서는 모든 차이가 같은 방향이므로 부호검정도 같은 정확 \(p\)값 \(0.001953\)을 낸다. 부호검정이 크기 정보를 버려도 손해를 보지 않는 유일한 경우이다.
파이썬 구현
보기 2. 동점이 있으면 임계값 8 의 뜻이 달라진다. 훈련 전후 점수 10쌍에서 열 쌍 모두 점수가 올랐다. wilcoxon(after, before) 이 \(W = 0\), \(p = 0.001953125\) 를 준다.
(1) 정확 양측 p-값이 \(2/1024\) 인 까닭을 말하시오. \(\lvert d \rvert\) 에 동점이 많은데도 이 값이 동점에 전혀 영향받지 않는 까닭은 무엇인가.
(2) 아래 연습문제 2 는 \(n = 10\) 의 양측 임계값이 \(8\) 이고 그 실제 수준이 \(0.0488\) 이라고 한다. 그것은 동점이 없을 때의 값이다. 이 자료의 중간순위로 귀무분포를 다시 열거하면 실제 수준이 얼마인가.
풀이
(1) 극단에서는 순위의 세부가 지워진다. 차이는
로 열 개가 모두 양수다. 따라서 \(W^- = 0\) 이고 \(W^+\) 는 순위의 총합 \(55\) 다.
\(H_0\) 과 대칭성 아래에서 각 순위의 부호는 독립적인 동전던지기이므로 \(2^{10} = 1024\) 가지 부호 배정이 모두 확률 \(1/1024\) 다. 그 가운데
- \(W^- = 0\) 을 주는 배정 — "모두 \(+\)" 하나
- \(W^+ = 0\) 을 주는 배정 — "모두 \(-\)" 하나
둘뿐이므로
동점이 영향을 주지 못하는 까닭이 여기 있다. 중간순위를 쓰든 \(1, 2, \dots, 10\) 을 쓰든 순위의 총합은 \(55\) 로 같고, "모두 한 부호" 인 배정은 언제나 두 개다. \(T = 0\) 은 분포의 양 끝이므로 순위가 어떻게 뭉쳤는지와 무관하다. scipy 의 정확검정이 동점을 무시하는 표를 쓰면서도 여기서 맞는 답을 주는 것은 운이다 — 이 자료가 하필 극단에 있기 때문이다.
(2) 실제 수준은 \(0.0488\) 이 아니라 \(0.0430\) 이다. 이 자료의 중간순위는
다. \(\lvert d \rvert\) 에서 \(1\) 이 셋(\(\to\) 순위 \(1,2,3\) 의 평균 \(2\)), \(2\) 가 셋(\(\to 4,5,6\) 의 평균 \(5\)), \(3\) 이 둘(\(\to 7,8\) 의 평균 \(7.5\)), \(4\) 와 \(5\) 가 각각 하나(\(\to 9\), \(10\))다. 이 순위로 \(1024\) 가지를 다시 열거해 \(T = \min(W^+, W^-)\) 의 분포를 얻으면
| \(c\) | 동점 없음 \(P(T \leq c)\) | 이 자료 \(P(T \leq c)\) |
|---|---|---|
| 6 | 0.027344 | 0.021484 |
| 7 | 0.037109 | 0.039062 |
| 8 | 0.048828 | 0.042969 |
| 9 | 0.064453 | 0.062500 |
\(c = 8\) 의 실제 수준이 \(0.048828\) 에서 \(0.042969\) 로 내려간다. 명목 \(0.05\) 를 쓰고 있다고 믿으면서 실제로는 \(0.043\) 짜리 검정을 돌리는 셈이다.
움직이는 방향이 한결같지 않다는 점도 보라. \(c = 7\) 에서는 오히려 \(0.037109\) 에서 \(0.039062\) 로 올라간다. 중간순위는 격자를 반 칸씩 밀어 놓으므로 어느 쪽으로 움직일지는 동점의 모양에 달려 있고, 미리 알 수 없다. \(T\) 가 가질 수 있는 값도 \(28\) 가지에서 \(43\) 가지로 늘어난다 — 반정수 \(7.5\) 가 끼어 부분합이 \(0.5\) 단위로 나오기 때문이다.
그러므로 동점이 있는 자료에 표의 임계값을 그대로 쓰지 말아야 한다. \(n\) 이 작으면 관측된 \(\lvert d \rvert\) 의 중간순위로 직접 열거하는 것이 옳다.
수치적으로.
import numpy as np
from scipy.stats import wilcoxon

# 훈련 전후의 점수. 같은 사람을 두 번 잰 대응자료다.
before = np.array([70, 68, 75, 80, 72, 74, 69, 77, 73, 76])
after = np.array([72, 69, 78, 85, 75, 76, 70, 79, 74, 80])

# 부호순위검정은 대응 t 검정의 비모수 대응이다. 차이의 부호와 크기 순위만
# 쓰므로 정규성을 요구하지 않는다. 열 쌍 모두 점수가 올랐으므로 통계량이
# 0 이 되고, 그때 나올 수 있는 가장 작은 p-값이 (1/2)^10 의 두 배다.
stat, p_value = wilcoxon(after, before)

print(f"Test Statistic: {stat}")     # 0.0
print(f"P-value: {p_value}")         # 0.001953125

# 결과 해석
alpha = 0.05
if p_value < alpha:
    print("Reject the null hypothesis: Significant improvement in scores.")
else:
    print("Fail to reject the null hypothesis: No significant improvement in scores.")
출력:
Test Statistic: 0.0
P-value: 0.001953125
Reject the null hypothesis: Significant improvement in scores.
import itertools
from scipy import stats

d = after - before
r = stats.rankdata(np.abs(d))
n = len(d)
print(f"차이        {d.tolist()}")
print(f"|차이| 순위  {r.tolist()}   합 {r.sum()}  (n(n+1)/2 = {n * (n + 1) / 2})")

signs = np.array(list(itertools.product([0, 1], repeat=n)))

def null_T(ranks):
    W_plus = signs @ ranks
    return np.minimum(W_plus, ranks.sum() - W_plus)

T_plain = null_T(np.arange(1, n + 1, dtype=float))   # 동점이 없을 때
T_tied = null_T(r)                                   # 이 자료의 중간순위
print(f"\nT 가 가질 수 있는 값: 동점 없음 {len(set(np.round(T_plain, 6)))} 가지,"
      f"  이 자료 {len(set(np.round(T_tied, 6)))} 가지")
print("  c   동점없음 P(T<=c)   이 자료 P(T<=c)")
for c in (0, 6, 7, 8, 9):
    print(f" {c:>2} {float((T_plain <= c + 1e-9).mean()):>16.6f} "
          f"{float((T_tied <= c + 1e-9).mean()):>17.6f}")
for lab, T in (("동점 없음", T_plain), ("이 자료  ", T_tied)):
    c = max(k for k in range(28) if (T <= k + 1e-9).mean() <= 0.05)
    print(f"  {lab}: 임계값 c = {c},  실제 수준 {float((T <= c + 1e-9).mean()):.6f}")
출력:
차이        [2, 1, 3, 5, 3, 2, 1, 2, 1, 4]
|차이| 순위  [5.0, 2.0, 7.5, 10.0, 7.5, 5.0, 2.0, 5.0, 2.0, 9.0]   합 55.0  (n(n+1)/2 = 55.0)

T 가 가질 수 있는 값: 동점 없음 28 가지,  이 자료 43 가지
  c   동점없음 P(T<=c)   이 자료 P(T<=c)
  0         0.001953          0.001953
  6         0.027344          0.021484
  7         0.037109          0.039062
  8         0.048828          0.042969
  9         0.064453          0.062500
  동점 없음: 임계값 c = 8,  실제 수준 0.048828
  이 자료  : 임계값 c = 8,  실제 수준 0.042969
\(c = 0\) 에서는 두 분포가 똑같이 \(0.001953\) 을 주고(\(= 2/1024\)), \(c = 8\) 에서는 \(0.048828\) 과 \(0.042969\) 로 갈린다. (1) 과 (2) 의 결론이 한 표에 나란히 보인다 — 극단에서는 동점이 지워지고, 중간에서는 지워지지 않는다.
대응 부호검정
Wilcoxon 부호순위검정의 대칭성 가정이 깨질 때는 대응 부호검정을 쓸 수 있다. 대응차이의 부호만 고려하고 크기와 순위는 모두 무시한다.
절차
- 차이 \(d_i = X_i - Y_i\)를 계산한다.
- 양의 차이 개수(\(n_+\))와 음의 차이 개수(\(n_-\))를 센다. 동점(\(d_i = 0\))은 무시한다.
- \(H_0\) 아래에서 각 차이가 양수일 확률과 음수일 확률이 같으므로 \(n_+ \sim \text{Binomial}(n, 0.5)\)이다.
- 이항분포로 \(p\)값을 계산한다.
보기 3. 부호검정을 뒤집으면 중앙값의 신뢰구간이 나온다. 같은 자료에 부호검정을 돌리면 \(n_+ = 10\), \(n_- = 0\), \(p = 0.001953\) 이다. p-값은 "중앙값이 0 이 아니다" 만 말한다. 그러나 같은 이항확률에서 얼마나 다른지까지 읽어 낼 수 있다.
(1) 정렬한 차이를 \(d_{(1)} \leq \dots \leq d_{(10)}\) 이라 할 때 구간 \([d_{(k)},\ d_{(11-k)}]\) 가 참 중앙값을 포함할 확률이 \(1 - 2P(\text{Bin}(10, 1/2) \leq k-1)\) 임을 보이시오. 95% 이상을 보장하는 \(k\) 와 그 구간을 구하시오.
(2) 그 구간이 \(0\) 을 포함하지 않는 것과 부호검정이 기각하는 것은 같은 일인가.
풀이
(1) 놓치는 사건을 세면 된다. 참 중앙값을 \(m\) 이라 하자. 구간이 \(m\) 을 놓치는 것은 두 경우다.
- \(m < d_{(k)}\) — 곧 \(m\) 보다 작은 관측값이 \(k - 1\) 개 이하
- \(m > d_{(11-k)}\) — 곧 \(m\) 보다 큰 관측값이 \(k - 1\) 개 이하
\(m\) 이 참 중앙값이고 분포가 연속이면 각 관측값이 \(m\) 보다 클 확률이 정확히 \(1/2\) 이고 관측값끼리 독립이므로, "\(m\) 보다 큰 개수" \(X \sim \text{Bin}(10, 1/2)\) 다. 따라서
이고(이항분포가 \(p = 1/2\) 에서 대칭이므로 두 꼬리가 같다), 포함률은
이다. \(\square\) 이 유도에 모집단 분포는 한 번도 쓰이지 않았다 — 연속이라는 것뿐이다. 그래서 분포무관 구간이다.
정렬한 차이는 \((1, 1, 1, 2, 2, 2, 3, 3, 4, 5)\) 이고
| \(k\) | 구간 | 포함률 |
|---|---|---|
| 1 | \([d_{(1)}, d_{(10)}] = [1,\ 5]\) | 0.998047 |
| 2 | \([d_{(2)}, d_{(9)}] = [1,\ 4]\) | 0.978516 |
| 3 | \([d_{(3)}, d_{(8)}] = [1,\ 3]\) | 0.890625 |
| 4 | \([d_{(4)}, d_{(7)}] = [2,\ 3]\) | 0.656250 |
95% 를 보장하는 가장 좁은 것은 \(k = 2\) 의 \([1,\ 4]\) 이고 실제 포함률은 97.85% 다. \(k = 3\) 으로 한 칸 좁히면 89.06% 로 떨어져 모자란다. \(n = 10\) 에서 정확히 95% 를 맞출 수는 없다 — 이산성 때문에 쓸 수 있는 포함률이 네댓 개뿐이다.
(2) 같은 일이다. 구간 \([d_{(k)}, d_{(11-k)}]\) 가 \(m_0\) 을 포함하지 않는다는 것은, 위 유도를 그대로 뒤집으면 \(m_0\) 보다 큰(또는 작은) 관측값이 \(k-1\) 개 이하라는 것이고, 그것이 바로 수준 \(2P(X \leq k-1)\) 의 부호검정 기각역이다. 구간과 검정이 같은 이항확률의 두 얼굴이다.
\(k = 2\) 를 쓰면 수준은 \(2P(X \leq 1) = 2 \times 11/1024 = 0.021484\) 이고, 구간 \([1, 4]\) 가 \(0\) 을 품지 않으므로 기각한다. 부호검정의 p-값 \(0.001953\) 이 \(0.021484\) 보다 작은 것과 맞아떨어진다.
그런데 구간 쪽이 더 쓸모 있다. p-값 \(0.001953\) 은 "\(0\) 이 아니다" 만 말하지만, 구간 \([1, 4]\) 는 "점수 향상의 중앙값이 적어도 1점이고 많아도 4점" 이라고 말한다. 신뢰구간이 크기를 함께 보고하는 것이 p-값보다 나은 까닭이 여기 있다. 다만 \(n = 10\) 에서 그 구간은 \(1\) 부터 \(4\) 까지로 꽤 넓다 — 부호검정은 가정을 적게 쓰는 대가로 넓은 구간을 준다.
수치적으로.
from scipy.stats import binom
import numpy as np

before = np.array([70, 68, 75, 80, 72, 74, 69, 77, 73, 76])
after = np.array([72, 69, 78, 85, 75, 76, 70, 79, 74, 80])

# 같은 자료에 부호검정을 돌린다. 크기는 버리고 부호만 세므로 계산이 더 쉽다.
differences = after - before
n_plus = np.sum(differences > 0)
n_minus = np.sum(differences < 0)
n = n_plus + n_minus
W = min(n_plus, n_minus)

# 귀무가설 아래에서 부호가 +일 확률이 0.5 이므로, 통계량이 이항분포를 따른다.
# 표본이 작을 때는 정규근사 대신 이렇게 정확분포를 쓰는 편이 낫다.
p_value = min(1.0, 2 * binom.cdf(W, n, 0.5))  # 양측

print(f"n+ = {n_plus}, n- = {n_minus}")   # n+ = 10, n- = 0
print(f"P-value: {p_value:.6f}")          # 0.001953
출력:
n+ = 10, n- = 0
P-value: 0.001953
d_sorted = np.sort(differences)
print(f"정렬한 차이 {d_sorted.tolist()}")
print(" k   구간          포함률")
for k in range(1, 5):
    cov = 1 - 2 * binom.cdf(k - 1, n, 0.5)
    print(f" {k}  [{d_sorted[k - 1]}, {d_sorted[n - k]}]  "
          f"  {cov:.6f}   (수준 {2 * binom.cdf(k - 1, n, 0.5):.6f})")

k = 2
lo, hi = d_sorted[k - 1], d_sorted[n - k]
level = 2 * binom.cdf(k - 1, n, 0.5)
print(f"\n95% 이상을 보장하는 가장 좁은 구간: k = {k},  [{lo}, {hi}],"
      f"  포함률 {1 - level:.6f}")
print(f"  0 을 포함하는가? {lo <= 0 <= hi}  ->  수준 {level:.6f} 에서 기각")
print(f"  부호검정 p-값 {p_value:.6f} < {level:.6f} ?  {p_value < level}")

# 포함률을 모의로 확인한다 (연속분포, 참 중앙값 0)
rng = np.random.default_rng(1)
B = 2000
for k in (2, 3):
    hit = sum(1 for _ in range(B)
              if (x := np.sort(rng.normal(0, 1, n)))[k - 1] <= 0 <= x[n - k])
    theory = 1 - 2 * binom.cdf(k - 1, n, 0.5)
    print(f"  k={k}: 모의 포함률 {hit / B:.4f},  이론 {theory:.4f},"
          f"  MC 오차 {np.sqrt(theory * (1 - theory) / B):.4f}")
출력:
정렬한 차이 [1, 1, 1, 2, 2, 2, 3, 3, 4, 5]
 k   구간          포함률
 1  [1, 5]    0.998047   (수준 0.001953)
 2  [1, 4]    0.978516   (수준 0.021484)
 3  [1, 3]    0.890625   (수준 0.109375)
 4  [2, 3]    0.656250   (수준 0.343750)

95% 이상을 보장하는 가장 좁은 구간: k = 2,  [1, 4],  포함률 0.978516
  0 을 포함하는가? False  ->  수준 0.021484 에서 기각
  부호검정 p-값 0.001953 < 0.021484 ?  True
  k=2: 모의 포함률 0.9810,  이론 0.9785,  MC 오차 0.0032
  k=3: 모의 포함률 0.8905,  이론 0.8906,  MC 오차 0.0070
이론 포함률 \(0.9785\) 와 \(0.8906\) 이 모의실험의 \(0.9810\) 과 \(0.8905\) 와 몬테카를로 오차(\(\pm 0.0032\), \(\pm 0.0070\)) 안에서 맞는다. 그리고 \(k = 1\) 줄의 수준 \(0.001953\) 이 바로 이 자료의 부호검정 p-값과 같은 수인 것을 보라 — 열 개가 모두 한쪽에 있는 것이 \(k = 1\) 의 기각역이기 때문이다.
\(2 \times\) 규칙은 1을 넘을 수 있다
\(2 \times P(S \le W)\)는 \(W\)가 \(n/2\)에 가까우면 1을 넘는다. 예를 들어 \(n = 10\), \(W = 5\)이면 \(2 \times 0.6230 = 1.246\)이다. 반드시 1로 자르거나 scipy.stats.binomtest를 쓰는 편이 안전하다.
비교: 대응 t 검정 대 비모수 대안
| 특징 | 대응 t 검정 | 대응 Wilcoxon | 대응 부호검정 |
|---|---|---|---|
| 가정 | 차이가 정규 | 차이가 대칭 | 없음 |
| 검정 대상 | 평균 차이 | 중앙값 차이 | 중앙값 차이 |
| 사용 정보 | 원 차이값 | 차이의 순위 | 부호만 |
| 검정력 | 최고 (정규일 때) | 높음 (ARE \(\approx 0.955\)) | 낮음 (ARE \(\approx 0.637\)) |
| 로버스트성 | 이상치에 민감 | 높음 | 매우 높음 |
선택 지침
- 차이가 정규: 검정력을 최대로 얻으려면 대응 t 검정.
- 대칭이지만 비정규: 대응 Wilcoxon 부호순위검정.
- 가정이 하나도 성립하지 않음(치우침, 순서형): 대응 부호검정.
장점과 한계
장점:
- 정규성을 가정하지 않는다.
- 이상치에 로버스트하다.
- 순서형 자료에도 쓸 수 있다.
한계:
- 차이 분포의 대칭성을 가정한다(Wilcoxon만 해당).
- 정규성이 성립할 때 모수적 검정보다 검정력이 낮다.
- 부호검정은 크기 정보를 버려 검정력이 더 떨어진다.
연습문제
연습문제 1. 교수법 보기 자료에서 네 가지 검정(대응 \(t\), Wilcoxon 정확·근사, 부호검정)의 \(p\)값을 모두 계산하고, 왜 부호검정이 Wilcoxon과 같은 값을 내는지 설명하라.
풀이
import numpy as np
from scipy import stats
before = np.array([70, 68, 75, 80, 72, 74, 69, 77, 73, 76])
after  = np.array([72, 69, 78, 85, 75, 76, 70, 79, 74, 80])
d = after - before

print(stats.ttest_rel(after, before).pvalue)                    # 0.000325
print(stats.wilcoxon(d, method='exact').pvalue)                 # 0.001953
print(stats.wilcoxon(d, method='approx', correction=False).pvalue)  # 0.004809
print(stats.binomtest(10, 10).pvalue)                           # 0.001953
출력:
0.0003248947130212966
0.001953125
0.004808563078561356
0.001953125
| 검정 | 양측 \(p\)값 |
|---|---|
| 대응 \(t\) | \(0.000325\) |
| Wilcoxon (정확) | \(0.001953\) |
| 부호검정 (정확) | \(0.001953\) |
| Wilcoxon (정규근사) | \(0.004809\) |
부호검정과 Wilcoxon 정확검정이 같은 값을 낸다. 이유는 자료가 극단적으로 한쪽에 쏠려 있기 때문이다.
두 검정 모두 \(2^{10} = 1024\)가지 부호 배정을 귀무분포로 쓴다. 관측된 배정은 "모두 \(+\)"인 단 하나이다. Wilcoxon에서 \(W^+ = 55\)는 도달 가능한 최댓값이고, 이를 달성하는 배정은 하나뿐이다. 부호검정에서 \(n_+ = 10\)을 달성하는 배정도 하나뿐이다. 따라서 두 정확 \(p\)값이 모두 \(2/1024\)가 된다.
일반적으로는 두 검정이 갈라진다. 음의 차이가 하나라도 있으면 그 차이의 크기가 Wilcoxon에는 영향을 주지만 부호검정에는 주지 않는다.
Wilcoxon 정규근사가 \(0.004809\)로 정확값의 2.5배임에 유의하라. 관측값이 분포의 끝점에 놓여 있어 정규근사가 가장 나쁘게 작동하는 위치이다. 꼬리 확률을 근사할 때 정규근사가 체계적으로 부정확한 이유이다.
연습문제 2. \(n = 10\)일 때 Wilcoxon 부호순위검정의 양측 임계값이 왜 \(8\)인지 정확 귀무분포를 열거하여 확인하라. 이 임계값의 실제 유의수준은 얼마인가?
풀이
import numpy as np, itertools
n = 10
ranks = np.arange(1, n + 1)
W = np.array([np.dot(s, ranks) for s in itertools.product([0, 1], repeat=n)])
T = np.minimum(W, n * (n + 1) // 2 - W)      # min(W+, W-)
for c in range(6, 12):
    print(c, (T <= c).mean())
출력:
6 0.02734375
7 0.037109375
8 0.048828125
9 0.064453125
10 0.083984375
11 0.10546875
| 임계값 \(c\) | \(P(T \le c)\) |
|---|---|
| 6 | 0.0273 |
| 7 | 0.0371 |
| 8 | 0.0488 |
| 9 | 0.0645 |
| 10 | 0.0840 |
| 11 | 0.1055 |
\(c = 8\)이 \(0.05\)를 넘지 않는 가장 큰 값이다(\(0.0488 \le 0.05 < 0.0645\)). 그래서 표에 \(8\)이 실려 있다.
실제 유의수준은 \(0.0488\)로 명목값 \(0.05\)에 매우 가깝다. \(n = 10\)에서 부호검정의 실제 크기가 \(0.0215\)였던 것과 비교하면 훨씬 낫다. Wilcoxon의 귀무분포는 \(T = \min(W^+, W^-)\)가 가질 수 있는 값이 \(28\)가지(\(0\)부터 \(27\)까지)라 \(\alpha\)를 촘촘히 채울 수 있는 반면, 부호검정은 \(6\)가지밖에 없다.
이것이 Wilcoxon 검정이 부호검정보다 강력한 두 번째 이유이다. ARE가 \(0.955\) 대 \(0.637\)인 것뿐 아니라, 소표본에서 유의수준을 훨씬 효율적으로 쓴다.
연습문제 3.
p_value = 2 * binom.cdf(W, n, 0.5)가 언제 1을 넘는가? \(n = 10\)에서 \(W = 0, 1, \ldots, 5\)에 대해 계산하고, 올바른 처리 방법을 제시하라.
풀이
from scipy.stats import binom, binomtest
n = 10
for W in range(6):
    naive = 2 * binom.cdf(W, n, 0.5)
    print(W, round(naive, 4), round(binomtest(W, n, 0.5).pvalue, 4))
출력:
0 0.002 0.002
1 0.0215 0.0215
2 0.1094 0.1094
3 0.3438 0.3438
4 0.7539 0.7539
5 1.2461 1.0
| \(W = \min(n_+, n_-)\) | \(2 \times P(S \le W)\) | binomtest |
|---|---|---|
| 0 | 0.0020 | 0.0020 |
| 1 | 0.0215 | 0.0215 |
| 2 | 0.1094 | 0.1094 |
| 3 | 0.3438 | 0.3438 |
| 4 | 0.7539 | 0.7539 |
| 5 | 1.2461 | 1.0000 |
\(W = 5\)(즉 \(n_+ = n_- = 5\))에서 \(1.2461\)이 나온다. \(P(S \le 5) = 0.6230\)을 두 배 했기 때문이다.
원인은 \(S = 5\)가 두 꼬리에 중복해서 세어지기 때문이다. \(P(S \le 5)\)와 \(P(S \ge 5)\)는 둘 다 \(P(S = 5) = 0.2461\)을 포함하므로 합이 \(1 + 0.2461\)이 된다.
올바른 처리 방법은 셋 중 하나이다.
- 1로 자른다.
min(1.0, 2 * binom.cdf(W, n, 0.5))--- 가장 간단하고 대부분의 교과서가 쓰는 규칙이다. scipy.stats.binomtest를 쓴다. SciPy는 "관측값만큼 가능성이 낮은 결과들의 확률합" 정의를 쓰므로 자동으로 1을 넘지 않는다.- 중복을 뺀다. \(2P(S \le W) - P(S = W)\) --- 이론적으로 깔끔하지만 표준 관행은 아니다.
\(p_0 = 0.5\)일 때는 분포가 대칭이라 1과 2가 \(W < n/2\)에서 정확히 일치한다. \(p_0 \ne 0.5\)이면 두 정의가 갈라진다.
연습문제 4. 교수법 보기에서 모든 차이가 양수인 것은 우연이 아닐 수 있다. 이 자료가 실제로 정규 차이에서 나왔다면 \(n = 10\)에서 모두 같은 부호일 확률은 얼마인가? 관측된 차이의 분포는 무엇을 시사하는가?
풀이
차이는 \(d = [2, 1, 3, 5, 3, 2, 1, 2, 1, 4]\)로 평균 \(2.4\), 표준편차 \(1.35\)이다.
참인 차이 분포가 \(\mathcal{N}(2.4, 1.35^2)\)이라면 한 관측값이 음수일 확률은
이고, 10개가 모두 양수일 확률은 \((1 - 0.0377)^{10} = 0.681\)이다. 전혀 놀랍지 않다.
import numpy as np
from scipy import stats
d = np.array([2, 1, 3, 5, 3, 2, 1, 2, 1, 4])
print(d.mean(), d.std(ddof=1))                          # 2.4, 1.3499
p_neg = stats.norm.cdf(0, d.mean(), d.std(ddof=1))
print(p_neg, (1 - p_neg) ** 10)                         # 0.0377, 0.681
출력:
2.4 1.3498971154211057
0.037709049885978514 0.680869711192701
그러나 자료 자체를 보면 다른 문제가 보인다. 차이의 값이 \(\{1, 2, 3, 4, 5\}\) 다섯 가지뿐이고 모두 정수이다. 시험 점수가 정수라 차이도 정수인 것은 자연스럽지만, 이 정도 이산성에서는 동점이 많이 생겨 순위 기반 검정의 정확 귀무분포가 엄밀하게는 성립하지 않는다.
실제로 이 자료에는 크기 3, 3, 2의 동점 집단이 있다. SciPy가 반환한 "정확" \(p\)값 \(0.001953\)은 동점이 없다고 가정한 값이다. 다행히 모든 차이가 양수라 \(W^+\)가 최댓값이라는 사실은 동점 여부와 무관하므로 이 경우에는 문제가 되지 않는다.
일반적 교훈: 이산 척도(정수 점수, Likert 척도)에서는 동점이 필연적이며, 순위 기반 검정의 "정확" \(p\)값이 사실은 근사이다. 동점 비율이 높으면 순열검정으로 동점을 포함한 실제 귀무분포를 직접 계산하는 편이 정직하다.
정리하며
대응 자료의 비모수 검정은 차이를 만들어 일표본으로 환원한다.
- 윌콕슨 부호순위검정이 대응 \(t\) 검정의 대안이다. 차이의 부호와 크기 순위를 함께 쓴다.
- 중앙값 차이가 \(0\) 인지를 묻는다. 평균이 아니라는 점이 \(t\) 검정과 다르며, 치우친 자료에서 둘의 결론이 갈릴 수 있다.
- 대칭성 가정이 있다. 없어도 되는 것은 부호검정이며, 그만큼 검정력을 잃는다.
- 짝짓기의 이득은 그대로다. 8장·9장에서 본 대로 피험자 간 변동이 뺄셈으로 사라지며, 그것이 비모수에서도 유효하다.
- 쌍이 적을 때 특히 유용하다. \(n<20\) 이면 정규성을 확인할 방법도 마땅치 않으므로 비모수가 안전하다.
다음 절 이표본 비모수 검정으로 넘어간다.