방법 선택 지침
능형, 라쏘, 엘라스틱넷 중에서 고르려면 자료의 특성과 분석 목표를 함께 살펴야 한다. 이 절은 선택에 영향을 주는 핵심 요인을 중심으로 결정 틀을 제시한다.
결정 요인
- 희소성. 대부분의 설명변수가 무관하다고(참 계수가 0에 가깝다고) 기대하는가?
- 상관 구조. 설명변수가 강하게 상관되어 자연스러운 집단을 이루는가?
- 차원. \(p\)가 \(n\)에 가깝거나 그보다 큰가?
- 목표. 주된 목표가 예측인가, 해석인가, 변수선택인가?
- 계산 제약. 모형 적합이 계산적으로 비싼가?
결정 틀
1단계: 기대되는 희소성 평가
대부분의 변수가 기여할 것으로 기대되면(조밀한 참 모형) 능형회귀가 최선일 가능성이 높다. 많은 계수가 작지만 0이 아닐 때 모든 변수를 남기고 축소를 최적으로 분배한다.
소수의 변수만 중요할 것으로 기대되면(희소한 참 모형) 라쏘나 엘라스틱넷이 낫다.
희소성이 불확실하면 중간 정도의 \(\alpha\)(\(0.5\) 등)를 쓴 엘라스틱넷이 합리적 절충이다.
2단계: 설명변수의 상관 평가
상관이 약하면(상관행렬이 대각에 가까우면) 라쏘가 적절하다. 강한 상관이 없으면 라쏘가 안정적으로 변수를 고르고, 상관 집단에서의 한계가 문제되지 않는다.
상관이 강하면 능형이나 엘라스틱넷이 낫다.
- 변수선택이 필요 없으면(예측 전용) 능형
- 상관 처리와 변수선택이 모두 필요하면 엘라스틱넷
상관된 변수에 순수 라쏘를 쓰지 말 것
설명변수가 강하게 상관되어 있으면 순수 라쏘를 피한다. 집단에서 하나를 고르고 나머지를 제외할 수 있으며, 자료 분할이나 작은 교란에 따라 그 선택이 불규칙하게 바뀐다.
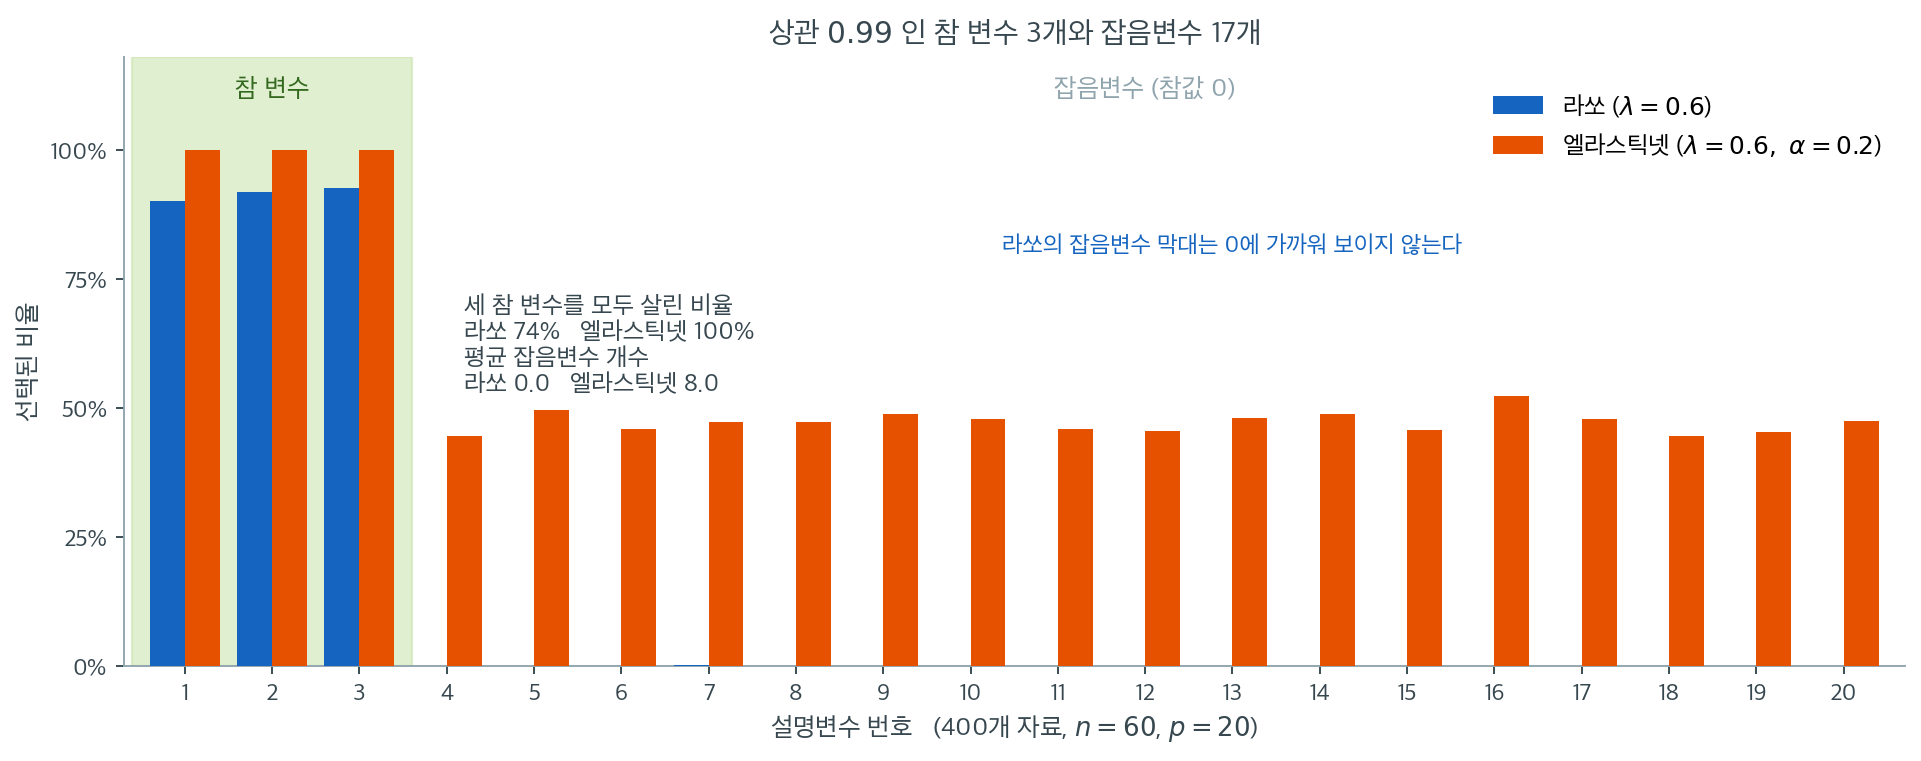
이 경고를 숫자로 확인해 보자. 같은 모집단에서 자료를 400번 새로 뽑아 매번 라쏘와 엘라스틱넷을 적합하고, 각 설명변수가 몇 번이나 선택되었는지 센 결과다. 참 변수는 \(x_1, x_2, x_3\) 세 개(참값 모두 \(2.0\), 서로 상관 \(0.99\))이고 나머지 열일곱 개는 참값이 0인 잡음변수다. \(n = 60\), \(p = 20\), \(\lambda = 0.6\)으로 두 방법을 맞췄다.
초록 띠 안을 보면 라쏘의 선택률이 각각 \(90\%\), \(92\%\), \(93\%\)다. 변수 하나만 놓고 보면 나쁘지 않아 보인다. 그런데 세 변수를 모두 살린 자료의 비율은 \(74\%\)로 떨어진다. 네 번에 한 번꼴로 참 변수 중 적어도 하나를 놓친다는 뜻이다. 셋이 거의 같은 정보를 담고 있으니 라쏘 입장에서는 어느 하나를 버려도 적합도가 거의 줄지 않고, 그래서 매번 다른 하나를 버린다. 논문에 "라쏘가 \(x_1\)과 \(x_3\)을 골랐다"고 쓰는 순간, 그 문장은 자료를 다시 뽑으면 바뀔 문장이 된다.
엘라스틱넷은 400번 모두 세 변수를 전부 살렸다(선택률 \(100\%\)). 대신 값을 치른다. 잡음변수 막대를 보면 열일곱 개가 모두 \(44\%\)에서 \(52\%\) 사이로 서 있다. 자료 하나당 평균 \(8.0\)개의 잡음변수가 딸려 들어온다는 뜻이다. 라쏘는 잡음변수를 평균 \(0.0\)개 고른다. 그림에서 잡음변수 구간에 파란 막대가 보이지 않는 이유가 그것이다.
그러므로 이 그림은 "엘라스틱넷이 낫다"가 아니라 두 가지 오류를 맞바꾼다는 이야기를 한다. 참 변수를 놓치는 오류(라쏘 \(26\%\))를 줄이려면 잡음을 들이는 오류(엘라스틱넷 평균 8개)를 감수해야 한다. 예측이 목적이면 상관된 변수를 함께 남기는 쪽이 대개 유리하고, 어느 변수가 원인인지 식별하는 것이 목적이면 두 방법 모두 그 답을 혼자서는 주지 못한다. 상관 집단이 있을 때 선택 결과를 보고하려면 최소한 붓스트랩을 돌려 위 그림 같은 선택빈도를 함께 제시해야 한다.
3단계: 차원 확인
\(p < n\)이면 세 방법 모두 가능하며, 선택은 다른 요인에 달려 있다.
\(p \approx n\)이거나 \(p > n\)이면
- 능형은 예측에 잘 작동하지만 \(p\)개 변수를 모두 남긴다.
- 라쏘는 최대 \(n\)개만 고를 수 있어 제약이 될 수 있다.
- 엘라스틱넷은 그런 제한이 없어 고차원에서 일반적으로 선호된다.
4단계: 목표의 정의
예측. 예측오차 최소화만이 목표라면 세 방법 모두 후보다. 교차검증으로 경험적으로 고른다. 성능 차이가 작은 경우가 많다.
변수선택. 어떤 변수가 유의미한지 식별하는 것이 목표라면 라쏘나 엘라스틱넷이 필요하다. 능형은 변수선택을 하지 않는다.
해석. 설명변수와 반응변수의 관계 이해가 목표라면, 변수가 상관되어 있을 때 엘라스틱넷의 그룹 효과가 더 해석 가능한 결과를 낸다. 사후 라쏘 OLS로 축소 편향을 제거하면 해석이 더 명확해진다.
빠른 참고표
| 상황 | 권장 방법 | \(\alpha\) | 핵심 이유 |
|---|---|---|---|
| 조밀한 모형, 상관된 변수 | 능형 | 해당 없음 | 계수를 분배하며 변수선택이 불필요 |
| 희소한 모형, 무상관 변수 | 라쏘 | 1.0 | 깔끔한 변수선택 |
| 희소한 모형, 상관된 변수 | 엘라스틱넷 | 0.5 | 그룹 효과 + 희소성 |
| \(p > n\), 중간 희소성 | 엘라스틱넷 | 0.5–0.9 | \(n\)개 제한이 없음 |
| \(p > n\), 강한 희소성 | 엘라스틱넷 | 0.9 | 라쏘에 가까운 희소성 + 안정성 |
| 예측만, 구조 무관 | 세 방법 모두 교차검증 | — | 자료가 결정하게 한다 |
| 구조를 모를 때 | 엘라스틱넷 | 0.5 | 안전한 기본값 |
실무 절차
- 설명변수를 표준화한다. 평균 0, 분산 1로 중심화·척도조정하여 벌점이 모든 계수를 동등하게 다루게 한다.
- 상관 구조를 살핀다. 상관행렬을 계산하고 상관된 집단을 찾는다. 쌍별 상관 0.7 이상이 흔하면 순수 라쏘를 피한다.
- \(p/n\) 비를 확인한다. \(p > n\)이면 엘라스틱넷이나 능형을 계획한다.
- 후보 방법을 고른다. 위 결정 틀에 따라 한둘에서 셋을 고른다.
- 초모수를 조정한다. 각 방법에 대해 \(K\)-겹 교차검증으로 \(\lambda\)(엘라스틱넷은 \(\alpha\)도)를 고른다.
- 방법을 비교한다. CV 오차가 가장 낮은 방법을 고르거나, 더 간결한 모형을 위해 1-SE 규칙을 쓴다.
- 검증한다. 떼어 둔 검정집합에서 최종 모형을 평가한다.
확신이 없으면 엘라스틱넷
탐색적 분석이고 자료 구조를 모른다면 \(\alpha = 0.5\)의 엘라스틱넷이 견고한 기본값이다. 넓은 범위의 상황에서 잘 작동하며, 능형(희소성 없음)과 라쏘(상관에서의 불안정성) 양쪽의 최악 거동을 피한다.
흔한 함정
변수를 고른 뒤 능형을 적합하기. 라쏘로 변수를 고르고 그 부분집합에 능형을 적합하는 것은 합리적 전략이지만, 두 단계를 함께 수행하는 엘라스틱넷과 비교해 보아야 한다.
절편을 벌점하기. 절편은 언제나 벌점에서 제외해야 한다. 대부분의 구현이 자동으로 처리하지만 확인이 필요하다.
표준화를 잊기. 척도가 다르면 분산이 작은 변수의 계수가 불균형하게 축소된다. 정칙화 전에 반드시 표준화한다.
조정 과정에 과적합하기. 광범위한 초모수 탐색은 검증집합에 과적합할 위험을 키운다. 조정에 쓴 자료로 성능을 보고한다면 중첩 교차검증을 써야 한다.
라쏘 계수를 효과크기로 보고하기. 라쏘 계수는 0 쪽으로 편향되어 있다. 효과크기 추정에는 사후 라쏘 OLS나 편향제거 라쏘(debiased lasso)의 신뢰구간을 쓴다.
연습문제
연습문제 1. California Housing 자료를 사용하라.
(a) 세 정칙화 모형과 OLS를 모두 적합하고 검정 MSE를 비교하라.
(b) 정칙화 경로를 그려라. 라쏘에서 계수가 0이 되는 \(\lambda\) 값은 얼마인가?
(c) 1-표준오차 규칙으로 모형을 선택하라. 최소 CV 오차 모형과 비교하면 어떤가?
풀이
import numpy as np
from sklearn.datasets import fetch_california_housing
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.linear_model import (LinearRegression, RidgeCV,
                                  LassoCV, ElasticNetCV, lasso_path)
from sklearn.model_selection import train_test_split

d = fetch_california_housing()
Xtr, Xte, ytr, yte = train_test_split(d.data, d.target,
                                      test_size=0.3, random_state=0)
for name, est in [('OLS', LinearRegression()),
                  ('Ridge', RidgeCV(alphas=np.logspace(-3, 3, 100))),
                  ('Lasso', LassoCV(cv=5, random_state=0)),
                  ('ENet', ElasticNetCV(l1_ratio=[.1,.5,.9,1],
                                        cv=5, random_state=0))]:
    pipe = Pipeline([('sc', StandardScaler()), ('m', est)]).fit(Xtr, ytr)
    print(name, ((yte - pipe.predict(Xte))**2).mean())
출력:
OLS 0.5431489670037236
Ridge 0.5437505440431417
Lasso 0.5432914057817635
ENet 0.5432914057817635
이 자료에서는 정칙화의 이득이 거의 없다
California Housing은 \(n \approx 20{,}600\), \(p = 8\)로 \(p/n \approx 0.0004\)이다. 과적합과 편향-분산 절충 연습문제 3의 표에 따르면 이 영역에서 OLS의 과적합은 무시할 수준이다.
따라서 네 방법의 검정 MSE가 소수 셋째 자리까지 거의 같게 나올 것이다. 이는 정칙화의 실패가 아니라 정칙화가 필요 없는 문제라는 뜻이다.
정칙화의 효과를 보려면 \(p\)를 인위적으로 늘려야 한다. 다항식 항과 교호작용 항을 추가하면(\(p\)를 44개 이상으로) 차이가 드러나기 시작한다.
(b) lasso_path로 경로를 계산하면 표준화된 자료에서 \(\lambda_{\max} = \|X^\top y\|_\infty/n\)이고, 그보다 큰 \(\lambda\)에서 모든 계수가 0이다. 변수가 8개뿐이므로 경로가 단순하며, MedInc(중위소득)가 가장 먼저 들어온다.
(c) \(\lambda_{1\text{SE}}\)가 \(\lambda_{\min}\)보다 큰 \(\lambda\)를 고르므로 더 적은 변수를 남긴다. 다만 이 자료에서는 변수가 8개뿐이라 차이가 크지 않다. 1-SE 규칙의 효과는 \(p\)가 클 때 뚜렷하다(\(\lambda\) 선택을 위한 교차검증 연습문제 1에서 \(p = 20\)일 때 12개에서 9개로 줄어드는 것을 보았다).
연습문제 2. "흔한 함정" 다섯 가지 중 결과를 가장 심각하게 왜곡하는 것은 무엇인가? 근거를 들어 순위를 매겨라.
풀이
심각도 순으로 매기면 다음과 같다.
| 순위 | 함정 | 왜곡의 크기 | 근거 |
|---|---|---|---|
| 1 | 조정 과정에 과적합 (누설) | 결론을 뒤집을 수 있다 | 순수 잡음 자료에서 CV 오차 \(1.05\) 대 \(2.27\) |
| 2 | 표준화를 잊음 | 변수 단위에 따라 선택이 결정된다 | 단위를 미터→킬로미터로 바꾸면 그 변수가 반드시 선택된다 |
| 3 | 라쏘 계수를 효과크기로 보고 | 계수가 정확히 \(\lambda\)만큼 편향된다 | 편향 \(-0.198, +0.211, -0.207\) (\(\lambda = 0.2\)) |
| 4 | 절편을 벌점 | 예측이 체계적으로 치우친다 | \(y\)의 중심이 0이 아니면 심각 |
| 5 | 변수선택 후 능형 | 대개 무해하나 비교가 필요 | 엘라스틱넷과 성능이 비슷한 경우가 많다 |
1위가 압도적으로 위험하다. 교차검증 연습문제 2에서 확인했듯, \(y\)를 쓰는 전처리를 겹 밖에서 하면 신호가 전혀 없는 자료에서도 완벽한 성능이 보고된다. 나머지 함정은 결과를 편향시키지만 이 정도로 뒤집지는 않는다.
2위도 조용히 치명적이다. 좌표하강 연습문제 2에서 보았듯, 표준화하지 않으면 갱신식의 분모가 변수마다 달라져 척도가 큰 변수가 자동으로 선택된다. 오류 메시지가 나지 않으므로 발견하기 어렵다.
3위는 널리 퍼져 있다. 논문에서 라쏘 계수를 그대로 효과크기로 보고하는 경우를 흔히 본다. 편향의 크기가 정확히 \(\lambda\)이므로, \(\lambda\)를 함께 보고하면 최소한 독자가 보정할 수 있다.
정리하며
능형, 라쏘, 엘라스틱넷의 선택은 참 모형의 기대 희소성, 설명변수의 상관 구조, 문제의 차원, 분석 목표에 달려 있다. 능형은 상관된 변수를 갖는 조밀한 모형에, 라쏘는 무상관 변수를 갖는 희소 모형에 적합하다. 엘라스틱넷은 자료 구조가 불확실할 때 견고한 기본값으로, 희소성과 상관 변수의 집단화를 결합한다.