μ와 σ²의 MLE
들어가며
Gaussian(정규) 분포 모수의 최대가능도추정량은 통계학에서 가장 중요한 결과에 속한다. \(X_1, \ldots, X_n \sim N(\mu, \sigma^2)\)에 대해 MLE는 평균 \(\mu\)와 분산 \(\sigma^2\) 모두에 대한 닫힌 형태의 추정량을 준다. 이 절에서는 이 추정량들을 유도하고, 성질을 분석하며, 그 결과를 더 넓은 추정이론과 연결한다.
정규 로그가능도
\(N(\mu, \sigma^2)\)에서 얻은 i.i.d. 표본 \(x_1, \ldots, x_n\)에 대해 로그가능도는:
MLE의 유도
mu의 MLE
\(\mu\)에 대해 미분하면:
0으로 놓으면:
평균의 MLE는 표본평균이다.
sigma-squared의 MLE
(\(\sigma^2\)을 하나의 변수로 보고) \(\sigma^2\)에 대해 미분하면:
0으로 놓고 \(\hat{\mu} = \bar{x}\)를 대입하면:
분산의 MLE는 \(n-1\)이 아니라 \(n\)으로 나눈다.
확인: 2계 조건
\((\hat{\mu}, \hat{\sigma}^2)\)에서 평가한 Hessian 행렬은:
대각 성분이 모두 음수이므로 음정부호이며, 최댓값임이 확인된다.
Gaussian MLE의 성질
mu-hat = X-bar의 성질
| 성질 | 결과 |
|---|---|
| 편향 | \(E[\hat{\mu}] = \mu\) (불편) |
| 분산 | \(\text{Var}(\hat{\mu}) = \sigma^2/n\) |
| 분포 | 정확히 \(\hat{\mu} \sim N(\mu, \sigma^2/n)\) |
| 효율성 | CRLB 달성, MVUE |
| 충분성 | (\(\sigma^2\)이 주어지면) \(\mu\)에 대해 충분 |
| 일치성 | \(\hat{\mu} \xrightarrow{p} \mu\) |
sigma-squared (MLE)의 성질
| 성질 | 결과 |
|---|---|
| 편향 | \(E[\hat{\sigma}^2] = \frac{n-1}{n}\sigma^2\) (편향됨) |
| 편향의 크기 | \(\text{Bias} = -\sigma^2/n\) |
| 분포 | \(n\hat{\sigma}^2/\sigma^2 \sim \chi^2_{n-1}\) |
| 분산 | \(\text{Var}(\hat{\sigma}^2) = \frac{2(n-1)}{n^2}\sigma^4\) |
| 평균제곱오차 | \(\frac{2n-1}{n^2}\sigma^4\) |
| 일치성 | \(\hat{\sigma}^2 \xrightarrow{p} \sigma^2\) |
| 점근적 불편성 | \(n \to \infty\)일 때 \(E[\hat{\sigma}^2] \to \sigma^2\) |
독립성
\(\hat{\mu}\)과 \(\hat{\sigma}^2\)은 (Cochran 정리에 의해) 독립이다. 정규분포에만 있는 특별한 성질이며 \(t\)-분포를 유도하는 데 결정적이다.
Fisher 정보행렬
\((\mu, \sigma^2)\)에 대한 Fisher 정보행렬은:
비대각 성분이 0이라는 사실은 \(\mu\)와 \(\sigma^2\)이 서로 독립적인 정보를 담고 있음을 확인해 준다.
Cramér-Rao 하한
\(\mu\)의 MLE는 CRLB를 정확히 달성한다. \(\sigma^2\)의 MLE는 유한표본에서는 CRLB에 도달하지 못하지만(분산이 \(2(n-1)\sigma^4/n^2 < 2\sigma^4/n\)이다) 점근적으로는 도달한다.
다른 모수화: (mu, sigma)
\((\mu, \sigma^2)\) 대신 \((\mu, \sigma)\)로 모수화하면 \(\sigma\)의 MLE는:
이는 MLE의 불변성에서 따라 나온다: \(\hat{\theta}\)가 \(\theta\)의 MLE이면 \(g(\hat{\theta})\)는 \(g(\theta)\)의 MLE이다.
\(\hat{\sigma}_{\text{MLE}}\)은 \(\sigma\)에 대해 편향되어 있음에 유의하라(Jensen 부등식에 의해 \(E[\sqrt{X}] < \sqrt{E[X]}\)).
편향 보정 추정량
\(\sigma^2\)의 불편추정량은:
비교:
| 추정량 | 공식 | \(E[\cdot]\) | 평균제곱오차 |
|---|---|---|---|
| MLE | \(\frac{1}{n}\sum(X_i - \bar{X})^2\) | \(\frac{n-1}{n}\sigma^2\) | \(\frac{2n-1}{n^2}\sigma^4\) |
| Bessel | \(\frac{1}{n-1}\sum(X_i - \bar{X})^2\) | \(\sigma^2\) | \(\frac{2}{n-1}\sigma^4\) |
| 평균제곱오차 최적 | \(\frac{1}{n+1}\sum(X_i - \bar{X})^2\) | \(\frac{n-1}{n+1}\sigma^2\) | 최소 |
로그가능도 곡면
로그가능도함수 \(\ell(\mu, \sigma^2)\)은 \((\mu, \sigma^2)\) 평면 위의 곡면을 이룬다:
- \(\sigma^2\)을 고정하면 \(\ell\)은 \(\mu\)에 대해 위로 볼록한(아래로 열린) 포물선이며 \(\bar{X}\)에서 최대가 된다
- \(\mu\)를 고정하면 \(\ell\)은 \(\sigma^2\)의 오목함수이다
- 전역 최댓값은 \((\bar{X}, \hat{\sigma}^2)\)에 있다
- 로그가능도가 일정한 등고선은 (큰 \(n\)에서 근사적으로) MLE를 중심으로 하는 타원이다
\(N(5, 2^2)\)에서 뽑은 \(n = 5\)짜리 표본 하나로 이 곡면을 실제로 그려 보자. 표본크기를 작게 잡은 이유는 \(\hat{\sigma}^2_{\text{MLE}}\)와 \(S^2\)의 비가 \((n-1)/n = 0.8\)이 되어 두 값이 눈에 띄게 벌어지기 때문이다.
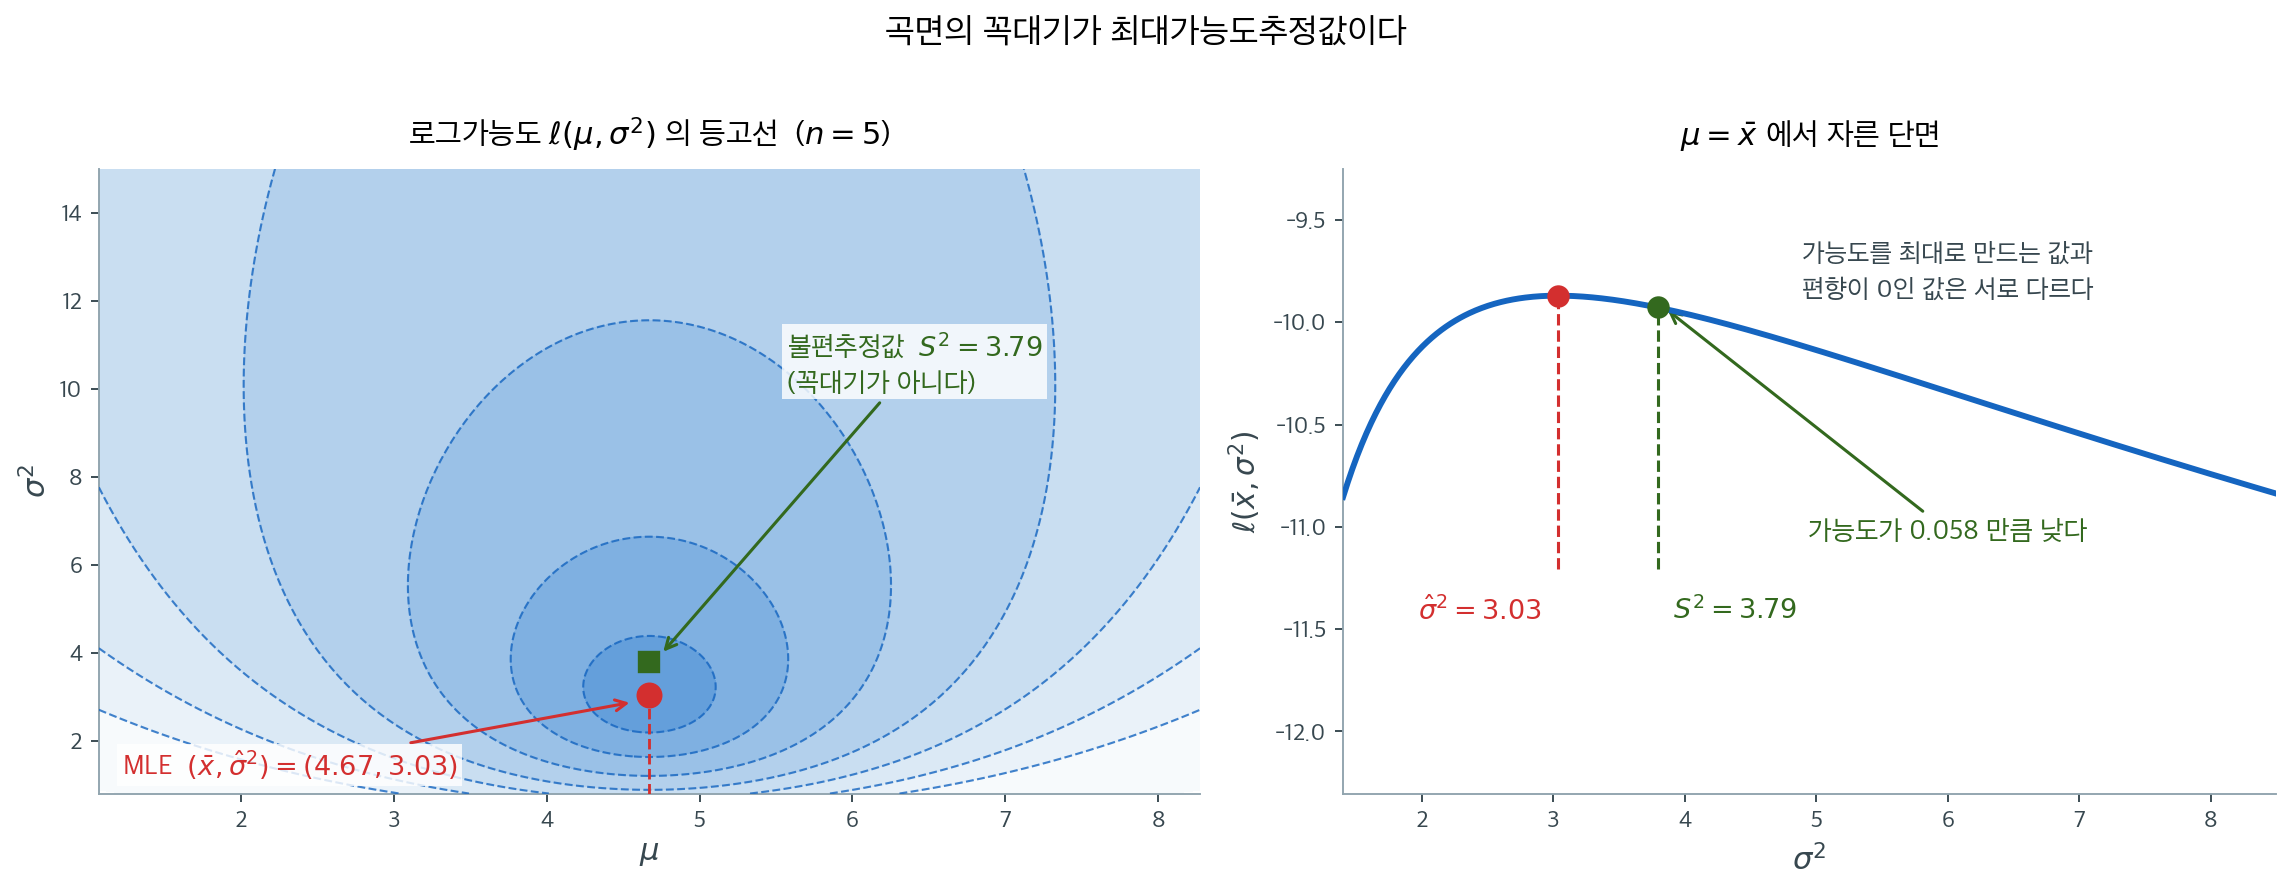
이 표본에서 \(\bar{x} = 4.67\), \(\hat{\sigma}^2_{\text{MLE}} = 3.03\), \(S^2 = 3.79\)이다. 왼쪽 등고선의 꼭대기(붉은 점)가 정확히 \((4.67, 3.03)\)에 있다. 등고선이 가로축 방향으로 대칭인 타원이라는 점에 주목하라 — 어느 높이에서 잘라도 그 조각은 \(\mu = \bar{x}\)를 중심으로 좌우대칭이다. 이것이 Fisher 정보행렬의 비대각 성분이 0이라는 말의 그림이다. \(\sigma^2\)을 어떤 값으로 잘못 잡아도 \(\mu\)의 최적값은 여전히 \(\bar{x}\)이며, 그래서 두 모수를 따로 풀 수 있었다. 반면 \(\sigma^2\) 방향으로는 등고선이 전혀 대칭이 아니다. 위쪽으로 길게 늘어져 있어서, 분산을 과대추정하는 쪽이 과소추정하는 쪽보다 가능도의 벌점이 작다.
오른쪽은 \(\mu = \bar{x}\)에서 자른 단면이다. 불편추정값 \(S^2 = 3.79\)(초록 점)는 꼭대기의 오른쪽 언덕에 앉아 있다. 불편추정량은 이 곡선을 최대로 만들지 않는다. 두 기준이 서로 다른 것을 요구하기 때문이며, 여기서 MLE가 \(n\)으로 나누는 이유와 \(S^2\)이 \(n-1\)로 나누는 이유가 갈라진다.
다만 그 차이가 얼마나 작은지도 함께 보아 둘 만하다. 꼭대기와 초록 점의 로그가능도 차이는 \(0.058\)에 불과하다. 가능도비로는 \(e^{-0.058} \approx 0.94\) — 자료가 \(S^2 = 3.79\)를 \(\hat{\sigma}^2 = 3.03\)보다 6% 덜 지지한다는 뜻일 뿐이다. 꼭대기 근처가 이토록 평평하다는 사실은 두 가지를 동시에 말해 준다. 어느 쪽을 쓰든 자료와의 적합도 차이는 미미하다는 것, 그리고 바로 그렇기 때문에 \(n\)으로 나눌지 \(n-1\)로 나눌지가 가능도만으로는 결정되지 않는다는 것이다.
가능도로부터의 신뢰영역
mu에 대해 (σ²를 아는 경우)
mu에 대해 (σ²를 모르는 경우)
여기서 \(S = \sqrt{S^2}\)이고 \(t_{n-1}\)은 자유도 \(n-1\)인 스튜던트 \(t\)-분포이다.
sigma-squared에 대해
제약 아래에서의 MLE
평균을 아는 경우
\(\mu = \mu_0\)이 알려져 있으면 \(\sigma^2\)의 제약 MLE는:
(\(\mu\)를 추정하는 경우와 달리) 이 추정량은 불편이다.
평균이 같은 경우 (합동분산)
공통 분산을 갖는 두 집단 \(X_1, \ldots, X_{n_1} \sim N(\mu_1, \sigma^2)\)과 \(Y_1, \ldots, Y_{n_2} \sim N(\mu_2, \sigma^2)\)에 대해 \(\sigma^2\)의 MLE는:
불편 버전은 \(n_1 + n_2 - 2\)로 나눈다.
금융과의 연결
-
수익률 모형화: 로그수익률이 \(r_t \sim N(\mu, \sigma^2)\)이라는 가정이 많은 금융 모형의 토대이다. MLE \(\hat{\mu} = \bar{r}\)과 \(\hat{\sigma}^2 = \frac{1}{n}\sum(r_t - \bar{r})^2\)이 표준적인 추정값이다.
-
Black-Scholes: 이 모형은 \(\log(S_T/S_t) \sim N((\mu - \sigma^2/2)(T-t), \sigma^2(T-t))\)를 가정한다. 과거 수익률로 구한 변동성의 MLE가 핵심 입력이다.
-
VaR 추정: 정규성 아래에서 \(\text{VaR}_\alpha = -(\hat{\mu} + z_\alpha \hat{\sigma})\)로, Gaussian MLE를 직접 쓴다.
-
포트폴리오 이론: Markowitz 최적화는 \(\hat{\mu}\)과 \(\hat{\Sigma}\)(표본평균 벡터와 공분산행렬)를 쓰는데, 이들이 다변량 Gaussian MLE이다.
-
정규성 검정: Gaussian MLE를 쓰기 전에 정규분포가 적절한지 검정해야 한다. 금융 수익률은 흔히 두꺼운 꼬리를 보이므로 Gaussian MLE가 최적이 아니게 된다.
요약
Gaussian MLE — \(\hat{\mu} = \bar{X}\)과 \(\hat{\sigma}^2 = \frac{1}{n}\sum(X_i - \bar{X})^2\) — 는 닫힌 형태이고 계산이 아주 쉬우며 훌륭한 성질을 갖는다. 평균추정량은 불편이고 효율적이며, 분산추정량은 편향되어 있지만 일치하고 불편 대안보다 평균제곱오차가 작다. (정규분포에만 있는) 이들의 독립성 덕분에 \(t\)와 \(\chi^2\) 분포를 통한 정확한 추론이 가능하다. 이 추정량들은 고전적 통계추론의 토대이며 금융 모수추정의 출발점이다.
핵심 공식
| 양 | 공식 |
|---|---|
| \(\hat{\mu}_{\text{MLE}}\) | \(\bar{X}\) |
| \(\hat{\sigma}^2_{\text{MLE}}\) | \(\frac{1}{n}\sum(X_i - \bar{X})^2\) |
| \(\mu\)의 Fisher 정보량 | \(I_n(\mu) = n/\sigma^2\) |
| \(\sigma^2\)의 Fisher 정보량 | \(I_n(\sigma^2) = n/(2\sigma^4)\) |
| \(\hat{\mu}\)의 분포 | \(N(\mu, \sigma^2/n)\) |
| \(n\hat{\sigma}^2/\sigma^2\)의 분포 | \(\chi^2_{n-1}\) |
| \(t\)-통계량 | \((\bar{X}-\mu)/(S/\sqrt{n}) \sim t_{n-1}\) |
연습문제
연습문제 1. \(N(\mu, \sigma^2)\)에 대해 \(\hat\mu_{\text{MLE}} = \bar X\)와 \(\hat\sigma^2_{\text{MLE}} = (1/n)\sum(X_i - \bar X)^2\)을 유도하고 2계 조건을 확인하라.
풀이
로그가능도: \(\ell(\mu, \sigma^2) = -(n/2)\ln(2\pi\sigma^2) - (1/(2\sigma^2))\sum(x_i - \mu)^2\).
\(\partial\ell/\partial\mu = (1/\sigma^2)\sum(x_i - \mu) = 0 \Rightarrow \hat\mu = \bar X\).
\(\partial\ell/\partial\sigma^2 = -n/(2\sigma^2) + (1/(2\sigma^4))\sum(x_i - \mu)^2 = 0\)이고, \(\hat\mu\)을 대입하면 \(\hat\sigma^2_{\text{MLE}} = (1/n)\sum(x_i - \bar X)^2\)을 얻는다.
Hessian: MLE에서 \(\partial^2\ell/\partial\mu^2 = -n/\sigma^2 < 0\), \(\partial^2\ell/\partial(\sigma^2)^2 = -n/(2\sigma^4) < 0\)이고, 혼합편도함수는 기댓값이 0이다. 음정부호이므로 최댓값임이 확인된다.
연습문제 2. \(N(\mu, \sigma^2)\)의 Fisher 정보행렬. 비대각 성분이 0임을 보이고 \(\bar X\)가 CRLB를 정확히 달성함을 확인하라.
풀이
\(I_{\mu\mu} = n/\sigma^2\), \(I_{\sigma^2 \sigma^2} = n/(2\sigma^4)\), \(I_{\mu \sigma^2} = \mathbb{E}[-(X-\mu)/\sigma^4] = 0\).
Fisher 정보행렬이 대각이다: \(\mu\)와 \(\sigma^2\)은 직교 모수이다. 하나를 추정하는 것이 다른 하나를 추정하는 점근분산에 영향을 주지 않는다.
\(\mathrm{Var}(\bar X) = \sigma^2/n = 1/I_{\mu\mu}\) — \(\bar X\)는 점근적으로만이 아니라 임의의 \(n\)에서 CRLB를 정확히 달성한다. \(\mu\)의 MLE는 완전히 효율적이다.
\(\sigma^2\)의 경우: \(\mathrm{Var}(\hat\sigma^2_{\text{MLE}}) = 2(n-1)\sigma^4/n^2\), CRLB \(= 2\sigma^4/n\). CRLB보다 약간 위이며 점근적으로 효율적이다.
연습문제 3. MLE의 불변성. (a) \(\sigma\), (b) \(\mathrm{CV} = \sigma/\mu\), (c) 99번째 백분위수 \(\mu + 2.326\sigma\)의 MLE를 구하라.
풀이
MLE 불변성에 의해 \(\widehat{g(\theta)} = g(\hat\theta_{\text{MLE}})\):
(a) \(\hat\sigma = \sqrt{\hat\sigma^2_{\text{MLE}}}\).
(b) \(\widehat{\mathrm{CV}} = \hat\sigma/\bar X\).
(c) \(\widehat{q_{0.99}} = \bar X + 2.326 \hat\sigma\).
주의: 불변성은 MLE 점추정값은 보존하지만 불편성은 보존하지 않는다. \(\hat\sigma\)은 편향되어 있으며(오목함수 \(\sqrt{\cdot}\)에 대한 Jensen 부등식), \(c_4\) 상수로 편향을 보정할 수 있다.
연습문제 4. \(\mu = 0\)이라는 제약 아래의 MLE. \(\mu\)가 0임을 알 때 \(\hat\sigma^2\)을 유도하라. 제약 없는 MLE와 분산을 비교하라.
풀이
\(\mu = 0\)이면 \(\hat\sigma^2_0 = (1/n) \sum X_i^2\)이다. \(\mathbb{E}[\hat\sigma^2_0] = (1/n) \cdot n\sigma^2 = \sigma^2\) — 불편이다(\(\mu\)를 추정한 것이 아니라 알고 있으므로 Bessel 수정이 필요 없다).
\(n\hat\sigma^2_0/\sigma^2 \sim \chi^2_n\)이므로 \(\mathrm{Var}(\hat\sigma^2_0) = 2\sigma^4/n\)이다.
제약 없는 경우: \(\mathrm{Var}(\hat\sigma^2_{\text{MLE}}) = 2\sigma^4(n-1)/n^2\).
제약 있는 추정량은 (자유도가 하나 더 많아) 분산이 약간 크지만 불편이다. \(\mu\)를 추정하는 "대가"는 자유도 \(-1\)이다.
연습문제 5. 모수적 VaR. 일별 수익률 252개에서 \(\hat\mu = 0.0003\), \(\hat\sigma = 0.012\)를 얻었다. (a) 1일 99% VaR. (b) 제곱근 규칙에 의한 10일 VaR. (c) 참 초과첨도가 3이라면 정규 VaR는 위험을 과대평가하는가, 과소평가하는가?
풀이
(a) \(\mathrm{VaR}_{0.99}^{\text{1일}} = -(\hat\mu + z_{0.01} \hat\sigma) = -(0.0003 - 2.326 \cdot 0.012) = 0.0276\) (2.76% 손실).
(b) \(\mathrm{VaR}_{0.99}^{\text{10일}} = \sqrt{10} \cdot 0.0276 \approx 0.0873\) (8.73%). i.i.d.이고 추세가 0이라는 가정 아래에서 유효하다.
(c) 두꺼운 꼬리(초과첨도 3 > 0)는 참 99번째 백분위수 손실이 정규 예측보다 크다는 뜻이다. 정규 VaR는 실제 위험을 과소평가한다. 보수적인 실무: 위험관리에는 \(t\)-분포 기반 VaR나 경험적 분위수를 쓰라.
연습문제 6. 몬테카를로 검증. \(N(5, 9)\)에서 \(n = 20\)인 표본 10000개를 모의실험하라. \(\mathbb{E}[\hat\mu], \mathbb{E}[\hat\sigma^2_{\text{MLE}}], \mathbb{E}[S^2]\)을 확인하라.
풀이
import numpy as np
rng = np.random.default_rng(0)
R, n, mu, var = 10_000, 20, 5.0, 9.0
samples = rng.normal(mu, np.sqrt(var), (R, n))
mu_hat = samples.mean(axis=1)
sig2_mle = samples.var(axis=1, ddof=0)
s2 = samples.var(axis=1, ddof=1)
print(f"E[mu_hat]   = {mu_hat.mean():.4f}   (true {mu})")
print(f"E[sig2_MLE] = {sig2_mle.mean():.4f} (true {(n-1)/n*var:.4f})")
print(f"E[S^2]      = {s2.mean():.4f}       (true {var})")
출력:
E[mu_hat]   = 5.0004   (true 5.0)
E[sig2_MLE] = 8.5701 (true 8.5500)
E[S^2]      = 9.0212       (true 9.0)
예상 결과:
- \(\mathbb{E}[\bar X] \approx 5.00\) (불편).
- \(\mathbb{E}[\hat\sigma^2_{\text{MLE}}] \approx 8.55 = (19/20) \cdot 9\) (\(\sigma^2/n\)만큼 아래로 편향).
- \(\mathbb{E}[S^2] \approx 9.00\) (Bessel 수정, 불편).
이론적 결과가 확인되며 분산에 대한 MLE의 편향이 드러난다.
연습문제 7. 정규 가정으로 계산한 VaR와 기대손실(ES) 이 꼬리가 두꺼운 자료에서 각각 얼마나 어긋나는지 비교하라. 어느 쪽이 더 민감한가?
풀이
정규 기준. 손실이 표준화되어 있다고 하면
\(t_5\)(분산을 1로 표준화).
비교.
| 측도 | 정규 | \(t_5\) | 과소평가 |
|---|---|---|---|
| VaR 99% | 2.326 | 2.606 | 11% |
| ES 99% | 2.665 | 3.449 | 23% |
ES가 훨씬 민감하다. VaR는 분위수 하나만 보므로 꼬리의 모양을 반영하지 못하지만, ES는 그 너머 전체의 평균이라 두꺼운 꼬리를 온전히 담는다.
더 극단적인 신뢰수준에서. 99.9%로 가면 차이가 더 벌어진다. \(t_5\)의 꼬리가 거듭제곱으로 줄고 정규는 초지수적으로 줄기 때문에, 신뢰수준이 높을수록 격차가 커진다.
실무적 함의.
- 정규 VaR는 꼬리 위험을 체계적으로 과소평가한다. 자본 규제의 기준으로 쓰면 위험하다.
- 2016년 바젤 규제가 VaR에서 ES로 옮긴 이유 중 하나가 이것이다. 다만 ES가 꼬리 가정에 더 민감하다는 점은 양날의 칼이다. 모형이 틀리면 오차도 더 크다.
- 대안: 경험적 분위수, \(t\) 분포 적합, 극단값 이론(임계값 초과분에 일반화파레토 적합).
덧붙임. VaR는 부분가법성을 만족하지 않아 "포트폴리오를 나누면 위험이 줄어드는 것처럼" 보일 수 있다. ES는 정합적 위험측도라 이 문제가 없다. 꼬리 민감도와 정합성 모두에서 ES가 이론적으로 우월하며, 추정 어려움이 그 대가다.
연습문제 8. 제곱근 규칙 \(\sigma_{h} = \sigma_1\sqrt h\)이 성립하는 조건을 밝히고, 자기상관이 있으면 어떻게 수정해야 하는지 적어라.
풀이
성립 조건. \(h\)기간 수익률이 \(r^{(h)} = \sum_{t=1}^h r_t\)이므로
이다. 따라서 수익률이 무상관이고 분산이 일정해야 \(h\sigma_1^2\)이 되고 제곱근 규칙이 성립한다.
자기상관이 있으면. 등상관이 아니라 AR(1) 구조 \(\rho_k=\phi^k\)라 하면
이고, \(h\)가 크면
이다. 따라서 보정된 규칙은
방향이 중요하다.
| \(\phi\) | 보정 인수 | 뜻 |
|---|---|---|
| \(+0.2\) | 1.22 | 제곱근 규칙이 과소평가 |
| \(0\) | 1.00 | 정확 |
| \(-0.2\) | 0.82 | 제곱근 규칙이 과대평가 |
현실의 수익률. 일별 주가 수익률의 1차 자기상관은 대개 작지만(\(|\phi|<0.1\)), 음수인 경우가 흔하다(호가 스프레드 반동). 그러면 제곱근 규칙이 위험을 과대평가한다. 반면 유동성이 낮은 자산이나 헤지펀드 수익률은 양의 자기상관이 크게 나타나(평활화된 가격 보고) 제곱근 규칙이 위험을 크게 과소평가한다.
다른 위반 요인.
- 변동성 군집. 분산이 일정하지 않으면 규칙이 깨진다. GARCH 모형의 \(h\)기간 예측을 써야 한다.
- 평균 회귀. 장기적으로 평균회귀하면 장기 분산이 \(h\)에 비례하는 것보다 느리게 는다.
- 꼬리. 분산이 무한하면 제곱근이 아니라 \(h^{1/\alpha}\)로 스케일한다.
권고. 바젤 규제가 10일 VaR에 \(\sqrt{10}\) 규칙을 허용하지만, 자기상관과 변동성 군집을 확인하지 않고 쓰면 안 된다. 최소한 \(\phi\)를 추정해 보정하거나, 직접 10일 수익률을 겹쳐 만들어 추정하는 편이 낫다.
연습문제 9. \(\mu=0\)이라는 제약을 두고 분산을 추정하면 얼마나 이득인가? 금융 수익률에서 이 제약이 정당화되는가?
풀이
제약 있는 추정량.
불편이고 \(\operatorname{Var}=2\sigma^4/n\)이다.
제약 없는 \(S^2\). \(\operatorname{Var}=2\sigma^4/(n-1)\).
이득.
| \(n\) | 분산 감소 |
|---|---|
| 21 | 4.8% |
| 63 | 1.6% |
| 252 | 0.4% |
작다. 관측 하나를 더 얻는 것과 같은 정도다.
정당화되는가. 일별 수익률에서는 대체로 그렇다.
- 연 기대수익률이 8%면 일별로는 \(0.08/252 = 0.032\%\)다.
- 일별 변동성은 대략 \(1.2\%\)다.
- 평균이 표준편차의 2.6%에 지나지 않는다. 제곱하면 \(0.07\%\)로, 분산 추정에 미치는 영향이 사실상 없다.
구체적으로, 평균을 무시해 생기는 편향이
로 \(\mu^2\)만큼 과대추정인데, 위 수치에서 \(\mu^2/\sigma^2 = 0.0007\)이다.
언제 정당화되지 않는가.
- 저빈도 자료. 연별 수익률이면 평균과 표준편차가 비슷한 규모라 무시할 수 없다.
- 추세가 강한 기간. 강세장이나 폭락기의 짧은 구간.
- 수익률이 아닌 자료. 가격 수준이나 지수는 평균이 크다.
실무. 실현변동성 계산에서 평균을 빼지 않는 것이 표준이며, 위 논증이 그 근거다. 고빈도일수록 제약이 더 타당해진다. 다만 자유도 하나를 아끼는 이득은 미미하므로, 의심스러우면 그냥 평균을 빼는 편이 안전하다.
연습문제 10. 정규 MLE로 추정한 모수를 위험관리에 쓸 때 저지르기 쉬운 실수를 세 가지 들고 각각의 대처를 적어라.
풀이
(1) 추정 불확실성을 무시한다. \(\hat\mu\)와 \(\hat\sigma\)를 참값처럼 쓰고 VaR를 계산한다.
- 문제: \(\hat\sigma\)의 상대 표준오차가 \(n=252\)에서도 4.5%(정규 가정)이고, 첨도를 반영하면 9%다. VaR가 \(\hat\sigma\)에 비례하므로 그만큼 흔들린다. \(\hat\mu\)는 훨씬 심하다.
- 대처: VaR의 신뢰구간을 부트스트랩으로 구하거나, 베이즈 사후 예측분포를 쓴다. 사후 예측은 모수 불확실성을 자동으로 반영해 꼬리를 두껍게 만든다.
(2) 정규 가정을 검증하지 않는다. 수익률의 초과첨도가 5~10인 것이 잘 알려져 있는데도 정규 VaR를 쓴다.
- 문제: 연습문제 7에서 본 대로 ES를 23% 과소평가한다. 극단적인 신뢰수준일수록 심하다.
- 대처: Q-Q 그림과 첨도를 확인하고, \(t\) 분포나 극단값 이론으로 옮긴다. 최소한 정규 결과와 \(t\) 결과를 나란히 보고한다.
(3) 변동성이 일정하다고 가정한다. 표본 전체의 \(\hat\sigma\)를 현재 위험으로 쓴다.
- 문제: 변동성 군집 때문에 조용한 기간에는 과대, 요동치는 기간에는 과소평가한다. 위기 직전에 위험을 가장 낮게 보는 셈이다.
- 대처: GARCH나 EWMA로 조건부 변동성을 쓴다. 리스크메트릭스의 \(\lambda=0.94\)가 표준적인 출발점이다.
그 밖에 흔한 실수.
- \(\sqrt h\) 규칙을 검증 없이 적용한다(연습문제 8).
- 상관을 정규 코퓰라로 모형화해 동시 폭락을 과소평가한다(앞 장의 금융위기 사례).
- 백테스트를 하지 않는다. VaR 위반 횟수가 명목값과 맞는지 확인해야 한다(쿠피엑 검정, 크리스토퍼슨 검정).
총괄 권고. 모형 위험을 명시적으로 다룬다. 여러 가정(정규 대 \(t\), 상수 대 조건부 변동성, 다른 추정 기간)에서 계산한 결과의 범위를 보고하고, 가장 보수적인 값을 자본 산정에 쓴다. 소수점 아래까지 정밀한 하나의 숫자보다 정직하다.
정리하며
정규분포의 최대가능도추정량은 점수방정식 둘을 풀어 닫힌 형태로 나온다.
- \(\hat\mu\) 는 불편이고 효율적이다. 피셔 정보량 \(I(\mu)=1/\sigma^2\) 이 주는 크라메르–라오 하한 \(\sigma^2/n\) 을 정확히 달성한다.
- \(\hat\sigma^2\) 은 \(n\) 으로 나누므로 편향되어 있다. 앞 절에서 본 소박한 추정량이며, 최대가능도가 불편성을 보장하지 않는다는 사실의 표준 예다.
- 두 모수가 분리된다. \(\hat\mu\) 가 \(\sigma^2\) 과 무관하게 정해지므로 연립방정식을 순서대로 풀 수 있다. 정보행렬이 대각이기 때문이며, 그래서 두 추정량이 점근적으로 독립이다.
- \((\sum X_i,\sum X_i^2)\) 이 충분통계량이다. 자료가 아무리 많아도 두 수만 남기면 되며, 이것이 지수족의 성질이다.
- 이 결과가 고전적 추론의 출발점이다. \(t\) 검정, 분산의 카이제곱 구간, 분산분석이 모두 여기서 갈라져 나온다.
다음 절 \(\sigma^2\) 에 대한 정규분포 최대가능도의 편향에서 그 편향을 정면으로 다룬다.