교차엔트로피 손실
정의 1. 범주형 교차엔트로피 손실
관측치 \(n\)개와 범주 \(C\)개에 대해 범주형 교차엔트로피 손실은
이다. 여기서 \(\mathbf{Y}\)는 \(n\times C\) 원-핫 이름표 행렬이고 \(\hat{\mathbf{Y}}\)는 소프트맥스가 낸 \(n\times C\) 예측확률 행렬이다.
기울기 dJ/dZ^o의 유도
이 기울기는 소프트맥스 층을 거치는 역전파의 출발점이며 놀랄 만큼 단순한 형태를 갖는다.
1단계 --- 손실 다시 쓰기
\(\hat{y}_{ic} = e^{z_{ic}^o}\big/\sum_{c'}e^{z_{ic'}^o}\)이므로
이고, \(\sum_c y_{ic}=1\)(원-핫)이므로
이다.
2단계 --- 미분하기
행렬 형태
이는 이항 로지스틱 회귀에 나타나는 "예측값 빼기 목표값" 잔차와 같은 형태다. 소프트맥스와 교차엔트로피의 조합은 범주 수와 무관하게 깔끔한 기울기를 만들어 낸다.
왜 하필 교차엔트로피인가
"\(\hat{\mathbf{Y}} - \mathbf{Y}\)라는 깔끔한 꼴이 나와서"는 절반의 답이다. 나머지 절반은 그 깔끔함이 어디에서 학습을 살려 내는가에 있다. 참 범주에 부여한 확률을 \(\hat{p}_y\)라 두고, 교차엔트로피 \(-\log\hat{p}_y\)와 제곱손실 \((1-\hat{p}_y)^2\)을 나란히 그려 보자.
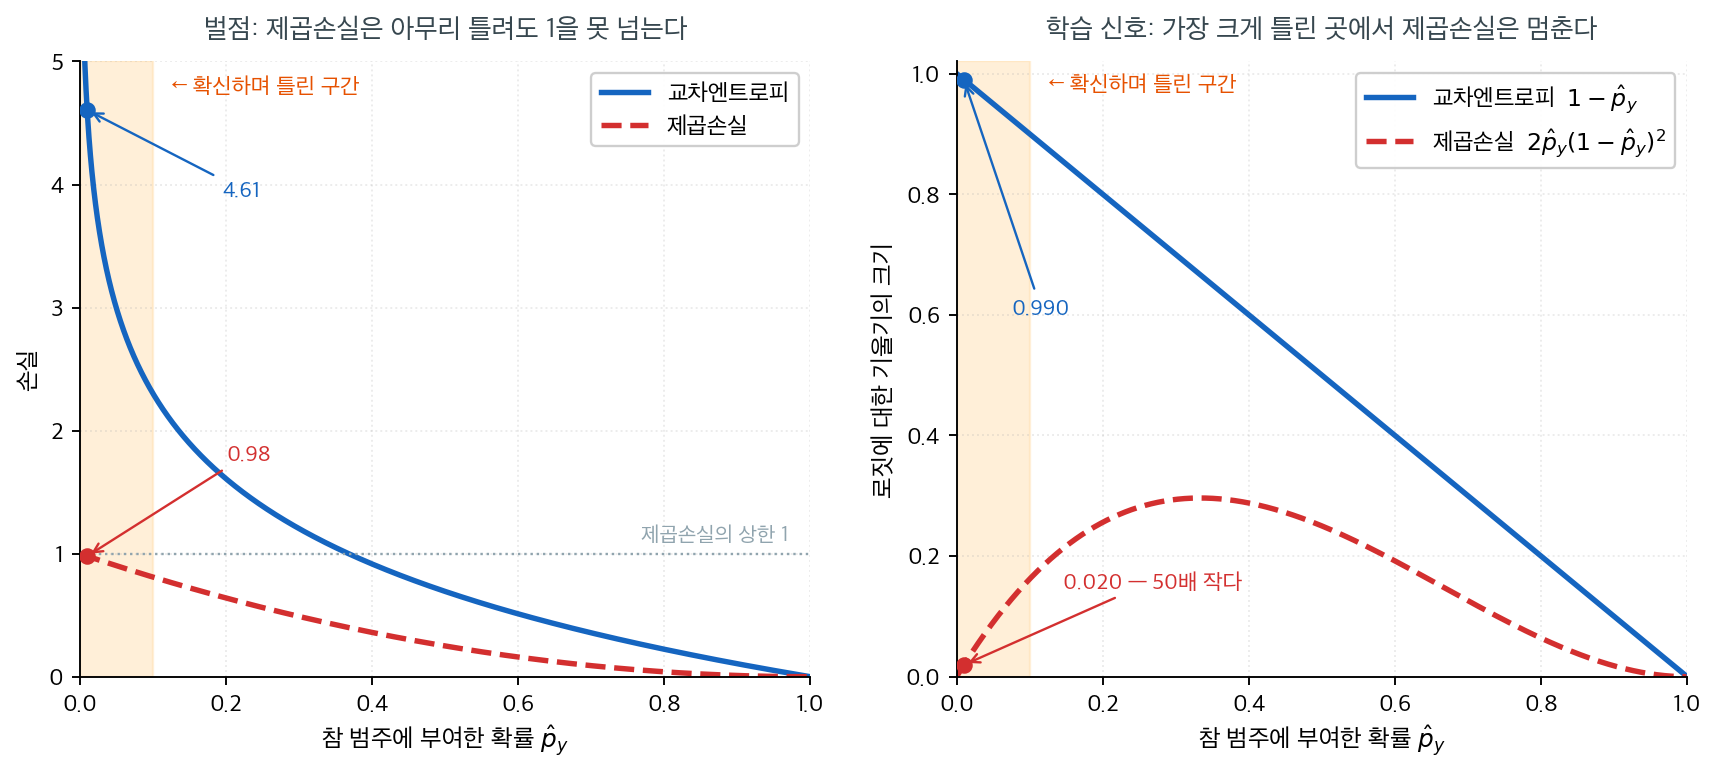
왼쪽 그림이 벌점의 차이다. 모형이 참 범주에 \(\hat{p}_y = 0.01\)만 주는, 즉 확신하며 틀린 사례에서 교차엔트로피는 \(4.61\)이지만 제곱손실은 \(0.98\)에 그친다. 제곱손실은 \(\hat{p}_y \to 0\) 에서도 \(1\)을 넘지 못한다. 회색 점선이 그 상한이다. 확률이 아무리 터무니없어도 벌점의 크기가 유한하게 묶여 있다는 뜻이며, 반대로 교차엔트로피는 \(-\log \hat p_y \to \infty\)로 발산한다. "자신 있게 틀리는 것"을 원리적으로 금지하는 쪽은 교차엔트로피뿐이다.
오른쪽 그림이 더 결정적이다. 최적화가 실제로 쓰는 것은 손실값이 아니라 기울기다. 로짓 \(z_y\)에 대한 기울기의 크기는 교차엔트로피가 \(1-\hat{p}_y\), 제곱손실이 \(2\hat{p}_y(1-\hat{p}_y)^2\)이다. \(\hat{p}_y = 0.01\)에서 앞의 것은 \(0.990\)으로 거의 최대치인데 뒤의 것은 \(0.0196\)으로 50배나 작다. 제곱손실의 기울기는 \(\hat{p}_y = 1/3\)에서 \(8/27 \approx 0.296\)으로 최대가 되고, 양쪽 끝에서 모두 0으로 눌린다. 소프트맥스 야코비에서 남은 \(\hat p_y(1-\hat p_y)\) 인자가 원흉이다.
이 그림이 말하는 바는 한 문장으로 요약된다. 제곱손실을 쓰면 모형이 가장 크게 틀린 곳에서 학습이 가장 느려진다. 고쳐야 할 사례일수록 갱신량이 0에 가까워지니, 나쁜 초기값에서 출발하면 빠져나오는 데 오래 걸린다. 교차엔트로피는 야코비의 \(\hat p_y(1-\hat p_y)\)가 로그의 미분 \(1/\hat p_y\)와 정확히 소거되어 기울기가 잔차 \(\hat{p}_y - y\)만 남는다. 앞 절에서 본 그 간결한 식은 우연한 대수적 행운이 아니라, 틀린 만큼 그대로 벌하겠다는 설계의 결과다.
KL 발산과의 관계
교차엔트로피는
로 분해된다. 원-핫 이름표에서는 \(H(\mathbf{y}_i)=0\)이므로, 교차엔트로피를 최소화하는 것은 참 분포와 예측 분포 사이의 KL 발산을 최소화하는 것과 같다.
수치적 안정성
실무에서는 로그-합-지수 기법을 써서 로짓 \(\mathbf{z}\)로부터 손실을 직접 계산한다.
여기서 \(m_i=\max_c z_{ic}\)다. 이렇게 하면 오버플로와 로그에서의 정밀도 손실을 모두 피할 수
있다. PyTorch의 nn.CrossEntropyLoss와 TensorFlow의
tf.nn.softmax_cross_entropy_with_logits가 이를 자동으로 구현한다.
연습문제
연습문제 1. 교차엔트로피 손실
참 범주 이름표가 \(y = 2\)(\(C = 4\)개 범주 중)이고 예측확률 벡터가 \(\hat{\mathbf{p}} = (0.1, 0.6, 0.2, 0.1)^\top\)인 훈련 사례 하나를 생각하자.
(a) 이 사례의 원-핫 부호화 \(\mathbf{y}\)를 쓰라.
(b) 교차엔트로피 손실을 계산하라.
(c) 다른 모형이 \(\hat{\mathbf{p}}' = (0.05, 0.85, 0.05, 0.05)^\top\)을 예측했다고 하자. 그 교차엔트로피 손실을 계산하고 어느 모형이 더 나은지 설명하라.
(d) 옳게 분류된 사례의 교차엔트로피 손실의 최솟값은 얼마인가? 언제 달성되는가?
풀이
(a) 범주 2의 원-핫 부호화는(1부터 세는 색인 기준)
이다.
(b) \(y_2 = 1\)만 0이 아니므로 합이 한 항으로 줄어든다.
(c) 두 번째 모형은
이다. \(L' < L\)이므로 두 번째 모형이 더 낫다. 참 범주에 더 높은 확률을 부여했기 때문이다. 교차엔트로피는 참 범주에 대한 확신이 낮은 것을 벌한다. \(\hat{p}_y\)가 1에 가까울수록 손실이 작아진다.
(d) 최솟값은 0이며, \(\hat{p}_y = 1\)일 때(모형이 참 범주에 확률 1을 부여할 때) 달성된다. \(-\log(1) = 0\)이므로 완벽히 확신하고 옳은 예측은 손실이 0이다.
0은 도달할 수 없는 하한이다
소프트맥스의 출력은 항상 엄밀히 0과 1 사이이므로 \(\hat p_y = 1\)은 유한한 로짓으로 달성할 수 없다. \(\hat p_y \to 1\)이 되려면 \(z_y - \max_{k \ne y} z_k \to \infty\)가 필요하다. 즉 훈련자료가 완전히 분리 가능하면 손실이 0으로 수렴하되 도달하지는 않으며, 가중치가 발산한다. 19장의 완전 분리 문제가 다범주에서 되풀이되는 것이며, 정칙화가 필요한 이유이기도 하다.
연습문제 2. 교차엔트로피의 기울기
범주 \(C\)개인 소프트맥스 회귀를 생각하자. 범주 \(k\)의 예측확률은 \(\hat{p}_k = \text{softmax}(\mathbf{z})_k\)이고 \(\mathbf{z} = \mathbf{W}\mathbf{x} + \mathbf{b}\) 이다.
(a) 소프트맥스 함수의 도함수가
를 만족함을 보여라(\(\delta_{kj}\)는 크로네커 델타).
(b) (a)의 결과를 이용해 로짓에 대한 교차엔트로피 손실의 기울기
를 유도하라.
(c) 이 기울기를 해석하라. 모형이 매우 확신하며 옳을 때는 어떻게 되는가? 확신하며 틀렸을 때는?
풀이
(a) 소프트맥스는 \(\hat{p}_k = e^{z_k} / S\)이고 \(S = \sum_m e^{z_m}\)이다.
경우 \(k = j\): 몫의 미분법으로
경우 \(k \ne j\):
두 경우가 \(\frac{\partial \hat{p}_k}{\partial z_j} = \hat{p}_k(\delta_{kj} - \hat{p}_j)\)로 통합된다.
(b) 교차엔트로피 손실은 \(L = -\sum_k y_k \log \hat{p}_k\)이고, 연쇄법칙에 의해
이다. \(\mathbf{y}\)가 원-핫이므로 \(\sum_k y_k = 1\)이고, 따라서
벡터 형태로는 \(\nabla_{\mathbf{z}} L = \hat{\mathbf{p}} - \mathbf{y}\)다.
(c) 기울기 \(\hat{p}_j - y_j\)는 깔끔하게 해석된다.
- 옳고 확신함(\(y_j = 1\), \(\hat{p}_j \approx 1\)): 기울기 \(\approx 0\). 이미 옳으므로 갱신이 거의 필요 없다.
- 옳지만 불확실함(\(y_j = 1\), \(\hat{p}_j \approx 0.3\)): 기울기 \(\approx -0.7\). 음의 기울기가 \(z_j\)를 올려 \(\hat{p}_j\)를 키운다.
- 틀렸고 확신함(\(y_j = 0\), \(\hat{p}_j \approx 0.9\)): 기울기 \(\approx 0.9\). 큰 양의 기울기가 \(z_j\)를 내려 \(\hat{p}_j\)를 줄인다.
이 "잔차" 형태 \((\hat{\mathbf{p}} - \mathbf{y})\)는 선형회귀에서 제곱오차의 기울기 \((\hat{\mathbf{y}} - \mathbf{y})\)와 나란하여 경사하강 갱신을 직관적으로 만든다.
제곱오차를 썼다면 이렇게 되지 않는다
분류에 제곱손실 \(\frac{1}{2}\|\hat{\mathbf{p}} - \mathbf{y}\|^2\)를 쓰면 기울기가 \((\hat{\mathbf{p}} - \mathbf{y})\)에 소프트맥스 야코비가 곱해진 형태가 되어 \(\hat p_j(1-\hat p_j)\) 인자가 남는다. 그러면 확신하며 틀린 경우 (\(\hat p_j \approx 1\), \(y_j = 0\))에 이 인자가 0에 가까워져 기울기가 사라진다. 가장 크게 틀린 사례에서 학습이 가장 느려지는 것이다. 교차엔트로피에서는 이 인자가 정확히 소거되므로 그런 문제가 없다. 이것이 분류에 교차엔트로피를 쓰는 실질적인 이유다.
정리하며
교차엔트로피가 소프트맥스의 손실함수다.
- 음의 로그가능도와 같다. 19장에서 본 대로 통계학의 최대가능도와 기계학습의 손실 최소화가 같은 계산이다.
- 기울기가 다시 단순하다. \(\nabla_{\mathbf W}L=\mathbf X^\top(\mathbf P-\mathbf Y)\) 이며, 로지스틱 회귀의 \(\mathbf X^\top(\mathbf p-\mathbf y)\) 와 같은 꼴이다. 소프트맥스와 교차엔트로피를 짝지어 쓰는 이유가 이 간결함에 있다.
- 정답 범주의 확률만 본다. 원-핫 라벨이면 \(-\log p_{y_i}\) 하나로 줄어든다.
- 오답에 무겁게 벌한다. 정답 확률이 \(0\) 에 가까우면 손실이 무한대로 가므로, 자신 있게 틀리는 것을 강하게 막는다.
- \(\log 0\) 을 피해야 한다. 로그-합-지수 기법으로 안정적으로 계산한다.
다음 절 최적화로 넘어간다.