이표본 비율 검정
개요
이표본 비율 검정은 독립인 두 모집단의 비율을 비교한다. A/B 검정, 임상시험, 사회과학 연구에서 처리나 개입이 이진 결과의 비율을 바꾸는지 판단하는 데 널리 쓰인다. 이항분포에 대한 정규근사에 기반한 z-통계량을 쓴다.
검정의 구성
가설:
- 양측: \(H_0\colon p_1 - p_2 = \delta_0\) 대 \(H_1\colon p_1 - p_2 \neq \delta_0\)
\(\delta_0 = 0\)(동일성 검정)일 때는 합동 표준오차를 쓴다:
\(\delta_0 \neq 0\)일 때는 Wald 표준오차를 쓴다:
검정통계량은
카이제곱 검정과 같은 검정이다
\(2 \times 2\) 분할표를 보면 같은 물음을 카이제곱 독립성 검정으로도 물을 수 있다. 두 검정은 닮은 검정이 아니라 같은 검정이다.
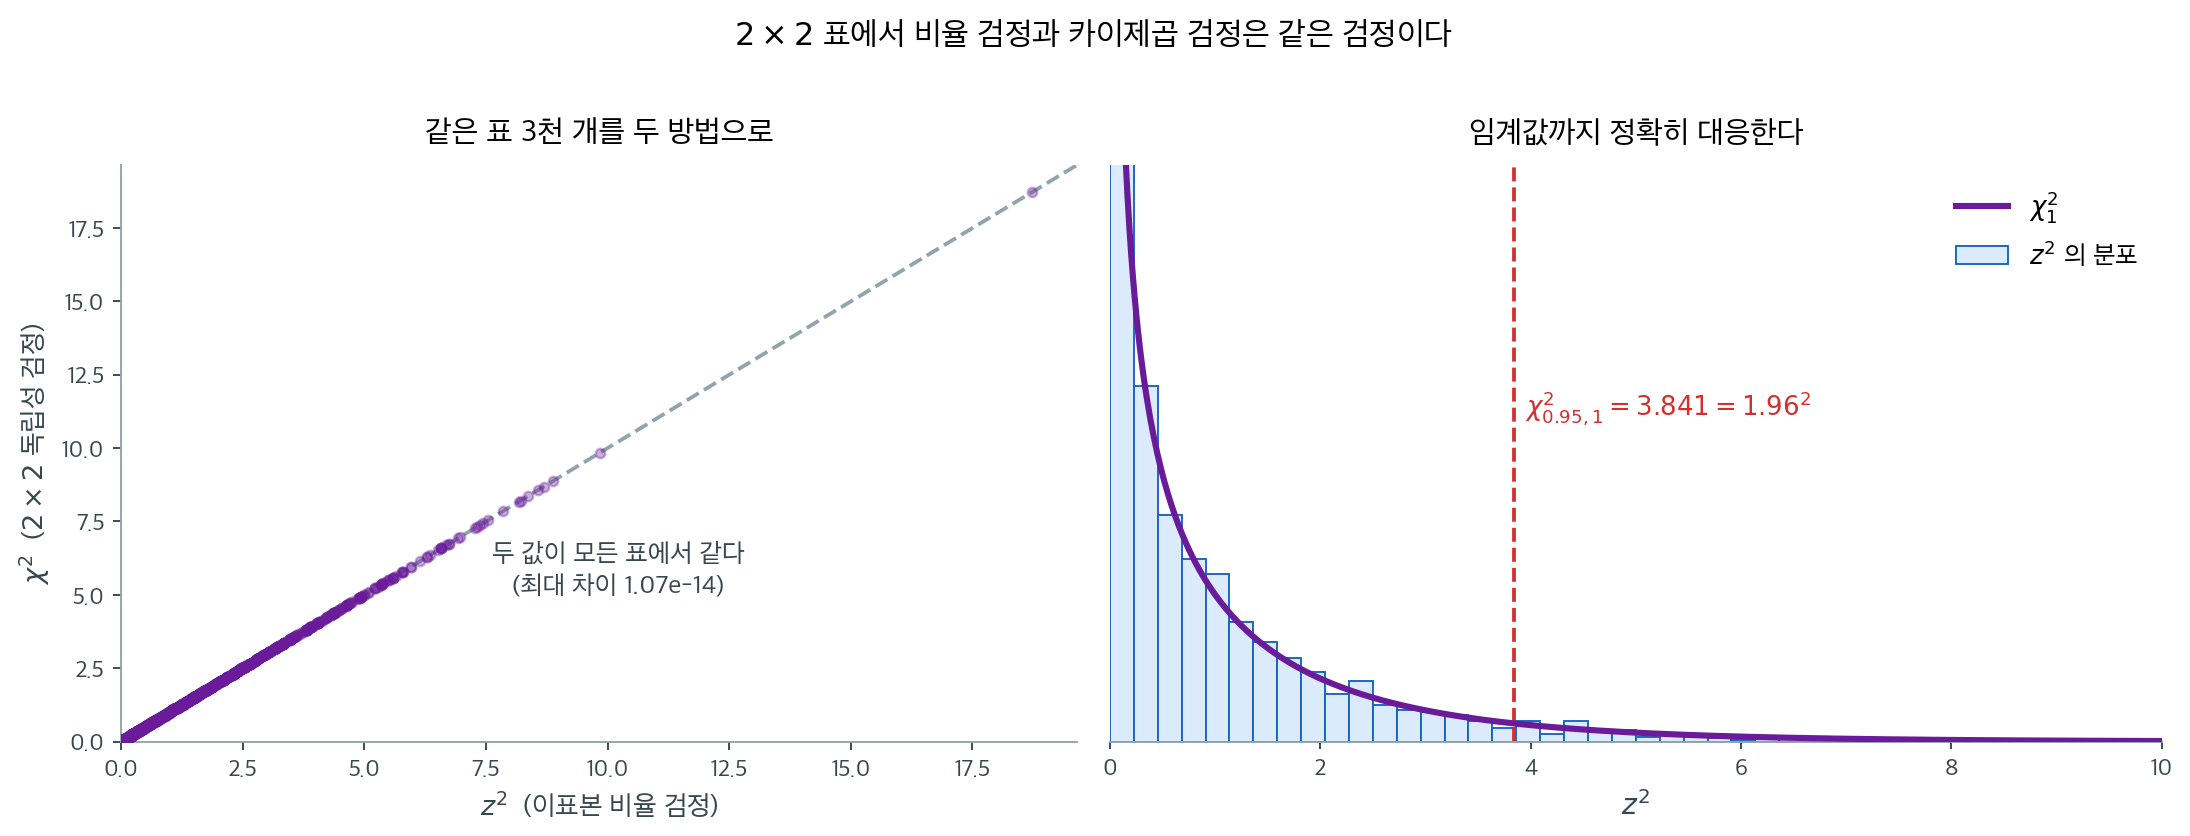
왼쪽에서 점들이 대각선 위에 정확히 놓인다. \(\delta_0 = 0\)이고 합동 표준오차를 쓰면
이 항등식으로 성립하며, 그림의 최대 차이 \(10^{-14}\)는 부동소수점 반올림일 뿐이다. 오른쪽에서 보듯 귀무분포도 대응한다. \(Z \sim N(0,1)\)이면 \(Z^2 \sim \chi^2_1\)이고, 임계값도 \(1.96^2 = 3.841\)로 맞아떨어진다.
그렇다면 왜 둘 다 배우는가. 두 가지가 다르다. 첫째, \(Z\)는 단측검정을 할 수 있지만 \(\chi^2\)은 할 수 없다. 제곱하는 순간 방향 정보가 사라지기 때문이다. 둘째, \(\chi^2\)은 \(2 \times 2\)를 넘어 확장된다. 범주가 셋 이상이거나 행이 여럿인 표에는 \(Z\)를 쓸 수 없다. 방향을 묻고 싶으면 \(Z\), 표가 커지면 \(\chi^2\)이다.
보기 1. 두 비율 차이 검정 계산기. 아래 함수는 \(\delta_0 = 0\)일 때는 합동 표준오차를, 그 밖의 경우에는 Wald 표준오차를 쓴다. 두 표준오차는 같은 자료에서 다른 수다.
(1) \(\text{SE}_{\text{pool}}^2 - \text{SE}_{\text{wald}}^2\)을 닫힌 꼴로 구하고 \(n_1 = n_2\)일 때로 특수화하시오. 어느 쪽이 큰지는 무엇이 정하는가.
(2) 그 식을 무작위 입력으로 검사하고, \(n_1 = 80\), \(n_2 = 60\)에서 두 표준오차의 크기 순서가 뒤집히는 경계를 찾으시오.
풀이
(1) 해석적으로. \(A = \hat p_1\), \(B = \hat p_2\), \(N = n_1 + n_2\)로 줄여 쓰면 합동 비율이 \(\bar p = (n_1A + n_2B)/N\)이므로
이다. 차에 \(n_1n_2\)를 곱하면 일차항에서
가 남고, 이차항에서는
이 남는다. 둘을 더해 \((A-B)\)로 묶으면
이다. \(n_1 = n_2 = n\)을 넣으면 첫 항이 사라지고
이 되어, 균형 설계에서는 합동 쪽이 언제나 크다. 이 특수한 꼴은 비율에 대한 이표본 Z-검정의 보기 2에서 \(p(1-p)\)의 오목성으로 얻었던 식과 같다. 위 식은 거기에 불균형 항을 더한 일반형이다.
순서를 뒤집는 것은 괄호 안의 첫 항이다. 둘째 항은 \((A-B)\)와 같은 부호여서 곱하면 언제나 \(\ge 0\)이지만, 첫 항은 \((n_1-n_2)\)와 \((1-A-B)\)의 부호에 따라 어느 쪽으로도 갈 수 있다. 특히 두 비율이 모두 높아 \(A + B > 1\)이 되면 \((1-A-B)\)가 음수가 되어, 표본이 큰 쪽의 비율이 높을 때 합동 표준오차가 Wald보다 작아질 수 있다. \(A - B\)를 고정했을 때의 경계는 괄호를 0으로 두어
로 구해진다.
(2) 수치적으로. 먼저 함수다.
import math
from scipy.stats import norm

def test_diff_two_props(k1, n1, k2, n2, delta0=0.0,
                        method="pooled", alt="two-sided", alpha=0.05):
    """귀무가설 H0: p1 - p2 = delta0.

    delta0=0이고 method='pooled'이면 합동 표준오차를 쓴다.
    돌려주는 값은 (z, p, 기각 여부, 이름).
    """
    p1, p2 = k1 / n1, k2 / n2
    d_hat = p1 - p2
    if delta0 == 0.0 and method == "pooled":
        # H0가 "두 비율이 같다"이면 그 공통값의 최선의 추정은 전체를 합친 비율이다.
        # 검정은 H0 아래의 분포를 쓰므로 여기서 합동하는 것이 옳다.
        p_pool = (k1 + k2) / (n1 + n2)
        se = math.sqrt(p_pool * (1 - p_pool) * (1 / n1 + 1 / n2))
        label = "pooled z-test"
    else:
        # delta0이 0이 아니면 "두 비율이 같다"는 가정이 없으므로 합동할 수 없다.
        # 신뢰구간에서 쓰는 것과 같은 표준오차다.
        se = math.sqrt(p1 * (1 - p1) / n1 + p2 * (1 - p2) / n2)
        label = "wald z-test"

    z = (d_hat - delta0) / se
    if alt == "two-sided":
        p = 2 * min(norm.cdf(z), 1 - norm.cdf(z))
    elif alt == "less":
        p = norm.cdf(z)
    else:
        p = 1 - norm.cdf(z)
    return z, p, (p < alpha), label
이제 (1)의 식을 검사한다.
import numpy as np


def se_pair(k1, n1, k2, n2):
    """합동 SE^2, Wald SE^2, 그리고 닫힌 꼴이 예측하는 차."""
    p1, p2 = k1 / n1, k2 / n2
    N = n1 + n2
    p_pool = (k1 + k2) / N
    se_p2 = p_pool * (1 - p_pool) * (1 / n1 + 1 / n2)
    se_w2 = p1 * (1 - p1) / n1 + p2 * (1 - p2) / n2
    pred = (p1 - p2) * ((n1 - n2) * (1 - p1 - p2)
                        + n1 * n2 * (p1 - p2) / N) / (n1 * n2)
    return se_p2, se_w2, pred


rng = np.random.default_rng(3)
worst = 0.0
for _ in range(200_000):
    a, b = int(rng.integers(2, 301)), int(rng.integers(2, 301))
    u, v = int(rng.integers(0, a + 1)), int(rng.integers(0, b + 1))
    if u + v in (0, a + b):
        continue                      # 합동 비율이 0 또는 1 이면 SE = 0
    sp2, sw2, pred = se_pair(u, a, v, b)
    worst = max(worst, abs(sp2 - sw2 - pred))
print(f"항등식 검사 20만 개: 절대오차의 최대값 = {worst:.3e}")

print("\nn1 = 80, n2 = 60 에서 같은 차이를 위로 옮기면 부호가 뒤집힌다")
print("  k1  k2   p1-p2   p1+p2    SE_p^2 - SE_w^2   큰 쪽")
for k1, k2 in ((30, 18), (44, 29), (48, 32), (50, 33), (52, 34)):
    sp2, sw2, pred = se_pair(k1, 80, k2, 60)
    print(f" {k1:3d} {k2:3d}  {k1/80 - k2/60:6.4f}  {k1/80 + k2/60:6.4f}"
          f"   {sp2 - sw2:+.3e}      {'합동' if sp2 > sw2 else 'Wald'}")
print(f"  부호가 바뀌는 경계: p1+p2 = "
      f"{1 + 80 * 60 / (140 * 20) * 0.075:.6f}  (p1-p2 = 0.075 고정)")
출력:
항등식 검사 20만 개: 절대오차의 최대값 = 6.245e-17

n1 = 80, n2 = 60 에서 같은 차이를 위로 옮기면 부호가 뒤집힌다
  k1  k2   p1-p2   p1+p2    SE_p^2 - SE_w^2   큰 쪽
  30  18  0.0750  0.6750   +1.417e-04      합동
  44  29  0.0667  1.0333   +2.249e-05      합동
  48  32  0.0667  1.1333   -5.291e-06      Wald
  50  33  0.0750  1.1750   -1.451e-05      Wald
  52  34  0.0833  1.2167   -2.563e-05      Wald
  부호가 바뀌는 경계: p1+p2 = 1.128571  (p1-p2 = 0.075 고정)
항등식이 성립한다. 표본크기를 2에서 300까지, 성공 수를 0에서 \(n\)까지 무작위로 뽑은 20만 개에서 절대오차의 최대값이 \(6 \times 10^{-17}\)로 부동소수점 한계다.
부호도 예측대로 뒤집힌다. \(p_1 - p_2 = 0.075\)를 유지한 채 두 비율을 함께 올리면 \((30, 18)\)에서 합동이 크고 \((50, 33)\)에서 Wald가 크다. 경계 \(p_1 + p_2 = 1.128571\)을 사이에 두고 \((44,29)\)의 \(1.0333\)은 아래, \((48,32)\)의 \(1.1333\)은 위다. 같은 차이, 같은 표본크기인데 비율의 수준만 달라져 두 표준오차의 순서가 바뀐다. 그러므로 "검정은 합동이라 더 보수적이다" 같은 어림짐작은 균형 설계에서만 옳다.
보기 2. 이표본 비율 검정. 집단 1에서 \(n_1 = 80\) 중 \(k_1 = 30\), 집단 2에서 \(n_2 = 60\) 중 \(k_2 = 18\)이 성공했다(\(\hat p_1 = 0.375\), \(\hat p_2 = 0.300\)).
(1) 합동과 Wald 두 가지로 \(z\)를 구하고, 어느 쪽 \(\lvert z \rvert\)가 큰지를 보기 1의 식으로 설명하시오. 합동 \(z\)의 제곱이 이 표의 피어슨 카이제곱통계량과 같은지 확인하시오.
(2) 이 표본크기에서 합동 \(z\) 검정의 정확한 제1종 오류율을 구하시오. 명목 5%를 얼마나 지키는가, 그리고 어디서 무너지는가.
풀이
(1) 해석적으로. \(\hat p_1 + \hat p_2 = 0.675 < 1\)이고 \(n_1 > n_2\), \(\hat p_1 > \hat p_2\)이므로 보기 1의 괄호 안 두 항이 모두 양수다.
이고 괄호는 \(9.0714\)다. 따라서
으로 합동 표준오차가 더 크다. 분자가 같으므로 \(\lvert z_{\text{pool}} \rvert < \lvert z_{\text{wald}} \rvert\), 곧 합동 쪽이 더 보수적이다. 실제로
이고 Wald 쪽은 \(\text{SE} = 0.080185\), \(z = 0.935333\)이다. 두 값이 가까운 것은 \(0.375\)와 \(0.300\)이 멀지 않아 합동비율 \(0.342857\)이 양쪽을 그런대로 대신하기 때문이다.
\(z_{\text{pool}}^2 = \chi^2\)은 본문에서 본 항등식이다. \(0.925191^2 = 0.855978\)이 \(2\times2\) 표의 피어슨 카이제곱(연속성 보정 없이)과 같아야 한다.
(2) 정확한 수준. \(p_1 = p_2 = p\)일 때 \((k_1, k_2)\)는 독립인 두 이항변수이므로, \((n_1+1)(n_2+1) = 81 \times 61 = 4941\)칸을 모두 훑어 기각되는 칸의 확률을 더하면 실제 오류율이 정확히 나온다. 근사도 모의실험도 필요 없다.
\(k_1 + k_2 = 0\) 또는 \(N\)인 두 칸은 합동 비율이 \(0\) 또는 \(1\)이어서 표준오차가 0이 되는데, 그때는 \(\hat p_1 - \hat p_2 = 0\)이므로 기각하지 않는 것으로 둔다.
수치적으로.
z, p, reject, label = test_diff_two_props(
    k1=30, n1=80, k2=18, n2=60, delta0=0.0, method="pooled"
)
print(label, "z:", z, "p:", p, "reject:", reject)

# 같은 자료를 합동하지 않은 Wald 표준오차로 계산하면 어떻게 다른가?
z2, p2, reject2, label2 = test_diff_two_props(
    k1=30, n1=80, k2=18, n2=60, delta0=0.0, method="wald"
)
print(label2, "z:", z2, "p:", p2, "reject:", reject2)
출력:
pooled z-test z: 0.9251909321159419 p: 0.3548665994806586 reject: False
wald z-test z: 0.9353331581027243 p: 0.3496166322568355 reject: False
import numpy as np
from scipy import stats

k1, n1, k2, n2 = 30, 80, 18, 60
p1, p2 = k1 / n1, k2 / n2
N = n1 + n2
p_pool = (k1 + k2) / N
se_p2 = p_pool * (1 - p_pool) * (1 / n1 + 1 / n2)
se_w2 = p1 * (1 - p1) / n1 + p2 * (1 - p2) / n2
pred = (p1 - p2) * ((n1 - n2) * (1 - p1 - p2)
                    + n1 * n2 * (p1 - p2) / N) / (n1 * n2)
print(f"p1 = {p1}, p2 = {p2}, p_pool = {p_pool:.9f}")
print(f"SE_pool = {math.sqrt(se_p2):.9f}   SE_wald = {math.sqrt(se_w2):.9f}")
print(f"SE_p^2 - SE_w^2 = {se_p2 - se_w2:.3e}   닫힌 꼴 = {pred:.3e}")
z_pool = (p1 - p2) / math.sqrt(se_p2)
chi = stats.chi2_contingency([[k1, n1 - k1], [k2, n2 - k2]],
                             correction=False).statistic
print(f"z_pool^2 = {z_pool**2:.12f}   피어슨 카이제곱 = {chi:.12f}")


def exact_level(n1, n2, p, alpha=0.05):
    """p1 = p2 = p 일 때 합동 z 검정의 **정확한** 제1종 오류율.

    (k1, k2) 의 (n1+1)(n2+1) 칸을 모두 훑어 기각 칸의 이항확률을 더한다.
    근사도 모의실험도 아니다.
    """
    zc = stats.norm.ppf(1 - alpha / 2)
    K1, K2 = np.arange(n1 + 1), np.arange(n2 + 1)
    pr = stats.binom.pmf(K1, n1, p)[:, None] * stats.binom.pmf(K2, n2, p)[None, :]
    P1, P2 = K1[:, None] / n1, K2[None, :] / n2
    PP = (K1[:, None] + K2[None, :]) / (n1 + n2)
    with np.errstate(divide="ignore", invalid="ignore"):
        z = (P1 - P2) / np.sqrt(PP * (1 - PP) * (1 / n1 + 1 / n2))
    rej = np.abs(z) > zc
    rej[~np.isfinite(z)] = False        # k1+k2 가 0 또는 n1+n2 인 두 칸
    return float((pr * rej).sum())


print(f"\n정확한 수준 (n1 = {n1}, n2 = {n2}, 명목 0.05)")
print("     p    실제 수준     n2*min(p,1-p)")
for p in (0.01, 0.02, 0.03, 0.05, 0.0833, 0.1, 0.2, 0.343, 0.5):
    print(f"  {p:.4f}   {exact_level(n1, n2, p):.6f}      {n2 * min(p, 1 - p):6.2f}")

ps = np.linspace(0.002, 0.998, 499)
lv = np.array([exact_level(n1, n2, p) for p in ps])
i = int(lv.argmax())
mid = (ps >= 0.03) & (ps <= 0.97)
print(f"\n격자 499 점의 최대 = {lv[i]:.6f} (p = {ps[i]:.3f})")
print(f"0.03 <= p <= 0.97 구간의 범위 = [{lv[mid].min():.6f}, {lv[mid].max():.6f}]")
print(f"0.05 를 넘는 점의 비율 = {float((lv > 0.05).mean()):.3f}")
출력:
p1 = 0.375, p2 = 0.3, p_pool = 0.342857143
SE_pool = 0.081064348   SE_wald = 0.080185332
SE_p^2 - SE_w^2 = 1.417e-04   닫힌 꼴 = 1.417e-04
z_pool^2 = 0.855978260870   피어슨 카이제곱 = 0.855978260870

정확한 수준 (n1 = 80, n2 = 60, 명목 0.05)
     p    실제 수준     n2*min(p,1-p)
  0.0100   0.010866        0.60
  0.0200   0.032648        1.20
  0.0300   0.047253        1.80
  0.0500   0.053474        3.00
  0.0833   0.050844        5.00
  0.1000   0.049784        6.00
  0.2000   0.047094       12.00
  0.3430   0.049443       20.58
  0.5000   0.049180       30.00

격자 499 점의 최대 = 0.053604 (p = 0.046)
0.03 <= p <= 0.97 구간의 범위 = [0.045280, 0.053604]
0.05 를 넘는 점의 비율 = 0.365
(1)이 맞는다. 두 표준오차가 \(0.081064\)와 \(0.080185\), 제곱의 차가 닫힌 꼴이 준 \(1.417\times10^{-4}\)와 같다. 두 \(z\)는 \(0.925191\)과 \(0.935333\)이고 양쪽 모두 \(p \approx 0.35\)로 기각하지 못한다. \(\hat p_1 - \hat p_2 = 7.5\)%p는 작지 않은 차이인데 80명과 60명으로는 가려낼 수 없다. \(z_{\text{pool}}^2 = 0.855978260870\)이 피어슨 카이제곱과 소수 열두째 자리까지 같아 항등식도 확인된다.
(2) 명목 5%는 생각보다 잘 지켜진다. \(0.03 \le p \le 0.97\)에서 실제 수준이 \([0.0453,\ 0.0536]\) 안에 있다. 참값 \(0.05\)를 넘는 경우가 격자의 37%이고 최대가 \(p = 0.046\)에서 \(0.0536\)이다. \(\pm 0.005\) 안쪽의 진동이며, 그 진동의 원인은 근사의 치우침이 아니라 \((k_1, k_2)\)가 이산이라는 사실이다. 기각역의 경계가 격자점 사이를 지나므로 \(p\)가 조금 움직일 때마다 어떤 칸이 들어오고 나간다.
무너지는 곳은 꼬리다. \(p = 0.02\)에서 \(0.0326\), \(p = 0.01\)에서 \(0.0109\)로 명목의 다섯 분의 일까지 내려간다. 이때 작은 집단의 기대 성공 수가 \(n_2 p = 1.2\)와 \(0.6\)으로, 흔히 쓰는 조건 \(n\hat p \ge 5\)를 크게 밑돈다. 그 조건의 경계 \(p = 5/60 = 0.0833\)에서는 실제 수준이 이미 \(0.0508\)로 제자리를 찾았다. 경험칙이 어디서 와서 어디까지 필요한지가 이 표에 그대로 나타나 있다.
보수적인 쪽으로 어긋난다는 점도 읽어 두어야 한다. 꼬리에서 실제 수준이 명목보다 낮으므로 거짓 양성은 걱정할 필요가 없지만, 그만큼 검정력도 함께 잃는다. 비율이 매우 작은 사건을 비교할 때 정규근사 대신 피셔의 정확검정이나 조건부 정확검정을 권하는 까닭이다.
해석
\(\hat{p}_1 = 30/80 = 0.375\), \(\hat{p}_2 = 18/60 = 0.300\)으로 \(H_0\colon p_1 = p_2\)를 검정한다. 합동 비율은 \(\hat{p}_{\text{pool}} = 48/140 \approx 0.343\)이다. 검정통계량은
양측 p-값이 약 0.35이므로 \(H_0\)을 기각하지 못한다.
연습문제
연습문제 1. 어떤 임상시험에서 약을 받은 환자 200명 중 45명이, 위약을 받은 200명 중 30명이 회복했다. \(\alpha = 0.05\)에서 \(H_0\colon p_1 = p_2\) 대 \(H_1\colon p_1 > p_2\)를 검정하라.
풀이
\(\hat{p}_1 = 0.225\), \(\hat{p}_2 = 0.150\), \(\hat{p}_{\text{pool}} = 75/400 = 0.1875\).
단측 p-값은 \(P(Z \geq 1.921) \approx 0.0274\)이다. \(0.0274 < 0.05\)이므로 \(H_0\)을 기각한다. 이 약의 회복률이 유의하게 높다. \(\square\)
연습문제 2. 합동 표준오차와 Wald 표준오차를 각각 언제 쓰는지 설명하라.
풀이
합동 표준오차는 \(H_0\)이 \(p_1 = p_2\)를 지정할 때(즉 \(\delta_0 = 0\)일 때) 쓴다. 이 귀무가설 아래에서 공통 비율의 최선의 추정값은 합동 비율 \(\hat{p}_{\text{pool}}\)이며, 이를 표준오차에 쓰면 더 정확한 검정이 된다.
Wald 표준오차는 \(\delta_0 \neq 0\)일 때(차이가 0이 아닌 어떤 값인지 검정할 때) 쓴다. 이 경우 추정할 공통 비율이 없으므로 각 집단의 비율을 따로 쓴다. 귀무가설의 값과 무관하게 \(p_1 - p_2\)의 신뢰구간을 만들 때에도 Wald 표준오차를 쓴다. \(\square\)
연습문제 3. 어떤 웹사이트 A/B 검정에서 변형 A는 방문자 5000명 중 120명이, 변형 B는 5000명 중 95명이 전환했다. \(\alpha = 0.05\)에서 차이를 검정하고 \(p_A - p_B\)의 95% 신뢰구간을 계산하라.
풀이
\(\hat{p}_A = 0.024\), \(\hat{p}_B = 0.019\), \(\hat{p}_{\text{pool}} = 215/10000 = 0.0215\).
검정:
양측 p-값: \(2 \times P(Z \geq 1.725) \approx 0.0845\). \(\alpha = 0.05\)에서 기각하지 못한다.
95% 신뢰구간 (Wald 표준오차 사용):
신뢰구간이 0을 포함하여 검정 결과와 일관된다. \(\square\)
연습문제 4. \(H_0\colon p_1 = p_2\)에 대한 가능도비 검정에서 합동 z-검정통계량을 유도하라.
풀이
\(H_0\colon p_1 = p_2 = p\) 아래에서 MLE는 \(\hat{p} = (k_1+k_2)/(n_1+n_2)\)이다. 제약 없는 모형에서 MLE는 \(\hat{p}_1 = k_1/n_1\)과 \(\hat{p}_2 = k_2/n_2\)이다. 로그가능도비는
점근이론에 의해 \(H_0\) 아래에서 \(\Lambda \xrightarrow{d} \chi^2_1\)이다. (1차까지 동등한) Rao 점수검정은 다음 검정통계량을 준다:
그리고 \(Z^2 \approx \Lambda\)이다. 이것이 바로 합동 z-통계량이며, 합동 검정이 점수검정/가능도비 검정의 틀에서 자연스럽게 나옴을 확인해 준다. \(\square\)
연습문제 5. 합동 \(z\) 검정이 \(n_1\hat{p}_{\text{pool}} \geq 10\)이고 \(n_1(1-\hat{p}_{\text{pool}}) \geq 10\)(\(n_2\)에 대해서도 마찬가지)을 요구하는 까닭을 설명하라. 이 조건이 깨지면 어떤 대안을 쓸 수 있는가?
풀이
z-검정은 중심극한정리 근사 \(\hat{p}_i \approx N(p_i, p_i(1-p_i)/n_i)\)에 기댄다. \(p\)가 0이나 1에 가깝거나(이항분포가 심하게 치우친다) \(n\)이 작으면 이 근사가 나쁘다. 문턱값을 \(5\)로 잡은 느슨한 기준은 이항분포가 정규근사를 쓸 만큼 충분히 대칭이 되도록, 곧 분포의 모양만 보장한다. 그런데 검정에서 지켜야 할 것은 모양이 아니라 제1종 오류율이다. 그래서 보수적 기준 \(\ge 10\)까지 올려 잡는다. 두 집단의 근사 오차가 더해진다는 점도 문턱을 높일 이유가 된다. 합동 검정에서는 \(\hat{p}_{\text{pool}}\)로 확인한다.
이 조건이 깨지면 다음 대안이 있다:
- Fisher의 정확검정: \(H_0\) 아래 초기하분포로 정확한 p-값을 계산한다. 점근근사가 필요 없다.
- Barnard의 정확검정: 조건을 두지 않는 정확검정으로 Fisher 검정보다 검정력이 클 수 있다.
- 베이즈 방법: 베타-이항 모형과 사후추론을 쓴다. \(\square\)
연습문제 6. 연습문제 3에서 쓴 Wald 신뢰구간 대신 뉴컴의 방법(윌슨 구간에 기반)을 적용하라. 두 방법의 포함률을 비교하라.
풀이
Wald 구간의 약점. \(\hat p\)가 0이나 1에 가까우면 표준오차 \(\sqrt{\hat p(1-\hat p)/n}\)이 0으로 붕괴한다. 극단적으로 \(\hat p=0\)이면 폭이 0인 구간이 나온다.
뉴컴의 방법. 각 집단에 윌슨 구간 \((l_j,u_j)\)를 구하고, 차이의 구간을
로 잡는다. 각 끝점에서 가장 불리한 쪽의 분산을 쓴다는 발상이다.
import numpy as np
from scipy import stats

Z = stats.norm.ppf(0.975)

def wilson(k, n, z=Z):
    p = k / n
    d = 1 + z * z / n
    centre = (p + z * z / (2 * n)) / d
    half = z * np.sqrt(p * (1 - p) / n + z * z / (4 * n * n)) / d
    return centre - half, centre + half

def wald(k1, n1, k2, n2, z=Z):
    p1, p2 = k1 / n1, k2 / n2
    se = np.sqrt(p1 * (1 - p1) / n1 + p2 * (1 - p2) / n2)
    return p1 - p2 - z * se, p1 - p2 + z * se

def newcombe(k1, n1, k2, n2, z=Z):
    l1, u1 = wilson(k1, n1, z)
    l2, u2 = wilson(k2, n2, z)
    p1, p2 = k1 / n1, k2 / n2
    lo = p1 - p2 - z * np.sqrt(l1 * (1 - l1) / n1 + u2 * (1 - u2) / n2)
    hi = p1 - p2 + z * np.sqrt(u1 * (1 - u1) / n1 + l2 * (1 - l2) / n2)
    return lo, hi

for label, args in [("연습문제 1 (45/200 대 30/200)", (45, 200, 30, 200)),
                    ("연습문제 3 (120/5000 대 95/5000)", (120, 5000, 95, 5000))]:
    lo_w, hi_w = wald(*args)
    lo_n, hi_n = newcombe(*args)
    print(f"{label}")
    print(f"  Wald     ({lo_w:8.5f}, {hi_w:8.5f})")
    print(f"  뉴컴     ({lo_n:8.5f}, {hi_n:8.5f})")
연습문제 1 (45/200 대 30/200)
  Wald     (-0.00115,  0.15115)
  뉴컴     (-0.00172,  0.15099)
연습문제 3 (120/5000 대 95/5000)
  Wald     (-0.00068,  0.01068)
  뉴컴     (-0.00070,  0.01076)
표본이 크면 둘이 거의 같다. 연습문제 3에서는 소수점 넷째 자리에서만 다르다.
차이는 작은 표본과 극단적 비율에서 드러난다.
rng = np.random.default_rng(313)
print(f"{'p1':>5s} {'p2':>5s} {'n':>5s} {'Wald':>8s} {'뉴컴':>8s}")
for p1, p2, n in [(0.50, 0.50, 20), (0.10, 0.10, 20), (0.02, 0.02, 50),
                  (0.30, 0.10, 30), (0.05, 0.02, 100)]:
    M = 20_000
    k1, k2 = rng.binomial(n, p1, M), rng.binomial(n, p2, M)
    a = b = 0
    for i in range(M):
        lo, hi = wald(k1[i], n, k2[i], n)
        a += lo <= p1 - p2 <= hi
        lo, hi = newcombe(k1[i], n, k2[i], n)
        b += lo <= p1 - p2 <= hi
    print(f"{p1:5.2f} {p2:5.2f} {n:5d} {a / M:8.4f} {b / M:8.4f}")
   p1    p2     n     Wald       뉴컴
 0.50  0.50    20   0.9210   0.9593
 0.10  0.10    20   0.9591   0.9820
 0.02  0.02    50   0.9850   0.9976
 0.30  0.10    30   0.9352   0.9534
 0.05  0.02   100   0.9345   0.9679
Wald가 목표 0.95에 미달한다. \(p_1=p_2=0.5\), \(n=20\)에서 0.921이고, \(p_1=0.05\)·\(p_2=0.02\)·\(n=100\)에서도 0.935다. 표본이 꽤 커도 미달한다는 점이 중요하다.
뉴컴은 언제나 0.95 이상이다(0.953~0.998). 대신 보수적이다 — 드문 사건(\(p=0.02\))에서 0.998까지 올라간다.
어느 쪽이 나은가. 신뢰구간에서는 과소 포함이 과대 포함보다 훨씬 나쁘다. 과소 포함은 "실제보다 확신한다"는 뜻이라 잘못된 결론으로 이어진다. 과대 포함은 단지 보수적일 뿐이다.
권고.
| 상황 | 구간 |
|---|---|
| 양쪽 \(n\hat p\), \(n(1-\hat p)\)가 모두 넉넉함(>15) | Wald로 충분 |
| 비율이 0이나 1에 가까움 | 뉴컴 |
| \(n\)이 작음 | 뉴컴 |
| 셀이 0 | 뉴컴(Wald는 붕괴) |
기본값을 뉴컴으로 삼아도 손해가 거의 없다.
연습문제 7. 연습문제 5가 말한 "정규근사 조건이 깨질 때"를 정량화하라. 소표본에서 합동 \(z\), 피셔 정확검정, 연속성 보정 카이제곱의 제1종 오류율을 비교하라.
풀이
import numpy as np
from scipy import stats

rng = np.random.default_rng(77)
print(f"{'군당 n':>7s} {'p':>5s} {'합동 z':>8s} {'Fisher':>8s} {'χ²(보정)':>10s}")
for n, p in [(10, 0.30), (20, 0.30), (20, 0.10), (50, 0.05), (100, 0.02)]:
    M = 10_000
    k1, k2 = rng.binomial(n, p, M), rng.binomial(n, p, M)
    a = b = c = 0
    for i in range(M):
        x, y = k1[i], k2[i]
        pp = (x + y) / (2 * n)
        if 0 < pp < 1:                       # 둘 다 0이거나 둘 다 n이면 정의 불가
            se = np.sqrt(pp * (1 - pp) * 2 / n)
            a += 2 * stats.norm.sf(abs((x / n - y / n) / se)) < 0.05
        b += stats.fisher_exact([[x, n - x], [y, n - y]]).pvalue < 0.05
        tbl = np.array([[x, n - x], [y, n - y]])
        if tbl.sum(0).min() > 0 and tbl.sum(1).min() > 0:
            c += stats.chi2_contingency(tbl, correction=True)[1] < 0.05
    print(f"{n:7d} {p:5.2f} {a / M:8.4f} {b / M:8.4f} {c / M:10.4f}")
   군당 n     p     합동 z   Fisher     χ²(보정)
     10  0.30   0.0368   0.0119     0.0119
     20  0.30   0.0551   0.0262     0.0229
     20  0.10   0.0392   0.0098     0.0033
     50  0.05   0.0409   0.0064     0.0064
    100  0.02   0.0419   0.0049     0.0049
결과가 통념과 다르다.
1 — 합동 \(z\)가 생각만큼 나쁘지 않다. 최악이 \(n=20\)·\(p=0.3\)에서 0.0551로, 명목을 10% 넘는 수준이다. 나머지는 0.037~0.042로 오히려 보수적이다.
2 — 피셔 정확검정이 매우 보수적이다. \(n=50\)·\(p=0.05\)에서 0.0064로 명목의 1/8이다. "정확검정"이라는 이름과 달리, 실제 수준이 명목과 같지 않다.
3 — 연속성 보정 카이제곱은 더 보수적이다. \(n=20\)·\(p=0.1\)에서 0.0033이다.
왜 정확검정이 보수적인가. 이항분포가 이산이기 때문이다. 도달 가능한 \(p\)-값이 띄엄띄엄하므로, "\(p\le0.05\)"를 만족하는 결과들의 확률 합이 0.05에 정확히 맞을 수 없고 대개 그보다 한참 작다. 피셔 검정은 주변합까지 고정해 조건부 분포를 쓰므로 이 이산성이 더 심해진다.
보수적이라는 것은 곧 검정력 손실이다. 수준이 0.0064라는 것은 0.05를 쓸 수 있었을 기회를 버렸다는 뜻이다.
그래서 실무의 선택은 이렇다.
| 목적 | 검정 |
|---|---|
| 수준을 절대 넘지 않아야 함(규제 제출) | 피셔 정확검정 |
| 검정력이 중요함(탐색 연구) | 합동 \(z\) 또는 보정 없는 카이제곱 |
| 절충 | 바너드 검정(무조건부 정확검정) |
| 중간 \(p\)-값을 쓸 수 있음 | 피셔 + 중간 \(p\)-값 보정 |
바너드 검정은 주변합을 고정하지 않아 피셔보다 검정력이 높으면서 수준을 지킨다. 계산이 무겁지만 \(2\times2\) 표에서는 실용적이다.
연습문제 5의 조건(\(n\hat p\ge10\))을 다시 보면. \(n=20\)·\(p=0.1\)이면 \(n\hat p=2\)로 조건에 한참 미달인데, 정작 합동 \(z\)의 수준은 0.0392로 문제없다. 보수적 기준이 이 검정에는 지나치게 엄격한 셈이다. 합동 \(z\)는 \(H_0\) 아래의 합동비율로 표준오차를 만드는 점수 검정이어서, 표준오차에 각자의 \(\hat p_i\)를 넣는 왈드형 통계량보다 훨씬 강건하다. 그러니 문턱값은 검정의 종류마다 달리 읽어야 한다. 다만 같은 조건이 수준뿐 아니라 신뢰구간의 포함률까지 겨냥한 것이므로, 구간을 쓸 때는 \(10\)을 지키는 것이 여전히 유용한 지침이다.
연습문제 8. 두 비율의 차이를 차이·위험비·오즈비·NNT로 각각 표현하고, 언제 무엇을 쓸지 정리하라.
풀이
import numpy as np

def summarise(k1, n1, k2, n2, label):
    p1, p2 = k1 / n1, k2 / n2
    rd = p1 - p2
    rr = p1 / p2
    or_ = (p1 / (1 - p1)) / (p2 / (1 - p2))
    print(f"{label}")
    print(f"  p1={p1:.4f}  p2={p2:.4f}")
    print(f"  위험차 RD = {rd:+.4f}   위험비 RR = {rr:.3f}   "
          f"오즈비 OR = {or_:.3f}   NNT = {1 / abs(rd):.1f}")

summarise(45, 200, 30, 200, "① 임상시험 (연습문제 1)")
summarise(120, 5000, 95, 5000, "② A/B 검정 (연습문제 3)")
summarise(2, 1000, 1, 1000, "③ 드문 부작용")
summarise(900, 1000, 800, 1000, "④ 흔한 결과")
① 임상시험 (연습문제 1)
  p1=0.2250  p2=0.1500
  위험차 RD = +0.0750   위험비 RR = 1.500   오즈비 OR = 1.645   NNT = 13.3
② A/B 검정 (연습문제 3)
  p1=0.0240  p2=0.0190
  위험차 RD = +0.0050   위험비 RR = 1.263   오즈비 OR = 1.270   NNT = 200.0
③ 드문 부작용
  p1=0.0020  p2=0.0010
  위험차 RD = +0.0010   위험비 RR = 2.000   오즈비 OR = 2.002   NNT = 1000.0
④ 흔한 결과
  p1=0.9000  p2=0.8000
  위험차 RD = +0.1000   위험비 RR = 1.125   오즈비 OR = 2.250   NNT = 10.0
③과 ④를 나란히 보면 문제가 드러난다.
| RD | RR | OR | NNT | |
|---|---|---|---|---|
| ③ 드문 부작용 | 0.001 | 2.00 | 2.00 | 1000 |
| ④ 흔한 결과 | 0.100 | 1.13 | 2.25 | 10 |
- "위험이 2배"(③)는 극적으로 들리지만, 실제로는 1000명 중 1명이 더 겪는다.
- "오즈비 2.25"(④)도 크게 들리지만, 위험비로는 1.13에 불과하다.
각 지표의 성격.
| 지표 | 정의 | 언제 쓰나 | 함정 |
|---|---|---|---|
| 위험차 RD | \(p_1-p_2\) | 의사결정, 공중보건 영향 | 기저 위험에 따라 달라짐 |
| 위험비 RR | \(p_1/p_2\) | 원인의 강도, 코호트 연구 | 기저가 낮으면 과장돼 보임 |
| 오즈비 OR | \(\frac{p_1/(1-p_1)}{p_2/(1-p_2)}\) | 환자대조군, 로지스틱 회귀 | \(p\)가 크면 RR을 크게 과장 |
| NNT | \(1/\lvert RD\rvert\) | 임상적 소통 | RD가 0에 가까우면 발산 |
핵심 규칙 넷.
1 — 의사결정에는 위험차를 쓴다. "이 정책으로 몇 명이 달라지는가"에 답하는 것은 RD뿐이다. ③에서 1000명을 치료해야 1명이 더 산다면, 비용과 부작용을 따져야 한다.
2 — 오즈비를 위험비로 읽지 않는다. \(p\)가 작으면 \(OR\approx RR\)이지만(③: 2.002 대 2.000), \(p\)가 크면 크게 벌어진다(④: 2.25 대 1.13). "오즈가 2배"를 "위험이 2배"로 옮기는 것은 흔하고 심각한 오해다.
3 — 상대지표만 보고하지 않는다. "위험 2배 증가"라는 기사 제목은 기저 위험 없이는 무의미하다. 반드시 절대 수치와 함께 쓴다.
4 — NNT는 유의하지 않을 때 보고하지 않는다. RD의 구간이 0을 포함하면 NNT의 구간이 \((\text{유한},\infty)\cup(-\infty,\text{유한})\)처럼 끊어진다. 해석할 수 없다.
왜 오즈비가 그럼에도 널리 쓰이는가.
- 환자대조군 연구에서 추정 가능한 유일한 지표다. 표본추출이 결과에 따라 이뤄져 \(p_1,p_2\)를 추정할 수 없지만 OR은 불변이다.
- 로지스틱 회귀의 계수가 곧 \(\log OR\)이다.
- 대칭적이다. 결과의 정의를 뒤집으면 \(OR\to1/OR\)이지만 RR은 그렇지 않다.
연습문제 9. 두 비율을 비교하는 연구의 표본크기를 계산하라. 기저 비율이 낮을수록 왜 표본이 급격히 커지는가?
풀이
공식. 합동 \(z\) 검정의 검정력을 \(1-\beta\)로 맞추려면 군당
분자는 \(H_0\)·\(H_1\) 각각의 표준오차, 분모는 탐지하려는 차이의 제곱이다.
import numpy as np
from scipy import stats

def n_two_props(p1, p2, power=0.80, alpha=0.05):
    za, zb = stats.norm.ppf(1 - alpha / 2), stats.norm.ppf(power)
    pbar = (p1 + p2) / 2
    num = (za * np.sqrt(2 * pbar * (1 - pbar))
           + zb * np.sqrt(p1 * (1 - p1) + p2 * (1 - p2)))**2
    return int(np.ceil(num / (p1 - p2)**2))

def n_arcsine(p1, p2, power=0.80, alpha=0.05):
    """코헨의 h 를 쓰는 아크사인 변환 근사."""
    h = 2 * np.arcsin(np.sqrt(p1)) - 2 * np.arcsin(np.sqrt(p2))
    za, zb = stats.norm.ppf(1 - alpha / 2), stats.norm.ppf(power)
    return int(np.ceil(2 * ((za + zb) / h)**2))

print(f"{'p1':>6s} {'p2':>6s} {'차이':>7s} {'위험비':>7s} "
      f"{'군당 n':>8s} {'arcsin':>8s}")
for p1, p2 in [(0.50, 0.40), (0.55, 0.45), (0.30, 0.20),
               (0.10, 0.05), (0.05, 0.025), (0.02, 0.01)]:
    print(f"{p1:6.3f} {p2:6.3f} {p1 - p2:7.3f} {p1 / p2:7.2f} "
          f"{n_two_props(p1, p2):8d} {n_arcsine(p1, p2):8d}")
    p1     p2      차이     위험비     군당 n   arcsin
 0.500  0.400   0.100    1.25      388      388
 0.550  0.450   0.100    1.22      392      392
 0.300  0.200   0.100    1.50      294      292
 0.100  0.050   0.050    2.00      435      424
 0.050  0.025   0.025    2.00      906      882
 0.020  0.010   0.010    2.00     2319     2254
두 근사가 거의 같다(최대 3% 차이). 어느 쪽을 써도 무방하다.
위험비를 2로 고정해도 표본이 폭증한다.
| \(p_1:p_2\) | 위험비 | 군당 \(n\) |
|---|---|---|
| 0.10 : 0.05 | 2.0 | 435 |
| 0.05 : 0.025 | 2.0 | 906 |
| 0.02 : 0.01 | 2.0 | 2,319 |
기저 비율을 절반으로 낮출 때마다 표본이 약 두 배가 된다.
왜 그런가. 분모의 \((p_1-p_2)^2\)이 비율의 제곱으로 줄어드는데, 분자의 \(p(1-p)\)는 비율에 비례해서만 줄기 때문이다. \(p\)가 작을 때 \(p_1=2p\), \(p_2=p\)로 두면
\(n\)이 \(1/p\)로 커진다. 기저 비율이 1/10이 되면 표본은 10배가 된다.
한편 \(p\)가 0.5 근처면 표본이 가장 많이 필요하다 — 같은 차이 0.10에 대해 \(0.50/0.40\)이 388명, \(0.30/0.20\)이 294명이다. \(p(1-p)\)가 0.5에서 최대이기 때문이다. 차이를 고정하면 0.5 근처가 최악, 비율을 고정하면 작은 \(p\)가 최악이다.
실무적 함의.
- 드문 결과를 연구하려면 대규모 자료가 필요하다. 백신 부작용, 희귀 부작용 연구가 수만~수십만 명 규모인 이유다.
- 결과를 더 흔하게 재정의하는 것이 한 방법이다. "사망"보다 "사망 또는 재입원"처럼 복합결과를 쓴다. 다만 해석이 흐려지는 대가가 있다.
- 연속형 대리결과를 쓰면 표본이 크게 줄지만, 대리결과가 진짜 결과를 대표하는지 확인해야 한다.
- 비율이 아니라 발생률(사람·시간)로 분석하면 추적기간을 늘려 표본을 줄일 수 있다.
연습문제 10. A/B 검정에서 결과를 중간에 계속 확인하면서 유의해지는 즉시 중단하면 어떻게 되는지 모의실험으로 보여라. 올바른 절차는?
풀이
import numpy as np
from scipy import stats

rng = np.random.default_rng(505)

def peek_experiment(peeks, N=5_000, p=0.05, M=5_000):
    """두 변형의 전환율이 실제로 같은데, peeks 번 중간 확인한다."""
    points = [int(N * (i + 1) / peeks) for i in range(peeks)]
    hit = 0
    for _ in range(M):
        a, b = rng.random(N) < p, rng.random(N) < p
        for t in points:
            k1, k2 = a[:t].sum(), b[:t].sum()
            pp = (k1 + k2) / (2 * t)
            if pp <= 0 or pp >= 1:
                continue
            se = np.sqrt(pp * (1 - pp) * 2 / t)
            if 2 * stats.norm.sf(abs((k1 / t - k2 / t) / se)) < 0.05:
                hit += 1
                break                     # 유의해지자마자 중단
    return hit / M

for k in [1, 2, 5, 10, 20]:
    print(f"중간 확인 {k:2d}회 → 제1종 오류율 {peek_experiment(k):.4f}")
중간 확인  1회 → 제1종 오류율 0.0516
중간 확인  2회 → 제1종 오류율 0.0830
중간 확인  5회 → 제1종 오류율 0.1418
중간 확인 10회 → 제1종 오류율 0.1924
중간 확인 20회 → 제1종 오류율 0.2382
20번 엿보면 두 변형이 똑같은데도 24%의 확률로 "승자"가 나온다. 명목의 5배다.
왜 그런가. 표본이 쌓이면서 \(z\) 통계량은 확률보행처럼 움직인다. 그 경로가 임계선 \(\pm1.96\)을 한 번이라도 넘을 확률은 마지막 시점에 넘을 확률보다 훨씬 크다. 무한히 자주 보면 확률이 1로 간다.
더 나쁜 것은 편향이다. 중단 시점에 관측된 효과는 과장돼 있다. 우연히 큰 값이 나왔을 때 멈췄기 때문이다(승자의 저주).
올바른 절차 다섯.
1 — 표본크기를 사전에 정하고 끝까지 간다. 가장 단순하고 확실하다. 연습문제 9의 계산을 쓴다.
2 — 군순차 설계를 쓴다. 중간분석을 미리 계획하고, 각 시점의 임계값을 조정한다.
| 방법 | 성격 |
|---|---|
| 포칵 | 모든 시점에 같은(엄격한) 임계값 |
| 오브라이언·플레밍 | 초기는 아주 엄격, 마지막은 거의 명목 수준 |
| 램·드미츠 소비함수 | 중간분석 횟수를 미리 못 정해도 됨 |
3 — 언제나 유효한 추론(always-valid inference)을 쓴다. 혼합 순차확률비 검정이나 베팅 기반 \(e\)-값을 쓰면, 몇 번을 보든 수준이 지켜진다. 대신 같은 검정력에 표본이 더 필요하다.
4 — 베이즈 접근. 사후확률은 정지규칙에 의존하지 않는다는 성질이 있지만, 의사결정 규칙("사후확률 95% 넘으면 중단")의 빈도특성은 여전히 따져야 한다. 자동으로 해결되지 않는다.
5 — 모니터링과 결정을 분리한다. 시스템 장애나 명백한 해악을 감시하는 것은 필요하다. 다만 그것이 효과 판정의 근거가 되어서는 안 된다.
얼마나 손해인가. 오브라이언·플레밍 경계로 5회 중간분석을 하면, 고정표본 대비 필요한 표본이 약 2~3% 늘어난다. 거의 공짜로 조기 중단의 기회를 얻는 셈이다. 반면 아무 보정 없이 엿보는 것은 수준을 5배로 만든다.
실무 체크리스트.
- [ ] 표본크기를 사전에 계산했는가
- [ ] 중간분석 계획(횟수·시점·경계)을 사전에 정했는가
- [ ] 주 결과지표를 하나로 정했는가
- [ ] 하위집단 분석은 탐색적이라고 명시했는가
- [ ] 실험 기간이 주기(요일·계절)를 온전히 포함하는가
- [ ] 중단 시점의 효과크기가 과장될 수 있음을 보고에 적었는가
정리하며
비율 차 검정에서 \(\delta_0\) 이 \(0\) 인지가 표준오차를 정한다.
- \(\delta_0=0\) 이면 합동 표준오차를 쓴다. \(H_0\) 아래에서 두 비율이 같으므로 공통 \(p\) 를 합쳐 추정하는 것이 옳다.
- \(\delta_0\ne0\) 이면 합동할 수 없다. 두 비율이 다르다고 가정한 상태이므로 각자의 \(\hat p_i\) 로 표준오차를 만든다. 비열등성 검정이 그런 경우다.
statsmodels.stats.proportion.proportions_ztest가 합동 버전을 제공하며, 손으로 구현할 때 이와 대조해 검산한다.- 표본이 작으면 피셔의 정확검정으로 간다. 기대도수가 작을 때 정규근사가 무너지며, 10장에서 다룬다.
- A/B 검정 실무에서는 조기 중단이 더 큰 위험이다. 유의해질 때까지 들여다보면 제1종 오류율이 명목값을 훨씬 넘어서며, 이 장 뒤의 \(p\)-해킹 절이 그 문제를 다룬다.
다음 절 이표본 \(t\) 검정 (대마 가격) 에서 실제 자료로 전체 흐름을 밟는다.