9장: 가설검정
개요
들어가는 이야기 — 같은 증거를 두 번 재어 답이 갈렸다
\(1995\) 년 \(10\) 월 \(3\) 일, 배심원단은 O. J. 심슨에게 무죄를 평결했다. 한 해 반 뒤인 \(1997\) 년 \(2\) 월 \(4\) 일, 같은 죽음을 두고 열린 민사재판의 배심원단은 그에게 책임이 있다고 평결하고 \(33.5\) 백만 달러의 배상을 명했다.
두 법정이 본 것은 대체로 같은 증거였다. 그런데 답이 갈렸다. 둘이 요구한 것이 달랐기 때문이다. 형사재판은 「합리적 의심을 넘어」를 요구하고, 민사재판은 「증거의 우위」만 요구한다. 앞의 기준은 멀리 있고 뒤의 기준은 기울어지는 쪽에 있다.
그래도 두 재판이 함께 지킨 것이 있다. 어느 쪽에서도 피고가 자기 결백을 증명할 의무를 지지 않는다. 한쪽을 기본값으로 놓고, 그것을 뒤집을 책임을 주장하는 쪽에만 지운다. 다른 것은 「얼마나 뒤집어야 하는가」였을 뿐이다.
가설검정이 그 구조다. 귀무가설(null hypothesis)이 기본값이고, 대립가설(alternative hypothesis)이 주장이고, 자료가 증거다. 그리고 그 기준 — 이 장에서는 유의수준(significance level) \(\alpha\) 가 정한다 — 은 고르는 것이지 자료가 정해 주는 것이 아니다. 어디에 두느냐가 무엇을 바꾸는지는 수로 볼 수 있다.
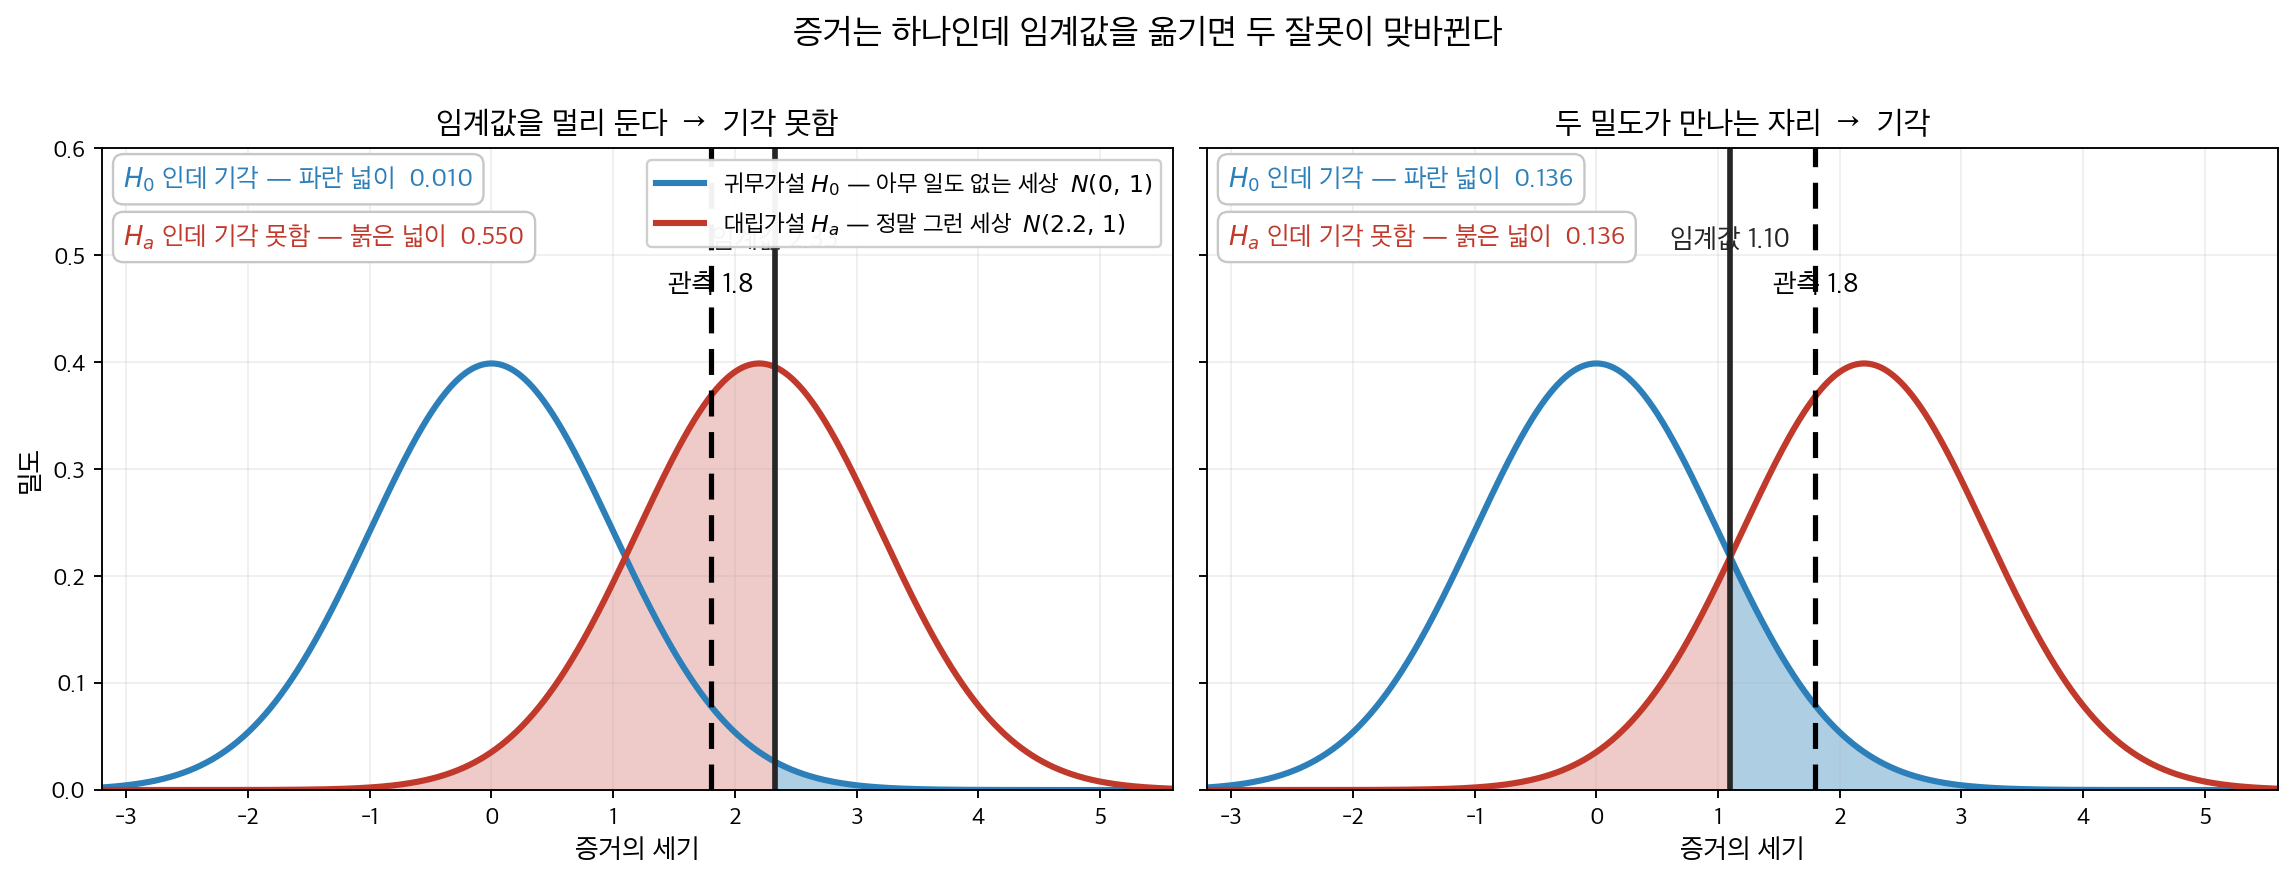
파란 곡선이 귀무가설 \(H_0\) — 아무 일도 없는 세상 \(N(0,\,1)\) 이고, 붉은 곡선이 대립가설 \(H_a\) — 정말 그런 세상 \(N(2.2,\,1)\) 이다. 증거의 세기는 양쪽 칸 모두 \(1.8\) 로 같고, 다른 것은 임계값의 자리뿐이다. 왼쪽은 임계값을 멀리 둔 경우다 — \(H_0\) 인데 기각할 확률(파란 넓이)이 \(0.010\) 으로 내려가는 대신 \(H_a\) 인데 기각하지 못할 확률(붉은 넓이)이 \(0.550\) 으로 올라가고, 관측값이 임계값에 못 미쳐 기각하지 못한다. 오른쪽은 두 밀도가 만나는 자리에 임계값을 둔 경우다 — 두 확률이 \(0.136\) 으로 같아지고 같은 관측값이 기각된다. 임계값은 잘못을 없애는 것이 아니라 둘 가운데 어느 쪽을 더 두려워할지 고르는 것이다. 두 세상을 \(N(0,\,1)\) 과 \(N(2.2,\,1)\) 로 두고 이 책이 계산했다.
그러니 이 장이 짜야 할 것이 셋이다. 무엇을 기본값으로 둘 것인가, 증거를 무엇으로 잴 것인가, 그리고 기각의 기준을 어디에 둘 것인가. 마지막 것은 자료가 답해 주지 않으므로 사람이 미리 정해 두어야 하고, 그래서 이 장은 「자료를 보기 전에 규칙을 적는다」를 거듭 말하게 된다.
확인한 곳 — 형사재판의 무죄 평결이 \(1995\) 년 \(10\) 월 \(3\) 일이고 기준이 「합리적 의심을 넘어」라는 것, 민사재판이 \(1997\) 년 \(2\) 월 \(4\) 일에 「증거의 우위」 기준으로 책임을 인정했다는 것은 Wikipedia 「Murder trial of O. J. Simpson」 · 배상액이 보상적 \(8.5\) 백만과 징벌적 \(25\) 백만을 합한 \(33.5\) 백만 달러라는 것과 징벌적 배상이 \(2\) 월 \(10\) 일에 정해졌다는 것은 CNN \(1997\) 년 \(2\) 월 \(10\) 일 보도. 그가 파산을 신청한 적은 없다 — 연금이 민사판결의 징수 대상이 아니어서 배상액 대부분이 끝내 걷히지 않았다. 그림의 두 분포와 네 확률은 모두 이 책이 계산한 값이다
가설검정은 표본자료에 근거하여 모수에 관한 결정을 내리는 형식적인 틀을 제공한다. 이 장은 가설검정의 전 과정을 다룬다: 귀무가설과 대립가설의 설정, 검정통계량과 p 값의 계산, 평균·비율·분산에 대한 일표본·이표본·대응표본(paired samples) 검정의 수행, 오류와 검정력의 분석, 그리고 많은 가설을 동시에 검정할 때의 다중검정 보정.
1. 장의 구성
9.1 기초
모든 가설검정의 바탕이 되는 개념적·수학적 틀:
- 귀무가설과 대립가설 -- 「기각하지 못했다」가 「참이다」가 아닌 까닭을 열 번 던져 앞면이 여덟 번 나온 동전으로 보이고, 단순가설과 복합가설을 정의하며, 단측 대립가설과 양측 대립가설을 구분한다.
- 검정통계량과 p 값 -- 검정통계량(z, t, 카이제곱, F)을 정의하고, p 값이 귀무가설에 반하는 증거의 강도를 어떻게 정량화하는지 설명한다. 모든 검정이 밟는 네 단계도 여기서 세운다 — 9.2 이후의 검정들은 그 가운데 둘째와 셋째, 곧 통계량과 표집분포(sampling distribution)만 바꿔 끼운 것이다.
- 유의수준과 판정 규칙 -- 유의수준 \(\alpha\) 를 제1종 오류(type I error) 확률의 상한으로 기술하고, 기각 결정을 내리는 p 값 접근과 임계값 접근을 비교한다.
- 신뢰구간과 검정의 쌍대성 -- 수준 \(\alpha\) 의 양측 가설검정과 \(1-\alpha\) 신뢰구간이 같은 사건임을 부등식의 동치변형으로 보이고, 서로에게서 유도할 수 있음을 보인다. 8장에서 만든 구간이 곧 검정이라는 사실이 여기서 드러난다.
9.2 일표본 검정
단일 모수를 가설의 값과 견주는 검정:
- μ에 대한 Z-검정 (σ를 아는 경우) -- 모표준편차를 알 때 표준정규분포로 모평균이 특정 값과 같은지 검정한다.
- μ에 대한 t-검정 (σ를 모르는 경우) -- \(\sigma\) 를 모를 때 자유도 \(n-1\) 인 \(t\) 분포로 모평균을 검정하며 비정규성에 대한 로버스트성을 논한다.
- p에 대한 Z-검정 (비율) -- 정규근사로 모비율(population proportion)이 가설의 값과 같은지 검정하며, 최소 기대도수 조건을 다룬다.
- σ²에 대한 카이제곱 검정 -- 카이제곱분포(chi-squared distribution)로 모분산이 가설의 값과 같은지 검정하며, 비정규성에 민감하다는 경고를 덧붙인다.
9.3 이표본 검정
독립인 두 모집단의 모수를 비교하는 검정:
- μ₁−μ₂에 대한 이표본 Z-검정 -- 두 모분산을 모두 알 때 두 모평균이 다른지 검정한다.
- 이표본 t-검정 (스튜던트와 웰치) -- 스튜던트 \(t\) 검정(등분산 가정) 또는 웰치 \(t\) 검정(분산이 다른 경우)으로 독립인 두 표본의 평균을 비교하며, 합동 표준편차와 웰치–새터스웨이트 자유도의 공식을 제시한다.
- p₁−p₂에 대한 이표본 Z-검정 -- 귀무가설 아래의 합동 비율을 써서 두 모비율이 다른지 검정한다.
- σ₁²/σ₂²에 대한 F-검정 -- F-분포로 두 모분산의 동일성을 검정하며, 비정규성에 매우 민감하다는 주의를 덧붙인다.
- 대마초 가격: 가정 확인부터 결론까지 -- 9.3절을 닫는 사례 연구다. 2014년과 2015년 캘리포니아 가격 자료(2.4절과 같은 합성자료)에 네 단계를 끝까지 적용한다. 샤피로–윌크로 정규성(normality)을 보고, 신뢰구간을 구성하고, 독립 이표본 t-검정을 수행하고, 품질 등급 비율에 카이제곱 적합도 검정(goodness-of-fit test)을 붙인다. 그리고 그 쪽의 마지막 절이 첫 단계를 되짚는다 — 검정을 통과한 가정이 선 것은 아니다. 정규성 검정이 \(t\) 검정이 걱정하는 것을 재지 않는 까닭, 그리고 「통과하면 \(t\), 아니면 비모수(nonparametric)」라는 분기를 권하지 않는 까닭이 거기 있다.
9.4 대응표본 검정
관측값이 자연스럽게 짝을 이루는 자료의 검정:
- μ_D에 대한 대응 t-검정 -- 대응된 차이에 일표본 t-검정을 적용하여 평균 차이가 0인지 검정하며, 검정통계량과 자유도의 공식을 제시한다.
- 대응표본과 이표본, 언제 무엇을 쓰는가 -- 연구 설계, 자연스러운 짝짓기의 존재, 피험자 내 변동성 감소라는 목표에 따라 대응 설계와 독립 설계 중 무엇을 고를지 지침을 준다.
9.5 오류와 검정력
잘못된 결정의 결과와 충분한 민감도를 갖춘 연구를 설계하는 법:
- 제1종 오류와 제2종 오류 -- 거짓 양성(참인 귀무가설을 기각)과 거짓 음성(거짓인 귀무가설을 기각하지 못함)을 정의하고, 판정 요약표와 실무 예시를 제시한다.
- 검정력 분석 -- 통계적 검정력을 \(1-\beta\) 로 정의하고, 검정력을 결정하는 네 요인(\(\alpha\), 표본크기, 효과크기(effect size), 모집단 변동성)을 짚으며, 사전 검정력 계산을 설명한다.
9.6 다중검정
여러 가설을 한꺼번에 검정할 때 부풀려지는 거짓 양성을 보정하는 방법은 이렇다.
이 절은 두 가지 다른 일을 한다 — 읽는 순서
가르는 자리는 하나다. \(m\) 을 아는가.
보정할 수 있는 경우. 결과변수를 스무 개 미리 정해 두고 하나도 숨기지 않아도, \(\alpha = 0.05\) 에서 적어도 하나가 거짓 양성일 확률은 \(0.64\) 다. 아무도 아무것도 고르지 않았는데 그렇다. 「가족단위 오류율(familywise error rate)」과 「본페로니와 홀름 보정」이 그 자리이고, 10.3절 투키 HSD를 비롯한 사후비교(post hoc comparison)가 통째로 이 둘 위에 선다 — 건너뛰지 말 것.
보정할 수 없는 경우. 여럿 돌리고 하나만 보고하면 \(m\) 을 아무도 모른다. 보고된 \(p\) 는 한 번의 검정을 전제로 계산되었는데 실제로는 \(m\) 개 가운데 최솟값이다. 1.2절 자료 수집을 설계하라가 체리피킹이라 부른 그것이고, 「분석의 자유는 곱해진다」와 「절단점을 고르면」이 그 팽창을 수로 잰다. 처방이 통계가 아니라 사전등록인 까닭이 여기 있다.
뒤로 미뤄도 되는 것 하나. 「절단점을 고르면」의 유효 후보 수는 후보들이 상관될 때 본페로니가 과보정이 되는 자리다. 입문의 범위를 넘으며 건너뛰어도 10.3 을 따라가는 데 지장이 없다. 통제 대상 자체를 바꾸는 거짓발견율(false discovery rate)은 아예 절을 갈라 9.7 ★ 로 두었다.
- 분석의 자유는 곱해진다 -- 아무 효과가 없는 모의자료에서 유의한 결과를 만들어 내는 세 가지 관행을 각각 모의실험한다. 여러 결과변수 중 골라 쓰기, \(p < 0.05\)가 되는 즉시 자료 수집을 멈추기(임의 중단), 부분집단이나 분석 방법을 골라 쓰기다. 거짓 양성 비율이 얼마나 부풀려지는지 수로 보인다.
- 절단점을 고르면: 상관된 후보와 유효 후보 수 -- 네 번째 수법을 실자료에서 본다. 연속형 변수를 범주로 나눌 때 절단점을 골라 쓰는 것이고, 앞의 셋과 달리 p-해킹이라는 자각 없이 일어난다. 후보들이 서로 상관되어 있어 앞 쪽의 1 빼기 0.95의 k 제곱 공식이 그대로 쓰이지 않는다 — 절단점 64 개가 독립인 14 개 값만 치르고, 반대로 후보가 둘일 때는 표의 이산성 탓에 독립 예측보다 오류율이 크다. 이분화가 치르는 검정력의 대가까지 함께 잰다.
- 가족단위 오류율 -- FWER을 \(m\)개의 검정 중 적어도 하나를 잘못 기각할 확률로 정의하고, 검정 수가 늘면 얼마나 빨리 커지는지 보인다.
- 본페로니와 홀름 보정 -- 본페로니 보정(\(\alpha/m\) 에서 기각)과 균일하게 더 강력한 홀름의 단계적 하강 절차를 제시한다.
9.7 거짓발견율 ★
★ 이 절에 대하여
이 절은 입문 과정의 범위를 넘는다. 앞 절까지가 「적어도 하나를 잘못 기각할 확률」을 통제했다면, 여기서는 통제 대상 자체를 「기각한 것 가운데 거짓의 비율」로 바꾼다. 건너뛰어도 10.3절 투키 HSD를 비롯한 사후비교를 따라가는 데 지장이 없다.
- 거짓발견율 (Benjamini-Hochberg) -- FDR을 거짓 발견의 기대 비율로 소개하고 이를 통제하는 Benjamini-Hochberg 절차를 기술한다. FWER 통제와 맞세워 언제 어느 쪽을 고를지, 수천 개를 한꺼번에 검정하는 유전체학에서 무엇이 달라지는지까지 다룬다.
2. 선수 지식
이 장은 다음 내용을 바탕으로 한다.
- 5장 (추정량과 표집분포) -- 검정통계량이 따르는 정규, t, 카이제곱, F 분포.
- 5.11절 편향–분산 분해와 평균제곱오차부터 5.13절까지 -- 추정량으로서 표본평균과 표본분산의 성질.
- 8장 (신뢰구간) -- 신뢰구간의 구성. 신뢰구간과 검정은 쌍대성으로 이어져 있다.
3. 핵심 요약
- 가설검정은 귀무가설을 기본 가정으로 삼아, 표본자료가 모수에 관한 주장을 기각할 만큼 충분한 증거를 주는지 판단하는 체계적인 절차이다.
- p 값은 귀무가설이 참이라는 가정 아래 관측된 것만큼 또는 그보다 극단적인 자료를 볼 확률을 잰다. 귀무가설이 참일 확률이 아니다.
- 일표본, 이표본, 대응표본 검정은 논리 구조가 같고 다만 쓰는 검정통계량과 표집분포가 다르다.
- 제1종 오류와 제2종 오류(type II error)는 검정이 틀릴 수 있는 두 가지 방식이다. 표본크기나 효과크기를 키우면 제1종 오류율을 부풀리지 않으면서 검정력이 커진다(제2종 오류가 줄어든다).
- 여러 가설을 동시에 검정할 때는 본페로니, 홀름, Benjamini-Hochberg 같은 보정이 전체 오류율을 통제하고 거짓 발견을 피하는 데 필수적이다.