Wilcoxon 순위합검정
Wilcoxon 순위합검정은 독립인 두 표본을 비교하는 가장 널리 쓰이는 비모수 검정이다. 두 모집단이 같은 분포를 갖는지 --- 더 구체적으로는 한 집단이 다른 집단보다 체계적으로 큰 값을 내는 경향이 있는지 --- 를 검정한다. 두 표본을 합쳐 모든 관측값에 함께 순위를 매기고, 각 집단에 배정된 순위의 합을 비교하는 방식이다.
Wilcoxon 순위합검정은 Mann-Whitney U 검정과 수학적으로 동치이다. 둘은 같은 절차의 서로 다른 표현이다.
가정
- 두 표본이 서로 독립이다.
- 관측값이 연속분포에서 추출된다.
- 두 모집단이 같은 모양을 갖는다(\(H_0\) 아래에서 같은 분포를 공유한다).
위치이동 모형
많은 교과서가 순위합검정을 위치이동 모형 \(F_Y(x) = F_X(x - \Delta)\) 아래에서 제시한다. 여기서 \(\Delta\)는 이동 모수이다. 이 모형에서 검정은 구체적으로 \(H_0 \colon \Delta = 0\)을 검정한다. 더 일반적으로는 위치이동만이 아니라 임의의 형태의 확률적 순서를 탐지한다.
가설
단측 대립가설: \(H_a \colon X\)가 \(Y\)보다 큰 경향이 있다, 또는 그 반대.
검정통계량
1단계. 크기 \(n_1\)과 \(n_2\)인 두 표본을 합쳐 크기 \(N = n_1 + n_2\)인 하나의 표본을 만든다.
2단계. \(N\)개 관측값 전체에 작은 값부터 순위를 매기고 동점에는 중간순위를 배정한다.
3단계. 집단 1의 순위합을 계산한다.
여기서 \(R_i\)는 합친 표본에서 집단 1의 \(i\)번째 관측값의 순위이다.
전체 순위합이 \(N(N+1)/2\)로 고정되므로 집단 2의 순위합은 \(W_2 = N(N+1)/2 - W\)이다.
귀무분포
\(H_0\) 아래에서 두 집단에 대한 순위 배정이 모두 동등하게 가능하다. \(\{1, 2, \ldots, N\}\)에서 \(n_1\)개를 고르는 방법은 \(\binom{N}{n_1}\)가지이다.
\(H_0\) 아래 \(W\)의 평균과 분산:
동점 보정: 크기가 \(t_1, \ldots, t_g\)인 동점 집단이 \(g\)개 있으면
정규근사
표본이 크면(보통 \(n_1, n_2 \ge 10\)) 표준화된 통계량
은 \(H_0\) 아래 근사적으로 \(\mathcal{N}(0, 1)\)을 따른다.
보기 1. 두 교수법의 시험 점수 비교. 두 교수법을 독립인 두 집단의 시험 점수로 비교한다.
집단 A (\(n_1 = 6\)): 78, 64, 85, 72, 91, 80
집단 B (\(n_2 = 6\)): 55, 68, 61, 70, 66, 58
풀이
1단계. \(N = 12\)개 관측값을 합쳐 순위를 매긴다.
| 값 | 집단 | 순위 |
|---|---|---|
| 55 | B | 1 |
| 58 | B | 2 |
| 61 | B | 3 |
| 64 | A | 4 |
| 66 | B | 5 |
| 68 | B | 6 |
| 70 | B | 7 |
| 72 | A | 8 |
| 78 | A | 9 |
| 80 | A | 10 |
| 85 | A | 11 |
| 91 | A | 12 |
2단계. 집단 A의 순위합: \(W = 4 + 8 + 9 + 10 + 11 + 12 = 54\).
3단계. 귀무 모수:
4단계. 표준화 통계량:
5단계. 양측 \(p\)값:
\(\alpha = 0.05\)에서 \(H_0\)을 기각한다. 집단 A의 점수가 집단 B보다 유의하게 높다.
정확 \(p\)값과의 비교
\(n_1 = n_2 = 6\)이면 \(\binom{12}{6} = 924\)가지 순위 배정을 모두 열거할 수 있다. 정확 양측 \(p\)값은 \(0.01515\)로 정규근사값 \(0.01631\)과 매우 가깝다.
from scipy import stats
A = [78, 64, 85, 72, 91, 80]; B = [55, 68, 61, 70, 66, 58]
print(stats.mannwhitneyu(A, B, method='exact').pvalue)    # 0.015152
print(stats.ranksums(A, B).pvalue)                        # 0.016309
출력:
0.015151515151515152
0.016309171877754974
두 집단이 완전히 분리되지 않은(집단 A의 \(64\)가 집단 B의 값 넷보다 작다) 자료임에도 근사가 잘 맞는다.
Mann-Whitney U 검정과의 관계
Mann-Whitney \(U\) 통계량은 \(W\)의 단순한 선형변환이다.
두 검정은 언제나 같은 \(p\)값을 낸다. \(U\) 통계량 표현과 그 확률적 해석은 Mann-Whitney U 검정을 보라.
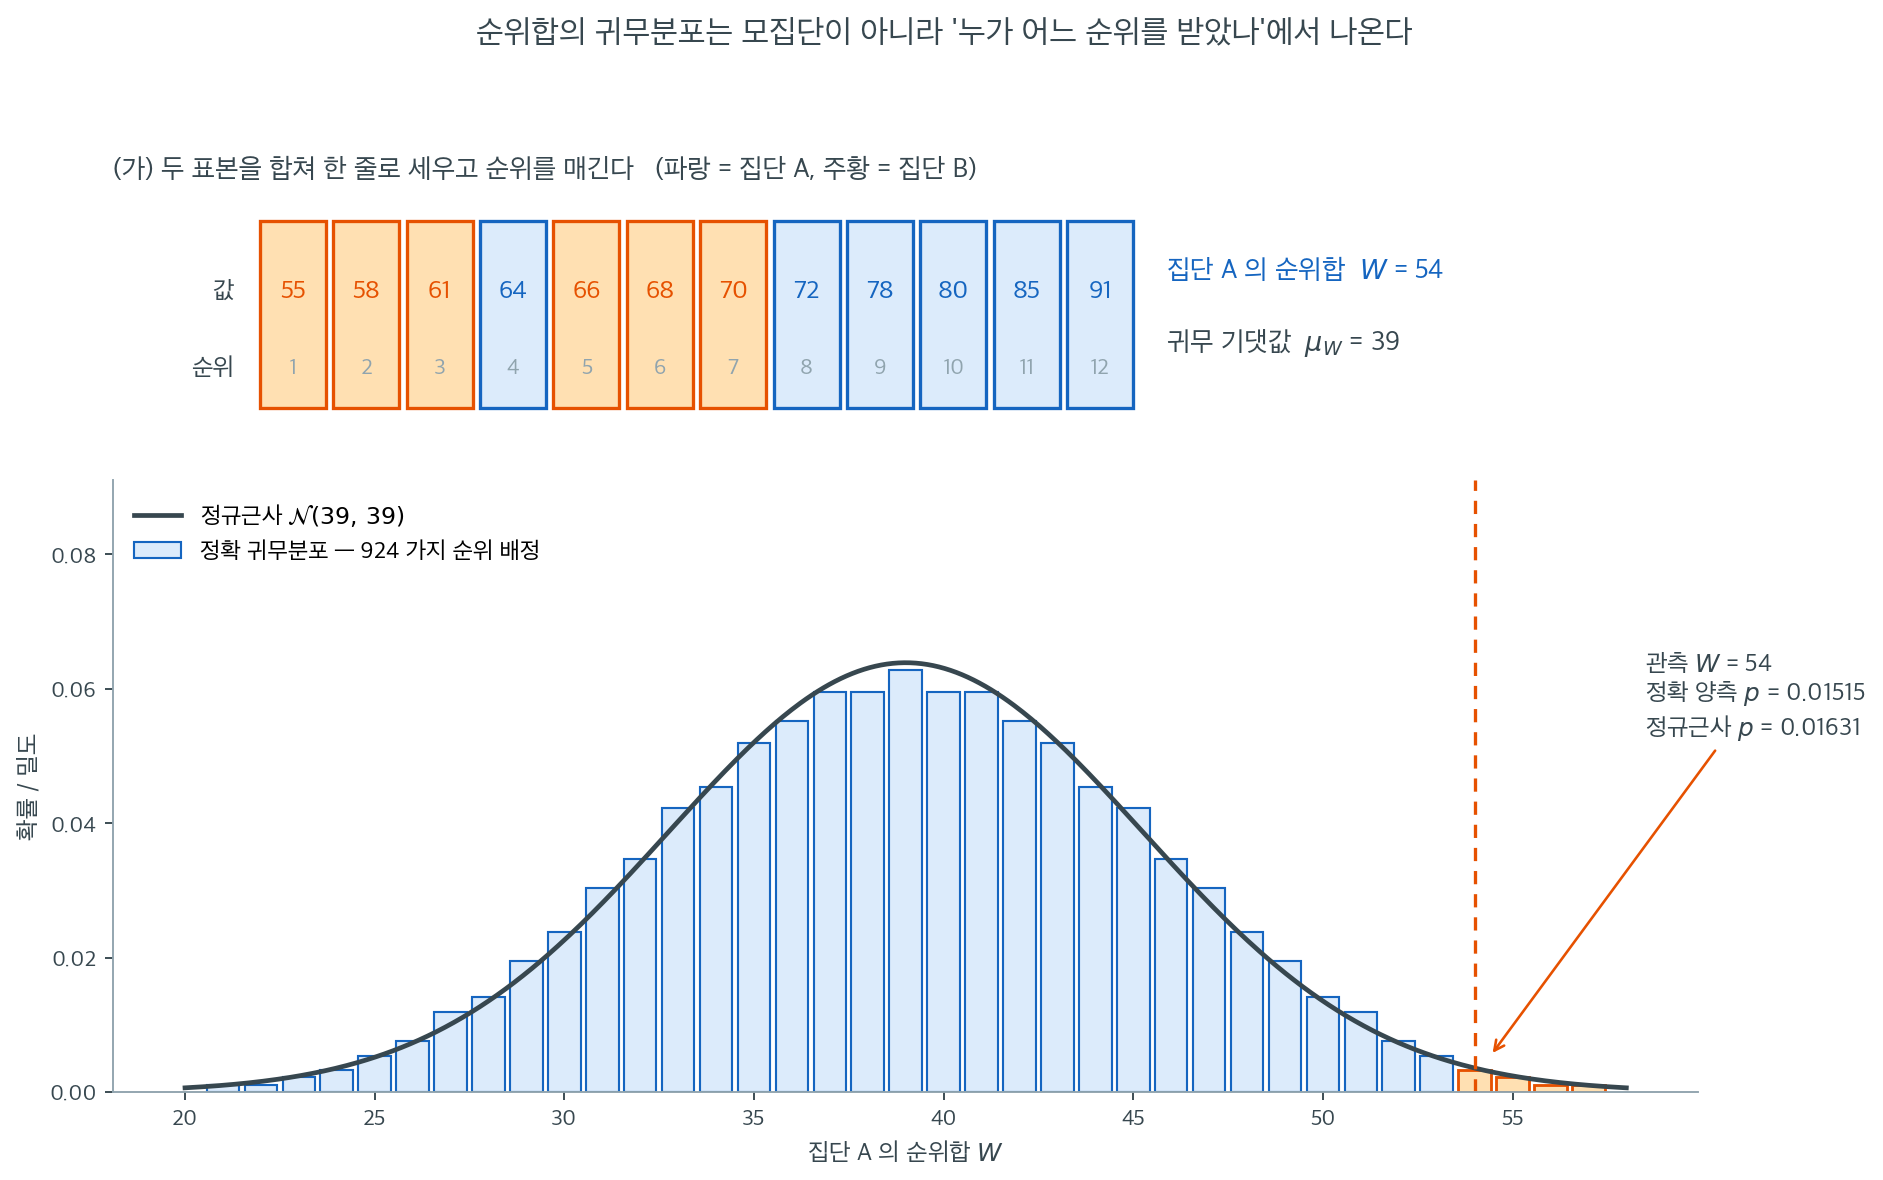
위에서 쓴 \(\mu_W = 39\)와 \(\sigma_W = 6.245\)가 어디에서 왔는지는 귀무분포를 통째로 그려 보면 분명해진다.
(가)는 보기 1의 자료 \(12\)개를 크기순으로 한 줄로 세운 것이다. 집단 B(주황)가 앞쪽을 거의 차지하고 집단 A(파랑)가 뒤쪽에 몰려 있다. 눈에 띄는 예외는 순위 \(4\)를 받은 \(64\) 하나뿐이다. 이 그림에서 값 자체는 이미 쓸모가 없다. \(91\)이 \(85\)보다 얼마나 큰지는 순위 \(12\)와 \(11\)이라는 사실로 대체되었고, 검정은 여기서부터 값을 다시 보지 않는다. 집단 A의 순위합은 \(W = 4 + 8 + 9 + 10 + 11 + 12 = 54\)이다.
(나)가 귀무분포이다. \(H_0\)이 참이면 어느 여섯 자리가 A에게 갈지는 순전히 우연이므로, \(\{1, \ldots, 12\}\)에서 여섯 개를 고르는 \(\binom{12}{6} = 924\)가지 배정이 모두 확률 \(1/924\)로 똑같이 가능하다. 그 \(924\)가지의 순위합을 전부 세면 막대그림이 되고, 이것이 \(W\)의 정확 귀무분포이다. 점수가 정규인지 치우쳤는지는 한 번도 쓰이지 않았다. 이것이 "분포무관"의 구체적인 의미이다.
관측값 \(W = 54\) 이상이 나오는 배정은 \(924\)가지 중 \(7\)가지뿐이어서 정확 양측 \(p\)값이 \(0.01515\)이다. 검은 곡선으로 겹쳐 놓은 정규근사 \(\mathcal{N}(39,\,39)\)는 \(p = 0.01631\)을 주는데, \(n_1 = n_2 = 6\)이라는 매우 작은 표본에서도 오차가 \(0.001\) 남짓이다. 순위합은 서로 다른 순위 여러 개의 합이라 중심극한정리가 빠르게 작동하기 때문이며, 실무에서 \(n_1, n_2 \ge 10\)이면 근사를 써도 좋다는 권고가 여기에서 나온다.
정확표와 소프트웨어
소표본(\(n_1, n_2 \le 20\))에서는 출간된 표나 소프트웨어(파이썬의 scipy.stats.ranksums, scipy.stats.mannwhitneyu 등)로 정확 임계값을 얻을 수 있다. 정확분포는 동등하게 가능한 \(\binom{N}{n_1}\)가지 순위 배정을 모두 열거하여 구한다.
연습문제
연습문제 1. 집단 A \(= \{3, 5, 7, 9\}\), 집단 B \(= \{6, 8, 10, 12, 14\}\)에 Wilcoxon 순위합검정을 적용하여 검정통계량 \(W\)를 계산하라.
풀이
합쳐서 순위를 매기면 3(1), 5(2), 6(3), 7(4), 8(5), 9(6), 10(7), 12(8), 14(9)이다.
집단 A의 순위: 1, 2, 4, 6. 합 \(W_A = 13\).
집단 B의 순위: 3, 5, 7, 8, 9. 합 \(W_B = 32\).
검산: \(13 + 32 = 45 = 9 \times 10 / 2\). \(\checkmark\)
작은 집단(A, \(n_1 = 4\))을 기준으로 \(W = W_A = 13\)이다.
\(H_0\) 아래에서 집단 A의 기대 순위합은 \(n_1(n_1 + n_2 + 1)/2 = 4(10)/2 = 20\)이다. \(W = 13 < 20\)이므로 집단 A가 작은 값을 갖는 경향이 있으며, 이는 자료와 일관된다.
정확 양측 \(p\)값은 \(0.1111\)로 유의하지 않다. \(n_1 = 4\), \(n_2 = 5\)에서 가능한 배정이 \(\binom{9}{4} = 126\)가지뿐이라 최소 \(p\)값이 \(2/126 = 0.0159\)이고, 이 자료는 완전 분리에서 멀다.
연습문제 2. Wilcoxon 순위합검정과 Mann-Whitney U 검정의 관계를 설명하라. 두 검정은 동치인가?
풀이
그렇다. 두 검정은 서로 관련된 다른 통계량을 쓰지만 동치이다. Mann-Whitney \(U_1\)은 \(x_i > y_j\)인 쌍 \((x_i, y_j)\)의 개수이다.
여기서 \(W_A\)는 집단 A의 Wilcoxon 순위합이다. 두 통계량은 언제나 같은 \(p\)값을 준다.
부등호의 방향에 주의
\(U_1 = W_A - n_1(n_1+1)/2\)가 세는 것은 \(x_i > y_j\)인 쌍이지 \(x_i < y_j\)인 쌍이 아니다. 따라서
연습문제 1의 자료로 확인해 보자. \(W_A = 13\)이므로 \(U_1 = 13 - 10 = 3\)이다. 실제로 \(x > y\)인 쌍을 세면 \((7,6)\), \((9,6)\), \((9,8)\)의 3개로 정확히 일치한다. \(x < y\)인 쌍은 17개이다.
a = [3, 5, 7, 9]; b = [6, 8, 10, 12, 14]
print(sum(1 for x in a for y in b if x > y))   # 3
print(sum(1 for x in a for y in b if x < y))   # 17
출력:
3
17
통계량의 선택은 관례의 문제이다. 순위합 형태가 계산이 간단하고, \(U\) 통계량은 확률적 해석이 깔끔하다.
연습문제 3. Wilcoxon 순위합검정이 실제로 검정하는 것은 무엇인가? 중앙값이 같은지를 검정하는 것인가?
풀이
Wilcoxon 순위합검정은 \(H_0\): 두 모집단이 같은 분포를 갖는다를, \(H_a\): 한 모집단이 큰 값을 내는 경향이 있다(확률적 우월)에 대해 검정한다.
흔히 "중앙값이 같은지를 검정한다"고 설명하지만, 이는 두 분포가 같은 모양을 갖고 위치만 다를 때만 정확하다. 분포의 모양이 다르면(예: 분산이나 왜도가 다르면) 중앙값이 같아도 기각할 수 있다.
구체적인 반례를 보자. \(X \sim \mathcal{N}(0, 1)\), \(Y \sim \mathcal{N}(0, 25)\)이면 중앙값이 둘 다 0이고 \(P(X > Y) = 0.5\)이므로 검정이 기각하지 않는다. 그러나 \(X \sim \text{Exp}(1) - \ln 2\)와 \(Y \sim -(\text{Exp}(1) - \ln 2)\)는 둘 다 중앙값이 0이지만 \(P(X > Y) \approx 0.596 \ne 0.5\)이다. 한쪽은 오른쪽으로, 다른 쪽은 왼쪽으로 치우쳐 있어 모양이 다르기 때문이다.
import numpy as np
from scipy import stats
rng = np.random.default_rng(0)
x = rng.exponential(1, 200000) - np.log(2)
y = -(rng.exponential(1, 200000) - np.log(2))
print(np.median(x), np.median(y))     # 약 0.000, 0.000
print((x > y).mean())                 # 0.596  ← 0.5가 아니다
출력:
-0.00482088991645685 0.0007391176296889235
0.59587
\(n = 100\)씩 표본을 뽑아 검정하면 기각률이 명목수준을 크게 넘는다. 중앙값이 같은데도 그렇다.
위치이동 모형(\(Y = X + \Delta\))에서는 검정이 \(H_0: \Delta = 0\)과 동치이며, 기각은 중앙값(과 평균)이 다름을 함의한다.
연습문제 4. 대표본에서 순위합검정은 정규근사를 쓴다. \(z\) 통계량의 공식을 쓰고, 연속성 보정의 효과를 보기 자료로 확인하라.
풀이
\(H_0\) 아래에서 순위합 \(W\)는
를 가지며 \(z\) 통계량은
이다. 이 근사는 \(n_1, n_2 \ge 10\)에서 정확하다. 더 작은 표본에서는 순열분포의 정확 \(p\)값을 써야 한다.
본문 보기(\(W = 54\), \(n_1 = n_2 = 6\))로 세 가지를 비교하면
from scipy import stats
A = [78, 64, 85, 72, 91, 80]; B = [55, 68, 61, 70, 66, 58]
print(stats.mannwhitneyu(A, B, method='exact').pvalue)              # 0.015152
print(stats.mannwhitneyu(A, B, method='asymptotic',
                         use_continuity=False).pvalue)              # 0.016309
print(stats.mannwhitneyu(A, B, method='asymptotic',
                         use_continuity=True).pvalue)               # 0.020241
출력:
0.015151515151515152
0.016309171877754974
0.020240570577077482
| 방법 | \(p\)값 |
|---|---|
| 정확 (열거) | \(0.01515\) |
| 정규근사, 보정 없음 | \(0.01631\) |
| 정규근사, 연속성 보정 | \(0.02024\) |
여기서는 연속성 보정이 오히려 정확값에서 멀어지게 한다. 보정 없는 근사의 오차가 \(0.0012\)인데 보정한 쪽은 \(0.0051\)로 네 배가 넘는다.
부호검정이나 부호순위검정에서 연속성 보정이 도움이 되었던 것과 대조적이다. 이유는 \(W\)의 귀무분포가 격자 간격 1로 촘촘한 반면(가능한 값이 \(21\)부터 \(57\)까지 \(37\)가지), 관측값 \(54\)가 이미 꼬리 깊숙이 있어 계단 보정보다 정규곡선 자체의 꼬리 오차가 더 크기 때문이다.
일반 지침: 연속성 보정은 근사를 보수적으로(= \(p\)값을 크게) 만든다. 근사가 이미 \(p\)값을 과대평가하고 있다면 보정이 상황을 악화시킨다. \(n \le 20\)이면 보정 여부를 고민하지 말고 정확검정을 쓰는 것이 옳다.
정리하며
Wilcoxon 순위합검정은 두 독립표본의 관측값을 합쳐 순위를 매기고 한 집단의 순위합을 계산하여 비교한다. 귀무가설 아래에서 순위합이 너무 크거나 너무 작을 확률이 낮으므로, 한 집단이 체계적으로 큰 값을 내는 경향을 탐지한다. 중간 이상의 표본에서는 정규근사가 신뢰할 만하고, 소표본은 정확표로 다룬다. 순위합검정은 Mann-Whitney \(U\) 검정과 동치이며, 정규성 아래에서 이표본 \(t\) 검정 대비 ARE \(3/\pi \approx 0.955\)를 달성한다.