절단자료의 최대가능도
앞 절들에서 여러 모수적 생존 모형 --- 지수, 와이불, 로그정규, 로그로지스틱 --- 을 소개하고 지수 모형의 MLE를 유도했다. 이 절에서는 모든 모수적 생존 모형의 모수 추정을 떠받치는 절단자료의 일반적인 가능도 틀을 전개한다.
핵심 착상은 관측된 사건과 절단된 관측치가 가능도에 서로 다른 인자를 기여한다는 것이다. 시점 \(t_i\)의 사건은 밀도 \(f(t_i)\)를, 시점 \(t_i\)의 절단은 생존확률 \(S(t_i)\)를 기여한다.
절단자료의 가능도
\((t_1, \delta_1), \ldots, (t_n, \delta_n)\)을 관측 자료라 하자. \(t_i\)는 관측된 시간이고 \(\delta_i \in \{0, 1\}\)은 사건 지시자다(사건이면 \(\delta_i = 1\), 절단이면 \(\delta_i = 0\)).
독립 절단 가정 아래에서 모수벡터 \(\boldsymbol{\theta}\)의 가능도는
이다.
해석:
- \(\delta_i = 1\)이면 그 대상이 정확히 \(t_i\)에 사건을 겪었으므로 기여는 밀도 \(f(t_i)\)다.
- \(\delta_i = 0\)이면 그 대상이 \(t_i\)에 절단되어 우리가 아는 것은 \(T_i > t_i\)뿐이므로 기여는 \(P(T_i > t_i) = S(t_i)\)다.
왜 밀도만 쓰면 안 되는가
절단된 관측치를 버리고 사건만 쓰면 정보를 낭비하고 추정이 짧은 생존시간 쪽으로 편향된다. 절단된 관측치를 \(S(t_i)\) 기여와 함께 포함시키면 그 대상이 적어도 \(t_i\)까지 생존했다는 정보를 보존한다.
로그가능도
\(f(t) = h(t) S(t)\)와 \(S(t) = \exp(-H(t))\)를 쓰면 가능도는
이 되고, 로그가능도는
이다. 이 분리된 형태는 계산에 편리하다. 위험함수와 누적위험함수가 어떤 모수 모형에서든 기본 구성요소이기 때문이다.
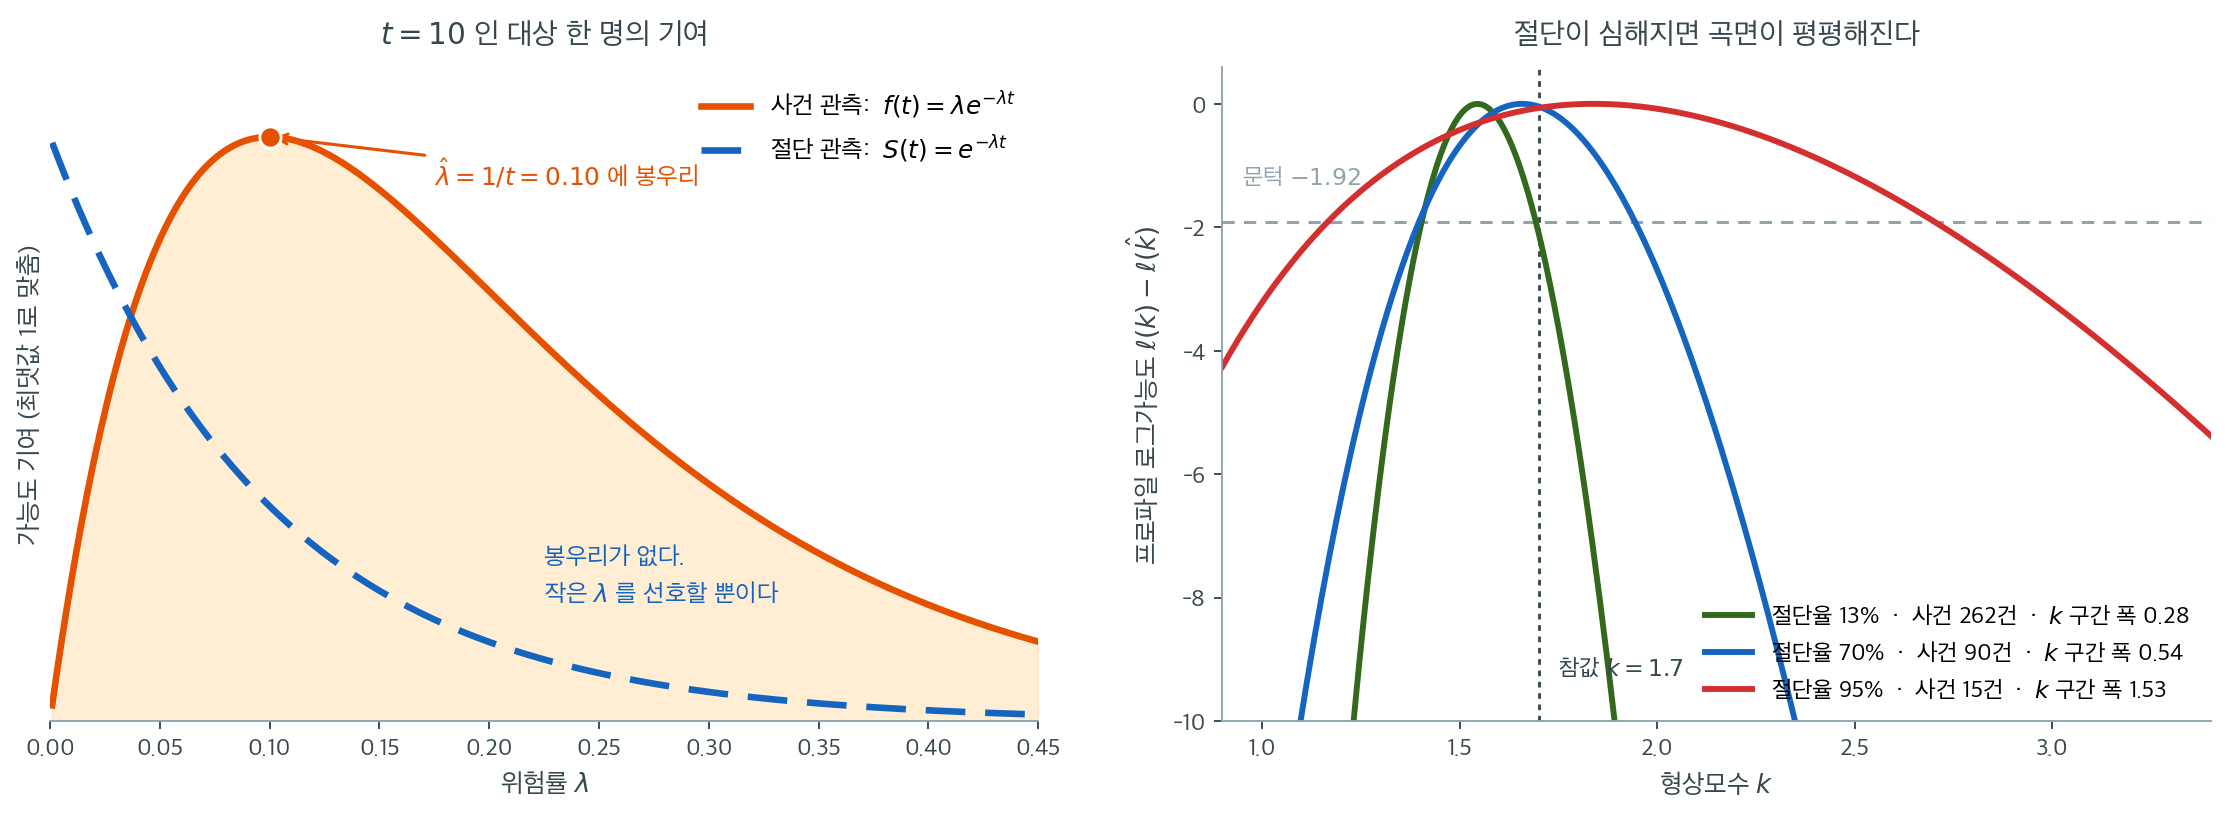
왼쪽은 지수 모형에서 \(t = 10\)에 관측된 대상 한 명의 가능도 기여를 \(\lambda\)의 함수로 그린 것이다. 사건으로 관측되었으면 기여가 \(f(10) = \lambda e^{-10\lambda}\)이고, 이 함수는 \(\hat\lambda = 1/10 = 0.10\)에서 뚜렷한 봉우리를 갖는다. "10개월에 사건이 일어났다"는 진술이 \(\lambda\)가 대략 얼마여야 하는지를 위아래 양쪽에서 좁혀 주기 때문이다.
절단으로 관측되었으면 기여가 \(S(10) = e^{-10\lambda}\)이고, 이 함수에는 봉우리가 없다. \(\lambda\)가 작을수록 단조 증가할 뿐이다. "적어도 10개월은 버텼다"는 진술은 \(\lambda\)가 너무 크지 않다는 상한만 말해 주고 하한은 전혀 말해 주지 않는다. 절단 관측이 정보를 주기는 하되 한쪽으로만 준다는 것이 이 두 곡선의 차이다. 앞의 상자에서 "절단된 관측치를 버리면 편향된다"고 한 것과 "절단만으로는 모수를 정할 수 없다"는 것이 동시에 참인 이유다.
오른쪽은 그 결과다. 와이불 \(k = 1.7\), \(\lambda = 50\)에서 \(n = 300\)을 뽑고 절단의 강도만 바꿔 가며 형상모수의 프로파일 로그가능도 \(\ell(k) - \ell(\hat k)\)를 그렸다. 절단율 \(13\%\)(사건 262건)에서는 곡선이 뾰족해 프로파일 95% 구간이 \((1.41,\ 1.69)\)로 폭 \(0.28\)이다. 절단율 \(70\%\)(사건 90건)에서는 폭이 \(0.54\)로 두 배, 절단율 \(95\%\)(사건 15건)에서는 \((1.17,\ 2.70)\)으로 폭이 \(1.53\)까지 부푼다. 마지막 경우는 "위험이 감소한다"(\(k<1\))만 겨우 배제할 뿐 그 이상 아무 말도 하지 못한다.
표본 크기 \(n = 300\)은 세 경우 모두 같았다는 점이 핵심이다. 달라진 것은 사건 수뿐이다. 왼쪽 그림이 그 이유를 이미 말했다. 봉우리를 만드는 것은 \(\delta_i \ln h(t_i)\) 항이고, 절단 관측은 그 항을 기여하지 않는다. 그래서 생존분석에서는 표본 크기가 아니라 사건 수를 세야 하며, 임상시험 설계가 "환자 몇 명"이 아니라 "사건 몇 건"을 목표로 잡는 것도 이 때문이다.
점수방정식
점수함수는 로그가능도의 기울기다.
MLE \(\hat{\boldsymbol{\theta}}\)는 \(U(\hat{\boldsymbol{\theta}}) = \mathbf{0}\)을 푼다.
정보행렬
관측 피셔 정보행렬은
를 \(\hat{\boldsymbol{\theta}}\)에서 평가한 것이다. MLE의 점근 공분산은 \(\text{Var}(\hat{\boldsymbol{\theta}}) \approx \mathcal{I}(\hat{\boldsymbol{\theta}})^{-1}\) 이다.
개별 모수의 신뢰구간은
이다.
수치 최적화
지수 모형을 제외하면 생존 모형의 점수방정식에는 닫힌 형태의 해가 없다. 표준적인 수치 방법은 다음과 같다.
- 뉴턴-랩슨. 헤세행렬(관측정보)을 써서 매 반복 모수 추정치를 갱신한다.
-
피셔 점수법. 관측정보를 기대정보로 대체한다. 모형이 옳게 지정되어 있으면 뉴턴-랩슨과 동등하다.
-
준뉴턴법(BFGS, L-BFGS). 이차도함수 계산을 피하려고 헤세행렬을 근사한다. 소프트웨어 패키지에서 널리 쓰인다.
초기값
좋은 초기값이 수렴을 앞당긴다. 와이불 모형은 \(k = 1\)(지수)과 \(\lambda = \sum t_i / d\)로 시작한다. 로그정규와 로그로지스틱 모형은 절단되지 않은 관측치의 \(\ln t_i\)의 표본평균과 표본분산을 쓴다.
양수 제약이 있는 모수는 로그 척도에서 최적화하라. \(k > 0\), \(\lambda > 0\)이므로 \(\ln k\)와 \(\ln\lambda\)를 최적화 변수로 두면 제약 없는 최적화가 되어 BFGS 같은 일반 최적화기를 그대로 쓸 수 있다. 아래 연습문제 2의 코드가 이 방식이다.
와이불 가능도
모수가 \((k, \lambda)\)인 와이불 모형에서
이므로 로그가능도는
이다.
가능도를 이용한 모형 비교
모수 모형은 가능도 기반 기준으로 비교할 수 있다.
가능도비 검정(내포 모형용). 지수 모형(\(k=1\))을 와이불 모형(\(k\) 자유)과 견주려면
를 쓴다.
아카이케 정보기준(비내포 모형용):
여기서 \(p\)는 모수의 개수다. AIC가 낮을수록 적합도와 복잡도의 절충이 낫다. 21.5절에서 AIC와 다른 선택 기준을 자세히 다룬다.
좌측절단과 구간절단 다루기
가능도는 다른 절단 유형으로도 확장된다.
- 좌측절단(\(T_i < t_i\)): \(F(t_i) = 1 - S(t_i)\)를 기여한다.
- 구간절단(\(L_i < T_i \leq R_i\)): \(S(L_i) - S(R_i) = F(R_i) - F(L_i)\)를 기여한다.
여러 절단 유형이 섞인 경우의 일반적인 가능도는
이다. 여기서 \(\mathcal{E}\), \(\mathcal{R}\), \(\mathcal{L}\), \(\mathcal{I}\)는 각각 정확 관측, 우측절단, 좌측절단, 구간절단 관측치의 집합이다.
절단이 심할 때의 식별 가능성
절단 비율이 매우 높으면(예: 관측치의 80% 이상이 절단) 가능도 곡면이 평평해져 MLE를 신뢰하기 어렵다. 이런 경우에는 표본 크기를 늘리거나, 추적 기간을 연장하거나, 정보가 있는 사전분포를 갖는 베이즈 방법을 고려하라.
연습문제
연습문제 1. 로그가능도 \(\ell = \sum_i [\delta_i \ln h(t_i) - H(t_i)]\)를 원래 형태 \(\prod_i f(t_i)^{\delta_i} S(t_i)^{1-\delta_i}\)에서 유도하라. 절단된 관측치가 왜 \(-H(t_i)\) 항만 기여하는지 설명하라.
풀이
\(f(t) = h(t)S(t)\)와 \(S(t) = e^{-H(t)}\)를 대입하면 각 인자는
가 된다. 지수 \(\delta_i\)가 \(S\)에서 완전히 사라지는 것이 핵심이다. 사건이든 절단이든 모든 관측치가 \(S(t_i)\)를 똑같이 기여하고, 사건만 추가로 \(h(t_i)\)를 기여한다.
\(S(t_i) = e^{-H(t_i)}\)이므로 로그를 취하면
해석. 이 형태는 두 종류의 정보를 분리해 보여준다.
- \(-H(t_i)\)는 "이 대상이 \(t_i\)까지 살아남았다"는 정보다. 모든 대상이 기여한다.
- \(\delta_i \ln h(t_i)\)는 "그리고 정확히 \(t_i\)에 사건을 겪었다"는 추가 정보다. 사건을 겪은 대상만 기여한다.
절단된 대상이 \(-H(t_i)\)만 기여하는 것은 그가 준 정보가 딱 그것뿐이기 때문이다. 언제 사건이 일어날지는 말해 주지 않는다. \(\square\)
연습문제 2. 와이불 로그가능도를 직접 구현하고 절단자료에서 \((\hat k, \hat\lambda)\)를 수치적으로 구하라. \(k = 1\)로 고정한 지수 모형과 가능도비 검정으로 비교하라.
풀이
import numpy as np
from scipy.optimize import minimize
from scipy import stats

rng = np.random.default_rng(31)
n = 400
k_true, lam_true = 1.7, 50.0
T = lam_true * rng.weibull(k_true, n)
C = rng.exponential(70.0, n)
t = np.minimum(T, C); d = (T <= C).astype(int)

def neg_loglik(p):
    k, lam = np.exp(p)                 # optimize on the log scale
    h = (k / lam) * (t / lam) ** (k - 1)
    H = (t / lam) ** k
    return -np.sum(d * np.log(h) - H)

res = minimize(neg_loglik, [0.0, np.log(t.mean())], method='BFGS')
k_hat, lam_hat = np.exp(res.x)
ll_weib = -res.fun

lam_exp = t.sum() / d.sum()            # exponential MLE, closed form
ll_exp = np.sum(d * np.log(1 / lam_exp) - t / lam_exp)

LR = 2 * (ll_weib - ll_exp)
print(f"Weibull : k={k_hat:.4f}, lambda={lam_hat:.3f}, loglik={ll_weib:.4f}")
print(f"Exp     : lambda={lam_exp:.3f}, loglik={ll_exp:.4f}")
print(f"LR = {LR:.4f}, p = {stats.chi2.sf(LR, 1):.3e}")
출력:
Weibull : k=1.5960, lambda=49.300, loglik=-1088.6557
Exp     : lambda=52.155, loglik=-1124.6066
LR = 71.9018, p = 2.262e-17
결과. 절단율은 \(43.2\%\)이고 사건은 227건이다.
| 모형 | 모수 | 로그가능도 | AIC |
|---|---|---|---|
| 와이불 | \(\hat k = 1.596\), \(\hat\lambda = 49.30\) | \(-1088.66\) | \(2181.31\) |
| 지수 | \(\hat\lambda = 52.16\) | \(-1124.61\) | \(2251.21\) |
가능도비 통계량은 \(\Lambda = 2(-1088.66 + 1124.61) = 71.90\)이고 \(p = 2.3 \times 10^{-17}\)로 지수 모형을 압도적으로 기각한다. AIC도 와이불이 \(70\)만큼 낮다.
참값 \(k = 1.7\)에 대해 \(\hat k = 1.596\)으로 다소 낮게 나왔는데, 이는 표집 변동이다. 와이불 절 연습문제 3의 그림 기반 추정치 \(1.360\)과 비교하면 최대가능도 쪽이 훨씬 정확하다. \(\square\)
연습문제 3. 절단율이 매우 높으면 왜 가능도 곡면이 평평해지는지 설명하라. 사건이 하나도 없으면 어떤 일이 일어나는가?
풀이
로그가능도 \(\ell = \sum_i [\delta_i \ln h(t_i) - H(t_i)]\)에서 모수의 모양에 대한 정보는 대부분 첫 항 \(\delta_i \ln h(t_i)\)에서 온다. 절단된 관측치는 \(-H(t_i)\)만 기여하는데, 이 항은 "생존시간이 \(t_i\)보다 길다"는 부등식 정보라 모수를 느슨하게만 제약한다.
절단율이 높으면 첫 항의 항 수가 줄어들어 곡면이 평평해진다. 특히 형상모수는 사건이 언제 일어나는지에 대한 정보를 필요로 하므로 절단에 특히 취약하다. 척도모수는 총 인시에서 비교적 잘 추정되지만 형상모수는 그렇지 않다.
사건이 하나도 없는 경우(\(d = 0\)). 로그가능도가
가 되어, 모든 \(t_i\)에서 \(H\)를 작게 만들수록 커진다. 와이불이면 \(H(t) = (t/\lambda)^k\)이므로 \(\lambda \to \infty\)에서 \(\ell \to 0\)이고, 최대점이 경계에 있어 MLE가 존재하지 않는다. 21.3절 지수 모형 연습문제 3에서 본 것과 같은 현상이다.
실무적 대응.
- 사건 수를 세라. 표본 크기가 아니라 사건 수가 정보량을 결정한다. 모수가 2개인 모형에 사건이 10건뿐이면 어떤 결과도 신뢰할 수 없다.
- 모형을 단순화하라. 형상모수를 추정할 수 없으면 \(k = 1\)로 고정한 지수 모형이 더 정직하다.
- 프로파일 가능도를 그려 보라. \(k\)에 대한 프로파일 로그가능도가 넓은 범위에서 평평하면 그것이 곧 식별 불가의 증거다. 왈드 표준오차만 보면 이 문제를 놓친다. \(\square\)
연습문제 4. 구간절단 자료에 대한 가능도 \(\prod_i [S(L_i) - S(R_i)]\)를 최대화할 때, 우측절단 자료보다 계산이 어려운 이유를 설명하라.
풀이
우측절단의 경우. 로그가능도가 \(\sum_i [\delta_i \ln h(t_i) - H(t_i)]\)로 각 항이 \(H\)와 \(\ln h\)의 단순한 합이다. \(H\)와 \(h\)가 모수의 매끄러운 함수이므로 기울기와 헤세행렬을 해석적으로 구할 수 있고, 로그가 곱을 합으로 바꿔 주어 수치적으로도 안정적이다.
구간절단의 경우. 각 항이 두 생존함수의 차 \(S(L_i) - S(R_i)\)이며 로그가 이 차를 분해하지 못한다.
여기에서 세 가지 어려움이 생긴다.
- 수치적 소거. \(L_i\)와 \(R_i\)가 가까우면 \(S(L_i) - S(R_i)\)가 두 비슷한 수의 차라 유효숫자가 대량으로 소실된다. 부동소수점에서 0이 되면 \(\ln 0 = -\infty\)가 된다.
- 미분이 복잡하다. \(\partial \ln[S(L)-S(R)]/\partial\theta\)가 몫 형태가 되어 기울기와 헤세행렬이 훨씬 복잡하고, 분모가 작을 때 불안정하다.
- 볼록성을 잃는다. 우측절단 가능도는 많은 모형에서 로그오목이지만 구간절단 가능도는 그렇지 않을 수 있다. 국소 최적점이 여러 개 생겨 초기값에 따라 다른 답에 이른다.
비모수적인 경우는 더 어렵다. 구간절단 자료의 비모수 MLE(터른불 추정량)는 닫힌 형태가 없고 EM 알고리즘 같은 반복법이 필요하며, 카플란-마이어처럼 한 번의 통과로 계산되지 않는다.
실무적 처방. 구간 폭이 좁고 균일하면 각 구간의 중점을 정확 관측으로 근사하는 것이
쓸 만한 지름길이다. 그러나 구간이 넓으면 편향이 커지므로(21.1절 연습문제 3의 경고) 제대로
된 구간절단 방법을 써야 한다. lifelines의 WeibullFitter.fit_interval_censoring이나
R의 icenReg 패키지가 이를 제공한다. \(\square\)
정리하며
절단자료의 가능도는 두 종류의 기여로 이루어진다.
- 사건이면 밀도, 절단이면 생존함수를 곱한다. 사건 관측은 "정확히 \(t_i\) 에 일어났다"이고, 절단 관측은 "\(t_i\) 를 넘겼다" 는 정보만 준다.
- 로그를 취하면 \(\sum[\delta_i\log h(t_i)-H(t_i)]\) 가 된다. 위험함수와 누적위험으로 적히며, 모든 모수 모형에 공통인 형태다.
- 절단 관측이 버려지지 않는다. 정보의 양이 적을 뿐 기여는 한다. 이것이 생존분석이 절단을 다루는 방식이다.
- 무작위 절단 가정이 여기에 들어 있다. 절단 시점이 사건시간과 독립이어야 이 가능도가 옳다.
- 6장의 최대가능도 이론이 그대로 적용된다. 수치 최적화, 피셔 정보량, 표준오차 모두 같은 방식이다.
다음 절 모수적 생존 모형 (코드) 로 넘어간다.