바이올린 그림¶
개요¶
자료가 둘 있다. 하나는 평균 \(2.45\) 에 중앙값 \(2.40\), 다른 하나는 평균 \(2.53\) 에 중앙값 \(2.55\) 로 중심이 사실상 같다. 그런데 첫째 자료에서 \(2.5\) 는 가장 흔한 값이 아니라 가장 드문 값이다 — \(0\) 근처와 \(5\) 근처에 각각 \(500\) 개가 몰린 두 덩어리이고 가운데는 비어 있다. 상자그림(box plot)은 이 차이를 말해 주지 않고, 바이올린은 말해 주지만, 곡선을 얼마나 매끄럽게 그릴지 정하는 대역폭(bandwidth)을 기본의 \(3.3\) 배로 늘리면 두 봉우리가 하나로 합쳐지고 \(0.25\) 배로 줄이면 없던 봉우리가 셋이 된다. 그러면 바이올린의 모양을 정하는 것은 자료인가.
바이올린 그림은 상자그림과 양쪽에 그린 커널밀도추정(KDE)을 결합하여 요약통계량과 함께 분포의 전체 모양을 보여준다. 상자그림이 분포를 다섯 개의 수와 이상치(outlier)로 줄이는 반면, 바이올린 그림은 상자그림이 감추는 다봉성, 왜도(skewness), 밀도의 변화를 드러낸다.
1. 바이올린 그림 대 상자그림¶
상자그림에 대한 바이올린 그림의 핵심 장점은 값에 따른 자료의 확률밀도를 보여줄 수 있다는 점이다. 덕분에 다음과 같은 경우에 특히 유용하다.
- 상자그림이 놓칠 이봉 또는 다봉 분포를 탐지할 때.
- 차이가 미묘한 집단 간 분포 모양을 비교할 때.
- 분포에 관한 이야기를 청중에게 온전히 전달할 때.
| 기능 | 상자그림 | 바이올린 그림 |
|---|---|---|
| 사분위수 표시 | 예 | 예(inner='quartile' 사용 시) |
| 이상치 표시 | 예(개별 점) | 아니오(매끄럽게 지워짐) |
| 전체 모양 표시 | 아니오 | 예 |
| 다봉성 드러냄 | 아니오 | 예 |
| 압축성 | 높음 | 보통 |
권장 실무
빠른 요약에는 상자그림을, 분포의 모양이 중요할 때는 바이올린 그림을 쓴다. 판단이 서지 않으면 둘을 나란히 보여준다.
2. 기본 바이올린 그림¶
상자그림이 무엇을 놓치는지 보려면, 중심은 거의 같은데 모양은 전혀 다른 두 자료를 나란히 놓으면 된다.
보기 1. 기본 바이올린 그림, 그리고 모양을 정하는 것은 자료가 아니라 대역폭이다. \(N(0,1)\)에서 \(500\)개, \(N(5,1)\)에서 \(500\)개를 이어 붙인 이봉 자료와, 중심이 같은 \(N(2.5, 2^2)\) 단봉 자료 \(1000\)개를 쓴다.
(1) 두 자료를 바이올린과 상자그림으로 나란히 그리고, 상자그림이 가리는 것을 수치와 함께 적으시오.
(2) 바이올린의 KDE 대역폭을 \(h\)라 하자. 이봉 자료의 봉우리 두 개가 사라지는 \(h\)의 임계값을 구하고, 대역폭을 바꾸어 가며 봉우리 개수를 세어 확인하시오.
풀이
(1) 그려 본다.
import matplotlib.pyplot as plt
import numpy as np

# 그림에 한글을 쓰므로 한글 글꼴을 지정한다. 후보를 늘어놓으면 matplotlib 가
# 설치된 첫 번째를 집으므로, 리눅스('NanumGothic')·맥('Apple SD Gothic Neo')·
# 윈도우('Malgun Gothic')에서 코드를 고치지 않고 그대로 돌릴 수 있다.
# 글꼴을 바꾸면 마이너스 기호가 깨지므로 unicode_minus 도 함께 꺼 준다.
plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams['axes.unicode_minus'] = False

np.random.seed(0)

# --- 자료 1: 봉우리가 둘인 분포 -------------------------------------
# 0 근처 500개와 5 근처 500개를 이어 붙인다.
# 두 무리의 한가운데인 2.5 부근에는 자료가 거의 없다.
data_1 = np.concatenate([np.random.normal(0, 1, 500),
                         np.random.normal(5, 1, 500)])

# --- 자료 2: 봉우리가 하나인 분포 -----------------------------------
# 중심을 자료 1과 같은 2.5 에 맞춘다. 중심만 보아서는
# 두 자료를 구별할 수 없게 만드는 것이 목적이다.
data_2 = np.random.normal(2.5, 2, 1000)

# 요약통계량을 먼저 확인한다. 상자그림이 그리는 것이 바로 이 수들이다.
for name, d in [("data_1 (이봉)", data_1), ("data_2 (단봉)", data_2)]:
    q1, q3 = np.percentile(d, [25, 75])
    print(f"{name}: 평균 {d.mean():.2f}, 중앙값 {np.median(d):.2f}, "
          f"표준편차 {d.std():.2f}, IQR [{q1:.2f}, {q3:.2f}]")

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 4))

# --- 왼쪽: 바이올린 그림 --------------------------------------------
# 좌우로 펼쳐진 폭이 그 높이에서의 커널밀도추정값이다.
# showmeans / showmedians 로 평균선과 중앙값선을 함께 표시한다.
ax1.violinplot([data_1, data_2], showmeans=True, showmedians=True)
ax1.set_title("바이올린 그림")
ax1.set_xticks([1, 2])
ax1.set_xticklabels(["이봉", "단봉"])

# --- 오른쪽: 같은 자료의 상자그림 -----------------------------------
# 다섯 수치 요약과 이상치만 그린다. 밀도 정보는 버려진다.
# 이름표는 boxplot 인자(labels= / tick_labels=)가 버전마다 달라지므로
# 축에 직접 달아 두면 버전에 상관없이 동작한다.
ax2.boxplot([data_1, data_2])
ax2.set_xticks([1, 2])
ax2.set_xticklabels(["이봉", "단봉"])
ax2.set_title("상자그림")

plt.tight_layout()
plt.show()
출력:
data_1 (이봉): 평균 2.45, 중앙값 2.40, 표준편차 2.67, IQR [-0.05, 4.93]
data_2 (단봉): 평균 2.53, 중앙값 2.55, 표준편차 1.94, IQR [1.19, 3.75]
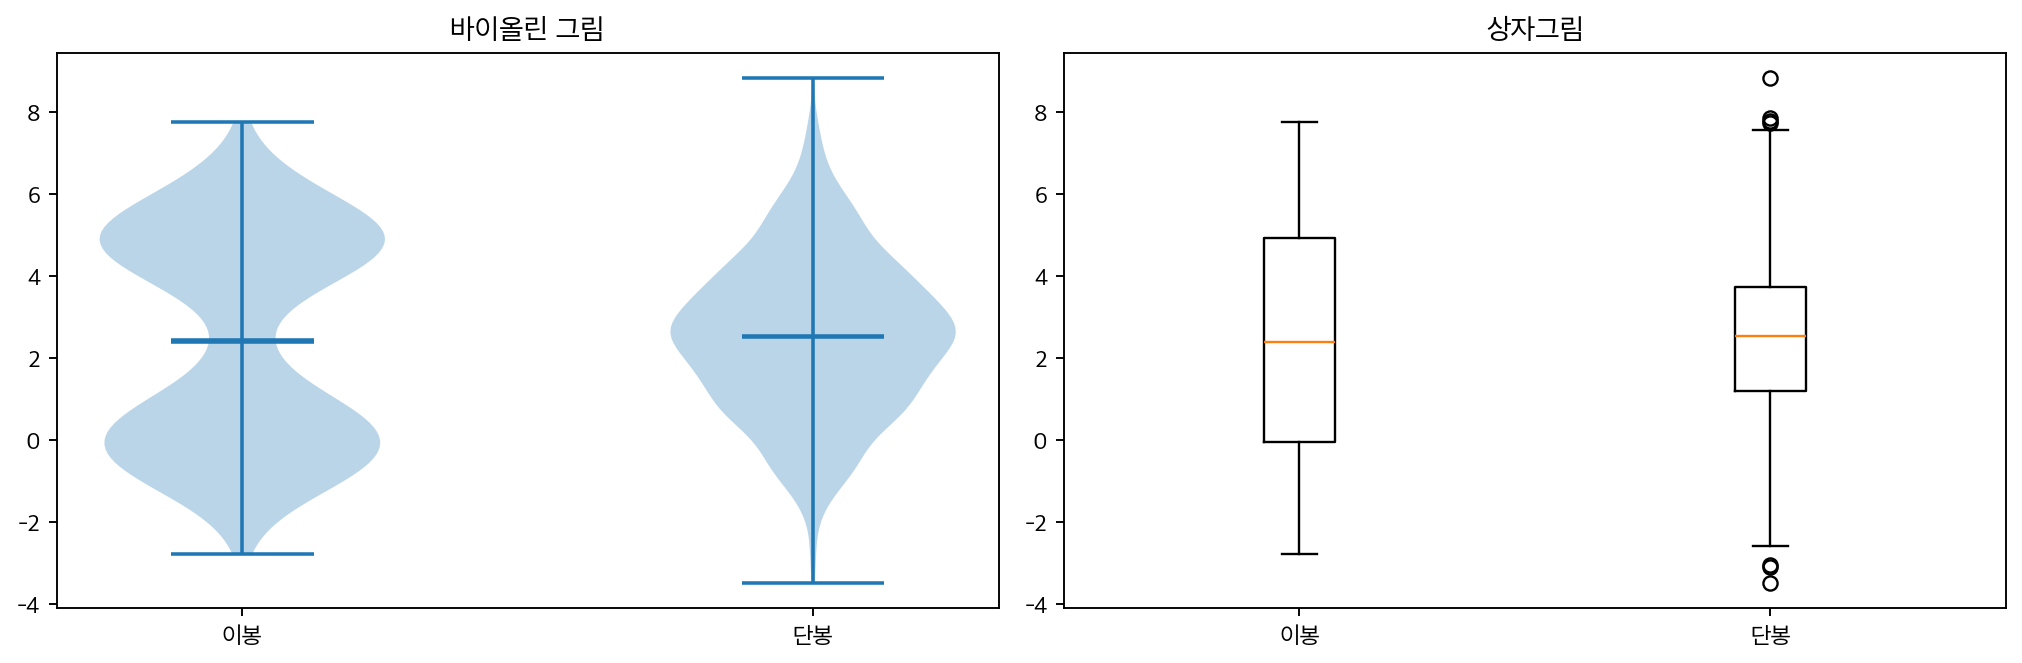
중심이 거의 같다. 평균이 2.45와 2.53, 중앙값이 2.40과 2.55다. 상자그림(오른쪽)이 알려 주는 것은 여기에 산포가 더해진 정도가 전부다. 이봉 자료의 상자가 더 길다는 것(\(\text{IQR}\)가 \(4.98\) 대 \(2.56\))은 보이지만, 왜 더 긴지는 말해 주지 않는다. 산포가 큰 단봉 분포여도 똑같은 상자가 나온다.
그런데 바이올린 그림(왼쪽)을 보면 이봉 자료가 가운데가 잘록한 두 덩어리임이 한눈에 드러난다.
이 차이가 중요한 이유는 실질적이다. 왼쪽 자료에서 "평균 근처인 2.5"는 가장 흔한 값이 아니라 가장 드문 값이다. 상자그림은 이 사실을 전혀 알려 주지 않는다.
(2) 봉우리를 지우는 대역폭. 해석적으로. 먼저 참 밀도가 언제 이봉인지 본다. 평균이 \(\pm\mu\)이고 분산이 \(\sigma^2\)인 두 정규를 반반 섞으면
이다(\(\varphi_\sigma\)는 \(N(0, \sigma^2)\)의 밀도함수다). 대칭이므로 \(x = 0\)은 언제나 정류점이다(\(f'(0) = 0\)). 가운데가 골인지 봉우리인지는 \(f''(0)\)의 부호가 정한다. \(\sigma = 1\)로 두고 계산하면
이므로
이다. 지수항은 늘 양수이니 부호는 \(\mu^2 - 1\)이 정한다. 곧 \(\mu > 1\)이면 \(f''(0) > 0\)이라 가운데가 골이고 봉우리가 둘, \(\mu < 1\)이면 가운데가 봉우리 하나다. 척도를 되살리면(\(x\)를 \(x/\sigma\)로 재면 \(\mu\) 자리에 \(\mu/\sigma\)가 온다)
이제 KDE를 끼워 넣는다. 대역폭 \(h\)인 가우스 커널밀도추정은 자료를 \(N(0, h^2)\)과 합성곱(convolution)한 것이다 — 관측값마다 \(N(x_i, h^2)\) 밀도를 하나씩 얹어 평균한 것이니, 자료의 분포에 \(N(0, h^2)\) 잡음을 더한 분포와 같다. 정규의 합성곱은 다시 정규이므로, 참 밀도를 추정하는 KDE가 보는 분포는 분산이 \(\sigma^2\)에서 \(\sigma^2 + h^2\)로 불어난 같은 혼합분포다. 중심 \(\pm\mu\)는 그대로다. 위 조건을 그대로 쓰면
이다. 우리 자료는 두 중심이 \(0\)과 \(5\)이므로 \(\mu = 2.5\), \(\sigma = 1\)이고
이다. 한편 scipy·matplotlib이 쓰는 스콧(Scott)의 기본 대역폭은 \(h_0 = \hat\sigma_{\text{전체}}\, n^{-1/5}\) 이고, 여기서 \(\hat\sigma_{\text{전체}} = 2.6706\), \(n^{-1/5} = 1000^{-1/5} = 0.2512\) 이므로 \(h_0 = 0.6708\) 이다. 따라서 기본 대역폭의 \(2.2913/0.6708 = 3.42\) 배를 넘기면 두 봉우리가 하나로 합쳐진다. 자료는 한 글자도 바뀌지 않았는데 말이다.
수치적으로.
from scipy.stats import gaussian_kde

n = len(data_1)
sd = data_1.std(ddof=1)
scott = n ** (-1 / 5)                 # scipy 의 'scott' 근사
h0 = sd * scott                       # 기본 대역폭
print(f"n = {n},  표본 sd = {sd:.4f},  n^(-1/5) = {scott:.4f}")
print(f"기본 대역폭  h0 = sd * n^(-1/5) = {h0:.4f}")

# 참값으로 본 임계 대역폭
mu, sig = 2.5, 1.0
h_crit = np.sqrt(mu ** 2 - sig ** 2)
print(f"참값   mu = {mu}, sigma = {sig} -> 임계 h = {h_crit:.4f}  (배율 {h_crit / h0:.4f})")

# 표본의 값으로 고쳐 본 임계 대역폭
a, b = data_1[:500], data_1[500:]
mu_h = (b.mean() - a.mean()) / 2
sg_h = np.sqrt((a.var(ddof=1) + b.var(ddof=1)) / 2)
h_crit2 = np.sqrt(mu_h ** 2 - sg_h ** 2)
print(f"표본   mu = {mu_h:.4f}, sigma = {sg_h:.4f} -> 임계 h = {h_crit2:.4f}  "
      f"(배율 {h_crit2 / h0:.4f})")


def peaks(factor):
    """대역폭을 기본의 factor 배로 준 KDE 의 봉우리 개수."""
    k = gaussian_kde(data_1, bw_method=factor * scott)
    xs = np.linspace(data_1.min() - 2, data_1.max() + 2, 4000)
    y = k(xs)
    m = (y[1:-1] > y[:-2]) & (y[1:-1] > y[2:])
    return int(m.sum()), xs, y


print("\n배율   대역폭 h   봉우리")
for f in [0.25, 0.5, 1.0, 2.0, 3.0, 3.4, 4.0]:
    print(f"{f:5.2f} {f * h0:8.4f} {peaks(f)[0]:7d}")

lo, hi = 1.0, 8.0                      # 이분법으로 실제 임계 배율을 찾는다
for _ in range(40):
    mid = (lo + hi) / 2
    lo, hi = (mid, hi) if peaks(mid)[0] >= 2 else (lo, mid)
print(f"\n실측 임계 배율 = {lo:.4f}   (h = {lo * h0:.4f})")

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 3.8),
                               gridspec_kw={"width_ratios": [1.4, 1]})
cols = {0.25: "#E65100", 1.0: "#1565C0", 3.4: "#6A1B9A"}
for f, c in cols.items():
    npk, xs, y = peaks(f)
    ax1.plot(xs, y, color=c, lw=1.8,
             label=f"배율 {f} (h = {f * h0:.2f}), 봉우리 {npk}개")
ax1.hist(data_1, bins=40, density=True, color="#CFD8DC", zorder=0)
ax1.set_xlabel("값")
ax1.set_ylabel("밀도")
ax1.set_title("같은 자료, 대역폭만 바꾼 KDE", fontsize=11)
ax1.legend(fontsize=9)
ax1.spines[["top", "right"]].set_visible(False)

for i, (f, c) in enumerate(cols.items(), start=1):
    pp = ax2.violinplot([data_1], positions=[i], widths=0.8,
                        showextrema=False, bw_method=f * scott)
    pp["bodies"][0].set_facecolor(c)
    pp["bodies"][0].set_alpha(0.55)
ax2.set_xticks([1, 2, 3])
ax2.set_xticklabels([f"배율 {f}" for f in cols])
ax2.set_title("같은 자료, 세 가지 바이올린", fontsize=11)
ax2.spines[["top", "right"]].set_visible(False)
plt.tight_layout()
plt.show()
출력:
n = 1000,  표본 sd = 2.6706,  n^(-1/5) = 0.2512
기본 대역폭  h0 = sd * n^(-1/5) = 0.6708
참값   mu = 2.5, sigma = 1.0 -> 임계 h = 2.2913  (배율 3.4157)
표본   mu = 2.4801, sigma = 0.9878 -> 임계 h = 2.2749  (배율 3.3912)

배율   대역폭 h   봉우리
 0.25   0.1677       3
 0.50   0.3354       2
 1.00   0.6708       2
 2.00   1.3416       2
 3.00   2.0124       2
 3.40   2.2808       1
 4.00   2.6833       1

실측 임계 배율 = 3.3120   (h = 2.2217)
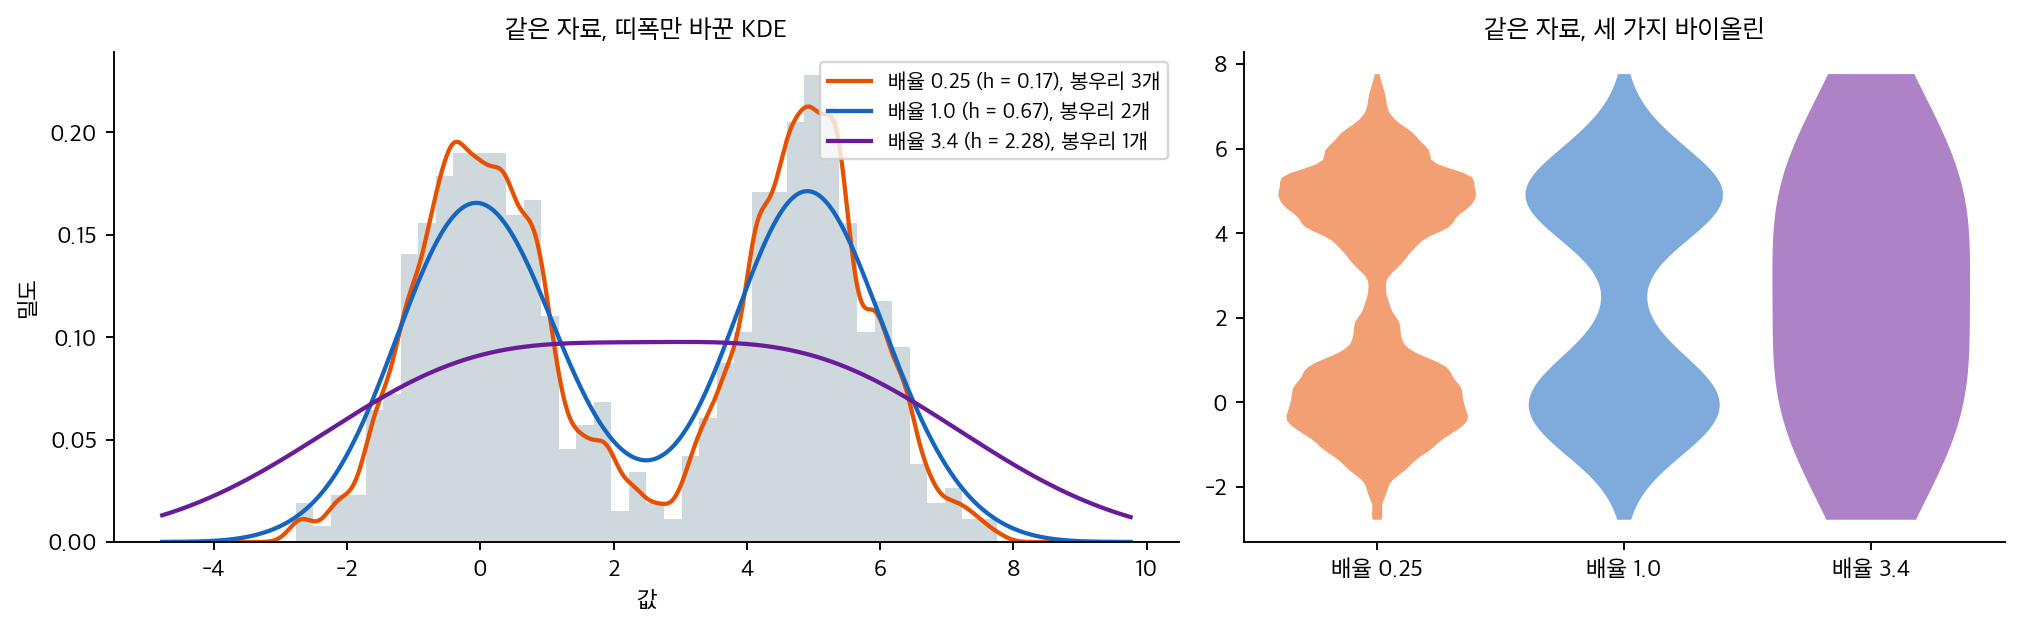
유도한 임계값이 맞는다. 참값으로 계산한 \(h_{\text{임계}} = 2.2913\), 표본의 중심과 군내 표준편차로 고쳐 계산한 값이 \(2.2749\), 봉우리를 실제로 세어 이분법으로 찾은 값이 \(2.2217\) 이다. 세 수가 \(3\%\) 안에서 일치한다. 표본으로 고친 쪽이 참값으로 계산한 쪽보다 실측값에 조금 더 가깝다 — 뽑힌 \(1000\)개의 두 무리 중심이 한가운데에서 \(\pm 2.5\) 가 아니라 \(\pm 2.4801\) 만큼 떨어져 있고 군내 표준편차도 \(1\)이 아니라 \(0.9878\) 이기 때문이다. 남은 \(2\%\) 는 표본이 두 정규의 혼합을 정확히 따르지는 않기 때문이고, 유도가 쓴 "KDE \(=\) 참밀도 \(*\,N(0,h^2)\)" 라는 등식도 \(n \to \infty\) 에서만 정확하다.
그래서 요점은 이것이다. 표의 배율 \(0.25\) 줄에서 봉우리가 셋이 되었다. 자료에는 무리가 둘뿐인데 대역폭이 너무 좁아 없는 봉우리를 하나 지어낸 것이다. 배율 \(3.4\) 에서는 거꾸로 있는 봉우리 하나를 지웠다. 그림 왼쪽 패널에서 세 곡선이 모두 같은 히스토그램 위에 그려져 있다는 것을 보라. 바이올린의 모양은 자료가 정하는 것이 아니라 자료와 대역폭이 함께 정한다. 바이올린을 하나만 보고 "봉우리가 둘이다"라고 말하려면 대역폭을 바꾸어 가며 그 봉우리가 버티는지 먼저 확인해야 한다.
3. 바이올린의 양 끝은 자료가 아니다¶
Seaborn은 집단화 기능이 내장된 더 다듬어진 바이올린 그림을 제공한다.
보기 2. Seaborn 으로 그리는 바이올린 그림, 그리고 바이올린의 양 끝은 자료가 아니다. 타이타닉 승객의 나이를 객실 등급과 성별로 갈라 split=True 바이올린으로 그린다.
(1) 그려 보고 표(등급·성별 중앙값과 평균)보다 무엇을 더 읽을 수 있는지 수치와 함께 적으시오.
(2) 그린 바이올린은 나이가 음수인 자리까지 뻗어 있다. 그 아래 끝이 정확히 어디에 놓이는지 식으로 구하고, 그림에서 실제 꼭짓점을 꺼내 맞는지 확인하시오. KDE 가 \(0\)세 미만에 두는 확률질량도 재시오.
풀이
(1) 그려 본다.
import seaborn as sns
import pandas as pd
import matplotlib.pyplot as plt

# 그림에 한글이 들어가므로 한글 글꼴을 지정한다(지정하지 않으면 네모로 깨진다).
plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams['axes.unicode_minus'] = False

# 자료를 인터넷에서 내려받으므로 실행에 연결이 필요하다.
url = "https://raw.githubusercontent.com/datasciencedojo/datasets/f0ccab6a7ceafdff780052166fb6fab3311398eb/titanic.csv"
df = pd.read_csv(url)

# 그림에 앞서 숫자로 먼저 확인한다. Age에 결측이 있어 count가 891보다 작다.
print(df.groupby(["Pclass", "Sex"])["Age"]
        .agg(["count", "median", "mean"]).round(1))

fig, ax = plt.subplots(figsize=(10, 4))

# x   : 바이올린을 나눌 기준 (객실 등급 1, 2, 3)
# y   : 분포를 볼 값 (나이)
# hue : 색으로 구분할 두 번째 범주 (성별)
# split=True : 두 색을 하나의 바이올린 좌우에 붙여 그린다.
#              범주가 정확히 둘일 때만 쓸 수 있고, 같은 등급 안에서
#              남녀를 곧바로 견주어 볼 수 있게 해 준다.
# 범례에 한글이 나오도록 값 자체를 한글로 바꾼 열을 따로 만든다.
# ax.legend(labels=[...]) 로 이름만 갈아 끼우면 색과 이름이 어긋날 위험이 있다.
df["성별"] = df["Sex"].map({"male": "남성", "female": "여성"})

sns.violinplot(data=df, x="Pclass", y="Age", hue="성별",
               hue_order=["여성", "남성"], split=True, ax=ax)
ax.set_title("객실 등급과 성별에 따른 나이 분포 (타이타닉)")
ax.set_xlabel("객실 등급")
ax.set_ylabel("나이 (세)")
plt.show()
출력:
               count  median  mean
Pclass Sex
1      female     85    35.0  34.6
       male      101    40.0  41.3
2      female     74    28.0  28.7
       male       99    30.0  30.7
3      female    102    21.5  21.8
       male      253    25.0  26.5
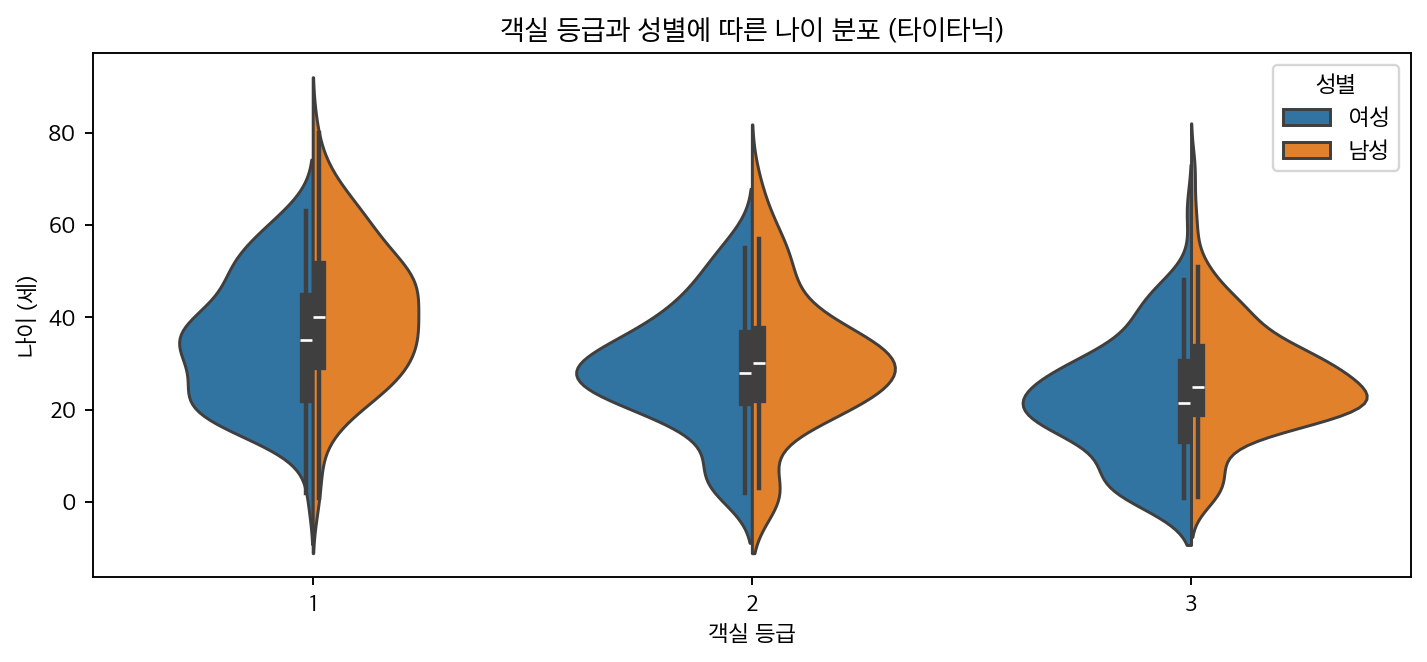
split=True가 두 색을 하나의 바이올린 좌우에 붙여 놓아, 등급마다 남녀를 곧바로 견줄 수 있다.
그림에서 읽히는 것이 표보다 많다.
- 등급이 낮아질수록 젊어진다. 중앙값이 1등급 35–40세, 2등급 28–30세, 3등급 21.5–25세로 내려간다.
- 2·3등급 아래쪽에 어린이 혹이 있다. 나이가 알려진 승객 가운데 10세 이하의 비율이 1등급 \(3/186 = 1.6\%\), 2등급 \(17/173 = 9.8\%\), 3등급 \(44/355 = 12.4\%\)다. 그래서 0–10세 구간이 2등급과 3등급에서 불룩하고 1등급에서는 거의 평평하다. 표의 중앙값과 평균만으로는 보이지 않는 특징이다.
- 위쪽 꼬리는 1등급이 가장 두껍다. 최고령이 1등급 80세, 2등급 70세, 3등급 74세이고 65세 이상이 각각 6명, 2명, 3명이다. 다만 세 바이올린의 세로 길이 차이가 크지 않은 것은 KDE가 꼬리를 매끄럽게 늘여 놓기 때문이며, 바이올린의 끝을 자료의 최댓값으로 읽어서는 안 된다.
- 모든 등급에서 남성이 조금 더 나이가 많다. 다만 그 차이는 등급 간 차이보다 훨씬 작다.
두 번째 항목이 바이올린 그림의 값어치를 잘 보여 준다. 어린이 무리는 분포에 작은 두 번째 봉우리를 만드는데, 상자그림이라면 그저 아래쪽 수염이 길어질 뿐이라 놓치기 쉽다.
(2) 바이올린의 아래 끝은 어디인가. 해석적으로. seaborn은 KDE를 그릴 격자를 자료 범위 그대로가 아니라 양옆으로 대역폭의 cut 배만큼 늘려서 잡는다. 기본값이 cut=2 이므로 격자는
이고, 바이올린의 꼭짓점도 정확히 거기까지 간다. 대역폭 \(h\)는 스콧의 근사 \(h = \hat\sigma n^{-1/5}\) 이고 집단마다 따로 계산된다.
왜 자료 밖까지 그리는가. 가우스 커널은 꼬리가 무한하므로 KDE 는 자료 밖에서도 \(0\)이 아니다. cut=2 는 그 꼬리를 "거의 다" 보여 주겠다는 뜻이다. 문제는 나이처럼 아래가 막힌 양에서 그 꼬리가 물리적으로 불가능한 자리로 넘어간다는 것이다. 1등급 남성은 \(x_{\min} = 0.92\), \(h = 6.0152\) 이므로 아래 끝이
가 된다. 꼬리가 넘어간 질량도 바로 적을 수 있다. 가우스 KDE 는 커널을 관측값마다 하나씩 얹은 것이므로 \(0\) 미만의 추정 질량은 각 커널이 \(0\) 아래에 남긴 몫의 평균이다.
수치적으로.
import numpy as np
from scipy.stats import gaussian_kde, norm

aged = df.dropna(subset=["Age"])
print(f"{'집단':<10}{'n':>5}{'최소':>7}{'bw':>8}{'예측 아래끝':>12}{'0세 미만 질량':>13}")
for (pc, sx), g in aged.groupby(["Pclass", "성별"]):
    x = g["Age"].values
    bw = np.sqrt(gaussian_kde(x, bw_method="scott").covariance[0, 0])
    lo = x.min() - 2 * bw                      # cut = 2 가 기본값
    print(f"{f'{pc}등급 {sx}':<10}{len(x):>5}{x.min():>7.2f}{bw:>8.4f}{lo:>12.4f}"
          f"{norm.cdf((0 - x) / bw).mean():>13.4f}")

fig, axes = plt.subplots(1, 2, figsize=(12, 4), sharey=True)
for ax, cut in zip(axes, [2, 0]):
    sns.violinplot(data=df, x="Pclass", y="Age", hue="성별",
                   hue_order=["여성", "남성"], split=True, cut=cut, ax=ax)
    ax.axhline(0, color="#D32F2F", ls="--", lw=1.4)
    ax.set_title(f"cut = {cut}", fontsize=11)
    ax.set_xlabel("객실 등급")
    ax.set_ylabel("나이 (세)" if cut == 2 else "")
    ax.spines[["top", "right"]].set_visible(False)
    if cut:
        ax.legend(fontsize=9, loc="upper right")
    else:
        ax.get_legend().remove()

# 그려 놓은 다각형에서 꼭짓점을 직접 꺼내 예측과 맞춰 본다.
fig.canvas.draw()
print("\n왼쪽(cut=2) 바이올린 꼭짓점의 실제 아래끝:")
for coll in axes[0].collections:
    if coll.get_paths():
        print(f"   {coll.get_paths()[0].vertices[:, 1].min():.4f}")
print("오른쪽(cut=0):")
for coll in axes[1].collections:
    if coll.get_paths():
        print(f"   {coll.get_paths()[0].vertices[:, 1].min():.4f}")
plt.tight_layout()
plt.show()
출력:
집단            n     최소      bw      예측 아래끝     0세 미만 질량
1등급 남성      101   0.92  6.0152    -11.1104       0.0072
1등급 여성       85   2.00  5.5981     -9.1962       0.0045
2등급 남성       99   0.67  5.9014    -11.1328       0.0332
2등급 여성       74   2.00  5.4428     -8.8856       0.0218
3등급 남성      253   0.42  4.0206     -7.6212       0.0155
3등급 여성      102   0.75  5.0479     -9.3457       0.0480

왼쪽(cut=2) 바이올린 꼭짓점의 실제 아래끝:
   -9.1962
   -11.1104
   -8.8856
   -11.1328
   -9.3457
   -7.6212
오른쪽(cut=0):
   2.0000
   0.9200
   2.0000
   0.6700
   0.7500
   0.4200
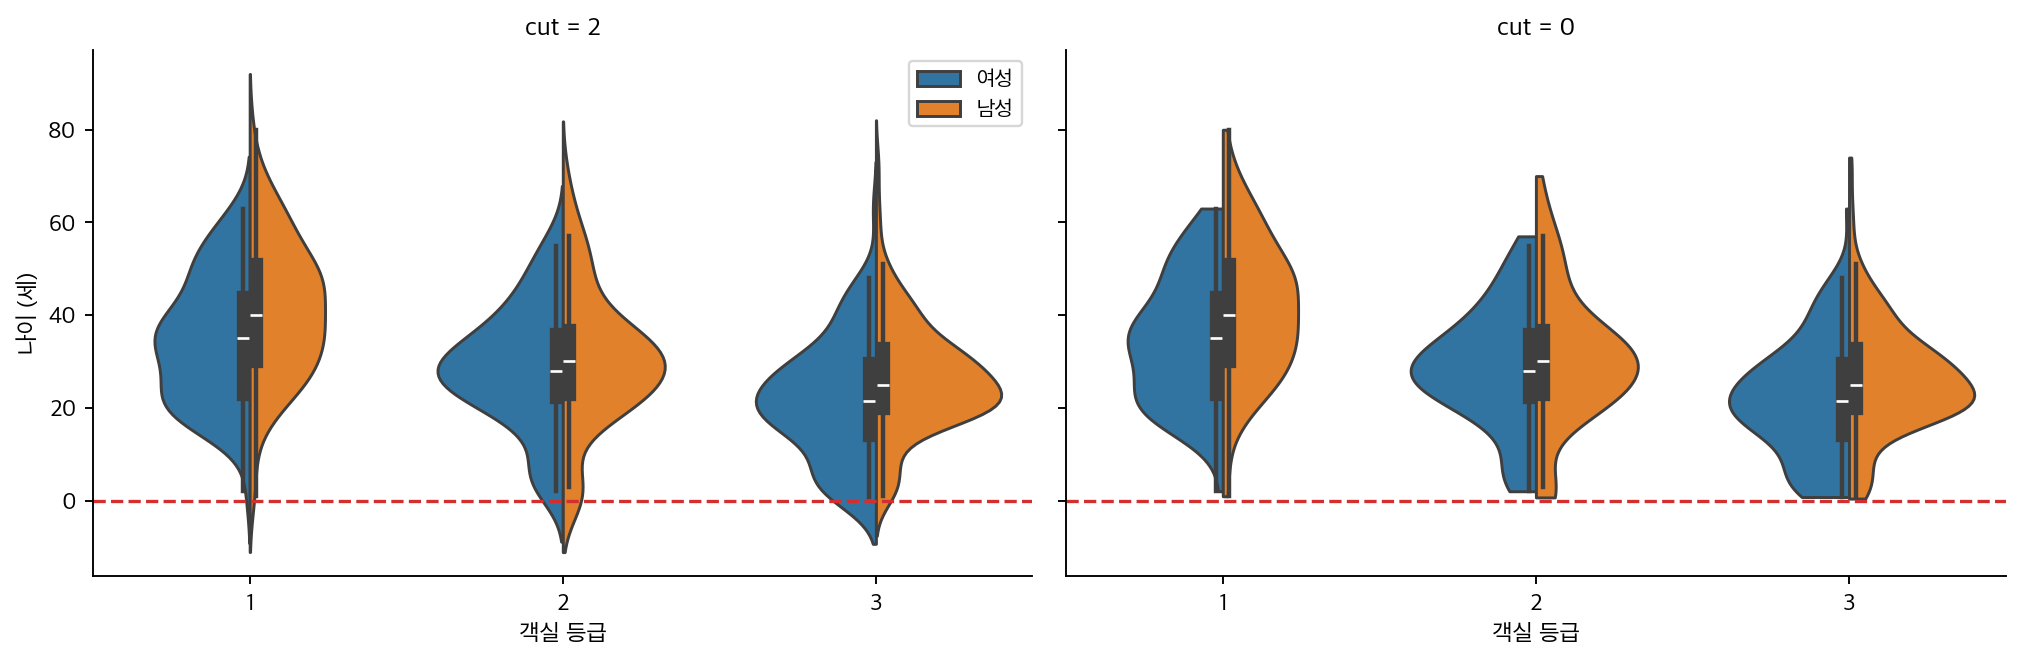
예측이 소수 넷째 자리까지 맞는다. 여섯 개의 반쪽 바이올린 모두 \(x_{\min} - 2h\) 와 실제 꼭짓점이 같다. \(-9.1962, -11.1104, -8.8856, -11.1328, -9.3457, -7.6212\) 가 두 목록에 그대로 나타난다. 그리고 cut=0 으로 바꾸면 아래 끝이 \(2.00, 0.92, 2.00, 0.67, 0.75, 0.42\) — 각 집단의 실제 최연소 승객 나이가 된다.
그러니 바이올린의 길이는 자료의 범위가 아니다. 1등급 남성 바이올린은 위로도 \(80 + 2\times 6.0152 = 92.03\) 세까지 뻗는다. 타이타닉에 \(92\)세는 타지 않았다. 양 끝 \(2h\) 는 순전히 그림이 덧붙인 것이고, \(h\) 가 집단마다 다르므로 덧붙는 길이도 집단마다 다르다. 3등급 남성은 \(n = 253\) 으로 가장 많아 \(h = 4.02\) 로 가장 작고, 그래서 양 끝이 \(8\)세어치만 늘어난다. 1등급 남성은 \(h = 6.02\) 라 \(12\)세어치가 늘어난다. 표본이 클수록 꼬리가 덜 늘어난다. 바이올린 길이를 집단끼리 견주는 것이 왜 위험한지가 여기 있다.
넘어간 질량도 작지 않다. 3등급 여성은 추정 밀도의 \(4.80\%\) 가 \(0\)세 미만에 놓인다. 2등급 남성은 \(3.32\%\) 다. 백 명 가운데 다섯 명이 태어나기 전이라는 그림이다. 이것은 KDE 가 경계가 있는 양을 모르기 때문에 생기는 전형적인 경계 인공물이고, 어린이 혹이 있는 집단일수록(곧 \(0\) 가까이에 관측이 몰린 집단일수록) 심하다. cut=0 은 넘어간 부분을 잘라내는 처방이지 넘어가지 않게 고치는 처방이 아니다. 잘라도 그 질량은 남은 곡선 안에 잘못 들어가 있다. 더 나은 교정법은 연습문제 9에서 다룬다.
4. 바이올린 그림을 쓸 때¶
바이올린 그림은 집단 간 분포의 모양을 비교할 때, 특히 분포가 비정규이거나 다봉일 수 있을 때 가장 가치가 크다. 중앙값과 IQR만이 중요한 단순한 비교라면 상자그림이 더 간결하고 읽기 쉽다.
AI로 보는 통계학 1. 바이올린은 자료가 없는 곳까지 그린다
바이올린의 윤곽은 커널밀도추정이다. 커널은 관측마다 매끄러운 봉우리를 얹으므로 자료의 양끝 바깥에도 밀도가 남는다. seaborn 은 기본값으로 그 꼬리를 대역폭의 두 배만큼 더 그린다(cut=2). 눈에 잘 띄지 않는 선택인데, 시드별 점수처럼 관측이 몇 개뿐인 자료에서는 그림의 절반을 만들어 낸다.
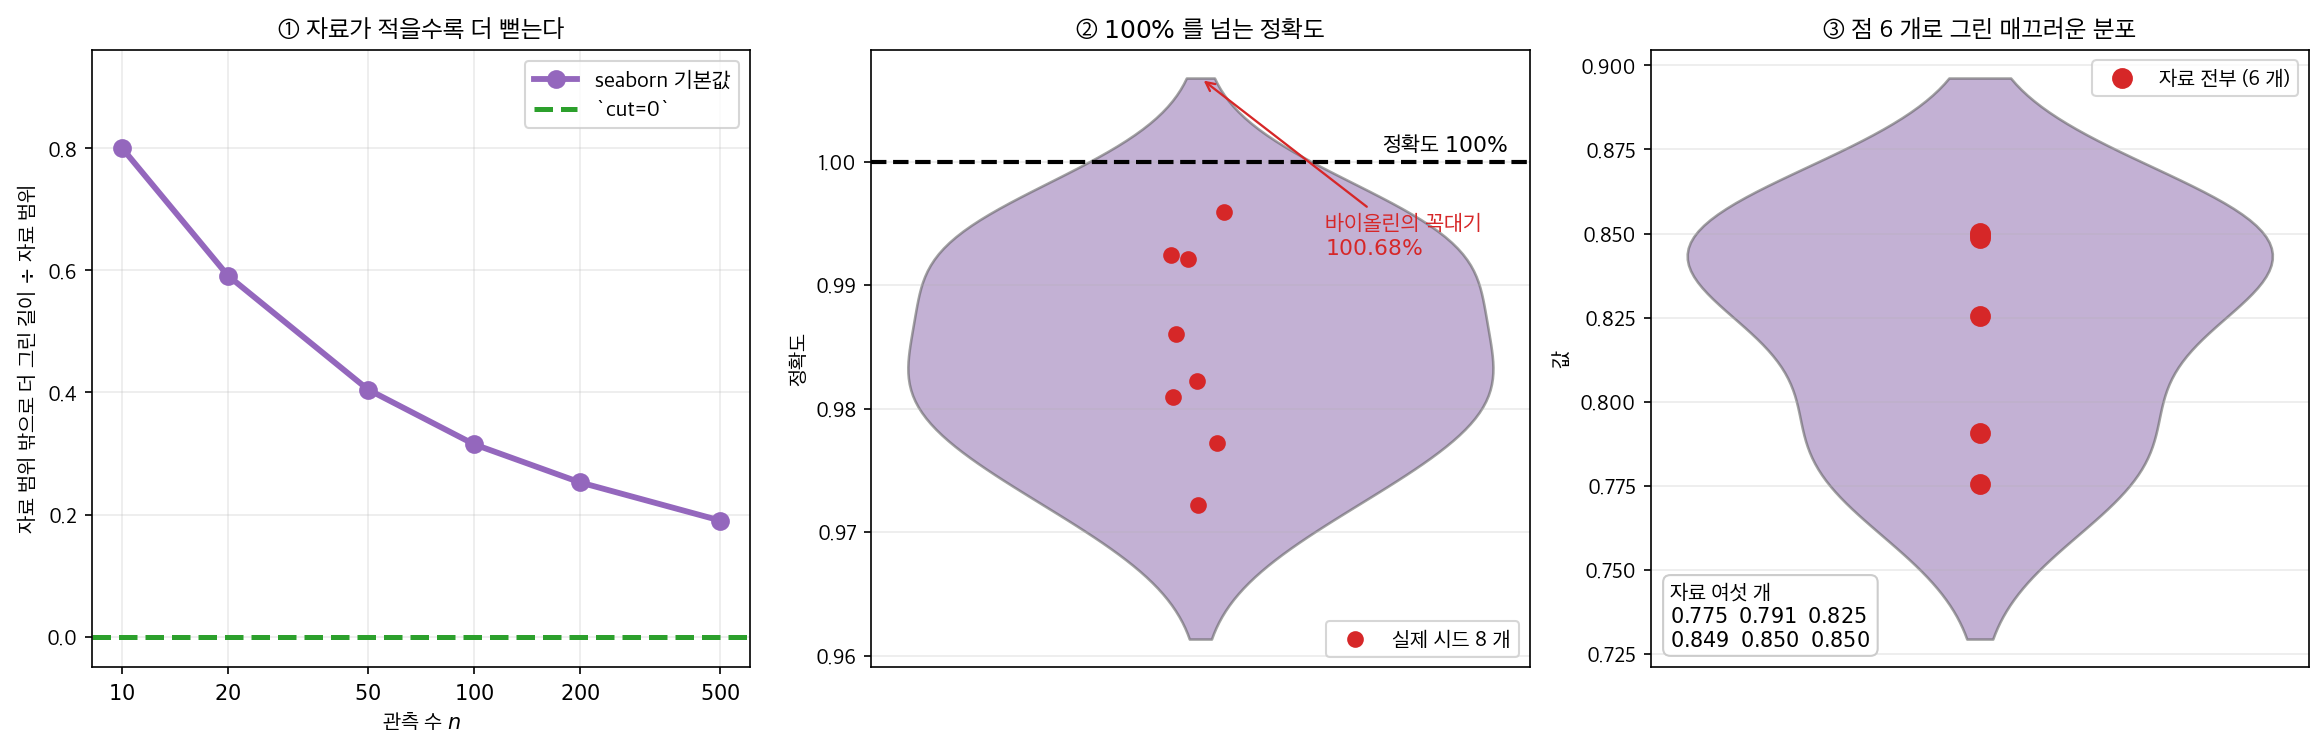
① 자료가 적을수록 더 뻗는다. 표준정규에서 \(n\) 개를 뽑아 바이올린을 그리고, 자료 범위 밖으로 더 그려진 길이를 자료 범위로 나누었다(\(200\) 번 평균).
| \(n\) | \(10\) | \(20\) | \(50\) | \(100\) | \(500\) |
|---|---|---|---|---|---|
| 자료 밖으로 더 그린 몫 | \(\mathbf{0.80}\) | \(0.59\) | \(0.41\) | \(0.32\) | \(0.19\) |
\(n = 10\) 이면 자료가 차지한 구간만큼을 한 번 더 그린다. 관측이 적을수록 대역폭이 넓어지는데 자료 범위는 좁아지니, 비율로는 두 배로 나빠진다. cut=0 으로 두면 어느 \(n\) 에서도 정확히 \(0\) 이다.
② 그래서 \(100\%\) 를 넘는 정확도가 나온다. 시드 여덟 개의 정확도가 \(0.9722\)–\(0.9959\) 인 자료로 기본값 바이올린을 그리면 위쪽 끝이 \(\mathbf{1.0068}\), 곧 \(100.68\%\) 다. 정확도·재현율·\(F_1\) 처럼 \(1\) 에서 끊기는 지표, \(0\) 에서 끊기는 지연시간이나 손실값에서 이 그림은 있을 수 없는 값에 질량을 준다. 그림 ②에서 붉은 점 여덟 개는 모두 검은 선 아래에 있는데 보라색 몸통만 선을 넘는다.
③ 여섯 개로도 분포가 그려진다. 값이 여섯 개뿐인 자료(\(0.775\)–\(0.850\))로 그려도 바이올린은 매끄러운 곡선을 낸다. 그림이 덮는 세로 길이 가운데 \(55\%\) 는 자료가 아니라 커널이 만든 것이고, 허리가 잘록한 모양도 점 여섯 개의 간격이 우연히 만든 것이지 분포의 성질이 아니다.
위 문단은 "분포가 비정규이거나 다봉일 수 있을 때 가장 가치가 크다"고 했다. 그 말에 조건을 하나 붙여야 한다 — 관측이 충분할 때. 관측이 적으면 바이올린이 보여 주는 모양은 자료의 모양이 아니라 커널의 모양이다.
실무로는 셋이다.
cut=0을 기본으로 둔다. 자료 끝에서 그림도 끝난다. 한 글자 고치는 일이다.- 점을 함께 찍는다.
inner="point"나 스트립을 겹치면 ③처럼 "실은 여섯 개였다"가 바로 보인다. - \(n\) 이 수십 아래면 바이올린을 쓰지 않는다. 점을 그대로 찍는 것이 더 정직하고 더 많이 말한다.
5. 집단을 나란히 놓고 본다¶
바이올린의 쓸모가 가장 분명해지는 자리는 집단이 여럿일 때다. 상자그림과 나란히 놓으면 무엇이 요약에서 지워지는지가 바로 보이고, 집단마다 모양이 다를 때는 바이올린만이 그것을 말해 준다. 다만 집단이 많아지면 그림 자체가 새로운 함정을 만든다 — 보기 3 과 4 가 그 둘을 함께 다룬다.
보기 3. 항공사별 지연. 네 항공사의 일간 지연율을 서로 다른 감마분포에서 \(100\)개씩 뽑아 상자그림과 바이올린 그림으로 견준다. 모수는 American \((2, 3)\), Delta \((1.5, 2.5)\), Southwest \((1.2, 2)\), United \((1.8, 3.2)\) 이다(모양, 척도).
(1) 두 그림을 그리고 무엇이 읽히는지 적으시오.
(2) 네 분포의 참 평균·표준편차·중앙값을 구해 표본이 재현하는지 보시오. 특히 American과 United의 산포 차이가 실제 모형의 차이인지 표집 변동인지 따지시오.
풀이
(1) 그려 본다.
설정. 항공편 지연은 승객의 이동 계획과 항공사 운영에 중요하다. 여기서는 네 항공사의 일간 지연율 분포를 비교한다. 각 항공사의 지연은 서로 다른 모양 및 척도 모수를 갖는 감마분포에서 뽑았으며, 이는 서로 다른 운영 특성을 반영한다.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

# 그림에 한글을 쓰므로 한글 글꼴을 지정한다. 후보를 늘어놓으면 matplotlib 가
# 설치된 첫 번째를 집으므로, 리눅스('NanumGothic')·맥('Apple SD Gothic Neo')·
# 윈도우('Malgun Gothic')에서 코드를 고치지 않고 그대로 돌릴 수 있다.
# 글꼴을 바꾸면 마이너스 기호가 깨지므로 unicode_minus 도 함께 꺼 준다.
plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams['axes.unicode_minus'] = False

np.random.seed(42)
airlines = ['American', 'Delta', 'Southwest', 'United']
n_obs = 100

# 감마분포는 0 이상이고 오른쪽으로 치우쳐 있어 지연율 모형에 적합하다.
# (shape, scale)로 모양과 척도를 따로 정한다. 평균은 shape x scale이다.
params = {
    'American':  (2,   3),    # 평균 6.0 — 지연이 잦은 편
    'Delta':     (1.5, 2.5),  # 평균 3.75 — 중간
    'Southwest': (1.2, 2),    # 평균 2.4 — 지연이 적음
    'United':    (1.8, 3.2),  # 평균 5.76 — American과 비슷하나 산포가 크다
}

data_list = []
for airline in airlines:
    shape, scale = params[airline]
    delays = np.random.gamma(shape=shape, scale=scale, size=n_obs)
    for delay in delays:
        data_list.append({'airline': airline, 'pct_carrier_delay': delay})

airline_stats = pd.DataFrame(data_list)

# 그림을 그리기 전에 숫자로 확인한다
print(airline_stats.groupby('airline')['pct_carrier_delay']
      .agg(['count', 'mean', 'median', 'std', 'max']).round(2))
출력:
           count  mean  median   std    max
airline
American     100  5.76    5.09  3.68  21.89
Delta        100  3.77    3.08  2.82  14.69
Southwest    100  2.31    1.67  2.08   9.07
United       100  6.18    5.09  4.92  24.20
American과 United의 중앙값이 5.09로 완전히 같다. 그런데 표준편차는 3.68과 4.92로 3분의 1 이상 차이 나고, 최댓값도 21.89와 24.20으로 다르다. 이 쌍이 다음 두 그림에서 어떻게 보이는지가 이 보기의 핵심이다.
상자그림으로 보기.
fig, ax = plt.subplots(figsize=(8, 5))

# by=     이 열의 값으로 집단을 나눈다
# column= 분포를 볼 열
airline_stats.boxplot(by='airline', column='pct_carrier_delay', ax=ax)

ax.set_xlabel('항공사')
ax.set_ylabel('지연 항공편의 일간 비율 (%)')
ax.set_title('항공사별 지연 비교: 상자그림')
plt.suptitle('')      # pandas가 자동으로 붙이는 제목을 지운다
plt.tight_layout()
plt.show()
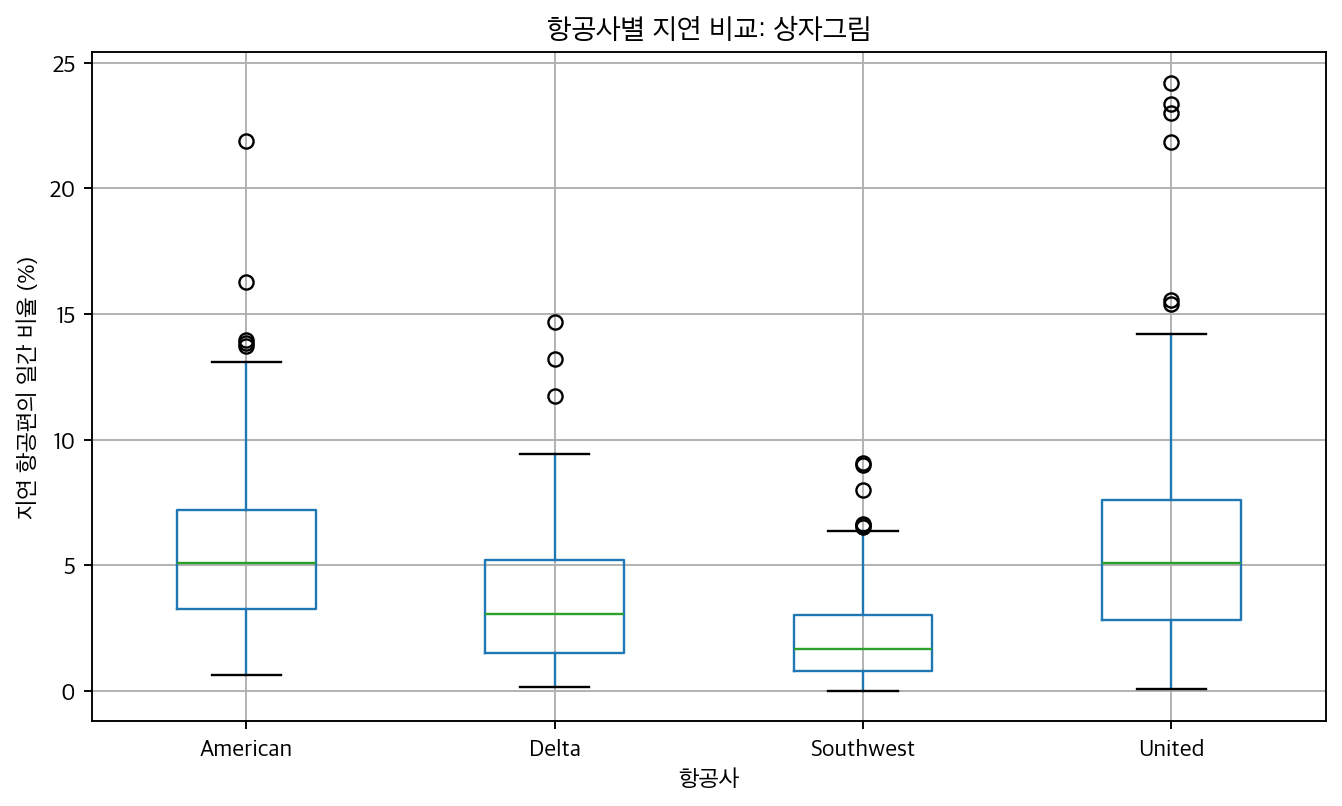
상자그림은 이렇게 읽는다.
- 상자는 \(Q_1\)에서 \(Q_3\)까지 뻗는다(지연의 가운데 50%).
- 상자 안의 선이 중앙값이다.
- 수염은 \(1.5 \times \text{IQR}\) 안의 가장 극단적인 관측값까지 뻗는다.
- 수염 너머의 점들이 이상치다.
바이올린 그림으로 보기.
fig, ax = plt.subplots(figsize=(8, 5))

# inner='quartile' 로 바이올린 안에 사분위수 선을 그려 넣으면
# 상자그림의 정보를 잃지 않으면서 밀도까지 함께 볼 수 있다.
sns.violinplot(data=airline_stats, x='airline', y='pct_carrier_delay',
               ax=ax, inner='quartile', color='lightblue')

ax.set_xlabel('항공사')
ax.set_ylabel('지연 항공편의 일간 비율 (%)')
ax.set_title('항공사별 지연 비교: 바이올린 그림')
plt.tight_layout()
plt.show()
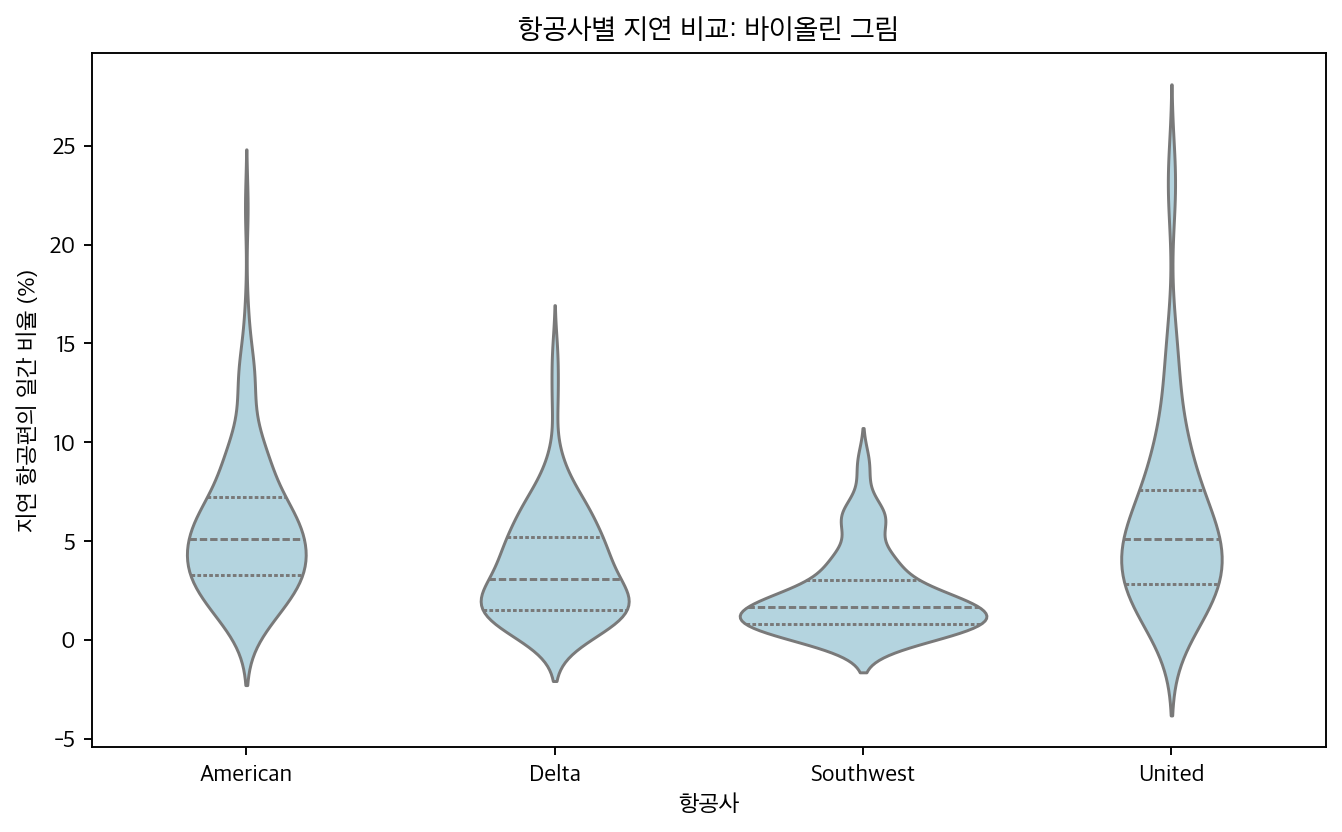
바이올린 그림은 이렇게 읽는다.
- 넓은 부분은 그 지연 수준에 관측값이 많음을 나타낸다.
- 좁은 부분은 관측값이 적음을 나타낸다.
- 치우친 모양은 지연 분포가 비대칭임을 나타낸다. 네 바이올린이 모두 아래쪽이 불룩하고 위로 길게 늘어져 있는데, 자료를 감마분포에서 뽑았으니 예상대로다.
- 이봉 모양(혹이 둘)이 보이면 전형적인 지연 시나리오가 둘이라는 뜻이겠지만, 이 그림에서는 그렇게 읽으면 안 된다. Southwest의 6 부근에 작은 혹이 하나 보이는데, 자료를 봉우리가 하나뿐인 감마분포에서 뽑았으니 참 분포에는 그런 혹이 없다. 집단당 \(n\)이 100뿐이라 KDE가 표집 잡음을 봉우리로 그려 낸 것이다(연습문제 7).
바이올린의 아래쪽 끝이 0 미만까지 내려가 있다
지연 비율은 \(0\) 이상인 양인데도 네 바이올린 모두 꼬리가 음수 구간까지 뻗어 있다. KDE가 관측값 주위에 커널을 대칭으로 놓아 생기는 경계 인공물이며, sns.violinplot(..., cut=0) 으로 자료 범위 밖을 잘라내야 한다(연습문제 9).
해석.
네 항공사의 순서는 두 그림에서 똑같이 읽힌다. Southwest가 가장 낮고, Delta가 중간이며, American과 United가 높다.
흥미로운 것은 American과 United의 비교다. 앞의 출력에서 두 항공사의 중앙값이 5.09로 완전히 같았다.
- 상자그림에서 두 중앙값 선의 높이가 같다. 상자의 세로 길이가 United 쪽이 조금 길지만(\(\text{IQR}\) \(4.78\) 대 \(3.95\)) 한눈에 들어올 만큼은 아니다. 이상치로 찍힌 점도 \(6\)개 대 \(5\)개로 비슷하다.
- 바이올린 그림에서는 United의 몸통이 위로 길게 늘어져 있어, 지연이 큰 날이 American보다 잦다는 사실이 곧바로 보인다.
숫자로도 확인된다. 표준편차가 3.68 대 4.92이고 최댓값이 21.89 대 24.20이다. "평균 지연이 비슷한 두 항공사"라도 승객이 겪는 위험은 다르다. 어쩌다 한 번의 큰 지연이 더 잦기 때문이다.
이것이 바이올린 그림을 함께 그리는 이유다. 중앙값이 같다는 사실은 두 분포가 같다는 뜻이 아니다.
(2) 참값과 표본. 해석적으로. 모양 \(k\), 척도 \(\theta\) 인 감마분포의 평균과 분산은
이다(중앙값은 닫힌 꼴이 없어 수치로 푼다). 네 항공사에 넣어 보자.
| 항공사 | \(k\) | \(\theta\) | 참 평균 \(k\theta\) | 참 SD \(\sqrt{k}\theta\) |
|---|---|---|---|---|
| American | \(2\) | \(3\) | \(6.0000\) | \(4.2426\) |
| Delta | \(1.5\) | \(2.5\) | \(3.7500\) | \(3.0619\) |
| Southwest | \(1.2\) | \(2\) | \(2.4000\) | \(2.1909\) |
| United | \(1.8\) | \(3.2\) | \(5.7600\) | \(4.2933\) |
여기서 멈추어 보아야 한다. American과 United의 참 표준편차가 \(4.2426\) 과 \(4.2933\) 으로 거의 같다. 비가 \(1.0119\) 다. 그런데 (1)의 표본은 \(3.68\) 과 \(4.92\) 를 주었고, 비가 \(1.336\) 이다. "United가 American보다 3분의 1 더 퍼져 있다"는 읽기가 모형에는 없는 것이다.
표본 표준편차가 얼마나 흔들리는지를 보면 설명이 된다. \(n = 100\) 이고 분포가 오른쪽으로 치우쳐 있으면 \(s\) 의 변동이 상당하다. 두 표본 표준편차의 비가 어느 범위를 오가는지는 같은 모형에서 다시 뽑아 보면 바로 나온다.
수치적으로.
from scipy import stats

samp = {a: airline_stats.loc[airline_stats.airline == a,
                             'pct_carrier_delay'].to_numpy()
        for a in airlines}

print(f"{'항공사':<11}{'참 평균':>9}{'참 sd':>9}{'참 중앙값':>11}"
      f"{'표본 평균':>11}{'표본 sd':>10}{'표본 중앙값':>12}")
for a in airlines:
    sh, sc = params[a]
    x = samp[a]
    print(f"{a:<11}{sh*sc:>9.4f}{np.sqrt(sh)*sc:>9.4f}"
          f"{stats.gamma.ppf(0.5, sh, scale=sc):>11.4f}"
          f"{x.mean():>11.4f}{x.std(ddof=1):>10.4f}{np.median(x):>12.4f}")

sd_a, sd_u = np.sqrt(2)*3, np.sqrt(1.8)*3.2
print(f"\n참 sd:  American {sd_a:.4f},  United {sd_u:.4f}  ->  비 {sd_u/sd_a:.4f}")
obs = samp['United'].std(ddof=1)/samp['American'].std(ddof=1)
print(f"표본 sd 비 = {obs:.4f}")

rng = np.random.default_rng(1)
ratios = np.array([rng.gamma(1.8, 3.2, 100).std(ddof=1)
                   / rng.gamma(2, 3, 100).std(ddof=1) for _ in range(20000)])
print(f"\n같은 모형에서 n=100 으로 20000 번 다시 뽑았을 때 표본 sd 비의 분포")
print(f"  중앙값 {np.median(ratios):.4f},  95% 구간 "
      f"[{np.quantile(ratios,0.025):.4f}, {np.quantile(ratios,0.975):.4f}]")
print(f"  관측된 {obs:.4f} 는 이 분포의 {100*(ratios<obs).mean():.1f} 분위수")

fig, (a1, a2) = plt.subplots(1, 2, figsize=(12, 3.6))
grid = np.linspace(0, 25, 500)
cols = {"American": "#1565C0", "United": "#E65100"}
for a in ["American", "United"]:
    sh, sc = params[a]
    a1.plot(grid, stats.gamma.pdf(grid, sh, scale=sc), color=cols[a], lw=2,
            label=f"{a} 참 분포 (sd = {np.sqrt(sh)*sc:.3f})")
    a1.hist(samp[a], bins=25, density=True, color=cols[a], alpha=0.25)
a1.set_xlabel("지연 비율 (%)")
a1.set_ylabel("밀도")
a1.set_title("참 분포는 산포가 거의 같다", fontsize=11)
a1.legend(fontsize=9)

a2.hist(ratios, bins=60, color="#DCEBFB", edgecolor="#90A4AE", lw=0.3)
a2.axvline(sd_u/sd_a, color="#1565C0", lw=2, label=f"참 비 {sd_u/sd_a:.4f}")
a2.axvline(obs, color="#D32F2F", lw=2, label=f"이 표본의 비 {obs:.4f}")
for q in [0.025, 0.975]:
    a2.axvline(np.quantile(ratios, q), color="#37474F", ls=":", lw=1.2)
a2.set_xlabel("표본 sd 비 (United / American)")
a2.set_ylabel("빈도")
a2.set_title("n = 100 이면 비가 0.74 ~ 1.37 사이를 오간다", fontsize=11)
a2.legend(fontsize=9)
for ax in (a1, a2):
    ax.spines[["top", "right"]].set_visible(False)
plt.tight_layout()
plt.show()
출력:
항공사             참 평균     참 sd      참 중앙값      표본 평균     표본 sd      표본 중앙값
American      6.0000   4.2426     5.0350     5.7575    3.6792      5.0924
Delta         3.7500   3.0619     2.9575     3.7739    2.8208      3.0805
Southwest     2.4000   2.1909     1.7759     2.3074    2.0814      1.6691
United        5.7600   4.2933     4.7355     6.1765    4.9154      5.0893

참 sd:  American 4.2426,  United 4.2933  ->  비 1.0119
표본 sd 비 = 1.3360

같은 모형에서 n=100 으로 20000 번 다시 뽑았을 때 표본 sd 비의 분포
  중앙값 1.0118,  95% 구간 [0.7402, 1.3745]
  관측된 1.3360 는 이 분포의 96.2 분위수
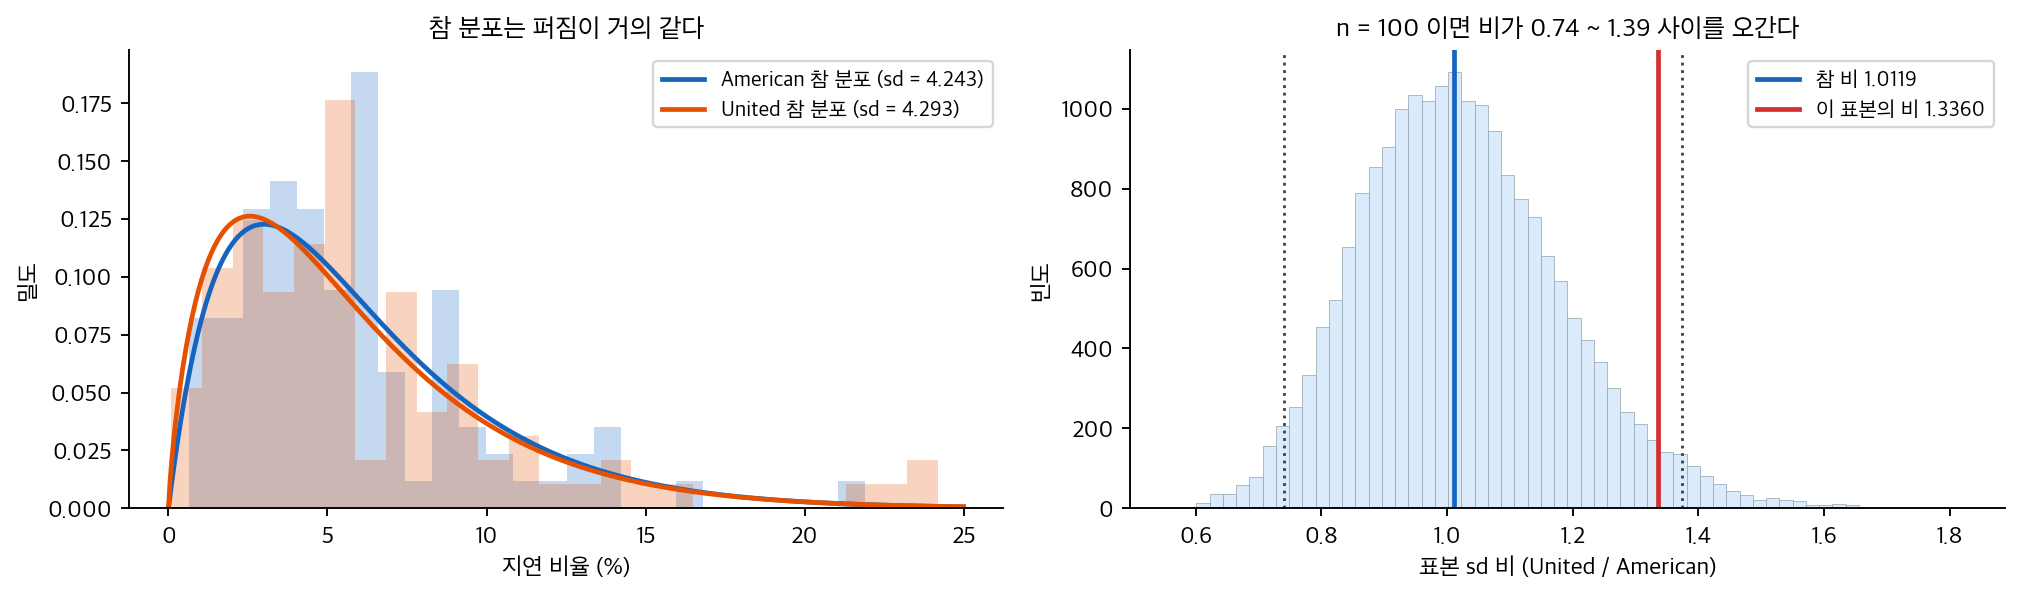
평균은 잘 맞는다. 참값 \(6.0000, 3.7500, 2.4000, 5.7600\) 에 표본이 \(5.7575, 3.7739, 2.3074, 6.1765\) 다. 표준오차 \(\sqrt{k}\theta/\sqrt{100}\) 이 \(0.42, 0.31, 0.22, 0.43\) 이므로 모두 \(1\) 표준오차 안이다.
그러나 (1)의 해석 가운데 두 가지는 표집 변동이었다.
첫째, 두 중앙값이 \(5.09\) 로 같은 것은 우연이다. 참 중앙값은 American \(5.0350\), United \(4.7355\) 로 \(0.30\) 만큼 다르다. 표본에서 \(5.0924\) 와 \(5.0893\) 으로 소수 둘째 자리까지 겹친 것은 이 씨앗에서만 일어난 일이다.
둘째, 더 중요하게, "United의 산포가 3분의 1 크다"는 것도 모형에 없는 차이다. 참 표준편차의 비는 \(1.0119\), 곧 \(1\%\) 차이뿐이다. 그런데 이 표본은 \(1.3360\) 을 주었다. 같은 모형에서 \(20{,}000\)번 다시 뽑아 보면 비가 \(0.74\) 에서 \(1.37\) 사이를 오가고, \(1.3360\) 은 그 분포의 \(96.2\) 분위수(quantile)다. 드물기는 해도 \(95\%\) 구간 안이다. \(n = 100\) 으로는 두 산포가 같은지 다른지 가릴 수 없다.
그림 왼쪽이 그 사실을 그대로 보여 준다. 두 참 밀도곡선(파랑과 주황)이 거의 겹쳐 있다. 겹치지 않는 것은 그 위에 깔린 히스토그램뿐이다.
그러므로 (1)의 마지막 문단은 고쳐 읽어야 한다. "승객이 겪는 위험이 다르다"는 결론은 이 자료로는 뒷받침되지 않는다. 두 분포의 참 모수는 평균이 \(6.00\) 대 \(5.76\), 표준편차가 \(4.24\) 대 \(4.29\) 로 사실상 같다. 바이올린 그림에서 United의 몸통이 위로 더 늘어나 보인 것은 그 표본에서 큰 값이 몇 개 더 나왔기 때문이고, 그 정도는 \(n = 100\) 에서 흔히 생긴다.
이것이 집단 비교 그림의 가장 흔한 함정이다. 그림은 표본의 산포 차이를 보여 주는데 사람은 그것을 모집단의 차이로 읽는다. 눈으로 본 차이가 표집 변동보다 큰지를 묻지 않으면, 그림은 언제나 "차이가 있다"고 말한다. 차이를 주장하려면 그림이 아니라 표집분포(sampling distribution)를 보아야 한다 — 위 오른쪽 그림이 바로 그것이다.
보기 4. 대출 신용등급별 소득. 등급 A–G 에서 \(100\)명씩, 평균은 등급당 \(8\)천 달러씩 내려가고 표준편차는 \(5\)천 달러씩 올라가도록 뽑는다.
(1) 바이올린 그림을 그리고 등급에 따라 무엇이 달라지는지 적으시오.
(2) 바이올린이 크게 겹친다고 해서 평균이 같은 것은 아니다. A등급 \(N(80{,}000, 15{,}000^2)\) 과 B등급 \(N(72{,}000, 20{,}000^2)\) 의 중첩 정도와 \(t\) 검정의 검정력을 각각 구하고, \(n\) 을 키우면 둘이 어떻게 달라지는지 보이시오.
풀이
(1) 그려 본다.
설정. 대부자는 대출 등급(A = 최상, G = 최하)에 걸친 소득 분포를 살펴 신용 위험을 평가한다. 등급이 낮을수록 소득이 낮고 더 넓게 퍼지는 경향이 있다.
np.random.seed(456)
grades = ['A', 'B', 'C', 'D', 'E', 'F', 'G']
n_per_grade = 100

data_list = []
for grade in grades:
    grade_idx = ord(grade) - ord('A')          # A=0, B=1, ... G=6
    # 등급이 낮아질수록 평균 소득은 내려가고(-8천/등급)
    # 산포는 커진다(+5천/등급). 두 변화를 동시에 준 것이 이 보기의 요점이다.
    base_income = 80_000 - grade_idx * 8_000
    income_std  = 15_000 + grade_idx * 5_000
    incomes = np.random.normal(base_income, income_std, n_per_grade)
    incomes = np.clip(incomes, 10_000, 200_000)
    for income in incomes:
        data_list.append({'grade': grade, 'income': income})

loans = pd.DataFrame(data_list)

# 등급별 요약. 여기서는 count를 뽑지 않으므로 표 전체를 나눠도 안전하다.
print((loans.groupby('grade')['income']
       .agg(['mean', 'median', 'std']) / 1000).round(1))

fig, ax = plt.subplots(figsize=(10, 5))
sns.violinplot(data=loans, x='grade', y='income', ax=ax, color='lightgreen')
ax.set_xlabel('대출 등급 (A=최상, G=최하)')
ax.set_ylabel('연 소득 (달러)')
ax.set_title('신용등급별 소득 분포')
plt.tight_layout()
plt.show()
출력(단위: 천 달러):
       mean  median   std
grade
A      82.2    81.2  13.9
B      69.8    69.5  21.9
C      67.5    68.8  24.7
D      52.5    52.1  29.2
E      53.5    49.1  32.6
F      43.1    38.2  32.4
G      36.2    23.9  32.2
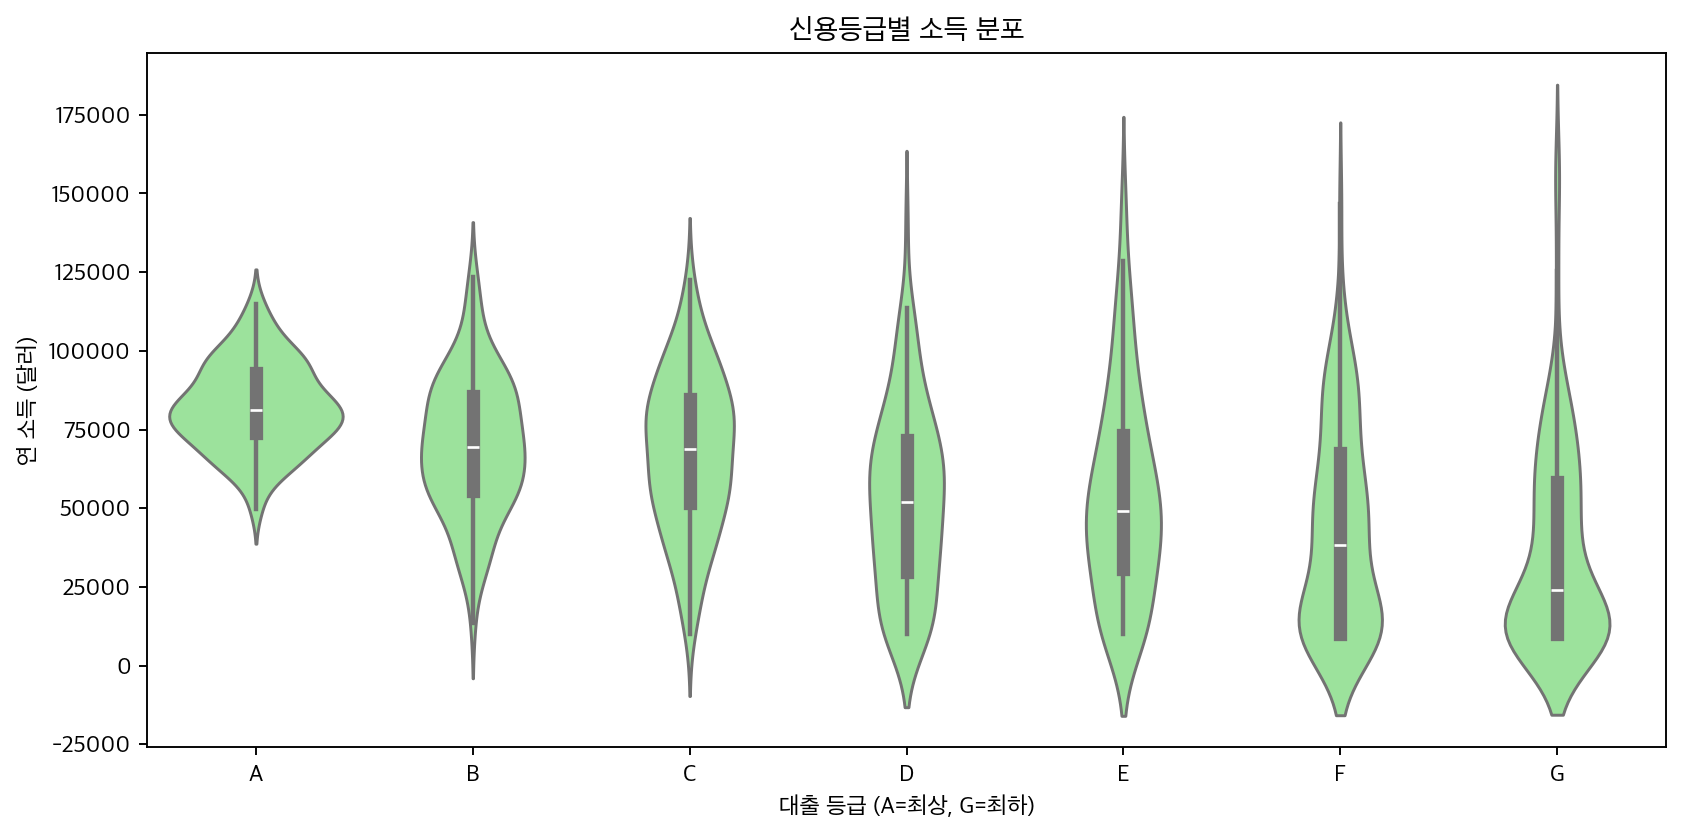
해석.
- A등급은 평균 82천 달러에 표준편차 13.9천 달러로 좁게 모여 있다. 바이올린이 세로로 짧고 통통하다.
- G등급은 평균 36천 달러에 표준편차 32.2천 달러로 두 배 이상 퍼져 있다. 바이올린이 세로로 길고 홀쭉하다.
- A에서 G로 갈수록 중심은 내려가고 세로 길이는 늘어난다. 소득이 낮아질 뿐 아니라 예측하기도 어려워진다는 뜻이며, 대부자에게는 두 가지 모두 위험 요인이다.
바이올린의 '폭'을 산포로 읽으면 안 된다
seaborn 의 기본값은 각 바이올린의 면적을 같게 맞추는 것이다(density_norm="area"). 그래서 산포가 큰 집단일수록 세로로 길어지는 대신 가로로는 오히려 좁아진다. 위 그림에서 가장 넓은 바이올린이 가장 산포가 작은 A등급인 것이 그 때문이다. 산포는 세로 길이로, 가로 폭은 그 값 근처의 상대적 밀도로 읽어야 한다(연습문제 5).
G등급에서 평균과 중앙값이 크게 갈린다
G등급의 평균은 36.2, 중앙값은 23.9로 12천 달러 넘게 차이 난다. 다른 등급에서는 둘이 거의 같았다.
원인은 코드의 np.clip(incomes, 10_000, 200_000)이다. G등급은 뽑을 때의 평균이 32천, 표준편차가 45천(\(15{,}000 + 6 \times 5{,}000\))이라 10천 미만인 값이 100개 중 37개나 나오는데, 그것들이 모두 하한 10천에 몰려 쌓인다. (표에 보이는 32.2천은 자르고 난 뒤의 표준편차이므로 이 계산에 쓰면 안 된다.) 그 결과 분포가 왼쪽 끝에 뭉치고 오른쪽으로 길게 늘어져 오른쪽으로 치우친 모양이 된다.
바이올린 그림의 아래쪽이 10천 근처에서 뭉툭하게 부풀어 있는 것이 그 흔적이다. 다만 KDE가 그 봉우리를 매끄럽게 퍼뜨려 놓기 때문에 0 아래의 불가능한 소득까지 바이올린이 뻗는다. 실제로 쌓여 있는 것은 정확히 10천 하나뿐이다. 이 모형이 낮은 등급에서는 현실적이지 않다는 신호이며, 실제라면 로그정규분포처럼 애초에 음수가 나오지 않는 분포를 쓰는 편이 낫다.
(2) 겹치는데도 다르다. 해석적으로. 바이올린이 얼마나 겹치는지는 중첩 계수(overlapping coefficient, OVL)
로 잰다. 이 값은 두 분포만으로 정해지고 표본 크기와 무관하다. 자료를 백만 개 모아도 그대로다.
반면 \(t\) 검정이 잡아내는 것은 평균의 차이이고, 그 정밀도는 표본 크기가 정한다.
여기서 \(\delta = \mu_A - \mu_B\) 는 참 평균 차이다. 비중심 모수(noncentrality parameter)는 그 차이가 표준오차의 몇 배인지를 나타내는 수로, 클수록 검정이 차이를 잡아낼 확률, 곧 검정력이 커진다.
그러므로 \(n\) 을 키우면 검정력은 \(1\) 로 가지만 중첩은 꿈쩍도 하지 않는다. 둘은 서로 다른 질문의 답이다.
- 중첩 — "아무나 한 사람 골랐을 때 어느 등급인지 알 수 있는가." 이것은 분류의 문제다.
- 검정력 — "두 등급의 평균이 다른가." 이것은 평균의 문제다.
바이올린이 거의 포개져 보여도 평균 차이는 확실히 잡힐 수 있고, 거꾸로 평균 차이가 확실해도 개인을 가려내는 데는 쓸모가 없을 수 있다.
수치적으로. A등급 \(N(80{,}000, 15{,}000^2)\), B등급 \(N(72{,}000, 20{,}000^2)\) 로 두고 재어 본다.
from scipy.integrate import quad

mA, sA = 80_000., 15_000.
mB, sB = 72_000., 20_000.
delta = mA - mB
print(f"A등급 N({mA:,.0f}, {sA:,.0f}^2),  B등급 N({mB:,.0f}, {sB:,.0f}^2)")
print(f"참 차이 delta = {delta:,.0f}")

ovl = quad(lambda x: min(stats.norm.pdf(x, mA, sA), stats.norm.pdf(x, mB, sB)),
           0, 200_000, limit=200)[0]
print(f"두 분포의 중첩 계수 OVL = int min(f_A, f_B) dx = {ovl:.4f}")
print(f"  -> 두 분포가 {100*ovl:.1f}% 겹친다. 아무리 n 을 키워도 이 값은 그대로다.")
print(f"P(B 쪽에서 뽑은 사람이 A 쪽 사람보다 소득이 높을 확률) = "
      f"{stats.norm.cdf(-delta/np.sqrt(sA**2+sB**2)):.4f}")

print(f"\n{'n(집단당)':>10}{'차의 SE':>11}{'비중심 모수':>13}{'검정력':>9}{'중첩':>9}")
for n in [10, 25, 50, 100, 200, 400]:
    se = np.sqrt(sA**2/n + sB**2/n)
    ncp = delta/se
    dfw = (sA**2/n + sB**2/n)**2 / ((sA**2/n)**2/(n-1) + (sB**2/n)**2/(n-1))
    crit = stats.t.ppf(0.975, dfw)
    power = stats.nct.sf(crit, dfw, ncp) + stats.nct.cdf(-crit, dfw, ncp)
    print(f"{n:>10}{se:>11,.0f}{ncp:>13.4f}{power:>9.4f}{ovl:>9.4f}")

rng = np.random.default_rng(11)
print(f"\n모의로 확인 (20000 회)")
for n in [25, 100, 400]:
    R = 20000
    A = rng.normal(mA, sA, (R, n))
    B = rng.normal(mB, sB, (R, n))
    t, p = stats.ttest_ind(A, B, axis=1, equal_var=False)
    print(f"  n={n:>4}: 기각 비율 {np.mean(p < 0.05):.4f}")

fig, (a1, a2) = plt.subplots(1, 2, figsize=(11, 3.6))
g = np.linspace(10_000, 150_000, 600)
a1.plot(g/1000, stats.norm.pdf(g, mA, sA), color="#1565C0", lw=2, label="A등급")
a1.plot(g/1000, stats.norm.pdf(g, mB, sB), color="#E65100", lw=2, label="B등급")
a1.fill_between(g/1000, np.minimum(stats.norm.pdf(g, mA, sA),
                                   stats.norm.pdf(g, mB, sB)),
                color="#CFD8DC", label=f"중첩 {100*ovl:.1f}%")
a1.set_xlabel("연 소득 (천 달러)")
a1.set_ylabel("밀도")
a1.set_title("두 분포는 70% 넘게 겹친다", fontsize=11)
a1.legend(fontsize=9)

ns = np.array([10, 25, 50, 100, 200, 400])
pw = []
for n in ns:
    se = np.sqrt(sA**2/n + sB**2/n)
    ncp = delta/se
    dfw = (sA**2/n + sB**2/n)**2/((sA**2/n)**2/(n-1) + (sB**2/n)**2/(n-1))
    crit = stats.t.ppf(0.975, dfw)
    pw.append(stats.nct.sf(crit, dfw, ncp) + stats.nct.cdf(-crit, dfw, ncp))
a2.plot(ns, pw, "o-", color="#1565C0", lw=2, label="t 검정의 검정력")
a2.axhline(ovl, color="#E65100", ls="--", lw=2, label=f"중첩 {ovl:.3f} (n 과 무관)")
a2.axhline(0.8, color="#90A4AE", ls=":", lw=1.2)
a2.set_xlabel("집단당 표본 크기 $n$")
a2.set_ylabel("확률")
a2.set_ylim(0, 1.05)
a2.set_title("중첩은 그대로인데 검정력만 오른다", fontsize=11)
a2.legend(fontsize=9)
for ax in (a1, a2):
    ax.spines[["top", "right"]].set_visible(False)
plt.tight_layout()
plt.show()
출력:
A등급 N(80,000, 15,000^2),  B등급 N(72,000, 20,000^2)
참 차이 delta = 8,000
두 분포의 중첩 계수 OVL = int min(f_A, f_B) dx = 0.7848
  -> 두 분포가 78.5% 겹친다. 아무리 n 을 키워도 이 값은 그대로다.
P(B 쪽에서 뽑은 사람이 A 쪽 사람보다 소득이 높을 확률) = 0.3745

    n(집단당)      차의 SE       비중심 모수      검정력       중첩
        10      7,906       1.0119   0.1591   0.7848
        25      5,000       1.6000   0.3468   0.7848
        50      3,536       2.2627   0.6098   0.7848
       100      2,500       3.2000   0.8894   0.7848
       200      1,768       4.5255   0.9947   0.7848
       400      1,250       6.4000   1.0000   0.7848

모의로 확인 (20000 회)
  n=  25: 기각 비율 0.3475
  n= 100: 기각 비율 0.8856
  n= 400: 기각 비율 1.0000
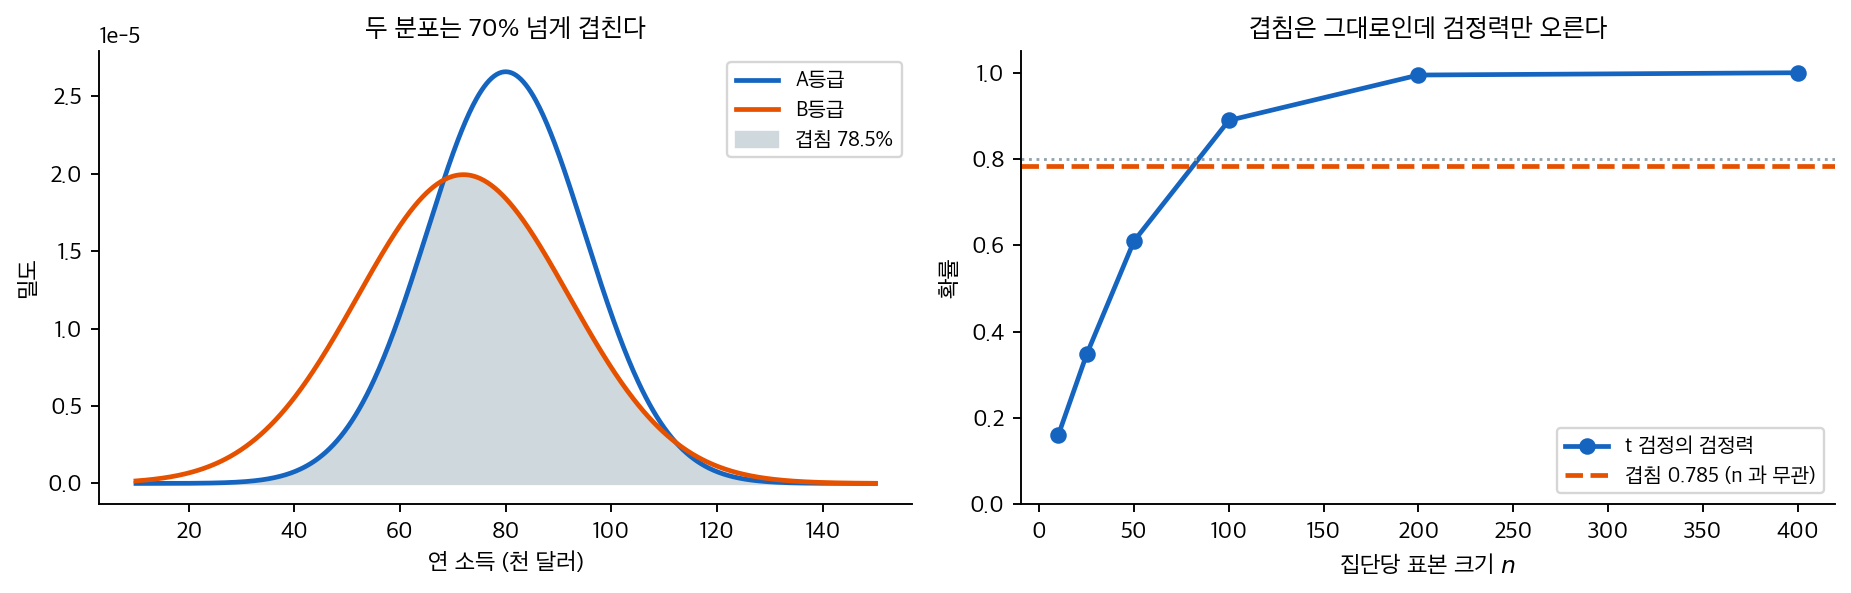
이론 검정력과 모의가 맞는다. \(n = 25\) 에서 \(0.3468\) 대 \(0.3475\), \(n = 100\) 에서 \(0.8894\) 대 \(0.8856\), \(n = 400\) 에서 둘 다 \(1.0000\) 이다. \(20{,}000\)회 모의의 몬테카를로(Monte Carlo) 오차가 \(\sqrt{0.35 \times 0.65/20000} = 0.0034\) 이므로 모두 그 안이다(비중심 \(t\) 로 구한 검정력은 웰치 자유도를 참 분산으로 고정해 계산한 근사라 소수 셋째 자리까지만 맞는다).
그리고 두 수가 전혀 다르게 움직인다.
- 중첩은 \(n\) 이 \(10\)이든 \(400\)이든 \(0.7848\) 로 고정이다. 두 등급의 소득 분포는 \(78.5\%\) 가 겹친다. B등급에서 아무나 한 사람 뽑았을 때 A등급의 아무나보다 소득이 높을 확률이 \(0.3745\) 다. 거의 동전 던지기에 가깝다.
- 검정력은 \(n = 10\) 에서 \(0.159\), \(n = 100\) 에서 \(0.889\), \(n = 400\) 에서 \(1.000\) 으로 올라간다. 비중심 모수가 \(\sqrt{n}\) 에 비례하기 때문이다(\(1.01 \to 1.60 \to 2.26 \to 3.20 \to 4.53 \to 6.40\), 네 배마다 두 배).
그러므로 "바이올린이 겹치니 두 등급은 다르지 않다"는 말은 틀렸다. \(n = 100\) 이면 \(89\%\) 의 확률로 차이를 잡아낸다. 그림 오른쪽에서 파란 곡선(검정력)이 주황 직선(중첩)을 \(n = 80\) 근처에서 가로지르는데, 두 선이 만나는 것은 아무 뜻도 없다. 둘은 단위가 같을 뿐 서로 다른 질문의 답이다.
거꾸로도 성립한다. \(n = 400\) 에서 \(p\) 값이 아무리 작게 나와도, 어느 개인이 A등급인지 B등급인지는 여전히 거의 알 수 없다. 소득만으로 등급을 맞히면 열에 넷 가까이 틀린다. 평균의 차이가 확실하다는 것과 개인을 가려낼 수 있다는 것은 다른 말이고, 바이올린 그림이 보여 주는 것은 뒤쪽이다.
연습문제¶
연습문제 1. 두 식물 생장 실험의 결과가 다음과 같다. 처리 1: \(\{5, 6, 6, 7, 7, 7, 8, 8, 9\}\), 처리 2: \(\{3, 5, 7, 7, 7, 7, 7, 9, 11\}\). (a) 다섯 수치 요약을 구하라. (b) 상자그림이 비슷해 보이겠는가? (c) 바이올린 그림은 어떻게 다른가?
풀이
(a) 두 자료 모두 \(n = 9\)이고 평균과 중앙값이 \(7\)로 같다. 다섯 수치 요약은 다르다.
| T1 | T2 | |
|---|---|---|
| 최솟값 | 5 | 3 |
| \(Q_1\) | 6 | 7 |
| 중앙값 | 7 | 7 |
| \(Q_3\) | 8 | 7 |
| 최댓값 | 9 | 11 |
| \(\text{IQR}\) | 2 | 0 |
| 표준편차 | 1.22 | 2.24 |
\(Q_1\)과 \(Q_3\)을 손으로 구해 보면 이유가 보인다. T2를 정렬하면 \(3, 5, 7, 7, 7, 7, 7, 9, 11\)인데, 아래쪽 절반에도 위쪽 절반에도 \(7\)이 가득하다. 그래서 어떤 분위수 규약을 쓰든(numpy 의 선형보간, 투키의 hinge, pandas.describe() 가 모두 같은 답을 준다) \(Q_1 = Q_3 = 7\)이고 \(\text{IQR} = 0\)이다.
(b) 아니다. 두 상자그림은 전혀 다르게 보인다.
- T1은 \([6, 8]\)의 정상적인 상자에 중앙값 선이 가운데 있고, 수염이 \(5\)와 \(9\)까지 뻗으며 이상치가 없다.
- T2는 \(\text{IQR} = 0\)이므로 상자가 납작하게 찌그러져 \(7\)에서 선 하나가 된다. 울타리도 \(Q_1 - 1.5 \times 0 = 7\)과 \(Q_3 + 1.5 \times 0 = 7\)로 겹치므로 수염이 뻗을 자리가 없고, \(3, 5, 9, 11\) 네 값이 모두 이상치로 찍힌다.
아홉 개 중 넷이 이상치라는 판정은 물론 터무니없다. \(1.5 \times \text{IQR}\) 규칙이 동점이 많아 \(\text{IQR}\)가 \(0\)에 가까운 자료에서 무너지는 것이며, 표본이 작을 때 흔히 생긴다.
(c) 바이올린 그림은 T2가 \(7\)에서 날카롭게 솟아 있음을(아홉 값 중 다섯이 \(7\)) 드러내는 반면, T1은 \(5\)–\(9\)에 걸쳐 \(1, 2, 3, 2, 1\)의 완만한 삼각형 모양임을 보여 준다. 중심은 둘 다 \(7\)인데 산포의 성격이 전혀 다르다. T2는 가운데에 몰린 덩어리와 양쪽으로 흩어진 네 점으로 이루어져 있다.
다만 \(n = 9\)에서는 바이올린도 믿을 것이 못 된다. 관측이 아홉 개뿐이면 KDE의 굴곡 대부분이 평활의 산물이다(연습문제 7). 이 자료의 정직한 그림은 점 아홉 개를 그대로 찍는 것이다.
연습문제 2. 바이올린 그림의 밀도는 커널밀도추정으로 계산된다. KDE 공식을 쓰고, 대역폭 \(h\)가 바이올린 그림의 모습에 어떤 영향을 주는지 논하라.
풀이
KDE 공식은 이렇게 된다.
여기서 \(K\)는 (보통 가우시안인) 커널이고 \(h > 0\)은 대역폭이다.
대역폭이 바이올린에 미치는 영향은 이렇다.
- \(h\)가 작을 때: 밀도추정이 뾰족뾰족해진다. 각 자료점이 좁은 봉우리를 만든다. 바이올린이 밑바탕 밀도가 아니라 개별 관측값을 보여주게 된다. 표집 잡음에 과적합할 수 있다.
- \(h\)가 클 때: 밀도가 지나치게 매끄러워진다. 최빈값들이 뭉개져 이봉 분포가 단봉으로 보인다. 바이올린이 보여주어야 할 바로 그 특징을 감추는 왜곡이다.
- 최적의 \(h\)(예: 실버만, 스콧, 플러그인 선택자): 편향과 분산의 균형을 잡는다.
대부분의 그림 라이브러리(matplotlib, seaborn)는 기본으로 스콧 규칙을 적용한다. 바이올린이 너무 들쭉날쭉하면 bw_method를 줄이고, 너무 매끄러우면 늘린다.
연습문제 3. 반쪽 바이올린(분할 바이올린) 그림은 하나의 수직축 양쪽에 두 집단을 보여준다. 이 표현이 나란히 놓은 전체 바이올린보다 선호되는 때는 언제인가?
풀이
분할 바이올린 그림은 다음과 같을 때 선호된다.
- 직접적인 짝 비교가 핵심 메시지일 때 — 예를 들어 각 승객 등급 안에서 남성과 여성의 나이 분포를 비교하는 경우.
- 두 분포가 미묘하게 다를 것으로 예상될 때. 공유하는 축의 양쪽에 놓으면 모양, 위치, 산포의 작은 차이가 시각적으로 분명해진다.
- 공간이 제한될 때: 분할 바이올린 하나는 나란히 놓은 전체 바이올린 둘의 절반 폭만 차지한다.
다음과 같을 때는 분할 바이올린을 피한다.
- 집단이 둘보다 많을 때.
- 두 집단의 표본 크기가 크게 다를 때(밀도가 정규화되어 불균형이 감춰진다).
- 모양이 매우 다를 때 — 눈이 "반대쪽 반쪽"을 대칭으로 읽어 오도할 수 있다.
연습문제 4. 어떤 의학 시험 결과 자료의 바이올린 그림이 물리적인 하한(예: 음이 아닌 양에 대한 0)에서 잘려 있다. KDE가 어떤 인공물을 만들어내며 어떻게 바로잡을 수 있는가?
풀이
표준 KDE는 각 관측값 주위에 커널 질량을 대칭적으로 배치한다. 딱딱한 경계 근처에서는 이 때문에 확률 질량이 경계 아래에 놓인다. 0에서 아래로 막힌 자료라면 KDE가 물리적으로 불가능한 음수 값에 0이 아닌 밀도를 부여한다.
시각적 인공물: 바이올린이 0 아래로 뻗은 것처럼 보여 자료가 음수일 수 있다는 인상을 준다. 또한 0 바로 위의 밀도도 과소추정된다 — 경계 근처 관측값의 커널 가운데 0 아래로 새어 나간 몫만큼이 경계 위에서 빠지기 때문이다.
바로잡는 방법은 이렇다.
- 반사법: 자료를 경계에 대해 반사시켜 두 배가 된 자료에 KDE를 적합한 뒤, 경계에서 잘라내고 그 위의 밀도를 두 배로 한다.
- \([0, 1]\)로 막힌 자료에는 베타 KDE, \([0, \infty)\) 자료에는 감마 / 로그정규 KDE 등 적절한 받침을 갖는 커널을 쓴다.
- 변환: 음이 아닌 자료에 \(\log(x + 1)\)을 취해 변환된 척도에서 KDE를 적합한 뒤 변수변환을 통해 원래 척도로 그린다.
대부분의 그림 라이브러리가 지정한 경계에서 바이올린을 잘라내게 해주지만, 밑바탕의 밀도추정은 여전히 경계 근처에서 편향되어 있을 수 있다. 바이올린의 경계 근처 부분은 언제나 조심해서 해석하라.
연습문제 5. 바이올린의 폭을 집단에 걸쳐 정규화하기도 하고(각 바이올린의 최대 폭이 같음) 정규화하지 않기도(폭이 표본 크기를 반영) 하는 이유는 무엇인가? 각각은 언제 적절한가?
풀이
정규화(각 바이올린의 최대 폭 = 1): 모양 비교를 강조한다. 집단에 관측값이 몇 개든 각 집단의 분포 모양이 온전한 시각적 크기로 표시된다. 표본 크기가 다르지만 모양을 직접 비교하고 싶을 때 적합하다.
도수 비례(폭 \(\propto n\)): 각 집단의 상대적 중요도를 보존한다. 관측값이 1000개인 집단이 10개인 집단보다 훨씬 넓게 나타나, 작은 집단의 밀도추정이 덜 믿을 만하다는 신호를 준다.
각각이 적절한 때는 이렇다.
- 표본 크기가 비슷하거나 메시지가 순전히 모양에 관한 것일 때 정규화를 쓴다(예: 인구 규모가 다른 나라들의 소득 분포를 비교할 때, 인구 3000만인 나라가 300만인 나라를 시각적으로 압도해서는 안 된다).
- 표본 크기의 차이 자체가 이야기의 일부일 때 도수 비례를 쓴다(예: 응답자 1000명의 처리군과 50명의 대조군을 비교할 때, 확신의 차이가 중요하다).
기본값은 둘 가운데 어느 것도 아니다. seaborn 의 density_norm="area" 는 각 바이올린의 면적을 같게 맞추는 것이어서 최대 폭도 \(n\) 도 맞추지 않는다 — 산포가 작은 집단이 되레 가장 넓어진다(§5 에서 확인한다). 최대 폭을 맞추는 것이 "width", 폭을 \(n\) 에 비례시키는 것이 "count" 다. 세 선택이 서로 다른 것을 같게 만드므로 어느 방식을 쓰고 있는지 늘 인지하고 그에 맞게 이름표를 달아라.
연습문제 6. 바이올린 그림의 강점은 분포의 모양을 보여준다는 것이고, 약점은 대부분의 청중에게 낯설다는 것이다. 통계 전문가가 아닌 일반 청중에게 바이올린 그림을 제시할 때 합리적인 소통 전략은 무엇인가?
풀이
서로 보완하는 몇 가지 전략이 있다.
- 중앙값을 표시하라: 수평선을 긋고 "중앙값"이라고 이름을 단다. 대부분의 청중은 중앙값을 즉시 이해한다.
- \(Q_1\)과 \(Q_3\)을 표시하라: 상자그림의 상자와 같은 위치에 선이나 음영을 넣는다. 더 익숙한 상자그림의 의미론에 바이올린을 붙들어 매는 효과가 있다.
- 실제 자료점을 겹쳐 그려라: 표본이 작으면
inner='points'나'sticks'를 쓴다. 자료점이 직접 보이면 아무것도 매끄럽게 지워버리지 않았다는 확신을 준다. - 처음 쓸 때는 같은 자료의 상자그림과 나란히 보여줘라. 이렇게 설명한다. "상자그림은 중앙값과 IQR을 알려주고, 바이올린은 밀도가 어디에 몰려 있는지 알려줍니다."
- 모양 정보가 중요할 때만 쓰라. 중앙값과 IQR만 흥미롭다면 상자그림으로 충분하다. 청중이 다봉성, 왜도, 모양의 차이를 봐야 하는 경우를 위해 바이올린을 아껴 두라.
목표는 이것이다. 바이올린은 인지 부담을 늘리지 않으면서 정보를 더해야 한다. 청중에게 이름표가 달린 막대그래프(bar chart)가 더 도움이 된다면 그쪽을 쓰라.
연습문제 7. 바이올린 그림은 KDE를 그린 것이므로 KDE의 약점을 그대로 물려받는다. 표본이 작을 때 바이올린이 없는 구조를 만들어 내는 것을 확인하라.
풀이
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import gaussian_kde

# 그림에 한글이 들어가므로 한글 글꼴을 지정한다(지정하지 않으면 네모로 깨진다).
plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams['axes.unicode_minus'] = False

rng = np.random.default_rng(0)

def n_modes(x):
    g = np.linspace(x.min() - 1, x.max() + 1, 600)
    d = gaussian_kde(x)(g)
    return sum(1 for i in range(1, len(d) - 1) if d[i] > d[i - 1] and d[i] > d[i + 1])

print("완전히 단봉인 N(0,1) 자료에서 KDE 가 봉우리 2개 이상을 보일 확률")
for n in (8, 15, 30, 100):
    print(f"  n={n:>4}: {np.mean([n_modes(rng.normal(0, 1, n)) >= 2 for _ in range(2000)]):.4f}")

samples = [rng.normal(0, 1, 8) for _ in range(4)]
fig, axes = plt.subplots(1, 2, figsize=(11, 4), sharey=True)
axes[0].violinplot(samples, showmedians=True)
axes[0].set_title("바이올린 (n=8 씩) — 넷이 달라 보인다", fontsize=10)
for i, s in enumerate(samples):
    axes[1].scatter(np.full(len(s), i + 1), s, s=30, alpha=0.8)
axes[1].set_title("원자료 — 같은 모집단에서 8개씩", fontsize=10)
for ax in axes:
    ax.set_xticks([1, 2, 3, 4])
    ax.set_xticklabels([f"표본 {i+1}" for i in range(4)])
fig.tight_layout()
plt.show()
출력:
완전히 단봉인 N(0,1) 자료에서 KDE 가 봉우리 2개 이상을 보일 확률
  n=   8: 0.1385
  n=  15: 0.1640
  n=  30: 0.1650
  n= 100: 0.1790
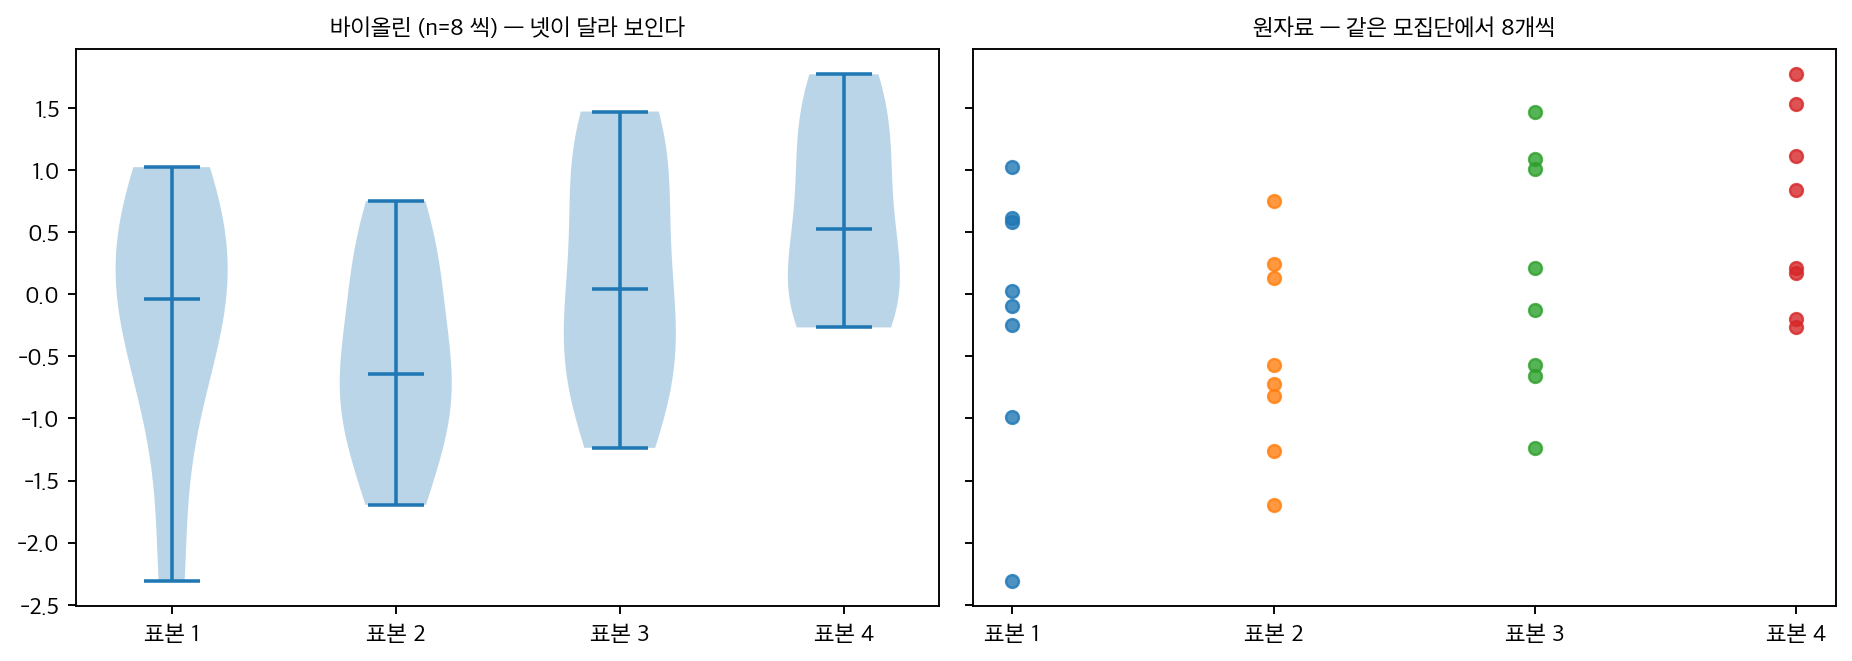
단봉 자료인데도 \(14\)–\(18\%\)의 확률로 봉우리가 둘 이상 보인다. 그리고 \(n\)이 커져도 나아지지 않는데, 2.3절 봉우리 수 연습문제 7에서 본 대로 기본 대역폭이 \(n\)과 함께 좁아지기 때문이다.
그림에서 네 표본은 같은 모집단 \(N(0,1)\)에서 \(8\)개씩 뽑은 것이다. 바이올린은 각기 다른 모양을 보여 주지만 오른쪽 원자료를 보면 그저 점 여덟 개씩이다. 바이올린의 굴곡은 자료가 아니라 평활의 산물이다.
실무 지침.
- 집단당 \(n\)이 \(20\) 미만이면 바이올린을 쓰지 마라. 스트립 그림(strip plot)이나 스웜 그림(swarm plot)이 정직하다.
- \(n\)이 \(20\)–\(50\)이면 바이올린에 점을 겹쳐 그려라. 독자가 굴곡의 근거를 직접 볼 수 있다.
- 어떤 경우에도 \(n\)을 표시하라. 상자그림에서와 같은 조언이다(2.5절 상자그림 연습문제 10).
바이올린이 상자그림보다 나은 점과 나쁜 점이 같은 뿌리에서 나온다. 더 많은 것을 보여 주지만, 그중 일부는 자료에 없는 것이다. \(\square\)
연습문제 8. 연습문제 2의 대역폭 효과를 그림으로 확인하라. 같은 자료에 대역폭만 바꾸면 바이올린이 어떻게 달라지는가?
풀이
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import gaussian_kde

# 그림에 한글이 들어가므로 한글 글꼴을 지정한다(지정하지 않으면 네모로 깨진다).
plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams['axes.unicode_minus'] = False

rng = np.random.default_rng(1)
x = np.concatenate([rng.normal(-2, 0.7, 150), rng.normal(2, 0.7, 150)])
grid = np.linspace(-6, 6, 800)

# 주의: gaussian_kde 의 bw_method 에 넣는 수는 대역폭 h 가 아니라 '계수'다.
# 실제 대역폭은 h = 계수 x 자료의 표준편차 이므로, 아래에서 h 를 따로 계산한다.
factors = [0.08, 0.2, "scott", 0.8, 1.2]
sd = x.std(ddof=1)

fig, axes = plt.subplots(1, 5, figsize=(16, 3.6), sharey=True)
for ax, bw in zip(axes, factors):
    kde = gaussian_kde(x, bw_method=bw)
    d = kde(grid)
    ax.fill_betweenx(grid, -d, d, alpha=0.6)
    peaks = sum(1 for i in range(1, len(d) - 1) if d[i] > d[i - 1] and d[i] > d[i + 1])
    ax.set_title(f"계수 {bw}  (h={kde.factor * sd:.2f})\n봉우리 {peaks}개", fontsize=9)
    ax.set_xticks([])
axes[0].set_ylabel("값")
fig.tight_layout()
plt.show()

print(f"자료의 표준편차 {sd:.3f}")
for bw in factors:
    kde = gaussian_kde(x, bw_method=bw)
    d = kde(grid)
    peaks = sum(1 for i in range(1, len(d) - 1) if d[i] > d[i - 1] and d[i] > d[i + 1])
    print(f"계수 {str(bw):>7}  ->  대역폭 h={kde.factor * sd:.3f}: 봉우리 {peaks}개")
출력:
자료의 표준편차 2.091
계수    0.08  ->  대역폭 h=0.167: 봉우리 5개
계수     0.2  ->  대역폭 h=0.418: 봉우리 2개
계수   scott  ->  대역폭 h=0.668: 봉우리 2개
계수     0.8  ->  대역폭 h=1.672: 봉우리 2개
계수     1.2  ->  대역폭 h=2.509: 봉우리 1개
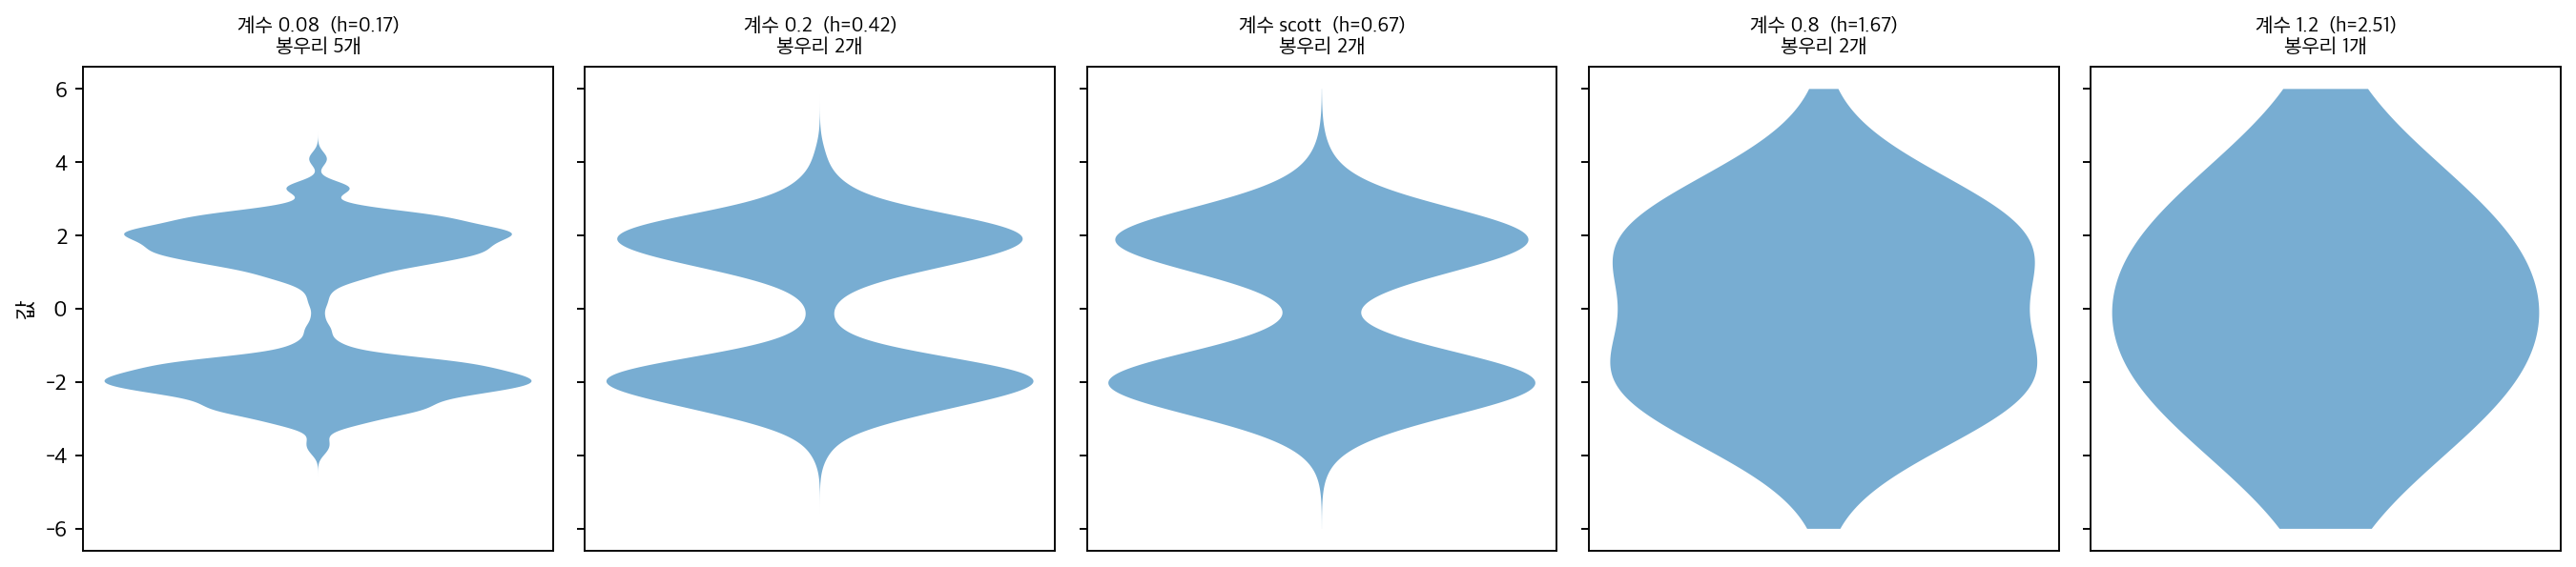
같은 자료가 대역폭에 따라 전혀 다른 이야기를 한다. 참 분포는 봉우리가 둘인 혼합인데, 너무 좁으면 여러 개의 가짜 봉우리가, 충분히 넓히면 하나로 뭉개진 봉우리가 나온다.
| 계수 | 실제 대역폭 \(h\) | 봉우리 | 결과 |
|---|---|---|---|
| \(0.08\) (과소평활) | \(0.17\) | \(5\) | 잡음이 봉우리로 보인다 |
| \(0.2\) | \(0.42\) | \(2\) | 참 구조가 드러난다 |
| 스콧 (자동) | \(0.67\) | \(2\) | 대개 적절하다 |
| \(0.8\) (과대평활) | \(1.67\) | \(2\) | 봉우리는 아직 둘이지만 골이 얕아지고, 자료가 없는 \(\pm 6\) 근처까지 번진다 |
| \(1.2\) (심한 과대평활) | \(2.51\) | \(1\) | 두 봉우리가 마침내 하나로 합쳐진다 |
두 봉우리를 지우려면 생각보다 넓혀야 한다. 두 성분의 중심이 \(\pm 2\)로 떨어져 있으므로, 계수 \(0.8\)(\(h = 1.67\))에서도 골은 남는다. 참 구조를 완전히 지우는 데 계수 \(1.2\)(\(h = 2.51\))가 필요하다는 사실 자체가 과대평활의 위험을 말해 준다. 모양이 사라지기 전에 먼저 왜곡되기 때문이다.
이것이 히스토그램의 구간 개수 문제와 정확히 같다(2.2절 히스토그램과 밀도 그림 연습문제 10). 편향–분산 트레이드오프(trade-off)이며, 좁으면 분산이 크고 넓으면 편향이 크다. 최적 대역폭도 마찬가지로 \(n^{-1/5}\)에 비례한다(히스토그램의 \(n^{-1/3}\)과 다른 것은 커널이 더 매끄럽기 때문이다).
주의할 점. 히스토그램은 구간 개수를 명시적으로 고르므로 독자가 그 선택을 인지한다. 바이올린 그림은 대역폭이 숨어 있어 독자가 자의적 선택이 있었다는 사실조차 모른다. seaborn.violinplot 의 bw_adjust 기본값이 무엇인지 아는 독자는 드물다.
권고. 결론이 바이올린의 모양에 의존한다면 여러 대역폭으로 그려 보고, 모든 설정에서 나타나는 특징만 이야기하라. 그리고 그림 설명에 대역폭 설정을 적어 두어라. \(\square\)
연습문제 9. 연습문제 4의 경계 인공물을 실제로 만들어 보고, 두 가지 교정법을 비교하라.
풀이
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import gaussian_kde

# 그림에 한글이 들어가므로 한글 글꼴을 지정한다(지정하지 않으면 네모로 깨진다).
plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams['axes.unicode_minus'] = False

rng = np.random.default_rng(2)
x = rng.exponential(1.0, 800)                  # 반드시 0 이상인 자료
grid = np.linspace(-1.5, 6, 900)

naive = gaussian_kde(x)(grid)
log_kde = gaussian_kde(np.log(x))
pos = grid > 0
transformed = np.zeros_like(grid)
transformed[pos] = log_kde(np.log(grid[pos])) / grid[pos]

print(f"단순 KDE 가 x<0 에 배정한 질량 {np.trapz(naive[grid < 0], grid[grid < 0]):.4f}")
print(f"x=0.05 에서: 단순 {gaussian_kde(x)(0.05)[0]:.4f}   "
      f"로그변환 {transformed[np.argmin(np.abs(grid - 0.05))]:.4f}   "
      f"참값 {np.exp(-0.05):.4f}")

fig, axes = plt.subplots(1, 3, figsize=(13, 4), sharey=True)
for ax, (d, title) in zip(axes, [
        (naive, "단순 KDE — 0 아래로 새어 나간다"),
        (np.where(grid >= 0, naive, 0), "단순히 잘라 내기 — 편향은 남는다"),
        (transformed, "로그변환 후 되돌리기")]):
    ax.fill_betweenx(grid, -d, d, alpha=0.6)
    ax.axhline(0, color="red", ls="--", lw=1.2)
    ax.set_title(title, fontsize=9)
    ax.set_xticks([])
axes[0].set_ylabel("값")
fig.tight_layout()
plt.show()
출력:
단순 KDE 가 x<0 에 배정한 질량 0.0790
x=0.05 에서: 단순 0.5156   로그변환 0.8476   참값 0.9512
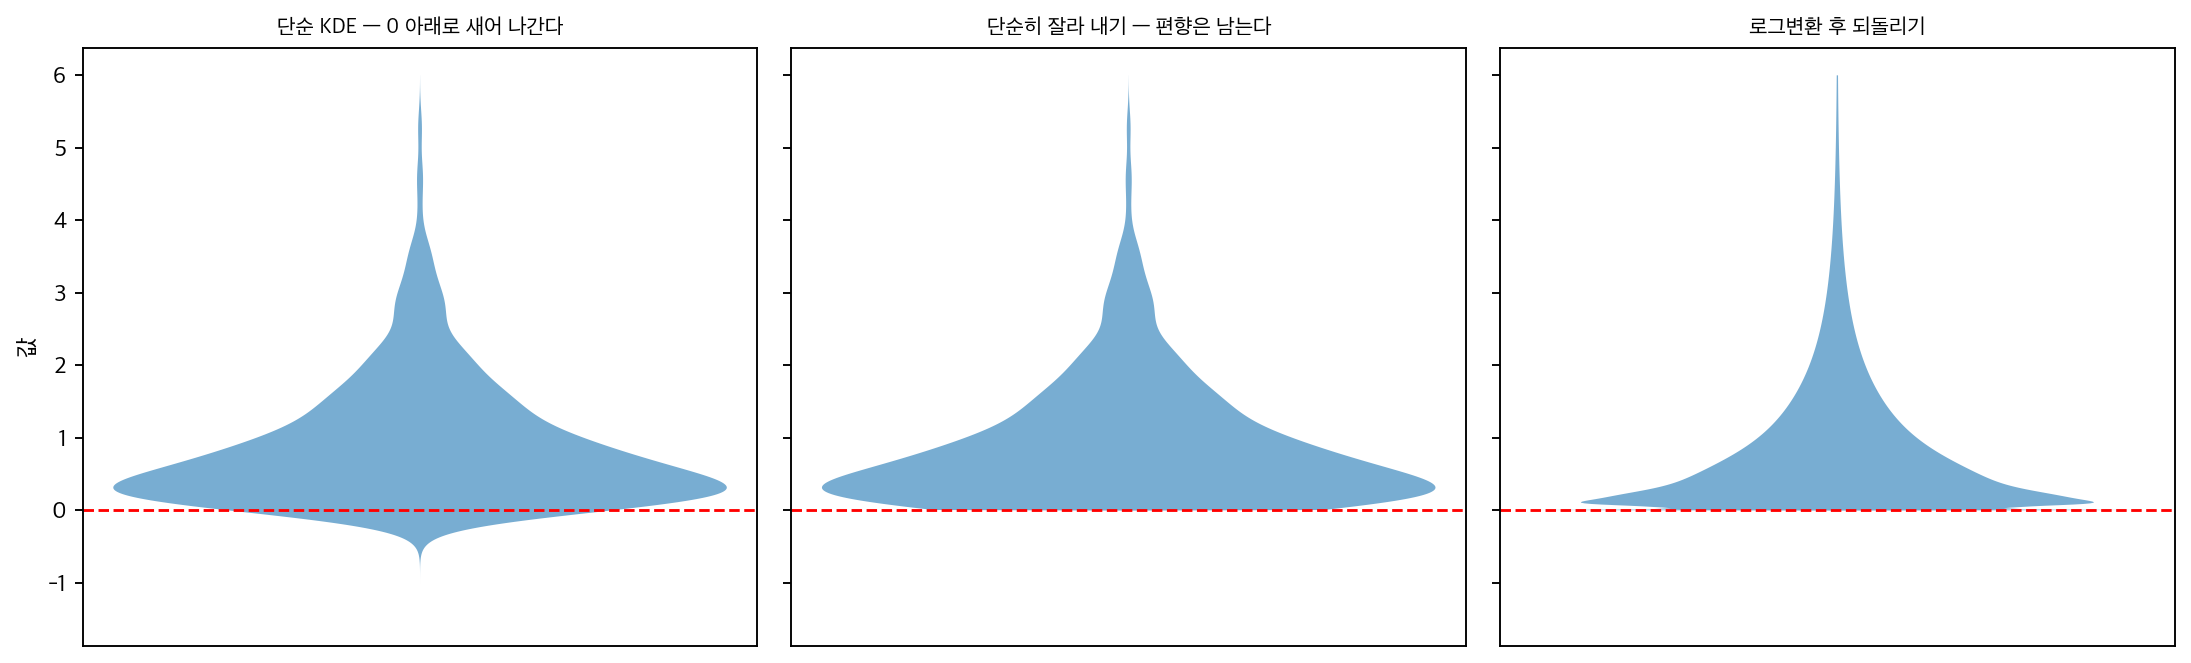
단순 KDE는 존재할 수 없는 \(x < 0\) 영역에 확률질량을 배정한다. 그리고 그만큼 \(x = 0\) 근처의 밀도가 깎여, 참값 \(0.951\)인 지점을 훨씬 낮게 추정한다.
두 교정법이 하는 일이 다르다.
- 잘라 내기(
seaborn의cut=0,clip=)는 곡선을 보기 좋게 자를 뿐이다. 경계 안쪽의 밀도가 낮게 추정된 것은 그대로 남는다. 2.2절 히스토그램과 밀도 그림 연습문제 8에서 이미 지적한 점이다. - 로그변환 후 되돌리기는 실제로 편향을 고친다. \(\log\) 척도에서는 경계가 \(-\infty\)로 밀려나 커널이 새어 나갈 곳이 없다.
어느 것을 쓰는가.
| 상황 | 권장 |
|---|---|
| 양수 자료, 경계 근처에 질량이 많다 | 로그변환 (또는 반사법) |
| 경계는 있으나 그 근처에 자료가 거의 없다 | 잘라 내기로 충분 |
| 비율 \([0,1]\) 자료 | 로짓 변환 |
| 정확한 밀도가 필요 없고 비교만 한다 | 잘라 내기 + 주석 |
가장 중요한 실무 조언. 바이올린이 물리적으로 불가능한 값까지 뻗어 있으면 독자가 그것을 자료로 오해한다. "응답 시간이 음수인 사람이 있나?"라는 질문을 받게 되며, 그 순간 그림의 신뢰도가 무너진다. 최소한 잘라 내기라도 반드시 적용하라. \(\square\)
연습문제 10. 바이올린 그림이 적극적으로 나쁜 경우가 있다. 이산 자료나 값의 종류가 적은 자료에 바이올린을 쓰면 어떻게 되는가?
풀이
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import gaussian_kde

# 그림에 한글이 들어가므로 한글 글꼴을 지정한다(지정하지 않으면 네모로 깨진다).
plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams['axes.unicode_minus'] = False

rng = np.random.default_rng(0)
likert = rng.choice([1, 2, 3, 4, 5], 3000, p=[.05, .15, .40, .30, .10]).astype(float)
grid = np.linspace(-1, 7, 800)
d = gaussian_kde(likert)(grid)

print(f"실제 분포: {np.round([np.mean(likert == k) for k in range(1, 6)], 3)}")
print(f"KDE 가 1 미만에 배정한 질량 {np.trapz(d[grid < 1], grid[grid < 1]):.4f}")
print(f"KDE 가 5 초과에 배정한 질량 {np.trapz(d[grid > 5], grid[grid > 5]):.4f}")
print(f"KDE 봉우리 개수 {sum(1 for i in range(1, len(d) - 1) if d[i] > d[i-1] and d[i] > d[i+1])}")

fig, axes = plt.subplots(1, 2, figsize=(11, 4))
axes[0].fill_betweenx(grid, -d, d, alpha=0.6)
axes[0].set_title("바이올린 — 있지도 않은 0.5 나 5.5 를 그린다", fontsize=10)
axes[0].set_xticks([])
levels, counts = np.unique(likert, return_counts=True)
axes[1].bar(levels, counts / counts.sum(), width=0.6)
axes[1].set_title("막대그래프 — 자료 그대로", fontsize=10)
axes[1].set_xlabel("응답")
fig.tight_layout()
plt.show()
출력:
실제 분포: [0.053 0.156 0.398 0.295 0.098]
KDE 가 1 미만에 배정한 질량 0.0259
KDE 가 5 초과에 배정한 질량 0.0474
KDE 봉우리 개수 5
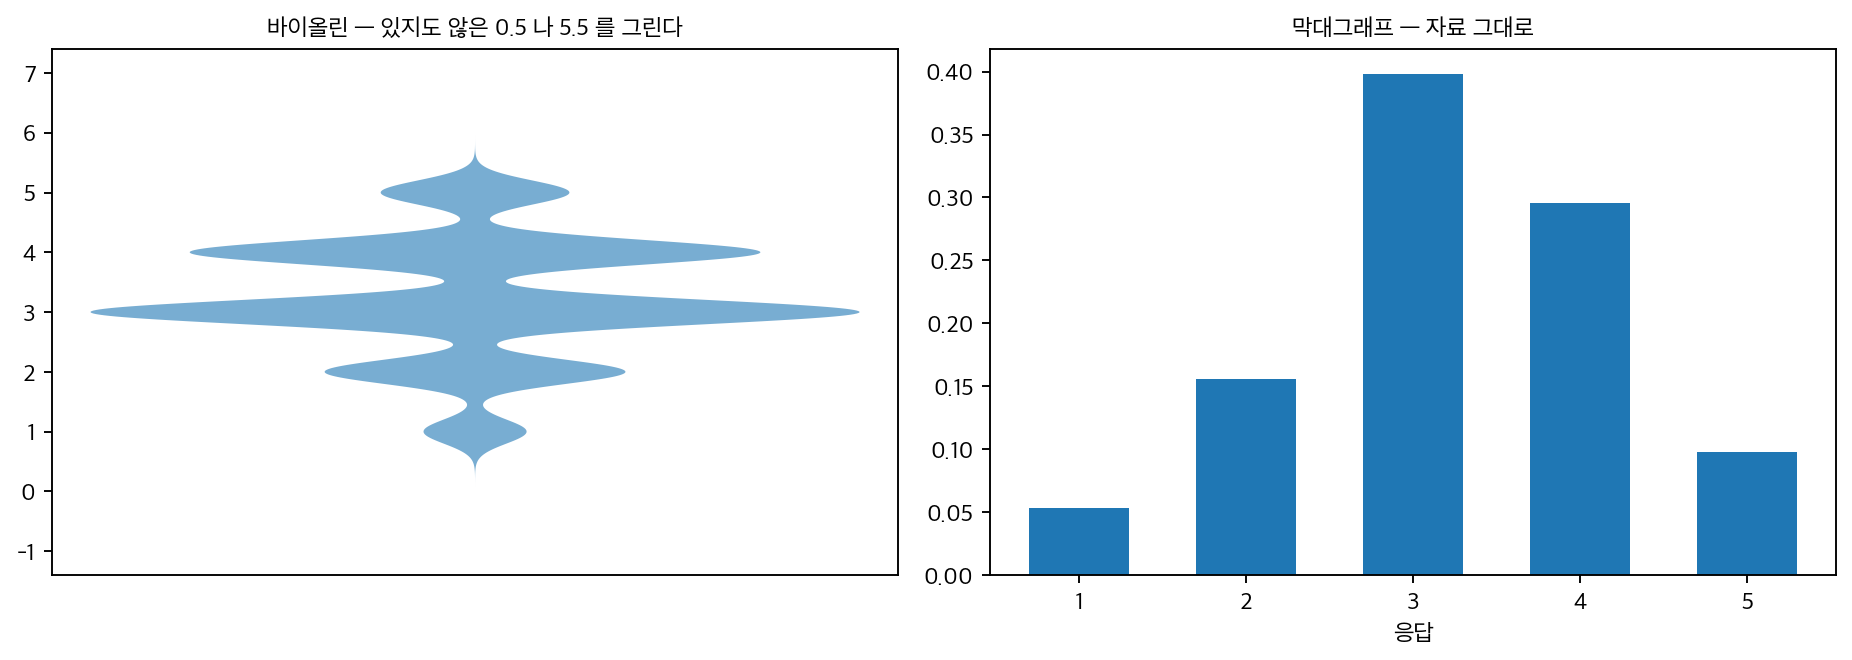
KDE가 \(1\) 미만에 \(2.6\%\), \(5\) 초과에 \(4.7\%\)의 질량을 배정한다. 응답이 \(1\)부터 \(5\)까지의 정수뿐인데 그렇다. 그림은 "\(0.5\)점을 준 사람"과 "\(5.5\)점을 준 사람"이 있는 것처럼 보인다.
봉우리도 \(5\)개로 나오는데, 이는 다섯 개의 이산 수준을 각각 봉우리로 그린 것이다. "분포에 봉우리가 다섯 개"라는 해석은 완전히 잘못된 것이다.
바이올린을 쓰지 말아야 할 경우.
| 자료 | 왜 나쁜가 | 대안 |
|---|---|---|
| 리커트·순서형 | 없는 중간값을 그린다 | 막대그래프, 누적 막대 |
| 계수(작은 값) | 정수 사이를 메운다 | 막대그래프 |
| 집단당 \(n < 20\) | 없는 구조를 만든다 (연습문제 7) | 스트립 그림 |
| 값의 종류가 몇 개뿐 | 봉우리가 값의 개수를 반영 | 도수표 |
| 경계가 있고 질량이 몰림 | 불가능한 값을 그린다 (연습문제 9) | 변환 후 그리기 |
KDE의 전제를 기억하라. 커널밀도추정은 연속인 밀도가 존재한다고 가정한다. 이산 자료에는 밀도가 없고 확률질량함수(probability mass function)가 있을 뿐이다. 없는 것을 추정하려 하면 그림이 거짓말을 한다.
바이올린이 빛나는 경우는 그 반대 조건이다. 연속 자료, 집단당 관측이 충분히 많고, 경계가 문제되지 않으며, 분포의 모양이 실제로 비교의 대상일 때다. 그런 상황에서는 상자그림보다 훨씬 많은 정보를 준다(연습문제 1, 2.5절 상자그림 연습문제 7).
도구를 고르는 순서. 먼저 자료가 어떤 종류인지(2장 첫 절의 자료형 분류) 확인하고, 그 다음에 그림을 고른다. 그림을 먼저 고르고 자료를 끼워 맞추면 이런 일이 생긴다. \(\square\)
연습문제 11. 중앙값과 IQR이 동일한 두 집단이 있는데, A 집단의 바이올린 그림은 봉우리가 하나이고 B 집단은 둘이다. 두 분포는 어떻게 다르며, 어떤 요약통계량이 이 차이를 포착하지 못하는가?
풀이
A 집단은 단봉이고 B 집단은 이봉이다. 평균, 중앙값, 분산, IQR은 두 집단에서 모두 비슷하거나 동일할 것이다. 중심과 산포에 근거한 표준 요약통계량은 봉우리 수를 포착하지 못한다. 바이올린 그림, 히스토그램, 밀도추정에서 보이는 전체 모양만이 그 차이를 드러낸다.
연습문제 12. 위의 항공사 지연 자료에서 아메리칸의 지연 중앙값이 6.0%, IQR이 4.5%이고 사우스웨스트의 지연 중앙값이 2.4%, IQR이 2.0%라고 하자. 어떤 관리자가 "아메리칸의 지연이 정확히 2.5배 나쁘다"고 주장한다. 이 주장을 비판하라.
풀이
중앙값의 비는 \(6.0 / 2.4 = 2.5\)이므로 중앙값에 대해서는 그 주장이 성립한다. 그러나 "2.5배 나쁘다"는 지나친 단순화다. IQR의 비는 \(4.5 / 2.0 = 2.25\)로 산포는 다른 배율로 차이가 난다. 게다가 모양도 다를 수 있다(아메리칸의 Gamma(2, 3)이 사우스웨스트의 Gamma(1.2, 2)보다 더 대칭적이다). 하나의 배율로는 중심, 산포, 모양의 차이를 동시에 담아낼 수 없다.
연습문제 13. 상자그림은 보여주는데 바이올린 그림은 보여주지 못하는 이상치가 있을 수 있는 이유를 설명하라. 어떤 상황에서 바이올린 그림이 분포의 꼬리에 대해 오도할 수 있는가?
풀이
상자그림은 \(1.5 \times \text{IQR}\) 너머의 개별 관측값을 이산적인 점으로 표시한다. 바이올린 그림은 자료를 매끄럽게 만드는 커널밀도추정을 쓴다. 꼬리에 관측값이 적으면 KDE 추정값이 아주 낮아 바이올린이 가는 선으로 좁아지므로 극단값이 보이지 않게 된다. 다음과 같을 때 오도한다.
- 표본 크기가 작고 개별 이상치가 중요할 때.
- 극단 관측값이 중요한 정보를 담는, 꼬리가 두꺼운 분포(예: 코시분포)일 때.
- KDE의 대역폭이 너무 커서 꼬리가 지나치게 매끄러워질 때.
연습문제 14. 스웜 그림(또는 지터(jitter)를 준 스트립 그림)은 겹쳐 그려지는 것을 피하기 위해 수직으로 조금씩 흩뜨리면서 모든 관측값을 가로축을 따라 보여준다. 스웜 그림이 상자그림이나 바이올린 그림보다 나은 때는 언제인가?
풀이
스웜 그림은 모든 개별 관측값을 보여주며, 다음과 같을 때 가치가 있다.
- 표본 크기가 작을 때(\(n < 50\)): 관측값이 적으면 요약통계량이 잡음에 흔들리므로 상자그림과 바이올린이 오도할 수 있다. 각 점을 보여주면 보는 사람이 자료를 직접 판단할 수 있다.
- 관측값의 정확한 개수가 중요할 때: 임상시험이나 실험 연구에서는 집단별 개수가 이야기의 일부다. 스웜 그림은 이를 한눈에 보여준다.
- 이상치를 덜 중요한 것처럼 보이게 해서는 안 될 때: 상자그림의 "이상치"는 "이건 무시하라"는 인상을 주는 고립된 점이다. 스웜 그림은 모든 관측값을 동등하게 다룬다.
- 집단 안에 다봉성이나 군집이 있을 때: 스웜 그림에서 빈틈이나 덩어리로 보이며, 매끄러워진 바이올린에서는 가려지기도 한다.
다음과 같을 때는 스웜 그림이 적절하지 않다.
- 표본 크기가 아주 클 때(\(n > 1000\)): 점을 흩뜨려도 겹침을 막을 수 없어 그림이 뭉개진다.
- 여러 집단을 비교할 때: 스웜 그림은 상자그림보다 가로 공간을 더 차지한다.
- 이상치 식별이 목표일 때: 상자그림이 이상치를 시각적으로 더 두드러지게 만든다.
흔히 쓰는 복합 그림은 스웜 그림 위에 상자그림을 겹치는 것으로, 개별 자료와 요약을 함께 준다. Seaborn의 sns.stripplot(..., dodge=True) + sns.boxplot(...)이 이를 만들어낸다.
연습문제 15. 바이올린 그림의 분할 모드(집단당 반쪽 바이올린)는 짝지은 집단 비교를 시각적으로 선명하게 만든다. 분할 바이올린이 보는 사람을 오도하는 경우를 설명하고 그런 경우의 대안을 제안하라.
풀이
분할 바이올린은 다음과 같을 때 오도한다.
- 집단 간 표본 크기가 크게 다를 때: 각 반쪽이 같은 시각적 폭을 차지하도록 정규화되어 불균형이 감춰진다. 관측값 10개인 집단이 1000개인 집단만큼 시각적 무게를 갖는 것처럼 보인다.
- 분포의 모양이 매우 다를 때: 눈이 반대쪽 반쪽을 대칭으로 읽어, 밀도가 서로 무관한데도 거울상 분포처럼 보일 수 있다.
- 기준 축이 임의적일 때: 어느 집단을 어느 쪽에 두느냐가 "높음"과 "낮음"의 해석에 영향을 준다. 관례적인 순서가 없다면(예: "처리 A" 대 "처리 B") 분할 바이올린이 근거 없는 해석을 유도할 수 있다.
대안: 각 아래에 표본 크기를 표기한(\(n = 10\) 대 \(n = 1000\)) 전체 바이올린을 나란히 놓는다. 분할 바이올린의 시각적 우아함을 포기하는 대신 자료에 대해 정직해진다.
짝지은 자료(같은 대상을 두 번 측정)의 경우 분할이든 나란히든 바이올린은 짝지음을 포착하지 못한다. 짝 그림을 쓰라. 각 대상의 두 측정값을 선으로 잇는다. 이렇게 하면 개별 변화와 대상 내 변동의 크기가 보이는데, 짝지은 설계에서 실제로 관심 있는 양이 바로 그것이다.
정리하며¶
바이올린 그림은 상자그림에 밀도 정보를 더해 확장한 것으로, 다봉성이나 비대칭 같은 분포의 세부를 드러내는 데 이상적이다. 요약통계량만이 아니라 분포의 모양이 분석을 좌우하는 집단 비교에서 특히 효과적이다.
다음 쪽 스트립 그림과 스웜 그림으로 넘어간다. 바이올린이 밀도를 추정해 보여 주는 데 비해, 거기서는 관측값을 하나도 요약하지 않고 모두 찍는다. 앤스컴의 4중주가 보인 대로 같은 요약 뒤에 전혀 다른 자료가 숨을 수 있기 때문이다.