카이제곱 적합도 검정 (scipy)
개요
이 페이지에서는 편의 함수 scipy.stats.chisquare로 카이제곱 적합도 검정을 수행하는 방법을 보인다. 통계량과 p-값을 손으로 계산하는 대신 chisquare에 관측도수와 기대도수 배열을 넘기면 두 값을 바로 돌려준다. 바탕에 있는 수학을 이해한 뒤라면 실무 코드에서는 이 방식을 권한다.
가설
- 귀무가설 (\(H_0\)): 관측도수가 지정된 기대분포를 따른다.
- 대립가설 (\(H_A\)): 관측도수가 지정된 기대분포를 따르지 않는다.
검정통계량
이 함수는 내부적으로
을 자유도 \(\text{df} = k - 1\)로 계산한다. 여기서 \(k\)는 범주의 개수이다.
보기 1. scipy로 적합도 검정. 가위바위보 24 판에서 승 4, 패 13, 무 7 을 얻었고 귀무가설은 세 결과가 똑같이 그럴듯하다는 것이다.
(1) chisquare 는 f_exp 의 합이 f_obs 의 합과 다르면 오류를 낸다. 왜 그래야 하는가. 비율 \([1/3, 1/3, 1/3]\) 을 그대로 넘겼다면 어떤 값이 나왔을지 식으로 예측하시오.
(2) 통계량과 p-값을 손으로 구하시오. 자유도 2 에서는 p-값이 닫힌 꼴로 적힌다.
(3) 그 p-값은 극한분포가 준 값이다. \(n = 24\) 에서의 정확한 p-값을 전수 열거로 구해 견주고, 명목 \(5\%\) 기각역의 실제 제1종 오류율도 재시오.
풀이
(1) 합이 맞아야 \(\chi^2\) 이 된다. 통계량이 \(\chi^2_{k-1}\) 을 따르는 데에는 \(\sum_i (O_i - E_i) = 0\) 이라는 제약이 결정적이다. 그 제약 하나가 자유도를 \(k\) 에서 \(k-1\) 로 깎는 것이고, 제약이 깨지면 통계량이 엉뚱한 곳으로 밀려난다.
얼마나 밀려나는지는 정확히 계산된다. \(E_i = c\,p_i\) (\(\sum_i p_i = 1\), \(c \ne n\))를 넣고 \(d_i = O_i - np_i\) 라 두면 \(\sum_i d_i = 0\) 이므로
곧 교차항이 사라지고 깔끔한 꼴이 남는다.
여기서 \(\chi^2\) 은 올바르게 계산한 값이다. 비율을 그대로 넘기면 \(c = 1\) 이므로 \(n\chi^2 + (n-1)^2\) 이 되고, 수를 넣으면
이다. 참값 \(5.25\) 대신 \(655\) 가 나오고, 그중 \(529\) 는 자료와 아무 상관 없는 순전한 눈금 오류다. scipy 가 오류를 내 주는 것이 다행인 까닭이다.
(2) 손계산. 기대도수는 \(E_i = n/k = 24/3 = 8\) 이고
다. 자유도는 \(k - 1 = 2\) 이고, \(\chi^2_2\) 의 밀도가 \(\tfrac12 e^{-x/2}\) (평균 2 인 지수분포)라서 꼬리확률이 바로 적분된다.
\(p > 0.05\) 이므로 기각하지 못한다.
(3) 수치적으로.
from scipy import stats

# 결과별 관측도수: 승, 패, 무
observed_frequencies = [4, 13, 7]

# H0(균등분포) 아래의 기대도수.
# f_exp의 합은 f_obs의 합과 같아야 한다. 다르면 scipy가 오류를 낸다.
total_games = sum(observed_frequencies)
expected_frequencies = [total_games / 3] * 3

chi_square_statistic, p_value = stats.chisquare(
    f_obs=observed_frequencies, f_exp=expected_frequencies
)

print(f"{chi_square_statistic = }")
print(f"{p_value = }")
출력:
chi_square_statistic = 5.25
p_value = 0.07243975703425146
수동 계산 페이지의 결과와 정확히 같다. chisquare는 같은 식을 감싼 것일 뿐이다.
stats.chisquare의 주요 인자:
| 인자 | 설명 |
|---|---|
f_obs |
관측도수 배열 |
f_exp |
기대도수 배열(f_obs와 합이 같아야 한다). 생략하면 균등분포를 가정한다. |
ddof |
자유도 조정. 기본값은 0이며 \(\text{df} = k - 1\)이 된다. 자료로부터 모수를 추정했다면 그에 맞게 설정한다. |
(3) 근사가 얼마나 정확한가. \(\chi^2_2\) 은 \(n \to \infty\) 에서의 극한분포다. \(n = 24\) 에서는 \((\text{승},\text{패},\text{무})\) 가 취할 수 있는 조합이 \(\binom{26}{2} = 325\) 가지뿐이므로 귀무분포를 전부 열거할 수 있다.
from math import factorial
from scipy import stats

n, k = 24, 3
obs_stat = 5.25

# H0 가 참인 세상에서 가능한 (승, 패, 무) 조합을 전부 열거한다.
dist = {}
for a in range(n + 1):
    for b in range(n + 1 - a):
        c = n - a - b
        prob = (factorial(n) / (factorial(a) * factorial(b) * factorial(c))
                / k ** n)
        stat = sum((x - n / k) ** 2 / (n / k) for x in (a, b, c))
        dist[round(stat, 9)] = dist.get(round(stat, 9), 0.0) + prob

crit = stats.chi2.ppf(0.95, k - 1)
print(f"확률의 총합              {sum(dist.values()):.12f}")
print(f"통계량이 가질 수 있는 값   {len(dist)} 개")
print(f"E[chi2]   정확 {sum(s * v for s, v in dist.items()):.6f}   이론 k-1 = {k - 1}")
print(f"p-값      정확 {sum(v for s, v in dist.items() if s >= obs_stat - 1e-9):.6f}"
      f"   근사 {stats.chi2.sf(obs_stat, k - 1):.6f}")
print(f"명목 5% 임계값 {crit:.4f} 에서의 실제 제1종 오류율 "
      f"{sum(v for s, v in dist.items() if s >= crit - 1e-9):.6f}")
출력:
확률의 총합              1.000000000000
통계량이 가질 수 있는 값   44 개
E[chi2]   정확 2.000000   이론 k-1 = 2
p-값      정확 0.080040   근사 0.072440
명목 5% 임계값 5.9915 에서의 실제 제1종 오류율 0.049902
세 가지를 읽을 수 있다.
- 평균은 근사가 아니다. 정확한 \(E[\chi^2]\) 이 \(2.000000\) 으로 자유도 \(k-1=2\) 와 같다. 이것은 \(E[\chi^2] = \sum_i(1-p_i) = k-1\) 이라는 항등식에서 나오며 \(n\) 과 무관하게 정확하다.
- 325 가지 조합인데 통계량의 값은 44 개뿐이다. 범주를 바꿔 넣어도 통계량이 같기 때문이다. 귀무분포가 44 개의 점으로만 이루어진 성근 계단이라는 뜻이고, 이것이 아래 그림 (나)의 파란 계단이다.
- p-값은 근사가 작게 나온다. 정확값 \(0.080040\) 대 근사 \(0.072440\) 으로 근사가 약 \(10\%\) 작다. 이산인 통계량을 연속분포로 재기 때문이다.
그런데 명목 \(5\%\) 기각역의 실제 오류율은 \(0.049902\) 로 거의 정확하다. p-값 하나에서는 \(10\%\) 어긋났지만 임계값 근처에서는 계단이 운 좋게 잘 맞는다. \(0.0724\) 든 \(0.0800\) 든 결론은 "기각하지 못한다" 로 같다.
f_exp를 생략해도 되는 경우
귀무가설이 균등분포를 지정한다면 f_exp를 아예 생략해도 된다:
보기 2. 기대도수를 생략하는 경우.
(1) f_exp 를 생략하면 chisquare 는 무엇을 넣는가.
(2) 생략한 결과와 그 값을 명시한 결과가 "거의 같은" 것이 아니라 부동소수점 비트 단위로 같은지 확인하시오. \(n/k\) 가 유한소수로 떨어지지 않는 경우도 넣어 보시오.
(3) 생략해도 되는 경우와 그러면 안 되는 경우를 가르시오. 보기 1 (1)의 합 불일치와 달리 이쪽은 왜 더 위험한가.
풀이
(1) 균등분포를 넣는다. f_obs 의 합을 \(n\), 길이를 \(k\) 라 하면 각 기대도수가 \(n/k\) 로 채워진다. 여기서는 \(24/3 = 8\) 이다. 합이 자동으로 \(n\) 이 되므로 보기 1 (1)의 오류가 일어날 수 없다.
(2) 비트 단위로 같아야 한다. 생략과 명시가 같은 산술 경로를 지나기 때문이다. chisquare 가 속으로 하는 일이 f_exp = [sum(f_obs)/k] * k 한 줄이고, 그 뒤의 계산은 전혀 다르지 않다. 그러므로 \(n/k\) 가 \(16/3 = 5.333\ldots\) 처럼 이진수로 떨어지지 않는 경우에도 양쪽이 똑같이 같은 반올림을 받는다. 반올림 오차가 생기더라도 두 경로에서 같은 크기로 생기므로 결과가 어긋나지 않는다.
(3) 생략은 조용히 틀린다. 합이 어긋나면 scipy 가 ValueError 로 멈춰 준다. 그러나 귀무가설이 균등분포가 아닌데 f_exp 를 생략하면 아무 경고도 없다. 함수는 시킨 대로 균등분포를 검정하고 정상적으로 수를 돌려준다. 다만 그 수가 묻고자 한 질문의 답이 아니다. 보기 3 의 \([0.4, 0.3, 0.3]\) 처럼 가설이 균등하지 않을 때 f_exp 를 빠뜨리는 것이 이 함수에서 가장 흔한 실수다.
수치적으로.
statistic, p = stats.chisquare(f_obs=[4, 13, 7])
print(f"{statistic = }, {p = }")
출력:
statistic = 5.25, p = 0.07243975703425146
SciPy가 자동으로 각 기대도수를 \(n / k\)로 설정한다. 여기서 \(n\)은 전체 도수, \(k\)는 f_obs의 길이이다. 앞의 결과와 완전히 같다.
(2)를 네 가지 자료로 확인한다.
from scipy import stats

for obs in [[4, 13, 7], [1, 2, 3, 4], [7, 7, 7, 7, 7], [0, 5, 11]]:
    k = len(obs)
    uniform = [sum(obs) / k] * k          # scipy 가 속으로 넣는 값
    a = stats.chisquare(obs)              # f_exp 생략
    b = stats.chisquare(obs, f_exp=uniform)
    print(f"{str(obs):>18s}  n/k = {sum(obs) / k!r:<18s} "
          f"chi2 {a.statistic:8.4f}   같은가 "
          f"{a.statistic == b.statistic and a.pvalue == b.pvalue}")
출력:
        [4, 13, 7]  n/k = 8.0                chi2   5.2500   같은가 True
      [1, 2, 3, 4]  n/k = 2.5                chi2   2.0000   같은가 True
   [7, 7, 7, 7, 7]  n/k = 7.0                chi2   0.0000   같은가 True
        [0, 5, 11]  n/k = 5.333333333333333  chi2  11.3750   같은가 True
네 번째 줄이 (2)의 요점이다. \(16/3\) 은 이진 부동소수점으로 정확히 표현되지 않아 5.333333333333333 로 저장되는데, 생략한 쪽과 명시한 쪽이 같은 부정확한 값을 쓰므로 == 비교가 True 다. 세 번째 줄의 \(\chi^2 = 0\) 은 관측이 기대와 완전히 일치하는 극단으로, 통계량이 음수가 될 수 없음을 상기시킨다.
균등하지 않은 기대 비율
귀무가설이 서로 다른 비율 \(p_1, p_2, \ldots, p_k\)를 지정하면 기대도수를 \(E_i = n \cdot p_i\)로 계산하여 명시적으로 넘긴다:
보기 3. 기대 비율이 균등하지 않을 때. 고객 300 명의 연령대가 \(18\)–\(25\), \(26\)–\(40\), \(41\) 이상에 \(40\%,\ 30\%,\ 30\%\) 로 나뉜다는 주장을 검정한다. 관측도수는 \((130,\ 85,\ 85)\) 다.
(1) 기대도수를 구하고 \(\chi^2\) 을 유리수로, p-값을 닫힌 꼴로 구하시오.
(2) 비율 \([0.4, 0.3, 0.3]\) 을 f_exp 에 그대로 넘기면 어떻게 되는가. 막히지 않았다면 어떤 값이 나왔을지 보기 1 (1)의 식으로 예측하고 확인하시오.
(3) \(\alpha = 0.05\) 에서 판정하시오.
풀이
(1) 유리수로. \(E_i = n p_i\) 이므로 기대도수는 \((120,\ 90,\ 90)\) 이고
다. 자유도는 \(k-1 = 2\) 이므로 보기 1 (2)와 같은 닫힌 꼴을 쓴다.
(2) 식이 예측한다. 비율을 그대로 넘기면 \(c = \sum_i p_i = 1\) 이고 \(n = 300\) 이므로 보기 1 (1)의 식이
을 준다. 참값 \(1.39\) 대신 \(89{,}818\) 이 나오고 그중 \(89{,}401\) 은 자료와 무관한 눈금 오류다. 다행히 scipy 가 ValueError 로 막는다.
(3) 판정. \(p = 0.4994 > 0.05\) 이므로 기각하지 못한다. 관측 비율이 \(43.3\%,\ 28.3\%,\ 28.3\%\) 로 가설의 \(40\%,\ 30\%,\ 30\%\) 와 가깝다. 자유도 2 인 카이제곱의 평균이 2 인데 관측값이 \(1.39\) 이니 평균보다도 작은, 아주 흔한 값이다.
수치적으로.
n = 300
proportions = [0.4, 0.3, 0.3]
# 비율이 아니라 **도수**를 넘겨야 한다. 비율 [0.4, 0.3, 0.3]을 그대로 넣으면
# 합이 f_obs의 합과 달라 오류가 나거나, 운이 나쁘면 엉뚱한 값이 나온다.
expected = [n * p for p in proportions]
stat, pval = stats.chisquare(f_obs=[130, 85, 85], f_exp=expected)
print(f"{stat = :.4f}, {pval = :.4f}")
출력:
stat = 1.3889, pval = 0.4994
관측 비율이 43.3%, 28.3%, 28.3%로 가설의 40%, 30%, 30%에 가까워 기각하지 못한다(\(p = 0.50\)). 출력의 1.3889 와 0.4994 가 (1)의 \(25/18\) 과 \(e^{-25/36}\) 과 맞는다.
(2)도 확인해 둔다.
from scipy import stats

n = 300
proportions = [0.4, 0.3, 0.3]
obs = [130, 85, 85]

# ① 도수로 바꾸어 넘긴다 — 올바른 사용
stat, pval = stats.chisquare(f_obs=obs, f_exp=[n * p for p in proportions])
print(f"도수로 넘김   chi2 = {stat:.6f},  p = {pval:.6f}")

# ② 비율을 그대로 넘긴다 — scipy 가 막아 준다
try:
    stats.chisquare(f_obs=obs, f_exp=proportions)
except ValueError as e:
    print(f"비율로 넘김   ValueError: {str(e).splitlines()[0][:60]}...")

# 막지 않았다면 어떤 값이 나왔을까. 보기 1 (1) 의 식으로 예측한다.
c = sum(proportions)
predicted = (n / c) * stat + (n - c) ** 2 / c
actual = sum((o - c * p) ** 2 / (c * p) for o, p in zip(obs, proportions))
print(f"식의 예측 (n/c)chi2 + (n-c)^2/c = {predicted:.4f}")
print(f"직접 계산                        = {actual:.4f}")
출력:
도수로 넘김   chi2 = 1.388889,  p = 0.499352
비율로 넘김   ValueError: For each axis slice, the sum of the observed frequencies mus...
식의 예측 (n/c)chi2 + (n-c)^2/c = 89817.6667
직접 계산                        = 89817.6667
예측과 직접 계산이 소수 넷째 자리까지 같다. 보기 1 (1)에서 교차항이 사라진다고 한 유도가 맞다는 뜻이다. 합이 맞지 않는 f_exp 는 조금 틀린 답을 주는 것이 아니라 자료와 무관한 수를 더해 버린다.
해석
가위바위보 보기에서 이 함수는 \(\chi^2 = 5.25\)와 \(p \approx 0.0725\)를 준다. 유의수준 \(\alpha = 0.05\)에서 \(H_0\)을 기각하지 못한다. 경기 결과가 균등분포에서 벗어난다는 증거가 충분하지 않다.
scipy.stats.chisquare 함수는 수동 계산을 얇게 감싼 것이다. 주된 장점은 간결함과 계산 실수의 여지가 줄어든다는 점이다.
5.25 는 얼마나 큰 값인가
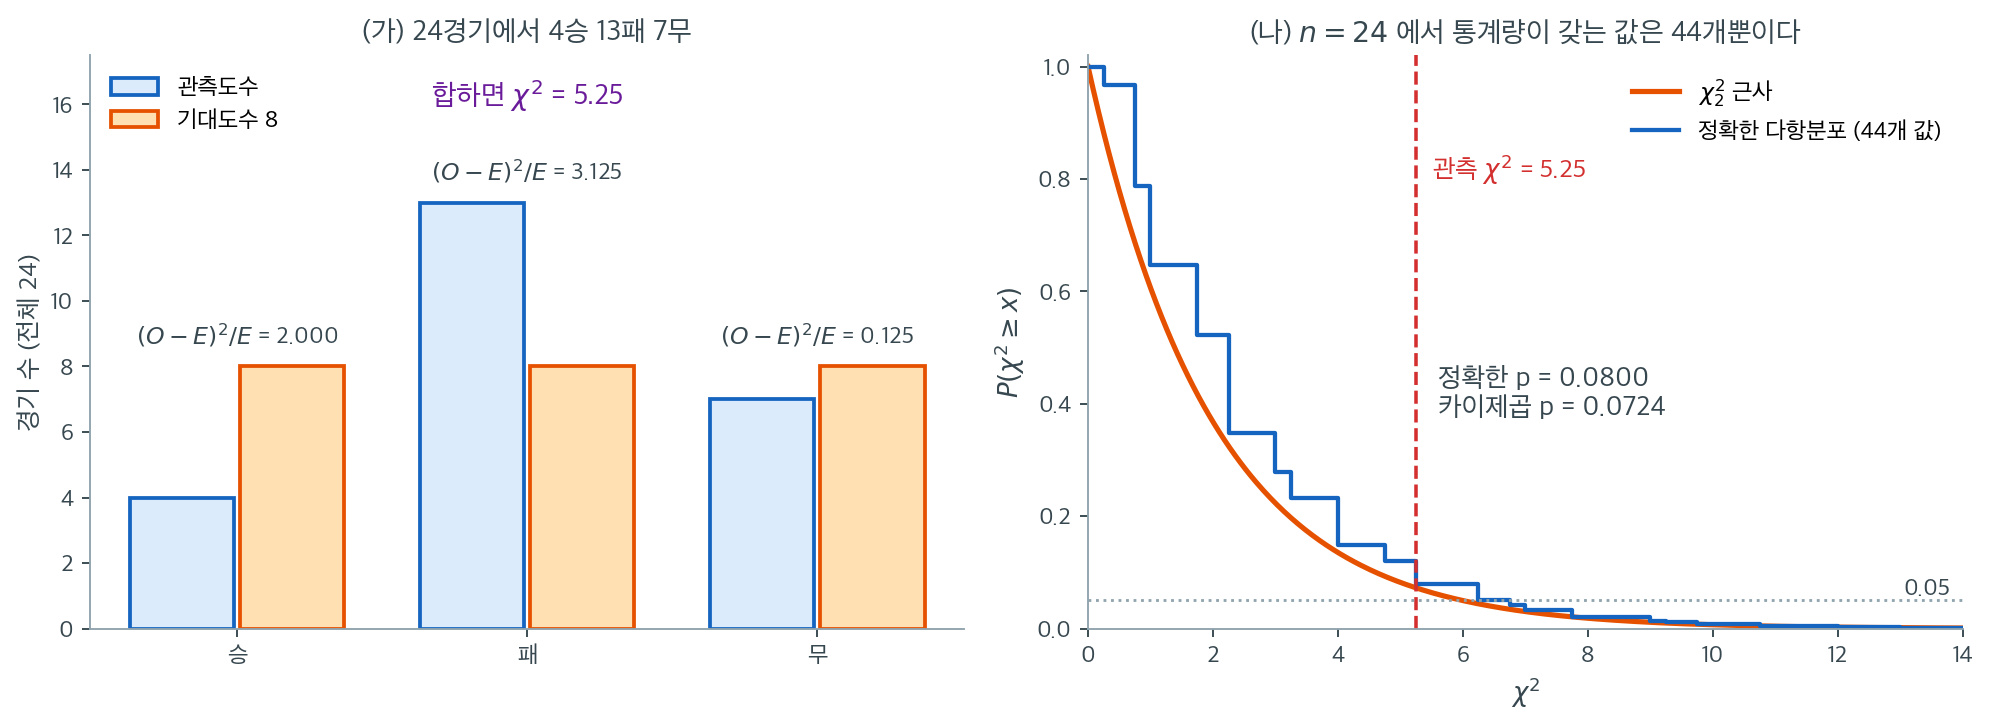
왼쪽 (가)가 자료다. 승 4, 패 13, 무 7이고 \(H_0\) 아래 기대도수는 셋 다 8이다. 칸별 기여도를 보면 패가 3.125로 가장 크고, 승이 2.000, 무가 0.125이다. 더하면 5.25다. 4승 13패는 눈으로 보기에 꽤 치우쳐 보이지만, 24경기에서 8을 기준으로 5칸 어긋난 것이 전부라는 점도 같이 보아야 한다.
오른쪽 (나)가 그 판단을 대신해 준다. \(n = 24\), 균등한 \(H_0\) 아래에서 가능한 분할을 전부 열거하면 통계량이 가질 수 있는 값은 44개뿐이고, 파란 계단이 그 정확한 꼬리확률이다. 관측 5.25에서 계단의 높이, 즉 정확한 p-값은 0.0800이다. 주황 곡선인 \(\chi^2_2\) 근사는 0.0724를 준다. 둘 다 0.05를 넘으므로 chisquare가 준 결론은 맞지만, 근사 쪽이 조금 작게 나온다는 점은 기억해 둘 만하다.
기대도수가 8이라 "모두 5 이상"이라는 경험 법칙은 만족한다. 실제로 근사의 품질을 다른 방식으로 재 보면, \(\chi^2_2\)의 5% 임계값 5.991을 기각 경계로 썼을 때 진짜 제1종 오류율은 0.0499로 명목값 0.05에 거의 정확히 맞는다. 계단이 성근데도 평균적으로는 잘 맞는다는 뜻이다.
한 가지만 덧붙이자. 같은 비율이 세 배 규모의 72경기에서 나왔다면 통계량도 세 배인 15.75가 되어 \(p = 0.0004\)가 된다. 기각하지 못한 것은 4대 13이라는 치우침이 작아서가 아니라 24경기가 적어서다. 표본이 작으면 꽤 큰 차이도 우연의 범위 안에 들어온다.
연습문제
연습문제 1.
stats.chisquare를 f_obs=[10, 20, 30]만 주고(f_exp 없이) 실행하라. SciPy는 어떤 기대도수를 가정하며, 통계량과 p-값은 얼마인가?
풀이
SciPy는 균등분포를 가정하므로 각 범주에서 \(E_i = 60/3 = 20\)이다. 통계량은
이다. \(\text{df} = 2\)에서 p-값은 \(P(\chi^2_2 \ge 10) \approx 0.0067\)이므로 \(\alpha = 0.05\)에서 \(H_0\)을 기각한다. \(\square\)
연습문제 2.
어떤 연구자가 자료에 포아송 모형을 적합하고 표본으로부터 모수 \(\lambda\)를 추정했다. 자료의 범주는 5개이다. ddof 인자에 어떤 값을 넘겨야 하며 이유는 무엇인가?
풀이
모수 하나(\(\lambda\))를 자료로부터 추정했으므로 자유도를 하나 더 잃는다. ddof=1을 넘기면 \(\text{df} = k - 1 - \text{ddof} = 5 - 1 - 1 = 3\)이 된다. ddof 인자는 자료로부터 추정한 모수가 표준 기준선 \(k-1\)보다 자유도를 더 줄이는 것을 반영한다. \(\square\)
연습문제 3.
f_exp의 합이 f_obs의 합과 같지 않으면 어떻게 되는가? stats.chisquare(f_obs=[10, 20], f_exp=[5, 5])로 시험해 보고 결과를 설명하라.
풀이
기대도수의 합(10)이 관측도수의 합(30)과 맞지 않으므로 SciPy는 오류를 내거나 오도하는 결과를 준다. 구체적으로 stats.chisquare는 f_exp를 자동으로 다시 축척하지 않는다. 검정이 의미를 가지려면 기대도수의 합이 관측도수의 합과 같아야 한다. 올바른 호출은 f_exp=[15, 15]처럼 다시 축척하거나, 비율에 관측 총합을 곱해서 쓰는 것이다. \(\square\)
연습문제 4. 카이제곱 통계량이 다음과 같이 다시 쓰일 수 있음을 대수적으로 보여라:
여기서 \(n = \sum_{i=1}^{k} O_i = \sum_{i=1}^{k} E_i\)이다.
풀이
표준 공식을 전개하면
이다. \(\sum O_i = \sum E_i = n\)이므로 이는
으로 단순해진다. \(\square\)
연습문제 5.
어떤 주머니에 빨강 50%, 파랑 30%, 초록 20%의 구슬이 들어 있다고 한다. 구슬 200개를 (복원으로) 뽑아 \([90, 70, 40]\)을 관측했다. stats.chisquare로 \(\alpha = 0.01\)에서 이 주장을 검정하고 결론을 서술하라.
풀이
기대도수: \(E = [200 \times 0.5,\; 200 \times 0.3,\; 200 \times 0.2] = [100, 60, 40]\).
from scipy import stats
stat, p = stats.chisquare(f_obs=[90, 70, 40], f_exp=[100, 60, 40])
print(f"{stat = :.4f}, {p = :.4f}")
출력:
stat = 2.6667, p = 0.2636
\(\text{df} = 2\)에서 p-값은 약 \(0.2636\)이다. \(p = 0.2636 > 0.01 = \alpha\)이므로 \(H_0\)을 기각하지 못한다. 1% 유의수준에서 자료는 주장된 비율과 부합한다. \(\square\)
연습문제 6.
scipy.stats.power_divergence의 lambda_ 인자로 카이제곱 계열의 여러 통계량을 한 번에 계산하고 비교하라.
풀이
크레시·리드 계열. 한 매개변수 \(\lambda\)로 여러 통계량을 통합한다.
| \(\lambda\) | 이름 |
|---|---|
| 1 | 피어슨 \(X^2\) |
| 0 | 우도비 \(G^2\) |
| \(-1/2\) | 프리먼·튜키 |
| \(2/3\) | 크레시·리드(권장값) |
| \(-1\) | 수정 우도비 |
| \(-2\) | 네이만 수정 |
from scipy import stats

obs = [90, 70, 40]
p = [0.5, 0.3, 0.2]
n = sum(obs)
exp = [n * q for q in p]

print(f"{'lambda_':>8s} {'이름':>14s} {'통계량':>10s} {'p 값':>9s}")
for lam, name in [(1, "피어슨 X²"), (0, "우도비 G²"), (-0.5, "프리먼·튜키"),
                  (2 / 3, "크레시·리드"), (-1, "수정 우도비"),
                  (-2, "네이만 수정")]:
    r = stats.power_divergence(f_obs=obs, f_exp=exp, lambda_=lam)
    print(f"{lam:8.3f} {name:>14s} {r.statistic:10.4f} {r.pvalue:9.4f}")
 lambda_             이름        통계량       p 값
   1.000         피어슨 X²     2.6667    0.2636
   0.000         우도비 G²     2.6162    0.2703
  -0.500         프리먼·튜키     2.5941    0.2733
   0.667         크레시·리드     2.6489    0.2659
  -1.000         수정 우도비     2.5740    0.2761
  -2.000         네이만 수정     2.5397    0.2809
여섯 통계량이 2.54~2.67로 거의 같다. \(p\) 값도 0.264~0.281이다. \(n=200\)이고 기대도수가 넉넉하면 어느 것을 써도 결론이 같다.
차이는 소표본에서 드러난다. 앞 절에서 본 대로 \(n=20\)이면 네이만 수정(\(\lambda=-2\), 분모가 \(O_i\)인 그것)이 수준을 0.28까지 부풀린다.
문자열과 \(\lambda\) 값의 대응에 주의한다. scipy에서 "neyman"은 \(\lambda=-2\), "mod-log-likelihood"는 \(\lambda=-1\)이다. 이름만 보고 짐작하면 틀리기 쉽다.
크레시·리드가 \(\lambda=2/3\)을 권장하는 이유. 피어슨(\(\lambda=1\))과 우도비(\(\lambda=0\)) 사이에서, 소표본 근사 오차가 가장 작다는 것이 그들의 결과다. 실무에서 큰 차이는 없지만 이론적으로는 매력적이다.
lambda_를 문자열로도 줄 수 있다.
for name in ["pearson", "log-likelihood", "freeman-tukey",
             "cressie-read", "neyman", "mod-log-likelihood"]:
    r = stats.power_divergence(f_obs=obs, f_exp=exp, lambda_=name)
    print(f"{name:>20s}  통계량 {r.statistic:.4f}")
             pearson  통계량 2.6667
      log-likelihood  통계량 2.6162
       freeman-tukey  통계량 2.5941
        cressie-read  통계량 2.6489
              neyman  통계량 2.5397
  mod-log-likelihood  통계량 2.5740
실무 권고.
| 상황 | 선택 |
|---|---|
| 기본 | chisquare(= lambda_=1) |
| 로그선형모형의 모형 비교 | lambda_=0 (\(G^2\)) |
| 소표본이 걱정 | lambda_=2/3 또는 정확검정 |
| 절대 쓰지 말 것 | lambda_=-2(네이만) |
연습문제 7.
chisquare, chi2_contingency, fisher_exact의 입력과 용도가 어떻게 다른지 정리하고, 같은 자료에 잘못 적용했을 때 무슨 일이 생기는지 보여라.
풀이
import numpy as np
from scipy import stats

table = np.array([[30, 20], [15, 35]])          # 2×2 분할표

r1 = stats.chi2_contingency(table, correction=False)
print(f"chi2_contingency (올바름)    χ²={r1[0]:.4f}  df={r1[2]}  "
      f"p={r1[1]:.6f}")
print(f"  기대도수\n{np.round(r1[3], 2)}")

# 잘못된 사용: 분할표를 1차원으로 펴서 적합도 검정으로
r2 = stats.chisquare(f_obs=table.ravel())
print(f"\nchisquare (잘못)             χ²={r2.statistic:.4f}  df=3  "
      f"p={r2.pvalue:.6f}")
print(f"  → 이것은 '네 칸이 모두 같은가'를 검정한 것이다")

odds, p_f = stats.fisher_exact(table)
print(f"\nfisher_exact                 오즈비={odds:.4f}  p={p_f:.6f}")
chi2_contingency (올바름)    χ²=9.0909  df=1  p=0.002569
  기대도수
[[22.5 27.5]
 [22.5 27.5]]

chisquare (잘못)             χ²=10.0000  df=3  p=0.018566
  → 이것은 '네 칸이 모두 같은가'를 검정한 것이다

fisher_exact                 오즈비=3.5000  p=0.004635
잘못된 사용이 오류를 내지 않고 그럴듯한 값을 준다. \(p=0.019\)도 유의하니 무심코 넘어가기 쉽다.
무엇이 달라졌나.
chi2_contingency |
chisquare(오용) |
|
|---|---|---|
| 검정하는 것 | 행과 열의 독립성 | 네 칸의 균등성 |
| 기대도수 | 주변합에서 계산 | 모두 25 |
| 자유도 | \((2-1)(2-1)=1\) | \(4-1=3\) |
오용은 "행 주변합과 열 주변합이 모두 균등하다"까지 함께 검정한 셈이다. 여기서는 열 주변합이 45와 55로 다른데, 그 차이가 통계량에 섞여 들어갔다.
세 함수의 용도.
| 함수 | 입력 | 검정 |
|---|---|---|
chisquare |
1차원 도수 + 기대도수 | 적합도 |
chi2_contingency |
2차원 분할표 | 독립성·동질성 |
fisher_exact |
2×2 표 | 독립성(정확) |
가장 흔한 실수 셋.
- 분할표를
chisquare에 넣기. 위의 경우다. chi2_contingency에 1차원 배열 넣기. 자유도가 0이 되어 오류가 나거나 무의미한 결과를 준다.correction=True를 \(2\times2\)에서 기본으로 두기.scipy의 기본값이True라서 모르는 사이에 야츠 보정이 적용된다.
for corr in [True, False]:
    r = stats.chi2_contingency(table, correction=corr)
    print(f"correction={str(corr):5s}:  χ²={r[0]:.4f}  p={r[1]:.6f}")
correction=True :  χ²=7.9192  p=0.004891
correction=False:  χ²=9.0909  p=0.002569
보정 여부로 \(p\)가 두 배 차이난다(0.0049 대 0.0026). 앞 절에서 본 대로 야츠 보정은 지나치게 보수적이므로, \(2\times2\)에서 correction=False를 명시하는 습관을 권한다.
연습문제 8.
연습문제 3이 확인한 "f_exp의 합이 맞아야 한다"는 제약을 실무에서 어떻게 다루는지 정리하라. 기대비율만 알 때의 올바른 코드를 작성하라.
풀이
import numpy as np
from scipy import stats

obs = [90, 70, 40]
p_exp = [0.5, 0.3, 0.2]           # 비율만 주어진 경우

# ① 틀린 방법: 비율을 그대로 f_exp 에 넣는다
try:
    stats.chisquare(f_obs=obs, f_exp=p_exp)
except ValueError as e:
    print(f"① 비율을 그대로:  ValueError\n   {e}\n")

# ② 올바른 방법: n 을 곱해 도수로 바꾼다
n = sum(obs)
exp = np.array(p_exp) * n
r = stats.chisquare(f_obs=obs, f_exp=exp)
print(f"② n 을 곱한 뒤:  χ²={r.statistic:.4f}  p={r.pvalue:.4f}")
print(f"   f_exp = {exp.tolist()},  합 = {exp.sum():.1f} = n\n")

# ③ 비율의 합이 1 이 아닐 때는 먼저 정규화한다
p_raw = [5, 3, 2]                  # 5:3:2 비율
p_norm = np.array(p_raw) / sum(p_raw)
exp3 = p_norm * n
r3 = stats.chisquare(f_obs=obs, f_exp=exp3)
print(f"③ 5:3:2 비율:  정규화 {np.round(p_norm, 4).tolist()}")
print(f"   f_exp = {exp3.tolist()},  χ²={r3.statistic:.4f}  p={r3.pvalue:.4f}")
① 비율을 그대로:  ValueError
   For each axis slice, the sum of the observed frequencies must agree with the sum of the expected frequencies to a relative tolerance of 1e-08, but the percent differences are:
199.0

② n 을 곱한 뒤:  χ²=2.6667  p=0.2636
   f_exp = [100.0, 60.0, 40.0],  합 = 200.0 = n

③ 5:3:2 비율:  정규화 [0.5, 0.3, 0.2]
   f_exp = [100.0, 60.0, 40.0],  χ²=2.6667  p=0.2636
scipy가 오류를 내 주는 것이 다행이다. 합이 다르면 통계량에 "전체 규모의 차이"가 섞여 들어가 무의미해지기 때문이다.
왜 합이 같아야 하는가. 카이제곱 통계량의 유도에서 제약 \(\sum(O_i-E_i)=0\)이 쓰였고, 이것이 자유도가 \(k-1\)인 이유다. 합이 다르면
- 제약이 깨져 자유도가 \(k\)가 되어야 하고,
- 게다가 "합이 다르다"는 사실 자체가 통계량을 부풀린다.
실무 함수로 감싸 두면 실수를 막을 수 있다.
def gof(obs, ratios=None, n_estimated=0):
    """기대비율(정규화 여부 무관)을 받아 적합도 검정을 수행한다."""
    obs = np.asarray(obs, float)
    n, k = obs.sum(), len(obs)
    if ratios is None:
        p = np.full(k, 1 / k)
    else:
        p = np.asarray(ratios, float)
        p = p / p.sum()                       # 알아서 정규화
    exp = n * p
    r = stats.chisquare(f_obs=obs, f_exp=exp, ddof=n_estimated)
    return {"chi2": r.statistic, "df": k - 1 - n_estimated,
            "p": r.pvalue, "E_min": exp.min()}

for ratios in [None, [0.5, 0.3, 0.2], [5, 3, 2], [50, 30, 20]]:
    out = gof(obs, ratios)
    print(f"ratios={str(ratios):>18s} → χ²={out['chi2']:7.4f}  "
          f"p={out['p']:.4f}  E_min={out['E_min']:.1f}")
ratios=              None → χ²=19.0000  p=0.0001  E_min=66.7
ratios=   [0.5, 0.3, 0.2] → χ²= 2.6667  p=0.2636  E_min=40.0
ratios=         [5, 3, 2] → χ²= 2.6667  p=0.2636  E_min=40.0
ratios=      [50, 30, 20] → χ²= 2.6667  p=0.2636  E_min=40.0
세 가지 표현이 모두 같은 결과를 준다. 정규화를 함수 안에서 처리했기 때문이다.
ratios=None(균등 가정)일 때 \(p=0.0001\)로 크게 다르다. 귀무가설이 달라졌으니 당연하다. "기대분포를 무엇으로 둘 것인가"가 검정의 핵심이고, f_exp를 생략하면 조용히 균등분포가 가정된다는 점을 잊으면 안 된다.
연습문제 9.
연속형 자료에 대해 chisquare와 전용 적합도 검정들을 같은 자료에 적용해 비교하라.
풀이
import numpy as np
from scipy import stats

rng = np.random.default_rng(4242)
n = 200

def compare(x, label):
    # ① 카이제곱: 등확률 구간 8개로 나눈다 (μ, σ 를 자료에서 추정)
    k = 8
    mu, sd = x.mean(), x.std(ddof=1)
    qs = np.linspace(0, 1, k + 1)[1:-1]
    edges = np.r_[-np.inf, mu + sd * stats.norm.ppf(qs), np.inf]
    obs = np.histogram(x, bins=edges)[0]
    chi2 = stats.chisquare(f_obs=obs, f_exp=np.full(k, len(x) / k),
                           ddof=2)
    print(f"{label}")
    print(f"  카이제곱(구간 8, ddof=2)  통계량 {chi2.statistic:7.4f}  "
          f"p={chi2.pvalue:.4f}")
    print(f"  샤피로·윌크              W={stats.shapiro(x).statistic:.4f}  "
          f"p={stats.shapiro(x).pvalue:.4f}")
    ad = stats.anderson(x, dist='norm')
    crit5 = ad.critical_values[list(ad.significance_level).index(5.0)]
    print(f"  앤더슨·달링              A²={ad.statistic:.4f}  "
          f"5% 임계값 {crit5:.4f}  "
          f"{'기각' if ad.statistic > crit5 else '기각 못 함'}")
    ks = stats.kstest((x - mu) / sd, 'norm')
    print(f"  콜모고로프·스미르노프      D={ks.statistic:.4f}  "
          f"p={ks.pvalue:.4f}  (모수 추정을 무시한 값이라 보수적)")

compare(rng.standard_normal(n), "① 정규자료")
print()
compare(rng.standard_t(4, n), "② t(4) — 꼬리가 두껍다")
print()
compare(rng.lognormal(0, 0.6, n), "③ 로그정규 — 오른쪽으로 치우침")
① 정규자료
  카이제곱(구간 8, ddof=2)  통계량  7.6000  p=0.1797
  샤피로·윌크              W=0.9961  p=0.8959
  앤더슨·달링              A²=0.2088  5% 임계값 0.7720  기각 못 함
  콜모고로프·스미르노프      D=0.0313  p=0.9862  (모수 추정을 무시한 값이라 보수적)

② t(4) — 꼬리가 두껍다
  카이제곱(구간 8, ddof=2)  통계량 18.4000  p=0.0025
  샤피로·윌크              W=0.8983  p=0.0000
  앤더슨·달링              A²=1.6305  5% 임계값 0.7720  기각
  콜모고로프·스미르노프      D=0.0767  p=0.1806  (모수 추정을 무시한 값이라 보수적)

③ 로그정규 — 오른쪽으로 치우침
  카이제곱(구간 8, ddof=2)  통계량 40.8800  p=0.0000
  샤피로·윌크              W=0.9027  p=0.0000
  앤더슨·달링              A²=4.2416  5% 임계값 0.7720  기각
  콜모고로프·스미르노프      D=0.0996  p=0.0352  (모수 추정을 무시한 값이라 보수적)
꼬리가 두꺼운 \(t(4)\)에서 검정들이 갈린다.
| 검정 | \(t(4)\) 판정 |
|---|---|
| 카이제곱 | \(p=0.0025\) — 잡음 |
| 콜모고로프·스미르노프 | \(p=0.181\) — 못 잡음 |
| 샤피로·윌크 | \(p<0.001\) — 잡음 |
| 앤더슨·달링 | \(A^2=1.63>0.77\) — 잡음 |
콜모고로프·스미르노프만 놓친다. \(D\) 통계량은 경험분포와 이론분포의 최대 수직 거리인데, 그 거리가 대개 분포의 중앙 근처에서 최대가 된다. 꼬리에서는 두 누적분포가 모두 0이나 1에 붙어 있어 차이가 드러나지 않는다.
앤더슨·달링은 정확히 그 약점을 고친 것이다. 가중치 \(1/[F(1-F)]\)가 꼬리에서 커지도록 설계되어 있다.
카이제곱이 여기서는 잡았지만, 운에 기댄 결과다. 등확률 구간 8개가 우연히 이 이탈을 담아냈다. 구간 수를 바꾸면 결론이 달라진다.
x = rng.standard_t(4, 300)
mu, sd = x.mean(), x.std(ddof=1)
print(f"{'구간 수':>7s} {'χ²':>9s} {'df':>4s} {'p':>9s}")
for k in [4, 6, 8, 12, 20]:
    qs = np.linspace(0, 1, k + 1)[1:-1]
    edges = np.r_[-np.inf, mu + sd * stats.norm.ppf(qs), np.inf]
    obs = np.histogram(x, bins=edges)[0]
    r = stats.chisquare(f_obs=obs, f_exp=np.full(k, len(x) / k), ddof=2)
    print(f"{k:7d} {r.statistic:9.4f} {k - 3:4d} {r.pvalue:9.4f}")
print(f"참고: 샤피로·윌크 p = {stats.shapiro(x).pvalue:.6f}")
   구간 수        χ²   df         p
      4    8.6667    1    0.0032
      6   10.0800    3    0.0179
      8   16.3200    5    0.0060
     12   17.3600    9    0.0434
     20   27.2000   17    0.0552
참고: 샤피로·윌크 p = 0.000007
같은 자료인데 \(p\)가 0.003에서 0.055까지 흔들린다. 구간 20개에서는 5% 수준을 넘지 못한다. 반면 샤피로·윌크는 \(p=7\times10^{-6}\)으로 흔들림 없이 잡아낸다.
결론 — 연속형 자료에 카이제곱을 쓰지 않는다.
- 구간을 나누면서 정보를 버린다.
- 구간 경계와 개수에 결과가 좌우된다. 위 표가 그 증거다.
- 모수를 추정하면 자유도가 정확하지 않다(체르노프·레만 문제).
- 전용 검정이 더 안정적이다. 샤피로·윌크와 앤더슨·달링은 세 자료 모두에서 일관된 판정을 내렸다.
주의 — 콜모고로프·스미르노프의 함정. 위 코드처럼 표본의 \(\bar x,s\)로 표준화한 뒤 kstest를 부르면, 모수를 추정했다는 사실을 반영하지 않아 지나치게 보수적이다. 올바르게 하려면 릴리포스 검정(statsmodels의 lilliefors)을 쓰거나 모의실험으로 임계값을 얻어야 한다.
연습문제 10.
scipy로 적합도 검정을 할 때의 함수 선택표와 흔한 함정을 정리하라.
풀이
함수 선택표.
| 상황 | 함수 | 핵심 인자 |
|---|---|---|
| 범주형 1차원, 적합도 | stats.chisquare |
f_exp, ddof |
| 계열 통계량 비교 | stats.power_divergence |
lambda_ |
| 분할표, 독립성·동질성 | stats.chi2_contingency |
correction |
| \(2\times2\), 소표본 | stats.fisher_exact |
alternative |
| \(2\times2\), 무조건부 | stats.barnard_exact |
— |
| 대응 \(2\times2\) | statsmodels의 mcnemar |
exact |
| 정규성 | stats.shapiro |
— |
| 임의 분포 적합도(연속) | stats.kstest, stats.anderson |
dist |
함정 여덟.
| # | 함정 | 증상·대처 |
|---|---|---|
| 1 | f_exp 합이 \(n\)과 다름 |
ValueError — \(n\)을 곱해 도수로 |
| 2 | f_exp를 생략 |
조용히 균등분포를 가정 |
| 3 | 모수 추정 후 ddof 누락 |
\(p\)가 커져 모형이 통과 |
| 4 | 분할표를 chisquare에 |
다른 가설을 검정하게 됨 |
| 5 | chi2_contingency의 correction 기본값 |
\(2\times2\)에서 자동으로 야츠 보정 |
| 6 | 백분율을 도수 자리에 | 사실상 \(n=100\) 고정 |
| 7 | 0인 칸 | \(G^2\)에서 log(0) 문제 |
| 8 | 연속형을 구간화 | 검정력 손실 |
2번과 5번은 오류가 나지 않아 특히 위험하다.
from scipy import stats

obs = [90, 70, 40]
print(f"f_exp 생략     → p = {stats.chisquare(f_obs=obs).pvalue:.6f}")
print(f"f_exp 명시     → p = "
      f"{stats.chisquare(f_obs=obs, f_exp=[100, 60, 40]).pvalue:.6f}")
f_exp 생략     → p = 0.000075
f_exp 명시     → p = 0.263597
같은 자료인데 \(p\)가 3500배 차이난다. 귀무가설이 다르니 당연하지만, 코드만 보고는 어느 가설을 검정했는지 알기 어렵다. f_exp를 언제나 명시하는 습관이 안전하다.
권장 작성 방식.
def run_gof(obs, ratios, n_estimated=0, label=""):
    """의도를 코드에 드러내는 적합도 검정 래퍼."""
    import numpy as np
    obs = np.asarray(obs, float)
    p = np.asarray(ratios, float)
    p = p / p.sum()
    exp = obs.sum() * p
    r = stats.chisquare(f_obs=obs, f_exp=exp, ddof=n_estimated)
    df = len(obs) - 1 - n_estimated
    print(f"{label}: χ²={r.statistic:.4f}, df={df}, p={r.pvalue:.4f}, "
          f"E_min={exp.min():.2f}")
    if exp.min() < 5:
        print("   ⚠ 기대도수가 5 미만인 칸이 있다. 병합이나 정확검정을 고려하라.")
    return r

run_gof([90, 70, 40], [0.5, 0.3, 0.2], label="주머니 구슬")
run_gof([4, 13, 7], [1, 1, 1], label="가위바위보")
run_gof([30, 12, 5, 2], [0.6, 0.25, 0.1, 0.05], label="소표본 예")
주머니 구슬: χ²=2.6667, df=2, p=0.2636, E_min=40.00
가위바위보: χ²=5.2500, df=2, p=0.0724, E_min=8.00
소표본 예: χ²=0.1020, df=3, p=0.9916, E_min=2.45
   ⚠ 기대도수가 5 미만인 칸이 있다. 병합이나 정확검정을 고려하라.
이런 래퍼의 이득 셋.
- 기대비율을 반드시 적게 만들어 2번 함정을 막는다.
- \(E_{\min}\)을 자동으로 경고해 4번·8번을 줄인다.
- 자유도를 함께 출력해 3번을 눈에 띄게 한다.
한 문장. scipy 함수는 짧지만, 무엇을 귀무가설로 두었는지가 인자에 숨어 있다. 그것을 코드 표면에 드러내는 것이 재현 가능한 분석의 첫걸음이다.
정리하며
실무에서는 scipy.stats.chisquare 한 줄이면 된다.
- 관측도수와 기대도수를 넘기면 통계량과 \(p\) 값이 나온다. 기대도수를 생략하면 균등분포를 가정한다.
f_exp의 합이f_obs의 합과 같아야 한다. 확률을 넘기면 안 되고 도수로 변환해 넘겨야 하며, 어긋나면 오류가 난다.ddof로 자유도를 조정한다. 기본 자유도가 \(k-1\) 이고, 모수를 \(r\) 개 추정했다면ddof=r을 주어야 \(k-1-r\) 이 된다. 이 인자를 빠뜨리는 것이 가장 흔한 실수다.- 앞 절의 수동 계산과 같은 값이 나오는지 확인한다. 그것이 이 두 절을 나란히 둔 이유다.
- 함수가 가정을 확인해 주지는 않는다. 기대도수가 작아도 조용히 값을 돌려주므로, 타당성 조건은 사용자가 따로 챙겨야 한다.
다음 절 독립성 검정 (수동 계산과 그림) 으로 넘어간다.