분산추정량의 평균제곱오차
동기
앞 절들에서 모분산의 자연스러운 추정량 둘을 만났다: \(n\)으로 나누기(MLE)와 \(n-1\)로 나누기(Bessel 수정). MLE는 편향되어 있지만 분산이 작고, Bessel 추정량은 불편이지만 변동이 크다. 평균제곱오차(MSE)는 편향과 분산을 함께 저울질하는 하나의 기준을 주므로 이렇게 물을 수 있다: 전체 추정오차를 최소화하는 분모가 존재하는가?
설정
\(X_1, X_2, \ldots, X_n \overset{iid}{\sim} N(\mu, \sigma^2)\)이라 하자. 편차제곱합을 다음과 같이 정의한다.
정규성 아래에서 \(Q / \sigma^2 \sim \chi^2_{n-1}\)이다. 이 분포 결과가 필요한 적률을 준다:
상수 \(c > 0\)에 대해 \(\hat{\sigma}^2 = cQ\) 형태인 \(\sigma^2\)의 추정량은 다음을 만족한다.
세 가지 추정량
위 공식에 흔히 쓰는 세 가지 \(c\)를 대입하면 다음 비교를 얻는다:
| 추정량 | 나누는 수 | 편향 | 평균제곱오차 |
|---|---|---|---|
| MLE | \(n\) | \(-\sigma^2/n\) | \(\dfrac{2n-1}{n^2}\,\sigma^4\) |
| Bessel 수정 | \(n-1\) | \(0\) | \(\dfrac{2}{n-1}\,\sigma^4\) |
| 평균제곱오차 최적 | \(n+1\) | \(-\dfrac{2\sigma^2}{n+1}\) | \(\dfrac{2}{n+1}\,\sigma^4\) |
각 항목은 위에서 유도한 일반 MSE 공식에 \(c = 1/n\), \(c = 1/(n-1)\), \(c = 1/(n+1)\)을 대입한 결과이다.
최적 분모의 유도
\(cQ\) 형태의 모든 추정량 중에서 어느 \(c\)가 평균제곱오차를 최소화하는가? MSE 식을 전개하면:
\(c\)에 대해 미분하고 0으로 놓으면:
\(2(n-1)\)을 묶어내면:
\(n \geq 2\)이므로 \(2(n-1)\)로 나눌 수 있고, \(c(n+1) = 1\)에서
이 형태의 모든 추정량 중에서 \(n+1\)로 나눌 때 평균제곱오차가 가장 작음이 확인된다.
수치 보기
실질적인 차이를 보기 위해 \(n = 10\), \(\sigma^2 = 1\)을 생각하자. 세 추정량의 평균제곱오차는:
| 추정량 | MSE 공식 | MSE 값 |
|---|---|---|
| MLE (\(c = 1/10\)) | \((2 \cdot 10 - 1)/100\) | \(0.190\) |
| Bessel (\(c = 1/9\)) | \(2/9\) | \(0.222\) |
| 평균제곱오차 최적 (\(c = 1/11\)) | \(2/11\) | \(0.182\) |
평균제곱오차 최적 추정량은 MLE보다 약 4%, Bessel 수정보다 약 18% 평균제곱오차를 줄인다. MLE 대비 개선이 크지 않은 것은 MLE가 이미 거의 최적이기 때문이다 — 편향이 살짝 클 뿐이다. Bessel 수정은 불편이지만 의미 있는 분산 대가를 치른다.
표의 세 줄은 연속적인 곡선 위의 세 점일 뿐이다. 나누는 수 \(d\)를 자유롭게 움직이며 그려 보면 세 추정량이 어디에 앉아 있는지가 한눈에 보인다.
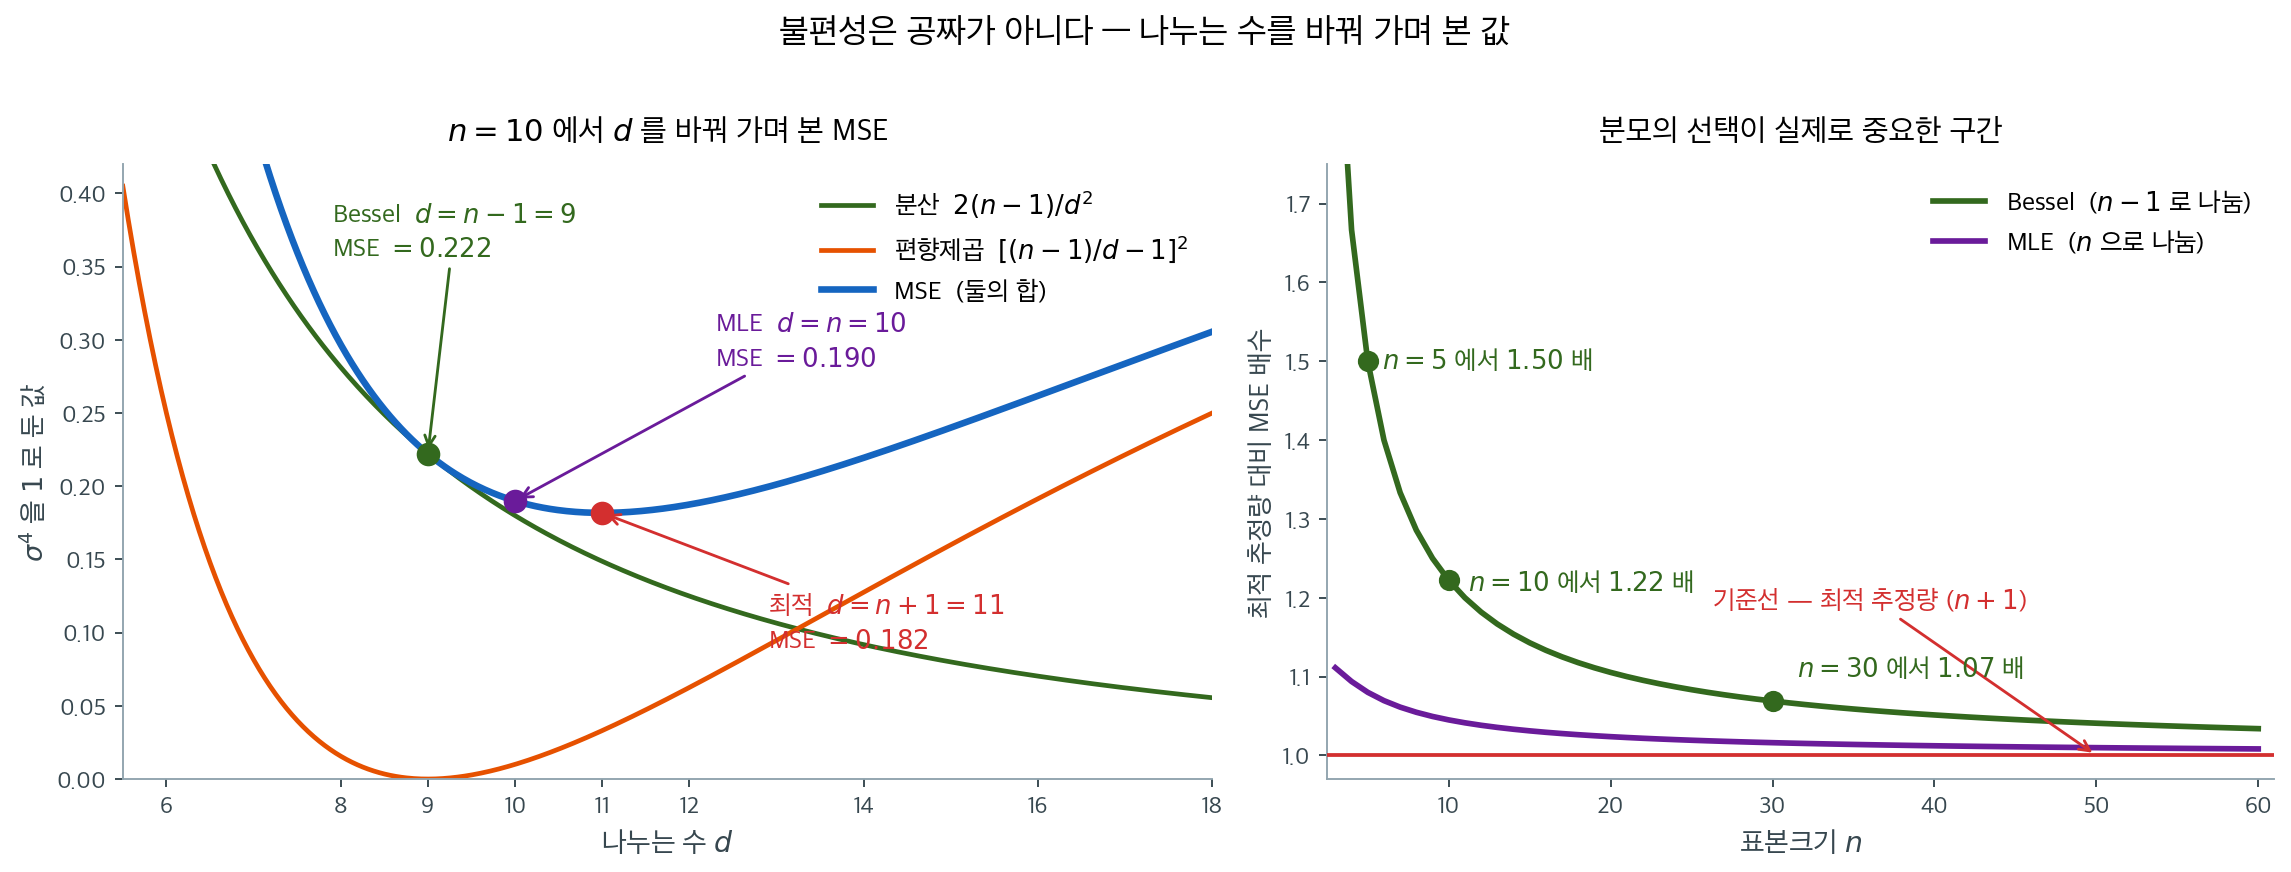
왼쪽이 \(n = 10\)에서의 그림이다. 초록색 분산 \(2(n-1)/d^2\)은 \(d\)가 커질수록 단조감소한다 — 크게 나눌수록 추정값이 덜 흔들린다. 주황색 편향제곱은 \(d = 9\)에서 정확히 \(0\)이 되고 양쪽으로 커진다. 파란 MSE는 이 둘의 합이므로, 분산이 내려가는 속도가 편향제곱이 올라가는 속도보다 빠른 동안은 계속 내려간다. 그 두 속도가 같아지는 지점이 \(d = n+1 = 11\)이고, 이것이 앞에서 미분으로 구한 \(c^* = 1/(n+1)\)이다.
\(d = 9\)(Bessel)에서 \(d = 11\)로 옮겨 가면서 편향제곱이 \(0\)에서 \(0.033\)으로 늘어나지만 분산이 \(0.222\)에서 \(0.149\)로 그보다 많이 줄어든다. 결과가 \(0.222 \to 0.182\)이다. 불편성은 주황 곡선을 \(0\)에 붙들어 두려는 요구인데, 그 자리는 파란 곡선의 바닥이 아니다.
오른쪽은 이 차이가 \(n\)에 따라 어떻게 변하는지를 최적 추정량 대비 배수로 그린 것이다. Bessel 추정량의 MSE 배수는 정확히 \((n+1)/(n-1)\)로, \(n = 5\)에서 \(1.50\)배, \(n = 10\)에서 \(1.22\)배, \(n = 30\)에서 \(1.07\)배다. MLE는 훨씬 납작해서 \(n = 5\)에서도 \(1.08\)배에 그친다. \(n\)이 \(30\)을 넘어가면 세 곡선이 사실상 한 줄이 된다. 분모 논쟁이 실제로 의미를 갖는 구간은 왼쪽 끝, 관측값이 열 개 남짓인 영역뿐이다.
핵심 통찰
평균제곱오차 최적 분모 \(n+1\)은 편향–분산 맞바꿈을 깔끔한 닫힌 형태로 보여준다. \(-2\sigma^2/(n+1)\)이라는 작은 편향을 받아들이는 대가로 그 이상을 보상하는 분산 감소를 얻는다. 표본크기 \(n\)이 커지면 세 추정량이 모두 같은 값으로 수렴하고 평균제곱오차의 차이도 무시할 만해진다 — 그러나 작은 표본에서는 분모의 선택이 중요하다.
어느 추정량을 언제 쓸 것인가
실무에서는 Bessel 수정(\(n-1\)로 나누기)이 여전히 기본이다. 불편성이 이론적 분석을 단순하게 하고 \(t\)-검정 같은 후속 절차가 이를 전제하기 때문이다. 평균제곱오차 최적 추정량은 주로 이론적 관심의 대상으로, 불편성이 언제나 최선의 기준은 아님을 보여준다.
연습문제
연습문제 1. 정규 자료에서 \(\hat\sigma^2_c = (1/c)\sum(X_i - \bar X)^2\)에 대해: (a) \(\mathrm{MSE}\)를 유도하라. (b) 최적 \(c^*\)를 구하라. (c) \(n = 10\)에서 확인하라.
풀이
(a) \(W = \sum(X_i - \bar X)^2 \sim \sigma^2 \chi^2_{n-1}\)일 때: \(\mathbb{E}[\hat\sigma^2_c] = (n-1)\sigma^2/c\), \(\mathrm{Var}(\hat\sigma^2_c) = 2(n-1)\sigma^4/c^2\).
\(\mathrm{MSE}(c) = (\sigma^4/c^2)[(n-1-c)^2 + 2(n-1)]\).
(b) 미분하여 0으로 놓으면 \(c^* = n + 1\).
(c) \(n = 10\), \(\sigma = 1\): \(\mathrm{MSE}(9) \approx 0.222\), \(\mathrm{MSE}(10) = 0.190\), \(\mathrm{MSE}(11) \approx 0.182\). \(c^* = 11\)이 이긴다.
연습문제 2. 분산추정에서 세 가지 분모(n, n-1, n+1)를 비교하라.
풀이
| 추정량 | 나누는 수 | 편향 | \(\mathrm{Var}/\sigma^4\) | \(\mathrm{MSE}/\sigma^4\) |
|---|---|---|---|---|
| \(\hat\sigma^2_{\text{MLE}}\) | \(n\) | \(-\sigma^2/n\) | \(2(n-1)/n^2\) | \((2n-1)/n^2\) |
| \(S^2\) (불편) | \(n-1\) | 0 | \(2/(n-1)\) | \(2/(n-1)\) |
| \(\hat\sigma^2_{c^*}\) | \(n+1\) | \(-2\sigma^2/(n+1)\) | \(2(n-1)/(n+1)^2\) | \(2/(n+1)\) |
최소 평균제곱오차: 분모 \(n+1\)이 MLE와 불편추정량을 모두 이긴다. 맞바꿈은 이렇다: 작은 편향을 받아들여 더 큰 분산 감소를 얻는다.
평균제곱오차에서 이기는데도 \(n+1\) 분모가 거의 쓰이지 않는 이유는 \(S^2\)의 해석이 더 깔끔하고(불편) 적당한 \(n\)에서는 평균제곱오차 차이가 작기 때문이다.
연습문제 3. 평균제곱오차는 손실함수에 따라 달라진다. 평균제곱오차가 표준이 된 이유는 무엇이며 어떤 대안이 있는가?
풀이
MSE는 제곱오차 손실 \(L(\hat\theta, \theta) = (\hat\theta - \theta)^2\)이다. 널리 쓰이는 이유:
- 수학적으로 다루기 쉽다(기댓값의 선형성, 편향 + 분산으로의 분해).
- 어디서나 미분 가능하다 — 해석적 최적화가 가능하다.
- 큰 오차에 큰 벌점을 준다(제곱).
대안:
- 절대오차: \(|\hat\theta - \theta|\). 사후 중앙값에서 최소가 되며 이상점에 더 로버스트하다.
- 분위 손실: \(\rho_\tau(\hat\theta - \theta) = (\hat\theta - \theta)(\tau - \mathbf 1\{\hat\theta < \theta\})\). 분위회귀에서 쓰인다.
- 0-1 손실: \(\mathbf 1\{\hat\theta \ne \theta\}\). 분류에서 쓰인다.
- 로그 손실 / KL 발산: 밀도추정, 확률적 예측에서 쓰인다.
손실의 선택은 어떤 종류의 오차에 벌점을 줄지를 반영한다. MSE는 기본값이지만 언제나 옳은 선택은 아니다.
연습문제 4. 축소와 James-Stein. 다변량 정규 평균의 MLE는 각 성분의 표본평균이다. James-Stein은 \(p \ge 3\)일 때 이것이 허용 불가능함을 보였다. 그 아이디어를 스케치하라.
풀이
(관측값 하나로) \(\mathbf X \sim N(\boldsymbol\mu, I_p)\)에서 \(\boldsymbol\mu \in \mathbb{R}^p\)를 추정한다. MLE: \(\hat{\boldsymbol\mu} = \mathbf X\). 평균제곱오차: \(\mathbb{E}[\|\mathbf X - \boldsymbol\mu\|^2] = p\).
James-Stein 추정량: \(\hat{\boldsymbol\mu}_{\text{JS}} = (1 - (p-2)/\|\mathbf X\|^2) \mathbf X\) (0 쪽으로 축소).
Stein(1956)이 보인 것: \(p \ge 3\)일 때 모든 \(\boldsymbol\mu\)에 대해 \(\mathrm{MSE}(\hat{\boldsymbol\mu}_{\text{JS}}) < p\)이다. MLE가 지배당한다 — 언제나 더 나은 추정량이 있다.
직관: 임의의 점 쪽으로 축소하더라도 JS 추정량이 평균제곱오차에서 MLE보다 낫다. 고차원에서는 도입된 편향보다 분산 감소가 더 크다.
현대 통계학: 고차원 문제에서 축소추정량(능형, 라소, James-Stein)이 평균제곱오차 기준으로 MLE를 일상적으로 이긴다. 경험적 Bayes와 계층 모형이 이를 형식화한다.
연습문제 5. 표본크기와 평균제곱오차. \(S^2\)에 대해 \(n\)을 네 배로 하면 \(\sqrt{\mathrm{MSE}}\)가 대략 절반이 됨을 보여라.
풀이
\(\mathrm{MSE}(S^2) = 2\sigma^4/(n-1)\). 제곱근을 취하면 \(\sqrt{\mathrm{MSE}} = \sigma^2 \sqrt{2/(n-1)}\).
\(n' = 4n\)이면 \(\sqrt{\mathrm{MSE}'} = \sigma^2 \sqrt{2/(4n - 1)} \approx \sigma^2 \sqrt{2/(n-1)}/2 = \sqrt{\mathrm{MSE}}/2\).
\(n\)이 네 배가 되면 절반이 된다. \(\bar X\)에서와 같은 \(\sqrt n\) 축척이며, 여기서는 분산추정의 RMSE에 적용된 것이다.
연습문제 6. 점근적 최적성. \(n \to \infty\)일 때 세 추정량(분모 \(n\), \(n-1\), \(n+1\))의 점근 평균제곱오차가 같음을 보여라.
풀이
세 가지 모두:
- \(\mathrm{MSE}(\hat\sigma^2_{\text{MLE}})/\sigma^4 = (2n-1)/n^2 \to 2/n\).
- \(\mathrm{MSE}(S^2)/\sigma^4 = 2/(n-1) \to 2/n\).
- \(\mathrm{MSE}(\hat\sigma^2_{c^*})/\sigma^4 = 2/(n+1) \to 2/n\).
점근적으로 동등하다 — \(1/n\)의 1차 항까지 보면 셋 모두 MSE \(\approx 2\sigma^4/n\)이다.
함의: 분모의 선택은 유한표본에서만 중요하다. 큰 \(n\)에서는 편한 것을 쓰면 된다. 차이가 무시할 수 없는 작은 \(n\)에서는 손실함수에 따라 고르라: 불편성(\(n-1\)), MLE의 편의(\(n\)), 최소 평균제곱오차(\(n+1\)).
연습문제 7. 분산추정에서 축소(shrinkage) 를 쓰면 평균제곱오차가 더 줄어들 수 있다. 목표값 \(\sigma_0^2\)을 향한 축소추정량 \(\hat\sigma^2_w = wS^2+(1-w)\sigma_0^2\)의 최적 \(w\)를 구하라.
풀이
평균제곱오차.
여기서 \(V = \operatorname{Var}(S^2) = 2\sigma^4/(n-1)\)이고 \(\Delta = \sigma^2-\sigma_0^2\)이다.
최적화. \(w\)로 미분해 0으로 두면
읽는 법.
- \(\Delta=0\)(목표가 정확히 맞음): \(w^*=0\)으로 자료를 전혀 쓰지 않는다. 목표값이 참값이면 그것을 쓰는 것이 당연하다.
- \(\Delta\)가 크면 \(w^*\to1\)로 표본분산을 그대로 쓴다.
- \(V\)가 크면(\(n\)이 작으면) \(w^*\)가 작아져 더 많이 축소한다.
최소 MSE.
언제나 \(S^2\)보다 낫다(\(V\)가 \(S^2\)의 MSE이므로). 다만 \(w^*\)가 미지의 \(\Delta\)에 의존해 직접 쓸 수 없다.
실무의 해법.
- \(\Delta\)를 추정한다. \(\hat\Delta^2 = \max(0,\ (S^2-\sigma_0^2)^2-V)\) 같은 추정값을 넣는다. 제임스-스타인의 발상과 같다.
- 경험 베이즈. 여러 분산을 동시에 추정할 때 그들의 흩어짐에서 \(\Delta\)를 추정한다. 유전자 발현 분석의
limma가 정확히 이 방식으로 유전자별 분산을 전체 평균 쪽으로 축소한다. - 르두아-울프. 공분산행렬에서 표본공분산을 구조화된 목표(대각행렬이나 등상관 행렬)로 축소하며, 최적 \(w\)를 자료에서 해석적으로 추정한다. 자산 수가 관측 수에 가까울 때 필수적이다.
연습문제 8. \(\sigma^2\) 대신 \(1/\sigma^2\)(정밀도)이나 \(\ln\sigma^2\)을 추정할 때 최적 분모가 달라지는가? 델타 방법으로 확인하라.
풀이
문제의 성격. 평균제곱오차는 척도에 의존한다. \(\sigma^2\)의 MSE를 최소로 하는 추정량이 \(\ln\sigma^2\)의 MSE도 최소로 하리라는 보장이 없다.
\(\ln\sigma^2\)의 경우. \(\hat\sigma^2_c = \text{SS}/c\)에 대해 \(\ln\hat\sigma^2_c = \ln\text{SS}-\ln c\)이므로, \(c\)를 바꾸는 것은 상수를 더하는 것이다. 따라서
- 분산은 \(c\)와 무관하다.
- 편향만 \(c\)가 결정한다. \(E[\ln\text{SS}] = \ln(2\sigma^2)+\psi\{(n-1)/2\}\)이므로, 불편이 되려면
$$ \ln c = \ln 2+\psi!\left(\frac{n-1}{2}\right) $$
즉 \(c^* = 2\exp\{\psi((n-1)/2)\}\)다.
\(n=10\)이면 \(\psi(4.5)=1.3888\)이므로 \(c^* = 2e^{1.3888} = 8.01\)로, \(n-1=9\)보다도 작다.
\(1/\sigma^2\)의 경우. \(E[1/\text{SS}]\)를 역카이제곱 적률로 계산하면
이므로 불편이 되려면 \(c = n-3\)이다. MSE를 최소로 하려면 더 작은 값이 나온다.
정리.
| 추정 대상 | 불편이 되는 \(c\) | MSE 최적 \(c\) |
|---|---|---|
| \(\sigma^2\) | \(n-1\) | \(n+1\) |
| \(\sigma\) | \((n-1)/c_4^2\) 꼴 | 더 큼 |
| \(\ln\sigma^2\) | \(2e^{\psi((n-1)/2)}\) | 같음(분산 불변) |
| \(1/\sigma^2\) | \(n-3\) | 더 작음 |
교훈. "최적 분모"는 무엇을 추정하느냐에 따라 달라진다. 이것이 불편성과 MSE 최적성이 모두 모수화에 의존한다는 사실의 구체적인 예다. \(\ln\sigma^2\) 척도에서 분산이 \(c\)에 무관하다는 점이 흥미로운데, 이는 로그 척도가 분산안정화 변환이기 때문이다.
연습문제 9. 여러 분산을 동시에 추정할 때 각각 따로 \(S_i^2\)을 쓰는 것보다 나은 방법이 있는가? 제임스-스타인의 발상이 분산에도 적용되는지 논하라.
풀이
상황. \(k\)개 집단에서 각각 \(S_i^2\)을 얻었다. 참 분산 \(\sigma_i^2\)들이 서로 다를 수 있다.
세 가지 선택.
| 방법 | 추정량 | 성격 |
|---|---|---|
| 완전 분리 | \(S_i^2\) | 불편, 분산 큼 |
| 완전 결합 | \(s_p^2\) | 분산 작음, \(\sigma_i^2\)가 다르면 편향 |
| 축소 | \(w_iS_i^2+(1-w_i)s_p^2\) | 그 사이 |
축소가 이득인 조건. 앞 연습문제의 결과에서 \(w_i^*\)가 \(\Delta_i^2/(V_i+\Delta_i^2)\)이므로
- \(n_i\)가 작으면(\(V_i\)가 크면) 더 많이 축소한다.
- 집단 간 분산의 차이가 작으면 더 많이 축소한다.
제임스-스타인의 적용. 로그 척도에서 하면 깔끔하다. \(\ln S_i^2\)이 근사적으로 정규이고 분산이 \(2/(n_i-1)\)로 \(\sigma_i\)에 무관하므로, 정규 평균의 축소 문제로 환원된다. 따라서 \(k\ge3\)이면 제임스-스타인류의 축소가 모든 \(\{\sigma_i^2\}\)에서 총 손실을 줄인다.
실제로 이것이 분산의 계층모형이며
를 두고 경험 베이즈로 \((\mu_0,\tau^2)\)을 추정한 뒤 각 \(\sigma_i^2\)을 축소한다.
대표적 응용. 유전자 발현 분석이다. 유전자가 2만 개인데 표본이 6개뿐이면 유전자별 \(S_i^2\)이 극도로 불안정하다. 우연히 작게 나온 분산이 \(t\) 통계량을 폭발시켜 거짓 발견을 양산한다. limma의 조절 \(t\) 통계량은 분산을 전체 쪽으로 축소해 이 문제를 해결하며, 실질적으로 자유도를 빌려 온다.
주의. 축소는 개별 \(\sigma_i^2\)의 추정을 나쁘게 할 수 있다. 총 손실이 줄어드는 것이지 모든 집단이 개선되지는 않는다. 특정 집단의 분산 자체가 관심사라면 신중해야 한다.
연습문제 10. 분산추정량을 비교하는 모의실험을 설계하라. 정규·균등·지수·\(t_5\) 네 모집단에서 무엇을 비교하고 어떻게 공정하게 맞출 것인가?
풀이
공정한 비교의 전제. 네 모집단의 참 분산을 같게 맞춰야 MSE를 직접 비교할 수 있다. 모두 \(\sigma^2=1\)로 표준화한다.
| 모집단 | 표준화 방법 | 초과첨도 |
|---|---|---|
| 정규 | \(N(0,1)\) | 0 |
| 균등 | \(U(-\sqrt3,\sqrt3)\) | \(-1.2\) |
| 지수 | \(\text{Exp}(1)\) | 6 |
| \(t_5\) | \(t_5/\sqrt{5/3}\) | 6 |
비교할 추정량. \(\text{SS}/c\) 계열(\(c=n-1,n,n+1\))과 강건 대안(MAD 기반, IQR 기반, 절사분산).
설계.
rng = np.random.default_rng(0)
B = 50_000
for n in [5, 10, 30, 100]:
    for name, draw in populations.items():
        ss = np.empty(B)
        for b in range(B):
            x = draw(n)
            ss[b] = ((x - x.mean()) ** 2).sum()
        for c in [n - 1, n, n + 1]:
            est = ss / c
            print(n, name, c, est.mean() - 1, est.var(), np.mean((est - 1) ** 2))
볼 것.
- 편향과 MSE를 따로. \(n-1\)이 모든 모집단에서 불편인지 확인한다(그래야 한다. 불편성은 분포에 무관하다).
- 최적 \(c\)가 어떻게 변하는지. \(c\)를 연속적으로 바꿔 MSE 곡선을 그려 최소점을 찾는다. 이론값 \(c^*\approx n+1+n\gamma_2/2\)와 맞는지 확인한다.
- 강건 추정량과의 비교. \(t_5\)에서 MAD 기반 추정량이 \(S^2\)보다 나은지 본다.
- \(n\)에 따른 수렴. \(n\)이 커지면 세 분모의 차이가 사라지는지 확인한다.
주의할 점.
- \(B\)를 충분히. MSE 추정값의 상대 표준오차가 \(\sqrt{2/B}\) 수준이므로, 5% 차이를 구별하려면 \(B\ge10^4\)이 필요하다.
- 공통난수. 같은 표본에서 여러 \(c\)를 계산하면 차이의 분산이 크게 줄어 훨씬 적은 \(B\)로 구별할 수 있다. 위 코드가 그렇게 되어 있다.
- \(t_5\)의 4차 적률. \(t_5\)는 4차 적률이 유한하지만(\(\nu>4\)) 아슬아슬하다. MSE 추정값이 잘 수렴하는지 확인해야 하며, \(t_3\)을 넣으면 4차 적률이 없어 MSE 자체가 무한임을 기억한다.
정리하며
MSE 를 기준으로 삼으면 \(n-1\) 도 \(n\) 도 최선이 아니다.
- 정규모집단에서 최적 분모는 \(n+1\) 이다. \(Q/(n+1)\) 이 \(\sigma^2\) 추정의 MSE 를 최소화하며, 이는 \(n\) 으로 나눈 것보다도 더 작게 만드는 셈이다.
- 편향을 더 들여 분산을 줄이는 거래다. \(Q\sim\sigma^2\chi^2_{n-1}\) 이므로 분모를 키우면 편향이 커지지만 분산이 더 빨리 줄어, 합인 MSE 가 내려간다.
- 세 추정량의 순서. MSE 기준으로 \(n+1\) < \(n\) < \(n-1\) 이다. 불편추정량이 셋 중 가장 나쁘다.
- 그런데도 실무는 \(n-1\) 을 쓴다. 이유는 세 가지다. 최적성이 정규성에 의존하고, 분산이 다른 계산(분산분석, \(t\) 검정, 신뢰구간)에 들어갈 때 불편성이 편하며, 차이가 \(O(1/n)\) 로 작기 때문이다.
- 교훈은 기준이 답을 정한다는 것이다. "좋은 추정량"이라는 말은 어떤 손실함수를 쓰느냐를 정하기 전에는 뜻이 없다.
다음 절 로버스트 분산추정량으로 넘어간다. 분모를 고르는 문제보다 훨씬 큰 위험이 이상치에 있다.