중도절단의 유형
평균 수명이 \(20\) 인 모집단에서 「\(10\) 을 넘긴 사람만」 명부에 올린다고 하자. 전체의 \(39.2\%\) 가 명부에서 사라지고, 남은 사람들의 평균 수명은 \(30.0\) 으로 참값 \(20.1\) 보다 \(50\%\) 높다. 아무도 자료를 조작하지 않았고 측정도 정확했는데 그렇다. 중도절단과 이 「절단」은 글자가 비슷하지만 전혀 다른 일이고, 다루는 법도 다르다. 어떤 꼴의 결측이 어떤 편향을 만들며, 그 가운데 고칠 수 있는 것은 무엇인가.
앞 쪽에서는 생존자료의 결정적 난제로 중도절단을 소개했다. 일부 대상의 참 사건시간이 부분적으로만 관측된다는 것이다. 그러나 모든 절단이 같지는 않다. 사건시간을 가리는 기제에 따라 남는 정보와 적절한 통계적 방법이 달라진다.
이 절에서는 주요 절단 유형 세 가지 --- 우측, 좌측, 구간 --- 를 분류하고, 타당한 추론의 바탕이 되는 독립 절단 가정을 논의한다.
1. 우측절단
우측절단은 실무에서 가장 흔한 유형이다. 사건이 관측된 시점 이후에 일어난다는 것은 알지만 정확한 사건시간을 모를 때 그 대상은 우측절단되었다고 한다.
형식적으로 \(T\)를 참 사건시간, \(C\)를 절단시간이라 하면 대상 \(i\)에 대해 관측되는 자료는
이다. \(\delta_i = 0\)이면 그 대상은 절단되었고, 우리가 아는 것은 \(T_i > t_i\)뿐이다.
우측절단은 여러 방식으로 생긴다.
- 제1종 절단. 연구의 종료일이 정해져 있다. 그날까지 사건을 겪지 않은 모든 대상이 같은 달력 시점에 절단된다(연구에 들어온 시점이 다르면 관측된 지속시간은 서로 다를 수 있다).
- 제2종 절단. 미리 정한 사건 수 \(r\)개가 관측될 때까지 연구를 계속하고 그때 멈춘다. 남은 \(n - r\)명이 절단된다.
- 무작위 절단. 각 대상이 독립적인 절단시간 \(C_i\)를 갖는다(예: 추적 실패). 가장 일반적이고 가장 흔한 상황이다.
대출 포트폴리오의 우측절단
어떤 은행이 2020년 1월에 실행한 대출 1,000건을 추적한다. 2023년 12월까지 200건이 부도(사건)를 냈고 800건은 정상(우측절단)이다. 정상인 각 대출에 대해 은행은 차입자가 적어도 \(t_i\)개월을 버텼다는 것은 알지만 최종 부도 시점은 모른다.
2. 좌측중도절단
사건이 관측 시점 이전에 일어났다는 것은 알지만 정확한 사건시간을 모를 때 그 대상은 좌측중도절단되었다고 한다. 관측되는 정보는 \(T_i < t_i\)이다. \(\S 4\) 의 좌측절단(지연 진입)과 다른 것이다 — 그쪽은 사건이 아니라 관측이 늦게 시작되는 것이고, 이 쪽의 요약표가 둘을 가려 적는다.
좌측중도절단은 우측절단보다 드물지만 특정 상황에서 나타난다.
- 지연된 발견. 시점 \(t\)의 검사에서 질병이 이미 존재함이 드러난다. 발병은 \(t\) 이전에 일어났지만 정확한 시점은 모른다.
- 검출 한계. 환경 측정값이 기기의 검출 임계값 아래로 내려가, 참 농도가 0과 임계값 사이 어딘가에 있음을 알려 준다.
질병 선별검사의 좌측중도절단
50세에 받은 정기 혈액검사에서 PSA 수치가 높아 전립선암이 확인되었다. 암은 알 수 없는 시점 \(T < 50\)에 생겼으므로 이 관측은 50에서 좌측중도절단되었다.
3. 구간절단
사건이 시간 구간 \((L_i, R_i]\) 안에서 일어났다는 것은 알지만 그 구간 안의 정확한 시점을 모를 때 그 대상은 구간절단되었다고 한다.
구간절단은 대상을 연속적으로 감시하는 대신 주기적으로 검사할 때 자연스럽게 발생한다.
임상시험의 구간절단
어떤 환자가 6개월과 12개월에 검사를 받는다. 6개월에는 질병이 없었고 12개월에는 있었다. 사건시간은 \(6 < T \leq 12\)를 만족하지만 정확한 달은 모른다.
우측절단과 좌측중도절단은 구간절단의 특수한 경우임에 유의하라.
- 우측절단: \(L_i = t_i\)이고 \(R_i = \infty\).
- 좌측중도절단: \(L_i = 0\)이고 \(R_i = t_i\).
4. 절단(truncation)과 중도절단(censoring)
절단(truncation)은 중도절단과 혼동되기 쉽지만 다른 현상을 가리킨다. 어떤 조건이 충족되지 않으면 그 대상의 존재 자체를 분석자가 전혀 알 수 없을 때 그 대상은 절단되었다고 한다.
- 좌측절단(지연 진입). 대상이 시점 \(a_i\)에 연구에 들어오며 \(T_i > a_i\)일 때만 관측된다. 연구에 들어오기 전에 사건을 겪은 대상은 아예 기록되지 않는다.
- 우측절단. 이미 사건을 겪은 대상만 포함된다(예: 확진 사례 등록부).
핵심적인 구별은, 중도절단은 사건시간에 대한 부분적인 정보를 제공하지만 절단은 제외된 대상에 대해 아무 정보도 제공하지 않는다는 점이다.
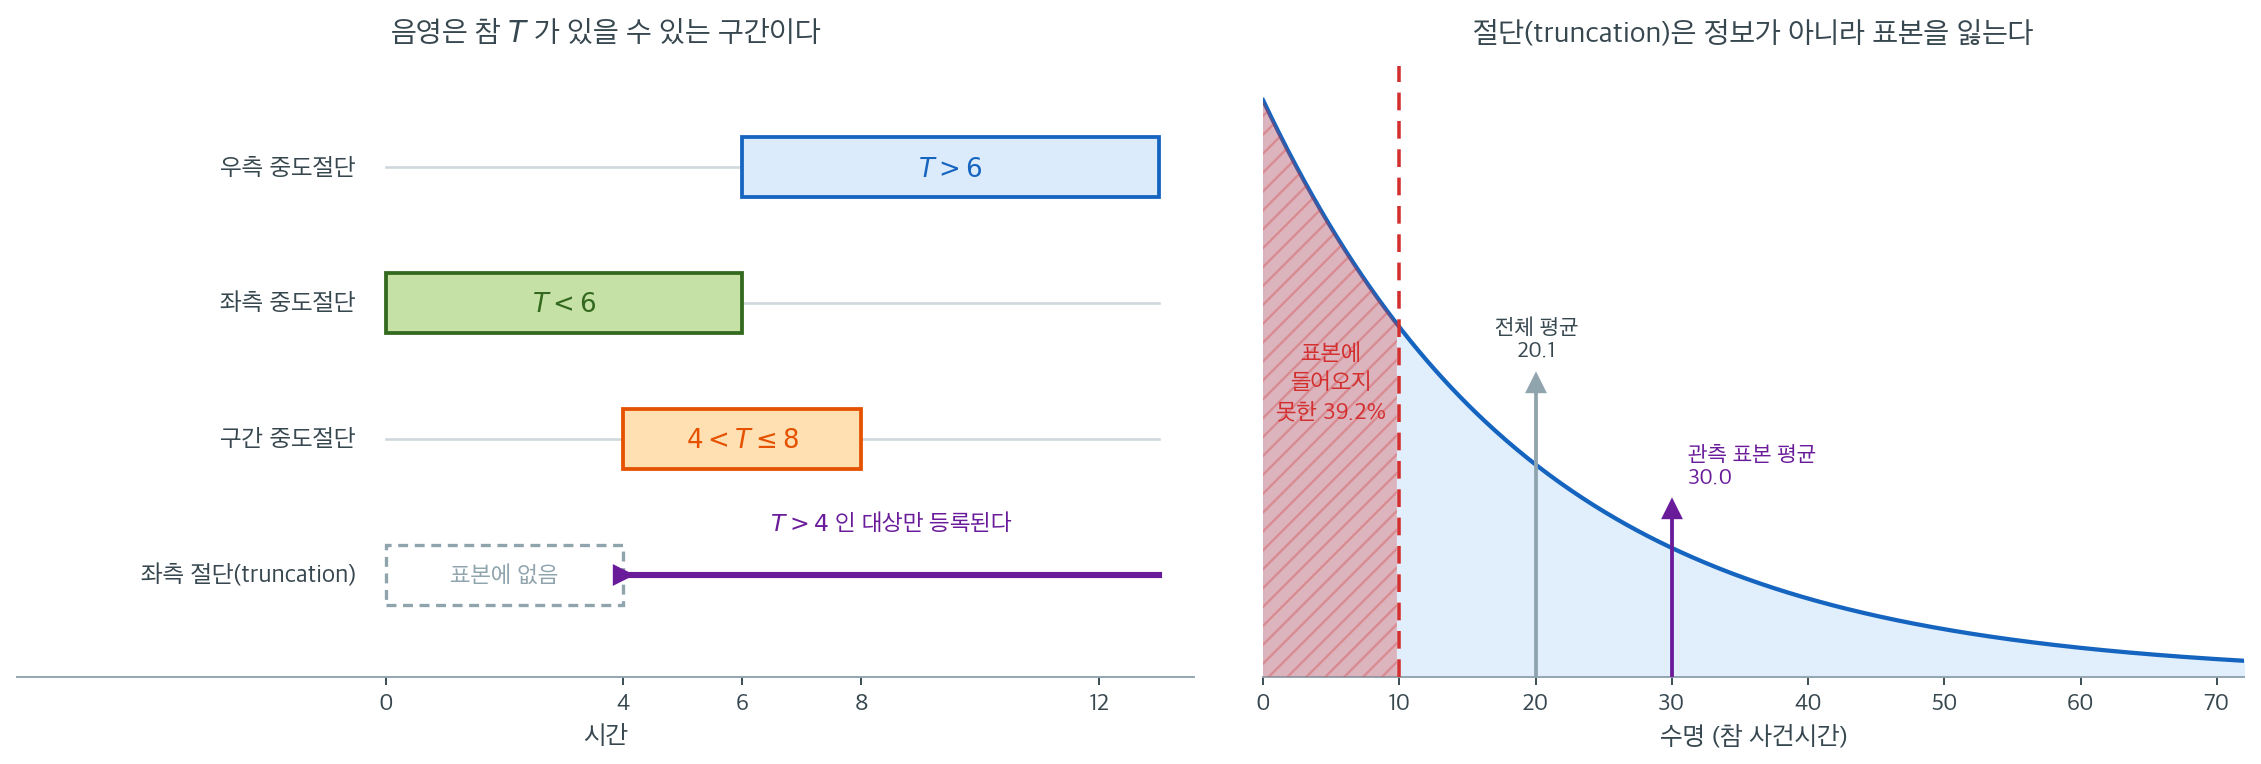
왼쪽 그림에서 색칠된 구간이 각 절단 유형이 우리에게 남겨 주는 참 \(T\)의 가능 구간이다. 세 유형의 차이는 이 구간이 시간축의 어디에 놓이는가뿐이다. 우측은 \((6, \infty)\)처럼 오른쪽으로 열려 있고, 좌측은 \((0, 6)\)처럼 왼쪽으로 열려 있으며, 구간절단은 \((4, 8]\)처럼 양쪽이 다 막혀 있다. 셋 다 관측치가 하나 있고 구간이 하나 붙어 있다. 이것이 앞에서 "우측과 좌측은 구간절단의 특수한 경우"라고 한 말의 그림이며, 연습문제 3에서 보듯 가능도 기여 \(S(L)-S(R)\) 하나로 세 경우가 모두 나온다.
맨 아래 줄만 성격이 다르다. 좌측 절단(truncation)에서는 점선 상자로 표시한 \(T \le 4\) 구간이 가능 구간이 아니라 빈자리다. 그 구간에서 사건을 겪은 대상은 구간을 남기기는커녕 관측치 자체를 남기지 않는다. 중도절단은 "이 사람에 대해 덜 안다"는 문제이고 절단은 "이 사람이 있었는지조차 모른다"는 문제다. 자료 파일의 행 수가 줄어드는 쪽은 뒤쪽뿐이다.
오른쪽 그림이 그 차이가 얼마나 비싼지 보여 준다. 평균 20인 지수분포(exponential distribution) 수명에서 \(T > 10\)인 대상만 명부에 오르게 하면 전체의 \(39.2\%\)가 사라진다. 남은 표본의 평균은 \(30.0\)으로, 참 평균 \(20.1\)보다 \(50\%\) 높다. 지수분포의 무기억성 때문에 \(T \mid T > 10\)이 \(10 + \text{Exp}(20)\)이 되어 정확히 임계값만큼 밀려 올라간 것이다. 사라진 39.2%는 중도절단된 관측치처럼 "적어도 얼마"라는 정보를 기여하지도 못하므로, 위험집합을 고쳐 잡기 전에는 어떤 추정량도 이 편향을 되돌릴 수 없다. 연금 수급자 사망률 표를 일반 인구에 그대로 쓰면 안 되는 이유가 이 그림 한 장에 들어 있다.
| 기제 | 관측되는 것 | 알 수 없는 것 |
|---|---|---|
| 우측 중도절단 | \(T > t\) | 정확한 \(T\) |
| 좌측 중도절단 | \(T < t\) | 정확한 \(T\) |
| 구간 중도절단 | \(L < T \leq R\) | 정확한 \(T\) |
| 좌측 절단 | \(T > a\)일 때만 대상이 존재 | \(T \leq a\)인 대상들 |
그림으로 보는 통계학 1. 한 살짜리의 연금이 열 살짜리보다 쌌다
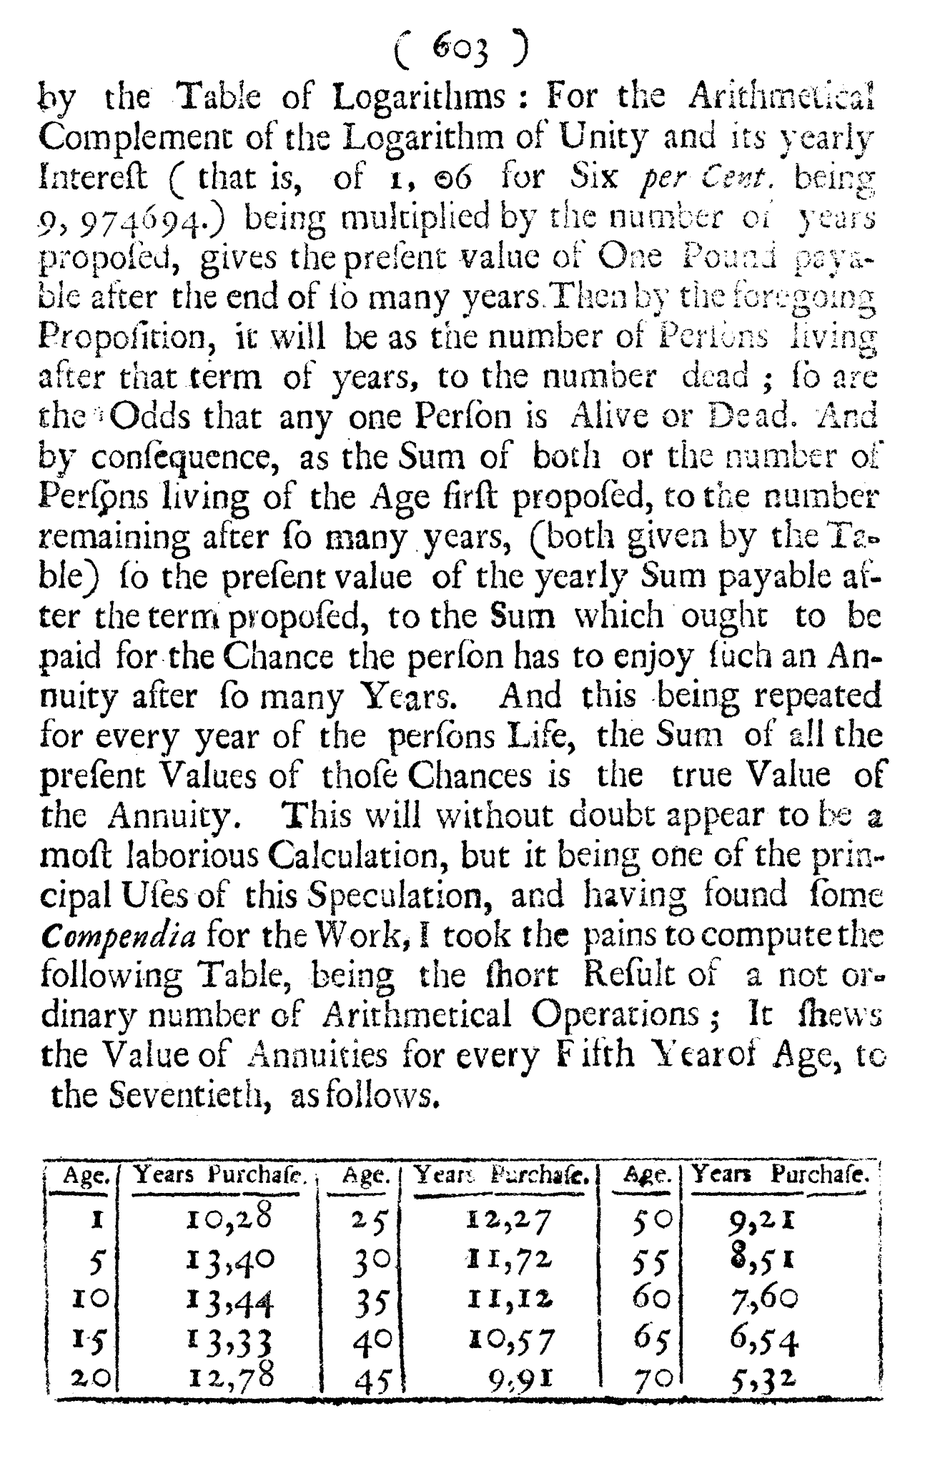
『철학회보』 제 \(17\) 권(\(1693\)) \(603\) 쪽. 본문 셋째 줄에 \(6\) 퍼센트에 해당하는 로그값 \(9{,}974694\) 가 보이고, 「의심할 바 없이 가장 수고로운 계산으로 보일 것」이라는 문장이 있다. 아래 표는 다섯 살 간격의 나이마다 종신연금이 몇 년치 값인지를 적은 것이다. (JSTOR Early Journal Content, 공개 자료)
연금 수급자 사망률 표 이야기가 위에 두 번 나왔다. 그 표를 처음 끝까지 만들어 본 쪽이 사진이다. 제목이 길다 — 「브레슬라우시의 출생과 장례에 관한 진기한 표에서 끌어낸 인류 사망률의 정도에 관한 추정, 종신연금의 값을 정해 보려는 시도와 함께」. 지은이는 혜성에 이름이 남은 그 사람이다.
왜 하필 브레슬라우인가. 그는 런던과 더블린의 기록을 두고 쓸 수 없다고 적는다. 브레슬라우는 바다에서 멀어 드나드는 외지인이 적고, 죽은 사람의 나이와 성별이 달마다 출생 수와 나란히 적혀 있었다. \(1687\) 년부터 \(1691\) 년까지 다섯 해 치다. 사람이 들고 나지 않아야 「몇 살에 몇 명이 죽었다」가 「그 나이까지 살 가망」으로 번역되기 때문이다.
이 쪽의 말로 하면 그는 좌측 절단과 우측 중도절단을 한꺼번에 피하려 한 것이다. 외지인이 흘러 들어오면 그 사람이 도착하기 전에 죽은 사람들은 명부에 아예 없고(좌측 절단), 빠져나가면 언제 죽었는지 알 길이 없다(우측 중도절단). 핼리에게는 위험집합을 고쳐 잡는 방법도, 가능도에 \(S(L)-S(R)\) 을 끼워 넣는 방법도 없었으므로 그런 일이 거의 일어나지 않는 도시를 골랐다. 방법 대신 자료를 고른 셈이다.
방법은 사진 가운데 문단에 있다. 연금을 사는 사람은 자기가 그때 살아 있을 가망만큼만 값을 치러야 하고, 이것을 해마다 따로 셈해 모두 더하면 그 사람의 종신연금 값이 된다는 것이다. \(t\) 년 뒤에 받을 \(1\) 파운드를 지금 값으로 내리는 일은 복리를 거꾸로 쓴 것이고, 거기에 \(t\) 년 뒤까지 살아 있을 확률 — 오늘 우리가 \(S(t)\) 라 적는 그것 — 을 곱해 모두 더한다.
그 내림을 그는 로그로 했다. 사진에 「\(1.06\) 의 로그의 산술 보수, 곧 \(9{,}974694\)」라고 적혀 있다. 실제로 \(\log 1.06=0.0253059\) 이니 \(10\) 에서 빼면 \(9.974694\) 로 끝자리까지 같다. 복리의 거듭제곱을 곱셈이 아니라 덧셈으로 처리한 것이다. 그러고도 그는 「이것은 의심할 바 없이 가장 수고로운 계산으로 보일 것」이라 적어 두었다.
표가 그 수고의 결과다. 그런데 눈에 걸리는 것은 맨 윗줄이다. 한 살은 \(10.28\), 다섯 살은 \(13.40\), 열 살은 \(13.44\) — 한 살짜리의 연금이 열 살짜리보다 싸다. 나이가 어릴수록 앞으로 받을 햇수가 길어 값이 비싸야 할 것 같은데 거꾸로다. 그때의 한 살은 다음 몇 해를 넘기지 못할 가망이 그만큼 컸기 때문이다. 표 맨 윗줄의 이 세 수가 그 시대의 영아 사망을 말하고 있다.
이 표의 수를 오늘 그대로 쓸 수는 없다. 이자는 \(6\) 퍼센트로 잡았고 사망은 한 도시의 다섯 해에서 얻은 것이라, 자리와 시대가 바뀌면 값이 달라진다. 바뀌지 않은 것은 셈의 모양이다 — 받을 돈에 받을 가망을 곱해 모두 더한다. 생존함수(survival function)에 할인계수를 곱해 더하는 오늘의 식이 삼백 년 전 이 쪽에서 왔다.
확인한 곳 — 논문은 Internet Archive 에 올라온 JSTOR Early Journal Content 사본 — 에드먼드 핼리, 『철학회보』 제 \(17\) 권(\(1693\)) \(596\)–\(610\) 쪽. 쪽 번호 \(603\), 로그값 \(9{,}974694\), 「사는 사람은 자기가 살아 있을 가망만큼만 치러야 하고 해마다 셈해 모두 더하면 연금 값이 된다」는 문단, 「가장 수고로운 계산으로 보일 것」, 그리고 나이별 「몇 년치 값」 표(\(1\) 세 \(10{,}28\) · \(5\) 세 \(13{,}40\) · \(10\) 세 \(13{,}44\) · \(70\) 세 \(5{,}32\))는 모두 사진에서 직접 읽었다 · 브레슬라우를 고른 까닭(바다에서 멀어 외지인의 드나듦이 적다), \(1687\)–\(1691\) 년의 다섯 해 자료, 런던과 더블린의 기록을 쓰지 않은 것은 같은 스캔의 인쇄 쪽 \(596\)–\(598\) 에서 직접 읽었다 · 로그값은 직접 맞추어 보았다 — \(\log 1.06=0.0253059\) 이고 \(10-0.0253059=9.974694\) 다. 같은 글 뒤쪽의 「\(90\) 년짜리 확정연금의 값 \(16{,}58\)」도 등비수열 합으로 계산하면 \(16.58\) 이 나온다
5. 독립 절단 가정
생존분석에서 타당한 추론을 하려면 절단이 무정보(noninformative)여야 한다. 즉 절단 기제가 관측되지 않은 사건시간에 의존해서는 안 된다. 형식적으로,
이며 \(\mathbf{x}\)는 관측된 공변량 벡터다. 기호 \(\perp\) 는 독립을 뜻하므로, 이 식은 \(\mathbf{x}\) 가 주어졌을 때 사건시간 \(T\) 와 절단시간 \(C\) 가 조건부 독립이라는 말이다. 이는 공변량을 조건으로 할 때 임의의 시점 \(t\)에서 절단된 대상이 그 시점에 아직 위험에 있는 모든 대상을 대표한다는 뜻이다.
정보가 있는 절단은 표준적인 방법을 무효로 만든다
상태가 빠르게 나빠지는 환자가 임상시험에서 이탈할 가능성이 높다면, 절단이 (관측되지 않은) 사건시간에 의존한다. 이런 상황에서는 표준적인 카플란–마이어와 콕스 모형 추정이 편향된다. 민감도 분석이나 사건과 이탈 과정을 함께 모형화하는 결합 모형이 필요하다.
AI로 보는 통계학 1. 가정이 없으면 자료가 말해 주는 범위는 이만큼이다
위 쪽지는 정보가 있는 절단이 추정을 무효로 만든다고 경고한다. 그러면 자연스러운 다음 물음은 「내 자료의 절단이 무정보인지 어떻게 확인하는가」인데, 확인할 수 없다. 절단된 사람의 사건시간은 끝내 관측되지 않으므로, 그가 언제 겪었을지에 대한 어떤 주장도 자료 밖에서 와야 한다.
그래서 \(T \perp C\) 는 검정할 수 있는 가설이 아니라 자료에 얹는 가정이다. 가정을 걷어내면 자료만으로 말할 수 있는 것은 범위뿐이다. 범위의 양 끝은 생각하기 쉽다 — 절단된 사람이 모두 직후에 겪었다고 보면 가장 낮은 생존곡선이, 아무도 겪지 않았다고 보면 가장 높은 곡선이 나온다.
import numpy as np

rng = np.random.default_rng(17)
N, LAM = 4000, 0.06                       # 참 위험 0.06 (평균 16.7 개월)

print("  절단율   시점   카플란-마이어    가정 없이 가능한 범위      폭     참값")
for target in (0.2, 0.4, 0.6):
    mu = LAM * target / (1 - target)      # 지수 절단으로 목표 절단율을 맞춘다
    T = rng.exponential(1 / LAM, N)
    C = rng.exponential(1 / mu, N)
    t, d = np.minimum(T, C), (T <= C)
    o = np.argsort(t); t, d = t[o], d[o]
    km = np.cumprod(1 - d / np.arange(N, 0, -1))
    for day in (10, 20):
        i = np.searchsorted(t, day, side="right") - 1
        s_km = km[i]
        lo = (t > day).sum() / N                        # 절단된 사람이 모두 이미 겪었다면
        hi = lo + ((t <= day) & ~d).sum() / N           # 모두 아직 안 겪었다면
        print(f"{1-d.mean():>8.1%}{day:>7}{s_km:>15.4f}   [{lo:.4f}, {hi:.4f}]"
              f"{hi-lo:>10.4f}{np.exp(-LAM*day):>9.4f}")
출력:
  절단율   시점   카플란-마이어    가정 없이 가능한 범위      폭     참값
   20.7%     10         0.5518   [0.4695, 0.5835]    0.1140   0.5488
   20.7%     20         0.2907   [0.2122, 0.3765]    0.1643   0.3012
   40.5%     10         0.5414   [0.3615, 0.6152]    0.2537   0.5488
   40.5%     20         0.2971   [0.1300, 0.4800]    0.3500   0.3012
   60.1%     10         0.5508   [0.2200, 0.6957]    0.4758   0.5488
   60.1%     20         0.2878   [0.0503, 0.6240]    0.5737   0.3012
카플란–마이어는 세 경우 모두 참값 근처를 맞힌다. 맞히는 것이 당연하다 — 이 모의실험은 절단을 독립으로 만들어 놓았으므로 가정이 참이다. 보아야 할 것은 그 옆 열이다. 같은 자료에서 가정을 걷으면 \(S(20)\) 이 \([0.13,\ 0.48]\) 이나 \([0.05,\ 0.62]\) 사이 어디든 될 수 있다. 절단율이 \(60\%\) 면 폭이 \(0.57\) 이다.
그 폭의 거의 전부를 독립 가정이 메우고 있다. 추정값 하나를 소수 넷째 자리까지 적고 신뢰구간을 붙여 봐야, 그 구간은 가정이 참일 때의 표집 변동만 잰다. 가정 자체가 틀릴 여지는 어느 구간에도 들어 있지 않다.
오늘 자료에서 이것이 특히 무거운 까닭은 절단이 설계가 아니라 운영의 부산물인 때가 많아서다. 관측이 끊기는 까닭이 사건과 얽혀 있는 경우 — 장애가 나서 수집이 멈추거나, 떠날 사람이 먼저 로그인을 끊거나 — 가 흔한데, 그 얽힘은 자료에 흔적을 남기지 않는다.
그러니 할 수 있는 일은 가정을 적어 두고 흔들어 보는 것이다. 절단된 사람의 위험이 남은 사람의 \(1.5\) 배, \(2\) 배라고 두고 다시 계산해, 결론이 뒤집히는 배수를 보고하는 것 — 그것이 위 쪽지가 말한 민감도 분석이고, 위 표의 양 끝은 그 민감도의 가장 바깥 경계다.
연습문제
연습문제 1. 다음 각 상황을 우측절단, 좌측중도절단, 구간절단, 좌측 절단(truncation) 중 하나로 분류하라.
(a) 연금 수급자 사망 자료에서 65세 이후 생존한 사람만 명부에 오른다.
(b) 정기 건강검진에서 2년 전에는 없던 종양이 발견되었다.
(c) 임상시험이 계획된 날짜에 종료되었고 일부 환자는 아직 재발하지 않았다.
(d) 수질 검사에서 오염물질 농도가 기기의 검출 한계 미만으로 나왔다.
풀이
| 상황 | 유형 | 이유 |
|---|---|---|
| (a) | 좌측 절단(truncation) | 65세 전에 사망한 사람은 명부에 존재조차 하지 않는다 |
| (b) | 구간절단 | 사건이 두 검진 사이 \((t-2, t]\)에서 일어났음만 안다 |
| (c) | 우측절단 | \(T > t\)임만 안다(제1종 절단) |
| (d) | 좌측중도절단 | 참 농도가 \((0, \text{한계})\) 안에 있음만 안다 |
(a)와 (c)를 혼동하기 쉽다. 둘 다 "정보가 부분적"이지만 (a)에서는 관측 자체가 없다. 65세 전에 사망한 사람의 존재를 우리가 모르므로 표본이 선택편향되어 있고, 이를 보정하지 않으면 평균 수명을 심하게 과대추정한다. 반면 (c)에서는 환자가 표본 안에 있고 "적어도 \(t\)까지 생존"이라는 정보를 기여한다.
좌측 절단의 처리: 위험집합을 조정한다. 시점 \(t\)의 위험집합에 \(a_i \le t\)인 대상만
포함시키면 카플란–마이어와 콕스 모형을 그대로 쓸 수 있다. 대부분의 소프트웨어가 진입시간
인자를 제공한다(lifelines의 entry, R survival의 Surv(start, stop, event)).
\(\square\)
연습문제 2. 좌측 절단을 무시하고 표준적인 생존분석을 수행하면 어떤 방향의 편향이 생기는지 모의실험으로 확인하라.
풀이
import numpy as np

rng = np.random.default_rng(3)
n = 200_000
T = rng.exponential(20.0, n)     # true lifetimes, mean 20
a = 10.0                          # entry threshold: observed only if T > 10

observed = T[T > a]
print(f"true mean lifetime      : {T.mean():.3f}")
print(f"naive mean of observed  : {observed.mean():.3f}")
print(f"fraction excluded       : {(T <= a).mean():.3f}")
출력:
true mean lifetime      : 20.053
naive mean of observed  : 30.019
fraction excluded       : 0.392
지수분포의 무기억성에 의해 \(T \mid T > 10\)은 \(10 + \text{Exp}(20)\)이므로 관측된 평균이 약 \(30\), 참 평균 \(20\)보다 \(50\%\) 높다. 즉 좌측 절단을 무시하면 생존시간을 과대추정한다.
왜 그런가. 절단 임계값보다 먼저 사건을 겪은 대상들이 표본에서 통째로 빠졌다. 남은 것은 "오래 사는 쪽"으로 선택된 표본이다. 이는 1장에서 다룬 생존자 편향의 정확한 사례이며, 생존분석에서 특히 자주 등장한다.
역사적 예: 연금 수급자 사망률 표를 그대로 일반 인구에 적용하면 기대수명을 과대추정한다. 연금을 받으려면 수급 개시 연령까지 생존해야 하기 때문이다. 보험 수리에서 이 보정은 필수다.
올바른 처리: 위험집합에서 \(a_i > t\)인 대상을 제외한다. 즉 대상이 진입한 뒤에만 위험에 있는 것으로 센다. 그러면 각 시점의 조건부 사건확률이 올바르게 추정되고 편향이 사라진다. \(\square\)
연습문제 3. 구간절단 자료의 가능도가 \(S(L_i) - S(R_i)\)를 기여함을 보여라. 구간 폭이 0으로 가면 어떻게 되는가?
풀이
구간절단된 대상에 대해 우리가 아는 것은 \(L_i < T_i \leq R_i\)뿐이다. 이 사건의 확률은
이다. 따라서 구간절단 자료의 가능도는
가 된다.
극한 확인. \(R_i \to L_i^+\)이면
이므로, 구간 폭에 비례하는 인자를 제외하면 정확한 관측의 기여인 밀도 \(f(L_i)\)가 된다. 폭이 모든 대상에서 같으면 그 인자는 상수라 최대화에 영향을 주지 않는다.
다른 두 극한은 이렇다.
- \(R_i = \infty\)이면 \(S(L_i) - 0 = S(L_i)\)로 우측절단의 기여가 된다.
- \(L_i = 0\)이면 \(1 - S(R_i) = F(R_i)\)로 좌측중도절단의 기여가 된다.
즉 구간절단 가능도가 세 유형을 모두 포괄한다.
구간절단에는 카플란–마이어를 쓸 수 없다
카플란–마이어는 사건이 정확한 시점에 관측된다는 전제 위에 있다. 구간절단에서는 사건 시점이 어디인지 모르므로 위험집합을 시점별로 셀 수 없다. 대신 반복적인 비모수(nonparametric) 최대가능도 추정(터른불 추정량)이나 모수 모형을 쓴다. 실무에서 구간절단을 구간의 중점이나 오른쪽 끝으로 대체해 카플란–마이어를 돌리는 경우가 있는데, 이는 편향을 낳으며 특히 검사 간격이 넓을 때 심각하다. \(\square\)
정리하며
| 유형 | 표기 | 전형적인 상황 |
|---|---|---|
| 우측 중도절단 | \(T > t\) | 연구 종료, 추적 실패 |
| 좌측 중도절단 | \(T < t\) | 지연된 발견, 검출 한계가 있는 기기 |
| 구간 중도절단 | \(L < T \leq R\) | 주기적 검사 |
| 좌측 절단 | \(T > a\)일 때만 관측 | 연구로의 지연 진입 |
실무에서는 우측 중도절단이 압도적으로 많으며, 이 장의 나머지에서 기본 가정으로 삼는다. 카플란–마이어 추정량(21.2절), 모수 모형(21.3절), 콕스 모형(21.4절)은 모두 달리 언급하지 않는 한 우측절단 자료를 가정한다.
다음 쪽 생존함수와 위험함수로 넘어간다. 자료의 꼴을 알았으니 이제 사건시간의 분포를 적는 언어가 필요하다 — 생존분석은 밀도나 누적분포함수(cumulative distribution function) 대신 생존함수와 위험함수로 말한다.