회귀에서의 정규성 (잔차 진단)
가정이 요구하는 것
흔한 오해 가운데 하나는 선형회귀가 설명변수나 반응변수의 정규분포를 요구한다는 것이다. 사실 회귀의 정규성 가정은 변수 자체가 아니라 오차항에 적용된다. 표준적인 선형회귀 모형
에서 가정은
이다. 이는 설명변수를 조건으로 할 때 반응변수가 정규분포를 따른다는 말과 같다.
설명변수 \(X_{ij}\)는 어떤 분포든 가질 수 있다. 치우친 설명변수, 이진 설명변수, 꼬리가 두꺼운 설명변수 모두 정규성 가정을 위배하지 않는다.
정규성은 설명변수가 아니라 잔차에 적용된다
설명변수나 \(Y\)의 무조건 분포에 정규성을 검정하는 것은 흔하지만 잘못된 관행이다. 정규성 확인은 관측되지 않는 오차 \(\varepsilon_i\)를 추정하는 잔차 \(\hat{\varepsilon}_i = Y_i - \hat{Y}_i\)에 대해 수행해야 한다.
한 자료에서 셋을 모두 검정해 보면
이 구분이 말장난이 아니라는 것은 인공 자료 하나로 바로 확인할 수 있다. 아래 자료는 \(X \sim \text{Exp}(1/3)\)에서 설명변수를 뽑고 \(Y = 2 + 3X + \varepsilon\), \(\varepsilon \sim N(0, 2^2)\)로 만든 \(n = 200\)개의 관측값이다. 가정을 조금도 어기지 않은 교과서적인 회귀 자료다.
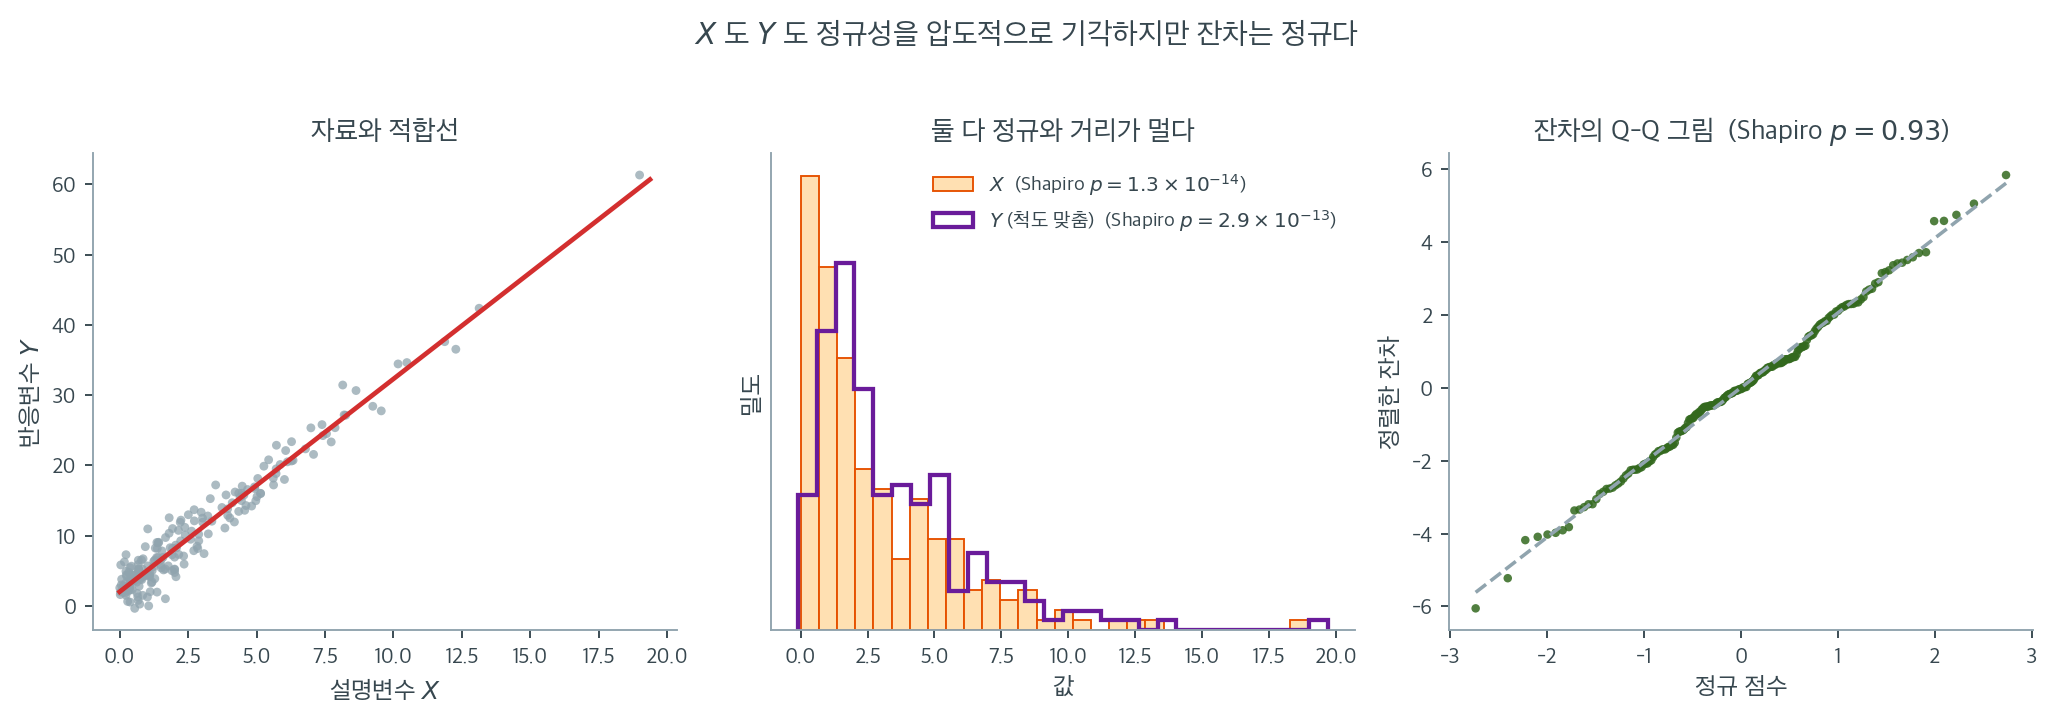
가운데 칸을 보라. 설명변수 \(X\)는 지수분포이므로 오른쪽으로 크게 치우쳐 있고 Shapiro-Wilk \(p = 1.3 \times 10^{-14}\)이다. 반응변수 \(Y\)는 그 \(X\)를 세 배 해서 정규 잡음을 더한 것이니 역시 치우쳐 있고 \(p = 2.9 \times 10^{-13}\)이다. 둘 다 "정규성 검정 통과"와는 거리가 멀다. 여기서 "정규성이 위배되었으니 회귀를 쓸 수 없다"고 판단한다면 완전히 잘못된 결론이다.
오른쪽 칸이 실제로 확인해야 할 것이다. 잔차의 Q-Q 그림에서 점들이 직선에 붙어 있고 Shapiro-Wilk \(p = 0.93\)이다. 모형이 요구한 바로 그 가정 — \(\varepsilon_i \sim N(0, \sigma^2)\) — 이 완벽하게 지켜지고 있다. 적합된 계수도 \(\hat\beta_0 = 2.00\), \(\hat\beta_1 = 3.03\)으로 참값 \((2, 3)\)에 정확히 맞는다.
왜 이런 일이 일어나는지는 모형 식을 다시 보면 분명하다. 정규성은 \(Y_i \mid X_i\)의 조건부 분포에 대한 가정이지 \(Y_i\)의 무조건 분포에 대한 가정이 아니다. \(Y\)의 무조건 분포는 서로 다른 평균 \(\beta_0 + \beta_1 X_i\)를 갖는 정규분포 200개를 \(X\)의 분포에 따라 섞은 것이므로, \(X\)가 치우쳐 있으면 \(Y\)도 따라 치우친다. 섞는 비율이 무엇이든 각 성분은 여전히 정규이고 오차도 여전히 정규다.
실무적으로 이 오해는 두 방향 모두에서 해를 끼친다. 멀쩡한 모형을 "정규성 위배"로 버리게 만들기도 하고, 반대로 \(Y\)가 우연히 종 모양이라는 이유로 잔차가 심하게 치우친 모형을 통과시키기도 한다. 회귀에서 shapiro에 넣어야 할 배열은 언제나 residuals다.
회귀에서 정규성이 중요한 이유
OLS 추정값 \(\hat{\beta}\)가 불편이거나 일치성을 갖는 데는 오차의 정규성이 필요하지 않다. Gauss-Markov 정리는 더 약한 조건(선형성, 외생성, 등분산성, 다중공선성 없음) 아래에서 OLS가 최소분산 선형불편추정량(BLUE)임을 보장한다. 정규성은 다음이 필요할 때 들어온다.
-
정확한 \(t\) 검정과 \(F\) 검정. 정규성 아래에서 \(H_0: \beta_j = 0\)의 검정통계량
\[ t_j = \frac{\hat{\beta}_j}{\text{SE}(\hat{\beta}_j)} \]는 자유도 \(n - p - 1\)의 \(t\) 분포를 정확히 따른다. 정규성이 없으면 이 분포 결과는 (큰 \(n\)에서 중심극한정리를 통해) 근사적으로만 성립한다.
-
정확한 신뢰구간. \(100(1-\alpha)\%\) 신뢰구간
\[ \hat{\beta}_j \pm t_{\alpha/2,\, n-p-1} \cdot \text{SE}(\hat{\beta}_j) \]는 정규성 아래에서만 정확한 포함확률을 갖는다. 정규성이 없으면 포함확률이 근사적이다.
-
예측구간. 새 관측값에 대한 예측구간은
\[ \hat{Y}_{\text{new}} \pm t_{\alpha/2,\, n-p-1} \cdot \hat{\sigma}\sqrt{1 + \mathbf{x}_{\text{new}}^\top (\mathbf{X}^\top\mathbf{X})^{-1} \mathbf{x}_{\text{new}}} \]이 구간은 예측오차가 정규분포를 따름을 보장하기 위해 오차의 정규성에 기댄다. 오차가 정규가 아니면 실제 포함확률이 \(1 - \alpha\)에서 크게 벗어날 수 있다.
잔차의 정규성 확인
참 오차 \(\varepsilon_i\)는 관측할 수 없으므로 잔차 \(\hat{\varepsilon}_i = Y_i - \hat{Y}_i\)로 정규성을 확인한다. 표준적인 진단 도구는 다음과 같다.
잔차의 Q-Q 그림
Q-Q 그림은 잔차의 분위수를 표준정규분포의 분위수와 비교한다. 오차가 정규이면 점들이 대략 직선을 따라 놓인다. 흔한 이탈 패턴은
- S자 곡선: 두꺼운 꼬리(양의 초과첨도)를 나타낸다
- 위로 휘는 곡률: 오른쪽 치우침을 나타낸다
- 양 끝이 아래로 휨: 얇은 꼬리(저첨)를 나타낸다
잔차에 대한 Shapiro-Wilk 검정
잔차에 Shapiro-Wilk 검정을 적용한다.
- \(H_0\): 잔차가 정규분포를 따른다
- \(H_1\): 잔차가 정규분포를 따르지 않는다
\(n\)이 크면 사소한 이탈로도 기각할 수 있으므로 그런 경우에는 시각적 방법이 더 유익하다.
잔차의 히스토그램
잔차의 히스토그램은 빠른 시각적 확인을 제공한다. 대략적인 대칭성과 종 모양 윤곽을 살핀다. 강한 치우침이나 여러 개의 봉우리는 비정규성의 신호이다.
잔차가 정규가 아닐 때의 결과
정규가 아닌 잔차의 영향은 분석의 목표에 달려 있다.
점추정. 나머지 Gauss-Markov 조건이 성립하는 한 OLS 추정량은 오차 분포와 무관하게 불편이고 일치성을 갖는다. 비정규성은 \(\hat{\beta}\)에 영향을 주지 않는다.
가설검정과 신뢰구간. \(n\)이 작으면 정규가 아닌 오차가 \(p\)값과 포함확률을 왜곡할 수 있다. \(n\)이 크면 중심극한정리가 \(\hat{\beta}_j\)의 근사적 정규성을 보장하므로 \(t\) 검정과 신뢰구간이 근사적으로 타당하게 유지된다.
예측구간. 예측구간은 \(\hat{\beta}_j\)의 신뢰구간보다 비정규성에 더 민감하다. 예측오차가 오차항 \(\varepsilon_{\text{new}}\) 전체를 포함하며 그 분포가 구간에 직접 들어오기 때문이다.
보기 1. 벗어남을 표준오차로 재기. \(X \sim \text{Uniform}(0,10)\), \(Y = 2 + 3X + \varepsilon\), \(\varepsilon \sim \mathcal{N}(0, 2^2)\)로 \(n = 100\)을 만들어 최소제곱 적합하고 잔차를 진단한다. 추정값은 \(\hat\beta_0 = 2.430\), \(\hat\beta_1 = 2.908\)이 나온다.
(1) \(\sigma = 2\)를 알고 있으므로 \(\mathrm{SE}(\hat\beta_0)\)와 \(\mathrm{SE}(\hat\beta_1)\)을 닫힌 꼴로 구할 수 있다. 참값 \((2, 3)\)에서의 벗어남이 각각 몇 표준오차인지 재시오.
(2) 두 벗어남의 부호가 반대다(\(\hat\beta_0\)은 크게, \(\hat\beta_1\)은 작게 나왔다). 우연인가? \(\operatorname{Cov}(\hat\beta_0, \hat\beta_1)\)을 구해 답하시오.
(3) 이 자료에서 \(X\), \(Y\), 잔차 셋 모두에 샤피로–윌크를 걸어 보시오. 어느 것이 통과하는가. \(X\)와 \(Y\)의 초과첨도를 닫힌 꼴로 구해 표본값과 맞추시오.
풀이
쪽의 코드를 먼저 그대로 돌린다.
import numpy as np
from scipy import stats

# ===================================================================
# 회귀 잔차의 정규성 확인
#
# 회귀에서 정규성은 반응변수가 아니라 오차항에 요구되는 가정이다.
# 게다가 계수 추정의 불편성에는 필요 없고, 작은 표본에서 t 검정과
# 신뢰구간을 쓰기 위해 필요하다.
# ===================================================================

np.random.seed(42)
n = 100

# 오차를 정규분포에서 만든다. 그러므로 잔차도 정규로 나와야 한다.
X = np.random.uniform(0, 10, size=n)
beta_0, beta_1 = 2.0, 3.0
epsilon = np.random.normal(0, 2, size=n)
Y = beta_0 + beta_1 * X + epsilon

# 정규방정식을 직접 풀어 적합한다. 첫 열의 1 이 절편에 대응한다.
X_design = np.column_stack([np.ones(n), X])
beta_hat = np.linalg.lstsq(X_design, Y, rcond=None)[0]
Y_hat = X_design @ beta_hat
residuals = Y - Y_hat

# 잔차에 대한 정규성 검정
sw_stat, sw_p = stats.shapiro(residuals)

# 검정이 기각되었을 때 무엇이 문제인지는 이 둘이 알려 준다.
# 왜도가 크면 치우침, 초과첨도가 크면 두꺼운 꼬리다.
skew_r = stats.skew(residuals)
kurt_r = stats.kurtosis(residuals)  # excess kurtosis

if __name__ == "__main__":
    print(f"Estimated coefficients: beta_0 = {beta_hat[0]:.3f}, "
          f"beta_1 = {beta_hat[1]:.3f}")
    print(f"\nResidual diagnostics:")
    print(f"  Shapiro-Wilk: W = {sw_stat:.4f}, p = {sw_p:.4f}")
    print(f"  Skewness:     {skew_r:.4f}")
    print(f"  Excess kurtosis: {kurt_r:.4f}")

    if sw_p > 0.05:
        print("\n  Residuals are consistent with normality.")
    else:
        print("\n  Evidence of non-normality in residuals.")
출력:
Estimated coefficients: beta_0 = 2.430, beta_1 = 2.908

Residual diagnostics:
  Shapiro-Wilk: W = 0.9846, p = 0.2984
  Skewness:     0.2173
  Excess kurtosis: -0.0712

  Residuals are consistent with normality.
(1) 표준오차는 닫힌 꼴로 나온다. 단순회귀의 설계행렬 \(\mathbf{X} = [\mathbf{1}\ \ \mathbf{x}]\)에 대해
이고 \(\operatorname{Var}(\hat{\boldsymbol\beta}) = \sigma^2 (\mathbf{X}^{\!\top}\mathbf{X})^{-1}\)이므로
이 표본에서 \(\bar x = 4.7018\), \(S_{xx} = 876.15\)이고 \(\sigma = 2\)를 알고 있으므로(모의실험이니까) 추정하지 않고 바로 넣을 수 있다.
따라서 벗어남은
이다. 둘 다 1.5 표준오차 안이다. 절편이 \(0.43\)이나 벗어난 것이 커 보이지만, 절편의 표준오차가 \(0.375\)나 되므로 평범한 변동이다. 반대로 기울기의 \(0.092\)는 작아 보이지만 표준오차가 \(0.068\)뿐이어서 상대적으로는 더 멀리 간 것이다. 벗어남의 크기는 눈으로 재는 것이 아니라 표준오차로 재는 것이다.
(2) 우연이 아니다. 위 역행렬의 비대각 성분에서
이다. \(\bar x > 0\)이면 언제나 음의 상관이다. 이 자료에서는 \(\operatorname{Cov} = -4 \times 4.7018/876.15 = -0.02147\), 상관 \(-0.8463\)이다. 곧 절편이 참값보다 크게 나오면 기울기는 작게 나오는 쪽으로 \(0.85\)만큼 묶여 있다.
기하적으로 분명하다. 최소제곱 적합선은 반드시 \((\bar x, \bar y)\)를 지난다(코드에서 \(\hat\beta_0 + \hat\beta_1 \bar x = 16.1033 = \bar y\)로 확인된다). 그 한 점에 못이 박혀 있으니 선을 시계 방향으로 돌리면 기울기가 줄고 절편이 늘어난다. 두 추정값은 독립적으로 흔들릴 수 없다.
그러므로 둘을 따로 보면 안 된다. 이변량으로 재면 마할라노비스 거리의 제곱이
이고 \(\chi^2_2\) 의 꼬리확률이 \(0.396\)이다. 합동으로 보아도 완전히 평범한 표본이다.
(3) 통과하는 것은 잔차뿐이다. 이 쪽의 주제가 보기 안에서 그대로 재현된다.
| 샤피로–윌크 \(p\) | \(g_1\) | \(g_2\) | 이론 초과첨도 | |
|---|---|---|---|---|
| \(X\) | \(0.000218\) | \(+0.1117\) | \(-1.2788\) | \(-1.2\) |
| \(Y\) | \(0.000636\) | \(+0.1990\) | \(-1.2004\) | \(-1.0816\) |
| 잔차 | \(0.298\) | \(+0.2173\) | \(-0.0712\) | \(0\) |
\(X\)와 \(Y\) 모두 \(p < 0.001\)로 강하게 기각되고 잔차만 \(p = 0.298\)로 통과한다. 모형은 조금도 틀리지 않았다. \(X\)에 검정을 걸었다면 멀쩡한 교과서적 회귀를 "정규성 위배"로 버렸을 것이다.
이론값이 그 까닭을 말해 준다. \(\text{Uniform}(a,b)\)의 초과첨도는 \(-6/5 = -1.2\)이고, 표본값 \(-1.279\)가 거기에 맞는다(\(n = 100\)에서 초과첨도의 귀무 표준오차가 \(\sqrt{24/100} = 0.49\)이므로 넉넉히 안쪽이다). \(Y\)는 독립인 \(3(X - 5) \sim \text{Uniform}(-15, 15)\)와 \(\varepsilon \sim \mathcal{N}(0,4)\)의 합이므로 중심적률이 더해져
이고 초과첨도는 \(11973/79^2 - 3 = -1.0816\)이다. 표본값 \(-1.200\)과 맞는다. (닫힌 꼴은 \(8\times10^6\)개 몬테카를로로도 확인했다. \(-1.0817\)이 나온다.) 곧 \(X\)도 \(Y\)도 정규가 아닌 것이 참이다. 평평한 균등분포가 정규보다 납작하기 때문이고, 정규 잡음을 더해도 \(-1.08\)까지만 끌어올린다.
왜도·첨도는 모두 scipy.stats.skew·kurtosis의 기본값이므로 보정하지 않은 \(g_1\)과 초과첨도 \(g_2\)다. 잔차의 보정판은 \(G_1 = +0.2206\), \(G_2 = -0.0124\)로 조금 다르다. \(n = 100\)에서는 차이가 작지만, 보고할 때는 어느 판본인지 밝혀야 한다.
import numpy as np
from scipy import stats

np.random.seed(42)
n = 100
X = np.random.uniform(0, 10, size=n)
Y = 2.0 + 3.0 * X + np.random.normal(0, 2, size=n)
Xd = np.column_stack([np.ones(n), X])
b = np.linalg.lstsq(Xd, Y, rcond=None)[0]
resid = Y - Xd @ b

sigma = 2.0                      # 참값을 알고 있으므로 이론 SE 를 쓸 수 있다
xbar, Sxx = X.mean(), ((X - X.mean())**2).sum()
se0 = sigma * np.sqrt(1/n + xbar**2 / Sxx)
se1 = sigma / np.sqrt(Sxx)
print(f"xbar = {xbar:.4f},  Sxx = {Sxx:.2f}")
print(f"SE(b0) = {se0:.4f}   b0 = {b[0]:.4f}  편차 {b[0]-2:+.4f} = {(b[0]-2)/se0:+.3f} SE")
print(f"SE(b1) = {se1:.4f}   b1 = {b[1]:.4f}  편차 {b[1]-3:+.4f} = {(b[1]-3)/se1:+.3f} SE")

V = sigma**2 * np.linalg.inv(Xd.T @ Xd)
print(f"Cov(b0, b1) = {V[0,1]:.5f},  Corr = {V[0,1]/np.sqrt(V[0,0]*V[1,1]):.4f}")
d = np.array([b[0] - 2, b[1] - 3])
m2 = d @ np.linalg.inv(V) @ d
print(f"마할라노비스^2 = {m2:.4f},  chi2_2 꼬리확률 = {stats.chi2.sf(m2, 2):.4f}")
print(f"b0 + b1*xbar = {b[0] + b[1]*xbar:.4f},  ybar = {Y.mean():.4f}")

print("\n정규성 검정을 어디에 걸어야 하는가")
for name, v, closed in [("X   ", X, -6/5), ("Y   ", Y, 30**4/80/79**2 + (6*75*4 + 3*16)/79**2 - 3),
                        ("잔차", resid, 0.0)]:
    print(f"  {name}: shapiro p = {stats.shapiro(v)[1]:>9.3g},"
          f"  g1 = {stats.skew(v):+.4f},  g2 = {stats.kurtosis(v):+.4f}"
          f"   (이론 초과첨도 {closed:+.4f})")
출력:
xbar = 4.7018,  Sxx = 876.15
SE(b0) = 0.3754   b0 = 2.4302  편차 +0.4302 = +1.146 SE
SE(b1) = 0.0676   b1 = 2.9080  편차 -0.0920 = -1.361 SE
Cov(b0, b1) = -0.02147,  Corr = -0.8463
마할라노비스^2 = 1.8522,  chi2_2 꼬리확률 = 0.3961
b0 + b1*xbar = 16.1033,  ybar = 16.1033

정규성 검정을 어디에 걸어야 하는가
  X   : shapiro p =  0.000218,  g1 = +0.1117,  g2 = -1.2788   (이론 초과첨도 -1.2000)
  Y   : shapiro p =  0.000636,  g1 = +0.1990,  g2 = -1.2004   (이론 초과첨도 -1.0816)
  잔차: shapiro p =     0.298,  g1 = +0.2173,  g2 = -0.0712   (이론 초과첨도 +0.0000)
손으로 구한 \(\mathrm{SE} = (0.3754,\ 0.0676)\), 벗어남 \((+1.146,\ -1.361)\) 표준오차, 상관 \(-0.8463\), 마할라노비스 \(1.8522\)가 모두 코드와 맞는다. 이론 초과첨도 \(-1.2\)와 \(-1.0816\)도 표본값과 맞는다.
잔차의 왜도 \(0.217\)과 초과첨도 \(-0.071\)이 모두 0에 가깝고 Shapiro-Wilk \(p = 0.298\)로 기각하지 못한다. 정규 오차로 자료를 생성했으므로 기대한 결과이다. 추정된 계수 \((2.430, 2.908)\)이 참값 \((2.0, 3.0)\)과 정확히 일치하지 않는 것은 \(n = 100\)에서의 표집변동일 뿐이다.
정규가 아닌 잔차에 대한 대책
잔차 진단이 비정규성을 드러내면 몇 가지 접근이 도움이 된다.
-
반응변수를 변환한다. \(Y\)에 로그나 Box-Cox 변환을 적용하면 잔차의 치우침을 줄일 수 있다. 변환된 모형은 \(g(Y_i) = \beta_0 + \beta_1 X_{i1} + \cdots + \varepsilon_i\)이다.
-
이상점을 조사한다. 비정규성이 몇 개의 극단적 잔차 때문이라면 그 관측값이 자료 오류인지 영향점인지 살펴본다.
-
로버스트 표준오차를 쓴다. 이분산 일치(HC) 표준오차는 적어도 점근적으로는 정규성 없이도 타당한 추론을 제공한다.
-
붓스트랩 추론을 쓴다. 붓스트랩 신뢰구간과 \(p\)값은 정규성 가정을 요구하지 않는다.
-
일반화선형모형을 쓴다. 반응변수가 본래 정규가 아니라면(예: 계수, 이진 결과) 변환한 OLS보다 적절한 연결함수를 가진 GLM이 더 낫다.
연습문제
연습문제 1. 선형회귀를 적합한 뒤 잔차의 Q-Q 그림을 그렸더니 오른쪽 꼬리의 점들은 기준선 위로, 왼쪽 꼬리의 점들은 기준선 아래로 벗어나 S자 모양을 이룬다. 이는 잔차 분포에 대해 무엇을 시사하는가?
풀이
오른쪽 꼬리가 선 위로, 왼쪽 꼬리가 선 아래로 벗어나 S자를 이루는 것은 두꺼운 꼬리(고첨)를 나타낸다. 잔차에 정규분포가 예측하는 것보다 극단적인 값이 많다는 뜻이다.
(양 끝이 모두 위로 휘는 것은 다른 패턴, 곧 오른쪽 치우침을 나타낸다는 점에 유의하라.)
원인으로는 이상점, 모형 오설정(비선형 항이나 중요한 설명변수의 누락), 또는 바탕 오차 분포가 실제로 두꺼운 꼬리를 갖는 경우가 있다. 회귀계수 추정값은 여전히 불편이지만(OLS는 정규성을 요구하지 않는다) 추론(p값, 신뢰구간)은 특히 작은 표본에서 믿을 수 없어질 수 있다.
연습문제 2. 선형회귀에서 정규성을 평가하는 잔차 그림 두 가지와 등분산성을 평가하는 그림 한 가지를 기술하라.
풀이
정규성 진단:
- 잔차의 Q-Q 그림: 잔차 분위수를 이론적 정규분위수에 대해 그린다. 선형이면 정규성을 나타낸다.
- 잔차의 히스토그램: 0을 중심으로 대략 종 모양이고 대칭이어야 한다.
등분산성 진단:
- 잔차-적합값 그림: \(e_i\)를 \(\hat{y}_i\)에 대해 그린다. 등분산성 아래에서는 흩어짐이 일정해야 한다(수평 띠). 깔때기 모양(\(\hat{y}\)가 커질수록 흩어짐이 커짐)은 이분산을 나타낸다.
연습문제 3. \(n = 40\)인 회귀 잔차에 대한 Shapiro-Wilk 검정이 \(p = 0.12\)를 준다. 오차가 정규분포를 따른다고 결론지을 수 있는가?
풀이
아니다. 귀무가설을 기각하지 못한 것(\(p = 0.12 > 0.05\))은 잔차가 정규가 아니라고 결론지을 증거가 부족하다는 뜻이다. 정규성을 증명하지는 않으며, 특히 \(n = 40\)에서는 검정력이 낮은 것을 반영할 뿐일 수 있다.
올바른 해석은 "자료가 정규성과 일관되지만 정규성이 증명된 것은 아니다"이다. 증거의 부재가 부재의 증거가 아니라는 가설검정의 고전적 한계이다. Q-Q 그림으로 보완하고, 관심 있는 이탈을 탐지할 만한 검정력을 표본크기가 제공하는지 고려하라.
연습문제 4. 회귀 잔차가 정규성 검정을 통과하지 못했을 때 문제를 해결하는 접근 세 가지를 선호 순서대로 들어라.
풀이
-
반응변수 변환: \(Y\)에 Box-Cox, 로그, 제곱근 변환을 적용한다. 잔차를 정규화하면서 동시에 분산도 안정화하는 경우가 많다. 모형을 다시 적합하고 잔차를 다시 확인한다.
-
로버스트 추론이나 붓스트랩 추론: 잔차가 정규가 아니지만 모형 구조가 옳다면 이분산 일치(HC) 표준오차나 붓스트랩 신뢰구간을 쓴다. 정규성 없이도 타당하다.
-
일반화선형모형: 반응변수가 본래 정규가 아니라면(예: 계수, 비율, 순양수) 올바른 분포를 직접 모형화하는 적절한 GLM(Poisson, 로지스틱, 감마)으로 갈아탄다.
덧붙여, 오차 분포를 탓하기 전에 모형 오설정(누락된 설명변수, 비선형 항)이 있는지 확인하라. 정규가 아닌 잔차는 분포의 문제라기보다 모형의 문제를 나타내는 경우가 많다.
정리하며
선형회귀에서 정규성 가정은 설명변수나 무조건 반응변수가 아니라 오차항에 적용된다. 정확한 \(t\) 검정, \(F\) 검정, 예측구간에는 정규성이 필요하지만, OLS 점추정값은 정규성 없이도 타당하다. 진단은 Q-Q 그림, 형식적 검정, 히스토그램으로 잔차에 대해 수행해야 한다. 비정규성이 탐지되면 그 실질적 영향은 표본크기와, 목표가 추정인지 검정인지 예측인지에 달려 있다.