μ_D에 대한 대응 t-검정
1. 대응표본 t 검정
들어가는 이야기 — 같은 사람을 두 번 재면
세마글루타이드의 STEP 1 시험은 \(1{,}961\) 명을 \(68\) 주에 걸쳐 두 번 재었다 — 시작할 때 한 번, 끝에 한 번이다. 사람마다 그 두 수의 차이를 내면 수가 하나씩 남는다. 짝을 지은 자료는 그렇게 수 하나로 줄어든다. 8.4절 μ_D (차이의 평균)의 신뢰구간이 그 차이들의 평균에 폭을 붙였다면, 이 절은 같은 수에 판정을 붙인다 — 「줄었다」고 적어도 되는가.
약을 받은 쪽은 \(1{,}306\) 명에 평균 \(-14.9\%\) 였다. 시험이 표본크기를 계산할 때 쓴 차이의 산포 \(10\) 퍼센트포인트로 재면 표준오차가 \(0.2767\) 퍼센트포인트이므로, 관측값은 \(0\) 에서 쉰 배 넘게 떨어져 있다. 판정은 볼 것도 없다. 약을 받지 않은 \(655\) 명과 견주는 일은 이 절이 아니라 이표본 검정이 하는 일이다.
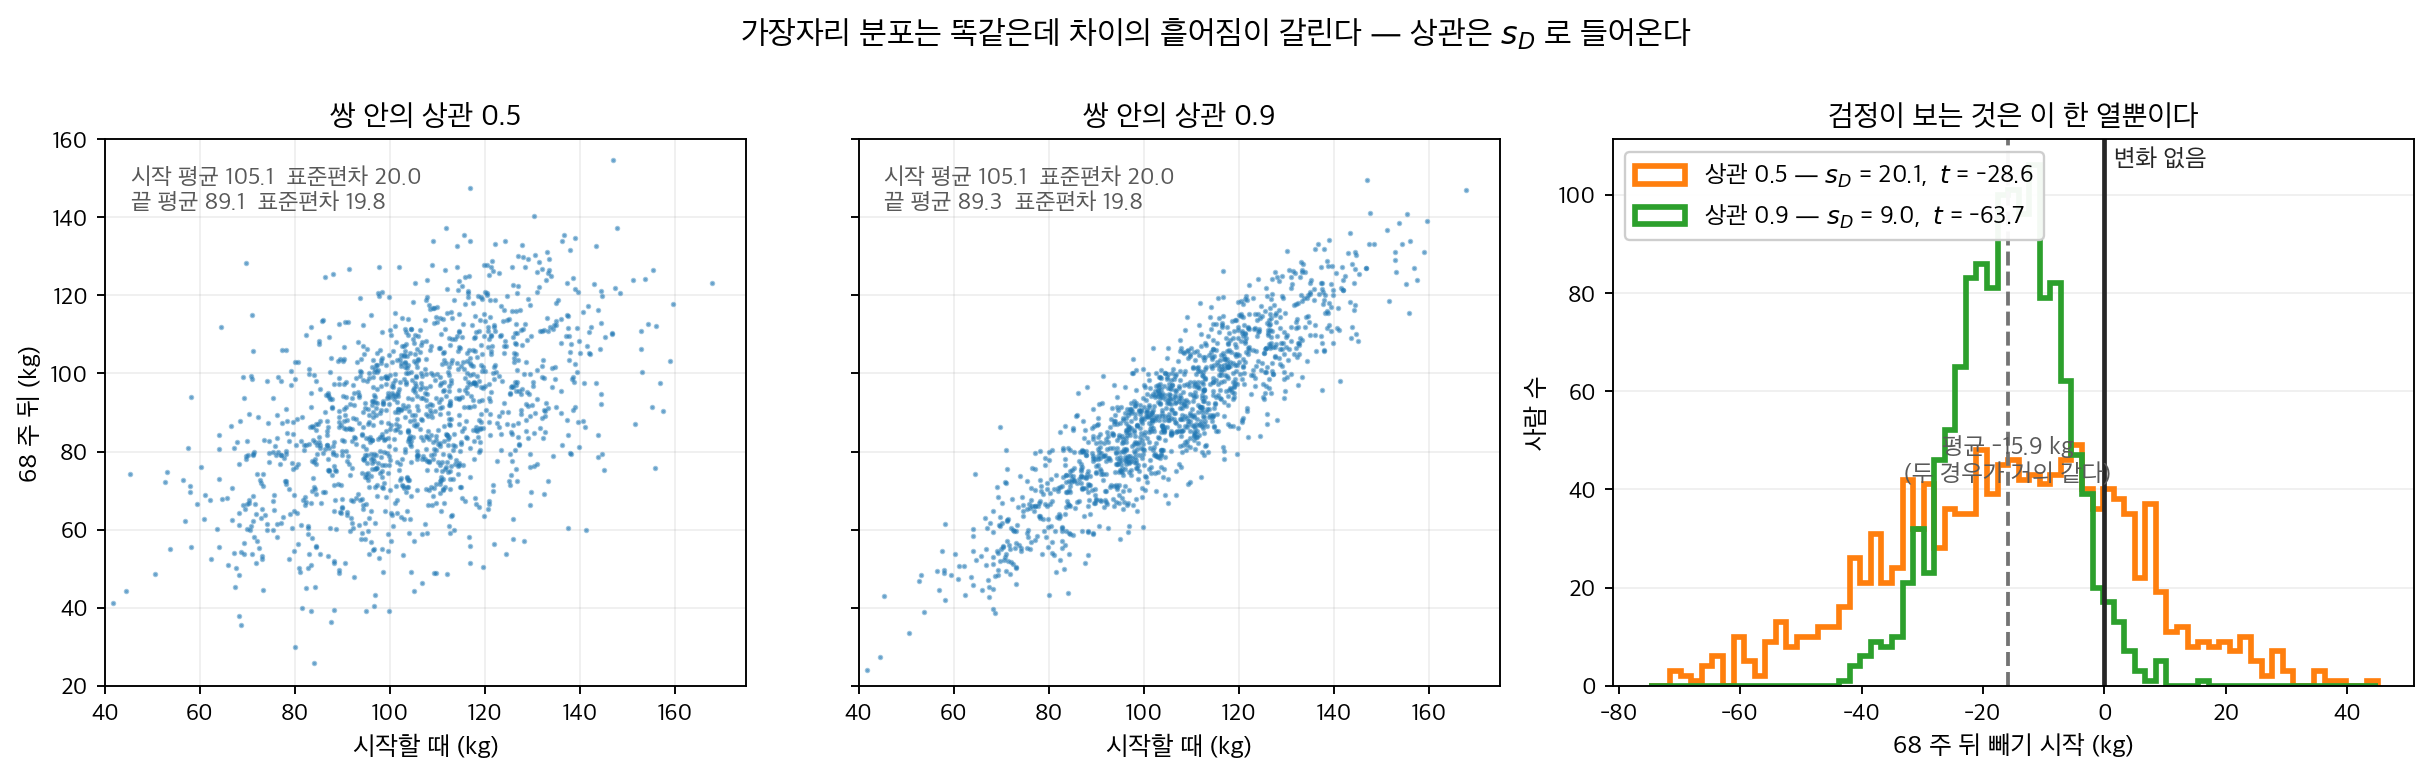
사람 수도 같고 시작 분포도 끝 분포도 같다 — 평균 \(105.1\) 과 \(89.1\), 표준편차 \(20.0\) 과 \(19.8\) 로 두 산점도(scatter plot)의 가장자리가 똑같다. 다른 것은 쌍 안의 상관뿐인데, 오른쪽에서 차이의 산포가 \(s_D = 20.1\) 과 \(9.0\) 으로 갈리고 그 한 수가 \(t\) 를 \(-28.6\) 과 \(-63.7\) 로 가른다. 검정은 상관을 받지 않지만 상관은 이미 \(s_D\) 안에 들어와 있다 — 그것이 이득의 원천을 보지 않고 이득을 챙기는 방법이다. 자료는 이 책이 만든 것이다.
눈여겨볼 것은 이 판정에 들어간 것이 \((n,\ \bar d,\ s_D)\) 세 수뿐이라는 점이다. 짝지어 놓고도 짝을 다시 들여다보지 않는다. 시작 때의 체중도 받지 않고, 사람마다 함께 오르내려 이 설계의 이득을 만들어 낸 쌍 안의 상관도 받지 않는다. 차이를 내는 그 한 번의 뺄셈에서 둘이 이미 식 밖으로 나가 버렸기 때문이다. 그러면서도 이득은 챙긴다 — 상관이 \(s_D\) 를 작게 만드는 방식으로 이미 자료 안에 들어와 있기 때문이다. 이득의 원천을 한 번도 보지 않는 검정이 어떻게 그 이득을 챙기는가. 이 절이 그 검정을 세우고 그 물음에 답한다.
확인한 곳 — Wilding 외, 『New England Journal of Medicine』 \(384\)(\(2021\)) \(989\) 쪽(\(1{,}961\) 명, \(2\) 대 \(1\) 배정으로 \(1{,}306\) 명과 \(655\) 명, \(68\) 주 평균 \(-14.9\%\)). 차이의 산포 \(10\) 퍼센트포인트는 Jastreboff 외, 같은 학술지 \(387\)(\(2022\)) \(205\) 쪽이 표본크기 계산에 쓴 가정이다. 표준오차와 배수는 그 수로 직접 계산한 값이다
대응표본(paired samples) t-검정은 종속표본 t-검정 또는 짝지은 쌍 t-검정이라고도 하며, 한 표본의 관측값을 다른 표본의 관측값과 짝지을 수 있는 두 표본에서 두 모평균을 비교하는 절차이다. 환자–대조군 연구, 반복측정(repeated measures), 처리 전후로 같은 개체를 측정하는 실험 등이 흔한 상황이다. 짝을 정하는 것은 자료가 아니라 설계이고, 짝 안의 상관 \(\rho\) 가 이 설계의 이득을 만든다 — 그 말을 세운 자리는 5.9절 대응표본 차의 평균 표집분포다.
A. 가설
가설은 개별 값이 아니라 짝지은 관측값들의 차이에 초점을 맞춘다.
- 귀무가설(null hypothesis) (\(H_0\)): 짝지은 관측값의 평균 차이가 미리 정한 값 \(\delta_0\) 이다.
$$ H_0: \mu_d = \delta_0 $$
- 대립가설(alternative hypothesis) (\(H_a\)): 짝지은 관측값의 평균 차이가 \(\delta_0\) 이 아니다.
- 양측: \(H_a: \mu_d \neq \delta_0\)
- 우측: \(H_a: \mu_d > \delta_0\)
- 좌측: \(H_a: \mu_d < \delta_0\)
여기서 \(\mu_d\) 는 차이 \(D_i = X_i - Y_i\) 의 모평균이다. 이 쪽의 보기와 연습문제는 같은 양을 \(\mu_D\) 로, 표본에서 구한 차이의 평균과 표준편차를 \(\bar d\) 와 \(s_d\)(또는 \(s_D\))로도 적는다.
가장 흔한 값은 「차이 없음」인 \(\delta_0 = 0\) 이고 이 쪽의 보기도 거의 다 그 값을 쓴다. 그러나 \(0\) 이어야 할 까닭은 없다. 「처리 뒤에 평균이 \(0.03\) 넘게 오른다」를 주장하려면 \(H_0\colon \mu_d = 0.03\) 대 \(H_a\colon \mu_d > 0.03\) 으로 세워야 한다 — \(0\) 에 대고 기각해서는 「올랐다」까지만 말할 수 있고 「\(0.03\) 넘게 올랐다」는 말하지 못한다. 9.1절 귀무가설과 대립가설의 표가 대응표본 줄을 \(0.15\) 로 적은 것도 같은 뜻이다.
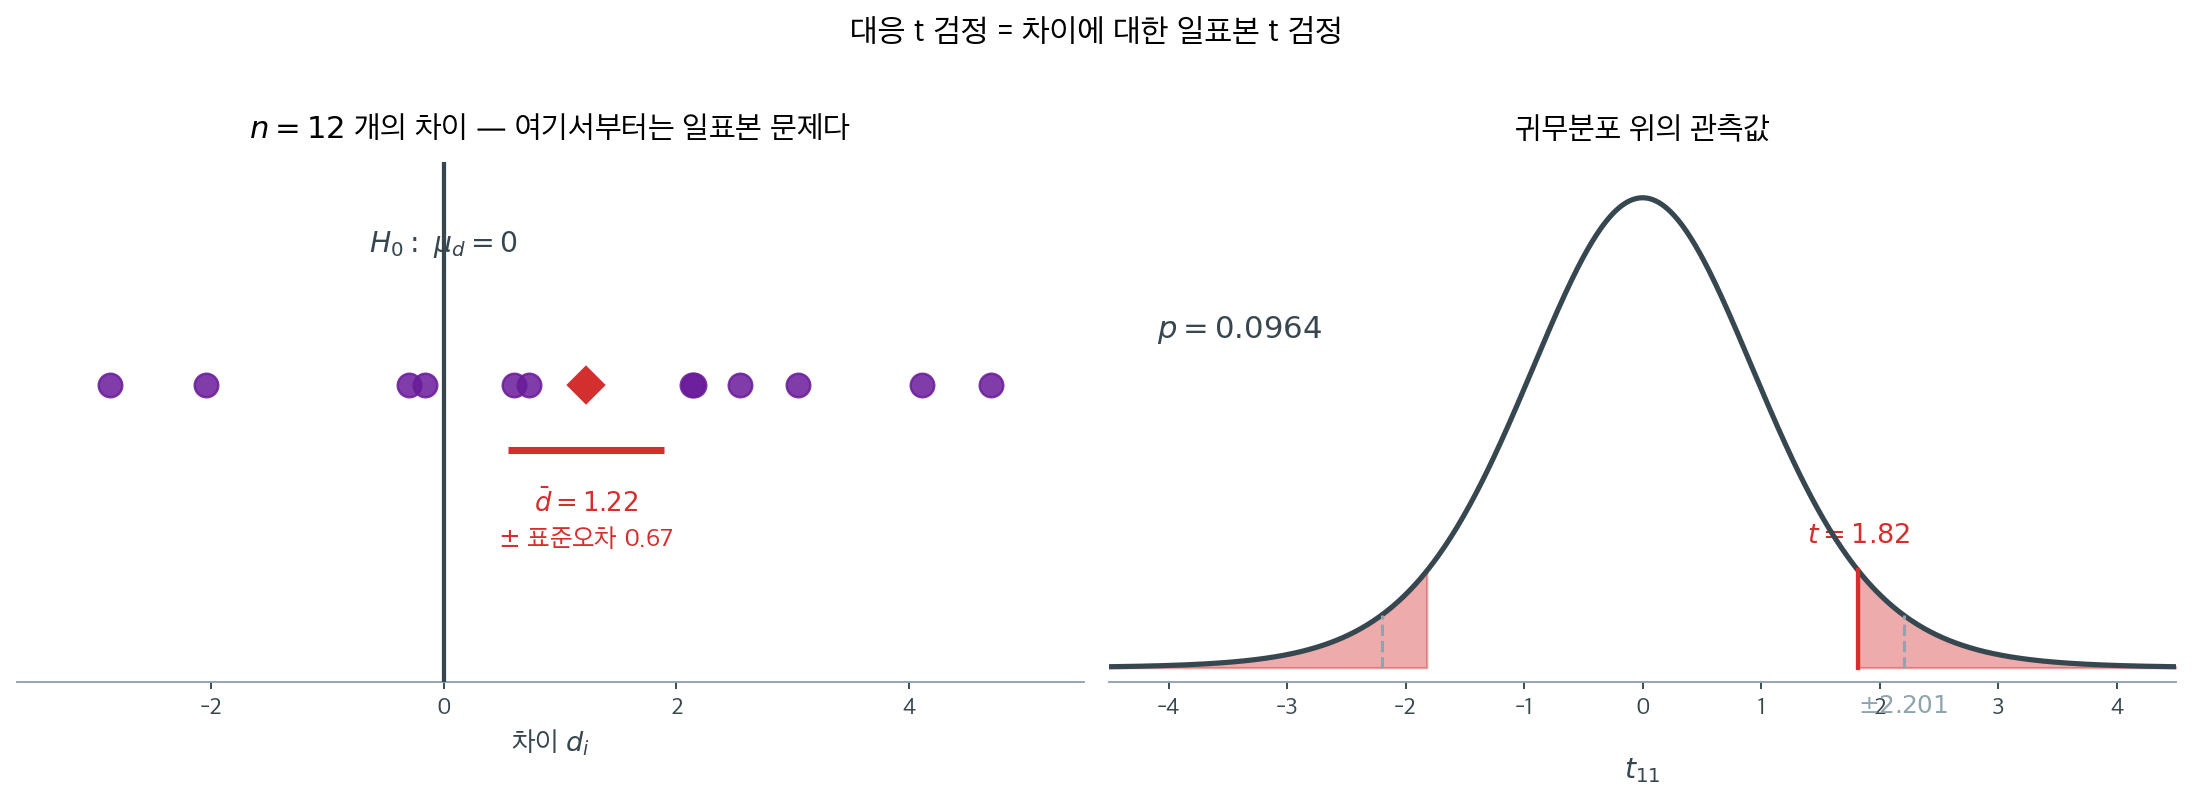
이 그림이 대응표본 검정의 전부다. 쌍마다 차이를 하나씩 계산하는 순간 두 표본 문제가 한 표본 문제로 줄어든다. 왼쪽에 남은 것은 수 \(n\)개와 그것들이 \(\delta_0\)(대개 \(0\))에서 얼마나 떨어져 있는가라는 물음뿐이며, 이는 9.2절 μ에 대한 t-검정 (σ를 모르는 경우)의 일표본 t 검정과 같은 물음이다.
그래서 새로 외울 공식이 없다. 아래의 검정통계량(test statistic)은 일표본 t 통계량에 \(\bar X\) 대신 \(\bar d\)를, \(S\) 대신 \(S_d\)를 넣은 것이고, 자유도도 그대로 \(n - 1\)이다. 쌍이 \(n\)개면 관측값은 \(2n\)개지만 자유도는 \(n-1\)이다. 차이를 취하면서 절반을 이미 써 버렸기 때문이다.
B. 검정통계량
대응표본 t-검정의 검정통계량은 다음과 같이 계산한다.
여기서 \(\bar{d}\)는 대응표본 차이의 평균, \(s_d\)는 그 차이의 표준편차, \(n\)은 쌍의 개수이다. 이 t-통계량은 \(H_0\) 아래에서 자유도 \(n - 1\)인 t-분포를 따른다. \(\delta_0 = 0\) 이면 분자가 \(\bar d\) 만 남아 흔히 보는 꼴 \(t = \bar d/(s_d/\sqrt n)\) 이 된다.
\(\delta_0\) 은 분자만 옮기고 분모는 건드리지 않는다. 쌍 \(n = 12\) 개에서 \(\bar d = 0.4\), \(s_d = 1.1\) 을 얻었다고 하고(아래 보기 4 의 수다) 우측 단측검정을 두 귀무값에 대어 본다.
import math
from scipy.stats import t as tdist

n, dbar, sd = 12, 0.4, 1.1
se = sd / math.sqrt(n)
print(f"se = {se:.4f}")
for d0 in (0.0, 0.03):
    t = (dbar - d0) / se
    print(f"delta0 = {d0:.2f}   t = {t:.4f}   p = {1 - tdist.cdf(t, n - 1):.4f}")
출력:
se = 0.3175
delta0 = 0.00   t = 1.2597   p = 0.1169
delta0 = 0.03   t = 1.1652   p = 0.1343
표준오차 \(0.3175\) 는 두 줄에서 같고, 통계량만 \(0.03/0.3175 = 0.0945\) 만큼 줄어든다. 넘어야 할 선을 올렸으니 같은 자료가 덜 놀랍다 — \(p\) 가 \(0.1169\) 에서 \(0.1343\) 으로 커진다.
C. 판정 규칙
- 양측검정(two-sided test): \(|t| > t_{1-\alpha/2, n-1}\)이면 \(H_0\)을 기각한다.
- 우측 단측검정(\(H_a\colon \mu_d > \delta_0\)): \(t > t_{1-\alpha, n-1}\)이면 \(H_0\)을 기각한다.
- 좌측 단측검정(\(H_a\colon \mu_d < \delta_0\)): \(t < -t_{1-\alpha, n-1}\)이면 \(H_0\)을 기각한다.
여기서 \(t_{q, n-1}\)은 자유도 \(n-1\)인 t-분포의 \(q\) 분위수다.
D. p 값
\(T\) 를 자유도 \(n-1\) 인 t-분포를 따르는 확률변수, \(t\) 를 자료에서 계산한 통계량의 값이라 하면
- 양측검정: \(p\text{-값} = 2P(T \geq |t|)\)
- 단측검정: 우측이면 \(p\text{-값} = P(T \geq t)\), 좌측이면 \(p\text{-값} = P(T \leq t)\).
E. 해석
- p 값 \(\leq \alpha\)이면 귀무가설을 기각할 통계적으로 유의한 증거가 있으며, 대응 차이의 평균이 \(\delta_0\) 과 유의하게 다르다는 뜻이다(\(\delta_0 = 0\) 이면 「차이가 있다」).
- p 값 \(> \alpha\)이면 귀무가설을 기각할 증거가 부족하다.
2. 쌍 안의 순서까지 섞어야 한다
대응 설계는 짝을 묶는 것만으로 끝나지 않는다. 쌍 안에서 어느 쪽을 먼저 받을지도 무작위로 정해야 순서 효과가 처리 효과로 새어 들지 않는다. 아래 보기가 동전을 던져 그것을 정하는 설계이고, 그 설계가 왜 필요한지 따라가며 본다.
보기 1. 러닝화. 올림픽 육상팀 감독은 Harpo 신발이 Zeppo 신발보다 기록을 낮출 수 있다고 의심한다. 러너 여섯 명이 각각 두 바퀴(신발마다 한 바퀴)를 달리며, 순서는 동전 던지기로 정한다. 어떤 검정을 써야 하는지 말하고 가설을 세우시오.
풀이
검정: 대응표본 t 검정. 같은 러너가 두 신발을 모두 신으므로 기록 둘이 러너마다 짝을 이룬다. 러너의 기량 차이는 두 기록에 똑같이 들어 있어, 러너마다 차이(Harpo \(-\) Zeppo)를 내면 사라진다.
「기록을 낮춘다」는 Harpo 로 달린 시간이 더 짧다는 뜻이므로 대립가설이 좌측이다. 순서를 동전으로 정하는 까닭은 둘째 바퀴의 피로(또는 몸이 풀린 효과)가 한 신발에만 몰리지 않게 하려는 것이다 — 언제나 Harpo 를 먼저 신기면 순서 효과와 신발 효과를 가를 수 없다.
보기 2. 사전/사후 시험 점수.
| 학생 | 사후 | 사전 | 차이 |
|---|---|---|---|
| 1 | 93 | 76 | 17 |
| 2 | 70 | 72 | -2 |
| 3 | 81 | 75 | 6 |
| 4 | 65 | 68 | -3 |
| 5 | 79 | 65 | 14 |
| 6 | 54 | 54 | 0 |
| 7 | 94 | 88 | 6 |
| 8 | 91 | 81 | 10 |
| 9 | 77 | 65 | 12 |
| 10 | 65 | 57 | 8 |
| 11 | 95 | 86 | 9 |
| 12 | 89 | 87 | 2 |
| 13 | 78 | 78 | 0 |
| 14 | 80 | 77 | 3 |
| 15 | 76 | 76 | 0 |
학생 \(15\) 명의 사전·사후 점수가 짝을 이룬다. 가설을 세우고 대응표본 \(t\) 검정으로 수업이 점수를 올렸는지 판정하라.
풀이
차이를 사후 \(-\) 사전(Post \(-\) Pre)으로 잡고 양측으로 세운다.
import numpy as np
import scipy.stats as stats

data = np.array([[93,76], [70,72], [81,75], [65,68], [79,65],
                 [54,54], [94,88], [91,81], [77,65], [65,57],
                 [95,86], [89,87], [78,78], [80,77], [76,76]])

# 짝마다 차이를 만들고 나면 그 뒤로는 완전히 일표본 문제다.
# 사람마다 점수 수준이 54에서 95까지 흩어져 있어도 그 개인차가 여기서 사라진다.
difference = data[:,0] - data[:,1]
x_bar = difference.mean()
mu = 0
s = difference.std(ddof=1)
n = difference.shape[0]      # 관측값 30개가 아니라 짝 15개

t = (x_bar - mu) / (s / np.sqrt(n))
p_value = 2 * stats.t(n-1).cdf(-abs(t))

print(f"{t       = :.4f}")
print(f"{p_value = :.4f}")

# scipy로 확인. ttest_ind가 아니라 ttest_**rel**이다.
t2, p2 = stats.ttest_rel(data[:,0], data[:,1], alternative="two-sided")
print(f"\nscipy: t = {t2:.4f}, p = {p2:.4f}")

# 짝을 무시하고 독립 이표본으로 다루면 어떻게 되는지 비교한다.
t3, p3 = stats.ttest_ind(data[:,0], data[:,1])
print(f"ttest_ind (틀린 분석): t = {t3:.4f}, p = {p3:.4f}")
출력:
t       = 3.4616
p_value = 0.0038

scipy: t = 3.4616, p = 0.0038
ttest_ind (틀린 분석): t = 1.3354, p = 0.1925
같은 자료인데 결론이 정반대다. 대응검정은 \(p = 0.0038\)로 기각하고(\(t = 3.4616 > 0\) 이므로 방향은 「올랐다」다), 짝을 무시한 검정은 \(p = 0.19\)로 기각하지 못한다.
이유는 산포에 있다. 점수 자체의 표준편차는 사전 10.3점, 사후 12.1점인데 사전–사후 차이의 표준편차는 6.1점뿐이다. 잘하는 학생은 두 번 다 잘하고 못하는 학생은 두 번 다 못하기 때문에, 짝을 지으면 그 개인차가 통째로 상쇄된다. 짝지어진 자료를 독립표본(independent samples)으로 분석하는 것은 검정력을 버리는 일이다.
보기 3. 대응표본 평균 검정 계산기. 함수가 받는 것은 \((n,\ \bar d,\ s_D)\) 세 수뿐이다. 두 집단의 산포 \(\sigma_1, \sigma_2\)도 쌍 안의 상관 \(\rho\)도 받지 않는다.
(1) 세 수만으로 충분한 까닭을 적고, \(\sigma_1 = \sigma_2 = \sigma\)일 때 짝짓기가 이득이 되기 시작하는 상관의 기준값(손익분기점) \(\rho^*\)를 닫힌 꼴로 구하시오.
(2) \(\rho^*\)를 \(n = 5, 10, 30\)에서 계산해 아래 「짝짓기의 이득과 그 대가」 그림의 값과 맞추고, 기준값을 검정력으로 다시 정의하면 어떻게 달라지는지 보이시오.
풀이
(1) 해석적으로. 쌍 \((X_i, Y_i)\)가 서로 독립이면 차이 \(D_i = X_i - Y_i\)는 i.i.d.이고, 대응 검정은 \(D\)에 대한 일표본 \(t\) 검정 그 자체다. 일표본 검정이 쓰는 것은 \((n, \bar d, s_D)\) 세 수뿐이므로 함수도 그 셋만 받으면 된다.
\(\sigma_1\), \(\sigma_2\), \(\rho\)가 필요 없어지는 것은 그것들이 사라졌기 때문이 아니라 \(s_D\) 안에 이미 들어와 있기 때문이다.
이고 \(s_D^2\)이 이 값을 추정한다. 세 모수가 각자 무엇이었는지는 알 수 없지만, 검정에 필요한 것은 그 조합 하나뿐이다.
기준값을 구한다. 관측값의 총수를 \(2n\)개로 같게 두고 두 설계를 견준다. \(\sigma_1 = \sigma_2 = \sigma\)라 하면
- 대응: 쌍 \(n\)개. \(\operatorname{sd}(D) = \sigma\sqrt{2(1-\rho)}\)이므로 표준오차는 \(\sigma\sqrt{2(1-\rho)/n}\), 자유도는 \(n-1\)이다.
- 독립 이표본: 각 \(n\)명의 두 집단. 표준오차는 \(\sigma\sqrt{2/n}\), 자유도는 \(2n-2\)다.
유의하다고 선언되는 최소 유의 차이(임계값 \(\times\) 표준오차)를 각각 적으면
이다. \(\sigma\)와 \(\sqrt{2/n}\)이 양쪽에 공통이므로 지워진다. 두 최소 유의 차이가 같아지는 조건은
이고, 양변을 제곱해 \(\rho\)로 풀면
이다. 자유도가 크면 \(t\) 임계값이 작아지므로 언제나 \(t_{2n-2} < t_{n-1}\)이고 따라서 \(0 < \rho^* < 1\)이다. \(\rho > \rho^*\)이면 짝짓기가 이득, \(\rho < \rho^*\)이면 손해다. 그리고 \(n \to \infty\)에서 두 임계값이 모두 \(z_{1-\alpha/2}\)로 가므로 \(\rho^* \to 0\), 곧 쌍이 많으면 상관이 조금만 있어도 짝짓기가 이긴다.
(2) 수치적으로. 먼저 함수를 만든다.
import math
from scipy.stats import t as tdist

def test_paired_mean(n, dbar, sd_d, mu_d0=0.0,
                     alt="two-sided", alpha=0.05):
    """대응 t-검정. 차이 D = X - Y에 대한 일표본 검정과 같다.

    받는 것은 짝의 개수 n, 차이의 평균, 차이의 표준편차뿐이다.
    두 집단의 산포나 상관을 따로 알 필요가 없다. 짝을 지으며 이미 흡수했기 때문이다.
    """
    df = n - 1               # 짝의 개수 - 1. 관측값 2n개가 아니다.
    se = sd_d / math.sqrt(n)
    t = (dbar - mu_d0) / se
    if alt == "two-sided":
        p = 2 * min(tdist.cdf(t, df), 1 - tdist.cdf(t, df))
    elif alt == "less":
        p = tdist.cdf(t, df)
    else:
        p = 1 - tdist.cdf(t, df)
    return t, p, (p < alpha)
\(\rho^*\) 를 두 가지 기준으로 계산한다. 하나는 (1)의 닫힌 꼴이고, 다른 하나는 두 설계의 검정력이 같아지는 \(\rho\)를 비중심 \(t\) 분포로 직접 찾은 것이다.
from scipy import stats
from scipy.optimize import brentq

print("  n   t_{n-1}   t_{2n-2}    rho*")
for n in (5, 10, 30):
    t1 = stats.t.ppf(0.975, n - 1)
    t2 = stats.t.ppf(0.975, 2 * n - 2)
    print(f"{n:4d}   {t1:.4f}    {t2:.4f}    {1 - (t2 / t1)**2:.4f}")


def pow_paired(n, rho, mu):
    """쌍 n 개, 상관 rho, 참 평균차 mu 일 때 대응 검정의 검정력."""
    nc = mu * math.sqrt(n) / math.sqrt(2 * (1 - rho))
    tc = stats.t.ppf(0.975, n - 1)
    return stats.nct.sf(tc, n - 1, nc) + stats.nct.cdf(-tc, n - 1, nc)


def pow_two(n, mu):
    """각 n 명인 독립 두 집단의 검정력. 자유도가 2n-2 로 늘어난다."""
    nc = mu * math.sqrt(n) / math.sqrt(2)
    tc = stats.t.ppf(0.975, 2 * n - 2)
    return stats.nct.sf(tc, 2 * n - 2, nc) + stats.nct.cdf(-tc, 2 * n - 2, nc)


print("\n검정력을 같게 만드는 rho (sigma = 1, 참 mu_D 를 바꾸며)")
print("   n    mu_D   독립 검정력    rho*")
for n in (5, 10, 30):
    for mu in (0.5, 1.0, 1.5):
        r = brentq(lambda rr: pow_paired(n, rr, mu) - pow_two(n, mu), -0.5, 0.95)
        print(f"{n:4d}   {mu:.1f}      {pow_two(n, mu):.4f}      {r:.4f}")
출력:
  n   t_{n-1}   t_{2n-2}    rho*
   5   2.7764    2.3060    0.3102
  10   2.2622    2.1009    0.1375
  30   2.0452    2.0017    0.0421

검정력을 같게 만드는 rho (sigma = 1, 참 mu_D 를 바꾸며)
   n    mu_D   독립 검정력    rho*
   5   0.5      0.1077      0.2191
   5   1.0      0.2863      0.2368
   5   1.5      0.5494      0.2563
  10   0.5      0.1851      0.1052
  10   1.0      0.5620      0.1112
  10   1.5      0.8870      0.1173
  30   0.5      0.4779      0.0335
  30   1.0      0.9677      0.0346
  30   1.5      0.9999      0.0356
첫 표의 \(0.3102\), \(0.1375\), \(0.0421\)이 아래 「짝짓기의 이득과 그 대가」 그림에서 읽는 \(0.31\), \(0.14\), \(0.04\)와 같다. 닫힌 꼴이 그림을 그대로 재현한다.
둘째 표가 이 보기에서 한 걸음 더 나간 부분이다. 검정력을 기준으로 삼으면 상관의 기준값이 조금 더 낮다. \(n = 10\)에서 \(0.1375\) 대신 \(0.105\)에서 \(0.117\) 사이이고, \(n = 5\)에서는 \(0.310\) 대신 \(0.219\)에서 \(0.256\) 사이다. 곧 (1)의 \(\rho^*\)는 짝짓기에 조금 불리한 쪽으로 기운 기준이며, 실제로는 그보다 낮은 상관에서도 짝짓기가 이긴다.
두 기준이 어긋나는 까닭은 자유도가 다르면 검정력 곡선의 모양까지 달라지기 때문이다. (1)은 최소 유의 차이 하나만 견주었으므로 \(\rho^*\)가 참 효과크기(effect size)와 무관한 수로 나오는데, 검정력은 참 \(\mu_D\)에 의존하므로 기준값도 함께 움직인다. 표에서 \(\mu_D\)가 커질수록 기준값이 \(0.1052 \to 0.1173\)으로(\(n = 10\)) 올라가는 것이 그 의존성이다.
실무에는 (1)의 닫힌 꼴로 충분하다. 보수적인 쪽으로 틀리기 때문이다. \(3 \le n \le 200\)과 검정력 \(0.05\)에서 \(0.9995\) 사이를 훑어 보면 검정력 기준의 기준값이 \(\rho^*\)를 넘는 경우가 한 번도 없었다. 그러므로 \(\rho > \rho^*\)를 확인했다면 검정력 기준으로도 이득이라고 보아도 된다.
보기 4. 대응 평균 검정 — 방향과 쌍의 개수. 쌍 \(n = 12\)개에서 \(\bar d = 0.4\), \(s_D = 1.1\)을 얻었다. 보기 3의 함수에 같은 자료를 넣고 대립가설만 바꾸면 \(H_a\colon \mu_D < 0\)에서 \(p = 0.883\), \(H_a\colon \mu_D > 0\)에서 \(p = 0.117\)이 나온다.
(1) 두 단측 p 값이 정확히 1로 더해지는 까닭을 보이고, 양측 p 값을 이 둘로 쓰시오. 단측 p 값이 \(0.5\)를 넘는다는 것은 무엇을 뜻하는가.
(2) \(\bar d = 0.4\)와 \(s_D = 1.1\)을 고정한 채 쌍의 개수만 늘린다. 우측 단측검정이 \(p < 0.05\)가 되는 가장 작은 \(n\)을 정규근사로 예측하고 정확한 값과 견주시오. 양측에서도 같이 하시오.
풀이
(1) 해석적으로. 검정통계량 \(T = (\bar d - \mu_{D_0})/(s_D/\sqrt n)\)은(\(\mu_{D_0}\) 은 귀무값으로 \(\S 1\) 의 \(\delta_0\) 이고 여기서는 \(0\) 이다) 세 대립가설에서 똑같은 수다. 달라지는 것은 그 수를 어느 꼬리로 읽는가뿐이다. \(F\)를 \(t_{n-1}\)의 분포함수라 하면
이므로 \(p_{<} + p_{>} = 1\)이다. \(t\) 분포가 연속이라 점질량이 없으므로 이 등식에 오차가 없다. 그리고 양측 p 값은
이다. 여기서는 \(2 \times 0.116929 = 0.233858\)이다.
\(p_{<} > 0.5\)는 \(F(t) > 1/2\), 곧 \(t > 0\)(\(t_{n-1}\)의 중앙값이 0이므로)과 같은 말이다. 그러므로 단측 p 값이 \(0.5\)를 넘으면 언제나 자료가 대립가설과 반대 방향에 있다는 뜻이다. \(0.883\)은 "증거가 아주 약하다"가 아니라 "\(\bar d = 0.4 > 0\)인데 \(\mu_D < 0\)을 검정했다"는 신호다. 이런 경우 올바른 보고는 "기각하지 못했다"가 아니라 "예상과 반대 방향"이다.
(2) 필요한 쌍의 개수. 분자와 분모가 고정이므로 \(t\)는 \(\sqrt n\)으로만 자란다.
기각하려면 \(t(n)\) 이 임계값 \(t_{q,\,n-1}\) 을 넘어야 한다(우측 단측이면 \(q = 0.95\), 양측이면 \(q = 0.975\)). \(t_{q,\,n-1}\)을 표준정규 분위수(quantile) \(z_q\)로 바꾸는 정규근사를 쓰면
이고, 단측(\(z_{0.95} = 1.644854\))에서 \(n > (1.644854 \times 2.75)^2 = 20.4607\), 곧 \(n = 21\)이다. 양측(\(z_{0.975} = 1.959964\))에서는 \(n > 29.0510\), 곧 \(n = 30\)이다.
이 두 답은 모두 틀렸다. \(t\) 분포의 임계값은 언제나 정규의 것보다 크므로(\(t_{q,\,\nu} > z_q\)), 정규근사는 필요한 표본을 낙관적으로 과소평가한다. 바로잡으려면 \(t\) 임계값을 그대로 둔 고정점
을 풀면 된다. 아래에서 보듯 단측은 \(22.3577\), 양측은 \(31.4990\)을 주어 올림하면 23과 32로 정확한 답을 짚는다.
수치적으로.
import numpy as np

dbar, sd_d = 0.4, 1.1

t_stat, p_less, rej_less = test_paired_mean(
    n=12, dbar=dbar, sd_d=sd_d, mu_d0=0.0, alt="less"
)
t2, p_gre, rej_gre = test_paired_mean(
    n=12, dbar=dbar, sd_d=sd_d, mu_d0=0.0, alt="greater"
)
_, p_two, rej_two = test_paired_mean(
    n=12, dbar=dbar, sd_d=sd_d, mu_d0=0.0, alt="two-sided"
)
print(f"t = {t_stat:.12f}   (두 호출이 같은가: {t_stat == t2})")
print(f"  alt='less'      p = {p_less:.12f}  기각 {rej_less}")
print(f"  alt='greater'   p = {p_gre:.12f}  기각 {rej_gre}")
print(f"  두 p 의 합       = {p_less + p_gre:.12f}")
print(f"  alt='two-sided' p = {p_two:.12f}  기각 {rej_two}"
      f"   2*min = {2 * min(p_less, p_gre):.12f}")

# (2) dbar 와 sd_d 를 고정하고 쌍의 개수만 늘린다.
d_over_s = dbar / sd_d
print(f"\nd/s = {d_over_s:.6f}")
for q, name in ((0.95, "단측"), (0.975, "양측")):
    crit = stats.norm.ppf(q)
    n_norm = (crit / d_over_s) ** 2
    n_fix = brentq(lambda n: d_over_s * math.sqrt(n) - stats.t.ppf(q, n - 1),
                   2.5, 5000)
    print(f"  {name}: 정규근사 n > {n_norm:.4f} → {math.ceil(n_norm):d},"
          f"   t 고정점 n > {n_fix:.4f} → {math.ceil(n_fix):d}")

# 전수 탐색. "조건을 만족하는 첫 칸" 만 보지 않는다.
ns = np.arange(2, 2001)
tt = d_over_s * np.sqrt(ns)
p_one = stats.t.sf(tt, ns - 1)
p_dbl = 2 * p_one
for p, name in ((p_one, "단측"), (p_dbl, "양측")):
    ok = ns[p < 0.05]
    print(f"\n{name}: p<0.05 인 n 의 개수 = {len(ok)},  가장 작은 n = {ok.min()},"
          f"  연속인가 = {bool(np.all(np.diff(ok) == 1))}")
    print(f"      p 가 n 에 대해 단조감소인가 = {bool(np.all(np.diff(p) < 0))}"
          f"   (최대 p = {p.max():.6f} at n = {ns[p.argmax()]})")

print("\n   n        t      단측 p     양측 p")
for n in (12, 21, 22, 23, 30, 31, 32):
    t = d_over_s * math.sqrt(n)
    print(f"{n:4d}  {t:.6f}  {stats.t.sf(t, n - 1):.6f}"
          f"  {2 * stats.t.sf(t, n - 1):.6f}")
출력:
t = 1.259673314596   (두 호출이 같은가: True)
  alt='less'      p = 0.883070909978  기각 False
  alt='greater'   p = 0.116929090022  기각 False
  두 p 의 합       = 1.000000000000
  alt='two-sided' p = 0.233858180045  기각 False   2*min = 0.233858180045

d/s = 0.363636
  단측: 정규근사 n > 20.4607 → 21,   t 고정점 n > 22.3577 → 23
  양측: 정규근사 n > 29.0510 → 30,   t 고정점 n > 31.4990 → 32

단측: p<0.05 인 n 의 개수 = 1978,  가장 작은 n = 23,  연속인가 = True
      p 가 n 에 대해 단조감소인가 = True   (최대 p = 0.348806 at n = 2)

양측: p<0.05 인 n 의 개수 = 1969,  가장 작은 n = 32,  연속인가 = True
      p 가 n 에 대해 단조감소인가 = True   (최대 p = 0.697612 at n = 2)

   n        t      단측 p     양측 p
  12  1.259673  0.116929  0.233858
  21  1.666391  0.055611  0.111221
  22  1.705606  0.051415  0.102831
  23  1.743939  0.047564  0.095128
  30  1.991718  0.027947  0.055894
  31  2.024642  0.025943  0.051885
  32  2.057038  0.024090  0.048180
(1)이 확인된다. 두 단측 p 값의 합이 소수 열두째 자리까지 \(1.000000000000\)이고, 양측 p 값이 작은 쪽의 정확히 두 배다. \(t\) 통계량은 세 호출에서 모두 같은 \(1.259673314596\)이다.
(2)에서는 정규근사가 두 번 다 모자란다. 단측에서 근사는 21을 주지만 \(n = 21\)의 실제 p 값은 \(0.055611\)로 아직 \(0.05\)를 넘고, \(n = 22\)에서도 \(0.051415\)다. 정확한 답은 23이다. 양측에서는 근사가 30을 주지만 \(n = 30\)에서 \(0.055894\), \(n = 31\)에서 \(0.051885\)이고 정확한 답은 32다. 두 번 모두 두 개씩 모자라며, 이는 \(t\) 임계값이 정규보다 크다는 사실의 직접적 귀결이다. \(t\) 고정점으로 바로잡으면 \(22.3577\)과 \(31.4990\)으로 올림해 정확히 23과 32를 짚는다.
전수 탐색도 함께 해 두었다. 여기서는 p 값이 \(n\)에 대해 단조감소이고 조건을 만족하는 \(n\)이 23(또는 32)부터 끊김 없이 이어진다. 9.2절 σ²에 대한 카이제곱 검정 보기 2에서는 p 값이 \(n = 8\)까지 올라갔다가 내려와 "첫 칸"만 보면 위험했는데, 평균 검정에서는 \(\bar d/s_D\)를 고정하면 그런 일이 없다. 분모가 자유도에 따라 분포까지 바뀌는 분산 검정과 달리, 여기서는 \(t\) 임계값이 \(n\)에 대해 단조감소하고 통계량 \(t(n) = (\bar d/s_D)\sqrt n\)은 단조증가하기 때문이다.
끝으로 수의 크기를 보아 두자. \(\bar d/s_D = 0.364\)는 차이의 표준편차로 표준화한 효과크기, 곧 코헨(Cohen)의 \(d_z\)로 작은 편의 효과다. 쌍 12개로는 양측 \(p = 0.234\)이고, 같은 \(\bar d/s_D\) 가 관측되었을 때 양측 5% 수준에서 유의하려면 쌍이 32개 필요하다. 12쌍은 이 효과를 가려낼 설계가 아니었다.
짝짓기의 이득과 그 대가
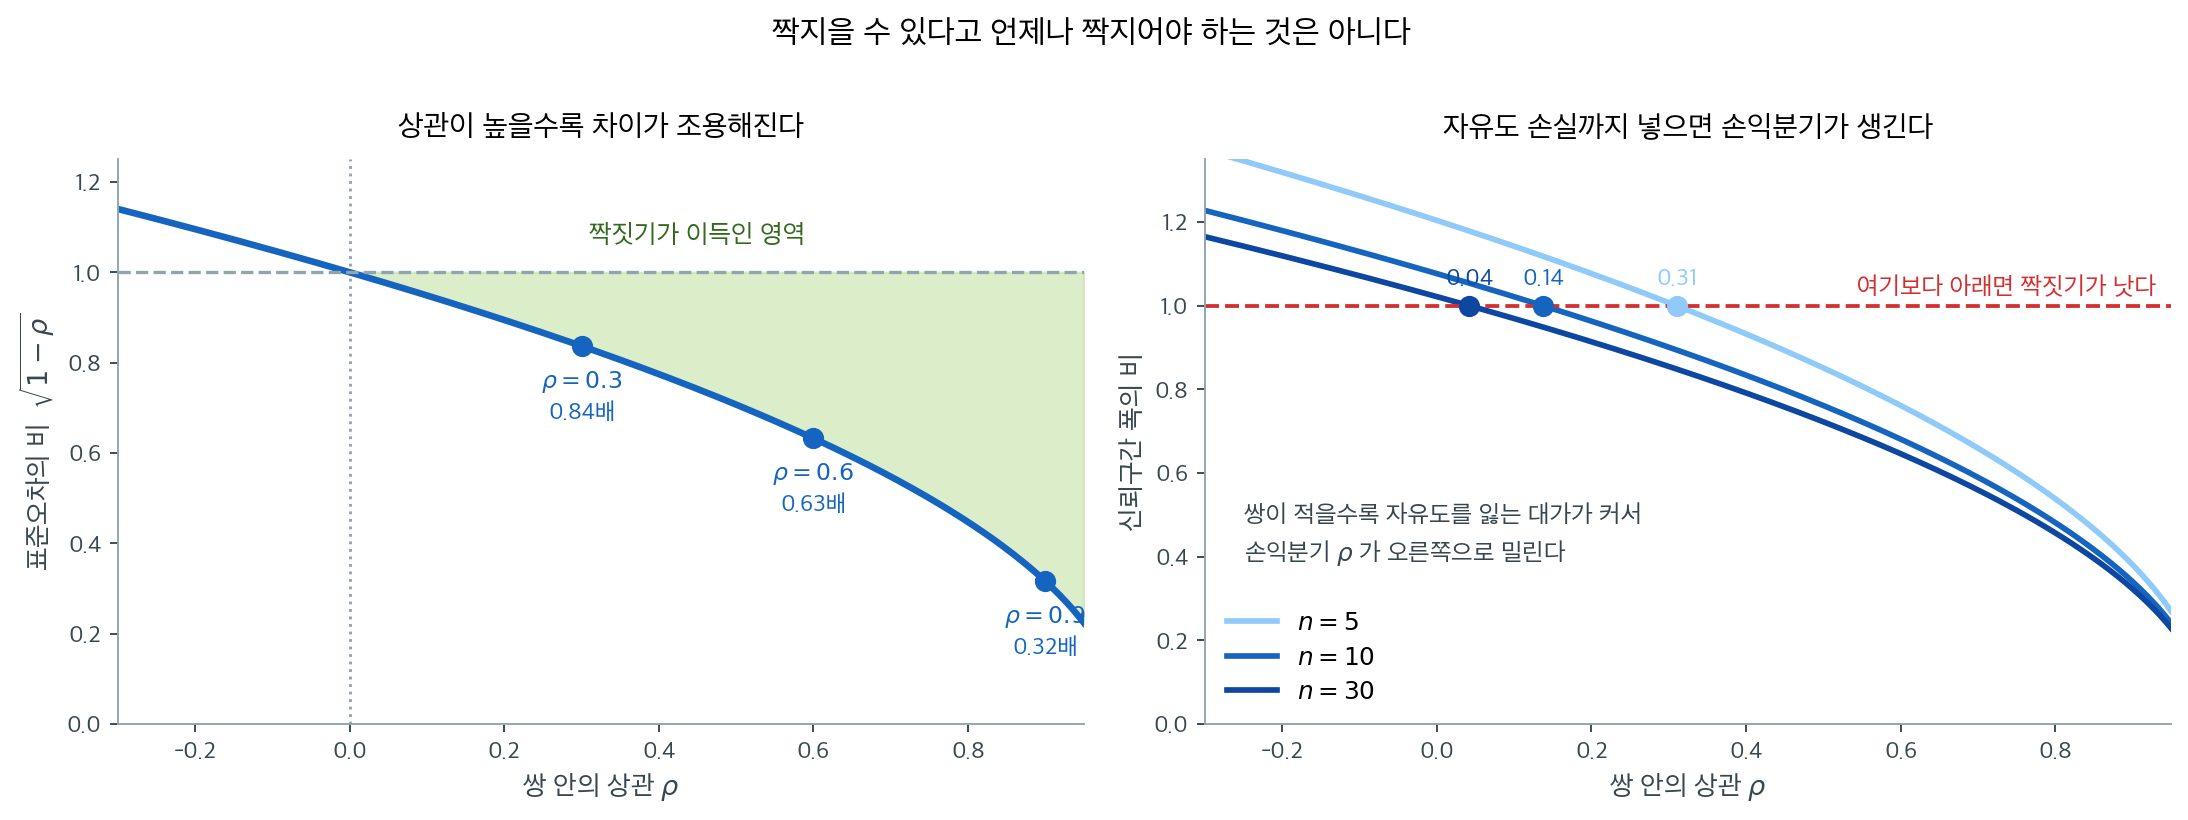
왼쪽이 보기 3에서 나온 인수 \(\sqrt{1-\rho}\), 곧 대응 설계의 표준오차를 독립 설계의 표준오차로 나눈 비다. 상관이 \(0.9\)면 표준오차가 독립 표본의 \(0.32\)배로 줄어든다. 같은 정밀도를 얻는 데 관측값이 십분의 일이면 된다는 뜻이다.
그런데 공짜가 아니다. 오른쪽이 자유도까지 셈에 넣은 그림이다. 쌍 \(n\)개의 대응 검정은 자유도가 \(n-1\)인 반면, 각 \(n\)명인 두 독립 집단은 \(2n-2\)를 쓴다. 자유도가 적으면 임계값이 커지므로, 상관이 0에 가까우면 짝짓기가 오히려 손해다. 손익분기점은 \(n = 5\)에서 \(\rho \approx 0.31\), \(n = 10\)에서 \(0.14\), \(n = 30\)에서 \(0.04\)다. 쌍이 적을수록 짝짓기가 더 확실히 이득이어야 값을 한다.
실무에서 이 계산이 중요한 경우는 드물다. 같은 사람을 두 번 재면 \(\rho\)는 대개 \(0.5\)를 훌쩍 넘기 때문이다. 다만 "짝지을 수 있으니 짝짓는다"가 언제나 옳은 것은 아니며, 짝짓기가 느슨할수록(예컨대 나이만 맞춘 대조군) 이득이 줄어든다는 점은 기억해 둘 만하다.
3. 대응표본 윌콕슨 부호순위 검정
대응표본 윌콕슨(Wilcoxon) 부호순위 검정은 짝지은 관측값의 중앙값 차이가 0과 유의하게 다른지 판단하는 비모수(nonparametric) 검정이다. 자료가 정규성(normality) 가정을 만족하지 못할 때 대응 t-검정의 비모수적 대안으로 쓰인다.
핵심 특징
- 귀무가설 (\(H_0\)): 대응표본 차이의 중앙값이 0이다.
- 자료 요건: 자료가 짝지어져 있고 연속형이거나 순서형이어야 한다. 쌍 사이의 차이가 대칭으로 분포해야 한다.
검정 절차
- 차이를 계산한다: \(d_i = X_i - Y_i\). \(d_i = 0\)인 것은 버린다.
- 절대차이 \(|d_i|\)를 오름차순으로 순위를 매긴다.
- 각 차이의 부호를 해당 순위에 부여한다.
- \(W^+ = \sum(\text{양의 순위})\)와 \(W^- = \sum(\text{음의 순위})\)를 계산한다.
- 검정통계량: \(W = \min(W^+, W^-)\).
- 표본이 크면(\(n > 20\)) 정규근사를 쓴다.
보기 5. 교수법의 개선 효과. 어떤 연구자가 학생 10명에 대해 새 교수법이 시험 점수를 높이는지 검정한다.
- 사전: \([70, 68, 75, 80, 72, 74, 69, 77, 73, 76]\)
- 사후: \([72, 69, 78, 85, 75, 76, 70, 79, 74, 80]\)
차이가 모두 양수이므로(\(d = [2, 1, 3, 5, 3, 2, 1, 2, 1, 4]\)) \(W^+ = 55\), \(W^- = 0\)이 되어 \(W = 0\)이다. \(W = 0 < 8\)(\(n=10\), \(\alpha=0.05\)의 임계값)이므로 \(H_0\)을 기각한다.
풀이
import numpy as np
from scipy.stats import wilcoxon

before = np.array([70, 68, 75, 80, 72, 74, 69, 77, 73, 76])
after = np.array([72, 69, 78, 85, 75, 76, 70, 79, 74, 80])

# 차이가 전부 양수라 음의 순위가 하나도 없다. W = min(W+, W-) = 0이 된다.
stat, p_value = wilcoxon(after, before)

print(f"Test Statistic: {stat}")
print(f"P-value: {p_value}")

alpha = 0.05
if p_value < alpha:
    print("Reject H0: Significant improvement in scores.")
else:
    print("Fail to reject H0: No significant improvement.")
출력:
Test Statistic: 0.0
P-value: 0.001953125
Reject H0: Significant improvement in scores.
p 값 \(0.001953125 = 1/512 = 2/2^{10}\)이 딱 떨어지는 분수다. 우연이 아니다. \(H_0\) 아래에서 10개의 부호가 각각 반반의 확률로 정해지므로 가능한 부호 배열이 \(2^{10} = 1024\)가지이고, 그중 "모두 같은 방향"인 배열은 양쪽 합해 둘뿐이다. 순위 자료를 다루는 비모수 검정에서는 이렇게 p 값이 조합론적으로 결정된다.
여기서 도달할 수 있는 가장 작은 p 값이 0.00195라는 뜻이기도 하다. \(n = 10\)이면 아무리 결과가 극단적이어도 그보다 작은 p 값은 나올 수 없다.
장점과 한계
장점: 정규성을 가정하지 않으며 이상치(outlier)에 로버스트하다.
한계: 차이 분포의 대칭성을 가정하며, 정규성이 성립할 때는 모수적 검정보다 검정력이 낮다.
4. 맺음말
대응표본 t-검정은 서로 종속인 두 표본을 쌍으로 비교할 때 쓰는 기본 도구이다. 전후 연구나 같은 피험자가 두 조건에 노출되는 상황에서 특히 유용하다. 이 검정은 피험자 간 변동을 통제하여 검정하려는 처리나 조건의 효과에 더 정확히 초점을 맞추게 해 준다. 대응표본의 종속성을 반영하므로, 대응 설계가 적절한 상황에서는 독립 이표본 검정보다 강력하고 민감한 분석을 제공한다.
그림으로 보는 통계학 1. 보수적인 줄 알았다
이 검정의 힘은 사람이 자기 자신의 대조군이라는 데서 나온다. 그런데 전후 연구에서 누군가는 두 번째 측정에 오지 않는다. 짝이 하나 깨진다.
오래도록 쓰인 처방은 간단했다. 마지막 관측값을 끝까지 끌고 간다(last observation carried forward, LOCF). 빠진 자리에 그 사람의 직전 값을 적어 넣는 것이다. 이 처방에는 안심이 되는 논리가 붙어 있었다 — 떠난 사람이 그 뒤로 더 좋아지지 않았다고 치는 것이니, 치료의 효과를 깎아내렸으면 깎아내렸지 부풀리지는 않으리라는 것이다. 조심스러운 쪽으로 틀리는 방법이라면 규제기관도 받아 줄 만하다.
\(2010\) 년, 미국 식품의약국의 요청으로 꾸려진 연구평의회 패널이 그 논리를 정면으로 부인했다. 보고서는 LOCF 를 둘러싼 「널리 퍼진 오해 둘」 가운데 하나로 「치료효과 추정값이 위약이나 표준치료 쪽에 유리하게 나오는 경향이 있다」는 믿음을 꼽고, 그것이 「일반적으로 참이 아니다 — 이 방법들이 늘 보수적인 추정량을 주지는 않기 때문」이라고 적었다. 오히려 치료를 중단한 사람이 시간이 갈수록 나빠지는 상황에서 LOCF 는 반보수적이며, 내약성 때문에 많이 중단하는 약이라면 「치료가 대조보다 훨씬 좋아 보이게 만들 수 있다」고 했다. 떠난 사람의 나빠짐이 그 사람의 좋았던 마지막 값에 가려지기 때문이다.
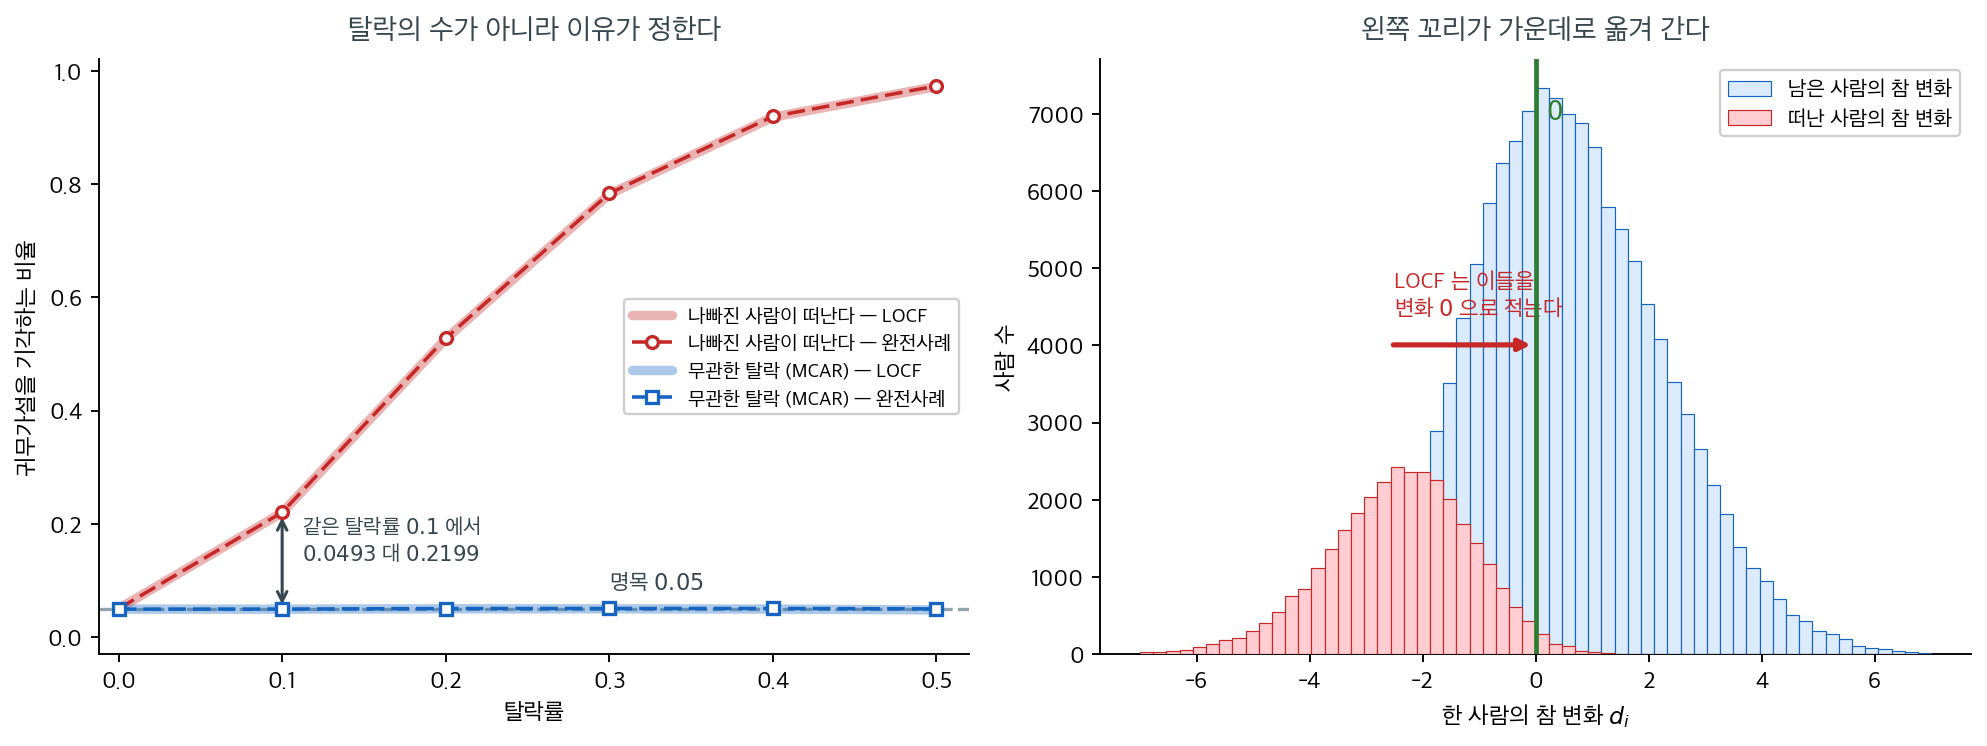
쌍 \(40\) 개, 참 평균변화 \(0\)(귀무가설이 참), 유의수준 \(0.05\), 반복 \(200{,}000\) 회.
귀무가설이 참인 자료를 만들어 놓고 탈락의 수는 그대로 둔 채 이유만 바꾸어 보았다. 탈락이 변화와 무관하면(완전 무작위 결측, missing completely at random, MCAR) LOCF 는 탈락률 \(0.1\) 에서 \(0.0493\), \(0.5\) 에서도 \(0.0480\) 으로 명목 수준을 지킨다. 이것이 이 처방이 통과해 온 시험이다. 그런데 나빠진 사람이 떠나는 쪽으로 이유만 바꾸면, 같은 탈락률 \(0.1\) 에서 기각 비율이 \(0.2199\) 로 뛴다. \(0.2\) 에서는 \(0.5265\) 다. 효과가 없는데도 둘에 한 번 유의하다고 말하는 검정이다.
오른쪽이 그 까닭이다. 떠난 사람의 참 변화는 왼쪽 꼬리에 몰려 있는데 LOCF 는 그들을 변화 \(0\) 으로 적는다. 왼쪽 꼬리가 통째로 가운데로 옮겨 가면 남은 분포의 평균이 오른쪽으로 밀린다. 보고서가 지적한 또 하나 — 대체의 불확실성을 무시하므로 표준오차와 신뢰구간 폭도 과소추정된다.
그림에서 눈여겨볼 것이 하나 더 있다. 완전사례 분석의 곡선이 LOCF 와 포개져 있다(\(0.2203\) 대 \(0.2199\)). 빠진 자리를 메우든 지우든 같은 자리에서 무너진다는 뜻이다. 그러므로 이 이야기의 교훈은 「LOCF 대신 무엇을 쓰라」가 아니다. 무너뜨린 것은 메우는 방식이 아니라 빠지는 이유이고, 이유는 자료 안에 적혀 있지 않다. LOCF 의 진짜 잘못은 틀린 답을 준 것이 아니라, 쉬운 경우에 멀쩡해 보여서 어려운 경우까지 믿고 들고 간 것이다. 보고서의 권고도 금지가 아니라 거기에 걸려 있다 — 「그 바탕 가정이 과학적으로 정당화되지 않는 한」 주된 방법으로 쓰지 말라.
확인한 곳 — 미국 식품의약국의 요청으로 미국 연구평의회가 꾸린 패널의 \(2010\) 년 보고서 『The Prevention and Treatment of Missing Data in Clinical Trials』, 그 \(4\) 장 「Drawing Inferences from Incomplete Data」(\(47\)–\(78\) 쪽)가 LOCF·BOCF 의 「널리 퍼진 오해 둘」을 적으며 치료효과가 위약 쪽에 유리하게 나온다는 믿음이 「일반적으로 참이 아니다 — 이 방법들이 늘 보수적인 추정량을 주지는 않기 때문」이라고 한 것, 치료를 중단한 사람이 시간이 갈수록 나빠지는 상황에서 LOCF 가 반보수적이며 내약성 때문에 많이 중단하면 「치료가 대조보다 훨씬 좋아 보이게 만들 수 있다」고 한 것, 대체의 불확실성을 무시하면 표준오차와 신뢰구간 폭이 과소추정된다고 한 것, 그리고 「LOCF·BOCF 같은 단일대체법은 그 바탕 가정이 과학적으로 정당화되지 않는 한 결측자료 처리의 주된 방법으로 쓰여서는 안 된다」는 권고. 그림과 표의 수는 모두 직접 계산한 값이다
연습문제
연습문제 1. 운동 프로그램: 참가자 10명의 체지방률(%)을 프로그램 전후로 측정했다. 차이(사전 \(-\) 사후)에서 \(\bar d = 1.7\), \(s_d \approx 0.483\)을 얻었다. 운동이 체지방을 줄이는지 \(\alpha = 0.05\)에서 검정하라.
풀이
차이를 사전 \(-\) 사후로 잡았으므로 「줄었다」는 \(\mu_d > 0\) 이다. \(H_0\colon \mu_d = 0\) 대 \(H_a\colon \mu_d > 0\) 을 세우고, 대응표본이므로 자유도 \(n - 1 = 9\) 인 \(t_9\)를 쓴다.
\(t = 1.7/(0.483/\sqrt{10}) = 1.7/0.153 \approx 11.13\).
우측 단측검정의 임계값은 \(t_{0.95,9} = 1.833\) 이다. \(11.13 \gg 1.833\) 이므로 압도적으로 기각한다. 체지방률이 프로그램 뒤에 유의하게 줄었다. 다만 대조군이 없는 전후 비교이므로 그 감소를 운동의 효과라고 단정할 수는 없다(연습문제 9).
연습문제 2. 식이요법: 참가자 12명의 콜레스테롤 수치를 식이요법 전후로 측정했다. 차이(사전 \(-\) 사후)의 평균이 \(\bar d = 7.5\) mg/dL(감소), 표준편차가 \(s_d \approx 2.61\) 이다. 식이요법이 콜레스테롤을 낮추는지 \(\alpha = 0.05\)에서 검정하라.
풀이
\(H_0\colon \mu_d = 0\) 대 \(H_a\colon \mu_d > 0\)(사전 \(-\) 사후이므로 감소가 양수다)을 세운다.
\(t = 7.5/(2.61/\sqrt{12}) = 7.5/0.753 \approx 9.95\).
우측 단측검정의 임계값은 자유도 \(11\) 에서 \(t_{0.95,11} = 1.796\) 이다. \(9.95 \gg 1.796\) 이므로 기각한다. 콜레스테롤 수치가 식이요법 뒤에 유의하게 낮아졌다(연습문제 1 과 마찬가지로 대조군 없는 전후 비교다).
연습문제 3. 대응이 독립보다 나은 이유. 연습문제 1에서 짝짓기를 무시하고 사전 값 10개와 사후 값 10개를 독립표본으로 취급한다고 하자. 무엇이 달라지는가?
풀이
두 측정의 요약이 다음과 같았다고 하자. 사전: 평균 28.2, 표준편차 2.66. 사후: 평균 26.5, 표준편차 2.42. 두 분산을 평균해 합동 표준편차를 구하면 \(\sqrt{(2.66^2 + 2.42^2)/2} \approx 2.55\) 다.
독립 \(t\) = \((28.2 - 26.5)/\sqrt{2.55^2(1/10 + 1/10)} = 1.7/1.14 \approx 1.49\). 임계값(단측, 자유도 18): 1.734. 기각하지 못한다.
대응 분석(\(t \approx 11.1\))은 압도적인 유의성을 주지만 독립 분석(\(t \approx 1.5\))은 탐지하지 못한다.
이유: 피험자 내 상관이 높다(각 피험자의 전후 값이 서로 비슷하다). 대응 분석은 이를 활용하지만 독립 분석은 잡음으로 취급한다.
교훈: 분석은 항상 설계에 맞추라. 짝짓기를 무시하면 정보를 낭비한다.
연습문제 4. 대응 \(t\)-검정의 조건. 이 검정이 타당하려면 무엇이 성립해야 하는지 적어라.
풀이
- 설계로 정해진 짝: 두 관측값이 자료를 보기 전에 짝지어져 있어야 한다(같은 피험자, 쌍둥이, 짝지은 대조군).
- 쌍 사이의 독립성(independence): 피험자들이 서로 영향을 주지 않는다.
- 차이 \(D_i\)의 근사적 정규성: 차이의 Q-Q 그림으로 확인한다.
유의: 사전이나 사후 값 각각이 아니라 차이가 정규여야 한다. 차이가 정규가 아니면 윌콕슨 부호순위 검정을 쓴다.
연습문제 5. 비모수적 대안으로서의 윌콕슨 부호순위 검정. 간단히 기술하라.
풀이
대응 자료에서는 이렇게 된다.
- 차이 \(D_i\)를 계산한다.
- \(|D_i|\)의 순위를 매긴다(부호는 무시).
- 양의 차이와 음의 차이의 순위를 각각 더한다.
- 검정통계량: 두 합 중 작은 것(또는 둘 다 임계값과 비교).
\(H_0: \mathrm{median}(D) = 0\) 아래에서 이 검정은 알려진 귀무분포를 갖는다(작은 \(n\)에서는 표로, 큰 \(n\)에서는 정규근사로).
장점: 정규성을 가정하지 않는다. 이상치에 로버스트하다.
단점: 정규성이 성립할 때 대응 \(t\)-검정보다 검정력이 낮다. 해석이 덜 직관적이다.
현대의 실무: 차이가 깨끗하게 정규이면 대응 \(t\), 치우쳤거나 이상치가 잦으면 윌콕슨.
연습문제 6. 대응과 비대응의 검정력. 피험자들이 상관 \(\rho\)로 짝지어져 있다면 대응 분석에서 \(n\)은 얼마나 작아도 되는가?
풀이
두 측정의 표준편차가 모두 \(\sigma\) 라 하자. 대응 설계에서 차이의 분산은 \(\sigma_D^2 = 2\sigma^2(1 - \rho)\) 이고, 비대응(독립) 설계에서 두 관측값 차의 분산은 \(\sigma_{\text{독립}}^2 = 2\sigma^2\) 이다.
비: \(\sigma_D^2/\sigma_{\text{독립}}^2 = 1 - \rho\).
같은 검정력에 필요한 \(n\)(대응이면 쌍의 수, 독립이면 집단마다의 크기)은 분산에 비례하므로 이렇게 된다.
\(n_{\text{대응}}/n_{\text{독립}} = 1 - \rho\).
\(\rho = 0.5\)이면 대응 분석에 자료가 절반만 필요하다. \(\rho = 0.9\)이면 10분의 1이면 된다.
실무적 함의: 가능하다면 짝짓기가 표본크기 예산을 크게 아껴 준다. 비용이 큰 연구(임상시험)에서 특히 가치가 있다.
연습문제 7. 대응 자료에서 한쪽이 결측된 쌍을 어떻게 다루는지 비교하라.
풀이
import numpy as np
from scipy import stats

rng = np.random.default_rng(19)
n, M, rho = 20, 5_000, 0.7
L = np.linalg.cholesky(np.array([[1, rho], [rho, 1]]))
hit_cc = hit_ind = 0

for _ in range(M):
    z = rng.standard_normal((n, 2)) @ L.T
    x, y = 10 + z[:, 0], 10.5 + z[:, 1]      # 참 차이 0.5
    miss = rng.random(n) < 0.25              # y 가 25% 결측

    d = (y - x)[~miss]                       # 완전사례 대응 검정
    hit_cc += stats.ttest_1samp(d, 0).pvalue < 0.05

    yy = y[~miss]                            # 있는 자료를 다 쓰되 독립으로
    hit_ind += stats.ttest_ind(yy, x, equal_var=False).pvalue < 0.05

print(f"완전사례 대응 검정   검정력 {hit_cc / M:.4f}")
print(f"짝 깨고 독립 검정    검정력 {hit_ind / M:.4f}")
완전사례 대응 검정   검정력 0.6380
짝 깨고 독립 검정    검정력 0.2096
완전사례 대응 검정이 세 배 강력하다. 자료의 25%를 버렸는데도 그렇다.
왜 그런가. \(\rho=0.7\)의 이득이 결측으로 잃는 정보보다 훨씬 크다. 쌍 15개의 대응 검정이 \((20,15)\) 두 독립표본보다 정보가 많다.
손익분기. 보기 3의 \(\rho^*\) 계산과 같은 구조다. 결측률 \(q\)에서 완전사례 대응이 유리할 조건은 대략
이다. 결측률보다 상관이 크면 대응을 유지한다. 실무에서는 대개 그렇다.
더 나은 방법 셋.
-
혼합모형. 개체를 임의효과로 두면 모든 관측값을 쓰면서 상관도 반영한다. 결측 여부가 관측된 값에만 달려 있는 무작위 결측(missing at random, MAR) 아래에서 완전사례보다 효율적이고 편향도 없다.
-
다중대체. 결측값을 여러 번 대체하고 루빈의 규칙으로 결합한다. 보조변수를 대체 모형에 넣을 수 있다.
-
이변량 정규의 최대가능도. 결측이 있어도 직접 적합할 수 있다.
하지 말 것 둘.
- 결측을 평균으로 채우기. 분산을 인위적으로 줄여 \(p\) 값이 작게 나온다.
- 마지막 관측값 이월(LOCF). 편향을 만들고 분산을 과소평가한다. 한때 표준이었으나 지금은 권장되지 않는다. 「보수적이니 안전하다」는 논리가 왜 뒤집혔는지는 이 쪽 「그림으로 보는 통계학 1. 보수적인 줄 알았다」 상자에 있다.
가장 중요한 것 — 결측 기전. 위 계산은 결측이 어떤 값과도 무관한 완전 무작위 결측(MCAR)을 가정했다. 상태가 나빠진 사람이 추적을 놓친다면 완전사례 분석이 편향된다. 결측 여부와 관측 변수의 관계를 반드시 조사한다.
연습문제 8. 대응 검정의 효과크기를 정의하는 여러 방식을 비교하고, 어느 것을 보고해야 하는지 논하라.
풀이
문제. 대응 설계에서는 "표준화"할 표준편차가 여럿이다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(72)
n, rho = 30, 0.7
L = np.linalg.cholesky(np.array([[1, rho], [rho, 1]]))
z = rng.standard_normal((n, 2)) @ L.T
pre = 50 + 10 * z[:, 0]
post = 53 + 10 * z[:, 1]
d = post - pre

sd_d = d.std(ddof=1)
sd_pre = pre.std(ddof=1)
sd_avg = np.sqrt((pre.var(ddof=1) + post.var(ddof=1)) / 2)
r = np.corrcoef(pre, post)[0, 1]

print(f"평균 차이 {d.mean():.4f}")
print(f"SD(차이) {sd_d:.4f},  SD(사전) {sd_pre:.4f},  "
      f"SD(평균) {sd_avg:.4f},  r = {r:.4f}")
print()
print(f"d_z   = 평균차/SD(차이)  = {d.mean() / sd_d:.4f}")
print(f"d_rm  = d_z × √(2(1-r))  = "
      f"{d.mean() / sd_d * np.sqrt(2 * (1 - r)):.4f}")
print(f"d_av  = 평균차/SD(평균)  = {d.mean() / sd_avg:.4f}")
print(f"d_pre = 평균차/SD(사전)  = {d.mean() / sd_pre:.4f}")
평균 차이 3.1253
SD(차이) 7.0163,  SD(사전) 8.5041,  SD(평균) 9.0700,  r = 0.7060

d_z   = 평균차/SD(차이)  = 0.4454
d_rm  = d_z × √(2(1-r))  = 0.3416
d_av  = 평균차/SD(평균)  = 0.3446
d_pre = 평균차/SD(사전)  = 0.3675
네 값이 0.34에서 0.45까지 걸친다. 같은 자료, 같은 평균 차이인데 30% 차이가 난다.
어느 것이 맞는가 — 목적에 달렸다.
| 지표 | 분모 | 언제 |
|---|---|---|
| \(d_z\) | SD(차이) | 검정력 계산. \(t\) 통계량과 직접 연결 |
| \(d_{av}\) | SD(사전·사후 평균) | 메타분석. 독립설계와 비교 가능 |
| \(d_{pre}\) | SD(사전) | 사전 분포를 기준으로 볼 때 |
| \(d_{rm}\) | 상관 보정 | 사전·사후 표준편차가 같으면 \(d_{av}\)와 일치한다(여기서는 \(0.3416\) 대 \(0.3446\)) |
핵심 — 메타분석에는 \(d_{av}\)를 쓴다. \(d_z\)는 \(\rho\)에 의존하므로, 상관이 다른 연구끼리 비교할 수 없다. \(\rho\)가 클수록 \(d_z\)가 커진다.
\(\rho=0.9\)면 \(d_z\)가 \(d_{av}\)의 2.24배다. 같은 효과인데 상관이 큰 연구가 "더 큰 효과"로 보인다.
for rho_v in [0.0, 0.5, 0.7, 0.9, 0.95]:
    print(f"ρ = {rho_v:.2f}: d_z / d_av = "
          f"{1 / np.sqrt(2 * (1 - rho_v)):.3f}")
ρ = 0.00: d_z / d_av = 0.707
ρ = 0.50: d_z / d_av = 1.000
ρ = 0.70: d_z / d_av = 1.291
ρ = 0.90: d_z / d_av = 2.236
ρ = 0.95: d_z / d_av = 3.162
보고 권고.
연습문제 9. 대응 검정의 결과를 보고하는 양식을 만들고, 흔한 잘못을 지적하라.
풀이
보고할 것 여덟.
- 설계. 무엇을 무엇과 짝지었는가. 전후인가, 교차인가, 짝지은 대조군인가.
- 각 조건의 요약. 평균과 SD를 조건별로.
- 차이의 요약. \(\bar d\), \(s_d\), 그리고 상관 \(r\).
- 검정통계량과 자유도. \(t(29)=2.44\).
- \(p\) 값과 단측/양측.
- 차이의 신뢰구간. 원 척도로.
- 효과크기. 어느 판인지 명시.
- 가정 확인. 차이의 정규성, 이상치.
좋은 보고의 예.
참가자 30명의 점수는 개입 전 49.1(SD 8.5), 개입 후 52.2(SD 9.6)였고, 사전·사후 상관은 0.71이었다. 평균 차이는 3.13점(SD 7.02)으로, 대응 \(t\) 검정에서 \(t(29)=2.44\), 양측 \(p=0.021\)이었다. 차이의 95% 신뢰구간은 0.51~5.75점, \(d_{av}\)는 0.34(95% CI 0.05~0.63)이다. 차이의 Q-Q 그림에서 정규성 위배는 보이지 않았고(왜도(skewness) \(-0.26\)), 윌콕슨 부호순위 검정도 같은 결론을 주었다(\(p=0.026\)). 임상적으로 의미 있다고 보는 5점 차이가 구간에 포함되므로, 효과의 실무적 크기는 확정하기 어렵다.
흔한 잘못 일곱.
| 잘못 | 왜 문제인가 |
|---|---|
| 사전·사후 SD만 적고 \(s_d\)를 안 적음 | 재계산이 불가능하다 |
| 상관 \(r\)을 안 적음 | 메타분석과 후속 설계에 필수 |
| 사전·사후 각각의 정규성을 검정 | 차이의 정규성이 필요하다 |
| 대응 자료를 독립 \(t\)로 분석 | 보기 2 와 연습문제 3 에서 본 대로 검정력을 크게 잃는다 |
| 독립 자료를 대응으로 분석 | 짝짓기 근거가 없으면 무효 |
| 효과크기 판을 명시하지 않음 | 연습문제 8 의 0.34와 0.45가 뒤섞인다 |
| 대조군 없는 전후 비교를 인과로 해석 | 평균회귀와 시간효과가 섞여 있다 |
마지막 항목이 가장 중요하다. 대조군 없는 전후 설계에서
이며, 통계는 이 넷을 분리하지 못한다. 대응 \(t\) 검정이 유의해도 "처리가 효과가 있다"고 말할 수 없다.
보고에 반드시 넣을 한 문장.
이 연구는 대조군이 없는 전후 설계이므로, 관측된 변화에는 처리효과 외에 시간 경과, 평균회귀, 기대효과가 섞여 있을 수 있다. 인과적 해석에는 대조군을 둔 후속 연구가 필요하다.
이 문장이 없는 전후 연구는 대부분 과잉해석되어 있다.
연습문제 10. 대응 자료에서 \(t\)·윌콕슨·부호검정의 검정력을 차이의 분포별로 비교하라.
풀이
import numpy as np
from scipy import stats

rng = np.random.default_rng(45)
n, M = 20, 10_000

cases = [("정규", lambda s: rng.normal(0, 1, s), 0.5),
         ("t(3)", lambda s: rng.standard_t(3, s), 0.5),
         ("이중지수", lambda s: rng.laplace(0, 1 / np.sqrt(2), s), 0.5),
         ("로그정규(중심화)",
          lambda s: rng.lognormal(0, 1, s) - np.exp(0.5), 0.8)]
print(f"{'차이의 분포':>16s} {'t':>8s} {'윌콕슨':>9s} {'부호':>8s}")
for name, gen, shift in cases:
    c = np.zeros(3)
    for _ in range(M):
        d = gen(n) + shift
        c[0] += stats.ttest_1samp(d, 0).pvalue < 0.05
        c[1] += stats.wilcoxon(d).pvalue < 0.05
        k = int((d > 0).sum())
        c[2] += stats.binomtest(k, n, 0.5).pvalue < 0.05
    print(f"{name:>16s} {c[0] / M:8.4f} {c[1] / M:9.4f} {c[2] / M:8.4f}")
          차이의 분포        t       윌콕슨       부호
              정규   0.5623    0.5454   0.3826
            t(3)   0.3182    0.3850   0.3297
            이중지수   0.5927    0.6669   0.6290
       로그정규(중심화)   0.3875    0.2819   0.0753
분포마다 최선이 다르다.
| 차이의 분포 | 최선 | 비고 |
|---|---|---|
| 정규 | \(t\)(0.562) | 윌콕슨이 0.545로 3%만 손해 |
| \(t_3\) | 윌콕슨(0.385) | \(t\)(0.318)보다 21% 강력 |
| 이중지수 | 윌콕슨(0.667) | 부호검정도 0.629로 선전 |
| 로그정규 | \(t\)(0.388) | 윌콕슨 0.282, 부호 0.075 |
마지막 줄이 중요하다. 치우친 분포에서 순위 기반 검정이 오히려 크게 약하다. 세 검정이 다른 모수를 검정하기 때문이다.
- \(t\)는 평균을 검정한다. 중심화한 로그정규에 0.8을 더했으므로 평균이 0.8이다.
- 윌콕슨은 유사중앙값(pseudomedian), 곧 두 관측값의 평균 \((D_i + D_j)/2\) 들의 중앙값을 검정한다. 그 값이 0.8보다 훨씬 작다.
- 부호검정은 중앙값을 검정하는데, 로그정규의 중앙값이 평균보다 한참 아래라 0에 가깝다. 그래서 검정력이 0.075로 거의 없다.
이것은 검정의 결함이 아니라 대상의 차이다. "로그정규 자료에는 비모수를 쓰라"는 조언이 얼마나 위험한지 보여 준다.
점근상대효율로 정리하면. 점근상대효율(ARE)은 표본이 클 때 두 검정이 같은 검정력을 내는 데 필요한 표본크기의 비다. \(1\)보다 크면 \(t\) 검정보다 적은 표본으로 같은 검정력을 낸다는 뜻이다.
| 분포 | \(t\) 대비 윌콕슨 | \(t\) 대비 부호 |
|---|---|---|
| 정규 | 0.955 | 0.637 |
| 균등 | 1.000 | 0.333 |
| 로지스틱 | 1.097 | 0.822 |
| 이중지수 | 1.500 | 2.000 |
| \(t_3\) | 1.90 | 1.62 |
이중지수에서 부호검정이 \(t\)의 두 배다. 중앙값이 이 분포의 최대가능도추정량이기 때문이다.
실무 지침 넷.
- 차이의 분포를 그려 본다. 대칭인가, 꼬리가 두꺼운가, 치우쳤는가.
- 대칭이면 윌콕슨이 안전한 기본값. 정규에서 손실이 4.5%뿐이고 두꺼운 꼬리에서 크게 이긴다.
- 치우쳤고 평균이 관심사면 \(t\)나 부트스트랩(bootstrap). 순위 검정으로 바꾸지 않는다.
- 방법을 사전에 정한다. 자료를 보고 고르면 9.2절 μ에 대한 t-검정 (σ를 모르는 경우) 연습문제 9 에서 본 2단계 절차(사전검정 뒤에 방법을 고르는 절차)의 문제가 생긴다.
연습문제 11. 환자 10명의 혈압을 새 약 투여 전후로 측정했다. 차이(투여 후 \(-\) 투여 전)는 \(-7, -8, -8, -7, -7, -8, -4, -7, -6, -7\)이다. \(\alpha = 0.05\)에서 이 약이 혈압을 유의하게 낮추는지 검정하라.
풀이
계산하면 \(\bar{D} = -6.9\), \(S_D \approx 1.197\), \(n = 10\)이다.
\(H_0\colon \mu_D = 0\) 대 \(H_a\colon \mu_D < 0\)을 검정한다.
\(\text{df} = 9\)에서 \(P(T_9 \leq -18.23) \approx 0\)이다. \(H_0\)을 강하게 기각한다. 이 약이 혈압을 유의하게 낮춘다. \(\square\)
연습문제 12. 어떤 연구가 피험자 8명의 반응시간(ms)을 카페인 조건과 위약 조건에서 측정했다. 대응 차이(카페인 \(-\) 위약)는 \(-15, -22, -8, -30, -12, -18, -25, -10\)이다. 평균 차이의 99% 신뢰구간을 계산하라.
풀이
계산하면 \(\bar{D} = (-15-22-8-30-12-18-25-10)/8 = -140/8 = -17.5\)이다.
99% 신뢰구간은 \(\bar{D} \pm t_{0.995,7} \cdot S_D/\sqrt{8}\)이다. \(t_{0.995,7} = 3.499\)이므로 이렇게 된다.
99% 신뢰구간은 \((-27.04, -7.96)\)이다. 0이 이 구간에 없으므로 \(\alpha = 0.01\)에서 \(H_0\colon \mu_D = 0\)을 기각한다. \(\square\)
연습문제 13.
test_paired_mean으로 연습문제 11의 자료를 세 가지 대립가설로 모두 검정하고, 차이의 부호를 반대로 잡았을 때 어떤 일이 벌어지는지 확인하라.
풀이
import math
import numpy as np
from scipy.stats import t as tdist

def test_paired_mean(n, dbar, sd_d, mu_d0=0.0,
                     alt="two-sided", alpha=0.05):
    df = n - 1
    se = sd_d / math.sqrt(n)
    t = (dbar - mu_d0) / se
    if alt == "two-sided":
        p = 2 * min(tdist.cdf(t, df), 1 - tdist.cdf(t, df))
    elif alt == "less":
        p = tdist.cdf(t, df)
    else:
        p = 1 - tdist.cdf(t, df)
    return t, p, bool(p < alpha)

d = np.array([-7, -8, -8, -7, -7, -8, -4, -7, -6, -7], float)
m, s = d.mean(), d.std(ddof=1)
print(f"차이(투여 후 - 투여 전)  평균 {m:.4f}  표준편차 {s:.4f}\n")

for alt in ["two-sided", "less", "greater"]:
    t, p, rej = test_paired_mean(10, m, s, 0, alt)
    print(f"{alt:10s} t={t:8.4f}  p={p:12.6g}  기각={rej}")

print("\n부호를 반대로 (투여 전 - 투여 후) 잡으면:")
for alt in ["less", "greater"]:
    t, p, rej = test_paired_mean(10, -m, s, 0, alt)
    print(f"{alt:10s} t={t:8.4f}  p={p:12.6g}  기각={rej}")
차이(투여 후 - 투여 전)  평균 -6.9000  표준편차 1.1972

two-sided  t=-18.2253  p= 2.05724e-08  기각=True
less       t=-18.2253  p= 1.02862e-08  기각=True
greater    t=-18.2253  p=           1  기각=False

부호를 반대로 (투여 전 - 투여 후) 잡으면:
less       t= 18.2253  p=           1  기각=False
greater    t= 18.2253  p= 1.02862e-08  기각=True
세 가지 관찰.
1 — \(t\) 값은 하나뿐이다. \(-18.2253\). 대립가설은 이 값을 어떻게 읽을지만 정한다.
2 — 단측 \(p\)는 양측의 정확히 절반이다(\(1.029\times10^{-8}\) 대 \(2.057\times10^{-8}\)). \(t\) 분포가 대칭이기 때문이다.
3 — 방향이 틀리면 \(p=1\)이다. "혈압이 올라갔는가"(\(\text{greater}\))를 물으면, 자료가 정반대 방향이므로 \(p\)가 1에 붙는다. \(p=1\)은 "증거 없음"이 아니라 "반대 방향의 압도적 증거"를 뜻한다.
부호 규약이 결정적이다. \(D=\text{투여 전}-\text{투여 후}\)로 잡으면 같은 자료로 \(\text{less}\)가 아니라 \(\text{greater}\)를 써야 한다. 부호와 대립가설의 방향이 짝을 이뤄 바뀐다.
실무 규칙 셋.
- 차이의 정의를 코드 주석과 보고문에 명시한다. "\(D=\) 투여 후 \(-\) 투여 전"처럼.
- 단측 검정의 방향은 자료를 보기 전에 정한다. 자료를 보고 \(p\)가 작아지는 쪽을 고르면 실제 수준이 0.05가 아니라 0.10이 된다.
- \(p\)가 1에 가까우면 부호를 의심한다. 대개 방향을 반대로 잡은 실수다.
연습문제 14. 대응 \(t\) 검정 결과의 보고 양식을 정리하고, 자주 빠지는 항목을 지적하라.
풀이
보고해야 할 것.
| 항목 | 예시 | 왜 필요한가 |
|---|---|---|
| 차이의 정의 | \(D=\) 투여 후 \(-\) 투여 전 | 부호 해석의 전제 |
| 쌍의 개수 | \(n=10\)쌍 | 자유도의 근거 |
| 평균 차이 | \(-6.90\) mmHg | 주된 결과 |
| 신뢰구간 | 95% CI \((-7.76,\ -6.04)\) | 불확실성의 크기 |
| 표준편차 또는 SE | \(S_D=1.20\), SE \(=0.379\) | 재분석·메타분석의 재료 |
| 검정통계량과 자유도 | \(t(9)=-18.23\) | 검증 가능성 |
| \(p\) 값 | \(p<0.001\) | 관행 |
| 효과크기 | \(d_z=-5.76\) | 척도 무관 비교 |
| 정규성 점검 | 차이의 그림 확인 | 가정의 타당성 |
문장 예시.
새 약 투여 전후 수축기 혈압을 10명에게서 측정했다. 차이(\(D=\) 투여 후 \(-\) 투여 전)의 평균은 \(-6.90\) mmHg(\(S_D=1.20\)), 95% 신뢰구간은 \((-7.76,\ -6.04)\)였다. 대응 \(t\) 검정 결과 \(t(9)=-18.23\), \(p<0.001\)로 통계적으로 유의했다(\(d_z=-5.76\)). 차이의 정규분위수그림에서 뚜렷한 이탈은 없었다.
import numpy as np
from scipy import stats

d = np.array([-7, -8, -8, -7, -7, -8, -4, -7, -6, -7], float)
n = len(d)
m, s = d.mean(), d.std(ddof=1)
se = s / np.sqrt(n)
t, p = stats.ttest_1samp(d, 0)
tc = stats.t.ppf(0.975, n - 1)
print(f"n={n}  평균 차이 {m:.2f}  SD {s:.2f}  SE {se:.3f}")
print(f"95% CI ({m - tc * se:.2f}, {m + tc * se:.2f})")
print(f"t({n - 1}) = {t:.2f},  p = {p:.3g}")
print(f"d_z = {m / s:.2f}")
n=10  평균 차이 -6.90  SD 1.20  SE 0.379
95% CI (-7.76, -6.04)
t(9) = -18.23,  p = 2.06e-08
d_z = -5.76
자주 빠지는 항목 여섯.
- 차이의 방향. "유의하게 감소"만 쓰고 \(D\)의 정의를 안 밝힌다. 독자가 부호를 뒤집어 읽을 수 있다.
- 신뢰구간. \(p\) 값만 쓴다. \(p\)는 "0인가"만 답하고, 구간은 "얼마나 큰가"를 답한다. 후자가 대개 더 중요하다.
- \(S_D\). 메타분석에 쓰려면 반드시 필요한데 자주 빠진다. \(S_D\)가 없으면 \(\rho\)를 역산할 수도 없다.
- 탈락과 결측. "10명"이 모집한 수인지 분석에 쓴 수인지 밝힌다.
- 정규성 점검. 했는지 여부만이라도 쓴다. \(n\)이 작을수록 중요하다.
- 단측인지 양측인지, 그리고 사전에 정했는지.
주의 — 이 예시의 \(d_z=-5.76\)은 비현실적으로 크다. 실제 혈압 자료에서 개인차가 이렇게 작을 리 없다. 연습문제용으로 만든 숫자이므로, 효과크기가 상식을 벗어나면 자료 생성 과정을 의심하는 습관을 들이자.
마지막으로 — 대조군이 없다. 이 설계는 "투여 전후"만 비교하므로, 관측된 감소가 약 때문인지 평균으로의 회귀·자연 경과·측정 반복 효과 때문인지 구분할 수 없다. 통계적 유의성은 인과를 만들어 주지 않는다. 인과를 말하려면 무작위 대조군이 필요하다.
연습문제 15. 짝짓기가 적절할 때 대응 t-검정이 독립 이표본 t-검정보다 강력한 이유를 설명하라.
풀이
독립 이표본 t-검정에서 평균 차이의 분산은
대응 검정에서 \(\bar{D}\)의 분산은
여기서 \(\rho = \text{Corr}(X_i, Y_i)\)이다. 짝짓기가 양의 상관을 만들면(\(\rho > 0\)) \(\bar{D}\)의 분산이 작아져 검정통계량이 커지고 검정력이 높아진다. 감소량은 \(2\rho\sigma_X\sigma_Y/n\)에 비례한다. \(\square\)
연습문제 16. 대응 t-검정이 차이에 대한 일표본 t-검정과 대수적으로 동등함을 보여라.
풀이
\(i = 1, \dots, n\)에 대해 \(D_i = X_i - Y_i\)로 정의한다. 그러면 \(\bar{D} = \bar{X} - \bar{Y}\)이고
대응 t-통계량은
표본 \(D_1, \dots, D_n\)에 귀무값 \(\mu_0 = 0\)으로 일표본 t-검정을 적용하면
검정통계량과 자유도(\(n-1\))가 모두 같으므로 두 검정은 동일하다. \(\square\)
연습문제 17. 대응 t-검정이 부적절한 조건은 무엇인가? 차이가 정규가 아닐 때의 대안을 제안하라.
풀이
대응 t-검정의 가정은 이렇다.
- 차이 \(D_i\)가 독립이다(서로 다른 피험자).
- 차이가 근사적으로 정규분포를 따른다(또는 \(n\)이 중심극한정리(central limit theorem)를 쓸 만큼 크다).
다음의 경우 부적절하다.
- 표본이 아주 작고 차이가 분명히 정규가 아닐 때(두꺼운 꼬리, 강한 왜도).
- 쌍이 자연스럽게 짝지어져 있지 않아 상관 구조가 무의미할 때.
비모수적 대안은 차이의 중앙값이 0인지 검정하는 윌콕슨 부호순위 검정이다. 절대차이의 순위를 매기고 부호를 부여한 뒤 부호 있는 순위의 합을 검정통계량으로 쓴다. 차이의 분포가 중앙값을 중심으로 대칭이라는 더 약한 가정 아래에서 타당하다. \(\square\)
연습문제 18. 대응 \(t\) 검정의 표본크기 설계를 다루자. 측정값 하나의 표준편차가 \(\sigma=10\)이고 찾고 싶은 평균 차이가 \(\delta=3\)일 때, 짝 내 상관 \(\rho\)에 따라 필요한 쌍의 개수를 구하라. 독립 이표본 설계와도 비교하라.
풀이
핵심은 \(\sigma_D\)의 환산이다. 두 측정값의 표준편차가 각각 \(\sigma\)이고 상관이 \(\rho\)이면
설계 단계에서 알아야 하는 것은 \(\sigma\)와 \(\rho\)이지 \(\sigma_D\)가 아니다. 문헌에서 얻기 쉬운 쪽도 이 둘이다.
import numpy as np
from scipy import stats

def power_paired(n, delta, sd_d, alpha=0.05):
    """쌍 n개, 참 평균 차이 delta 일 때 양측 대응 t 검정의 검정력."""
    nc = delta / (sd_d / np.sqrt(n))     # 비중심 모수
    df = n - 1
    crit = stats.t.ppf(1 - alpha / 2, df)
    return stats.nct.sf(crit, df, nc) + stats.nct.cdf(-crit, df, nc)

def n_paired(delta, sigma, rho, power=0.80, alpha=0.05):
    sd_d = sigma * np.sqrt(2 * (1 - rho))
    for n in range(5, 100_000):          # n=5 부터: 극소표본은 수치가 불안정
        if power_paired(n, delta, sd_d, alpha) >= power:
            return n, sd_d, power_paired(n, delta, sd_d, alpha)

print(f"{'ρ':>5s} {'SD_D':>8s} {'필요 쌍':>8s} {'측정 횟수':>10s} {'검정력':>8s}")
for rho in [0.0, 0.3, 0.5, 0.7, 0.9]:
    n, sd, pw = n_paired(3.0, 10.0, rho)
    print(f"{rho:5.1f} {sd:8.3f} {n:8d} {2 * n:10d} {pw:8.4f}")

def n_independent(delta, sigma, power=0.80, alpha=0.05):
    """군당 표본크기."""
    for n in range(5, 100_000):
        nc = delta / (sigma * np.sqrt(2 / n))
        df = 2 * n - 2
        crit = stats.t.ppf(1 - alpha / 2, df)
        if stats.nct.sf(crit, df, nc) + stats.nct.cdf(-crit, df, nc) >= power:
            return n

n_ind = n_independent(3.0, 10.0)
print(f"\n독립 이표본: 군당 {n_ind}명, 총 {2 * n_ind}명 (측정 {2 * n_ind}회)")
    ρ     SD_D     필요 쌍      측정 횟수      검정력
  0.0   14.142      177        354   0.8015
  0.3   11.832      125        250   0.8031
  0.5   10.000       90        180   0.8038
  0.7    7.746       55        110   0.8054
  0.9    4.472       20         40   0.8121

독립 이표본: 군당 176명, 총 352명 (측정 352회)
읽는 법 — 무엇을 세는가에 따라 결론이 달라진다.
| 기준 | \(\rho=0\) | \(\rho=0.9\) |
|---|---|---|
| 모집할 사람 수 | 177 대 352 → 대응이 절반 | 20 대 352 → 대응이 1/18 |
| 측정 횟수 | 354 대 352 → 거의 같음 | 40 대 352 → 대응이 1/9 |
\(\rho=0\)이어도 사람은 절반만 모집하면 된다. 다만 한 사람이 두 번 측정되므로 총 측정 횟수는 같다. 상관이 없으면 "측정당 정보"의 이득은 없고 "사람당 정보"의 이득만 있다.
\(\rho\)가 커질수록 두 기준 모두에서 대응이 압도적이다. \(\rho=0.9\)면 20쌍으로 끝난다.
어느 비용이 지배하는가.
- 모집이 비싸고 측정이 싸다(희귀질환, 침습적 등록 절차): 대응이 압도적으로 유리하다.
- 모집이 싸고 측정이 비싸다(대규모 코호트의 고가 영상검사): \(\rho\)가 충분히 커야 이득이 있다.
주의 — \(\rho\)를 낙관하지 말 것. \(\rho=0.7\)을 가정해 55쌍을 모았는데 실제가 0.5면 필요한 수가 90쌍이고, 검정력이 0.80이 아니라 0.59로 떨어진다.
n, _, _ = n_paired(3.0, 10.0, 0.7)
sd_actual = 10.0 * np.sqrt(2 * (1 - 0.5))
print(f"ρ=0.7 가정으로 {n}쌍 모집 → 실제 ρ=0.5 였다면 "
      f"검정력 {power_paired(n, 3.0, sd_actual):.4f}")
ρ=0.7 가정으로 55쌍 모집 → 실제 ρ=0.5 였다면 검정력 0.5891
\(\rho\)를 보수적으로 잡는 것이 안전하다.
연습문제 19. 대응 자료로 동등성을 주장하려면 어떻게 하는가? \(\mu_{D_0}\neq0\)인 검정을 두 번 쓰는 TOST 절차를 20쌍 자료에 적용하라.
풀이
문제의 출발점. "차이가 없다"를 보이고 싶은데, \(p>0.05\)는 차이가 없다는 증거가 아니다. 검정력이 낮아서일 수도 있다.
TOST(two one-sided tests, 두 단측검정). 먼저 동등성 한계 \(\Delta\)를 정한다. "\(|\mu_D|<\Delta\)면 실질적으로 같다"는 임상적·실무적 판단이다. 그리고 두 단측검정을
로 세우고 둘 다 기각되면 동등성을 인정한다. TOST의 \(p\) 값은 두 \(p\)의 최댓값이다.
import numpy as np
from scipy import stats

d = np.array([-1.2, 0.8, -0.3, 1.5, 0.2, -0.9, 0.6, 1.1, -0.5, 0.4,
              0.9, -0.2, 1.3, 0.1, -0.7, 0.5, 0.3, -1.0, 0.7, 0.0])
n, delta_eq = len(d), 1.0          # 동등성 한계 ±1.0
m, s = d.mean(), d.std(ddof=1)
se, df = s / np.sqrt(n), n - 1

t_lo = (m - (-delta_eq)) / se      # H01: μ ≤ -Δ 에 대한 단측
p_lo = stats.t.sf(t_lo, df)
t_hi = (m - delta_eq) / se         # H02: μ ≥ +Δ 에 대한 단측
p_hi = stats.t.cdf(t_hi, df)

print(f"n={n}  평균 차이 {m:.4f}  SD {s:.4f}  SE {se:.4f}\n")
print(f"하한 검정  t={t_lo:7.4f}  p={p_lo:.6f}")
print(f"상한 검정  t={t_hi:7.4f}  p={p_hi:.6f}")
print(f"TOST p = max = {max(p_lo, p_hi):.6f}  → "
      f"동등성 {'인정' if max(p_lo, p_hi) < 0.05 else '미인정'}\n")

tc90 = stats.t.ppf(0.95, df)       # TOST 는 90% 구간과 짝을 이룬다
tc95 = stats.t.ppf(0.975, df)
print(f"90% CI ({m - tc90 * se:7.4f}, {m + tc90 * se:7.4f})  ← ±1.0 안에 들어감")
print(f"95% CI ({m - tc95 * se:7.4f}, {m + tc95 * se:7.4f})")
print(f"보통의 대응 t 검정 p = {stats.ttest_1samp(d, 0).pvalue:.6f}")
n=20  평균 차이 0.1800  SD 0.7770  SE 0.1738

하한 검정  t= 6.7913  p=0.000001
상한 검정  t=-4.7194  p=0.000075
TOST p = max = 0.000075  → 동등성 인정

90% CI (-0.1204,  0.4804)  ← ±1.0 안에 들어감
95% CI (-0.1837,  0.5437)
보통의 대응 t 검정 p = 0.313225
두 결론이 함께 성립한다.
- 보통의 검정: \(p=0.313\) → "차이가 있다고 할 수 없다."
- TOST: \(p=0.000075\) → "차이가 \(\pm1.0\)보다 작다고 단언할 수 있다."
앞의 것은 소극적 진술이고, 뒤의 것이 적극적 주장이다. 동등성을 말하려면 TOST가 필요하다.
90% 구간과의 대응. \(\alpha=0.05\)의 TOST는 \(100(1-2\alpha)\%=90\%\) 신뢰구간이 \((-\Delta,\Delta)\) 안에 완전히 들어가는 것과 동치다. 여기서 \((-0.120,\ 0.480)\subset(-1,1)\)이므로 동등하다. 95%가 아니라 90%라는 점이 자주 틀리는 대목이다.
\(\Delta\)가 전부다. \(\Delta\)를 크게 잡으면 동등성을 쉽게 인정한다. 따라서
- 자료를 보기 전에 정하고 사전등록한다.
- 임상적·실무적 근거를 댄다(최소 임상적 중요 차이 등). 통계로 정하는 값이 아니다.
- 보고할 때 \(\Delta\)와 그 근거를 함께 쓴다.
비열등성은 한쪽만 쓴다. "새 치료가 기존보다 \(\Delta\) 이상 나쁘지는 않다"를 주장하려면 위의 하한 검정 하나만 하면 된다.
연습문제 20. 예비연구에서 추정한 \(S_D\)로 본연구의 표본크기를 정하면, 실제로 얻는 검정력이 목표에 못 미치는 일이 잦다. 그 정도를 모의실험으로 재고 대책을 제시하라.
풀이
문제의 구조. 표본크기 공식은 \(\sigma_D\)를 알려진 값으로 취급한다. 실제로는 예비연구의 \(S_D\)를 꽂아 넣는데, 이 값 자체가 확률변수다.
예비 표본 \(m\)이 작으면 \(S_D\)가 크게 흔들린다. \(S_D\)가 우연히 작게 나오면 \(n\)을 적게 잡고, 그 결과 실제 검정력이 목표에 못 미친다.
import numpy as np
from scipy import stats

def power_paired(n, delta, sd_d, alpha=0.05):
    nc = delta / (sd_d / np.sqrt(n))
    df = n - 1
    crit = stats.t.ppf(1 - alpha / 2, df)
    return stats.nct.sf(crit, df, nc) + stats.nct.cdf(-crit, df, nc)

def n_for(delta, sd_d, power=0.80, alpha=0.05):
    for n in range(5, 100_000):
        if power_paired(n, delta, sd_d, alpha) >= power:
            return n
    return 100_000

delta, sd_true = 3.0, 8.0
print(f"참 SD_D={sd_true} 를 안다면 필요한 쌍 = {n_for(delta, sd_true)}\n")

rng = np.random.default_rng(7)
print(f"{'예비 m':>7s} {'계획 n 중앙값':>13s} {'5~95%':>12s} "
      f"{'실제 검정력':>12s} {'0.8 미달':>9s}")
for m in [10, 20, 40]:
    ns, pws = [], []
    for _ in range(2_000):
        # 예비연구의 S_D 를 카이제곱분포에서 생성
        s = sd_true * np.sqrt(stats.chi2.rvs(m - 1, random_state=rng) / (m - 1))
        n = n_for(delta, s)
        ns.append(n)
        pws.append(power_paired(n, delta, sd_true))   # 실제 SD 로 평가
    ns, pws = np.array(ns), np.array(pws)
    print(f"{m:7d} {np.median(ns):13.0f} "
          f"{np.percentile(ns, 5):5.0f}~{np.percentile(ns, 95):<6.0f} "
          f"{pws.mean():12.3f} {np.mean(pws < 0.8):9.3f}")
참 SD_D=8.0 를 안다면 필요한 쌍 = 58

   예비 m      계획 n 중앙값        5~95%       실제 검정력    0.8 미달
     10            52    22~107           0.731     0.590
     20            57    32~91            0.770     0.522
     40            58    39~81            0.790     0.497
세 가지 사실.
1 — 계획한 \(n\)이 엄청나게 흔들린다. 예비 10쌍이면 90% 범위가 22~107쌍이다. 참값 58쌍의 0.4배에서 1.8배까지.
2 — 평균 검정력이 목표에 못 미친다. 0.80을 목표했는데 예비 10쌍이면 평균 0.731이다.
3 — 절반 안팎이 0.80에 못 미친다. 미달 비율이 예비 10쌍에서 \(0.590\), 20쌍에서 \(0.522\) 다. 예비 40쌍으로 늘려도 미달 비율이 0.497이다. 이것은 없앨 수 없다. \(n\)이 \(\sigma_D\)의 증가함수라서, \(S_D\)가 참값보다 작을 확률(약 절반)만큼 미달이 생긴다.
왜 \(m\)을 키워도 미달 비율이 0.5 근처인가. 큰 \(m\)은 편차의 크기를 줄일 뿐 방향의 확률을 바꾸지 않는다. \(m=40\)의 미달은 대개 0.79 같은 미세한 미달이고, \(m=10\)의 미달은 0.5까지 떨어질 수 있다. 평균 검정력이 0.731에서 0.790으로 개선된 것이 진짜 이득이다.
대책 넷.
-
\(S_D\)의 상한신뢰한계를 쓴다. \(S_D\) 대신 \(S_D\sqrt{(m-1)/\chi^2_{1-\gamma,\,m-1}}\)을 꽂으면 보수적이다.
m, s_obs = 10, 8.0
s_upper = s_obs * np.sqrt((m - 1) / stats.chi2.ppf(0.20, m - 1))
print(f"S_D={s_obs} 의 80% 상한 = {s_upper:.3f} → "
      f"필요한 쌍 {n_for(3.0, s_upper)} (점추정으로는 {n_for(3.0, s_obs)})")
S_D=8.0 의 80% 상한 = 10.347 → 필요한 쌍 96 (점추정으로는 58)66% 더 모집하는 대신 검정력 미달 위험을 크게 줄인다. 비용이 만만치 않으므로 상한의 신뢰수준(confidence level, \(\gamma\))을 얼마로 할지는 예산과의 타협이다.
-
보증(assurance)을 쓴다. \(S_D\)의 사후분포(posterior distribution)에 대해 검정력을 평균한 값을 목표로 삼는다.
- 내부 예비연구를 한다. 본연구 도중 눈가림 상태로 \(S_D\)를 다시 추정해 \(n\)을 조정한다. 처리군 정보를 보지 않으므로 제1종 오류(type I error)가 거의 부풀지 않는다.
- 군순차 설계를 쓴다. 중간분석으로 조기 종료·표본 재계산을 하되, 경계는 사전에 정한다.
가장 중요한 것. 예비연구의 \(S_D\) 하나를 믿고 계산한 \(n\)은 점추정일 뿐이다. 표본크기 계산 결과는 항상 범위로 제시하고, 민감도 분석을 함께 보고한다.
정리하며
대응 \(t\) 검정은 차이를 만들어 일표본 문제로 바꾼다.
- 가설이 개별 값이 아니라 차이에 대한 것이다. 두 측정의 평균을 각각 다루지 않고 짝별 차이 하나만 본다.
- 자유도는 쌍의 개수에서 하나를 뺀 \(n-1\) 이다. 관측 총수 \(2n\) 이 아니다.
- 피험자 간 변동이 뺄셈으로 사라진다. 개인차가 클수록 이득이 크며, 그것이 이 설계를 쓰는 이유다.
- 차이의 정규성만 가정한다. 원래 두 측정이 각각 정규일 필요는 없다.
- 짝을 깨뜨리면 안 된다. 자료를 섞어 독립 이표본으로 다루는 순간 짝짓기의 정보가 통째로 버려진다.
다음 절 대응표본과 이표본, 언제 무엇을 쓰는가에서 그 선택의 기준을 정리한다.