해석과 흔한 오해
1. 반복표본추출 해석
들어가는 이야기 — 덮어 놓은 동전
보고서에 「\(95\%\) 신뢰구간 \((2.1,\ 7.9)\)」라고 적혀 있다. 거의 모든 사람이 이것을 「참값이 \(2.1\) 과 \(7.9\) 사이에 있을 확률이 \(95\%\)」로 읽는다. 자연스러운 읽기지만, 틀린 읽기다.
왜 틀렸는지는 동전으로 보면 빠르다. 동전을 던져 손바닥으로 덮었다. 지금 그것이 앞면일 확률은 얼마인가. 이미 앞면이거나 뒷면이다. 확률은 던지기 전에 있던 것이고, 덮고 난 뒤에 남은 것은 확률이 아니라 「모른다」는 사실뿐이다. 구간도 똑같다. 자료를 받아 구간을 만든 순간 그 구간은 참값을 담았거나 못 담았다. 우리가 모를 뿐이다.
그 사정은 참값을 아는 자리에서 보면 분명해진다. \(\mu = 100\), \(\sigma = 15\) 인 모집단에서 \(n = 25\) 를 뽑아 \(95\%\) 구간을 만드는 일을 \(200{,}000\) 번 반복해 보았다. 참값을 아는 우리는 그 구간들을 하나하나 확률 없이 채점할 수 있다 — 담았으면 \(1\), 못 담았으면 \(0\) 이다. \(190{,}067\) 개가 담고 \(9{,}933\) 개가 못 담아 비율이 \(0.9503\) 으로 약속대로 나왔다(이론값 \(0.95\), 반복이 남긴 변동이 \(0.0005\)).
그런데 채점표에 적힌 수는 \(0\) 과 \(1\) 뿐이다. \(0.95\) 가 적힌 줄은 \(200{,}000\) 개 가운데 하나도 없다. \(0.95\) 는 그 채점표의 평균이지 어느 한 줄의 값이 아니다. 그러니 못 담은 \(9{,}933\) 개에게 「\(95\%\) 의 확률로 담았다」고 말할 자리가 없다 — 그것들은 빗나간 채 그냥 빗나간 것이다.
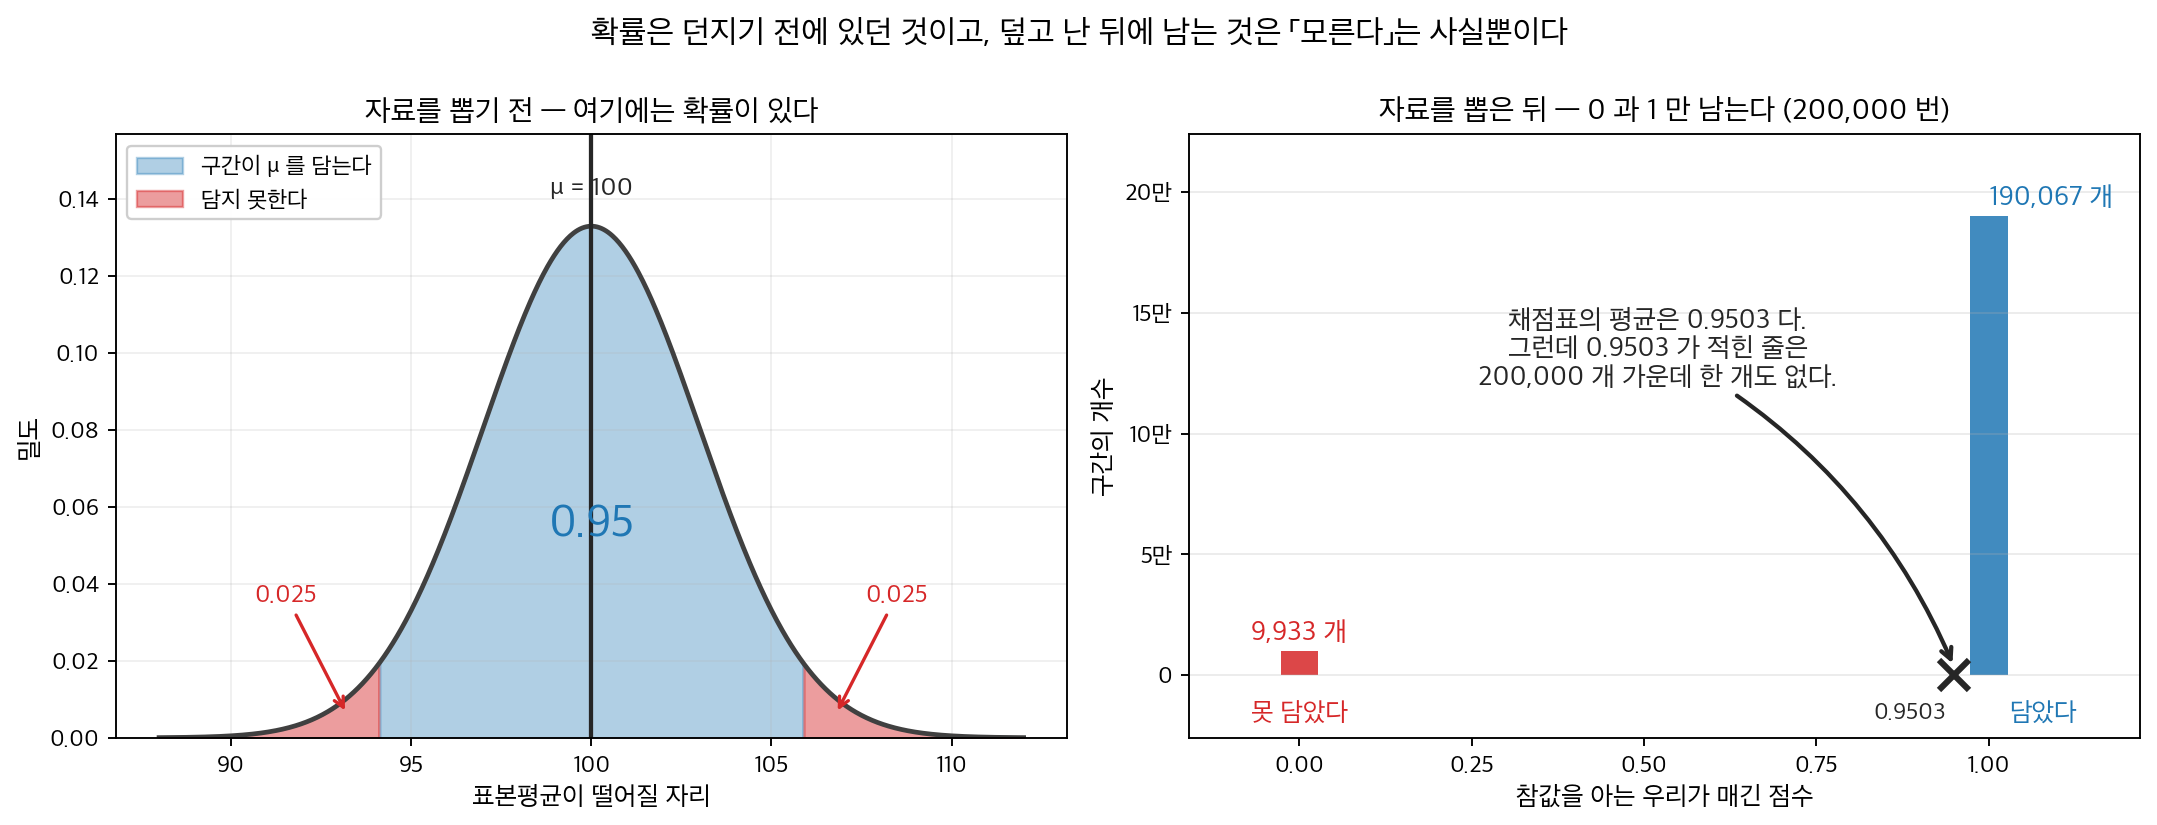
왼쪽은 자료를 뽑기 전이다. 구간의 끝점이 아직 확률변수이므로 「구간이 \(\mu\) 를 담는다」가 사건이고 거기에 확률 \(0.95\) 가 붙는다. 오른쪽은 뽑은 뒤다. 참값을 아는 우리가 매긴 점수는 \(0\) 아니면 \(1\) 이고, 그 둘 말고는 아무것도 없다. \(\times\) 로 찍은 \(0.9503\) 은 채점표의 평균이 서는 자리인데 거기 선 구간은 한 개도 없다. 덮어 놓은 동전과 같다 — 확률은 던지기 전에 있었고, 덮은 뒤에 남은 것은 앞면 아니면 뒷면이다.
더 사나운 것은 빗나간 구간에 아무 표시가 없다는 점이다. 여기는 \(\sigma\) 를 아는 자리라 구간의 폭이 \(200{,}000\) 개 모두 \(11.7598\) 로 똑같다. 담은 것과 못 담은 것이 길이도 생김새도 구별되지 않고, 다른 것은 어디에 놓였는가 하나뿐인데 그것은 \(\mu\) 를 알아야 보인다. 실무에서 모르는 것이 바로 그 \(\mu\) 다.
그 이름이 자료를 담는다는 뜻도 아니다. 폭 \(11.7598\) 짜리 창을 모집단 한가운데 놓아도 관측값은 \(0.3049\) 만 들어온다 — 「\(95\%\) 구간」이 자료의 \(30\%\) 밖에 담지 못한다. 겨냥한 것이 애초에 관측값이 아니었기 때문이다. \(2\) 절의 「오해 \(2\)」가 그 셈을 따로 따진다.
그러면 그 \(95\%\) 라는 수는 무엇에 붙어 있는가. 이 쪽은 그 답을 세우고, 거기서 갈라져 나오는 흔한 오해 셋을 하나씩 깬다.
95% 신뢰구간은 "\(\mu\)가 이 구간 안에 있을 확률이 95%이다"라는 뜻이 아니다. 모수 \(\mu\)는 고정된 (그러나 미지의) 수이며, 구간 안에 있거나 없거나 둘 중 하나이다.
올바른 해석은 구간 하나가 아니라 절차를 두고 하는 말이다. 같은 조건에서 표본추출을 여러 번 반복해 매번 \(95\%\) 신뢰구간을 만들면 그 구간들 가운데 약 \(95\%\) 가 참 모수를 담는다. 손에 쥔 구간 하나가 어느 쪽인지는 이 문장이 말해 주지 않는다.
형식적 진술
\(\sigma\)를 아는 \(X_1, \ldots, X_n \overset{\text{iid}}{\sim} N(\mu, \sigma^2)\)을 생각하자. 구간
은 모든 \(\mu\) 와 \(\sigma\) 에서 다음 등식을 만족한다.
이 확률 진술은 \(\mu\)에 대한 것이 아니라 확률적인 끝점 \(\bar{X} \pm z_{1-\alpha/2}\sigma/\sqrt{n}\)에 대한 것이다.
모의실험을 통한 확인
보기 1. 신뢰수준(confidence level)의 뜻을 모의실험으로 확인하기. \(\mu = 50\), \(\sigma = 10\) 인 정규모집단에서 크기 \(n = 30\) 인 표본을 뽑아 \(z\)-구간을 만든다. \(\sigma\) 를 안다고 둔다. 반복은 \(1000\)회다.
(1) 구간의 폭은 얼마인가. 표본마다 달라지는가. 포함률의 참값은 얼마인가.
(2) 모의실험으로 (1)을 확인하시오.
(3) 다음 네 진술을 수로 가르시오.
- (가) "계산을 마치고 손에 든 구간이 \(\mu\) 를 담을 확률이 \(0.95\) 다."
- (나) "자료의 \(95\%\) 가 이 구간 안에 들어간다."
- (다) "\(n\) 을 네 배로 하면 포함률이 올라간다."
- (라) "두 집단의 \(95\%\) 구간이 겹치면 차이가 유의하지 않다."
풀이
(1) 폭이 상수다. \(\sigma\) 를 알고 있으므로 오차한계가
로 자료에 전혀 의존하지 않는다. 폭은 \(2E = 7.15691\) 이고 모든 표본에서 같다. 표본마다 달라지는 것은 중심 \(\bar X\) 하나뿐이다. (\(t\)-구간이었다면 폭이 \(s\) 에 비례해 흔들렸을 것이다.)
포함률은 정확히 \(0.95\)다. 구간이 \(\mu\) 를 담는 사건은
이고 가운데 양이 정확히 \(N(0,1)\) 이므로 확률은 \(2\Phi(1.96) - 1 = 0.950004\) 다(\(1.96\) 이 \(z_{0.975} = 1.95996\) 의 반올림이라 여섯째 자리에서만 다르다).
확률이 붙는 자리를 보라. 이 식에서 흔들리는 것은 \(\bar X\) 이고 \(\mu\) 는 고정된 수다. 확률은 \(\mu\) 가 아니라 끝점에 붙어 있다.
(2) 모의실험.
import numpy as np
np.random.seed(42)

mu, sigma, n = 50, 10, 30
alpha = 0.05
z = 1.96
n_simulations = 1000

covers = 0
for _ in range(n_simulations):
    sample = np.random.normal(mu, sigma, n)
    xbar = sample.mean()
    # sigma를 알고 있으므로 오차한계는 표본과 무관한 **상수**다.
    # 구간의 너비는 매번 같고 중심 xbar만 움직인다.
    me = z * sigma / np.sqrt(n)
    lower, upper = xbar - me, xbar + me
    # mu는 고정이고 lower/upper가 흔들린다. 확률이 붙는 쪽은 끝점이다.
    if lower <= mu <= upper:
        covers += 1

print(f"Coverage: {covers}/{n_simulations} = {covers/n_simulations:.3f}")

# (1) 오차한계는 상수다.
print(f"오차한계 = {me:.5f},  폭 = {2 * me:.5f}  (모든 표본에서 같다)")

# (다) n 을 네 배로 하면 폭은 절반이 되지만 포함률은 그대로다.
# 0.95 와 0.94 를 가르려면 반복이 1000 회로는 모자라 2만 회로 올린다.
M = 20_000
for nn in (30, 120):
    me_n = z * sigma / np.sqrt(nn)
    xb = np.random.normal(mu, sigma / np.sqrt(nn), M)
    print(f"  n={nn:3d}: 오차한계 {me_n:.5f}  포함률 {np.mean(np.abs(xb - mu) <= me_n):.4f}")

# (나) 이 구간 안에 들어가는 '관측값'의 비율
from scipy.stats import norm
print(f"폭 {2 * me:.3f} 짜리 구간에 드는 관측값의 비율 = {2 * norm.cdf(me / sigma) - 1:.4f}")
print(f"자료의 95% 가 드는 범위의 폭 = {2 * z * sigma:.3f}")

# (라) 두 막대가 겹치지 않을 임계값과 차이가 유의할 임계값
se = sigma / np.sqrt(n)
print(f"SE = {se:.5f}   차이가 유의할 임계값 {z * np.sqrt(2) * se:.5f}"
      f"   막대가 갈라질 임계값 {2 * z * se:.5f}")
출력:
Coverage: 951/1000 = 0.951
오차한계 = 3.57845,  폭 = 7.15691  (모든 표본에서 같다)
  n= 30: 오차한계 3.57845  포함률 0.9494
  n=120: 오차한계 1.78923  포함률 0.9495
폭 7.157 짜리 구간에 드는 관측값의 비율 = 0.2795
자료의 95% 가 드는 범위의 폭 = 39.200
SE = 1.82574   차이가 유의할 임계값 5.06070   막대가 갈라질 임계값 7.15691
(1)이 맞는다. 오차한계 \(3.57845\), 폭 \(7.15691\) 이고, 포함률 \(951/1000 = 0.951\) 이 참값 \(0.950004\) 와 \(0.001\) 차이다. 반복 \(1000\)회의 몬테카를로(Monte Carlo) 표준오차가 \(\sqrt{0.95 \times 0.05/1000} = 0.00689\) 이므로 \(0.15\) 표준오차 안이다.
(3) 네 진술을 차례로 가른다.
(가) 틀렸다. \(0.95\) 는 끝점이 아직 확률변수일 때의 성질이다. 계산을 마치면 끝점이 수가 되고, \(\mu\) 는 애초에 수였다. 남은 확률변수가 없으므로 "담을 확률"은 \(0\) 아니면 \(1\) 이다. 이 모의실험이 그것을 그대로 보여 준다. 우리는 \(\mu = 50\) 을 알고 있으므로 \(1000\)개 구간을 하나하나 확률 없이 채점할 수 있었고, \(951\)개가 담고 \(49\)개가 못 담았다. 실무에서 달라지는 것은 \(\mu\) 를 모른다는 사실뿐인데, 모른다고 해서 \(0\) 또는 \(1\) 이던 값이 \(0.95\) 가 되지는 않는다. \(0.95\) 는 구간이 아니라 구간을 만드는 절차의 성적표다.
(나) 틀렸다. \(95\%\) 가 아니라 \(28\%\)다. 구간의 폭은 \(7.157\) 인데, 이 폭의 창을 모집단 한가운데 놓으면 관측값이 들어갈 확률은
다. 자료의 \(95\%\) 가 드는 범위는 \(\mu \pm 1.96\sigma = (30.4,\ 69.6)\) 으로 폭이 \(39.2\), 신뢰구간의 \(5.5\)배다. 둘을 가르는 것은 \(\sqrt n\) 하나다. 신뢰구간은 \(\sigma/\sqrt n\) 를 쓰고 자료의 범위는 \(\sigma\) 를 쓴다. 그래서 \(n\) 을 키우면 신뢰구간만 좁아지고 자료의 범위는 꿈쩍도 하지 않는다.
(다) 틀렸다. 포함률은 \(n\) 과 무관하다. \(n\) 을 \(30\) 에서 \(120\) 으로 네 배 하면 오차한계가 \(3.57845\) 에서 \(1.78923\) 로 정확히 절반이 되지만, 반복 \(2\)만 회의 포함률은 \(0.9494\) 와 \(0.9495\) 로 똑같다. 까닭은 (1)의 유도에 \(n\) 이 남아 있지 않다는 것이다. \(n\) 은 \(\bar X\) 와 오차한계에 같은 비율로 들어가 약분된다.
(라) 틀렸다. 겹치는데 유의한 구간이 있다. 두 집단의 표준오차가 같고 \(\text{SE} = 1.82574\) 라 하자. 차이의 표준오차는 합이 아니라 제곱합(sum of squares)의 제곱근이다.
그러므로 두 임계값이 다르다.
| 판단 | 조건 | 임계값 |
|---|---|---|
| 차이가 유의하다 | \(\lvert \bar x_1 - \bar x_2 \rvert > 1.96\sqrt2\,\text{SE}\) | \(5.06070\) |
| 두 막대가 갈라진다 | \(\lvert \bar x_1 - \bar x_2 \rvert > 2 \times 1.96\,\text{SE}\) | \(7.15691\) |
두 평균의 차이가 \(5.06\) 과 \(7.16\) 사이면 막대는 겹치는데 차이는 유의하다. 이 폭이 유의 임계값의 \(41\%\) 나 되므로 드문 일이 아니다. 거꾸로 막대가 갈라지면 차이는 반드시 유의하다 — 한쪽 방향만 성립한다.
제대로 하려면 차이 자체의 구간을 계산한다. 집단별 구간을 그려 놓고 눈으로 중첩을 재는 것은 임계값이 \(41\%\) 어긋난 편법이다.
1000번 중 951번이 참값 \(\mu = 50\)을 담았다. 어느 한 구간을 놓고 "\(\mu\)가 여기 있을 확률"을 말한 것이 아니라, 같은 절차를 반복했을 때의 성공 비율을 센 것이다. 이것이 신뢰수준의 뜻이다.
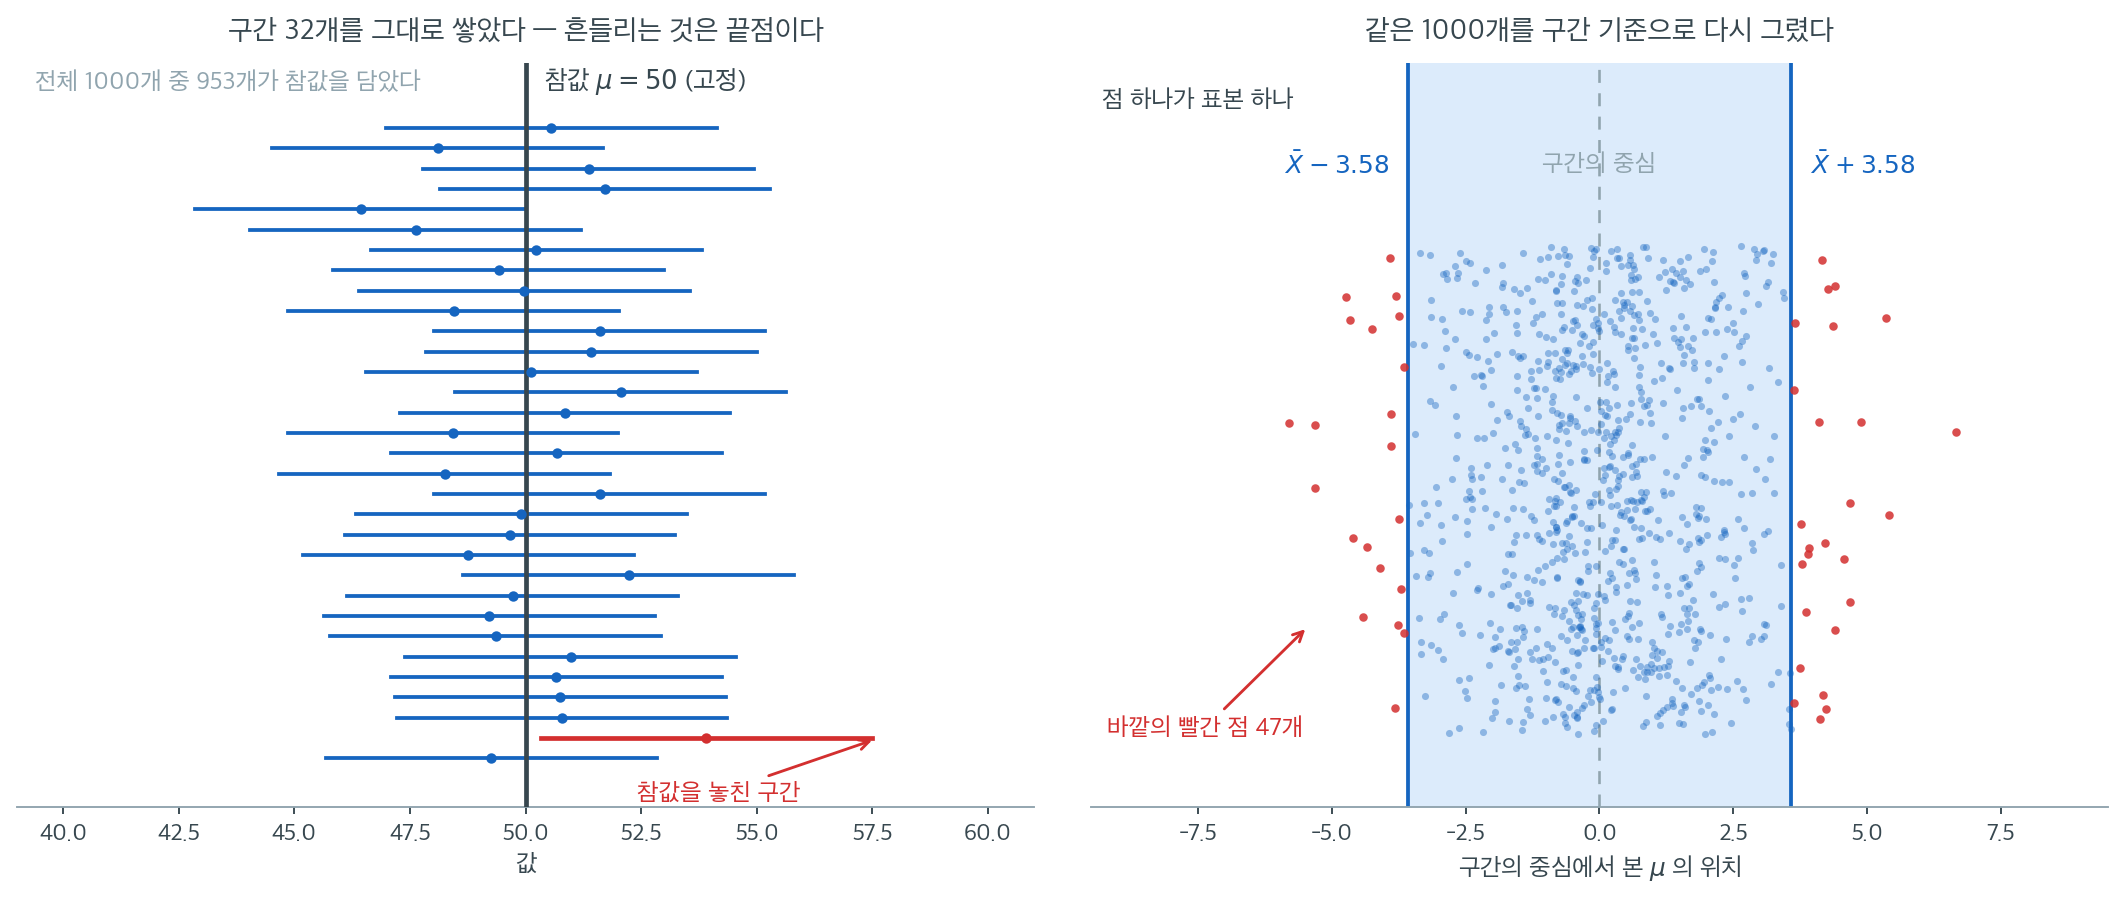
같은 모의실험을 두 가지 방식으로 그린 것이다(\(\mu = 50\), \(\sigma = 10\), \(n = 30\), 1000회). \(\sigma\)를 알고 있으므로 오차한계는 \(1.96 \times 10/\sqrt{30} = 3.58\)로 모든 표본에서 같다. 왼쪽 그림의 가로선들이 길이가 전부 같고 위치만 다른 것은 그 때문이다. 한가운데 굵은 세로선이 \(\mu = 50\)인데, 이 선은 그림 어디서도 움직이지 않는다. 움직이는 것은 \(\bar X \pm 3.58\)이라는 끝점이고, 확률이 붙는 자리도 거기다.
오른쪽 그림은 같은 1000개를 구간의 입장에서 다시 그렸다. 각 표본의 구간을 제자리에 고정해 놓고 "\(\mu\)가 이 구간의 어디쯤에 떨어졌는가"를 점 하나로 찍은 것이다. 점들이 파란 띠 \([\bar X - 3.58,\ \bar X + 3.58]\) 안팎으로 흩어지고, 바깥으로 나간 빨간 점이 47개다. 즉 \(953/1000 = 0.953\)이 담겼다(위 코드와 난수 생성기가 달라 951이 아니라 953이다). 왼쪽과 오른쪽은 완전히 같은 정보이며, 어느 쪽으로 그려도 확률은 \(\mu\)가 아니라 구간의 위치에 붙어 있다.
여기서 흔한 오해가 왜 생기는지도 보인다. 손에 든 구간은 왼쪽 그림의 가로선 하나다. 그 하나만 떼어 놓고 보면 그것이 파란색인지 빨간색인지 알 수 없고, 알 수 없다는 사실이 "확률 95%"처럼 느껴진다. 그러나 색을 칠하려면 세로선의 위치, 곧 \(\mu\)를 알아야 하고, \(\mu\)를 알면 색은 확률이 아니라 사실이다. 실무에서 우리가 아는 것은 색을 칠하는 절차의 성공률뿐이다.
마지막으로 \(n\)의 역할을 확인해 두자. \(n\)을 4배인 120으로 늘리면 오차한계가 \(3.58\)에서 \(1.79\)로 절반이 된다. 왼쪽 그림에서는 가로선이 모두 짧아지고, 오른쪽 그림에서는 파란 띠가 좁아진다. 그런데도 바깥으로 나가는 빨간 점의 비율은 여전히 5% 근처다. 정밀도는 \(n\)이 결정하고, 포함확률은 \(\alpha\)가 결정한다. 둘은 따로 논다.
2. 흔한 오해
오해 1: "μ가 이 구간 안에 있을 확률이 95%이다"
\([48.2, 51.8]\)을 계산한 뒤에 "\(\mu\)가 48.2와 51.8 사이에 있을 확률이 95%이다"라고 말하는 것은 틀렸다. \(\mu\)는 그 구간 안에 있거나 없거나 둘 중 하나이며, 더 이상 확률적인 요소가 남아 있지 않다.
95%는 특정한 구간 하나가 아니라 절차를 가리킨다.
이 구별은 통계에만 있는 것이 아니다. 공장에서 나온 휴대폰의 불량률이 \(5\%\) 라고 하자. 상자를 뜯기 전이라면
라고 말하는 데 아무도 토를 달지 않는다. 그런데 뜯어서 켜 본 뒤에는 같은 물음의 답이
이 된다. \(5\%\) 가 틀린 수가 되는 것이 아니다. 그 수는 애초에 내 휴대폰이 아니라 공장의 성적을 말하고 있었고, 뜯고 나면 내 것에 대해서는 더 물을 것이 남지 않는다.
신뢰구간이 꼭 이것이다. \(0.95\) 는 구간을 만드는 공장의 성적이고, \([48.2,\ 51.8]\) 은 이미 뜯어 본 한 대다. 「\(95\%\) 는 어디로 갔는가」라는 물음이 생기는 까닭은 그 수를 처음부터 내 구간의 성질로 읽었기 때문이다.
그렇다면 그 물음 자체가 틀린 물음인가. 아니다 — 다른 틀에서는 답이 있다. \(\mu\) 를 고정된 수로 두지 않고 거기에 분포를 얹으면, 사후분포(posterior distribution)에서 잘라 낸 구간에 대해 「\(\mu\) 가 이 안에 있을 확률이 \(0.95\) 다」라고 말하는 것이 옳은 문장이 된다. 그것이 6.3절 정규–정규 켤레 모형의 신용구간(credible interval)이다. 값을 치르고 얻는 것이라는 점만 기억하면 된다 — 사전분포(prior distribution)를 골라야 하고, 결론이 그 선택에 얼마나 흔들리는지를 따로 확인해야 한다. 이 쪽이 다루는 신뢰구간은 그 값을 치르지 않는 쪽을 골랐고, 그래서 확률을 구간이 아니라 절차에 붙인다.
그림으로 보는 통계학 1. 「확률」이라 부르지 않으려고
예지 네이만(\(1894\)–\(1981\)). (Wikimedia Commons, 촬영 Konrad Jacobs, 오버볼파흐 수학연구소, CC BY-SA 2.0 DE)
절 \(1\) 의 문장은 유난히 조심스럽다. 「구간들 중 약 \(95\%\) 가 참 모수를 담는다」고는 하면서 「이 구간에 모수가 들어갈 확률이 \(95\%\) 다」라고는 끝내 말하지 않는다. 읽기 거추장스러운 이 조심스러움은 실수가 아니라 설계다.
신뢰구간을 세운 사람은 폴란드 사람 예지 네이만(\(1894\)–\(1981\))이다. \(1934\) 년 왕립통계학회에서 읽은 표본조사 논문의 부록에 처음 적었고, \(1937\) 년 논문에서 틀을 갖추어 내놓았다.
그가 풀어야 했던 것은 계산이 아니라 말이었다. 모수 \(\mu\) 는 우리가 모를 뿐 고정된 수다. 그러니 관측을 마치고 구간이 숫자로 굳고 나면 「\(\mu\) 가 거기 들어 있을 확률」은 \(0\) 아니면 \(1\) 이지 그 사이의 값일 수가 없다. 바로 위에서 \([48.2,\ 51.8]\) 을 두고 한 말이 그것이다. 그런데도 우리는 「\(95\%\) 쯤은 믿는다」고 말하고 싶다. 네이만은 그 말을 확률이 붙을 수 있는 자리로 옮겼다 — 구간이 아니라 구간을 만드는 절차에 붙인 것이다.
「이미 뽑은 표본으로 만든 그 구간에 모수가 들어갈 확률이 그 값이냐」는 물음에 그는 「명백히 아니다」라고 못 박았다. 그래서 이름도 확률(probability)이 아니라 신뢰(confidence)라는 말로 따로 지었다. 낱말을 새로 만들어서라도 둘이 섞이지 않게 하려 한 것이다.
그 조심스러움은 지금도 값어치가 있다. 「\(95\%\) 신뢰구간」을 「모수가 \(95\%\) 의 확률로 이 안에 있다」로 읽는 것은 통계에서 가장 흔한 오해이고, 절 \(1\) 의 그림이 바로 그 자리를 보여 준다 — 흔들리는 것은 막대이지 세로선이 아니다.
다만 조심스러움에는 값이 따른다. 신뢰구간은 「지금 손에 든 이 구간이 맞을 가능성」을 끝내 말해 주지 않는다. 그것까지 말하려면 모수에 분포를 얹는 다른 틀이 필요하다.
확인한 곳 — MacTutor 「Jerzy Neyman」 · Wikipedia 「Neyman construction」 · Morey 외 「Continued misinterpretation of confidence intervals」
오해 2: "자료의 95%가 구간 안에 들어간다"
이 오해는 이름에서 온다. 「\(95\%\) 구간」이라는 말이 「자료의 \(95\%\) 를 담는 구간」으로 읽히는 것이다. 그러나 신뢰구간이 겨냥하는 것은 개별 관측값이 아니라 모수 하나다.
두 폭의 크기를 견주면 오해가 설 자리가 없다. \(\sigma = 10\) 인 정규모집단에서 \(n = 100\) 을 뽑았다고 하자. 관측값의 \(95\%\) 가 드는 범위는 \(\mu \pm 1.96\sigma = \mu \pm 19.6\) 이지만, 신뢰구간은 \(\bar x \pm 1.96\sigma/\sqrt{100} = \bar x \pm 1.96\) 이다. 열 배 좁다. 그리고 \(n\) 을 키우면 둘이 더 벌어진다 — 구간의 폭은 \(1/\sqrt n\) 으로 \(0\) 을 향해 줄어드는데, 자료가 흩어진 폭은 \(\sigma\) 가 정한 그대로 꿈쩍하지 않는다. 표본을 늘려도 자료가 덜 흩어지지는 않는다.
자료를 담는 범위를 정말 원한다면 쓸 도구가 따로 있다. 다음 관측값이 들 범위는 예측구간(prediction interval)이고, 모집단의 일정 비율이 드는 범위는 허용구간(tolerance interval)이다. 둘 다 \(n \to \infty\) 에서 \(0\) 으로 줄어들지 않는다는 점이 신뢰구간과 다르다. 재는 대상이 모수가 아니라 관측값이기 때문이다.
오해 3: "두 신뢰구간이 겹치면 차이가 유의하지 않다"
두 집단의 구간을 나란히 그려 놓으면 겹치는지가 눈에 먼저 들어온다. 그래서 그것을 판정에 쓰고 싶어진다. 그러나 겹치는데도 차이가 유의한 띠가 존재하고, 산수로 바로 드러난다.
두 추정값이 독립이고 표준오차가 같다고 하자(\(\mathrm{SE}_1 = \mathrm{SE}_2 = \mathrm{SE}\)). 차의 표준오차는 각각의 것보다 크지만 두 배는 아니다.
그러므로 차가 \(5\%\) 에서 유의해지는 임계값은 \(\lvert d\rvert > 1.96\sqrt 2\,\mathrm{SE} = 2.772\,\mathrm{SE}\) 다. 한편 두 구간이 겹치기를 그치는 임계값은 각자의 반폭을 더한 \(\lvert d\rvert > 2 \times 1.96\,\mathrm{SE} = 3.920\,\mathrm{SE}\) 다. 둘이 다르고, 사이에 띠가 있다.
이 띠 안에서는 차가 유의한데도 두 구간이 겹쳐 보인다. \(\sqrt 2 < 2\) 이기 때문에 생기는 간격이고, 중첩 규칙은 유의성 검정보다 더 엄격한 기준인 셈이다.
거꾸로는 맞다. 겹치지 않으면 \(\lvert d\rvert > 3.920\,\mathrm{SE} > 2.772\,\mathrm{SE}\) 이므로 차는 반드시 유의하다. 곧 「겹치지 않음 \(\Rightarrow\) 유의」는 참이고 그 역이 거짓이다. 눈으로 보는 규칙이 틀리는 방향은 한쪽뿐이라는 것을 알아 두면, 겹친 그림을 보고 「차이 없음」이라 적는 일은 피할 수 있다.
중첩을 꼭 눈으로 판정하고 싶다면 그릴 구간의 신뢰수준을 낮추어야 한다. 중첩이 풀리는 임계값과 유의 임계값이 같아지려면 \(2z^{*} = 1.96\sqrt 2\), 곧 \(z^{*} = 1.386\) 이어야 하고 그 신뢰수준은 \(83.4\%\) 다. 그런 그림을 그리는 분야도 있지만, 독자가 \(95\%\) 를 기대하는 자리에서는 혼란이 더 크다.
제대로 하는 길은 하나다. 차 \(\mu_1 - \mu_2\) 에 대한 구간을 직접 만들어 그것이 \(0\) 을 담는지 본다. 8.3절 μ₁−μ₂의 신뢰구간이 그 구간을 세운다.
자료를 본 뒤에 고르면 — 갈림길의 정원
위 셋은 다 만든 구간을 잘못 읽는 일이다. 그보다 조용한 잘못이 하나 더 있다 — 구간을 만들기 전에 자료를 먼저 보는 것이다. 양측으로 할지 단측으로 할지, 스튜던트 \(t\) 로 할지 웰치로 할지, 이상치(outlier)을 뺄지 말지를 자료를 본 뒤에 정하면, 그렇게 나온 구간은 더 이상 \(1-\alpha\) 를 약속하지 않는다. 같은 자료가 절차를 고르는 데 한 번, 구간을 만드는 데 또 한 번 쓰였기 때문이다.
겔먼과 로켄이 이것을 「갈림길의 정원」이라 불렀다. 분석자가 여러 분석을 실제로 돌려 보지 않아도 문제가 생긴다는 것이 요점이다 — 자료가 달랐다면 다른 갈림길을 택했을 것이라는 사실만으로 보장이 깨진다. 그래서 「나는 하나만 계산했다」는 변명이 통하지 않는다.
막는 길은 절차를 자료가 아니라 설계에서 정하는 것이다. 8.3절 μ₁−μ₂의 신뢰구간 \(\S 5\) 가 등분산 검정으로 구간을 고르면 안 되는 까닭을 이 자리로 돌려 설명하고, 9.6절 분석의 자유는 곱해진다가 그 자유를 수로 센다.
3. 너비, 신뢰수준, 표본크기
\(z\) 구간의 오차한계는 세 양의 곱이다.
이 한 줄에 구간의 폭을 정하는 것이 모두 들어 있다. 신뢰수준을 올리면 \(z_{1-\alpha/2}\) 가 커져 구간이 넓어지고(\(95\%\) 에서 \(99\%\) 로 가면 \(1.96\) 이 \(2.576\) 이 되어 폭이 \(31.4\%\) 늘어난다), 모집단의 변동성이 크면 \(\sigma\) 가 커져 역시 넓어진다. 좁히는 쪽으로 움직이는 것은 \(n\) 하나뿐이고, 그것도 \(1/\sqrt n\) 으로만 줄어든다 — 폭을 절반으로 하려면 표본을 네 배 모아야 한다.
세 양을 우리가 다룰 수 있는 정도는 서로 다르다. \(\sigma\) 는 모집단의 성질이라 손댈 수 없고, 신뢰수준은 낮추면 폭이 줄지만 그만큼 덜 믿는 구간이 된다. 실제로 고를 수 있는 것은 \(n\) 뿐이고, 그것이 다음 대목의 물음이다.
표본크기의 결정
오차한계의 식을 \(n\) 에 대해 풀면 필요한 표본크기가 나온다. 신뢰수준 \(1-\alpha\) 에서 오차한계를 \(E\) 이하로 누르려면
만큼 모으면 된다. \(\sigma = 10\) 인 모집단에서 \(95\%\) 신뢰수준으로 모평균을 \(\pm 2\) 안에 잡고 싶다면 \(n = (1.96 \times 10/2)^2 = 96.04\) 이므로 \(97\) 개가 필요하다.
소수가 나오면 늘 올린다. \(96\) 으로 내리면 오차한계가 \(2\) 를 조금 넘어 애초의 요구를 어기기 때문이다. 그리고 이 식에는 모르는 값 \(\sigma\) 가 들어 있다. 표본을 뽑기 전에 \(n\) 을 정해야 하므로 \(\sigma\) 를 어디선가 가져와 꽂아야 하고, 그 자리를 어떻게 메우는지가 8.5절 표본크기 계산의 일이다.
흔히 쓰는 신뢰수준
실무에서 거의 세 값만 쓴다. 임계값을 외워 두면 머릿셈이 되므로 함께 적는다.
| 신뢰수준 | \(\alpha\) | \(z_{1-\alpha/2}\) |
|---|---|---|
| 90% | 0.10 | 1.645 |
| 95% | 0.05 | 1.960 |
| 99% | 0.01 | 2.576 |
4. 단측 신뢰구간 (신뢰한계)
물음이 늘 양쪽을 묻지는 않는다. 불순물 함량이 얼마 아래인지, 수명이 얼마 위인지만 알면 되는 자리가 있다. 그때는 한쪽 끝만 적는다. 신뢰수준 \(1-\alpha\) 의 상한은 \(\mu \le \bar X + z_{1-\alpha}\,\sigma/\sqrt n\) 이고 하한은 \(\mu \ge \bar X - z_{1-\alpha}\,\sigma/\sqrt n\) 이다.
임계값이 \(z_{1-\alpha/2}\) 가 아니라 \(z_{1-\alpha}\) 다. 양측구간은 놓칠 확률 \(\alpha\) 를 두 꼬리에 절반씩 나눠 쓰는데, 단측 한계는 꼬리가 하나뿐이어서 거기에 \(\alpha\) 를 다 쓴다. 그래서 \(95\%\) 단측 한계의 임계값은 \(z_{0.95} = 1.645\) 이고 양측의 \(1.960\) 보다 작다. 같은 신뢰수준에서 한쪽만 묻는 것이 더 조이는 한계를 준다 — 반대쪽을 포기한 대가로 받는 것이다.
기본값은 양측이다. 단측 한계가 맞는 자리는 물음이 애초에 한쪽만 묻는 곳이다 — 불순물 상한, 수명 하한처럼 자료를 보기 전에 방향이 정해져 있는 경우다. 자료를 보고 나서 「이쪽이 유리하니 단측으로 하자」로 가면 위에서 말한 조임을 공짜로 받는 셈이고, 그것이 바로 \(\S 2\) 의 갈림길의 정원이다. 방향은 설계 단계에 적어 두고 거기서 바꾸지 않는다.
위험관리가 이 꼴을 많이 쓴다. 포트폴리오에서 알고 싶은 것은 손실이 얼마 아래인가뿐이고 이익 쪽 끝에는 관심이 없다. 「손실이 $X 를 넘지 않는다고 \(95\%\) 신뢰한다」는 보고가 단측 상한이며, 금융에서 VaR(value at risk)라 부르는 양이 같은 생각 위에 서 있다.
연습문제
연습문제 1. 콜레스테롤에 대한 95% 신뢰구간이 \((188.3, 205.7)\)이다. (a) 다음 중 올바른 해석은? (i) 참 평균이 188.3과 205.7 사이에 있을 확률이 95%이다. (ii) 이 연구를 여러 번 반복하면 그 결과 구간들 중 약 95%가 참 평균을 담는다. (iii) 콜레스테롤 수치의 95%가 188.3과 205.7 사이에 있다. (b) 점추정값과 오차한계는?
풀이
(a) (ii)만 옳다: "이 연구를 여러 번 반복하면 그 결과 구간들 중 약 95%가 참 평균을 담는다."
(i)은 틀렸다: 고정된 모수에 확률을 부여하는데, 빈도주의 관점에서는 그것이 오류다. 모수는 고정되어 있고 구간이 확률적이다.
(iii)도 틀렸다: 평균에 대한 신뢰구간을 자료의 산포와 혼동한다. 신뢰구간은 개별 콜레스테롤 수치의 범위가 아니라 모평균에 관한 것이다.
(b) \(\bar X = (188.3 + 205.7)/2 = 197.0\). 오차한계 = \((205.7 - 188.3)/2 = 8.7\).
연습문제 2. 너비와 신뢰수준. (a) 신뢰수준이 높아질 때, (b) 표본크기가 커질 때, (c) 모분산이 커질 때 신뢰구간의 너비는 어떻게 변하는가?
풀이
신뢰구간 너비 = \(2 \cdot z_{1-\alpha/2} \cdot \mathrm{SE} = 2 z_{1-\alpha/2} \sigma/\sqrt n\).
(a) 신뢰수준이 높으면(0.95 대신 \(1 - \alpha = 0.99\)): \(z_{0.995} = 2.576\) 대 \(z_{0.975} = 1.96\). 너비가 31% 커진다. 더 확신하려면 구간이 넓어진다.
(b) \(n\)이 크면: 너비가 \(1/\sqrt n\)으로 줄어든다. \(n\)을 4배 하면 너비가 절반이 된다.
(c) \(\sigma\)가 크면: 너비가 \(\sigma\)에 비례해 커진다. 표준편차가 두 배면 너비도 두 배이다.
실무적으로, 목표 오차한계를 달성하려면 \(n = (z_{1-\alpha/2} \sigma/\mathrm{ME})^2\)이다(\(\mathrm{ME}\) 는 목표 오차한계). \(z\)와 \(\sigma\)에 대해 이차이고 오차한계에 대해 역제곱이다.
연습문제 3. 모수에 95% 확률이 없는 이유. 빈도주의 신뢰구간이 \(\mu\)에 대한 확률 진술을 허용하지 않는 이유를 설명하라.
풀이
빈도주의 통계학에서 \(\mu\)는 확률변수가 아니라 고정된 상수이다. 확률변수는 확률분포를 갖지만 상수는 그렇지 않다. "\(P(\mu \in (188, 206)) = 0.95\)" 같은 진술은 무의미하다. \(\mu\)는 구간 안에 있거나(확률 1) 밖에 있을 뿐(확률 0)이며 \(\mu\)에는 확률적인 요소가 없기 때문이다.
확률적인 것은 구간 자체이다(끝점이 표본에 따라 달라진다). 95%는 절차를 가리킨다: 여러 표본으로 만든 모든 95% 신뢰구간 중 95%가 \(\mu\)를 잡아낸다.
\(\mu\)에 대한 확률 진술을 하려면 베이즈 추론이 필요하다. 거기서는 \(\mu\)가 사전분포를 갖고 사후분포가 "\(P(\mu \in \text{구간} \mid \text{자료}) = 0.95\)"를 주며, 이를 신용구간이라 한다.
연습문제 4. 포함확률. 포함확률을 정의하고, 95% 신뢰구간의 실제 포함확률이 95%보다 낮을 수 있는 이유를 설명하라.
풀이
포함확률: \(P(\theta \in \text{CI})\) — 절차가 참 모수를 잡아낼 확률. \(1 - \alpha\)와 같도록 설계된다.
실제 포함확률이 명목값보다 낮아지는 이유는 이렇다.
- 근사오차: 신뢰구간이 유한한 \(n\)에서 점근이론(중심극한정리(central limit theorem))에 기반한다. 비율에 대한 왈드 신뢰구간은 \(p = 0\)이나 \(p = 1\) 근처에서 포함확률이 95%를 크게 밑돈다.
- 분포의 잘못된 지정: \(t\)-구간은 정규성(normality)을 가정한다. 치우친 자료에 \(n\)이 작으면 포함확률이 95%가 아니라 85–90%가 될 수 있다.
- 갈림길의 정원: 자료를 본 뒤에 절차를 고르면 그 "신뢰구간"은 제대로 된 신뢰구간이 아니며 포함확률이 명목값에서 크게 벗어날 수 있다.
- 다중검정: 신뢰구간의 \(1 - \alpha\) 보장은 구간 하나당 보장이다. 20개를 만들고 "흥미로운" 것 하나만 보고하면 미포함 확률이 부풀려진다.
비율에 대한 윌슨 신뢰구간은 왈드의 나쁜 포함확률을 고치려고 개발되었다. 의심스러울 때는 항상 모의실험으로 포함확률을 확인하라.
연습문제 5. 단측 신뢰구간. 단측 신뢰구간은 언제 적절한가? 예를 하나 들라.
풀이
단측 신뢰구간은 관심 방향에 따라 \((-\infty, \hat\theta + z_{1-\alpha} \mathrm{SE})\) 또는 \((\hat\theta - z_{1-\alpha} \mathrm{SE}, \infty)\)이다.
한쪽 방향만 중요할 때 적절하다.
- 품질관리: "불량률이 최대 5%임을 보장" — \(p\)에 대한 상한 단측 신뢰구간.
- 동등성/비열등성: 새 치료법이 기존 치료법보다 나쁘지 않다 — 치료 효과 차이에 대한 하한 단측 신뢰구간.
- 약물 독성: 용량 한계를 넘을 확률이 1% 미만임을 보장.
장점: \(\alpha\) 전부를 한쪽 꼬리에 쓰므로 관심 있는 쪽의 한계가 더 조인다. 단점: 반대쪽에 대한 정보가 없다.
과학적 보고의 기본값은 단측이 충분히 정당화되지 않는 한 양측이다. 규제 맥락에서는 단측을 요구하는 경우가 많다.
연습문제 6. 베이즈 신용구간. 베이즈 95% 신용구간이란 무엇이며 빈도주의 신뢰구간과 어떻게 다른가?
풀이
베이즈 95% 신용구간: 사후확률이 \(P(\theta_L \le \theta \le \theta_U \mid x) = 0.95\)가 되는 구간 \((\theta_L, \theta_U)\).
빈도주의 신뢰구간: 반복표본추출에서 구성 절차의 포함확률이 95%인 구간.
차이점은 이렇다.
- 해석: 베이즈는 \(\theta\)에 직접 확률을 부여하고, 빈도주의의 확률은 절차에 관한 것이다.
- 주관성: 베이즈는 사전분포가 필요하고, 빈도주의는 표집분포(sampling distribution)가 필요하다.
- 점근적 일치: 자료가 충분히 정보를 담고 있으면 (베른슈타인–폰 미제스(Bernstein–von Mises) 정리에 의해 — 표본이 커지면 사후분포가 최대가능도추정량을 중심으로 한 정규분포에 가까워진다) 둘이 비슷한 구간으로 수렴한다.
- 작은 표본: 상당히 다를 수 있다. 사전분포가 정보를 많이 담고 있으면 베이즈 구간이 훨씬 좁을 수 있다.
무엇을 보고할지는 철학과 독자에 달려 있다. 현대의 실무에서는 둘 다 쓰는 경우가 많다: 추론에는 베이즈, 가설 \(H_0: \theta = \theta_0\)의 검정에는 빈도주의. 많은 물리학자들이 주요 실험에서 둘 다 보고한다.
연습문제 7. "신뢰구간이 겹치면 차이가 없다" 는 판단이 왜 틀렸는지 수치로 보여라.
풀이
상황. 두 독립 표본에서
- 집단 A: \(\bar x_1=10.0\), \(\operatorname{SE}_1=1.0\) → 95% 구간 \((8.04,\ 11.96)\)
- 집단 B: \(\bar x_2=13.0\), \(\operatorname{SE}_2=1.0\) → 95% 구간 \((11.04,\ 14.96)\)
두 구간이 \((11.04,\ 11.96)\)에서 겹친다. "차이가 없다"고 할 것인가?
차이에 대한 구간을 계산하자.
0을 담지 않는다. 차이가 유의하다. \(z=3/1.414=2.12\), \(p=0.034\).
왜 이런 일이 생기는가. 개별 구간이 겹치지 않으려면 차이가
보다 커야 한다. 반면 차이가 유의하려면
보다 크면 된다. \(\sqrt{a^2+b^2}<a+b\) 이므로, 유의한데도 겹치는 구역이 항상 존재한다.
| 차이 | 구간 중첩? | 유의? |
|---|---|---|
| 2.0 | 중첩 | 아니오 |
| 3.0 | 중첩 | 예 |
| 4.5 | 안 중첩 | 예 |
중첩 판정의 실제 수준. 표준오차가 같을 때, "겹치지 않으면 유의"라는 규칙은 실질적으로 \(\alpha\approx0.006\) 인 검정에 해당한다. 지나치게 보수적이다.
import numpy as np
from scipy import stats

se = 1.0
thresh = 1.96 * (se + se)              # 구간이 갈라지는 차이
print(f"겹치지 않는 최소 차이 {thresh:.3f}")
print(f"이때의 z {thresh / np.sqrt(2 * se**2):.3f}")
print(f"실질 유의수준 {2 * stats.norm.sf(thresh / np.sqrt(2 * se**2)):.4f}")
겹치지 않는 최소 차이 3.920
이때의 z 2.772
실질 유의수준 0.0056
반대 방향은 성립한다. 겹치지 않으면 반드시 유의하다. 하지만 겹친다고 유의하지 않은 것은 아니다. 한쪽 방향으로만 타당한 규칙이다.
권고. 두 집단을 비교하려면 차이에 대한 구간을 직접 계산한다. 그림을 그린다면 차이의 구간을 따로 보여 주는 것이 정직하다.
연습문제 8. 신뢰구간과 예측구간의 차이를 설명하고, \(n=30\), \(\bar x=100\), \(s=15\)인 정규 자료에서 둘을 모두 계산하라.
풀이
대상이 다르다.
| 신뢰구간 | 예측구간 | |
|---|---|---|
| 담는 것 | 모수 \(\mu\)(고정된 수) | 새 관측값 \(X_{n+1}\)(확률변수) |
| 불확실성 | 추정의 불확실성만 | 추정 + 개체 변동 |
| \(n\to\infty\) | 폭 \(\to0\) | 폭 \(\to\) \(2z\sigma\)(0이 아님) |
공식.
예측구간의 \(\sqrt{1+1/n}\)에서 1이 개체 변동, \(1/n\)이 \(\bar x\)의 불확실성이다.
import numpy as np
from scipy import stats

n, xbar, s = 30, 100.0, 15.0
t = stats.t.ppf(0.975, n - 1)

hc = t * s / np.sqrt(n)                  # 신뢰구간 반폭
hp = t * s * np.sqrt(1 + 1 / n)          # 예측구간 반폭
print(f"t({n-1}, .975) = {t:.4f}")
print(f"신뢰구간 ({xbar - hc:.2f}, {xbar + hc:.2f})  폭 {2 * hc:.2f}")
print(f"예측구간 ({xbar - hp:.2f}, {xbar + hp:.2f})  폭 {2 * hp:.2f}")
print(f"폭의 비 {hp / hc:.2f}배")
t(29, .975) = 2.0452
신뢰구간 (94.40, 105.60)  폭 11.20
예측구간 (68.81, 131.19)  폭 62.37
폭의 비 5.57배
예측구간이 5.6배 넓다. \(n\)이 커지면 이 비가 \(\sqrt n\)에 가까워진다(\(\sqrt{30}=5.48\)).
해석의 차이.
- 신뢰구간 \((94.4,\ 105.6)\): "이 방법으로 만든 구간의 95%가 모평균을 담는다." 개별 관측값이 이 구간 밖에 있는 것은 당연하다.
- 예측구간 \((68.8,\ 131.2)\): "새로 뽑는 한 개체가 95% 확률로 이 안에 든다."
흔한 오해. "95% 신뢰구간이 \((94.4, 105.6)\)이니 자료의 95%가 그 안에 있다"는 말은 틀렸다. 실제로는 \(\pm1.96\times15=\pm29.4\) 범위, 즉 \((70.6,\ 129.4)\) 안에 95%가 있다.
제3의 구간 — 허용구간. "모집단의 95%를 95% 신뢰도로 담는 구간"은 또 다른 것이다. 예측구간보다 넓다.
어느 것이 필요한가.
- 정책 결정, 집단 비교 → 신뢰구간
- 개별 사례 예측, 보증 범위 → 예측구간
- 규격 설정, 공정관리 → 허용구간
연습문제 9. 논문에서 "\(p>0.05\)이므로 두 처리는 동등하다" 는 결론을 보았다. 왜 틀렸는지 설명하고, 동등성을 주장하려면 무엇을 해야 하는지 밝혀라.
풀이
왜 틀렸는가. 기각하지 못한 것은 증거가 없다는 뜻이지 없다는 증거가 아니다. 두 가지 다른 상황이 같은 \(p\) 값을 준다.
| 상황 | 추정 차이 | 95% 구간 | \(p\) |
|---|---|---|---|
| A. 정밀하고 효과 없음 | 0.2 | \((-0.50,\ 0.90)\) | 0.58 |
| B. 부정확함 | 3.0 | \((-3.50,\ 9.50)\) | 0.37 |
B에서는 9.5만큼의 큰 차이도 배제하지 못한다. "동등하다"고 말할 근거가 전혀 없다. A에서만 동등성을 논할 수 있다.
동등성을 주장하는 올바른 방법.
1단계 — 동등성 한계 \(\delta\)를 미리 정한다. "이 정도 차이는 임상적으로 무의미하다"는 값이다. 자료를 보기 전에 정해야 하며, 임상적·실무적 근거가 필요하다.
2단계 — TOST(two one-sided tests, 두 단측검정). 두 개의 단측 가설을 각각 수준 \(\alpha\)로 검정한다.
둘 다 기각되면 동등성을 주장한다.
3단계 — 같은 판정을 구간으로 내릴 수 있다. \(100(1-2\alpha)\%\) 신뢰구간(즉 \(\alpha=0.05\)면 90% 구간)이 \((-\delta,\delta)\) 안에 완전히 들어가면 동등하다.
import numpy as np
from scipy import stats

delta = 2.0                       # 동등성 한계
for name, diff, se in [("A", 0.2, 0.357), ("B", 3.0, 3.316)]:
    z = stats.norm.ppf(0.95)      # 90% 구간
    lo, hi = diff - z * se, diff + z * se
    ok = (-delta < lo) and (hi < delta)
    p1 = stats.norm.sf((diff + delta) / se)      # H01 기각용
    p2 = stats.norm.cdf((diff - delta) / se)     # H02 기각용
    print(f"{name}: 90% 구간 ({lo:6.2f}, {hi:6.2f})  "
          f"TOST p = {max(p1, p2):.4f}  동등성 {'인정' if ok else '불인정'}")
A: 90% 구간 ( -0.39,   0.79)  TOST p = 0.0000  동등성 인정
B: 90% 구간 ( -2.45,   8.45)  TOST p = 0.6185  동등성 불인정
A는 동등성이 인정되고 B는 아니다. 두 경우 모두 통상적인 \(p>0.05\)였지만 결론이 정반대다.
비열등성. 한쪽만 문제가 되는 경우(새 약이 기존 약보다 나쁘지만 않으면 된다)에는 단측 검정 하나만 하면 된다. 구간의 한쪽 끝만 \(-\delta\)보다 크면 된다.
보고할 것. 동등성 한계 \(\delta\)와 그 근거, 사용한 구간의 신뢰수준, 검정력 계산. \(\delta\)를 사후에 정하면 어떤 결과든 만들 수 있다.
연습문제 10. 신뢰구간을 그림으로 제시하는 방법들을 비교하고, 오해를 부르는 관행을 지적하라.
풀이
주요 방식.
1 — 오차막대. 점추정값 위아래로 선을 긋는다. 가장 흔하지만 무엇을 나타내는지 명시하지 않는 경우가 많다.
| 오차막대의 정체 | 반폭 | 상대 크기 |
|---|---|---|
| 표준편차 \(s\) | \(s\) | \(\sqrt n\)배 큼 |
| 표준오차 \(s/\sqrt n\) | \(s/\sqrt n\) | 기준 |
| 95% 신뢰구간 | \(\approx2s/\sqrt n\) | 약 2배 |
\(n=30\)이면 SD 막대가 SE 막대의 5.5배다. 캡션에 무엇인지 적지 않으면 그림을 읽을 수 없다.
2 — 숲그림(forest plot). 여러 연구나 하위집단의 구간을 세로로 나열한다. 메타분석의 표준이며, 구간의 폭 차이가 한눈에 보인다. 연구 크기를 점의 면적으로 표시하는 관행이 좋다.
3 — 구간 자체의 분포를 보이기. 부트스트랩(bootstrap) 분포의 히스토그램이나 바이올린 위에 구간을 겹친다. 비대칭이 드러난다.
4 — 여러 신뢰수준을 겹치기. 50%, 80%, 95% 구간을 굵기가 다른 선으로 겹쳐 그린다. 베이즈 분석에서 흔하며, 하나의 임계값에 집착하지 않게 한다.
5 — 등급 그림(gradient). 신뢰수준을 색의 농도로 연속 표현한다. "안이냐 밖이냐"의 이분법을 피한다.
오해를 부르는 관행.
- 오차막대의 정체를 밝히지 않기. 가장 흔한 잘못이다. 캡션에 반드시 "오차막대는 95% 신뢰구간"처럼 적는다.
- 중첩으로 유의성 판단하기. 연습문제 7 에서 본 대로 틀렸다. 비교가 목적이면 차이의 구간을 그린다.
- 막대그래프(bar chart) 위에 오차막대. 막대의 면적이 0부터 시작하는 시각적 무게를 주어, 실제로는 작은 차이를 크게 보이게 한다. 점과 선이 낫다. 자료가 적으면 원자료 점을 모두 찍는 것이 가장 정직하다.
- 세로축 잘라내기. 축을 0이 아닌 곳에서 시작하면 차이가 과장된다. 의도적으로 할 수는 있지만 명시해야 한다.
- 대칭 막대로 비대칭 구간 그리기. 부트스트랩이나 비율의 구간은 비대칭이다. 위아래를 다르게 그려야 한다.
- 한 그림에 너무 많은 구간. 20개 이상이면 개별 해석이 불가능하고, 다중비교(multiple comparisons) 문제가 숨는다.
좋은 캡션의 예.
그림 3. 처리군별 평균 반응시간. 점은 표본평균(sample mean), 선은 95% 신뢰구간(\(t\) 방법, \(n=24\)/군). 구간의 중첩으로 군 간 차이를 판단할 수 없으며, 쌍별 차이는 표 2에 있다.
연습문제 11. 신뢰구간을 보고할 때 지켜야 할 사항을 정리하라. 흔히 놓치는 것은 무엇인가?
풀이
반드시 적을 것.
- 신뢰수준. 95%가 기본이지만 명시한다. 90%나 99%를 썼다면 특히.
- 구성 방법. \(t\) 구간인지 부트스트랩인지 가능도비인지. 부트스트랩이면 어느 변형(백분위, BCa)이고 \(B\)가 얼마인지.
- 점추정값. 구간만으로는 중심을 알 수 없다. 비대칭 구간이면 특히 중요하다.
- 표본크기. 독자가 정밀도를 가늠하는 기준이다.
- 단측인지 양측인지.
- 다중비교 보정 여부. 여러 구간을 보고하면 동시 보장이 있는지.
흔히 놓치는 것.
- 표집오차만 담는다는 사실. 무응답 편향, 측정오차, 모형 오설정은 구간에 들어 있지 않다. 조사 자료라면 응답률을 함께 적어야 한다.
- "유의하지 않다"와 "효과가 없다"의 혼동. 구간이 0을 담는다고 효과가 없는 것이 아니다. 구간이 넓으면 큰 효과도 배제하지 못한다. 구간의 양끝을 보고 실무적으로 의미 있는 값이 포함되는지 논해야 한다.
- 유효숫자의 과잉. \(n=30\)인 자료에서 구간을 소수 넷째 자리까지 적으면 없는 정밀도를 주장하는 것이다. 대략 표준오차의 10분의 1 자리까지가 적당하다.
- 비대칭을 대칭으로 보고. 부트스트랩 구간이 \((0.12, 0.45)\)인데 "\(0.28\pm0.17\)"로 적으면 비대칭 정보가 사라진다.
- 여러 구간의 비교. 두 구간이 겹치는지로 차이의 유의성을 판단하면 안 된다. 차이에 대한 구간을 따로 계산해야 한다.
좋은 보고의 예.
처리군과 대조군의 회복률 차이는 15.0%포인트였다(\(n_1=n_2=200\), 95% 신뢰구간 5.3%p~24.7%p, 왈드 방법). 구간이 0을 담지 않으므로 차이가 있다고 볼 근거가 있으나, 실무적으로 의미 있다고 보는 5%p 임계값에 하한이 가까워 효과의 크기는 불확실하다.
정리하며
\(95\%\) 신뢰구간은 "\(\mu\) 가 이 구간에 있을 확률이 \(95\%\)"라는 뜻이 아니다.
- \(\mu\) 는 고정된 수다. 구간 안에 있거나 없거나 둘 중 하나이고, 거기에 확률은 없다. 확률 진술의 대상은 확률적인 끝점 \(\bar X\pm z_{1-\alpha/2}\sigma/\sqrt n\) 이다.
- 올바른 해석은 절차에 관한 것이다. 같은 방식으로 표본을 뽑아 구간을 만들기를 반복하면 그 구간들 중 약 \(95\%\) 가 참값을 담는다. 손에 든 이 구간 하나에 대한 진술이 아니다.
- 모의실험이 그 뜻을 보여 준다. 구간 100개를 그려 보면 대략 다섯 개가 참값을 놓치며, 어느 것이 빗나갔는지는 참값을 알 때만 보인다. 실무에서는 알 수 없다.
- "확률 \(95\%\) 로 구간에 있다"고 말하려면 베이즈 신용구간이 필요하다. 6장에서 본 대로 사후분포를 쓰면 그 진술이 가능해지며, 대신 사전분포를 정해야 한다.
- 흔한 오해 두 가지 더. 구간이 겹친다고 차이가 유의하지 않은 것은 아니고, 구간은 다음 관측이 아니라 모수의 범위다. 후자를 원하면 예측구간이 따로 있다.
다음 쪽 오차막대 그림에서 같은 구간을 그림으로 보고하는 법을 보고, 8.2절부터 각 모수를 하나씩 깊이 다룬다.