라쏘의 정식화와 희소성
능형회귀는 모든 계수를 0 쪽으로 축소하지만 어떤 것도 제거하지 않는다. 많은 응용에서, 특히 \(p\)가 클 때 우리는 무관한 변수의 계수를 정확히 0으로 만들어 자동으로 식별해 주는 추정량을 원한다. Tibshirani(1996)가 도입한 라쏘(Least Absolute Shrinkage and Selection Operator)는 L2 벌점을 L1 벌점으로 바꿈으로써 정칙화와 변수선택을 동시에 달성한다.
라쏘 목적함수
여기서 \(\|\boldsymbol{\beta}\|_1 = \sum_{j=1}^p |\beta_j|\)이고 \(\lambda \geq 0\)이다. 인자 \(1/(2n)\)은 표본크기가 달라도 \(\lambda\)를 비교할 수 있게 하는 관례다.
동등한 제약 형태는
이며 \(t\)는 KKT 조건을 통해 \(\lambda\)로 결정된다.
미분 불가능성과 부분미분
L2 벌점 \(\|\boldsymbol{\beta}\|_2^2\)과 달리 L1 노름 \(\|\boldsymbol{\beta}\|_1\)은 \(\beta_j = 0\)인 모든 점에서 미분 불가능하다. 따라서 기울기를 0으로 두는 것만으로는 안 되고, 비매끄러운 볼록함수로 기울기를 일반화한 부분미분을 쓴다.
\(\beta_j = 0\)에서 부분미분이 구간 \([-1, +1]\) 전체다. 덕분에 여러 자료 배치에서 \(\beta_j = 0\)인 채로 최적성 조건이 만족될 수 있으며, 이것이 희소해를 낳는 기제다.
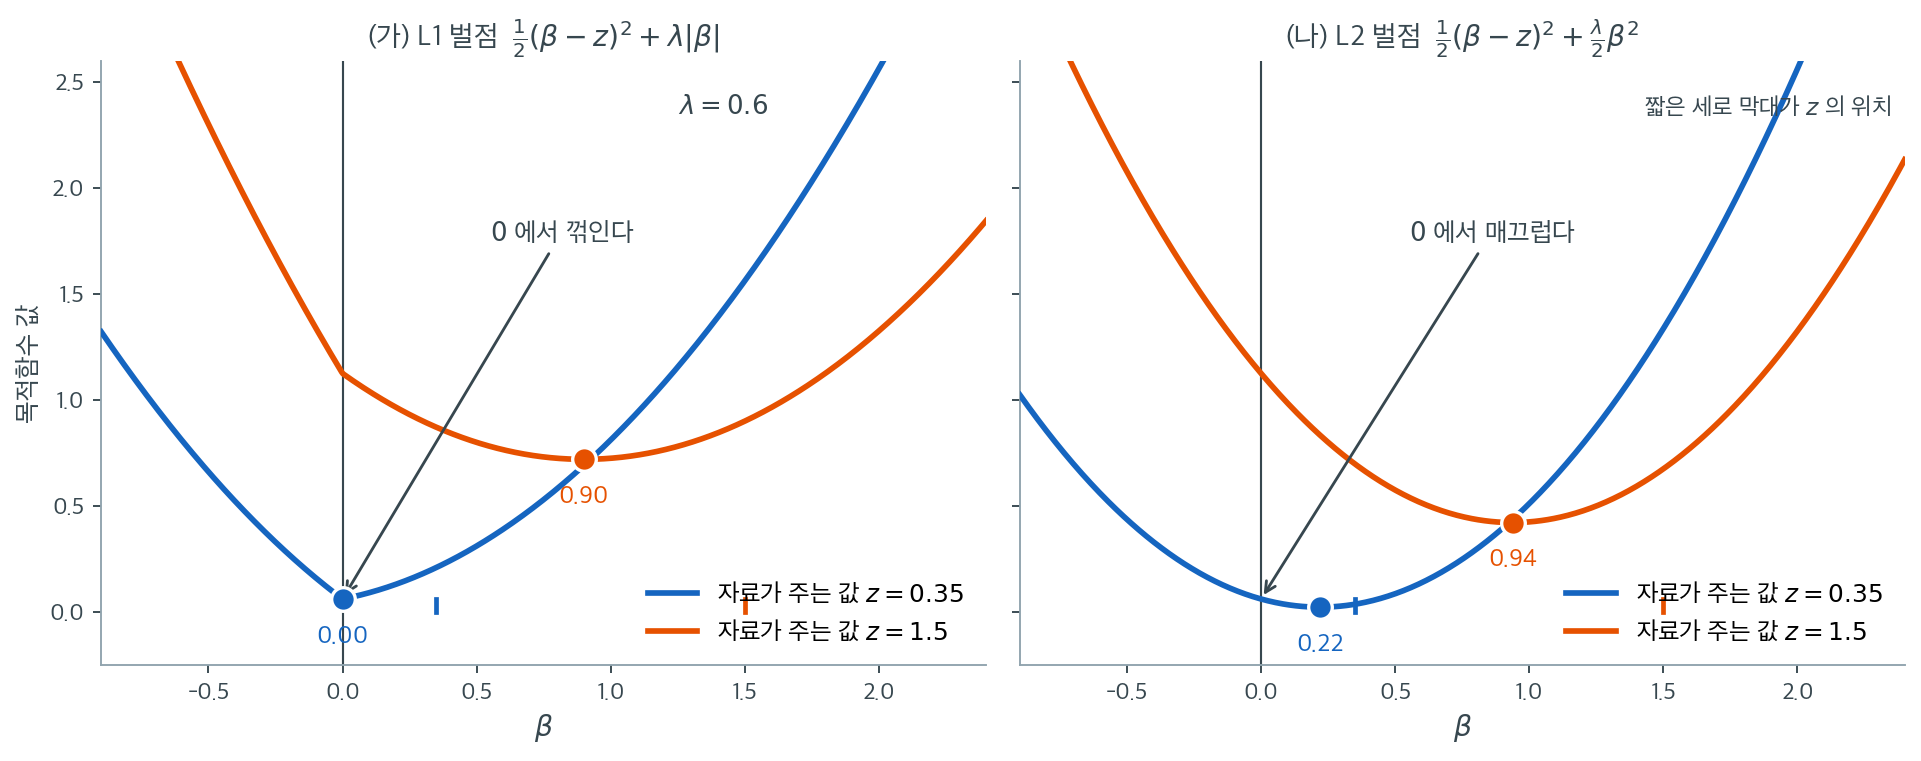
계수가 하나뿐인 가장 단순한 경우로 줄여 보면 희소성의 정체가 한눈에 보인다. 자료가 \(\beta\)에 대해 \(z\)라는 값을 말한다고 하자(직교 설계라면 \(z\)가 곧 OLS 추정값이다). 벌점을 더한 목적함수를 \(\lambda = 0.6\)에서 그린 것이 위 그림이고, 두 곡선은 자료가 강한 경우(\(z = 1.5\))와 약한 경우(\(z = 0.35\))다.
왼쪽 L1 벌점의 두 곡선은 \(\beta = 0\)에서 뾰족하게 꺾여 있다. 절댓값 함수가 그곳에서 미분 불가능하기 때문이다. 이 꺾임이 하는 일은 단순하다. \(\beta = 0\)의 오른쪽에서 곡선의 기울기는 \(-(z - \beta) + \lambda\)이고 왼쪽에서는 \(-(z-\beta) - \lambda\)이므로, \(0\)에서 양쪽 기울기가 \(\lambda - z\)와 \(-\lambda - z\)로 부호가 다를 수 있다. 파란 곡선(\(z = 0.35 < \lambda\))이 정확히 그 경우여서 최솟값이 \(0\)에 걸린다. 주황 곡선(\(z = 1.5 > \lambda\))은 0에서 오른쪽 기울기가 여전히 음수라 밖으로 빠져나가 \(0.90 = 1.5 - 0.6\)에서 멈춘다.
오른쪽 L2 벌점에는 그런 일이 없다. 두 곡선 모두 \(\beta = 0\)에서 매끄럽고, 그 점에서의 기울기는 \(-z\) 하나뿐이다. \(z \neq 0\)이면 이 기울기가 0이 아니므로 \(0\)은 절대 최솟값이 될 수 없다. 약한 신호 \(z = 0.35\)조차 \(0.22 = 0.35/1.6\)으로 축소될 뿐 살아남는다. 강한 신호는 \(0.94\)가 된다.
두 그림이 말하는 바를 하나로 요약하면 이렇다. 능형은 모든 계수를 같은 비율로 줄이고, 라쏘는 모든 계수에서 같은 양 \(\lambda\)를 깎은 뒤 음수가 되면 0에서 멈춘다. 비율로 줄이면 아무리 줄여도 0이 되지 않지만, 같은 양을 깎으면 작은 것부터 바닥에 닿는다. 다음 절의 연성 문턱 공식은 이 그림에 이름을 붙인 것에 지나지 않는다.
연성 문턱 연산자
직교 설계(\(\mathbf{X}^\top\mathbf{X} = n\mathbf{I}\))라는 특수한 경우에 라쏘는 연성 문턱 연산자로 표현되는 닫힌 형태 해를 갖는다.
- \(|\hat{\beta}_j^{\text{OLS}}| \leq \lambda\)이면 계수가 정확히 0이 된다.
- \(|\hat{\beta}_j^{\text{OLS}}| > \lambda\)이면 계수가 0 쪽으로 \(\lambda\)만큼 이동한다.
연성 문턱과 경성 문턱
연성 문턱(라쏘)은 작은 계수를 0으로 만들면서 큰 계수도 축소한다. 경성 문턱(최량 부분집합 선택)은 작은 계수를 0으로 만들되 큰 계수는 그대로 둔다. 능형회귀는 문턱 없이 비례 축소 \(\hat{\beta}_j^{\text{ridge}} = \hat{\beta}_j^{\text{OLS}}/(1 + \lambda)\)를 적용한다.
일반적인 경우에는 닫힌 형태 해가 없다
직교가 아닌 설계에서는 라쏘에 닫힌 형태 해가 없다. L1 벌점이 \(\mathbf{X}^\top\mathbf{X}\)의 교차항을 통해 계수들을 결합시켜 문제를 볼록하지만 비매끄러운 최적화로 만든다. 좌표하강 같은 수치 알고리즘이 필요하며 뒤의 절에서 다룬다.
희소성
라쏘의 결정적 특징은 희소 해를 만든다는 것이다. \(\lambda\)가 충분히 크면 \(\hat{\boldsymbol{\beta}}_{\text{lasso}}\)의 많은 성분이 정확히 0이 된다.
- \(\lambda = 0\)에서 해는 OLS다(\(p < n\)일 때).
- \(\lambda_{\max} = \frac{1}{n}\|\mathbf{X}^\top\mathbf{y}\|_\infty = \max_j \left|\frac{1}{n}\sum_i x_{ij}y_i\right|\)에서 모든 계수가 0이다.
- 그 사이에서 \(\lambda\)를 키우면 계수가 차례로 0이 된다.
\(p > n\)일 때 라쏘의 한계
\(p > n\)이면 라쏘는 0이 아닌 계수를 최대 \(n\)개까지만 고를 수 있다. 라쏘 해가 최대 \(n\)차원 부분공간에 놓이기 때문이다. 참으로 유의미한 변수가 \(n\)개를 넘으면 라쏘는 그것들을 동시에 복원할 수 없다.
축소 연산자의 비교
| 방법 | 축소 규칙 | 정확한 0 | 유형 |
|---|---|---|---|
| OLS | \(\hat{\beta}_j^{\text{OLS}}\) | 없음 | 축소 없음 |
| 능형 | \(\hat{\beta}_j^{\text{OLS}} / (1 + \lambda)\) | 없음 | 비례 축소 |
| 라쏘 | \(\text{sign}(\hat{\beta}_j^{\text{OLS}})\max(\lvert\hat{\beta}_j^{\text{OLS}}\rvert - \lambda, 0)\) | 있음 | 평행이동 축소 |
| 최량 부분집합 | \(\hat{\beta}_j^{\text{OLS}} \cdot \mathbf{1}(\lvert\hat{\beta}_j^{\text{OLS}}\rvert > \lambda)\) | 있음 | 경성 문턱 |
능형은 균일한 비례 축소를, 라쏘는 \(\lambda\)에서 잘라내는 균일한 평행이동 축소를 적용한다. 최량 부분집합 선택은 경성 문턱을 적용하되 남긴 계수는 축소하지 않는다.
연습문제
연습문제 1. 직교 설계에서 라쏘가 정말 연성 문턱과 일치하는지, 능형이 비례 축소와 일치하는지 수치로 확인하라.
풀이
\(\mathbf{X}^\top\mathbf{X} = n\mathbf{I}\)가 되도록 QR 분해로 직교 계획행렬을 만든다.
import numpy as np
from sklearn.linear_model import Ridge, Lasso
rng = np.random.default_rng(18)

n, p = 100, 5
Q, _ = np.linalg.qr(rng.normal(size=(n, p)))
X = Q * np.sqrt(n)                       # X'X = nI
beta = np.array([3.0, -1.5, 0.5, 0.05, 0.0])
y = X @ beta + rng.normal(0, 1, n)
b_ols = np.linalg.lstsq(X, y, rcond=None)[0]

lam = 2.0
b_ridge = Ridge(alpha=lam, fit_intercept=False).fit(X, y).coef_
pred_ridge = b_ols * n/(n + lam)

a = 0.05
b_lasso = Lasso(alpha=a, fit_intercept=False, max_iter=100000).fit(X, y).coef_
pred_lasso = np.sign(b_ols) * np.maximum(np.abs(b_ols) - a, 0)
| \(\hat\beta_1\) | \(\hat\beta_2\) | \(\hat\beta_3\) | \(\hat\beta_4\) | \(\hat\beta_5\) | |
|---|---|---|---|---|---|
| OLS | 2.8893 | \(-1.4653\) | 0.7013 | 0.0863 | \(-0.0740\) |
| 능형 (실측) | 2.8326 | \(-1.4365\) | 0.6876 | 0.0846 | \(-0.0726\) |
| 능형 (예측 \(\hat\beta_{\text{OLS}}\cdot\frac{n}{n+\lambda}\)) | 2.8326 | \(-1.4365\) | 0.6876 | 0.0846 | \(-0.0726\) |
| 라쏘 (실측) | 2.8393 | \(-1.4153\) | 0.6513 | 0.0363 | \(-0.0240\) |
| 라쏘 (예측 \(S_a(\hat\beta_{\text{OLS}})\)) | 2.8393 | \(-1.4153\) | 0.6513 | 0.0363 | \(-0.0240\) |
두 공식 모두 소수 넷째 자리까지 정확히 맞는다.
두 축소의 성질 차이를 표에서 직접 볼 수 있다.
- 능형은 비례적이다. 모든 계수가 같은 비율 \(n/(n+\lambda) = 100/102 = 0.980\)로 줄어든다. \(2.8893 \times 0.980 = 2.8326\).
- 라쏘는 평행이동이다. 모든 계수가 같은 양 \(a = 0.05\)만큼 줄어든다. \(2.8893 - 0.05 = 2.8393\), \(0.0863 - 0.05 = 0.0363\).
결과적으로 작은 계수에 미치는 상대적 영향이 전혀 다르다. \(\hat\beta_4 = 0.0863\)에 대해 능형은 2%를 깎지만 라쏘는 58%를 깎는다. \(a\)를 \(0.0863\) 이상으로 올리면 라쏘는 이 계수를 정확히 0으로 만들고 능형은 결코 그러지 못한다.
연습문제 2. \(\lambda_{\max} = \frac{1}{n}\|\mathbf{X}^\top\mathbf{y}\|_\infty\)에서 모든 계수가 0이 된다는 주장을 확인하라.
풀이
import numpy as np
from sklearn.linear_model import Lasso
lmax = np.abs(X.T @ y).max() / n
for f in (1.0, 0.99, 0.5, 0.1):
    b = Lasso(alpha=lmax*f, fit_intercept=False, max_iter=100000).fit(X, y).coef_
    print(f, (np.abs(b) > 1e-10).sum())
출력:
1.0 0
0.99 1
0.5 1
0.1 3
표준화된 설명변수 15개, \(n = 80\)인 자료에서 \(\lambda_{\max} = 3.5230\)이다.
| \(\lambda / \lambda_{\max}\) | \(\lambda\) | 0이 아닌 계수의 수 |
|---|---|---|
| 1.00 | 3.5230 | 0 |
| 0.99 | 3.4878 | 1 |
| 0.50 | 1.7615 | 1 |
| 0.10 | 0.3523 | 5 |
\(\lambda_{\max}\)에서 정확히 모든 계수가 0이고, 그보다 1%만 작아지면 정확히 하나가 살아난다.
왜 이 공식인가. \(\boldsymbol{\beta} = \mathbf{0}\)이 최적이려면 부분미분 최적성 조건
가 성립해야 한다. 이 조건이 모든 \(j\)에서 성립하는 가장 작은 \(\lambda\)가 곧 최댓값 \(\frac{1}{n}\|\mathbf{X}^\top\mathbf{y}\|_\infty\)이다.
\(\lambda\)가 그보다 조금 작아지면 조건을 처음 위반하는 변수, 즉 반응변수와 상관이 가장 큰 변수가 먼저 활성화된다. 이것이 정칙화 경로에서 변수가 등장하는 순서를 결정한다.
실무적 쓰임: sklearn과 glmnet은 \(\lambda\) 격자를 \(\lambda_{\max}\)에서 시작해 로그 간격으로 \(0.001\lambda_{\max}\)까지 내려가도록 자동 설정한다. \(\lambda_{\max}\)보다 큰 값은 계산할 이유가 없다.
정리하며
라쏘는 능형회귀의 L2 벌점을 L1 벌점 \(\lambda\|\boldsymbol{\beta}\|_1\)으로 바꾼다. 절댓값 함수가 0에서 미분 불가능하다는 점이 희소해를 낳는 수학적 기제다. 부분미분 덕분에 여러 배치에서 \(\beta_j = 0\)으로 최적성 조건이 만족된다. 직교인 경우 라쏘 해는 연성 문턱 연산자로 주어진다. 일반적인 설계에서는 닫힌 형태 해가 없어 반복 알고리즘이 필요하다. 희소성 덕분에 라쏘는 정칙화 방법이면서 동시에 변수선택 방법이 된다.