독립성 검정 - 타이타닉 생존과 성별
앞 절에서 독립성 검정의 얼개를 세웠다. 이 절은 그 절차를 하나의 실제 자료에 끝까지 적용한다. 기대도수부터 검정통계량, \(p\)값, 효과크기, 신뢰구간, 그리고 층화까지 한 번에 따라간다.
자료는 1912년 타이타닉호 승객 891명의 기록이다. 2장의 사례 연구에서 이미 탐색해 둔 자료이며, 거기서 답하지 못하고 남겨 둔 질문이 이 절의 출발점이다.
자료를 내려받는다
자료는 인터넷에서 읽어 온다. 네트워크가 없으면 실행되지 않지만, 출력을 모두 실어 두었으므로 읽는 데는 지장이 없다.
2장에서 남겨 둔 질문
2장에서 얻은 것은 이 표 하나였다.
여성 생존율 \(233/314=74.20\%\), 남성 생존율 \(109/577=18.89\%\). 55.31%포인트의 차이다.
2장은 여기서 멈췄다. 탐색은 무엇이 보이는가까지 답하기 때문이다. 남은 질문은 이것이다.
성별과 생존이 아무 관계가 없는데도, 단지 우연히 이 정도로 치우친 표가 나올 수 있는가?
이 질문에 답하려면 "우연히 이 정도"가 얼마나 있을 법한 일인지 재야 하고, 그 도구가 카이제곱 검정이다.
이 자료는 독립성인가 동질성인가
계산에 들어가기 전에 어느 검정인지 분명히 해 둔다. 동질성 검정 절에서 본 구별이 그대로 적용된다.
| 묻는 것 | 이 자료에서는 |
|---|---|
| 표본이 몇 개인가 | 하나다. 승객 명부 891명 |
| 무엇이 설계로 고정되었나 | 아무것도 고정되지 않았다 |
| 행 합 577/314는 무엇인가 | 결과다. 남성 577명을 뽑기로 정한 사람이 없다 |
따라서 독립성 검정이다. 하나의 표본을 성별과 생존이라는 두 변수로 교차 분류한 것이기 때문이다.
헷갈리기 쉬운 지점이 있다. 우리가 던지는 질문 — "여성 집단과 남성 집단의 생존율이 같은가" — 은 두 집단을 견주는 동질성의 말투다. 그래서 이 자료를 동질성 검정으로 착각하기 쉽다.
구별은 질문의 말투가 아니라 표집 설계에 있다. 만약 연구자가 처음부터 "여성 300명, 남성 300명을 뽑아 생존 여부를 조사하자"고 정했다면 그것은 동질성이다. 여기서는 배에 누가 탔는지가 자료를 정했다.
다행히 계산은 같다
두 검정은 같은 기대도수, 같은 검정통계량, 같은 자유도를 쓴다. 설계를 잘못 불러도 숫자는 틀리지 않는다. 달라지는 것은 결론을 적는 문장이다. 독립성이면 "성별과 생존은 독립이 아니다", 동질성이면 "두 모집단의 생존율 분포가 다르다"가 된다.
가설
확률로 적으면 \(H_0\)는 모든 칸에서
가 성립한다는 뜻이다. 유의수준은 \(\alpha=0.05\)로 둔다.
기대도수
\(H_0\)가 참이라면 각 칸에 몇 명이 있어야 하는가. 주변합에서 곧바로 나온다.
보기 1. 주변합에서 기대도수까지. 위의 \(2\times2\) 표를 행 합 \(R_1 = 314\), \(R_2 = 577\), 열 합 \(C_1 = 549\), \(C_2 = 342\), 총합 \(n = 891\) 로 적고, 교차곱의 차이를
라 둔다.
(1) 기대도수 네 개를 \(E_{ij} = R_i C_j / n\) 으로 구하시오. 네 값의 합이 \(n\) 으로 되돌아오는지 확인하시오.
(2) 네 칸의 어긋남 \(O_{ij} - E_{ij}\) 가 모두 절댓값이 같고 그 값이 \(\lvert\Delta\rvert / n\) 임을 보이시오. 이 표에서 그것을 유리수로 구하시오.
(3) 코드로 확인하고 카이제곱 근사의 타당성 조건을 점검하시오.
풀이
(1) 기대도수. \(n = 891 = 9 \times 99\) 이고 행 합·열 합이 모두 9 의 배수와 얽혀 있어 네 값이 분모 99 의 유리수로 떨어진다.
네 값을 더하면 \((19154 + 11932 + 35197 + 21926)/99 = 88209/99 = 891\) 로 총합이 되살아난다. 행별로 더해도 \(314\) 와 \(577\), 열별로 더해도 \(549\) 와 \(342\) 다. 기대표는 주변합을 고스란히 보존한다.
(2) 어긋남은 한 수다. 첫 칸부터 본다. \(O_{11} = 81\), \(E_{11} = R_1 C_1 / n\) 이므로
이고, 분자에 \(n = O_{11}+O_{12}+O_{21}+O_{22}\) 를 넣어 전개하면
로 \(O_{11}^2\), \(O_{11}O_{12}\), \(O_{11}O_{21}\) 세 항이 모두 지워진다. 따라서 \(O_{11} - E_{11} = \Delta/n\) 이다.
나머지 세 칸은 따로 계산할 필요가 없다. (1)에서 본 보존 성질 때문에 행마다 어긋남의 합이 0, 열마다도 0 이므로
가 된다. 수를 넣으면 \(\Delta = 8829 - 109044 = -100215\) 이고 \(100215 = 9 \times 11135\), \(891 = 9 \times 99\) 이므로
곧 \(112.\overline{47}\) 이 끝없이 반복되는 유리수다. 출력에 네 번 나타나는 \(112.47\) 이 이 수를 소수 둘째 자리에서 끊은 것이다.
(3) 수치적으로.
import warnings
warnings.filterwarnings("ignore")

import numpy as np
import pandas as pd

URL = ("https://raw.githubusercontent.com/datasciencedojo/"
       "datasets/f0ccab6a7ceafdff780052166fb6fab3311398eb/titanic.csv")
df = pd.read_csv(URL, index_col="PassengerId")

# Survived 와 Sex 에는 결측이 없다. 891명 전수를 쓴다.
print(f"Survived 결측 {df['Survived'].isna().sum()}개, "
      f"Sex 결측 {df['Sex'].isna().sum()}개")

tab = pd.crosstab(df["Sex"], df["Survived"])
print("\n관측도수")
print(pd.crosstab(df["Sex"], df["Survived"], margins=True).to_string())

# 기대도수를 정의대로 만든다. scipy 를 쓰지 않는다.
n = tab.values.sum()
row = tab.sum(axis=1)        # 314, 577
col = tab.sum(axis=0)        # 549, 342
exp = pd.DataFrame(np.outer(row, col) / n,
                   index=tab.index, columns=tab.columns)

print("\n기대도수 (H0: 독립)")
print(exp.round(2).to_string())

# 한 칸만 손으로 확인해 본다.
print(f"\n손계산 E[여성, 생존] = 314 * 342 / 891 = "
      f"{row['female'] * col[1] / n:.2f}")

print("\n관측 - 기대")
print((tab - exp).round(2).to_string())
Survived 결측 0개, Sex 결측 0개

관측도수
Survived    0    1  All
Sex
female     81  233  314
male      468  109  577
All       549  342  891

기대도수 (H0: 독립)
Survived       0       1
Sex
female    193.47  120.53
male      355.53  221.47

손계산 E[여성, 생존] = 314 * 342 / 891 = 120.53

관측 - 기대
Survived       0       1
Sex
female   -112.47  112.47
male      112.47 -112.47
기대도수가 모두 120 을 넘는다. 타당성 조건(모든 기대도수 5 이상)이 넉넉하게 충족되므로 카이제곱 근사를 그대로 써도 좋다. 자세한 기준은 기대 칸 도수와 타당성 조건 절에 있다.
독립이라면 여성 생존자는 120.53명이어야 하는데 실제로는 233명이다. 거의 두 배다.
네 칸의 기대도수가 (1)의 유리수 \(19154/99\), \(11932/99\), \(35197/99\), \(21926/99\) 와 소수 둘째 자리까지 맞고, "관측 \(-\) 기대" 네 칸이 모두 \(\pm 112.47\) 로 (2)의 \(\delta = -11135/99\) 와 맞는다. 부호가 대각선끼리 같고 비대각선끼리 같게 번갈아 나오는 것까지 유도한 모양 그대로다.
어긋남이 한 수뿐이라는 것이 곧 자유도 1 이다. 칸이 넷이어도 움직일 수 있는 것은 \(\delta\) 하나다.
이 바로 그 사실을 적은 것이다. 같은 이야기를 "여성 생존자 수 하나가 정해지면 나머지 셋이 따라 정해진다" 로 적으면 연습문제 1 의 설명이 되고, "\(\chi^2\) 이 그 한 수의 함수다" 로 적으면 보기 4 가 된다.
검정통계량
보기 2. 정의대로 계산한 카이제곱.
(1) 보기 1 의 \(\delta = \Delta/n\) 을 써서 \(2\times2\) 표의 검정통계량이
임을 보이시오. 고비는 \(\sum_{i,j} 1/E_{ij}\) 를 계산하는 데 있다. 이 표의 \(\chi^2\) 을 유리수로 구하시오.
(2) 네 칸의 어긋남이 모두 같은데 칸별 기여는 \(35.58\) 에서 \(104.96\) 까지 세 배 차이가 난다. 네 기여의 비가 무엇으로 정해지는지 식으로 적고 수로 확인하시오.
(3) 코드로 확인하고 \(\alpha = 0.05\) 에서 판정하시오.
풀이
(1) \(\sum 1/E_{ij}\) 가 곱으로 쪼개진다. 보기 1 에서 네 칸의 어긋남이 모두 \(\pm\delta\) 였으므로 제곱하면 부호가 사라지고 \(\delta^2\) 이 공통으로 빠져나온다.
\(1/E_{ij} = n/(R_i C_j)\) 에서 \(i\) 와 \(j\) 가 분리되어 있으므로 이중합이 두 합의 곱이 된다.
마지막 등식은 \(R_1 + R_2 = C_1 + C_2 = n\) 을 두 번 쓴 것이다. 그러므로
이다. 수를 넣으면
이다. 이 닫힌 꼴이 연습문제 3 에서 \(\varphi = \sqrt{\chi^2/n}\) 를 증명할 때, 그리고 보기 4 에서 뒤섞기 통계량을 한 줄로 계산할 때 다시 쓰인다.
(2) 기여의 비는 기대도수의 역수 비다. 칸별 항이 \(\delta^2/E_{ij}\) 이고 \(\delta^2\) 은 네 칸에 공통이므로 두 칸의 기여를 견주면 기대도수만 남는다.
\(\delta^2 = (11135/99)^2 = 12650.5688\) 이므로 네 기여는 이 한 수를 기대도수로 나눈 것이다.
더하면 \(263.05\) 다. 기대가 작은 칸에서 같은 크기의 이탈이 더 크게 친다. 기대도수가 가장 작은 칸이 "여성 생존"(120.53)이고, 그 칸의 기여가 가장 크다.
(3) 수치적으로.
# 칸마다 (관측-기대)^2 / 기대 를 구해 더한다. 그것이 전부다.
cells = (tab - exp) ** 2 / exp
print("칸별 기여도")
print(cells.round(2).to_string())

chi2_stat = cells.values.sum()
print(f"\nchi2 = {chi2_stat:.4f}")

# 기여도가 큰 칸부터 본다. 어디서 독립이 깨졌는지 알려 준다.
flat = cells.stack().sort_values(ascending=False)
print("\n기여도가 큰 칸부터")
for (s, surv), v in flat.items():
    obs_v = tab.loc[s, surv]
    exp_v = exp.loc[s, surv]
    mark = "관측이 많다" if obs_v > exp_v else "관측이 적다"
    print(f"  {s:6s} 생존={surv}  기여 {v:6.2f}  "
          f"({obs_v:3d} 대 {exp_v:6.2f}, {mark})")
칸별 기여도
Survived      0       1
Sex
female    65.39  104.96
male      35.58   57.12

chi2 = 263.0506

기여도가 큰 칸부터
  female 생존=1  기여 104.96  (233 대 120.53, 관측이 많다)
  female 생존=0  기여  65.39  ( 81 대 193.47, 관측이 적다)
  male   생존=1  기여  57.12  (109 대 221.47, 관측이 적다)
  male   생존=0  기여  35.58  (468 대 355.53, 관측이 많다)
\(\chi^2=263.05\)이고 자유도는 1이다. 유의수준 0.05에서 기각역의 경계는 \(\chi^2_{0.05}(1)=3.8415\)이므로, 관측값은 임계값의 68배다. (1)의 유리수 \(110473508475/419970604 = 263.050574\) 와 출력의 263.0506 이 맞는다.
기여도가 가장 큰 칸은 "여성 생존"(104.96)이다. 네 칸의 "관측 \(-\) 기대"는 모두 112.47로 같은데 기여도가 다른 이유는 (2)에서 본 대로 기대도수로 나누기 때문이다. 출력의 네 기여에 각각 그 칸의 기대도수를 곱해 보면 \(104.96 \times 120.53\), \(65.39 \times 193.47\), \(57.12 \times 221.47\), \(35.58 \times 355.53\) 이 모두 \(12650.6\) 근처로 같은 수가 나온다. 그것이 \(\delta^2\) 이다.
보기 3. scipy 와 예이츠 연속성 보정. 예이츠 보정은 각 칸의 이탈 \(\lvert O_{ij} - E_{ij}\rvert\) 에서 \(0.5\) 를 깎은 뒤 계산한다.
(1) 보기 1 에서 네 이탈이 모두 같았으므로 보정된 통계량에도 닫힌 꼴이 있다. 그 꼴을 구하고, 보정 전후의 비를 \(\Delta\) 와 \(n\) 만으로 적으시오.
(2) 이 표의 보정값을 손으로 구하시오. (1)의 비는 \(n\) 이 커질 때 어떻게 되는가.
(3) scipy.stats.chi2_contingency 의 기본값이 correction=True 인 것이 왜 함정인지, 그리고 이 자료에서 보정이 거의 영향을 주지 않는 까닭을 말하시오.
풀이
(1) 보정에도 닫힌 꼴이 있다. 보정된 통계량은
이다. 보기 1 에서 네 이탈의 절댓값이 모두 \(\lvert\delta\rvert = \lvert\Delta\rvert/n\) 로 같았으므로 괄호 안이 네 칸에서 똑같은 수가 되고, 보기 2 의 셈이 그대로 되풀이된다.
보기 2 의 식과 견주면 \(\lvert\Delta\rvert\) 가 \(\lvert\Delta\rvert - n/2\) 로 바뀐 것뿐이다. 그러므로 두 통계량의 비가 깔끔하게 적힌다.
(2) 수를 넣는다. \(\lvert\Delta\rvert = 100215\), \(n/2 = 445.5\) 이므로
\(n\) 이 커지면 비가 1 로 간다. 비율을 고정한 채 표를 \(\lambda\) 배 키우면 네 칸이 모두 \(\lambda\) 배이므로 \(\Delta\) 는 \(\lambda^2\) 배, \(n\) 은 \(\lambda\) 배가 된다. 따라서 \(n/(2\lvert\Delta\rvert)\) 는 \(1/\lambda\) 규모로 줄어들고 보정의 몫도 그만큼 사라진다. 예이츠 보정은 작은 표의 이야기다.
(3) 수치적으로.
from scipy.stats import chi2_contingency
from scipy.stats import chi2 as chi2_dist

# scipy 의 기본값은 correction=True 이며, 2x2 표에만 예이츠 보정을 건다.
# 2x2 를 다룰 때 이 기본값을 모르면 손계산과 답이 어긋난다.
for flag in [False, True]:
    res = chi2_contingency(tab, correction=flag)
    label = "보정 없음" if not flag else "보정 있음(scipy 기본값)"
    print(f"{label:22s} chi2 = {res.statistic:8.4f}   "
          f"p = {res.pvalue:.4e}")

print(f"\n정의대로 구한 값        chi2 = {chi2_stat:8.4f}")
print(f"임계값 chi2_0.05(1)     {chi2_dist.ppf(0.95, 1):.4f}")
print(f"p값을 직접 구하면       {chi2_dist.sf(chi2_stat, 1):.4e}")

# 보정은 각 칸의 이탈을 0.5 만큼 줄인 뒤 계산한다.
yates = ((tab - exp).abs() - 0.5) ** 2 / exp
print(f"\n손으로 건 예이츠 보정   {yates.values.sum():.4f}")
보정 없음                  chi2 = 263.0506   p = 3.7117e-59
보정 있음(scipy 기본값)       chi2 = 260.7170   p = 1.1974e-58

정의대로 구한 값        chi2 = 263.0506
임계값 chi2_0.05(1)     3.8415
p값을 직접 구하면       3.7117e-59

손으로 건 예이츠 보정   260.7170
보정 없는 값이 보기 2의 손계산과 정확히 맞는다. scipy 의 기본값은 보정을 켜 놓은 상태이므로, 정의대로 계산한 값과 비교할 때는 correction=False를 주어야 한다. 코드의 마지막 줄에서 손으로 건 보정이 scipy 의 260.7170 과 같은 값을 주는 것도 확인된다.
(1)의 비가 실제로 맞는다. \(260.717020 / 263.050574 = 0.9911289\) 이고, 이것이 \((1 - 445.5/100215)^2\) 과 소수 일곱째 자리까지 같다. 연습문제 2 가 \(n = 20\) 까지 줄여 가며 만든 표도 같은 식으로 설명된다. 그 표의 \(n = 20\) 짜리 분할표는 \(\begin{pmatrix}2 & 5\\ 11 & 2\end{pmatrix}\) 이므로 \(\Delta = 4 - 55 = -51\) 이고
로 그 표의 35.37 과 맞는다.
예이츠 보정은 여기서 거의 영향이 없다. 263.05가 260.72로 바뀔 뿐이고 결론은 조금도 달라지지 않는다. 기대도수가 모두 120을 넘을 만큼 표본이 크기 때문이다. 보정이 의미를 갖는 것은 기대도수가 5 근처로 작아질 때이며, 그때조차 피셔의 정확검정이 더 나은 선택인 경우가 많다.
우연이라면 어디까지 갈 수 있는가
\(p=3.7\times10^{-59}\)이라는 수는 너무 작아서 감이 오지 않는다. 직접 우연을 만들어 보면 이 수가 무슨 뜻인지 눈으로 볼 수 있다.
생존 여부를 성별과 무관하게 무작위로 다시 나눠 준다. 살아남은 사람은 여전히 342명이고, 그것이 누구인지만 우연에 맡기는 것이다. 이것이 \(H_0\)가 참인 세계다.
보기 4. 무작위로 뒤섞어 본 귀무분포. 주변합 \(891,\ 314,\ 342\) 를 고정한 채 생존자 342 명을 성별과 무관하게 다시 고른다. 여성 생존자 수를 \(A\) 라 한다(코드의 a).
(1) \(A\) 는 어떤 분포를 따르는가. 평균과 표준편차를 구하고, 관측값 \(233\) 이 평균에서 몇 표준편차인지 구하시오.
(2) 보기 2 의 닫힌 꼴을 \(A\) 로 다시 적으면
가 됨을 보이시오. 기준분포가 왜 \(\chi^2_1\) 인지에 대한 답이 이 식이다.
(3) (2)에서 귀무분포의 평균이 정확히 \(n/(n-1)\) 임이 따라 나온다. 1 만 번 뒤섞은 모의값과 맞춰 보시오. 분산은 전수 열거로 정확히 구해 견주시오.
풀이
(1) \(A\) 는 초기하분포다. 891 명 가운데 여성이 314 명인 모집단에서 생존자 342 명을 비복원으로 고르는 것이므로, 뽑힌 342 명 중 여성의 수는 \(\text{HG}(342,\ 891,\ 314)\) 를 따른다(뽑는 수 342, 전체 891, 표시된 것 314). 거꾸로 "여성 314 명 중 생존자" 로 세어도 같은 분포다.
\(E[A]\) 가 보기 1 의 기대도수 \(E_{12} = 11932/99\) 와 같은 수라는 데 주목하라. 기대도수란 바로 이 귀무분포의 평균이다.
관측값 233 은
곧 평균에서 16.2 표준편차 떨어져 있다.
(2) \(\chi^2\) 은 \(Z^2\) 의 상수배다. 보기 1 에서 \(O_{12} - E_{12} = A - E[A]\) 이고 네 칸의 어긋남이 모두 그 크기였으므로, 보기 2 의 식은
로 다시 적힌다. 한편 초기하분포의 분산을 주변합으로 적으면 (\(n - R_1 = R_2\), \(C_1 + C_2 = n\) 을 쓴다)
이다. 두 식에 나온 주변합 덩어리가 서로 역수라서 통째로 약분된다.
따라서
이다. \(2\times2\) 카이제곱 통계량은 표준화된 초기하 편차의 제곱이다(\(n/(n-1)\) 배만 붙는다). \(n\) 이 크면 \(A\) 가 정규분포에 가까워지므로 \(Z^2\) 이 \(\chi^2_1\) 에 가까워진다. 기준분포가 자유도 1 인 카이제곱인 까닭이 여기 있다.
관측값으로 확인한다. \(\frac{891}{890}\times 16.2097^2 = 1.0011236 \times 262.7554 = 263.0506\) 으로 보기 2 의 값과 같다.
(3) 귀무분포의 평균. \(E[Z^2] = 1\) 이므로 (2)에서 곧바로
이 나온다. 분산은 \(\operatorname{Var}(\chi^2) = (n/(n-1))^2\bigl(E[Z^4]-1\bigr)\) 인데 초기하분포의 네 번째 적률은 닫힌 꼴이 지저분하다. 대신 \(A\) 가 취할 수 있는 값이 \(0\) 부터 \(314\) 까지 유한하므로 전수 열거로 정확히 구할 수 있다. 뒤섞어 본 뒤에 그렇게 한다.
뒤섞는다.
import numpy as np

rng = np.random.default_rng(0)

n, n_f, n_s = 891, 314, 342          # 전체, 여성, 생존자

def chi2_2x2(a):
    """여성 생존자 수 a 하나로 2x2 표가 결정된다 (주변합이 고정되어 있으므로)."""
    b = n_f - a                      # 여성 사망
    c = n_s - a                      # 남성 생존
    d = n - n_f - c                  # 남성 사망
    return n * (a * d - b * c) ** 2 / (n_f * (n - n_f) * n_s * (n - n_s))

obs = chi2_2x2(233)
print(f"관측 chi2 = {obs:.4f}  (여성 생존자 233명)")

# 생존자 342명을 성별과 무관하게 다시 고른다. 이것이 H0 가 참인 세계다.
B = 10000
is_female = np.zeros(n, dtype=bool)
is_female[:n_f] = True

a_perm = np.empty(B, dtype=int)
for i in range(B):
    survivors = rng.permutation(n)[:n_s]
    a_perm[i] = is_female[survivors].sum()

stats = chi2_2x2(a_perm)

print(f"\n재표본 {B}회")
print(f"  여성 생존자 수  관측 233명,  재표본 {a_perm.min()}~{a_perm.max()}명")
print(f"  chi2 최댓값     {stats.max():.4f}")
print(f"  chi2 평균 {stats.mean():.4f}, 분산 {stats.var():.4f}"
      f"   (chi2(1) 이론값 1, 2)")
print(f"  관측값 이상     {(stats >= obs).sum()}회")
관측 chi2 = 263.0506  (여성 생존자 233명)

재표본 10000회
  여성 생존자 수  관측 233명,  재표본 97~146명
  chi2 최댓값     13.4943
  chi2 평균 1.0140, 분산 1.9319   (chi2(1) 이론값 1, 2)
  관측값 이상     0회
우연에 맡기면 여성 생존자는 97명에서 146명 사이에 떨어진다. 실제로는 233명이었다. 1만 번을 뒤섞어도 200명 근처에조차 가지 못한다. (1)에서 구한 \(Z = 16.21\) 이 그 거리다.
\(\chi^2\)로 보면 더 분명하다. 우연이 만들어 낸 가장 극단적인 표의 \(\chi^2\)가 13.49인데, 관측값은 263.05다. 20배 가까이 떨어져 있다.
이제 (3)을 확인한다. \(A\) 의 분포를 전수 열거해 \(\chi^2\) 의 정확한 평균과 분산을 구하고 모의값과 맞춘다.
import numpy as np
from scipy.stats import hypergeom

n, R1, R2, C1, C2 = 891, 314, 577, 549, 342     # 전체, 여성, 남성, 사망, 생존

A = np.arange(0, R1 + 1)             # 여성 생존자 수가 취할 수 있는 모든 값
pmf = hypergeom.pmf(A, n, C2, R1)    # 전체 n, 표시된 것 C2, 뽑는 수 R1

mu = R1 * C2 / n
var = R1 * R2 * C1 * C2 / (n ** 2 * (n - 1))
const = n ** 3 / (R1 * R2 * C1 * C2)
chis = const * (A - mu) ** 2         # 보기 2 의 닫힌 꼴을 A 로 적은 것

m1 = (pmf * chis).sum()                      # 평균
m2 = (pmf * (chis - m1) ** 2).sum()          # 분산
m4 = (pmf * (chis - m1) ** 4).sum()          # 네 번째 중심적률

print(f"확률의 총합      {pmf.sum():.12f}")
print(f"E[A] = {mu:.4f},  sd(A) = {np.sqrt(var):.4f}")
print(f"Var(A) * const = {var * const:.7f}   이론 n/(n-1) = {n / (n - 1):.7f}")
print(f"정확한 평균 {m1:.7f}   모의 1.0140   오차 {np.sqrt(m2 / 10000):.4f}"
      f"   차이/오차 {abs(1.0140 - m1) / np.sqrt(m2 / 10000):.2f}")
print(f"정확한 분산 {m2:.7f}   모의 1.9319   오차 "
      f"{np.sqrt((m4 - m2 ** 2) / 10000):.4f}   차이/오차 "
      f"{abs(1.9319 - m2) / np.sqrt((m4 - m2 ** 2) / 10000):.2f}")
print(f"E[Z^4] = {m2 / (n / (n - 1)) ** 2 + 1:.4f}   (정규분포라면 3)")
출력:
확률의 총합      1.000000000000
E[A] = 120.5253,  sd(A) = 6.9387
Var(A) * const = 1.0011236   이론 n/(n-1) = 1.0011236
정확한 평균 1.0011236   모의 1.0140   오차 0.0141   차이/오차 0.91
정확한 분산 2.0009729   모의 1.9319   오차 0.0747   차이/오차 0.93
E[Z^4] = 2.9965   (정규분포라면 3)
(2)에서 유도한 \(\operatorname{Var}(A)\cdot n^3/(R_1R_2C_1C_2) = n/(n-1)\) 이 소수 일곱째 자리까지 맞는다. 평균의 정확한 값은 \(1.0011236\) 이고 모의값 \(1.0140\) 은 몬테카를로 오차의 \(0.91\) 배 떨어져 있다. 분산의 정확한 값은 \(2.0009729\) 이고 모의값 \(1.9319\) 는 오차의 \(0.93\) 배다. 둘 다 어긋난 것이 아니다.
"\(\chi^2(1)\) 이론값 1, 2" 라 적은 것은 어림이다. 정확한 값은 평균 \(n/(n-1) = 1.0011\), 분산 \(2.0010\) 이다. \(E[Z^4] = 2.9965\) 가 정규분포의 \(3\) 에 못 미치는 만큼 분산도 \(2\,(n/(n-1))^2 = 2.0045\) 보다 조금 작다. 어느 쪽이든 \(n = 891\) 에서는 소수 셋째 자리의 이야기이고, 뒤섞기만으로 \(\chi^2(1)\) 표본분포가 재현된다는 것이 요점이다.
\(p=3.7\times10^{-59}\)은 이 그림의 요약이다. 우연으로는 여기까지 올 길이 없다는 뜻이다.
그림으로 보는 같은 이야기
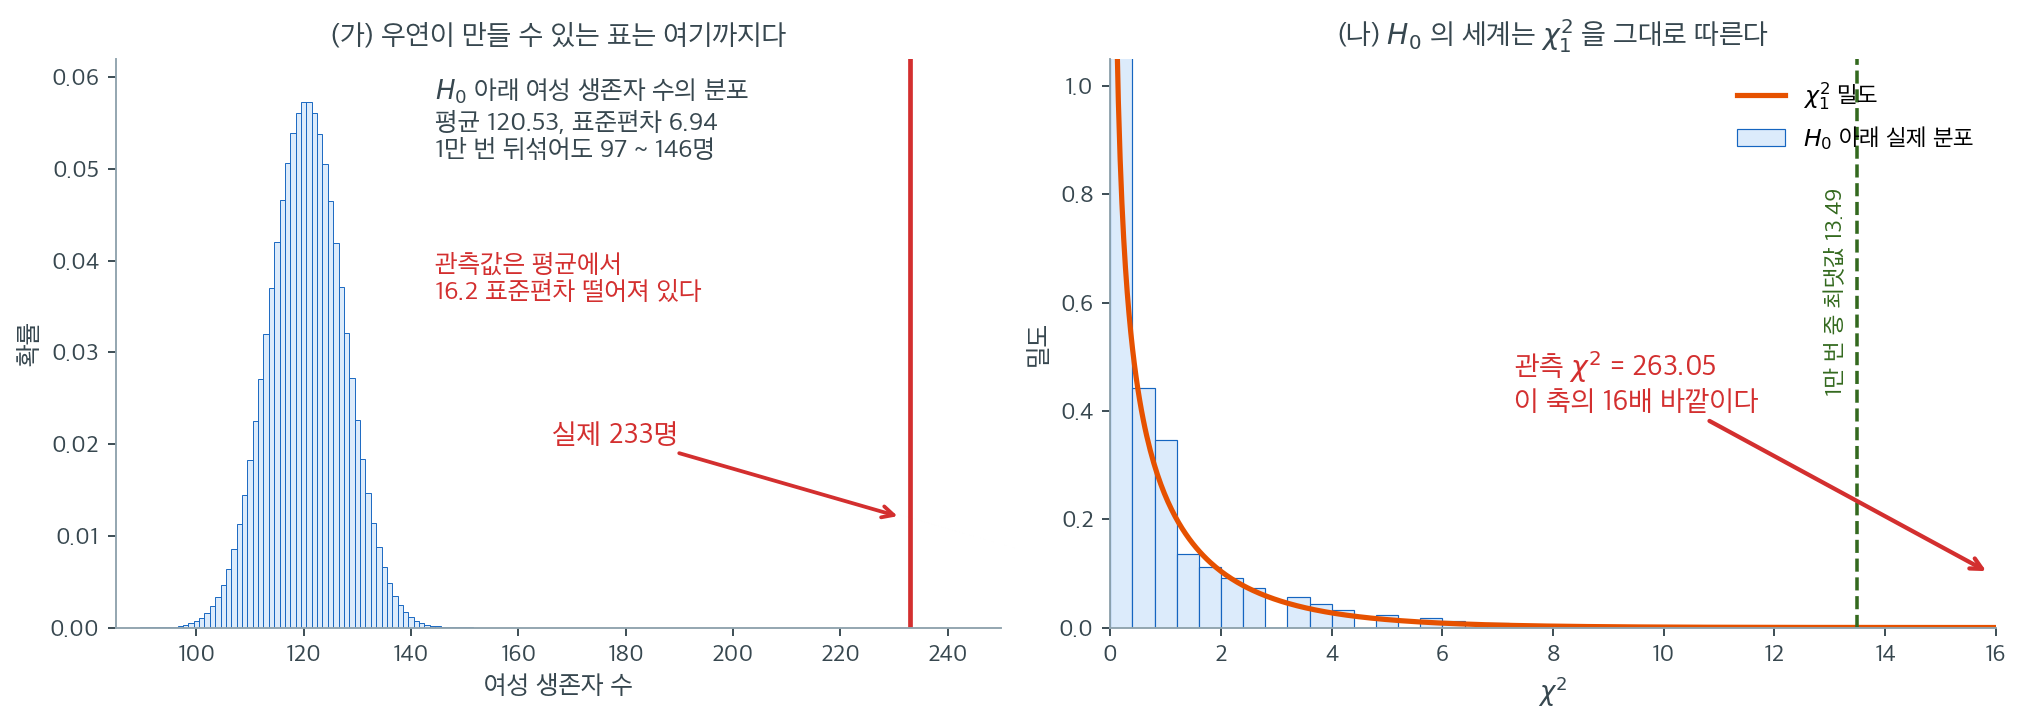
왼쪽 (가)가 \(H_0\)의 세계다. 주변합 891, 314, 342를 고정한 채 생존자를 무작위로 고르면 여성 생존자 수는 초기하분포를 따르고, 평균은 \(314 \times 342 / 891 = 120.53\), 표준편차는 6.94다. 그림의 파란 봉우리 전체가 100에서 145 사이에 들어간다. 1만 번 뒤섞은 결과가 97~146이었던 것과 정확히 맞는다.
실제 값 233은 그 봉우리에서 한참 오른쪽, 그림의 거의 끝에 있다. 평균에서 \((233 - 120.53)/6.94 = 16.2\) 표준편차 떨어진 위치다. 정규분포에서 3 표준편차만 나가도 드물다고 하는데 16.2다. \(p = 3.7 \times 10^{-59}\)이라는 수가 감이 오지 않는다면, 봉우리와 빨간 선 사이의 저 텅 빈 공간이 그 수의 뜻이라고 생각하면 된다.
오른쪽 (나)는 같은 뒤섞기를 \(\chi^2\) 척도로 옮긴 것이다. 파란 막대가 \(H_0\) 아래 실제 분포이고 주황 곡선이 \(\chi^2_1\) 밀도인데, 둘이 거의 완전히 겹친다. 재표본의 평균 1.01과 분산 1.93이 이론값 1, 2에 맞는다는 말이 이 겹침이다. 기대도수가 모두 120을 넘을 만큼 표본이 크므로 근사가 잘 듣는 것이며, 앞의 \(p\)값을 카이제곱 분포에서 읽어도 되는 이유이기도 하다.
그런데 이 축은 16까지밖에 그리지 못했다. 1만 번 중 가장 극단적인 표조차 13.49였기 때문이다. 관측값 263.05는 이 축의 16배 바깥에 있다. 그림 두 장의 메시지는 하나다. 우연이 갈 수 있는 곳과 실제 자료가 있는 곳 사이에는 다리가 놓이지 않는다.
결론. \(\chi^2(1)=263.05\), \(p<10^{-58}\)이므로 \(H_0\)를 기각한다. 성별과 생존은 독립이 아니다.
p값이 말하지 않는 것
여기서 멈추면 안 된다. \(p\)값은 "우연으로 보기 어려운가"에만 답하고, "얼마나 차이 나는가"에는 답하지 않기 때문이다.
보기 5. 효과크기는 표본 크기에 흔들리지 않는다. 타이타닉의 비율(여성 생존 \(74.20\%\), 남성 생존 \(18.89\%\), 여성 비율 \(35.24\%\))을 그대로 두고 전체 인원 \(n\) 만 20 부터 5,000 까지 바꾼다.
(1) 보기 2 의 닫힌 꼴에서 \(\chi^2 = n\varphi^2\) 이 따라 나옴을 보이고, \(\varphi\) 가 비율만의 함수임을 확인하시오. 표를 만들어 수로 확인하시오.
(2) 거꾸로 묻는다. 효과크기가 \(\varphi\) 일 때 \(\alpha = 0.05\) 에서 유의해지려면 \(n\) 이 얼마나 필요한가. 닫힌 꼴로 적고 \(\varphi = 0.543\) 과 \(\varphi = 0.0205\) 에 대해 계산하시오.
풀이
(1) \(\chi^2 = n\varphi^2\). 보기 2 의 식에서 \(n\) 하나만 밖으로 빼면 된다.
괄호 안이 파이 계수이고, 그것이 두 이분변수의 피어슨 상관계수와 같다는 것은 연습문제 3 이 대수적으로 증명한다.
\(\varphi\) 가 비율만의 함수라는 것도 이 꼴에서 바로 보인다. 네 칸을 모두 \(\lambda\) 배 하면 \(\Delta\) 는 \(\lambda^2\) 배가 되고 \(\sqrt{R_1R_2C_1C_2}\) 도 \(\lambda^2\) 배가 되므로 \(\varphi\) 는 변하지 않는다. 반면 \(\chi^2 = n\varphi^2\) 은 \(n\) 에 정비례한다. 그래서 \(\chi^2\) 과 p-값은 "표본이 얼마나 큰가" 를, \(\varphi\) 는 "효과가 얼마나 큰가" 를 말해 준다.
(2) 유의해지는 데 필요한 \(n\). \(\chi^2 = n\varphi^2 \ge \chi^2_{0.05}(1) = 3.8415\) 를 \(n\) 에 대해 풀면
이다. \(\varphi\) 의 제곱에 반비례하므로 효과가 절반이면 표본은 네 배 필요하다.
타이타닉의 \(\varphi = 0.5430\) 이면 \(n \ge 3.8415/0.29485 = 13.0\), 곧 열네 명만 있어도 유의해진다. 아래 표의 \(n = 20\) 에서 이미 \(p = 0.0122\) 인 것이 그 때문이다.
반대쪽 끝을 본다. 생존율 \(40\%\) 와 \(38\%\) 를 집단 크기가 같게 놓으면 칸 비율이 \(0.20,\ 0.30,\ 0.19,\ 0.31\) 이므로
이고 \(\varphi = 0.0205\) 로 두면 \(n \ge 3.8415/0.0205^2 = 9{,}141\) 이다. 같은 유의성을 얻는 데 표본이 700 배 필요하다. 거꾸로 \(n = 100{,}000\) 이면 \(\chi^2 = 42.0\), \(p = 9.0\times10^{-11}\) 로 실질적으로 무시해도 좋은 차이가 "압도적으로 유의" 해진다.
(1)을 수치로 확인한다.
import numpy as np
from scipy.stats import chi2_contingency

# 타이타닉의 비율(여성 74.20%, 남성 18.89%, 여성 비율 35.24%)을 그대로 두고
# 전체 인원만 바꾼다. 효과의 크기는 조금도 변하지 않는다.
f_rate, m_rate, f_share = 0.7420, 0.1889, 0.3524

print(f"{'n':>7s}{'chi2':>11s}{'p':>12s}{'phi':>9s}"
      f"{'생존율 차':>11s}{'유의':>7s}")
for n_tot in [20, 50, 100, 300, 891, 5000]:
    nf = round(n_tot * f_share); nm = n_tot - nf
    fs = round(nf * f_rate);     ms = round(nm * m_rate)
    T = np.array([[nf - fs, fs], [nm - ms, ms]])
    res = chi2_contingency(T, correction=False)
    phi = np.sqrt(res.statistic / n_tot)
    diff = fs / nf - ms / nm
    print(f"{n_tot:>7d}{res.statistic:>11.3f}{res.pvalue:>12.2e}"
          f"{phi:>9.4f}{diff:>11.4f}"
          f"{'예' if res.pvalue < 0.05 else '아니오':>7s}")
      n       chi2           p      phi      생존율 차     유의
     20      6.282    1.22e-02   0.5604     0.5604      예
     50     13.981    1.85e-04   0.5288     0.5347      예
    100     30.092    4.12e-08   0.5486     0.5582      예
    300     88.890    4.17e-21   0.5443     0.5546      예
    891    263.051    3.71e-59   0.5434     0.5531      예
   5000   1474.237    0.00e+00   0.5430     0.5528      예
효과크기는 0.55 근처에 붙박이인데 \(p\)값은 \(10^{-2}\)에서 \(10^{-59}\)까지 57자릿수를 움직인다.
\(\chi^2\) 열을 \(n\) 열로 나누면 \(\varphi^2\) 이 나온다. \(263.051/891 = 0.29523\) 과 \(1474.237/5000 = 0.29485\) 가 거의 같은 수이고, 그 제곱근이 표의 \(\varphi\) 열이다. \(\varphi\) 가 \(0.5604\) 에서 \(0.5430\) 까지 조금 흔들리는 것은 round 때문이다. \(n = 20\) 에서는 여성 7 명 중 생존 5 명처럼 정수로 끊어야 하니 \(5/7 = 0.7143\) 이 되어 \(0.7420\) 을 정확히 재현하지 못한다.
\(\varphi\)를 고정하면 \(\chi^2\)은 \(n\)을 따라 커진다. \(n=5000\)이면 \(5000\times0.5430^2\approx1474\)다.
(2)의 식도 확인한다.
import numpy as np
from scipy.stats import chi2 as chi2_dist

crit = chi2_dist.ppf(0.95, 1)
print(f"chi2_0.05(1) = {crit:.4f}")
for phi, label in [(0.5430, "타이타닉"), (0.30, "중간"),
                   (0.10, "약함"), (0.0205, "40% 대 38%")]:
    print(f"  phi = {phi:.4f} ({label:10s})  n >= {crit / phi ** 2:9.1f}")

# 40% 대 38% 짜리 효과를 큰 표본으로 재면
phi = 0.020502
print()
for n_tot in [9000, 10000, 100000]:
    chi2_v = n_tot * phi ** 2
    print(f"  n = {n_tot:>6d}   chi2 = {chi2_v:7.3f}   "
          f"p = {chi2_dist.sf(chi2_v, 1):.3e}")
출력:
chi2_0.05(1) = 3.8415
  phi = 0.5430 (타이타닉      )  n >=      13.0
  phi = 0.3000 (중간        )  n >=      42.7
  phi = 0.1000 (약함        )  n >=     384.1
  phi = 0.0205 (40% 대 38% )  n >=    9140.9

  n =   9000   chi2 =   3.783   p = 5.178e-02
  n =  10000   chi2 =   4.203   p = 4.034e-02
  n = 100000   chi2 =  42.033   p = 8.974e-11
\(n = 9{,}000\) 에서 \(p = 0.0518\), \(n = 10{,}000\) 에서 \(p = 0.0403\) 으로 임계점이 \(9{,}141\) 근처라는 것이 확인된다.
\(p\)값은 효과의 크기를 말하지 않는다
\(p=3.7\times10^{-59}\)은 "관계가 있다"는 것만 말한다. "얼마나 강한가"는 말하지 않는다.
역방향의 함정이 더 위험하다. 아주 작은 효과도 \(n\)만 크면 유의해진다. 생존율 40% 대 38%(\(\varphi=0.0205\))는 실질적으로 무시해도 좋은 차이지만, \(n=10{,}000\)이면 유의해지고 \(n=100{,}000\)이면 \(p\approx10^{-10}\)이 된다.
그러므로 검정 결과는 언제나 효과크기와 함께 보고한다.
효과크기
보기 6. 파이 계수, 위험비, 오즈비. 같은 표에서 세 가지 효과크기를 뽑는다. 여성 생존 \(a = 233\), 여성 사망 \(b = 81\), 남성 생존 \(c = 109\), 남성 사망 \(d = 468\) 로 적는다(코드와 같은 이름이다).
(1) 이 표의 위험비는 \(3.93\), 오즈비는 \(12.35\) 로 세 배 넘게 다르다. 두 값을 잇는 정확한 관계식을 세우고 유리수로 확인하시오. "몇 배 더 살아남았다" 에 해당하는 것은 어느 쪽인가.
(2) 생존율이 작을 때 두 값이 비슷해지는 까닭을 (1)의 식으로 설명하시오.
(3) \(\varphi\) 를 주변 비율로 적으면 천장이 눈에 보인다. 그 꼴을 쓰고 \(\varphi_{\max}\) 와 도달률을 구하시오.
풀이
(1) 오즈비 \(=\) 위험비 \(\times\) "살아남지 못할 확률" 의 비. 두 집단의 생존율을 \(p_1 = a/(a+b)\), \(p_2 = c/(c+d)\) 라 하면 정의에서 바로
이다. 유리수로 넣는다. \(p_1 = 233/314\), \(p_2 = 109/577\) 이므로
이고 곱하면 \(314\), \(577\) 이 약분되어
으로 정확히 맞는다.
위험비가 "몇 배 더 살아남았다" 다. 여성의 생존 확률이 남성의 \(3.93\) 배다. 오즈비 \(12.35\) 를 그렇게 옮기면 틀린다. 오즈비는 "생존 대 사망의 비" 를 다시 비교한 수다.
(2) 생존율이 작으면 보정항이 1 로 간다. (1)의 식에서 두 지표를 가르는 것은 \(\dfrac{1-p_2}{1-p_1}\) 하나다. \(p_1, p_2 \to 0\) 이면 이 항이 \(1\) 로 가므로 \(\text{OR} \approx \text{RR}\) 이다. 여기서는 \(1 - p_1 = 81/314 = 0.2580\) 이 작고 그 작은 수로 나누기 때문에 보정항이 \(3.14\) 까지 커진다. 드문 사건을 다루는 역학에서 오즈비를 위험비처럼 읽어도 되는 것은 그 항이 1 에 가까울 때뿐이다.
(3) \(\varphi\) 의 천장. \(\varphi\) 는 두 이분변수의 피어슨 상관계수이므로(연습문제 3), 생존 비율 \(\pi = 342/891 = 0.383838\), 여성 비율 \(\kappa = 314/891 = 0.352413\), "여성이고 생존" 의 비율 \(\pi_{11} = 233/891 = 0.261504\) 로 적으면
이고 \(\sqrt{\chi^2/n} = \sqrt{263.050574/891} = 0.543351\) 과 같다.
이 꼴이 천장을 바로 보여 준다. 분자의 \(\pi_{11}\) 은 \(\min(\pi, \kappa)\) 를 넘을 수 없다. "여성이고 생존" 인 사람이 여성 전체보다, 또 생존자 전체보다 많을 수는 없기 때문이다. 분모는 주변 비율만으로 정해져 있으니
이고 도달률은 \(0.543351/0.934652 = 0.5813\) 이다. 주변 비율이 더 치우치면 이 천장이 더 낮아진다는 것은 연습문제 4 가 표로 보인다.
수치적으로.
import numpy as np

a = tab.loc["female", 1]; b = tab.loc["female", 0]   # 여성 생존 / 사망
c = tab.loc["male",   1]; d = tab.loc["male",   0]   # 남성 생존 / 사망
n1, n2 = a + b, c + d
p1, p2 = a / n1, c / n2

print(f"여성 생존율 {p1:.4f} ({a}/{n1})")
print(f"남성 생존율 {p2:.4f} ({c}/{n2})")

print(f"\n비율 차이  {p1 - p2:.4f}   ({(p1 - p2) * 100:.2f}%포인트)")
print(f"위험비     {p1 / p2:.4f}배")
print(f"오즈비     {(a * d) / (b * c):.4f}")

# 파이 계수는 카이제곱을 n 으로 나눈 것의 제곱근이다.
# 2x2 에서는 Cramer 의 V 와 같은 값이 된다.
phi = np.sqrt(chi2_stat / n)
print(f"\nphi = sqrt(chi2/n) = sqrt({chi2_stat:.4f}/{n}) = {phi:.4f}")

# 주변 비율이 다르면 phi 가 1에 닿지 못한다. 도달 가능한 최댓값을 구해 둔다.
p_s = col[1] / n                 # 생존 비율
q_f = row["female"] / n          # 여성 비율
phi_max = (min(p_s, q_f) - p_s * q_f) / np.sqrt(
    p_s * (1 - p_s) * q_f * (1 - q_f))
print(f"\n생존 비율 {p_s:.4f}, 여성 비율 {q_f:.4f}")
print(f"phi_max = {phi_max:.4f},  도달률 = {phi / phi_max:.4f}")
여성 생존율 0.7420 (233/314)
남성 생존율 0.1889 (109/577)

비율 차이  0.5531   (55.31%포인트)
위험비     3.9280배
오즈비     12.3507

phi = sqrt(chi2/n) = sqrt(263.0506/891) = 0.5434

생존 비율 0.3838, 여성 비율 0.3524
phi_max = 0.9347,  도달률 = 0.5813
같은 표에서 나온 두 "배율"이 3.93과 12.35로 크게 다르다. 틀린 것이 아니라 다른 것을 재고 있다.
위험비는 확률의 비, 오즈비는 오즈의 비다. (1)에서 본 대로 둘의 비가 정확히 \(\dfrac{1-p_2}{1-p_1} = \dfrac{16328}{5193} = 3.144\) 이고, \(3.928037 \times 3.144233 = 12.350663\) 으로 출력의 12.3507 과 맞는다. 오즈비 12.35를 "12배 더 살아남았다"고 옮기면 틀린다. 생존율의 비는 3.93배다.
\(\varphi=0.5434\)는 보기 2의 \(\chi^2=263.05\)를 \(n=891\)로 나눈 것의 제곱근이며, (3)에서 주변 비율로 다시 계산한 \(0.543351\) 과 소수 여섯째 자리까지 같다. 이 값은 2장에서 구한 두 이진 변수의 피어슨 상관계수의 절댓값과 정확히 같다. 검정통계량과 상관계수가 같은 하나의 수인 셈이다.
\(\varphi\)를 읽을 때는 \(\varphi_{\max}\)를 함께 보아야 한다. 주변 비율이 치우치면 \(\varphi\)는 1에 닿지 못한다. 여기서는 \(\varphi_{\max}=0.9347\)이라 사정이 좋은 편이고, 관측값은 도달 가능한 최댓값의 58%다. 일반론은 효과크기와 Cramér의 V 절에 있다.
완전한 보고
검정, 효과크기, 신뢰구간이 모두 있어야 보고가 된다. 신뢰구간의 이론은 \(p_1-p_2\)의 신뢰구간 절에서 다루었다.
보기 7. 신뢰구간까지 붙이기. 보기 6 과 같은 이름을 쓴다(\(a = 233\), \(b = 81\), \(c = 109\), \(d = 468\), \(n_1 = 314\), \(n_2 = 577\)).
(1) 비율 차이 \(\hat p_1 - \hat p_2\) 의 표준오차를 적고 \(95\%\) 신뢰구간을 손으로 구하시오.
(2) \(\log\text{OR}\) 의 표준오차가 \(\sqrt{1/a + 1/b + 1/c + 1/d}\) 임을 델타법으로 유도하시오. 같은 방법으로 \(\log\text{RR}\) 의 표준오차가 \(\sqrt{1/a - 1/n_1 + 1/c - 1/n_2}\) 가 됨도 보이시오.
(3) 왜 위험비와 오즈비는 원 척도가 아니라 로그 척도에서 구간을 만드는가. 그 결과로 나온 구간의 비대칭에 어떤 규칙성이 있는지 수로 확인하시오.
풀이
(1) 비율 차이. 두 집단이 서로 독립이므로 분산이 더해진다.
\(z_{0.975} = 1.959964\) 이므로
(2) 델타법. 매끄러운 함수 \(g\) 에 대해 \(\operatorname{Var}\bigl(g(\hat\theta)\bigr) \approx g'(\theta)^2\operatorname{Var}(\hat\theta)\) 다.
로그 오즈. \(g(p) = \log\dfrac{p}{1-p}\) 의 도함수는 \(g'(p) = \dfrac{1}{p(1-p)}\) 이고 \(\operatorname{Var}(\hat p_1) = p_1(1-p_1)/n_1\) 이므로
여기에 \(\hat p_1 = a/n_1\), \(1 - \hat p_1 = b/n_1\) 을 넣으면 \(n_1 \hat p_1(1-\hat p_1) = ab/n_1 = ab/(a+b)\) 이므로
이다. 두 집단이 독립이라 \(\log\text{OR}\) 의 분산은 두 로그 오즈의 분산의 합이고
로그 비율. \(g(p) = \log p\) 이면 \(g'(p) = 1/p\) 이므로
이고, 더하면 \(\operatorname{SE}(\log\text{RR}) = \sqrt{1/a - 1/n_1 + 1/c - 1/n_2} = \sqrt{0.0085483} = 0.092457\) 이다.
이제 구간을 만든다. \(\log\text{OR} = \log 12.350663 = 2.513710\) 이므로
(3) 왜 로그 척도인가. 두 가지 이유다. 첫째, \(\widehat{\text{OR}}\) 의 표본분포는 \([0,\infty)\) 에 놓이고 오른쪽으로 길게 늘어져 있어 정규근사가 나쁘다. 로그를 취하면 \((-\infty,\infty)\) 로 펴지고 훨씬 정규에 가까워진다. 둘째, 원 척도에서 \(\pm z\cdot\text{SE}\) 를 쓰면 하한이 음수가 될 수 있다. 비율이나 오즈가 음수일 수는 없으므로 말이 되지 않는 구간이다.
로그 척도에서 대칭이라는 것은 원 척도에서 곱셈적으로 대칭이라는 뜻이다. \(e^{z\cdot\text{SE}} = e^{0.327663} = 1.387722\) 이므로
로 하한에 같은 수를 두 번 곱하면 점추정값과 상한이 차례로 나온다. 덧셈으로 보면 아래로 \(3.451\), 위로 \(4.789\) 라 비대칭이지만 곱셈으로 보면 양쪽이 똑같이 \(1.3877\) 배다.
수치적으로.
import numpy as np
from scipy.stats import norm

z = norm.ppf(0.975)

# (1) 비율 차이 -- 원 척도에서 대칭 구간을 쓴다.
se_d = np.sqrt(p1 * (1 - p1) / n1 + p2 * (1 - p2) / n2)
diff = p1 - p2
print(f"비율 차이 {diff:.4f},  SE {se_d:.4f}")
print(f"  95% CI [{diff - z * se_d:.4f}, {diff + z * se_d:.4f}]")

# (2) 위험비, (3) 오즈비 -- 로그 척도에서 구간을 만든 뒤 되돌린다.
# 두 비율 모두 표본분포가 오른쪽으로 치우쳐 있어 원 척도에서는 대칭이 아니다.
se_lr = np.sqrt(1 / a - 1 / n1 + 1 / c - 1 / n2)
lr = np.log(p1 / p2)
print(f"\n위험비 {np.exp(lr):.4f}")
print(f"  95% CI [{np.exp(lr - z * se_lr):.4f}, "
      f"{np.exp(lr + z * se_lr):.4f}]")

se_lo = np.sqrt(1 / a + 1 / b + 1 / c + 1 / d)
lo = np.log((a * d) / (b * c))
print(f"\n오즈비 {np.exp(lo):.4f},  log(OR) {lo:.4f},  SE {se_lo:.4f}")
print(f"  95% CI [{np.exp(lo - z * se_lo):.4f}, "
      f"{np.exp(lo + z * se_lo):.4f}]")
print(f"  로그 척도에서 [{lo - z * se_lo:.4f}, {lo + z * se_lo:.4f}] "
      f"를 지수로 되돌린 것이다")
비율 차이 0.5531,  SE 0.0296
  95% CI [0.4951, 0.6111]

위험비 3.9280
  95% CI [3.2770, 4.7084]

오즈비 12.3507,  log(OR) 2.5137,  SE 0.1672
  95% CI [8.9000, 17.1393]
  로그 척도에서 [2.1860, 2.8414] 를 지수로 되돌린 것이다
세 구간 모두 귀무값을 한참 벗어난다. (1)의 손계산 \([0.495148,\ 0.611112]\) 와 (2)의 \([8.899955,\ 17.139285]\) 가 출력의 [0.4951, 0.6111], [8.9000, 17.1393] 과 맞고, 표준오차 \(0.029583\), \(0.167178\), \(0.092457\) 도 출력의 0.0296, 0.1672 와 맞는다.
| 지표 | 추정값 | 95% 신뢰구간 | 귀무값 |
|---|---|---|---|
| 비율 차이 | 0.5531 | \([0.4951,\ 0.6111]\) | 0 |
| 위험비 | 3.9280 | \([3.2770,\ 4.7084]\) | 1 |
| 오즈비 | 12.3507 | \([8.9000,\ 17.1393]\) | 1 |
오즈비의 구간이 12.35를 가운데 두고 대칭이 아니다. 아래로 3.45, 위로 4.79다. 로그 척도에서 대칭인 구간을 지수로 되돌렸기 때문이며, (3)에서 본 대로 곱셈으로는 양쪽이 똑같이 \(1.3877\) 배다. 원 척도에서 \(\pm z\cdot\text{SE}\)를 그대로 쓰면 구간이 달라지고, 표본이 작을 때는 하한이 음수가 되어 아예 말이 안 되는 결과가 나온다.
검정과 구간이 같은 말을 한다. 구간이 귀무값을 포함하지 않는다는 것과 \(p<0.05\)라는 것은 같은 사실의 두 표현이다.
이 자료에 대한 보고는 이렇게 적는다.
타이타닉 승객 891명의 성별과 생존 (Survived, Sex 결측 없음)

  여성 74.20% (233/314) 생존
  남성 18.89% (109/577) 생존

  차이   55.31%포인트  95% CI [49.51, 61.11]
  위험비  3.93         95% CI [ 3.28,  4.71]
  오즈비 12.35         95% CI [ 8.90, 17.14]
  phi = 0.543 (phi_max = 0.935)

  카이제곱 독립성 검정: chi2(1) = 263.05, p < 1e-58
  모든 기대도수가 120 이상이어서 근사의 타당성 조건을 충족한다.

  관찰자료이며 객실 등급이 성별·생존 양쪽과 연관되어 있다.
  인과적 해석은 하지 않는다.
마지막 두 줄이 빠지면 좋은 보고가 아니다. 왜 그런지는 연습문제 5에서 확인한다.
연습문제
연습문제 1. 이 검정을 임계값 방식으로 판정하라. \(\chi^2_{0.05}(1)\)과 \(\chi^2_{0.01}(1)\)을 구하고, 관측값과 견주어라. 또 자유도가 1인 이유를 표의 칸 수와 주변합으로 설명하라.
풀이
from scipy.stats import chi2 as chi2_dist

chi2_stat = 263.0506
for alpha in [0.05, 0.01, 0.001]:
    crit = chi2_dist.ppf(1 - alpha, 1)
    print(f"alpha={alpha:<6} 임계값 {crit:7.4f}   "
          f"관측 {chi2_stat:.2f}   "
          f"{'기각' if chi2_stat > crit else '기각 못 함'}")
alpha=0.05   임계값  3.8415   관측 263.05   기각
alpha=0.01   임계값  6.6349   관측 263.05   기각
alpha=0.001  임계값 10.8276   관측 263.05   기각
어느 유의수준에서도 기각된다. 관측값이 가장 엄격한 임계값의 24배다.
자유도가 1인 이유. 표에는 칸이 넷 있지만 주변합 넷이 모두 고정되어 있다. 행 합 314와 577, 열 합 549와 342다.
여성 생존자 수를 \(a\)라고 하면 나머지 셋이 자동으로 정해진다.
자유롭게 움직일 수 있는 수가 \(a\) 하나뿐이다. 그래서 \(\text{df}=1\)이다. 일반식 \((r-1)(c-1)\)이 이것을 \(r\times c\) 표로 확장한 것이다.
보기 4의 재표본 결과가 이 사실을 보여 준다. 뒤섞기에서 기록한 것도 여성 생존자 수 하나뿐이었고, 그것만으로 \(\chi^2\)을 계산할 수 있었다. \(\square\)
연습문제 2. 보기 3에서 예이츠 연속성 보정을 손으로 계산해 scipy 와 맞추었다. 보정의 정의를 적고, 보정이 언제 중요해지는지 표본 크기를 줄여 가며 확인하라.
풀이
정의. \(2\times2\) 표에서 각 칸의 이탈을 0.5만큼 줄인 뒤 계산한다.
이산인 도수를 연속인 카이제곱분포로 근사하는 데서 오는 치우침을 줄이려는 것이다.
import numpy as np
import pandas as pd
from scipy.stats import chi2_contingency

# 타이타닉의 비율을 유지한 채 표본만 줄인다.
f_rate, m_rate, f_share = 0.7420, 0.1889, 0.3524

print(f"{'n':>6s}{'최소 기대도수':>14s}{'보정 없음':>11s}"
      f"{'보정 있음':>11s}{'차이(%)':>10s}")
for n_tot in [20, 40, 100, 300, 891]:
    nf = round(n_tot * f_share); nm = n_tot - nf
    fs = round(nf * f_rate);     ms = round(nm * m_rate)
    T = np.array([[nf - fs, fs], [nm - ms, ms]])
    r0 = chi2_contingency(T, correction=False)
    r1 = chi2_contingency(T, correction=True)
    print(f"{n_tot:>6d}{r0.expected_freq.min():>14.2f}"
          f"{r0.statistic:>11.4f}{r1.statistic:>11.4f}"
          f"{100 * (1 - r1.statistic / r0.statistic):>10.2f}")
     n       최소 기대도수      보정 없음      보정 있음     차이(%)
    20          2.45     6.2819     4.0599     35.37
    40          5.25    10.5788     8.4689     19.94
   100         13.30    30.0920    27.7692      7.72
   300         40.99    88.8899    86.5669      2.61
   891        120.53   263.0506   260.7170      0.89
보정의 효과가 \(n\)이 줄수록 커진다. \(n=891\)에서는 0.89%에 불과하지만 \(n=20\)에서는 35.4%나 깎인다.
최소 기대도수가 기준이다. \(n=20\)에서는 2.45로 5 미만이며, 바로 여기가 카이제곱 근사 자체가 흔들리는 영역이다.
그러나 보정이 해답은 아니다. 기대도수가 작을 때 예이츠 보정은 지나치게 보수적이라고 알려져 있다. 그 영역에서는 피셔의 정확검정을 쓰는 편이 낫다.
실무 권고. \(n\)이 크고 기대도수가 넉넉하면 보정 여부가 결론을 바꾸지 않으므로 고민할 필요가 없다. 작으면 보정이 아니라 정확검정으로 간다. \(\square\)
연습문제 3. \(\varphi=\sqrt{\chi^2/n}\)을 \(2\times2\) 표에서 대수적으로 증명하라. 보기 6에서 수치로만 확인했던 관계다.
풀이
표기. \(2\times2\) 표를
| \(Y=0\) | \(Y=1\) | 합 | |
|---|---|---|---|
| \(X=0\) | \(a\) | \(b\) | \(a+b\) |
| \(X=1\) | \(c\) | \(d\) | \(c+d\) |
| 합 | \(a+c\) | \(b+d\) | \(n\) |
라 두자.
1단계 — 파이 계수의 닫힌 꼴. \(X,Y\)가 0/1이므로
이고, 0/1 변수는 \(X^2=X\)이므로 \(\operatorname{Var}(X)=\bar X(1-\bar X)\)다. 따라서
분자는 \(n=a+b+c+d\)를 대입해 전개하면 교차항이 상쇄되어
분모는
이므로
2단계 — 카이제곱의 닫힌 꼴. 기대도수는 \(E_{11}=(a+b)(a+c)/n\) 등이고, 네 칸의 "관측 \(-\) 기대"가 모두 \(\pm(ad-bc)/n\)으로 같다(보기 1에서 112.47로 확인한 그 사실이다). 이를 대입해 정리하면
3단계 — 결합. 두 식을 견주면
import numpy as np
from scipy.stats import chi2_contingency

a, b = tab.loc["female", 0], tab.loc["female", 1]
c, d = tab.loc["male",   0], tab.loc["male",   1]
n_ = a + b + c + d

denom = (a + b) * (c + d) * (a + c) * (b + d)
phi_f  = (a * d - b * c) / np.sqrt(denom)
chi2_f = n_ * (a * d - b * c) ** 2 / denom

print(f"공식으로 구한 phi   {phi_f:+.6f}")
print(f"공식으로 구한 chi2  {chi2_f:.6f}")
print(f"scipy chi2          "
      f"{chi2_contingency(tab, correction=False).statistic:.6f}")
print(f"n * phi^2           {n_ * phi_f ** 2:.6f}")
공식으로 구한 phi   -0.543351
공식으로 구한 chi2  263.050574
scipy chi2          263.050574
n * phi^2           263.050574
소수점 여섯 자리까지 맞는다.
\(\varphi\)의 부호는 표의 행·열 순서가 정한다. 여기서는 행이 female부터라 음수가 나왔다. \(\chi^2\)은 제곱이라 부호를 잃으므로, \(\sqrt{\chi^2/n}\)으로는 크기만 얻고 방향은 따로 정해야 한다. \(\square\)
연습문제 4. \(\varphi\)가 \(\pm1\)에 도달하지 못하는 경우가 있다. \(\varphi_{\max}\)가 주변 비율에 따라 어떻게 변하는지 보이고, 이 때문에 서로 다른 표의 \(\varphi\)를 견주는 것이 왜 위험한지 설명하라.
풀이
행 비율 \(p\), 열 비율 \(q\)가 고정되어 있을 때 겹침을 최대로 하면
import numpy as np

def phi_max(p, q):
    return (min(p, q) - p * q) / np.sqrt(p * (1 - p) * q * (1 - q))

print(f"{'p':>6s}{'q':>6s}{'phi_max':>10s}")
for pp, qq in [(0.50, 0.50), (0.38, 0.35), (0.50, 0.35),
               (0.50, 0.10), (0.10, 0.90), (0.05, 0.50)]:
    print(f"{pp:>6.2f}{qq:>6.2f}{phi_max(pp, qq):>10.4f}")

print(f"\n타이타닉 p=0.3838, q=0.3524 -> "
      f"phi_max = {phi_max(0.3838, 0.3524):.4f}")
print(f"관측 |phi| = 0.5434,  도달률 = "
      f"{0.5434 / phi_max(0.3838, 0.3524):.4f}")

# 연관의 '세기'(오즈비)는 같은데 주변 비율만 다른 두 표
print("\n오즈비는 같고 주변 비율만 다를 때")
print(f"{'표':>16s}{'phi':>9s}{'OR':>9s}")
for lab, T in [("균형 (50/50)", np.array([[40, 10], [10, 40]])),
               ("한쪽이 드묾",  np.array([[80, 20], [ 2,  8]]))]:
    a, b, c, d = T[0, 0], T[0, 1], T[1, 0], T[1, 1]
    phi = (a * d - b * c) / np.sqrt(
        (a + b) * (c + d) * (a + c) * (b + d))
    print(f"{lab:>16s}{phi:>9.4f}{a * d / (b * c):>9.4f}")
     p     q   phi_max
  0.50  0.50    1.0000
  0.38  0.35    0.9373
  0.50  0.35    0.7338
  0.50  0.10    0.3333
  0.10  0.90    0.1111
  0.05  0.50    0.2294

타이타닉 p=0.3838, q=0.3524 -> phi_max = 0.9347
관측 |phi| = 0.5434,  도달률 = 0.5814

오즈비는 같고 주변 비율만 다를 때
               표      phi       OR
      균형 (50/50)   0.6000  16.0000
          한쪽이 드묾   0.3960  16.0000
\(p=q\)일 때만 \(\varphi_{\max}=1\)이다.
타이타닉은 사정이 좋은 경우다. 생존 비율 0.384와 여성 비율 0.352가 가까워 \(\varphi_{\max}=0.935\)로 1에 가깝다. 그래서 \(\varphi=0.543\)을 거의 액면 그대로 읽어도 큰 무리가 없다.
\(p=0.1\), \(q=0.9\)라면 사정이 전혀 다르다. 두 변수가 완벽하게 연관되어도 \(\varphi\)가 0.111을 넘을 수 없다. 이때 \(\varphi=0.09\)를 "약한 연관"이라 부르면 완전히 틀린 해석이다. 도달률로는 81%다.
그래서 표들 사이의 비교에는 오즈비를 쓴다. 마지막 출력에서 두 표의 오즈비는 16으로 같은데 \(\varphi\)는 0.600과 0.396으로 다르다. 주변 비율이 치우친 쪽에서 \(\varphi\)가 눌린 것이다.
권고. 하나의 표를 묘사할 때는 비율 차이를, 여러 표의 연관 강도를 비교할 때는 오즈비를 쓴다. \(\varphi\)나 Cramér의 \(V\)를 보고할 때는 주변 비율을 함께 밝힌다. 자세한 논의는 효과크기와 Cramér의 V 절에 있다. \(\square\)
연습문제 5.
객실 등급(Pclass)으로 층화해 검정을 다시 하라. 성별의 효과가 세 등급에서 모두 살아남는가? 전체 오즈비와 층별 오즈비를 견주고, 그 차이를 설명하라.
풀이
import numpy as np
import pandas as pd
from scipy.stats import chi2_contingency

print("전체 (등급 무시)")
fr = 233 / 314; mr = 109 / 577
print(f"  여성 {fr:.4f}  남성 {mr:.4f}  "
      f"차이 {fr - mr:+.4f}  OR 12.3507  chi2 263.05")

print("\n등급별")
print(f"{'등급':>5s}{'n':>6s}{'여성 생존율':>12s}{'남성 생존율':>12s}"
      f"{'차이':>9s}{'오즈비':>10s}{'chi2':>10s}{'p':>12s}")
for pc in [1, 2, 3]:
    s = df[df["Pclass"] == pc]
    t = pd.crosstab(s["Sex"], s["Survived"])
    f_ = t.loc["female", 1] / t.loc["female"].sum()
    m_ = t.loc["male",   1] / t.loc["male"].sum()
    orr = (t.loc["female", 1] * t.loc["male", 0]) / \
          (t.loc["female", 0] * t.loc["male", 1])
    r = chi2_contingency(t, correction=False)
    print(f"{pc:>5d}{len(s):>6d}{f_:>12.4f}{m_:>12.4f}"
          f"{f_ - m_:>+9.4f}{orr:>10.4f}"
          f"{r.statistic:>10.4f}{r.pvalue:>12.2e}")

print("\n등급 자체의 효과 (성별 무시)")
print(f"{'등급':>5s}{'생존율':>10s}{'여성 비율':>11s}")
for pc in [1, 2, 3]:
    s = df[df["Pclass"] == pc]
    print(f"{pc:>5d}{s['Survived'].mean():>10.4f}"
          f"{(s['Sex'] == 'female').mean():>11.4f}")
전체 (등급 무시)
  여성 0.7420  남성 0.1889  차이 +0.5531  OR 12.3507  chi2 263.05

등급별
   등급     n      여성 생존율      남성 생존율       차이       오즈비      chi2           p
    1   216      0.9681      0.3689  +0.5992   51.9037   81.7530    1.54e-19
    2   184      0.9211      0.1574  +0.7636   62.4510  104.3632    1.68e-24
    3   491      0.5000      0.1354  +0.3646    6.3830   73.6556    9.30e-18

등급 자체의 효과 (성별 무시)
   등급       생존율      여성 비율
    1    0.6296     0.4352
    2    0.4728     0.4130
    3    0.2424     0.2933
성별의 효과가 세 등급 모두에서 살아남는다. 세 층 모두 \(p<10^{-17}\)이고 방향이 뒤집히지 않으므로 심슨의 역설은 일어나지 않았다.
| 등급 | 여성 | 남성 | 차이 | 오즈비 |
|---|---|---|---|---|
| 1 | 0.9681 | 0.3689 | \(+0.599\) | 51.90 |
| 2 | 0.9211 | 0.1574 | \(+0.764\) | 62.45 |
| 3 | 0.5000 | 0.1354 | \(+0.365\) | 6.38 |
| 전체 | 0.7420 | 0.1889 | \(+0.553\) | 12.35 |
1·2등실의 층별 오즈비가 전체 오즈비보다 훨씬 크다. 51.90, 62.45인데 전체는 12.35다. 이것이 비붕괴성(non-collapsibility)이다. 전체 오즈비는 층별 오즈비들의 평균이 아니다.
등급이 교란변수 노릇을 한다. 아래 출력이 그 연결을 보여 준다.
3등실:  생존율 0.2424 (가장 낮음),  여성 비율 0.2933 (가장 낮음)
1등실:  생존율 0.6296 (가장 높음),  여성 비율 0.4352 (가장 높음)
등급이 성별과 생존 양쪽에 연결되어 있으므로, 전체 오즈비 12.35는 성별의 효과와 등급의 효과가 섞인 값이다.
차이 척도로 보면 이야기가 또 다르다. 1·2등실에서는 차이가 0.60, 0.76인데 3등실은 0.36이다. 효과가 층에 따라 달라지는 것이며, 이것은 교란이 아니라 상호작용이다. 1·2등실 여성은 거의 전원(97%, 92%) 살아남았지만 3등실 여성은 절반이었다.
결론. 검정은 세 층에서 모두 \(H_0\)를 기각한다. 그러나 하나의 오즈비로 요약하면 층마다 효과가 다르다는 사실을 잃는다. 층화에서 방향까지 뒤집히는 경우가 심슨의 역설이며 생태학적 상관 절에서 다룬다. \(\square\)
연습문제 6. 이 자료에 피셔의 정확검정을 적용하고 카이제곱 검정과 비교하라. 두 방법이 각각 무엇을 계산하는지, 이 자료에서 어느 쪽을 써야 하는지 답하라.
풀이
from scipy.stats import fisher_exact, chi2_contingency

# 행·열 순서를 [생존, 사망] x [여성, 남성] 으로 맞춰 오즈비 방향을 정한다.
T = [[233, 81],       # 여성 생존, 여성 사망
     [109, 468]]      # 남성 생존, 남성 사망
res_f = fisher_exact(T)
res_c = chi2_contingency(T, correction=False)

print(f"피셔 정확검정   OR = {res_f[0]:.4f}   p = {res_f[1]:.4e}")
print(f"카이제곱 검정   chi2 = {res_c.statistic:.4f}   "
      f"p = {res_c.pvalue:.4e}")
print(f"\n최소 기대도수 {res_c.expected_freq.min():.2f}")
피셔 정확검정   OR = 12.3507   p = 6.4639e-60
카이제곱 검정   chi2 = 263.0506   p = 3.7117e-59

최소 기대도수 120.53
두 \(p\)값이 모두 \(10^{-59}\) 수준이고 결론이 같다.
계산하는 것이 다르다.
| 피셔의 정확검정 | 카이제곱 검정 | |
|---|---|---|
| 방식 | 주변합을 고정하고 가능한 표를 모두 세어 확률을 더한다 | \(\chi^2(1)\) 근사를 쓴다 |
| 표본분포 | 초기하분포 (정확) | 카이제곱분포 (근사) |
| 조건 | 없음 | 기대도수가 충분히 커야 한다 |
| 비용 | 표가 크면 계산이 무겁다 | 가볍다 |
보기 4의 재표본 실험이 사실 피셔의 논리였다. 주변합을 고정한 채 표를 다시 뽑았기 때문이다. 다만 거기서는 1만 번을 뽑아 근사했고, 피셔의 정확검정은 그 확률을 직접 계산한다.
이 자료에서는 어느 쪽이든 좋다. 최소 기대도수가 120.53이라 근사가 매우 정확하기 때문이다. 두 \(p\)값이 한 자릿수 안에서 다른 것은 실질적으로 아무 의미가 없다 — \(10^{-59}\)과 \(10^{-60}\)의 차이다.
정확검정이 꼭 필요한 때는 표본이 작을 때다. 어떤 기대도수가 5 미만이면 카이제곱 근사를 믿을 수 없고, 그때는 피셔를 쓴다. 자세한 내용은 피셔의 정확검정 절에 있다. \(\square\)
연습문제 7. \(\chi^2 = 263.05\)는 네 칸이 합쳐 만든 값이다. 어느 칸이 얼마나 기여했는가? 피어슨 잔차 \((O-E)/\sqrt{E}\)와 조정잔차를 각각 구하고, \(2\times2\) 표에서 조정잔차의 절댓값이 네 칸 모두 같은 이유를 설명하라.
풀이
import numpy as np, pandas as pd
from scipy import stats

URL = "https://raw.githubusercontent.com/datasciencedojo/datasets/f0ccab6a7ceafdff780052166fb6fab3311398eb/titanic.csv"
t = pd.read_csv(URL)
ct = pd.crosstab(t.Sex, t.Survived)
O = ct.values.astype(float)
chi2, p, dof, E = stats.chi2_contingency(O, correction=False)

r = (O - E) / np.sqrt(E)                       # 피어슨 잔차
n = O.sum()
rowp, colp = O.sum(1) / n, O.sum(0) / n
adj = (O - E) / np.sqrt(E * np.outer(1 - rowp, 1 - colp))   # 조정잔차

print(f"{'칸':>16}{'관측':>8}{'기대':>10}{'피어슨잔차':>12}{'조정잔차':>11}{'기여%':>9}")
for i, s in enumerate(ct.index):
    for j, c in enumerate(ct.columns):
        lab = f"{s},{'생존' if c == 1 else '사망'}"
        print(f"{lab:>16}{O[i,j]:>8.0f}{E[i,j]:>10.2f}"
              f"{r[i,j]:>12.3f}{adj[i,j]:>11.3f}{r[i,j]**2/chi2*100:>9.1f}")
출력:
               칸      관측        기대       피어슨잔차       조정잔차      기여%
       female,사망      81    193.47      -8.086    -16.219     24.9
       female,생존     233    120.53      10.245     16.219     39.9
         male,사망     468    355.53       5.965     16.219     13.5
         male,생존     109    221.47      -7.558    -16.219     21.7
기여가 가장 큰 칸은 "여성 생존"이다(\(39.9\%\)). 기대도수 \(120.53\)명에 관측 \(233\)명으로, 기대의 거의 두 배다. 그다음이 "여성 사망"(\(24.9\%\))으로, 여성 쪽 두 칸이 전체 \(\chi^2\)의 \(65\%\)를 만든다.
남성 쪽 기여가 작은 것은 \(n\)이 커서다. 남성 사망은 \(355.53\)명 기대에 \(468\)명으로 절대 차이가 \(112\)명이지만, \(\sqrt{E}\)로 나누면 여성 쪽보다 작아진다. \(\chi^2\)는 절대 차이가 아니라 기대 대비 상대 차이를 잰다.
조정잔차의 절댓값이 네 칸 모두 \(16.219\)로 같다. \(2\times2\) 표에서는 자유도가 \(1\)이기 때문이다. 주변합이 고정된 상태에서 한 칸을 정하면 나머지 셋이 자동으로 정해지므로, 네 칸의 편차는 크기가 같고 부호만 엇갈린다. 실제로 \(O - E\)가 \(-112.47, +112.47, +112.47, -112.47\)로 절댓값이 모두 같다.
조정잔차는 잔차를 그 표준오차로 나눈 것이라 근사적으로 표준정규를 따른다. \(|16.2|\)는 정규분포에서 사실상 불가능한 값이고, \(16.219^2 = 263.05 = \chi^2\)로 제곱하면 검정통계량 자체가 된다.
큰 표에서 진짜 쓸모가 생긴다. \(2\times2\)에서는 잔차가 하나의 정보를 네 번 보여 주는 셈이라 새로울 것이 없지만, \(r\times c\) 표에서는 어느 칸이 독립성을 깼는지 짚어 준다. 조정잔차의 절댓값이 \(2\)를 넘는 칸을 주목하는 것이 관례이며, 연습문제 9에서 \(3\times2\) 표에 적용한다.
연습문제 8. 연습문제 5에서 등급별로 검정을 따로 했다. 세 층을 하나의 검정으로 합치는 방법이 맨텔–헨첼이다. 맨텔–헨첼 공통 오즈비와 검정통계량을 구하고, 전체 표를 그냥 쓴 "조" 오즈비 \(12.35\)와 견주어라.
풀이
층마다 \(2\times2\) 표가 하나씩 있을 때, 각 표의 정보를 가중 결합한다. 층 \(k\)의 칸을 \(a_k\)(여성 생존), \(b_k\)(여성 사망), \(c_k\)(남성 생존), \(d_k\)(남성 사망), \(n_k\)라 하면
이다.
import numpy as np, pandas as pd
from scipy import stats

URL = "https://raw.githubusercontent.com/datasciencedojo/datasets/f0ccab6a7ceafdff780052166fb6fab3311398eb/titanic.csv"
t = pd.read_csv(URL)

num = den = 0.0
numz = denz = 0.0
print(f"{'등급':>5}{'여생':>6}{'여사':>6}{'남생':>6}{'남사':>6}{'n':>6}{'층별 OR':>10}")
for pc in (1, 2, 3):
    s = t[t.Pclass == pc]
    c = pd.crosstab(s.Sex, s.Survived)
    a, b = c.loc['female', 1], c.loc['female', 0]
    cc, d = c.loc['male', 1],   c.loc['male', 0]
    n = a + b + cc + d
    num += a * d / n
    den += b * cc / n
    r1, c1 = a + b, a + cc                       # 행합, 열합
    numz += a - r1 * c1 / n
    denz += r1 * (n - r1) * c1 * (n - c1) / (n ** 2 * (n - 1))
    print(f"{pc:>5}{a:>6}{b:>6}{cc:>6}{d:>6}{n:>6}{(a*d)/(b*cc):>10.4f}")

ct = pd.crosstab(t.Sex, t.Survived)
crude = (ct.loc['female',1] * ct.loc['male',0]) / (ct.loc['female',0] * ct.loc['male',1])
mh = numz ** 2 / denz
print(f"\n전체(조) OR   = {crude:.4f}")
print(f"맨텔-헨첼 OR  = {num/den:.4f}")
print(f"맨텔-헨첼 chi2 = {mh:.4f}   p = {stats.chi2.sf(mh, 1):.3e}")
출력:
   등급    여생    여사    남생    남사     n     층별 OR
    1    91     3    45    77   216   51.9037
    2    70     6    17    91   184   62.4510
    3    72    72    47   300   491    6.3830

전체(조) OR   = 12.3507
맨텔-헨첼 OR  = 13.7586
맨텔-헨첼 chi2 = 250.4473   p = 2.075e-56
공통 오즈비가 \(13.76\)으로 조 오즈비 \(12.35\)보다 크다. 등급을 보정하면 성별 효과가 오히려 조금 더 커진다. 등급이 성별과 생존 양쪽에 얽혀 있어(여성이 1·2등석에 더 많고, 1·2등석이 더 안전했다) 보정 전에는 효과가 약간 희석되어 있었던 것이다.
검정통계량은 \(250.45\)로 전체 표의 \(263.05\)보다 작다. 층 안에서만 비교하므로 등급이 만들던 몫을 걷어 낸 결과다. 그래도 \(p \approx 2\times10^{-56}\)이라 결론은 같다.
맨텔–헨첼을 쓸 수 있는 조건이 있다. 층별 오즈비가 서로 비슷해야 하나의 "공통 오즈비"를 말할 수 있는데, 여기서는 \(51.9\), \(62.5\), \(6.4\)로 3등석이 크게 다르다. 2장 연습문제 6에서 본 교호작용이다.
| 층별 OR | 공통 OR 을 말할 수 있나 | |
|---|---|---|
| 1·2등석 | \(51.9\), \(62.5\) | 비슷하다 |
| 3등석 | \(6.4\) | 크게 다르다 |
그래서 \(13.76\)이라는 하나의 수를 보고하는 것은 조심스럽다. 브레슬로–데이 검정 같은 동질성 검정으로 층별 오즈비가 같다고 볼 수 있는지 먼저 확인하는 것이 순서이고, 다르다면 층별로 따로 보고하는 편이 정직하다. 맨텔–헨첼은 교란을 보정하는 도구이지 교호작용을 다루는 도구가 아니다.
연습문제 9. 표를 \(2\times2\)에서 \(3\times2\)로 넓혀 객실등급과 생존의 독립성을 검정하라. 자유도가 왜 \(2\)인지 설명하고, 표준화잔차로 어느 등급이 독립성을 깼는지 짚어라. 효과크기는 \(\varphi\) 대신 무엇을 쓰는가?
풀이
import numpy as np, pandas as pd
from scipy import stats

URL = "https://raw.githubusercontent.com/datasciencedojo/datasets/f0ccab6a7ceafdff780052166fb6fab3311398eb/titanic.csv"
t = pd.read_csv(URL)
ct3 = pd.crosstab(t.Pclass, t.Survived)
c3, p3, d3, E3 = stats.chi2_contingency(ct3.values, correction=False)
print(ct3)

V = np.sqrt(c3 / (len(t) * min(ct3.shape[0] - 1, ct3.shape[1] - 1)))
print(f"\nchi2={c3:.4f}  dof={d3}  p={p3:.3e}   Cramer V={V:.4f}")

r3 = (ct3.values - E3) / np.sqrt(E3)
print("\n표준화잔차:")
for i, s in enumerate(ct3.index):
    print(f"  {s}등석: 사망 {r3[i,0]:+.3f}  생존 {r3[i,1]:+.3f}")
출력:
Survived    0    1
Pclass
1          80  136
2          97   87
3         372  119

chi2=102.8890  dof=2  p=4.549e-23   Cramer V=0.3398

표준화잔차:
  1등석: 사망 -4.602  생존 +5.831
  2등석: 사망 -1.538  생존 +1.948
  3등석: 사망 +3.994  생존 -5.060
자유도가 \(2\)인 이유. 칸이 \(6\)개지만 주변합이 고정되어 있다. 행합 \(3\)개 중 \(2\)개, 열합 \(2\)개 중 \(1\)개가 독립이고 총합까지 맞춰야 하므로, 자유롭게 정할 수 있는 칸은
개다. 연습문제 1에서 \(2\times2\)가 \((2-1)(2-1)=1\)이었던 것의 일반형이다. 실제로 왼쪽 위 두 칸을 정하면 나머지 넷이 전부 결정된다.
잔차가 이야기를 나눠 준다.
- 1등석과 3등석이 독립성을 깬다. 잔차의 절댓값이 \(4\sim5.8\)로 크다. 1등석은 생존이 기대보다 많고, 3등석은 기대보다 적다.
- 2등석은 거의 기대대로다. 잔차가 \(\pm1.5\sim1.9\)로 관례적 기준 \(2\)에 못 미친다. 2등석은 전체 평균과 비슷하게 행동했다.
\(2\times2\)에서 네 칸의 조정잔차가 모두 같았던 것(연습문제 7)과 달리, 여기서는 칸마다 값이 다르다. 자유도가 \(2\)로 늘어 정보가 하나 더 생겼기 때문이며, 이것이 큰 표에서 잔차를 보는 이유다.
효과크기는 크레이머의 \(V\)를 쓴다.
\(\varphi = \sqrt{\chi^2/n}\)는 \(2\times2\) 전용이다. 더 큰 표에서는 \(\chi^2\)가 \(n\)을 넘어설 수 있어 \(\varphi\)가 \(1\)을 초과하기 때문이다. \(\min(r-1,c-1)\)로 한 번 더 나누면 언제나 \([0,1]\)에 들어온다. 여기서는 \(\min(2,1)=1\)이라 \(V = \varphi\)와 값이 같지만, \(3\times3\) 표라면 달라진다.
\(V = 0.34\)는 성별의 \(0.54\)보다 작다. 등급도 생존을 강하게 갈랐지만 성별만큼은 아니었다는 뜻이며, 연습문제 8의 맨텔–헨첼에서 등급을 보정해도 성별 효과가 살아남은 것과 일관된다.
연습문제 10. 이 자료는 \(n = 891\)로 컸고 \(p\)값이 \(10^{-59}\)이었다. 검정력의 관점에서 뒤집어 묻자. 이 표본 크기로 얼마나 작은 효과까지 잡아낼 수 있는가? \(w = 0.1, 0.3, 0.5\)에 대해 검정력을 구하고, 검정력 \(0.8\)에 필요한 \(n\)을 각각 계산하라.
풀이
대립가설 아래에서 \(\chi^2\)는 비중심 카이제곱을 따른다. 효과크기를 \(w\)(=\(2\times2\)에서는 \(|\varphi|\))라 하면 비중심모수가 \(\lambda = nw^2\)이고, 검정력은
이다.
import numpy as np
from scipy import stats

crit = stats.chi2.ppf(0.95, 1)
print(f"{'n':>6}{'w=0.1':>10}{'w=0.3':>10}{'w=0.5':>10}")
for nn in (50, 100, 200, 500, 891):
    row = [stats.ncx2.sf(crit, 1, nn * w ** 2) for w in (0.1, 0.3, 0.5)]
    print(f"{nn:>6}{row[0]:>10.4f}{row[1]:>10.4f}{row[2]:>10.4f}")

print()
for w in (0.1, 0.3, 0.5):
    nn = 1
    while stats.ncx2.sf(crit, 1, nn * w ** 2) < 0.8:
        nn += 1
    print(f"  검정력 0.8 에 필요한 n (w={w}): {nn}")
출력:
     n     w=0.1     w=0.3     w=0.5
    50    0.1090    0.5641    0.9424
   100    0.1701    0.8508    0.9988
   200    0.2930    0.9888    1.0000
   500    0.6088    1.0000    1.0000
   891    0.8473    1.0000    1.0000

  검정력 0.8 에 필요한 n (w=0.1): 785
  검정력 0.8 에 필요한 n (w=0.3): 88
  검정력 0.8 에 필요한 n (w=0.5): 32
\(n = 891\)은 \(w = 0.1\)의 작은 효과도 \(85\%\) 확률로 잡아낸다. 관례적으로 \(w = 0.1\)을 "작은", \(0.3\)을 "중간", \(0.5\)를 "큰" 효과로 부르는데, 이 표본은 작은 효과까지 충분히 탐지한다.
관측된 \(\varphi = 0.543\)은 "큰" 효과를 한참 넘는다. \(w = 0.5\)면 \(n = 32\)만 있어도 검정력이 \(0.8\)이다. 실제로 \(891\)명이었으니 검정력이 사실상 \(1\)이었고, \(p = 3.7\times10^{-59}\)이라는 극단적인 값이 나온 것이 당연하다.
이것이 보기 5의 논점을 정량화한다. 거기서 "\(p\)값은 표본 크기에 흔들리지만 효과크기는 아니다"라고 했는데, 검정력 표가 그 이유를 보여 준다. 같은 \(w\)라도 \(n\)이 커지면 검정력이 \(1\)로 가고 \(p\)값은 \(0\)으로 간다. \(w = 0.1\)에서 \(n\)을 \(50 \to 891\)로 늘리면 검정력이 \(0.11 \to 0.85\)로 뛴다.
실무적 함의 둘.
- 큰 표본에서는 유의성이 거의 보장되므로 효과크기를 반드시 함께 보고해야 한다. \(n = 100{,}000\)이면 \(w = 0.01\)의 사소한 연관도 유의해진다.
- 작은 표본에서 유의하지 않았다면 "관계가 없다"가 아니라 "못 잡았다"일 수 있다. \(n = 50\)에서 \(w = 0.1\)의 검정력은 \(0.11\)에 불과하다. 실제로 효과가 있어도 열 번 중 아홉 번은 놓친다. 검정력을 계산하지 않고 "유의하지 않음"을 "효과 없음"으로 읽는 것이 9장에서 경고한 대표적인 오독이다. \(\square\)
정리하며
하나의 \(2\times2\) 표에 독립성 검정을 처음부터 끝까지 적용했다.
- 기대도수는 주변합에서 나온다. \(E_{ij}=(\text{행 합})(\text{열 합})/n\)이고, 여기서는 모두 120을 넘어 근사의 타당성 조건이 넉넉히 충족된다.
- \(2\times2\)의 자유도가 1인 이유는 칸 하나만 자유롭기 때문이다. 네 칸의 "관측 \(-\) 기대"가 모두 \(\pm112.47\)로 같았던 것이 그 사실의 다른 표현이다.
- 예이츠 보정은 여기서 무의미하다. 263.05가 260.72로 바뀔 뿐이다. 보정이 중요해지는 것은 기대도수가 작을 때이고, 그때는 피셔의 정확검정이 낫다.
- 뒤섞기가 \(p\)값의 뜻을 보여 준다. 1만 번 무작위로 나눠 준 결과 여성 생존자는 97~146명에 머물렀다. 실제는 233명이었다.
- \(p\)값과 효과크기는 다른 것을 잰다. \(\chi^2=n\varphi^2\)이므로 \(\varphi\)를 고정한 채 \(n\)만 키우면 \(p\)는 얼마든지 작아진다.
- 오즈비 12.35와 위험비 3.93은 다른 것이다. "12배 더 살아남았다"는 틀린 문장이다.
- 층화하면 이야기가 더 있다. 세 등급 모두 같은 방향이지만 효과의 크기는 6.4에서 62.5까지 벌어진다.
검정이 답한 것은 하나다. "우연으로 보기 어려운가" — 그렇다. 왜 그런가는 답하지 않았다. "여성과 어린이 먼저"라는 대피 관행이 작용했겠지만, 등급이 함께 움직인다는 것도 연습문제 5에서 보았다. 연관에서 인과로 넘어가는 문제는 12장에서 다룬다.
같은 계산을 여러 모집단을 견주는 설계에 적용하면 동질성 검정이 된다. 다음 절에서 다룬다.