통계 모형 대 학습 알고리즘
모수적 통계 모형에서 유연한 학습 알고리즘으로의 전환은 자료 분석에서 가장 중요한 변화 중 하나이며, 이해냐 예측이냐라는 서로 다른 목표를 반영한다.
정의 1. 통계 모형과 학습 알고리즘
통계 모형은 해석 가능한 모수로 지표화된 확률분포의 족을 지정한다(예: \(Y = \beta_0 + \beta_1 X + \varepsilon\)). 학습 알고리즘은 완전한 확률 모형을 반드시 지정하지 않은 채 자료에서 패턴을 찾아내는 계산 절차다(예: 랜덤 포레스트, 신경망).
| 측면 | 통계 모형 | 학습 알고리즘 |
|---|---|---|
| 주된 목표 | 추론과 이해 | 예측과 패턴 발견 |
| 가정 | 명시적(분포적, 구조적) | 최소한이거나 암묵적 |
| 해석가능성 | 대체로 높음(모형이 옳게 지정되었을 때 모수에 의미가 있음) | 흔히 낮음(블랙박스) |
| 자료 요구 | 작고 정형화된 자료로도 작동 | 크고 복잡한 자료에서 진가를 발휘 |
| 과적합 위험 | 낮음(모수가 적음), 대신 모형 오지정에서 오는 편향이 크다 | 높음(교차검증으로 관리) |
표의 양쪽이 각각 어디서 무너지는지도 함께 알아야 한다. 통계 모형의 해석가능성은 공짜가 아니라 조건부다. 설명변수가 서로 강하게 얽혀 있으면 계수는 표본마다 요동치고(앞 절의 공선성 그림), 같은 자료를 거의 똑같이 잘 설명하는 모형이 여럿 나와 서로 다른 "설명"을 내놓는다(연습문제 9). 반대로 학습 알고리즘이 언제나 블랙박스인 것도 아니어서, 일반화 가법 모형이나 단조 제약을 건 부스팅은 유연성을 상당 부분 지키면서 구조가 투명하다(연습문제 10).
실무에서 경계는 흐릿하다. 정칙화 회귀(LASSO, 능형회귀)는 알고리즘적 정칙화로 보강한 모형이고, 베이즈 신경망은 딥러닝과 확률적 불확실성을 결합하며, 그래디언트 부스팅은 반복적 모형 적합으로 볼 수 있다.
선택은 목표에 달려 있다. 왜 그런지 이해해야 한다면 해석 가능한 모형을 택하고, 무엇이 될지 예측해야 한다면 알고리즘이 흔히 앞선다.
보기 1. 통계 모형 대 학습 알고리즘. 참 자료생성과정이 \(y = 3 + 2x - 0.1x^2 + \varepsilon\)이고 \(x \sim U(0,10)\), \(\varepsilon \sim N(0, 2^2)\), \(n = 200\)이다. 직선과 이차식을 각각 적합한다.
(1) 직선은 참 구조를 담지 못한다. 그래도 최소제곱이 수렴하는 모집단 직선의 기울기와 절편을 구하시오.
(2) 두 모형이 남기는 모집단 MSE를 구하고, 표본 내 MSE 둘을 그것과 견주시오.
풀이
(1) 해석적으로. 모형이 틀렸어도 최소제곱은 사라지지 않는다. \(\{1, x\}\)가 뻗는 공간 위로 \(E[y \mid x]\)를 사영한 것으로 수렴하며, 그 기울기는
다. \(x \sim U(0,10)\)에서 \(\operatorname{Var}(x) = 100/12 = 8.3333\), \(E[x^2] = 33.3333\), \(E[x^3] = 250\)이므로
이고
따라서
로 정확히 1이다. 참 모형의 선형항 계수가 \(2\)인데 직선을 고집하면 \(1\)이 나온다. 이차항이 가진 "오른쪽에서 꺾여 내려가는" 몫이 기울기를 절반으로 끌어내린 것이다. 절편은
이다. 모형이 틀리면 계수가 참 계수가 아니라 사영의 계수가 된다. 모수의 해석이 모형에 달려 있다는 말의 뜻이 이것이다.
(2) 해석적으로. 이차식은 참 구조를 담으므로 남는 것이 잡음뿐이고 모집단 MSE가 \(\sigma^2 = 4\)다.
직선이 남기는 몫은 그 위에 사영 잔차의 분산이 더해진다. \(x^2\)을 \(\{1,x\}\)에 사영하면 기울기가 \(\operatorname{Cov}(x,x^2)/\operatorname{Var}(x) = 10\)이므로 잔차함수는 \(-0.1(x^2 - 10x + \text{상수})\)이고
다. 따라서 직선의 모집단 MSE는 \(4 + 0.5556 = 4.5556\)이다. 모형 오지정이 더하는 몫은 \(0.56\)으로 잡음 \(4\)의 \(14\%\)에 지나지 않는다. 두 모형의 차이가 작은 것은 이차항이 약해서다.
(1)(2) 수치적으로.
import numpy as np

np.random.seed(42)
n = 200
x = np.random.uniform(0, 10, n)

# 참 자료생성과정: 이차식이다. 우리는 이것을 알지만 모형은 모른다.
y = 3 + 2 * x - 0.1 * x**2 + np.random.normal(0, 2, n)

# === 모형 1: 단순 선형회귀 (해석하기 쉬운 통계 모형) ===
# 설계행렬 X = [1, x]. 첫 열의 1은 절편에 대응한다.
# 참 구조는 이차인데 직선으로 맞추므로 **편향**이 생긴다.
X_lin = np.column_stack([np.ones(n), x])
beta_lin = np.linalg.lstsq(X_lin, y, rcond=None)[0]   # 최소제곱해
y_pred_lin = X_lin @ beta_lin
mse_lin = np.mean((y - y_pred_lin)**2)

# === 모형 2: 이차 다항회귀 (더 유연한 모형) ===
# 설계행렬에 x^2 열을 더한다. 참 구조를 담을 수 있게 된다.
# 여전히 "선형"모형이라는 점에 주의하라. 계수에 대해 선형이면 선형모형이다.
X_poly = np.column_stack([np.ones(n), x, x**2])
beta_poly = np.linalg.lstsq(X_poly, y, rcond=None)[0]
y_pred_poly = X_poly @ beta_poly
mse_poly = np.mean((y - y_pred_poly)**2)

print(f"Linear model MSE:     {mse_lin:.3f}  (coeffs: {beta_lin.round(3)})")
print(f"Polynomial model MSE: {mse_poly:.3f}  (coeffs: {beta_poly.round(3)})")
print(f"True: y = 3 + 2x - 0.1x^2 + noise")

# --- (1)(2) 의 이론값 ---
var_x = 100 / 12
Ex2, Ex3, Ex4 = 25 + var_x, 250.0, 2000.0
cov_x_x2 = Ex3 - 5 * Ex2
slope = (2 * var_x - 0.1 * cov_x_x2) / var_x
intercept = (3 + 2 * 5 - 0.1 * Ex2) - slope * 5
var_resid = 0.01 * ((Ex4 - Ex2 ** 2) + 100 * var_x - 20 * cov_x_x2)
print(f"이론 모집단 직선: 기울기 {slope:.4f}, 절편 {intercept:.4f}")
print(f"이론 모집단 MSE: 직선 {4 + var_resid:.4f}, 이차식 {4.0:.4f}")
출력:
Linear model MSE:     4.069  (coeffs: [4.81  0.991])
Polynomial model MSE: 3.718  (coeffs: [ 3.504  1.802 -0.082])
True: y = 3 + 2x - 0.1x^2 + noise
이론 모집단 직선: 기울기 1.0000, 절편 4.6667
이론 모집단 MSE: 직선 4.5556, 이차식 4.0000
유도가 맞는다. 직선의 추정계수가 \((4.810,\ 0.991)\)로 모집단 값 \((4.6667,\ 1.0000)\) 근처에 있다. 기울기 \(0.991\)이 참 모형의 \(2\)가 아니라 사영의 \(1\)에 붙어 있다는 점이 중요하다.
이차식의 계수 \((3.504,\ 1.802,\ -0.082)\)는 참값 \((3,\ 2,\ -0.1)\) 근처다. 모형이 옳으므로 계수가 자료생성과정의 계수를 겨냥한다.
표본 내 MSE는 \(4.069\)와 \(3.718\)로 모집단 값 \(4.5556\)과 \(4.0000\)보다 둘 다 작다. 당연한 일이다. 적합에 쓴 바로 그 자료에서 쟀으므로 모수를 추정한 만큼 낙관적이고, 그 몫이 대략 \((n-p)/n\)배다. \(n = 200\)에서 MSE 추정의 표준오차가 \(\text{MSE}\sqrt{2/n} = 0.45\)와 \(0.40\)이므로 두 어긋남 모두 \(1\) 표준오차 안이다.
두 가지를 짚고 넘어가야 한다. 첫째, 여기 비교한 둘은 모두 통계 모형이다. 이차항을 넣은 쪽도 계수에 대해서는 선형이어서 계수마다 표준오차와 신뢰구간이 그대로 따라 나온다. 학습 알고리즘과의 대비는 다음 절과 연습문제 7에서 본다.
둘째, 위의 MSE는 적합에 쓴 바로 그 자료에서 잰 표본 내 값이다. 설명변수를 하나 더 넣으면 표본 내 MSE는 구조가 맞든 틀리든 반드시 줄어들므로, 이 두 숫자만으로 이차식이 낫다고 결론지을 수는 없다. 여기서 이차식의 손을 들어 주는 근거는 MSE 차이가 아니라 추정된 계수 \((3.504,\ 1.802,\ -0.082)\)가 참값 \((3,\ 2,\ -0.1)\) 근처에 있다는 사실이다. 모형을 고르는 근거로 삼을 수 있는 것은 표본 밖 오차이며, 그 이야기가 이 절의 나머지를 채운다.
훈련 구간을 벗어나면 갈린다
앞의 보기는 같은 자료에 두 모형을 얹고 적합도를 비교했다. 그런데 두 접근의 차이가 가장 또렷해지는 곳은 자료가 있는 구간이 아니라 자료가 없는 구간이다. 아래 그림은 \(x \in [0, 6]\)에서 관측값 \(150\)개를 만든 다음(잡음의 표준편차는 \(1\)), 통계 모형으로 직선을, 학습 알고리즘으로 랜덤 포레스트를 적합시키고 둘 모두에게 \(x = 12\)까지 예측하게 한 것이다. 왼쪽은 참 관계가 직선 \(y = 1 + 1.6x\)인 경우이고, 오른쪽은 참 관계가 휘는 \(y = 6\ln(1+x)\)인 경우다.
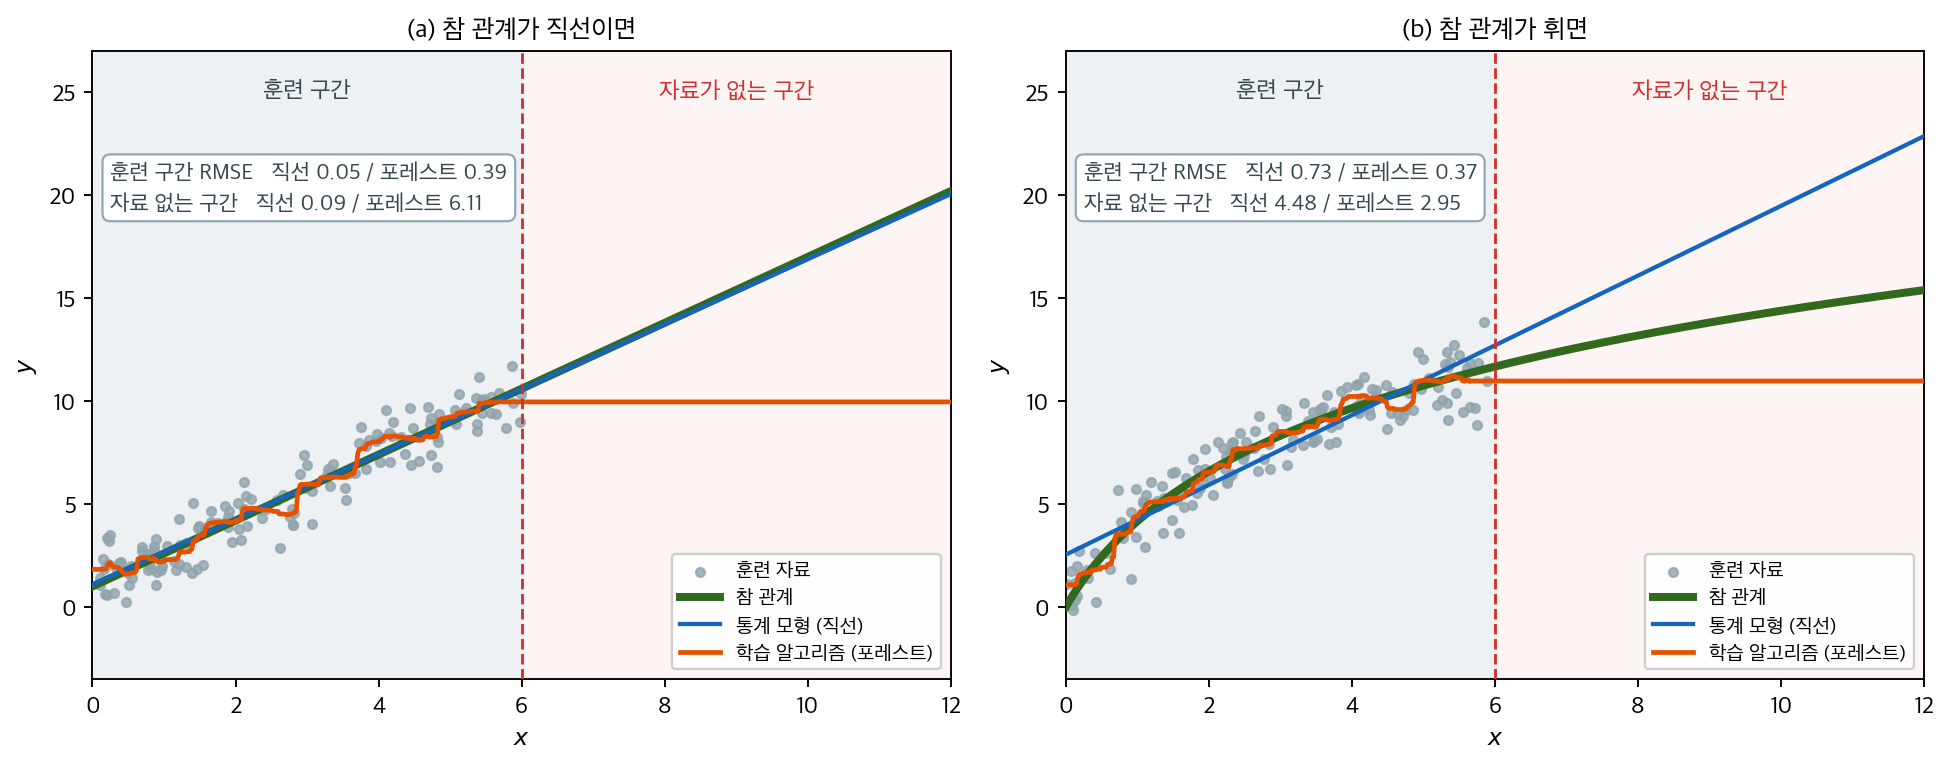
훈련 구간 안에서는 결과가 예상대로다. 참 관계가 직선이면 직선의 RMSE 가 \(0.05\), 포레스트가 \(0.39\)로 직선이 이기고, 참 관계가 휘면 \(0.73\) 대 \(0.37\)로 뒤집힌다. 가정이 맞으면 모형이, 틀리면 알고리즘이 낫다는 연습문제 7의 이야기다. 차이는 빨간 선 오른쪽에서 나온다. 직선은 기울기를 유지한 채 계속 나아가고, 포레스트는 마지막 잎의 값에서 수평으로 멈춘다. 참 관계가 직선일 때 직선은 자료 없는 구간에서도 RMSE \(0.09\)로 그대로 맞히지만 포레스트는 \(6.11\)로 무너진다. 참 관계가 휠 때는 직선이 \(4.48\)로 자신 있게 틀리고, 포레스트는 \(2.95\)로 멈춘 채 틀린다.
이 네 숫자가 말하는 것은 가정이 곧 외삽 능력이라는 사실이다. 직선을 가정하는 순간 자료가 없는 곳에 대해서도 말할 수 있게 되는데, 그 말은 가정이 맞을 때만 옳다. 포레스트는 가정을 거의 하지 않으므로 자료가 없는 곳에 대해 사실상 아무 말도 하지 않는다. 수평선은 예측이라기보다 "여기서부터는 본 적이 없다"는 표시에 가깝다. 어느 쪽이 안전한지는 통계가 아니라 용도가 정한다. 틀린 외삽의 대가가 크면 멈추는 쪽이 낫고, 자료 밖을 꼭 예측해야 하면 가정을 명시한 쪽이 낫다.
마지막으로 두 접근이 손에 쥐여 주는 물건이 다르다. 왼쪽 그림의 직선은 기울기 \(1.580\)과 \(95\%\) 신뢰구간 \([1.500,\ 1.660]\)을 내놓고, 참값 \(1.6\)이 그 안에 들어 있다. 이 숫자 하나가 결론이자 검정 대상이고, 다음 연구가 반박할 수 있는 주장이다. 포레스트에는 대응하는 숫자가 없다. 나무 \(300\)그루의 분기 규칙을 모두 적어 놓아도 "기울기"라고 부를 것이 없기 때문이다. 표 첫 줄의 "추론과 이해 대 예측과 패턴 발견"은 취향의 차이가 아니라 이 산출물의 차이다.
연습문제
연습문제 1. 선형회귀 모형은 \(\varepsilon \sim N(0, \sigma^2)\)인 \(Y = \beta_0 + \beta_1 X + \varepsilon\)을 가정한다. 랜덤 포레스트는 그런 분포 가정을 두지 않는다. 각 접근의 장점을 하나씩 설명하라.
풀이
선형회귀의 장점: 해석가능성과 추론. 계수 \(\beta_1\)은 명확한 해석을 갖고(\(X\)가 한 단위 변할 때 \(Y\)의 기대 변화량), \(\beta_1\)에 대한 신뢰구간과 가설검정을 구성할 수 있다. 이 모형은 불확실성 정량화를 틀 안에 내장하고 있다.
랜덤 포레스트의 장점: 유연성. 랜덤 포레스트는 분석가가 미리 지정하지 않아도 비선형 관계, 상호작용, 복잡한 패턴을 포착할 수 있다. \(X\)와 \(Y\)의 참된 관계가 강하게 비선형이라면, 랜덤 포레스트는 잘못 지정된 선형모형보다 대체로 더 나은 예측을 낸다.
연습문제 2. 단순한 모수적 모형과 복잡한 알고리즘적 모형 중에서 고르는 맥락에서 편향–분산 절충을 설명하라. 편향이 더 큰데도 단순한 모형을 선호하게 되는 경우는 언제인가?
풀이
편향–분산 절충은 예측오차 = 편향\(^2\) + 분산 + 줄일 수 없는 잡음이라는 것이다. 단순한 모형(예: 선형회귀)은 편향이 크지만(참된 패턴을 놓칠 수 있지만) 분산이 작다(표본이 바뀌어도 안정적이다). 복잡한 모형(예: 심층 신경망)은 편향이 작지만 분산이 크다(잡음에 과적합할 수 있다).
다음과 같을 때 단순한 모형을 선호한다.
- 표본 크기가 작을 때: 자료가 제한적이면 단순한 모형이 주는 분산 감소가 편향의 대가를 능가한다.
- 해석가능성이 요구될 때: 규제 맥락이나 과학적 맥락에서는 설명 가능한 모형이 필요할 수 있다.
- 참된 관계가 대체로 선형일 때: 자료생성 과정이 단순한 모형으로 잘 근사된다면 편향이 작고 분산 이득이 지배한다.
- 표본 내 적합보다 일반화가 중요할 때: 신호 대 잡음 비가 낮을 때는 단순한 모형이 새 자료로 더 잘 일반화되는 경향이 있다.
연습문제 3. 어떤 데이터 과학자가 만든 신경망이 훈련 자료에서 98%의 정확도를 내지만 시험 자료에서는 72%에 그친다. 이 현상을 설명하고 두 가지 해결책을 제안하라.
풀이
훈련 정확도(98%)와 시험 정확도(72%) 사이의 큰 격차는 과적합을 나타낸다. 모형이 밑바탕의 패턴을 학습한 것이 아니라 훈련 자료를(잡음까지 포함해) 외운 것이다. 본 적 있는 자료에서는 잘하지만 새 자료에서는 못한다.
두 가지 해결책:
- 정칙화: 모형 복잡도에 벌점을 부과해(예: L2 가중치 감쇠, 드롭아웃 층) 잡음을 적합하지 않도록 억제한다. 훈련 오차는 약간 늘지만 시험 성능은 좋아진다.
- 훈련 자료 확대: 자료가 많아지면 모형이 개별 보기를 외울 여지가 줄고 일반적인 패턴을 배워야 한다. 추가 자료를 구할 수 없을 때는 자료 증강이 부분적인 대안이 된다.
그 밖에 모형 복잡도 축소(층/모수 수 감소), 조기 종료, 교차검증을 통한 초모수 조정도 있다.
연습문제 4. 추론과 예측의 구분을 이용해 통계 모형과 기계학습 알고리즘의 목표를 비교하라. 각 목표가 우선인 구체적 상황을 제시하라.
풀이
추론은 변수 사이의 관계를 이해하는 것을 목표로 한다. 모수를 추정하고, 가설을 검정하고, 불확실성을 정량화한다. 예측은 모형이 해석 가능한지와 무관하게 새 관측값의 결과를 정확히 예측하는 것을 목표로 한다.
추론이 우선인 상황: 어떤 경제학자가 최저임금 인상이 고용에 미치는 효과를 연구한다. 목표는 인과 모수(예: 최저임금에 대한 고용의 탄력성)를 추정하고 그것이 통계적으로 유의한지 검정하는 것이다. 가정이 명확한 구조 모형이 필수적이다.
예측이 우선인 상황: 어떤 스트리밍 서비스가 사용자가 다음에 볼 영화를 예측하려 한다. 목표는 추천 정확도이지 사용자가 왜 그 영화를 고르는지 이해하는 것이 아니다. 모수에 해석 가능한 의미가 없더라도 복잡한 협업 필터링 알고리즘이나 딥러닝 모형이 적절하다.
현실의 많은 문제는 두 목표를 모두 포함하며, 어느 쪽에 무게를 두느냐가 적절한 도구를 결정한다.
연습문제 5. 브레이먼의 "두 문화"(2001)는 통계학자와 기계학습 연구자가 같은 자료를 서로 다른 심적 모형으로 대한다고 주장했다. 두 문화를 요약하고, 그 논문이 나온 이후 경계가 좁아졌는지 논하라.
풀이
브레이먼이 서술한 두 문화는 다음과 같다.
- 자료 모형 문화(대부분의 통계학자): 자료가 확률 모형(예: 정규 오차를 갖는 선형회귀)에서 나왔다고 가정하고, 그 모수를 추정하며, 적합된 모형으로 추론한다. 타당성은 그 모형이 대체로 옳은지에 달려 있다.
- 알고리즘 모형 문화(기계학습): 자료생성 기제를 블랙박스로 취급한다. 유연한 알고리즘을 적합시키고 떼어놓은 자료로 평가한다. 성공은 생성 모형에 대한 충실성이 아니라 예측 정확도로 측정된다.
브레이먼은 특히 복잡하고 고차원인 자료를 다루는 현실 문제 다수에서 알고리즘 문화가 더 유용할 것이라고 주장했다.
경계가 좁아졌는가? 상당히 그렇다. 현대 통계학은 기계학습에서 교차검증, 정칙화, 앙상블 방법을 받아들였다. 기계학습은 형식적 확률 틀(베이즈 신경망, 컨포멀 예측, 보정)을 받아들였다. 인과 기계학습 방법은 두 문화를 명시적으로 잇는다. 그러나 밑바탕의 인식론적 차이 — 타당성이 모형에 있느냐 표본 밖 성능에 있느냐 — 는 남아 있으며, 실무에서 가장 흔한 함정은 여전히 자신도 모르게 둘을 뒤섞는 데서 나온다.
연습문제 6. 어떤 팀이 고객 신용위험을 예측하는 랜덤 포레스트를 만들었다. 표본 밖 정확도가 95%지만, 은행 감독기관은 모형이 설명 가능해야 한다고 요구한다. 불리한 신용 결정에는 구체적인 사유가 따라야 한다는 것이다. 랜덤 포레스트를 포기하지 않고 이 요건을 충족할 현실적 전략 두 가지를 논하라.
풀이
전략 1 — SHAP / 특성 기여도 방법: SHAP 값은 개별 예측마다 각 특성이 모집단 기준선 대비 그 예측에 얼마나 기여했는지를 계산한다. 거절된 신청자에 대해서는 "신용점수가 \(-0.15\), 부채상환비율이 \(-0.10\), 최근 조회 이력이 \(-0.05\)만큼 기여했다"와 같은 설명이 가능하다. 이는 모형 자체에서 유도한 결정별 사유 코드를 제공하면서 랜덤 포레스트의 예측 정확도를 그대로 보존한다. SHAP 값은 일관된 게임이론적 토대(섀플리 값)를 가지며, 많은 감독기관이 말하는 "구체적 사유"의 요건을 충족한다.
전략 2 — 대리 모형: 훈련 자료에서 랜덤 포레스트의 예측을 흉내 내도록 더 단순한 해석 가능 모형(예: 로지스틱 회귀나 얕은 결정트리)을 학습시킨다. 그 대리 모형의 계수나 규칙이 "설명"이 된다. 대가는 대리 모형이 해석 가능하지만 랜덤 포레스트와 완벽히 일치하지는 않는다는 점이다. 혼합 접근은 실제 결정에는 랜덤 포레스트를, 설명에는 대리 모형을 쓰면서 둘의 일치도를 진단한다.
다른 선택지도 있다. 본래 해석 가능하면서도 유연한 모형(EBM, 설명 가능 부스팅 기계)을 학습시켜 랜덤 포레스트에 가까운 정확도를 얻거나, 알려진 방향으로 단조성 제약을 둔 심층 모형을 적합시키는 것이다. 후자는 정칙화 효과와 해석 보조를 동시에 준다.
연습문제 7. 연습문제 1과 2를 수치로 확인하라. 가정이 맞을 때와 틀릴 때 선형모형과 랜덤 포레스트의 성적이 어떻게 뒤바뀌는가? 표본 크기의 역할도 함께 보라.
풀이
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.ensemble import RandomForestRegressor

rng = np.random.default_rng(0)

def compare(kind, n):
    f = (lambda z: 1 + 2 * z) if kind == "선형" else (lambda z: np.sin(3 * z) + 0.5 * z ** 2)
    X = rng.uniform(-2, 2, (n, 1))
    y = f(X[:, 0]) + rng.normal(0, 1, n)
    Xt = rng.uniform(-2, 2, (4000, 1))
    yt = f(Xt[:, 0]) + rng.normal(0, 1, 4000)

    lin = LinearRegression().fit(X, y)
    rf = RandomForestRegressor(n_estimators=200, random_state=0, n_jobs=-1).fit(X, y)
    return (np.mean((lin.predict(Xt) - yt) ** 2),
            np.mean((rf.predict(Xt) - yt) ** 2))

print(f"{'참 함수':>7}{'n':>7}{'선형모형':>12}{'랜덤 포레스트':>16}{'승자':>10}")
for kind in ("선형", "비선형"):
    for n in (30, 100, 1000):
        a, b = compare(kind, n)
        print(f"{kind:>7}{n:>7}{a:>12.4f}{b:>16.4f}"
              f"{('선형' if a < b else '포레스트'):>10}")
print("\n잡음 하한(달성 가능한 최소 MSE) = 1.0")
출력:
   참 함수      n        선형모형         랜덤 포레스트        승자
     선형     30      1.0805          1.6776        선형
     선형    100      1.0071          1.4344        선형
     선형   1000      0.9936          1.5216        선형
    비선형     30      1.8238          1.3903      포레스트
    비선형    100      1.9058          1.5846      포레스트
    비선형   1000      1.8818          1.5367      포레스트

잡음 하한(달성 가능한 최소 MSE) = 1.0
결과가 깔끔하게 갈린다.
| 참 함수 | \(n\) | 선형모형 | 랜덤 포레스트 |
|---|---|---|---|
| 선형 | \(30\) | \(\mathbf{1.08}\) | \(1.68\) |
| 선형 | \(1000\) | \(\mathbf{0.99}\) | \(1.52\) |
| 비선형 | \(30\) | \(1.82\) | \(\mathbf{1.39}\) |
| 비선형 | \(1000\) | \(1.88\) | \(\mathbf{1.54}\) |
가정이 맞으면 선형모형이 이긴다. \(n = 1000\)에서 MSE \(0.99\)로 잡음 하한 \(1.0\)에 사실상 도달한다. 더 잘할 수 없는 수준이다. 랜덤 포레스트는 같은 자료로 \(1.52\)에 머무는데, 직선이라는 사실을 모른 채 계단으로 근사하기 때문이다.
가정이 틀리면 반대가 된다. 선형모형은 \(n\)을 아무리 키워도 \(1.88\)에서 내려오지 않는다. 자료가 부족해서가 아니라 모형이 담을 수 없는 구조이기 때문이며, 이것이 줄지 않는 편향이다.
\(n = 30\)의 비선형 경우가 흥미롭다. 포레스트가 이기지만 \(1.39\)로 하한 \(1.00\)과 거리가 있다. 유연한 방법은 자료를 많이 요구한다.
정리하면 이것이 편향–분산 절충의 다른 얼굴이다.
- 가정은 정보다. 맞으면 자료를 아껴 준다(\(n = 30\)에서 선형모형이 이미 \(1.08\)).
- 가정은 위험이다. 틀리면 자료로 고칠 수 없다.
- 유연한 방법은 가정을 덜 지불하는 대신 자료를 더 지불한다.
실무에서 어느 쪽인지 미리 알 수 없으므로, 답은 표본 밖 성능으로 판정하는 것이다. 그리고 잔차 그림 같은 진단으로 가정이 어긋나는 방식을 살펴야 한다. \(\square\)
연습문제 8. 잘 순위를 매기는 모형과 잘 보정된 모형은 다르다. 두 성질을 분리해서 측정하고, 어느 쪽이 언제 중요한지 논하라.
풀이
import numpy as np
from sklearn.naive_bayes import GaussianNB
from sklearn.linear_model import LogisticRegression
from sklearn.calibration import CalibratedClassifierCV
from sklearn.metrics import roc_auc_score, brier_score_loss

rng = np.random.default_rng(0)
n = 20_000
corr = np.full((4, 4), 0.9); np.fill_diagonal(corr, 1.0)
X = rng.normal(0, 1, (n, 4)) @ np.linalg.cholesky(corr).T   # 특징들이 강하게 상관
y = (rng.random(n) < 1 / (1 + np.exp(-(0.9 * X[:, 0] + 0.6 * X[:, 1])))).astype(int)
tr, te = np.arange(12_000), np.arange(12_000, n)

models = [("나이브 베이즈", GaussianNB()),
          ("로지스틱", LogisticRegression()),
          ("보정된 NB", CalibratedClassifierCV(GaussianNB(), cv=3, method="isotonic"))]

print(f"{'모형':>15}{'AUC (순위)':>13}{'브라이어 (보정)':>17}")
for name, m in models:
    pr = m.fit(X[tr], y[tr]).predict_proba(X[te])[:, 1]
    print(f"{name:>15}{roc_auc_score(y[te], pr):>13.4f}"
          f"{brier_score_loss(y[te], pr):>17.4f}")

print("\n나이브 베이즈의 신뢰도 곡선")
pr = GaussianNB().fit(X[tr], y[tr]).predict_proba(X[te])[:, 1]
for lo in (0.0, 0.2, 0.4, 0.6, 0.8):
    m = (pr >= lo) & (pr < lo + 0.2)
    if m.sum() > 30:
        print(f"  예측 [{lo:.1f}, {lo + 0.2:.1f}): "
              f"평균 예측 {pr[m].mean():.4f}   실제 비율 {y[te][m].mean():.4f}")
출력:
             모형     AUC (순위)        브라이어 (보정)
        나이브 베이즈       0.8008           0.2164
           로지스틱       0.8031           0.1812
         보정된 NB       0.8004           0.1829

나이브 베이즈의 신뢰도 곡선
  예측 [0.0, 0.2): 평균 예측 0.0378   실제 비율 0.2328
  예측 [0.2, 0.4): 평균 예측 0.2960   실제 비율 0.4416
  예측 [0.4, 0.6): 평균 예측 0.5012   실제 비율 0.5032
  예측 [0.6, 0.8): 평균 예측 0.7028   실제 비율 0.5856
  예측 [0.8, 1.0): 평균 예측 0.9619   실제 비율 0.7809
AUC는 거의 같은데 브라이어 점수는 크게 다르다.
| 모형 | AUC | 브라이어 |
|---|---|---|
| 나이브 베이즈 | \(0.8008\) | \(0.2164\) |
| 로지스틱 | \(0.8031\) | \(\mathbf{0.1812}\) |
| 보정된 NB | \(0.8004\) | \(\mathbf{0.1829}\) |
신뢰도 곡선이 원인을 보여 준다. 나이브 베이즈는 \(0.038\)이라고 말한 집단에서 실제로 \(23.3\%\)가 양성이고, \(0.962\)라고 말한 집단에서 실제로는 \(78.1\%\)다. 지나치게 자신만만하다.
왜 그런가. 나이브 베이즈는 특징들이 조건부 독립이라고 가정하는데, 여기서 상관이 \(0.9\)다. 같은 증거를 네 번 세는 셈이라 확률이 극단으로 밀린다. 그런데 순위는 망가지지 않는다. 단조 변환은 순서를 보존하기 때문이다.
어느 쪽이 중요한가.
| 용도 | 필요한 성질 |
|---|---|
| 상위 \(k\)명에게 마케팅 | 순위 (AUC) |
| 심사 대상 선별 | 순위 |
| 기대손실 계산, 보험료 산정 | 보정 |
| 의사에게 "이 환자의 위험은 \(12\%\)" 제시 | 보정 |
| 여러 모형의 예측을 결합 | 보정 |
결정 임계값이 비용에서 나올 때는 보정이 필수다. "치료 비용이 \(C\)이고 미치료 손해가 \(L\)이면 \(p > C/L\)일 때 치료한다"는 규칙은 \(p\)가 진짜 확률일 때만 옳다.
보정은 사후에 고칠 수 있다. 이소토닉 회귀나 플랫 스케일링으로 브라이어를 \(0.2164 \to 0.1829\)로 되돌리면서 AUC는 그대로 유지했다. 순위 능력은 모형이 가진 정보의 문제라 사후에 만들어 낼 수 없지만, 보정은 단조 변환이므로 별도 자료만 있으면 언제든 고칠 수 있다. \(\square\)
연습문제 9. 연습문제 5의 브레이먼이 지적한 라쇼몽 효과를 재현하라. 성능이 거의 같은 여러 모형이 서로 전혀 다른 "설명"을 내놓는 것을 보여라.
풀이
import numpy as np
from sklearn.linear_model import LinearRegression

rng = np.random.default_rng(2)
n = 400
Z = rng.normal(0, 1, n)                         # 관측되지 않는 실제 원인
X1 = Z + rng.normal(0, 0.3, n)                  # Z 의 세 가지 대리 측정
X2 = Z + rng.normal(0, 0.3, n)
X3 = Z + rng.normal(0, 0.3, n)
X4 = rng.normal(0, 1, n)
y = 2 * Z + 0.5 * X4 + rng.normal(0, 1, n)
F = np.column_stack([X1, X2, X3, X4])

print(f"{'사용한 변수':<28}{'R^2':>8}   계수")
for sub in [(0, 3), (1, 3), (2, 3), (0, 1, 2, 3)]:
    m = LinearRegression().fit(F[:, sub], y)
    r2 = m.score(F[:, sub], y)
    names = "[" + ", ".join(f"X{i + 1}" for i in sub) + "]"
    print(f"{names:<28}{r2:>8.4f}   {np.round(m.coef_, 3)}")
출력:
사용한 변수                           R^2   계수
[X1, X4]                      0.7552   [1.889 0.5  ]
[X2, X4]                      0.7407   [1.891 0.481]
[X3, X4]                      0.7540   [1.923 0.484]
[X1, X2, X3, X4]              0.7959   [0.738 0.501 0.781 0.496]
| 사용한 변수 | \(R^2\) | X1 계수 | X2 계수 | X3 계수 |
|---|---|---|---|---|
| X1, X4 | \(0.755\) | \(1.889\) | — | — |
| X2, X4 | \(0.741\) | — | \(1.891\) | — |
| X3, X4 | \(0.754\) | — | — | \(1.923\) |
| 전부 | \(0.796\) | \(0.738\) | \(0.501\) | \(0.781\) |
네 모형의 성능이 실질적으로 같다(\(R^2\) \(0.74\)–\(0.80\)). 그런데 설명이 완전히 다르다.
- 첫 모형은 "X1이 가장 중요하다(계수 \(1.89\))"고 말한다.
- 둘째 모형은 "X2가 가장 중요하다(계수 \(1.89\))"고 말한다. X1은 언급조차 없다.
- 전부 넣으면 셋이 \(0.74\), \(0.50\), \(0.78\)로 임의로 나뉜다. 어느 것도 참값 \(2.0\)이 아니다.
참 원인 \(Z\)는 어느 모형에도 없다. 세 변수는 모두 \(Z\)의 대리이며, 자료만으로는 어느 대리를 쓸지 고를 근거가 없다.
이것이 브레이먼의 라쇼몽 효과다. 같은 자료를 거의 똑같이 잘 설명하는 모형이 여럿 있고, 그들의 "설명"은 서로 모순된다. 자료는 그중 하나를 고르라고 말해 주지 않는다.
실무적 함의가 무겁다.
- 변수 선택 결과를 발견으로 보고하면 안 된다. 라소가 X1을 고르고 X2를 버렸다면, 그것은 X2가 무관해서가 아니라 둘 중 하나만 필요했기 때문이다.
- 모형이 하나만 있으면 이 사실이 보이지 않는다. 처방은 여러 모형을 일부러 적합해 보는 것이다. 라쇼몽 집합(성능이 거의 같은 모형들)을 탐색하면 어떤 결론이 견고하고 어떤 것이 임의적인지 드러난다.
- 위 표에서 X4의 계수만 네 모형에서 \(0.48\)–\(0.50\)으로 안정적이다. 다른 변수와 상관되지 않았기 때문이다. 안정성 자체가 신뢰의 근거가 된다.
브레이먼이 두 문화를 대비시키며 강조한 것이 이것이다. 알고리즘적 문화는 "참 모형"이라는 관념을 버리고 예측 성능으로 판정하는데, 그 대가로 해석의 유일성도 함께 버린다. \(\square\)
연습문제 10. 연습문제 6의 규제 요건을 실제로 다루어 보라. 블랙박스 모형에 대리 모형과 개별 사유 코드를 붙이는 두 전략을 구현하고 한계를 밝혀라.
풀이
import numpy as np
from sklearn.ensemble import RandomForestRegressor
from sklearn.linear_model import LinearRegression
from sklearn.tree import DecisionTreeRegressor

rng = np.random.default_rng(3)
n = 8000
X = rng.normal(0, 1, (n, 5))
y = (2 * X[:, 0] - 1.5 * X[:, 1] + 0.8 * X[:, 2] * X[:, 3]
     + rng.normal(0, 1, n))                      # 상호작용이 들어 있다

tr, te = np.arange(6000), np.arange(6000, n)
rf = RandomForestRegressor(n_estimators=200, random_state=0, n_jobs=-1).fit(X[tr], y[tr])
print(f"랜덤 포레스트 시험 R^2 {rf.score(X[te], y[te]):.4f}")

# 전략 1: 전역 대리 모형 — 블랙박스의 예측을 단순 모형으로 흉내 낸다
for name, surrogate in [("선형 대리", LinearRegression()),
                        ("깊이 3 트리 대리", DecisionTreeRegressor(max_depth=3, random_state=0))]:
    s = surrogate.fit(X[tr], rf.predict(X[tr]))
    print(f"  {name}: 블랙박스 예측과의 충실도 R^2 = {s.score(X[te], rf.predict(X[te])):.4f}")

# 전략 2: 개별 사유 코드 — 각 특징을 기준값으로 바꿨을 때 예측이 얼마나 변하는가
i = te[0]
base = rf.predict(X[i:i + 1])[0]
print(f"\n관측 {i} 의 예측값 {base:.3f} 에 대한 사유 코드")
for j in range(5):
    Xm = X[i:i + 1].copy(); Xm[0, j] = 0.0        # 해당 특징만 평균으로
    print(f"  특징 {j}: 값 {X[i, j]:+.3f} → 기여 {base - rf.predict(Xm)[0]:+.3f}")
출력:
랜덤 포레스트 시험 R^2 0.8282
  선형 대리: 블랙박스 예측과의 충실도 R^2 = 0.9686
  깊이 3 트리 대리: 블랙박스 예측과의 충실도 R^2 = 0.8022

관측 6000 의 예측값 3.822 에 대한 사유 코드
  특징 0: 값 +2.330 → 기여 +5.621
  특징 1: 값 +0.915 → 기여 -1.123
  특징 2: 값 -0.129 → 기여 +0.003
  특징 3: 값 -0.913 → 기여 +0.282
  특징 4: 값 +2.844 → 기여 -0.291
전략 1: 전역 대리 모형. 블랙박스의 예측을 단순 모형으로 근사한다. 결과가 흥미롭다.
| 대리 모형 | 충실도 \(R^2\) |
|---|---|
| 선형 | \(0.969\) |
| 깊이 \(3\) 트리 | \(0.802\) |
선형 대리가 트리 대리보다 훨씬 충실하다. 자료생성 과정에 상호작용 \(0.8\,X_2X_3\)이 들어 있는데도 그렇다. 주효과 \(2X_0 - 1.5X_1\)이 분산의 대부분을 차지해서, 상호작용을 놓쳐도 예측의 \(97\%\)가 설명되기 때문이다. 반면 깊이 \(3\) 트리는 가지가 여덟 개뿐이라 매끄러운 선형 함수조차 계단으로 거칠게 근사한다.
교훈은 "단순한 대리는 충실도가 낮다"가 아니라 "어느 단순 모형이 맞는지는 자료가 정한다" 는 것이다. 대리 모형을 고를 때도 충실도를 측정해야 한다.
그리고 충실도가 낮은 대리 모형은 위험하다. 설명이 실제 결정과 다르다면 그 설명은 거짓이다. 규제 목적으로 쓰려면 충실도를 반드시 함께 보고해야 한다. 충실도 \(0.80\)은 결정의 \(20\%\)를 설명하지 못한다는 뜻이며, 거절 사유를 통지해야 하는 맥락에서 이는 결코 작은 수치가 아니다.
전략 2: 개별 사유 코드. 각 특징을 기준값으로 바꿨을 때 예측이 얼마나 변하는지 계산한다. "귀하의 신청이 거절된 주된 사유는 부채비율입니다" 같은 문장을 만들 수 있다. SHAP는 이 착상을 게임이론적으로 정교화해 기여도의 합이 예측값과 정확히 맞아떨어지게 만든 것이다.
한계를 정확히 알아야 한다.
- 기준값 선택에 의존한다. 평균으로 바꿀지, 최빈값으로 바꿀지, 주변분포에서 뽑을지에 따라 답이 달라진다.
- 특징이 상관되면 무의미한 지점을 평가한다. "소득은 그대로인데 직업만 없는" 가상의 사람에서 모형을 평가하게 된다.
- 인과가 아니다. 앞 절에서 본 대로, 사유 코드는 "모형이 왜 그렇게 판단했는가"이지 "무엇을 바꾸면 결과가 달라지는가"가 아니다. 후자를 원하면 반사실적 설명(예: "부채비율을 \(0.35\) 이하로 낮추면 승인됩니다")이 더 적절하며, 실제로 규제 맥락에서 요구되는 것도 이쪽에 가깝다.
세 번째 길이 있다. 애초에 본질적으로 해석 가능한 모형을 쓰는 것이다. 일반화 가법 모형(GAM), 규칙 목록, 단조 제약을 건 부스팅은 상당한 유연성을 유지하면서 구조가 투명하다. 루딘(2019)은 고위험 의사결정에서는 블랙박스에 사후 설명을 붙이는 대신 이런 모형을 써야 한다고 주장했으며, 성능 손실이 흔히 생각하는 것보다 훨씬 작다는 점이 그 논거다. \(\square\)
정리하며
통계 모형은 해석 가능한 모수로 지표화된 확률분포의 족을 지정하고, 학습 알고리즘은 완전한 확률 모형 없이 자료에서 패턴을 찾는 계산 절차다.
- 가정의 위치가 다르다. 모형은 분포와 구조를 명시적으로 적고, 알고리즘은 가정을 최소화하거나 암묵적으로 둔다. 명시적 가정은 틀릴 수 있지만 검토할 수 있다는 것이 장점이다.
- 자료의 크기가 갈림길이다. 모형은 작고 정형화된 자료에서도 작동하고, 알고리즘은 크고 복잡한 자료에서 진가를 낸다.
- 경계는 흐릿하다. 능형회귀·라쏘는 알고리즘적 정칙화로 보강한 모형이고, 그래디언트 부스팅은 반복적 모형 적합으로 읽을 수 있으며, 베이즈 신경망은 양쪽을 섞는다. 둘을 배타적 진영으로 보는 것은 실무와 맞지 않는다.
- 목표가 선택을 정한다. 왜 그런지 이해해야 하면 해석 가능한 모형을, 무엇이 될지 맞혀야 하면 알고리즘을 택한다.
이것으로 1장이 끝난다. 1.1에서 모집단과 표본을 나누고, 1.2와 1.3에서 자료를 만드는 두 가지 태도를 보았으며, 1.4에서 자료가 우리를 속이는 방식들을, 1.5에서 두 패러다임의 거래 조건을 정리했다. 관통하는 물음은 하나다. 이 자료는 어떻게 생겨났는가.
다음 장 기술통계부터는 실제로 자료를 마주한다. 모형을 세우기 전에 먼저 보고, 세고, 그려 보는 일이며, 그 습관이 뒤에 나올 모든 추론의 안전장치가 된다.