15장: 분산 검정
개요
들어가는 이야기 — 출렁임은 몰려 다닌다
주식 값이 날마다 오르내리는 그림을 보면 금방 눈에 띄는 것이 있다. 크게 출렁이는 날은 몰려 다닌다. 조용한 날이 한참 이어지다가, 한번 크게 흔들리기 시작하면 며칠이고 계속 크게 흔들린다. 하루하루가 서로 상관없이 제멋대로라면 이런 군집은 생기지 않는다.
그래서 돈을 다루는 사람은 늘 묻게 된다. 「이 기간이 저 기간보다 더 출렁였는가.」 평균이 올랐는지 내렸는지가 아니라 얼마나 제각각인지를 견주는 물음이다. 손해를 볼 위험을 재는 일이 대개 이쪽이기 때문이다. \(1982\) 년에 엥글이라는 학자가 이 물음을 다루는 방식을 바꾸었다 — 「출렁임의 크기」를 고정된 수 하나로 보지 않고 출렁임 자체가 날마다 변하는 모형을 세운 것이고, 그 공로로 \(2003\) 년에 노벨 경제학상을 받았다.
이 장은 그 앞에 오는 물음을 다룬다. 두 집단이, 또는 여러 집단이 얼마나 제각각인지를 견주는 일이다. 평균을 견주는 법은 여기저기서 배우지만 「퍼진 정도」를 견주는 법은 따로 배워야 한다. 그리고 하나 더 — 그 일을 하는 방법들이 생각보다 약하다. 평균을 견줄 때는 자료가 종 모양이 아니어도 웬만하면 버텨 주는 든든한 뒷배가 있는데, 퍼진 정도를 견줄 때는 그런 뒷배가 없다.
그러면 종 모양에서 조금 벗어난 자료에서 이 검정들은 어느 방향으로 얼마나 어긋나고, 그 불일치는 표본을 늘려서 고쳐지는가. 고쳐지지 않는다면 대신 무엇을 써야 하는가. 이 장이 고전적인 셋과 로버스트한 셋을 차례로 세운 뒤 같은 자리에 나란히 놓고 수로 가른다.
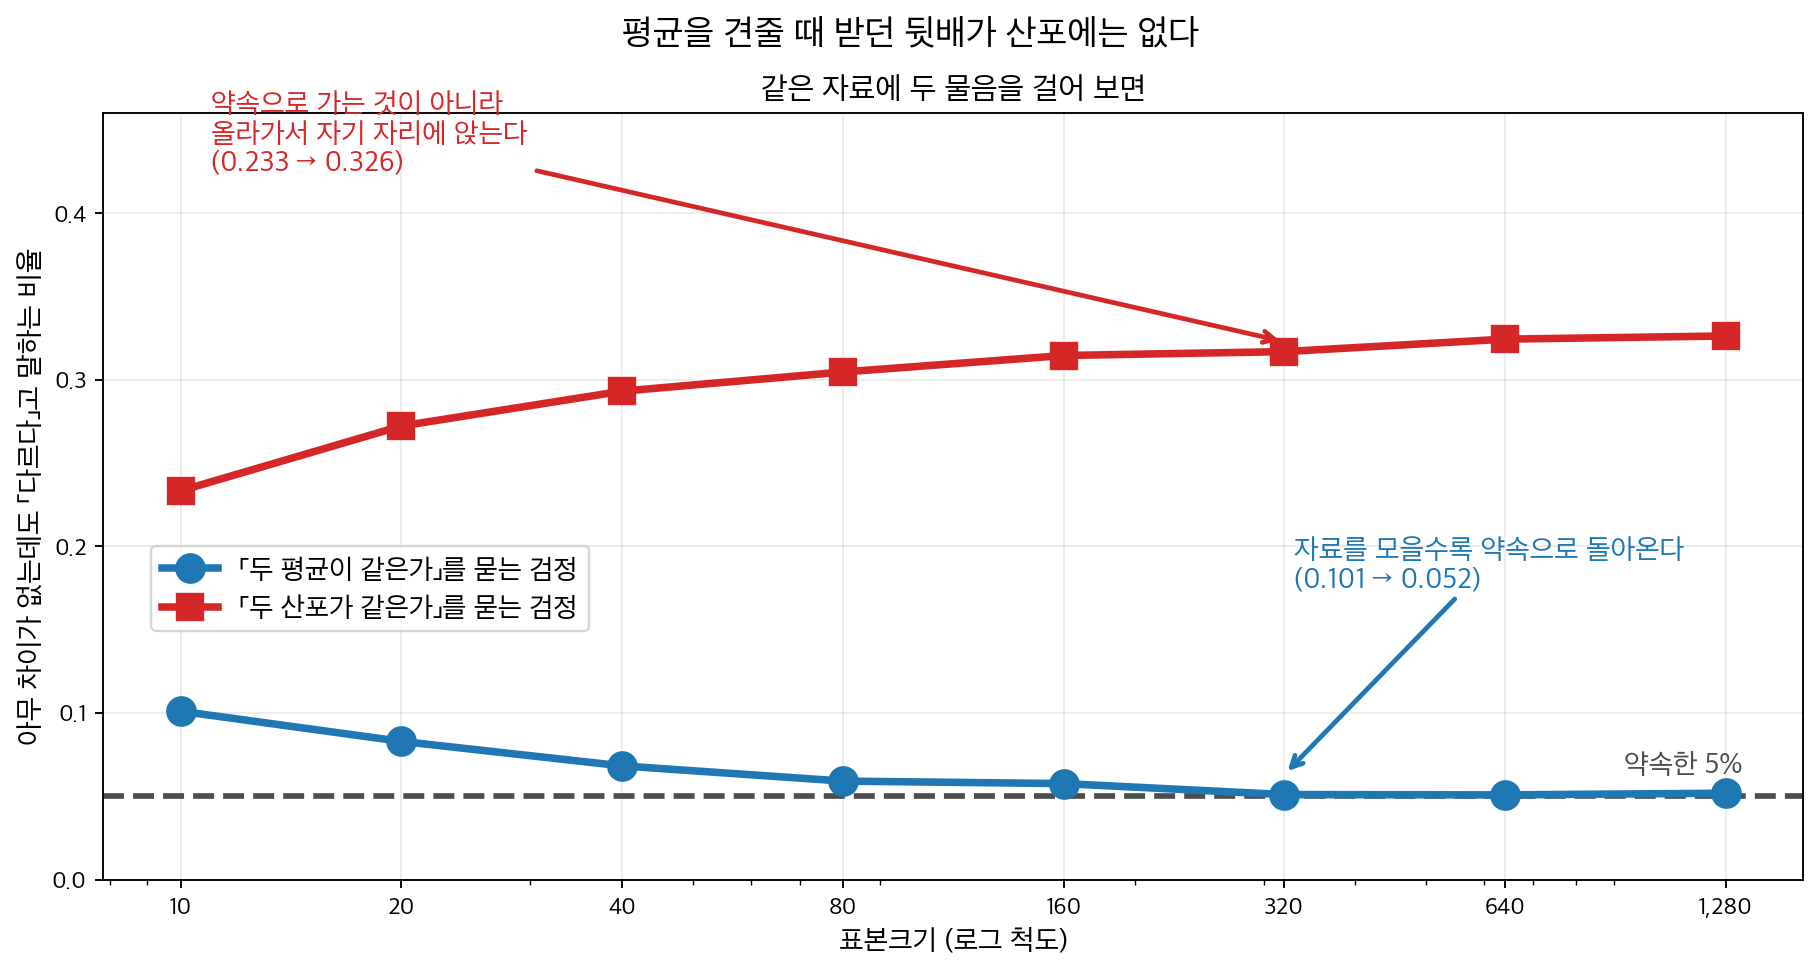
종 모양이 아닌 같은 자료에 두 물음을 걸고 표본을 늘려 보았다. 둘 다 아무 차이가 없는 자료이므로 두 선은 약속한 \(5\%\) 에 있어야 한다. 평균을 묻는 쪽은 \(n\) 을 늘리자 \(0.101\) 에서 \(0.052\) 로 내려와 약속에 닿는데, 산포를 묻는 쪽은 \(0.233\) 에서 \(0.326\) 으로 올라가 자기 자리에 앉는다. 평균을 견줄 때 받던 뒷배가 여기에는 없다는 말이 이것이고, 그래서 「자료를 더 모으자」가 답이 되지 않는다. 이 장은 그 뒷배 없는 자리에서 쓸 연장을 세우고, 어느 것이 얼마나 버티는지를 수로 가른다. 모집단은 지수분포(exponential distribution)이고 반복은 자리마다 \(40{,}000\) 회다.
확인한 곳 — 15.7절 금융 변동성 비교의 엥글 상자와 그 출처 줄
분산 검정은 집단이나 모집단 사이에서 관찰된 변동성의 차이가 통계적으로 유의한지 평가한다. 이 검정들은 통계적 추론의 기본 도구이며, 분산분석(analysis of variance)이나 회귀분석 같은 다른 방법의 가정을 검증하는 데 결정적인 역할을 한다. 이 장은 고전적 모수적 접근(카이제곱, F 검정, 바틀렛 검정)에서 로버스트 대안(레빈, 브라운–포사이드, 플리그너–킬린)을 거쳐 현대적 계산 방법과 베이즈 기법에 이르는 분산 검정 방법을 폭넓게 다룬다.
1. 장의 구성
15.1 분산 검정 입문
동기와 분산 검정 지형의 개관.
- 왜 분산을 검정하는가 — 분산분석에서 등분산성(homoscedasticity)을 확인하고, 회귀 가정을 검증하며, 금융 상품 간 변동성을 비교하는 데 분산 검정이 갖는 실무적 중요성을 설명한다. 이어서 주요 분산 검정(카이제곱, F 검정, 바틀렛, 레빈, 브라운–포사이드, 플리그너–킬린)의 검정통계량(test statistic)과 분포 가정을 한자리에 모으고, 같은 분포에서 뽑은 자료로 넷의 실제 제1종 오류율을 재어 선택의 근거를 그림으로 보인다.
- 분산 검정의 공통 가정 — 독립성(independence), 확률표집, (모수적 검정의 경우) 정규성이라는 공통 요구조건과 이를 위반했을 때의 결과를 논한다.
15.2 분산에 대한 카이제곱 검정
모집단 분산이 지정된 값과 같은지 검정하는 일표본 검정.
- 일표본 카이제곱 분산 검정 — 통계량 \(\chi^2 = (n-1)s^2 / \sigma_0^2\)으로 \(H_0: \sigma^2 = \sigma_0^2\)을 검정한다. 단측과 양측 형태 및 보기를 다룬다. 검정통계량이 왜 \(\chi^2_{n-1}\) 을 따르는지는 정리 1 과 접히는 증명으로 이 쪽 안에 있고, 그 유도가 기댄 정규성(normality)이 깨지면 무엇이 일어나는지를 같은 쪽 마지막 절이 네 모집단에서 수로 잰다.
- \(\sigma^2\)의 신뢰구간 — 카이제곱 검정을 뒤집어 모분산과 모표준편차의 신뢰구간을 구성한다.
- 카이제곱분포 (분산 검정) — 앞의 검정과 구간이 기대어 선 분포 자체를 따로 본다. 적률, 가법성, 자유도에 따라 모양이 어떻게 변하는지를 모으고, 분산분석의 등분산 확인처럼 이 분포를 짧게 스쳐 가는 다른 자리들과 이어 준다.
15.3 두 분산 비교를 위한 F 검정
표본분산(sample variance)의 비에 기반한 이표본 검정.
- 이표본 F 검정 — 통계량 \(F = s_1^2 / s_2^2\)으로 \(H_0: \sigma_1^2 = \sigma_2^2\)을 검정한다. 두 모집단이 정규이면 귀무가설(null hypothesis) 아래에서 \(F\) 분포를 따른다.
- F 분포와 자유도 — \(F\) 분포의 성질과 분자·분모 자유도가 어떻게 정해지는지 자세히 다룬다.
- 비정규성에 대한 민감도 — F 검정이 정규성 이탈에 매우 민감하며 비정규 자료에서 제1종 오류율을 크게 부풀리는 경우가 많음을 경고한다.
- F 검정의 정규성 민감도와 로버스트 대안 — 앞 쪽이 잰 고장을 피하려 「먼저 정규성을 검정해 보자」는 흐름이 왜 듣지 않는지 샤피로–윌크의 탐지력으로 보이고, 대신 쓸 레빈·브라운–포사이드·플리그너–킬린을 제시한다.
15.4 바틀렛 검정
분산의 동질성에 대한 다집단 모수적 검정.
- 분산의 동일성에 대한 바틀렛 검정 — 정규성 아래에서 \(\chi^2_{k-1}\) 분포를 따르는 합동분산(pooled variance) 기반 통계량으로 \(H_0: \sigma_1^2 = \sigma_2^2 = \cdots = \sigma_k^2\)을 검정한다. 통계량이 보정된 가능도비라는 것은 정리 1 과 접히는 증명으로 이 쪽 안에 있다.
- 비정규성 아래의 한계 — 바틀렛 검정이 비정규성에 매우 민감하여 정규성 가정이 의심스러울 때 신뢰할 수 없음을 강조한다. 극한 제1종 오류율을 첨도(kurtosis)의 함수로 유도하고, 같은 식이 \(k = 2\) 에서 F 검정의 것과 일치함을 보인다.
- 바틀렛 검정 비정규성 민감도 — 앞 쪽이 유도한 극한값을 모의실험으로 재어 확인하고, 대수정규 자료에서 바틀렛을 레빈·플리그너–킬린과 나란히 견준다.
15.5 로버스트 검정
분산 비교를 위한 분포무관·이상치(outlier) 저항 대안들.
- 분산 동일성의 로버스트 검정 — 절의 지도에 해당한다. 네 검정이 같은 자료를 각각 어떤 양으로 바꾸어 놓는지 한자리에서 보이고, 순위로 바꾸어 비모수(nonparametric)로 만드는 플리그너–킬린을 다룬다.
- 레빈 검정 — 각 관측값과 집단평균의 절대편차에 일원분산분석을 수행하여 분산의 동일성을 검정한다. 중간 정도의 정규성 이탈에 로버스트하다.
- 브라운–포사이드 검정 — 집단평균 대신 집단중앙값으로부터의 편차를 쓰는 레빈 검정의 변형으로, 치우친 분포와 이상치에 추가적인 로버스트성을 제공한다.
- 플리그너–킬린 검정 — 집단중앙값으로부터의 절대편차의 순위를 쓰는 비모수 검정으로, 순위만 보므로 꼬리의 두께에 가장 덜 흔들린다. 다만 왜도(skewness)는 다른 이야기여서, 로그정규에서는 크기가 \(0.102\) 까지 올라가 브라운–포사이드(\(0.039\))에 진다.
- 로버스트 방법의 비교 — 여러 분포 모양에 걸쳐 레빈, 브라운–포사이드, 플리그너–킬린을 제1종 오류(type I error) 조절, 검정력, 로버스트성 측면에서 나란히 평가한다.
- 대수정규에서의 비교 (왜도가 극단일 때) — 앞 쪽 표의 마지막 줄 하나를 확대한다. 왜도 \(6.19\), 초과첨도 \(110.9\) 의 대수정규에서는 네 검정 가운데 셋이 무너진다. 순위를 쓰는 플리그너–킬린조차 명목 수준을 지키지 못하고, 중앙값 중심화를 쓰는 브라운–포사이드 하나가 남는다.
- 레빈 검정 정규 대 치우친 분포 모의실험 — 같은 설정을 이어받아, 중앙값 중심 레빈이 정규와 대수정규 양쪽에서 명목 크기 \(\alpha = 0.05\) 를 지키는지 몬테카를로(Monte Carlo)로 확인한다.
15.6 고급 방법
분산 비교를 위한 계산적·베이즈 접근.
- 부트스트랩 분산 검정 — 재표집으로 분산비나 분산차의 귀무분포를 구성하여 분포 가정 없이 타당한 추론을 제공한다.
- 베이즈 분산 검정 — 분산 모수에 사전분포(prior distribution, 보통 역감마)를 두어 분산 가설에 대한 사후확률과 베이즈 인자를 계산한다.
- 분산에 대한 가능도비 검정 — 귀무가설과 대립가설(alternative hypothesis) 아래의 최대가능도를 비교하여 점근적으로 카이제곱을 따르는 검정통계량을 제공한다.
15.7 응용
분산 검정이 필수적인 실무 사례.
- 분산분석 등분산성 사전검정 — 「먼저 레빈이나 바틀렛으로 확인하고 분산이 다르면 웰치로 간다」는 두 단계 절차를 그대로 세워 놓고, 그 결합된 절차의 실제 제1종 오류율을 재어 무엇이 잘못되는지 보인다. 사전검정을 통과했다는 것이 분산이 같다는 뜻이 아니라는 것, 그리고 합동할 자리는 사전검정이 아니라 설계가 정한다는 것이 이 쪽의 결론이다.
- 회귀에서의 분산 검정 — 회귀 잔차에 분산 검정(예: 브로이시–페이건)을 적용하여 이분산을 탐지하고, 가중최소제곱과 로버스트 표준오차 같은 처방을 다룬다.
- 금융 변동성 비교 — 서로 다른 자산, 포트폴리오, 기간의 변동성을 비교하여 위험 차이를 평가하고 포트폴리오 구성 결정에 활용한다.
2. 선행 지식
이 장은 다음 내용 위에 세워진다.
- 5장 (추정량과 표집분포(sampling distribution)) — 카이제곱, \(F\), 정규분포와 분산에 관한 추론에서의 역할.
- 8장 (신뢰구간) — 신뢰구간 구성, 특히 카이제곱분포(chi-squared distribution)를 이용한 \(\sigma^2\)의 구간.
- 9장 (가설검정) — 귀무가설과 대립가설, 검정통계량, \(p\) 값, 판정규칙이라는 일반적 틀. 틀만이 아니다. 9.2절 \(\sigma^2\)에 대한 카이제곱 검정과 9.3절 두 분산에 대한 F-검정이 이 장의 두 고전적 검정을 이미 수행한다. 거기서는 많은 검정 가운데 둘이었고, 이 장은 그 둘이 정규성에 기대는 방식과 그 가정이 깨질 때 무엇을 쓸지로 들어간다.
- 14장 (정규성 검정) — 고전적 분산 검정이 요구하는 정규성 가정이 충족되는지 확인하는 방법.
3. 핵심 요약
- 고전적 분산 검정(카이제곱, F 검정, 바틀렛)은 정규성 아래에서 강력하지만 비정규 자료에 매우 민감하여, 정규성 가정이 위배되면 오도하는 결과를 내기 쉽다.
- 로버스트 대안이라고 다 같지 않다. 가르는 것은 중심을 무엇으로 잡는가다. 중앙값을 쓰는 브라운–포사이드는 이 장의 크기 표에서 모든 분포에 걸쳐 \(0.035\)~\(0.048\)로 명목 수준을 지키지만, 평균을 쓰는 레빈은 왜도에 무너진다 — 지수에서 \(0.192\), 로그정규에서 \(0.254\)다. 순위를 쓰는 플리그너–킬린은 두꺼운 꼬리에는 강하나 로그정규에서 \(0.102\)로 밀린다. 정규성이 불확실할 때 고전적 검정보다 로버스트 검정을 쓰는 것은 맞되, 어느 로버스트 검정인가가 그만큼 중요하다.
- 브라운–포사이드 검정(중앙값 기반 레빈)은 대부분의 실무 응용에서 로버스트성과 검정력의 균형이 가장 좋고, 플리그너–킬린은 가장 강한 비모수적 보장을 제공한다.
- 부트스트랩(bootstrap)과 베이즈 방법은 각각 분포 가정을 완전히 피하거나 사전정보를 반영하는 현대적 대안을 제공한다.
- 분산 검정의 제자리는 분산 자체가 물음인 자리다 — 공정의 균일성, 측정 장치의 재현성, 변동성 비교처럼 「산포가 같은가」가 결론인 경우다. 반대로 평균을 견주려고 거치는 문지기로는 쓰지 않는다. 15.1절의 왜 분산을 검정하는가와 분산 검정의 공통 가정 \(\S 5\) 가 그 까닭을 수로 적고, 15.7절 분산분석 등분산성 사전검정이 두 단계 절차의 실제 오류율을 재어 둔다. 등분산을 믿을 근거가 설계에 없으면 검정하지 말고 처음부터 웰치와 브라운–포사이드를 기본값으로 쓴다.