Brown-Forsythe 검정 (scipy)
개요
Brown-Forsythe 검정은 여러 집단의 분산 동일성을 평가하는, Bartlett 검정의 로버스트 대안이다. Levene 검정의 변형으로 중심화에 집단평균 대신 집단중앙값을 써서 정규성 이탈에 저항한다. SciPy에서는 scipy.stats.levene에 center='median' 인자를 주어 쓴다.
검정 설정
크기 \(n_1, \ldots, n_k\)인 독립 집단 \(k\)개가 주어졌을 때 가설은
작동 방식
Brown-Forsythe 검정은 원래의 관측값을 집단중앙값으로부터의 절대편차로 변환한다.
여기서 \(\tilde{x}_i\)는 집단 \(i\)의 중앙값이다. 그런 다음 변환값 \(z_{ij}\)에 일원분산분석 \(F\) 검정을 수행한다.
여기서 \(\bar{z}_{i\cdot}\)은 집단 \(i\)의 변환값 평균, \(\bar{z}_{\cdot\cdot}\)은 전체평균, \(N = \sum n_i\)이다. \(H_0\) 아래에서 \(W\)는 근사적으로 \(F(k-1, N-k)\)이다.
왜 중앙값인가
원래의 Levene 검정은 중심화에 집단 평균을 쓴다(\(z_{ij} = |x_{ij} - \bar{x}_i|\)). Brown과 Forsythe(1974)는 평균을 중앙값으로 바꾸면 다음과 같은 검정이 됨을 보였다.
- 치우쳤거나 꼬리가 두꺼운 분포에서 올바른 제1종 오류율을 유지한다.
- 정규성 아래에서 Levene 검정에 견줄 만한 검정력을 갖는다.
- 중앙값이 위치의 로버스트 추정량이므로 이상점의 영향을 덜 받는다.
세 번째 항목이 왜 중요한지는 기계적으로 따라가 보면 분명하다. 아래 보기의 첫 집단 g1 = [12, 15, 14, 10, 13, 14, 12, 11]에서 값 하나만 \(10 \to 34\)로 바꾸어 보자.
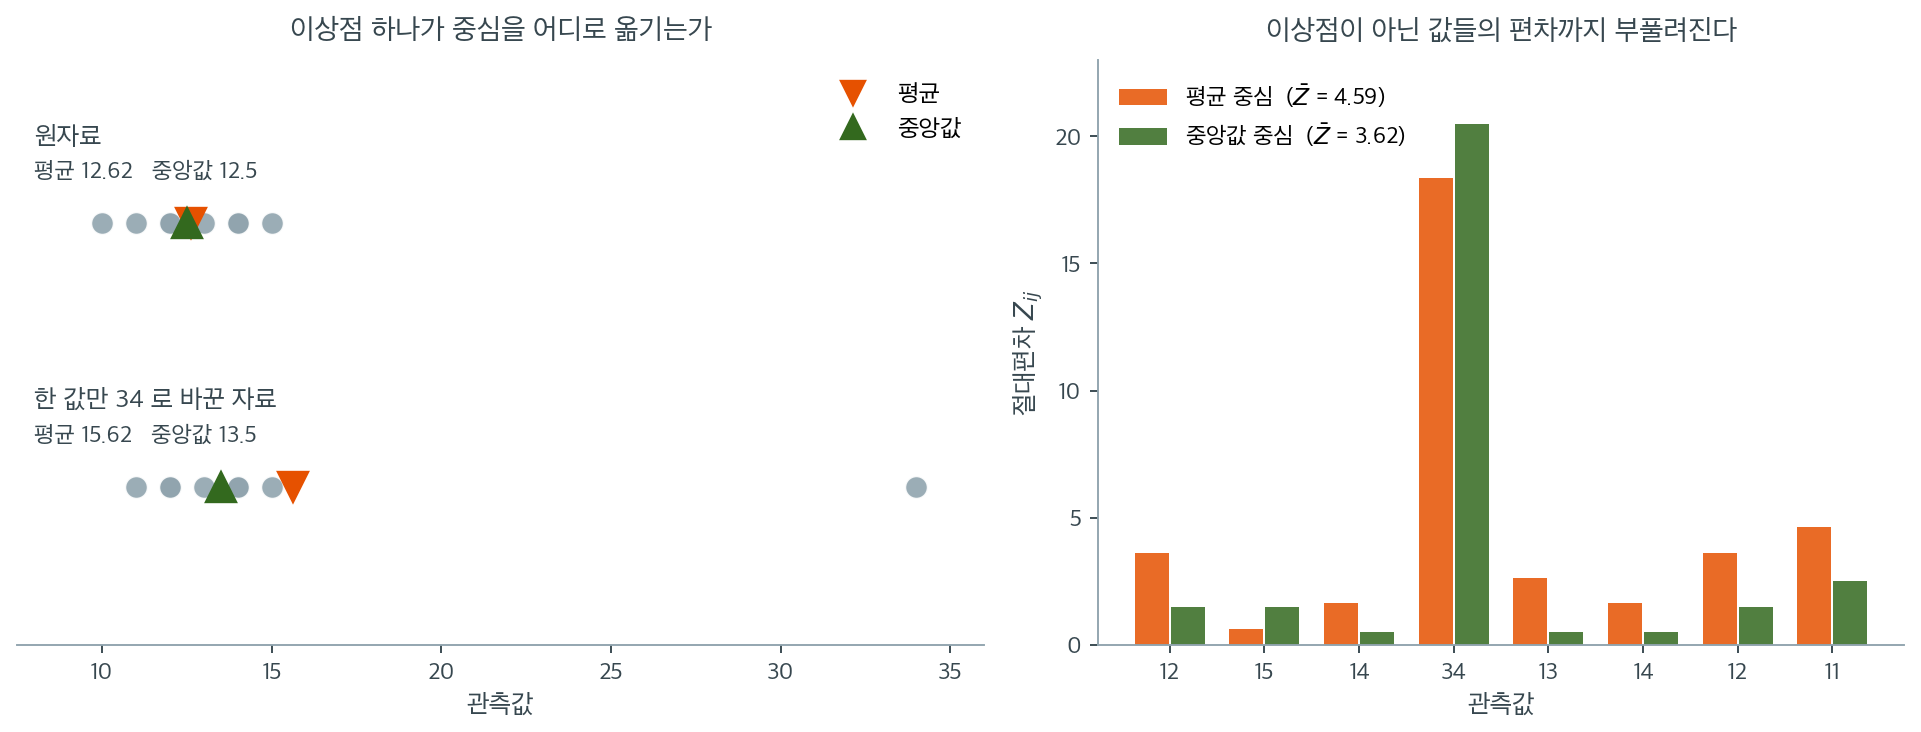
왼쪽에서 두 중심의 반응이 갈린다. 평균은 \(12.62\)에서 \(15.62\)로 3만큼 끌려가 원자료 여덟 개 중 여섯 개보다 오른쪽에 자리 잡는다. 더 이상 이 자료의 중심이 아니다. 중앙값은 \(12.5\)에서 \(13.5\)로 한 칸 움직였을 뿐이다. 중앙값이 옮겨 가려면 순서상 이웃한 값까지만 가면 되기 때문이며, 이것이 붕괴점 50%의 실제 모습이다.
오른쪽이 그 결과다. 이상점 하나 때문에 중심이 3만큼 밀리면, 이상점이 아닌 나머지 일곱 값의 절대편차까지 전부 달라진다. 값 13의 편차는 중앙값 기준 \(0.5\)인데 평균 기준으로는 \(2.62\)다. 값 11은 \(2.5\) 대 \(4.62\)다. 오염된 관측값은 하나인데 오염된 편차는 여덟 개가 되는 셈이다.
이 전파가 검정 결과를 바꾼다. 세 집단에 대해 실제로 돌려 보면 오염 전에는 평균 중심 \(p = 0.3444\), 중앙값 중심 \(p = 0.3489\)로 사실상 같다. 오염 후에는 평균 중심이 \(p = 0.1593\)으로 절반 이하로 떨어지는데 중앙값 중심은 \(p = 0.5276\)으로 오히려 올라간다. 평균 중심 판은 "집단 1의 산포가 크다"는 쪽으로 끌려가고, 중앙값 중심 판은 흔들리지 않는다.
한 가지 덧붙일 것이 있다. 중앙값 중심에서 이상점 자신의 편차는 \(20.5\)로 평균 중심의 \(18.38\)보다 오히려 크다. 브라운–포사이드가 이상점을 무시하는 것이 아니라, 이상점의 영향을 그 한 점에 가두어 나머지 관측값이 오염되지 않게 한다는 뜻이다.
SciPy에서는 함수 호출 한 번으로 끝난다.
보기 1. 중앙값 중심과 평균 중심. 집단당 \(n = 8\), 세 집단의 위치는 크게 다르고 퍼짐은 비슷한 자료다.
(1) \(g_3\) 가 \(g_1\) 의 평행이동임을 확인하고, 그로부터 \(W\) 가 네 수 \(\bar z_1, \bar z_2, S_1, S_2\) 로만 적히는 닫힌 꼴임을 유도하시오. 여기서 \(S_i = \sum_j (z_{ij} - \bar z_i)^2\) 이다.
(2) 두 판본에서 분자가 정확히 같고 분모만 다름을 보이고 그 까닭을 밝히시오. 두 \(W\) 의 비를 분모만으로 예측하고 확인하시오.
풀이
(1) \(g_3 = g_1 + 20\) 이다. 여덟 쌍을 하나씩 빼 보면 전부 \(20\) 이다. 평행이동은 중심(평균이든 중앙값이든)도 같이 \(20\) 만큼 옮기므로 절대편차가 글자 그대로 같아진다.
그러므로 \(\bar z_3 = \bar z_1\), \(S_3 = S_1\) 이고, 세 집단 문제가 두 집단의 정보로 줄어든다.
닫힌 꼴. \(\bar z_1 = \bar z_3 = a\), \(\bar z_2 = b\), \(n_i = 8\), \(N = 24\), \(k = 3\) 이라 쓰자. 전체평균이 \(\bar z = (2a+b)/3\) 이므로 세 집단의 편차가
이고 집단간 제곱합은
이다. 집단내 제곱합은 \(S_1 + S_2 + S_3 = 2S_1 + S_2\) 이므로
를 얻는다. 네 수만 알면 \(W\) 가 정해진다.
(2) 분자가 왜 같은가. 분자는 \(a\) 와 \(b\) 로만 만들어지므로, 두 중심에서 \(a\) 와 \(b\) 가 같으면 분자도 같다. 두 가지 우연이 겹쳐 그렇게 된다.
\(b\) 가 같은 까닭. \(g_2\) 를 정렬하면 \(18, 19, \ldots, 25\) 로 연속한 여덟 정수라 평균과 중앙값이 둘 다 \(21.5\) 다. 중심이 같으니 \(z_{2j}\) 자체가 같고 \(b\) 도 \(S_2\) 도 같다.
\(a\) 가 같은 까닭. 이쪽은 더 섬세하다. \(g_1\) 의 중앙값은 \(12.5\), 평균은 \(12.625\) 로 다르다. 그런데 \(g(c) = \sum_j \lvert x_{1j} - c\rvert\) 는 볼록·조각선형이고 \(n\) 이 짝수이므로 최소점이 한 점이 아니라 구간 \([x_{(4)}, x_{(5)}] = [12, 13]\) 이다(11.5절 보기 1 의 유도). 평균 \(12.625\) 가 그 구간 안에 든다. 그러므로
이고 \(a = 11/8 = 1.375\) 가 두 중심에서 같다. 개별 \(z_{1j}\) 는 다른데 합이 같다.
그러므로 차이는 분모에만 남는다. \(S_1\) 은 \(z_{1j}\) 의 산포이므로 개별 값이 바뀌면 달라진다. 두 \(W\) 의 비는
로 분모만의 비가 된다.
확인한다.
import numpy as np
from scipy.stats import levene

# 세 집단의 평균은 크게 다르지만 퍼짐은 거의 같다.
g1 = np.array([12, 15, 14, 10, 13, 14, 12, 11], dtype=float)
g2 = np.array([22, 25, 20, 18, 24, 23, 19, 21], dtype=float)
g3 = np.array([32, 35, 34, 30, 33, 34, 32, 31], dtype=float)

print("variances:", [round(np.var(g, ddof=1), 4) for g in (g1, g2, g3)])

# scipy 에는 brown_forsythe 라는 함수가 따로 없다. levene 에
# center='median' 을 주는 것이 곧 Brown-Forsythe 이고, 이것이 기본값이다.
W, p = levene(g1, g2, g3, center='median')
print(f"Brown-Forsythe W = {W:.6f}, p-value = {p:.6f}")

W_mean, p_mean = levene(g1, g2, g3, center='mean')
print(f"Levene (mean)  W = {W_mean:.6f}, p-value = {p_mean:.6f}")

# (1) g3 가 g1 의 평행이동인가.
print(f"\ng3 - g1 = {g3 - g1}   ->  g3 = g1 + {int((g3 - g1)[0])} 인가: "
      f"{np.all(g3 - g1 == 20)}")

# (1)(2) 닫힌 꼴 W = 56 (zbar1 - zbar2)^2 / (2 S1 + S2) 를 두 중심에서 조립한다.
print(f"\n{'중심':>7}{'zbar1':>9}{'zbar2':>9}{'S1':>9}{'S2':>9}"
      f"{'분자 56(dz)^2':>15}{'분모 2S1+S2':>13}{'W':>11}")
for name, c in [("median", np.median), ("mean", np.mean)]:
    z1, z2, z3 = (np.abs(g - c(g)) for g in (g1, g2, g3))
    assert np.array_equal(z1, z3)          # g3 = g1 + 20 이므로 편차가 같다
    a, b = z1.mean(), z2.mean()
    S1 = ((z1 - a) ** 2).sum()
    S2 = ((z2 - b) ** 2).sum()
    num, den = 56 * (a - b) ** 2, 2 * S1 + S2
    print(f"{name:>7}{a:>9.4f}{b:>9.4f}{S1:>9.4f}{S2:>9.4f}"
          f"{num:>15.5f}{den:>13.4f}{num / den:>11.6f}")

# 왜 zbar1 이 두 중심에서 같은가. 중앙값이 sum|y-c| 를 최소화하는 구간을 본다.
s = np.sort(g1)
print(f"\ng1 정렬 = {s}")
print(f"  중앙값 = {np.median(g1):.3f},  평균 = {g1.mean():.3f}")
print(f"  최소화 구간 [x_(4), x_(5)] = [{s[3]:.0f}, {s[4]:.0f}] 에 평균이 드는가: "
      f"{s[3] <= g1.mean() <= s[4]}")
for c in (s[3], np.median(g1), g1.mean(), s[4]):
    print(f"    c = {c:7.3f}  ->  sum|g1 - c| = {np.abs(g1 - c).sum():.6f}")
print(f"\ng2 의 평균 {g2.mean():.3f} = 중앙값 {np.median(g2):.3f} 인가: "
      f"{g2.mean() == np.median(g2)}")

# (2) 분자가 같으니 두 W 의 비는 분모의 비와 같아야 한다.
print(f"\nW(mean)/W(median) = {W_mean / W:.6f}")
print(f"분모의 비 19.75/19.50 = {19.75 / 19.50:.6f}")
출력:
variances: [2.8393, 6.0, 2.8393]
Brown-Forsythe W = 1.107595, p-value = 0.348894
Levene (mean)  W = 1.121795, p-value = 0.344444

g3 - g1 = [20. 20. 20. 20. 20. 20. 20. 20.]   ->  g3 = g1 + 20 인가: True

     중심    zbar1    zbar2       S1       S2    분자 56(dz)^2    분모 2S1+S2          W
 median   1.3750   2.0000   4.8750  10.0000       21.87500      19.7500   1.107595
   mean   1.3750   2.0000   4.7500  10.0000       21.87500      19.5000   1.121795

g1 정렬 = [10. 11. 12. 12. 13. 14. 14. 15.]
  중앙값 = 12.500,  평균 = 12.625
  최소화 구간 [x_(4), x_(5)] = [12, 13] 에 평균이 드는가: True
    c =  12.000  ->  sum|g1 - c| = 11.000000
    c =  12.500  ->  sum|g1 - c| = 11.000000
    c =  12.625  ->  sum|g1 - c| = 11.000000
    c =  13.000  ->  sum|g1 - c| = 11.000000

g2 의 평균 21.500 = 중앙값 21.500 인가: True

W(mean)/W(median) = 1.012821
분모의 비 19.75/19.50 = 1.012821
닫힌 꼴이 SciPy 와 소수 여섯째 자리까지 맞는다. 네 수 \((a, b, S_1, S_2)\) 만으로 조립한 \(W\) 가 중앙값 쪽 \(1.107595\), 평균 쪽 \(1.121795\) 로 levene 의 값과 같다. 손으로 따라가면
이다. assert np.array_equal(z1, z3) 가 통과한 것이 \(g_3 = g_1 + 20\) 의 결과를 확인해 준다.
(2)의 예측이 모두 맞는다. 분자가 두 중심에서 \(21.87500\) 으로 완전히 같고, \(S_2 = 10.0000\) 도 같다. 달라진 것은 \(S_1\) 하나, \(4.8750\) 대 \(4.7500\) 뿐이다. 그래서 분모가 \(19.75\) 대 \(19.50\) 이 되고 \(W\) 의 비가 \(1.012821\), 분모의 비 \(19.75/19.50 = 1.012821\) 과 소수 여섯째 자리까지 같다.
\(\sum_j \lvert g_1 - c\rvert\) 가 네 점에서 모두 정확히 \(11\) 이라는 줄이 (2)의 핵심이다. \(c = 12,\ 12.5,\ 12.625,\ 13\) 어디서 재도 같다. 짝수 표본에서 최소점이 구간이라는 사실이 눈에 보이는 꼴이며, 평균이 그 구간 안에 들어 있었다는 우연 덕분에 분자가 보존되었다. 평균이 \([12, 13]\) 밖으로 나가면 \(a\) 가 커지고 분자까지 달라진다.
\(S_1\) 쪽이 중앙값에서 더 크다는 것도 눈여겨볼 만하다. \(4.875 > 4.750\) 이다. 중앙값은 \(z\) 의 합을 최소화하지만 \(z\) 의 산포는 최소화하지 않으며, 여기서는 오히려 키웠다. 그 결과 중앙값 판의 \(W\) 가 더 작고 \(p\) 값이 더 크다(\(0.348894\) 대 \(0.344444\)). 로버스트성의 대가인 검정력 손실이 이 자료에서는 \(p\) 값 소수 셋째 자리만큼이다.
해석
- \(W\) 통계량이 크면(\(p\)값이 작으면) \(H_0\)을 기각하고 집단분산이 모두 같지는 않다고 결론짓는다.
- 이 세 집단은 주로 위치가 다르고 산포는 비슷하므로 \(W\)가 작고 \(p\)가 크게 나온다. 등분산을 기각하지 못한다.
- 자료의 정규성이 불확실할 때 등분산성 검정의 권장 기본값이 Brown-Forsythe 검정이다.
표본분산이 \(2.84\), \(6.00\), \(2.84\)로 최대·최소 비가 \(2.1\)인데도 유의하지 않다. 각 집단 \(n = 8\)로는 검정력이 매우 낮기 때문이다.
연습문제
연습문제 1. 두 집단 \(\mathbf{x}_1 = (2, 4, 6)\)과 \(\mathbf{x}_2 = (1, 5, 9, 13)\)에 대해 Brown-Forsythe 검정통계량 \(W\)를 손으로 계산하라. 집단중앙값, 절대편차, 편차의 집단평균, \(F\) 비의 각 단계를 보여라.
풀이
집단중앙값: \(\tilde{x}_1 = 4\), \(\tilde{x}_2 = 7\).
중앙값으로부터의 절대편차:
- 집단 1: \(z_{11} = |2-4| = 2\), \(z_{12} = |4-4| = 0\), \(z_{13} = |6-4| = 2\)
- 집단 2: \(z_{21} = |1-7| = 6\), \(z_{22} = |5-7| = 2\), \(z_{23} = |9-7| = 2\), \(z_{24} = |13-7| = 6\)
집단평균: \(\bar{z}_1 = (2+0+2)/3 = 4/3\), \(\bar{z}_2 = (6+2+2+6)/4 = 4\).
전체평균: \(\bar{z} = (2+0+2+6+2+2+6)/7 = 20/7 = 2.8571\).
집단간 제곱합:
집단내 제곱합:
import numpy as np
from scipy.stats import levene, f

x1 = np.array([2, 4, 6.])
x2 = np.array([1, 5, 9, 13.])
print(levene(x1, x2, center='median'))
print(f"F critical (1, 5) at alpha=0.05: {f.ppf(0.95, 1, 5):.4f}")
출력:
LeveneResult(statistic=3.2653061224489797, pvalue=0.13057297707695592)
F critical (1, 5) at alpha=0.05: 6.6079
\(F(1, 5)\)의 \(\alpha = 0.05\) 임계값이 \(6.61\)이므로 \(3.27 < 6.61\)이 되어 \(H_0\)을 기각하지 못한다(\(p = 0.131\)).
표본분산이 \(4\) 대 \(26.67\)로 6.7배나 차이 나는데도 그렇다. \(n_1 = 3\), \(n_2 = 4\)라는 극단적으로 작은 표본에서는 어떤 검정도 무력하다. \(\square\)
연습문제 2. 모의실험 연구를 수행하라. 표준 대수정규분포에서 크기 30인 세 집단을 생성한다(모두 등분산). Bartlett 검정과 Brown-Forsythe 검정을 \(\alpha = 0.05\)에서 3,000회 반복 적용하여 거짓 양성률을 비교하라.
풀이
import numpy as np
from scipy.stats import bartlett, levene

rng = np.random.default_rng(42)
rej_bart, rej_bf = 0, 0
n_sims = 3000

for _ in range(n_sims):
    g1 = rng.lognormal(0, 1, 30)
    g2 = rng.lognormal(0, 1, 30)
    g3 = rng.lognormal(0, 1, 30)
    _, p_b = bartlett(g1, g2, g3)
    _, p_bf = levene(g1, g2, g3, center='median')
    if p_b < 0.05:
        rej_bart += 1
    if p_bf < 0.05:
        rej_bf += 1

print(f"Bartlett false-positive rate:       {rej_bart/n_sims:.4f}")
print(f"Brown-Forsythe false-positive rate: {rej_bf/n_sims:.4f}")
출력:
Bartlett false-positive rate:       0.7303
Brown-Forsythe false-positive rate: 0.0307
Bartlett의 거짓 양성률이 \(0.730\)이다. 명목값의 15배로, 등분산인 자료의 4분의 3에서 잘못 기각한다.
\(\text{Lognormal}(0,1)\)의 초과첨도가 \(110.9\)로 극단적이기 때문이다. 15.4절 Bartlett 검정 연습문제 4에서 \(n = 20\)일 때 \(0.675\)였는데, \(n = 30\)으로 키우니 오히려 \(0.730\)으로 악화되었다. 15.3절에서 확인한 "표본을 키우면 나빠진다"는 성질이 여기서도 나타난다.
Brown-Forsythe는 \(0.031\)로 명목값보다 약간 보수적이지만 완전히 통제된다. 로버스트 중심화의 효과가 24배 차이로 나타난다. \(\square\)
연습문제 3. Brown-Forsythe 검정이 위치 이동에 불변임을 증명하라. 곧 집단 \(i\)의 모든 관측값에 상수 \(c_i\)를 더해도 검정통계량 \(W\)가 변하지 않음을 보여라.
풀이
집단 \(i\)의 모든 \(j\)에 대해 \(x_{ij}' = x_{ij} + c_i\)라 하자. 집단중앙값도 같은 양만큼 이동한다. \(\tilde{x}_i' = \tilde{x}_i + c_i\). 변환값은
모든 \(z_{ij}\) 값이 변하지 않으므로 검정통계량 \(W\)도 동일하다. 이는 Brown-Forsythe 검정이 집단평균이 아니라 각 집단 내부의 산포에만 의존함을 확인해 준다.
왜 이것이 중요한 성질인가. 분산 검정이 위치에 의존한다면, 집단평균이 크게 다른 자료에서 분산 차이와 평균 차이를 구별할 수 없게 된다. 본문 보기에서 세 집단의 평균이 \(12.6\), \(21.5\), \(32.6\)으로 크게 다른데도 \(W\)가 오직 산포만 반영한다.
척도에는 불변이 아니다. 모든 집단에 같은 상수 \(c\)를 곱하면 모든 \(z_{ij}\)가 \(c\)배가 되지만, \(W\)는 분자와 분모 모두 \(c^2\)배가 되므로 여전히 불변이다. 그러나 집단마다 다른 상수를 곱하면 분산비가 바뀌므로 \(W\)가 달라진다. 이는 당연하며, 그것이 바로 이 검정이 탐지하려는 것이다. \(\square\)
연습문제 4. \(N(0, 1)\), \(N(0, 1.5)\), \(N(0, 2)\), \(N(0, 3)\)(표준편차 기준)에서 각각 \(n = 25\)인 네 집단을 생성하여 Brown-Forsythe 검정을 적용하라. \(W\)와 \(p\)값을 보고하라. 그런 다음 각 집단을 \(n = 100\)으로 늘려 반복하라. 표본크기가 검정력에 어떤 영향을 주는가?
풀이
import numpy as np
from scipy.stats import levene

rng = np.random.default_rng(42)

for n in [25, 100]:
    g1 = rng.normal(0, 1.0, n)
    g2 = rng.normal(0, 1.5, n)
    g3 = rng.normal(0, 2.0, n)
    g4 = rng.normal(0, 3.0, n)
    W, p = levene(g1, g2, g3, g4, center='median')
    print(f"n={n:3d}: W={W:.4f}, p={p:.6g}")
출력:
n= 25: W=8.3766, p=5.29567e-05
n=100: W=29.2350, p=4.28901e-17
\(n = 25\)에서 이미 \(p = 5.3 \times 10^{-5}\)로 강하게 기각한다. \(n = 100\)에서는 \(p = 4.3 \times 10^{-17}\)이다.
표준편차 비가 \(3:1\), 곧 분산비가 \(9:1\)로 매우 크기 때문이다. 15.4절 연습문제 4에서 세 집단 총 30개로 4배 차이를 겨우 탐지했음을 떠올리면, 여기 네 집단 총 100개로 9배 차이를 탐지하는 것은 쉬운 편이다.
표본크기의 효과. \(W\)가 \(8.38\)에서 \(29.24\)로 3.5배 커졌다. 표본크기가 네 배가 되면 검정통계량이 대략 네 배가 되어야 하는데(집단간 제곱합이 \(n\)에 비례), 3.5배는 그에 부합한다. 각 \(S_i^2\)의 표집변동이 줄어 참 분산 차이가 더 뚜렷해진다.
주의. 이 보기는 단일 실행이므로 검정력이 아니라 하나의 표본에서의 결과이다. 검정력을 논하려면 여러 번 반복하여 기각 비율을 세어야 한다. \(\square\)
연습문제 5. Brown-Forsythe 검정은 중심화에 중앙값을 쓴다. 대안으로 절사평균(예: 10% 절사)을 쓸 수 있다. \(z_{ij} = |x_{ij} - \bar{x}_{i,\text{trim}}|\)을 계산하고 \(z\) 값에 일원분산분석 \(F\) 검정을 수행하는 판을 구현하라. \(t(3)\) 분포 자료에서 중앙값 기반 판과 거짓 양성률을 비교하라.
풀이
import numpy as np
from scipy.stats import levene, trim_mean, f_oneway

rng = np.random.default_rng(0)
rej_med, rej_trim = 0, 0
n_sims = 3000

for _ in range(n_sims):
    g1 = rng.standard_t(3, 30)
    g2 = rng.standard_t(3, 30)
    g3 = rng.standard_t(3, 30)

    # 중앙값 중심 — Brown-Forsythe
    _, p_med = levene(g1, g2, g3, center='median')
    if p_med < 0.05:
        rej_med += 1

    # 절사평균 중심. 편차는 잘라 내지 않은 전체 표본에서 잰다
    # from the trimmed mean (data are NOT discarded)
    z_groups = [np.abs(g - trim_mean(g, 0.1)) for g in (g1, g2, g3)]
    _, p_trim = f_oneway(*z_groups)
    if p_trim < 0.05:
        rej_trim += 1

print(f"Median centering FPR:       {rej_med/n_sims:.4f}")
print(f"Trimmed mean centering FPR: {rej_trim/n_sims:.4f}")
출력:
Median centering FPR:       0.0383
Trimmed mean centering FPR: 0.0447
\(t(3)\) 분포에서 두 방법 모두 거짓 양성률을 0.05 근처로 조절한다. 절사평균 판이 \(0.045\)로 명목값에 조금 더 가깝다.
대칭이면서 꼬리가 중간 정도인 자료에서는 절사평균이 중앙값보다 효율적인 위치 추정량이므로 대립가설 아래 검정력이 조금 높을 수 있다. 다만 극단적인 치우침에는 중앙값이 더 로버스트하다.
이 구현과 SciPy의 center='trimmed'는 다르다
위 코드는 절사평균을 중심으로만 쓰고 편차는 모든 관측값에 대해 계산한다. 자료를 버리지 않는다.
반면 SciPy의 stats.levene(..., center='trimmed')는 자료 자체를 잘라낸다. 각 집단에서 양 끝 10%를 제거한 뒤 남은 관측값으로만 검정을 수행한다. 15.5절 Brown-Forsythe 검정에서 측정했듯 그 결과 정규 자료에서도 크기가 0.12~0.19까지 부풀려진다.
| 방법 | 자료 처리 | 정규 자료 크기 |
|---|---|---|
center='median' |
전부 사용 | 0.04 |
| 위 코드(절사평균 중심) | 전부 사용 | 0.05 |
center='trimmed' |
양 끝 10% 제거 | 0.15 |
가장 큰 편차들을 제거하면 F 통계량의 분모(집단내 제곱합)가 과도하게 줄어드는데, \(F\) 기준분포가 이 선택 효과를 보정하지 않기 때문이다.
절사평균 중심화를 쓰고 싶다면 위 코드처럼 직접 구현해야 한다. \(\square\)
정리하며
브라운–포사이드의 호출 방법은 간단하다.
levene(..., center='median')이 곧 이 검정이다. 별도 함수가 없으며, 기본값이므로 인자를 생략해도 같다.- 이름과 구현이 어긋나 보이는 점을 기억해 두면 문서를 읽을 때 혼동이 줄어든다.
- 중앙값 계산이 집단별로 이루어진다. 전체 중앙값이 아니라 각 집단의 중앙값에서 편차를 잰다.
- 표본이 짝수면 중앙값이 두 값의 평균이라 절대편차에 0 이 포함되지 않을 수 있다. 소표본에서 미세한 차이를 만든다.
- 보고할 때 어느 중심을 썼는지 밝힌다. 평균 중심과 중앙값 중심이 다른 답을 줄 수 있기 때문이다.
다음 절 Fligner-Killeen (코드) 로 넘어간다.