검정력 분석
1. 검정력의 정의
들어가는 이야기 — 1,950 명으로 산 99%
검정력은 참 효과가 정말 있을 때 그것을 잡아낼 확률이고, 교과서는 \(0.80\) 을 목표로 잡으라 한다. 그런데 세마글루타이드의 STEP 1 시험은 \(1{,}950\) 명으로 \(99\%\) 를 샀다. 그 \(99\%\) 는 「체중이 얼마나 줄었는가」 하나에 붙은 값이 아니다. 시험에는 그 물음 말고도 뒤이어 묻기로 미리 적어 둔 물음들이 있었고, \(99\%\) 는 그것들을 정해진 순서로 차례차례 검정하는 설계 전체에 붙는 값이다.
시험이 그만큼을 더 모은 까닭이 그것이다. 주 결과변수만 떼어 놓고 재면 수가 전혀 달라진다. 보고된 차이가 \(-12.44\) 퍼센트포인트이고, 신뢰구간에서 되짚은 공통 표준편차가 \(9.91\) 퍼센트포인트다. 이 둘로 \(0.80\) 을 맞추는 데는 집단당 열 명이면 되고 \(0.99\) 를 원해도 스물넷이면 된다. 같은 검정, 같은 효과인데 필요한 인원이 스무 명과 \(1{,}950\) 명으로 갈린다. 그 사이의 간격이 설계가 무엇을 더 사기로 했는지를 말해 준다.
그러니 「검정력 \(0.80\)」이라고만 적힌 수는 그대로 읽을 수 없다. 검정력은 수 하나가 아니다. 「무엇의 검정력인가」와 함께 오는 양이다. 검정력 곡선은 효과가 커질수록 올라가고 \(\alpha\) 를 조일수록 내려가는데, 그 곡선을 그리고 셈을 세우는 것이 이 절이고, 거기서 나온 수를 설계로 옮기는 자리는 8.5절 두 집단 비교를 위한 표본크기다.
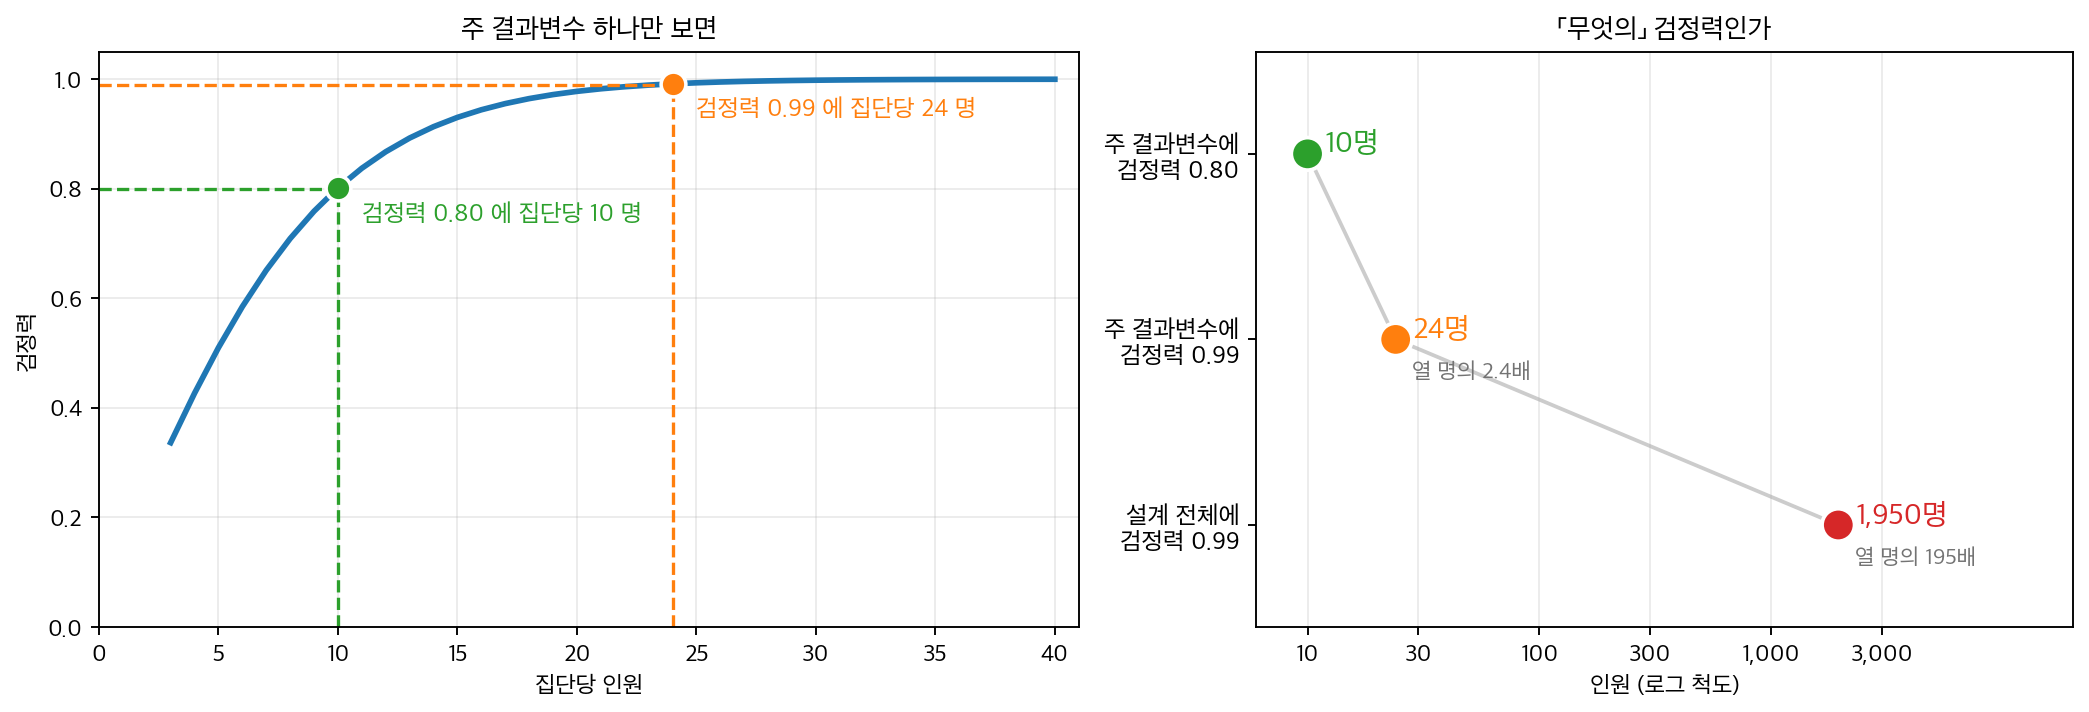
왼쪽 곡선은 보고된 차 \(-12.44\) 퍼센트포인트와 신뢰구간에서 되짚은 공통 표준편차 \(9.91\) 로 직접 그린 것이다. 같은 \(0.99\) 인데 오른쪽 둘째 점과 셋째 점이 \(81\) 배 떨어져 있다. 붙이는 대상이 다르기 때문이다 — \(24\) 명은 주 결과변수 하나에, \(1{,}950\) 명은 미리 적어 둔 물음들을 정해진 순서로 차례차례 검정하는 설계 전체에 붙는 값이다. 「검정력 \(0.80\)」이라고만 적힌 수를 그대로 읽을 수 없는 까닭이 여기 있다.
확인한 곳 — Wilding 외, 『New England Journal of Medicine』 \(384\)(\(2021\)) \(989\) 쪽의 통계 분석 절(「\(1{,}950\) 명이 공동 주결과변수와 확정적 이차 결과변수에 대해, 미리 정한 위계에 따라 검정할 때 유효 검정력 \(99\%\) 를 주었다」)과 결과 절(차이 \(-12.44\) 퍼센트포인트, \(95\%\) 구간 \(-13.37\) 에서 \(-11.51\), 두 군 \(1{,}306\) 명과 \(655\) 명). 공통 표준편차 \(9.91\) 퍼센트포인트와 집단당 인원은 그 구간과 두 군의 인원으로 직접 계산한 값이다
가설검정의 검정력(power)은 거짓인 귀무가설(null hypothesis)을 올바르게 기각할 확률이다. 제2종 오류율 \(\beta\), 곧 대립가설 \(H_a\) 가 참인데도 \(H_0\) 을 기각하지 못할 확률을 \(1\) 에서 뺀 값이다.
검정력이 높은 검정은 참 효과가 있을 때 그것을 탐지할 가능성이 크다. 연구자들은 보통 검정력 0.80(80%) 이상을 목표로 하며, 이는 참 효과를 탐지할 확률이 80%라는 뜻이다.
2. 검정력에 영향을 주는 요인
검정력을 결정하는 핵심 요인은 넷이다.
1. 유의수준 (α)
\(\alpha\)를 키우면(예: 0.01에서 0.05로) \(H_0\)을 기각하기 쉬워져 검정력이 커진다. 그러나 제1종 오류(type I error)의 위험도 함께 커진다.
2. 표본크기 (n)
표본이 클수록 검정통계량(test statistic)의 표준오차가 줄어 참 차이를 탐지하기 쉬워지므로 검정력이 커진다. 실무에서 검정력을 높이는 가장 현실적인 지렛대이다.
3. 효과크기
효과크기(effect size)는 참 차이 또는 효과의 크기를 잰다. 효과가 클수록 탐지하기 쉬워 검정력이 커진다. 흔히 쓰는 측도가 둘이다.
- 평균 비교의 코헨의 \(d\)(Cohen's \(d\)): \(d = \frac{\mu_1 - \mu_0}{\sigma}\)
- 비율 비교의 비율 차이
4. 모집단의 변동성 (σ)
모집단의 변동성이 작을수록 참 효과를 탐지하기 쉬워 검정력이 커진다. 연구자가 모집단 변동성을 통제하기는 대개 어렵지만, 더 나은 연구 설계로 측정오차는 줄일 수 있다.
3. 실무에서의 검정력 분석
검정력 분석은 주로 두 가지 방식으로 쓰인다.
사전 검정력 분석 (표본크기의 결정)
연구를 수행하기 전에, 예상되는 효과크기를 원하는 검정력과 유의수준으로 탐지하는 데 필요한 최소 표본크기를 검정력 분석으로 정한다.
보기 1. 필요한 표본크기 구하기. \(\sigma\)를 아는 일표본 \(z\) 검정에서 효과크기 \(d = \delta/\sigma\)를 \(\alpha = 0.05\) 양측, 검정력 \(0.80\)으로 탐지하려 한다.
(1) 필요한 표본크기가
임을 유도하시오. 왜 두 분위수(quantile)를 더하는가.
(2) \(d = 0.5\)에서 값을 구하고, 효과크기가 절반이 되면 표본이 몇 배가 되는지 말하시오.
풀이
(1) 해석적으로. \(H_0\) 아래에서 \(Z = (\bar X - \mu_0)/(\sigma/\sqrt n) \sim N(0,1)\)이고 \(\lvert Z \rvert > z_{1-\alpha/2}\)일 때 기각한다. \(H_a\colon \mu = \mu_0 + \delta\)(\(\delta > 0\)) 아래에서 \(\bar X\)의 중심이 \(\delta\)만큼 옮겨 가므로
이다. 왼쪽 꼬리로 기각할 확률은 \(\delta > 0\)이면 무시할 수 있을 만큼 작으므로
이다. 이것을 \(1-\beta\)와 같다고 놓으면 \(d\sqrt n - z_{1-\alpha/2} = z_{1-\beta}\), 곧
이고 양변을 제곱하면 주어진 식이다.
두 분위수를 더하는 까닭. 기각 임계값은 하나뿐이다. 그 임계값은 \(H_0\) 분포의 중심에서 오른쪽으로 \(z_{1-\alpha/2}\)만큼, \(H_a\) 분포의 중심에서 왼쪽으로 \(z_{1-\beta}\)만큼 떨어진 자리다. 그러므로 두 중심 사이의 거리가 \(z_{1-\alpha/2} + z_{1-\beta}\)이고, 그 거리를 표준오차 단위로 재면 \(d\sqrt n\)이다. 더하는 것은 두 오류를 양쪽에서 함께 막기 때문이다. 코드에서 \(z_{1-\beta}\)를 ppf(power)로 쓰는 것도 같은 이유다. 검정력이 클수록 \(H_a\) 쪽에서 더 깊이 들어가야 하므로 \(z_{1-\beta}\)가 커진다.
「무시할 수 있을 만큼」이 얼마인가
위에서 왼쪽 꼬리를 버렸다. \(d = 0.5\)에서 \(\lambda = d\sqrt n\)으로 두 꼬리를 따로 재면
| \(n\) | \(\lambda\) | 첫째 항 \(\Phi(\lambda - z_{1-\alpha/2})\) | 둘째 항 \(\Phi(-z_{1-\alpha/2}-\lambda)\) |
|---|---|---|---|
| \(20\) | \(2.236068\) | \(0.608766\) | \(1.358\times10^{-5}\) |
| \(50\) | \(3.535534\) | \(0.942438\) | \(1.948\times10^{-8}\) |
| \(100\) | \(5.000000\) | \(0.998817\) | \(1.702\times10^{-12}\) |
이다. 둘째 항은 \(n = 20\)에서도 전체의 \(0.002\%\)뿐이고 \(n\)이 커지면 자릿수로 사라진다. 참 효과가 양수인데 표본이 거꾸로 나와 왼쪽 꼬리에서 기각되는 경우이니, 효과가 뚜렷할수록 일어나지 않는다.
그래도 식에서 빼면 안 된다. \(\lambda\)가 작으면 둘째 항이 되살아난다. \(\lambda = 0.5\)에서는 첫째 항이 \(0.072150\), 둘째 항이 \(0.006948\)로 둘째가 전체의 \(8.8\%\)다. \(\lambda = 0\)에서는 \(0.025 + 0.025\)가 되어 둘을 합쳐야 정확히 \(\alpha\)가 된다. 버리는 것은 효과가 뚜렷하다는 전제 아래에서만 옳고, 검정력이 낮은 설계를 따질 때는 그 전제가 바로 깨진다.
기각이 기각이기는 하지만 반가운 일은 아니다. 효과의 방향을 반대로 보고하게 되기 때문이다. 이 둘째 꼬리를 정면으로 재는 것이 연습문제 15의 부호 오류(S-오류)다.
(2) 해석적으로. \(z_{0.975} = 1.959964\), \(z_{0.8} = 0.841621\)이므로
이다. \(n\)이 \(d^{-2}\)에 비례하므로 효과가 절반이면 표본은 네 배가 된다. \(d = 0.25\)에서는 \(125.58 \rightarrow 126\)이다.
수치적으로.
from scipy import stats
import numpy as np

def sample_size_z_test(effect_size, alpha=0.05, power=0.80, alternative='two-sided'):
    """일표본 z-검정에 필요한 표본크기."""
    if alternative == 'two-sided':
        z_alpha = stats.norm.ppf(1 - alpha / 2)
    else:
        z_alpha = stats.norm.ppf(1 - alpha)
    # z_beta는 ppf(power)이지 ppf(1 - power)가 아니다.
    # 검정력이 클수록 z_beta가 커져 n이 늘어나야 하기 때문이다.
    z_beta = stats.norm.ppf(power)
    # 두 임계값을 **더한다**. alpha는 H0 분포의 오른쪽 꼬리에서,
    # beta는 Ha 분포의 왼쪽 꼬리에서 재므로 둘 사이의 거리가 두 값의 합이다.
    n = ((z_alpha + z_beta) / effect_size) ** 2
    return int(np.ceil(n))

# 효과크기 0.5를 검정력 80%로 탐지하려면?
n = sample_size_z_test(effect_size=0.5)
print(f"Required sample size: {n}")

# (2) 올림하기 전의 값과 1/d^2 비례를 확인한다.
za, zb = stats.norm.ppf(0.975), stats.norm.ppf(0.80)
print(f"za + zb = {za + zb:.6f}")
for d in (0.5, 0.25):
    print(f"  d = {d:.2f}: n = {((za + zb) / d) ** 2:.4f}"
          f"  -> {sample_size_z_test(effect_size=d)}")
출력:
Required sample size: 32
za + zb = 2.801585
  d = 0.50: n = 31.3955  -> 32
  d = 0.25: n = 125.5821  -> 126
유도한 \(31.3955\)와 \(125.5821\)이 그대로 나왔고, 뒤가 앞의 정확히 네 배다.
올림 때문에 정수 답은 \(32\)와 \(126\)이라 네 배가 되지 않는 것처럼 보이지만(\(32 \times 4 = 128\)), 올림 전의 값은 정확히 네 배다. 효과크기가 분모에서 제곱되므로 작은 효과를 보는 일은 언제나 비싸다.
사후 검정력 분석
연구를 마친 뒤 관측된 효과크기, 표본크기, 유의수준으로 달성된 검정력을 계산할 수 있다. 그러나 유의하지 않은 결과에 대한 사후 검정력 분석은 p 값을 넘는 정보를 거의 주지 않으므로 일반적으로 권장되지 않는다. 관측된 효과크기를 그대로 넣어 계산한 검정력은 p 값이 정해지면 따라서 정해지는 값이어서, p 값이 크면 사후 검정력은 저절로 낮게 나온다. 같은 정보를 다른 이름으로 한 번 더 적는 셈이다.
4. 검정력의 시각화
\(H_0\)과 \(H_a\) 아래의 분포를 함께 그리면 검정력을 이해할 수 있다.
보기 2. 검정력을 그림으로 보기. \(\mu_0 = 50\), \(\mu_a = 52\), \(\sigma = 10\), \(n = 25\)인 우측 단측 \(z\) 검정을 \(\alpha = 0.05\)에서 본다.
(1) 임계값 \(x_c\)와 검정력의 닫힌 꼴을 구하고 값을 계산하시오.
(2) 검정력을 \(0.80\)으로 올리려면 \(n\)이 얼마여야 하는가. 그림에서 무엇이 달라지는가.
풀이
(1) 해석적으로. 표준오차는 \(\text{SE} = \sigma/\sqrt n = 10/5 = 2\)다. 우측 단측이므로 임계값은 \(H_0\) 분포의 오른쪽 \(5\%\) 자리,
이다. 검정력은 같은 임계값을 \(H_a\) 분포에서 재는 것이다.
여기서 \((\mu_a - \mu_0)/\text{SE} = 2/2 = 1\)이므로
이다. 참 평균이 정말 52인데도 네 번 중 세 번은 기각하지 못한다.
(2) 해석적으로. 보기 1의 식을 단측으로 바꾸면 \(z_{1-\alpha/2}\) 자리에 \(z_{1-\alpha}\)가 들어간다. \(d = \delta/\sigma = 2/10 = 0.2\)이므로
이다. \(25\)에서 \(155\)로 여섯 배가 넘게 든다. 그림에서는 두 곡선이 모두 \(\sqrt{155/25} = 2.49\)배 좁아져 중첩이 크게 줄고, 임계값이 \(50 + 1.644854 \times 10/\sqrt{155} = 51.32\)로 왼쪽으로 옮겨 가며, 빨간 영역이 \(H_a\) 분포 넓이의 80%를 차지하게 된다.
수치적으로.
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False

def plot_power(mu_0, mu_a, sigma, n, alpha=0.05):
    """단측 z 검정의 검정력을 그림으로 보인다.

        귀무분포와 대립분포를 겹쳐 그리고, 기각역에 해당하는 두 넓이를 칠한다.
        귀무 쪽 넓이가 alpha, 대립 쪽 넓이가 검정력이다.
        """
    se = sigma / np.sqrt(n)
    z_crit = stats.norm.ppf(1 - alpha)
    x_crit = mu_0 + z_crit * se

    x = np.linspace(mu_0 - 4*se, mu_a + 4*se, 300)

    # 귀무가설이 참일 때의 분포
    y_h0 = stats.norm(mu_0, se).pdf(x)
    # 대립가설이 참일 때의 분포. 중심만 오른쪽으로 옮겨 간다.
    y_ha = stats.norm(mu_a, se).pdf(x)

    fig, ax = plt.subplots(figsize=(12, 4))
    ax.plot(x, y_h0, 'b-', label=f'$H_0$: $\\mu = {mu_0}$')
    ax.plot(x, y_ha, 'r-', label=f'$H_a$: $\\mu = {mu_a}$')

    # 귀무 분포에서 기각역에 해당하는 꼬리. 그 넓이가 유의수준 alpha 다.
    x_reject = x[x >= x_crit]
    ax.fill_between(x_reject, stats.norm(mu_0, se).pdf(x_reject), alpha=0.3, color='blue', label=f'$\\alpha$ = {alpha}')

    # 대립 분포에서 같은 기각역의 넓이. 그것이 검정력이다.
    ax.fill_between(x_reject, stats.norm(mu_a, se).pdf(x_reject), alpha=0.3, color='red', label=f'Power = {1 - stats.norm(mu_a, se).cdf(x_crit):.3f}')

    ax.axvline(x_crit, color='k', linestyle='--', label=f'Critical value = {x_crit:.2f}')
    ax.legend()
    ax.set_xlabel('Sample Mean')
    ax.set_ylabel('Density')
    ax.set_title('Power of a Hypothesis Test')
    plt.show()

plot_power(mu_0=50, mu_a=52, sigma=10, n=25)

# (1) 과 (2) 의 닫힌 꼴을 확인한다.
mu0, mua, sigma, n_now, al = 50, 52, 10, 25, 0.05
se = sigma / np.sqrt(n_now)
z_al, z_be = stats.norm.ppf(1 - al), stats.norm.ppf(0.80)
x_c = mu0 + z_al * se
print(f"SE = {se}, x_c = {x_c:.6f}")
print(f"검정력  닫힌 꼴 {stats.norm.sf(z_al - (mua - mu0) / se):.6f}"
      f"   직접 {stats.norm(mua, se).sf(x_c):.6f}")

d = (mua - mu0) / sigma
n_need = ((z_al + z_be) / d) ** 2
print(f"검정력 0.80 에 필요한 n = {n_need:.2f} -> {int(np.ceil(n_need))}")
se2 = sigma / np.sqrt(np.ceil(n_need))
print(f"  그때 SE = {se2:.4f} (지금의 1/{se / se2:.2f}),"
      f"  x_c = {mu0 + z_al * se2:.2f},"
      f"  검정력 = {stats.norm.sf(z_al - (mua - mu0) / se2):.4f}")
출력:
SE = 2.0, x_c = 53.289707
검정력  닫힌 꼴 0.259511   직접 0.259511
검정력 0.80 에 필요한 n = 154.56 -> 155
  그때 SE = 0.8032 (지금의 1/2.49),  x_c = 51.32,  검정력 = 0.8010
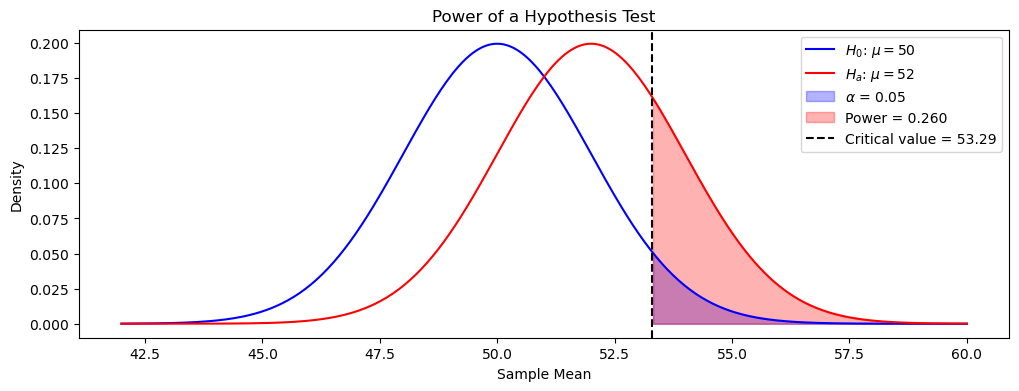
(1)에서 유도한 \(x_c = 53.289707\)과 검정력 \(0.259511\)이 그대로 나왔고, 닫힌 꼴 \(\Phi(d\sqrt n - z_{1-\alpha})\)와 \(H_a\) 분포에서 직접 잰 값이 소수점 여섯째 자리까지 같다. (2)의 \(n = 155\)도 확인되며, 그 설계의 실제 검정력은 \(0.8010\)으로 목표를 갓 넘는다.
파란 곡선이 \(H_0\) 아래, 빨간 곡선이 \(H_a\) 아래의 \(\bar X\) 분포다. 검은 점선이 임계값 \(53.29\)이고, 그 오른쪽의 파란 영역이 \(\alpha = 0.05\), 빨간 영역이 검정력이다(그림의 범례는 소수점 셋째 자리로 반올림해 \(0.260\)으로 적혀 있다).
두 곡선이 겹치는 정도가 곧 검정의 무력함이다. 두 중심이 \(2\)만큼 떨어져 있는데 표준오차가 \(2\)라 딱 한 표준오차만큼만 벌어져 있다. 보기 1의 식으로 읽으면 \(d\sqrt n = 1\)인데 \(0.80\)을 얻으려면 \(z_{0.95} + z_{0.8} = 2.486\)이 필요하니, 지금 가진 것은 필요한 거리의 40%뿐이다. 거리는 \(\sqrt n\)에 비례하므로 모자란 \(1/0.40 = 2.49\)배를 메우려면 \(n\)을 \(2.49^2 = 6.2\)배로 늘려야 하고, 그래서 \(25 \to 155\)가 된다.
5. 검정력, 표본크기, 효과크기의 관계
| 효과크기 | 필요한 \(n\) (이표본, 집단당, 검정력 = 0.80, \(\alpha\) = 0.05) |
|---|---|
| 작음 (\(d = 0.2\)) | ~393 |
| 중간 (\(d = 0.5\)) | ~64 |
| 큼 (\(d = 0.8\)) | ~26 |
이 값들은 작은 효과를 탐지하려면 왜 훨씬 큰 표본이 필요한지 보여준다.
그림으로 보는 통계학 1. 전쟁이 끝날 때까지 묶여 있던 검정
지금까지의 셈은 모두 \(n\) 을 미리 정하는 셈이었다. \(\alpha\) 와 검정력을 고르면 \(n\) 이 나오고, 그 \(n\) 만큼 모아서 한 번에 판정한다.
1943 년에 어떤 해군 장교가 컬럼비아 대학의 통계연구단(Statistical Research Group, SRG)에 그 전제를 되물었다. 탄약 검사 이야기였다. 계획은 「\(181\) 발을 쏘아 보고 불량이 \(4\) 발 이하면 그 그룹을 합격시킨다」 같은 모양이다.
그런데 첫 스무 발에서 불량이 다섯 발 나오면, 왜 나머지 백예순 발을 마저 쏘는가? 결론은 이미 났는데.
통계연구단은 이 책에 이미 한 번 나왔다. 돌아온 비행기만 보고 장갑을 어디에 댈지 정한 아브라함 왈드의 각서가 같은 곳, 같은 사람의 일이다.
왈드(Wald)의 답은 한 발마다 판단을 갱신하는 것이었다. 로그가능도비(log-likelihood ratio)를 쌓아 가며 두 임계값과 견준다.
위를 넘으면 되돌려보내고, 아래를 넘으면 합격시키고, 사이면 한 발 더. 이것이 순차확률비검정(sequential probability ratio test, SPRT)이다.
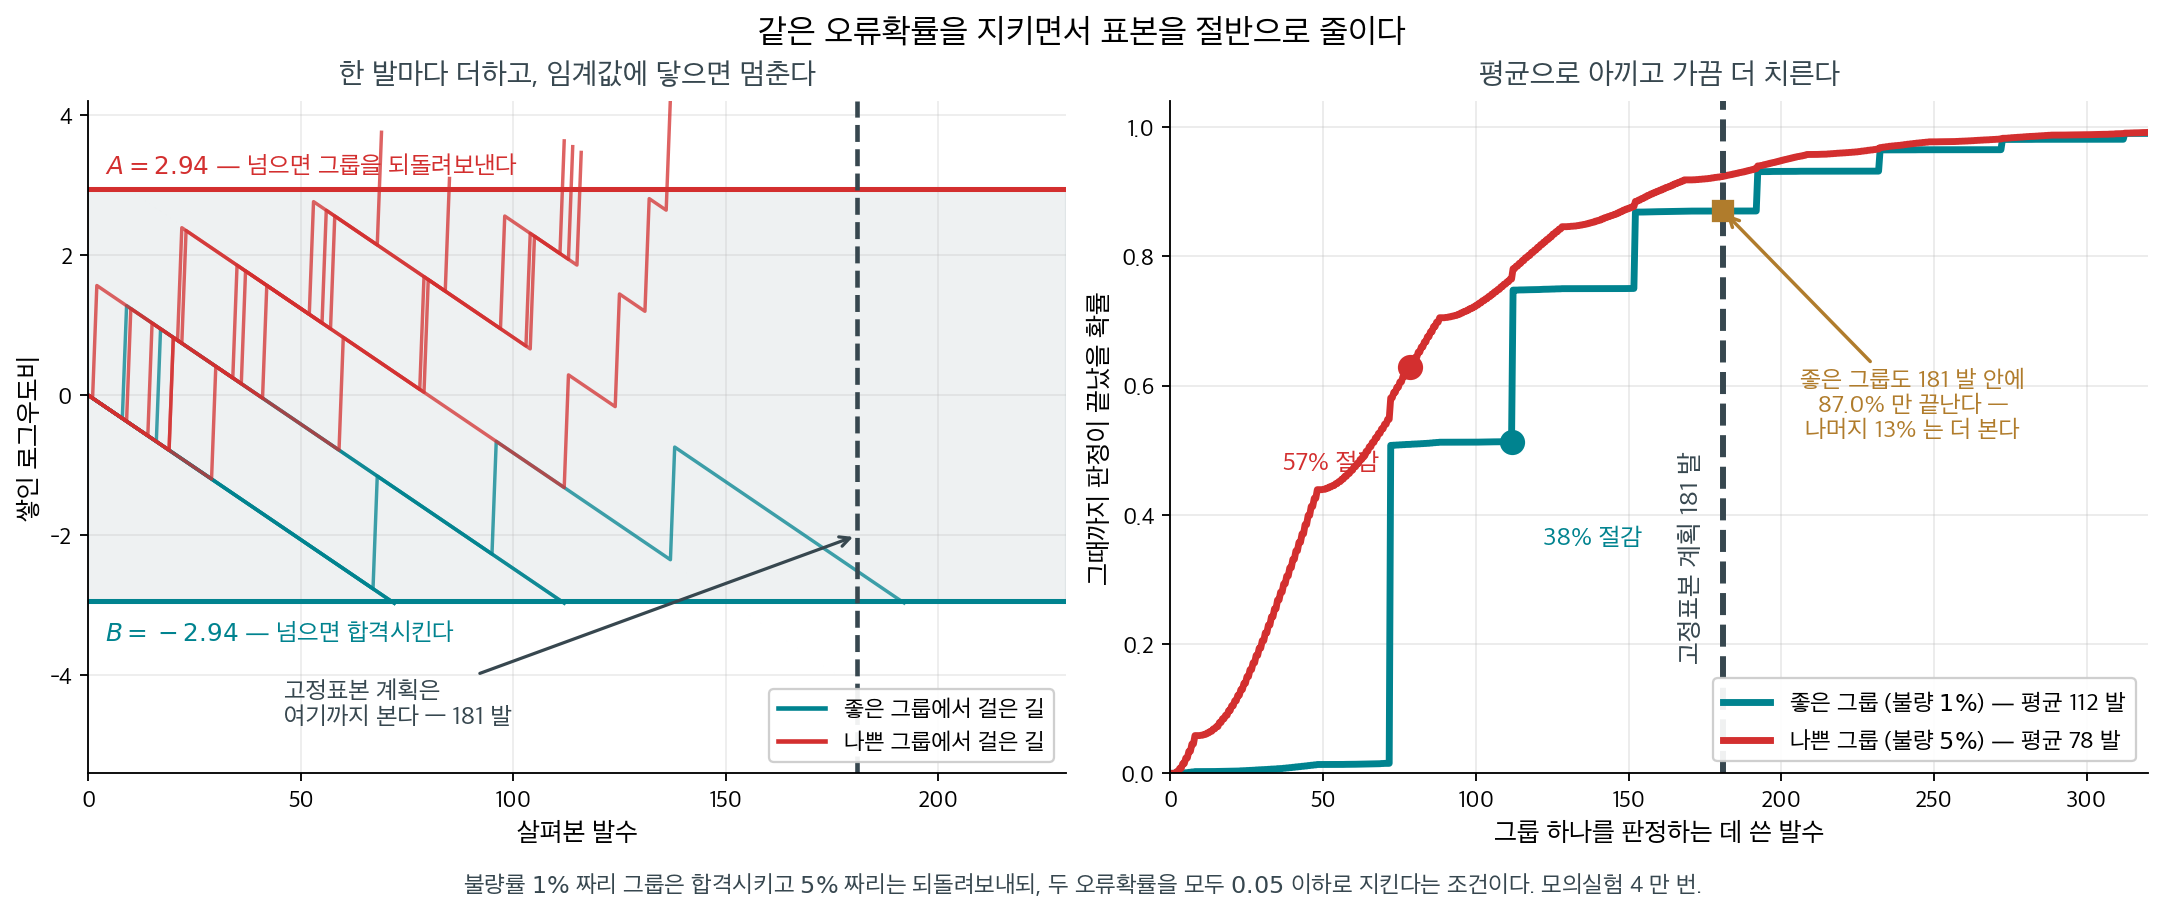
왼쪽에서 멀쩡한 한 발은 선을 아주 조금 내리고(\(-0.041\)) 불량 한 발은 크게 올린다(\(+1.609\)). 오른쪽 왼편의 가파른 계단은 \(72\) 발이 내리 멀쩡하면 그것만으로 합격이라는 뜻이다.
재 보면 이렇다. 불량률 \(1\%\) 는 합격시키고 \(5\%\) 는 되돌려보내되 두 오류확률을 모두 \(0.05\) 이하로 지키라는 조건이다.
| 쓰는 발수 | 절감 | |
|---|---|---|
| 고정표본 계획 | \(181\) 발 (불량 \(4\) 발 이하면 합격) | — |
| SPRT, 좋은 그룹에서 | 평균 \(\mathbf{112}\) 발 | \(38\%\) |
| SPRT, 나쁜 그룹에서 | 평균 \(\mathbf{78}\) 발 | \(57\%\) |
오류확률은 그대로다 — 모의실험에서 좋은 그룹을 되돌려보낸 비율이 \(0.028\), 나쁜 그룹을 되돌려보낸 비율이 \(0.950\) 이었다. 같은 약속을 지키면서 탄약을 절반 가까이 아낀 것이다.
전시에 이 수가 무슨 뜻이었는지는 설명이 필요 없다. 이 방법은 군사적 가치가 커서 전쟁이 끝날 때까지 공개가 묶였다. 왈드의 책 『순차분석』은 \(1947\) 년에야 나왔다. 영국에서도 바너드(Barnard)가 따로 같은 것에 이르렀고, 그쪽도 묶였다.
\(1948\) 년에 왈드와 울포위츠(Wolfowitz)가 더 센 것을 증명했다. 오류확률이 \(\alpha\), \(\beta\) 이하인 모든 검정 가운데 — 순차든 고정이든 — SPRT 가 두 가설 아래의 기대 표본크기를 동시에 최소화한다. 더 나은 것이 있을 수 없다는 뜻이다.
다만 공짜는 아니다. 그림 오른쪽이 그 값을 보여 준다. SPRT 가 쓰는 발수는 들쭉날쭉하다. 좋은 그룹이라도 \(181\) 발 안에 끝나는 것은 \(87.0\%\) 뿐이고, 나머지 \(13\%\) 는 고정 계획보다 더 쏜다. 평균으로 아끼고 가끔 더 치르는 거래다. 검사 일정을 미리 못 박아야 하는 공장에서 이것이 문제가 되어, 뒤에 최대 발수를 잘라 둔 절단 SPRT 가 나왔다.
확인한 곳 — 왈드가 \(1943\) 년 \(9\) 월 자 열람 제한 보고서로 순차확률비검정과 그 이론을 제출한 것, 군사·해군 장비 개발에 쓸모가 커서 공개가 묶였고 네 해 뒤 『Sequential Analysis』(Wiley, \(1947\))로 나온 것, 왈드·울포위츠의 「Optimum character of the sequential probability ratio test」(『Annals of Mathematical Statistics』, \(1948\)). 표와 그림의 수는 모두 직접 모의실험한 값이다
6. 검정마다 손 근사와 패키지 값을 맞춰 보기
Statsmodels는 여러 검정 유형에 대한 검정력 분석 함수를 폭넓게 제공한다.
일표본 t-검정
보기 3. 일표본 t-검정의 검정력. \(\sigma\)를 모르는 경우다. \(\mu_0 = 0\), \(\mu_a = 5\), \(\sigma = 15\)라 \(d = 1/3\)이고, \(\alpha = 0.05\) 양측에서 검정력 \(0.80\)을 목표로 한다.
(1) 보기 1의 \(z\) 공식으로 \(n\)을 근사하고, \(n = 50\)일 때의 검정력도 \(z\)로 근사하시오.
(2) statsmodels가 쓰는 비중심 \(t\)의 답과 견주시오. 어느 쪽으로 얼마나 어긋나는가.
풀이
(1) 해석적으로. \(z_{0.975} + z_{0.8} = 2.801585\)이고 \(d = 1/3\)이므로
이다. \(n = 50\)에서의 검정력은 보기 1에서 쓴 식 \(\Phi(d\sqrt n - z_{1-\alpha/2})\)에 넣으면
이다.
(2) 비중심 \(t\)가 옳은 답이다. \(\sigma\)를 모르면 분모가 \(S\)라 통계량이 \(t\)를 따르고, \(H_a\) 아래에서는 비중심모수(noncentrality parameter) \(\lambda = d\sqrt n\)인 비중심 \(t\)를 따른다. \(z\) 공식은 두 군데에서 낙관적이다. 임계값이 \(z_{1-\alpha/2}\)가 아니라 더 큰 \(t_{1-\alpha/2,\,n-1}\)이고, 대립분포의 꼬리도 정규보다 두껍다. 그래서 \(z\) 근사는 필요한 \(n\)을 적게, 주어진 \(n\)의 검정력을 크게 내놓는다.
수치적으로.
from statsmodels.stats.power import TTestPower
import numpy as np

analysis = TTestPower()

# 5점 차이를 탐지하려면 몇 명이 필요한가? (mu_0 = 0, mu_a = 5, sigma = 15)
# 검정력 계산에 들어가는 것은 delta도 sigma도 아니라 그 비뿐이다.
# 5점/15와 1점/3은 검정력 관점에서 완전히 같은 문제다.
effect_size = 5 / 15  # Cohen's d = 0.333

n_needed = analysis.solve_power(effect_size=effect_size, alpha=0.05,
                                power=0.80, alternative='two-sided')
print(f"One-sample t-test:")
print(f"  Effect size (Cohen's d): {effect_size:.3f}")
print(f"  Sample size needed for 80% power: {int(np.ceil(n_needed))}")

# 반대 방향의 질문: n이 정해져 있을 때 검정력은 얼마인가?
power = analysis.power(effect_size=effect_size, nobs=50, alpha=0.05,
                      alternative='two-sided')
print(f"  Power with n=50: {power:.3f}")

# (1) 의 z 근사와 견준다.
za, zb = stats.norm.ppf(0.975), stats.norm.ppf(0.80)
n_z = ((za + zb) / effect_size) ** 2
pw_z = stats.norm.sf(za - effect_size * np.sqrt(50))
print(f"\n  z 근사   n = {n_z:.4f},  n=50 의 검정력 = {pw_z:.6f}")
print(f"  비중심 t n = {n_needed:.4f},  n=50 의 검정력 = {power:.6f}")
print(f"  차이        {n_needed - n_z:+.4f}명,"
      f"             {power - pw_z:+.6f}")
출력:
One-sample t-test:
  Effect size (Cohen's d): 0.333
  Sample size needed for 80% power: 73
  Power with n=50: 0.637

  z 근사   n = 70.6399,  n=50 의 검정력 = 0.654338
  비중심 t n = 72.5839,  n=50 의 검정력 = 0.637094
  차이        +1.9440명,             -0.017244
(1)에서 손으로 구한 \(70.6399\)와 \(0.654338\)이 그대로 나왔다.
\(z\) 근사는 예상대로 낙관적이다. 필요한 표본을 두 명 적게 잡고(\(70.64\) 대 \(72.58\)), 검정력을 \(0.0172\) 크게 잡는다. 올림하면 \(71\) 대 \(73\)이라 두 명 차이다. \(n\)이 70쯤이면 이 정도지만 \(n\)이 작을수록 벌어지므로, 소표본 설계에서는 \(z\) 공식을 그대로 쓰면 안 된다.
실무적으로 더 중요한 것은 두 번째 줄이다. 73명이 필요한데 50명만 모으면 검정력이 \(0.80\)에서 \(0.637\)로 떨어진다. 표본을 \(32\%\) 줄였을 뿐인데 효과를 놓칠 확률은 \(20\%\)에서 \(36\%\)로 거의 두 배가 된다. 검정력은 \(n\)에 선형으로 반응하지 않는다.
이표본 t-검정 (독립표본)
보기 4. 이표본 t-검정의 검정력. \(d = 0.5\), \(\alpha = 0.05\) 양측, 검정력 \(0.80\)으로 두 집단을 견준다. 배분을 \(1{:}1\)로 할 때와 \(1{:}2\)로 할 때를 비교한다.
(1) 두 집단의 크기 비를 \(r = n_2/n_1\)이라 둘 때, 같은 검정력에 필요한 총 표본크기가
배가 됨을 보이시오. 이것이 \(r = 1\)에서 최소임도 보이시오.
(2) \(r = 2\)에서 (1)이 예측하는 총 표본크기를 구하고 코드와 맞춰 보시오.
풀이
(1) 해석적으로. 차이 \(\bar X_1 - \bar X_2\)의 분산은 \(\sigma^2(1/n_1 + 1/n_2)\)이므로, 검정력은 오로지
를 통해서만 \(n_1, n_2\)에 달려 있다. 검정력을 고정한다는 것은 \(\lambda\)를 고정한다는 것이고, 곧
를 지킨다는 뜻이다. \(n_2 = r n_1\)을 넣으면
이고 총 표본은
다. \(r = 1\)에서 \(N(1) = 4/c\)이므로 비는 주어진 식이 된다.
\(r = 1\)이 최소임은 산술–기하평균 부등식에서 바로 나온다. \(r > 0\)에서 \(r + 1/r \ge 2\)이고 등호는 \(r = 1\)일 때만이다. 따라서
이다. 같은 검정력을 얻는 데 드는 총인원은 균등 배분에서 가장 적다.
(2) 해석적으로. \(r = 2\)를 넣으면
이다. \(1{:}1\) 설계가 총 128명이므로 \(1{:}2\) 설계는 \(128 \times 1.125 = 144\)명이다.
수치적으로.
from statsmodels.stats.power import TTestIndPower

# 두 집단을 견주는 t-검정의 검정력 분석
analysis = TTestIndPower()

# 두 집단의 크기를 같게 두는 설계다. 같은 총인원이면 이때 검정력이 가장 높다.
# 효과크기 Cohen 의 d = 0.5. 두 평균이 표준편차의 절반만큼 떨어진 경우다.
effect_size = 0.5

n_per_group = analysis.solve_power(effect_size=effect_size, alpha=0.05,
                                   power=0.80, ratio=1.0,
                                   alternative='two-sided')
print(f"\nTwo-sample t-test (equal n):")
print(f"  Effect size (Cohen's d): {effect_size:.3f}")
print(f"  Sample size per group for 80% power: {int(np.ceil(n_per_group))}")
print(f"  Total sample size: {2 * int(np.ceil(n_per_group))}")

# 집단 크기가 다른 경우 (예: 2:1 배분)
# ratio는 nobs2/nobs1이고, solve_power가 돌려주는 것은 **nobs1**이다.
# 따라서 두 번째 집단은 ratio를 곱해서 얻어야 한다. 나누면 거꾸로다.
ratio = 2.0
n_group1 = analysis.solve_power(effect_size=effect_size, alpha=0.05,
                                power=0.80, ratio=ratio,
                                alternative='two-sided')
n_group2 = n_group1 * ratio
n1, n2 = int(np.ceil(n_group1)), int(np.ceil(n_group2))
print(f"\nTwo-sample t-test (2:1 ratio):")
print(f"  Group 1 n: {n1}")
print(f"  Group 2 n: {n2}")
print(f"  Total sample size: {n1 + n2}")

# (1) 의 식을 여러 r 에서 확인한다.
print(f"\n{'r':>5} {'n1':>8} {'n2':>8} {'총':>6} {'관측 비':>8} {'식':>8}")
base = None
for r in (1.0, 1.5, 2.0, 3.0, 4.0):
    a = analysis.solve_power(effect_size=0.5, alpha=0.05, power=0.80,
                             ratio=r, alternative='two-sided')
    total = a * (1 + r)
    base = total if base is None else base
    print(f"{r:>5.1f} {a:>8.2f} {a * r:>8.2f} {total:>6.1f}"
          f" {total / base:>8.4f} {(2 + r + 1 / r) / 4:>8.4f}")
출력:
Two-sample t-test (equal n):
  Effect size (Cohen's d): 0.500
  Sample size per group for 80% power: 64
  Total sample size: 128

Two-sample t-test (2:1 ratio):
  Group 1 n: 48
  Group 2 n: 96
  Total sample size: 144

    r       n1       n2      총     관측 비        식
  1.0    63.77    63.77  127.5   1.0000   1.0000
  1.5    53.11    79.66  132.8   1.0410   1.0417
  2.0    47.74    95.48  143.2   1.1231   1.1250
  3.0    42.35   127.04  169.4   1.3282   1.3333
  4.0    39.63   158.53  198.2   1.5538   1.5625
(1)의 식이 맞는다. \(r = 2\)에서 예측 \(1.1250\)에 관측 \(1.1231\)로 \(0.2\%\) 안쪽이고, \(r = 4\)에서도 \(1.5625\) 대 \(1.5538\)이다. 작은 차이는 \(z\) 공식에는 없는 자유도 효과 때문이다. \(r\)이 커지면 \(n_1\)이 줄어 자유도 \(n_1+n_2-2\)가 식이 가정한 만큼 늘지 않는다.
올림한 정수로 보면 \(1{:}1\)이 \(64 + 64 = 128\)명, \(1{:}2\)가 \(48 + 96 = 144\)명이다. (2)에서 예측한 \(128 \times 1.125 = 144\)와 정확히 같다.
배분이 균등에서 멀어질수록 총 표본이 늘어난다. 한쪽 집단을 모으기 쉽다고 해서 그쪽만 키우면 전체 비용이 오히려 커질 수 있다. (1)의 식에서 보듯 작은 쪽 집단이 병목이기 때문이다. \(r \to \infty\)에서 \(N(r)/N(1) \to \infty\)이지만, 작은 쪽 집단 \(n_1\)은 \(N(1)/4\), 곧 32명 아래로는 결코 내려가지 않는다. 한쪽을 무한히 늘려도 다른 쪽을 절반 아래로 줄일 수는 없다.
비율에 대한 검정 (A/B 검정)
보기 5. 비율 검정의 검정력 — A/B 검정. 대조군 전환율 \(p_0 = 1.1\%\)를 실험군에서 \(p_1 = 1.65\%\)로 올리는 것이 목표다. \(\alpha = 0.05\) 단측, 검정력 \(0.80\), 집단 크기는 같다.
(1) 코헨의 \(h = 2\arcsin\sqrt{p_1} - 2\arcsin\sqrt{p_0}\)을 계산하고, 집단당 표본크기가 \(n = 2\left((z_{1-\alpha} + z_{1-\beta})/h\right)^2\)임을 보인 뒤 값을 구하시오.
(2) 코드와 맞춰 보고, 그 표본에서 전환이 몇 건쯤 일어나는지 세어 보시오.
풀이
(1) 해석적으로. \(\arcsin\) 변환을 쓰는 까닭부터 보자. \(\hat p\)의 분산 \(p(1-p)/n\)은 \(p\)에 달려 있어 식이 \(p\)마다 달라진다. 그런데 \(\varphi = 2\arcsin\sqrt{\hat p}\)으로 바꾸면 분산이 \(p\)와 무관하게 \(1/n\)이 된다(분산안정화 변환, variance-stabilizing transformation). 그러므로 두 집단의 차 \(\varphi_1 - \varphi_2\)의 분산은 \(1/n_1 + 1/n_2 = 2/n\)이고, 효과크기를 \(h\)로 재면 보기 1의 식이 그대로 쓰인다.
보기 4의 \(r = 1\)인 경우와 같은 꼴이고, 계수 2가 거기서 왔다.
이제 \(h\)를 잰다. \(\arcsin\sqrt{0.0165} = \arcsin(0.1284523) = 0.1288082\), \(\arcsin\sqrt{0.011} = \arcsin(0.1048809) = 0.1050741\)이므로
이다. 단측이므로 \(z_{0.95} = 1.644854\), \(z_{0.8} = 0.841621\)을 쓰면
이다.
(2) 수치적으로.
import numpy as np
import statsmodels.stats.api as sms
from statsmodels.stats.power import NormalIndPower

# 전환율을 견주는 A/B 검정
# 대조군 전환율 1.1%
# 실험군 전환율 1.65%. 상대적으로는 50% 개선이지만 절대차는 0.55%p 다.
p0 = 0.011   # Control baseline
p1 = 0.0165  # Treatment goal

# 비율에서는 두 값의 차이 대신 arcsin 변환 후의 차이를 효과크기로 쓴다.
#   h = 2*arcsin(sqrt(p1)) - 2*arcsin(sqrt(p0)) — 비율을 각도로 바꿔 재는 효과크기다.
# 이렇게 하면 분산이 p에 의존하는 문제가 사라져 하나의 공식으로 처리된다.
# 0.011 대 0.0165는 절대차로 0.55%p뿐이지만 상대적으로는 50% 증가다.
effect_size = sms.proportion_effectsize(p1, p0)

# alternative='larger'는 단측이다. A/B 검정에서는 "개선되었는가"만 보는 일이 많다.
analysis = NormalIndPower()
n_ab = analysis.solve_power(effect_size=effect_size, alpha=0.05,
                            power=0.80, ratio=1.0, alternative='larger')

print(f"\nA/B Test (Proportions):")
print(f"  Control rate: {p0:.2%}")
print(f"  Treatment goal: {p1:.2%}")
print(f"  Effect size: {effect_size:.4f}")
print(f"  Sample size per group for 80% power: {int(np.ceil(n_ab))}")

# (1) 의 손계산과 맞춰 본다.
h = 2 * np.arcsin(np.sqrt(p1)) - 2 * np.arcsin(np.sqrt(p0))
z_a, z_b = stats.norm.ppf(0.95), stats.norm.ppf(0.80)
n_formula = 2 * ((z_a + z_b) / h) ** 2
print(f"\n  h 직접 계산   {h:.8f}   statsmodels {effect_size:.8f}")
print(f"  n 공식        {n_formula:.4f}   statsmodels {n_ab:.4f}")

# (2) 그 표본에서 전환은 몇 건인가.
n_int = int(np.ceil(n_ab))
print(f"\n  집단당 {n_int:,}명 x 2 = {2 * n_int:,}명")
print(f"  기대 전환 건수: 대조군 {n_int * p0:.1f}건,"
      f" 실험군 {n_int * p1:.1f}건,  차이 {n_int * (p1 - p0):.1f}건")
출력:
A/B Test (Proportions):
  Control rate: 1.10%
  Treatment goal: 1.65%
  Effect size: 0.0475
  Sample size per group for 80% power: 5488

  h 직접 계산   0.04746819   statsmodels 0.04746819
  n 공식        5487.7312   statsmodels 5487.7312

  집단당 5,488명 x 2 = 10,976명
  기대 전환 건수: 대조군 60.4건, 실험군 90.6건,  차이 30.2건
유도한 \(h = 0.0474682\)와 \(n = 5487.73\)이 statsmodels와 소수점 넷째 자리까지 같다. 비율 검정에는 \(t\) 보정이 없으므로(정규근사를 쓰는 검정이다) 공식과 라이브러리가 완전히 일치한다. 보기 3에서 두 명이 어긋났던 것과 대조된다.
집단당 \(5{,}488\)명, 합쳐서 약 \(11{,}000\)명이 필요하다. 전환율이 낮으면 표본이 이렇게 커진다. \(1.1\%\)의 기저율에서는 집단당 \(5{,}488\)명이라도 전환이 \(60\)건 남짓에 불과하고, 두 군의 기대 차이는 \(30\)건뿐이다. 세는 사건이 적으면 상대적인 변동이 크다는 것이 이 수의 정체다. 웹 실험이 몇 주씩 걸리는 이유가 여기 있다.
한 가지 덧붙이면, \(0.011 \to 0.0165\)는 상대적으로 50% 개선인데도 \(h\)가 \(0.047\)로 아주 작다. 효과크기는 비율의 비가 아니라 변환한 척도의 차로 재기 때문이다. 기저율이 낮으면 같은 상대 개선이라도 \(h\)가 작아지고, 그래서 표본이 폭증한다.
일원분산분석
보기 6. 일원분산분석의 검정력. 코헨의 \(f = 0.25\)(중간), 집단 \(k = 4\), \(\alpha = 0.05\), 검정력 \(0.80\)이다. FTestAnovaPower.solve_power가 돌려주는 수는 집단당인가 총인가.
(1) \(k = 2\)로 두고 같은 계산을 돌리면 보기 4의 이표본 \(t\) 검정과 같은 문제가 된다(\(f = d/2\)이므로 \(f = 0.25\)는 \(d = 0.5\)다). 이 사실을 써서 돌려주는 수가 무엇인지 판정하시오.
(2) 그에 따라 \(k = 4\)의 집단당 표본크기와 총 표본크기를 바르게 구하시오.
풀이
(1) 해석적으로. 먼저 \(f = d/2\)를 확인한다. 집단이 둘이고 크기가 같을 때 집단평균의 표준편차는
이므로 \(f = \sigma_m/\sigma = d/2\)다. 그러니 \(f = 0.25\), \(k = 2\)는 \(d = 0.5\)인 이표본 \(t\) 검정과 같은 설계이고, 보기 4에서 그 답이 총 \(127.531\)명(집단당 \(63.766\))이었다.
분산분석(analysis of variance)의 검정력이 비중심모수 \(\lambda = f^2 N\)에 달려 있고 \(N\)이 총 관측수라는 점을 떠올리면 판정이 끝난다. solve_power가 \(k=2\)에서 \(63.8\)을 주면 집단당, \(127.5\)를 주면 총이다. 아래 코드가 \(127.531\)을 준다. 따라서 이 함수가 돌려주는 것은 총 표본크기다.
(2) 해석적으로. \(k = 4\)에서 함수가 주는 \(178.396\)은 총 표본이므로 집단당은
이고 실제로 쓰는 총 표본은 \(4 \times 45 = 180\)명이다.
수치적으로.
from statsmodels.stats.power import FTestAnovaPower

# 분산분석의 효과크기는 Cohen 의 f 다. t-검정의 d 와는 척도가 다르므로
# 0.25 를 d 로 읽으면 안 된다. f 는 0.10 작음, 0.25 중간, 0.40 큼으로 본다.
analysis = FTestAnovaPower()

effect_size = 0.25   # 중간 크기 효과
k_groups = 4         # 비교할 집단 수

# **nobs 는 총 관측수다.** 집단당이 아니다. 아래 k=2 검산이 그것을 보인다.
n_total = analysis.solve_power(effect_size=effect_size, alpha=0.05,
                               power=0.80, k_groups=k_groups)
n_each = int(np.ceil(n_total / k_groups))
print(f"\nOne-way ANOVA (4 groups):")
print(f"  Effect size (Cohen's f): {effect_size:.3f}")
print(f"  Total sample size for 80% power: {n_total:.3f}"
      f" -> {k_groups * n_each}")
print(f"  Sample size per group: {n_total / k_groups:.3f} -> {n_each}")
print(f"  실제 검정력: "
      f"{analysis.power(effect_size=effect_size, nobs=k_groups * n_each, alpha=0.05, k_groups=k_groups):.4f}")

# (1) 의 검산: k=2 는 d=0.5 인 이표본 t 검정과 같은 문제여야 한다.
n_k2 = analysis.solve_power(effect_size=0.25, alpha=0.05, power=0.80,
                            k_groups=2)
n_t = TTestIndPower().solve_power(effect_size=0.5, alpha=0.05, power=0.80,
                                  ratio=1.0, alternative='two-sided')
print(f"\n  ANOVA k=2 가 준 수      {n_k2:.5f}")
print(f"  이표본 t 의 집단당       {n_t:.5f}   총 {2 * n_t:.5f}")
print(f"  -> 돌려준 수는 '총'이다 (차이 {abs(n_k2 - 2 * n_t):.2e})")

# 집단 수를 늘리면 어떻게 되는가.
print(f"\n{'k':>3} {'총 N':>9} {'집단당':>8} {'올림 후 총':>10}")
for k in (2, 3, 4, 5, 6):
    N = analysis.solve_power(effect_size=0.25, alpha=0.05, power=0.80,
                             k_groups=k)
    each = int(np.ceil(N / k))
    print(f"{k:>3} {N:>9.3f} {N / k:>8.3f} {k * each:>10}")
출력:
One-way ANOVA (4 groups):
  Effect size (Cohen's f): 0.250
  Total sample size for 80% power: 178.396 -> 180
  Sample size per group: 44.599 -> 45
  실제 검정력: 0.8040

  ANOVA k=2 가 준 수      127.53062
  이표본 t 의 집단당       63.76561   총 127.53122
  -> 돌려준 수는 '총'이다 (차이 6.00e-04)

  k       총 N      집단당     올림 후 총
  2   127.531   63.765        128
  3   157.189   52.396        159
  4   178.396   44.599        180
  5   195.766   39.153        200
  6   210.845   35.141        216
검산이 결정적이다. \(k = 2\)에서 분산분석이 준 \(127.531\)이 이표본 \(t\) 검정의 총 \(127.531\)과 소수점 셋째 자리까지 같다(차이 \(6\times10^{-4}\)은 두 구현의 수치해법 차이다). 집단당 \(63.766\)과는 두 배 차이가 나므로, FTestAnovaPower의 nobs는 총 관측수다. 함수 이름이나 변수 이름만 보고 "집단당"으로 읽으면 표본을 \(k\)배로 부풀리게 된다.
\(k = 4\)의 답은 집단당 45명, 총 180명이고 그때 실제 검정력은 \(0.8040\)이다.
맨 아래 표가 집단 수의 대가를 보여 준다. \(f\)를 \(0.25\)로 고정한 채 집단을 둘에서 여섯으로 늘리면 총 표본은 \(128\)에서 \(216\)으로 69% 늘지만 집단당은 \(64\)에서 \(36\)으로 오히려 줄어든다. 집단이 많아지면 분자 자유도가 커져 임계값이 올라가므로 총량은 늘지만, 그 증가가 집단 수에 비례하지는 않는다.
끝으로 척도를 혼동하지 말 것. \(f = 0.25\)는 분산분석에서 "중간"이지만 \(d = 0.5\)와 같은 수가 아니다. 둘 사이에 \(f = d/2\)라는 관계가 서는 것은 집단이 둘일 때뿐이고, 집단이 셋 이상이면 평균들이 어떻게 흩어져 있느냐에 따라 달라진다.
검정력 곡선: 표본크기와 검정력의 관계
보기 7. 표본크기와 검정력의 곡선. 일표본 \(t\) 검정에서 \(d = 0.2,\ 0.5,\ 0.8\)에 대한 검정력 곡선을 그린다(\(\alpha = 0.05\) 양측).
(1) 보기 1의 \(z\) 공식 \(n = ((z_{1-\alpha/2}+z_{1-\beta})/d)^2\)으로 세 효과크기에서 검정력 \(0.80\)에 필요한 \(n\)을 근사하시오. 셋의 비는 얼마인가.
(2) 비중심 \(t\)의 정확한 답과 견주시오. 차이가 \(d\)에 따라 어떻게 나타나는가. 그 때문에 (1)에서 구한 비가 어떻게 달라지는가.
풀이
(1) 해석적으로. \(z_{0.975} + z_{0.8} = 2.801585\)이므로
이고, \(d = 0.2,\ 0.5,\ 0.8\)에서 각각
이다. \(n_z \propto d^{-2}\)이므로 비는 효과크기 비의 제곱이다.
(2) 예상. 보기 3에서 보았듯 비중심 \(t\)는 \(z\) 근사보다 큰 \(n\)을 요구한다. 그 차이가 \(d\)에 따라 어떻게 변하는지는 손으로 알기 어렵다. 아래에서 재어 보자.
수치적으로.
import matplotlib.pyplot as plt

plt.rcParams["font.sans-serif"] = ["NanumGothic", "Apple SD Gothic Neo", "Malgun Gothic"]
plt.rcParams["font.family"] = "sans-serif"
plt.rcParams["axes.unicode_minus"] = False

# 효과크기를 세 가지로 두고 표본크기에 따른 검정력을 그린다.
# 세 곡선이 모두 위로 볼록하다는 점이 중요하다. 표본을 늘릴수록 얻는 것이
# 줄어들므로, 검정력 0.8 을 0.9 로 올리는 비용이 0.5 를 0.8 로 올리는 비용보다 크다.
fig, ax = plt.subplots(figsize=(10, 6))

analysis = TTestPower()
sample_sizes = np.arange(10, 200, 5)

for d in [0.2, 0.5, 0.8]:
    power_values = [analysis.power(effect_size=d, nobs=n, alpha=0.05)
                    for n in sample_sizes]
    ax.plot(sample_sizes, power_values, linewidth=2, label=f"d = {d:.1f}")

# 관례로 쓰는 두 기준선. 0.80 이 가장 흔하다.
ax.axhline(0.80, color='red', linestyle='--', linewidth=1, label='Power = 0.80')
ax.axhline(0.90, color='orange', linestyle='--', linewidth=1, label='Power = 0.90')

ax.set_xlabel('Sample Size (n)', fontsize=12)
ax.set_ylabel('Power', fontsize=12)
ax.set_title('Power Curves: Sample Size vs. Power\n(One-Sample t-Test, α = 0.05)')
ax.legend(fontsize=11)
ax.grid(True, alpha=0.3)
ax.set_ylim([0, 1])

plt.tight_layout()
plt.show()

# (1) 의 z 근사와 (2) 의 정확한 답을 나란히 둔다.
za, zb = stats.norm.ppf(0.975), stats.norm.ppf(0.80)
print(f"{'d':>5} {'z 근사':>10} {'비중심 t':>10} {'차이':>8}")
exact = {}
for d in (0.2, 0.5, 0.8):
    nz = ((za + zb) / d) ** 2
    nt = analysis.solve_power(effect_size=d, alpha=0.05, power=0.80,
                              alternative='two-sided')
    exact[d] = nt
    print(f"{d:>5.1f} {nz:>10.3f} {nt:>10.3f} {nt - nz:>+8.3f}")

print(f"\n비 n(0.2)/n(0.8):  z 근사 {16:.2f}"
      f"   정확 {exact[0.2] / exact[0.8]:.2f}")
print(f"비 n(0.2)/n(0.5):  z 근사 {6.25:.2f}"
      f"   정확 {exact[0.2] / exact[0.5]:.2f}")

# 검정력을 더 올리는 비용 (d = 0.5)
print()
for pw in (0.80, 0.90, 0.95):
    n = analysis.solve_power(effect_size=0.5, alpha=0.05, power=pw,
                             alternative='two-sided')
    print(f"  d=0.5, 검정력 {pw:.2f}: n = {n:.3f} -> {int(np.ceil(n))}")
출력:
    d       z 근사      비중심 t       차이
  0.2    196.222    198.151   +1.929
  0.5     31.396     33.367   +1.972
  0.8     12.264     14.303   +2.039

비 n(0.2)/n(0.8):  z 근사 16.00   정확 13.85
비 n(0.2)/n(0.5):  z 근사 6.25   정확 5.94

  d=0.5, 검정력 0.80: n = 33.367 -> 34
  d=0.5, 검정력 0.90: n = 43.995 -> 44
  d=0.5, 검정력 0.95: n = 53.941 -> 54
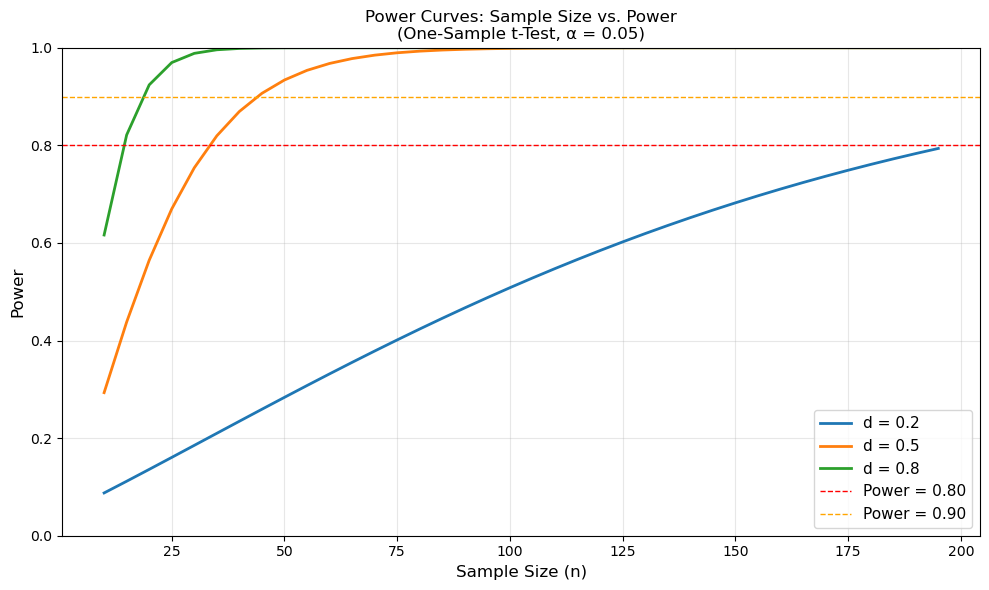
(1)에서 손으로 구한 \(196.222\), \(31.396\), \(12.264\)가 z 근사 열과 그대로 맞는다.
차이가 거의 일정하다. 두 답의 차가 \(+1.93\), \(+1.97\), \(+2.04\)로, \(n\)이 \(196\)이든 \(12\)든 두 명 남짓이다. \(z\) 근사가 놓치는 것은 \(S\)를 추정하느라 생기는 비용인데, 그 비용이 비율이 아니라 덧셈으로 붙는다는 뜻이다.
그래서 (1)의 비가 무너진다. 상수를 더하면 작은 수가 비율로 더 크게 부푼다. \(n(0.2)/n(0.8)\)은 \(z\) 법칙의 \(16\)이 아니라 \(13.85\)이고, \(n(0.2)/n(0.5)\)도 \(6.25\)가 아니라 \(5.94\)다. \(d^{-2}\) 법칙은 \(n\)이 클 때만 쓸 만하다. 올림한 정수로 보면 \(d = 0.8\)에 15명, \(d = 0.5\)에 34명, \(d = 0.2\)에 199명이고, 효과크기가 4분의 1로 줄 때 표본은 열세 배가 된다.
맨 아래 세 줄이 그림의 평평해지는 구간을 수로 옮긴 것이다. \(d = 0.5\)에서 검정력 \(0.80\)에는 34명이면 되지만 \(0.90\)에는 44명, \(0.95\)에는 54명이 필요하다. 30% 더 모아서 10%p를 얻는 셈이고, 그다음 5%p에 또 10명이 든다. 세 곡선이 모두 위로 볼록하므로 마지막 몇 %p가 가장 비싸다. 작은 효과를 탐지하는 일은 표본이 곧 예산이다.
검정력 분석의 작업 흐름
보기 8. 연구 설계 작업 흐름. 앞의 보기들을 하나의 함수로 묶어 설계 단계에서 시나리오를 바꿔 가며 표본크기를 비교할 수 있게 한다.
(1) 이 함수가 돌려주는 표에서 무엇을 읽을 수 있는가. 연구계획서에 그대로 옮길 수 있는가.
(2) 이 함수가 해 주지 않는 것은 무엇인가. 겉보기와 달리 말없이 실패하는 자리를 찾아 보이시오.
풀이
유도할 답이 있는 문제가 아니다. 이 코드가 무엇을 해 주고 무엇을 해 주지 않는가가 이 보기의 전부다.
먼저 코드를 보자. anova 가지는 보기 6에서 밝힌 대로 solve_power가 돌려주는 수를 총 표본으로 읽어야 한다.
def design_study(test_type, effect_size, alpha=0.05, power=0.80,
                 **kwargs):
    """연구 설계를 위한 검정력 분석을 한자리에 모은 함수.

    검정 종류마다 statsmodels의 클래스가 다르고 인자 이름도 다르다.
    그 차이를 여기서 흡수해 두면 설계 단계에서 시나리오를 바꿔 가며
    표본크기를 비교하기가 쉬워진다.

    test_type : 'one-sample', 'two-sample', 'anova', 'proportions'
    effect_size : 표준화된 효과크기 (종류마다 척도가 다르다: d, d, f)
    alpha : 유의수준
    power : 목표 검정력
    **kwargs : 검정별 추가 인자 (예: ANOVA의 k_groups)
    """
    results = {'test_type': test_type, 'alpha': alpha, 'power': power}

    if test_type == 'one-sample':
        analysis = TTestPower()
        n = analysis.solve_power(effect_size=effect_size, alpha=alpha,
                                power=power, alternative='two-sided')
        results['sample_size'] = int(np.ceil(n))

    elif test_type == 'two-sample':
        analysis = TTestIndPower()
        n = analysis.solve_power(effect_size=effect_size, alpha=alpha,
                                power=power, ratio=1.0, alternative='two-sided')
        results['sample_size_per_group'] = int(np.ceil(n))
        results['total_sample_size'] = 2 * int(np.ceil(n))

    elif test_type == 'anova':
        analysis = FTestAnovaPower()
        k = kwargs.get('k_groups', 3)
        # **FTestAnovaPower 의 nobs 는 총 관측수다**(보기 6).
        # 집단당으로 읽으면 표본을 k 배로 부풀리게 된다.
        n_total = analysis.solve_power(effect_size=effect_size, alpha=alpha,
                                       power=power, k_groups=k)
        each = int(np.ceil(n_total / k))
        results['k_groups'] = k
        results['sample_size_per_group'] = each
        results['total_sample_size'] = k * each

    return results

# 사용 예
print("\n" + "="*60)
print("STUDY DESIGN: Two-Sample Comparison")
print("="*60)
design = design_study('two-sample', effect_size=0.5)
for key, value in design.items():
    print(f"{key:.<30} {value}")

# 세 가지를 나란히 돌려 본다.
print("\n" + "="*60)
for args in [('one-sample', 0.5, {}),
             ('two-sample', 0.5, {}),
             ('anova', 0.25, {'k_groups': 4})]:
    kind, es, kw = args
    print(f"{kind:>12}  es={es}  ->  {design_study(kind, es, **kw)}")

# 말없이 실패하는 자리.
print("\n" + "="*60)
print("proportions :", design_study('proportions', 0.0475))
print("오타 'twosample':", design_study('twosample', 0.5))
출력:
============================================================
STUDY DESIGN: Two-Sample Comparison
============================================================
test_type..................... two-sample
alpha......................... 0.05
power......................... 0.8
sample_size_per_group......... 64
total_sample_size............. 128

============================================================
  one-sample  es=0.5  ->  {'test_type': 'one-sample', 'alpha': 0.05, 'power': 0.8, 'sample_size': 34}
  two-sample  es=0.5  ->  {'test_type': 'two-sample', 'alpha': 0.05, 'power': 0.8, 'sample_size_per_group': 64, 'total_sample_size': 128}
       anova  es=0.25  ->  {'test_type': 'anova', 'alpha': 0.05, 'power': 0.8, 'k_groups': 4, 'sample_size_per_group': 45, 'total_sample_size': 180}

============================================================
proportions : {'test_type': 'proportions', 'alpha': 0.05, 'power': 0.8}
오타 'twosample': {'test_type': 'twosample', 'alpha': 0.05, 'power': 0.8}
(1) 읽히는 것. 표에 설계의 다섯 요소가 모두 있다. 검정 종류, 유의수준 \(0.05\), 목표 검정력 \(0.80\), 집단당 64명, 총 128명. 이 다섯 줄은 연구계획서의 표본크기 절에 그대로 옮겨 적을 수 있다. 세 검정을 나란히 돌린 둘째 그룹은 보기 7·4·6의 답(\(34\)명, \(64+64\)명, \(45\times4\)명)을 그대로 재현하므로 함수가 맞게 짜였음도 확인된다.
(2) 해 주지 않는 것 — 효과크기. 표에 effect_size가 아예 적혀 있지 않다. 그런데 검정력 분석에서 정작 어려운 부분은 계산이 아니라 그 값을 정하는 일이다. 선행 연구, 예비조사, 또는 "이보다 작으면 실무적으로 의미가 없다"는 기준 중 하나를 근거로 삼아야 하고, 그 근거를 함께 적어야 한다. 함수는 입력받은 수를 그대로 믿을 뿐 그 근거를 묻지도 기록하지도 않는다.
말없이 실패하는 자리가 둘 있다. 하나는 독스트링이 'proportions'를 다룬다고 적어 두었지만 그 가지가 없다는 것이다. design_study('proportions', 0.0475)를 부르면 예외도 경고도 없이 sample_size 키가 빠진 사전이 돌아온다. 다른 하나는 오타다. 'twosample'처럼 하이픈을 빠뜨려도 똑같이 조용히 알맹이 없는 사전이 나온다.
둘 다 "답이 틀리는" 실패가 아니라 "답이 없는 줄 모르고 지나가는" 실패다. 설계 문서에 표본크기 줄이 통째로 빠진 채 제출되기 쉽고, 그런 오류는 눈에 띄지 않는다. 고치려면 else: raise ValueError(f"알 수 없는 test_type: {test_type}") 한 줄이면 된다. 갈래가 여럿인 함수에서 마지막 else를 비워 두지 말 것이 이 보기가 남기는 교훈이다.
끝으로 척도의 함정이 있다. effect_size 하나에 \(d\)와 \(f\)가 번갈아 들어가는데 함수는 그것을 구별하지 못한다. anova에 \(f\) 대신 \(d = 0.5\)를 넣으면 아무 불평 없이 계산해 주고, 그 답은 뜻이 없다. 인자 이름이 같다고 같은 양이 아니다.
연습문제
연습문제 1. 어떤 검정의 \(\alpha = 0.05\)이고 검정력 \(= 0.80\)이다. 제1종 오류, 제2종 오류(type II error), 올바른 기각, 올바른 비기각의 확률은 각각 얼마인가?
풀이
- 제1종 오류 (\(\alpha\)): \(P(H_0 \text{ 기각} \mid H_0 \text{ 참}) = 0.05\)
- 제2종 오류 (\(\beta\)): \(P(H_0 \text{ 기각 못 함} \mid H_0 \text{ 거짓}) = 1 - \text{검정력} = 1 - 0.80 = 0.20\)
- 올바른 기각(검정력): \(P(H_0 \text{ 기각} \mid H_0 \text{ 거짓}) = 0.80\)
- 올바른 비기각: \(P(H_0 \text{ 기각 못 함} \mid H_0 \text{ 참}) = 1 - \alpha = 0.95\)
연습문제 2. 어떤 연구자가 \(\alpha = 0.05\)(양측, 이표본 \(t\)-검정)에서 효과크기 \(d = 0.3\)을 검정력 90%로 탐지하려 한다. 공식 \(n = 2(z_{1-\alpha/2} + z_{1-\beta})^2/d^2\)으로 집단당 필요한 표본크기를 추정하라.
풀이
\(\alpha = 0.05\)이면 \(z_{0.975} = 1.96\)이다. 검정력 \(= 0.90\)이면 \(\beta = 0.10\)이므로 \(z_{0.9} = 1.282\)이다.
올림하면 집단당 \(n = 234\)(총 468)이다. 작은 효과를 높은 검정력으로 탐지하려면 상당한 표본이 필요하다.
연습문제 3. 검정의 검정력을 높이는 방법 네 가지를 들라. 보통 어느 것이 가장 현실적인가?
풀이
- 표본크기 \(n\)을 늘린다: 자료가 많아지면 표준오차가 줄어 참 효과를 탐지하기 쉬워진다. 보통 가장 현실적인 방법이다.
- \(\alpha\)를 키운다: 유의수준을 덜 엄격하게 하면(예: 0.05 대신 0.10) 검정력이 커지지만 제1종 오류율도 커진다.
- 효과크기를 키운다: 참 차이가 클수록 탐지하기 쉽다. 보통 연구자가 통제할 수 없지만, 더 나은 실험 설계(예: 더 극단적인 처리)로 어느 정도 가능할 때도 있다.
- 변동성 \(\sigma\)를 줄인다: 더 정밀한 측정이나 더 동질적인 표본은 \(\sigma\)를 줄여 신호 대 잡음 비를 높인다. 더 나은 측정기기, 교란요인의 통제, 대응 설계 등으로 달성할 수 있다.
연습문제 4. 표본크기가 고정되어 있을 때 제1종 오류(\(\alpha\))와 제2종 오류(\(\beta\)) 사이의 트레이드오프(trade-off)을 설명하라. 둘을 동시에 얼마든지 작게 만들 수 없는 이유는?
풀이
표본크기와 효과크기가 고정되어 있으면 직접적인 트레이드오프가 있다: \(\alpha\)를 줄이면(\(H_0\)을 기각하기 어렵게 하면) \(\beta\)가 커지고(참 효과를 탐지하기 어려워지고), 그 반대도 마찬가지이다. 두 오류율 모두 \(H_0\)과 \(H_a\) 아래 분포에 대한 기각 임계값의 위치에 달려 있기 때문이다.
임계값을 옮겨 기각을 드물게 만들면(작은 \(\alpha\)) 동시에 대립가설(alternative hypothesis)을 탐지하기 어려워진다(큰 \(\beta\)). 둘을 동시에 줄이는 유일한 방법은 표본크기를 늘리거나(두 분포의 표준오차를 함께 줄인다) 효과크기를 키우는 것(두 분포를 더 멀리 떼어 놓는다)이다. 자료가 무한하면 \(\alpha\)와 \(\beta\)가 모두 0에 다가갈 수 있지만, 유한한 자료에서는 트레이드오프를 피할 수 없다.
연습문제 5. 검정력의 네 요소(\(\alpha\), \(n\), 효과크기, 검정력) 중 셋을 알면 넷째가 정해진다. 각 방향의 계산을 모두 보여라.
풀이
네 가지 방향.
import numpy as np
from scipy import stats
from scipy.optimize import brentq

def power_t2(n, d, alpha=0.05):
    """이표본 t 검정(집단당 n)의 정확한 검정력"""
    nu = 2 * n - 2
    lam = d * np.sqrt(n / 2)
    tc = stats.t.ppf(1 - alpha / 2, nu)
    return stats.nct.sf(tc, nu, lam) + stats.nct.cdf(-tc, nu, lam)

# ① n 구하기
n = next(m for m in range(4, 5000) if power_t2(m, 0.5) >= 0.80)
print(f"① d=0.5, α=0.05, 검정력 0.80  →  집단당 n = {n}")

# ② 검정력 구하기
print(f"② d=0.5, α=0.05, n=40        →  검정력 = {power_t2(40, 0.5):.4f}")

# ③ 탐지 가능한 최소 효과크기
d = brentq(lambda x: power_t2(40, x) - 0.80, 0.01, 3.0)
print(f"③ α=0.05, n=40, 검정력 0.80  →  d = {d:.4f}")

# ④ 필요한 α
a = brentq(lambda x: power_t2(40, 0.5, x) - 0.80, 1e-6, 0.5)
print(f"④ d=0.5, n=40, 검정력 0.80   →  α = {a:.4f}")
① d=0.5, α=0.05, 검정력 0.80  →  집단당 n = 64
② d=0.5, α=0.05, n=40        →  검정력 = 0.5981
③ α=0.05, n=40, 검정력 0.80  →  d = 0.6343
④ d=0.5, n=40, 검정력 0.80   →  α = 0.1672
네 계산의 쓰임이 각각 다르다.
| 방향 | 언제 쓰나 | 주의 |
|---|---|---|
| ① \(n\) 구하기 | 설계 단계의 기본 | 효과크기의 근거가 관건 |
| ② 검정력 구하기 | 표본이 제약될 때 | 낮으면 연구 재검토 |
| ③ 최소 효과크기 | 예산이 먼저 정해진 경우 | 이 값이 실무적으로 의미 있는지 판단 |
| ④ \(\alpha\) 구하기 | 드물다 | 0.17은 받아들여지지 않는다 |
③이 특히 유용하다. "집단당 40명밖에 못 모은다"면 "\(d=0.63\) 이상만 탐지 가능"이라고 말할 수 있다. 그 크기의 효과가 그럴듯한지를 영역 전문가와 논의하면, 연구를 할지 말지 판단할 수 있다.
④는 경고다. 검정력 80%를 지키려면 \(\alpha\)를 0.17로 올려야 한다는 것은 설계가 부족하다는 신호다. \(\alpha\)를 올려 해결하려 들면 안 된다.
주의 — 사후 검정력은 이 네 가지에 속하지 않는다. 관측된 효과크기를 ②에 넣는 것은 절 3에서 본 대로 \(p\) 값의 재포장일 뿐이다.
연습문제 6. 검정력이 검정 방법에 따라 얼마나 달라지는지 여러 분포에서 비교하라.
풀이
import numpy as np
from scipy import stats

rng = np.random.default_rng(42)
n, M = 25, 10_000

def run(gen, shift):
    cnt = np.zeros(3)
    for _ in range(M):
        x = gen(n)
        y = gen(n) + shift
        cnt[0] += stats.ttest_ind(x, y, equal_var=False).pvalue < 0.05
        cnt[1] += stats.mannwhitneyu(x, y).pvalue < 0.05
        # 중앙값검정 (합친 표본의 중앙값을 기준으로 2x2 표를 만들어 카이제곱 검정을 한다)
        med = np.median(np.concatenate([x, y]))
        tab = [[np.sum(x > med), np.sum(x <= med)],
               [np.sum(y > med), np.sum(y <= med)]]
        cnt[2] += stats.chi2_contingency(tab).pvalue < 0.05
    return cnt / M

cases = [("정규", lambda m: rng.normal(0, 1, m), 0.8),
         ("t(3)", lambda m: rng.standard_t(3, m), 0.8),
         ("지수", lambda m: rng.exponential(1, m), 0.8),
         ("로그정규", lambda m: rng.lognormal(0, 1, m), 1.2)]
print(f"{'분포':>8s} {'웰치 t':>9s} {'만-휘트니':>11s} {'중앙값검정':>11s}")
for name, gen, sh in cases:
    r = run(gen, sh)
    print(f"{name:>8s} {r[0]:9.4f} {r[1]:11.4f} {r[2]:11.4f}")
      분포      웰치 t       만-휘트니       중앙값검정
      정규    0.7854      0.7585      0.4788
    t(3)    0.4438      0.5716      0.3980
      지수    0.7939      0.9406      0.6787
    로그정규    0.6173      0.9597      0.7971
분포에 따라 순위가 바뀐다.
| 분포 | 최선 | 최악 |
|---|---|---|
| 정규 | 웰치 \(t\)(0.785) | 중앙값검정(0.479) |
| \(t_3\) | 만–휘트니(0.572) | 중앙값검정(0.398) |
| 지수 | 만–휘트니(0.941) | 중앙값검정(0.679) |
| 로그정규 | 만–휘트니(0.960) | 웰치 \(t\)(0.617) |
로그정규에서 \(t\) 검정이 0.617, 만–휘트니가 0.960이다. 몇 개의 큰 값이 표본평균(sample mean)과 표준편차를 함께 부풀려 \(t\) 통계량을 희석하기 때문이다. 표본크기로 환산하면 두 배 이상의 차이다.
\(t_3\)에서도 만–휘트니가 앞선다(0.572 대 0.444). 두꺼운 꼬리가 \(t\) 검정의 분모를 키운다.
정규에서는 만–휘트니의 손실이 작다. 0.785 대 0.759로 2.7%포인트다. 이론적으로 점근상대효율(asymptotic relative efficiency)이 \(3/\pi=0.955\)이며, 표본크기로는 4.5% 손해에 해당한다.
중앙값검정은 네 분포 모두에서 만–휘트니에 뒤진다. 로그정규에서만 웰치 \(t\)를 앞설 뿐(\(0.797\) 대 \(0.617\)) 나머지 셋에서는 꼴찌다. 순서 정보를 "중앙값보다 큰가"로 이분화해 버려 정보를 많이 잃는다.
실무 지침.
- 정규성(normality)이 확실하면 \(t\). 다만 이득이 작다.
- 꼬리가 두껍거나 치우쳐 있으면 만–휘트니. 손실이 작고 이득이 클 수 있다.
- 다만 추정 대상이 다르다. 만–휘트니는 \(P(X<Y)\)에 대한 검정이며, 이것은 평균 차이와 다른 양이다.
- 자료를 보고 고르면 안 된다. 예비검정으로 분포를 살핀 뒤 방법을 고르는 2단계 절차는 그 선택까지 포함한 전체 오류율을 명목 수준에서 벗어나게 한다. 사전에 정한다.
연습문제 7. 검정력이 부족한 연구를 하는 것이 왜 비윤리적일 수 있는지 논하고, 반론도 함께 검토하라.
풀이
비윤리적이라는 논거.
-
참가자를 헛되이 위험에 노출한다. 결론을 낼 수 없는 연구에 환자를 참여시키는 것은 위험은 지우고 이득은 없는 거래다.
-
자원을 낭비한다. 연구비, 시간, 시료는 유한하다.
-
거짓 정보를 생산한다. 아래 연습문제 15 가 정의하는 M-오류·S-오류 때문에, 검정력이 낮은 연구에서 나온 유의한 결과는 과장되고 부호가 틀릴 수 있다. 이것이 문헌에 남아 후속 연구를 오도한다.
-
거짓 음성이 발전을 막는다. 효과가 있는 처리를 "효과 없음"으로 결론 내면 그 방향의 연구가 중단될 수 있다.
-
동의의 전제가 깨진다. 참가자는 "의미 있는 연구에 기여한다"고 믿고 동의한다. 그 연구가 애초에 결론을 낼 수 없다면 동의의 근거가 부실하다.
반론과 그에 대한 재반론.
반론 1 — "메타분석에 기여한다." 작은 연구들이 모이면 결론이 난다는 주장이다.
- 일리가 있다. 다만 모든 연구가 보고되어야 성립한다. 출판 편향이 있으면 메타분석이 오히려 왜곡된다.
- 조건: 사전등록하고, 결과와 무관하게 보고하며, 효과크기와 표준오차를 반드시 싣는다. 그러면 작은 연구도 정당하다.
반론 2 — "탐색적 연구는 다르다." 가설 생성이 목적이면 검정력 기준이 다르다는 주장이다.
- 타당하다. 다만 탐색적임을 명시해야 하고, 확증적 결론을 내지 말아야 한다.
반론 3 — "희귀질환에서는 불가피하다." 환자가 100명뿐인 질환에서 검정력 80%를 요구할 수 없다는 주장이다.
- 타당하다. 대신 베이즈 방법, 단일군 설계, n-of-1 시험, 국제 공동연구 등 대안을 적극적으로 검토해야 한다. "어쩔 수 없다"고 끝내면 안 된다.
반론 4 — "검정력 계산의 입력값도 추측이다." 효과크기를 모르는데 검정력을 계산하는 것이 형식적이라는 주장이다.
- 일부 타당하다. 그래서 민감도 분석과 탐지 가능한 최소 효과 보고가 중요하다. 계산이 불완전하다는 것이 계산을 안 해도 된다는 뜻은 아니다.
균형 잡힌 결론.
- 확증적 연구에서 검정력 부족은 정당화하기 어렵다.
- 탐색적·희귀질환 연구는 다른 기준이 필요하되, 그 성격을 명시하고 결과를 전부 보고해야 한다.
- 가장 중요한 것은 투명성이다. 검정력이 낮다는 사실을 숨기는 것이 낮은 것 자체보다 나쁘다.
제도적 장치. 여러 연구윤리위원회가 검정력 계산을 심사 요건으로 요구한다. 등록보고서 제도는 검정력이 확보된 연구만 사전 승인한다.
연습문제 8. 여러 결과변수가 있을 때 검정력을 어떻게 정의하고 계획하는지 설명하라.
풀이
검정력의 정의가 여럿이 된다.
| 정의 | 뜻 | 언제 쓰나 |
|---|---|---|
| 개별 검정력 | 각 결과변수에서의 검정력 | 결과마다 독립적으로 판단 |
| 분리 검정력(disjunctive) | 적어도 하나에서 유의 | "어느 하나라도 효과가 있으면 성공" |
| 결합 검정력(conjunctive) | 모두에서 유의 | "모든 지표가 개선되어야 성공" |
import numpy as np
from scipy import stats

rng = np.random.default_rng(8)
M, k, n = 40_000, 3, 64
d = 0.5

print(f"{'ρ':>5s} {'개별':>8s} {'적어도 하나':>12s} {'모두':>8s} "
      f"{'본페로니 후 하나':>16s}")
for rho in [0.0, 0.3, 0.6, 0.9]:
    S = rho * np.ones((k, k)) + (1 - rho) * np.eye(k)
    L = np.linalg.cholesky(S)
    z = rng.standard_normal((M, k)) @ L.T + d * np.sqrt(n / 2)
    p = 2 * stats.norm.sf(np.abs(z))
    sig = p < 0.05
    sig_b = p < 0.05 / k
    print(f"{rho:5.1f} {sig[:, 0].mean():8.4f} {sig.any(1).mean():12.4f} "
          f"{sig.all(1).mean():8.4f} {sig_b.any(1).mean():16.4f}")
    ρ       개별       적어도 하나       모두        본페로니 후 하나
  0.0   0.8105       0.9932   0.5231           0.9631
  0.3   0.8115       0.9725   0.5853           0.9170
  0.6   0.8065       0.9382   0.6451           0.8563
  0.9   0.8092       0.8797   0.7304           0.7667
세 정의가 크게 다르다. 개별 0.81인데 "모두"는 0.52, "적어도 하나"는 0.99다.
상관이 커지면 수렴한다. \(\rho=0.9\)에서 세 값이 0.73~0.88로 가까워진다. 결과변수들이 사실상 같은 것을 재기 때문이다.
본페로니 보정 후에도 "적어도 하나"는 높다. \(\rho=0\)에서 0.963이다. 보정의 대가가 생각보다 작다.
계획 지침.
-
주 결과변수를 하나로 정하는 것이 가장 깔끔하다. 그러면 정의의 문제가 사라진다.
-
여럿이 불가피하면 어느 정의를 쓸지 사전에 명시한다. "적어도 하나"인지 "모두"인지에 따라 필요한 표본이 크게 다르다.
-
"모두"를 요구하면 표본이 많이 든다. \(\rho=0\)에서 결합 검정력 80%를 얻으려면 개별 검정력이 \(0.8^{1/3}=0.928\)이어야 하고, 그만큼 표본이 는다.
-
복합 결과변수를 고려한다. 여러 지표를 하나로 합치면 문제가 사라지지만, 그 대신 해석이 흐려진다.
-
계층적 검정. 순서를 정해 순차 검정하면 보정 없이 FWER이 유지된다.
주의. 위 계산은 모든 결과변수에서 효과가 같다고 가정했다. 실제로는 일부만 효과가 있는 경우가 흔하고, 그때는 "적어도 하나"의 검정력이 크게 떨어진다.
연습문제 9. 결측과 탈락이 검정력에 미치는 영향을 계산하고, 설계에서 어떻게 대비하는지 정리하라.
풀이
단순한 경우 — 완전 무작위 탈락. 유효 표본이 \(n(1-q)\)로 줄고, 검정력이 그에 맞게 떨어진다.
import numpy as np
from scipy import stats

def power_t2(n, d=0.5, alpha=0.05):
    nu = max(2 * n - 2, 1)
    lam = d * np.sqrt(n / 2)
    tc = stats.t.ppf(1 - alpha / 2, nu)
    return stats.nct.sf(tc, nu, lam) + stats.nct.cdf(-tc, nu, lam)

n0 = 64                                   # 계획 표본(검정력 0.80)
print(f"{'탈락률':>8s} {'유효 n':>8s} {'실제 검정력':>12s} "
      f"{'보정 모집 n':>12s}")
for q in [0.0, 0.05, 0.10, 0.20, 0.30, 0.50]:
    neff = int(np.floor(n0 * (1 - q)))
    nadj = int(np.ceil(n0 / (1 - q)))
    print(f"{q:8.0%} {neff:8d} {power_t2(neff):12.4f} {nadj:12d}")
     탈락률     유효 n       실제 검정력      보정 모집 n
      0%       64       0.8015           64
      5%       60       0.7753           68
     10%       57       0.7538           72
     20%       51       0.7056           80
     30%       44       0.6402           92
     50%       32       0.5036          128
탈락률 20%면 검정력이 0.80에서 0.71로 떨어진다. 회복하려면 집단당 80명을 모집해야 한다.
대응설계에서는 더 심각하다. 두 측정 가운데 한쪽이 빠지면 쌍이 깨지므로, 개체 탈락률 \(q\)에서 완전한 쌍의 비율이 \((1-q)^2\)다.
for q in [0.10, 0.20, 0.30]:
    print(f"개체 탈락 {q:.0%} → 쌍 손실 {1 - (1 - q)**2:.1%}, "
          f"필요 모집 배율 {1 / (1 - q)**2:.2f}배")
개체 탈락 10% → 쌍 손실 19.0%, 필요 모집 배율 1.23배
개체 탈락 20% → 쌍 손실 36.0%, 필요 모집 배율 1.56배
개체 탈락 30% → 쌍 손실 51.0%, 필요 모집 배율 2.04배
더 나쁜 경우 — 정보적 탈락. 탈락이 결과와 관련되면 검정력만이 아니라 편향이 생긴다. 이때는 표본을 늘려도 해결되지 않는다.
설계에서의 대비.
| 항목 | 내용 |
|---|---|
| 표본 계산 | \(n/(1-q)\) 또는 대응이면 \(n/(1-q)^2\) |
| \(q\)의 출처 | 유사 연구의 실제 탈락률. 낙관하지 않는다 |
| 추적 계획 | 연락 수단 다중화, 방문 간격 단축, 보상 |
| 기저 정보 | 탈락자의 특성을 반드시 확보 |
| 분석 계획 | 혼합모형·다중대체를 사전 명시 |
| 민감도 | 결측이 결과와 관련된(비무작위 결측, missing not at random, MNAR) 시나리오에서의 결과 |
| 중간 점검 | 실제 탈락률을 확인하고 필요시 모집 확대 |
흔한 실수. 검정력 계산에서 나온 \(n\)을 그대로 모집 목표로 삼는 것이다. 임상시험 계획서를 검토할 때 가장 자주 발견되는 누락이다.
연습문제 10. 검정력 분석의 한계를 정리하라. 계산이 답해 주지 못하는 것은 무엇인가?
풀이
답해 주지 못하는 것 여덟.
1 — 효과크기가 얼마인가. 검정력 계산은 효과크기를 입력으로 받는다. 그것을 모르면 계산 전체가 가정 위에 선다. 순환논법에 가깝다.
2 — 연구를 할 가치가 있는가. 검정력 80%를 달성해도, 그 질문이 중요하지 않거나 이미 답이 알려져 있으면 무의미하다.
3 — 측정이 타당한가. 앞 쪽 제1종 오류와 제2종 오류 연습문제 9가 다룬 제3종 오류의 영역이다. 검정력이 아무리 높아도 잘못된 것을 재면 소용없다.
4 — 표본이 대표적인가. 검정력은 내적 타당도의 일부만 다룬다. 일반화 가능성은 전혀 다루지 않는다.
5 — 모형 가정이 맞는가. 정규성·독립성(independence)·등분산을 가정하고 계산한 검정력은, 그 가정이 깨지면 달라진다. 연습문제 6의 로그정규에서 본 대로 크게 떨어질 수 있다.
6 — 비표집오차. 무응답 편향, 측정오차, 누락변수 편향은 표본을 늘려도 줄지 않는다. 검정력을 높이는 것이 이들을 해결하지 못한다.
7 — 여러 연구를 합친 결론. 하나의 연구가 검정력 80%여도, 분야 전체의 신뢰도는 사전등록·보고 관행·재현 문화에 달려 있다.
8 — 결과를 어떻게 쓸 것인가. 정책 결정, 임상 지침, 후속 연구의 방향은 통계 밖의 문제다.
검정력 계산의 진짜 가치.
이 모든 한계에도 검정력 분석이 중요한 이유는
- 자원 배분을 합리화한다. "이 설계로 무엇을 알 수 있는가"를 사전에 묻게 한다.
- 효과크기를 명시하게 만든다. 이 과정에서 "우리가 찾는 효과가 얼마나 큰가"를 영역 전문가와 논의하게 되며, 이 논의 자체가 계산 결과보다 값질 때가 많다.
- 실현 불가능한 연구를 걸러 낸다. "필요한 표본이 5,000명"이라는 계산은 계획을 바꾸라는 신호다.
- 투명성을 강제한다. 가정을 문서에 적게 한다.
권고 세 가지.
- 하나의 숫자가 아니라 범위로 생각한다. 여러 효과크기와 가정에서 계산해 표로 제시한다.
- "탐지 가능한 최소 효과"를 함께 보고한다. 자원이 제한된 현실에서 가장 정직한 표현이다.
- 검정력이 낮으면 낮다고 밝힌다. 숨기는 것이 가장 나쁘다. 밝히면 독자가 결과를 올바로 할인해 읽을 수 있다.
한 문장. 검정력 분석은 연구의 품질을 보장하지 않는다. 다만 품질을 논의할 언어를 준다.
연습문제 11. (\(\sigma\)를 아는) 양측 일표본 z-검정에서 \(\mu = \mu_0 + \delta\)를 탐지하는 검정력을 다음과 같이 쓸 수 있음을 보여라.
풀이
\(H_a\colon \mu = \mu_0 + \delta\) 아래에서 검정통계량 \(Z = (\bar{X}-\mu_0)/(\sigma/\sqrt{n})\)은 \(N(\delta\sqrt{n}/\sigma,\,1)\)을 따른다. \(\lambda = \delta\sqrt{n}/\sigma\)라 하자. 이 검정은 \(|Z| > z_{1-\alpha/2}\)일 때 기각하므로
\(Z \sim N(\lambda, 1)\)이므로 이렇게 된다.
둘을 더하면 원하는 결과를 얻는다. \(\square\)
연습문제 12. 유의수준 \(\alpha\)와 효과크기 \(\delta > 0\)이 고정되어 있을 때 \(n \to \infty\)이면 이표본 z-검정의 검정력이 1에 다가감을 증명하라.
풀이
검정력은
\(n \to \infty\)이면 항 \(\delta / (\sigma\sqrt{2/n}) = \delta\sqrt{n}/({\sigma\sqrt{2}}) \to \infty\)이다. 따라서 이렇게 된다.
- 첫째 항: \(\Phi(\infty - z_{1-\alpha/2}) = \Phi(\infty) = 1\).
- 둘째 항: \(\Phi(-\infty - z_{1-\alpha/2}) = \Phi(-\infty) = 0\).
그러므로 \(1-\beta \to 1\)이다. 자료가 충분하면 0이 아닌 어떤 고정된 효과도 결국 탐지됨을 확인해 준다. \(\square\)
연습문제 13. 조건부 검정력과 예측 검정력을 정의하고, 중간분석에서 무익성(futility)을 판단하는 데 어떻게 쓰이는지 설명하라.
풀이
상황. 계획 표본의 절반을 모았다. 지금까지의 결과로 "끝까지 가면 유의해질까"를 묻는다.
조건부 검정력(CP). 현재까지의 자료를 조건으로, 특정 참 효과 아래에서 최종 유의할 확률이다.
import numpy as np
from scipy import stats

za = stats.norm.ppf(0.975)
t = 0.5                                  # 정보 비율(절반 모음)

def cp(z_now, delta_over_se_final, t=0.5, za=za):
    """z_now: 현재 시점의 z 통계량 (정보비율 t)"""
    num = za - np.sqrt(t) * z_now - (1 - t) * delta_over_se_final
    return stats.norm.sf(num / np.sqrt(1 - t))

print(f"{'현재 z':>8s} {'δ=계획값':>10s} {'δ=현재추정':>12s} {'δ=0':>8s}")
for z_now in [0.0, 0.5, 1.0, 1.5, 2.0]:
    planned = za + stats.norm.ppf(0.90)          # 검정력 90% 설계
    print(f"{z_now:8.1f} {cp(z_now, planned):10.4f} "
          f"{cp(z_now, z_now / np.sqrt(t)):12.4f} {cp(z_now, 0.0):8.4f}")
    현재 z      δ=계획값       δ=현재추정      δ=0
     0.0     0.3157       0.0028   0.0028
     0.5     0.5081       0.0382   0.0115
     1.0     0.6986       0.2201   0.0382
     1.5     0.8462       0.5903   0.1017
     2.0     0.9358       0.8903   0.2201
읽기.
- 현재 \(z=0\)이면 계획한 효과가 참이어도 최종 유의 확률이 0.32에 불과하다. 절반의 정보를 이미 썼는데 아무 신호가 없기 때문이다.
- 현재 추정값을 참으로 놓으면 0.003이다. 거의 확실히 실패한다.
- \(\delta=0\) 가정은 무익성의 최악 시나리오다.
예측 검정력(PP). \(\delta\)를 하나로 고정하지 않고 사후분포(posterior distribution)로 적분한다.
- 장점: \(\delta\)를 임의로 고르는 문제를 피한다. 현재 자료의 불확실성을 반영한다.
- 단점: 사전분포(prior distribution)가 필요하다.
무익성 중단 규칙. 흔히 "CP(현재 추정값) \(<0.20\)이면 중단"을 쓴다. 위 표에서 \(z<1.0\)이면 중단에 해당한다.
주의할 점 넷.
-
어느 \(\delta\)를 쓰는지가 결정적이다. 계획값을 쓰면 낙관적, 현재 추정값을 쓰면 비관적, \(\delta=0\)이면 극단적으로 비관적이다. 미리 정해 문서화해야 한다.
-
검정력이 조금 떨어진다. 무익성 중단을 넣으면 참 효과가 있는데도 일찍 멈출 확률이 생긴다. 설계 단계에서 이 손실을 반영해 표본을 조금 늘린다.
-
\(\alpha\)에는 영향이 거의 없다. 무익성 중단은 기각을 줄이는 방향이므로 제1종 오류율을 높이지 않는다. 오히려 낮춘다.
-
구속력 여부. 무익성 경계를 "반드시 따른다(binding)"로 하면 \(\alpha\)를 되찾을 수 있지만, 운영위원회의 재량이 사라진다. 실무에서는 비구속적으로 두는 경우가 많다.
윤리적 의미. 실패할 시험을 계속하면 참가자를 불필요한 위험에 노출시키고 자원을 낭비한다. 무익성 중단은 통계적 장치이기 전에 윤리적 장치다.
연습문제 14. 검정력 계산을 모의실험으로 하는 법을 보이고, 공식이 없는 상황에서 어떻게 쓰는지 예를 들어라.
풀이
원리. ① 대립가설 아래에서 자료를 생성하고 ② 계획한 분석을 그대로 수행하여 ③ 기각 비율을 센다.
import numpy as np
from scipy import stats

rng = np.random.default_rng(101)
M = 20_000

def sim_power(gen, analyze, M=M, alpha=0.05):
    return np.mean([analyze(*gen()) < alpha for _ in range(M)])

# 1) 공식이 있는 경우로 검증
n, d = 30, 0.5
gen1 = lambda: (rng.normal(d, 1, n), rng.normal(0, 1, n))
ana1 = lambda x, y: stats.ttest_ind(x, y, equal_var=False).pvalue
theo = stats.norm.sf(stats.norm.ppf(0.975) - d / np.sqrt(2 / n))
print(f"t 검정  모의 {sim_power(gen1, ana1):.4f}   이론(정규근사) {theo:.4f}")

# 2) 공식이 마땅치 않은 경우: 치우친 자료에 만-휘트니
def gen2():
    x = rng.lognormal(0.3, 1.0, n)
    y = rng.lognormal(0.0, 1.0, n)
    return x, y
ana2 = lambda x, y: stats.mannwhitneyu(x, y, alternative="two-sided").pvalue
ana3 = lambda x, y: stats.ttest_ind(x, y, equal_var=False).pvalue
print(f"로그정규 — 만-휘트니 {sim_power(gen2, ana2):.4f}   "
      f"웰치 t {sim_power(gen2, ana3):.4f}")
t 검정  모의 0.4768   이론(정규근사) 0.4906
로그정규 — 만-휘트니 0.1961   웰치 t 0.1422
첫 줄이 코드의 검증이다. 모의실험 0.477이 정규근사 0.491에 가깝다. 차이는 \(t\) 분포의 꼬리와 자유도를 정규근사가 무시한 데서 오며, \(n\)을 키우면 사라진다. 모의실험 코드를 짤 때 이런 대조를 반드시 먼저 해 본다.
둘째 줄이 모의실험의 가치다. 로그정규 자료에서 만–휘트니가 웰치 \(t\)보다 검정력이 1.4배 높다(0.196 대 0.142). 이런 비교는 공식으로 하기 어렵다. 두 방법 모두 검정력이 낮은 것은 로그정규의 변동이 커서 \(n=30\)으로는 부족하다는 뜻이며, 이 사실을 설계 전에 아는 것 자체가 모의실험의 가치다.
모의실험이 필요한 상황.
| 상황 | 왜 공식이 없나 |
|---|---|
| 비정규 자료의 \(t\)/비모수 비교 | 비중심분포가 표준이 아님 |
| 혼합모형, 반복측정 | 자유도와 상관구조가 복잡 |
| 다단계·적응 설계 | 중단 규칙이 얽힘 |
| 결측·탈락이 있는 설계 | 유효 표본이 확률적 |
| 다중비교 보정 후 검정력 | 검정 간 상관 반영 |
| 사용자 정의 통계량 | 분포가 알려지지 않음 |
설계 시 주의.
- 분석 코드를 그대로 쓴다. 실제로 쓸 코드를 모의실험에 넣어야 한다. 단순화하면 의미가 없다.
- \(M\)과 몬테카를로(Monte Carlo) 표준오차(MCSE)를 보고한다. 검정력 0.8 근처에서 \(M=10{,}000\)이면 MCSE가 0.004다.
- 여러 시나리오를 훑는다. 효과크기, 분산, 결측률, 분포 형태.
- 가장 비관적인 시나리오를 반드시 포함한다. 설계는 최악에 견뎌야 한다.
- 씨앗과 코드를 계획서에 첨부한다.
연습문제 15. 검정력이 낮으면 유의한 결과의 효과크기가 과장되고 부호까지 틀릴 수 있다. 이를 정량화하라(M-오류와 S-오류).
풀이
개념. 겔먼과 칼린이 제안한 두 지표다.
- M-오류(type M error, 과장 비): 유의한 결과만 모았을 때 \(E[|\hat\theta|\mid\text{유의}]/|\theta|\). M 은 크기(magnitude)다.
- S-오류(type S error, 부호 오류율): 유의한 결과의 부호가 참 부호와 반대일 확률.
import numpy as np
from scipy import stats
from scipy.optimize import brentq

rng = np.random.default_rng(6)
M = 400_000
za = stats.norm.ppf(0.975)

print(f"{'검정력':>8s} {'θ/SE':>7s} {'과장 비 M':>10s} {'부호 오류 S':>12s}")
for pw in [0.06, 0.10, 0.20, 0.50, 0.80, 0.95]:
    # 목표 검정력을 주는 참 효과(표준오차 단위)
    nc = brentq(lambda c: stats.norm.sf(za - c)
                + stats.norm.cdf(-za - c) - pw, 1e-9, 10)
    z = rng.normal(nc, 1, M)
    est = z[np.abs(z) > za]                      # 유의한 결과만
    print(f"{pw:8.0%} {nc:7.3f} {np.mean(np.abs(est)) / nc:10.3f} "
          f"{np.mean(est < 0):12.4f}")
     검정력    θ/SE     과장 비 M      부호 오류 S
      6%   0.295      8.015       0.2030
     10%   0.652      3.710       0.0449
     20%   1.115      2.258       0.0051
     50%   1.960      1.407       0.0001
     80%   2.802      1.125       0.0000
     95%   3.605      1.030       0.0000
검정력 20%인 연구에서 유의하게 나온 효과는 평균적으로 참값의 2.3배다. 검정력 10%면 3.7배, 6%면 8배다.
부호까지 틀릴 수 있다. 검정력 6%이면 유의한 결과의 20%가 참 효과와 반대 방향이다. "여성에게 효과가 있다"가 실제로는 "해롭다"일 수 있다는 뜻이다.
왜 그런가. 유의하려면 \(|\hat\theta|>1.96\,\text{SE}\)여야 한다. 참 효과가 SE보다 훨씬 작으면, 이 임계값을 넘는 표본은 우연히 크게 나온 것뿐이다. 선택이 곧 과장을 만든다.
검정력 80% 이상이면 문제가 거의 없다. 과장 비 1.13, 부호 오류 0이다. 이것이 "검정력 80%"라는 관례의 숨은 근거 중 하나다.
실무적 함의.
-
소규모 연구의 "놀라운 발견"을 의심한다. 효과가 크게 보이는 것 자체가 검정력이 낮다는 증거일 수 있다.
-
후속 연구의 표본을 원 연구의 효과크기로 계산하면 안 된다. 과장된 값을 쓰면 표본이 크게 모자란다. 문헌의 효과크기를 절반으로 할인하는 것이 안전하다는 제안이 있다.
-
메타분석에서 소규모 연구가 큰 효과를 보이는 현상(소규모 연구 효과)이 여기서 부분적으로 설명된다. 출판 편향과 겹친다.
-
설계 단계에서 M-오류를 계산해 볼 가치가 있다. "이 설계로 유의한 결과가 나온다면 그것을 얼마나 믿을 수 있는가"를 미리 아는 것이다.
정리하며
- 검정력은 참 효과를 올바르게 탐지할 확률이다.
- 표본크기가 충분한지 확인하기 위해 연구 전에 항상 검정력 분석을 하라.
- 표본크기를 늘리는 것이 검정력을 높이는 가장 현실적인 방법이다.
- \(\alpha\), \(\beta\), 표본크기, 효과크기 사이에는 직접적인 트레이드오프가 있다.
- Statsmodels는 여러 검정 유형에 대한 편리한 검정력 분석 함수를 제공한다.
- 검정력 곡선으로 표본크기와 검정력의 관계를 시각화하라.
- \(n\) 이 효과크기의 제곱에 반비례한다. 효과가 절반이면 표본은 네 배다. 작은 효과를 찾는 연구가 왜 대규모여야 하는지가 여기서 나온다.
- 가장 어려운 입력은 통계가 아니다. 「의미 있는 최소 효과」는 분야 지식이 정하며, 그 값 없이는 계산 자체가 시작되지 않는다.
다음 절 다중검정으로 넘어간다. 여기까지는 검정 하나의 오류율과 검정력을 따졌는데, 검정을 여럿 하면 각각이 \(\alpha\) 를 지켜도 적어도 하나가 틀릴 확률은 그보다 훨씬 커진다.