붓스트랩 원리
동기
표본 \(x_1, \ldots, x_n\)에서 계산한 통계량 \(\hat{\theta}\)의 표준오차를 추정하고 싶다고 하자. 정규모집단의 표본평균이라면 답이 간단하다. \(s / \sqrt{n}\)이다. 그런데 \(\hat{\theta}\)가 중앙값, 절사평균, 두 추정량의 비, 또는 자료의 복잡한 함수라면 어떨까? 실제 상황에서는 표준오차의 닫힌 공식이 존재하지 않는 경우가 많다.
Bradley Efron은 1979년에 바로 이 문제를 풀기 위해 붓스트랩을 도입했다. 핵심 발상은 놀랍도록 단순하다. 관측된 표본을 마치 모집단인 것처럼 다루고, 재표집으로 \(\hat{\theta}\)의 거동을 배우는 것이다.
대입 원리
붓스트랩은 통계학의 일반적 전략인 대입 원리(plug-in principle)에 기댄다. 관심 있는 양이 알려지지 않은 모집단 분포 \(F\)에 의존한다면, \(F\) 자리에 경험적 분포함수 \(\hat{F}_n\)을 대입하여 추정한다.
경험적 분포함수는 관측된 각 자료점에 같은 질량 \(1/n\)을 둔다.
예를 들어 모평균 \(\mu = \int x \, dF(x)\)는 \(\bar{x} = \int x \, d\hat{F}_n(x) = \frac{1}{n}\sum_{i=1}^n x_i\)로 추정된다. 모분산 \(\sigma^2 = \int (x - \mu)^2 \, dF(x)\)는 표본 대응물 \(\frac{1}{n}\sum_{i=1}^n (x_i - \bar{x})^2\)으로 추정된다. 대입 원리는 이 발상을 \(F\)의 임의의 범함수로 확장할 뿐이다.
대입 원리가 작동하는 이유
Glivenko-Cantelli 정리는 \(n \to \infty\)일 때 \(\hat{F}_n \to F\)가 거의 확실하게 균등수렴함을 보장한다. 연속인 범함수 \(T(F)\)에 대해 이 수렴은 \(T(\hat{F}_n) \to T(F)\)를 함의하므로, 온건한 정칙조건 아래에서 대입 추정량은 일치추정량이다.
대입에서 붓스트랩으로
대입 원리는 모수를 어떻게 추정할지 알려 준다. 붓스트랩은 이 발상을 추정량의 표본분포를 추정하는 데까지 확장한다.
i.i.d. 표본 \(X_1, \ldots, X_n \sim F\)에서 계산한 통계량 \(\hat{\theta} = g(X_1, \ldots, X_n)\)을 생각하자. 그 표본분포는 알려지지 않은 \(F\)에 의존한다. 붓스트랩은 모든 곳에서 \(F\)를 \(\hat{F}_n\)으로 대체한다.
| 모집단 세계 | 붓스트랩 세계 | |
|---|---|---|
| 분포 | \(F\) (미지) | \(\hat{F}_n\) (기지) |
| 표본 | \(X_1, \ldots, X_n \overset{\text{iid}}{\sim} F\) | \(X_1^*, \ldots, X_n^* \overset{\text{iid}}{\sim} \hat{F}_n\) |
| 통계량 | \(\hat{\theta} = g(X_1, \ldots, X_n)\) | \(\hat{\theta}^* = g(X_1^*, \ldots, X_n^*)\) |
| 목표 | \(F\) 아래 \(\hat{\theta}\)의 분포 | \(\hat{F}_n\) 아래 \(\hat{\theta}^*\)의 분포 |
\(\hat{F}_n\)은 \(\{x_1, \ldots, x_n\}\) 위에 지지집합을 갖는 이산분포이므로, \(\hat{F}_n\)에서 추출하는 것은 원자료에서 복원추출하는 것과 같다.
핵심 유비
Efron의 통찰은 한 문장으로 요약된다. 붓스트랩 세계와 관측된 표본의 관계는 현실 세계와 모집단의 관계와 같다.
현실 세계에서 우리는 모집단에서 표본을 뽑아 통계량을 계산한다. 표본이 하나뿐이므로 이 실험을 반복할 수 없다. 붓스트랩 세계에서는 "표본에서 표본을" 뽑아 같은 통계량을 계산한다. "모집단"(관측자료)을 완전히 알고 있으므로 원하는 만큼 반복할 수 있다.
붓스트랩 표본에 걸친 \(\hat{\theta}^*\)의 변동이 \(F\)에서 반복 표집했을 때의 \(\hat{\theta}\)의 변동을 근사한다.
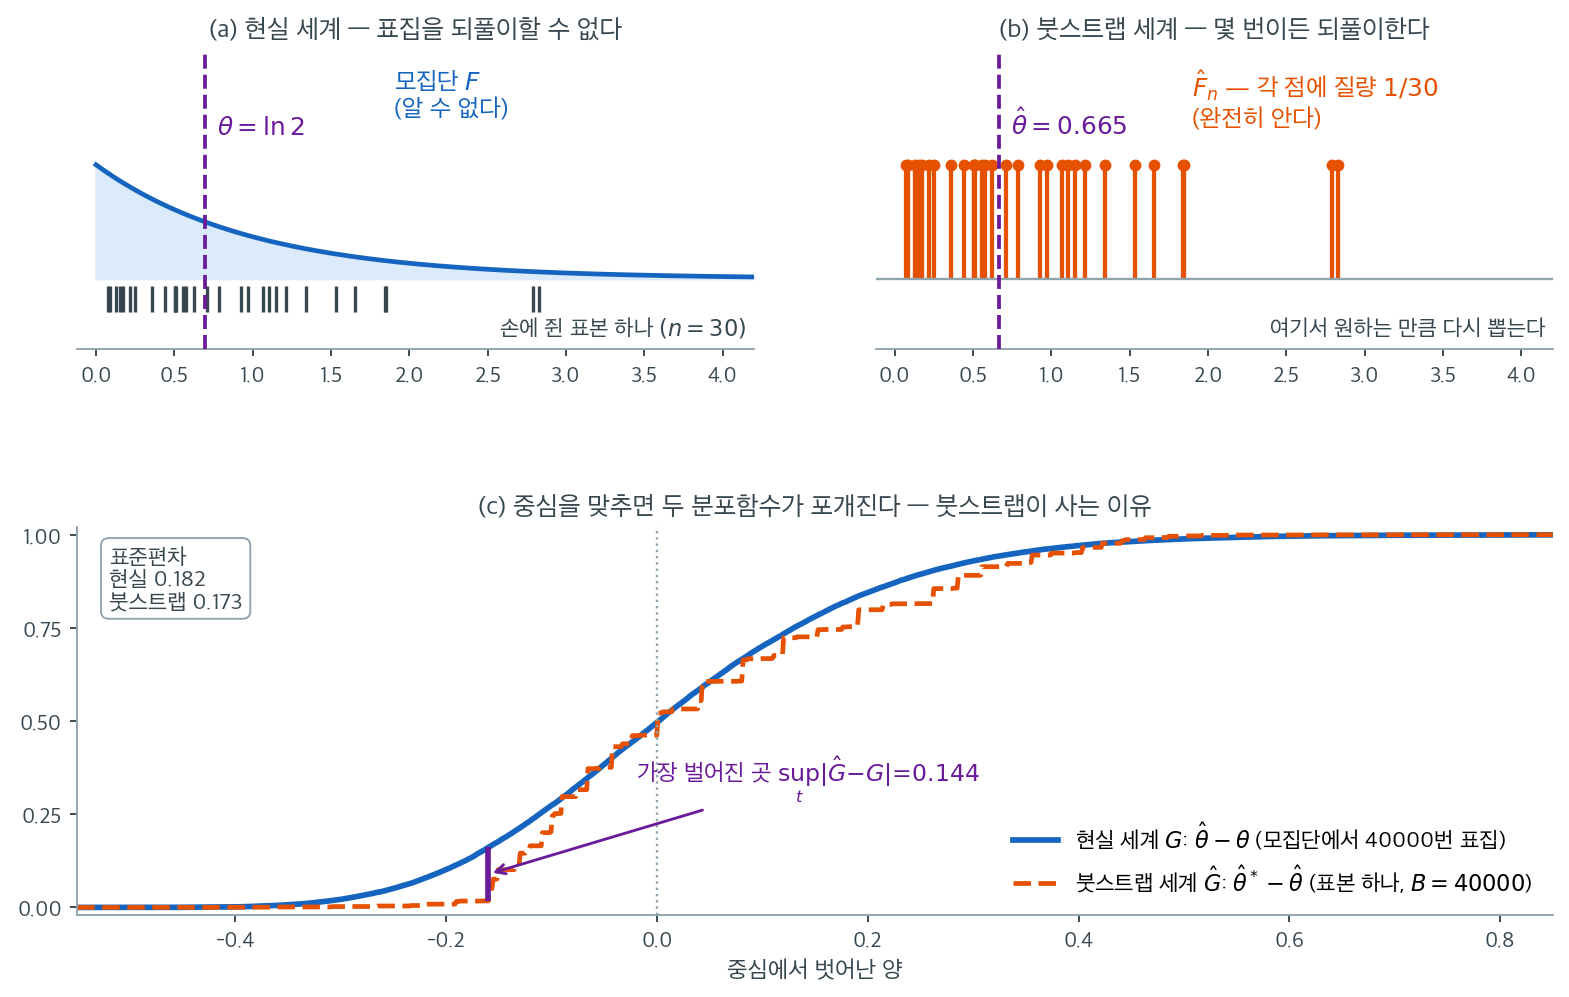
그림의 위쪽 두 칸이 유비 그 자체이다. (a)에서 \(\text{Exp}(1)\) 모집단에서 \(n = 30\)을 뽑았고 중앙값의 참값은 \(\theta = \ln 2 = 0.693\)이지만, 우리에게 주어진 것은 눈금으로 찍힌 저 30개뿐이다. 같은 실험을 다시 할 수 없으므로 \(\hat\theta\)가 얼마나 흔들리는지 알 길이 없다. (b)는 같은 30개를 다른 눈으로 본 것이다. 각 점에 질량 \(1/30\)을 얹으면 그것이 \(\hat{F}_n\)이고, 이 분포는 미지의 대상이 아니라 우리가 완전히 아는 대상이다. 그래서 (b)에서는 표집을 몇 번이든 되풀이할 수 있다. 이 표본의 중앙값은 \(\hat\theta = 0.665\)이며, 붓스트랩 세계에서는 이 값이 "참 모수" 노릇을 한다.
아래 칸이 유비가 실제로 값을 하는 지점이다. 두 세계에서 각각 4만 번씩 반복하여 각자의 중심에서 벗어난 양을 모았다. 파란 곡선은 현실 세계의 \(\hat\theta - \theta\)이고 주황 계단은 붓스트랩 세계의 \(\hat\theta^* - \hat\theta\)인데, 서로 다른 중심에서 출발했는데도 두 분포함수가 거의 포개진다. 표준편차가 \(0.182\) 대 \(0.173\)이다. 참 표준오차를 알려면 모집단이 필요한데, 손에 든 표본 하나만으로 그 값을 \(5\%\) 오차 안에서 재현한 셈이다. 중앙값에는 \(s/\sqrt{n}\) 같은 공식이 없다는 점을 기억하면 이것이 공짜로 얻은 것이 아님을 알 수 있다.
동시에 그림은 붓스트랩의 한계도 숨기지 않는다. 주황 곡선이 계단인 것은 붓스트랩 중앙값이 관측된 30개 값의 조합에서만 나올 수 있기 때문이다. 두 곡선이 가장 벌어진 곳에서 간격이 \(\sup_t |\hat{G} - G| = 0.144\)이며, 이 틈은 \(B\)를 아무리 키워도 줄지 않는다. 위의 일치성 정리가 \(B \to \infty\)가 아니라 \(n \to \infty\)를 요구하는 이유가 여기에 있다. \(B\)는 붓스트랩 세계를 얼마나 촘촘히 탐색했는지를 정할 뿐이고, 그 세계 자체가 현실 세계와 얼마나 닮았는지는 오직 \(n\)이 정한다.
형식적 서술
\(\hat{\theta}_n = T(\hat{F}_n)\)을 경험적 분포에서 평가한 통계적 범함수라 하자. \(\hat{\theta}_n - \theta\)의 분포에 대한 붓스트랩 추정은
이다. 여기서 \(P^*\)는 (관측자료에 조건부로) 붓스트랩 재표집에 대한 확률이고 \(\hat{F}_n^*\)은 붓스트랩 표본의 경험적 분포이다.
\(\hat{G}_n\)이 \(\hat{\theta}_n - \theta\)의 참 분포 \(G\)로 확률수렴하면 붓스트랩이 일치한다고 한다. 정칙조건(\(T\)의 매끄러움, 유한한 2차 적률) 아래에서 이 수렴이 성립한다.
실무적 함의
붓스트랩 일치성은 \(n\)이 충분히 크고 재표집 횟수 \(B\)가 충분히 크면 \(\hat{\theta}^* - \hat{\theta}\)의 붓스트랩 분포가 \(\hat{\theta} - \theta\)의 참 표본분포를 충실히 대변한다는 뜻이다. 이것이 붓스트랩 복제로 신뢰구간을 만들고 가설검정을 수행하는 것을 정당화한다.
보기 1. 중앙값의 표준오차. \(n = 20\)인 표본에서 표본중앙값의 표준오차를 구하고 싶다고 하자. 평균의 \(s/\sqrt{n}\)과 달리 간단한 공식이 없다.
붓스트랩 절차:
- 관측된 중앙값 \(\hat{\theta} = \text{median}(x_1, \ldots, x_{20})\)을 계산한다.
- \(b = 1, \ldots, B\)에 대해 자료에서 복원추출로 20개를 뽑아 중앙값 \(\hat{\theta}^{*(b)}\)을 계산한다.
- \(B\)개 붓스트랩 중앙값의 표준편차로 표준오차를 추정한다.
풀이
여기서 \(\bar{\hat{\theta}}^* = \frac{1}{B}\sum_{b=1}^{B} \hat{\theta}^{*(b)}\)이다.
이 절차는 \(\hat{\theta}\)가 중앙값이든 상관계수든 회귀계수든 다른 어떤 통계량이든 똑같이 작동한다.
붓스트랩 표본의 성질
크기 \(n\)인 각 붓스트랩 표본은 복원추출로 뽑으므로, 원래 관측값 중 일부는 여러 번 나타나고 일부는 전혀 나타나지 않는다. 특정 관측값이 한 붓스트랩 표본에서 제외될 확률은
이다. 평균적으로 원래 고유 관측값의 약 63.2%가 각 붓스트랩 표본에 나타난다. 나머지 36.8%는 out-of-bag 관측값이라 불리며 랜덤 포레스트 같은 응용에서 중요한 역할을 한다.
붓스트랩은 새로운 정보를 만들지 않는다
붓스트랩이 마술처럼 새 자료를 만들거나 표집변동을 줄여 주지는 않는다. 붓스트랩은 관측된 단 하나의 표본에 담긴 정보만으로, 모집단에서 반복 표집했을 때 통계량이 얼마나 변할지를 추정한다. 표본이 모집단을 대표하지 못하면 붓스트랩은 그 비대표성을 충실히 재현할 뿐이다.
연습문제
연습문제 1. 붓스트랩 표본을 왜 비복원이 아니라 복원추출로 뽑는가? 원자료에서 크기 \(n\)인 표본을 비복원으로 뽑으면 무슨 일이 일어나는가?
풀이
크기 \(n\)인 자료에서 크기 \(n\)인 표본을 비복원으로 뽑으면 원자료를 순서만 바꾼 것이 나온다. 자료의 다중집합이 언제나 동일하므로 모든 붓스트랩 표본이 같은 통계량 값을 준다.
import numpy as np
rng = np.random.default_rng(0)
x = rng.normal(0, 1, 20)
without = [rng.permutation(x).mean() for _ in range(1000)]
withrep  = [rng.choice(x, 20, replace=True).mean() for _ in range(1000)]
print(np.std(without), np.std(withrep))   # 4.9e-17, 0.1905
출력:
4.9214322082716815e-17 0.19048618210062987
비복원의 표준편차가 \(5 \times 10^{-17}\)로 사실상 \(0\)이다(부동소수점 오차만 남는다). 변동이 전혀 없으므로 표준오차 추정값이 \(0\)이 되고 붓스트랩이 완전히 무의미해진다.
더 근본적인 이유는 붓스트랩 세계가 현실 세계를 흉내 내야 한다는 데 있다. 현실에서 우리는 무한(또는 매우 큰) 모집단 \(F\)에서 \(n\)개를 뽑는다. 이는 사실상 복원추출이다. 붓스트랩 세계에서 \(\hat{F}_n\)은 \(\{x_1, \ldots, x_n\}\) 위의 이산분포이고, 이 분포에서 i.i.d.로 \(n\)개를 뽑는 것이 바로 복원추출이다.
\(m\)-out-of-\(n\) 붓스트랩
예외가 있다. 표본크기 \(m < n\)으로 뽑는 \(m\)-out-of-\(n\) 붓스트랩은 표준 붓스트랩이 실패하는 상황(예: 최댓값이나 극단 분위수 추정)에서 일치성을 회복하는 데 쓰인다. 이 경우에도 추출은 복원으로 한다.
연습문제 2. \((1 - 1/n)^n\)이 \(n\)에 대해 어떻게 변하는지 계산하고, \(e^{-1}\)로의 수렴이 얼마나 빠른지 확인하라. \(n\)이 작을 때 붓스트랩 표본에 포함되는 고유 관측값의 비율은 얼마인가?
풀이
import numpy as np
for n in (5, 10, 20, 50, 100, 1000):
    p_out = (1 - 1/n) ** n
    print(n, round(p_out, 4), round(1 - p_out, 4))
print(np.exp(-1))
출력:
5 0.3277 0.6723
10 0.3487 0.6513
20 0.3585 0.6415
50 0.3642 0.6358
100 0.366 0.634
1000 0.3677 0.6323
0.36787944117144233
| \(n\) | \(P(\text{제외})= (1-1/n)^n\) | 포함되는 고유 관측값 비율 |
|---|---|---|
| 5 | 0.3277 | 0.6723 |
| 10 | 0.3487 | 0.6513 |
| 20 | 0.3585 | 0.6415 |
| 50 | 0.3642 | 0.6358 |
| 100 | 0.3660 | 0.6340 |
| 1000 | 0.3677 | 0.6323 |
| \(\infty\) | 0.3679 | 0.6321 |
수렴이 위에서 아래로 단조롭게 일어난다. \((1-1/n)^n\)은 \(n\)에 대해 증가하며 \(e^{-1} = 0.36788\)로 수렴한다.
수렴이 꽤 빠르다. \(n = 20\)에서 이미 \(0.3585\)로 극한값과 \(0.009\) 차이이고, \(n = 100\)에서는 \(0.002\) 차이이다. 오차가 대략 \(e^{-1}/(2n)\) 정도로 줄어든다.
실무적 함의: \(n\)이 작아도 "약 63%" 규칙이 그런대로 맞는다. \(n = 5\)에서도 \(67\%\)로 크게 벗어나지 않는다. 다만 \(n = 5\)에서는 붓스트랩 자체가 신뢰할 만하지 않다는 점이 훨씬 큰 문제이다.
연습문제 3. 붓스트랩이 실패하는 예를 하나 구성하라. 표본최댓값 \(\hat{\theta} = \max(X_1, \ldots, X_n)\)의 붓스트랩 분포가 왜 참 표본분포를 근사하지 못하는가?
풀이
\(X_i \sim \text{Uniform}(0, \theta)\)이고 \(\hat{\theta} = \max_i X_i\)라 하자.
참 표본분포. \(\hat{\theta}/\theta\)의 분포는 연속이며 \(P(\hat\theta \le t) = (t/\theta)^n\)이다. 특히 \(n(\theta - \hat{\theta})/\theta \xrightarrow{d} \text{Exp}(1)\)이다.
붓스트랩 분포. 붓스트랩 표본의 최댓값 \(\hat{\theta}^*\)는 관측된 최댓값 \(x_{(n)}\)을 결코 넘을 수 없다. 그리고 \(\hat{\theta}^* = x_{(n)}\)일 확률은 \(x_{(n)}\)이 붓스트랩 표본에 적어도 한 번 포함될 확률이므로
이다. 즉 붓스트랩 분포가 관측값 \(\hat{\theta}\)에 확률질량 \(0.632\)의 원자를 갖는다. 참 분포는 연속인데 붓스트랩 분포는 그렇지 않다.
import numpy as np
rng = np.random.default_rng(1)
n, theta = 50, 1.0
x = rng.uniform(0, theta, n)
obs = x.max()
boot = np.array([rng.choice(x, n, replace=True).max() for _ in range(20000)])
print("P*(max* == max) =", (boot == obs).mean())   # 0.6384
print("이론값 =", 1 - (1 - 1/n) ** n)               # 0.6358
출력:
P*(max* == max) = 0.63845
이론값 = 0.6358303199128832
이 원자 때문에 붓스트랩 신뢰구간의 포함확률이 무너진다. 백분위수 구간의 상한이 \(\hat{\theta}\)를 절대 넘지 못하는데, 참인 \(\theta\)는 언제나 \(\hat{\theta}\)보다 크기 때문이다.
왜 실패하는가. 붓스트랩 일치성은 통계량이 \(\hat{F}_n\)의 매끄러운 범함수일 것을 요구한다. 최댓값은 매끄럽지 않다. 자료점 하나(가장 큰 것)에 전적으로 의존하며, 이는 미분 가능한 범함수가 아니다.
해결책. \(m\)-out-of-\(n\) 붓스트랩(\(m = o(n)\))이나 subsampling을 쓰면 일치성이 회복된다. 자세한 내용은 재표집이 실패할 때에서 다룬다.
정리하며
붓스트랩 원리는 다루기 어려운 해석적 문제(\(\hat{\theta}\)의 표본분포 구하기)를 계산 문제(관측자료에서 재표집하기)로 바꾼다. \(F\) 자리에 \(\hat{F}_n\)을 대입함으로써, 알려지지 않은 모집단 분포에 의존하는 임의의 양을 모의실험으로 근사할 수 있다. 이어지는 절에서는 구체적인 붓스트랩 절차 --- 비모수 붓스트랩, 모수적 붓스트랩, 그리고 이들을 신뢰구간과 가설검정에 적용하는 방법 --- 을 전개한다.