일표본 평균에 대한 붓스트랩 검정
동기
일표본 \(t\) 검정은 \(\bar{X}\)의 표본분포가 근사적으로 정규라고 가정한다. 모집단이 심하게 치우쳤거나 꼬리가 두껍거나 표본크기가 작으면 이 가정이 성립하지 않을 수 있다. 일표본 평균에 대한 붓스트랩 검정은 정규성에 기대지 않는 대안을 제공한다. 재표집으로 검정통계량의 귀무분포를 추정하므로, \(t\) 분포가 나쁜 근사일 때에도 타당한 추론이 가능하다.
가설
다음을 검정한다.
(양측이며, 단측은 \(p\)값 계산만 바꾸면 된다.)
관측 검정통계량은
또는 스튜던트화한 형태로
이다.
붓스트랩 분포의 중심화
붓스트랩 가설검정에서 결정적인 단계는 귀무가설을 만족하는 붓스트랩 표본을 생성하는 것이다. \(H_0: \mu = \mu_0\) 아래에서는 \(\mu_0\)에 중심을 둔 붓스트랩 표본이 필요한데, 원자료는 \(\bar{x}\)에 중심을 두고 있다.
해법은 재표집 전에 자료를 이동시키는 것이다.
이동된 표본 \(\{\tilde{x}_1, \ldots, \tilde{x}_n\}\)은 평균이 \(\mu_0\)이면서 원래의 산포와 모양을 그대로 보존한다. 여기서 뽑은 붓스트랩 표본은 "\(H_0\)이 참이라면 자료가 어떻게 보일까"를 나타낸다.
왜 중심화가 필요한가
중심화하지 않으면 \(\bar{x}\)에 중심을 둔 자료에서 재표집하게 되고, 이는 참 모수값 아래의 표본분포를 근사한다. 가설검정에는 귀무분포 --- \(H_0\)이 참이라는 가정 아래 검정통계량의 분포 --- 가 필요하다. \(\mu_0\)으로 중심화해야 붓스트랩이 이 귀무분포를 생성한다.
이 단계를 빠뜨리면 \(H_0\)이 참이어도 \(p\)값이 언제나 \(1\)에 가까워진다. 15장에서 같은 함정을 보았다.
알고리즘: 스튜던트화하지 않은 판본
- \(t_{\text{obs}} = \bar{x} - \mu_0\)을 계산한다.
- 중심화된 자료 \(\tilde{x}_i = x_i - \bar{x} + \mu_0\)을 만든다.
- \(b = 1, \ldots, B\)에 대해:
- \(\{\tilde{x}_1, \ldots, \tilde{x}_n\}\)에서 복원추출로 \(\tilde{x}_1^*, \ldots, \tilde{x}_n^*\)을 뽑는다.
- \(t^{*(b)} = \bar{\tilde{x}}^{*(b)} - \mu_0\)을 계산한다.
- 양측 \(p\)값은
알고리즘: 스튜던트화 판본
스튜던트화 판본은 \(t\) 통계량을 쓰며 대체로 검정력이 더 좋다.
- \(t_{\text{obs}} = (\bar{x} - \mu_0) / (s / \sqrt{n})\)을 계산한다.
- 중심화된 자료 \(\tilde{x}_i = x_i - \bar{x} + \mu_0\)을 만든다.
- \(b = 1, \ldots, B\)에 대해:
- \(\{\tilde{x}_1, \ldots, \tilde{x}_n\}\)에서 복원추출로 뽑는다.
- \(t^{*(b)} = (\bar{\tilde{x}}^{*(b)} - \mu_0) / (s^{*(b)} / \sqrt{n})\)을 계산한다.
- 양측 \(p\)값은
스튜던트화 대 비스튜던트화
스튜던트화 판본이 선호된다. 붓스트랩 표본마다 표준오차가 달라지는 변동을 반영하기 때문이다. 그 결과 검정이 이분산에 더 로버스트해지고 대체로 더 정확한 \(p\)값을 낸다. 연습문제 1에서 이 차이가 얼마나 큰지 확인한다.
이 권고의 근거는 "귀무분포가 표본마다 얼마나 달라지는가"에 있다. \(\text{Exp}(1)\)에서 \(n = 10\)짜리 표본을 여럿 뽑아, \(s\)가 유난히 작은 것(\(s = 0.46\))과 큰 것(\(s = 1.73\))을 하나씩 골라 각자의 귀무분포를 그려 보았다.
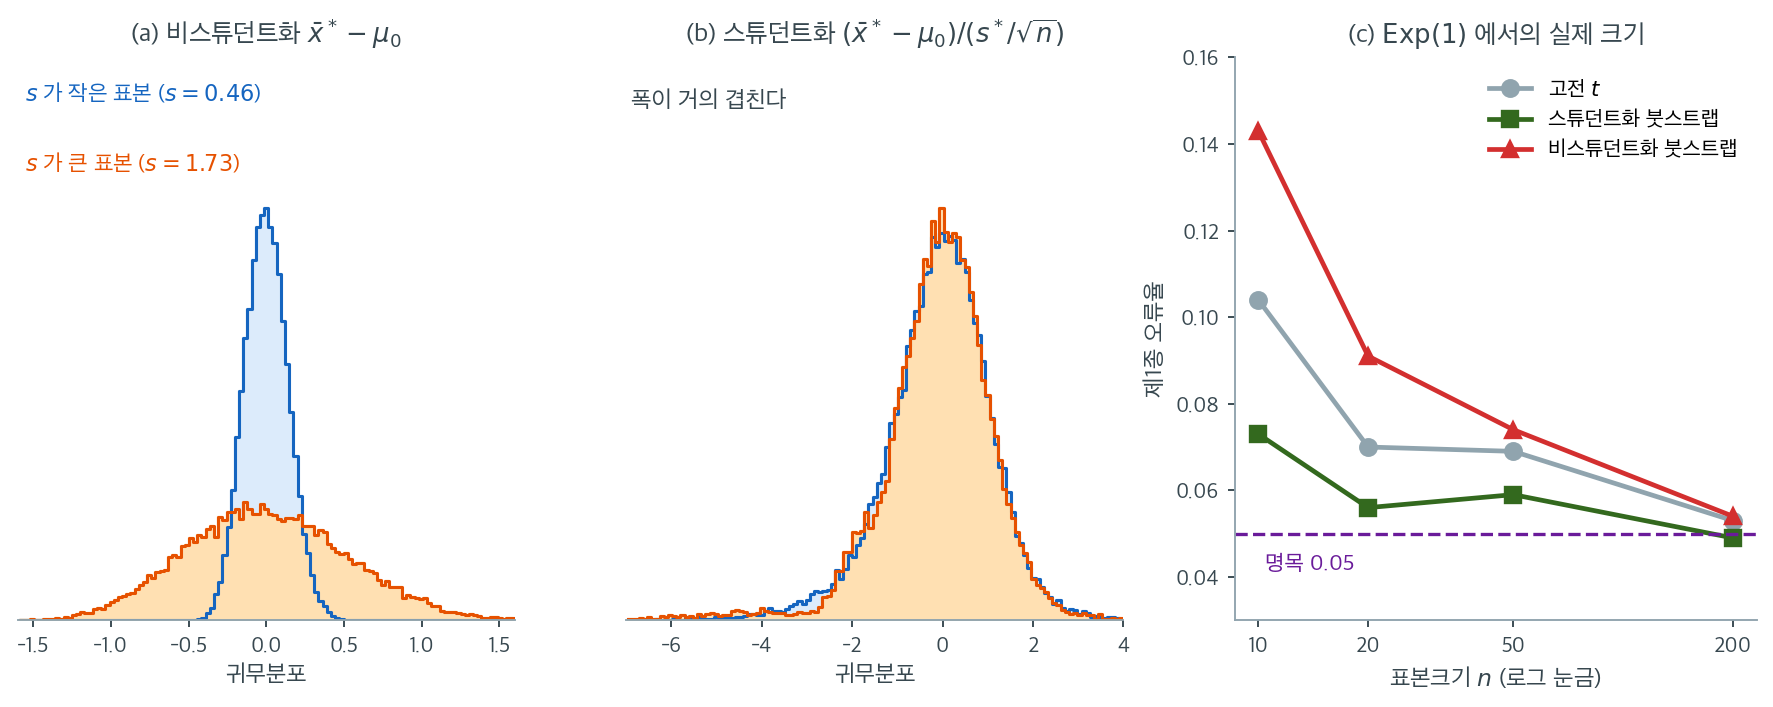
(a)의 두 분포는 폭이 4배 가까이 다르다. 표준편차가 \(0.138\)과 \(0.517\)이다. 귀무가설은 양쪽 모두 \(\mu = 1\)로 같은데, 기각의 기준이 되는 분포가 어느 표본을 얻었느냐에 따라 이만큼 달라진다는 뜻이다. 문제는 여기서 그치지 않는다. 지수분포에서는 \(\bar{x}\)와 \(s\)가 강한 양의 상관을 가지므로, \(s\)가 작은 표본은 \(\bar{x}\)도 작아 \(|t_{\text{obs}}|\)가 크게 나오는데 동시에 귀무분포까지 좁아진다. 두 효과가 같은 방향으로 겹쳐 과도한 기각을 만든다.
(b)는 같은 두 표본의 스튜던트화 귀무분포다. 이번에는 거의 포개진다. \(2.5\)/\(97.5\) 백분위수가 \((-2.76,\ 2.04)\)와 \((-3.01,\ 1.98)\)로, 왼쪽 꼬리가 길다는 공통된 모양까지 같다. \(s^*\)로 나누는 순간 자료의 척도가 빠져나가고 모양만 남기 때문이며, 이것이 "\(t^*\)가 근사 추축량"이라는 말의 실제 내용이다.
(c)가 그 대가와 보상이다. 비스튜던트화 붓스트랩은 \(n = 10\)에서 제1종 오류율이 \(0.143\)으로 명목값의 세 배에 이르러 고전 \(t\) 검정(\(0.104\))보다도 나쁘다. 스튜던트화 붓스트랩은 \(0.073\)으로 셋 중 가장 낫다. 다만 \(n = 10\)에서는 그것도 명목값보다 \(46\%\) 크다는 점을 함께 보아야 한다. 붓스트랩이 정규성 가정을 없애 주지만 표본이 작다는 사실까지 없애 주지는 않는다.
단측검정
\(H_1: \mu > \mu_0\)이면 양의 방향으로 극단적인 복제값을 센다.
\(H_1: \mu < \mu_0\)이면
보기 1. 배달시간 평균의 붓스트랩 검정. 어느 음식점의 배달시간(분) \(n = 12\)개 표본에서 \(\bar{x} = 34.2\), \(s = 8.7\)이었다. 음식점은 평균 배달시간이 30분이라고 주장한다. \(H_0: \mu = 30\) 대 \(H_1: \mu \neq 30\)을 검정한다.
풀이
1단계. \(t_{\text{obs}} = (34.2 - 30) / (8.7/\sqrt{12}) = 1.672\)
2단계. 자료를 이동한다: \(\tilde{x}_i = x_i - 34.2 + 30 = x_i - 4.2\)
3단계. 이동된 자료에서 스튜던트화 통계량의 붓스트랩 복제값 \(B = 10{,}000\)개를 생성한다.
4단계. \(10{,}000\)개 중 \(832\)개가 \(|t^{*(b)}| \ge 1.672\)를 만족했다고 하자.
붓스트랩 \(p\)값은 \(832/10{,}000 = 0.0832\)이다.
비교를 위해 고전적 \(t\) 검정은 \(t_{11}\) 분포로 \(p = 0.1226\)을 준다. 차이가 나는 것은 붓스트랩이 정규성을 가정하지 않기 때문이다. 배달시간이 오른쪽으로 치우쳐 있다면 붓스트랩 \(p\)값이 더 믿을 만하다.
신뢰구간과의 관계
붓스트랩 검정과 붓스트랩 신뢰구간 사이에는 직접적인 쌍대성이 있다. 붓스트랩 검정이 수준 \(\alpha\)에서 \(H_0: \mu = \mu_0\)을 기각하는 것은 \(\mu_0\)이 대응하는 \(100(1-\alpha)\%\) 붓스트랩 신뢰구간 바깥에 있는 것과 같다.
따라서 붓스트랩 검정을 따로 돌리는 대신 붓스트랩 신뢰구간을 만들고 \(\mu_0\)이 그 안에 있는지 확인해도 된다.
쌍대성은 짝이 맞는 방법 사이에서만 정확하다
이 쌍대성은 검정통계량과 구간의 구성 방식이 대응할 때에만 정확하다.
- 스튜던트화하지 않은 붓스트랩 검정 ↔ 기본(추축) 구간
- 스튜던트화 붓스트랩 검정 ↔ 붓스트랩-\(t\) 구간
백분위수 구간이나 BCa 구간은 여기에 정확히 대응하지 않는다. 스튜던트화 붓스트랩 검정의 \(p\)값이 \(0.03\)인데 백분위수 구간이 \(\mu_0\)을 포함하는 일이 얼마든지 가능하다. 검정과 구간을 함께 보고할 때는 짝을 맞추어야 한다.
p값의 몬테카를로 변동
붓스트랩 \(p\)값은 모의실험으로 추정되므로 몬테카를로 오차를 갖는다. \(B = 10{,}000\)에서 참 \(p\)값이 \(0.05\)이면 몬테카를로 표준오차가 약 \(\sqrt{0.05 \times 0.95 / 10{,}000} \approx 0.002\)이다. \(p\)값이 유의수준에 가까우면 \(B\)를 늘려 잘못된 결정의 확률을 줄여야 한다.
연습문제
연습문제 1. 붓스트랩 검정이 정말로 \(t\) 검정보다 나은지 확인하라. \(\text{Exp}(1)\) 자료에서 \(H_0: \mu = 1\)을 검정할 때 세 방법(고전 \(t\), 스튜던트화 붓스트랩, 비스튜던트화 붓스트랩)의 제1종 오류율을 비교하라.
풀이
import numpy as np
from scipy import stats
rng = np.random.default_rng(0)

for n in (10, 20, 50, 200):
    M, B = 2000, 999
    s_t = s_stud = s_unstud = 0
    for _ in range(M):
        x = rng.exponential(1, n)
        s_t += stats.ttest_1samp(x, 1).pvalue < 0.05

        xs = x - x.mean() + 1.0          # 중심화
        xb = xs[rng.integers(0, n, (B, n))]

        tobs = (x.mean() - 1) / (x.std(ddof=1) / np.sqrt(n))
        tb = (xb.mean(axis=1) - 1) / (xb.std(axis=1, ddof=1) / np.sqrt(n))
        s_stud += (np.abs(tb) >= abs(tobs)).mean() < 0.05

        uobs = x.mean() - 1
        ub = xb.mean(axis=1) - 1
        s_unstud += (np.abs(ub) >= abs(uobs)).mean() < 0.05
    print(n, round(s_t/M, 3), round(s_stud/M, 3), round(s_unstud/M, 3))
출력:
10 0.104 0.074 0.143
20 0.07 0.056 0.091
50 0.069 0.06 0.074
200 0.053 0.048 0.054
| \(n\) | 고전 \(t\) | 스튜던트화 붓스트랩 | 비스튜던트화 붓스트랩 |
|---|---|---|---|
| 10 | 0.104 | 0.073 | 0.143 |
| 20 | 0.070 | 0.056 | 0.091 |
| 50 | 0.069 | 0.059 | 0.074 |
| 200 | 0.053 | 0.049 | 0.054 |
스튜던트화 붓스트랩이 모든 표본크기에서 가장 낫다. \(n = 10\)에서 \(0.073\)으로 \(t\) 검정의 \(0.104\)보다 명목값에 훨씬 가깝다.
비스튜던트화 붓스트랩은 \(t\) 검정보다도 나쁘다. \(n = 10\)에서 \(0.143\)으로 명목값의 거의 세 배이다. 이것이 "스튜던트화 판본이 선호된다"는 권고의 구체적 근거이다.
왜 스튜던트화가 이렇게 중요한가. 비스튜던트화 통계량 \(\bar{X}^* - \mu_0\)의 붓스트랩 분포는 산포가 관측된 \(s\)에 의존한다. 우연히 \(s\)가 작은 표본을 얻으면 붓스트랩 분포가 좁아지고, 좁은 귀무분포에 비해 관측값이 극단적으로 보여 기각을 많이 하게 된다.
지수분포에서는 16장 연습문제 1에서 본 대로 \(\bar{X}\)와 \(s\)가 강한 양의 상관을 갖는다. \(\bar{X}\)가 작으면 \(s\)도 작아 이 문제가 증폭된다.
한계도 정직하게 보아야 한다. \(n = 10\)에서 스튜던트화 붓스트랩도 \(0.073\)으로 명목값보다 46% 크다. 붓스트랩이 정규성 가정을 없애 주지만, 표본이 작으면 여전히 부정확하다.
연습문제 2. 중심화를 빠뜨리면 어떻게 되는가? 중심화 없이 \(\hat\theta^{*}\)를 \(\mu_0\)과 직접 비교하는 잘못된 구현을 만들어 \(p\)값 분포를 확인하라.
풀이
import numpy as np
rng = np.random.default_rng(5)
n, B, M = 30, 999, 2000
mu0 = 1.0

p_right, p_wrong = [], []
for _ in range(M):
    x = rng.exponential(1, n)          # H0 가 참이다
    tobs = x.mean() - mu0

    # 올바른 구현: 중심화 후 재표집
    xs = x - x.mean() + mu0
    tb = xs[rng.integers(0, n, (B, n))].mean(axis=1) - mu0
    p_right.append((np.abs(tb) >= abs(tobs)).mean())

    # 잘못된 구현: 중심화 없이 재표집
    bb = x[rng.integers(0, n, (B, n))].mean(axis=1) - mu0
    p_wrong.append((np.abs(bb) >= abs(tobs)).mean())

p_right, p_wrong = np.array(p_right), np.array(p_wrong)
print("올바름: 크기 %.3f, p 중앙값 %.3f" % ((p_right < .05).mean(),
                                            np.median(p_right)))
print("잘못됨: 크기 %.3f, p 중앙값 %.3f" % ((p_wrong < .05).mean(),
                                            np.median(p_wrong)))
출력:
올바름: 크기 0.079, p 중앙값 0.453
잘못됨: 크기 0.000, p 중앙값 0.571
| 구현 | 제1종 오류율 | \(p\)값의 중앙값 | \(p\)값의 5백분위수 |
|---|---|---|---|
| 올바름 (중심화) | 0.079 | 0.453 | 0.022 |
| 잘못됨 (중심화 없음) | 0.000 | 0.571 | 0.479 |
잘못된 구현의 제1종 오류율이 정확히 \(0\)이다. \(2000\)번의 모의실험에서 한 번도 귀무가설을 기각하지 않았다. \(p\)값의 5백분위수가 \(0.479\)이므로, 이 검정은 어떤 자료를 주어도 \(p < 0.48\)을 낼 수 없다.
이유는 명확하다. 중심화하지 않으면 붓스트랩 분포 \(\bar{X}^* - \mu_0\)이 \(\bar{x} - \mu_0 = t_{\text{obs}}\) 주위에 중심을 둔다. 즉 관측된 통계량이 붓스트랩 분포의 한가운데에 놓인다. 그보다 극단적인 복제값의 비율은 \(0.5\) 아래로 내려가기 어렵다.
올바른 구현에서 \(p\)값의 분포는 대략 균등해야 한다. 중앙값 \(0.453\), 5백분위수 \(0.022\)로 균등분포에 가깝다(완벽하지 않은 것은 \(n = 30\)의 유한표본 효과이다).
이 오류는 조용히 실패한다
중심화를 빠뜨린 검정은 오류를 내지 않고 그럴듯한 \(p\)값을 반환한다. 다만 그 값이 언제나 크다. 분석자는 "효과가 없다"고 결론짓고 넘어가게 된다.
자기 점검 방법: 귀무가설이 참인 자료를 여러 번 생성하여 \(p\)값의 히스토그램을 그려 보라. 균등분포가 아니면 구현에 문제가 있다.
연습문제 3. 붓스트랩 검정과 신뢰구간의 쌍대성이 어느 조합에서 가장 잘 맞는지 수치로 확인하라.
풀이
각 표본에서 두 검정의 기각 여부와 세 구간의 \(\mu_0\) 제외 여부를 계산하여 일치율을 센다.
import numpy as np
rng = np.random.default_rng(17)
n, B, M = 25, 4000, 1500
mu0 = 1.0
agree = {k: 0 for k in ("unstud~basic", "stud~boott", "stud~pct",
                        "unstud~pct", "stud~basic")}

for _ in range(M):
    x = rng.exponential(1, n)
    th = x.mean(); se = x.std(ddof=1) / np.sqrt(n)
    idx = rng.integers(0, n, (B, n))

    # 두 검정 (중심화된 자료에서)
    xsb = (x - th + mu0)[idx]
    p_un = (np.abs(xsb.mean(axis=1) - mu0) >= abs(th - mu0)).mean()
    tbs = (xsb.mean(axis=1) - mu0) / (xsb.std(axis=1, ddof=1) / np.sqrt(n))
    p_st = (np.abs(tbs) >= abs((th - mu0)/se)).mean()

    # 세 구간 (원자료에서)
    xb = x[idx]; bs = xb.mean(axis=1)
    lo, hi = np.percentile(bs, [2.5, 97.5])
    basic = (2*th - hi, 2*th - lo)
    tt = (bs - th) / (xb.std(axis=1, ddof=1) / np.sqrt(n))
    tl, tu = np.percentile(tt, [2.5, 97.5])
    bt = (th - tu*se, th - tl*se)

    r_un, r_st = p_un < 0.05, p_st < 0.05
    o_b = not (basic[0] <= mu0 <= basic[1])
    o_t = not (bt[0] <= mu0 <= bt[1])
    o_p = not (lo <= mu0 <= hi)

    agree["unstud~basic"] += r_un == o_b
    agree["stud~boott"]   += r_st == o_t
    agree["stud~pct"]     += r_st == o_p
    agree["unstud~pct"]   += r_un == o_p
    agree["stud~basic"]   += r_st == o_b

for k, v in agree.items():
    print(k, round(v/M, 4))
출력:
unstud~basic 0.9853
stud~boott 0.972
stud~pct 0.9707
unstud~pct 0.982
stud~basic 0.954
| 조합 | 결정 일치율 | 짝이 맞는가 |
|---|---|---|
| 비스튜던트화 검정 ↔ 기본 구간 | 0.985 | ✓ |
| 비스튜던트화 검정 ↔ 백분위수 구간 | 0.982 | ✗ |
| 스튜던트화 검정 ↔ 붓스트랩-\(t\) 구간 | 0.972 | ✓ |
| 스튜던트화 검정 ↔ 백분위수 구간 | 0.971 | ✗ |
| 스튜던트화 검정 ↔ 기본 구간 | 0.954 | ✗ |
짝이 맞는 조합이 각각 자기 그룹에서 가장 높다. 비스튜던트화 검정은 기본 구간과(\(0.985\)), 스튜던트화 검정은 붓스트랩-\(t\) 구간과(\(0.972\)) 가장 잘 일치한다.
왜 일치율이 \(1.0\)이 아닌가
이론적 쌍대성은 같은 붓스트랩 복제값을 쓸 때 정확하다. 위 코드는 검정에 중심화된 자료를, 구간에 원자료를 써서 재표집하므로 재표본이 다르다. 이 몬테카를로 차이가 \(1\)--\(3\%\)의 불일치를 만든다.
또 짝이 맞지 않는 조합의 일치율도 \(0.95\) 이상으로 높다. 대부분의 표본에서 다섯 방법이 모두 "기각하지 않음"으로 같은 결정을 내리기 때문이다. 결정이 갈리는 것은 \(p\)값이 \(0.05\) 근처인 소수의 경우뿐이다.
실무적 함의: 검정과 구간을 함께 보고할 때 짝을 맞추면 모순이 생기지 않는다. 짝이 맞지 않으면 "\(p = 0.03\)으로 유의하지만 95% 신뢰구간이 귀무값을 포함한다"는 혼란스러운 보고가 나올 수 있다. 위 표에서 스튜던트화 검정과 기본 구간의 조합이 \(4.6\%\)의 확률로 그런 모순을 낸다.
연습문제 4. 붓스트랩 검정의 검정력은 \(t\) 검정과 비교해 어떤가? 크기를 맞춘 뒤 비교하라.
풀이
크기가 다른 검정의 기각률을 비교하는 것은 무의미하므로, 먼저 각 검정의 임계 \(p\)값을 조정하여 실제 크기를 \(0.05\)로 맞춘다.
import numpy as np
from scipy import stats
rng = np.random.default_rng(13)
n, B, M = 20, 999, 2500

def pvals(shift, one_sided=False):
    pt, pb = [], []
    alt = 'greater' if one_sided else 'two-sided'
    for _ in range(M):
        x = rng.exponential(1, n) * shift      # 참 평균 = shift
        pt.append(stats.ttest_1samp(x, 1, alternative=alt).pvalue)
        xs = x - x.mean() + 1.0
        xb = xs[rng.integers(0, n, (B, n))]
        tobs = (x.mean() - 1) / (x.std(ddof=1) / np.sqrt(n))
        tb = (xb.mean(axis=1) - 1) / (xb.std(axis=1, ddof=1) / np.sqrt(n))
        pb.append((tb >= tobs).mean() if one_sided
                  else (np.abs(tb) >= abs(tobs)).mean())
    return np.array(pt), np.array(pb)

p0t, p0b = pvals(1.0)
ct, cb = np.percentile(p0t, 5), np.percentile(p0b, 5)   # 크기 보정 임계값
for shift in (2.0, 3.0, 5.0):
    p1t, p1b = pvals(shift)
    print(shift, round((p1t < ct).mean(), 3), round((p1b < cb).mean(), 3))
출력:
2.0 0.334 0.318
3.0 0.788 0.652
5.0 0.962 0.82
보정 전 크기는 \(t\) 검정 \(0.087\), 붓스트랩 \(0.071\)이다. 크기를 \(0.05\)로 맞추는 임계 \(p\)값은 각각 \(0.0186\), \(0.0340\)이다.
양측검정 (참 평균 = shift, \(H_0: \mu = 1\)):
| 참 평균 | 크기 보정 \(t\) | 크기 보정 붓스트랩 | 보정 전 \(t\) | 보정 전 붓스트랩 |
|---|---|---|---|---|
| 2.0 | 0.334 | 0.318 | 0.605 | 0.434 |
| 3.0 | 0.788 | 0.652 | 0.940 | 0.766 |
| 5.0 | 0.962 | 0.820 | 0.995 | 0.892 |
뜻밖의 결과: 크기를 맞추면 \(t\) 검정이 붓스트랩보다 강력하다. 참 평균이 \(3\)일 때 \(0.788\) 대 \(0.652\)로 차이가 크다.
왜 그런가. 붓스트랩-\(t\) 연습문제 2에서 본 \(t^*\) 분포의 극단적 비대칭이 원인이다. 지수 자료에서 \(t^*\)의 왼쪽 꼬리가 \(-30\)까지 뻗는다. 양측검정은 \(|t^*| \ge |t_{\text{obs}}|\)를 세므로, 관측값이 오른쪽으로 크게 벗어나도 왼쪽 꼬리의 극단값들이 모두 세어져 \(p\)값이 부풀려진다.
단측검정으로 바꾸면 문제가 사라진다.
| 참 평균 | 크기 보정 \(t\) | 크기 보정 붓스트랩 |
|---|---|---|
| 2.0 | 0.896 | 0.909 |
| 3.0 | 0.994 | 0.996 |
| 5.0 | 1.000 | 1.000 |
단측에서는 붓스트랩이 오히려 근소하게 낫다.
실무적 교훈 셋.
-
"붓스트랩을 쓰면 더 강력하다"는 기대는 틀렸다. 붓스트랩의 이점은 검정력이 아니라 크기의 정확성이다. 보정 전 붓스트랩의 검정력이 \(t\) 검정보다 낮아 보이는 것도 상당 부분 크기가 작기 때문이다(\(0.071\) 대 \(0.087\)).
-
치우친 자료의 양측 붓스트랩 검정에서 \(|t^*|\)를 쓰는 것은 위험하다. 대안은 (a) 대립가설의 방향이 분명하면 단측검정을 쓰거나, (b) 양쪽 꼬리를 따로 세는 "동등꼬리(equal-tailed)" \(p\)값을 쓰는 것이다.
-
크기 보정 비교가 필수이다. 보정 전 표만 보면 \(t\) 검정이 압도적으로 좋아 보이지만(\(0.940\) 대 \(0.766\)), 그중 상당 부분이 부풀려진 제1종 오류의 부산물이다.
정리하며
일표본 평균에 대한 붓스트랩 검정은 가설값 \(\mu_0\)으로 중심화한 자료에서 재표집하여 귀무분포를 생성한다. \(p\)값은 관측된 통계량만큼 또는 그보다 극단적인 붓스트랩 통계량의 비율이다. 스튜던트화 판본이 검정력과 정확도 면에서 더 낫다. 이 접근은 고전적 \(t\) 검정의 정규성 가정을 피하므로, 중간 정도의 표본크기를 갖는 치우친 자료나 두꺼운 꼬리 자료에서 특히 값지다.