17장: 재표집 방법
개요
들어가는 이야기 — 중위소득의 32% 라는 선
나라에서 생활이 어려운 집에 생계비를 보태 주는 제도가 있다. 받을 수 있는지 없는지를 가르는 기준이 「중위소득」의 \(32\%\) 다. 중위소득이란 모든 집을 소득 순서로 줄 세웠을 때 한가운데 집의 소득이다. \(2026\) 년 네 식구 기준으로 월 \(649\) 만 원쯤인데, 이 수는 나라 전체를 다 조사해서 얻은 것이 아니다. \(2\) 만 집쯤을 골라 조사해서 정한다.
그러니 물어야 할 것이 생긴다. 다른 \(2\) 만 집을 골라 조사했다면 그 수가 얼마나 달라졌을까? 기준선이 조금만 움직여도 경계에 걸쳐 있던 집들이 함께 움직인다. 누군가에게는 받느냐 못 받느냐가 갈리는 일이다.
평균이라면 답이 쉽다. 「이만큼 흔들린다」를 적어 주는 공식이 있고 어느 교과서에나 나온다. 그런데 한가운데 값에는 그런 공식이 없다. 구하기는 평균보다 쉬운데 — 줄 세워 가운데를 집으면 그만이다 — 얼마나 흔들리는지를 재는 일은 훨씬 어렵다. 양끝을 조금씩 잘라 내고 낸 평균, 두 수의 비, 자료를 한 번 줄 세운 뒤에 계산하는 거의 모든 것이 같은 처지다.
에프론이 이 막힌 자리를 뚫은 발상은 놀랄 만큼 단순하다. 나라 전체를 다시 조사할 수는 없으니 이미 가지고 있는 \(2\) 만 집에서 다시 뽑아 본다. 그 안에서 아무거나 \(2\) 만 번 집어 새 그룹을 만들고 한가운데 값을 구하는 일을 수천 번 반복하면, 쌓인 값들이 퍼진 폭이 곧 알고 싶던 변동이다. 그의 말이 더 깔끔하다 — 「가지고 있는 표본과 거기서 다시 뽑은 것의 관계는, 세상과 우리 표본의 관계와 같다.」 그렇다면 이 한 줄은 어디까지 통하고 어디서 통하지 않는가. 이 장이 그 여러 모습을 펼친 뒤, 자료가 애초에 담고 있지 않은 것은 다시 뽑아도 생기지 않는다는 대목까지 센다.
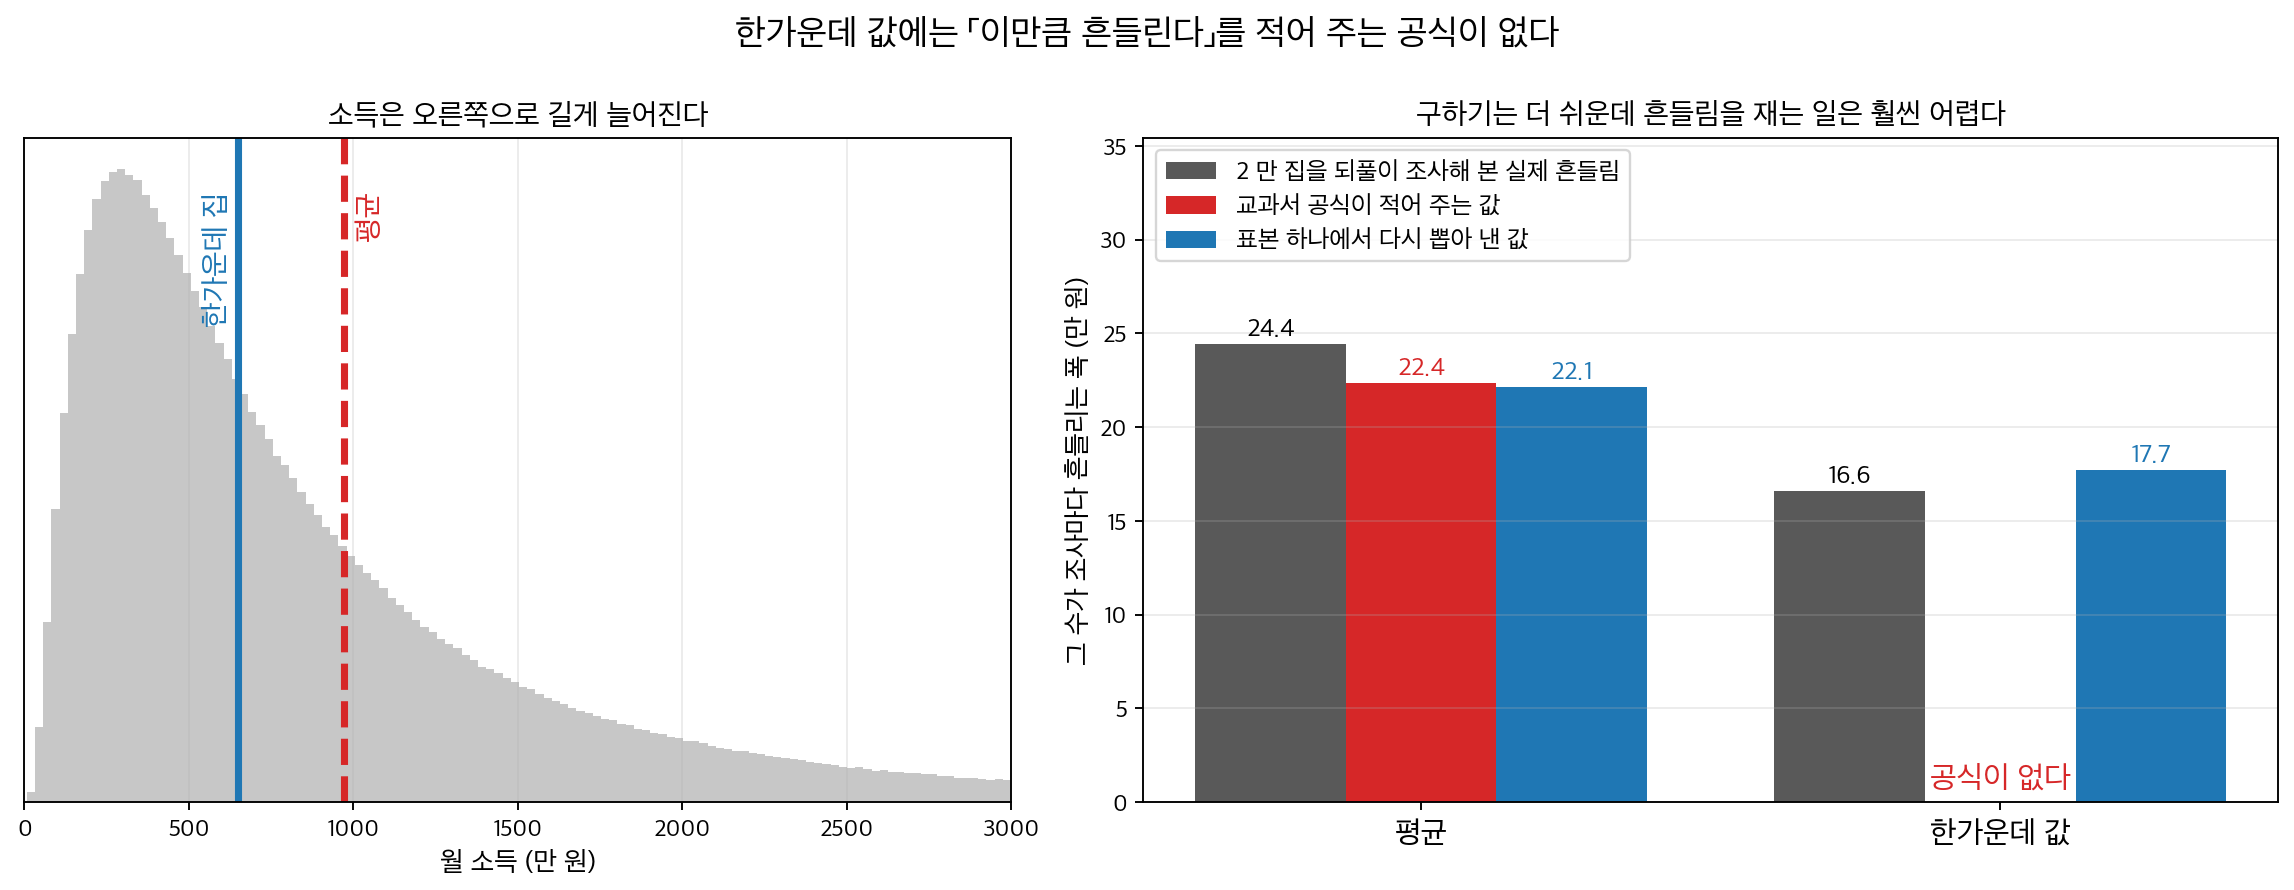
왼쪽. 소득꼴 모집단에서 \(2{,}000\) 가구를 뽑는 일을 \(4{,}000\) 번 반복했다. 오른쪽. 같은 자료에서 「이 수가 조사마다 얼마나 흔들리는가」를 세 가지로 재었다. 평균에서는 반복 조사가 \(24.4\), 교과서 공식이 \(22.4\), 표본 하나에서 다시 뽑은 값이 \(22.1\) 로 셋이 맞는다. 한가운데 값에서는 반복 조사가 \(16.6\), 다시 뽑기가 \(17.7\) 인데 가운데 칸이 비어 있다 — 넣을 공식이 없다. 구하기는 평균보다 쉬운 수인데 변동을 적는 일은 훨씬 어렵다는 것이 이 장이 푸는 문제다.
확인한 곳 — 기준 중위소득과 생계급여 선정기준은 17.2절 중앙값의 부트스트랩 (코드)의 들머리와 그 출처(보건복지부 보도자료) · 에프론의 \(1979\) 년 도입과 「부트스트랩 세계와 관측된 표본의 관계는 현실 세계와 모집단의 관계와 같다」는 17.1절 부트스트랩 원리와 그 출처 줄
재표집 방법은 관측된 자료에서 반복적으로 표본을 뽑아 통계량의 표집분포(sampling distribution)를 경험적으로 구성하는, 계산집약적인 통계적 추론 접근이다. 이론적 분포 가정에 기대는 모수적 방법과도, 값을 순위로 대체하는 순위 기반 비모수(nonparametric) 방법과도 달리, 재표집 방법은 원자료의 값을 직접 다룬다. 이 장에서는 두 가지 주요 재표집 패러다임 --- 추정과 신뢰구간을 위한 부트스트랩(bootstrap), 가설검정을 위한 순열검정(permutation test) --- 을 다루고, 둘 사이의 선택에 대한 실무 지침도 함께 제시한다.
1. 장의 구성
17.1 부트스트랩의 기초
부트스트랩 재표집의 이론적 토대와 핵심 알고리즘이다.
- 부트스트랩 원리 --- 표본의 경험적 분포가 알려지지 않은 모집단 분포의 합리적인 대용물이라는 핵심 통찰을 소개하고, 이것이 분포무관 추론을 가능하게 함을 보인다. 부트스트랩보다 먼저 나온 잭나이프가 왜 매끄러운 통계량에서만 통하는지도 여기서 다룬다.
- 비모수 부트스트랩 --- 관측자료에서 복원추출로 표본을 뽑아 복제 통계량을 계산함으로써 표집분포를 근사하는 표준 부트스트랩 알고리즘을 상세히 다룬다.
- 모수적 부트스트랩 --- 경험적 분포 대신 적합된 모수적 모형에서 부트스트랩 표본을 뽑는 변형으로, 분포형이 가정될 때 유용하다.
- 재표집 방법 --- 표준오차 추정, 63.2% 고유 관측값 성질, 실제 구현 단계를 포함하여 부트스트랩 재표집 알고리즘을 처음부터 끝까지 따라간다.
17.2 부트스트랩 신뢰구간
부트스트랩 분포에서 신뢰구간을 만드는 방법이다.
- 백분위수법 --- 부트스트랩 분포의 분위수(quantile)를 신뢰구간의 양 끝점으로 그대로 쓰는 가장 단순한 접근이다.
- 기본법 (역백분위수법) --- 같은 분위수를 \(\hat\theta\) 에 대해 반사해서 읽는다. 한 줄 차이인데 두 구간이 거울상이 되고, 어느 쪽이 옳은지는 부트스트랩 분포가 아니라 참 표집분포가 어느 쪽으로 치우쳤는지가 정한다.
- BCa (편향보정 가속) --- 부트스트랩 분포의 편향과 왜도(skewness)를 보정하여 비대칭 통계량에 더 나은 포함확률을 주는 개선된 방법이다.
- 부트스트랩-t 방법 --- 각 부트스트랩 표본 안에서 표준오차를 추정하여 부트스트랩 분포를 스튜던트화함으로써 더 높은 차수의 정확도를 갖는 구간을 얻는다.
- 신뢰수준의 시각화 --- 서로 다른 신뢰수준(confidence level, 예: 90% 대 95%)의 부트스트랩 신뢰구간을 시각적으로 해석하고 비교하여 포함확률의 의미를 분명히 한다.
- 부트스트랩 신뢰구간 방법의 비교 --- 백분위수법, BCa, 부트스트랩-t를 포함확률의 정확도, 계산비용, 적용범위 면에서 나란히 평가한다.
- 중앙값의 부트스트랩 (코드) --- 닫힌 꼴 공식이 없는 통계량에 이 절의 방법을 그대로 걸어 본다. 중앙값의 부트스트랩 분포가 계단이라는 것, 그리고 그 계단이 구간의 끝점을 어떻게 정하는지를 본다.
17.3 부트스트랩 가설검정
부트스트랩 재표집으로 가설검정을 수행한다.
- 일표본 평균에 대한 부트스트랩 검정 --- 귀무가설(null hypothesis) 아래에서 부트스트랩 분포를 중심화하여 모평균이 가설값과 같은지 검정한다.
- 두 평균에 대한 부트스트랩 검정 --- 차이가 없다는 귀무가설 아래에서 부트스트랩하여 두 모집단의 평균이 같은지 검정한다.
- 상관에 대한 부트스트랩 검정 --- 귀무가설 아래에서 대응 관측값을 재표집하여 모상관계수가 0인지 검정한다.
17.4 순열검정
자료 라벨의 무작위 재배열에 기반한 정확검정과 근사검정이다.
- 순열검정의 기초 --- 순열검정의 논리를 소개한다. 귀무가설 아래에서 집단 라벨은 교환 가능하므로, 이를 섞으면 임의의 검정통계량(test statistic)의 귀무분포가 생성된다. 정확 열거와 무작위 순열의 구별, 그리고 설계 단계에서 먼저 따져야 할 최소 \(p\) 값도 여기서 다룬다.
- 이표본 위치에 대한 순열검정 --- 집단 라벨을 반복해서 섞고 차이 통계량을 계산하여 독립인 두 집단의 위치(보통 평균)가 다른지 검정하며, A/B 검정에 응용한다.
- 상관에 대한 순열검정 --- 한 변수를 고정한 채 다른 변수를 순열하여 참인 연관성을 끊음으로써 상관계수의 유의성을 검정한다.
- 대응자료에 대한 순열검정 --- 처치효과가 없다는 귀무가설 아래에서 대응차이의 부호를 무작위로 뒤집어 순열 논리를 대응설계에 적용한다.
- 순열검정의 구현 (이표본·다집단·비율) --- 앞의 논리를 코드로 내린다. 평균차, 일원분산분석에 대응하는 다집단, 그리고 비율 셋을 한자리에서 짜고, 가장 작은 자료에서 \(n!\) 를 끝까지 열거해 모수적 검정과 어디까지 일치하는지 본다.
- A/B 검정 순열검정 (코드) --- 체류시간·전환율·여러 헤드라인의 클릭률 세 시나리오에 순열검정과 모수적 대안을 나란히 돌린다. 검정력 분석까지 붙인다.
- 재표집 (신발 판매 A/B 검정) (코드) --- 한 사례에 순열검정·효과크기(effect size)·부트스트랩 구간 셋을 함께 걸어 유의성과 실질적 중요성을 갈라 읽는다.
17.5 비교와 실무 지침
재표집 접근들 사이에서 언제 무엇을 어떻게 고를 것인가.
- 부트스트랩 대 순열검정 --- 목적(추정 대 검정), 재표집 방식(복원 대 비복원), 가정(대표성 대 교환가능성), 전형적 출력의 네 측면에서 두 방법을 대비한다.
- 재표집 횟수와 수렴 --- 부트스트랩 복제나 순열의 횟수를 고르는 지침(보통 \(1{,}000\)~\(10{,}000\) 회)과 결과가 안정되었는지 평가하는 방법을 제시한다.
- 재표집이 실패할 때 --- 작은 표본, 극단 분위수, 종속자료, 대표성 없는 표본 등 재표집의 한계와 실패 양상을 논한다.
2. 선수 지식
이 장은 다음 내용 위에 세워진다.
- 8장 (신뢰구간) --- 모수적 신뢰구간 구성, 포함확률, 해석.
- 9장 (가설검정) --- 귀무가설과 대립가설(alternative hypothesis), p 값, 제1종·제2종 오류(type II error), 검정통계량의 논리.
- 5장·6장 --- 추정량의 성질(편향·분산·일치성, 5.11~5.12)과 최대가능도추정(6.1).
- 16장 (비모수 검정) --- 비모수 추론의 또 다른 접근인 순위 기반 분포무관 방법.
3. 핵심 요약
- 부트스트랩은 관측자료에서 복원추출로 재표집하여 임의의 통계량의 표집분포를 근사하므로, 닫힌 형태의 유도 없이 표준오차와 신뢰구간을 얻을 수 있다.
- BCa 부트스트랩 신뢰구간은 편향과 왜도를 보정하여 단순 백분위수법보다 대체로 나은 포함확률을 주며, 중앙값처럼 치우친 통계량에서 특히 그렇다.
- 순열검정은 교환가능성이라는 귀무가설 아래에서 집단 라벨을 무작위로 재배열하여 귀무분포를 생성함으로써 정확 p 값을 제공한다.
- 부트스트랩은 주로 추정(신뢰구간, 표준오차)을 위한 것이고 순열검정은 주로 가설검정(p 값)을 위한 것이지만, 둘의 역할은 겹치는 부분이 있다.
- 재표집 방법은 표본이 모집단을 대표하기에 너무 작을 때, 극단 분위수를 추정할 때, 관측값이 종속일 때 실패할 수 있으며, 결과가 수렴하려면 재표집 횟수가 충분히 커야 한다.