상관 타원 그림
개요
타원 그림은 상관행렬을 시각화할 때 색으로 부호화하는 열지도의 대안이 된다. 행렬의 각 칸을 타원으로 나타내고 그 모양, 방향, 크기가 상관의 부호와 크기를 부호화한다. 회색조 출판물에 특히 유용하고 색각 이상이 있는 독자도 읽을 수 있다.
타원 부호화
타원의 기하와 상관의 대응은 다음과 같다:
| 상관 | 타원 모양 | 회전 |
|---|---|---|
| \(r = +1\) | 가는 선(퇴화한 타원) | \(+45°\) |
| \(0 < r < 1\) | 좁은 타원 | \(+45°\) |
| \(r = 0\) | 원 | \(0°\) |
| \(-1 < r < 0\) | 좁은 타원 | \(-45°\) |
| \(r = -1\) | 가는 선(퇴화한 타원) | \(-45°\) |
핵심 착상은 타원의 이심률이 \(|r|\)을, 방향이 \(r\)의 부호를 부호화한다는 것이다. 완전한 원은 상관이 0임을 뜻하고, \(|r| \to 1\)이면 타원이 선으로 붕괴한다.
타원의 구성
상관값 \(r_{ij}\)에 대한 타원의 모수는 다음과 같다:
- 너비: \(w = 1 + \delta\) (거의 일정)
- 높이: \(h = 1 - |r_{ij}| - \delta\) (\(|r_{ij}|\)가 커질수록 줄어든다)
- 각도: \(\theta = 45° \cdot \text{sign}(r_{ij})\)
여기서 \(\delta\)는 수치 안정성을 위한 작은 상수이다. 너비와 높이의 비가 이심률을 정하고, 회전각이 양의 상관과 음의 상관을 구별한다.
보기 1. 타원으로 상관행렬 그리기. 코드는 칸마다 너비 \(w = 1.01\), 높이 \(h = 0.99 - \lvert r\rvert\), 각도 \(45^\circ\cdot\operatorname{sign}(r)\) 인 타원을 놓는다.
(1) 이 부호화에서 타원의 가로세로비를 \(\lvert r\rvert\) 의 함수로 적으시오.
(2) 한편 분산이 같은 이변량 정규분포의 등밀도 타원은 축비가 \(\sqrt{(1+\lvert r\rvert)/(1-\lvert r\rvert)}\) 다(12.1절 보기 1). 두 부호화를 \(\lvert r\rvert = 0,\ 0.3,\ 0.5,\ 0.8,\ 0.97\) 에서 견주시오. 작은 상관을 눈에 보이게 하는 데 어느 쪽이 나은가.
(3) 대각선 칸(\(r = 1\))에서 \(h\) 는 얼마인가. 문제가 없는가.
(4) 함수를 짜시오.
풀이
(1) 가로세로비. 너비가 \(1.01\) 로 고정이고 높이가 \(0.99 - \lvert r\rvert\) 이므로
다. \(\lvert r\rvert = 0\) 이면 \(1.01/0.99 = 1.02\) 로 거의 원이고, \(\lvert r\rvert \to 0.99\) 면 분모가 \(0\) 으로 가서 발산한다.
(2) 두 부호화는 다른 곡선이다. 수를 넣어 본다.
| \(\lvert r\rvert\) | 코드의 비 \(\dfrac{1.01}{0.99-\lvert r\rvert}\) | 참 타원 \(\sqrt{\dfrac{1+\lvert r\rvert}{1-\lvert r\rvert}}\) |
|---|---|---|
| \(0\) | \(1.020\) | \(1.000\) |
| \(0.3\) | \(1.464\) | \(1.363\) |
| \(0.5\) | \(2.061\) | \(1.732\) |
| \(0.8\) | \(5.316\) | \(3.000\) |
| \(0.97\) | \(50.5\) | \(8.10\) |
큰 \(\lvert r\rvert\) 에서 코드 쪽이 훨씬 가파르다. \(\lvert r\rvert = 0.8\) 에서 이미 \(5.3\) 대 \(3.0\) 이고, \(0.97\) 에서는 \(50\) 대 \(8\) 로 여섯 배 차이다. 코드의 분모가 \(0.99-\lvert r\rvert\) 로 일차로 사라지는 반면 참 타원의 비는 \(\sqrt{2/(1-\lvert r\rvert)}\) 꼴로 제곱근으로 느리게 자라기 때문이다.
그러나 작은 상관을 보이는 데에는 어느 쪽도 쓸모가 없다. \(\lvert r\rvert = 0.3\) 에서 코드는 \(1.46\), 참 타원은 \(1.36\) 이다. 가로세로비 \(1.4\) 짜리 타원은 눈으로 원과 거의 구별되지 않는다. 단축이 장축의 \(70\%\) 쯤이기 때문이다.
이것이 타원 그림의 가장 큰 한계다. \(\lvert r\rvert \le 0.3\) 구간이 전부 "동그란 것" 으로 뭉개진다. 그런데 실제 분석에서 흥미로운 상관은 흔히 바로 그 구간에 있다. 다행히 이 코드는 색도 함께 쓰므로(\(\texttt{array=M.ravel()}\)), 모양으로 안 보이는 것을 색이 보완한다. 모양만으로 읽어야 하는 흑백 인쇄에서는 약한 상관이 사라진다는 점을 알고 써야 한다.
(3) 대각선에서 높이가 음수가 된다. \(r = 1\) 이면
로 음수다. 타원의 방정식에는 높이가 제곱으로 들어가므로 matplotlib 은 \(\lvert h\rvert = 0.01\) 인 타원을 그리고, 결과적으로 가로세로비 \(101\) 짜리 선분이 나온다. 보기에는 멀쩡하지만 의도한 것이 아니라 우연히 맞은 것이다.
\(\lvert r\rvert > 0.99\) 인 칸은 모두 같은 처지다. \(\lvert r\rvert = 0.995\) 와 \(\lvert r\rvert = 0.985\) 의 높이가 똑같이 \(0.005\) 가 되어 구별되지 않는다. 안전하게 쓰려면 h = np.maximum(1 - np.abs(M).ravel(), 0.01) 처럼 아래에서 잘라 주는 편이 낫다.
(4) 함수.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.collections import EllipseCollection
from matplotlib.colors import Normalize


def plot_corr_ellipses(data, figsize=None, **kwargs):
    """상관행렬을 타원 격자로 그린다.

    칸마다 타원 하나를 놓는다. 타원이 납작할수록 상관이 강하고, 원에
    가까울수록 약하다. 기울기의 방향이 부호를 나타낸다. 색과 모양이
    같은 정보를 두 번 실어 주므로 흑백으로 인쇄해도 읽힌다.
    """
    M = np.array(data)
    fig, ax = plt.subplots(1, 1, figsize=figsize,
                           subplot_kw={'aspect': 'equal'})
    ax.set_xlim(-0.5, M.shape[1] - 0.5)
    ax.set_ylim(-0.5, M.shape[0] - 0.5)
    ax.invert_yaxis()

    # 칸의 중심 좌표. [::-1] 로 (행, 열)을 (x, y) 순서로 뒤집는다.
    xy = np.indices(M.shape)[::-1].reshape(2, -1).T

    # 너비는 고정하고 높이만 |r| 에 따라 줄인다. r=1 이면 선분처럼 납작해지고
    # r=0 이면 원이 된다. 기울기는 부호를 따라 ±45도로 놓는다.

    w = np.ones_like(M).ravel() + 0.01
    h = 1 - np.abs(M).ravel() - 0.01
    a = 45 * np.sign(M).ravel()

    ec = EllipseCollection(
        widths=w, heights=h, angles=a,
        units='x', offsets=xy,
        norm=Normalize(vmin=-1, vmax=1),
        offset_transform=ax.transData,
        array=M.ravel(),
        **kwargs
    )
    ax.add_collection(ec)

    if isinstance(data, pd.DataFrame):
        ax.set_xticks(np.arange(M.shape[1]))
        ax.set_xticklabels(data.columns, rotation=90)
        ax.set_yticks(np.arange(M.shape[0]))
        ax.set_yticklabels(data.index)

    return ec, ax
(2)의 두 곡선을 수로 확인한다.
import numpy as np

print("  |r|     코드의 비    참 타원     h = 0.99-|r|")
for r in (0.0, 0.3, 0.5, 0.8, 0.97, 1.0):
    h = 0.99 - r
    enc = 1.01 / abs(h)
    tru = np.sqrt((1 + r) / (1 - r)) if r < 1 else np.inf
    print(f"{r:5.2f}   {enc:10.3f}  {tru:9.3f}      {h:+.3f}")
출력:
  |r|     코드의 비    참 타원     h = 0.99-|r|
 0.00        1.020      1.000      +0.990
 0.30        1.464      1.363      +0.690
 0.50        2.061      1.732      +0.490
 0.80        5.316      3.000      +0.190
 0.97       50.500      8.103      +0.020
 1.00      101.000        inf      -0.010
(2)의 표가 그대로 나온다. \(\lvert r\rvert = 0.3\) 에서 두 비가 \(1.464\) 와 \(1.363\) 으로 둘 다 \(1.5\) 에 못 미친다. 단축이 장축의 \(68\%\) 와 \(73\%\) 이니 눈으로는 원과 다름없다.
마지막 줄이 (3)이다. \(h = -0.010\) 으로 음수다. 그래도 그림이 그려지는 것은 타원 방정식이 높이를 제곱으로 쓰기 때문이고, 설계가 옳아서가 아니다.
모의 자료 보기
상관된 변수 다섯 개를 만들어 타원 그림으로 상관 구조를 시각화한다:
보기 2. 업종 수익률 자료로 그려 보기. 독립인 \(z_1, z_2, e \sim N(0,1)\) 과 독립인 \(x_5 \sim N(0,1)\) 로 다섯 변수를 만든다.
(1) 열 쌍의 모상관을 닫힌 꼴로 구하시오.
(2) \(n = 200\) 표본의 상관과 견주시오. 표준오차 \((1-\rho^2)/\sqrt n\) 에 비추어 어긋남이 우연의 범위인지 판정하시오.
(3) 그림 아래 본문은 Tech–Finance 를 \(r \approx 0.8\), Tech–Utilities 를 \(r \approx -0.6\) 이라 읽었다. 맞는가.
(4) 코드로 확인하시오.
풀이
(1) 모상관. 세 잡음이 독립이고 분산이 모두 1 이므로 분산과 공분산이 계수의 내적으로 바로 나온다.
공분산은 \(z_1\) 계수끼리, \(z_2\) 계수끼리 곱해 더하면 된다(\(e\) 는 \(x_3\) 에만 있다).
\(x_5\) 는 다른 넷과 독립이므로 \(\rho_{15} = \rho_{25} = \rho_{35} = \rho_{45} = 0\) 이다. 모상관행렬은
다.
(2) 표본과 이론. \(n = 200\) 이므로 \(\operatorname{SE}(r) \approx (1-\rho^2)/\sqrt{200}\) 이다.
| 쌍 | 표본 \(r\) | 이론 \(\rho\) | 차 | SE | 차/SE |
|---|---|---|---|---|---|
| Tech–Finance | \(+0.9684\) | \(+0.9701\) | \(-0.0017\) | \(0.0042\) | \(-0.41\) |
| Tech–Utilities | \(-0.6870\) | \(-0.6508\) | \(-0.0363\) | \(0.0408\) | \(-0.89\) |
| Tech–Energy | \(+0.4484\) | \(+0.3939\) | \(+0.0545\) | \(0.0597\) | \(+0.91\) |
| Tech–Commodity | \(+0.0654\) | \(0\) | \(+0.0654\) | \(0.0707\) | \(+0.92\) |
| Finance–Utilities | \(-0.6690\) | \(-0.6314\) | \(-0.0376\) | \(0.0425\) | \(-0.89\) |
| Finance–Energy | \(+0.6570\) | \(+0.6051\) | \(+0.0519\) | \(0.0448\) | \(+1.16\) |
| Finance–Commodity | \(+0.0364\) | \(0\) | \(+0.0364\) | \(0.0707\) | \(+0.51\) |
| Utilities–Energy | \(-0.3212\) | \(-0.2564\) | \(-0.0648\) | \(0.0661\) | \(-0.98\) |
| Utilities–Commodity | \(+0.0392\) | \(0\) | \(+0.0392\) | \(0.0707\) | \(+0.55\) |
| Energy–Commodity | \(-0.0673\) | \(0\) | \(-0.0673\) | \(0.0707\) | \(-0.95\) |
열 쌍 모두 \(1.2\) 표준오차 안쪽이다. 모의가 의도대로 되었다.
눈여겨볼 것은 표준오차가 \(\rho\) 에 따라 크게 다르다는 점이다. Tech–Finance 는 \(\rho\) 가 \(1\) 에 가까워 SE 가 \(0.0042\) 에 지나지 않는 반면, Commodity 가 끼는 네 쌍은 \(\rho = 0\) 이라 SE 가 \(0.0707\) 로 열일곱 배다. 그래서 Commodity 열의 표본 상관이 \(\pm0.07\) 쯤 흔들리는 것은 당연한 일이고, 그림에서 그 칸들이 완전한 원이 아닌 것도 그 때문이다.
(3) 본문의 두 수는 틀렸다. 계수와 상관을 혼동한 것이다.
| 본문 | 이론 \(\rho\) | 표본 \(r\) | |
|---|---|---|---|
| Tech–Finance | \(\approx 0.8\) | \(0.9701\) | \(0.9684\) |
| Tech–Utilities | \(\approx -0.6\) | \(-0.6508\) | \(-0.6870\) |
\(0.8\) 과 \(-0.6\) 은 자료를 만들 때 \(z_1\) 에 곱한 계수이지 상관이 아니다. 상관은 분모에 \(\sqrt{\operatorname{Var}}\) 가 들어가는데, \(x_2\) 의 분산이 \(0.68 < 1\) 이라 나누면 값이 커진다.
Tech–Utilities 도 \(-0.6/\sqrt{0.85} = -0.6508\) 로 \(-0.6\) 보다 조금 세다. 공교롭게 이쪽은 차이가 작아 "\(\approx -0.6\)" 이 대충 맞아 보이지만, Tech–Finance 는 \(0.8\) 과 \(0.97\) 로 전혀 다르다.
그림이 본문보다 정직하다. 그림의 Tech–Finance 칸은 대각선의 \(r = 1\) 칸과 거의 구별되지 않는 가는 선이다. 보기 1 (2)의 표에 따르면 \(\lvert r\rvert = 0.8\) 이면 가로세로비가 \(5.3\) 이라 아직 눈에 띄는 타원이어야 하는데, 실제 그림은 \(1.01/(0.99-0.9684) = 46.9\) 짜리 선분이다. 눈으로만 봐도 \(0.8\) 이 아니다.
(4) 수치적으로.
np.random.seed(42)
n = 200

# 업종별 수익률을 흉내 낸 자료다. 공통 요인 z1 을 섞는 비율로 상관을 만든다.
z1 = np.random.randn(n)
z2 = np.random.randn(n)

x1 = z1
x2 = 0.8 * z1 + 0.2 * z2
x3 = -0.6 * z1 + np.random.randn(n) * 0.7
x4 = 0.3 * z1 + 0.7 * z2
x5 = np.random.randn(n)

df = pd.DataFrame(
    np.column_stack([x1, x2, x3, x4, x5]),
    columns=['Tech', 'Finance', 'Utilities', 'Energy', 'Commodity']
)

corr_matrix = df.corr()

ec, ax = plot_corr_ellipses(corr_matrix, figsize=(6, 5), cmap='bwr_r')
plt.colorbar(ec, ax=ax, label='Correlation Coefficient')
ax.set_title('Correlation Matrix: Ellipse Visualization')
plt.tight_layout()
plt.show()
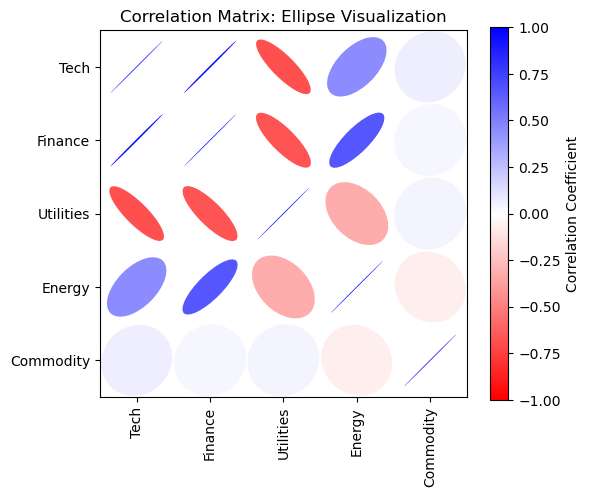
대각선 위아래가 거울상이고, Tech–Finance 칸이 대각선 칸과 거의 같은 가는 선이다. Utilities 행·열은 \(-45^\circ\) 로 기운 빨간 타원, Commodity 행·열은 거의 완전한 원이다.
이제 (1)\~(3)의 수를 확인한다.
import numpy as np
import pandas as pd

names = ['Tech', 'Finance', 'Utilities', 'Energy', 'Commodity']

# (1) 계수행렬로부터 모상관을 닫힌 꼴로.  행 = 변수, 열 = (z1, z2, e, x5)
A = np.array([[ 1.0, 0.0, 0.0, 0.0],
              [ 0.8, 0.2, 0.0, 0.0],
              [-0.6, 0.0, 0.7, 0.0],
              [ 0.3, 0.7, 0.0, 0.0],
              [ 0.0, 0.0, 0.0, 1.0]])
S = A @ A.T
d = np.sqrt(np.diag(S))
R = S / np.outer(d, d)
print("분산", np.round(np.diag(S), 4))
print("모상관\n", pd.DataFrame(np.round(R, 4), index=names, columns=names))

# (2) 표본과 견주기
np.random.seed(42)
n = 200
z1, z2 = np.random.randn(n), np.random.randn(n)
cols = [z1, 0.8 * z1 + 0.2 * z2, -0.6 * z1 + np.random.randn(n) * 0.7,
        0.3 * z1 + 0.7 * z2, np.random.randn(n)]
C = pd.DataFrame(np.column_stack(cols), columns=names).corr().values

print("\n쌍                     표본      이론       차      SE   차/SE")
for i in range(5):
    for j in range(i + 1, 5):
        s, th = C[i, j], R[i, j]
        se = (1 - th**2) / np.sqrt(n)
        print(f"{names[i]:9s}-{names[j]:9s} {s:+.4f}  {th:+.4f}  {s - th:+.4f}"
              f"  {se:.4f}  {(s - th) / se:+.2f}")

# (3) 본문의 두 수와 견주기
print(f"\nTech-Finance   본문 0.8   이론 {R[0, 1]:.4f}   표본 {C[0, 1]:.4f}")
print(f"Tech-Utilities 본문 -0.6  이론 {R[0, 2]:.4f}   표본 {C[0, 2]:.4f}")
print(f"0.8 / sqrt(0.68) = {0.8 / np.sqrt(0.68):.4f}")
print(f"그림의 Tech-Finance 가로세로비 {1.01 / (0.99 - C[0, 1]):.1f}"
      f"   (|r|=0.8 이라면 {1.01 / (0.99 - 0.8):.1f})")
출력:
분산 [1.   0.68 0.85 0.58 1.  ]
모상관
              Tech  Finance  Utilities  Energy  Commodity
Tech       1.0000   0.9701    -0.6508  0.3939        0.0
Finance    0.9701   1.0000    -0.6314  0.6051        0.0
Utilities -0.6508  -0.6314     1.0000 -0.2564        0.0
Energy     0.3939   0.6051    -0.2564  1.0000        0.0
Commodity  0.0000   0.0000     0.0000  0.0000        1.0

쌍                     표본      이론       차      SE   차/SE
Tech     -Finance   +0.9684  +0.9701  -0.0017  0.0042  -0.41
Tech     -Utilities -0.6870  -0.6508  -0.0363  0.0408  -0.89
Tech     -Energy    +0.4484  +0.3939  +0.0545  0.0597  +0.91
Tech     -Commodity +0.0654  +0.0000  +0.0654  0.0707  +0.92
Finance  -Utilities -0.6690  -0.6314  -0.0376  0.0425  -0.89
Finance  -Energy    +0.6570  +0.6051  +0.0519  0.0448  +1.16
Finance  -Commodity +0.0364  +0.0000  +0.0364  0.0707  +0.51
Utilities-Energy    -0.3212  -0.2564  -0.0648  0.0661  -0.98
Utilities-Commodity +0.0392  +0.0000  +0.0392  0.0707  +0.55
Energy   -Commodity -0.0673  +0.0000  -0.0673  0.0707  -0.95

Tech-Finance   본문 0.8   이론 0.9701   표본 0.9684
Tech-Utilities 본문 -0.6  이론 -0.6508   표본 -0.6870
0.8 / sqrt(0.68) = 0.9701
그림의 Tech-Finance 가로세로비 46.9   (|r|=0.8 이라면 5.3)
분산 [1. 0.68 0.85 0.58 1.] 과 모상관행렬이 (1)의 손계산과 넷째 자리까지 같다.
(2)의 열 쌍 모두 \(\lvert\)차/SE\(\rvert \le 1.16\) 이다. SE 열을 보면 \(0.0042\) 에서 \(0.0707\) 까지 열일곱 배 벌어진다. 같은 \(n = 200\) 인데도 그렇다.
(3)이 요점이다. 0.8 / sqrt(0.68) = 0.9701 한 줄이 본문의 오류를 설명한다. \(0.8\) 은 계수이고 상관은 \(0.97\) 이다. 마지막 줄은 그림으로도 확인된다. 그려진 타원의 가로세로비가 \(46.9\) 인데 \(\lvert r\rvert = 0.8\) 이었다면 \(5.3\) 이었을 것이다.
타원 그림 읽기
출력을 살펴보면 다음을 알 수 있다:
- Tech–Finance: \(+45°\)로 기울어진 좁은 타원. 아주 강한 양의 상관(\(\rho = 0.8/\sqrt{0.68} = 0.9701\))을 나타낸다. \(0.8\)은 자료를 만들 때 쓴 계수이지 상관이 아니다(보기 2).
- Tech–Utilities: \(-45°\)로 기울어진 좁은 타원. 중간 정도의 음의 상관(\(\rho = -0.6/\sqrt{0.85} = -0.6508\))을 나타낸다.
- Commodity 행/열: 거의 원에 가까운 타원. 다른 모든 변수와 상관이 0에 가깝다.
- 대각선: \(r = 1\)에 해당하는 퇴화한 타원(\(+45°\)의 선).
해석
타원 그림은 표준 열지도에 비해 몇 가지 장점이 있다:
- 회색조 호환성. 색이 없어도 타원의 모양과 방향이 상관에 대한 정보를 온전히 전달한다.
- 접근성. 색각 이상이 있는 독자도 정보 손실 없이 그림을 해석할 수 있다.
- 이중 부호화. 크기(\(|r|\)을 이심률로)와 부호(\(\text{sign}(r)\)을 회전으로)를 동시에 부호화한다.
주된 단점은 값이 표시된 열지도에 비해 정확한 수치를 읽기 어렵다는 점이다. 출판물에서는 타원 그림과 상관 수치표를 함께 제시하는 경우가 많다.
연습문제
연습문제 1. \(r_{12} = 0.9\), \(r_{13} = -0.7\), \(r_{14} = 0\), \(r_{23} = -0.5\), \(r_{24} = 0.3\), \(r_{34} = -0.2\)인 \(4 \times 4\) 상관행렬을 손으로 만들어라. 타원 함수로 그리고 타원 모양이 예상과 맞는지 눈으로 확인하라.
풀이
import numpy as np
import pandas as pd

corr = np.array([
    [1.0,  0.9, -0.7,  0.0],
    [0.9,  1.0, -0.5,  0.3],
    [-0.7, -0.5,  1.0, -0.2],
    [0.0,  0.3, -0.2,  1.0]
])
df_corr = pd.DataFrame(corr, columns=['A', 'B', 'C', 'D'],
                       index=['A', 'B', 'C', 'D'])

ec, ax = plot_corr_ellipses(df_corr, figsize=(5, 5), cmap='bwr_r')
ax.set_title('Hand-crafted Correlation Matrix')
import matplotlib.pyplot as plt
plt.colorbar(ec, ax=ax)
plt.tight_layout()
plt.show()
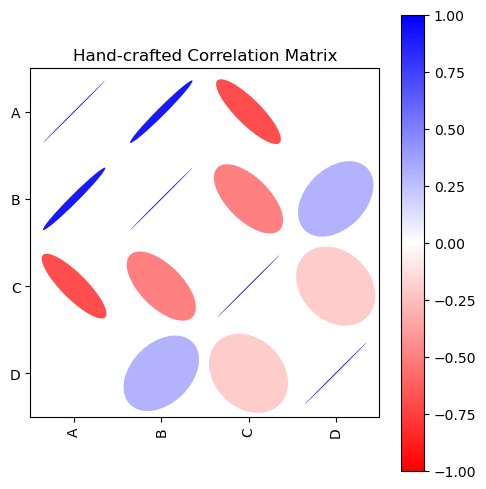
타원 안에 들어가는 점의 비율이 지정한 신뢰수준에 대응한다.
\((A, B)\)의 타원은 \(+45°\)로 매우 좁아야 한다(강한 양). \((A, C)\)의 타원은 \(-45°\)로 어느 정도 좁아야 한다(강한 음). \((A, D)\)의 타원은 거의 원이어야 한다(상관 0). \(\square\)
연습문제 2. 행렬 \(\begin{pmatrix} 1 & 0.9 \\ 0.9 & 1 \end{pmatrix}\)은 타당한 상관행렬이지만 \(\begin{pmatrix} 1 & 1.2 \\ 1.2 & 1 \end{pmatrix}\)은 그렇지 않은 이유를 설명하라. 어떤 행렬이 타당한 상관행렬이 되기 위한 필요충분조건을 진술하라.
풀이
행렬 \(\mathbf{R}\)이 타당한 상관행렬일 필요충분조건은:
- 대칭이다: \(R_{ij} = R_{ji}\).
- 모든 대각 성분이 1이다: \(R_{ii} = 1\).
- 모든 비대각 성분이 \(|R_{ij}| \le 1\)을 만족한다.
- 양반정치이다: 모든 \(\mathbf{v}\)에 대해 \(\mathbf{v}^\top \mathbf{R}\, \mathbf{v} \ge 0\).
첫 번째 행렬은 고윳값이 \(1 + 0.9 = 1.9\)와 \(1 - 0.9 = 0.1\)로 모두 음이 아니므로 타당하다.
두 번째 행렬은 성분 \(1.2\)가 \(|1.2| > 1\)이어서 조건 3을 위반한다. 게다가 행렬식이 \(1 \cdot 1 - 1.2 \cdot 1.2 = -0.44 < 0\)이므로 음의 고윳값을 가져 조건 4도 만족하지 못한다. 상관계수는 Cauchy-Schwarz 부등식에 의해 \([-1, 1]\)에 갇히므로 \(r = 1.2\)는 불가능하다. \(\square\)
연습문제 3.
각 타원 안에 상관 수치를 표시하도록 plot_corr_ellipses 함수를 고쳐라. \(5 \times 5\) 행렬에서 시험하라.
풀이
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.collections import EllipseCollection
from matplotlib.colors import Normalize

def plot_corr_ellipses_annotated(data, figsize=None, **kwargs):
    M = np.array(data)
    fig, ax = plt.subplots(1, 1, figsize=figsize,
                           subplot_kw={'aspect': 'equal'})
    ax.set_xlim(-0.5, M.shape[1] - 0.5)
    ax.set_ylim(-0.5, M.shape[0] - 0.5)
    ax.invert_yaxis()

    xy = np.indices(M.shape)[::-1].reshape(2, -1).T
    w = np.ones_like(M).ravel() + 0.01
    h = 1 - np.abs(M).ravel() - 0.01
    a = 45 * np.sign(M).ravel()

    ec = EllipseCollection(
        widths=w, heights=h, angles=a,
        units='x', offsets=xy,
        norm=Normalize(vmin=-1, vmax=1),
        offset_transform=ax.transData,
        array=M.ravel(), **kwargs
    )
    ax.add_collection(ec)

    # 칸마다 숫자를 적는다
    for i in range(M.shape[0]):
        for j in range(M.shape[1]):
            ax.text(j, i, f'{M[i, j]:.2f}',
                    ha='center', va='center', fontsize=8)

    if isinstance(data, pd.DataFrame):
        ax.set_xticks(np.arange(M.shape[1]))
        ax.set_xticklabels(data.columns, rotation=90)
        ax.set_yticks(np.arange(M.shape[0]))
        ax.set_yticklabels(data.index)

    return ec, ax

# 확인
np.random.seed(42)
data = np.random.randn(200, 5)
df = pd.DataFrame(data, columns=[f'V{i}' for i in range(1, 6)])
ec, ax = plot_corr_ellipses_annotated(df.corr(), figsize=(6, 6),
                                      cmap='bwr_r')
plt.colorbar(ec, ax=ax)
plt.tight_layout()
plt.show()
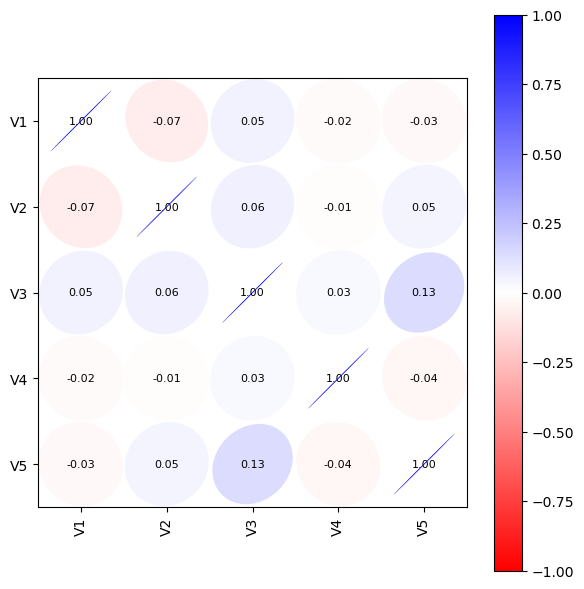
\(r\)이 0이면 타원이 축에 정렬된 원에 가깝고, \(|r|\)이 커질수록 대각선 방향으로 길쭉해진다. 타원의 주축 방향과 길이가 곧 공분산행렬의 고유벡터와 고유값이다.
주석 루프가 모든 \((i, j)\) 성분을 돌며 ax.text로 각 타원의 중심에 수치를 놓는다. 타원 시각화의 장점(모양 부호화)과 정확한 수치 가독성을 함께 얻는다. \(\square\)
연습문제 4. \(2 \times 2\) 상관행렬 \(\mathbf{R} = \begin{pmatrix} 1 & r \\ r & 1 \end{pmatrix}\)에 대해 \(r\)로 표현한 고윳값과 고유벡터를 유도하라. 이변량 정규분포 집중타원의 주축이 \(\mathbf{R}\)의 고유벡터와 일치함을 보여라.
풀이
특성방정식은
이다. 풀면 \(\lambda_1 = 1 + r\), \(\lambda_2 = 1 - r\)이다.
\(\lambda_1 = 1 + r\)에 대해 \((\mathbf{R} - \lambda_1 \mathbf{I})\mathbf{v} = 0\)은 \(-r v_1 + r v_2 = 0\)을 주므로 \(\mathbf{v}_1 = \frac{1}{\sqrt{2}}(1, 1)^\top\)이다.
\(\lambda_2 = 1 - r\)에 대해서도 마찬가지로 \(\mathbf{v}_2 = \frac{1}{\sqrt{2}}(1, -1)^\top\)이다.
상관이 \(r\)인 이변량 정규분포의 집중타원은 \(\mathbf{z} = (x, y)^\top\)일 때 어떤 상수 \(c\)에 대한 집합 \(\{(x, y) : \mathbf{z}^\top \mathbf{R}^{-1} \mathbf{z} = c\}\)이다. 이 타원의 주축은 \(\mathbf{R}^{-1}\)의 고유벡터(고유벡터를 공유하므로 \(\mathbf{R}\)의 고유벡터와 같다)이다. 축은 \(\frac{1}{\sqrt{2}}(1, 1)^\top\)과 \(\frac{1}{\sqrt{2}}(1, -1)^\top\) 방향, 즉 \(+45°\)와 \(-45°\) 방향을 가리킨다. 타원 그림이 \(\pm 45°\) 회전을 쓰는 이유이다. \(\square\)
연습문제 5. 변수가 \(k\)개면 타원 그림에는 \(k^2\)개의 타원이 들어간다. 그중 몇 개가 중복인가(다른 타원으로부터 알 수 있는가)? 중복이 아닌 타원만 보이는 수정판을 제안하라.
풀이
상관행렬이 대칭이므로(\(R_{ij} = R_{ji}\)) 위쪽 삼각형과 아래쪽 삼각형은 거울상이다. 대각선은 언제나 \(r = 1\)을 보여준다. 따라서:
- 전체 타원: \(k^2\)
- 대각선(자명하게 \(r = 1\)): \(k\)
- 서로 다른 비대각: \(\frac{k(k-1)}{2}\)
- 중복: \(k + \frac{k(k-1)}{2} = \frac{k(k+1)}{2}\)
중복이 없는 형태는 아래쪽 삼각형의 \(\frac{k(k-1)}{2}\)개 타원만 보인다:
def plot_lower_triangle_ellipses(data, figsize=None, **kwargs):
    M = np.array(data)
    k = M.shape[0]
    fig, ax = plt.subplots(figsize=figsize,
                           subplot_kw={'aspect': 'equal'})
    ax.set_xlim(-0.5, k - 0.5)
    ax.set_ylim(-0.5, k - 0.5)
    ax.invert_yaxis()

    # 아래쪽 삼각형만 — 상관행렬은 대칭이라 위쪽은 되풀이다
    for i in range(k):
        for j in range(i):
            r = M[i, j]
            from matplotlib.patches import Ellipse
            e = Ellipse(xy=(j, i),
                        width=1.01,
                        height=1 - abs(r) - 0.01,
                        angle=45 * np.sign(r))
            e.set_facecolor(plt.cm.bwr_r((r + 1) / 2))
            ax.add_patch(e)

    if isinstance(data, pd.DataFrame):
        ax.set_xticks(range(k))
        ax.set_xticklabels(data.columns, rotation=90)
        ax.set_yticks(range(k))
        ax.set_yticklabels(data.index)
    plt.tight_layout()
    return ax
시각적 혼잡이 줄고 서로 다른 \(\binom{k}{2}\)개의 상관값에 집중할 수 있다. \(\square\)
연습문제 6. 연습문제 4의 고유분해를 이어, 타원의 면적과 축 비율이 \(r\)에 어떻게 의존하는지 정량화하라.
풀이
\(2\times2\) 상관행렬의 고윳값은 \(\lambda_1=1+|r|\), \(\lambda_2=1-|r|\)이다.
| 양 | 식 |
|---|---|
| 축 비율 | \(\sqrt{\lambda_1/\lambda_2}=\sqrt{(1+\lvert r\rvert)/(1-\lvert r\rvert)}\) |
| 면적 | \(\pi c\sqrt{\lambda_1\lambda_2}=\pi c\sqrt{1-r^2}\) |
여기서 \(c=\chi^2_{2,\,0.95}=5.991\)이다.
import numpy as np
from scipy import stats

c = stats.chi2.ppf(0.95, 2)
print(f"95% 타원의 임계값 c = χ²(2, 0.95) = {c:.4f}\n")
print(f"{'r':>6s} {'λ1':>8s} {'λ2':>8s} {'축 비율':>9s} "
      f"{'면적':>10s} {'독립 대비':>10s}")
for r in [0.0, 0.3, 0.5, 0.7, 0.9, 0.99]:
    l1, l2 = 1 + abs(r), 1 - abs(r)
    print(f"{r:6.2f} {l1:8.3f} {l2:8.3f} {np.sqrt(l1 / l2):9.3f} "
          f"{np.pi * c * np.sqrt(l1 * l2):10.4f} {np.sqrt(l1 * l2):10.4f}")
95% 타원의 임계값 c = χ²(2, 0.95) = 5.9915

     r       λ1       λ2      축 비율         면적      독립 대비
  0.00    1.000    1.000     1.000    18.8227     1.0000
  0.30    1.300    0.700     1.363    17.9558     0.9539
  0.50    1.500    0.500     1.732    16.3010     0.8660
  0.70    1.700    0.300     2.380    13.4421     0.7141
  0.90    1.900    0.100     4.359     8.2046     0.4359
  0.99    1.990    0.010    14.107     2.6553     0.1411
면적이 정확히 \(\sqrt{1-r^2}\)에 비례한다.
| \(r\) | 축 비율 | 면적 비 |
|---|---|---|
| 0.0 | 1.00(원) | 1.000 |
| 0.5 | 1.73 | 0.866 |
| 0.7 | 2.38 | 0.714 |
| 0.9 | 4.36 | 0.436 |
| 0.99 | 14.11 | 0.141 |
축 비율은 \(r\)에 훨씬 민감하다. \(r\)이 0.9에서 0.99로 가면 면적은 3배 줄지만 축 비율은 3배 늘어난다(4.36 → 14.11).
이것이 타원 그림이 잘 작동하는 이유다.
| 부호화 | 지각 난이도 |
|---|---|
| 색의 진하기 | 어렵다(맥락 의존) |
| 면적 | 중간(과소평가하는 경향) |
| 길이·기울기 | 쉽다 |
사람은 길이와 방향을 가장 정확히 읽는다(클리블랜드-맥길의 서열). 타원의 납작한 정도는 축의 길이 비이므로 정확히 읽힌다.
면적은 오히려 \(r\)에 둔감하다. \(r=0.3\)에서 면적이 겨우 4.6% 줄어든다. 그래서 면적이 아니라 모양이 정보를 나른다.
부호는 기울기로. 고유벡터가
이므로 장축이 \(r>0\)이면 \(+45^\circ\), \(r<0\)이면 \(-45^\circ\)로 항상 고정이다.
r > 0 :  ╱  방향으로 납작
r < 0 :  ╲  방향으로 납작
r = 0 :  ○  원
기울기가 \(\pm45^\circ\) 둘뿐이므로 부호 판별이 매우 쉽다. 이것이 색각 이상 독자에게 유리한 지점이다.
연습문제 7. 신뢰타원과 개별 신뢰구간의 사각형은 왜 다른가? 피복확률을 비교하라.
풀이
세 영역.
| 영역 | 정의 |
|---|---|
| 타원 | \(\mathbf{d}^TR^{-1}\mathbf{d}\leq\chi^2_{2,0.95}\) |
| 개별 95% 사각형 | \(\lvert x\rvert<1.96\) 그리고 \(\lvert y\rvert<1.96\) |
| 본페로니 사각형 | 각 축에 97.5% 구간 |
import warnings
warnings.filterwarnings("ignore")

import numpy as np
from scipy import stats

rng = np.random.default_rng(28003)
B = 200_000
c = stats.chi2.ppf(0.95, 2)
zb = stats.norm.ppf(1 - 0.025 / 2)
print(f"{'r':>5s} {'타원':>9s} {'개별 95% 사각형':>15s} {'본페로니 사각형':>15s}")
for r in [0.0, 0.5, 0.9]:
    z = rng.standard_normal((B, 2))
    x = z[:, 0]
    y = r * z[:, 0] + np.sqrt(1 - r**2) * z[:, 1]
    d = np.column_stack([x, y])
    R = np.array([[1, r], [r, 1]])
    m2 = np.einsum('ij,jk,ik->i', d, np.linalg.inv(R), d)
    print(f"{r:5.1f} {(m2 <= c).mean():9.4f} "
          f"{((np.abs(x) < 1.96) & (np.abs(y) < 1.96)).mean():15.4f} "
          f"{((np.abs(x) < zb) & (np.abs(y) < zb)).mean():15.4f}")
    r        타원      개별 95% 사각형        본페로니 사각형
  0.0    0.9492          0.9022          0.9502
  0.5    0.9503          0.9093          0.9540
  0.9    0.9501          0.9300          0.9641
타원만 정확히 0.95를 준다. 세 \(r\) 모두에서 그렇다.
| 영역 | \(r=0\) | \(r=0.9\) |
|---|---|---|
| 타원 | 0.950 | 0.950 |
| 개별 95% 사각형 | 0.903 | 0.930 |
| 본페로니 사각형 | 0.950 | 0.964 |
개별 구간을 겹쳐 놓으면 결합 피복이 0.90으로 떨어진다. \(0.95^2=0.9025\)다.
본페로니는 반대로 보수적이다. \(r\)이 클수록 심해져 \(r=0.9\)에서 0.964다.
왜 그런가 — 상관이 있으면 검정이 덜 독립적이기 때문이다.
r = 0  : 두 구간이 독립 → 본페로니가 거의 정확 (0.9502)
r = 0.9: 두 구간이 거의 같은 정보 → 본페로니가 과보정 (0.9641)
타원과 사각형의 모양 차이가 실질적인 결론을 바꾼다.
r = 0.9 인 경우

  점 (1.8, -1.8) 은
    개별 구간으로는 둘 다 안에 있다  → "이상 없음"
    타원 밖에 멀리 있다              → "매우 이상함"

  두 변수가 같이 움직여야 하는데
  반대로 움직였기 때문이다
반대로 타원 안인데 사각형 밖인 점도 있다. \((2.1, 2.1)\)은 상관 구조와 일치하므로 타원 안일 수 있다.
실무적 함의 넷.
- 다변량 이상점 탐지는 타원(마할라노비스 거리)으로 한다. 변수별로 보면 놓친다.
- 결합 신뢰영역을 보고할 때 개별 구간의 곱집합을 쓰면 안 된다.
- 회귀계수 두 개의 결합 검정도 마찬가지다. \(F\) 검정이 타원에 대응한다.
- 차원이 커지면 차이가 급격히 벌어진다. \(p=10\)이면 \(0.95^{10}=0.60\)이다.
네 번째가 고차원에서 결정적이다. 변수 10개를 각각 95% 구간으로 점검하면 정상 개체의 40%가 "이상"으로 잡힌다.
연습문제 8. 타원 그림과 열지도를 정량적으로 비교하라. 어떤 상황에서 어느 쪽이 나은가?
풀이
두 그림이 부호화하는 방식.
| 정보 | 열지도 | 타원 그림 |
|---|---|---|
| 부호 | 색상(빨강/파랑) | 기울기(\(\pm45^\circ\)) |
| 크기 | 색의 진하기 | 납작한 정도 |
| 0에 가까움 | 흰색 | 원 |
| \(\pm1\)에 가까움 | 진한 색 | 선분에 가까움 |
지각적 정확도의 서열(클리블랜드-맥길, 1984).
정확한 쪽 →                           → 부정확한 쪽
1. 공통 축 위의 위치
2. 공통 척도 없는 위치
3. 길이 · 방향 · 각도      ← 타원 그림
4. 면적
5. 부피 · 곡률
6. 명도 · 색의 채도        ← 열지도
타원이 3번, 열지도가 6번이다. 값을 정확히 읽는 과제에서는 타원이 유리하다.
그런데 열지도가 더 널리 쓰인다. 이유가 있다.
| 열지도의 장점 | 내용 |
|---|---|
| 패턴 인식 | 블록 구조가 한눈에 |
| 변수 수 | 50개 이상도 가능 |
| 익숙함 | 독자가 해석 방법을 안다 |
| 구현 | imshow 한 줄 |
타원의 한계. 변수가 30개를 넘으면 각 타원이 몇 픽셀로 줄어 모양을 구분할 수 없다.
선택 기준.
| 상황 | 권장 |
|---|---|
| 변수 5~15개, 값을 읽어야 함 | 타원 |
| 변수 20개 이상, 패턴 파악 | 열지도 |
| 흑백 인쇄 | 타원 |
| 색각 이상 독자 | 타원 또는 숫자 병기 |
| 슬라이드·빠른 스캔 | 열지도 |
세 번째와 네 번째가 타원의 결정적 장점이다.
흑백 인쇄에서
  열지도: 빨강과 파랑이 비슷한 회색이 된다 → 부호 소실
  타원:   기울기는 그대로 보인다           → 부호 유지
가장 좋은 방법은 결합이다.
| 요소 | 부호화 |
|---|---|
| 타원의 모양 | \(\lvert r\rvert\) |
| 타원의 기울기 | \(r\)의 부호 |
| 타원의 색 | \(r\)(중복 부호화) |
| 칸 안의 숫자 | 정확한 값 |
중복 부호화(redundant encoding)가 접근성의 원칙이다. 하나의 채널이 막혀도 정보가 전달된다.
구현 요령.
타원의 매개변수 (중심 (i,j) 의 칸에)
  폭   w = 2 · s · √(1+|r|) / √2
  높이 h = 2 · s · √(1-|r|) / √2
  각도 θ = 45° if r > 0 else -45°
  s 는 칸 크기의 절반 정도

matplotlib.patches.Ellipse((j, i), w, h, angle=θ)
주의 — 크기로 다른 정보를 담지 않는다. 타원의 전체 크기를 \(n\)이나 유의성에 연결하면 모양 판독이 방해받는다.
연습문제 9. 마할라노비스 거리와 타원의 관계를 확인하고, 다변량 이상점 탐지에 적용하라.
풀이
정의.
\(D^2\)의 등고선이 곧 타원이며, 다변량 정규에서 \(D^2\sim\chi^2_p\)다.
import warnings
warnings.filterwarnings("ignore")

import numpy as np
from scipy import stats

rng = np.random.default_rng(28004)
print("D² 의 분포가 χ²(p) 인가")
print(f"{'p':>4s} {'평균 D²':>9s} {'이론 p':>8s} {'95 분위':>9s} {'χ²(p,0.95)':>11s}")
for p in [2, 5, 10]:
    A = rng.standard_normal((p, p))
    S = A @ A.T + p * np.eye(p)
    X = rng.multivariate_normal(np.zeros(p), S, size=200_000)
    D2 = np.einsum('ij,jk,ik->i', X, np.linalg.inv(S), X)
    print(f"{p:4d} {D2.mean():9.4f} {p:8d} {np.quantile(D2, 0.95):9.4f} "
          f"{stats.chi2.ppf(0.95, p):11.4f}")

print("\n### 변수별 점검 대 마할라노비스 점검")
r = 0.9
S = np.array([[1, r], [r, 1]])
X = rng.multivariate_normal([0, 0], S, size=200_000)
D2 = np.einsum('ij,jk,ik->i', X, np.linalg.inv(S), X)
out_m = D2 > stats.chi2.ppf(0.95, 2)
out_u = (np.abs(X[:, 0]) > 1.96) | (np.abs(X[:, 1]) > 1.96)
print(f"  정상 자료에서 (r={r})")
print(f"    마할라노비스로 이상 판정: {out_m.mean():.4f}")
print(f"    변수별 |z|>1.96 로 판정:  {out_u.mean():.4f}")
print(f"    둘 다 이상:               {(out_m & out_u).mean():.4f}")
print(f"    마할라노비스만 이상:      {(out_m & ~out_u).mean():.4f}")
print(f"    변수별만 이상:            {(~out_m & out_u).mean():.4f}")

probe = np.array([[1.8, -1.8], [2.4, 2.4], [3.0, 0.0]])
print(f"\n  특정 점의 판정 (r={r})")
for pt in probe:
    d2 = pt @ np.linalg.inv(S) @ pt
    print(f"    ({pt[0]:+.1f}, {pt[1]:+.1f}): D²={d2:8.3f} → "
          f"{'타원 밖' if d2 > stats.chi2.ppf(0.95, 2) else '타원 안':>6s},  "
          f"변수별 → {'밖' if np.any(np.abs(pt) > 1.96) else '안'}")
D² 의 분포가 χ²(p) 인가
   p     평균 D²     이론 p     95 분위  χ²(p,0.95)
   2    2.0029        2    5.9949      5.9915
   5    4.9953        5   11.0777     11.0705
  10   10.0214       10   18.3520     18.3070

### 변수별 점검 대 마할라노비스 점검
  정상 자료에서 (r=0.9)
    마할라노비스로 이상 판정: 0.0491
    변수별 |z|>1.96 로 판정:  0.0701
    둘 다 이상:               0.0316
    마할라노비스만 이상:      0.0176
    변수별만 이상:            0.0386

  특정 점의 판정 (r=0.9)
    (+1.8, -1.8): D²=  64.800 →   타원 밖,  변수별 → 안
    (+2.4, +2.4): D²=   6.063 →   타원 밖,  변수별 → 밖
    (+3.0, +0.0): D²=  47.368 →   타원 밖,  변수별 → 밖
\(D^2\)의 평균이 정확히 \(p\)이고 95분위가 \(\chi^2_{p,0.95}\)와 일치한다.
두 판정이 크게 어긋난다.
| 판정 | 비율 |
|---|---|
| 마할라노비스만 이상 | 1.76% |
| 변수별만 이상 | 3.86% |
| 둘 다 이상 | 3.16% |
두 방법이 서로 다른 5.6%를 잡아낸다. 겹치는 부분은 3.2%뿐이다.
\((+1.8,-1.8)\)이 가장 극적인 예다.
| 점검 | 결과 |
|---|---|
| 변수별 | 둘 다 \(\lvert z\rvert<1.96\) → 정상 |
| 마할라노비스 | \(D^2=64.8\)(임계값 5.99) → 극단적 이상 |
손으로 검산해 보면. \(R^{-1}=\dfrac{1}{1-0.81}\begin{pmatrix}1&-0.9\\-0.9&1\end{pmatrix}\)이므로
\(r=0.9\)이면 두 변수가 같이 움직여야 하는데 정반대로 움직였다. 변수를 하나씩 보면 절대 보이지 않는다.
실무 지침 넷.
- 다변량 자료의 이상점은 \(D^2\)으로 찾는다.
- \(\Sigma\)를 강건하게 추정한다. 이상점이 \(\Sigma\)를 오염시키면 자기 자신을 숨긴다(가림 효과).
sklearn의MinCovDet(최소 공분산 행렬식)이 표준 도구다.- \(p\)가 크면 \(D^2\)이 불안정하다. \(n\gg p\)가 필요하다.
from sklearn.covariance import MinCovDet
mcd = MinCovDet(support_fraction=0.75).fit(X)
d2 = mcd.mahalanobis(X)          # 강건한 D²
두 번째가 가장 자주 간과된다. 표본 공분산으로 계산한 \(D^2\)은 이상점이 여럿이면 아무것도 못 잡는다.
연습문제 10. 타원 그림의 사용 지침을 정리하라.
풀이
부호화 규칙.
| 타원의 성질 | 나타내는 것 | 식 |
|---|---|---|
| 기울기 | \(r\)의 부호 | \(+45^\circ\) 또는 \(-45^\circ\) |
| 납작한 정도 | \(\lvert r\rvert\) | 축 비 \(\sqrt{(1+\lvert r\rvert)/(1-\lvert r\rvert)}\) |
| 면적 | \(\sqrt{1-r^2}\) | 정보가 적다 |
| 색(선택) | \(r\)(중복 부호화) | — |
핵심 수치 여섯.
| 사실 | 값 |
|---|---|
| \(r=0.9\)의 축 비 | 4.36 |
| \(r=0.99\)의 축 비 | 14.11 |
| \(r=0.9\)의 면적 비 | 0.436 |
| \(r=0.3\)의 면적 비 | 0.954(거의 원) |
| 95% 타원의 임계값(\(p=2\)) | \(\chi^2_{2,0.95}=5.991\) |
| 개별 95% 사각형의 결합 피복 | 0.903 |
면적이 \(r\)에 둔감하다는 점이 요점이다. \(r=0.3\)에서 면적이 4.6%밖에 안 줄어들므로, 모양(축 비)이 정보를 나른다.
언제 타원 그림을 쓰나.
| 상황 | 타원이 나은가 |
|---|---|
| 변수 5~15개 | 그렇다 |
| 흑백 인쇄 | 그렇다 |
| 색각 이상 독자 | 그렇다 |
| 값을 정확히 읽어야 함 | 그렇다 |
| 변수 30개 이상 | 아니다(열지도) |
| 슬라이드, 빠른 패턴 스캔 | 아니다 |
제작 체크리스트 여섯.
□ 대각선(r=1)은 가리거나 선분으로 표시
□ 위쪽 삼각형을 가려 중복 제거
□ 색을 함께 써서 중복 부호화
□ 변수가 15개 이하면 숫자도 병기
□ 타원의 전체 크기는 고정 (다른 정보를 담지 않는다)
□ 범례에 "기울기 = 부호, 납작함 = 크기"를 명시
다섯 번째를 어기기 쉽다. "\(n\)이 클수록 크게" 같은 부호화를 추가하면 모양 판독이 무너진다.
타원은 신뢰영역으로도 쓰인다. 두 용도를 혼동하지 않는다.
| 용도 | 무엇의 타원인가 |
|---|---|
| 상관 행렬 그림 | 각 칸이 \(2\times2\) 상관행렬의 모양 |
| 신뢰타원 | 두 모수의 결합 신뢰영역 |
| 집중타원 | 자료의 95%가 들어가는 영역 |
| 예측타원 | 새 관측의 95% 영역 |
셋째와 넷째의 차이는 모수 추정의 불확실성 포함 여부다. 표본이 크면 거의 같아진다.
흔한 실수 넷.
| 실수 | 대가 |
|---|---|
| 면적으로 \(\lvert r\rvert\)를 읽음 | 둔감(\(r=0.3\)에서 4.6%) |
| 크기에 다른 정보를 담음 | 모양 판독 방해 |
| 변수 30개에 타원 그림 | 아무것도 안 보임 |
| 개별 구간 사각형을 결합영역으로 | 피복 0.90 |
한 문장. 타원 그림은 상관을 색이 아니라 모양으로 부호화하여 흑백·색각 이상 조건에서도 읽히게 만드는 도구이며, 변수 수가 적당할 때 열지도보다 정확하게 읽힌다.
정리하며
타원 그림은 색 대신 모양으로 상관을 부호화한다.
- 이심률이 \(|r|\), 기울기 방향이 부호다. 원이면 \(r=0\), 납작할수록 \(|r|\) 이 크며, \(|r|\to1\) 에서 선으로 붕괴한다.
- 4장의 이변량 정규 등고선과 같은 기하다. 공분산행렬의 고유분해가 타원의 축을 정한다는 사실이 여기서 시각적으로 쓰인다.
- 회색조 인쇄와 색각 이상 독자에게 유리하다. 색 하나에만 의존하지 않는 부호화이므로 접근성이 좋다.
- 모양은 크기보다 읽기 쉽다. 사람은 색의 미세한 차이보다 형태의 차이를 잘 구별하며, 특히 약한 상관과 중간 상관을 가르는 데 낫다.
- 열지도와 병용하면 좋다. 타원으로 모양을, 색으로 부호를 함께 주면 읽기가 더 쉬워진다.
다음 절 공분산 밑바닥부터 만들기로 넘어간다.